Análisis Avanzado de Datos — 1. Introducción y repaso de regresión lineal
estadistica
regresion-lineal
scikit-learn
Primer artículo de la serie: la regresión lineal simple a fondo, con fórmula cerrada, forma matricial, interpretación de coeficientes y residuales, y ejercicios en scikit-learn.
Author
Wilder Ramírez Delgado
Published
August 26, 2026
Análisis Avanzado de Datos — 1. Introducción y repaso de regresión lineal
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
¿Qué es la regresión lineal y qué problema resuelve?
Este es el primer artículo de la serie, y vale la pena tomárselo con calma: la regresión lineal es la base sobre la que se construye prácticamente todo lo demás — regularización, modelos lineales generalizados, suavizado, incluso partes de los artículos sobre datos dependientes (series de tiempo y datos longitudinales). Si entiendes bien esta pieza, todo lo que viene después te va a resultar mucho más natural.
En el fondo, la pregunta que resuelve la regresión es sencilla: ¿puedes predecir un valor numérico a partir de otras variables que sí conoces?
Piensa en ejemplos cotidianos:
Predecir el precio de una casa a partir de su tamaño, su ubicación y su antigüedad.
Predecir las ventas del próximo mes a partir de la inversión en publicidad.
Predecir cómo va a evolucionar una enfermedad en un paciente a partir de variables clínicas como su edad, su presión arterial o su índice de masa corporal (IMC).
En los tres casos tienes una variable que te interesa predecir (el objetivo o variable de respuesta, \(y\)) y una o más variables que usas para predecirla (las variables predictoras o features, \(x\)). La regresión lineal asume algo concreto: que la relación entre esas variables predictoras y el objetivo se puede aproximar razonablemente bien con una línea recta (o, con varias variables, con un plano o hiperplano).
Es un supuesto fuerte — el mundo real casi nunca es perfectamente lineal — pero es muy útil como punto de partida: es fácil de ajustar, fácil de interpretar y, en muchos problemas, funciona sorprendentemente bien. Por eso es el primer modelo que vas a dominar a fondo en esta serie.
A lo largo de este notebook vas a trabajar con el dataset diabetes de scikit-learn: datos clínicos de 442 pacientes (edad, sexo, IMC, presión arterial y varias mediciones de sangre) con los que vas a predecir un índice cuantitativo de progresión de la enfermedad un año después de la medición inicial. Es un dataset pequeño, real y viene incluido en la librería, así que todo el código de este notebook corre sin depender de archivos externos.
import numpy as npimport pandas as pdfrom sklearn.datasets import load_diabetesSEMILLA =42# semilla global para toda celda con aleatoriedaddiabetes = load_diabetes(as_frame=True)X_completo = diabetes.datay = diabetes.target # progresión de la enfermedad, medida un año después del inicioprint(f"Observaciones: {X_completo.shape[0]}")print(f"Variables predictoras: {list(X_completo.columns)}")X_completo.head()
Antes de seguir, vale la pena saber qué mide cada columna — las vas a interpretar más adelante:
Variable
Significado
age
Edad del paciente
sex
Sexo del paciente
bmi
Índice de masa corporal (IMC)
bp
Presión arterial media
s1
Colesterol total en sangre (tc)
s2
Colesterol LDL, el “colesterol malo” (ldl)
s3
Colesterol HDL, el “colesterol bueno” (hdl)
s4
Razón colesterol total / HDL (tch)
s5
Nivel de triglicéridos en sangre, en escala logarítmica (ltg)
s6
Nivel de azúcar en sangre (glu)
Y la variable de salida, y, es una medida cuantitativa de qué tan avanzada está la enfermedad un año después de la medición inicial: cuanto más alto el valor, más ha progresado.
Regresión lineal simple: una variable predictora
Empieza por el caso más simple posible: predecir \(y\) usando una sola variable predictora, \(x\). El modelo de regresión lineal simple es una recta:
\[\hat{y} = \beta_0 + \beta_1 x\]
Donde:
\(\hat{y}\) es el valor predicho por el modelo, distinto del valor real observado, \(y\).
\(\beta_0\) es el intercepto: el valor predicho de \(y\) cuando \(x = 0\). Geométricamente, es el punto donde la recta cruza el eje vertical.
\(\beta_1\) es la pendiente: cuánto cambia \(\hat{y}\) por cada unidad que aumenta \(x\). Si \(\beta_1 > 0\), la relación es positiva (a más \(x\), más \(y\)); si \(\beta_1 < 0\), es negativa.
¿Cómo encuentras esa recta? (y por qué no basta con el \(y = mx + b\) del colegio)
Seguro te acuerdas del colegio: para encontrar la ecuación de una recta \(y = mx + b\) te bastaba con dos puntos — resolvías un sistema de dos ecuaciones y dos incógnitas (\(m\) y \(b\)), y la recta pasaba exactamente por esos dos puntos. Fin del problema.
El problema es que en regresión no tienes dos puntos: tienes diez, cientos o miles. Y esos puntos casi nunca están perfectamente alineados — hay ruido, variabilidad, factores que no mediste. Si intentaras resolver el sistema con todos los puntos a la vez, tendrías muchas más ecuaciones (una por cada observación) que incógnitas (solo dos: \(\beta_0\) y \(\beta_1\)). Un sistema así, con más ecuaciones que incógnitas, casi nunca tiene solución exacta: no existe ninguna recta que pase exactamente por todos los puntos al mismo tiempo, a menos que por pura casualidad estén perfectamente alineados.
Entonces, en lugar de buscar una recta que pase exactamente por todos los puntos (imposible, en la práctica), buscas la recta que se acerque lo más posible a todos ellos, en promedio. Para eso necesitas dos cosas: una forma de medir “qué tan lejos” queda la recta de cada punto, y un criterio para decidir cuál recta queda “más cerca” en general.
Lo primero es fácil: para cada observación \(i\), el modelo predice \(\hat{y}_i\), pero el valor real es \(y_i\). La diferencia es el residual:
\[e_i = y_i - \hat{y}_i\]
Un residual positivo significa que el modelo subestimó el valor real; uno negativo, que lo sobrestimó.
Lo segundo — el criterio — es lo que le da nombre al método. Mínimos cuadrados ordinarios (Ordinary Least Squares, OLS) elige los coeficientes \(\beta_0\) y \(\beta_1\) que minimizan la suma de esos residuales al cuadrado:
Esa suma se conoce como SSE (sum of squared errors): por cada punto, mides qué tan lejos quedó la recta, elevas esa distancia al cuadrado y sumas todo. Cuanto más pequeña sea la suma, mejor se ajusta la recta a los datos — y la “mejor” recta, por definición, es la que hace esa suma lo más pequeña posible.
¿Por qué elevar al cuadrado y no, por ejemplo, sumar los valores absolutos? Dos razones prácticas:
Penaliza con más fuerza los errores grandes que los pequeños: un error del doble de tamaño aporta cuatro veces más a la suma. (Tanto el cuadrado como el valor absoluto evitan que un residual positivo se cancele con uno negativo; por eso no sirve sumar los residuales tal cual: una recta con errores enormes pero balanceados daría una suma cercana a cero y parecería “perfecta” sin serlo.)
Convierte el problema en uno que tiene una solución exacta, calculable con álgebra — no hace falta “probar” rectas una por una.
Tiene respaldo teórico: si los errores tienen media cero, varianza constante y no están correlacionados, el teorema de Gauss–Markov garantiza que mínimos cuadrados da, entre todos los estimadores lineales insesgados, el de menor varianza; y si además los errores son normales, coincide con el estimador de máxima verosimilitud.
En resumen: la ecuación de la recta del colegio resuelve un problema determinado (misma cantidad de ecuaciones que de incógnitas, con dos puntos exactos). Mínimos cuadrados resuelve un problema sobredeterminado — muchas más ecuaciones que incógnitas — encontrando la mejor aproximación posible en lugar de una solución exacta.
La fórmula cerrada: la solución al problema de minimización
Resolver ese problema de minimización (con cálculo: derivando el SSE respecto a \(\beta_0\) y \(\beta_1\), e igualando a cero) te da una fórmula directa para los coeficientes óptimos — la que probablemente ya conoces de estadística básica:
Donde \(\bar{x}\) y \(\bar{y}\) son los promedios de \(x\) y de \(y\). La intuición detrás:
El numerador de \(\beta_1\) es, salvo una constante, la covarianza entre \(x\) y \(y\): mide si ambas variables se mueven juntas.
El denominador es, con la misma constante, la varianza de \(x\): qué tanto se dispersan los valores de \(x\) alrededor de su media.
\(\beta_1\) es, entonces, “cuánto se mueven juntas \(x\) y \(y\)” dividido entre “cuánto se mueve \(x\) por sí sola” — la razón de cambio que buscabas.
\(\beta_0\) garantiza que la recta pase exactamente por el punto \((\bar{x}, \bar{y})\): el centro de masa de los datos.
¿Por qué no hay que iterar, como en otros modelos de machine learning?
Si ya oíste hablar de descenso de gradiente (gradient descent) en otro contexto, probablemente te estás haciendo esta pregunta: ¿por qué aquí no hay que “ir probando” iterativamente, acercándose poco a poco al mínimo, como sí se hace para entrenar una red neuronal?
La respuesta está en la forma de la función que estás minimizando. El SSE es una función cuadrática de los coeficientes: visto como función de \(\beta_0\) y \(\beta_1\), es un paraboloide, una superficie con forma de tazón, suave y convexa, sin mínimos locales falsos ni mesetas donde un algoritmo se pueda quedar atascado (con más variables sigue siendo un paraboloide, en más dimensiones). Eso te da dos garantías:
Existe un único mínimo global, siempre que los valores de \(x\) no sean todos iguales (con varias variables: que ninguna columna de la matriz de datos sea combinación lineal de las demás) — no hay riesgo de encontrar una solución subóptima “por mala suerte”.
Ese mínimo tiene una ubicación exacta y calculable: es, sencillamente, el punto donde el fondo del tazón es plano, es decir, donde la derivada del SSE respecto a cada \(\beta\) vale cero. Resolver ese sistema de ecuaciones (derivadas = 0) es justo lo que te da la fórmula cerrada de arriba — o, en su versión matricial, la ecuación normal que vas a ver más adelante.
Otros modelos no tienen esa suerte. En la regresión logística, que verás más adelante en la serie, la función de costo sigue siendo convexa (un único mínimo), pero no tiene fórmula cerrada: hay que llegar a ese mínimo con un método iterativo. En las redes neuronales, además, la función de costo no es convexa: hay que iterar con descenso de gradiente, dando pasos pequeños hacia donde el error disminuye, sin garantía de encontrar el mínimo global. La regresión lineal es uno de los pocos modelos “con suerte”: puedes saltarte todo ese proceso iterativo e ir directo a la respuesta exacta con una fórmula.
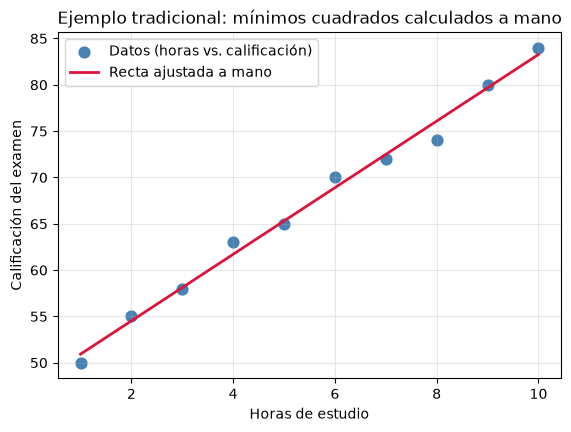
Esta fórmula no es una elección arbitraria: es, precisamente, la solución del problema de mínimos cuadrados que acabas de plantear. Aplícala sobre un ejemplo pequeño y tradicional — horas de estudio de 10 estudiantes contra su calificación en un examen — usando solo NumPy, sin ninguna librería de machine learning.
La pendiente \(\beta_1 = 3.59\) dice que cada hora adicional de estudio se asocia, en promedio, con 3.59 puntos más de calificación. El intercepto \(\beta_0 = 47.33\) es la calificación que la recta predice para 0 horas: un valor fuera del rango observado (de 1 a 10 horas), que conviene leer solo como el punto de anclaje de la recta. Y puedes comprobar que la recta pasa por el centro de los datos: \(47.33 + 3.59 \times 5.50 \approx 67.10 = \bar{y}\).
Compruébalo ahora con scikit-learn: ajusta el mismo modelo sobre los mismos datos y confirma que llegas exactamente a los mismos coeficientes por el camino “automático”.
from sklearn.linear_model import LinearRegressionmodelo_estudio = LinearRegression()modelo_estudio.fit(horas_estudio.reshape(-1, 1), calificacion)print("Fórmula clásica (a mano):", round(beta0_manual, 2), round(beta1_manual, 2))print("scikit-learn: ", round(modelo_estudio.intercept_, 2), round(modelo_estudio.coef_[0], 2))predicho = modelo_estudio.predict(np.array([[12]]))[0] # 12 horas: fuera del rango observado (1 a 10)print(f"Predicción de calificación para 12 horas de estudio: {predicho:.2f}")
Fórmula clásica (a mano): 47.33 3.59
scikit-learn:             47.33 3.59
Predicción de calificación para 12 horas de estudio: 90.46
Cómo funciona scikit-learn por dentro: instanciar, ajustar, predecir
Detente un momento en ese código, porque el mismo patrón de tres pasos se repite en todos los modelos de scikit-learn que vas a usar en la serie — regresión, regularización, clasificación, lo que sea:
Instanciar el modelo: LinearRegression() crea un objeto “vacío”, que todavía no ha visto ningún dato. En este punto no tiene coeficientes ni sabe nada — solo declara qué tipo de modelo vas a usar (y, si aplica, sus hiperparámetros: valores que fijas tú antes del ajuste y que el modelo no aprende de los datos, como alpha en Ridge(alpha=1.0)).
Ajustar, con .fit(X, y): aquí ocurre el aprendizaje. scikit-learn recibe la matriz de variables predictoras X y el vector objetivo y, resuelve por dentro el mismo problema de mínimos cuadrados que viste a mano, y guarda el resultado como atributos del objeto: modelo_estudio.intercept_ y modelo_estudio.coef_. El guion bajo al final (intercept_, coef_) es una convención de scikit-learn: marca que ese atributo se calculó durante el .fit(), no que lo definiste tú.
Predecir, con .predict(X_nuevo): una vez ajustado, el objeto ya “conoce” \(\beta_0\) y \(\beta_1\), así que puede darte predicciones para datos nuevos sin volver a calcular nada — solo evalúa el modelo con los coeficientes que ya aprendió.
Este patrón — instanciar → ajustar → predecir — es la razón por la que más adelante vas a poder cambiar LinearRegression por Ridge, Lasso o casi cualquier otro modelo de la serie modificando una sola línea: todos comparten la misma interfaz.
Un detalle sobre horas_estudio.reshape(-1, 1): scikit-learn siempre espera que X sea una matriz 2D (filas = observaciones, columnas = variables), incluso cuando solo tienes una variable predictora — por eso conviertes el vector de 10 valores en una matriz de 10 filas y 1 columna. y, en cambio, sí puede pasarse como un vector 1D.
Como esperabas, ambos caminos llegaron exactamente al mismo resultado (47.33 y 3.59) — scikit-learn resuelve por dentro el mismo problema de mínimos cuadrados cuando llamas a .fit(). La última línea usa .predict() para 12 horas y da 90.46; ten presente que es una extrapolación: nadie en los datos estudió más de 10 horas, así que nada garantiza que la tendencia lineal se mantenga ahí (y, extendida lo suficiente, la recta superaría el máximo de 100 puntos).
Antes de seguir, pregúntate
Si mantienes la pendiente y solo bajas el intercepto 3 puntos, toda la recta baja 3 puntos. ¿Cuánto debería crecer el SSE? Anota tu respuesta y compárala con la salida de la próxima celda.
Ahora, ¿cómo sabes que esa fórmula realmente te da la recta con el SSE más bajo posible, y no solo una recta razonable? Compruébalo con números concretos: calcula el SSE que produce la recta ajustada, y compáralo con el de un par de rectas alternativas elegidas de forma arbitraria (un poco más inclinada, un poco más alta). Si la fórmula es correcta, ninguna alternativa debería producir un SSE menor.
SSE con la recta de mínimos cuadrados:       9.3
SSE con pendiente +1 (recta alternativa 1):  394.3
SSE con intercepto -3 (recta alternativa 2): 99.3
Cómo leer este resultado
La recta de mínimos cuadrados deja un SSE de 9.3; subir la pendiente en 1 lo lleva a 394.3 y bajar el intercepto en 3, a 99.3. Los aumentos no son casuales: como los residuales de la recta óptima suman cero y no están correlacionados con \(x\), desplazar el intercepto en \(\delta\) suma exactamente \(n\delta^2 = 10 \cdot 3^2 = 90\) al SSE, y cambiar la pendiente en \(\delta\) suma \(\delta^2 \sum x_i^2 = 1 \cdot 385 = 385\). Eso sí: probar dos alternativas no demuestra nada por sí solo. La garantía de que ninguna otra recta da un SSE menor viene de la derivación (el SSE es convexo y la fórmula anula sus derivadas); esta comparación solo la ilustra.
La diferencia real entre calcular a mano y usar scikit-learn aparece con la escala: con una variable y diez observaciones, la fórmula a mano es perfectamente manejable; con cientos de observaciones prefieres que la librería haga el cálculo por ti, de forma más rápida y numéricamente estable.
Un detalle importante que vas a necesitar para interpretar los coeficientes en el dataset real: scikit-learn entrega el dataset diabetes con las 10 variables ya centradas en media cero y reescaladas. Es decir, un valor de bmi de 0.05 no es un IMC de 0.05 — es una versión reescalada del IMC real del paciente (en la sección de interpretación verás exactamente qué reescalado). Ten esto presente en la interpretación.
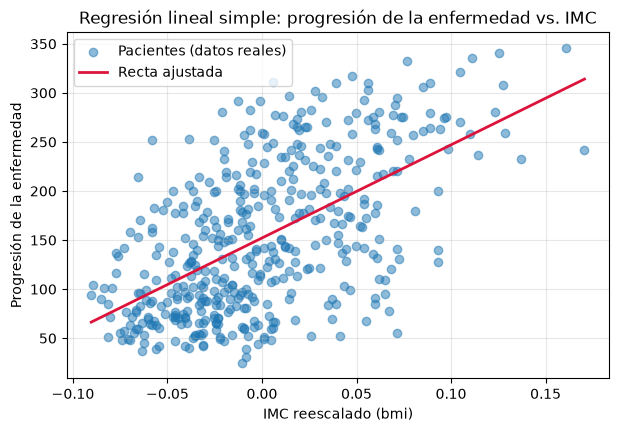
Ahora aplica lo mismo sobre datos clínicos reales, usando bmi como variable predictora y LinearRegression de scikit-learn.
x_bmi = X_completo[["bmi"]] # scikit-learn espera una matriz 2D, no un vectormodelo_simple = LinearRegression()modelo_simple.fit(x_bmi, y)beta0 = modelo_simple.intercept_beta1 = modelo_simple.coef_[0]print(f"Intercepto (beta0): {beta0:.2f}")print(f"Pendiente (beta1): {beta1:.2f}")x_recta = np.linspace(x_bmi["bmi"].min(), x_bmi["bmi"].max(), 100)y_recta = beta0 + beta1 * x_rectafig, ax = plt.subplots(figsize=(7, 4.5))ax.scatter(x_bmi, y, alpha=0.5, label="Pacientes (datos reales)")ax.plot(x_recta, y_recta, color="crimson", linewidth=2, label="Recta ajustada")ax.set_xlabel("IMC reescalado (bmi)")ax.set_ylabel("Progresión de la enfermedad")ax.set_title("Regresión lineal simple: progresión de la enfermedad vs. IMC")ax.legend()ax.grid(alpha=0.3)plt.show()
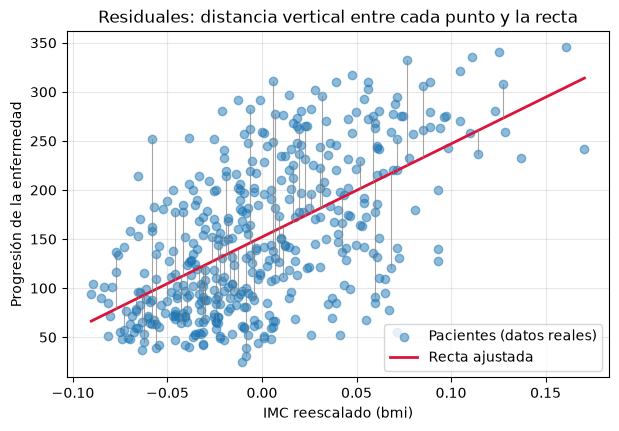
Ya comprobaste con números que la fórmula minimiza el error. Ahora hazlo visual: dibuja los residuales como líneas verticales entre cada punto y la recta ajustada, esta vez sobre los datos reales de bmi y el modelo que ajustaste con scikit-learn.
y_pred_bmi = modelo_simple.predict(x_bmi)residuales_bmi = y - y_pred_bmi# Para que la gráfica sea legible, dibuja los residuales solo de una muestra de pacientesrng = np.random.default_rng(SEMILLA)idx_muestra = rng.choice(len(y), size=60, replace=False)fig, ax = plt.subplots(figsize=(7, 4.5))ax.scatter(x_bmi, y, alpha=0.5, label="Pacientes (datos reales)")ax.plot(x_recta, y_recta, color="crimson", linewidth=2, label="Recta ajustada")for i in idx_muestra: xi = x_bmi["bmi"].iloc[i] ax.plot([xi, xi], [y.iloc[i], y_pred_bmi[i]], color="gray", linewidth=0.8, alpha=0.7)ax.set_xlabel("IMC reescalado (bmi)")ax.set_ylabel("Progresión de la enfermedad")ax.set_title("Residuales: distancia vertical entre cada punto y la recta")ax.legend()ax.grid(alpha=0.3)plt.show()print(f"Suma de residuales al cuadrado (SSE): {np.sum(residuales_bmi **2):,.0f}")
Suma de residuales al cuadrado (SSE): 1,719,582
Interpretación de los coeficientes
Ya tienes el modelo ajustado, pero un modelo solo es útil si sabes leer lo que dice. Fíjate en los valores de beta0 y beta1 que imprimiste arriba (\(\beta_0 \approx 152\), \(\beta_1 \approx 949\)):
El intercepto (\(\beta_0 \approx 152\)) es la progresión de la enfermedad que predice el modelo cuando bmi vale 0, es decir, para un paciente con un IMC exactamente igual al promedio de la muestra (recuerda: la variable está centrada en cero). No lo interpretes como “IMC igual a cero” en el sentido literal — nadie tiene un IMC de cero — sino como “un paciente con IMC promedio”. De hecho, 152.13 es exactamente el promedio de \(y\): la recta pasa por \((\bar{x}, \bar{y})\) y aquí \(\bar{x} = 0\).
La pendiente (\(\beta_1 \approx 949\)) te dice cuánto sube, en promedio, el índice de progresión de la enfermedad por cada unidad que aumenta bmi. Atención a un detalle fácil de asumir mal: scikit-learn no reescaló esta variable a la estandarización habitual (media 0, varianza 1). La centró en media cero y luego dividió cada columna para que la suma de cuadrados diera exactamente 1 (norma L2 unitaria) — un detalle propio de cómo empaquetaron este dataset en particular. La desviación estándar real de esta bmi reescalada es de apenas ≈0.048, no 1 — así que “una unidad” no es un punto de IMC real, y tampoco es una desviación estándar: es sencillamente la unidad de esa escala normalizada específica, sin una lectura clínica directa. De hecho, una unidad de esa escala equivale a unas 21 desviaciones estándar (\(1/0.048\)), más que todo el rango observado de bmi (de −0.09 a 0.17). Una lectura más útil es por desviación estándar: \(949.44 \times 0.048 \approx 45\), es decir, un paciente con un IMC una desviación estándar por encima de otro tiene, en promedio, unas 45 unidades más de progresión. Y el signo se lee sin ambigüedad: la pendiente es positiva, lo que concuerda con la intuición clínica de que un IMC más alto se asocia (asociación, no causalidad) con una enfermedad más avanzada al año.
Este es un punto que te va a servir en cualquier dataset que uses de aquí en adelante: antes de interpretar un coeficiente, revisa en qué unidades está la variable — y no asumas que “estandarizado” siempre significa lo mismo. Un mismo coeficiente significa cosas muy distintas si \(x\) está en las unidades originales o si fue reescalada, y de qué forma.
Interpretación de los errores (residuales)
Ya interpretaste qué dicen los coeficientes. La otra mitad de la historia son los residuales — la diferencia entre lo que predijo el modelo y lo que pasó en realidad, \(e_i = y_i - \hat{y}_i\) — que ya usaste antes para comprobar que la recta minimiza el SSE. Pero los residuales no solo sirven para verificar la fórmula: también te dicen si el modelo está capturando bien la relación entre bmi y la progresión de la enfermedad, o si se le está escapando algo.
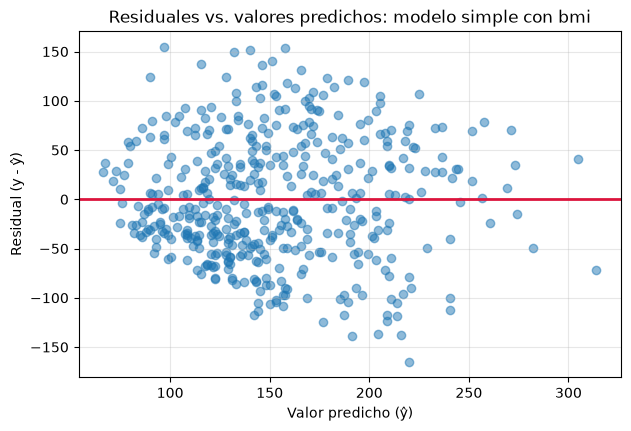
La forma más rápida de leerlos es graficar cada residual contra el valor predicho \(\hat{y}_i\). Buscas que los puntos formen una nube sin forma clara, repartida al azar alrededor de la línea horizontal en cero:
Si ves una curva en vez de una nube sin forma, es señal de que la relación real no es lineal — el modelo se está dejando algo sin capturar.
Si el ancho de la nube cambia de forma clara a medida que te mueves de izquierda a derecha (por ejemplo, se abre como un abanico), es señal de heterocedasticidad: la varianza del error no es constante en todo el rango de predicciones.
Si la nube se ve pareja y sin patrón visible, es una señal razonable de que el modelo no está violando el supuesto de linealidad de forma obvia — aunque un diagnóstico riguroso (normalidad de los residuales, multicolinealidad entre varias variables, etc.) necesita más que una inspección visual, algo que vas a ver a fondo en el próximo artículo de la serie, sobre regresión lineal múltiple.
La celda imprime además dos resúmenes numéricos. La desviación estándar de los residuales, en las mismas unidades que \(y\), dice qué tan lejos de la recta queda un paciente típico. El coeficiente de determinación\(R^2 = 1 - \text{SSE}/\text{SST}\), donde \(\text{SST} = \sum_i (y_i - \bar{y})^2\) es la variabilidad total de \(y\), es la proporción de esa variabilidad que explica el modelo: 0 si no explica nada, 1 si los puntos caen exactamente sobre la recta. Es la forma de poner en contexto el SSE de 1,719,582 que imprimiste arriba, difícil de leer por sí solo porque está en unidades al cuadrado.
fig, ax = plt.subplots(figsize=(7, 4.5))ax.scatter(y_pred_bmi, residuales_bmi, alpha=0.5)ax.axhline(0, color="crimson", linewidth=2)ax.set_xlabel("Valor predicho (ŷ)")ax.set_ylabel("Residual (y - ŷ)")ax.set_title("Residuales vs. valores predichos: modelo simple con bmi")ax.grid(alpha=0.3)plt.show()print(f"R² del modelo: {modelo_simple.score(x_bmi, y):.3f}")print(f"Desviación estándar de los residuales: {residuales_bmi.std():.2f}")
R² del modelo: 0.344
Desviación estándar de los residuales: 62.44
Cómo leer este resultado
La nube no muestra una curva evidente: no hay señal de que la relación con bmi deje de ser lineal. El ancho, en cambio, no es del todo parejo: para predicciones bajas (a la izquierda de \(\hat{y} \approx 110\)) la nube es más angosta y su borde inferior forma una diagonal. Esa diagonal no es un defecto de la recta, sino un límite de los datos: la progresión mínima observada en el dataset es 25, así que ningún residual puede ser menor que \(25 - \hat{y}\). Es una heterocedasticidad leve, que conviene tener presente.
Lo que sí salta a la vista es la dispersión: los residuales se mueven en un rango amplio (desviación estándar de más de 60 unidades) y el R² apenas llega a 0.34.
Eso no es un problema del ajuste — la recta sí es la que minimiza el SSE — sino una limitación de usar una sola variable: bmi por sí solo deja bastante variabilidad de la progresión de la enfermedad sin explicar.
Esa brecha se reduce, aunque no desaparece, al combinar varias variables predictoras: con las 10 variables juntas en un LinearRegression, el \(R^2\) sobre estos mismos datos sube a cerca de 0.52 (compruébalo ajustando el modelo con X_completo). Cómo construir, interpretar y diagnosticar ese modelo de regresión lineal múltiple es el tema del próximo artículo de la serie.
Otro ejemplo: predecir el valor de una vivienda
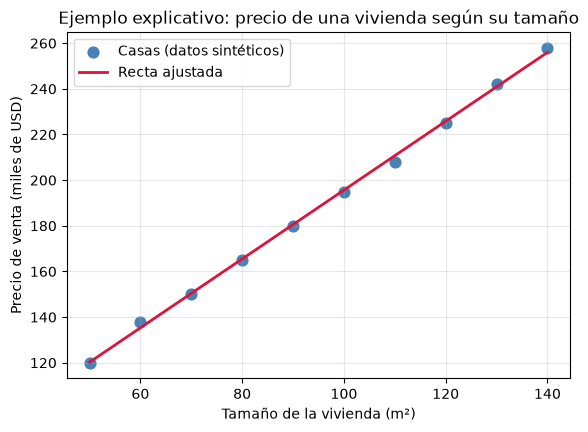
Para que la idea no se limite a un solo dataset, repítela con un problema clásico y puramente ilustrativo: predecir el precio de una vivienda a partir de su tamaño. No necesitas un dataset real para esto — con unos pocos puntos sintéticos alcanza para ver el patrón con claridad.
Aplica exactamente el mismo procedimiento que ya conoces: calcula \(\beta_0\) y \(\beta_1\) con la fórmula clásica y, por separado, con LinearRegression, para comprobar otra vez que ambos caminos llegan al mismo resultado.
# Datos sintéticos, solo para ilustrar: tamaño (m²) y precio de venta (miles de USD) de 10 casastamano_m2 = np.array([50, 60, 70, 80, 90, 100, 110, 120, 130, 140])precio = np.array([120, 138, 150, 165, 180, 195, 208, 225, 242, 258])# Camino 1: fórmula clásica, a manox_media_h = tamano_m2.mean()y_media_h = precio.mean()beta1_h = np.sum((tamano_m2 - x_media_h) * (precio - y_media_h)) / np.sum( (tamano_m2 - x_media_h) **2)beta0_h = y_media_h - beta1_h * x_media_h# Camino 2: scikit-learnmodelo_vivienda = LinearRegression()modelo_vivienda.fit(tamano_m2.reshape(-1, 1), precio)print("Fórmula clásica (a mano):", round(beta0_h, 2), round(beta1_h, 2))print("scikit-learn: ", round(modelo_vivienda.intercept_, 2), round(modelo_vivienda.coef_[0], 2))x_recta_h = np.linspace(tamano_m2.min(), tamano_m2.max(), 100)y_recta_h = beta0_h + beta1_h * x_recta_hfig, ax = plt.subplots(figsize=(6.5, 4.5))ax.scatter(tamano_m2, precio, color="steelblue", s=60, label="Casas (datos sintéticos)")ax.plot(x_recta_h, y_recta_h, color="crimson", linewidth=2, label="Recta ajustada")ax.set_xlabel("Tamaño de la vivienda (m²)")ax.set_ylabel("Precio de venta (miles de USD)")ax.set_title("Ejemplo explicativo: precio de una vivienda según su tamaño")ax.legend()ax.grid(alpha=0.3)plt.show()
Fórmula clásica (a mano): 44.79 1.51
scikit-learn:             44.79 1.51
Cómo leer este resultado
Los dos caminos coinciden otra vez (\(\beta_0 = 44.79\), \(\beta_1 = 1.51\)). La pendiente confirma la intuición: cada m² adicional se asocia, en promedio, con 1.51 mil USD más de precio (unos 1 510 USD). El intercepto, 44.79 mil USD, sería el precio de una casa de 0 m²: una extrapolación sin sentido físico, fuera del rango de 50 a 140 m², que solo fija la altura de la recta. Ya tienes un modelo ajustado — ahora la pregunta natural es: ¿cómo lo usas para predecir un caso nuevo, uno que no está en los datos?
Con la recta ya ajustada, predecir es tan simple como evaluarla en el nuevo valor de \(x\). Fíjate en un detalle práctico: scikit-learn espera que le pases una matriz 2D para predecir, incluso si es un único valor y una sola variable — por eso [[105.0]] y no simplemente 105.0. Es la misma forma que tenía tamano_m2.reshape(-1, 1) cuando ajustaste el modelo.
# ¿Cuánto costaría, según el modelo, una casa de 105 m²?tamano_nuevo = np.array([[105.0]])precio_predicho = modelo_vivienda.predict(tamano_nuevo)print(f"Precio predicho para 105 m²: {precio_predicho[0]:.1f} mil USD")
Precio predicho para 105 m²: 203.2 mil USD
Forma matricial: \(\hat{y} = X\beta\)
Hasta ahora escribiste el modelo variable por variable: \(\hat{y} = \beta_0 + \beta_1 x\). Esa notación funciona bien con una sola variable, pero se vuelve incómoda apenas tienes varias — y el dataset diabetes tiene 10. La solución es usar álgebra lineal: agrupar todas las observaciones y todos los coeficientes en matrices y expresar el modelo completo como un único producto matricial.
Define la matriz de diseño\(X\) agregando una columna de unos al inicio (para que multiplique al intercepto \(\beta_0\)) y luego una columna por cada variable predictora:
Con esto, las predicciones de todas las observaciones a la vez se calculan con un solo producto matricial:
\[\hat{y} = X\beta\]
Y el problema de mínimos cuadrados que planteaste antes tiene una solución exacta, cerrada, conocida como la ecuación normal:
\[\beta = (X^\top X)^{-1} X^\top y\]
Esta fórmula exige que \(X^\top X\) sea invertible, es decir, que ninguna columna de \(X\) sea combinación lineal de las demás. scikit-learn no resuelve exactamente así por dentro (LinearRegression usa scipy.linalg.lstsq, un método numéricamente más estable que invertir la matriz), pero el resultado es equivalente.
Antes de aplicarlo sobre datos reales, hazlo tangible con un ejemplo pequeño que ya conoces bien: horas de estudio contra calificación. Con \(n=10\) observaciones y \(p=1\) variable, la matriz de diseño \(X_{estudio}\) tiene 10 filas y 2 columnas (la columna de unos, más la de horas) — lo suficientemente pequeña para verla completa — y el vector \(y_{estudio}\) reúne las calificaciones:
Cada fila de \(X_{estudio}\) es un estudiante: un 1 (para el intercepto) y sus horas de estudio. Aplica la ecuación normal, \(\beta = (X^\top X)^{-1} X^\top y\), sobre estas matrices exactas y compara el resultado con \(\beta_0\) y \(\beta_1\) que ya calculaste antes.
# Matriz de diseño X para el ejemplo de horas de estudio: columna de 1s + columna de horasn_estudio = horas_estudio.shape[0]X_estudio = np.hstack([np.ones((n_estudio, 1)), horas_estudio.reshape(-1, 1)])print("Matriz de diseño X (10 filas: columna de 1s | horas de estudio):")print(X_estudio)# Ecuación normal: beta = (X^T X)^-1 X^T ybeta_estudio_matricial = np.linalg.inv(X_estudio.T @ X_estudio) @ X_estudio.T @ calificacionprint("\nCoeficientes con la ecuación normal: ", beta_estudio_matricial)print("Coeficientes con la fórmula de covarianza:", np.array([beta0_manual, beta1_manual]))
Matriz de diseño X (10 filas: columna de 1s | horas de estudio):
[[ 1.  1.]
 [ 1.  2.]
 [ 1.  3.]
 [ 1.  4.]
 [ 1.  5.]
 [ 1.  6.]
 [ 1.  7.]
 [ 1.  8.]
 [ 1.  9.]
 [ 1. 10.]]

Coeficientes con la ecuación normal:       [47.33333333  3.59393939]
Coeficientes con la fórmula de covarianza: [47.33333333  3.59393939]
Los coeficientes coinciden exactamente con los que calculaste con la fórmula de covarianza/varianza (47.33 y 3.59) — tiene que ser así, porque son dos caminos algebraicos distintos para llegar a la misma solución del mismo problema de mínimos cuadrados. La diferencia es que la forma matricial escala sin esfuerzo a cualquier cantidad de variables: con el ejemplo de las viviendas (o con cualquier otro) obtendrías, por el mismo camino, los mismos \(\beta_0 = 44.79\) y \(\beta_1 = 1.51\) de antes.
Ahora aplícala sobre datos reales: reconstruye el modelo simple de bmi con NumPy puro, usando la ecuación normal, y verifica que obtienes los mismos coeficientes que te dio LinearRegression.
n = x_bmi.shape[0]columna_unos = np.ones((n, 1))X_matriz = np.hstack([columna_unos, x_bmi.to_numpy()]) # columna de 1s + columna de bmi# Ecuación normal: beta = (X^T X)^-1 X^T ybeta_matricial = np.linalg.inv(X_matriz.T @ X_matriz) @ X_matriz.T @ y.to_numpy()print("Coeficientes con la ecuación normal (NumPy):", beta_matricial)print("Coeficientes con scikit-learn: ", np.array([beta0, beta1]))
Coeficientes con la ecuación normal (NumPy): [152.13348416 949.43526038]
Coeficientes con scikit-learn:               [152.13348416 949.43526038]
Ejercicios: consolida la regresión simple
Ya tienes todas las piezas: la fórmula clásica, scikit-learn, la forma matricial y la ecuación normal. Antes de pasar a modelos con más de una variable predictora — el tema del próximo artículo de la serie — vale la pena practicar el mismo patrón unas cuantas veces más: con otra variable, con casos nuevos, comparando variables entre sí, repitiendo el álgebra matricial y poniendo a prueba qué tan frágil es una recta ajustada con pocos datos. Los cinco ejercicios que siguen usan exactamente las herramientas que ya construiste arriba.
Ejercicio 1 — Repite el patrón con otra variable: bp
Hasta ahora trabajaste la regresión simple sobre bmi. Repite el procedimiento completo que ya aplicaste por partes — fórmula manual (como con las horas de estudio), LinearRegression y gráfica de la recta ajustada (como con bmi) — pero esta vez con bp (presión arterial media) como única variable predictora. La idea es que el patrón quede automatizado en tu cabeza, no memorizado para una sola variable.
# Tu código aquí. Guía de pasos:# 1. Extrae "bp" de X_completo como matriz 2D: x_bp = X_completo[["bp"]]# 2. Calcula beta0 y beta1 a mano con la fórmula de covarianza/varianza (igual que hiciste con horas_estudio);# usa la columna como vector: x_bp["bp"]# 3. Ajusta un LinearRegression sobre x_bp y compara sus coeficientes con los del paso 2# 4. Grafica los puntos (x_bp, y) junto con la recta ajustada, con matplotlib
Ejercicio 2 — Predicciones sobre tres pacientes hipotéticos
Usa el modelo simple que ya ajustaste con bmi (modelo_simple) para predecir la progresión de la enfermedad en tres pacientes hipotéticos: uno con IMC bajo, uno con IMC medio y uno con IMC alto. En lugar de inventar valores al azar, toma los percentiles 10, 50 y 90 de la columna bmi real, para que los tres casos sean plausibles dentro del rango observado.
# Tu código aquí. Guía de pasos:# 1. Calcula los percentiles 10, 50 y 90 de x_bmi["bmi"] con np.percentile# 2. Arma una tabla (por ejemplo, un pd.DataFrame) con esos tres valores de bmi, uno por paciente# 3. Usa modelo_simple.predict(...) sobre esa tabla para obtener la progresión predicha de cada paciente# 4. Imprime los tres resultados junto con el valor de bmi que los generó
Ejercicio 3 — ¿Qué variable explica mejor la progresión, por sí sola?
Ya ajustaste una regresión simple con bmi y otra con bp. Generaliza el ejercicio: ajusta una regresión simple distinta para cada una de las 10 variables clínicas, calcula el \(R^2\) que logra cada una por su cuenta y ordénalas de mayor a menor. Aquí el \(R^2\) se calcula sobre los mismos datos con los que ajustas (más adelante en la serie, en el artículo de evaluación de modelos, vas a ver por qué eso no basta para medir qué tan bien generaliza un modelo) — el objetivo de este ejercicio es solo comparar variables entre sí, no evaluar el modelo rigurosamente.
Fíjate en el resultado: la mejor variable por sí sola (bmi, con \(R^2 = 0.344\), como ya viste) queda lejos del \(R^2 \approx 0.52\) que se obtiene al combinar las 10 en un modelo de regresión lineal múltiple, el tema del próximo artículo de la serie. Ten presente que, sobre los datos de ajuste, el \(R^2\) nunca baja al agregar variables: por eso la comparación justa entre modelos de distinto tamaño requiere evaluar fuera de la muestra.
# Tu código aquí. Guía de pasos:# 1. Recorre cada columna de X_completo (por ejemplo, con un for sobre X_completo.columns)# 2. Para cada columna, ajusta un LinearRegression usando solo esa variable como predictor# 3. Calcula el R² de esa regresión sobre los mismos datos, con r2_score# (from sklearn.metrics import r2_score) o con el método .score(X, y) del modelo# 4. Guarda los resultados (por ejemplo, en un diccionario o un pd.Series) y ordénalos de mayor a menor
Ejercicio 4 — Ecuación normal con s5
Ya reconstruiste con NumPy puro, vía ecuación normal, el modelo simple de bmi. Repite exactamente el mismo procedimiento — matriz de diseño con columna de unos + columna de la variable, y \(\beta = (X^\top X)^{-1} X^\top y\) — pero ahora con s5 (triglicéridos, en escala logarítmica), la variable que quedó en segundo lugar en el ranking del ejercicio anterior. Verifica que el resultado coincide con LinearRegression.
# Tu código aquí. Guía de pasos:# 1. Extrae x_s5 = X_completo[["s5"]]# 2. Construye la matriz de diseño: columna de unos + columna de s5 (np.hstack, igual que hiciste con bmi)# 3. Aplica la ecuación normal: beta = (X^T X)^-1 X^T y, con np.linalg.inv# 4. Ajusta también un LinearRegression sobre x_s5 y compara ambos resultados
Ejercicio 5 — Qué tan frágil es la recta ante un solo dato raro
Vuelve al ejemplo de horas de estudio contra calificación. Agrega un único estudiante atípico — uno que estudió muy poco (2 horas) pero sacó una calificación muy alta (95) — y reajusta la recta con la fórmula clásica. Compara la nueva recta con la original, tanto en los coeficientes como visualmente.
Esto sirve para ver algo importante que mínimos cuadrados no te dice por sí solo: como el criterio de ajuste eleva los residuales al cuadrado, un único punto muy alejado de la tendencia general puede desplazar la recta bastante más de lo que su “peso” en el conjunto de datos (1 de 11 observaciones) sugeriría. OLS no distingue entre una observación real y un error de medición — ajusta la recta que minimiza el SSE, punto.
# Tu código aquí. Guía de pasos:# 1. Crea horas_con_outlier y calificacion_con_outlier agregando el par (2, 95) a los arrays originales,# con np.append# 2. Recalcula beta0 y beta1 con la fórmula clásica, pero sobre los datos con el outlier incluido# 3. Compara los nuevos coeficientes contra beta0_manual y beta1_manual (los originales, sin el outlier)# 4. Grafica ambas rectas (original vs. con el outlier) sobre el mismo scatter para ver el desplazamiento
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.