Big Data e Ingeniería de Datos
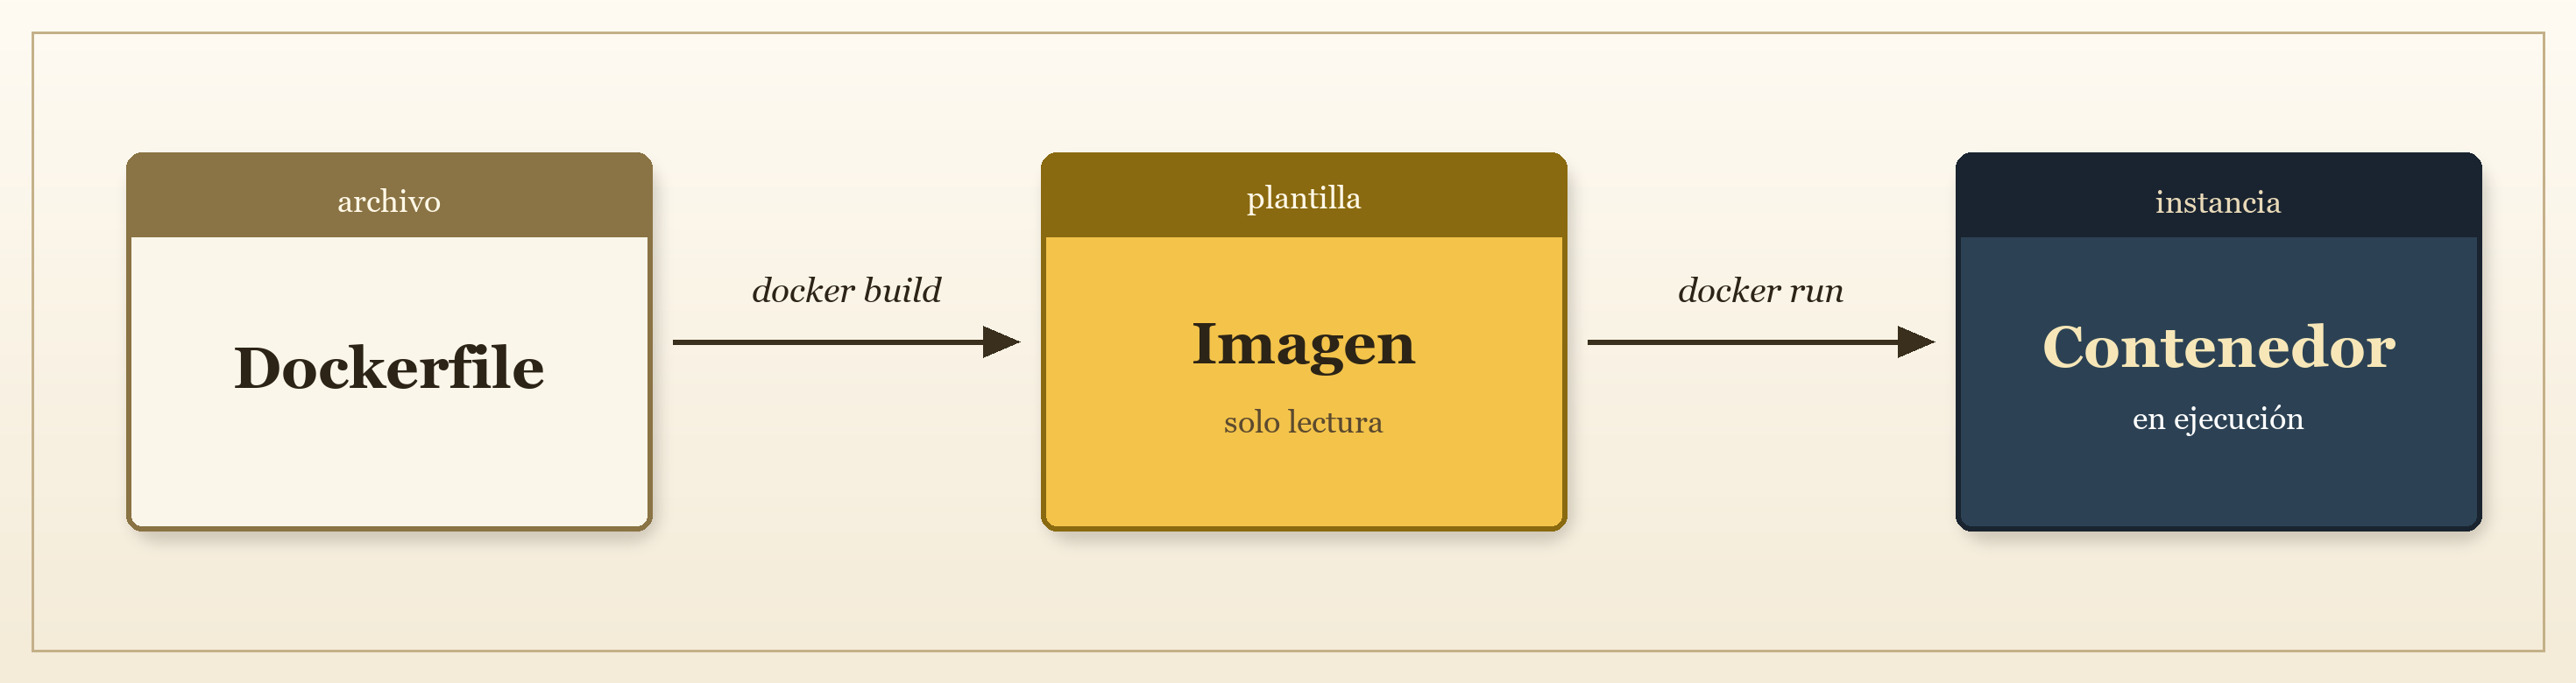
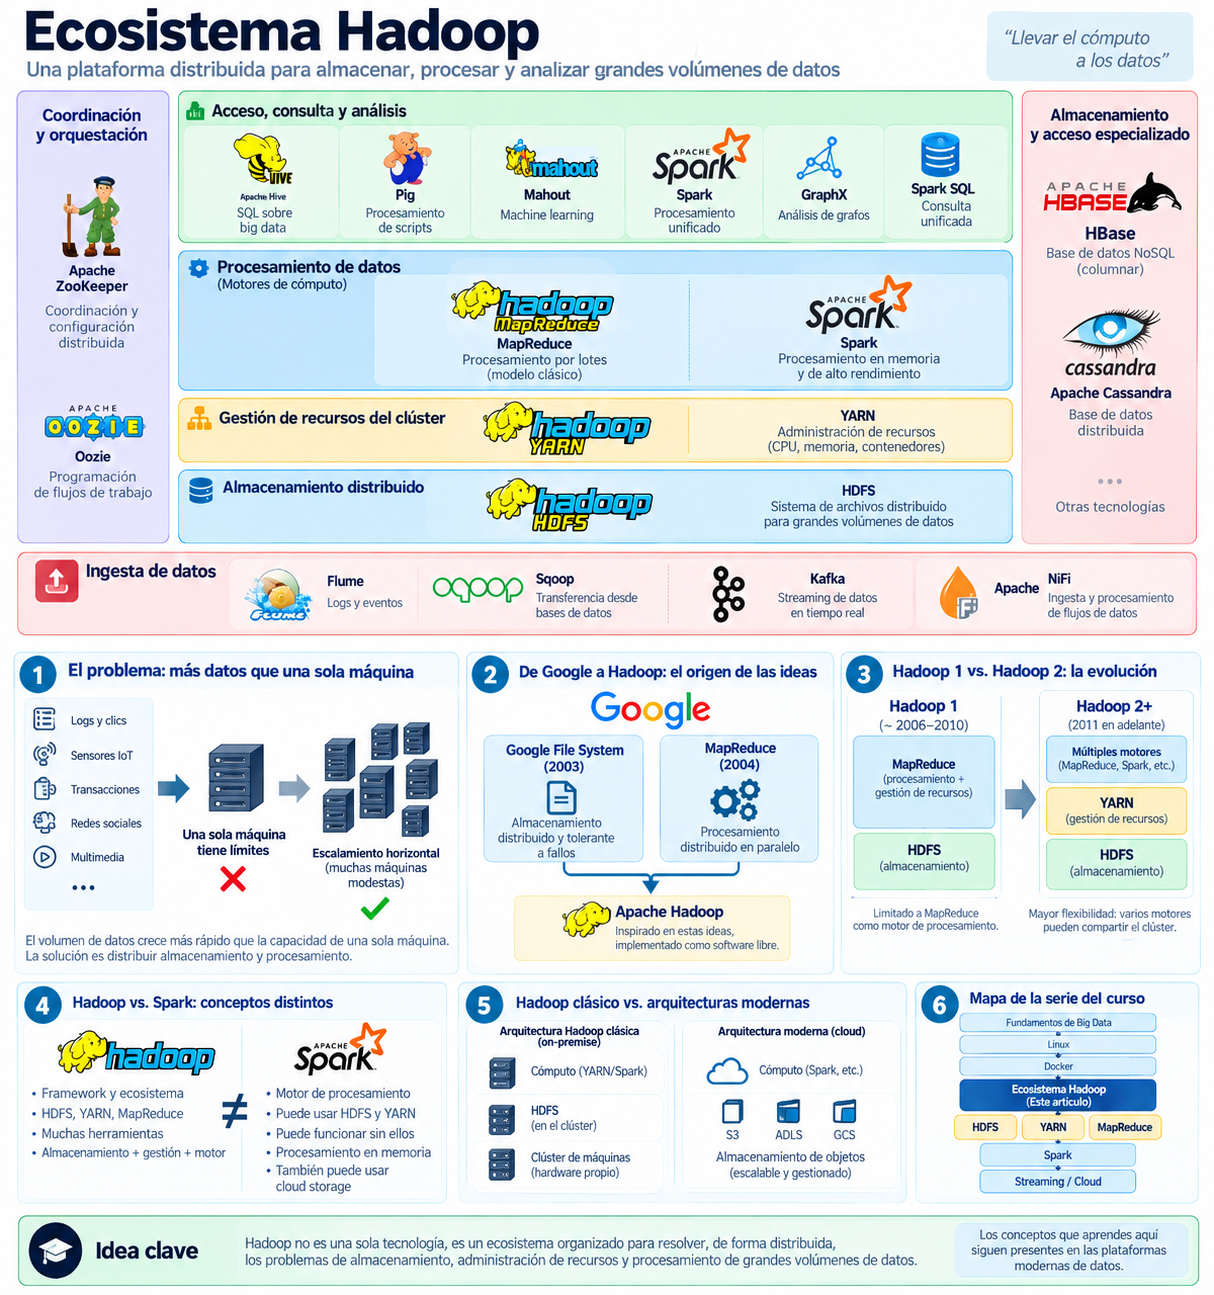
Un curso de Big Data e Ingeniería de Datos construido desde los fundamentos: por qué nace el ecosistema Hadoop, cómo se organiza el almacenamiento distribuido con HDFS, cómo se reparten los recursos del clúster con YARN, cómo Docker se convirtió en la forma estándar de levantar toda esa infraestructura sin depender de “en mi máquina funciona”, y cómo se procesan los datos sobre ella: MapReduce, Spark y PySpark. Cada módulo teórico va acompañado, cuando aplica, de un laboratorio guiado y reproducible, con evidencia real de ejecución.
Los módulos están pensados para leerse en orden.
Módulo 1 — Fundamentos
Módulo 2 — Contenedores
Módulo 3 — Arquitectura Hadoop
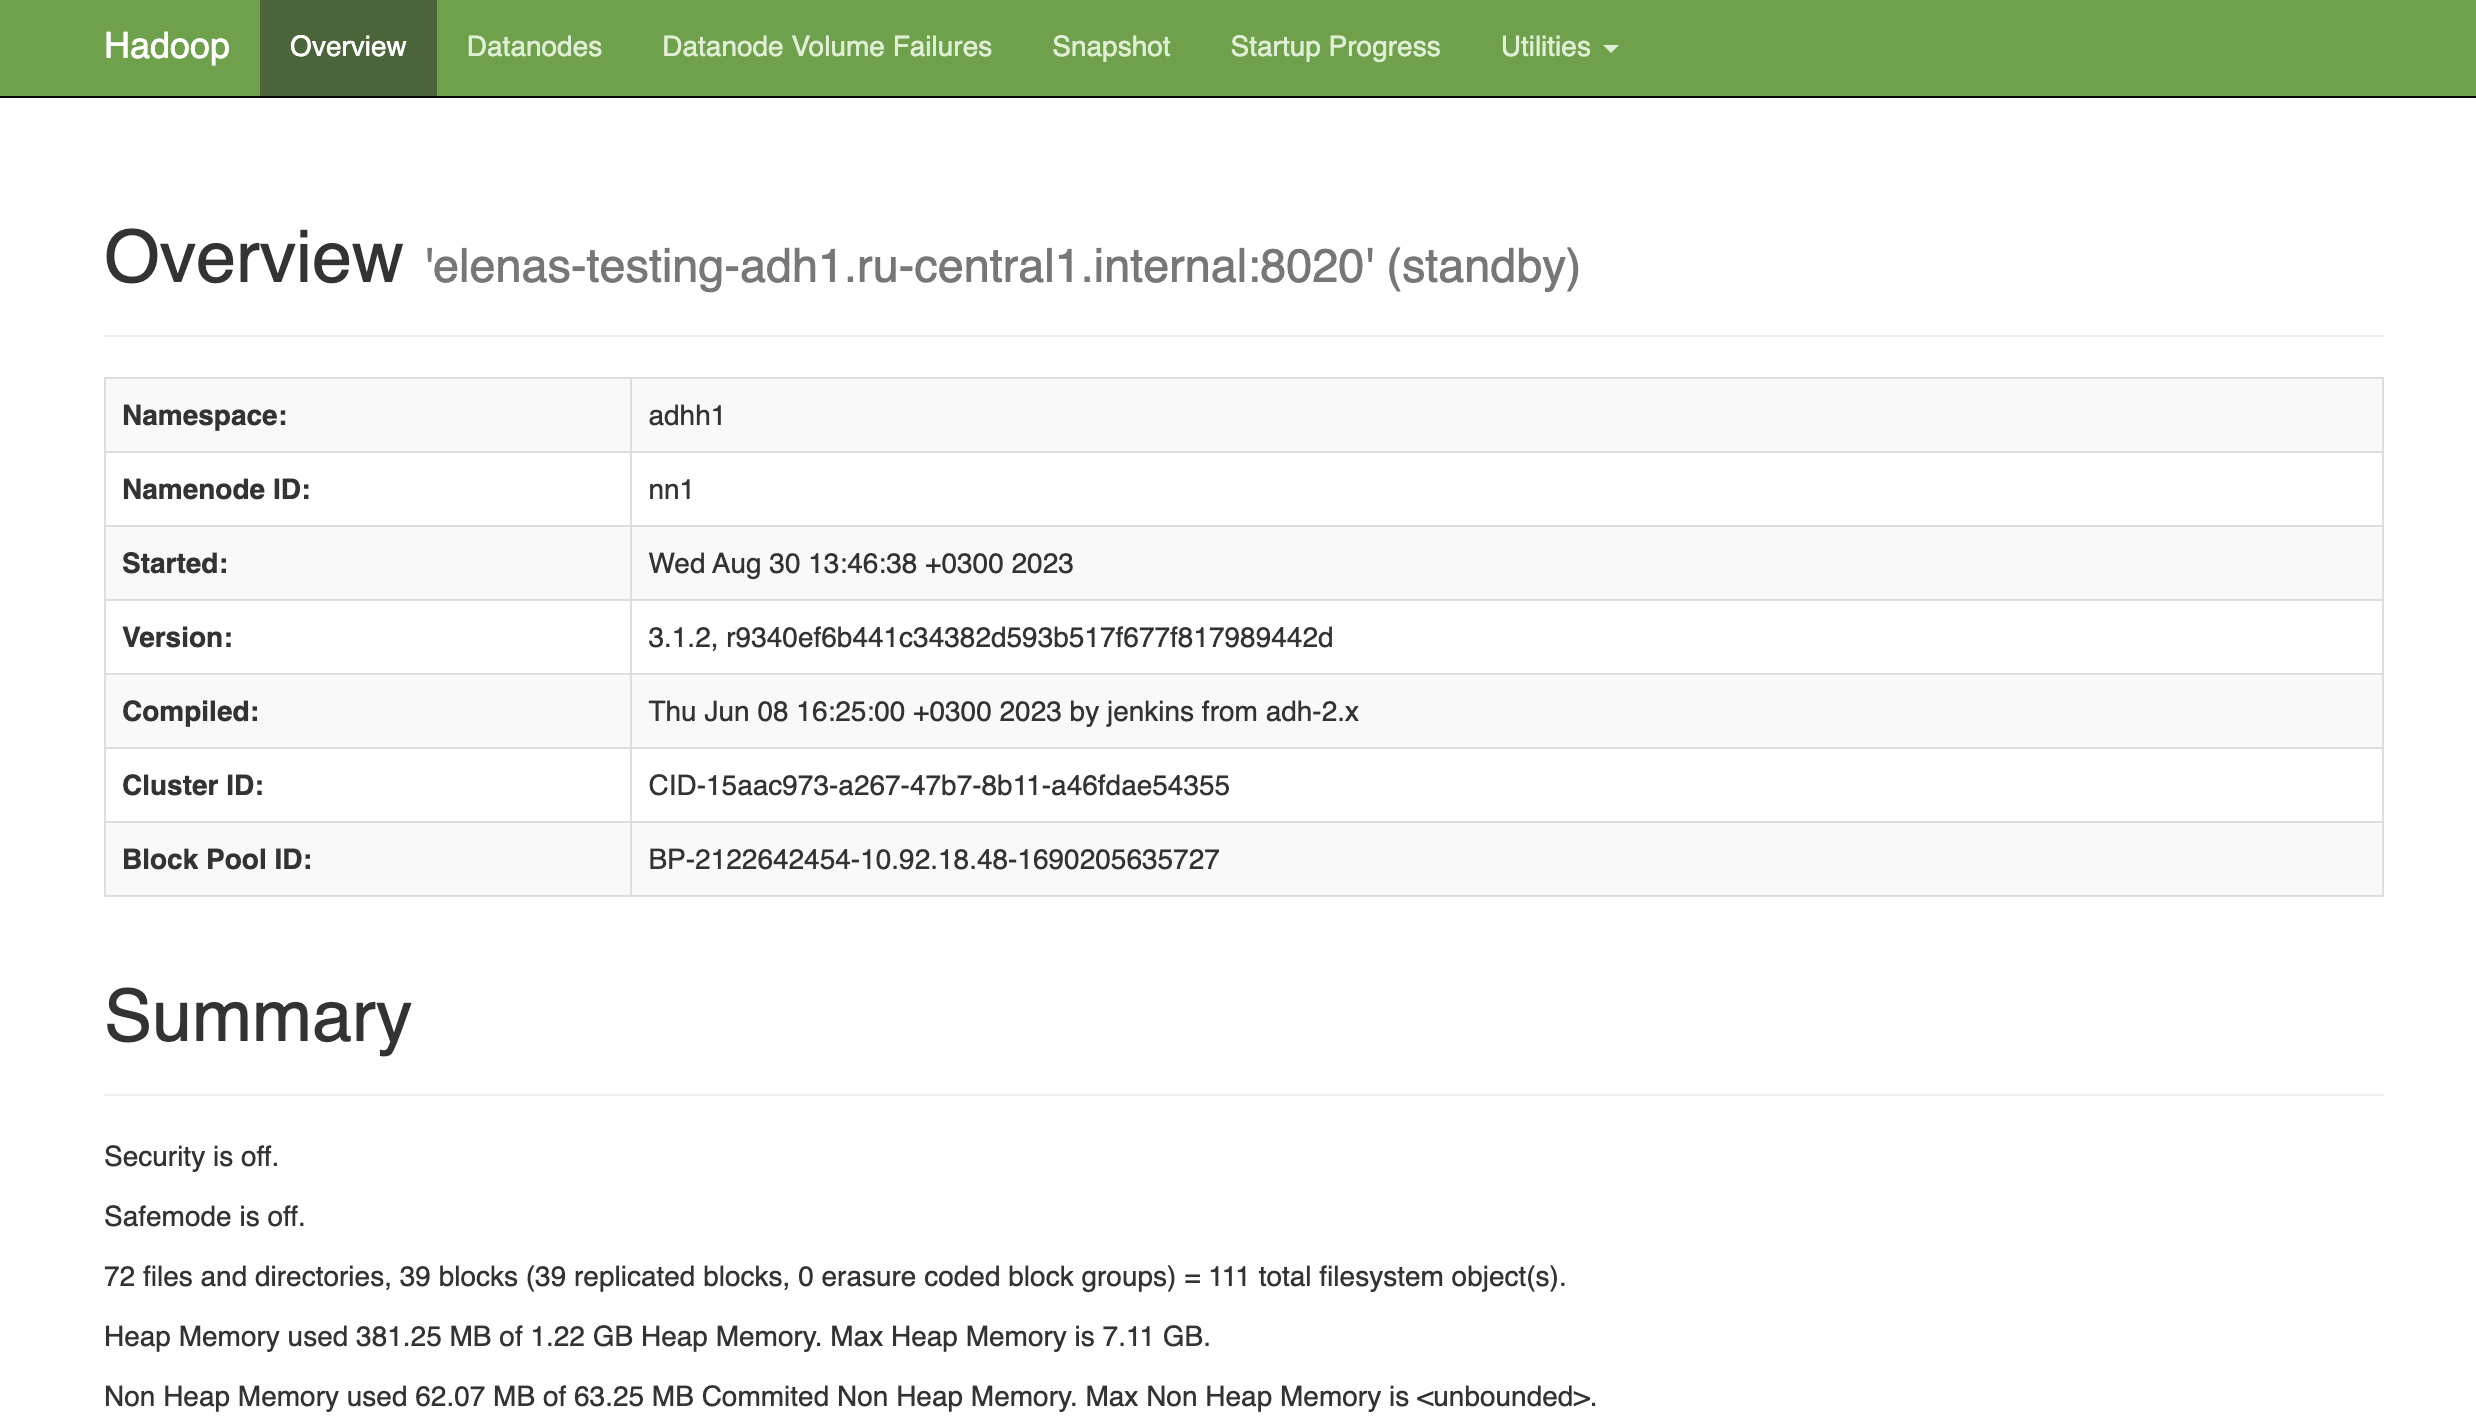
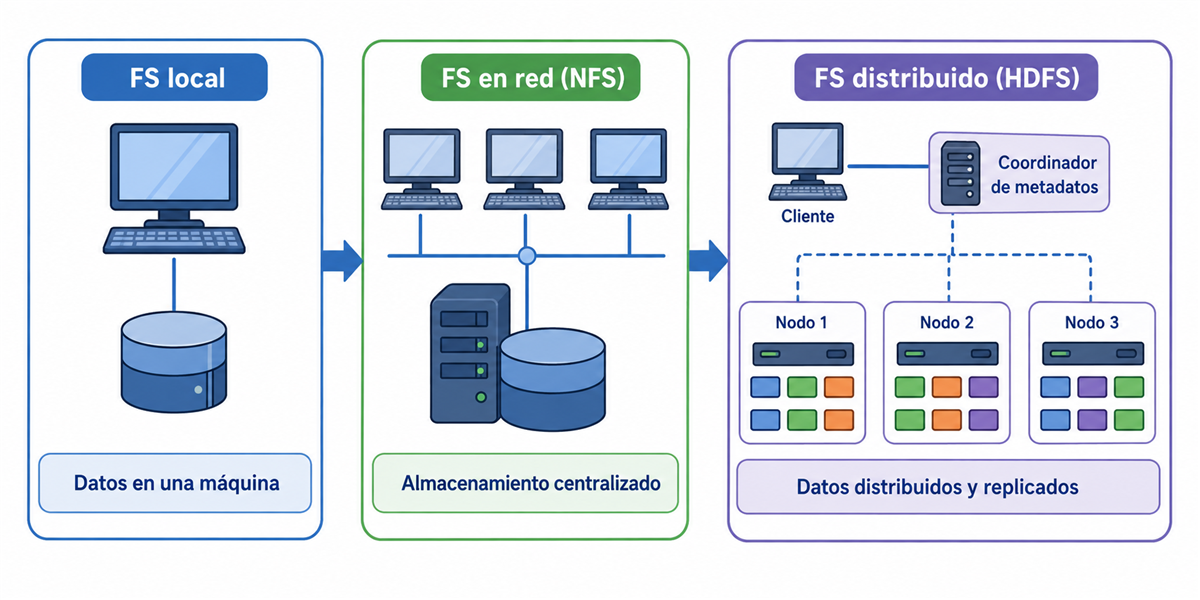
Módulo 4 — HDFS
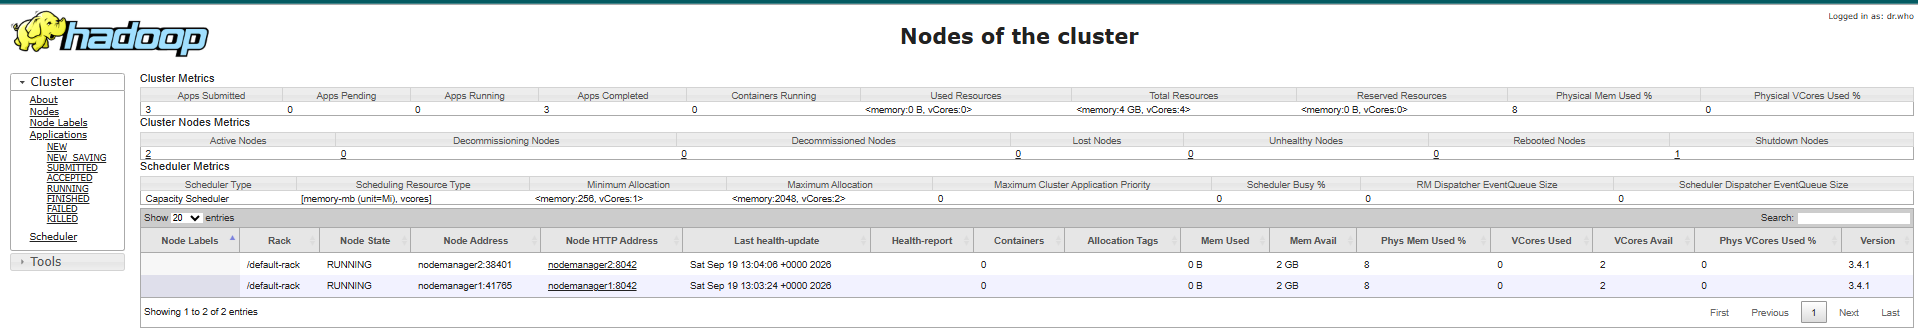
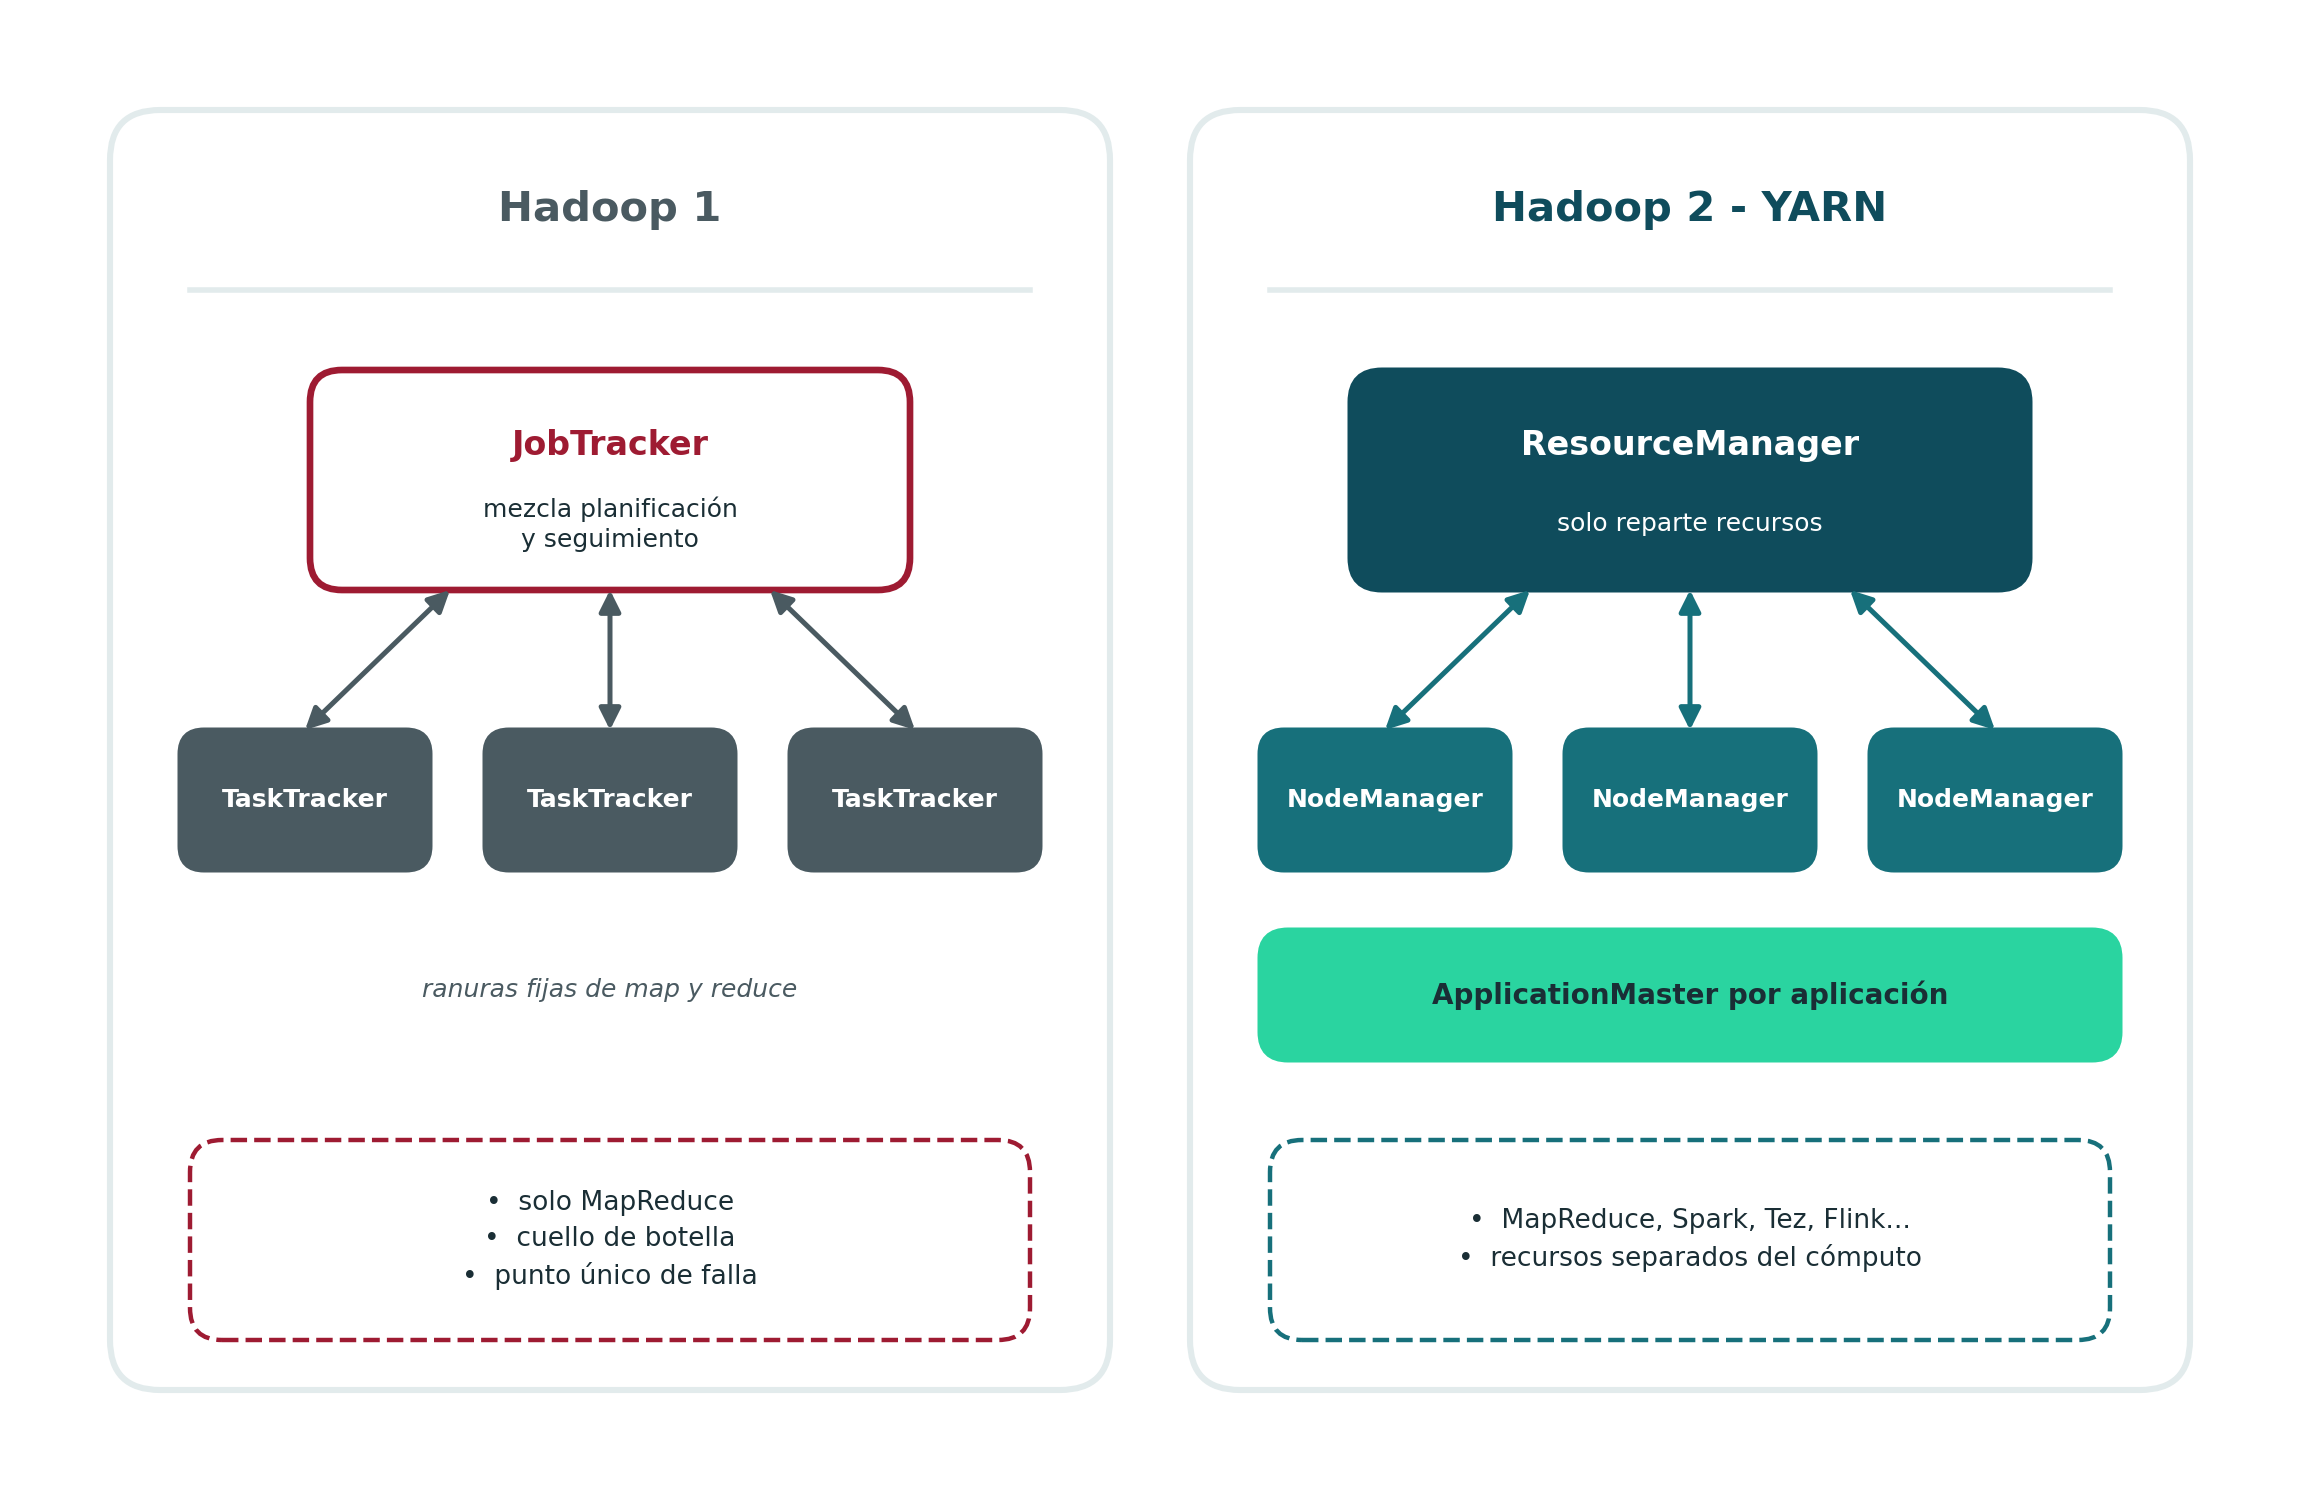
Módulo 5 — YARN
Módulo 6 — Spark sobre el clúster
Módulo 7 — MapReduce
Módulo 8 — Spark
Módulo 9 — PySpark
Todas las clases publicadas
No matching items