Spark: el motor de procesamiento sobre YARN
Spark: el motor de procesamiento sobre YARN
Un DAG de etapas en lugar de un solo map-reduce
En este artículo vas a entender qué pregunta responde Apache Spark, en qué se diferencia de MapReduce y cómo se reparte el trabajo entre driver y executors cuando corre sobre YARN. El centro es el enfoque: un grafo acíclico dirigido (DAG) de etapas, evaluación perezosa y una aplicación que puede encadenar varios pasos sin volver a HDFS entre cada uno.
El clúster ya está (HDFS, YARN y el cliente Spark) y MapReduce ya está. Aquí no se vuelve a montar Docker ni a explicar el NameNode. SparkPi de comprobación ya corriste al añadir el cliente. El taller (Taller de Spark) vuelve a lanzar SparkPi y un wordcount Spark para ver el modelo (tipo SPARK, driver, executors), no para fabricar el contenedor.
PySpark (la API en Python) tiene su propia teoría y su propio laboratorio, después de esta clase.
Tiempo estimado de lectura: 20 minutos
Nivel: Intermedio
Conocimientos previos recomendados: - El clúster del curso: HDFS, YARN y el cliente Spark (laboratorio que añade spark-client) - MapReduce: map, shuffle, reduce, tipo MAPREDUCE en el portal
Tecnologías mencionadas: - Apache Spark 3.5 (driver, executors, SparkContext) - YARN (modo client) - MapReduce (como contraste) - Scala (lenguaje en el que está escrito Spark; no hay que programarlo aquí)
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
📌 Parte de la serie Big Data.
MapReduce responde cómo calcular en paralelo con una receta rígida: un map, un shuffle, un reduce, y a menudo un vuelco a HDFS si quieres otro paso. Eso funciona. También se vuelve incómodo cuando el análisis es una cadena: filtrar, agregar, juntar, volver a filtrar. Cada eslabón sería otro job MapReduce.
Spark es otro motor de procesamiento sobre el mismo HDFS y el mismo YARN. No sustituye al NameNode ni al ResourceManager. Cambia cómo se describe el cálculo: una sola aplicación puede tener varias etapas, y el motor arma un plan antes de tocar los datos.
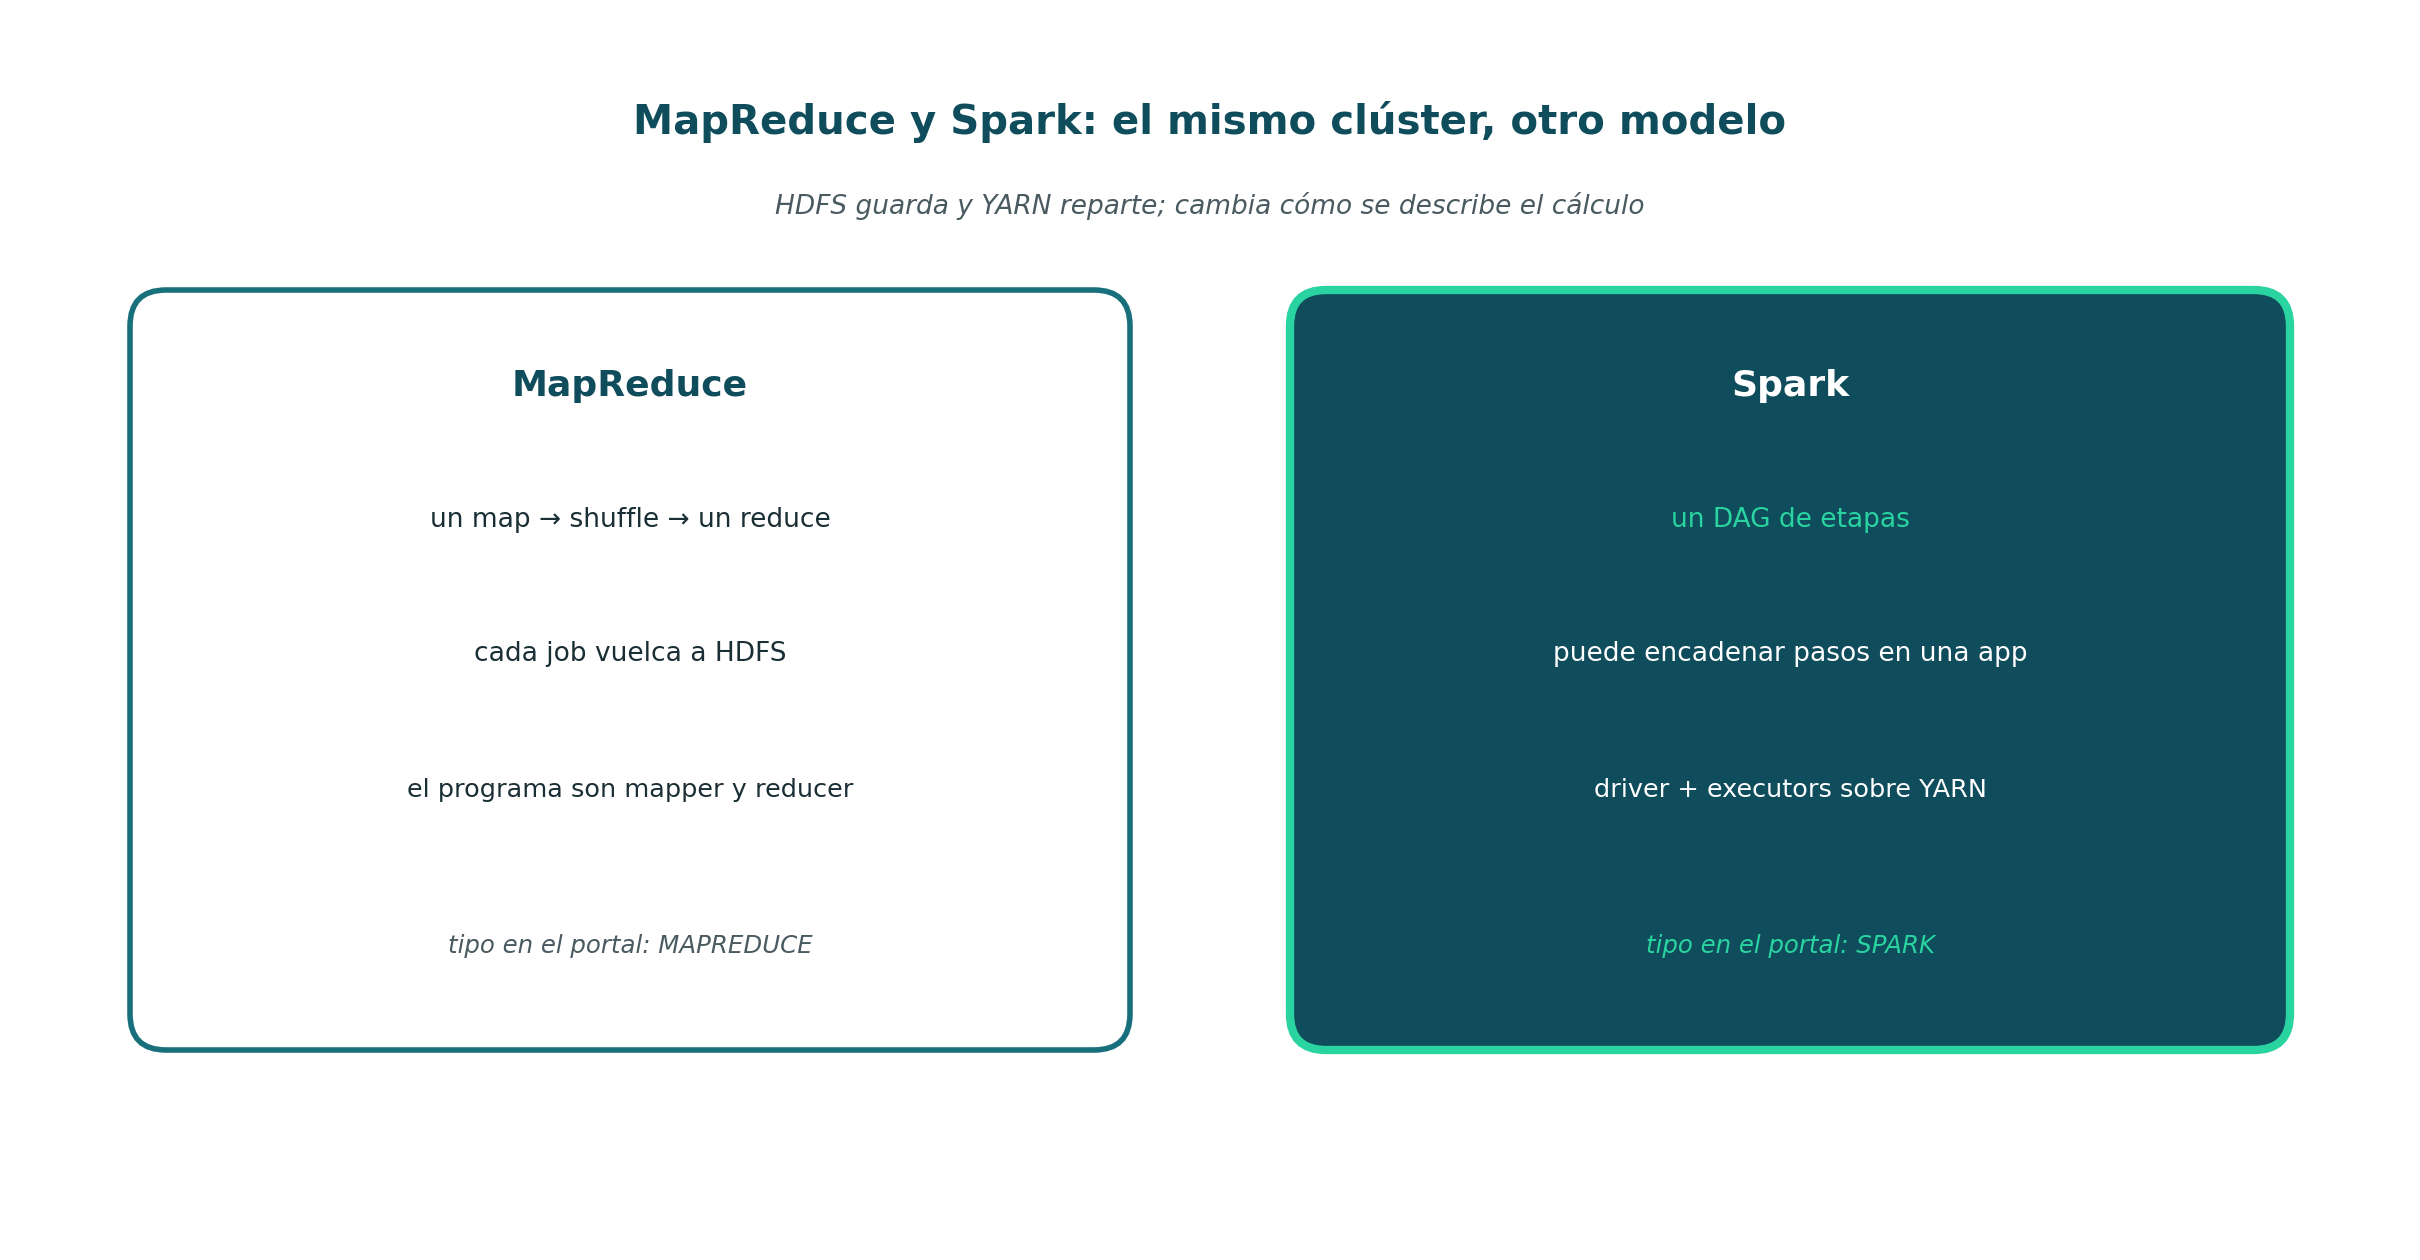
Figura 1. HDFS y YARN no cambian. Cambia el modelo: tres fases fijas frente a un DAG. En el portal, el tipo pasa de MAPREDUCE a SPARK.
Parte 1 — La pregunta que Spark responde
Un DAG (directed acyclic graph, grafo acíclico dirigido) es un conjunto de pasos con flechas que no vuelven atrás: A puede alimentar a B y a C, pero no hay ciclos. Spark representa tu programa como un DAG de etapas (stages). Una etapa es un tramo que Spark puede ejecutar sin un shuffle (el mismo movimiento caro de MapReduce: reagrupar por clave a través de la red). Cada shuffle corta una etapa nueva.
¿Para qué sirve esta idea? Para no esperar un job MapReduce por cada filter y cada groupBy. Spark puede fusionar transformaciones en el plan y ejecutarlas cuando hace falta un resultado.
Eso se llama evaluación perezosa (lazy evaluation): registrar operaciones sin calcularlas hasta que una acción pide un número, una tabla en pantalla o una escritura. El detalle de transformaciones frente a acciones es el corazón de PySpark; aquí basta la consecuencia: el portal no muestra “trabajo” solo por haber escrito filter en el código.
Parte 2 — Driver y executors (sobre YARN)
Spark no instala un clúster paralelo al de Hadoop. Le pide contenedores a YARN, el mismo del laboratorio de recursos.
El driver es el proceso que arma el plan, pide recursos y recoge el resultado. En el laboratorio vivirá en un contenedor cliente; en esta clase basta: hay un proceso coordinador fuera de los NodeManagers.
Los executors son los procesos que ejecutan las tareas (tasks: la unidad de trabajo dentro de una etapa). YARN los lanza como contenedores YARN dentro de los NodeManagers. No son contenedores Docker nuevos. El hostname del driver tiene que ser alcanzable: los executors le devuelven datos y estado.
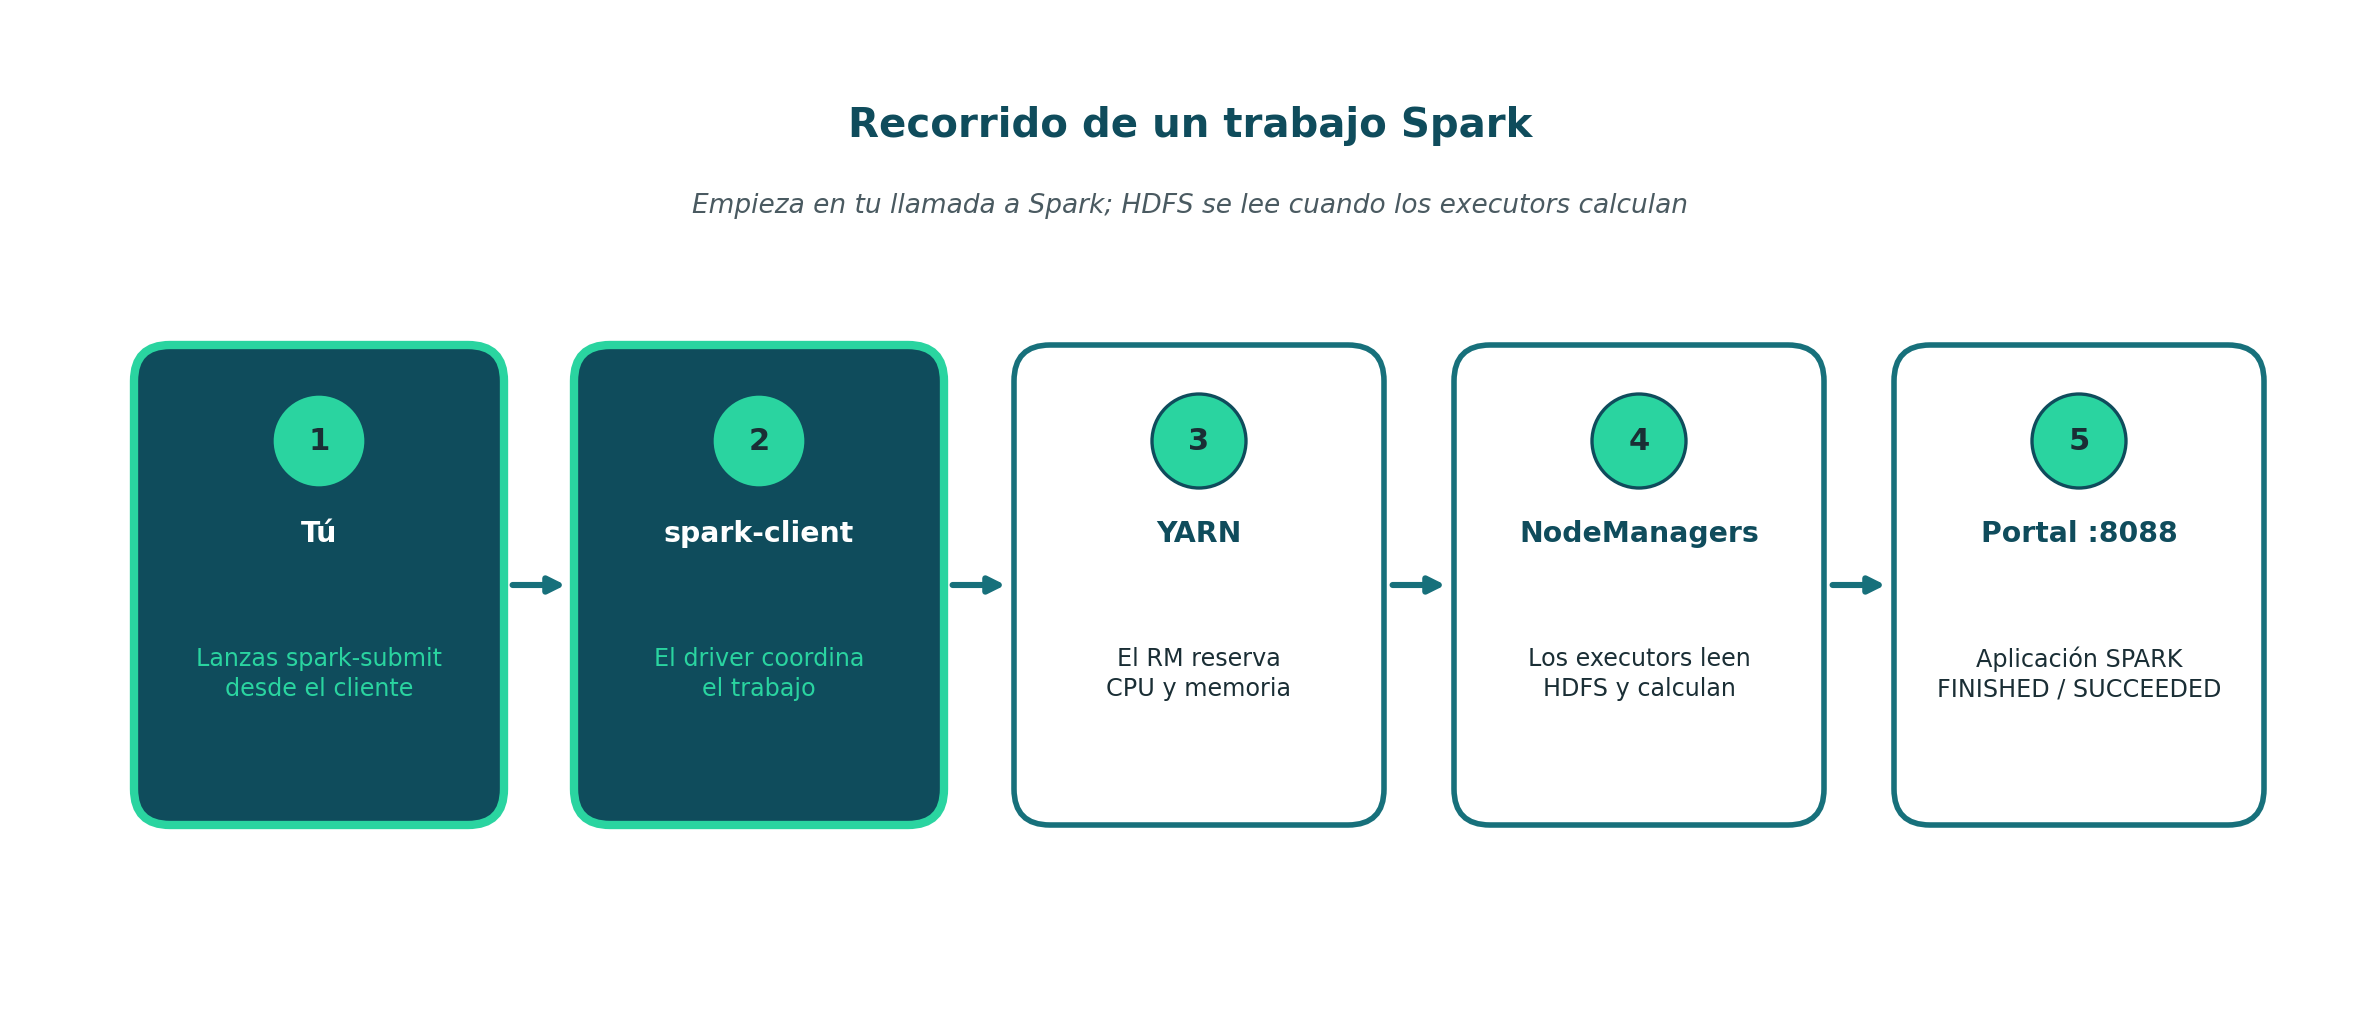
Figura 2. Empieza en tu llamada a Spark. El driver coordina; YARN reparte; los executors leen HDFS. El portal muestra tipo SPARK.
Modo client. spark.submit.deployMode = client significa: el driver no se mueve a un contenedor YARN; se queda en el proceso cliente. YARN solo lanza executors. Es el modo del laboratorio (Jupyter necesita el driver en el mismo proceso que el kernel). Eso se configura allí, no aquí.
El SparkContext es el objeto interno que representa la conexión al clúster (master yarn, identificador de aplicación). Encima, en Python, verás la SparkSession; eso se explica en la teoría de PySpark.
Jerarquía que conviene nombrar:
| Término | Qué es |
|---|---|
| Aplicación | Lo que YARN lista (application_…), tipo SPARK |
| Job | Lo que dispara una acción (count, SparkPi al terminar) |
| Etapa (stage) | Tramo del DAG entre shuffles |
| Tarea (task) | Un trozo de una etapa en un executor |
Parte 3 — RDD, en una frase
Un RDD (Resilient Distributed Dataset) es la abstracción original de Spark: una colección distribuida y tolerante a fallos de elementos, partida en particiones. map y reduceByKey sobre un RDD se parecen al mapper y al reducer. SparkPi está en Scala, dentro de un JAR de ejemplos: sirve para ver el motor sin Python. Los RDD se programan en PySpark, junto al DataFrame.
Scala es el lenguaje de la JVM en el que está escrito Spark. No hay que escribir Scala en este curso para entender el motor.
Parte 4 — Qué no es Spark
| No es | Porque |
|---|---|
| HDFS | Spark lee y escribe; no guarda bloques |
| YARN | YARN concede CPU y RAM; Spark las usa en executors |
| Un segundo NameNode | El laboratorio del cliente añadió un proceso Spark, no otro HDFS |
| “Todo cabe en memoria” | Spark puede persistir en RAM; también usa disco y red. El shuffle sigue existiendo |
| PySpark | PySpark es la API en Python. Spark es el motor (Scala/JVM) |
Cierre
Al terminar esta clase deberías poder decir:
- Spark calcula sobre el mismo HDFS y el mismo YARN; cambia el modelo (DAG, no un solo map-reduce).
- El driver planifica; los executors calculan en contenedores YARN.
- Perezoso: el plan se arma ahora; el job aparece cuando hay una acción.
- En el portal el tipo es
SPARK, noMAPREDUCE.
La práctica de esta clase es el taller: SparkPi, wordcount Spark, tipo SPARK en el portal, driver y executors. El cliente y SparkPi de comprobación ya quedaron al ampliar el clúster; el taller no vuelve a montar Docker. Programar DataFrames es PySpark, después. El orden: clúster (HDFS, YARN, cliente Spark) → MapReduce → Spark (esta clase y su taller) → PySpark.
Referencias: Spark Overview, Spark sobre YARN.