MapReduce: el modelo de procesamiento de Hadoop
MapReduce: el modelo de procesamiento de Hadoop
Cómo partir un cálculo, agrupar por clave y combinar resultados
En este artículo vas a entender qué pregunta responde MapReduce, en qué se diferencia de HDFS y de YARN, y cómo un trabajo recorre las fases map, shuffle y reduce. El centro es el enfoque: llevar el cómputo a los datos, emitir pares clave-valor y agregar por clave.
El clúster ya está (HDFS, YARN y el cliente Spark). Aquí no se vuelve a construir. Sí hay dos ejemplos sencillos sobre ese mismo clúster (π y wordcount del JAR de Hadoop, desde el NameNode) para ver el motor. Escribir mapper.py y reducer.py es el taller, después de esta clase.
Tiempo estimado de lectura: 28 minutos (incluye los dos ejemplos en el clúster que ya tienes)
Nivel: Intermedio
Conocimientos previos recomendados: - El clúster del curso: HDFS, YARN y el cliente Spark - En el laboratorio de YARN ya enviaste pi y wordcount desde el NameNode; esta clase dice qué era ese tipo MAPREDUCE
Tecnologías mencionadas: - Hadoop MapReduce (modelo y motor) - Hadoop Streaming (una forma de escribir MapReduce sin Java) - YARN (como árbitro, no como el cálculo) - Spark (como contraste de modelo, no como tutorial)
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
📌 Parte de la serie Big Data.
En HDFS resolvimos dónde están los archivos. En YARN resolvimos quién obtiene CPU y memoria. Falta la pregunta del cálculo: dado un archivo grande ya repartido en bloques, cómo lo procesamos en paralelo sin arrastrar terabytes a una sola máquina y sin que cada equipo reescriba la distribución, el fallo y la agregación.
Esa pregunta la responde MapReduce. No es un disco. No es el árbitro de recursos. Es un modelo de procesamiento —y, en Hadoop, el motor clásico que implementa ese modelo sobre YARN.
Parte 1 — La pregunta que MapReduce responde
Un modelo de procesamiento es una receta fija de cómo se parte un cálculo y cómo se combinan los resultados. MapReduce fija tres movimientos:
- transformar cada trozo de entrada por separado;
- agrupar lo transformado por clave;
- combinar cada grupo en un resultado.
El paper de Jeffrey Dean y Sanjay Ghemawat (Google, 2004) describió esa receta para clústeres enormes. Hadoop MapReduce es la implementación de código abierto que la industria usó durante años como primer motor sobre HDFS. El enfoque no es “un servidor potente ejecuta un for”. Es llevar el cómputo a los datos: las tareas map corren, en lo posible, en los nodos que ya tienen el bloque.
¿Para qué sirve esta idea? Para no confundir tres cajas del ecosistema. Si el job falla, la pregunta útil es: ¿falló el disco (HDFS), el árbitro (YARN) o el programa que transforma y agrega (MapReduce)?
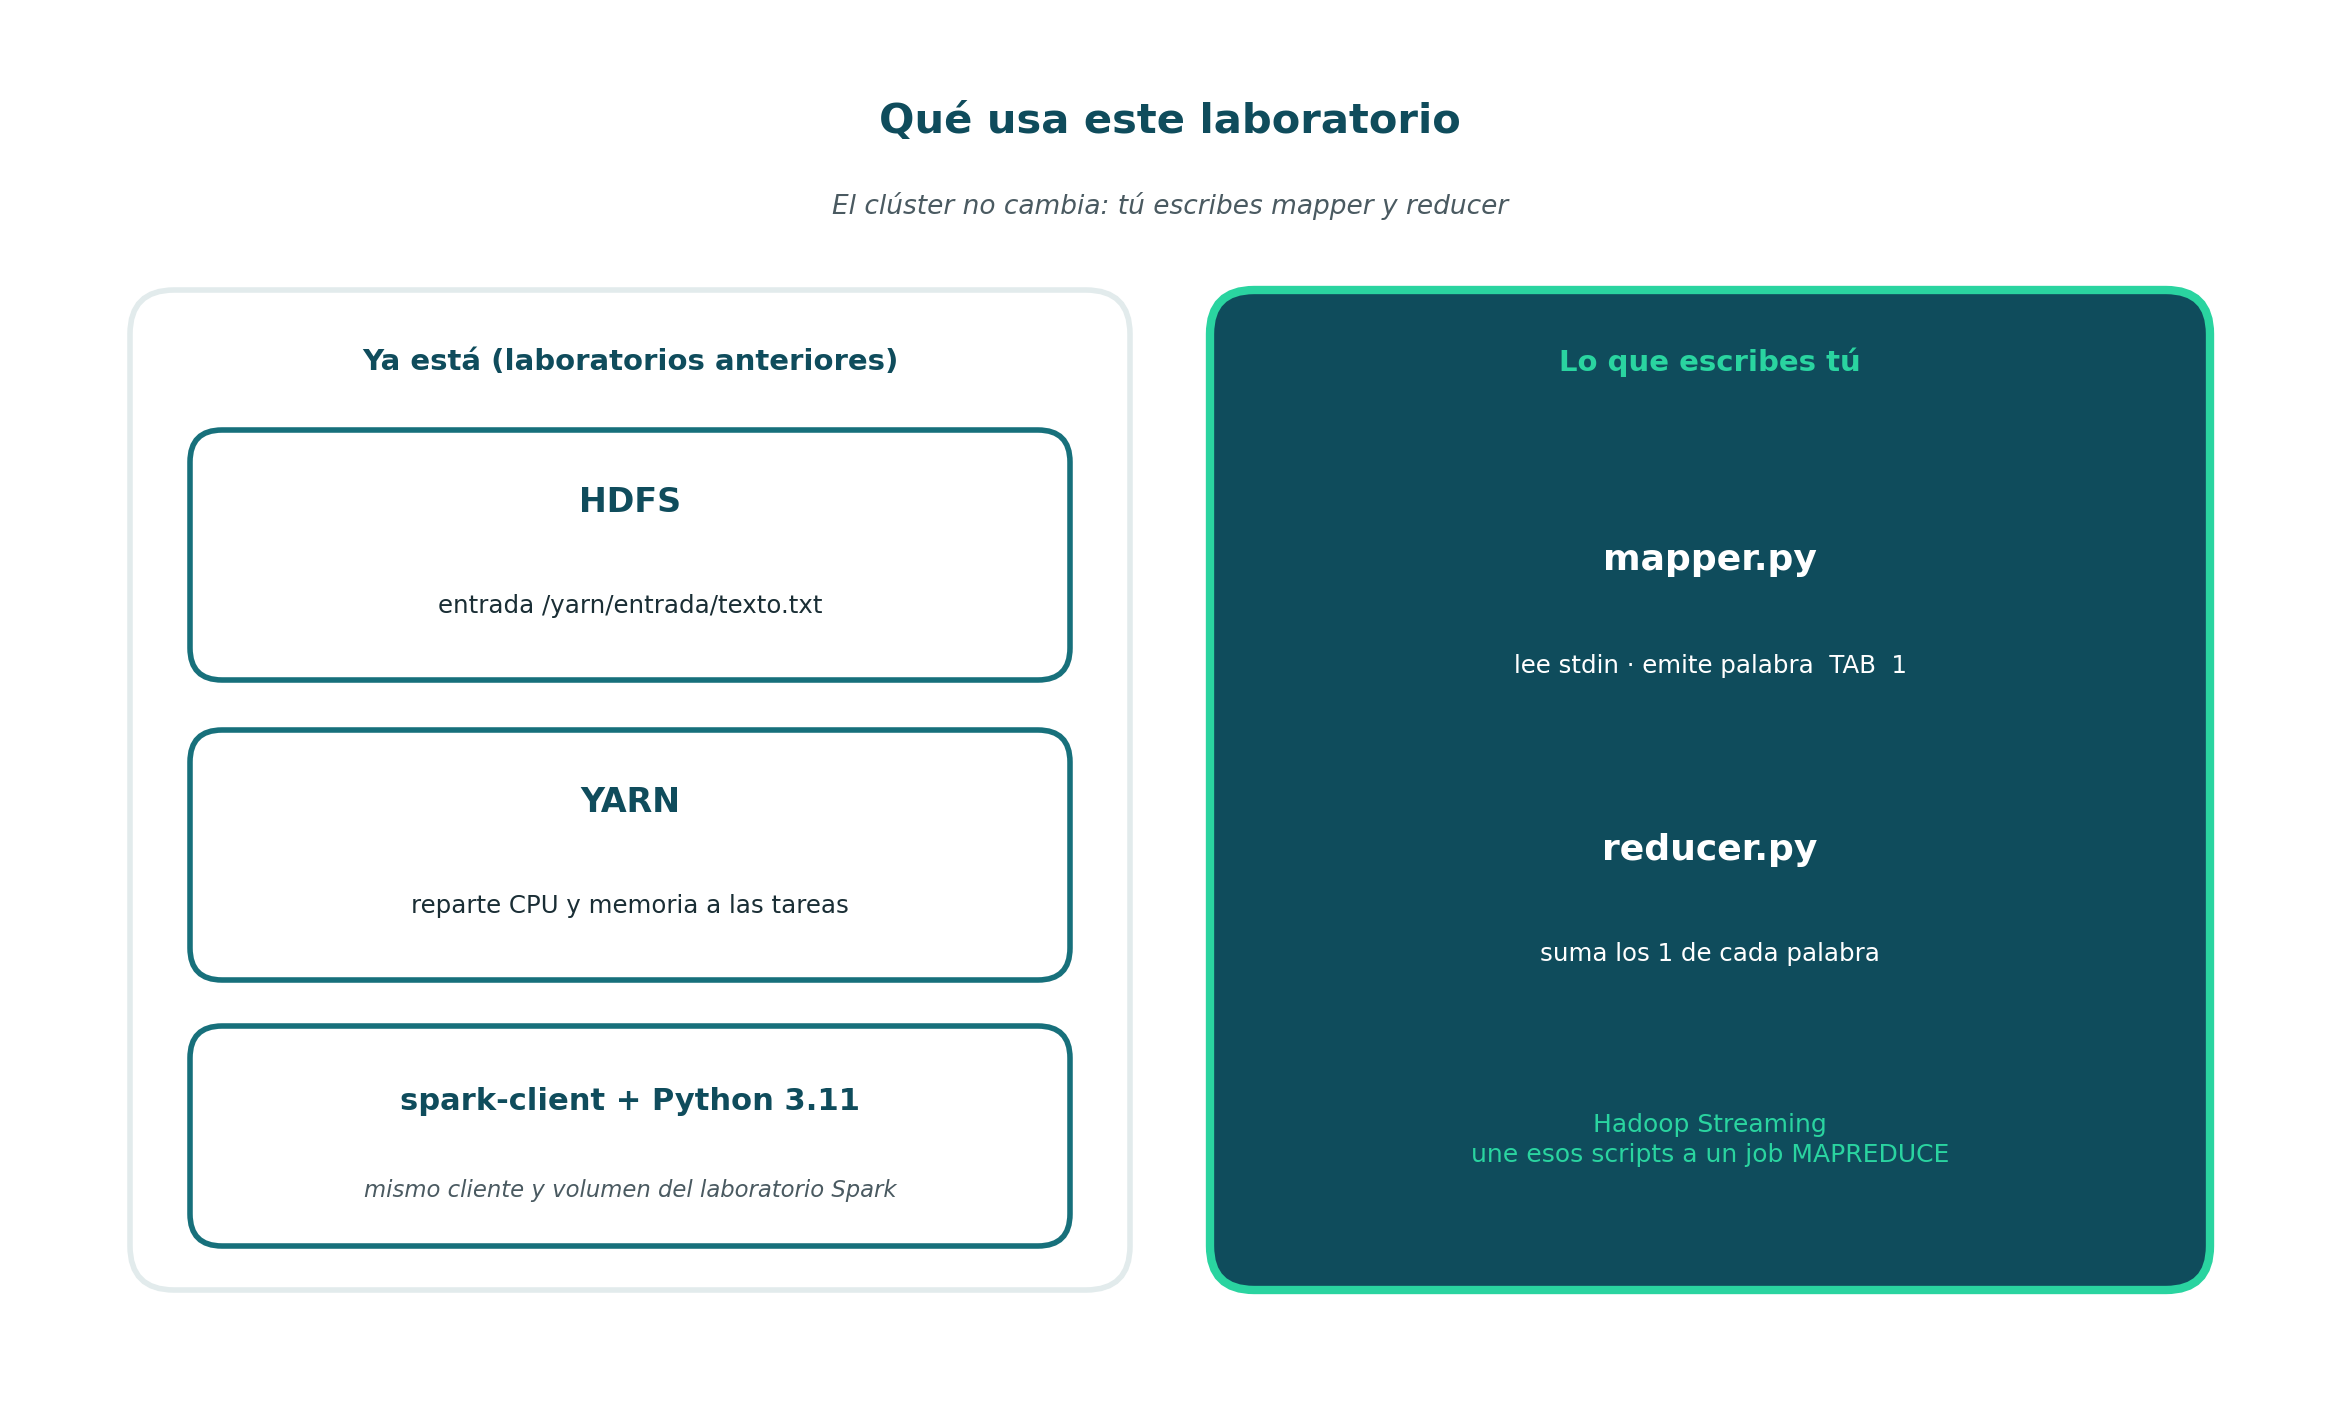
Figura 1. HDFS guarda. YARN reparte hardware. MapReduce es el motor: tú (o un JAR de ejemplos) defines qué se calcula; el clúster dónde y con cuánto.
El tipo MAPREDUCE del portal, en el laboratorio de YARN, era este motor. El laboratorio siguiente te hará escribir el programa en Python.
Parte 2 — Map, shuffle, reduce
Tres fases. Los nombres vuelven a aparecer en Spark, con otro motor.
Map. Un programa —el mapper— lee un split (un trozo de entrada, a menudo alineado con un bloque de HDFS) y emite pares clave-valor. Un par clave-valor es el átomo del modelo: una clave (por qué se agrupará) y un valor (qué se agregará). En un wordcount la clave es la palabra y el valor es 1 (una aparición). El mapper no suma el archivo entero: emite eventos.
Shuffle. Hadoop ordena esos pares por clave y junta los que coinciden. La misma clave termina en el mismo reducer. Esta fase mueve datos por la red; por eso es, a menudo, la más cara.
Reduce. Un programa —el reducer— recibe una clave y la lista de valores que le tocó, y emite el resultado. En el wordcount, la suma de los 1.
Con el texto corto del curso el recorrido se puede seguir a mano:
hadoop hdfs yarn
hadoop mapreduce yarn
spark hadoop datos
yarn datos datos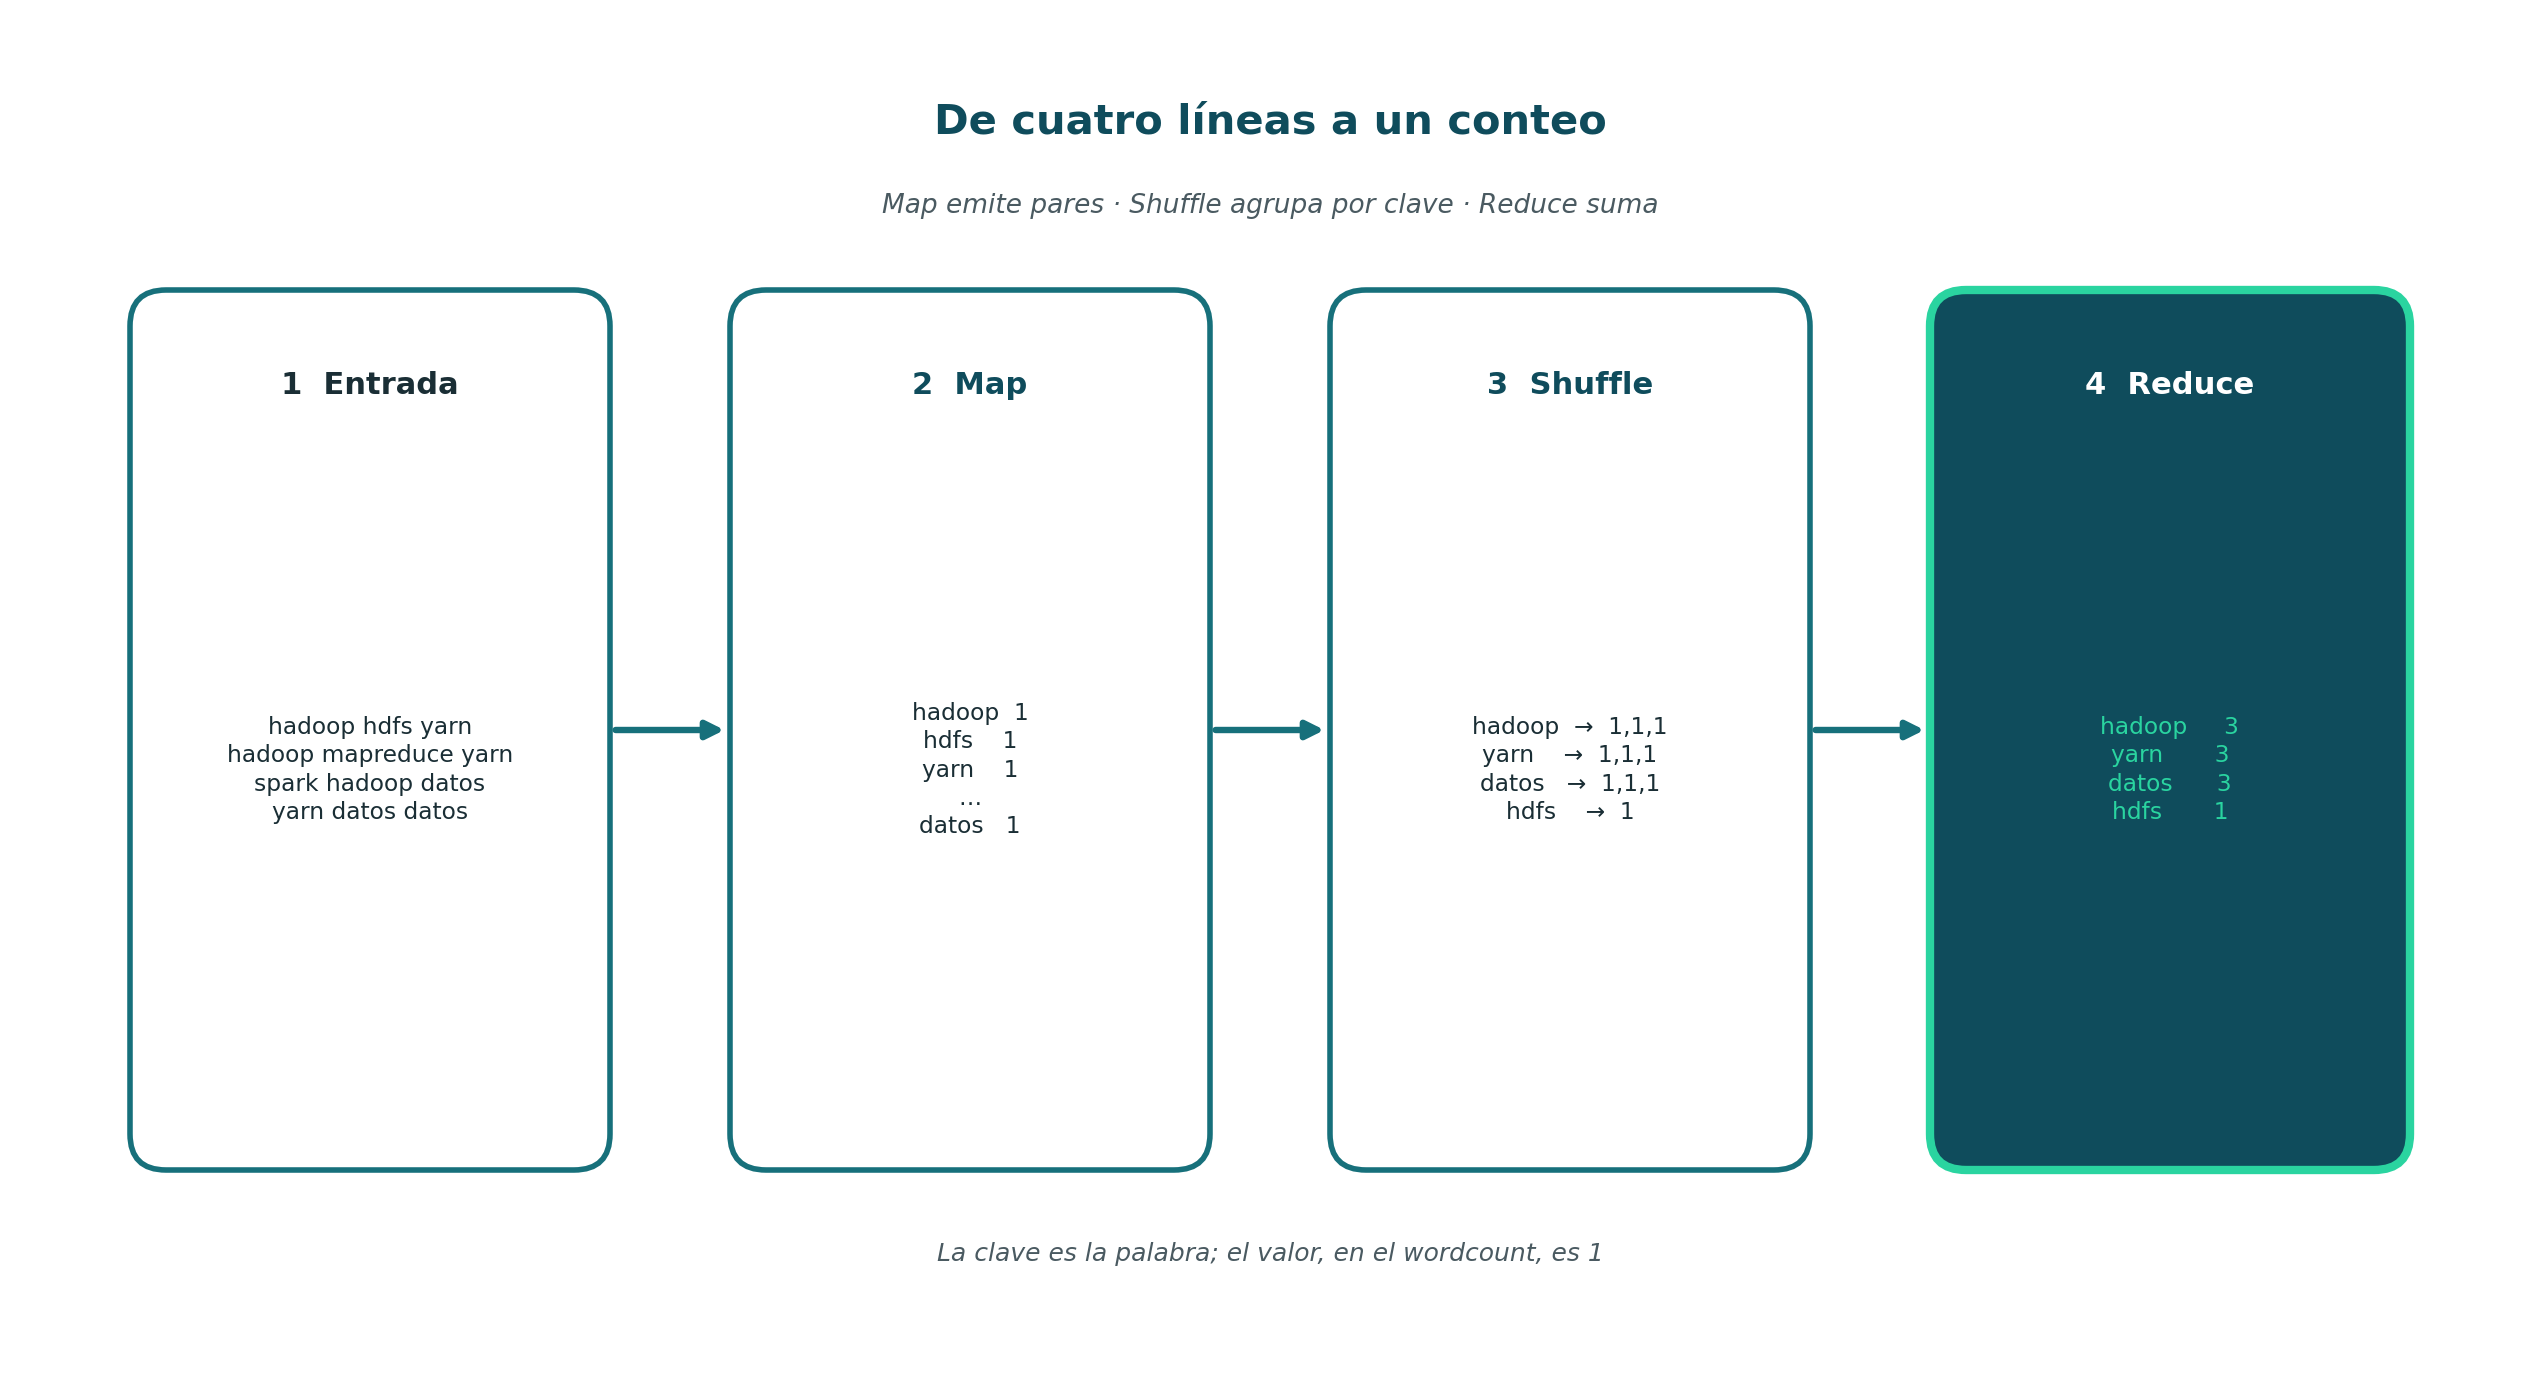
Figura 2. Map emite palabra TAB 1. Shuffle agrupa. Reduce suma. Resultado: hadoop 3, yarn 3, datos 3, hdfs 1, mapreduce 1, spark 1.
Si vienes de Linux, ya usaste el mismo enfoque en una sola máquina:
cat texto.txt | tr ' ' '\n' | sort | uniq -ctr parte (map). sort agrupa (shuffle). uniq -c suma (reduce). Hadoop MapReduce es esa tubería repartida entre nodos, con HDFS en los dos extremos: se lee de HDFS y se escribe en HDFS.
¿Para qué sirve verlo así? Para no tratar el mapper como “el programa que cuenta”. El mapper declara apariciones; el reducer agrega cuando la clave ya está junta.
En el clúster que ya tienes, mira la entrada (no envía un job):
cd ~/hdfs-docker-lab
docker compose exec namenode hdfs dfs -cat /yarn/entrada/texto.txt
El aviso de log4j se ignora. Las cuatro líneas deben coincidir con la Figura 2. Si falta el archivo, está en el paso 8 del laboratorio de YARN.
Parte 3 — El job sobre YARN
MapReduce no sustituye a YARN. Un trabajo MapReduce es una aplicación YARN más (tipo MAPREDUCE en el portal). El ResourceManager concede contenedores; el ApplicationMaster de esta aplicación coordina mapas y reduces.
Hay dos usos de contenedor y no son el mismo:
| Término | Qué es |
|---|---|
| Contenedor Docker | El proceso aislado que ya tenías (namenode, datanode1, resourcemanager…). Enviar un job no crea uno nuevo. |
| Contenedor YARN | Reserva de CPU y memoria dentro de un NodeManager para una tarea map o reduce. |
El recorrido conceptual:
- El cliente Hadoop (en este curso, el NameNode, como en el laboratorio de YARN) envía el job.
- YARN arranca el ApplicationMaster.
- Las tareas map leen splits de HDFS y emiten pares.
- El shuffle agrupa por clave.
- Las tareas reduce escriben en HDFS archivos
part-*(uno por reducer) y, si todo fue bien, un marcador_SUCCESS.
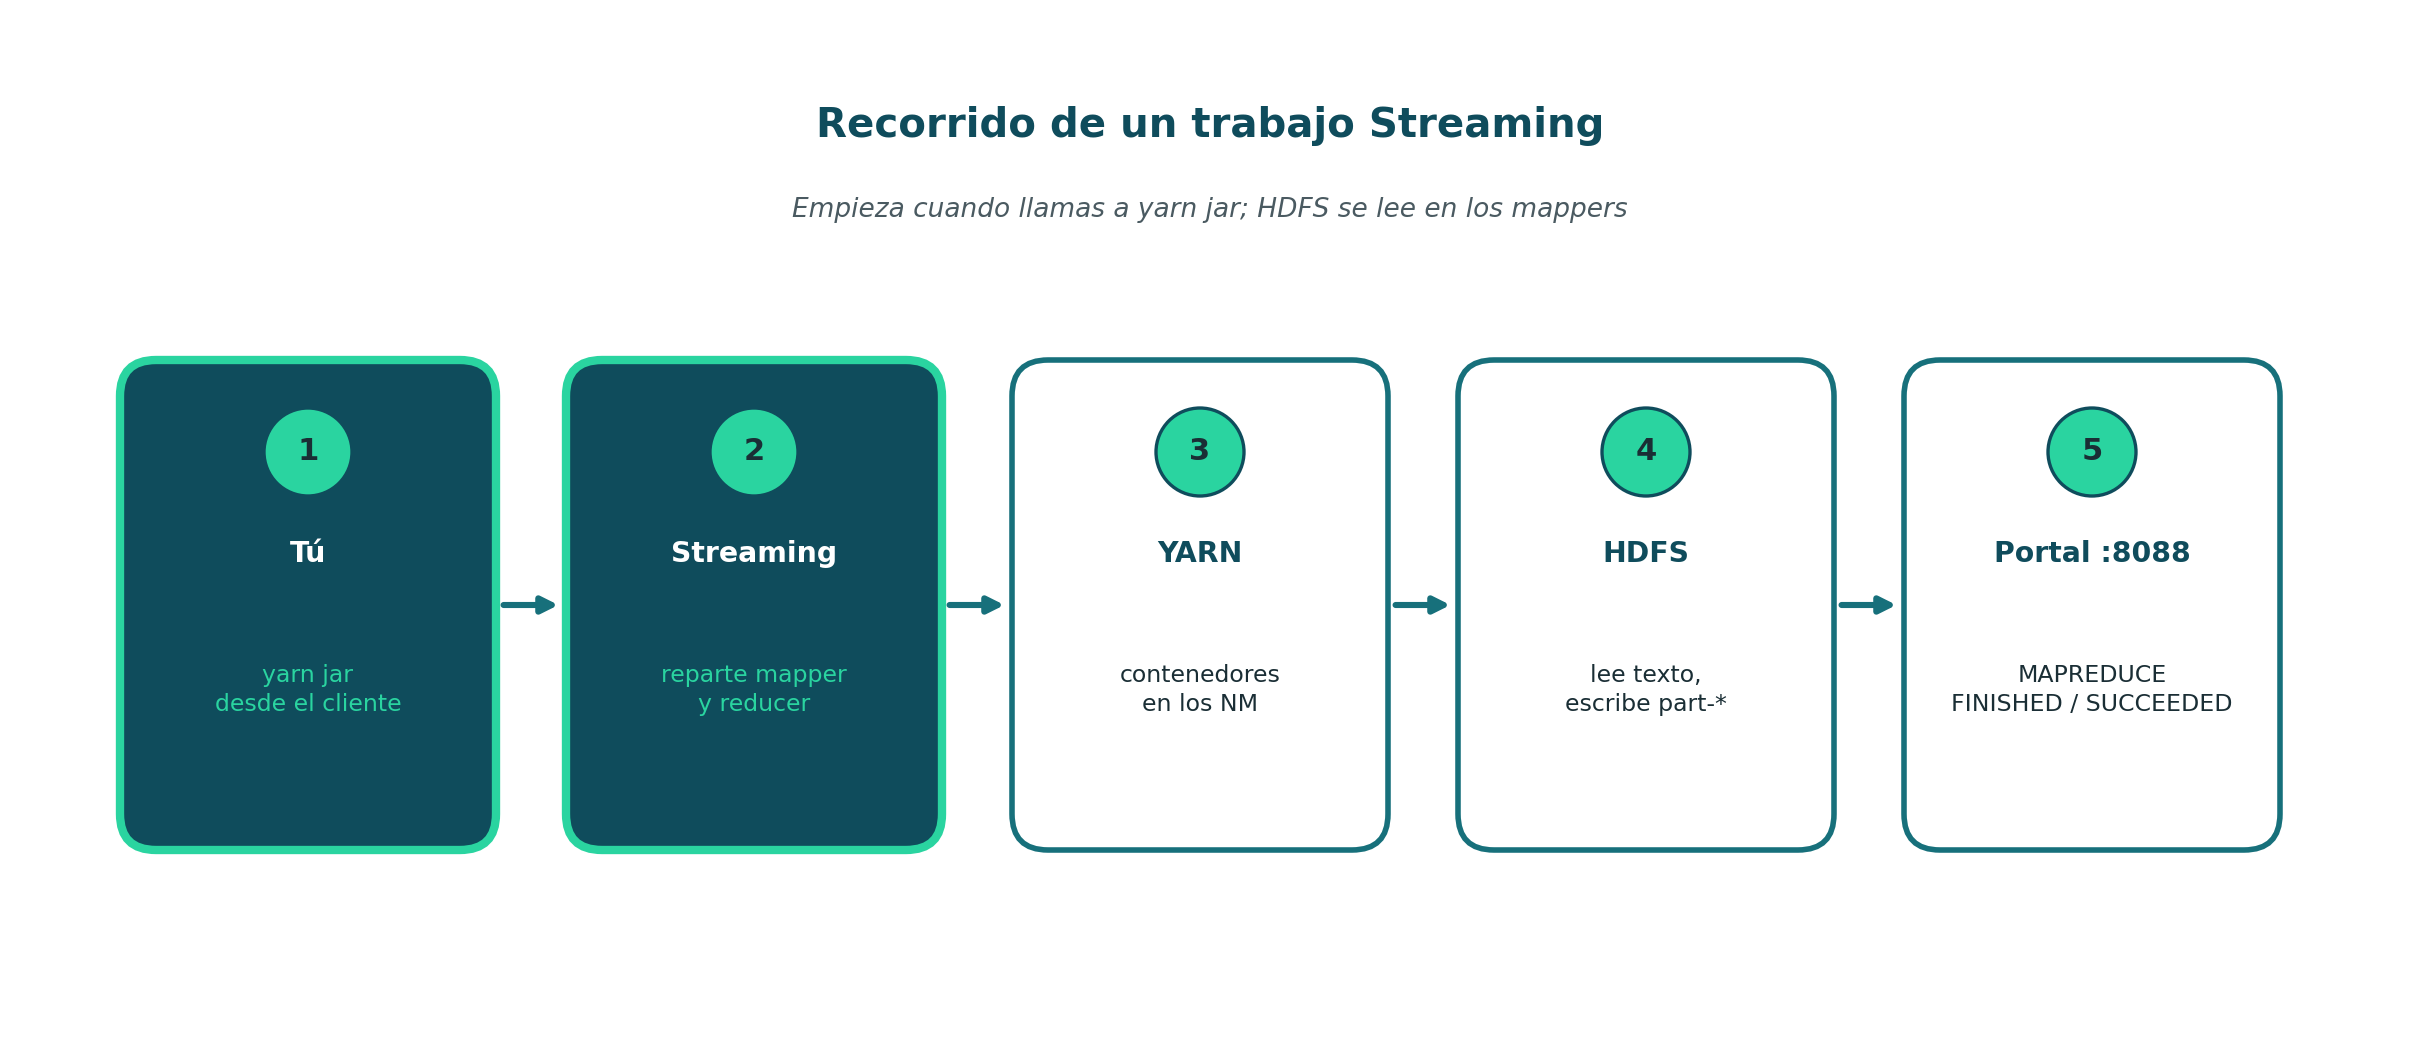
Figura 3. El trabajo empieza en el cliente. YARN lanza las tareas. HDFS se lee en el map y se escribe en el reduce. El portal :8088 muestra una aplicación de tipo MAPREDUCE.
Número de reducers. Es cuántas copias del reducer pide el job, no “cuántas funciones hay en el código”. Un reducer → un part-*. Varios reducers → varios part-*; una clave no puede aparecer en dos archivos. El particionador (partitioner) es quien decide, a partir de la clave, a qué reducer va cada par. Leer un solo part-* con varios reducers da un resultado incompleto.
Un combiner es un mini-reducer opcional que Hadoop puede correr tras el map, en el mismo nodo, para recortar el shuffle. Solo es correcto si la operación es asociativa (se puede parcializar). Sumar cuentas sí; promediar promedios no: hay que conservar (suma, cantidad). Eso se practica en el laboratorio; aquí basta la regla.
Parte 4 — Hadoop Streaming: el mismo modelo, otro lenguaje
El motor MapReduce de Hadoop está escrito para lanzar tareas. El programa del usuario, en el ejemplo clásico, es una clase Java. Hadoop Streaming es un JAR que permite el mismo modelo con cualquier programa que lea la entrada estándar (stdin: lo que llega por la tubería) y escriba la salida estándar (stdout: lo que imprime). El JAR no cuenta palabras: adapta stdin/stdout al job.
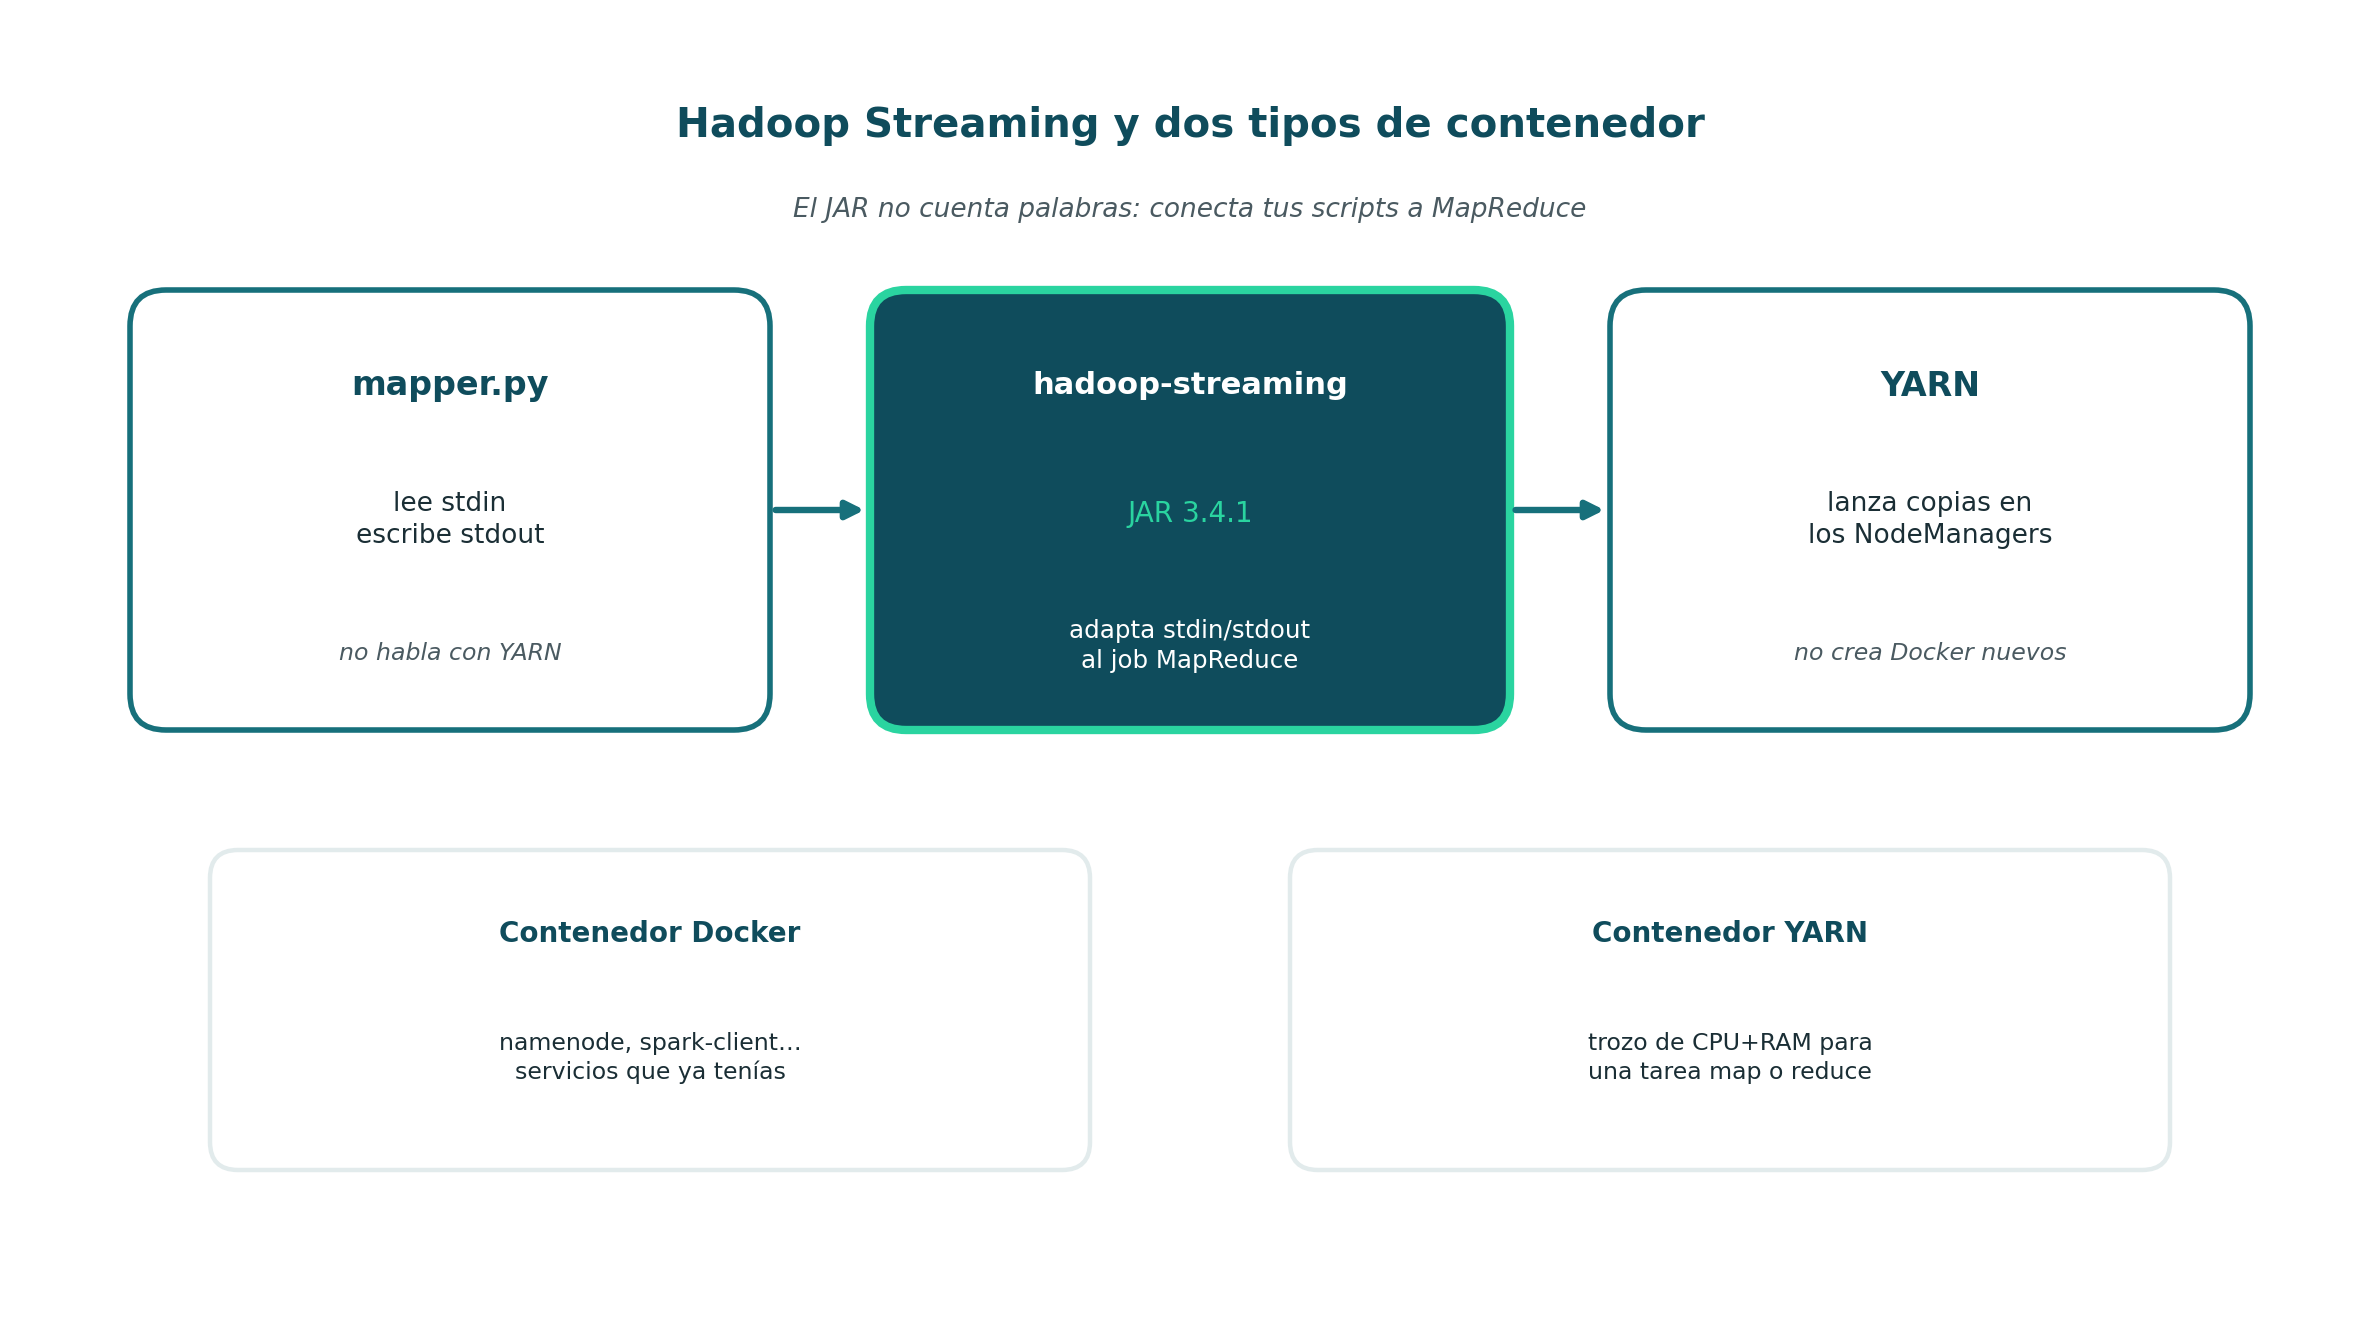
Figura 4. A la izquierda, programas que no hablan con YARN. En el medio, el JAR Streaming. A la derecha, YARN. Abajo: contenedor Docker ≠ contenedor YARN.
En el laboratorio escribirás mapper.py y reducer.py con ese contrato. En esta clase aún no los escribes: los dos ejemplos de la parte 5 usan el JAR de ejemplos de Hadoop, para ver el motor, no para programarlo. El cliente sigue siendo el NameNode.
Parte 5 — Dos ejemplos para ver MapReduce en marcha
Para qué. Hasta aquí el modelo es un dibujo. Estos dos jobs son el dibujo corriendo en el clúster que ya montaste. No sustituyen al laboratorio de Streaming. No hay que completar TODO ni crear scripts. No se añade Spark.
Ejemplo 1 — estimar π. No lee HDFS. Las tareas map “tiran dardos” al azar (método de Monte Carlo) y el reduce combina. Sirve para ver map y reduce aunque no haya un archivo de texto.
Ejemplo 2 — wordcount. Lee las cuatro líneas de /yarn/entrada/texto.txt y escribe el conteo. Es la Figura 2 en el clúster.
En el laboratorio de YARN ya los lanzaste. Aquí vuelves a lanzarlos para mirar el modelo (fases map/reduce, tipo MAPREDUCE), no para rehacer YARN.
El clúster, arriba
Mismo Bash y misma carpeta que en YARN. Un solo compose.yaml:
cd ~/hdfs-docker-lab
docker compose up -d
docker compose exec namenode hdfs dfsadmin -safemode wait
docker compose exec namenode yarn node -list
docker compose exec namenode hdfs dfs -cat /yarn/entrada/texto.txt
Qué debes ver: Safe mode is OFF, dos NodeManagers RUNNING, las cuatro líneas. El aviso log4j se ignora. Si falta el texto, paso 8 del laboratorio de YARN.
El JAR de ejemplos:
/opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar
Ejemplo 1: π
docker compose exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  pi 4 1000
4 es el número de tareas map; 1000 son muestras por tarea. En la terminal: Submitted application application_…, map …% / reduce …% hasta 100 %, y una línea Estimated value of Pi is 3.14…. En http://localhost:8088 el nombre interno es QuasiMonteCarlo, tipo MAPREDUCE, FINISHED / SUCCEEDED.
Ejemplo 2: wordcount
MapReduce no escribe encima de un directorio que ya exista. Si /yarn/teoria_mr_wc quedó de otra corrida, bórralo o cambia el nombre.
docker compose exec namenode hdfs dfs -rm -r -f /yarn/teoria_mr_wc
docker compose exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  wordcount /yarn/entrada/texto.txt /yarn/teoria_mr_wc
docker compose exec namenode hdfs dfs -cat /yarn/teoria_mr_wc/part-r-00000
Qué debes ver en part-r-00000 (el Java de ejemplos usa el prefijo part-r-):
datos   3
hadoop  3
hdfs    1
mapreduce   1
spark   1
yarn    3
Eso es el shuffle + reduce de la Figura 2. En el portal, una segunda aplicación MAPREDUCE llamada word count.
Qué observar (los dos)
| Dónde | Qué confirma |
|---|---|
Terminal: map 100% reduce 100% |
Las dos fases del modelo ocurrieron |
Portal :8088, tipo MAPREDUCE |
No es Spark: es el motor de esta clase |
π sin -input |
MapReduce no exige un texto; el wordcount sí, porque su mapper lee líneas |
part-r-00000 = seis claves |
Un reducer, un archivo; el diccionario coincide con el dibujo |
Para apagar sin borrar datos: docker compose stop (como en el laboratorio de YARN).
Parte 6 — Qué no es MapReduce (y qué viene después)
| No es | Porque |
|---|---|
| HDFS | HDFS guarda bloques; MapReduce los lee y escribe |
| YARN | YARN concede CPU y RAM; MapReduce las usa en tareas map/reduce |
| “Un contenedor Docker” | El cálculo vive en contenedores YARN |
| Spark | Spark también corre sobre YARN, pero el modelo de ejecución es otro (DAG de etapas, memoria, más de un paso map-reduce) |
Spark no invalida MapReduce como idea: groupByKey, reduceByKey y el shuffle de Spark son primos de estas tres fases. Por eso MapReduce va antes de Spark y de PySpark: primero este modelo, después el otro motor y su API en Python.
Límites clásicos del enfoque. Un job MapReduce es, en lo esencial, un map seguido de un reduce (con shuffle en medio). Encadenar varios pasos implica varios jobs y varios vuelcos a HDFS. El shuffle es caro. El reducer debe emitir el último grupo: el contrato es “una clave a la vez, en orden”, no un diccionario de todo el archivo en memoria.
Cierre
Al terminar esta clase deberías poder decir, con tus palabras:
- MapReduce responde cómo se calcula en paralelo sobre datos ya guardados, no dónde se guardan ni quién reparte el hardware.
- El mapper emite pares; el shuffle agrupa por clave; el reducer combina cada grupo.
- El wordcount de cuatro líneas es el mismo dibujo que
tr | sort | uniq -c, a escala de clúster. - Un job MapReduce es una aplicación YARN; Docker y YARN no son el mismo contenedor.
- Streaming es una forma de escribir ese modelo con
stdin/stdout. - En el portal, π (QuasiMonteCarlo) y wordcount son dos aplicaciones
MAPREDUCEdel mismo motor; la diferencia es si hay archivo de entrada y shuffle de palabras.
La práctica —programar mapper y reducer— está en Taller de MapReduce Streaming. El orden: clúster (HDFS, YARN, cliente Spark) → MapReduce (esta clase y su taller) → Spark → PySpark.
Referencias: Dean y Ghemawat, MapReduce (2004), Hadoop MapReduce, Hadoop Streaming.