PySpark: la API de Spark en Python
PySpark: la API de Spark en Python
SparkSession, DataFrames y el motor que ya conoces
En este artículo vas a entender qué es PySpark: no un motor distinto, sino la API en Python de Spark. El centro es la SparkSession, la diferencia RDD / DataFrame, y el par transformación / acción (evaluación perezosa).
El clúster, MapReduce y Spark ya están. Aquí no se explica HDFS ni se construye el cliente. Programar las celdas es el taller.
Tiempo estimado de lectura: 18 minutos
Nivel: Intermedio
Conocimientos previos recomendados: - Clúster: HDFS, YARN y el cliente Spark - MapReduce (el wordcount de cuatro líneas: el mismo problema, otra API) - Spark: driver, executors, DAG, tipo SPARK
Tecnologías mencionadas: - PySpark 3.5 (SparkSession, DataFrame, funciones select / filter / groupBy) - RDD (contraste) - Catalyst (optimizador, a nivel de idea)
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
📌 Parte de la serie Big Data.
Spark está escrito en Scala y corre en la JVM. PySpark es el puente: escribes Python; el driver y los executors siguen siendo Spark. El Python del driver y el de las tareas YARN tiene que coincidir (eso ya lo dejó el laboratorio de Spark).
No hay un “clúster PySpark” aparte. El master sigue siendo YARN. En el portal el tipo sigue siendo SPARK.
Parte 1 — SparkSession
La SparkSession es el objeto por el que el código Python habla con Spark: DataFrames, SQL y, debajo, el SparkContext. SparkSession.builder.getOrCreate() crea la aplicación YARN (o reutiliza una ya abierta). Hasta spark.stop(), los executors siguen reservados aunque no estés calculando.
Sesión = aplicación. Si el portal no muestra nada, la sesión no nació. La memoria y el host del driver ya están en la configuración del laboratorio Spark; esta clase no la reescribe.
Parte 2 — RDD y DataFrame
Un RDD (Resilient Distributed Dataset) es una colección distribuida de elementos. Tú escribes map y reduceByKey. Está cerca de MapReduce.
Un DataFrame es una tabla distribuida: columnas con nombre y tipo. Encima trabaja Catalyst, el optimizador de Spark: reordena filtros, elige un plan. Es la API de este curso (SQL, más adelante streaming y MLlib, también hablan DataFrame).
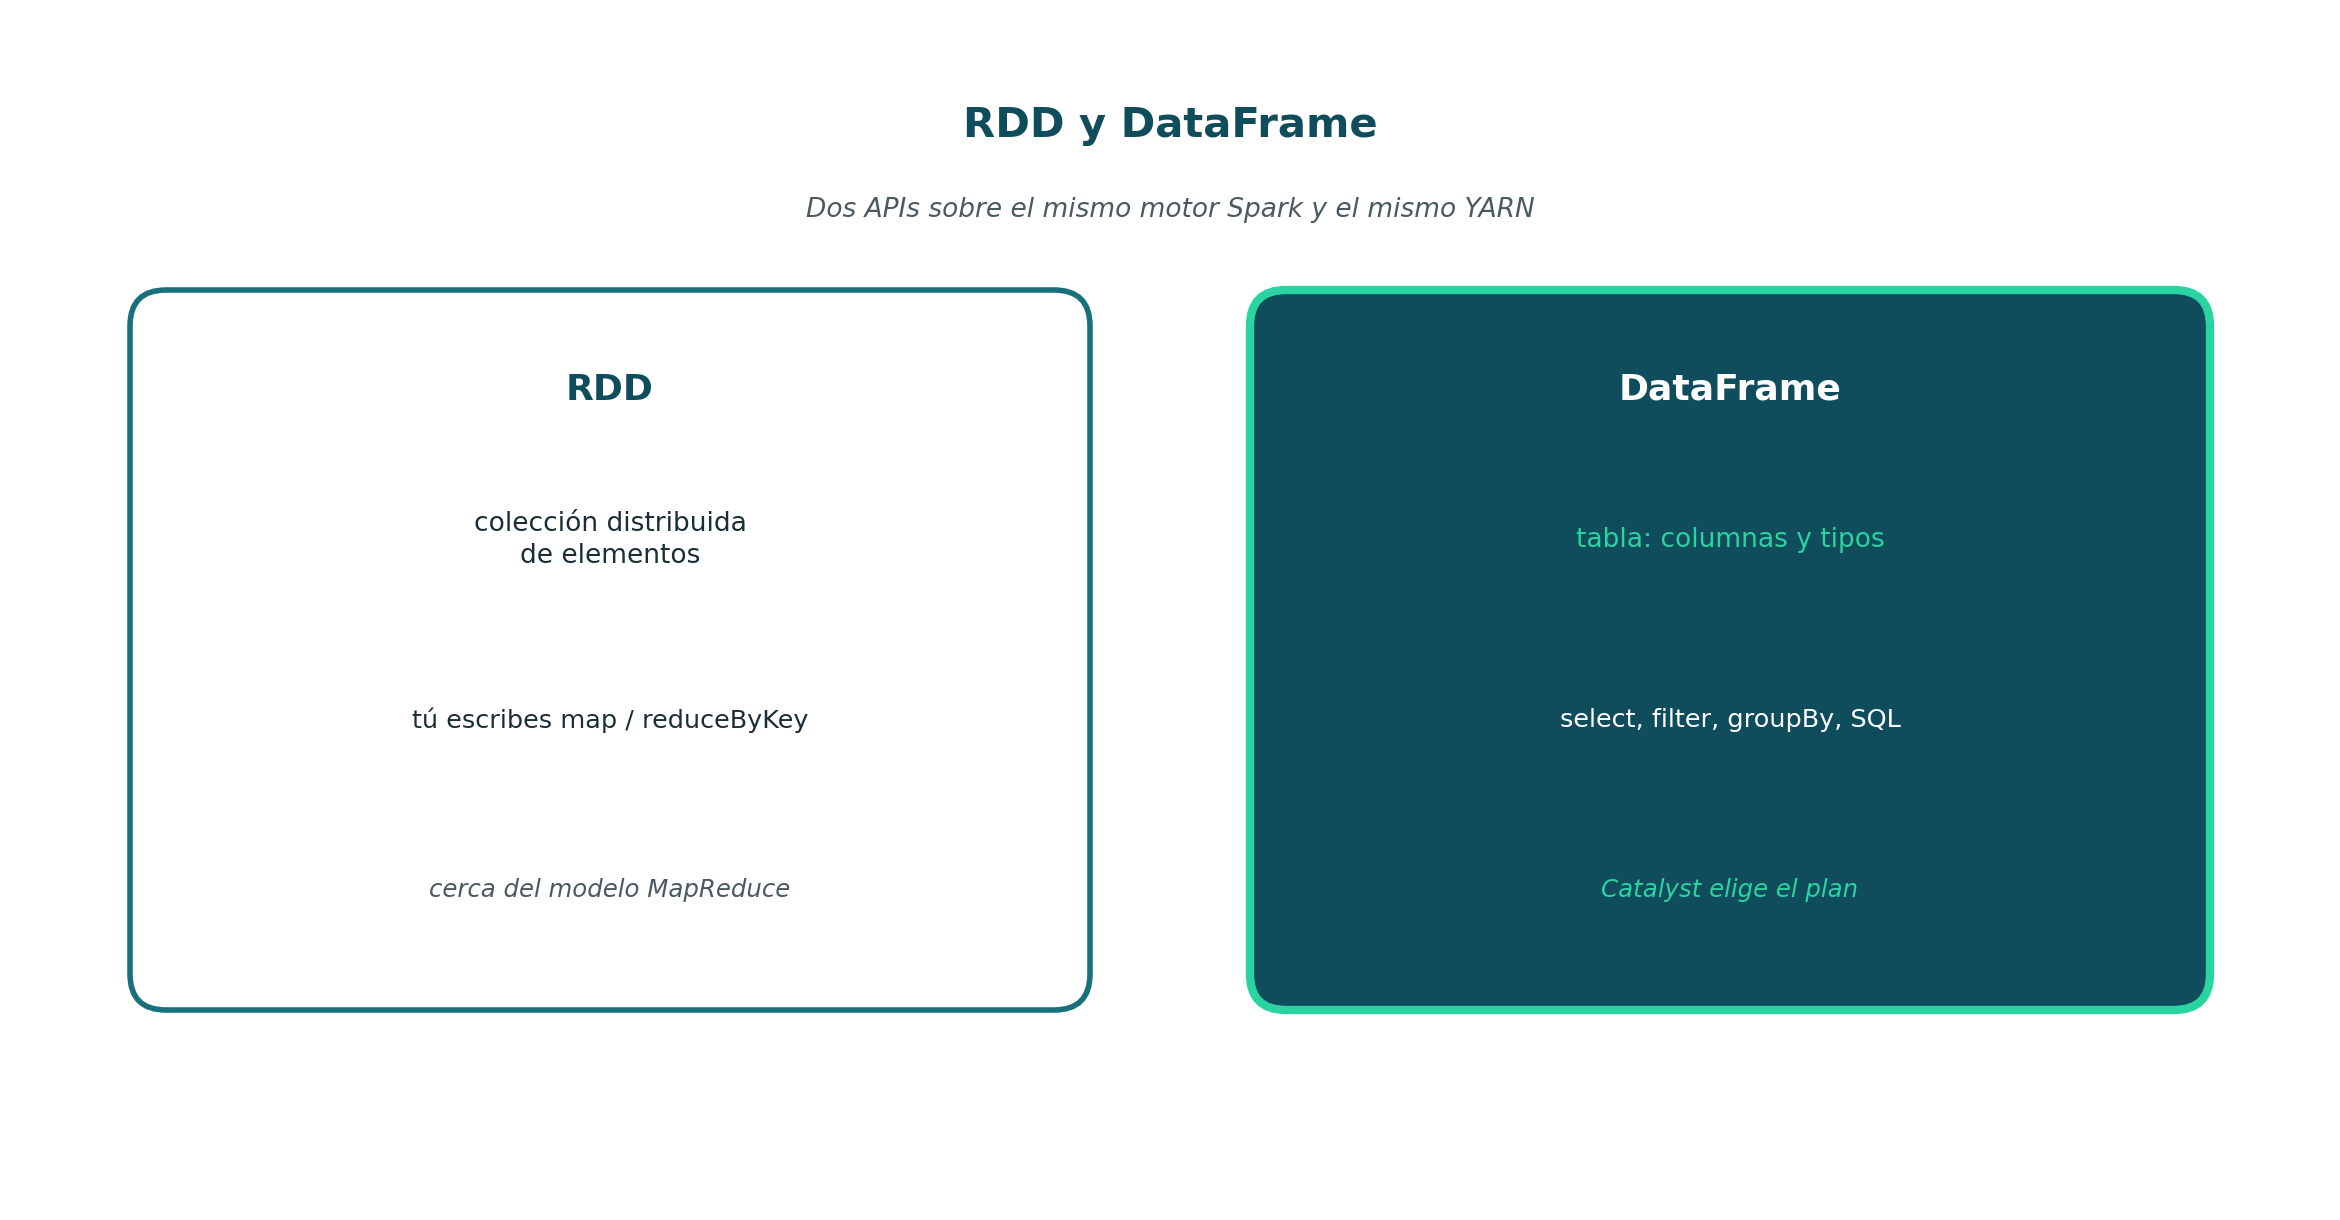
Figura 1. Mismo motor. RDD: funciones sobre elementos. DataFrame: columnas, tipos y un optimizador.
¿Para qué sirve la distinción? Si piensas en tuplas (palabra, 1), estás en RDD. Si piensas en SELECT / WHERE / GROUP BY, estás en DataFrame. El wordcount del laboratorio se hace en DataFrame a propósito: el mismo problema de MapReduce, leído como tabla.
collect() trae todas las filas al driver. Con cuatro palabras es inofensivo; con un archivo grande llena la RAM del cliente. show() enseña unas filas y deja el resto en los executors.
Parte 3 — Transformaciones y acciones
Una transformación (filter, select, groupBy, split…) añade un paso al plan. No calcula.
Una acción (count, show, write, collect) pide un resultado. Ahí Spark arma el DAG, YARN ejecuta y, si hace falta, hay shuffle.
Eso es la evaluación perezosa: el filtro “con hadoop” no corre al escribir .filter(...); corre al .count().
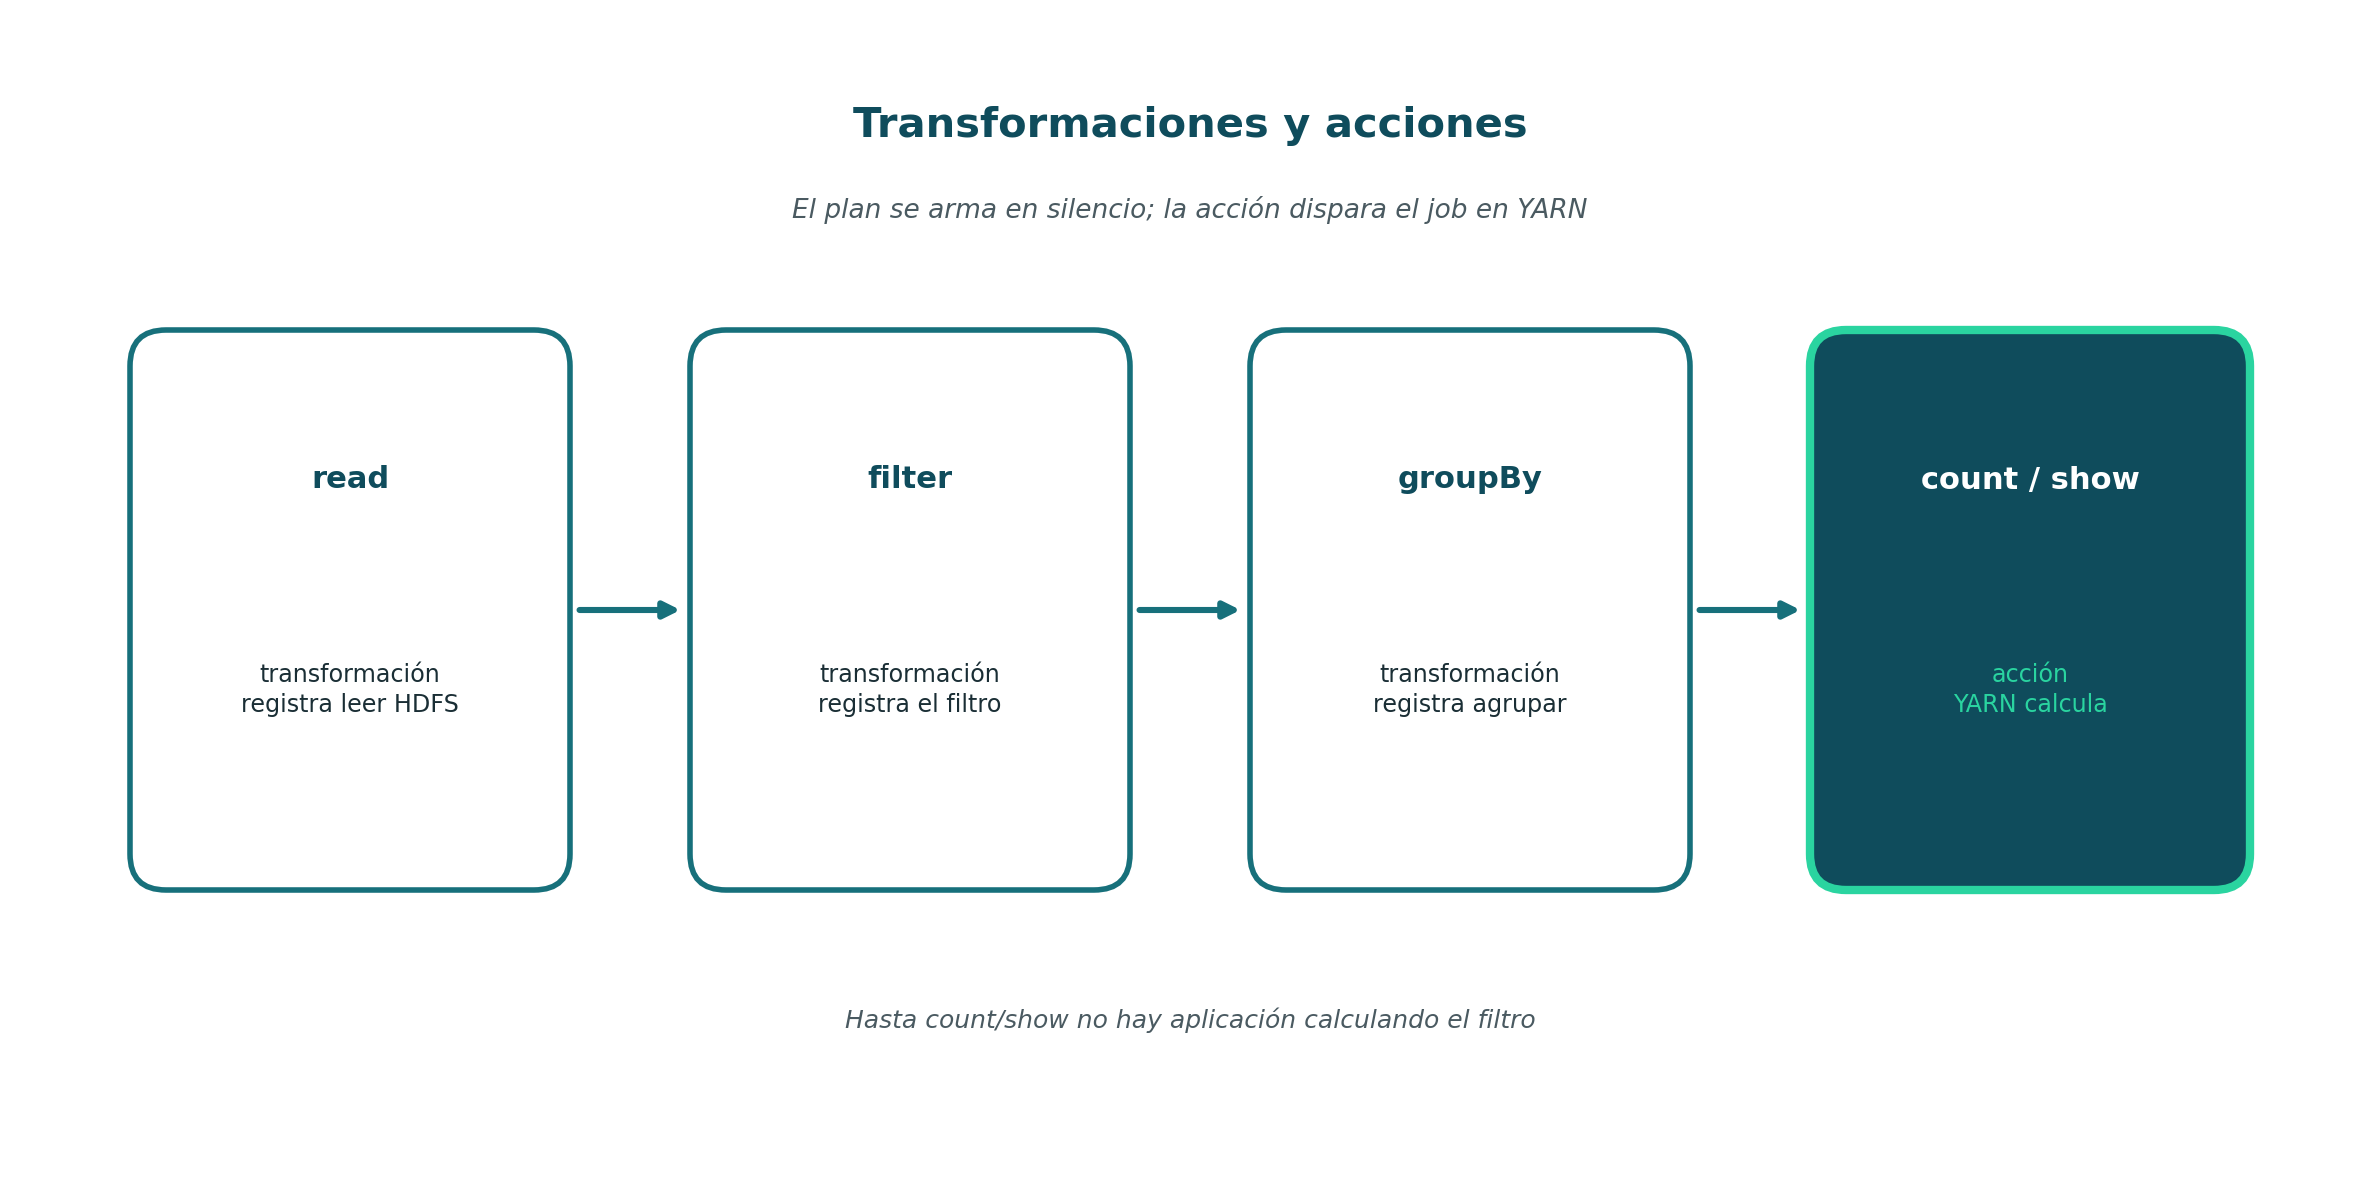
Figura 2. read / filter / groupBy registran. count o show disparan el job.
Que la aplicación ya esté en :8088 no significa que el filtro se haya calculado: la sesión reservó executors al crearse. El job (la acción) es otra cosa, más abajo en la UI de Spark (:4040 mientras la sesión vive).
Leer metadatos o inferir un esquema (inferSchema) puede tocar el archivo antes de tu count. La pereza se refiere al plan que tú encadenas, no a “Spark nunca lee disco”.
Parte 4 — El wordcount, ahora como tabla
En MapReduce: mapper emite palabra TAB 1; shuffle agrupa; reducer suma.
En DataFrame, sobre las mismas cuatro líneas:
splitparte la línea (el map sobre el texto).explodeconvierte cada palabra en una fila.groupBy("palabra").count()agrupa y cuenta (shuffle + reduce).orderBydeja el resultado comparable conpart-*de Streaming.
No escribes un archivo HDFS entre cada paso. El shuffle puede ocurrir igual. Si no pides caché, una segunda acción puede volver a ejecutar el plan.
¿Para qué sirve? Para ver que el modelo de la clase MapReduce no desaparece: cambia cuánto código hace falta y cuándo se materializa el resultado. Escribir a HDFS (write) es una acción: cierra el ciclo del clúster.
Parte 5 — Qué no es PySpark
| No es | Porque |
|---|---|
| Un Python del portátil | El laboratorio usa el Python del clúster, el mismo de las tareas YARN |
| Instalar PySpark en el host | El motor ya está en el cliente Spark |
| Spark SQL como producto aparte | SQL entra por la misma SparkSession |
| “No hay shuffle” | groupBy sigue pudiendo barajar datos entre executors |
Cierre
Al terminar esta clase deberías poder decir:
- PySpark es Python hablando con el Spark de YARN, no otro clúster.
- SparkSession abre (y
stopcierra) la aplicación. - DataFrame es la tabla; RDD es la colección de elementos.
- Transformación arma el plan; acción lo ejecuta.
La práctica está en Taller de PySpark. El orden: clúster (HDFS, YARN, cliente Spark) → MapReduce → Spark → PySpark (esta clase y su taller).
Referencias: PySpark, Spark SQL, DataFrames.