# Librerías base para regresión múltiple
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

import statsmodels.api as sm
from statsmodels.stats.outliers_influence import variance_inflation_factor

# Estilo visual base para mantener uniformidad en todas las graficas
sns.set_theme(style="whitegrid", context="notebook")
plt.rcParams["axes.titlesize"] = 12
plt.rcParams["axes.labelsize"] = 10

# Semillas globales para reproducibilidad
SEMILLA = 24         # dataset de energía y partición entrenamiento/prueba
SEMILLA_DEMO = 2026 # dataset sintético de la exploración (Etapas 1-8)Análisis Avanzado de Datos — 2. Regresión lineal múltiple
estadistica
analisis-multivariado
regresion-multiple
Regresión lineal con varios predictores: supuestos, multicolinealidad y VIF, cuándo regularizar y cómo diagnosticar los residuos paso a paso.
Análisis Avanzado de Datos — 2. Regresión lineal múltiple

👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
De una variable a varias
En el artículo anterior ajustaste una recta con un solo predictor y viste su límite: ninguna variable, por sí sola, se acerca al poder explicativo de combinarlas. Este artículo da el paso natural: la regresión lineal múltiple, que explica una respuesta con varios predictores a la vez. Recorremos el concepto, los supuestos, el flujo de modelado, la multicolinealidad, la evaluación predictiva y el diagnóstico de residuos.
El ejemplo que guía el artículo es el consumo energético residencial.
1. Qué es análisis multivariado
En análisis univariado observamos una variable a la vez. En bivariado estudiamos la relación entre dos.
En multivariado analizamos varias variables simultáneamente para:
Explicar una variable objetivo con múltiples predictores: en lugar de asumir que un solo factor determina el resultado, modelamos la contribución conjunta de varias variables. Esto permite representar mejor fenómenos reales, que casi siempre son multifactoriales.
Controlar factores de confusión: algunas variables pueden distorsionar una relación aparente entre predictor y respuesta. Incluirlas en el modelo ayuda a aislar relaciones más limpias y evita conclusiones engañosas.
Estimar efectos parciales (manteniendo constantes otras variables): cada coeficiente se interpreta como el cambio esperado en la respuesta cuando una variable aumenta una unidad y las demás permanecen fijas. Esta idea es clave para interpretar impactos individuales.
Mejorar capacidad predictiva y toma de decisiones: combinar información de varias fuentes suele reducir error de predicción y producir recomendaciones más útiles para la acción (priorizar variables, diseñar intervenciones o asignar recursos).
Una precisión de vocabulario: en sentido estricto, el análisis multivariado estudia varias variables respuesta a la vez (lo verás con PCA más adelante en la serie). Un modelo con una sola respuesta y varios predictores se llama, con más precisión, regresión múltiple, que es el caso de este artículo.
2. Modelo base: regresión lineal múltiple
Una formulación típica es:
\[y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \cdots + \beta_p x_p + \varepsilon\]
donde:
- \(y\) es la variable objetivo,
- \(x_1, \ldots, x_p\) son predictores,
- \(\beta_j\) representa el cambio esperado en \(y\) por una unidad adicional de \(x_j\), manteniendo las demás variables constantes,
- \(\varepsilon\) es el término de error: captura la variación que los predictores no explican y se supone de media cero.
3. Ejemplo de contexto (energía residencial)
Objetivo: explicar el consumo mensual de energía (kWh) a partir de variables como:
- temperatura promedio exterior,
- número de ocupantes,
- área de la vivienda (m²),
- índice de aislamiento térmico,
- cantidad de electrodomésticos intensivos.
Este tipo de problema es naturalmente multivariado: una sola variable rara vez explica por completo el consumo.
# Dataset sintetico: energia residencial
rng = np.random.default_rng(SEMILLA)
n = 500

temperatura = rng.normal(20, 4, n)
ocupantes = rng.integers(1, 7, n)
area_m2 = rng.normal(85, 20, n).clip(35, 180)
aislamiento = rng.uniform(0.2, 1.0, n)
electrodomesticos = rng.integers(2, 11, n)

ruido = rng.normal(0, 25, n)
consumo_kwh = (
    120
    + 1.8 * area_m2
    + 18 * ocupantes
    + 9 * electrodomesticos
    - 55 * aislamiento
    + 2.7 * np.abs(temperatura - 22)
    + ruido
)

df = pd.DataFrame({
    "temperatura": temperatura,
    "ocupantes": ocupantes,
    "area_m2": area_m2,
    "aislamiento": aislamiento,
    "electrodomesticos": electrodomesticos,
    "consumo_kwh": consumo_kwh
})

df.head()| temperatura | ocupantes | area_m2 | aislamiento | electrodomesticos | consumo_kwh | |
|---|---|---|---|---|---|---|
| 0 | 25.402989 | 6 | 63.467466 | 0.844029 | 3 | 299.966911 |
| 1 | 21.372362 | 2 | 91.735187 | 0.989880 | 2 | 270.224405 |
| 2 | 15.348039 | 3 | 113.854308 | 0.644984 | 8 | 484.737064 |
| 3 | 19.251657 | 6 | 103.425939 | 0.868907 | 6 | 438.477021 |
| 4 | 18.642142 | 3 | 104.342106 | 0.951808 | 10 | 391.704887 |
4. Flujo recomendado de trabajo
Definir la pregunta y la variable objetivo. ¿Qué quieres entender o predecir exactamente? Fija la variable objetivo (el resultado que se explica), la unidad de análisis (hogar, persona, empresa) y el horizonte temporal (día, mes, año). Si la pregunta es difusa, el modelo también lo será.
Revisar la calidad de los datos. Busca nulos (datos faltantes), atípicos (outliers, valores muy alejados del comportamiento normal), diferencias de escala (por ejemplo, 0–1 frente a 0–10 000) y problemas de codificación de categorías. Un modelo no corrige datos mal preparados; arrastra sus problemas a las conclusiones.
Explorar relaciones entre predictores y objetivo. Antes de modelar, busca relaciones claras o débiles, efectos no lineales, interacciones (el efecto de una variable depende del nivel de otra) y predictores redundantes. Es la sección 5.
Partir los datos en entrenamiento y prueba. El modelo se ajusta con el conjunto de entrenamiento y se evalúa con el de prueba, que no vio; así se mide la generalización (desempeño en datos nuevos) y no la memoria.
Ajustar un modelo base. Empieza por OLS (ordinary least squares, mínimos cuadrados ordinarios): elige los coeficientes que minimizan la suma de los residuos al cuadrado (una recta con un predictor, un hiperplano con varios). Cada coeficiente indica cuánto cambia la respuesta si su predictor sube una unidad, con los demás constantes; el intercepto es el valor esperado cuando todos los predictores valen cero. Este modelo es la referencia para saber si la complejidad adicional aporta.
Diagnosticar supuestos y multicolinealidad. La pregunta no es solo “¿cuánto acierta?”, sino “¿es confiable lo que dice?”. Se revisan los residuos (valor real menos valor predicho): si muestran patrón, el modelo deja estructura sin explicar; si su dispersión cambia a lo largo de las predicciones, falla la homoscedasticidad. Y se mide la multicolinealidad (solapamiento de información entre predictores) con el VIF, que indica cuánto se infla la incertidumbre de un coeficiente por colinealidad. Si esta etapa falla, no interpretes los coeficientes como firmes, aunque el error global parezca bueno (secciones 6, 7 y 10).
Evaluar con métricas y validación cruzada. El MAE (error absoluto medio, en unidades reales), el RMSE (parecido, pero castiga más los errores grandes) y el \(R^2\) (coeficiente de determinación: proporción de la variabilidad de la respuesta que explica el modelo; en datos nuevos puede ser incluso negativo) dicen cómo le fue al modelo en una partición concreta. La validación cruzada (CV) divide los datos en \(k\) partes o pliegues (folds), entrena con \(k-1\) y evalúa en la restante, rotando: dice si el resultado se sostiene o depende de una muestra afortunada. No decidas con una sola métrica: un buen \(R^2\) puede convivir con errores absolutos demasiado altos para la decisión (fórmulas y lectura en la sección 8).
Iterar. Con los resultados en mano, prueba transformaciones (cambiar la escala o forma de una variable), regularización (penalizar la complejidad para evitar sobreajuste; Ridge y Lasso, sección 9) o selección de variables. El primer modelo rara vez es el mejor.
Comunicar resultados con interpretación y límites. Explica qué se encontró, con qué confianza y bajo qué condiciones: la significancia estadística (evidencia, bajo supuestos, de que una relación no es producto del azar) no equivale a relevancia práctica (que el efecto importe en la realidad), y toda conclusión declara sus limitaciones. La guía de la sección 11 organiza esta lectura paso a paso.
Criterio general: en análisis multivariado, la claridad de la pregunta y la calidad de los datos suelen influir más en el resultado que elegir un algoritmo más sofisticado.
5. Exploración multivariada
La exploración multivariada es el puente entre “tener datos” y “construir un modelo con criterio”. Su objetivo no es solo describir, sino detectar señales útiles y riesgos metodológicos antes del entrenamiento formal.
En esta etapa buscamos responder preguntas prácticas como: - ¿Qué variables parecen realmente informativas? - ¿Cuáles variables parecen duplicar información? - ¿Hay patrones no lineales que un modelo lineal simple no capturaría bien? - ¿Existen grupos atípicos que puedan sesgar conclusiones?
5.1 Distribuciones marginales
Una distribución marginal muestra el comportamiento de cada variable por separado. Aquí observamos centro (media/mediana), dispersión (rango, desviación), asimetría y presencia de valores extremos.
Por qué importa: si una variable tiene cola muy larga o fuerte asimetría, puede requerir transformación para modelar mejor.
5.2 Relación predictor-objetivo
Luego observamos cada predictor contra la variable objetivo. No buscamos perfección, buscamos forma general de relación: creciente, decreciente, curvilínea o casi nula.
Por qué importa: ayuda a priorizar variables y evita asumir linealidad donde no la hay.
5.3 Relación entre predictores
También analizamos cómo se relacionan los predictores entre sí. Si dos variables se mueven casi juntas, pueden aportar información redundante.
Por qué importa: la redundancia puede inflar incertidumbre de coeficientes y dificultar interpretación.
5.4 Matriz de correlaciones: qué sí y qué no
La correlación resume asociación lineal entre pares de variables. Es útil como mapa rápido, pero no reemplaza la inspección visual ni implica causalidad.
Lectura prudente: - Correlación alta sugiere relación lineal fuerte, no necesariamente utilidad causal. - Correlación baja no descarta relación no lineal. - Correlación entre predictores alerta posible colinealidad.
5.5 Patrones no lineales
En multivariado real, muchas relaciones no son rectas. Puede haber umbrales, saturaciones o efectos en U.
Por qué importa: si forzamos linealidad cuando la relación es curvilínea, aumentan residuos sistemáticos y baja capacidad explicativa.
5.6 Segmentos y heterogeneidad
A veces el mismo fenómeno se comporta distinto en subgrupos (por zona, tipo de hogar, estrato de consumo, etc.). Esto se llama heterogeneidad estructural.
Por qué importa: un solo modelo global puede ocultar patrones opuestos entre segmentos.
5.7 Atípicos con contexto
No todo atípico es un error. Algunos son errores de captura; otros son casos reales raros pero informativos.
Buena práctica: diferenciar el atípico técnico (dato incorrecto) del atípico sustantivo (caso extremo real). La decisión de tratar o conservar debe quedar justificada.
5.8 Resultado esperado de esta fase
Una buena exploración multivariada produce tres entregables concretos: 1. Hipótesis de trabajo sobre qué variables deberían entrar al modelo base. 2. Lista de riesgos (colinealidad, no linealidad, outliers, posibles segmentos). 3. Plan de modelado (transformaciones, interacciones y pruebas diagnósticas a ejecutar).
5.9 Ejemplo guiado con dataset sintético y validación
En las celdas siguientes construimos un dataset sintético (Etapa 1) y validamos cada punto anterior de forma observable, en ocho etapas cuya hoja de ruta aparece justo después de construirlo.
Idea central: no es solo “mirar gráficos”; es transformar observaciones en decisiones de modelado.
# Etapa 1: construir un dataset sintetico controlado
from sklearn.preprocessing import PolynomialFeatures

rng = np.random.default_rng(SEMILLA_DEMO)
n = 450

# Segmento para heterogeneidad estructural
segmento = rng.choice(["urbano", "rural"], size=n, p=[0.65, 0.35])

# Predictores con relación y colinealidad parcial
ingreso = rng.normal(2500, 700, n).clip(700, 6000)
tamano_hogar = rng.integers(1, 7, n)
edad_vivienda = rng.normal(18, 9, n).clip(1, 60)
aislamiento = rng.uniform(0.25, 0.95, n)

# Variable casi redundante con ingreso (colinealidad intencional)
gasto_electrico_base = 0.28 * ingreso + rng.normal(0, 120, n)

# Relación no lineal intencional con temperatura
temperatura = rng.normal(22, 5, n)
efecto_temp = 3.5 * np.abs(temperatura - 24)

# Consumo con diferencias por segmento
efecto_segmento = np.where(segmento == "urbano", 55, -20)
ruido = rng.normal(0, 45, n)

consumo = (
    140
    + 0.045 * ingreso
    + 26 * tamano_hogar
    + 1.4 * edad_vivienda
    - 95 * aislamiento
    + 0.10 * gasto_electrico_base
    + efecto_temp
    + efecto_segmento
    + ruido
)

df_demo = pd.DataFrame({
    "segmento": segmento,
    "ingreso": ingreso,
    "tamano_hogar": tamano_hogar,
    "edad_vivienda": edad_vivienda,
    "aislamiento": aislamiento,
    "gasto_electrico_base": gasto_electrico_base,
    "temperatura": temperatura,
    "consumo_kwh": consumo
})

# Inyectamos unos pocos outliers tecnicos
idx_out = rng.choice(df_demo.index, size=6, replace=False)
df_demo.loc[idx_out, "consumo_kwh"] *= rng.uniform(2.2, 3.0, size=6)

preds = ["ingreso", "tamano_hogar", "edad_vivienda", "aislamiento", "gasto_electrico_base", "temperatura"]

print("Dataset listo:", df_demo.shape)
df_demo.head()
Dataset listo: (450, 8)| segmento | ingreso | tamano_hogar | edad_vivienda | aislamiento | gasto_electrico_base | temperatura | consumo_kwh | |
|---|---|---|---|---|---|---|---|---|
| 0 | urbano | 3529.588009 | 5 | 18.831308 | 0.318681 | 848.615877 | 27.700205 | 651.985974 |
| 1 | urbano | 3011.545595 | 1 | 17.317106 | 0.395043 | 943.795033 | 21.264064 | 455.502952 |
| 2 | urbano | 1867.989940 | 2 | 19.121387 | 0.916190 | 641.560758 | 19.776674 | 381.269929 |
| 3 | urbano | 2766.180609 | 6 | 7.003895 | 0.350032 | 725.326119 | 27.505114 | 580.113407 |
| 4 | urbano | 3329.189267 | 4 | 33.654735 | 0.762742 | 879.857518 | 13.710123 | 537.211727 |
5.10 Hoja de ruta de las etapas
En lugar de un script único, separamos el análisis en etapas para validar cada idea por separado.
- Etapa 1: crear datos sintéticos con patrones controlados.
- Etapa 2: revisar distribuciones marginales.
- Etapa 3: medir correlación de predictores con la variable objetivo.
- Etapa 4: estudiar correlación entre predictores (aquí está el foco principal).
- Etapa 5: confirmar redundancia con VIF.
- Etapa 6: comprobar no linealidad.
- Etapa 7: evaluar heterogeneidad por segmento.
- Etapa 8: detectar atípicos con el criterio del rango intercuartílico (IQR, \(Q_3 - Q_1\)): se marca todo valor por debajo de \(Q_1 - 1.5\,\text{IQR}\) o por encima de \(Q_3 + 1.5\,\text{IQR}\).
Sugerencia: ejecuta en orden para que cada etapa use objetos creados en las anteriores.
La Etapa 1 no busca probar hipótesis: construye un laboratorio de 450 hogares y 8 columnas con estructura controlada (colinealidad, heterogeneidad, no linealidad y atípicos) para que cada patrón aparezca de forma observable. La lección vale para cualquier dataset: antes de interpretar resultados, verifica que entiendes cómo se generó o recolectó el dato.
Una aclaración antes de seguir: para que estos patrones (colinealidad fuerte, heterogeneidad clara, outliers marcados) se vean con nitidez, el dataset que acabas de construir en la Etapa 1 es distinto del de energía residencial de la sección 3 — tiene variables propias (ingreso, tamano_hogar, gasto_electrico_base, segmento urbano/rural) diseñadas a propósito para ilustrar cada fenómeno con claridad. Cuando lleguemos a la sección 6 y construyamos el modelo completo, vas a volver al dataset original de la sección 3.
# Etapa 2: distribuciones marginales y asimetría
vars_plot = ["consumo_kwh", "ingreso", "tamano_hogar", "edad_vivienda", "aislamiento", "temperatura"]

fig, axes = plt.subplots(2, 3, figsize=(14, 7))
for ax, col in zip(axes.ravel(), vars_plot):
    sns.histplot(df_demo[col], kde=True, ax=ax)
    ax.set_title(f"Distribución: {col}")
plt.tight_layout()
plt.show()

print("Asimetría (skewness) por variable:")
display(df_demo[vars_plot].skew().to_frame("skew"))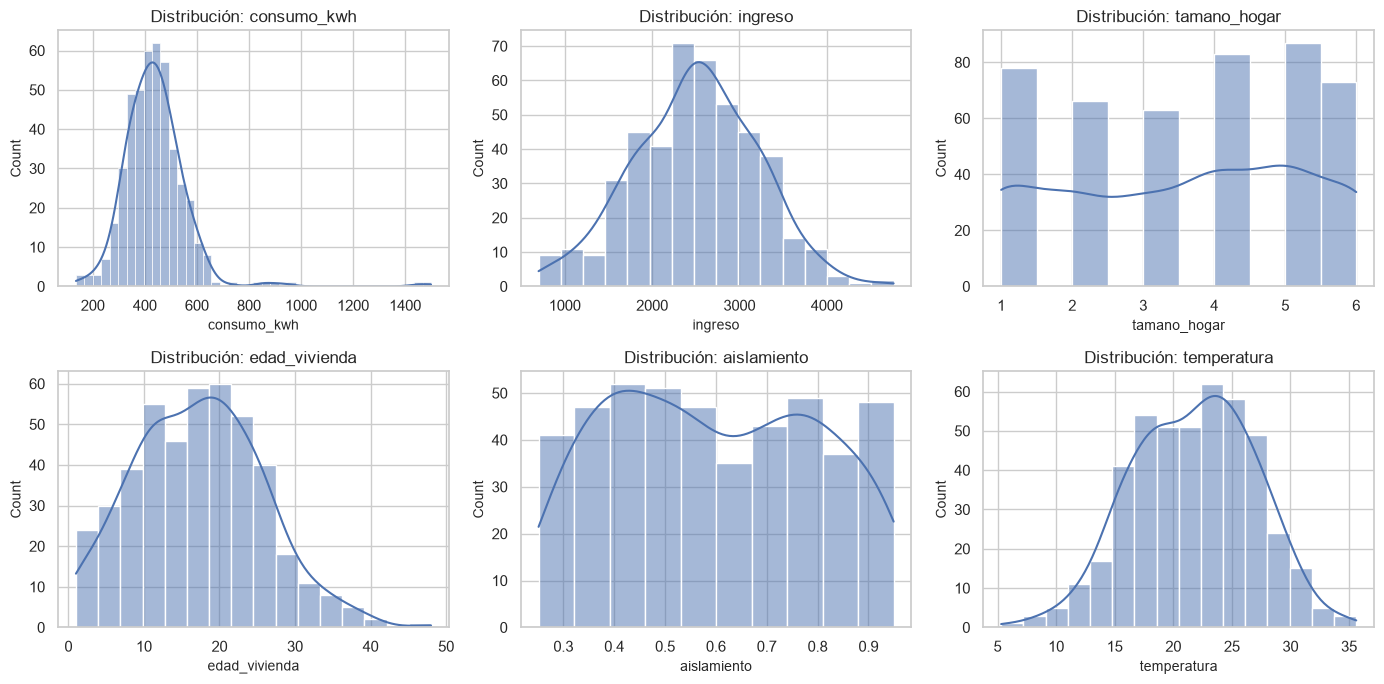
Asimetría (skewness) por variable:| skew | |
|---|---|
| consumo_kwh | 2.880080 |
| ingreso | -0.046295 |
| tamano_hogar | -0.115303 |
| edad_vivienda | 0.255195 |
| aislamiento | 0.081775 |
| temperatura | -0.130655 |
Cómo leer este resultado: distribuciones y asimetría
- La asimetría de
consumo_kwhes 2.88, frente a valores entre −0.13 y 0.26 en todos los predictores: la respuesta tiene una cola derecha marcada, visible en el histograma como unos pocos valores aislados por encima de 800 kWh. - Los predictores principales muestran formas razonables y no patológicas en comparación con la variable objetivo.
- Conclusión analítica: ya hay evidencia temprana de observaciones extremas en la respuesta; esto justifica revisar outliers más adelante (Etapa 8).
# Etapa 3: correlación de cada predictor con la variable objetivo
corr_target = df_demo[preds + ["consumo_kwh"]].corr()["consumo_kwh"].drop("consumo_kwh")
corr_target = corr_target.sort_values(key=np.abs, ascending=False)

print("Correlación predictor -> consumo (ordenada por magnitud absoluta):")
display(corr_target.to_frame("corr_con_consumo"))

plt.figure(figsize=(7, 4))
corr_target.sort_values().plot(kind="barh")
plt.title("Correlación de predictores con consumo_kwh")
plt.xlabel("Coeficiente de correlación")
plt.tight_layout()
plt.show()

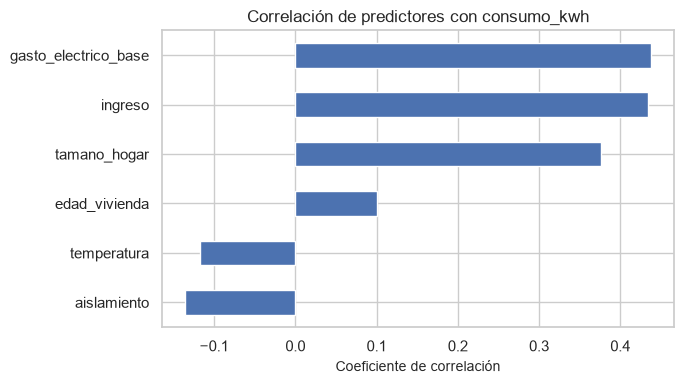
print("Interpretación: magnitud más alta = asociación lineal más fuerte (no implica causalidad).")
Correlación predictor -> consumo (ordenada por magnitud absoluta):| corr_con_consumo | |
|---|---|
| gasto_electrico_base | 0.437479 |
| ingreso | 0.434257 |
| tamano_hogar | 0.375648 |
| aislamiento | -0.135343 |
| temperatura | -0.117516 |
| edad_vivienda | 0.099901 |
Interpretación: magnitud más alta = asociación lineal más fuerte (no implica causalidad).Cómo leer este resultado: correlación con la respuesta
- Los predictores con mayor correlación absoluta con
consumo_kwhsongasto_electrico_base(0.437) eingreso(0.434); son candidatos fuertes para el modelo base, aunque, como verás en la Etapa 4, cuentan casi la misma historia. tamano_hogar(0.376) también aporta señal útil, aunque menor;aislamiento(−0.135),temperatura(−0.118) yedad_vivienda(0.100) quedan muy por debajo.- Variables con correlación baja no se descartan automáticamente: podrían actuar de forma no lineal o en interacción con otras.
temperaturaes el ejemplo: su efecto se construyó en forma de V (\(3.5\,|T-24|\)), y una correlación lineal no puede capturarlo. - Conclusión clave: una correlación alta prioriza, pero no prueba causalidad.
# Etapa 4: correlación entre predictores (foco principal)
corr_preds = df_demo[preds].corr()

print("Matriz de correlación entre predictores:")
display(corr_preds)

plt.figure(figsize=(8, 5))
sns.heatmap(corr_preds, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Correlación entre predictores")
plt.show()

# Ranking de pares con mayor correlación absoluta
pairs = (
    corr_preds.where(np.triu(np.ones(corr_preds.shape), k=1).astype(bool))
    .stack()
    .reset_index()
    .rename(columns={"level_0": "var_1", "level_1": "var_2", 0: "corr"})
)
pairs["abs_corr"] = pairs["corr"].abs()
pairs = pairs.sort_values("abs_corr", ascending=False)

print("Top 8 pares más correlacionados (en valor absoluto):")
display(pairs.head(8))

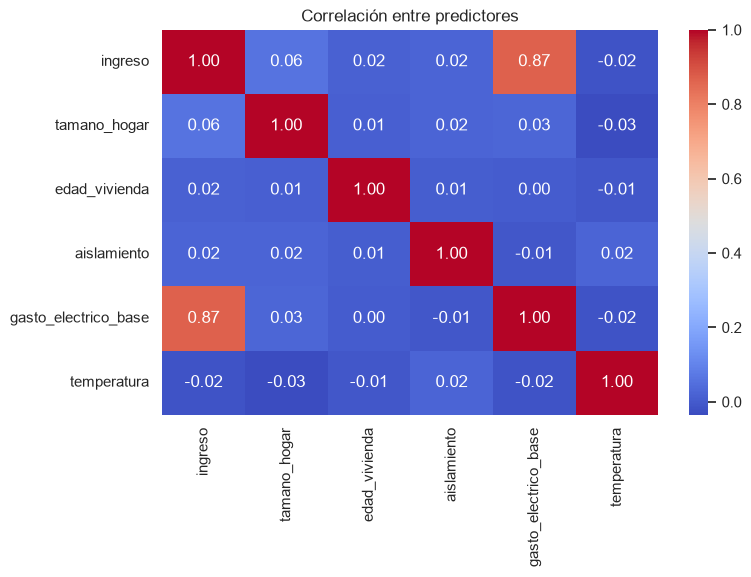
print("Lectura clave: una correlación alta entre predictores sugiere posible redundancia de información.")
Matriz de correlación entre predictores:| ingreso | tamano_hogar | edad_vivienda | aislamiento | gasto_electrico_base | temperatura | |
|---|---|---|---|---|---|---|
| ingreso | 1.000000 | 0.058265 | 0.015557 | 0.022029 | 0.869356 | -0.015021 |
| tamano_hogar | 0.058265 | 1.000000 | 0.010388 | 0.023812 | 0.026014 | -0.034876 |
| edad_vivienda | 0.015557 | 0.010388 | 1.000000 | 0.005575 | 0.003494 | -0.008368 |
| aislamiento | 0.022029 | 0.023812 | 0.005575 | 1.000000 | -0.008215 | 0.022293 |
| gasto_electrico_base | 0.869356 | 0.026014 | 0.003494 | -0.008215 | 1.000000 | -0.017753 |
| temperatura | -0.015021 | -0.034876 | -0.008368 | 0.022293 | -0.017753 | 1.000000 |
Top 8 pares más correlacionados (en valor absoluto):| var_1 | var_2 | corr | abs_corr | |
|---|---|---|---|---|
| 4 | ingreso | gasto_electrico_base | 0.869356 | 0.869356 |
| 1 | ingreso | tamano_hogar | 0.058265 | 0.058265 |
| 11 | tamano_hogar | temperatura | -0.034876 | 0.034876 |
| 10 | tamano_hogar | gasto_electrico_base | 0.026014 | 0.026014 |
| 9 | tamano_hogar | aislamiento | 0.023812 | 0.023812 |
| 23 | aislamiento | temperatura | 0.022293 | 0.022293 |
| 3 | ingreso | aislamiento | 0.022029 | 0.022029 |
| 29 | gasto_electrico_base | temperatura | -0.017753 | 0.017753 |
Lectura clave: una correlación alta entre predictores sugiere posible redundancia de información.Cómo leer este resultado: correlación entre predictores
- La matriz y el ranking de pares muestran una correlación muy alta entre ingreso y gasto_electrico_base (alrededor de 0.87).
- Esto indica redundancia informativa: ambas variables están capturando, en parte, el mismo fenómeno.
- Riesgo práctico: si ambas entran juntas al modelo, los coeficientes pueden volverse menos estables y más difíciles de interpretar.
- Regla práctica: una correlación alta entre dos predictores obliga a revisar la colinealidad; una correlación baja por pares no la descarta, porque un predictor puede ser casi combinación lineal de varios otros. Por eso el siguiente paso es el VIF.
# Etapa 5: cuantificar redundancia entre predictores con VIF
X_vif_demo = sm.add_constant(df_demo[preds])
vif_demo = pd.DataFrame({
    "variable": X_vif_demo.columns,
    "VIF": [variance_inflation_factor(X_vif_demo.values, i) for i in range(X_vif_demo.shape[1])]
})

display(vif_demo.sort_values("VIF", ascending=False))
print("Guía rápida: VIF < 5 usualmente aceptable; 5-10 zona de alerta; >= 10 problema serio.")| variable | VIF | |
|---|---|---|
| 0 | const | 46.990296 |
| 1 | ingreso | 4.132227 |
| 5 | gasto_electrico_base | 4.119082 |
| 2 | tamano_hogar | 1.007616 |
| 4 | aislamiento | 1.004502 |
| 6 | temperatura | 1.002103 |
| 3 | edad_vivienda | 1.000809 |
Guía rápida: VIF < 5 usualmente aceptable; 5-10 zona de alerta; >= 10 problema serio.Cómo leer este resultado: VIF de la exploración
ingreso(4.13) ygasto_electrico_base(4.12) tienen un VIF unas cuatro veces mayor que el resto de predictores (todos entre 1.00 y 1.01): la varianza de sus coeficientes se multiplica por cuatro y su error estándar por \(\sqrt{4.1} \approx 2\).- Con un solo par correlacionado, el VIF se deduce de la correlación: \(1/(1-0.869^2) \approx 4.1\). Aunque 0.87 es una correlación muy alta, el VIF queda por debajo del umbral orientativo de 5: los umbrales son convenciones, y la interpretación simultánea de ambos coeficientes igual debe hacerse con cuidado.
- El VIF de la constante (46.99) no se interpreta: la columna de unos no es un predictor.
- Conclusión metodológica: correlación alta sugiere, VIF confirma el nivel del problema.
# Etapa 6: validar no linealidad (lineal vs polinomial en temperatura)
X_lin = df_demo[["temperatura"]]
y_lin = df_demo["consumo_kwh"]

m_lin = LinearRegression().fit(X_lin, y_lin)
r2_lin = m_lin.score(X_lin, y_lin)

poly = PolynomialFeatures(degree=2, include_bias=False)
X_poly = poly.fit_transform(X_lin)
m_poly = LinearRegression().fit(X_poly, y_lin)
r2_poly = m_poly.score(X_poly, y_lin)

print(f"R2 lineal (temperatura -> consumo): {r2_lin:.3f}")
print(f"R2 polinomial grado 2:             {r2_poly:.3f}")
print("Si el polinomial mejora de forma clara, hay evidencia de curvatura.")

# Misma comparación, controlando por los demás predictores y sin los 6 atípicos inyectados en la Etapa 1
datos_ctrl = df_demo.drop(index=idx_out).copy()
datos_ctrl["urbano"] = (datos_ctrl["segmento"] == "urbano").astype(int)
datos_ctrl["temperatura2"] = datos_ctrl["temperatura"] ** 2
base_ctrl = ["ingreso", "tamano_hogar", "edad_vivienda", "aislamiento", "gasto_electrico_base", "urbano", "temperatura"]
m_base = sm.OLS(datos_ctrl["consumo_kwh"], sm.add_constant(datos_ctrl[base_ctrl])).fit()
m_curva = sm.OLS(datos_ctrl["consumo_kwh"], sm.add_constant(datos_ctrl[base_ctrl + ["temperatura2"]])).fit()
print(f"R2 controlado, lineal en temperatura: {m_base.rsquared:.3f}")
print(f"R2 controlado, con temperatura^2:     {m_curva.rsquared:.3f}")
print(f"p-valor del término cuadrático:        {m_curva.pvalues['temperatura2']:.3f}")
R2 lineal (temperatura -> consumo): 0.014
R2 polinomial grado 2: 0.014
Si el polinomial mejora de forma clara, hay evidencia de curvatura.
R2 controlado, lineal en temperatura: 0.771
R2 controlado, con temperatura^2: 0.775
p-valor del término cuadrático: 0.008Cómo leer este resultado: no linealidad
- Comparación marginal (solo
temperatura): \(R^2\) lineal = 0.014 y polinomial de grado 2 = 0.014. No hay mejora apreciable. - Sin embargo, la curvatura existe por construcción: el consumo se generó con \(3.5\,|T - 24|\), un efecto en V. La comparación marginal no la detecta porque el efecto de la temperatura es pequeño frente al resto de la variación (los demás predictores, el segmento y los 6 atípicos inyectados), y un modelo con una sola variable deja todo eso en el error.
- Al controlar por los demás predictores y excluir los atípicos inyectados, el término cuadrático sí aparece: el \(R^2\) pasa de 0.771 a 0.775 y su p-valor es 0.008.
- Conclusión: no asumas no linealidad por intuición, pero tampoco la descartes con una comparación marginal; la evidencia se busca con el resto de variables en el modelo.
# Etapa 7: validar heterogeneidad por segmento
resumen_segmento = df_demo.groupby("segmento")["consumo_kwh"].agg(["mean", "median", "std", "count"])
print("Resumen por segmento:")
display(resumen_segmento)

plt.figure(figsize=(7, 4))
sns.boxplot(data=df_demo, x="segmento", y="consumo_kwh")
plt.title("Consumo por segmento")
plt.show()

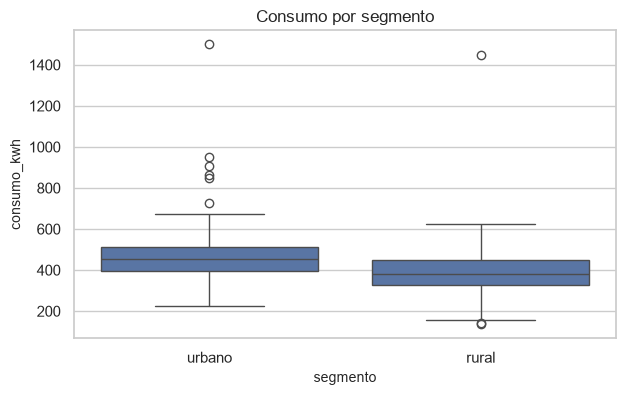
print("Si las medias/medianas difieren de forma consistente, hay heterogeneidad estructural.")
Resumen por segmento:| mean | median | std | count | |
|---|---|---|---|---|
| segmento | ||||
| rural | 390.330223 | 382.678209 | 124.188189 | 153 |
| urbano | 462.614223 | 455.502952 | 117.755586 | 297 |
Si las medias/medianas difieren de forma consistente, hay heterogeneidad estructural.Cómo leer este resultado: diferencias por segmento
- El consumo medio urbano (462.6 kWh) supera al rural (390.3 kWh) en 72.3 kWh, y las medianas cuentan lo mismo (455.5 frente a 382.7). Con desviaciones estándar cercanas a 120 kWh en ambos grupos, la diferencia es clara, pero las distribuciones se superponen mucho, como muestra el diagrama de caja.
- Lo que muestra esta tabla es una diferencia de nivel: el segmento debe entrar al modelo como variable indicadora. Eso no prueba que los predictores actúen distinto en cada grupo; para afirmar heterogeneidad en ese sentido (pendientes distintas) hay que probar interacciones. En estos datos el segmento solo desplaza el nivel: se generó con +55 kWh para urbano y −20 kWh para rural.
- Lección: promediar sin segmentar puede ocultar diferencias importantes; distingue un cambio de nivel de un cambio en la forma de la relación.
# Etapa 8: detectar outliers con IQR y revisar casos
q1 = df_demo["consumo_kwh"].quantile(0.25)
q3 = df_demo["consumo_kwh"].quantile(0.75)
iqr = q3 - q1
lim_inf = q1 - 1.5 * iqr
lim_sup = q3 + 1.5 * iqr

mask_out = (df_demo["consumo_kwh"] < lim_inf) | (df_demo["consumo_kwh"] > lim_sup)
n_out = int(mask_out.sum())
pct_out = 100 * n_out / len(df_demo)

print(f"Límites IQR: [{lim_inf:.1f}, {lim_sup:.1f}] kWh")
print("Índices de los atípicos inyectados en la Etapa 1:", sorted(idx_out.tolist()))
print(f"Atípicos detectados por IQR: {n_out} ({pct_out:.2f}%)")
print("Primeros casos para inspección contextual:")
display(df_demo.loc[mask_out, ["segmento", "ingreso", "temperatura", "consumo_kwh"]].head(10))

plt.figure(figsize=(8, 4))
sns.scatterplot(
    data=df_demo,
    x=df_demo.index,
    y="consumo_kwh",
    hue=mask_out,
    palette={False: "steelblue", True: "crimson"},
    alpha=0.7
)
plt.title("Outliers IQR resaltados")
plt.xlabel("Índice de observación")
plt.legend(title="Outlier")
plt.show()
Límites IQR: [173.1, 682.0] kWh
Índices de los atípicos inyectados en la Etapa 1: [18, 36, 37, 43, 96, 444]
Atípicos detectados por IQR: 10 (2.22%)
Primeros casos para inspección contextual:| segmento | ingreso | temperatura | consumo_kwh | |
|---|---|---|---|---|
| 18 | urbano | 2538.787656 | 21.959488 | 909.347068 |
| 36 | urbano | 2634.936971 | 18.557640 | 847.581914 |
| 37 | urbano | 878.806315 | 17.065044 | 948.831839 |
| 43 | rural | 3251.097441 | 24.611346 | 1445.817729 |
| 96 | urbano | 1553.545359 | 16.699184 | 863.513000 |
| 134 | urbano | 4299.768079 | 30.301488 | 726.822478 |
| 180 | rural | 1570.405241 | 22.073216 | 135.410652 |
| 263 | rural | 1816.872298 | 18.462113 | 158.588262 |
| 323 | rural | 1752.390752 | 25.020978 | 140.435608 |
| 444 | urbano | 2564.273788 | 15.801986 | 1499.488896 |
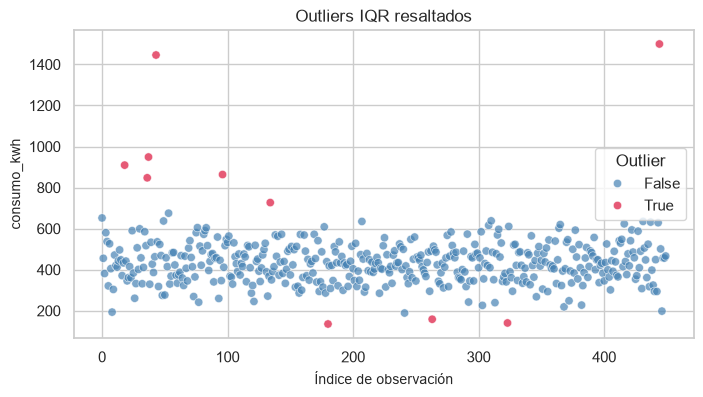
Cómo leer este resultado: atípicos con IQR
- El criterio IQR marca 10 observaciones (2.22 %), fuera del intervalo [173.1, 682.0] kWh.
- De esas 10, seis son justo los atípicos técnicos inyectados en la Etapa 1 (índices 18, 36, 37, 43, 96 y 444, con consumos entre 848 y 1499 kWh). Las otras cuatro son casos reales: un consumo alto (índice 134, 727 kWh) y tres consumos bajos de hogares rurales (índices 180, 263 y 323, entre 135 y 159 kWh).
- Conclusión práctica: la regla IQR detecta valores extremos, no errores. Aquí encontró todos los errores inyectados, pero también cuatro hogares legítimos; eliminar las 10 filas a ciegas borraría información válida.
- Decisión recomendada: documentar criterio de tratamiento de outliers y luego comparar métricas con y sin esos casos para medir impacto.
5.11 Cierre de la exploración
La exploración dejó cuatro hallazgos que se llevan al modelado: un par de predictores redundantes (ingreso y gasto_electrico_base, VIF ≈ 4.1), una curvatura en la temperatura que solo aparece al controlar por el resto, una diferencia de nivel entre segmentos y unos pocos atípicos, de los cuales no todos son errores. Si tienes poco tiempo, las Etapas 3, 4 y 5 (correlación con la respuesta, correlación entre predictores y VIF) son las que más informan sobre la redundancia.
6. Supuestos clave en regresión múltiple
La regresión múltiple no se evalúa solo por el \(R^2\). Para interpretar coeficientes, p-valores e intervalos de confianza con rigor, hay supuestos que deben revisarse.
6.1 Linealidad
La relación esperada entre cada predictor y la respuesta (controlando los demás) debe ser aproximadamente lineal.
Si falla: aparecen patrones sistemáticos en residuos y sesgo en coeficientes.
6.2 Independencia de errores
Los residuos deben ser aproximadamente independientes entre observaciones.
Si falla: errores estándar mal estimados, pruebas t/F menos confiables.
6.3 Homoscedasticidad
La varianza de residuos debe ser parecida a lo largo del rango de predicción.
Si falla: puede no afectar tanto la predicción media, pero sí compromete inferencia (p-valores e intervalos).
6.4 Normalidad aproximada de residuos
No es el supuesto más crítico para predecir, pero sí para inferencia clásica, sobre todo en muestras pequeñas.
Si falla con fuerza: intervalos y contrastes pueden ser inestables.
6.5 Baja multicolinealidad
Los predictores no deben ser casi copias entre sí.
Si falla: coeficientes inestables, signos que cambian entre muestras y mayor incertidumbre en cada beta.
En rigor, OLS solo exige que no haya colinealidad perfecta (ningún predictor es combinación lineal exacta de otros); la colinealidad alta no sesga los coeficientes, pero sí infla su varianza.
6.6 Especificación del modelo
El modelo debe incluir variables relevantes y forma funcional razonable (por ejemplo, incluir no linealidad si existe).
Si falla: sesgo por variable omitida o mala forma del modelo.
Idea clave: un modelo puede tener un buen \(R^2\) y aun así tener problemas de interpretación si no cumple supuestos básicos.
A partir de aquí volvemos al dataset de energía residencial de la sección 3 (df, con temperatura, ocupantes, area_m2, aislamiento y electrodomesticos) — el dataset de las Etapas 1-8 (df_demo) fue solo para ilustrar los fenómenos de exploración multivariada, y ya cumplió su función. Ahora construyes el modelo completo con inferencia formal (statsmodels), VIF, evaluación predictiva y diagnóstico de residuos.
# Separación train/test y ajuste con statsmodels para inferencia
X = df.drop(columns=["consumo_kwh"])
y = df["consumo_kwh"]

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=SEMILLA
)

X_train_sm = sm.add_constant(X_train)
modelo_ols = sm.OLS(y_train, X_train_sm).fit()
print(modelo_ols.summary())
OLS Regression Results
==============================================================================
Dep. Variable: consumo_kwh R-squared: 0.823
Model: OLS Adj. R-squared: 0.821
Method: Least Squares F-statistic: 367.6
Date: Sun, 27 Sep 2026 Prob (F-statistic): 6.43e-146
Time: 20:56:01 Log-Likelihood: -1875.2
No. Observations: 400 AIC: 3762.
Df Residuals: 394 BIC: 3786.
Df Model: 5
Covariance Type: nonrobust
=====================================================================================
coef std err t P>|t| [0.025 0.975]
-------------------------------------------------------------------------------------
const 161.9641 9.716 16.670 0.000 142.862 181.066
temperatura -1.8394 0.325 -5.658 0.000 -2.479 -1.200
ocupantes 18.9569 0.808 23.457 0.000 17.368 20.546
area_m2 1.8394 0.062 29.560 0.000 1.717 1.962
aislamiento -58.7356 5.689 -10.325 0.000 -69.919 -47.552
electrodomesticos 8.9760 0.511 17.566 0.000 7.971 9.981
==============================================================================
Omnibus: 1.336 Durbin-Watson: 1.889
Prob(Omnibus): 0.513 Jarque-Bera (JB): 1.250
Skew: -0.137 Prob(JB): 0.535
Kurtosis: 3.015 Cond. No. 686.
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.Cómo leer este resultado: la salida OLS
1) Calidad global del modelo - R-squared = 0.823: el modelo explica el 82.3 % de la variabilidad de consumo_kwh en el entrenamiento. - Adj. R-squared = 0.821: ajuste alto y muy cercano al \(R^2\), sin señal fuerte de sobreparametrización. - F-statistic = 367.6 y Prob(F) = 6.43e-146: en conjunto, los predictores aportan explicación estadísticamente significativa.
2) Tamaño muestral y grados de libertad - No. Observations = 400: se ajustó con 400 observaciones. - Df Model = 5: hay cinco predictores en el modelo. - Df Residuals = 394: consistente con 400 - 5 - 1 (intercepto).
3) Coeficientes (interpretación ceteris paribus) - const = 161.9641: consumo esperado cuando los predictores valen 0 (interpretación contextual limitada). - temperatura = -1.8394: al aumentar 1 °C la temperatura, el consumo disminuye en promedio ~1.84 kWh, manteniendo lo demás constante. Ojo: es la pendiente de una recta ajustada a una relación que no es lineal. Los datos se generaron con \(2.7\,|T - 22|\) (efecto en V con mínimo en 22 °C) y temperaturas de media 20 °C, así que la mayoría cae en el tramo descendente de la V. Un coeficiente puede ser muy significativo y, aun así, describir mal la forma del efecto. - ocupantes = 18.9569: cada ocupante adicional aumenta el consumo en ~18.96 kWh. - area_m2 = 1.8394: cada m² adicional aumenta el consumo en ~1.84 kWh. - aislamiento = -58.7356: pasar del índice de aislamiento 0 al 1 reduce el consumo en ~58.7 kWh (en los datos, el índice va de 0.2 a 1.0). - electrodomesticos = 8.9760: cada equipo adicional aumenta el consumo en ~8.98 kWh. - Como los datos son simulados, puedes compararlos con los valores verdaderos de la celda que los generó: 1.8 (área), 18 (ocupantes), 9 (electrodomésticos) y −55 (aislamiento). Los cuatro intervalos de confianza al 95 % los contienen. El intercepto (162 frente a 120) se aleja más porque absorbe la parte del efecto de la temperatura que la recta no captura.
4) Significancia individual de predictores - Todos los p-valores reportados son ~0.000 (prácticamente < 0.001). - Los intervalos de confianza al 95% no cruzan 0 en ningún coeficiente. - Lectura: cada predictor muestra evidencia de aporte estadístico en presencia de los demás.
5) Diagnósticos de residuos y supuestos - Durbin–Watson = 1.889: el estadístico de Durbin–Watson mide la correlación entre residuos consecutivos (ideal ≈ 2). Solo informa cuando las filas tienen un orden natural, como el tiempo; aquí son hogares en orden arbitrario, así que un valor cercano a 2 es lo esperable y no aporta evidencia sobre independencia. - Omnibus p = 0.513 y JB p = 0.535: las pruebas Ómnibus y de Jarque–Bera contrastan la normalidad de los residuos a partir de su asimetría y curtosis; con p-valores tan altos no hay evidencia para rechazarla. - Skew = -0.137 y Kurtosis = 3.015: forma residual bastante cercana a normalidad.
6) Complejidad y comparación de modelos - AIC = 3762 y BIC = 3786: útiles para comparar con modelos alternativos; menor valor indica mejor equilibrio ajuste-complejidad.
7) Señal de colinealidad / condición numérica - Cond. No. = 686: el número de condición mide qué tan cerca está la matriz de diseño de ser singular. Aquí refleja sobre todo las escalas distintas de los predictores (el área ronda 85 m² y el aislamiento va de 0.2 a 1.0), no colinealidad: la sección 7 confirma VIF ≈ 1 en todos los predictores. statsmodels solo emite advertencia por encima de 1000.
8) Nota de inferencia - Covariance Type: nonrobust indica que los errores estándar se calculan suponiendo errores homoscedásticos y no correlacionados. - Si sospechas heteroscedasticidad, conviene contrastar con errores estándar robustos (por ejemplo, fit(cov_type="HC3")).
En síntesis El modelo luce fuerte en ajuste global y consistente en signos/efectos. La lectura profesional no termina en \(R^2\): siempre se cierra con diagnóstico de supuestos, colinealidad y estabilidad inferencial.
7. Multicolinealidad y VIF
La multicolinealidad es el solapamiento de información entre predictores: varias variables explicativas aportan casi la misma señal dentro del modelo. El VIF (variance inflation factor, factor de inflación de la varianza) es el indicador que cuantifica ese problema, midiendo cuánto se infla la varianza de cada coeficiente por depender linealmente de los demás predictores. Sí, está relacionado con la correlación: correlaciones altas entre predictores suelen ser una alerta inicial, pero el VIF es más completo porque evalúa la colinealidad conjunta (no solo pares aislados).
Diferencia clave: la correlación describe asociación lineal entre dos variables a la vez (visión bivariada), mientras que el VIF evalúa para cada predictor cuánta redundancia tiene respecto al conjunto de todos los demás predictores (visión multivariada). Por eso, puede haber casos con correlaciones por pares moderadas pero VIF elevado, si la combinación de varias variables juntas explica casi la misma información. En una frase: la correlación mira relaciones por pares; el VIF mide la colinealidad de cada variable frente al bloque completo de predictores.
7.1 Por qué ocurre
- Variables que miden casi el mismo fenómeno (ejemplo:
ingresoygasto_electrico_baseen la Etapa 4). - Variables derivadas entre sí.
- Escenarios donde varias variables crecen/disminuyen juntas por diseño del proceso.
7.2 Qué problema genera
- Coeficientes inestables: cambian mucho entre muestras parecidas.
- Errores estándar inflados: baja precisión en cada beta.
- p-valores menos informativos para decidir qué variable “importa”.
- Signos contraintuitivos en algunos coeficientes.
7.3 Qué NO hace la multicolinealidad
- No significa automáticamente que el modelo prediga mal.
- No implica que haya error en los datos.
- No invalida por completo el ajuste global (\(R^2\) puede seguir alto).
7.4 VIF como herramienta práctica
Con la fórmula \(VIF_j = 1/(1-R_j^2)\), donde \(R_j^2\) es el \(R^2\) de regresar el predictor \(j\) sobre los demás, un VIF de 5 equivale a \(R_j^2 = 0.8\) y uno de 10 a \(R_j^2 = 0.9\).
Regla orientativa (no absoluta): - VIF < 5: zona normalmente aceptable. - \(5 \leq VIF < 10\): zona de alerta, revisar con criterio. - \(VIF \geq 10\): riesgo alto de inestabilidad interpretativa.
7.5 Cómo decidir en un proyecto
- Mirar pares de correlación altos entre predictores.
- Confirmar con VIF.
- Si hay problema:
- quitar o combinar variables redundantes,
- usar regularización (Ridge/Lasso),
- priorizar interpretabilidad según objetivo del estudio.
Idea clave: en análisis explicativo, la multicolinealidad es sobre todo un problema de interpretación de coeficientes, no solo de ajuste.
# Cálculo e interpretación práctica de VIF
X_vif = sm.add_constant(X_train).copy()

vif_df = pd.DataFrame({
    "variable": X_vif.columns,
    "VIF": [variance_inflation_factor(X_vif.values, i) for i in range(X_vif.shape[1])]
})

# El intercepto no se interpreta para colinealidad, se excluye en el semaforo.
vif_eval = vif_df[vif_df["variable"] != "const"].copy()

def clasificar_vif(v):
    if v < 5:
        return "OK (<5)"
    if v < 10:
        return "Alerta (5-10)"
    return "Alto (>=10)"

vif_eval["lectura"] = vif_eval["VIF"].apply(clasificar_vif)
vif_eval = vif_eval.sort_values("VIF", ascending=False).reset_index(drop=True)

display(vif_eval)

n_alerta = (vif_eval["VIF"] >= 5).sum()
n_alto = (vif_eval["VIF"] >= 10).sum()

vif_max = float(vif_eval["VIF"].max())
var_max = str(vif_eval.loc[vif_eval["VIF"].idxmax(), "variable"])

print(f"VIF máximo: {vif_max:.3f} ({var_max})")
print(f"Variables en alerta (VIF >= 5): {n_alerta}")
print(f"Variables en riesgo alto (VIF >= 10): {n_alto}")| variable | VIF | lectura | |
|---|---|---|---|
| 0 | ocupantes | 1.014488 | OK (<5) |
| 1 | temperatura | 1.010758 | OK (<5) |
| 2 | aislamiento | 1.007479 | OK (<5) |
| 3 | electrodomesticos | 1.005178 | OK (<5) |
| 4 | area_m2 | 1.003686 | OK (<5) |
VIF máximo: 1.014 (ocupantes)
Variables en alerta (VIF >= 5): 0
Variables en riesgo alto (VIF >= 10): 0
Cómo leer este resultado: multicolinealidad y VIF
Cómo se calcula e interpreta el VIF en este notebook
- Se toma la matriz de predictores de entrenamiento (
X_train) y se agrega constante para el ajuste auxiliar. - Para cada predictor \(X_j\), se estima una regresión auxiliar donde \(X_j\) es respuesta y los demás predictores explican su variación.
- De esa regresión se obtiene \(R_j^2\) y se calcula: \(VIF_j = \frac{1}{1-R_j^2}\).
- Se repite para todos los predictores y se clasifican en:
OK (<5)Alerta (5-10)Alto (>=10)
Lectura de resultados obtenidos
- VIF máximo observado: 1.014 (variable
ocupantes). Contrasta con la Etapa 5, dondeingresoygasto_electrico_basellegaban a 4.13: en el dataset de energía los predictores se simularon de forma independiente. - Variables en alerta (\(VIF \geq 5\)): 0.
- Variables en riesgo alto (\(VIF \geq 10\)): 0.
Conclusión metodológica
No hay evidencia relevante de multicolinealidad en este modelo. Por tanto, la interpretación de coeficientes es estable desde el punto de vista de colinealidad. Se puede continuar con el conjunto actual de predictores, manteniendo monitoreo de VIF si se agregan nuevas variables o interacciones.
8. Evaluación predictiva
La evaluación predictiva responde dos preguntas: 1. ¿Qué tan grande es el error en unidades reales? 2. ¿Qué tan estable es el desempeño cuando cambia la muestra?
Primero definimos el error por observación (residuo de predicción):
\[e_i = y_i - \hat{y}_i\]
Con esos residuos, las métricas principales son:
MAE (Mean Absolute Error): \[\text{MAE} = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i|\]
MSE (Mean Squared Error): \[\text{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2\]
RMSE (Root Mean Squared Error): \[\text{RMSE} = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2} = \sqrt{\text{MSE}}\]
\(R^2\) (coeficiente de determinación): \[R^2 = 1 - \frac{\sum_{i=1}^{n}(y_i - \hat{y}_i)^2}{\sum_{i=1}^{n}(y_i - \bar{y})^2}\]
Interpretación conceptual: - MAE: error promedio en unidades originales; fácil de explicar a negocio/política pública. - MSE: error cuadrático promedio; amplifica errores grandes y es muy útil para comparar modelos durante optimización matemática. - RMSE: raíz del MSE; conserva la sensibilidad a errores grandes pero vuelve a la escala original de la variable objetivo. - \(R^2\): proporción de variabilidad explicada; útil para comparar ajuste global.
La validación cruzada complementa la evaluación en un único conjunto de prueba: en lugar de depender de una sola partición, mide robustez en varios pliegues.
Idea clave: no conviene decidir con una sola métrica. Un modelo puede tener un buen \(R^2\) y aun así un error absoluto demasiado alto para el contexto de decisión.
Guía rápida de lectura de métricas
| Métrica | Qué penaliza más | Cuándo priorizarla | Si el valor es X, tener cuidado porque probablemente significa… | Qué se debería verificar / hacer / comparar |
|---|---|---|---|---|
| MAE | Penaliza todos los errores de forma lineal | Cuando quieres una medida robusta y fácil de comunicar en unidades reales | MAE alto respecto a la escala de y: el error promedio ya es grande para la decisión práctica. MAE bajo: error promedio manejable. | Verificar MAE contra una tolerancia de negocio/operación (ej.: porcentaje del valor medio de y) y comparar con un modelo de referencia que predice la media. |
| MSE | Penaliza cuadráticamente, castiga fuerte los errores grandes | Cuando quieres sensibilidad alta a atípicos y función de costo para optimización | MSE muy alto: existen errores grandes que dominan el desempeño. MSE bajo: menos impacto de errores extremos. | Revisar observaciones con error grande, detectar atípicos y comparar antes/después de limpieza o transformaciones. |
| RMSE | Penaliza más fuerte los errores grandes (vía cuadrado) y vuelve a escala original | Cuando los errores extremos son costosos y necesitas interpretación en unidades reales | RMSE mucho mayor que MAE: hay cola de errores grandes y conviene revisar atípicos o no linealidad. RMSE cercano a MAE: error más homogéneo. | Comparar RMSE vs MAE y revisar residuos: si RMSE >> MAE, verificar no linealidad, segmentación o variables omitidas. |
| \(R^2\) | No mide error absoluto; mide varianza explicada | Cuando comparas ajuste global entre modelos sobre el mismo problema | \(R^2\) cercano a 1: buena explicación global. \(R^2\) cerca de 0: el modelo mejora poco frente a predecir la media. \(R^2\) negativo: peor que la referencia de la media. | Comparar el \(R^2\) en entrenamiento, prueba y CV, y con modelos alternativos; confirmar que la mejora sea estable y no sobreajuste. |
Regla práctica: interpreta MAE/RMSE siempre en la unidad real de la variable objetivo y valida la estabilidad con CV, no solo con una partición de prueba.
# Modelo base con sklearn + lectura de estabilidad
lr = LinearRegression()
lr.fit(X_train, y_train)
pred_test = lr.predict(X_test)

mae = mean_absolute_error(y_test, pred_test)
rmse = np.sqrt(mean_squared_error(y_test, pred_test))
r2 = r2_score(y_test, pred_test)

# CV solo sobre el entrenamiento: el conjunto de prueba queda reservado para el reporte final
cv_r2 = cross_val_score(lr, X_train, y_train, cv=5, scoring="r2")
cv_r2_mean = float(cv_r2.mean())
cv_r2_std = float(cv_r2.std())

print(f"MAE : {mae:.2f}")
print(f"RMSE: {rmse:.2f}")
print(f"R2 test: {r2:.3f}")
print(f"R2 CV (media): {cv_r2_mean:.3f}")
print(f"R2 CV (desv):  {cv_r2_std:.3f}")

# Brecha test vs CV como chequeo rapido de estabilidad
gap_test_cv = r2 - cv_r2_mean
print(f"Brecha R2 test - R2 CV media: {gap_test_cv:+.3f}")
MAE : 22.40
RMSE: 27.66
R2 test: 0.820
R2 CV (media): 0.817
R2 CV (desv): 0.032
Brecha R2 test - R2 CV media: +0.003Cómo leer este resultado: evaluación predictiva
- En esta corrida: MAE = 22.40 kWh y RMSE = 27.66 kWh (error en la escala real de
consumo_kwh); \(R^2\) de prueba = 0.820: el modelo explica el 82 % de la variabilidad en datos que no vio. - El RMSE es 1.23 veces el MAE, cerca del cociente \(\sqrt{\pi/2} \approx 1.25\) que se espera con errores normales: no hay una cola de errores grandes. Y el RMSE está cerca de la desviación estándar del ruido simulado (25 kWh), que es el piso del error de predicción.
- \(R^2\) de CV (media de 5 pliegues sobre el entrenamiento) = 0.817, con desviación de 0.032 entre pliegues. La brecha prueba − CV es de +0.003, menor que esa desviación.
- Brecha pequeña: el desempeño es estable entre particiones y el resultado en prueba no depende de una partición afortunada.
9. Cuándo usar regularización
Definición breve (antes del detalle): Regularizar significa entrenar el modelo minimizando no solo el error de ajuste, sino también una penalización por coeficientes grandes. En la práctica, es una forma de controlar complejidad para reducir sobreajuste y mejorar generalización.
En palabras simples, así funciona el proceso matemático:
Qué hace OLS (sin regularización) - Solo intenta minimizar el error de predicción. - Si hay ruido o variables muy parecidas, puede asignar coeficientes grandes e inestables para “perseguir” detalles de la muestra.
Qué agrega la regularización - Además de minimizar error, agrega un “costo” por coeficientes grandes. - Eso obliga al modelo a preferir soluciones más sobrias.
Ridge (penalización \(L_2\))
Idea en palabras: encoge todos los coeficientes, pero no los lleva exactamente a cero (solo se acercan a cero a medida que crece la penalización).
Qué hace en la práctica: 1. Recorta suavemente magnitudes grandes. 2. Reparte mejor el peso cuando hay variables correlacionadas. 3. Estabiliza coeficientes entre distintas muestras. 4. No filtra variables de forma dura: normalmente todas quedan, pero con menos peso.
En una frase: Ridge reduce el peso de todas las variables, pero no elimina ninguna.
Lasso (penalización \(L_1\))
Idea en palabras: encoge y además puede anular algunos coeficientes (dejarlos en cero).
Qué hace en la práctica: 1. Recorta coeficientes. 2. Filtra variables: algunas quedan exactamente en 0. 3. Simplifica el modelo (selección automática de predictores). 4. Puede ser menos estable si hay muchas variables muy correlacionadas entre sí, porque “elige” algunas y descarta otras.
En una frase: Lasso reduce el peso de las variables y, además, elimina algunas.
Rol de \(\alpha\)
- \(\alpha\) pequeño: casi como OLS.
- \(\alpha\) grande: más recorte.
- En Ridge: más contracción global.
- En Lasso: más coeficientes llevados a cero.
- El valor de \(\alpha\) se elige promediando el desempeño por validación cruzada.
Un requisito práctico: Ridge y Lasso exigen estandarizar los predictores, porque la penalización suma magnitudes de coeficientes y esas magnitudes dependen de las unidades. Por eso el código siguiente usa StandardScaler dentro de un Pipeline.
Mensaje final para la sección: regularizar no busca maquillar resultados, busca reducir sensibilidad al ruido y mejorar generalización fuera de muestra. Aquí solo la usamos para comparar; el siguiente artículo de la serie desarrolla Ridge y Lasso a fondo, con sus fórmulas y la elección de \(\alpha\) por validación cruzada.
# Comparación: OLS vs Ridge vs Lasso con validación cruzada
modelos = {
    "OLS": LinearRegression(),
    "Ridge(alpha=1.0)": Pipeline([("scaler", StandardScaler()), ("m", Ridge(alpha=1.0))]),
    "Lasso(alpha=0.05)": Pipeline([("scaler", StandardScaler()), ("m", Lasso(alpha=0.05, max_iter=10000))]),
}

res_reg = []
for nombre, modelo in modelos.items():
    scores = cross_val_score(modelo, X_train, y_train, cv=5, scoring="r2")  # CV solo sobre entrenamiento
    res_reg.append({
        "modelo": nombre,
        "r2_cv_mean": float(scores.mean()),
        "r2_cv_std": float(scores.std())
    })

res_reg_df = pd.DataFrame(res_reg).sort_values("r2_cv_mean", ascending=False).reset_index(drop=True)
display(res_reg_df)

mejor_modelo = str(res_reg_df.loc[0, "modelo"])
mejor_r2 = float(res_reg_df.loc[0, "r2_cv_mean"])
print(f"Mejor modelo por R2 CV medio: {mejor_modelo} ({mejor_r2:.3f})")| modelo | r2_cv_mean | r2_cv_std | |
|---|---|---|---|
| 0 | Ridge(alpha=1.0) | 0.817280 | 0.032450 |
| 1 | Lasso(alpha=0.05) | 0.817274 | 0.032368 |
| 2 | OLS | 0.817271 | 0.032268 |
Mejor modelo por R2 CV medio: Ridge(alpha=1.0) (0.817)Cómo leer este resultado: regularización
- Comparación por validación cruzada sobre el entrenamiento (\(R^2\) CV medio): Ridge(alpha=1.0) = 0.81728, Lasso(alpha=0.05) = 0.81727, OLS = 0.81727 — prácticamente empatados.
- Entre el primero y el último hay 0.000009, varios órdenes de magnitud menos que la desviación entre pliegues (≈ 0.032): no hay evidencia de que regularizar aporte una mejora real en este dataset. Además, los valores de \(\alpha\) están fijos, no elegidos por CV: el empate muestra que estas penalizaciones no cambian nada, no que ninguna pueda servir.
- Con VIF máximo de 1.014 (ver sección 7), no hay multicolinealidad que justifique Ridge, ni un exceso de variables que justifique la selección de Lasso: OLS sin regularizar es una elección razonable aquí.
10. Diagnóstico de residuos
El residuo es la parte que el modelo no logra explicar:
\[e_i = y_i - \hat{y}_i\]
Mirar residuos permite detectar problemas que no se ven en una sola métrica de desempeño. Un modelo puede tener un buen \(R^2\) y, aun así, mostrar fallas estructurales en residuos.
Qué se debe revisar (versión simple)
Que los residuos estén alrededor de 0 Si su promedio está cerca de 0, el modelo no tiene un sesgo sistemático fuerte.
Que no haya patrón en residuo vs predicción Debe verse una nube desordenada. Si aparece curva, pendiente o forma clara, el modelo está dejando estructura sin explicar. Conviene mirar también el residuo frente a cada predictor: una curvatura en un solo predictor puede diluirse y no verse contra la predicción.
Que la dispersión sea parecida en todo el rango Si al aumentar la predicción los residuos se abren como embudo, hay varianza no constante.
Que no haya demasiados casos extremos Muchos residuos muy grandes pueden distorsionar resultados y conclusiones.
Que la forma general sea razonable Con un histograma y un gráfico Q-Q (cuantiles de los residuos frente a los de una normal: si los residuos son normales, los puntos caen sobre la diagonal) revisamos si se parecen de forma aproximada a una distribución normal.
Un cuidado importante: entrenamiento vs. prueba
Dos de los chequeos numéricos más comunes —la media de los residuos y la correlación entre predicción y residuo— dan exactamente 0 por construcción cuando se calculan sobre los mismos datos con los que se ajustó un modelo OLS con intercepto. No es que el modelo sea bueno: es una propiedad algebraica de mínimos cuadrados (las ecuaciones normales obligan a que los residuos sean ortogonales a las columnas de \(X\), incluida la de unos). Por eso, esos dos chequeos solo aportan información real si se calculan sobre datos de prueba, que el modelo no vio al ajustarse.
Si aparece una alerta, qué hacer
- Probar transformaciones (por ejemplo log).
- Agregar términos no lineales o interacciones.
- Revisar outliers y calidad de datos.
- Considerar segmentar el análisis o usar errores robustos.
Idea clave: el diagnóstico de residuos conecta ajuste predictivo con validez estadística de la interpretación.
# Diagnóstico de residuos: gráfico + resumen numérico
from statsmodels.stats.stattools import durbin_watson

pred_train = modelo_ols.predict(X_train_sm)
resid = y_train - pred_train

# Prediccion y residuos sobre el conjunto de PRUEBA: el modelo no los vio al ajustarse,
# por eso son los unicos que permiten un chequeo no tautologico de media y correlacion (ver nota arriba).
X_test_sm = sm.add_constant(X_test)
pred_test = modelo_ols.predict(X_test_sm)
resid_test = y_test - pred_test

fig, axes = plt.subplots(1, 3, figsize=(15, 4))

# 1) Residuo vs predicción
axes[0].scatter(pred_train, resid, alpha=0.6)
axes[0].axhline(0, color="red", linestyle="--")
axes[0].set_xlabel("Predicción")
axes[0].set_ylabel("Residuo")
axes[0].set_title("Residuo vs predicción")

# 2) Histograma de residuos
sns.histplot(resid, kde=True, ax=axes[1])
axes[1].set_title("Distribución de residuos")
axes[1].set_xlabel("Residuo")

# 3) Q-Q plot
sm.qqplot(resid, line="45", ax=axes[2], fit=True)
axes[2].set_title("Q-Q plot de residuos")

plt.tight_layout()
plt.show()

# Resumen numerico rapido (sobre train, para escala/forma) mas el chequeo no tautologico (sobre test)
resid_mean = float(resid.mean())
resid_std = float(resid.std())
corr_pred_resid = float(np.corrcoef(pred_train, resid)[0, 1])
pct_extremos = float((np.abs(resid) > 2 * resid_std).mean() * 100)
dw = float(durbin_watson(resid))

resid_test_mean = float(resid_test.mean())
corr_pred_resid_test = float(np.corrcoef(pred_test, resid_test)[0, 1])

print(f"Media de residuos (entrenamiento, ~0 por construcción, no es diagnóstico): {resid_mean:.3f}")
print(f"Media de residuos (prueba, chequeo real):                                 {resid_test_mean:.3f}")
print(f"Desv. estándar de residuos (entrenamiento): {resid_std:.3f}")
print(f"Correlación predicción-residuo (entrenamiento, ~0 por construcción, no es diagnóstico): {corr_pred_resid:.3f}")
print(f"Correlación predicción-residuo (prueba, chequeo real):                                 {corr_pred_resid_test:.3f}")
print(f"% residuos extremos (|resid| > 2*std): {pct_extremos:.2f}%")
print(f"Durbin-Watson: {dw:.3f}")

# Lectura automatica orientativa (usa el chequeo de test, el unico no tautologico)
if abs(corr_pred_resid_test) > 0.2:
    print("Alerta: hay dependencia notable entre predicción y residuo en prueba; revisar especificación.")
else:
    print("OK: no hay dependencia lineal fuerte entre predicción y residuo en prueba.")

if pct_extremos > 8:
    print("Alerta: porcentaje alto de residuos extremos; revisar atípicos y no linealidad.")
else:
    print("OK: porcentaje de residuos extremos en rango razonable.")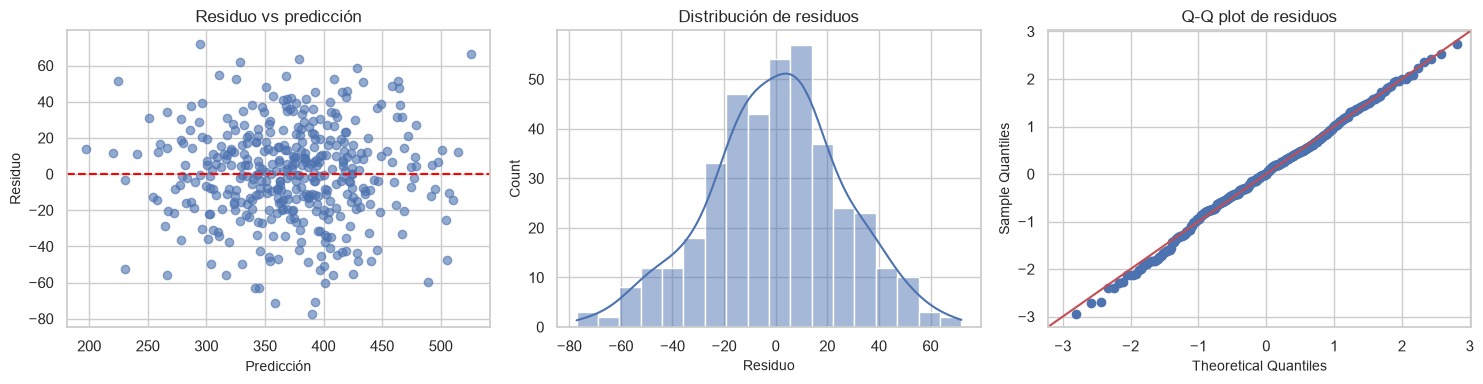
Media de residuos (entrenamiento, ~0 por construcción, no es diagnóstico): 0.000
Media de residuos (prueba, chequeo real):                                 2.371
Desv. estándar de residuos (entrenamiento): 26.319
Correlación predicción-residuo (entrenamiento, ~0 por construcción, no es diagnóstico): -0.000
Correlación predicción-residuo (prueba, chequeo real):                                 0.088
% residuos extremos (|resid| > 2*std): 5.25%
Durbin-Watson: 1.889
OK: no hay dependencia lineal fuerte entre predicción y residuo en prueba.
OK: porcentaje de residuos extremos en rango razonable.
Cómo leer este resultado: diagnóstico de residuos
Definición explícita de Durbin–Watson - Durbin–Watson mide si los residuos consecutivos están correlacionados (autocorrelación). - Su rango aproximado es 0 a 4. - Cerca de 2: independencia razonable de errores (deseable). - Menor que 2: autocorrelación positiva. - Mayor que 2: autocorrelación negativa. - Solo es informativo cuando las observaciones tienen un orden natural (tiempo, secuencia); con filas en orden arbitrario, como aquí, un valor cercano a 2 es lo esperable.
Lectura de esta ejecución (qué significa y por qué es bueno)
- Media de residuos (entrenamiento) = 0.000 vs. media de residuos (prueba) = 2.371
- Significa: en entrenamiento, la media da exactamente 0 por construcción de OLS (no es un hallazgo); el valor que sí informa es el de prueba: 2.37 kWh, pequeño frente a la dispersión típica del error (26.3 kWh). Con 100 observaciones de prueba, su error estándar ronda \(26.3/\sqrt{100} \approx 2.6\) kWh, así que es compatible con cero.
- Por qué es bueno: un sesgo promedio tan pequeño en datos no vistos indica que el modelo no está sistemáticamente sobreestimando ni subestimando fuera de la muestra de entrenamiento.
- Desv. estándar de residuos = 26.319
- Significa: tamaño típico de la dispersión del error.
- Por qué es bueno: es muy cercano a la desviación estándar del ruido con que se simularon los datos (25 kWh, sección 3). Ese ruido es el piso del error: ningún modelo puede bajar de ahí, y este está casi en él.
- Correlación predicción-residuo (entrenamiento) = -0.000 vs. (prueba) = 0.088
- Significa: en entrenamiento, esta correlación es cero por construcción (ortogonalidad de mínimos cuadrados), no un hallazgo; el valor que sí informa es el de prueba: 0.088, por debajo del umbral de alerta (0.2) y, con 100 observaciones, compatible con cero.
- Por qué es bueno: en datos que el modelo no vio al ajustarse, tampoco aparece una relación lineal apreciable entre lo que predice y su error, lo que reduce evidencia de patrón sistemático omitido.
- % residuos extremos = 5.25%
- Significa: 21 de los 400 residuos de entrenamiento superan 2 desviaciones estándar. Con errores normales se esperaría alrededor de 4.6 %, así que 5.25 % está en línea con lo esperado.
- Por qué es bueno: no parece existir una cola extrema dominante que distorsione todo el modelo.
- Durbin–Watson = 1.889
- Significa: valor cercano a 2, como se espera con filas en orden arbitrario.
- Alcance: como los hogares no tienen orden temporal, este valor no aporta evidencia; la independencia aquí la garantiza el diseño (hogares simulados de forma independiente), no el estadístico.
- Mensajes automáticos: OK y OK
- Significa: el sistema no detecta, sobre el conjunto de prueba, dependencia lineal fuerte ni exceso de extremos bajo los umbrales definidos.
- Por qué es bueno: confirma que, en chequeo básico sobre datos no vistos, la salud residual es adecuada.
Lectura de las gráficas - Residuo vs predicción: nube sin patrón claro y centrada en 0, lo cual es favorable. Pero este gráfico no delata todo: el efecto de la temperatura se simuló en forma de V y el modelo lo trata como una recta; esa curvatura queda en los residuos, diluida entre los demás predictores. Graficar los residuos contra temperatura es el chequeo que corresponde para buscarla. - Histograma: forma aproximadamente simétrica, compatible con normalidad aproximada. - Q-Q plot: puntos cercanos a la diagonal, con desviaciones leves aceptables en colas.
En síntesis - El diagnóstico residual de esta corrida es saludable: no hay alertas fuertes de sesgo ni exceso de extremos. La deuda pendiente es la forma del efecto de la temperatura, que un modelo lineal no captura (los splines y los GAM, más adelante en la serie, la resuelven). - Se puede continuar con interpretación del modelo, manteniendo monitoreo si se cambian variables o se usa otro dataset.
11. Guía práctica para interpretar resultados (paso a paso)
Usa esta guía cada vez que termines un modelo. La idea es responder: - qué tan bien predice, - si es estable, - y si se puede interpretar con confianza.
Paso 1: mirar error en unidades reales
Revisa MAE y RMSE. - Si son bajos para el contexto, el modelo es útil en términos prácticos. - Si RMSE es mucho mayor que MAE, hay errores grandes que debes investigar.
Paso 2: mirar capacidad explicativa
Revisa el \(R^2\) en el conjunto de prueba. - \(R^2\) alto: el modelo explica gran parte de la variabilidad. - \(R^2\) bajo: pueden faltar variables, forma funcional o calidad de datos, o el fenómeno simplemente tiene mucho ruido irreducible.
Paso 3: revisar estabilidad
Compara el \(R^2\) de prueba con el \(R^2\) promedio de validación cruzada. - Si son parecidos, buena estabilidad. - Si hay brecha grande, posible sobreajuste o partición poco representativa.
Paso 4: revisar salud de residuos
Confirma 4 cosas mínimas: 1. residuos centrados en 0, 2. sin patrón claro en residuo vs predicción, 3. dispersión parecida (sin embudo fuerte), 4. porcentaje de extremos razonable.
Paso 5: revisar independencia de errores
Mira Durbin–Watson, solo si los datos tienen un orden temporal o secuencial. - Cerca de 2: bien (independencia razonable). - Muy lejos de 2: alerta de autocorrelación.
Paso 6: revisar multicolinealidad
Mira VIF de predictores. - VIF < 5: normalmente aceptable. - 5 a 10: alerta. - \(\geq 10\): problema serio de interpretación.
Paso 7: decidir acción
- Si métricas y diagnósticos son buenos: reportar y usar.
- Si predice bien pero falla diagnóstico: ajustar modelo (transformaciones, no linealidad, segmentación, robustez).
- Si predice mal: volver a variables, datos y especificación.
Semáforo de decisión rápido
- Verde: \(R^2\) estable + residuos sanos + VIF sano.
- Amarillo: predice razonable, pero con alguna alerta diagnóstica.
- Rojo: baja estabilidad o diagnósticos con fallas fuertes; no interpretar coeficientes sin corregir.
Plantilla corta mejorada (lista para copiar)
Desempeño “MAE = , RMSE = , \(R^2\) de prueba = . Interpretación: el error en escala real es y la capacidad explicativa es ___.”
Estabilidad “\(R^2\) CV medio = , desviación CV = , brecha (\(R^2\) de prueba − \(R^2\) CV) = . Interpretación: la estabilidad es (alta/media/baja).”
Diagnóstico residual “Media resid = , corr(pred,resid) = , % extremos = , Durbin–Watson = . Interpretación: residuos ___ (saludables / con alertas en ___).”
Colinealidad “VIF max = ___ (variable: ). Interpretación: colinealidad (baja/moderada/alta).”
Decisión final “Decisión: ___ (usar / ajustar / replantear). Justificación: se decide esto porque ___.”
Criterio de cierre rápido
- Si los cuatro bloques de diagnóstico (1 a 4) salen favorables, o solo uno con una alerta leve: modelo útil para el reporte final.
- Si 2 o más bloques salen en alerta: ajustar antes de cerrar conclusiones.
Idea clave: interpretar un modelo no es mirar un solo número; es seguir una guía completa y consistente.
12. Cierre
En este artículo pasaste de un predictor a varios: formulaste la regresión múltiple, exploraste los datos buscando redundancia, curvatura, segmentos y atípicos, ajustaste el modelo con inferencia formal, mediste la colinealidad con el VIF, evaluaste el desempeño en prueba y con validación cruzada, y diagnosticaste los residuos.
En el ejemplo de energía, el modelo explica el 82 % de la variabilidad en datos no vistos, con un RMSE de 27.66 kWh, muy cerca del piso que impone el ruido; Ridge y Lasso no mejoraron nada porque no había colinealidad que corregir. El siguiente artículo de la serie se ocupa justo del caso contrario: cuando hay muchos predictores o predictores redundantes, la regularización Ridge y Lasso deja de ser un empate y se vuelve necesaria.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.