Análisis Avanzado de Datos — 3. Regularización Ridge y Lasso
estadistica
regularizacion
ridge-lasso
Regularización Ridge (L2) y Lasso (L1) paso a paso: por qué la regresión lineal se queda corta ante el sobreajuste y cómo equilibrar sesgo y varianza.
Author
Wilder Ramírez Delgado
Published
August 28, 2026
Análisis Avanzado de Datos — 3. Regularización Ridge y Lasso
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
¿Por qué la regresión lineal se queda corta?
En los dos artículos anteriores de la serie trabajaste con la regresión lineal, simple y múltiple, y viste cómo el factor de inflación de la varianza (VIF) diagnostica la multicolinealidad. Es un modelo simple, interpretable y funciona sorprendentemente bien en muchos problemas reales. Pero tiene puntos débiles que se vuelven críticos en la práctica:
Cuando hay muchas variables predictoras, algunas correlacionadas entre sí (multicolinealidad), los coeficientes se vuelven inestables: pequeños cambios en los datos producen coeficientes muy distintos.
Cuando el modelo tiene más flexibilidad de la necesaria (muchas variables, o términos polinomiales), tiende a memorizar el ruido del conjunto de entrenamiento en lugar de aprender el patrón real — esto se llama sobreajuste (overfitting).
No tienes forma de decirle al modelo qué variables no aportan, para que las ignore.
La solución a estos tres problemas tiene un nombre: regularización. En este artículo vas a construir la intuición completa, con código ejecutable de principio a fin, sobre las dos formas de regularización más usadas en regresión: Ridge y Lasso.
Repaso: regresión lineal múltiple
La regresión lineal múltiple modela una variable de respuesta \(y\) como una combinación lineal de \(p\) variables predictoras:
Para repasarla, vas a usar un dataset real: precios de vivienda en California, disponible directamente en scikit-learn. Cada fila es un bloque censal, con variables como ingreso medio, antigüedad de las viviendas, número de habitaciones, población y ubicación geográfica; el objetivo es predecir el precio medio de la vivienda.
import numpy as npimport pandas as pdfrom sklearn.datasets import fetch_california_housingSEMILLA =42# semilla global: se usa en toda celda con aleatoriedad# Dataset real: precios de vivienda en California (incluido en scikit-learn)housing = fetch_california_housing(as_frame=True)X = housing.datay = housing.target # precio medio de vivienda, en cientos de miles de USDprint(f"Observaciones: {X.shape[0]}")print(f"Variables predictoras: {list(X.columns)}")X.head()
Para evaluar el modelo de forma honesta, separa los datos en un conjunto de entrenamiento y uno de prueba: ajusta el modelo solo con el primero y evalúalo con el segundo, que nunca vio durante el entrenamiento.
Como métricas vas a usar el coeficiente de determinación\(R^2\) (proporción de la varianza de \(y\) que explica el modelo) y la raíz del error cuadrático medio (RMSE, root mean squared error), \(\text{RMSE} = \sqrt{\tfrac{1}{n}\sum_{i=1}^{n} (y_i - \hat y_i)^2}\), que está en las mismas unidades de \(y\). Su cuadrado, sin la raíz, es el error cuadrático medio (MSE, mean squared error), que aparecerá en la siguiente sección.
from sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_squared_error, r2_score# X e y son los datos de California cargados en la celda anteriorX_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=SEMILLA)modelo_lineal = LinearRegression()modelo_lineal.fit(X_train, y_train)y_pred = modelo_lineal.predict(X_test)print(f"R² en prueba: {r2_score(y_test, y_pred):.3f}")print(f"RMSE en prueba: {np.sqrt(mean_squared_error(y_test, y_pred)):.3f}")coeficientes = pd.Series(modelo_lineal.coef_, index=X.columns).sort_values()print("\nCoeficientes del modelo:")print(coeficientes)print(f"\nCorrelación AveRooms-AveBedrms: {X['AveRooms'].corr(X['AveBedrms']):.2f}")# ¿Qué tan precisos son esos dos coeficientes? Errores estándar del mismo modelo con statsmodelsimport statsmodels.api as smmodelo_sm = sm.OLS(y_train, sm.add_constant(X_train)).fit()print(f"Observaciones de entrenamiento: {len(X_train)}")print(f"Error estándar — AveRooms: {modelo_sm.bse['AveRooms']:.3f}, AveBedrms: {modelo_sm.bse['AveBedrms']:.3f}")
R² en prueba:   0.576
RMSE en prueba: 0.746

Coeficientes del modelo:
Longitude    -0.433708
Latitude     -0.419792
AveRooms     -0.123323
AveOccup     -0.003526
Population   -0.000002
HouseAge      0.009724
MedInc        0.448675
AveBedrms     0.783145
dtype: float64

Correlación AveRooms-AveBedrms: 0.85
Observaciones de entrenamiento: 16512
Error estándar — AveRooms: 0.007, AveBedrms: 0.033
Cómo leer este resultado
El modelo explica una parte razonable de la varianza del precio: \(R^2 = 0.576\) en el conjunto de prueba (RMSE = 0.746, en cientos de miles de USD), un resultado aceptable para ocho variables socioeconómicas y geográficas sin transformaciones ni interacciones.
AveRooms y AveBedrms están correlacionadas 0.85 entre sí y sus coeficientes salen con signos opuestos: AveRooms con −0.12 (¿más habitaciones promedio, precio más bajo?) y AveBedrms con +0.78. Leídos por separado parecen contraintuitivos, pero cada coeficiente mide el efecto de su variable manteniendo fijas las demás: más habitaciones con el mismo número de dormitorios no describe lo mismo que “una vivienda más grande”.
Aquí la correlación no alcanza a volver inestables los coeficientes: con 16512 observaciones de entrenamiento, sus errores estándar son 0.007 y 0.033, muy pequeños frente a los coeficientes. La multicolinealidad se vuelve un problema serio cuando hay pocas observaciones por variable o correlaciones más extremas, y ahí es donde la regularización marca la diferencia. Para verlo con claridad, el resto del artículo usa ejemplos sintéticos pequeños.
El problema del sobreajuste y el compromiso sesgo–varianza
Para ver el sobreajuste con claridad, aléjate por un momento del dataset de 8 variables y mira un ejemplo con una sola variable, donde puedas graficar el ajuste directamente.
Imagina que la relación real entre \(x\) y \(y\) es una curva suave, pero solo tienes observaciones con ruido. Si ajustas:
Un modelo demasiado simple (una recta) va a subajustar (underfitting): no captura la curva real. Esto es alto sesgo.
Un modelo demasiado flexible (un polinomio de grado muy alto) va a memorizar el ruido de los puntos de entrenamiento. Esto es alta varianza: el modelo cambia mucho si cambian ligeramente los datos.
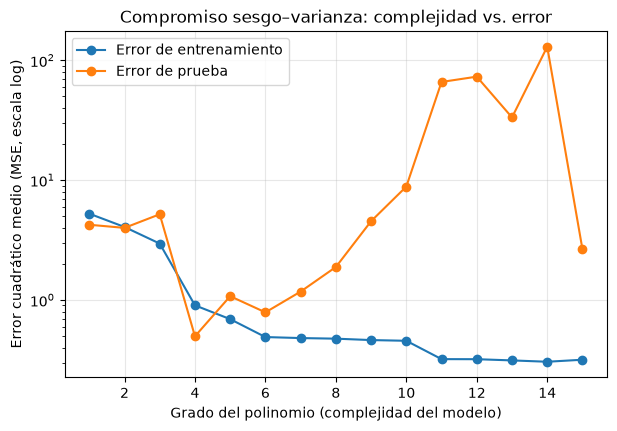
El objetivo es encontrar el punto intermedio donde el error en datos nuevos (no vistos durante el entrenamiento) es mínimo.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_squared_errorfrom sklearn.preprocessing import PolynomialFeatures, StandardScalerfrom sklearn.pipeline import make_pipeline# Datos sintéticos: una curva real + ruidorng = np.random.default_rng(SEMILLA)x = np.sort(rng.uniform(0, 10, 60))y_real = np.sin(x) *3+0.3* xy = y_real + rng.normal(scale=1.0, size=x.shape)X = x.reshape(-1, 1)X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=SEMILLA)grados =range(1, 16)error_train, error_test = [], []for grado in grados:# Escalar x antes de generar las potencias evita que las columnas de alto grado# exploten en magnitud y hagan inestable la solución de mínimos cuadrados. modelo = make_pipeline(StandardScaler(), PolynomialFeatures(grado), LinearRegression()) modelo.fit(X_train, y_train) error_train.append(mean_squared_error(y_train, modelo.predict(X_train))) error_test.append(mean_squared_error(y_test, modelo.predict(X_test)))fig, ax = plt.subplots(figsize=(7, 4.5))ax.plot(list(grados), error_train, marker="o", label="Error de entrenamiento")ax.plot(list(grados), error_test, marker="o", label="Error de prueba")ax.set_xlabel("Grado del polinomio (complejidad del modelo)")ax.set_ylabel("Error cuadrático medio (MSE, escala log)")ax.set_yscale("log")ax.set_title("Compromiso sesgo–varianza: complejidad vs. error")ax.legend()ax.grid(alpha=0.3)plt.show()grado_optimo =list(grados)[int(np.argmin(error_test))]print(f"Grado con menor error de prueba: {grado_optimo} (MSE_test={min(error_test):.2f}, MSE_train={error_train[np.argmin(error_test)]:.2f})")print(f"MSE de prueba en grado 12: {error_test[11]:.2f}")grado_peor =list(grados)[int(np.argmax(error_test))]print(f"Grado con mayor error de prueba: {grado_peor} (MSE_test={max(error_test):.2f})")grado_train_min =list(grados)[int(np.argmin(error_train))]print(f"MSE de entrenamiento: grado 1 = {error_train[0]:.2f}, grado 15 = {error_train[-1]:.2f}; mínimo en grado {grado_train_min} ({min(error_train):.3f})")fuera = (X_test < X_train.min()) | (X_test > X_train.max())print(f"Puntos de prueba fuera del rango de entrenamiento [{X_train.min():.2f}, {X_train.max():.2f}]: {np.round(X_test[fuera], 2)}")
Grado con menor error de prueba: 4 (MSE_test=0.50, MSE_train=0.90)
MSE de prueba en grado 12: 73.09
Grado con mayor error de prueba: 14 (MSE_test=129.86)
MSE de entrenamiento: grado 1 = 5.25, grado 15 = 0.32; mínimo en grado 14 (0.305)
Puntos de prueba fuera del rango de entrenamiento [0.44, 9.76]: [0.07]
Cómo leer este resultado
El error de entrenamiento baja casi siempre al aumentar la complejidad: pasa de 5.25 en grado 1 a 0.305 en grado 14 (el grado 15 queda en 0.32, casi igual). Con 16 coeficientes para 42 puntos, el polinomio de grado 15 logra un error de entrenamiento muy por debajo de la varianza del ruido con que se generaron los datos (1.0): está ajustando parte de ese ruido.
El error de prueba cuenta otra historia: toca su mínimo en grado 4 (MSE = 0.50) y a partir del grado 9 crece con fuerza y de forma errática: 73.09 en grado 12 (casi 150 veces el mínimo) y 129.86 en grado 14. En grado 4 el error de entrenamiento (0.90) incluso supera al de prueba: con solo 18 puntos de prueba, el error de prueba es una estimación muy ruidosa.
Los picos tienen una causa concreta: un punto de prueba (\(x \approx\) 0.07) queda fuera del rango de entrenamiento, y los polinomios de grado alto se disparan al extrapolar. Por eso la curva de prueba sube y baja de un grado a otro en vez de crecer de forma suave.
La brecha entre “el entrenamiento sigue mejorando” y “la prueba empeora” es la definición operativa de sobreajuste. Una aclaración de protocolo: aquí el conjunto de prueba se usa solo para ilustrar la curva; para elegir el grado sin fuga de información se usa validación cruzada sobre el entrenamiento, tema de los dos artículos siguientes de la serie.
Regularización Ridge (L2)
Ridge modifica la función de costo de la regresión lineal agregando una penalización proporcional a la suma de los coeficientes al cuadrado:
El hiperparámetro \(\alpha\) (alpha) controla la fuerza de la penalización:
\(\alpha = 0\) → Ridge es idéntico a la regresión lineal ordinaria.
\(\alpha \to \infty\) → todos los coeficientes se acercan a cero (el modelo se vuelve casi constante).
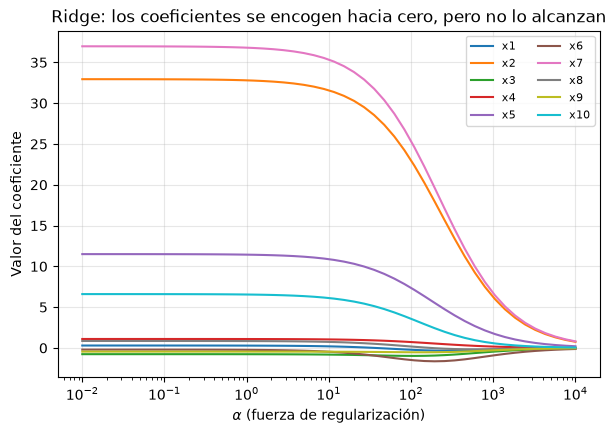
La intuición: Ridge encoge (shrinks) el vector de coeficientes hacia cero —su norma \(\sqrt{\sum_j \beta_j^2}\) disminuye siempre al crecer \(\alpha\), aunque algún coeficiente individual puede crecer por el camino—, con más fuerza en las direcciones en que los datos varían poco, que son justo las que crea la multicolinealidad. En la práctica no los lleva a cero exacto. Esto reduce la varianza del modelo a cambio de un poco de sesgo — justo el compromiso que viste arriba.
Para ver el efecto con claridad, genera un dataset sintético con variables informativas y variables que son puro ruido, y observa cómo cambian los coeficientes a medida que aumenta \(\alpha\). Sus 10 variables son prácticamente independientes entre sí, así que aquí verás el encogimiento en estado puro, sin el efecto de la multicolinealidad. En scikit-learn, Ridge minimiza exactamente la expresión de arriba, sin penalizar el intercepto.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import make_regressionfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import Ridge# Dataset sintético: 10 variables, solo 4 realmente informativasX, y, coef_real = make_regression( n_samples=200, n_features=10, n_informative=4, noise=10.0, coef=True, random_state=SEMILLA,)X = StandardScaler().fit_transform(X) # estandarizar es clave para regularizaralphas = np.logspace(-2, 4, 50)coeficientes_ridge = []for alpha in alphas: modelo = Ridge(alpha=alpha) modelo.fit(X, y) coeficientes_ridge.append(modelo.coef_)coeficientes_ridge = np.array(coeficientes_ridge)fig, ax = plt.subplots(figsize=(7, 4.5))for i inrange(X.shape[1]): ax.plot(alphas, coeficientes_ridge[:, i], label=f"x{i+1}")ax.set_xscale("log")ax.set_xlabel(r"$\alpha$(fuerza de regularización)")ax.set_ylabel("Valor del coeficiente")ax.set_title("Ridge: los coeficientes se encogen hacia cero, pero no lo alcanzan")ax.legend(loc="upper right", fontsize=8, ncol=2)ax.grid(alpha=0.3)plt.show()print(f"Variables realmente informativas (coeficiente ≠ 0 en la generación): {[f'x{i+1}'for i, c inenumerate(coef_real) ifabs(c) >0]}")print(f"\nSuma de |coeficientes| en alpha={alphas[0]:.2f}: {np.sum(np.abs(coeficientes_ridge[0])):.1f}")print(f"Suma de |coeficientes| en alpha={alphas[-1]:.0f}: {np.sum(np.abs(coeficientes_ridge[-1])):.1f}")print(f"Coeficiente de x7 (el más grande, informativo) — alpha bajo: {coeficientes_ridge[0][6]:.2f}, alpha alto: {coeficientes_ridge[-1][6]:.2f}")
Variables realmente informativas (coeficiente ≠ 0 en la generación): ['x2', 'x5', 'x7', 'x10']

Suma de |coeficientes| en alpha=0.01: 91.7
Suma de |coeficientes| en alpha=10000: 2.1
Coeficiente de x7 (el más grande, informativo) — alpha bajo: 36.97, alpha alto: 0.80
Cómo leer este resultado
Las variables realmente informativas (\(x_2\), \(x_5\), \(x_7\) y \(x_{10}\)) son justo las que parten con los coeficientes más grandes cuando \(\alpha\) es bajo: el modelo captura la señal real antes de regularizar.
A medida que \(\alpha\) crece de 0.01 a 10000, la suma de |coeficientes| cae de 91.7 a 2.1, un encogimiento de más de 40 veces que afecta a todas las variables, no solo a las irrelevantes.
\(x_7\) (la variable con el mayor coeficiente real) pasa de 36.97 a apenas 0.80: se encoge muchísimo, pero en ningún punto del camino llega a cero exacto, la firma que distingue a Ridge de Lasso.
El encogimiento no es uniforme ni siempre monótono: en la figura, el coeficiente de \(x_6\) se vuelve más negativo alrededor de \(\alpha \approx 10^2\) antes de regresar a cero. Lo que Ridge garantiza es que la norma del vector de coeficientes baje al crecer \(\alpha\), no que cada coeficiente lo haga.
Regularización Lasso (L1)
Lasso (Least Absolute Shrinkage and Selection Operator) usa una penalización distinta: la suma de los valores absolutos de los coeficientes.
La diferencia con Ridge parece sutil (cuadrado vs. valor absoluto), pero tiene una consecuencia geométrica importante: si se escribe el problema en su forma equivalente con restricción, la región permitida de Lasso (\(\sum_j |\beta_j| \le t\), un rombo en dos dimensiones) tiene esquinas sobre los ejes, donde algún coeficiente es exactamente cero, mientras que la de Ridge (\(\sum_j \beta_j^2 \le t\)) es una esfera suave. Eso hace que la solución óptima de Lasso “aterrice” con frecuencia exactamente sobre uno de esos ejes.
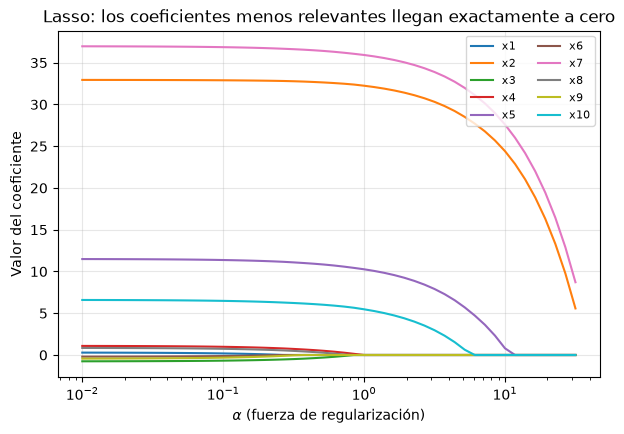
En la práctica, esto significa que Lasso no solo encoge coeficientes: puede llevarlos exactamente a cero. Es, de facto, un método de selección automática de variables.
Un detalle de scikit-learn que conviene conocer: Lasso no minimiza exactamente la expresión de arriba, sino \(\frac{1}{2n}\sum_{i=1}^n (y_i - \hat y_i)^2 + \alpha \sum_{j=1}^p |\beta_j|\). Por eso los valores de \(\alpha\) de Ridge y Lasso no están en la misma escala: con \(n = 200\), Lasso(alpha=1.0) equivale a una penalización de \(2n\alpha = 400\) en la fórmula de arriba.
Usa el mismo dataset sintético de antes (10 variables, solo 4 informativas) para comprobarlo.
from sklearn.linear_model import Lasso# Mismo dataset sintético de la sección de Ridge (X estandarizada, y, coef_real)alphas = np.logspace(-2, 1.5, 50)coeficientes_lasso = []for alpha in alphas: modelo = Lasso(alpha=alpha, max_iter=10000) modelo.fit(X, y) coeficientes_lasso.append(modelo.coef_)coeficientes_lasso = np.array(coeficientes_lasso)fig, ax = plt.subplots(figsize=(7, 4.5))for i inrange(X.shape[1]): ax.plot(alphas, coeficientes_lasso[:, i], label=f"x{i+1}")ax.set_xscale("log")ax.set_xlabel(r"$\alpha$(fuerza de regularización)")ax.set_ylabel("Valor del coeficiente")ax.set_title("Lasso: los coeficientes menos relevantes llegan exactamente a cero")ax.legend(loc="upper right", fontsize=8, ncol=2)ax.grid(alpha=0.3)plt.show()print("Valor de alpha en que cada coeficiente llega a cero por primera vez:")for i inrange(X.shape[1]): indices_cero = np.flatnonzero(coeficientes_lasso[:, i] ==0)iflen(indices_cero) >0:print(f" x{i+1}: alpha = {alphas[indices_cero[0]]:.2f}")else:print(f" x{i+1}: sigue activa en todo el rango probado (hasta alpha = {alphas[-1]:.1f})")# Ajuste con un alpha fijo: ¿qué variables sobreviven?modelo_lasso = Lasso(alpha=1.0, max_iter=10000)modelo_lasso.fit(X, y)no_cero = np.sum(modelo_lasso.coef_ !=0)print(f"Variables con coeficiente distinto de cero: {no_cero} de {X.shape[1]}")print(f"Variables realmente informativas: {np.sum(np.abs(coef_real) >0)}")print(f"Seleccionadas por Lasso: {[f'x{i+1}'for i in np.flatnonzero(modelo_lasso.coef_)]}")print(f"Informativas reales: {[f'x{i+1}'for i in np.flatnonzero(coef_real)]}")
Valor de alpha en que cada coeficiente llega a cero por primera vez:
  x1: alpha = 0.32
  x2: sigue activa en todo el rango probado (hasta alpha = 31.6)
  x3: alpha = 0.85
  x4: alpha = 1.00
  x5: alpha = 11.79
  x6: alpha = 0.27
  x7: sigue activa en todo el rango probado (hasta alpha = 31.6)
  x8: alpha = 0.85
  x9: alpha = 0.37
  x10: alpha = 6.11
Variables con coeficiente distinto de cero: 4 de 10
Variables realmente informativas: 4
Seleccionadas por Lasso: ['x2', 'x5', 'x7', 'x10']
Informativas reales:     ['x2', 'x5', 'x7', 'x10']
Cómo leer este resultado
En el camino de Lasso (figura y salida de la celda anterior), las seis variables irrelevantes llegan a cero entre \(\alpha \approx\) 0.27 y \(\alpha =\) 1.00; después caen \(x_{10}\) (\(\alpha =\) 6.11) y \(x_5\) (\(\alpha =\) 11.79), mientras que \(x_2\) y \(x_7\) siguen activas en todo el rango probado. El orden de salida sigue el tamaño del coeficiente real.
Con \(\alpha = 1.0\), Lasso dejó exactamente 4 coeficientes distintos de cero de las 10 variables, y son precisamente \(x_2\), \(x_5\), \(x_7\) y \(x_{10}\): las mismas 4 que generaron la señal al construir el dataset sintético. Las 6 variables sin efecto real (\(x_1\), \(x_3\), \(x_4\), \(x_6\), \(x_8\), \(x_9\)) quedaron en exactamente cero, no solo pequeñas.
Esa coincidencia perfecta depende del valor elegido: \(x_4\) llega a cero justo en \(\alpha =\) 1.00, así que con un \(\alpha\) un poco menor seguiría activa. Un \(\alpha\) elegido por validación cruzada para predecir bien suele ser menor y conservar alguna variable irrelevante: la selección de Lasso es útil, pero no infalible.
En un problema real no conoces coef_real de antemano, pero el mecanismo es el mismo: al aumentar \(\alpha\), Lasso apaga primero las variables que menos aportan. De ahí su uso como método de selección automática de variables.
Comparación visual: sin regularizar vs. Ridge vs. Lasso
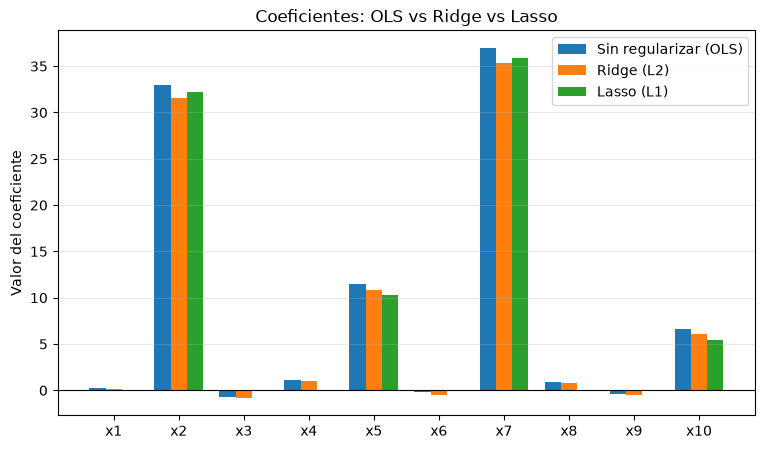
Ahora compara, lado a lado, los coeficientes que produce cada enfoque sobre el mismo dataset sintético, con un valor de \(\alpha\) fijo para cada uno, elegido a mano para ilustrar y no optimizado. Recuerda que en scikit-learn las escalas de \(\alpha\) de Ridge y Lasso no son comparables, así que el contraste es cualitativo: muestra cómo actúa cada penalización, no cuál predice mejor.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.linear_model import LinearRegression, Ridge, Lasso# Mismo dataset sintético de las secciones anteriores (X estandarizada, y, coef_real)modelo_ols = LinearRegression().fit(X, y)modelo_ridge = Ridge(alpha=10.0).fit(X, y)modelo_lasso = Lasso(alpha=1.0, max_iter=10000).fit(X, y)variables = [f"x{i+1}"for i inrange(X.shape[1])]ancho =0.25posiciones = np.arange(len(variables))fig, ax = plt.subplots(figsize=(9, 5))ax.bar(posiciones - ancho, modelo_ols.coef_, width=ancho, label="Sin regularizar (OLS)")ax.bar(posiciones, modelo_ridge.coef_, width=ancho, label="Ridge (L2)")ax.bar(posiciones + ancho, modelo_lasso.coef_, width=ancho, label="Lasso (L1)")ax.set_xticks(posiciones)ax.set_xticklabels(variables)ax.set_ylabel("Valor del coeficiente")ax.set_title("Coeficientes: OLS vs Ridge vs Lasso")ax.axhline(0, color="black", linewidth=0.8)ax.legend()ax.grid(alpha=0.3, axis="y")plt.show()print(f"Coeficientes distintos de cero — OLS: {np.sum(modelo_ols.coef_ !=0)}, Ridge: {np.sum(modelo_ridge.coef_ !=0)}, Lasso: {np.sum(modelo_lasso.coef_ !=0)}")print(f"Suma de |coeficientes| — OLS: {np.sum(np.abs(modelo_ols.coef_)):.1f}, Ridge: {np.sum(np.abs(modelo_ridge.coef_)):.1f}, Lasso: {np.sum(np.abs(modelo_lasso.coef_)):.1f}")print(f"Coeficiente de x4 (irrelevante, coef_real=0) — OLS: {modelo_ols.coef_[3]:.2f}, Ridge: {modelo_ridge.coef_[3]:.2f}, Lasso: {modelo_lasso.coef_[3]:.2f}")
OLS asigna coeficiente distinto de cero a las 10 variables, incluidas las 6 que no tienen ningún efecto real. \(x_4\), por ejemplo, sale con +1.10 pese a que su coeficiente real es 0: ruido que el modelo interpreta como señal.
Ridge (\(\alpha = 10\)) reduce apenas un poco la magnitud total (de 91.7 a 87.6 en suma de |coeficientes|) y deja las 10 variables activas: a \(x_4\) lo baja de 1.10 a 1.05, un recorte mínimo. Con este \(\alpha\) el encogimiento es leve; uno mayor encogería más, como mostró el camino de Ridge.
Lasso (\(\alpha = 1.0\)) es el único que produce un modelo disperso (con pocos coeficientes distintos de cero): solo 4 de 10 quedan activos y \(x_4\) queda en 0.00 exacto. Además encoge los que conserva: la suma de |coeficientes| baja a 83.9, menos que con Ridge.
Cierre técnico: ¿cuándo usar cada una?
Situación
Recomendación
Muchas variables correlacionadas entre sí (multicolinealidad)
Ridge — reparte el efecto entre las variables correlacionadas, mientras que Lasso tiende a quedarse con una de ellas de forma casi arbitraria
Sospechas que muchas variables son irrelevantes y quieres un modelo más simple e interpretable
Lasso — hace selección de variables automáticamente
Quieres selección de variables y, a la vez, estabilidad ante predictores correlacionados
Elastic Net — combina las penalizaciones L1 y L2 (no cubierto en este artículo, disponible en sklearn.linear_model.ElasticNet)
No hay señales de sobreajuste y el modelo lineal simple ya generaliza bien
Regresión lineal ordinaria — no toda situación necesita regularización
En la práctica, el valor de \(\alpha\)no se elige a mano: se selecciona con validación cruzada (RidgeCV, LassoCV en scikit-learn), probando un rango de valores y quedándote con el que minimiza el error en datos de validación. La validación cruzada es justamente el tema de los dos artículos siguientes de la serie: evaluación de modelos y bootstrap, y validación cruzada k-fold.
Un último punto práctico: tanto Ridge como Lasso son sensibles a la escala de las variables — por eso, en todos los ejemplos con Ridge y Lasso de este artículo, se estandarizaron los datos con StandardScaler antes de ajustar el modelo. Si te saltas ese paso, la penalización deja de ser pareja: una variable medida en una escala pequeña necesita un coeficiente grande y queda castigada de más, mientras que una en escala grande necesita un coeficiente pequeño y casi no se penaliza; el resultado pasa a depender de las unidades y no de la importancia de cada variable. Cuando además separas entrenamiento y prueba, ajusta el escalador solo con el entrenamiento (por ejemplo, dentro de un Pipeline).
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.