Análisis Avanzado de Datos — 4. Evaluación de modelos y bootstrap
estadistica
evaluacion
bootstrap
Métricas de rendimiento fuera de la muestra y remuestreo bootstrap para cuantificar la incertidumbre de las estimaciones, con ejemplos ejecutables en Python.
Author
Wilder Ramírez Delgado
Published
September 8, 2026
Análisis Avanzado de Datos — 4. Evaluación de modelos y bootstrap
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
Cuando un modelo mal evaluado cuesta cientos de millones de dólares
En noviembre de 2021, Zillow —una de las plataformas inmobiliarias más grandes de Estados Unidos— anunció el cierre de Zillow Offers, su negocio de comprar casas directamente a sus dueños, remodelarlas y revenderlas con margen. El resultado: cerca de 500 millones de dólares en pérdidas por inventario que no pudo revender al precio esperado, y el despido de unas 2.000 personas, alrededor del 25% de su plantilla.
En el centro de esa operación había un modelo de valoración que, a partir de decenas de variables (ubicación, tamaño, antigüedad, remodelaciones, tendencias del vecindario), predecía a qué precio se podría revender cada casa. Con esa predicción, Zillow decidía cuánto ofrecer por miles de propiedades cada mes.
El modelo se veía muy bien con los datos históricos con los que fue ajustado. El problema apareció cuando el mercado inmobiliario cambió de forma abrupta durante 2021: el modelo empezó a fallar sistemáticamente en casas y momentos que nunca estuvieron bien representados al medir su desempeño. Zillow terminó comprando miles de casas a precios que después no pudo recuperar.
Fíjate en dónde estuvo el error de fondo: no fue “tener un mal modelo”, fue no evaluar correctamente qué tan bien generalizaba ese modelo a datos y condiciones nuevas, ni cuantificar la incertidumbre de sus propias predicciones. Un modelo que ajusta bien el pasado puede fallar en el futuro si nadie preguntó con qué margen de error confiar en él.
Este notebook te da las dos herramientas básicas que un equipo así necesita antes que cualquier otra: cómo medir el desempeño de un modelo de forma honesta, en datos que no vio al entrenarse, y cómo cuantificar cuánta incertidumbre hay detrás de cada número que reportas. No bastan por sí solas —cuando el mercado cambia con el tiempo, como en 2021, la evaluación también tiene que respetar el orden temporal, algo que la serie retoma en el artículo de series de tiempo—, pero sin ellas ni siquiera sabrías con qué margen de error confiar en el modelo cuando todo parece ir bien.
El caso de Zillow no es aislado. Aquí tienes cinco situaciones más que pueden pasar por el inadecuado manejo de la evaluación de modelos y de la incertidumbre de sus estimaciones, aspecto que vamos a analizar en el presente notebook:
1. Predicción de precios de vivienda. Un modelo que predice el precio de venta de casas, al aplicarlo sobre las mismas casas con las que fue construido, da predicciones casi perfectas; pero sobre casas nuevas que nunca había visto, las predicciones quedan muy lejos del precio real. Un modelo puede parecer excelente con los datos que ya conoce y aun así fallar por completo con datos nuevos.
2. Predicción de tiempos de entrega. Un modelo que predice cuántos minutos tardará en llegar un pedido a domicilio acierta bastante bien en la mayoría de los pedidos, pero en un pequeño grupo se equivoca por decenas de minutos. Un resumen general de “en promedio funciona bien” puede esconder errores puntuales muy grandes.
3. Modelo de riesgo crediticio. Dos analistas construyen el mismo modelo con los mismos datos, pero cada uno separa una porción distinta de clientes para comprobar qué tan bien funciona. Uno concluye que el modelo es muy bueno; el otro, que es mediocre. Qué clientes específicos quedaron en el grupo de comprobación puede cambiar por completo la conclusión sobre qué tan bueno es un modelo.
4. Comparación de modelos de fuga de clientes. Al comprobar dos modelos que predicen qué clientes abandonarán un servicio, uno obtiene un resultado apenas un poco mejor que el otro, así que la empresa lo adopta. Meses después, la retención de clientes no mejora nada. Una diferencia pequeña entre dos modelos puede deberse simplemente al azar de cómo se dividieron los datos, no a que uno sea realmente mejor.
5. Efecto del gasto en publicidad sobre las ventas. Un modelo entrega un único número (el efecto estimado de la publicidad en las ventas) que la empresa reporta a la gerencia como “la respuesta”. Semanas después, al aumentar el gasto en publicidad, las ventas no reaccionan ni de cerca como ese número prometía. Reportar un solo número sin decir qué tan seguros están de él invita a decisiones demasiado confiadas.
Los cinco casos comparten el mismo problema de fondo: se confió en un resultado sin comprobar si era honesto ni cuánta incertidumbre cargaba.
En los artículos anteriores aprendiste a construir modelos de regresión: simple, múltiple y regularizada con Ridge y Lasso. Ahora viene la pregunta que de verdad importa: ¿qué tan bueno es tu modelo, y cuánto puedes confiar en esa respuesta? Este artículo cubre las dos herramientas centrales para responderla: la validación (medir el desempeño de forma honesta) y el bootstrap (cuantificar la incertidumbre de tus estimaciones mediante remuestreo). Y el foco no es solo ejecutarlas, sino aprender a leer lo que los resultados te dicen: después de cada resultado clave encontrarás un análisis de qué mirar, qué significan los números y qué decisión tomar con ellos.
Objetivos de aprendizaje
Al terminar este notebook vas a ser capaz de:
Evaluar la capacidad de generalización de un modelo de regresión, comparando su error sobre el conjunto de entrenamiento contra su error sobre un conjunto de prueba independiente, e identificando señales de sobreajuste.
Calcular e interpretar las métricas de error MAE (Error Absoluto Medio), MSE (Error Cuadrático Medio), RMSE (Raíz del Error Cuadrático Medio) y el coeficiente de determinación R², reconociendo qué pregunta responde cada una.
Aplicar validación cruzada k-fold para obtener una estimación del desempeño de un modelo que no dependa de una única partición de los datos, y usarla para comparar modelos en igualdad de condiciones, sin confundir el ruido de la partición con una mejora real.
Implementar el método bootstrap (remuestreo con reemplazo) para estimar la distribución muestral de un estadístico cuando no existe una fórmula analítica cerrada o cuando sus supuestos son dudosos.
Construir intervalos de confianza por percentiles a partir de una distribución bootstrap, y contrastarlos con el intervalo de confianza analítico de una regresión por mínimos cuadrados ordinarios (OLS, por sus siglas en inglés) basado en el error estándar del coeficiente.
Preparación del entorno
Primero, las librerías que vas a usar y una semilla fija para que los resultados sean reproducibles.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.datasets import load_diabetesfrom sklearn.linear_model import LinearRegression, Ridge, Lassofrom sklearn.model_selection import train_test_split, KFold, cross_val_scorefrom sklearn.metrics import mean_absolute_error, mean_squared_error, r2_scoreimport statsmodels.api as smSEMILLA =2026rng = np.random.default_rng(SEMILLA)# Dataset de diabetes: viene incluido en scikit-learn (no requiere internet)datos = load_diabetes(as_frame=True)X = datos.datay = datos.targetprint('Observaciones:', X.shape[0], '| Variables:', X.shape[1])X.head()
Observaciones: 442 | Variables: 10
age
sex
bmi
bp
s1
s2
s3
s4
s5
s6
0
0.038076
0.050680
0.061696
0.021872
-0.044223
-0.034821
-0.043401
-0.002592
0.019907
-0.017646
1
-0.001882
-0.044642
-0.051474
-0.026328
-0.008449
-0.019163
0.074412
-0.039493
-0.068332
-0.092204
2
0.085299
0.050680
0.044451
-0.005670
-0.045599
-0.034194
-0.032356
-0.002592
0.002861
-0.025930
3
-0.089063
-0.044642
-0.011595
-0.036656
0.012191
0.024991
-0.036038
0.034309
0.022688
-0.009362
4
0.005383
-0.044642
-0.036385
0.021872
0.003935
0.015596
0.008142
-0.002592
-0.031988
-0.046641
El dataset tiene 442 observaciones y 10 variables (edad, sexo, IMC, presión arterial y varios marcadores de sangre). Fíjate en que las columnas del head() no muestran valores “normales” como 25 (IMC) o 120 (presión): scikit-learn entrega estas variables ya centradas y escaladas: a cada columna se le resta su promedio sobre los 442 pacientes y se divide por su desviación estándar multiplicada por \(\sqrt{n}\), de modo que cada columna tiene media 0 y norma euclídea 1 (su desviación estándar es ≈ 0.048, no 1). Lo que ves, entonces, son desviaciones respecto al promedio de cada variable, no las unidades clínicas originales; incluso el sexo, que es binario, aparece codificado con dos valores (0.051 y −0.045). La variable respuesta sí conserva su escala original: una medida cuantitativa de la progresión de la enfermedad un año después de la medición inicial.
El error de entrenamiento engaña
El error más común al evaluar un modelo es medirlo sobre los mismos datos con los que se entrenó. El problema: el modelo ya “vio” esos datos, así que su desempeño ahí es optimista. Compara el error medido en entrenamiento contra el medido en datos que el modelo no usó para aprender.
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=SEMILLA)modelo_2 = LinearRegression().fit(X_tr, y_tr)# El mismo modelo, medido en los datos que vio y en los que no vior2_entrenamiento = r2_score(y_tr, modelo_2.predict(X_tr))r2_prueba = r2_score(y_te, modelo_2.predict(X_te))print(f'R2 medido en entrenamiento (optimista): {r2_entrenamiento:.3f}')print(f'R2 medido en datos nuevos (honesto): {r2_prueba:.3f}')
R2 medido en entrenamiento (optimista): 0.513
R2 medido en datos nuevos (honesto):    0.513
Antes de seguir, pregúntate
El R² de entrenamiento y el de prueba del mismo modelo coinciden a tres decimales (0.513 y 0.513). ¿Qué te dice eso sobre si el modelo está memorizando los datos de entrenamiento? ¿Y qué te diría, en cambio, una brecha grande?
Cómo leer este resultado
Lo primero es comparar los dos R² del mismo modelo: 0.513 en entrenamiento frente a 0.513 en datos nuevos. Aquí la brecha es prácticamente nula, y eso ya es información: este modelo casi no sobreajusta, porque una regresión lineal con 10 variables y 309 observaciones de entrenamiento tiene poca capacidad para “memorizar” los datos. Ojo, sin embargo, con leer demasiado en una sola partición: más adelante verás que el R² de prueba cambia bastante según qué filas caen en cada lado y que, promediado sobre muchos remuestreos, el R² de entrenamiento sí resulta sistemáticamente más alto que el de datos nuevos.
La señal de alarma sería la contraria. Si vieras algo como 0.95 en entrenamiento y 0.60 en prueba, esa brecha grande sería la huella clásica del sobreajuste: el modelo habría aprendido el ruido de los datos de entrenamiento en vez del patrón real. Por eso conviene leer la brecha entre ambos números, no cada uno por separado.
La decisión práctica: el número que reportas siempre es el de datos nuevos (0.513). Un R² alto en entrenamiento no vale nada si se desploma al enfrentar datos que el modelo no ha visto.
Métricas de regresión: MAE, MSE, RMSE y R²
Para regresión, estas son las cuatro métricas que vas a usar todo el tiempo. Sea \(y_i\) el valor real de la observación \(i\), \(\hat{y}_i\) el valor predicho por el modelo, \(\bar{y}\) el promedio de los valores reales, y \(n\) el número de observaciones:
MAE (Error Absoluto Medio): promedio de los errores en valor absoluto, en las mismas unidades que la variable objetivo.
MSE (Error Cuadrático Medio): promedio de los errores al cuadrado; castiga más los errores grandes, pero queda en unidades al cuadrado.
RMSE (Raíz del MSE): vuelve a las unidades originales; es el más reportado.
R²: la fracción de la variabilidad total (\(SS_{tot}\)) que el modelo logra explicar y no deja como error residual (\(SS_{res}\)). 1 es perfecto, 0 equivale a predecir siempre la media \(\bar{y}\).
Métrica       Valor
    MAE   42.258535
    MSE 2804.920028
   RMSE   52.961496
     R2    0.512744
Antes de seguir, pregúntate
Mirando la tabla, ¿cuál de las cuatro métricas usarías para explicarle el resultado a alguien no técnico, y cuál no tiene sentido interpretar directamente? ¿Qué te dice que el RMSE (53.0) sea mayor que el MAE (42.3)?
Cómo leer estas métricas
No mires las cuatro por igual: cada una responde una pregunta distinta, y conviene leerlas en un orden concreto. Empieza por el MAE de 42.3, porque es la lectura más intuitiva: en promedio, el modelo se equivoca por unas 42 unidades de la escala de progresión de la diabetes, y es la cifra que le explicarías a alguien no técnico. Luego compáralo con el RMSE de 53.0: como el RMSE siempre es mayor o igual al MAE, la diferencia entre ambos (53 frente a 42) te dice cuánto peso tienen los errores grandes en el total; aquí el cociente es 53.0/42.3 ≈ 1.25, justo el que esperarías si los errores fueran aproximadamente normales (\(\sqrt{\pi/2} \approx 1.25\)), así que hay algunos errores grandes pero no dominan el resultado — si el RMSE fuera, por ejemplo, el doble del MAE, eso sería la señal de alarma de que unas pocas predicciones muy malas están inflando el error. El MSE de 2804.9 no lo interpretes de forma aislada, porque está en unidades al cuadrado y no tiene una lectura directa; su función es servir de base para optimizar y comparar modelos, no para comunicar resultados. Cierra con el R² de 0.513: el modelo explica alrededor del 51% de la variabilidad de la progresión de la enfermedad, y en datos clínicos —donde hay mucha variabilidad biológica que ninguna variable logra capturar— un R² de 0.5 es un resultado razonable, no uno decepcionante. La regla práctica que debe quedarte es reportar siempre RMSE y R² juntos: el primero dice cuánto te equivocas en unidades reales, el segundo qué fracción del problema resolviste, y uno sin el otro solo cuenta media historia.
Una sola partición entrenamiento/prueba no basta
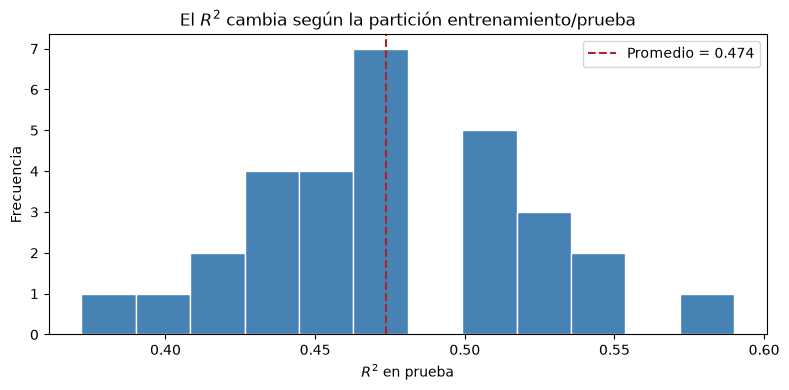
Dividir en entrenamiento y prueba es lo mínimo, pero tiene una debilidad: el resultado depende de qué filas cayeron en cada lado. Repite la partición con distintas semillas y observa cuánto se mueve el R².
r2_por_particion = []for semilla inrange(30): Xa, Xb, ya, yb = train_test_split(X, y, test_size=0.3, random_state=semilla) m = LinearRegression().fit(Xa, ya) r2_por_particion.append(r2_score(yb, m.predict(Xb)))r2_por_particion = np.array(r2_por_particion)print(f'R2 mínimo: {r2_por_particion.min():.3f}')print(f'R2 máximo: {r2_por_particion.max():.3f}')print(f'R2 promedio: {r2_por_particion.mean():.3f} (desviación {r2_por_particion.std():.3f})')
plt.figure(figsize=(8, 4))plt.hist(r2_por_particion, bins=12, color='steelblue', edgecolor='white')plt.axvline(r2_por_particion.mean(), color='firebrick', linestyle='--', label=f'Promedio = {r2_por_particion.mean():.3f}')plt.xlabel('$R^2$ en prueba')plt.ylabel('Frecuencia')plt.title('El $R^2$ cambia según la partición entrenamiento/prueba')plt.legend()plt.tight_layout()plt.show()
Antes de seguir, pregúntate
Si solo hubieras hecho una partición y te hubiera tocado el R² más bajo (0.372) o el más alto (0.590), ¿qué conclusión equivocada habrías sacado sobre el modelo? ¿Por qué ninguno de esos dos extremos es “el” desempeño real del modelo?
Cómo leer este histograma
Este es el resultado más revelador hasta ahora. Con los mismos datos y el mismo modelo, el R² de prueba fue desde 0.37 hasta 0.59 según qué filas cayeron en el conjunto de prueba: un rango de 0.22, enorme.
Piensa en lo que implica. Si hubieras hecho una sola partición y te tocaba la “afortunada” (0.59), reportarías un modelo mucho mejor de lo que realmente es; si te tocaba la “desafortunada” (0.37), lo subestimarías. Ninguno de los dos extremos es el desempeño real — el valor honesto está cerca del centro de la distribución (~0.47). Fíjate además en que el 0.513 de la primera sección queda por encima de ese promedio de 0.474: aquella partición fue más bien favorable.
La lección para tu práctica: nunca confíes en el R² de una sola partición. Un solo número puede caer en cualquier punto de ese rango por puro azar. La solución es promediar sobre varias particiones, que es justo lo que hace la validación cruzada.
Validación cruzada k-fold
La validación cruzada resuelve el problema anterior de forma sistemática. La idea del k-fold (validación cruzada en \(k\) bloques): divides los datos en \(k\) bloques (folds) de tamaño similar —aquí, con \(n = 442\) y \(k = 5\), de 88 u 89 observaciones—; entrenas con \(k-1\) y evalúas en el que sobra; repites \(k\) veces rotando cuál bloque queda para prueba.
Si \(\text{Error}_j\) es la métrica obtenida al usar el fold\(j\) como conjunto de prueba (un error como el MSE o, como en el código de abajo, el \(R^2\), que en rigor es una medida de ajuste y no un error), el estimador de validación cruzada del desempeño del modelo es el promedio de los \(k\) valores:
Así, cada observación se usa para evaluar exactamente una vez, y en vez de un solo número obtienes un promedio \(\text{CV}_k\) acompañado de su desviación \(s_{\text{CV}}\), que resume qué tanto varía el desempeño según qué datos caen en cada fold. Ese par promedio ± desviación, que ya no depende del azar de una sola partición, es también la base para comparar modelos entre sí en igualdad de condiciones.
kfold = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)scores = cross_val_score(LinearRegression(), X, y, cv=kfold, scoring='r2')print('R2 en cada fold:', np.round(scores, 3))print(f'R2 promedio (validación cruzada): {scores.mean():.3f} 'f'± {scores.std():.3f}')
R2 en cada fold: [0.539 0.47  0.441 0.534 0.493]
R2 promedio (validación cruzada): 0.495 ± 0.037
La validación cruzada también sirve para comparar modelos de forma justa: si todos se evalúan con los mismos folds, las diferencias no dependen de una partición afortunada. Comparemos la regresión lineal con Ridge y Lasso.
# La validación cruzada también sirve para COMPARAR modelos de forma justamodelos = {'Lineal': LinearRegression(),'Ridge': Ridge(alpha=1.0),'Lasso': Lasso(alpha=0.1),}resultados = {}for nombre, m in modelos.items(): s = cross_val_score(m, X, y, cv=kfold, scoring='r2') resultados[nombre] = sprint(f'{nombre:7s} R2 = {s.mean():.3f} ± {s.std():.3f}')# Los tres modelos usan los mismos folds: se pueden comparar fold a foldfor nombre in ['Ridge', 'Lasso']: dif = resultados[nombre] - resultados['Lineal']print(f'{nombre} - Lineal por fold: {np.round(dif, 3)} (promedio {dif.mean():+.3f})')
Comparando los tres promedios, ¿cuáles diferencias te parecen más grandes que la variabilidad entre folds (entre ±0.035 y ±0.041), y cuáles caben dentro de ese margen? En las diferencias fold a fold, ¿el signo se mantiene? ¿Declararías un “ganador” entre Lineal y Lasso con estos números?
Cómo leer esta comparación
Ahora tienes tres modelos evaluados con la misma validación cruzada y los mismos folds, así que la comparación es válida. Lo primero que debes mirar no son los promedios sino su variabilidad entre folds (±0.037, ±0.035 y ±0.041), porque esa cifra es la incertidumbre del resultado, no un adorno: antes de declarar un ganador, pregúntate si la diferencia entre dos promedios se distingue de ese ruido. Compara Lineal (0.495) y Lasso (0.489): su diferencia promedio es de apenas 0.006, mucho menor que la variabilidad entre folds, y la comparación fold a fold lo confirma: Lasso gana en dos folds (+0.008 y +0.006) y pierde en tres (−0.015, −0.016 y −0.015). No puedes afirmar que uno sea mejor que el otro. Ridge (0.421), en cambio, queda por debajo de Lineal en los cinco folds, con diferencias entre −0.052 y −0.112 (promedio −0.075): eso ya no es ruido de partición. No significa que Ridge sea un mal modelo en general, sino que con alpha=1.0 penaliza de más en este dataset: como cada columna tiene norma 1, un \(\alpha\) de 1 es del mismo orden que la diagonal de \(X^TX\) y encoge los coeficientes con fuerza. En el artículo de regularización viste que \(\alpha\) no se elige a mano sino con validación cruzada sobre el entrenamiento; en el próximo artículo, dedicado a la validación cruzada, verás ese proceso por dentro. La regla de lectura que debe quedarte: cuando dos modelos comparten los folds, compáralos fold a fold; una diferencia de promedios que cambia de signo entre folds no es una diferencia real, y comparar promedios sin mirar su variabilidad es el error más común al elegir un modelo.
Pipelines de scikit-learn
Antes de seguir comparando modelos, hay una trampa silenciosa que puede sesgar una validación cruzada en cuanto agregues preprocesamiento: dónde y cuándo lo aplicas.
Un Pipeline de scikit-learn encadena varios pasos —típicamente una o más transformaciones (por ejemplo, estandarizar las variables) seguidas de un modelo— en un solo objeto que se comporta exactamente como cualquier estimador: tiene .fit() y .predict(). Por fuera, usar un pipeline se ve igual que usar un modelo solo; por dentro, cada vez que llamas a .fit(), el pipeline ajusta primero las transformaciones y luego el modelo, y cada vez que llamas a .predict(), aplica esas mismas transformaciones (ya ajustadas) antes de predecir.
¿Por qué importa esto justo aquí, en la sección de validación cruzada? Porque si estandarizas todo tu dataset antes de partirlo en folds, el StandardScaler calcula la media y la desviación estándar usando también las observaciones que en cada fold terminarán en el conjunto de prueba. Es la misma lógica que distingue fit_transform de transform: fit_transform se usa sobre el entrenamiento porque ahí sí “aprende” los parámetros de la transformación, mientras que transform se usa sobre la prueba porque solo aplica lo ya aprendido, sin volver a mirar esos datos. Si mezclas las dos —ajustando el escalador con todo el dataset antes de dividirlo— filtras información del conjunto de prueba al de entrenamiento. Esto se llama fuga de datos (data leakage), y el riesgo es que tu R² de validación cruzada quede artificialmente inflado: que te diga que el modelo generaliza mejor de lo que en realidad generaliza. Con un simple escalado la fuga suele ser pequeña; con pasos que aprenden más de los datos —imputar faltantes, seleccionar variables, codificar categorías usando la respuesta— puede ser grande.
Un pipeline resuelve esto de forma automática: cuando le pasas el pipeline completo a cross_val_score, en cada fold el StandardScaler se ajusta (fit) solo con los datos de entrenamiento de ese fold, y luego se aplica (transform) tanto a ese entrenamiento como al fold de prueba. El preprocesamiento queda encapsulado dentro de cada partición, exactamente donde debe estar.
In a Jupyter environment, please rerun this cell to show the HTML representation or trust the notebook. On GitHub, the HTML representation is unable to render, please try loading this page with nbviewer.org.
scores_pipeline = cross_val_score(pipeline, X, y, cv=kfold, scoring='r2')print('R2 en cada fold:', np.round(scores_pipeline, 3))print(f'R2 promedio (pipeline + validación cruzada): {scores_pipeline.mean():.3f} 'f'± {scores_pipeline.std():.3f}')
R2 en cada fold: [0.539 0.47  0.441 0.534 0.493]
R2 promedio (pipeline + validación cruzada): 0.495 ± 0.037
Cómo leer este resultado
Compara este resultado con el de la validación cruzada sin pipeline de más arriba: 0.495 ± 0.037 en ambos casos, número idéntico, fold por fold. Eso no es un error ni una coincidencia rara — es justo lo que esperabas, porque en una regresión lineal, escalar las variables no cambia las predicciones del modelo (solo cambia la escala de los coeficientes), así que el R² permanece igual con o sin StandardScaler.
Entonces, ¿de qué te sirvió el pipeline si el número no cambió? De lo que protege, no de lo que cambia aquí: el escalado se ajustó dentro de cada fold, usando solo los datos de entrenamiento de ese fold, sin que el StandardScaler viera nunca las observaciones de prueba. Y la coincidencia no se debe a que este dataset ya venga centrado y escalado: una regresión lineal con intercepto da exactamente las mismas predicciones con cualquier reescalado lineal de sus columnas, sin importar con qué datos se calculen la media y la desviación. Por eso aquí el número coincide fold a fold, y coincidiría también con datos crudos.
La lección está en otro lado. Con un modelo sensible a la escala —Ridge y Lasso, como viste en el artículo de regularización, o los métodos de kernel que vienen más adelante en la serie— y con datos crudos en escalas muy distintas (edad en años, ingreso en millones, una variable binaria 0/1), estandarizar antes de partir en folds sí filtra información del conjunto de prueba al de entrenamiento. Con el escalado, esa fuga suele mover poco el R²; con pasos que aprenden más de los datos, como seleccionar variables o imputar faltantes, puede inflarlo mucho. En esos escenarios el pipeline deja de ser un detalle técnico y pasa a ser imprescindible para que tu evaluación sea honesta. La regla práctica que te debe quedar: cuando tu flujo de trabajo combine preprocesamiento y validación cruzada, usa siempre un pipeline — nunca cuesta más y, en el momento en que sí importa, es lo único que te separa de una métrica que se ve bien pero que miente.
El método Bootstrap: intuición
La validación cruzada estima el desempeño; el bootstrap estima la incertidumbre de casi cualquier cantidad. Su idea es simple: como solo tienes una muestra \(\{x_1, x_2, \dots, x_n\}\) de tamaño \(n\), el bootstrap la trata como si fuera la población y genera \(B\) “nuevas” muestras remuestreando con reemplazo:
\[x_1^{*(b)}, x_2^{*(b)}, \dots, x_n^{*(b)} \sim \text{muestreo uniforme con reemplazo de } \{x_1, \dots, x_n\}, \qquad b = 1, \dots, B\]
Para cada remuestreo \(b\) calculas tu estadístico de interés \(\hat{\theta}^{*(b)}\) (por ejemplo, un R² o un coeficiente de regresión). La distribución empírica de \(\hat{\theta}^{*(1)}, \dots, \hat{\theta}^{*(B)}\) —la distribución bootstrap— aproxima la distribución muestral real de \(\hat{\theta}\), y su dispersión aproxima la incertidumbre real del estadístico.
La muestra original tiene media 11.5, pero cada remuestreo da una media distinta (11.12, 12.25, 12.62) porque al elegir con reemplazo unos valores se repiten y otros quedan afuera por puro azar. Esa variación de un remuestreo a otro es exactamente lo que el bootstrap va a usar para medir incertidumbre.
Intervalos de confianza por bootstrap
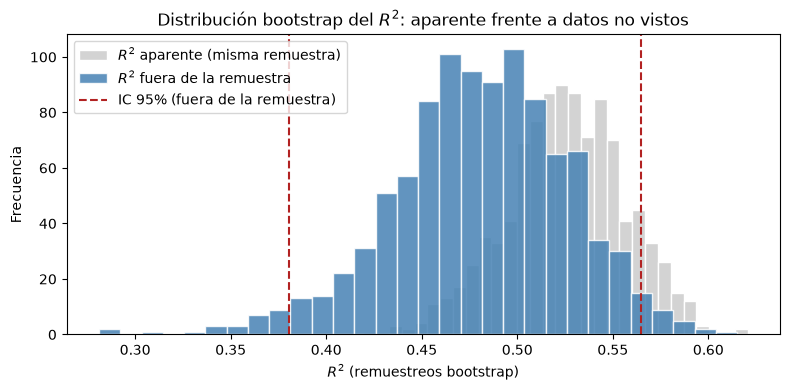
Ahora lo aplicamos a algo útil: estimar la incertidumbre del R² del modelo en datos nuevos. El procedimiento: remuestrear las observaciones con reemplazo \(B\) veces, reentrenar con cada remuestra y medir el estadístico \(\hat{\theta}^{*(b)}\) (aquí, el R²). Hay una trampa, la misma de la primera sección: si mides el R² sobre la propia remuestra con la que entrenaste, obtienes un R² aparente, de entrenamiento, y por tanto optimista. Por eso lo medimos sobre las observaciones que quedaron fuera de cada remuestra: en promedio, cerca del 37% de los datos, porque la probabilidad de que una observación no salga en \(n\) extracciones es \((1-1/n)^n \approx e^{-1} \approx 0.37\). Calculamos los dos R² para que veas la diferencia.
El intervalo de confianza por percentiles al 95% se construye tomando los percentiles 2.5 y 97.5 de la distribución bootstrap del estadístico:
donde \(\hat{\theta}^{*}_{(p\%)}\) denota el percentil \(p\) de los \(B\) valores \(\{\hat{\theta}^{*(1)}, \dots, \hat{\theta}^{*(B)}\}\). En palabras: ordenas los \(B\) estadísticos bootstrap de menor a mayor y recortas el 2.5% de cada extremo; lo que queda en medio es tu intervalo del 95%.
rng = np.random.default_rng(SEMILLA) # semilla local: fija el resultado de este bloqueXv = X.valuesyv = y.valuesn =len(yv)B =1000# número de remuestreos bootstrapr2_aparente = np.empty(B) # R2 sobre la misma remuestra con la que se entrenó (optimista)r2_boot = np.empty(B) # R2 sobre las observaciones que quedaron fuera de la remuestrafor b inrange(B): idx = rng.integers(0, n, size=n) # índices con reemplazo fuera = np.setdiff1d(np.arange(n), idx) # observaciones que no salieron en esta remuestra m = LinearRegression().fit(Xv[idx], yv[idx]) r2_aparente[b] = r2_score(yv[idx], m.predict(Xv[idx])) r2_boot[b] = r2_score(yv[fuera], m.predict(Xv[fuera]))ic_bajo, ic_alto = np.percentile(r2_boot, [2.5, 97.5])print(f'R2 aparente (sobre la propia remuestra): media = {r2_aparente.mean():.3f}')print(f'R2 fuera de la remuestra: media = {r2_boot.mean():.3f}')print(f'IC 95% por bootstrap (fuera de la remuestra): [{ic_bajo:.3f}, {ic_alto:.3f}]')
R2 aparente (sobre la propia remuestra): media = 0.526
R2 fuera de la remuestra:                media = 0.481
IC 95% por bootstrap (fuera de la remuestra): [0.381, 0.565]
plt.figure(figsize=(8, 4))plt.hist(r2_aparente, bins=30, color='lightgray', edgecolor='white', label='$R^2$ aparente (misma remuestra)')plt.hist(r2_boot, bins=30, color='steelblue', edgecolor='white', alpha=0.85, label='$R^2$ fuera de la remuestra')plt.axvline(ic_bajo, color='firebrick', linestyle='--', label='IC 95% (fuera de la remuestra)')plt.axvline(ic_alto, color='firebrick', linestyle='--')plt.xlabel('$R^2$ (remuestreos bootstrap)')plt.ylabel('Frecuencia')plt.title('Distribución bootstrap del $R^2$: aparente frente a datos no vistos')plt.legend()plt.tight_layout()plt.show()
Antes de seguir, pregúntate
¿Por qué el R² aparente (media 0.526) sale más alto que el medido fuera de la remuestra (media 0.481)? ¿Qué le añade el intervalo [0.381, 0.565] a simplemente reportar que el R² es 0.481? Si el intervalo fuera mucho más ancho, por ejemplo [0.20, 0.85], ¿qué te diría eso sobre la calidad de tu estimación?
Cómo leer la distribución bootstrap
El histograma no es un adorno: es el rango de valores plausibles del R² en datos nuevos dado tu único conjunto de datos, y hay que leerlo en cuatro pasos. Primero, compara las dos distribuciones: el R² aparente (media 0.526) queda sistemáticamente a la derecha del medido fuera de la remuestra (media 0.481). Es el mismo optimismo del error de entrenamiento de la primera sección, que en aquella partición casi no se notaba y que, promediado sobre 1000 remuestreos, aparece con claridad. Segundo, mira el centro de la distribución honesta (~0.481): queda cerca del R² de validación cruzada (0.495) y del promedio de las 30 particiones (0.474); son tres estimaciones distintas del mismo desempeño que cuentan la misma historia. Sale algo por debajo de la validación cruzada en parte porque cada remuestra contiene solo alrededor del 63% de observaciones distintas, y el modelo se entrena con menos información. Tercero, mira el intervalo [0.381, 0.565]: es el rango donde cae el 95% central de los R² en datos no vistos al repetir el experimento con remuestras; en palabras simples, “mi modelo explica entre el 38% y el 57% de la variabilidad de la progresión de la enfermedad en datos que no vio”. Cuarto —y esto es lo que más información aporta— mira el ancho del intervalo, de unos 0.18: ese ancho mide cuánta incertidumbre tienes realmente; un intervalo estrecho señalaría una estimación confiable, mientras que uno muy ancho sería la señal de alarma de que tienes pocos datos o mucho ruido y de que conviene ser cauto con cualquier afirmación sobre el modelo. Compara esto con reportar solo “R² = 0.48”: suena preciso, pero esconde que el rango plausible es amplio, y reportar el intervalo completo —no solo el punto— es justo lo que distingue un análisis riguroso de uno ingenuo.
Bootstrap para un coeficiente (y su contraste con statsmodels)
El bootstrap sirve para muchas otras estimaciones, incluido un coeficiente de regresión. Recuerda que el estimador de mínimos cuadrados ordinarios (OLS), en notación matricial, es:
\[\hat{\beta} = (X^T X)^{-1} X^T y\]
donde \(X\) es la matriz de diseño (los predictores más una columna de unos para el intercepto) y \(y\) es el vector de la variable de respuesta. Bajo los supuestos clásicos de OLS (errores con media cero, varianza constante \(\sigma^2\), no correlacionados y normales, o bien una muestra grande), el error estándar de cada coeficiente \(\hat{\beta}_j\) permite construir un intervalo de confianza analítico:
donde \(\text{EE}(\hat{\beta}_j)\) es el error estándar del coeficiente y \(t_{n-p,\,0.975}\) es el cuantil 97.5 de una distribución t de Student con \(n-p\) grados de libertad (\(n\) observaciones, \(p\) parámetros estimados). Esta es justo la fórmula que usa statsmodels por debajo. Para que la comparación sea fácil de seguir, usamos una regresión simple de la progresión de la enfermedad sobre una sola variable, el índice de masa corporal (bmi); su coeficiente no es el mismo que tendría esa variable dentro del modelo con las 10 variables. Vamos a estimar su incertidumbre con bootstrap y a compararla con este intervalo analítico.
rng = np.random.default_rng(SEMILLA) # semilla local: fija el resultado de este bloquevariable ='bmi'x1 = X[[variable]].valuescoef_boot = np.empty(B)for b inrange(B): idx = rng.integers(0, n, size=n) m = LinearRegression().fit(x1[idx], yv[idx]) coef_boot[b] = m.coef_[0]ic_b_bajo, ic_b_alto = np.percentile(coef_boot, [2.5, 97.5])print(f'Coeficiente de {variable} (bootstrap): media = {coef_boot.mean():.1f}')print(f'IC 95% por bootstrap: [{ic_b_bajo:.1f}, {ic_b_alto:.1f}]')
Coeficiente de bmi (bootstrap): media = 946.4
IC 95% por bootstrap:  [834.2, 1064.9]
X_sm = sm.add_constant(x1)ols = sm.OLS(yv, X_sm).fit()ic_sm = ols.conf_int(alpha=0.05)[1] # fila 1 = pendiente (fila 0 = intercepto)print(f'Coeficiente de {variable} (statsmodels): {ols.params[1]:.1f}')print(f'IC 95% analítico: [{ic_sm[0]:.1f}, {ic_sm[1]:.1f}]')# Errores estándar: dispersión bootstrap frente a la fórmula clásicaprint(f'Error estándar: bootstrap = {coef_boot.std(ddof=1):.1f} | fórmula = {ols.bse[1]:.1f}')# Intervalo con errores estándar robustos a varianza no constante (HC3)ic_hc3 = ols.get_robustcov_results(cov_type='HC3').conf_int(alpha=0.05)[1]print(f'IC 95% robusto (HC3): [{ic_hc3[0]:.1f}, {ic_hc3[1]:.1f}]')
Coeficiente de bmi (statsmodels): 949.4
IC 95% analítico:      [826.6, 1072.3]
Error estándar: bootstrap = 56.8 | fórmula = 62.5
IC 95% robusto (HC3):  [836.7, 1062.2]
Antes de seguir, pregúntate
¿Qué esperarías que pasara si los dos intervalos (bootstrap y statsmodels) fueran muy distintos entre sí? ¿A qué método le darías más crédito si sospecharas que los supuestos de la regresión no se cumplen?
Cómo leer esta comparación
Fíjate primero en lo cerca que quedan los dos intervalos: bootstrap [834.2, 1064.9] y statsmodels [826.6, 1072.3], muy parecidos en sus dos extremos y centrados en valores muy próximos (946.4 el promedio bootstrap, 949.4 la estimación de statsmodels). Que dos métodos construidos de forma tan distinta —uno remuestreando mil veces, el otro con una fórmula analítica— lleguen casi al mismo lugar es una buena señal. Pero la lectura importante está en la pequeña diferencia que sí existe: el intervalo bootstrap es algo más estrecho (error estándar 56.8 frente a 62.5). La fórmula clásica de statsmodels asume errores de varianza constante (y normales, o una muestra grande); el intervalo robusto HC3, que no asume varianza constante, da [836.7, 1062.2], casi el mismo que el bootstrap. Es decir, aquí el supuesto de varianza constante no se cumple del todo, y el bootstrap lo captó sin que se lo pidieras, porque no asume nada sobre la forma ni la varianza del error: solo remuestrea los datos observados. Sí asume, en cambio, que las observaciones son independientes y de la misma distribución, y que la muestra es razonablemente grande; con datos dependientes —series de tiempo, datos longitudinales— este remuestreo simple deja de ser válido. La decisión práctica que te debe quedar: si confías en los supuestos de tu modelo, usa la fórmula porque es instantánea; si dudas de ellos (varianza no constante, colas pesadas) o tu estadístico no tiene una fórmula cerrada, el bootstrap es tu red de seguridad, y como acabas de comprobar, contrastarlo contra la fórmula cuesta muy poco y te avisa cuando algo no cuadra.
Cierre técnico
Recapitulando lo que ahora sabes leer, no solo calcular:
La brecha entre error de entrenamiento y de prueba, para detectar sobreajuste.
Las métricas (MAE, RMSE, R²) y qué comunica cada una.
La dispersión entre particiones, que obliga a usar validación cruzada.
El ± de la validación cruzada, para comparar modelos sin dejarte engañar por el ruido.
El ancho del intervalo bootstrap, medido en datos que quedaron fuera de cada remuestra, como medida honesta de tu incertidumbre.
Con esto puedes decir no solo “mi modelo tiene tal desempeño”, sino “tal desempeño, con esta incertidumbre” — el lenguaje de un análisis serio. En el próximo artículo abrimos la validación cruzada k-fold por dentro: dibujaremos las particiones observación por observación, veremos cómo elegir \(k\) y por qué hay que barajar, y leeremos los resultados fold a fold. Con la evaluación ya resuelta, la serie dará después el salto a la suavización (splines y métodos de kernel), para modelar relaciones que la línea recta no alcanza a capturar.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.