# Bloque inicial del notebook: preparación del entorno
# En esta celda cargamos las librerías base de la serie y definimos una
# paleta visual consistente para que todas las gráficas se lean igual.
# Además, fijamos la semilla para que los datos sintéticos sean
# reproducibles en cada ejecución del notebook.

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures, SplineTransformer, StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.model_selection import KFold, cross_val_score, train_test_split
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

SEMILLA = 42
rng = np.random.default_rng(SEMILLA)

plt.rcParams["figure.dpi"] = 110
plt.rcParams["axes.spines.top"] = False
plt.rcParams["axes.spines.right"] = False

COLOR_DATOS = "#4C78A8"
COLOR_VERDAD = "#333333"
COLOR_LINEAL = "#E45756"
COLOR_POLI = "#F58518"
COLOR_SPLINE = "#54A24B"
COLOR_KNOT = "#B279A2"
COLORES_BASE = [
    "#4C78A8",
    "#F58518",
    "#E45756",
    "#54A24B",
    "#B279A2",
    "#72B7B2",
    "#ECA400",
    "#9D755D",
]


def metricas_regresion(y_true, y_pred, nombre=""):
    mae = mean_absolute_error(y_true, y_pred)
    rmse = float(np.sqrt(mean_squared_error(y_true, y_pred)))
    r2 = r2_score(y_true, y_pred)
    encabezado = nombre if nombre else "Modelo"
    print(f"{encabezado}")
    print(f"  MAE  = {mae:.3f}")
    print(f"  RMSE = {rmse:.3f}")
    print(f"  R²   = {r2:.3f}")
return mae, rmse, r2Análisis Avanzado de Datos — 6. Métodos de suavización: splines
estadistica
suavizacion
splines
Regresión polinómica, el fenómeno de Runge, splines cúbicos y el rol de los knots, con selección de complejidad por validación cruzada k-fold, y una comparación final entre modelo lineal, polinómico y spline.
Análisis Avanzado de Datos — 6. Métodos de suavización: splines

👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
El tráfico no cabe en una recta
Imagina que formas parte del equipo de movilidad de una ciudad. Cada día registran el flujo vehicular de una avenida (vehículos por minuto) y quieren un modelo sencillo: si me das la hora, te digo cuántos vehículos esperar. Con esa predicción dimensionan semáforos, buses y personal.
Cualquiera que haya cruzado esa avenida sabe lo que va a pasar. A las 3 de la mañana el cauce está casi vacío. A las 8, el pico de entrada al trabajo. Al mediodía baja. A las 6 de la tarde vuelve a saturarse. El efecto de la hora no es el mismo a lo largo del día: en algunas regiones de \(X\) subir una hora casi no cambia nada; en otras, media hora marca la diferencia entre fluidez y congestión.
Una recta obliga a que el efecto de \(X\) sea constante en todo el dominio. En muchos fenómenos reales eso simplemente no ocurre. El consumo eléctrico según la temperatura, el precio de una vivienda según el área cuando el mercado cambia de segmento, la concentración de un medicamento según el tiempo, el rendimiento de una máquina cuando se calienta: la relación se dobla, se aplana o tiene más de un régimen.
En los artículos anteriores de la serie aprendiste a evaluar si un modelo generaliza: separación entre entrenamiento y prueba, error absoluto medio (MAE), raíz del error cuadrático medio (RMSE), \(R^2\), validación cruzada k-fold y bootstrap. Esa pregunta sigue vigente. Ahora aparece otra, distinta:
¿Qué ocurre cuando el problema no es que el modelo esté mal evaluado, sino que la relación entre \(X\) e \(y\) simplemente no puede ser representada de forma adecuada mediante una recta?
Todo el artículo gira alrededor de una sola pregunta de diseño:
¿Cómo permitimos que un modelo cambie su comportamiento en distintas regiones de \(X\) sin producir una curva artificial o discontinua?
Este notebook no empieza por una función nueva de Python. Empieza por la recta fallando a la vista. Después: no linealidad, polinomio global, partir el dominio, nodos (knots), el salto en los empalmes, y recién entonces el spline. La herramienta tiene que sentirse inevitable: ahora entiendo por qué había que inventarlos.
Objetivos de aprendizaje
Al terminar este notebook vas a ser capaz de:
- Reconocer cuándo una relación lineal es insuficiente, tanto en el gráfico como en las métricas de error.
- Explicar qué es una regresión polinómica y por qué sigue siendo lineal en los parámetros.
- Identificar los problemas de un polinomio global de alto grado, sobre todo en los extremos del dominio.
- Explicar qué significa ajustar funciones por tramos y qué es un knot (nodo, punto de corte).
- Diferenciar un polinomio por tramos de un spline: la diferencia no es el número de piezas, sino cómo se unen.
- Comprender qué condiciones de continuidad impone un spline cúbico y por qué importan geométricamente.
- Usar
SplineTransformerdentro de unPipeline: el spline expande \(X\);LinearRegressionestima los pesos. - Controlar la flexibilidad del modelo con el número de knots y el grado, y relacionarlo con subajuste y sobreajuste.
- Seleccionar esa complejidad con validación cruzada k-fold, no a simple vista sobre el ajuste de entrenamiento.
- Comparar modelos lineales, polinómicos y splines con métricas de generalización, no solo con la gráfica más atractiva.
Preparación del entorno
Cargamos NumPy, pandas, matplotlib y scikit-learn, fijamos una semilla y definimos la paleta de la serie, para que los gráficos se lean igual en todos los artículos. Los datos de la primera parte son sintéticos a propósito: así controlamos la forma de la relación y podemos dibujar la curva verdadera debajo de las observaciones. No hace falta ningún archivo externo.
Cómo vamos a dibujar
Estas funciones no son un alias de plot o scatter. Cada una arma la figura completa: abre el lienzo, pinta lo que toca, pone ejes y la muestra. En las celdas del análisis solo quedan los datos, el modelo y una llamada.
| Función | Qué figura completa genera |
|---|---|
figura_nube |
Observaciones y, si quieres, la curva verdadera |
figura_curvas |
Nube + verdad + uno o varios ajustes + knots |
figura_residuos |
Residuos contra \(X\), con la línea en cero |
figura_paneles |
Varios paneles: la misma nube y una predicción distinta en cada uno |
figura_esquema_knots |
Dibujo didáctico de cortes y regiones |
figura_histograma_knots |
Histograma de \(X\) y, debajo, dónde caen distintos juegos de knots |
figura_cv |
RMSE de validación cruzada contra la complejidad, con el valor elegido |
Los nombres de ejes por defecto son los del tráfico. Si cambias de fenómeno, pásalos tú.
def _cerrar(fig, titulo_superior=None, y_sup=1.03):
    if titulo_superior:
        fig.suptitle(titulo_superior, y=y_sup)
    plt.tight_layout()
    plt.show()


def _nube(ax, x, y, etiqueta="Observaciones", tamano=22):
    ax.scatter(
        x, y,
        c=COLOR_DATOS, s=tamano, alpha=0.7,
        edgecolors="white", linewidths=0.35, zorder=3, label=etiqueta,
    )


def _verdad(ax, x, y, etiqueta="Relación verdadera"):
    ax.plot(x, y, color=COLOR_VERDAD, lw=1.5, ls="--", label=etiqueta)


def _marca_knots(ax, knots):
    for xi in np.asarray(knots, dtype=float).ravel():
        ax.axvline(xi, color=COLOR_KNOT, ls=":", lw=1.4)


def _eje(ax, titulo, xlabel, ylabel=None, xlim=None):
    ax.set_title(titulo)
    ax.set_xlabel(xlabel)
    if ylabel:
        ax.set_ylabel(ylabel)
    if xlim is not None:
        ax.set_xlim(*xlim)
    ax.grid(True, alpha=0.25)


def _trazo(ax, x, y, color, etiqueta=None, trozos=None):
    if trozos is None:
        ax.plot(x, y, color=color, lw=2.2, label=etiqueta)
        return
    for i, (izq, der, *_) in enumerate(trozos):
        mascara = (x >= izq) & (x <= der)
        ax.plot(x[mascara], y[mascara], color=color, lw=2.2, label=etiqueta if i == 0 else None)


def figura_nube(
    x, y,
    x_linea=None, y_linea=None, etiqueta_linea="Relación verdadera",
    titulo="", xlabel="Hora del día", ylabel="Flujo (vehículos / min)", xlim=(0, 24),
):
    """Figura completa: la nube de observaciones y, si se pasan, una curva (casi siempre la verdadera)."""
    fig, ax = plt.subplots(figsize=(9.5, 4.8))
    _nube(ax, x, y, tamano=28)
    if x_linea is not None:
        _verdad(ax, x_linea, y_linea, etiqueta=etiqueta_linea)
    _eje(ax, titulo, xlabel, ylabel, xlim)
    ax.legend(frameon=False)
    _cerrar(fig)


def figura_curvas(
    x, y, x_grid, curvas,
    y_verdad=None, knots=None, trozos=None, colores=None,
    titulo="", xlabel="Hora del día", ylabel="Flujo (vehículos / min)", xlim=(0, 24),
    loc_leyenda="best",
):
    """Figura completa: observaciones + curva verdadera + uno o varios ajustes.

    curvas es un diccionario: {"Regresión lineal": prediccion_en_x_grid, ...}.
    knots dibuja líneas verticales punteadas. trozos parte el trazo si las piezas pueden saltar.
    """
    fig, ax = plt.subplots(figsize=(9.5, 4.8))
    _nube(ax, x, y)
    if y_verdad is not None:
        _verdad(ax, x_grid, y_verdad)
    if colores is None:
        colores = [COLOR_LINEAL, COLOR_POLI, COLOR_SPLINE, COLOR_KNOT] + COLORES_BASE
    for i, (nombre, pred) in enumerate(curvas.items()):
        _trazo(ax, x_grid, pred, colores[i % len(colores)], etiqueta=nombre, trozos=trozos)
    if knots is not None:
        _marca_knots(ax, knots)
    _eje(ax, titulo, xlabel, ylabel, xlim)
    ax.legend(frameon=False, loc=loc_leyenda)
    _cerrar(fig)


def figura_residuos(
    x, residuos,
    titulo="", xlabel="Hora del día", ylabel="Residuo (observado − predicción)", xlim=(0, 24),
):
    """Figura completa de residuos: puntos contra X y una línea horizontal en cero."""
    fig, ax = plt.subplots(figsize=(9.5, 4.2))
    _nube(ax, x, residuos, etiqueta=None, tamano=28)
    ax.axhline(0, color=COLOR_VERDAD, lw=1.2)
    _eje(ax, titulo, xlabel, ylabel, xlim)
    _cerrar(fig)


def figura_paneles(
    x, y, x_grid, paneles,
    y_verdad=None, knots=None, trozos=None, colores=None,
    titulo_figura=None, xlabel="Hora del día", ylabel="Flujo (vehículos / min)", xlim=(0, 24),
    n_cols=None, knots_por_panel=None,
):
    """Varios paneles con la misma nube. paneles = {"Grado 3": pred, "Grado 8": pred, ...}.

    En cada panel se pinta una predicción. knots_por_panel, si se pasa, es una lista de
    cortes distinta por panel (por ejemplo 3, 5, 8 y 15 knots).
    """
    nombres = list(paneles.keys())
    preds = list(paneles.values())
    n = len(nombres)
    if n_cols is None:
        n_cols = n if n <= 3 else 2
    n_filas = int(np.ceil(n / n_cols))
    fig, axes = plt.subplots(
        n_filas, n_cols,
        figsize=(4.2 * n_cols + 0.4, 3.7 * n_filas + 0.5),
        sharey=True, sharex=True,
    )
    axes_lista = np.atleast_1d(axes).ravel()
    if colores is None:
        colores = [COLOR_POLI] * n
    for i, ax in enumerate(axes_lista):
        if i >= n:
            ax.axis("off")
            continue
        _nube(ax, x, y, etiqueta=None, tamano=14)
        if y_verdad is not None:
            _verdad(ax, x_grid, y_verdad, etiqueta=None)
        _trazo(ax, x_grid, preds[i], colores[i % len(colores)], trozos=trozos)
        cortes = knots
        if knots_por_panel is not None:
            cortes = knots_por_panel[i]
        if cortes is not None:
            _marca_knots(ax, cortes)
        _eje(ax, nombres[i], xlabel, ylabel if i % n_cols == 0 else None, xlim)
    _cerrar(fig, titulo_superior=titulo_figura)


def figura_esquema_knots(x, y, knots, nombres_region, titulo=""):
    """Figura didáctica: una curva suave, líneas verticales en los knots y el nombre de cada región."""
    fig, ax = plt.subplots(figsize=(9.8, 4.6))
    ax.plot(x, y, color=COLOR_SPLINE, lw=2.6, zorder=3)
    knots = np.asarray(knots, dtype=float).ravel()
    for i, xi in enumerate(knots, start=1):
        ax.axvline(xi, color=COLOR_KNOT, ls=":", lw=1.8)
        ax.text(xi, y.max() + 3.5, rf"$\xi_{i}$", color=COLOR_KNOT, ha="center", fontsize=13, fontweight="bold")
    bordes = np.concatenate([[x.min()], knots, [x.max()]])
    for i, nombre in enumerate(nombres_region):
        ax.text(0.5 * (bordes[i] + bordes[i + 1]), y.min() - 4.5, nombre, ha="center", va="top", fontsize=11, color=COLOR_VERDAD)
    ax.set_xlabel("X")
    ax.set_ylabel("f(X)")
    ax.set_title(titulo)
    ax.set_xlim(0, 24)
    ax.set_ylim(y.min() - 10, y.max() + 10)
    ax.set_yticks([])
    ax.grid(True, alpha=0.25, axis="x")
    _cerrar(fig)


def figura_histograma_knots(
    x, grupos_knots, n_bins=24,
    titulo_hist="", titulo_knots="", xlabel="Hora del día", xlim=(0, 24),
):
    """Dos paneles: arriba un histograma de X; abajo los mismos puntos y varios juegos de knots.

    grupos_knots = {"Uniformes": (valores, color, estilo), "Cuantiles": (...)}.
    """
    fig, axes = plt.subplots(2, 1, figsize=(9.5, 6.2), sharex=True)
    axes[0].hist(x, bins=n_bins, color=COLOR_DATOS, edgecolor="white")
    axes[0].set_ylabel("Cantidad de mediciones")
    axes[0].set_title(titulo_hist)
    axes[0].grid(True, alpha=0.25, axis="y")
    axes[1].scatter(x, np.zeros_like(x), c=COLOR_DATOS, s=14, alpha=0.45, label="Observaciones (eje X)")
    for nombre, (xs, color, estilo) in grupos_knots.items():
        for i, xi in enumerate(np.asarray(xs, dtype=float).ravel()):
            axes[1].axvline(xi, color=color, ls=estilo, lw=1.6, label=nombre if i == 0 else None)
    axes[1].set_yticks([])
    _eje(axes[1], titulo_knots, xlabel, xlim=xlim)
    axes[1].legend(frameon=False, loc="upper left")
    _cerrar(fig)


def figura_cv(valores, rmse, std, elegido=None, xlabel="n_knots", ylabel="RMSE de validación cruzada", titulo=""):
    """Figura completa: error de CV contra la complejidad, con barras de 1 desv. estándar y el valor elegido."""
    fig, ax = plt.subplots(figsize=(9.5, 4.8))
    ax.errorbar(
        valores, rmse, yerr=std, fmt="o-",
        color=COLOR_SPLINE, ecolor=COLOR_KNOT, capsize=4, lw=2.0, ms=8,
        label="RMSE CV (media ± 1 desv. estándar)",
    )
    if elegido is not None:
        idx = list(valores).index(elegido)
        ax.scatter(
            [elegido], [rmse[idx]], s=160, facecolors="none",
            edgecolors=COLOR_LINEAL, lw=2.2, zorder=5,
            label=f"Seleccionado: {xlabel} = {elegido}",
        )
        ax.axvline(elegido, color=COLOR_LINEAL, ls="--", lw=1.2, alpha=0.85)
        ax.annotate(
            "Mejor complejidad según CV",
            xy=(elegido, rmse[idx]),
            xytext=(elegido - 3.2, rmse[idx] + 3.5),
            fontsize=10, color=COLOR_LINEAL,
            arrowprops=dict(arrowstyle="->", color=COLOR_LINEAL, lw=1.2),
        )
    _eje(ax, titulo, xlabel, ylabel)
    ax.legend(frameon=False)
    _cerrar(fig)
Cuando una recta no alcanza
Vamos a construir un día de tráfico. La relación verdadera tiene dos picos —entrada y salida laboral— sobre un ritmo de fondo que sube y baja con suavidad. Encima hay ruido: no todos los martes se parecen, hay un accidente, un partido, una lluvia.
Tres cosas importan de este diseño. Primera: la curva no es una recta ni un arco suave de un solo máximo. Segunda: conocemos la función que genera los datos, así que más adelante podrás juzgar si el modelo recuperó la forma o solo recorrió los puntos. Tercera: el ruido existe; un modelo que pase exactamente por cada observación estará memorizando el martes, no el patrón.
La pregunta de esta sección todavía no es “qué modelo usar”. Es más simple: ¿una recta puede contar esta historia?
Generar el día de tráfico y mirar los puntos
Ciento ochenta mediciones a lo largo del día, con la curva verdadera dibujada solo como referencia didáctica. En un problema real esa curva no la tienes: por eso el modelo tiene que inferirla.
# Generamos un dataset sintético para representar un patrón de tráfico con dos horas pico.
# La idea es construir una relación no lineal y luego añadir ruido para simular variabilidad real.
# La función 'flujo_verdadero' representa la curva teórica del fenómeno, pero en la práctica
# no la vemos: el modelo debe inferirla a partir de las observaciones ruidosas.

def flujo_verdadero(hora):
    """Vehículos por minuto en función de la hora del día."""
    # Componente suave de fondo: el flujo sube y baja durante el día.
    ritmo_base = 24 + 7 * np.sin((hora - 5) * np.pi / 12)
    # Dos picos locales: uno por la mañana y otro por la tarde.
    pico_manana = 80 * np.exp(-0.5 * ((hora - 8.0) / 0.95) ** 2)
    pico_tarde = 92 * np.exp(-0.5 * ((hora - 18.2) / 1.15) ** 2)
    return ritmo_base + pico_manana + pico_tarde


# 180 observaciones distribuidas uniformemente en el rango del día, con ruido gaussiano.
# La variable 'hora' será la entrada X, y 'flujo' la variable objetivo y.
n = 180
hora = np.sort(rng.uniform(0.4, 23.6, size=n))
flujo = flujo_verdadero(hora) + rng.normal(0, 6.5, size=n)

# Preparamos las matrices para trabajar con sklearn.
# En este caso, X tiene una sola columna: la hora del día.
X = hora.reshape(-1, 1)
y = flujo.copy()

# Creamos una grilla fina para dibujar la curva de predicción sobre todo el eje X.
x_grid = np.linspace(hora.min(), hora.max(), 400)
X_grid = x_grid.reshape(-1, 1)
y_real_grid = flujo_verdadero(x_grid)

# Resumen del dataset generado.
print(f"Observaciones: {n}")
print(f"Hora mínima: {hora.min():.2f}  |  hora máxima: {hora.max():.2f}")
print(f"Flujo medio: {y.mean():.1f} vehículos/min")

figura_nube(
    hora, y,
    x_linea=x_grid, y_linea=y_real_grid,
    titulo="El flujo vehicular cambia de régimen a lo largo del día",
)
Observaciones: 180
Hora mínima: 0.57 | hora máxima: 23.42
Flujo medio: 46.0 vehículos/min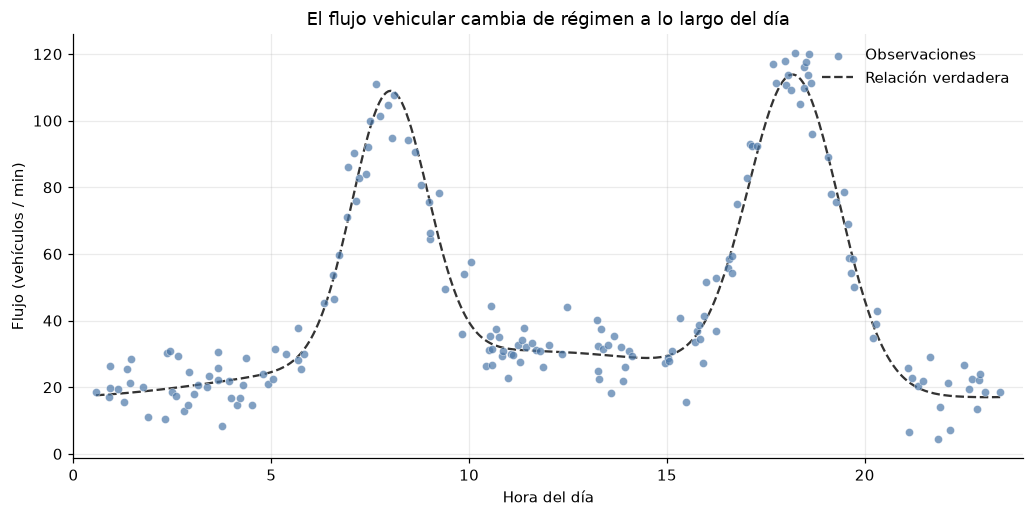
Cómo leer este resultado
No estás viendo una nube con pendiente. Estás viendo dos montañas y un valle entre ellas. Si tu modelo solo puede dibujar una recta, va a tener que atravesar las dos montañas como si fueran ruido alrededor de una media. El patrón está a la vista; la recta no tiene permiso para seguirlo.
Esa es la distinción que importa: los datos no son “ruidosos y sin estructura”. Tienen una estructura que el modelo lineal no puede nombrar.
Ajustar la recta que ya conoces
Misma herramienta del primer artículo de la serie: \(y = \beta_0 + \beta_1 x + \varepsilon\). Las métricas también son las de siempre. Gracias a los artículos de evaluación sabemos medir el error. Ahora hay que preguntarse por qué aparece.
modelo_lineal = LinearRegression()  # instancia el modelo
modelo_lineal.fit(X, y)
pred_lineal = modelo_lineal.predict(X)
pred_lineal_grid = modelo_lineal.predict(X_grid)

print(
    f"Intercepto = {modelo_lineal.intercept_:.2f}  |  "
    f"pendiente = {modelo_lineal.coef_[0]:.3f} vehículos/min por hora"
)
metricas_regresion(y, pred_lineal, "Regresión lineal (ajuste in-sample)")

figura_curvas(
    hora, y, x_grid,
    curvas={"Regresión lineal": pred_lineal_grid},
    y_verdad=y_real_grid,
    colores=[COLOR_LINEAL],
    titulo="Una recta no distingue las horas pico",
)
Intercepto = 31.89 | pendiente = 1.192 vehículos/min por hora
Regresión lineal (ajuste in-sample)
MAE = 24.500
RMSE = 30.217
R² = 0.062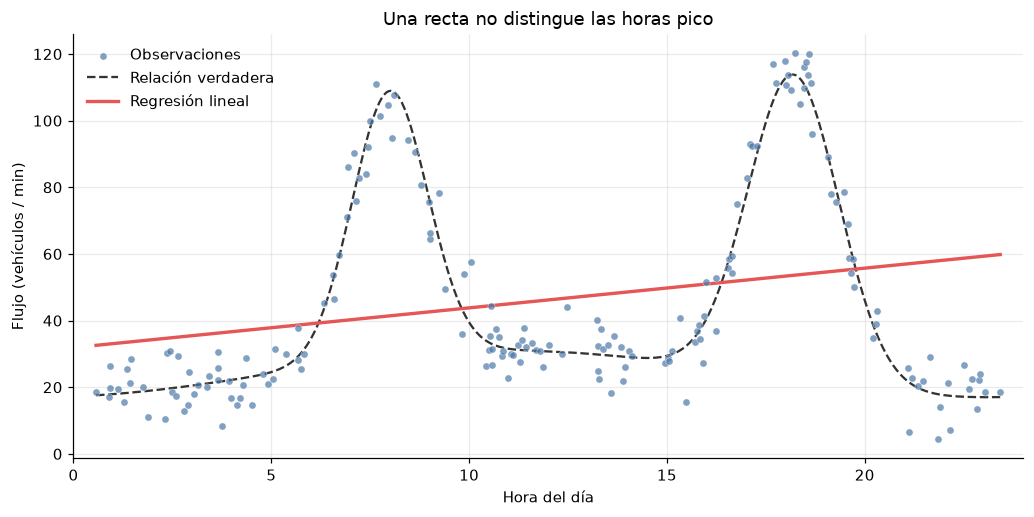
Cómo leer este resultado
Con este dataset, la recta que acabas de ajustar tiene la forma
\[ \hat{y} = \beta_0 + \beta_1 x \]
Los números concretos salen en la celda anterior: un intercepto de 31.89 vehículos por minuto y una pendiente de 1.192 vehículos por minuto por hora. Sobre el rango observado (de las 0:34 a las 23:25), esa pendiente hace subir la recta unos 27 vehículos por minuto, de ~33 a ~60. Eso resume todo el día en una sola tendencia global, que sube porque el pico de la tarde es más alto y más ancho que el de la mañana. El flujo sube hacia cada pico y vuelve a bajar después; esas subidas y bajadas se compensan en buena parte, y la pendiente solo recoge esa tendencia leve. La pendiente no es incorrecta de forma matemática; lo que está mal es la forma funcional. El modelo no está “detectando que la hora casi no importa”: está obligado a decir que importa siempre igual, y con esa obligación lo único que puede contar es una tendencia promedio. La relación real tiene un fondo suave, un pico de la mañana y un pico de la tarde, y una sola recta no puede representar esos cambios locales sin promediarlos.
Las métricas que imprimiste cuentan la misma historia:
- MAE cerca de 25: en promedio, cada predicción se equivoca en unos 25 vehículos por minuto. Como la variable objetivo está en esas mismas unidades, el número se lee directo. Un error típico de ese tamaño significa que, incluso en el mejor caso del ajuste global, la recta falla en una fracción grande del flujo de cada instante.
- RMSE cerca de 30: el error cuadrático amplifica los errores más grandes, por eso suele ser mayor que el MAE. Esos errores grandes aparecen en los picos de la mañana y la tarde, donde la recta subestima o sobreestima mucho más que el promedio. RMSE te dice: la peor parte del error es alta y no se puede ignorar.
- \(R^2\) cerca de 0.06: solo explica alrededor del 6% de la variación total. Es decir, la recta no captura la estructura del fenómeno y predice casi igual que la media del flujo (una línea horizontal). Un valor tan bajo indica que la relación no es lineal ni estable en todo el día.
En pocas palabras: MAE y RMSE miden cuánto se equivoca el modelo; \(R^2\) mide cuánto de la variación real logra explicar. Aquí se equivoca bastante y explica muy poco. El \(R^2\) de 0.062 no es un problema de métrica, sino el síntoma de un modelo cuya forma no coincide con el fenómeno; el gráfico te dice dónde se concentra el error: en los dos picos, exactamente donde a un operador de tráfico le importaría acertar.
En los artículos de evaluación aprendiste que un error grande puede ser sobreajuste, subajuste o simple azar de la partición. Aquí todavía ni siquiera hemos salido del ajuste dentro de la muestra (in-sample: el error se mide sobre los mismos datos con los que se ajustó) y el error ya es enorme. La recta no falla porque el ruido sea enorme ni porque hayamos evaluado mal: falla porque no es el objeto correcto.
Antes de seguir, pregúntate
- Si la recta explica apenas el 6% de la variación, ¿significa que la hora no importa para el tráfico?
- El \(R^2\) que acabas de ver, ¿está cerca de 0 porque hay mucho ruido o porque el modelo está mal especificado?
- ¿En qué regiones del día la recta se equivoca de forma sistemática —siempre por encima o siempre por debajo— y no de forma aleatoria?
Los residuos cuentan la misma historia
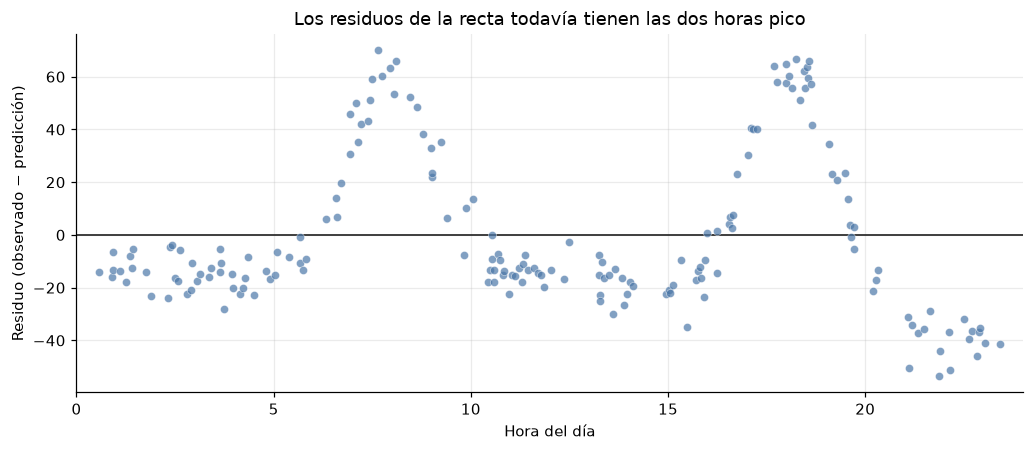
Si el modelo estuviera bien especificado, los residuos no deberían guardar la forma de las horas pico. Vamos a comprobarlo.
residuos_lineal = y - pred_lineal  # residuo = observado − predicción

figura_residuos(
    hora, residuos_lineal,
    titulo="Los residuos de la recta todavía tienen las dos horas pico",
)
Cómo leer estos residuos
Los residuos no forman una nube aleatoria alrededor de cero. Tienen una estructura clara en función de la hora: son positivos en los dos picos, negativos en la madrugada, el mediodía y la noche, y el signo cambia justo donde cambia el patrón del tráfico. La recta no está ignorando el tráfico: está forzando una forma demasiado rígida y deja toda la estructura en los residuos, que repiten la forma de la señal que intentamos explicar. Eso no es ruido, sino la firma de un modelo mal especificado: el problema es la elección de la función. Necesitamos permitir que la predicción se curve.
Un buen modelo deja residuos sin patrón: dispersos alrededor de cero, sin tendencia, sin curvatura ni picos repetidos. Si los residuos siguen la forma del fenómeno original, entonces el modelo está dejando la estructura en el error y no está capturando bien la relación.
Regresión polinómica: curvar sin salir de la regresión lineal
La primera ampliación natural es permitir potencias de \(X\):
\[ y = \beta_0 + \beta_1 x + \beta_2 x^2 + \cdots + \beta_p x^p + \varepsilon \]
Fíjate en lo que no cambió. Los parámetros \(\beta_0,\ldots,\beta_p\) siguen entrando de forma lineal. Si llamas \(z_1 = x\), \(z_2 = x^2\), \(\ldots\), \(z_p = x^p\), esto es una regresión lineal múltiple sobre variables derivadas (features). Por eso se estima con el mismo LinearRegression de siempre: el truco está en expandir \(X\), no en cambiar el motor de estimación.
Lo que sí cambió es la forma que el modelo puede dibujar. Grado 1 es la recta. Grado 2 puede hacer un arco. Grado 3 puede tener un máximo y un mínimo. Cada grado extra añade un posible cambio de curvatura.
La pregunta que debes tener en la cabeza no es “¿cuál se ve más bonito?”. Es: ¿qué está haciendo realmente este modelo en todo el dominio a la vez?
| Grado | Forma típica | Qué puede representar |
|---|---|---|
| 1 | línea recta | tendencia global constante |
| 2 | arco | una sola curvatura, como una U o una montaña |
| 3 | dos cambios de dirección | un máximo y un mínimo |
| 4 | más flexibilidad | varios cambios de pendiente sin llegar a ser muy oscilatorio |
| 5 | curva más compleja | más detalles locales, pero también más riesgo de sobreajuste |
Este cuadro resume la idea: a medida que aumenta el grado, la curva gana libertad para seguir la forma real de los datos, pero también se vuelve más sensible al ruido.
Miremos un ejemplo pequeño para ver qué hace esta transformación. Si empezamos con una sola variable \(x\), PolynomialFeatures crea nuevas columnas con \(x\), \(x^2\) y \(x^3\) para que el modelo pueda aprender una curva.
El parámetro degree dice hasta qué potencia se expandirá la variable. Si degree=2, la base es \([x, x^2]\); si degree=3, la base es \([x, x^2, x^3]\). Un grado mayor da más libertad para doblar la curva, pero también aumenta el riesgo de sobreajustar.
Por otra parte, include_bias=False evita añadir una columna de 1 al inicio. Esto es útil porque en muchos pipelines el modelo ya incluye un intercepto por sí mismo. Si se incluyera un término constante en la matriz de diseño, estaríamos duplicando ese término.
from sklearn.preprocessing import PolynomialFeatures

x = np.array([1, 2, 3, 4]).reshape(-1, 1)

for grado in [2, 3]:
    poly = PolynomialFeatures(degree=grado, include_bias=False)
    X_poly = poly.fit_transform(x)
    print(f"Grado {grado}:")
    print(np.round(X_poly, 3))
    print()

# Con grado 2 cada fila se vuelve [x, x^2].
# Con grado 3 cada fila se vuelve [x, x^2, x^3].
# Más potencia = más flexibilidad para capturar curvatura, pero también más riesgo de
# ajustar ruido en lugar de tendencia real.
Grado 2:
[[ 1. 1.]
[ 2. 4.]
[ 3. 9.]
[ 4. 16.]]
Grado 3:
[[ 1. 1. 1.]
[ 2. 4. 8.]
[ 3. 9. 27.]
[ 4. 16. 64.]]
El problema de una única función para todo el dominio
Un polinomio global usa la misma fórmula para todo el dominio de \(x\). Eso es importante porque si la relación real tiene dos picos distintos, ese mismo modelo debe intentar acomodarlos con la misma forma matemática en todas partes.
A medida que sube el grado, la curva gana flexibilidad, pero también puede volverse más inestable. No es una falla de programación ni un error de Python: es la naturaleza de una sola función global tratando de explicar varias zonas distintas del dominio.
Subir el grado con calma: 1, 2 y 3
Tres paneles, no todas las curvas encimadas en uno. En cada uno, la misma nube, la misma curva verdadera y un solo polinomio. PolynomialFeatures fabrica las columnas \(x, x^2, \ldots\); LinearRegression estima los \(\beta\). El StandardScaler que va en el medio no cambia la idea: evita que \(x^p\) explote numéricamente cuando la hora está en una escala de 0 a 24.
El Pipeline de la celda siguiente no es un atajo de programación: es la receta de esos tres pasos pegados. Escala, expande a potencias y estima los \(\beta\) como un solo objeto. Así, fit y predict recorren la misma cadena y no se te olvida escalar a la hora de predecir. Seguimos usando regresión lineal, pero ya no sobre una sola variable, sino sobre una expansión polinómica de la entrada. Eso es lo que permite doblar la curva sin cambiar el algoritmo base.
Si la entrada original es una sola columna \(x\), entonces para grado \(p\) la matriz construida es:
\[ X_p = \begin{bmatrix} x_1 & x_1^2 & x_1^3 & \cdots & x_1^p \\ x_2 & x_2^2 & x_2^3 & \cdots & x_2^p \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ x_n & x_n^2 & x_n^3 & \cdots & x_n^p \end{bmatrix} \]
Y la predicción sigue siendo una regresión lineal sobre esa matriz:
\[ \hat{y} = \beta_0 + \beta_1 x + \beta_2 x^2 + \cdots + \beta_p x^p \]
El cambio no está en el algoritmo, sino en la representación de la entrada. Antes teníamos solo una columna; ahora tenemos varias columnas que codifican la curvatura. Esa es la idea que permite aproximar una relación no lineal con una estructura lineal en los parámetros.
# Tres grados, uno por uno. No buscamos un ganador: queremos ver qué forma
# puede cada uno y si alcanza para dos picos. Los tres son UNA fórmula
# para todo el día.

# El Pipeline es una tubería: cada paso recibe la salida del anterior.
#
#   hora (X)
#      → StandardScaler          (x − media) / desv.   →  X_escalada
#      → PolynomialFeatures      [x, x², …, xᵖ]        →  X_polinómica
#      → LinearRegression        estima los β          →  ŷ
#
# PolynomialFeatures no ve la hora cruda (0 a 24): ve la hora ya escalada.
# Si x³ se fabricara antes, 24³ = 13824 aplastaría a x.
# include_bias=False: LinearRegression ya trae el intercepto.
#
# fit recorre la cadena y cada paso aprende lo suyo (media y desv.; luego β).
# predict recorre la misma cadena con datos nuevos.


paneles = {}  # título de cada panel → su predicción en la malla


# Grado 1: una recta. Una pendiente para las 24 horas.
modelo_g1 = Pipeline(
    [
        ("escala", StandardScaler()),  # centra y escala la hora
        ("poly", PolynomialFeatures(degree=1, include_bias=False)),  # columnas: x
        ("modelo", LinearRegression()),  # estima β0 y β1
    ]
)
modelo_g1.fit(X, y)
_, rmse_g1, r2_g1 = metricas_regresion(
    y, modelo_g1.predict(X), "Polinomio grado 1 (in-sample)"
)
paneles[f"Grado 1  |  RMSE={rmse_g1:.1f}  $R^2$={r2_g1:.2f}"] = modelo_g1.predict(X_grid)


# Grado 2: un arco. Tiene a lo sumo un pico, así que no puede formar los dos.
modelo_g2 = Pipeline(
    [
        ("escala", StandardScaler()),  # misma hora escalada que en el grado 1
        ("poly", PolynomialFeatures(degree=2, include_bias=False)),  # columnas: x, x²
        ("modelo", LinearRegression()),  # estima β0, β1 y β2
    ]
)
modelo_g2.fit(X, y)
_, rmse_g2, r2_g2 = metricas_regresion(
    y, modelo_g2.predict(X), "Polinomio grado 2 (in-sample)"
)
paneles[f"Grado 2  |  RMSE={rmse_g2:.1f}  $R^2$={r2_g2:.2f}"] = modelo_g2.predict(X_grid)


# Grado 3: en este rango, un solo máximo. Se acerca, pero sigue siendo un cubo
# global: no trata cada hora pico por separado.
modelo_g3 = Pipeline(
    [
        ("escala", StandardScaler()),  # otra vez: escala primero, potencias después
        ("poly", PolynomialFeatures(degree=3, include_bias=False)),  # columnas: x, x², x³
        ("modelo", LinearRegression()),  # estima β0, β1, β2 y β3
    ]
)
modelo_g3.fit(X, y)
_, rmse_g3, r2_g3 = metricas_regresion(
    y, modelo_g3.predict(X), "Polinomio grado 3 (in-sample)"
)
paneles[f"Grado 3  |  RMSE={rmse_g3:.1f}  $R^2$={r2_g3:.2f}"] = modelo_g3.predict(X_grid)


figura_paneles(
    hora,  # eje X de las observaciones (la hora)
    y,  # eje Y de las observaciones (el flujo)
    x_grid,  # grilla fina: ahí se dibujan las curvas, no en los puntos
    paneles,  # título de cada cuadro y su predicción ya calculada
    y_verdad=y_real_grid,  # relación verdadera, punteada, para comparar formas
    colores=[COLOR_POLI] * 3,  # el mismo color en los tres polinomios
    titulo_figura="Polinomios de grado bajo: todavía una sola onda para dos picos",  # título general
)
Polinomio grado 1 (in-sample)
MAE = 24.500
RMSE = 30.217
R² = 0.062
Polinomio grado 2 (in-sample)
MAE = 23.349
RMSE = 28.663
R² = 0.156
Polinomio grado 3 (in-sample)
MAE = 22.881
RMSE = 28.418
R² = 0.170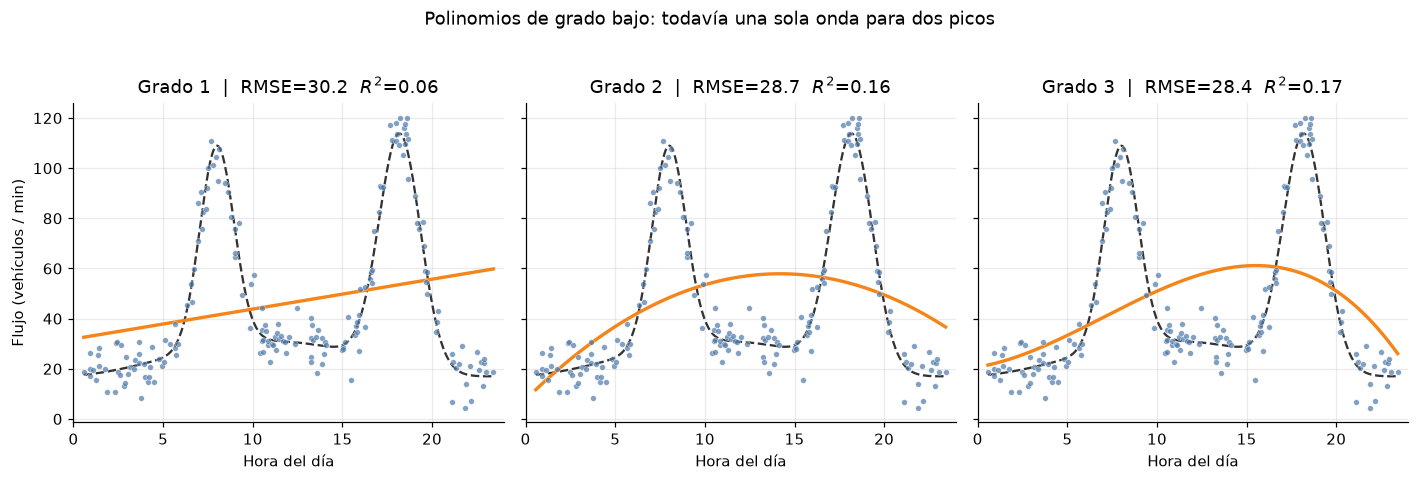
Cómo leer estos tres paneles
El grado 1 es la recta de antes (RMSE 30.2, \(R^2\) = 0.06). El grado 2 añade un arco, y con un solo máximo no puede servir a los dos picos: lo coloca hacia las 14 h, justo en el valle entre ellos (RMSE 28.7, \(R^2\) = 0.16). El grado 3 podría subir, bajar y volver a subir, pero en estos datos no le conviene: su curva tiene un único máximo, hacia las 15.5 h, y apenas mejora (RMSE 28.4, \(R^2\) = 0.17). Sigue siendo una función polinómica global, con muy pocos cambios de curvatura permitidos. Los dos picos afilados del tráfico no son un cubo suave. El modelo está intentando contar dos historias locales con un vocabulario demasiado pequeño.
Qué ocurre si aumentamos el grado
Grado 5, 10 y 12. Más parámetros, más permiso para doblarse. La tentación es creer que “más grado = más verdad”. Mira los extremos del día, no solo el centro.
# En la celda anterior escribiste la tubería a mano (grado 1, 2 y 3) para
# ver cada paso. A partir de aquí la misma tubería se usa muchas veces:
# grados altos, k-fold, comparación de modelos y el mini caso energético.
# Por claridad y reutilización, la metemos en una función: le pasas el
# grado y te devuelve el Pipeline listo para .fit() / .predict().
def pipeline_polinomico(grado):
    return Pipeline(
        [
            ("escala", StandardScaler()),
            ("poly", PolynomialFeatures(degree=grado, include_bias=False)),
            ("modelo", LinearRegression()),
        ]
    )


# Tres grados altos. El for solo cambia el número; el resto es idéntico.
grados_altos = [5, 10, 12]
paneles = {}
for grado in grados_altos:
    modelo = pipeline_polinomico(grado)
    modelo.fit(X, y)
    _, rmse, r2 = metricas_regresion(y, modelo.predict(X), f"Polinomio grado {grado} (in-sample)")
    paneles[f"Grado {grado}  |  RMSE={rmse:.1f}  $R^2$={r2:.2f}"] = modelo.predict(X_grid)

figura_paneles(
    hora, y, x_grid, paneles,
    y_verdad=y_real_grid,
    colores=[COLOR_POLI] * 3,
    titulo_figura="Más grado: mejor centro, peor conducta en los extremos",
)
Polinomio grado 5 (in-sample)
MAE = 19.006
RMSE = 23.779
R² = 0.419
Polinomio grado 10 (in-sample)
MAE = 11.269
RMSE = 13.663
R² = 0.808
Polinomio grado 12 (in-sample)
MAE = 9.619
RMSE = 11.645
R² = 0.861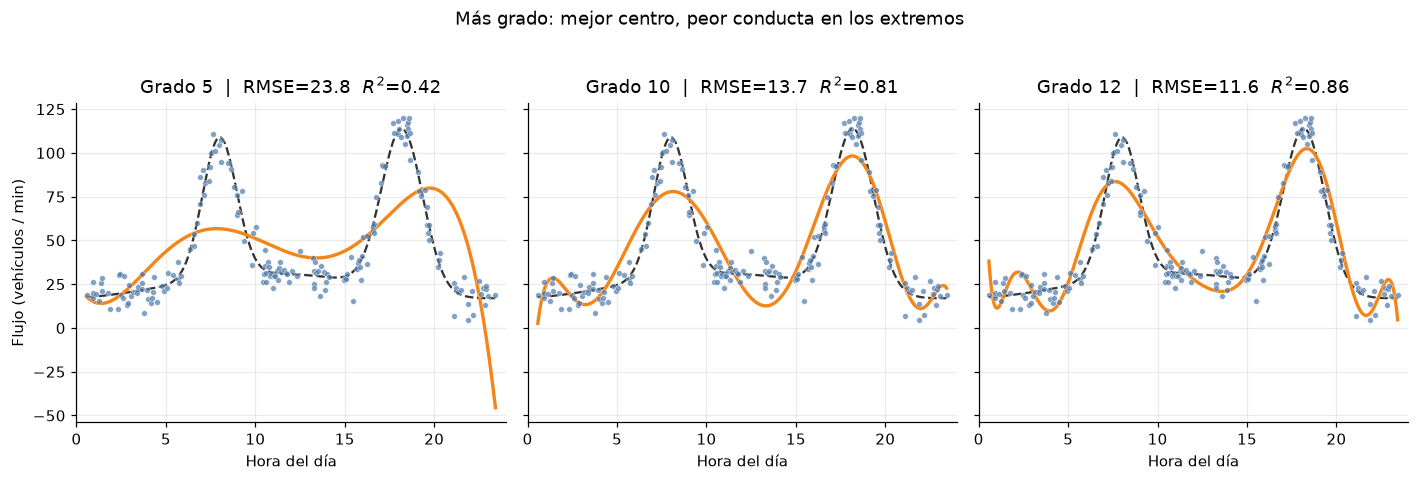
Antes de seguir, pregúntate
- ¿El RMSE in-sample más bajo corresponde al modelo que tú usarías para predecir las 23:30 de un día nuevo?
- ¿Qué está haciendo el polinomio de grado 12 entre las 0 y las 4, donde la curva verdadera es casi plana (de 17 a 22 vehículos por minuto) y los datos solo lo anclan desde un lado?
- Si un cambio de grado mejora el pico de las 8 pero estropea el valle de las 14, ¿quién “paga” ese arreglo?
Cómo leer este resultado
Al subir el grado, el polinomio gana flexibilidad y el error de entrenamiento baja: RMSE in-sample de 23.8 (grado 5), 13.7 (grado 10) y 11.6 (grado 12). Eso no es gratis. Un polinomio de grado alto es una función global: los mismos \(\beta\) tienen que servir para las 5 de la mañana y para las 6 de la tarde. Para clavar un pico afilado, la función necesita ondular; esas ondulaciones no se quedan en el pico, viajan por el resto del dominio. El síntoma típico es el vaivén en los extremos, donde la curva solo tiene vecinos de un lado que la anclen: el grado 5 se desploma hasta −45.6 vehículos por minuto a las 23:25 —un flujo negativo, imposible— y el grado 12 arranca en 38 a las 0:34, cuando la curva verdadera está cerca de 18.
Estás viendo tres regímenes de complejidad, los mismos de los artículos de regularización y de evaluación:
- bajo ajuste: grados 1–3, la forma no alcanza;
- ajuste razonable: un grado intermedio se acerca, con concesiones;
- exceso de flexibilidad: el modelo persigue el ruido y se porta mal donde no hay datos de más.
Más grado no es necesariamente un mejor modelo. Es un modelo distinto, con una factura que se paga en otro lado del eje \(X\).
El fenómeno de Runge: el polinomio oscila donde la función no lo hace
Eso que acabas de ver en el tráfico no es una falla de Python ni un accidente de estos datos. Tiene nombre: fenómeno de Runge.
Carl Runge mostró, a comienzos del siglo XX, un hecho incómodo: si interpolas o ajustas una función suave con un polinomio de grado cada vez más alto, sobre puntos igualmente espaciados, no es cierto que te acerques a la función. En el centro el ajuste puede mejorar. Cerca de los extremos la curva oscila y, al subir el grado, esas oscilaciones crecen. Más grado no implica más verdad: puede implicar peor conducta justo en los bordes.
La razón es geométrica, no computacional. Un polinomio de grado \(n\) es una sola función global: los mismos coeficientes \(\beta_0,\ldots,\beta_n\) tienen que servir en todo el intervalo. Para pasar cerca de muchos puntos del centro, la curva se ve obligada a compensar en los extremos, donde hay menos vecinos que la anclen. Esas ondulaciones no las pidió \(f\): las inventa el modelo.
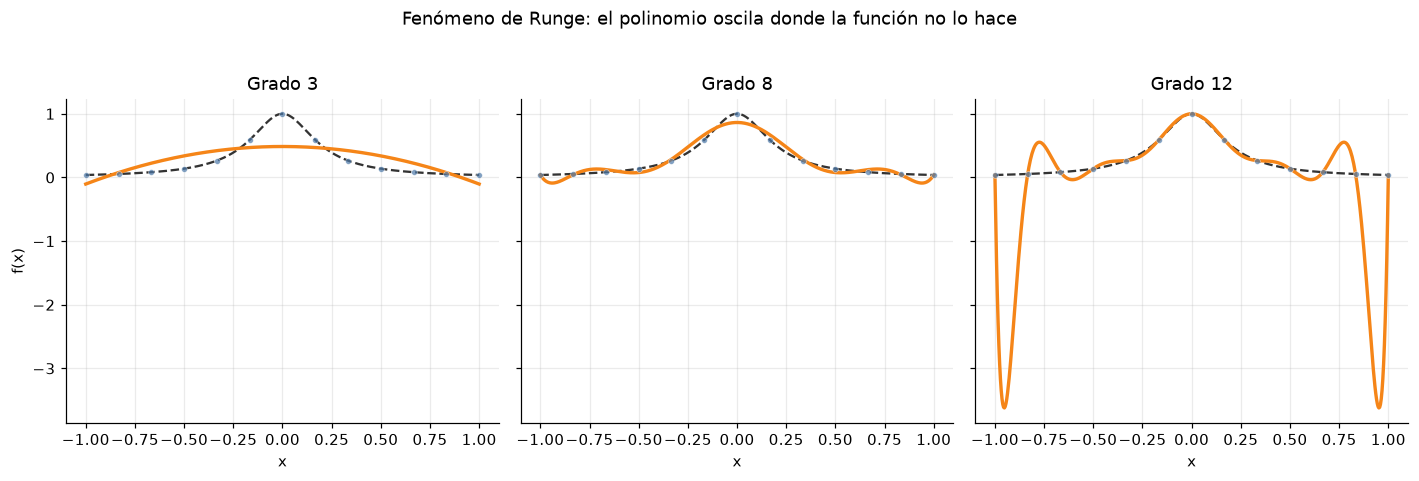
Un ejemplo clásico aísla la idea sin el ruido del tráfico. La función verdadera es suave: no tiene saltos, ni picos afilados, ni oscilaciones propias. Es una campana centrada en 0, con máximo 1, que decae de forma monótona hacia los extremos (en \(x=\pm 1\) vale \(1/26 \approx 0.04\)).
\[ f(x) = \frac{1}{1 + 25x^2}, \qquad x \in [-1, 1] \]
En la celda siguiente tomamos trece puntos igualmente espaciados de esta función, sin ruido, y les ajustamos polinomios de grado 3, 8 y 12. El centro se ajusta bien; los bordes oscilan, y como la función es suave, cualquier oscilación en los bordes la inventó el modelo. El grado no es un volumen que se sube sin consecuencias.
x_runge = np.linspace(-1, 1, 13)
y_runge = 1.0 / (1.0 + 25.0 * x_runge**2)
x_runge_fino = np.linspace(-1, 1, 500)
y_runge_real = 1.0 / (1.0 + 25.0 * x_runge_fino**2)
X_runge = x_runge.reshape(-1, 1)
X_runge_fino = x_runge_fino.reshape(-1, 1)

paneles = {}
for grado in [3, 8, 12]:
    modelo = Pipeline(
        [
            ("poly", PolynomialFeatures(degree=grado, include_bias=False)),
            ("modelo", LinearRegression()),
        ]
    )
    modelo.fit(X_runge, y_runge)
    paneles[f"Grado {grado}"] = modelo.predict(X_runge_fino)

figura_paneles(
    x_runge, y_runge, x_runge_fino, paneles,
    y_verdad=y_runge_real,
    colores=[COLOR_POLI] * 3,
    titulo_figura="Fenómeno de Runge: el polinomio oscila donde la función no lo hace",
    xlabel="x",
    ylabel="f(x)",
    xlim=None,
)
Cómo leer este resultado
El grado 3 se queda corto: aplana la campana y deja el pico en 0.49 cuando la función vale 1. El grado 8 se acerca en el centro (máximo 0.86) y ya muestra ondulaciones cerca de los bordes, que bajan hasta −0.09 aunque \(f\) nunca es negativa. El grado 12, con trece puntos, tiene exactamente un parámetro por observación (trece coeficientes, contando el intercepto): interpola los trece puntos sin error y, entre los dos últimos de cada lado, se hunde hasta −3.6, cuando la función verdadera no baja de 0.04. La función verdadera nunca pidió esa oscilación.
La enseñanza no es “prohibido usar polinomios”. Es más precisa: una sola función polinómica para todo el dominio acopla regiones que no deberían estar acopladas. Más grado \(\neq\) necesariamente mejor modelo.
Entonces la pregunta natural es otra.
Una idea más natural: dividir el problema
¿Y si, en lugar de obligar a una única función a explicar las 3 de la mañana y las 6 de la tarde, permitimos que diferentes regiones de \(X\) tengan comportamientos diferentes?
Eso es un polinomio por tramos: el dominio se corta en intervalos y en cada intervalo rige un polinomio propio. La flexibilidad deja de ser “subir el grado de todo el día” y pasa a ser “dónde permito que la historia cambie”.
Antes de ajustar nada, hay que nombrar esos cortes.
Qué es un knot
Los puntos de corte se llaman knots (nodos, puntos de corte). Los notamos
\[ \xi_1,\ \xi_2,\ \xi_3 \]
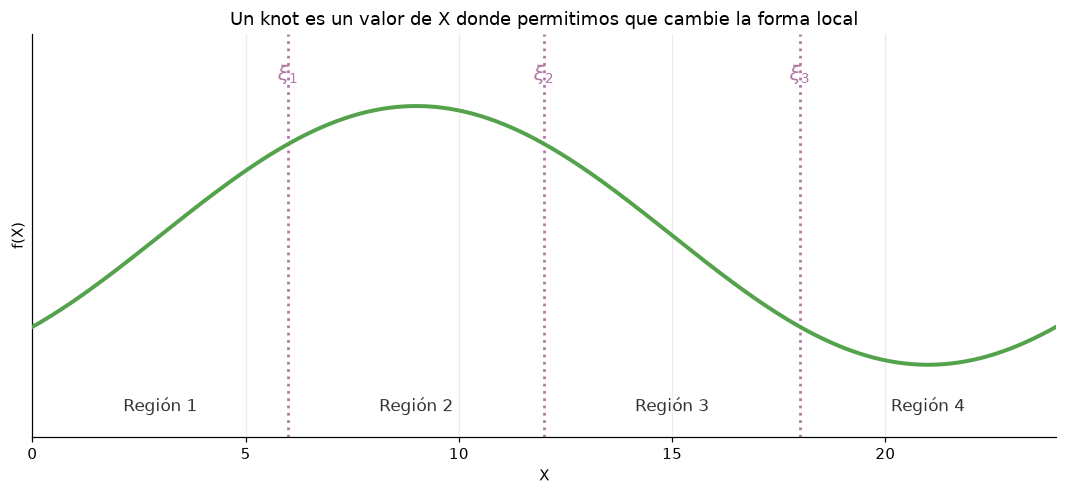
Con tres knots el eje \(X\) queda partido en cuatro regiones. La figura de abajo no busca ajustar tráfico: solo enseña esa geometría.
# Tres cortes → cuatro regiones. Esto es solo geometría: no ajustamos datos.
knots_esquema = np.array([6.0, 12.0, 18.0])

x_esquema = np.linspace(0, 24, 400)
# Curva ilustrativa, suave, sin saltos. Los knots no la "rompen": solo la marcan.
y_esquema = 40 + 18 * np.sin((x_esquema - 3) * np.pi / 12)

nombres_region = ["Región 1", "Región 2", "Región 3", "Región 4"]

figura_esquema_knots(
    x_esquema, y_esquema, knots_esquema,
    nombres_region=nombres_region,
    titulo="Un knot es un valor de X donde permitimos que cambie la forma local",
)
Cómo leer un knot
Los knots son valores de \(X\) donde permitimos que cambie la forma local de la función. Tres precisiones que no conviene olvidar:
- Un knot no tiene que coincidir con una observación. Es una decisión de diseño sobre el eje \(X\), no un punto especial de la muestra.
- Un knot no significa que la curva sea discontinua. Solo indica dónde el modelo puede cambiar de pieza.
- A la izquierda de \(\xi_k\) rige una forma; a la derecha, otra. Si esas formas se unen bien o mal es otro problema: el que viene ahora.
Polinomios por tramos
Con dos knots el modelo se escribe así:
\[ f(x)= \begin{cases} p_1(x), & x < \xi_1 \\[4pt] p_2(x), & \xi_1 \leq x < \xi_2 \\[4pt] p_3(x), & x \geq \xi_2 \end{cases} \]
Cada \(p_i(x)\) es un polinomio y gobierna solo su región. Los knots \(\xi_i\) separan esas regiones.
Si estimamos cada \(p_i\) de manera independiente, nada garantiza que las piezas coincidan en los knots. Eso todavía no es un spline: es flexibilidad local cruda.
Volviendo al tráfico: los tres cortes del esquema eran solo para ver la geometría; para el experimento bastan dos knots, \(\xi_1=8\) y \(\xi_2=17\), que parten el día en madrugada, jornada y noche. En nuestras horas queda así:
\[ f(x)= \begin{cases} p_1(x), & x < 8 \quad \text{(madrugada)} \\[4pt] p_2(x), & 8 \leq x < 17 \quad \text{(jornada)} \\[4pt] p_3(x), & x \geq 17 \quad \text{(noche)} \end{cases} \]
No hay un modelo nuevo: son tres LinearRegression, cada una solo con los puntos de su intervalo. Después las pegamos y miramos el empalme.
knots_demo = np.array([8.0, 17.0])  # cortes: madrugada | jornada | noche

# Región 1: misma LinearRegression de siempre, solo con horas < 8
m1 = hora < 8  # máscara: True/False por observación
modelo_madrugada = LinearRegression()  # recta: y = β0 + β1 x
modelo_madrugada.fit(X[m1], y[m1])  # X[m1] se queda solo con las filas True

# Región 2: 8 ≤ hora < 17. Los paréntesis son obligatorios.
m2 = (hora >= 8) & (hora < 17)  # & = "y" casilla por casilla
modelo_jornada = LinearRegression()
modelo_jornada.fit(X[m2], y[m2])  # esta recta no ve madrugada ni noche

# Región 3: hora ≥ 17
m3 = hora >= 17
modelo_noche = LinearRegression()
modelo_noche.fit(X[m3], y[m3])

# Hasta aquí solo hay tres modelos ajustados; falta predecir en la malla para dibujarlos.

# Predicción en la grilla fina: cada hora usa SOLO la recta de su región
pred_tramos_grid = np.full(x_grid.shape, np.nan)  # vector vacío (NaN) del tamaño de la grilla
pred_tramos_grid[x_grid < 8] = modelo_madrugada.predict(X_grid[x_grid < 8])  # tramo 1
pred_tramos_grid[(x_grid >= 8) & (x_grid < 17)] = modelo_jornada.predict(
    X_grid[(x_grid >= 8) & (x_grid < 17)]
)  # tramo 2
pred_tramos_grid[x_grid >= 17] = modelo_noche.predict(X_grid[x_grid >= 17])  # tramo 3

# Lo mismo sobre las observaciones, para MAE / RMSE / R²
pred_tramos_obs = np.full(hora.shape, np.nan)
pred_tramos_obs[m1] = modelo_madrugada.predict(X[m1])
pred_tramos_obs[m2] = modelo_jornada.predict(X[m2])
pred_tramos_obs[m3] = modelo_noche.predict(X[m3])

piezas_lineales = [(0.0, 8.0), (8.0, 17.0), (17.0, 24.0)]  # para no unir el salto con una línea

figura_curvas(
    hora,  # eje X de las observaciones
    y,  # flujo observado
    x_grid,  # grilla donde se dibujan las tres rectas
    curvas={"Recta por tramos": pred_tramos_grid},  # las tres predicciones ya pegadas
    knots=knots_demo,  # verticales en 8 y 17
    trozos=piezas_lineales,  # pinta cada tramo aparte: así se ve el salto
    colores=[COLOR_POLI],
    titulo="Tres rectas independientes: la predicción puede saltar en el knot",
)

# Primero TODO el día: las tres predicciones pegadas, no una zona sola.
_ = metricas_regresion(y, pred_tramos_obs, "Tres rectas pegadas — todo el día (in-sample)")

# Ahora POR ZONA: cada recta solo contra los puntos de su intervalo.
_ = metricas_regresion(y[m1], pred_tramos_obs[m1], "Solo madrugada (hora < 8)")
_ = metricas_regresion(y[m2], pred_tramos_obs[m2], "Solo jornada (8 ≤ hora < 17)")
_ = metricas_regresion(y[m3], pred_tramos_obs[m3], "Solo noche (hora ≥ 17)")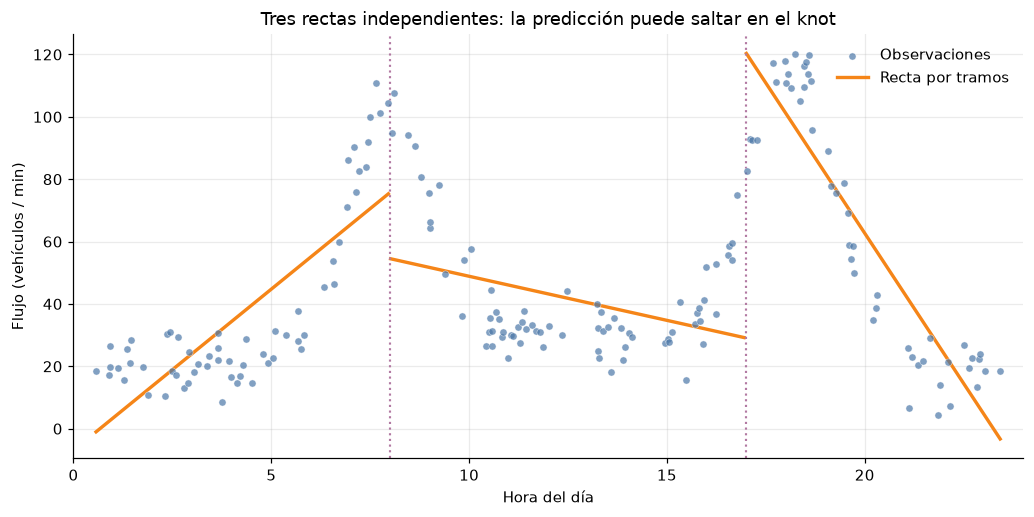
Tres rectas pegadas — todo el día (in-sample)
  MAE  = 14.779
  RMSE = 17.556
  R²   = 0.683
Solo madrugada (hora < 8)
  MAE  = 14.700
  RMSE = 16.949
  R²   = 0.633
Solo jornada (8 ≤ hora < 17)
  MAE  = 14.564
  RMSE = 18.141
  R²   = 0.136
Solo noche (hora ≥ 17)
  MAE  = 15.190
  RMSE = 17.402
  R²   = 0.814
Antes de seguir, pregúntate
Los modelos locales pueden ajustar bien cada región. Pero ¿qué ocurre exactamente en los puntos donde una región termina y comienza la siguiente?
En el gráfico, busca \(\xi_1\) y \(\xi_2\). ¿La predicción llega al corte con el mismo valor desde la izquierda y desde la derecha? Si un vehículo pasa de las 7:59 a las 8:01, ¿el modelo tiene derecho a cambiarle el flujo de golpe?
Esa pregunta es la antesala del spline. Todavía no lo definas: míralo en la figura.
Cómo leer este resultado
Cada pieza puede ser razonable dentro de su región. El problema aparece en el empalme. En la figura, a las 8:00 la recta de la madrugada llega a ~76 vehículos por minuto y la de la jornada arranca en ~55; a las 17:00 el salto es mayor, de ~29 a ~120. Un salto significa que el modelo trata el knot como una pared: a las 7:59 una historia, a las 8:01 otra. Las métricas también muestran el costo de cortar mal: la recta de la jornada tiene \(R^2\) = 0.136, porque el knot de las 17 cae antes del pico de la tarde y la subida de las 16–17 h queda dentro de un tramo que la recta no puede seguir. En un fenómeno continuo eso no es flexibilidad, es un artefacto de estimar las piezas por separado.
La idea de partir el dominio era correcta. Faltaba una restricción: las piezas tienen que reunirse bien.
Splines: polinomios por tramos que se conectan suavemente
Un spline es un polinomio por tramos con condiciones de continuidad en los knots: las piezas no se estiman sueltas, están obligadas a coincidir en valor, pendiente y —si el grado alcanza— curvatura. El más usado —y el foco de este artículo— es el cúbico, porque cada región es un polinomio de grado 3: alcanza para imponer continuidad de \(f\), \(f'\) y \(f''\) y la curva se siente de una pieza, sin las ondulaciones de un grado más alto.
Eso tiene nombre. Se dice que una función es \(C^k\) si es continua y se puede derivar \(k\) veces, y esas \(k\) derivadas también son continuas. El superíndice no es un adorno: es cuántas capas de suavidad pides en el knot.
- \(C^0\): coincide \(f\). Puedes dibujar la curva sin levantar el lápiz. En el knot todavía puede haber una esquina (la pendiente cambia de golpe).
- \(C^1\): coinciden \(f\) y \(f'\). Ya no hay esquina: el flujo y el ritmo al que sube o baja se entregan juntos.
- \(C^2\): coinciden \(f\), \(f'\) y \(f''\). Tampoco hay quiebre de curvatura: la curva no cambia de carácter de golpe al cruzar el corte.
El spline cúbico es \(C^2\). En el tráfico, a las 8:00, la madrugada le entrega a la jornada el mismo caudal, la misma pendiente y el mismo arqueo. Un vehículo no nota el knot.
“Costura” no es el nombre técnico: sirve como imagen. En la literatura se habla de condiciones de continuidad o de empalme en los knots, y de condiciones de frontera en los extremos del intervalo.
Acabas de ver por qué hace falta: partir el día era la idea correcta, pero estimar cada pieza por su lado produce un salto en el knot.
Por qué se llama cúbico
El apellido no viene de que haya tres knots ni tres modelos. Viene del grado de cada pieza.
Recuerda la familia:
- grado 1: una recta, \(p(x)=\beta_0+\beta_1 x\)
- grado 2: una parábola, \(p(x)=\beta_0+\beta_1 x+\beta_2 x^2\)
- grado 3: un cúbico, \(p(x)=\beta_0+\beta_1 x+\beta_2 x^2+\beta_3 x^3\)
Un spline cúbico es esto: en cada región vive un polinomio de grado 3. En el tráfico, con \(\xi_1=8\) y \(\xi_2=17\), escribimos primero las tres piezas y, de una vez, sus derivadas. Todavía no imponemos nada: son doce coeficientes libres.
Las tres piezas: \(f\), \(f'\) y \(f''\)
\[ \begin{aligned} p_1(x) &= a_1+b_1 x+c_1 x^2+d_1 x^3, && 0\leq x<8,\\ p_2(x) &= a_2+b_2 x+c_2 x^2+d_2 x^3, && 8\leq x<17,\\ p_3(x) &= a_3+b_3 x+c_3 x^2+d_3 x^3, && 17\leq x\leq 24. \end{aligned} \]
La curva del día es \(f(x)=p_i(x)\) en cada tramo. Derivando término a término —la misma receta en las tres regiones— obtienes la pendiente y la curvatura:
\[ p_i'(x)=b_i+2c_i x+3d_i x^2, \qquad p_i''(x)=2c_i+6d_i x, \qquad i=1,2,3. \]
Escrito por tramos, para no perder de vista qué vive en cada región:
\[ f(x)= \begin{cases} a_1+b_1 x+c_1 x^2+d_1 x^3, & 0\leq x<8 \\[4pt] a_2+b_2 x+c_2 x^2+d_2 x^3, & 8\leq x<17 \\[4pt] a_3+b_3 x+c_3 x^2+d_3 x^3, & 17\leq x\leq 24 \end{cases} \]
\[ f'(x)= \begin{cases} b_1+2c_1 x+3d_1 x^2, & 0\leq x<8 \\[4pt] b_2+2c_2 x+3d_2 x^2, & 8\leq x<17 \\[4pt] b_3+2c_3 x+3d_3 x^2, & 17\leq x\leq 24 \end{cases} \]
\[ f''(x)= \begin{cases} 2c_1+6d_1 x, & 0\leq x<8 \\[4pt] 2c_2+6d_2 x, & 8\leq x<17 \\[4pt] 2c_3+6d_3 x, & 17\leq x\leq 24 \end{cases} \]
En el tráfico: \(f\) es el flujo, \(f'\) cuánto sube o baja por hora, \(f''\) cómo se arquea esa pendiente. Cada tramo puede curvarse (tiene \(x^2\) y \(x^3\)). Si las dejáramos independientes, volveríamos al salto. El spline no las deja independientes: primero simplifica los extremos, después cose los knots.
Primero: condiciones de frontera
En \(x=0\) y \(x=24\) no hay otro tramo con el que empalmar. El spline cúbico natural (una de las variantes más usadas) pide curvatura nula en los extremos:
\[ f''(0)=0, \qquad f''(24)=0. \]
Sustituye en las segundas derivadas que ya tienes:
\[ p_1''(0)=2c_1=0 \implies c_1=0, \]
\[ p_3''(24)=2c_3+6d_3\cdot 24=2c_3+144d_3=0 \implies c_3=-72d_3. \]
Esas dos igualdades reducen las piezas de los extremos. El tramo del medio no toca la frontera, así que sigue con sus cuatro coeficientes. Queda
\[ \begin{aligned} p_1(x) &= a_1+b_1 x+d_1 x^3,\\ p_1'(x) &= b_1+3d_1 x^2,\\ p_1''(x) &= 6d_1 x, \end{aligned} \qquad \begin{aligned} p_3(x) &= a_3+b_3 x-72d_3 x^2+d_3 x^3,\\ p_3'(x) &= b_3-144d_3 x+3d_3 x^2,\\ p_3''(x) &= 6d_3(x-24). \end{aligned} \]
Lee las curvaturas simplificadas: \(p_1''(x)=6d_1 x\) empieza en cero a las 0:00 y cambia de forma lineal con \(x\) (crece en valor absoluto, con el signo de \(d_1\)); \(p_3''(x)=6d_3(x-24)\) llega a cero a las 24:00. No le pedimos un pico inventado a los extremos; el doblez extra se reserva para los knots del medio, donde el fenómeno sí cambia de régimen.
De doce coeficientes pasamos a diez: se fueron \(c_1\) y \(c_3\).
Después: condiciones de continuidad
En cada knot el cúbico de la izquierda y el de la derecha tienen que coincidir en \(f\), \(f'\) y \(f''\). En el tráfico eso se lee en vehículos por minuto, no en abstracto.
Empalme de las 8 — la madrugada le entrega el flujo a la jornada:
\[ \begin{aligned} p_1(8) &= p_2(8) && \text{mismo flujo a las 8:00} \\[4pt] p_1'(8) &= p_2'(8) && \text{el flujo sube o baja al mismo ritmo} \\[4pt] p_1''(8) &= p_2''(8) && \text{el flujo se arquea igual: no hay quiebre} \end{aligned} \]
Con \(p_1\) ya simplificado (\(c_1=0\)):
\[ \begin{aligned} a_1+8b_1+512d_1 &= a_2+8b_2+64c_2+512d_2,\\ b_1+192d_1 &= b_2+16c_2+192d_2,\\ 48d_1 &= 2c_2+48d_2. \end{aligned} \]
Si \(p_1(8)\neq p_2(8)\), a las 7:59 predices un caudal y a las 8:01 otro: un salto imposible. Si las pendientes no coinciden, el gráfico forma una esquina. Si fallan las curvaturas, la curva “cambia de carácter” de golpe al cruzar las 8.
Empalme de las 17 — la jornada le entrega el flujo a la noche:
\[ \begin{aligned} p_2(17) &= p_3(17) && \text{mismo flujo a las 17:00} \\[4pt] p_2'(17) &= p_3'(17) && \text{misma pendiente} \\[4pt] p_2''(17) &= p_3''(17) && \text{misma curvatura} \end{aligned} \]
Con \(p_3\) ya simplificado (\(c_3=-72d_3\)):
\[ \begin{aligned} a_2+17b_2+289c_2+4913d_2 &= a_3+17b_3-15895d_3,\\ b_2+34c_2+867d_2 &= b_3-1581d_3,\\ 2c_2+102d_2 &= -42d_3. \end{aligned} \]
Seis ecuaciones lineales sobre diez coeficientes. Quedan 4 grados de libertad: esos son los que se ajustan a la nube del tráfico por mínimos cuadrados. El resto del vector no es libre: lo amarran la frontera y la continuidad.
Fíjate en los números del empalme de las 17 (\(15895\), \(1581\)): salen de evaluar potencias \(17^2\), \(17^3\). Esa es la base monomial, y se pone fea rápido. Por eso, en la práctica, no armamos esta matriz a mano. SplineTransformer fabrica columnas que ya cumplen estas igualdades. En la siguiente celda solo eliges knots y grado, y LinearRegression estima los pesos.
Un spline lineal (grado 1 en cada tramo) solo pide continuidad de \(f\): puedes dibujarlo sin levantar el lápiz, pero en el knot puede quebrar. El cúbico pide \(f\), \(f'\) y \(f''\). Por eso se siente de una pieza aunque por debajo sean varios polinomios.
¿Por qué grado 3 y no 10? Un cúbico tiene cuatro números por región. Las condiciones de continuidad y de frontera gastan parte de ellos y dejan libertad para ajustar los datos sin volver a las ondulaciones del polinomio global. El cúbico es el equilibrio que buscamos en este artículo: flexible por regiones, \(C^2\) en los empalmes.
Un poco más abajo vas a ver las tres geometrías juntas: salto, esquina o curva que se desliza. La idea que te tienes que llevar: flexibilidad local con continuidad \(C^2\).
Montar el spline cúbico, paso a paso
Sí: no hay que armar las columnas a mano. scikit-learn ya las calcula con SplineTransformer. Tú eliges el grado y los knots; él fabrica una base local que ya nace \(C^2\). Después, la de siempre: LinearRegression.
knots incluye los extremos del día. En el tráfico: \(0\), \(8\), \(17\) y \(24\). include_bias=False deja el intercepto en el modelo, como en el resto de la serie.
Vas a ver 5 columnas. Con el intercepto que agrega LinearRegression son 6 parámetros, no los 4 grados de libertad del spline natural que acabas de contar a mano (esos 4 ya incluían el intercepto: \(a_1\) estaba entre los diez coeficientes). La diferencia son justo las dos condiciones de frontera: SplineTransformer no impone \(f''(0)=f''(24)=0\), así que el conteo es \(12 - 6 = 6\) (doce coeficientes menos seis igualdades de continuidad). Lo que sí heredas es el empalme \(C^2\) en los knots.
bases = SplineTransformer(
    degree=3,  # cúbico: cada pieza es grado 3, empalme C²
    knots=np.array([[0.0], [8.0], [17.0], [24.0]]),  # extremos del día + cortes 8 y 17
    include_bias=False,  # el intercepto lo pone LinearRegression, no la base
)

X_spline = bases.fit_transform(X)  # fabrica las columnas B_j(hora) con los knots que le diste
print(f"Columnas que fabricó SplineTransformer: {X_spline.shape[1]}")  # cuántas bases salieron

# Arriba solo se construyen las bases del spline.

# abajo ajustamos los pesos

modelo_cubico = LinearRegression()  # la misma recta de siempre, ahora sobre las B_j
modelo_cubico.fit(X_spline, y)  # estima los pesos β_j

# El modelo no come horas crudas: come las columnas B_j. X_grid son horas de la
# grilla (0.57, 0.63, …). transform las convierte en las MISMAS bases, ya evaluadas
# ahí. Si hicieras modelo_cubico.predict(X_grid) fallaría: espera 5 columnas, no 1.
X_spline_grid = bases.transform(X_grid)
pred_cubico_paso_a_paso = modelo_cubico.predict(X_spline_grid)

figura_curvas(
    hora,  # eje X de las observaciones
    y,  # flujo observado
    x_grid,  # grilla donde se dibuja la curva
    curvas={"Spline cúbico": pred_cubico_paso_a_paso},  # predicción ya calculada
    y_verdad=y_real_grid,  # relación verdadera, punteada
    knots=knots_demo,  # verticales en 8 y 17
    colores=[COLOR_SPLINE],
    titulo="SplineTransformer arma las bases; LinearRegression estima los pesos",
)
Columnas que fabricó SplineTransformer: 5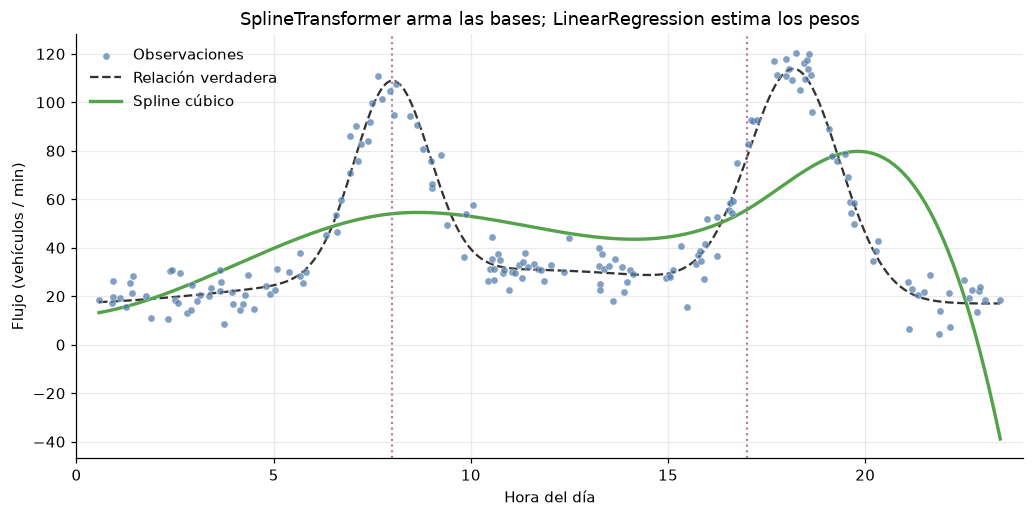
Ahora sí: comparar salto, esquina y curva suave
Ya montaste el cúbico con SplineTransformer. La pregunta es qué ganas frente a lo de antes.
Tres ajustes, mismos datos, mismos cortes \(8\) y \(17\):
- izquierda: las tres rectas sueltas (pueden saltar);
- centro: el mismo
SplineTransformer, ahora condegree=1(continuo, puede tener esquina); - derecha: el cúbico de la celda anterior (
degree=3).
No hay función nueva. Cambia solo el grado.
pred_salto = pred_tramos_grid  # las tres rectas sueltas de antes
pred_cubico_spline = pred_cubico_paso_a_paso  # el cúbico que acabas de ajustar

# Mismos knots, grado 1: continuo, puede quebrar (esquina)
bases_lin = SplineTransformer(
    degree=1,
    knots=np.array([[0.0], [8.0], [17.0], [24.0]]),
    include_bias=False,
)
modelo_lin_sp = LinearRegression()
modelo_lin_sp.fit(bases_lin.fit_transform(X), y)  # ajusta β sobre las bases lineales
pred_lineal_spline = modelo_lin_sp.predict(bases_lin.transform(X_grid))  # predice en la grilla

# ¿Cuánto cuesta la continuidad con solo dos knots? RMSE in-sample de los tres ajustes
rmse_tramos = np.sqrt(mean_squared_error(y, pred_tramos_obs))
rmse_lin_sp = np.sqrt(mean_squared_error(y, modelo_lin_sp.predict(bases_lin.transform(X))))
rmse_cub_sp = np.sqrt(mean_squared_error(y, modelo_cubico.predict(bases.transform(X))))
print(f"RMSE in-sample  |  tramos: {rmse_tramos:.3f}  |  spline lineal: {rmse_lin_sp:.3f}  |  spline cúbico: {rmse_cub_sp:.3f}")
print(f"Mínimo del spline cúbico en la malla: {pred_cubico_spline.min():.1f} vehículos/min")

figura_paneles(
    hora, y, x_grid,
    {
        "Tramos independientes\n(pueden saltar)": pred_salto,
        "Spline lineal\n(continuo, con esquinas)": pred_lineal_spline,
        "Spline cúbico\n(continuo en nivel, pendiente y curvatura)": pred_cubico_spline,
    },
    knots=knots_demo,
    trozos=piezas_lineales,  # para que el salto de la izquierda no se tape
    colores=[COLOR_POLI, COLOR_LINEAL, COLOR_SPLINE],
    titulo_figura="La diferencia no es partir el dominio: es cómo se unen las piezas",
)
RMSE in-sample | tramos: 17.556 | spline lineal: 27.569 | spline cúbico: 24.761
Mínimo del spline cúbico en la malla: -38.9 vehículos/min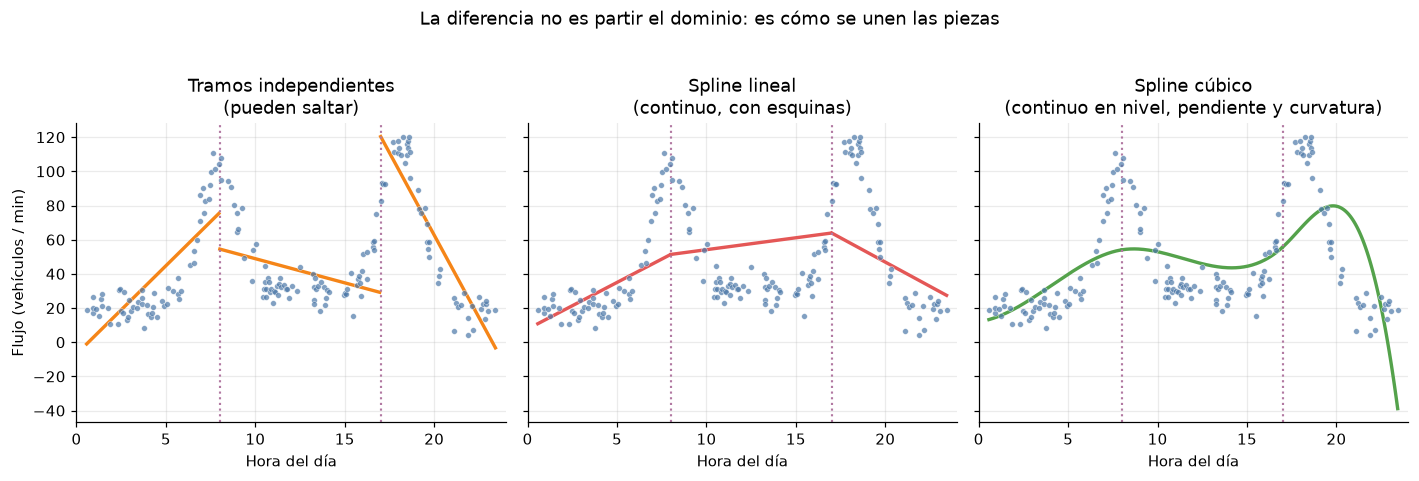
Cómo leer esta figura
Las verticales punteadas son los mismos knots. Lo que cambia es si hay condiciones de continuidad.
A la izquierda, cada recta vive su vida: busca el salto. Al centro, el spline lineal es continuo —lo dibujas sin levantar el lápiz— pero en el knot puede quebrar: solo se impuso \(f\). A la derecha, el cúbico es \(C^2\): mismo flujo, misma pendiente, misma curvatura. Las 5 columnas que fabricó SplineTransformer ya traían esas igualdades; LinearRegression solo estimó los pesos —más el intercepto—.
Ojo con una lectura apresurada: más suave no significa mejor ajuste. Con solo dos knots internos, las condiciones de continuidad amarran las piezas y les quitan libertad. El RMSE in-sample lo muestra: 17.556 con las tres rectas sueltas, 27.569 con el spline lineal y 24.761 con el cúbico, que además se hunde hasta −38.9 vehículos por minuto a las 23:25. La continuidad arregla el empalme, no la falta de flexibilidad; para devolverle flexibilidad al spline hay que darle más knots, y eso es lo que viene.
El álgebra está al servicio de esa geometría, no al revés.
Qué controla la flexibilidad: el número de knots
En Ridge y Lasso el parámetro que controlaba la complejidad era \(\lambda\). Aquí el control más directo es cuántos knots permites.
Pocos knots  →  modelo rígido     →  alto sesgo (underfitting)
Muchos knots →  modelo flexible   →  alta varianza (overfitting)
El mecanismo es otro; el problema de fondo es el mismo: el compromiso sesgo-varianza (bias-variance tradeoff), es decir, controlar la complejidad.
Vamos a ajustar splines cúbicos con 3, 5, 8 y 15 knots internos, colocados de forma uniforme. No elijas todavía el “mejor”: mira qué le ocurre a la curva.
El mismo spline cúbico, cuatro cantidades de knots
Cuatro paneles, el mismo dataset. 3, 5, 8 y 15 knots internos. Los cortes se marcan para que veas dónde se le permitió cambiar al modelo.
Al algoritmo no le pasas horas elegidas a simple vista. Le pasas cuántos knots y una regla. Con knots="uniform" (el valor por defecto), fit(X) reparte ese número entre \(x_{\min}\) y \(x_{\max}\) en intervalos iguales: es el mismo np.linspace que escribimos en la celda de abajo (y que retomaremos en la sección sobre dónde colocar los knots). En la celda de abajo lo hacemos a mano y se lo entregamos en knots=..., para que veas las posiciones. Las verticales de la figura son esas mismas horas, no otro cálculo paralelo.
n_knots_internos = [3, 5, 8, 15]
paneles = {}
cortes = []
filas_flex = []  # una fila por cantidad de knots: MAE, RMSE, R² in-sample
xmin, xmax = float(hora.min()), float(hora.max())  # el rango de X: ahí se reparte el reloj

for n_k in n_knots_internos:
    # K internos + 2 extremos, a la misma distancia en horas. Esto SÍ se lo pasamos
    # al transformador: no adivina las 8 y las 17; las calcula así, sobre [xmin, xmax].
    knots_todos = np.linspace(xmin, xmax, n_k + 2).reshape(-1, 1)
    knots_internos = knots_todos[1:-1, 0]  # las verticales de la figura: sin xmin ni xmax

    bases_k = SplineTransformer(
        degree=3,
        knots=knots_todos,  # posiciones, no solo el número; incluye los extremos
        include_bias=False,
    )
    # Equivalente a n_knots=n_k+2 y knots="uniform": fit(X) haría este linspace solo.
    modelo_k = LinearRegression()
    modelo_k.fit(bases_k.fit_transform(X), y)
    pred = modelo_k.predict(bases_k.transform(X_grid))
    pred_obs = modelo_k.predict(bases_k.transform(X))
    mae, rmse, r2 = metricas_regresion(y, pred_obs, f"Spline cúbico, {n_k} knots internos (in-sample)")
    paneles[f"{n_k} knots internos  |  RMSE={rmse:.1f}  $R^2$={r2:.2f}"] = pred
    cortes.append(knots_internos)  # las mismas horas que recibió SplineTransformer
    filas_flex.append(
        {
            "Knots internos": n_k,
            "MAE": mae,
            "RMSE": rmse,
            "R²": r2,
        }
    )

figura_paneles(
    hora, y, x_grid, paneles,
    y_verdad=y_real_grid,
    knots_por_panel=cortes,
    colores=[COLOR_SPLINE] * 4,
    n_cols=2,
    titulo_figura="Pocos knots: rígido. Más knots: la curva alcanza los dos picos",
)

# Mismas métricas de siempre, ahora en una tabla. In-sample: el error es sobre
# los puntos con los que se ajustó, no sobre un día nuevo.
tabla_flex = pd.DataFrame(filas_flex)
print("Métricas in-sample (mismo martes con el que se ajustó)")
tabla_flex.round(3)
Spline cúbico, 3 knots internos (in-sample)
MAE = 15.559
RMSE = 18.923
R² = 0.632
Spline cúbico, 5 knots internos (in-sample)
MAE = 10.993
RMSE = 13.510
R² = 0.812
Spline cúbico, 8 knots internos (in-sample)
MAE = 5.972
RMSE = 7.501
R² = 0.942
Spline cúbico, 15 knots internos (in-sample)
MAE = 5.036
RMSE = 6.264
R² = 0.960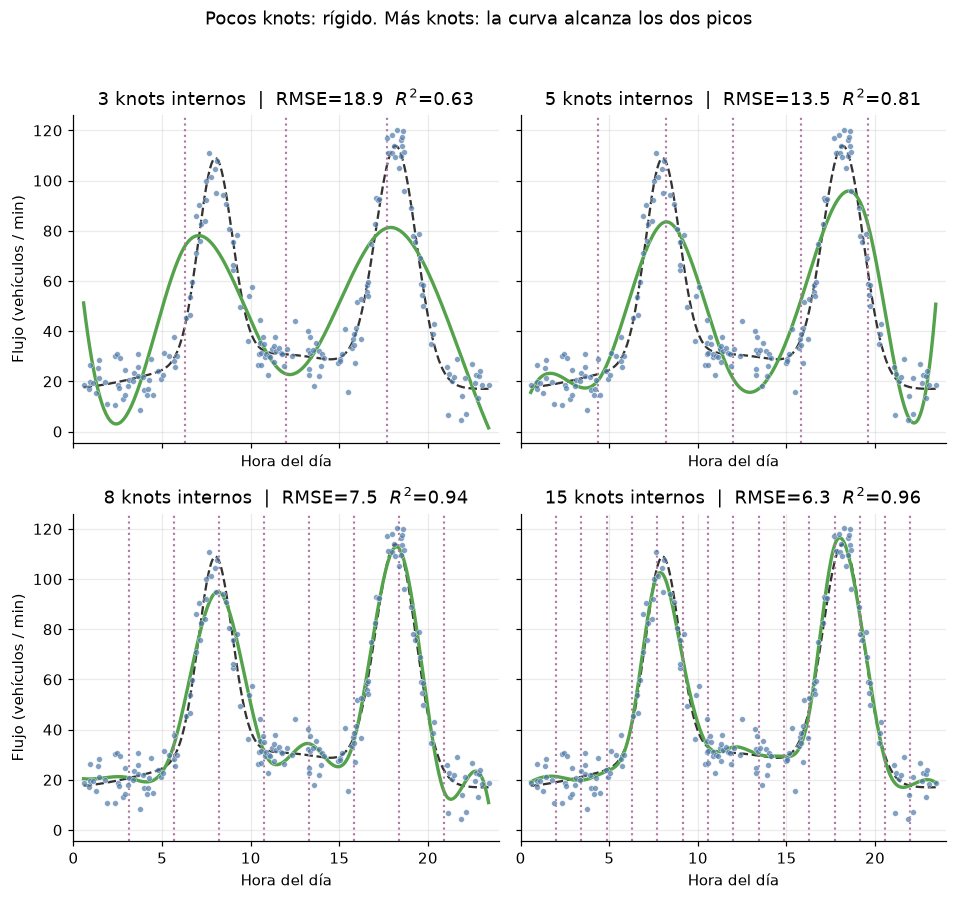
Métricas in-sample (mismo martes con el que se ajustó)| Knots internos | MAE | RMSE | R² | |
|---|---|---|---|---|
| 0 | 3 | 15.559 | 18.923 | 0.632 |
| 1 | 5 | 10.993 | 13.510 | 0.812 |
| 2 | 8 | 5.972 | 7.501 | 0.942 |
| 3 | 15 | 5.036 | 6.264 | 0.960 |
Antes de seguir, pregúntate
- Con 3 knots, ¿cuál de los dos picos “gana” y cuál se queda a medias?
- Con 15 knots, el RMSE in-sample es el más bajo (6.264). ¿Ese número basta para confiar en él mañana a las 7:40, o hace falta medirlo sobre datos que el modelo no vio?
- Si este parámetro te recuerda a \(\lambda\) en Ridge/Lasso, ¿qué sería aquí el equivalente de “meter todas las variables y no penalizar”?
Cómo leer este resultado
En la tabla, de 3 a 15 knots internos, MAE y RMSE bajan y \(R^2\) sube: 15 knots gana las tres columnas (MAE 5.036, RMSE 6.264, \(R^2\) 0.960). A más cortes, más permiso para pegarse a estos puntos. Eso no elige modelo: las métricas son in-sample, medidas sobre el mismo martes con el que se ajustó, ruido incluido. La pregunta no es quién acierta hoy, sino quién va a acertar mañana.
En la figura, con 3 knots internos el modelo apenas puede cambiar de pieza: deja los picos en ~78 y ~81 cuando la curva verdadera llega a ~109 y ~114, y hacia las 2:30 se hunde hasta ~3. Eso es subajuste (underfitting, alto sesgo). Con 5 y 8 la curva empieza a parecerse al día real. Con 15 knots internos sigue de cerca los dos picos y, en esta muestra, todavía no persigue el ruido: como aquí conocemos la función verdadera, se puede medir su distancia a ella, y es de 2.7 (RMSE sobre la malla) frente a 5.3 con 8 knots y 18.3 con 3. Ese es el punto delicado: en la tabla in-sample, 15 knots ganaría aunque estuviera sobreajustando, porque el error de entrenamiento siempre baja al agregar knots. Con muchos más knots aparecería el sobreajuste (overfitting, alta varianza): ondulaciones que son ruido de este martes, aunque la función siga viéndose “suave” comparada con un polinomio de grado 12. ¿Dónde está la frontera? No lo dice la tabla de entrenamiento; lo dice la validación cruzada de más abajo.
El espectro es el de siempre:
subajuste \(\leftrightarrow\) complejidad adecuada \(\leftrightarrow\) sobreajuste
Ridge y Lasso penalizan el tamaño de los coeficientes. Aquí el número de knots controla la flexibilidad local. Distinto mecanismo, misma factura de sesgo y varianza. Y, igual que entonces, el ajuste sobre los datos usados para entrenar no es el juez.
Dónde colocar los knots
Dos estrategias simples bastan para este artículo.
Uniformes en \(X\). Se reparte el rango observado en intervalos de igual longitud. Es transparente y funciona cuando las observaciones cubren el eje de forma más o menos pareja.
Cuantiles de \(X\). Los knots se colocan en percentiles de la muestra (por ejemplo, los terciles, cuartiles, etc.). Si \(X\) está amontonada en una región —muchas mediciones en hora pico y casi ninguna a las 4 a.m.— los cuantiles gastan más knots donde hay más datos, que es donde puedes permitirte estimar cambios locales, y menos donde apenas hay información.
Ninguna de las dos reglas es preferible en todos los casos. El error que sí debe evitarse es de procedimiento: fijar los knots inspeccionando \(y\) —por ejemplo, colocándolos en los picos del tráfico— sobre el conjunto completo y evaluar luego el modelo como si esas posiciones fueran independientes de la respuesta. En ese caso \(y\) interviene dos veces: primero en el diseño del spline y después en su evaluación. La salida es usar una regla que no mire \(y\) (uniforme o por cuantiles de \(X\)) y calcularla solo con cada partición de entrenamiento (fold) de la validación cruzada; más adelante, el Pipeline se encarga de esto último. El Pipeline no te protege, en cambio, si escribes a mano knots elegidos mirando \(y\): esa decisión es tuya.
Un eje X desigual: uniformes frente a cuantiles
En el presente ejemplo no se ajusta ningún modelo. No hay variable respuesta ni mínimos cuadrados. Solo se va a ver dónde caen los knots cuando las horas no están repartidas de forma pareja.
Qué se va a hacer. Se fabrica un día artificial con muchas mediciones en las dos horas pico y pocas de madrugada y de noche. Sobre esas mismas horas se colocan \(K=6\) knots internos con las dos reglas de la sección anterior:
- Uniformes. Los cortes quedan a la misma distancia en el reloj. Da igual que en un tramo haya 55 puntos y en otro 4.
- Cuantiles. Entre knot y knot hay (casi) el mismo número de observaciones. Donde hay más datos, los knots se juntan; donde hay pocos, se alejan.
Para qué. Para comprobar que, si \(X\) está amontonada, las dos reglas no marcan las mismas horas. El histograma muestra cómo se concentran las observaciones; debajo, dónde pone los cortes cada criterio.
Cómo leerlo. Si las marcas coinciden, el muestreo era parejo y da lo mismo qué regla uses. Si se separan —sobre todo cerca de las 8 y de las 18—, estás viendo el efecto de la densidad de \(X\) sobre el diseño del spline.
# Un día mal muestreado a propósito: muchas mediciones en las dos horas pico,
# pocas de madrugada y de noche. Así se ve la diferencia entre las dos reglas.
hora_desigual = np.sort(  # de menor a mayor: el histograma se lee como un eje de tiempo
    np.concatenate(  # pega los cinco bloques en un solo vector de horas
        [
            rng.uniform(0.5, 6.5, 20),    # madrugada: 20 puntos en ~6 h
            rng.uniform(7.0, 9.5, 55),    # pico mañana: 55 puntos en ~2.5 h
            rng.uniform(10.0, 16.0, 25),  # mediodía: 25 puntos en 6 h
            rng.uniform(16.5, 19.5, 55),  # pico tarde: 55 puntos en ~3 h
            rng.uniform(20.0, 23.5, 20),  # noche: 20 puntos en ~3.5 h
        ]
    )
)

n_internos = 6  # K knots INTERIORES; los extremos no se cuentan (el spline ya los usa)

# Uniformes: K+2 puntos igualmente espaciados entre xmin y xmax (incluidos).
# [1:-1] tira xmin y xmax. El paso es (xmax-xmin)/(K+1): reparte el RELOJ.
knots_unif = np.linspace(hora_desigual.min(), hora_desigual.max(), n_internos + 2)[1:-1]

# Cuantiles: las mismas K+2 probabilidades de 0 a 1; se tiran 0 y 1 (min y max
# muestrales) y se evalúa el percentil de X. Equidistancia en el ORDEN de la
# muestra: entre knot y knot hay (casi) el mismo número de observaciones, no las mismas horas.
knots_cuant = np.quantile(hora_desigual, np.linspace(0, 1, n_internos + 2)[1:-1])

figura_histograma_knots(
    hora_desigual,  # histograma de X arriba; marcas de knots abajo
    {
        "Uniformes": (knots_unif, COLOR_LINEAL, "--"),  # espacio constante en horas
        "Cuantiles": (knots_cuant, COLOR_SPLINE, "-"),  # espacio constante en cuantiles
    },
    titulo_hist="X no es uniforme: hay muchas más observaciones en las horas pico",
    titulo_knots="Los cuantiles agrupan knots donde hay datos; los uniformes, donde hay rango",
)

print("Knots uniformes :", np.round(knots_unif, 2))  # deberían verse casi aritméticos
print("Knots cuantiles :", np.round(knots_cuant, 2))  # más apretados cerca de 8 y 18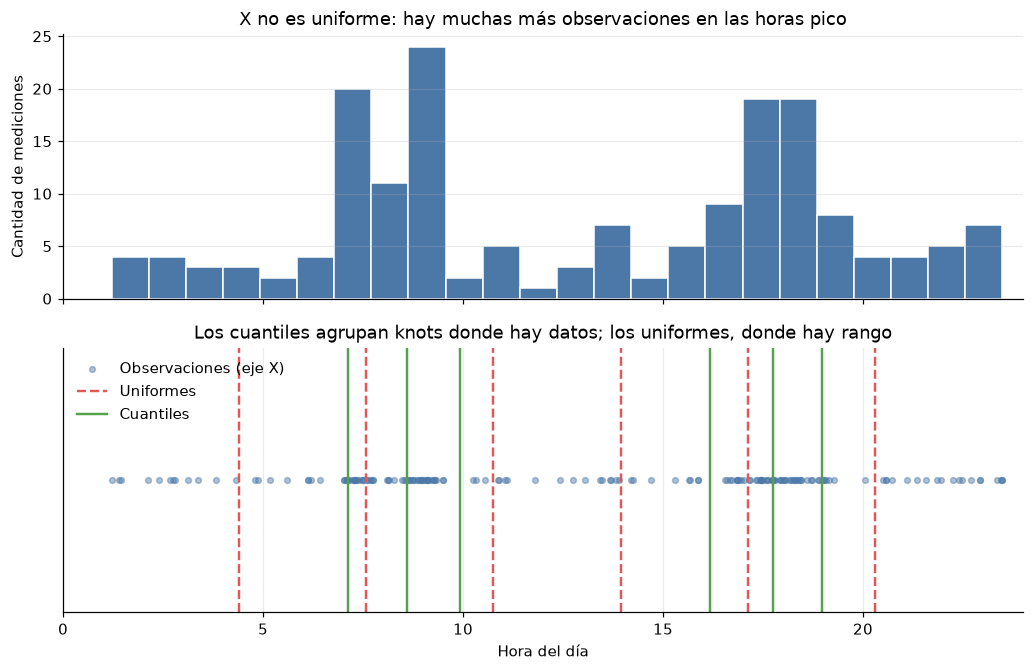
Knots uniformes : [ 4.39  7.57 10.76 13.94 17.12 20.3 ]
Knots cuantiles : [ 7.13  8.61  9.93 16.17 17.74 18.99]
Cómo leer este resultado
El histograma de arriba no es plano: la ciudad midió más en las horas críticas. Los cortes rojos (uniformes) se espacian por reloj: de 4.39 a 20.30 h, cada 3.2 h. Los verdes (cuantiles) se concentran en los dos bloques pico: tres entre 7.13 y 9.93 h y tres entre 16.17 y 18.99 h. No ponen ninguno en la madrugada, el mediodía ni la noche. Si tu interés es estimar bien los picos y allí es donde tienes muestra, los cuantiles son una regla razonable. Si tu interés es cubrir el reloj de forma equitativa aunque a las 4 a.m. tengas cuatro puntos, los uniformes son más honestos… y más frágiles en esas zonas vacías.
En la siguiente sección esas dos reglas son las opciones knots="uniform" (la que usaremos, y la de por defecto) y knots="quantile" del transformador. Aquí basta la geometría: dónde hay datos, ahí puedes permitirte un knot.
Implementación con scikit-learn: SplineTransformer
Ya lo usaste a mano: knots, grado y LinearRegression. Ahora lo dejamos en un Pipeline. Es la forma que vas a usar cuando elijas n_knots con k-fold —y cuando las dos reglas de colocación (uniforme o cuantiles) tengan que calcularse dentro de cada fold, no con el dataset entero.
El spline no reemplaza la regresión lineal. Transforma \(X\) en nuevas variables y después una regresión lineal aprende los pesos. Es feature engineering.
X
 ↓
SplineTransformer
 ↓
B₁(X), B₂(X), ..., Bₘ(X)
 ↓
LinearRegression
 ↓
ŷ
n_knots en scikit-learn cuenta también los knots de los extremos. degree=3 es el spline cúbico. include_bias=False deja el intercepto en manos de LinearRegression. Las dos reglas de la sección anterior son knots="uniform" (por defecto) y knots="quantile".
Qué produjo realmente SplineTransformer
Antes del Pipeline, mira la transformación sola: dimensión de \(X\) frente a dimensión de las bases, y unas pocas filas. Esas columnas son las \(B_j(x)\). Después sí, el modelo.
spline_feat = SplineTransformer(n_knots=5, degree=3, include_bias=False)
X_spline = spline_feat.fit_transform(X)

print(f"X.shape        = {X.shape}")
print(f"X_spline.shape = {X_spline.shape}")
print("Primeras filas de las bases B_j(X):")
print(
    pd.DataFrame(
        X_spline[:6],
        columns=[f"B{j+1}" for j in range(X_spline.shape[1])],
    ).round(3).to_string(index=False)
)

pipeline_spline = Pipeline(
    [
        ("spline", SplineTransformer(n_knots=5, degree=3, include_bias=False)),
        ("modelo", LinearRegression()),
    ]
)
pipeline_spline.fit(X, y)
pred_sk_obs = pipeline_spline.predict(X)
pred_sk_grid = pipeline_spline.predict(X_grid)

print(
    f"Columnas del spline en el Pipeline: {pipeline_spline.named_steps['modelo'].coef_.shape[0]}"
)
_ = metricas_regresion(y, pred_sk_obs, "Pipeline SplineTransformer(n_knots=5, degree=3)")

figura_curvas(
    hora, y, x_grid,
    curvas={"Spline (Pipeline)": pred_sk_grid},
    y_verdad=y_real_grid,
    colores=[COLOR_SPLINE],
    titulo="SplineTransformer expande X; LinearRegression estima los pesos",
)
X.shape = (180, 1)
X_spline.shape = (180, 6)
Primeras filas de las bases B_j(X):
B1 B2 B3 B4 B5 B6
0.167 0.667 0.167 0.0 0.0 0.0
0.139 0.663 0.197 0.0 0.0 0.0
0.137 0.663 0.200 0.0 0.0 0.0
0.137 0.663 0.200 0.0 0.0 0.0
0.123 0.658 0.218 0.0 0.0 0.0
0.113 0.653 0.234 0.0 0.0 0.0
Columnas del spline en el Pipeline: 6
Pipeline SplineTransformer(n_knots=5, degree=3)
MAE = 15.559
RMSE = 18.923
R² = 0.632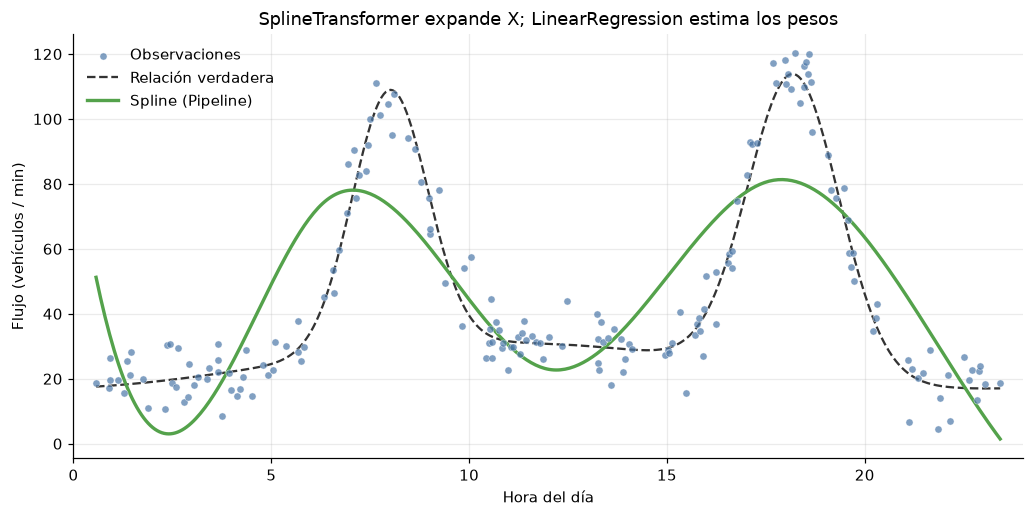
Cómo leer este Pipeline
\(X\) tenía una columna; X_spline tiene seis: n_knots + degree − 1 = 7 bases, menos la que quita include_bias=False. Cada una es una base \(B_j\) evaluada en cada hora. Eso es la ingeniería de variables (feature engineering): no cambiaste el modelo, cambiaste las variables.
Fíjate en las métricas: RMSE 18.923 y \(R^2\) 0.632, idénticas al panel de “3 knots internos” de la figura de flexibilidad. No es casualidad: n_knots=5 cuenta los dos extremos, así que es el mismo modelo, y por eso la curva todavía se queda corta en los dos picos. Lo que cambió es la forma de escribirlo, no la flexibilidad.
El Pipeline hace exactamente esa expansión y después LinearRegression estima los \(\beta_j\). Si más adelante cambias n_knots o degree, no cambias de algoritmo: cambias el espacio de variables. Por eso el spline se lleva tan bien con pipelines, k-fold y métricas. Y por eso la transformación tiene que vivir dentro del Pipeline: si no, los folds de prueba ya vieron cómo se construyeron las columnas.
Tenemos un nuevo problema
Ya sabemos que más knots permiten mayor flexibilidad. Pero mirar la curva y elegir el número que “se vea mejor” no es un procedimiento estadístico confiable: el RMSE de entrenamiento premia siempre al modelo más elástico.
¿Cómo sabemos cuántos knots usar?
La respuesta es la del artículo anterior: evaluamos generalización mediante validación cruzada (CV, por cross-validation). Antes de elegir nada, apartamos un 25 % de las observaciones como conjunto de prueba: no participa en ninguna decisión y solo se usa al final, para el reporte. Sobre el 75 % restante (el entrenamiento), mismo KFold barajado, semilla fija, un Pipeline distinto por candidato. La métrica principal es el RMSE de CV —misma unidad que el flujo, sensible a picos mal predichos—. El número que importa no es el de una partición: es el promedio entre folds, con su desviación.
Recorrer n_knots con k-fold
En esta celda vamos a elegir cuántos knots usar, para no quedarnos con el modelo que mejor se ve en entrenamiento, mediante validación cruzada k-fold.
Qué se hace. Se prueba una lista de candidatos —de pocos knots a muchos, hasta 40— para ver el descenso del RMSE y, si la flexibilidad sobra, el repunte a la derecha. (Más allá de 40, cada fold de entrenamiento tiene apenas ~108 puntos, algunos tramos entre knots quedan casi vacíos y el ajuste se vuelve numéricamente inestable.) Para cada valor se arma el mismo Pipeline (SplineTransformer + LinearRegression) y se estima el RMSE, solo con el entrenamiento, con el mismo KFold de 5 folds. Al final se conserva el n_knots con menor RMSE promedio.
Cómo leer n_knots. En scikit-learn ese argumento cuenta también los extremos \(x_{\min}\) y \(x_{\max}\). Los knots internos son \(n_{\mathrm{knots}}-2\). Por ejemplo, n_knots=5 son 3 knots internos; no es el panel de “5 knots internos” de la figura de flexibilidad (ese equivaldría a n_knots=7).
# Conjunto de prueba: se aparta ANTES de elegir nada y solo se usa en el reporte final.
X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    X, y, test_size=0.25, random_state=SEMILLA
)
print(f"Entrenamiento: {len(y_ent)} observaciones  |  prueba: {len(y_prueba)}")

kf = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)
valores_knots = [3, 4, 5, 6, 8, 10, 12, 15, 20, 25, 30, 40]

filas_knots = []
for n_knots in valores_knots:
    pipe = Pipeline(
        [
            ("spline", SplineTransformer(n_knots=n_knots, degree=3, include_bias=False)),
            ("modelo", LinearRegression()),
        ]
    )
    rmse_folds = -cross_val_score(
        pipe, X_ent, y_ent, cv=kf, scoring="neg_root_mean_squared_error"
    )
    filas_knots.append(
        {
            "n_knots": n_knots,
            "RMSE_CV": rmse_folds.mean(),
            "STD_RMSE": rmse_folds.std(ddof=1),
        }
    )

tabla_knots = pd.DataFrame(filas_knots)
mejor_n_knots = int(tabla_knots.loc[tabla_knots["RMSE_CV"].idxmin(), "n_knots"])
print(f"Mejor n_knots según RMSE de CV: {mejor_n_knots}")
tabla_knots.round(3)
Entrenamiento: 135 observaciones | prueba: 45
Mejor n_knots según RMSE de CV: 15| n_knots | RMSE_CV | STD_RMSE | |
|---|---|---|---|
| 0 | 3 | 24.554 | 2.089 |
| 1 | 4 | 23.534 | 1.272 |
| 2 | 5 | 18.361 | 0.718 |
| 3 | 6 | 14.463 | 1.600 |
| 4 | 8 | 13.596 | 1.191 |
| 5 | 10 | 7.636 | 0.311 |
| 6 | 12 | 9.089 | 1.544 |
| 7 | 15 | 7.209 | 0.646 |
| 8 | 20 | 7.241 | 0.935 |
| 9 | 25 | 7.508 | 0.835 |
| 10 | 30 | 7.824 | 1.032 |
| 11 | 40 | 9.352 | 1.888 |
Complejidad frente a error de validación
Cada punto es el RMSE promedio de los 5 folds. Las barras indican la desviación estándar de ese RMSE entre folds: miden cuánto varía el error al cambiar la partición, no un intervalo de confianza. Si dos valores de n_knots tienen medias parecidas y las barras se solapan, no hay base para declarar un ganador: conviene el más simple.
figura_cv(
    tabla_knots["n_knots"].to_list(),
    tabla_knots["RMSE_CV"].to_list(),
    tabla_knots["STD_RMSE"].to_list(),
    elegido=mejor_n_knots,
    titulo="La complejidad ahora se elige con k-fold, no con el gráfico de entrenamiento",
)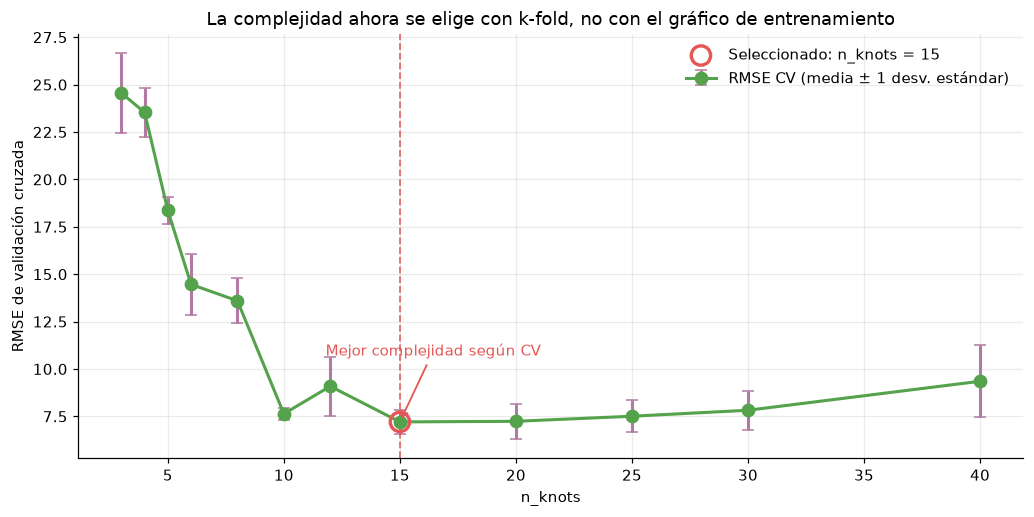
Antes de seguir, pregúntate
- ¿El mínimo de esta curva coincide con el modelo que tenía el mejor RMSE in-sample unas celdas atrás?
- Si dos valores de
n_knotstienen RMSE CV parecido y el de más knots tiene mayor desviación entre folds, ¿cuál reportarías, y por qué? - El RMSE CV del candidato elegido, ¿es una estimación honesta de su error en datos nuevos, o sale optimista porque justo lo usamos para elegir? ¿Qué papel cumple el conjunto de prueba que apartamos al principio?
Cómo leer este resultado
La validación cruzada no busca la curva que mejor sigue los datos observados, sino la configuración que produce el menor error esperado sobre datos nuevos.
El eje horizontal es complejidad; el vertical, error de generalización estimada. A la izquierda el modelo es rígido (alto sesgo). Mientras la curva baja hacia el mínimo, cada knot extra reduce el sesgo más de lo que aumenta la varianza. Pasado el mínimo ocurre lo contrario: si la curva sube o se aplana, estás comprando flexibilidad que el día nuevo no te agradece.
El marcador no es “el spline verdadero”. Es el candidato con menor RMSE CV en este diseño: n_knots = 15, con RMSE CV de 7.209. Sus vecinos quedan muy cerca y las barras se solapan; con esa evidencia, un candidato algo más simple sería igual de defendible (la regla de “un error estándar” formaliza esa preferencia). Y el error de validación puede empeorar al añadir knots aunque después baje otra vez: de n_knots=10 a n_knots=12 el RMSE CV sube de 7.636 a 9.089 y luego vuelve a bajar. Más knots no es un tobogán monótono: también importa dónde caen los knots respecto de los picos.
Acabas de convertir una decisión visual —esta curva se ve bien— en una decisión basada en generalización. Eso es exactamente el puente con el artículo de validación cruzada k-fold.
Comparación final: lineal, polinómico y spline
En esta sección vamos a comparar tres familias —recta, polinomio y spline cúbico— para decidir cuál generaliza mejor en el tráfico, mediante el mismo KFold de 5 folds y las mismas métricas: MAE, RMSE y \(R^2\) de validación cruzada (promedio y desviación entre folds).
Qué se hace. El lineal no tiene hiperparámetros: entra tal cual. El polinomio sí: se elige el grado por RMSE de CV sobre el entrenamiento. El spline ya trajo su n_knots de la celda anterior. Los tres se evalúan después en la misma tabla: primero con validación cruzada sobre el entrenamiento y, al final, una sola vez sobre el conjunto de prueba. Mismo protocolo para los tres, para que la comparación no dependa de haber favorecido a uno a simple vista.
La tesis que debes poder defender al salir:
el modelo más flexible visualmente no necesariamente es el que mejor generaliza.
Elegir el grado del polinomio con el mismo k-fold
Grados 2, 3, 5, 8, 10 y 12. El ganador entra a la tabla final; los demás no se esconden: ves su RMSE CV.
candidatos_grado = [2, 3, 5, 8, 10, 12]
filas_grado = []
for grado in candidatos_grado:
    pipe = pipeline_polinomico(grado)
    rmse_folds = -cross_val_score(
        pipe, X_ent, y_ent, cv=kf, scoring="neg_root_mean_squared_error"
    )
    filas_grado.append(
        {
            "grado": grado,
            "RMSE_CV_promedio": rmse_folds.mean(),
            "RMSE_CV_std": rmse_folds.std(ddof=1),
        }
    )

tabla_grado = pd.DataFrame(filas_grado)
mejor_grado = int(tabla_grado.loc[tabla_grado["RMSE_CV_promedio"].idxmin(), "grado"])
print(f"Mejor grado polinómico según RMSE de CV: {mejor_grado}")
tabla_grado.round(3)
Mejor grado polinómico según RMSE de CV: 10| grado | RMSE_CV_promedio | RMSE_CV_std | |
|---|---|---|---|
| 0 | 2 | 28.503 | 2.178 |
| 1 | 3 | 28.405 | 1.902 |
| 2 | 5 | 24.616 | 1.969 |
| 3 | 8 | 14.100 | 1.073 |
| 4 | 10 | 13.420 | 0.890 |
| 5 | 12 | 16.385 | 5.669 |
Tabla de generalización de los tres modelos
Tres pipelines, las tres métricas de la serie (MAE, RMSE y \(R^2\)), media y desviación entre los cinco folds del entrenamiento y, en la última columna, el RMSE sobre el conjunto de prueba.
def evaluar_cv(modelo, X, y, kf):
    mae = -cross_val_score(modelo, X, y, cv=kf, scoring="neg_mean_absolute_error")
    rmse = -cross_val_score(modelo, X, y, cv=kf, scoring="neg_root_mean_squared_error")
    r2 = cross_val_score(modelo, X, y, cv=kf, scoring="r2")
    return {
        "MAE_CV": mae.mean(),
        "MAE_std": mae.std(ddof=1),
        "RMSE_CV": rmse.mean(),
        "RMSE_std": rmse.std(ddof=1),
        "R2_CV": r2.mean(),
        "R2_std": r2.std(ddof=1),
    }


modelos_finales = {
    "Regresión lineal": LinearRegression(),
    f"Polinomio grado {mejor_grado}": pipeline_polinomico(mejor_grado),
    f"Spline cúbico (n_knots={mejor_n_knots})": Pipeline(
        [
            (
                "spline",
                SplineTransformer(n_knots=mejor_n_knots, degree=3, include_bias=False),
            ),
            ("modelo", LinearRegression()),
        ]
    ),
}

filas_final = []
for nombre, modelo in modelos_finales.items():
    res = evaluar_cv(modelo, X_ent, y_ent, kf)  # CV solo sobre el entrenamiento
    modelo.fit(X_ent, y_ent)  # ajuste final con todo el entrenamiento
    pred_prueba = modelo.predict(X_prueba)  # la prueba se usa una sola vez, aquí
    res["RMSE_prueba"] = float(np.sqrt(mean_squared_error(y_prueba, pred_prueba)))
    filas_final.append({"Modelo": nombre, **res})

tabla_final = pd.DataFrame(filas_final)
tabla_mostrar = pd.DataFrame(
    {
        "Modelo": tabla_final["Modelo"],
        "MAE CV": tabla_final["MAE_CV"].round(3),
        "RMSE CV": [
            f"{m:.3f} ± {s:.3f}"
            for m, s in zip(tabla_final["RMSE_CV"], tabla_final["RMSE_std"])
        ],
        "R² CV": tabla_final["R2_CV"].round(3),
        "RMSE prueba": tabla_final["RMSE_prueba"].round(3),
    }
)
tabla_mostrar| Modelo | MAE CV | RMSE CV | R² CV | RMSE prueba | |
|---|---|---|---|---|---|
| 0 | Regresión lineal | 24.461 | 30.286 ± 1.701 | 0.002 | 31.221 |
| 1 | Polinomio grado 10 | 10.985 | 13.420 ± 0.890 | 0.799 | 16.640 |
| 2 | Spline cúbico (n_knots=15) | 5.762 | 7.209 ± 0.646 | 0.944 | 9.291 |
Cómo leer la tabla
Tres columnas de error, no una. El MAE te habla del error típico en vehículos por minuto. El RMSE, más sensible a los picos mal predichos. El \(R^2\) de CV, de cuánto mejor que predecir la media es cada procedimiento (un valor cercano a 0 significa que no mejora nada). La desviación entre folds te impide celebrar una diferencia de dos décimas si los folds se mueven más que eso.
La recta queda claramente atrás (RMSE CV 30.286, \(R^2\) CV 0.002): no es una competencia de hiperparámetros, es una forma imposible. Entre el polinomio ganador y el spline ganador, mira quién generaliza, no quién dibuja la curva más entretenida: el spline tiene un RMSE CV de 7.209 frente a 13.420 del polinomio de grado 10, una diferencia mucho mayor que la desviación entre folds de cualquiera de los dos. No gana porque “los splines son más modernos”: gana porque la flexibilidad local describe dos picos sin obligar al resto del día a ondular.
Fíjate además en el piso. El ruido del experimento tiene desviación \(\sigma = 6.5\), así que ningún modelo puede bajar de forma sostenida de un RMSE cercano a 6.5 en datos nuevos. El spline, con 7.209, está cerca de ese piso: casi todo el error que le queda es ruido irreducible. En el conjunto de prueba, que no intervino en ninguna elección, el orden se mantiene: RMSE de 31.221 (recta), 16.640 (polinomio) y 9.291 (spline). Con solo 45 puntos de prueba, esas cifras son más ruidosas que las de CV; su papel es confirmar, no volver a elegir.
Visualización final: qué ganamos con un spline
Tres curvas sobre la misma nube, más la relación verdadera en punteado. El spline y el polinomio que entran aquí son los que k-fold eligió, no los que se veían mejor en entrenamiento.
pred_lin_grid = LinearRegression().fit(X, y).predict(X_grid)
pred_poli_grid = pipeline_polinomico(mejor_grado).fit(X, y).predict(X_grid)
modelo_spline_final = Pipeline(
    [
        ("spline", SplineTransformer(n_knots=mejor_n_knots, degree=3, include_bias=False)),
        ("modelo", LinearRegression()),
    ]
)
pred_spl_grid = modelo_spline_final.fit(X, y).predict(X_grid)

figura_curvas(
    hora, y, x_grid,
    {
        "Regresión lineal": pred_lin_grid,
        f"Polinomio grado {mejor_grado}": pred_poli_grid,
        f"Spline cúbico (n_knots={mejor_n_knots})": pred_spl_grid,
    },
    y_verdad=y_real_grid,
    colores=[COLOR_LINEAL, COLOR_POLI, COLOR_SPLINE],
    titulo="Qué gana el spline: picos locales sin comprar ondulaciones globales",
    loc_leyenda="upper left",
)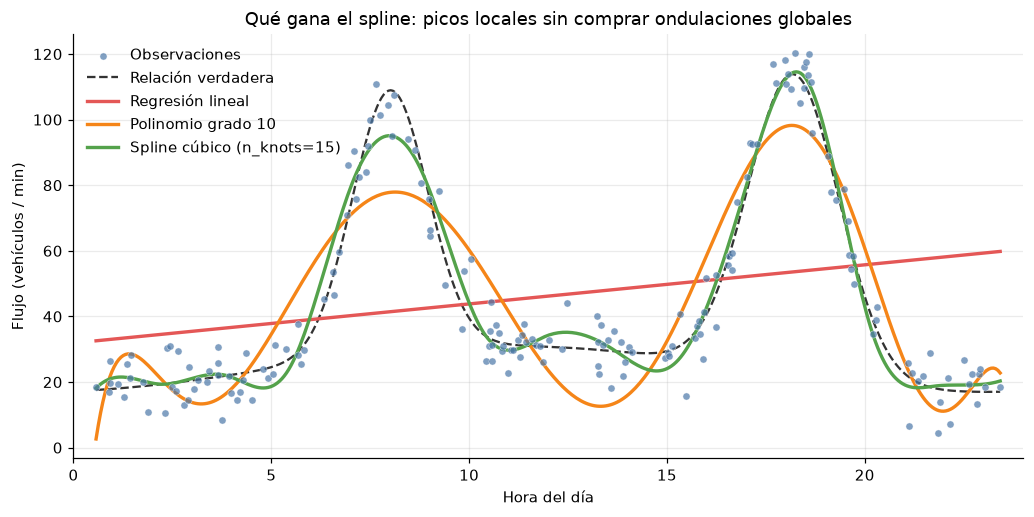
Cómo leer la comparación visual
La recta atraviesa el día como un promedio disfrazado de modelo. El polinomio, incluso el elegido por CV, tiene que resolver los dos picos con una sola receta global: se queda en 77.9 en la mañana y 98.2 en la tarde, cuando la curva verdadera llega a ~109 y ~114. Para lograr eso, a las 13:20 baja hasta 12.6 (la verdad está cerca de 30) y a las 0:34 arranca en 2.6. El spline llega a 95.1 en la mañana y 114.6 en la tarde: se queda algo corto en el pico de la mañana, pero sigue bien ambos picos sin deformar los tramos que no piden flexibilidad.
Eso es lo que ganamos. No una curva más “bonita”. Una forma de no linealidad local que se estima con las mismas herramientas lineales de la serie, y que se calibra con la misma honradez de k-fold.
Errores comunes al trabajar con splines
Pensar que más knots siempre es mejor. Más knots es más flexibilidad. La flexibilidad de más memoriza el ruido. El juez es la validación, no el RMSE de entrenamiento ni el “se ve más pegado a los puntos”.
Colocar los knots mirando todo el dataset —a veces incluso mirando \(y\)— y evaluar después como si no se hubieran usado. Eso es fuga. Los knots (uniformes o por cuantiles) deben nacer del fold de entrenamiento. El
Pipelineexiste para eso.Confundir spline con regresión polinómica. Un polinomio de grado 10 es una función global. Un spline cúbico con varios knots es una función por tramos con costura. Pueden tener un número parecido de parámetros y comportamientos opuestos en los extremos.
Olvidar la transformación dentro del Pipeline. Ajustar el
SplineTransformera \(X\) completo, transformar, y luego meter las columnas ya listas encross_val_scorees exactamente el error de preprocesar fuera de la validación.Interpretar cada \(\beta_j\) como si fuera una pendiente simple. “El tercer coeficiente es 12, luego cada hora extra suma 12 vehículos” es falso. Cada \(\beta_j\) pondera una columna de
SplineTransformer, que actúa sobre un tramo de \(X\), no sobre todo el día. La pendiente del spline cambia a lo largo de \(X\); eso era el punto.Extrapolar demasiado lejos del rango observado. Fuera del intervalo de \(X\) con el que se construyeron las bases, el spline ya no está anclado. No es una ley física: preguntarle el flujo a una hora que no existió en la muestra es pedirle que invente. En
SplineTransformerel valor por defecto esextrapolation="constant": fuera del rango de entrenamiento la predicción se queda plana en el valor del borde; con"linear"o"continue"prolonga la tendencia del borde. Ninguna opción convierte la extrapolación en un dato.Evaluar únicamente el ajuste visual. Una curva que recorre los puntos puede ser un sobreajuste elegante. La gráfica convence; el k-fold decide. Usa las dos, en ese orden de autoridad cuando entren en conflicto.
Lo que debes llevarte de este artículo
- Una relación no lineal no implica automáticamente usar un polinomio de alto grado.
- Los polinomios globales modifican toda la curva: un arreglo en una región puede desordenar otra.
- Los splines introducen flexibilidad local.
- Los knots determinan dónde puede cambiar el comportamiento. No son observaciones mágicas ni saltos.
- Las piezas deben conectarse suavemente; si no, vuelves a los tramos discontinuos.
- Los splines cúbicos piden continuidad de \(f\), \(f'\) y \(f''\): una curva especialmente suave.
- Más knots implican mayor flexibilidad.
- Mayor flexibilidad no garantiza mejor generalización.
- K-fold permite seleccionar la complejidad con datos que no se usaron para ajustar.
SplineTransformer + LinearRegressionmuestra que todavía formulamos el problema como regresión sobre nuevas características.
¿Qué sigue?
Los splines construyen una función flexible mediante polinomios locales y knots. La pregunta del siguiente artículo apunta a otro oficio, todavía dentro de la suavización:
¿Podríamos estimar el comportamiento de una función utilizando directamente la información de los puntos que están cerca de cada valor de \(X\), sin construir una base polinómica?
Eso es la idea de los métodos de kernel para suavización: una ventana alrededor de cada \(x\), un peso que decae con la distancia, y una estimación local. No hay knots que colocar; hay un ancho de ventana que elegir —y, otra vez, un parámetro de complejidad que no se debe fijar a simple vista—.
Dejamos los splines aquí, con k-fold todavía en la mano. En el próximo notebook, esa misma mano va a calibrar un kernel.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.