Análisis Avanzado de Datos — Caso aplicado: mapas de entrega con kernels
estadistica
suavizacion
kernel
caso-practico
Caso aplicado de suavización por kernel en dos dimensiones: mapas de densidad de entregas.
Author
Wilder Ramírez Delgado
Published
September 27, 2026
Análisis Avanzado de Datos — Caso aplicado: mapas de entrega con kernels
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
El problema: no todos los barrios entregan igual
Una empresa de mensajería tiene miles de entregas registradas, cada una con su ubicación (latitud, longitud) y el tiempo que tardó. La pregunta operativa es sencilla y valiosa: dada una dirección cualquiera de la ciudad, ¿cuánto tardará una entrega ahí? La respuesta es un mapa de calor: zonas rápidas y zonas lentas.
Este es un problema donde la variable de entrada tiene dos dimensiones (la posición en el mapa), y donde —como veremos— las técnicas que sirvieron en una dimensión fracasan, mientras que el suavizado por kernel resuelve el problema de forma natural. La razón es intuitiva: para saber cuánto tarda una entrega en un punto, lo más sensato es mirar las entregas cercanas en el mapa. Eso es exactamente lo que hace un kernel.
Objetivos
Al terminar este caso vas a ser capaz de:
Reconocer cuándo un problema tiene estructura espacial (dos dimensiones) y por qué eso rompe a los modelos globales.
Aplicar la regresión por kernel en dos dimensiones para construir un mapa de calor de predicción.
Comparar de forma justa el kernel con la regresión lineal, el polinomio bidimensional y los k-vecinos, con validación, sin fuga de información y repitiendo el reparto de los datos con varias semillas.
Interpretar el ancho de banda como el radio de influencia en el mapa y elegirlo por validación.
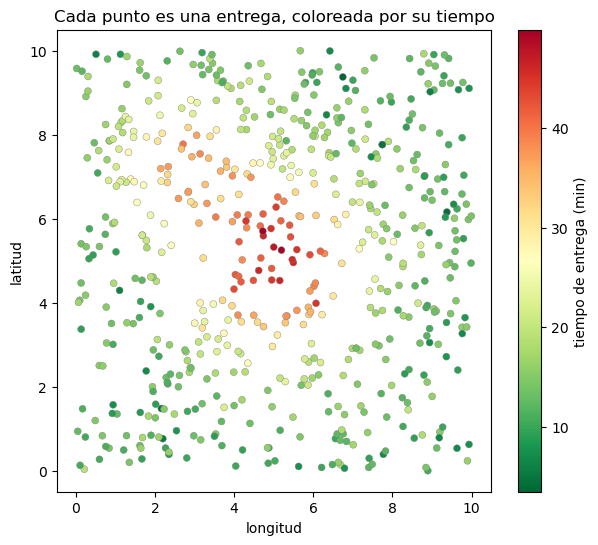
Simulamos una ciudad en una cuadrícula de 10×10. Cada entrega ocurre en una posición (lon, lat) y tarda un tiempo que depende de la zona: hay un centro congestionado (lento) y otra zona lenta al noroeste; el resto es más rápido. Añadimos ruido para simular la variabilidad real (un día con más tráfico, un repartidor más ágil, etc.). En la práctica no conocemos la fórmula: solo tenemos los puntos.
n =600lon = rng.uniform(0, 10, n)lat = rng.uniform(0, 10, n)def tiempo_real(lon, lat): base =12 centro =35* np.exp(-0.5* (((lon -5) /1.6) **2+ ((lat -5) /1.6) **2)) zona_lenta =22* np.exp(-0.5* (((lon -2.5) /1.1) **2+ ((lat -7.5) /1.1) **2))return base + centro + zona_lentatiempo = tiempo_real(lon, lat) + rng.normal(0, 3, n)X = np.column_stack([lon, lat])y = tiempoplt.scatter(lon, lat, c=y, cmap='RdYlGn_r', s=25, edgecolor='gray', linewidth=0.3)plt.colorbar(label='tiempo de entrega (min)')plt.xlabel('longitud'); plt.ylabel('latitud')plt.title('Cada punto es una entrega, coloreada por su tiempo'); plt.show()print(f'{n} entregas | tiempo medio: {y.mean():.1f} min | rango: {y.min():.1f}-{y.max():.1f} min')
600 entregas | tiempo medio: 19.2 min | rango: 3.5-49.9 min
Cómo leer este mapa
Cada punto es una entrega; el color es el tiempo (verde = rápido, rojo = lento). A simple vista se ve una mancha roja en el centro y otra hacia el noroeste: son las zonas congestionadas. El resto de la ciudad es más verde. El objetivo es convertir esta nube de puntos en un mapa continuo que prediga el tiempo en cualquier dirección, incluso donde no hay una entrega registrada.
Preparación para evaluar
Separamos entrenamiento y prueba, y definimos una malla que cubre toda la ciudad para dibujar los mapas de calor de cada modelo. El conjunto de prueba no se usará para elegir ningún parámetro: solo para medir, al final, qué modelo generaliza mejor.
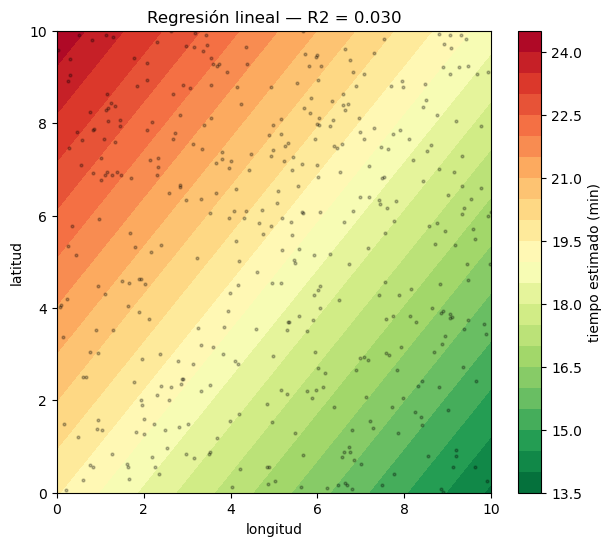
Empecemos por lo más simple, lo que ya conoces: una regresión lineal. En dos dimensiones, ajusta un plano — el tiempo sube de forma constante en alguna dirección. ¿Podrá un plano representar una ciudad con un centro lento rodeado de zonas rápidas?
lin = LinearRegression().fit(Xtr, ytr)r2_lin = r2_score(yte, lin.predict(Xte))mapa(lin.predict(malla), f'Regresión lineal — R2 = {r2_lin:.3f}')print(f'R2 en prueba (lineal): {r2_lin:.3f}')
R2 en prueba (lineal): 0.030
Cómo leer este resultado
El mapa es un gradiente plano: el modelo solo puede decir “el tiempo aumenta hacia tal esquina”, y pinta la ciudad con una rampa de color uniforme. No hay rastro de la mancha central ni de la zona noroeste. El R² de 0.030 lo confirma: el plano explica prácticamente nada de la variabilidad. Es el fracaso esperado — la relación no es lineal ni monótona, y un plano no puede doblarse para envolver un punto caliente en el centro.
Intento 2: polinomio bidimensional
Si un plano no basta, subamos la flexibilidad con un polinomio en dos variables (términos como \(lon^2\), \(lat^2\), \(lon\cdot lat\), etc.). Elegimos el grado por validación cruzada para no hacer trampa.
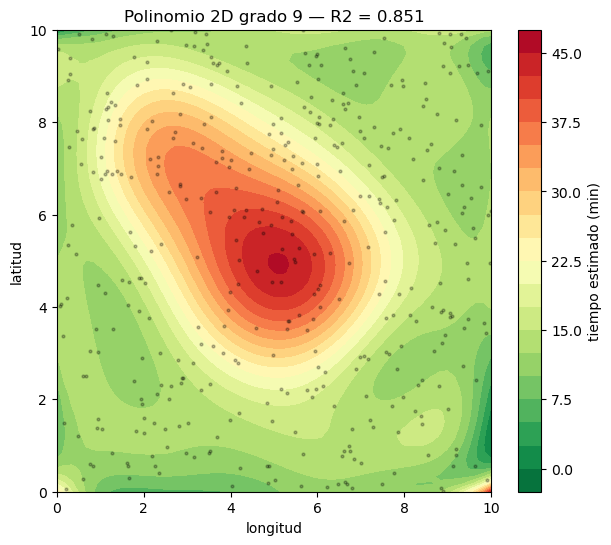
grados =list(range(1, 11))kf = KFold(5, shuffle=True, random_state=SEMILLA)# Para cada grado candidato, medimos el error de validación en cada foldcv_g = []for g in grados: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): modelo_g = make_pipeline(PolynomialFeatures(g), LinearRegression()) modelo_g.fit(Xtr[idx_tr], ytr[idx_tr]) pred_va = modelo_g.predict(Xtr[idx_va]) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_g.append(np.mean(errores_folds))g_opt = grados[int(np.argmin(cv_g))]print('MSE de validación por grado:')for g, e inzip(grados, cv_g):print(f' grado {g:2d}: {e:10.2f}')poli = make_pipeline(PolynomialFeatures(g_opt), LinearRegression()).fit(Xtr, ytr)r2_pol = r2_score(yte, poli.predict(Xte))mapa(poli.predict(malla), f'Polinomio 2D grado {g_opt} — R2 = {r2_pol:.3f}')print(f'Grado óptimo: {g_opt} | R2 en prueba (polinomio): {r2_pol:.3f}')
MSE de validación por grado:
  grado  1:      91.26
  grado  2:      48.56
  grado  3:      45.90
  grado  4:      22.94
  grado  5:      21.65
  grado  6:      15.95
  grado  7:      17.81
  grado  8:      14.02
  grado  9:      12.07
  grado 10:      16.15
Grado óptimo: 9 | R2 en prueba (polinomio): 0.851
Cómo leer este resultado
Ampliamos la búsqueda hasta grado 10 para no quedar pegados al borde del rango, y esta vez el mínimo cae dentro de lo probado: la validación cruzada elige grado 9, con un MSE de validación cercano a 12 (frente a 16 del grado 6, 14 del grado 8 y 16 del grado 10). Fíjate en que la curva no es una U limpia: sube y baja con altibajos y vuelve a empeorar en el grado 10, señal de que el polinomio se vuelve inestable a medida que crece.
Con grado 9 el R² en prueba sube a 0.851, muy por encima del plano. Pero mira el mapa con calma: el polinomio capta el centro caliente y funde la zona noroeste en un solo lóbulo alargado, sin separarla del centro. Y en los bordes aparecen ondulaciones que no están en los datos; en la esquina inferior derecha el color se dispara y la barra llega a marcar tiempos negativos, algo imposible para una entrega. Es el equivalente en dos dimensiones del fenómeno de Runge que viste con los polinomios de una variable. Además, necesita 55 coeficientes para llegar hasta aquí. Mejor que la recta, pero costoso e inestable en los extremos.
La idea local: kernel en dos dimensiones
Volvamos a la intuición del problema: para estimar el tiempo en un punto del mapa, lo natural es promediar las entregas cercanas, dándoles más peso cuanto más cerca estén. Eso es la regresión por kernel, ahora con la distancia medida en el plano:
\[\hat{m}(x) = \frac{\sum_{i} K\!\left(\frac{\lVert x - x_i \rVert}{h}\right) y_i}{\sum_{i} K\!\left(\frac{\lVert x - x_i \rVert}{h}\right)}\]
donde \(\lVert x - x_i \rVert\) es la distancia entre dos puntos del mapa y \(h\) es el radio de influencia (el ancho de banda). No hay que decidir estructuras ni grados: solo ese radio.
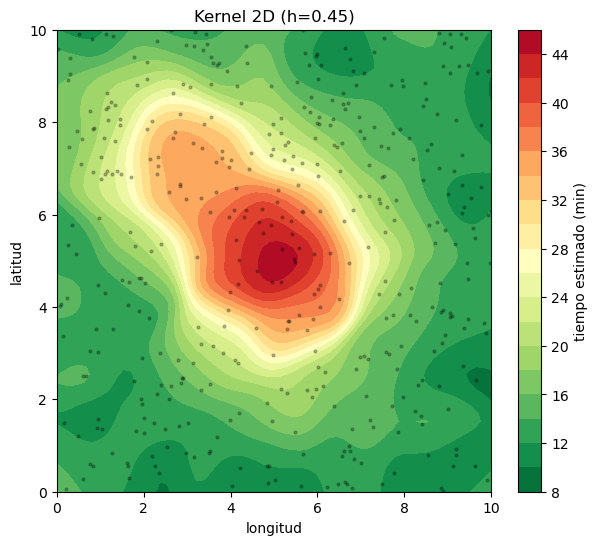
def kernel_2d(Xtr, ytr, Xq, h): out = np.empty(len(Xq))for i, q inenumerate(Xq): d2 = np.sum((Xtr - q) **2, axis=1) # distancia al cuadrado en el mapa w = np.exp(-0.5* d2 / h **2) # peso: decae con la distancia s = w.sum() out[i] = (w * ytr).sum() / s if s >0else np.nanreturn outmapa_kernel = kernel_2d(Xtr, ytr, malla, h=0.45)mapa(mapa_kernel, 'Kernel 2D (h=0.45)')
Cómo leer este resultado
Con un radio de 0.45, el mapa del kernel muestra la mancha central bien definida y un lóbulo hacia el noroeste, que es la segunda zona lenta; el resto de la ciudad queda en verde. No inventó una rampa ni se disparó en los bordes: simplemente promedió lo cercano. La zona noroeste aparece como un “hombro” naranja pegado al centro y no como una isla aparte, porque en la realidad ambas zonas se solapan y el suavizado las une en parte. Esta es la ventaja del método local en un mapa: se adapta a la forma real sin imponer una fórmula global.
El ancho de banda es el radio de influencia
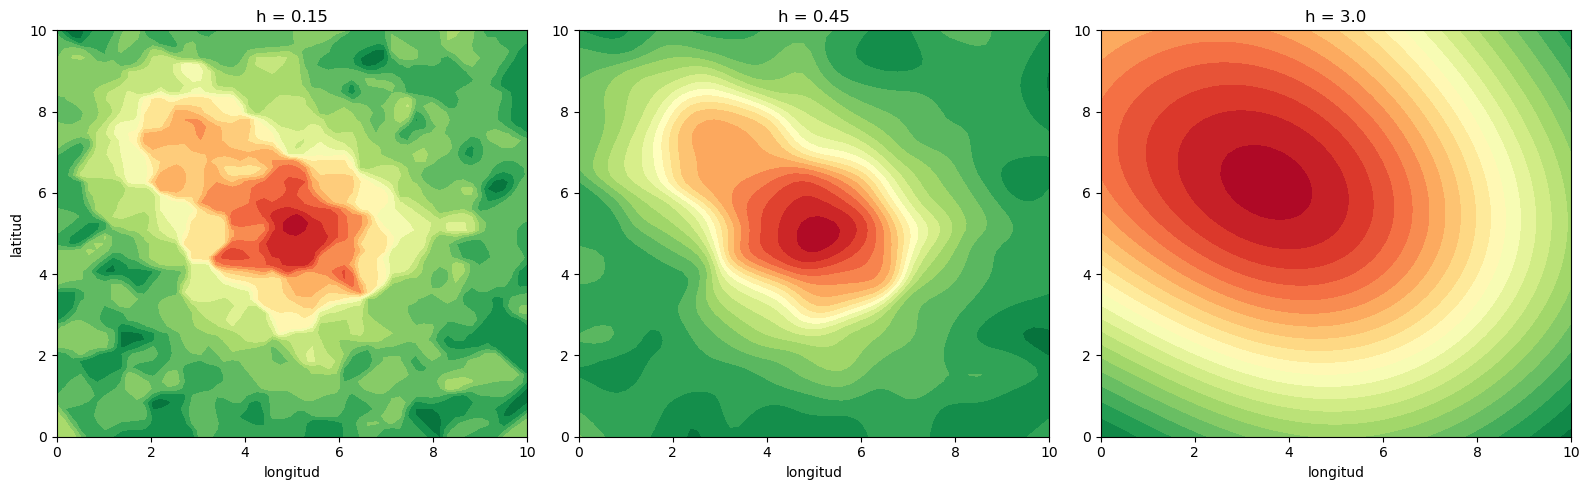
En dos dimensiones, \(h\) tiene una lectura muy física: cuán lejos alcanza la vecindad que se promedia para cada punto. Comparemos tres radios; el del medio, 0.45, es el que la validación elegirá un poco más adelante.
h = 0.15 (radio pequeño): el mapa se ve manchado y lleno de parches sueltos, incluso en zonas donde no pasa nada; cada punto promedia muy pocos vecinos, así que el ruido pasa directo al mapa. Sobreajuste.
h = 0.45 (equilibrado): la mancha central y el lóbulo del noroeste se ven limpios y suaves, sin parches espurios. Es el radio que la validación cruzada elegirá enseguida.
h = 3.0 (radio grande): el promedio abarca buena parte de la ciudad y el mapa se reduce a una sola mancha borrosa, desplazada hacia el noroeste, donde ya no distingues el centro de la otra zona. Subajuste.
El mismo compromiso sesgo-varianza de siempre, ahora como un radio en el mapa.
Elegir el radio por validación
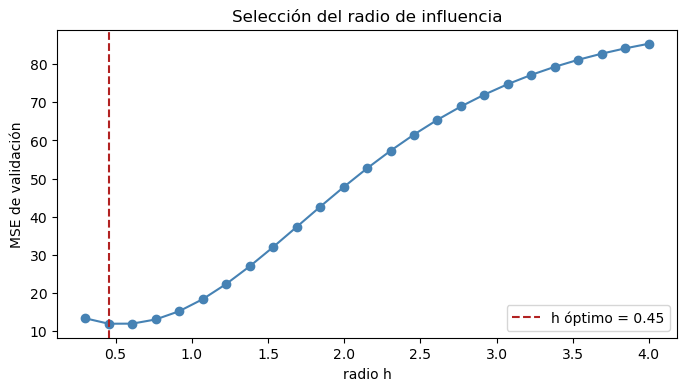
Como siempre, no elegimos \(h\) a simple vista: probamos varios por validación cruzada sobre el entrenamiento y nos quedamos con el que mejor generaliza.
hs = np.linspace(0.3, 4.0, 25)# Para cada radio candidato, medimos el error de validación en cada foldcv_h = []for h in hs: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): pred_va = kernel_2d(Xtr[idx_tr], ytr[idx_tr], Xtr[idx_va], h) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_h.append(np.mean(errores_folds))h_opt = hs[int(np.argmin(cv_h))]plt.figure(figsize=(8, 4))plt.plot(hs, cv_h, marker='o', color='steelblue')plt.axvline(h_opt, color='firebrick', linestyle='--', label=f'h óptimo = {h_opt:.2f}')plt.xlabel('radio h'); plt.ylabel('MSE de validación'); plt.legend()plt.title('Selección del radio de influencia'); plt.show()print(f'h óptimo (validación cruzada): {h_opt:.2f} | MSE de validación: {min(cv_h):.2f}')
h óptimo (validación cruzada): 0.45 | MSE de validación: 11.89
Cómo leer este resultado
La curva vuelve a tener forma de U: radios muy pequeños sobreajustan, radios muy grandes difuminan (el error sube sin parar), y el mínimo queda en h = 0.45, con un MSE de validación cercano a 12. Ese es el mismo valor que usamos como caso “equilibrado” en el panel de tres radios, así que lo que viste a simple vista coincide con lo que elige la validación. Fíjate también en que el fondo de la U es plano entre 0.45 y 0.6: valores cercanos rinden casi igual, de modo que no necesitas afinar el radio al milímetro. El punto de la izquierda (h = 0.3) ya sube, señal de que el mínimo es real y no un efecto del borde del rango. Ese es el radio que usaremos en la comparación final.
Comparación final: los cuatro modelos, lado a lado
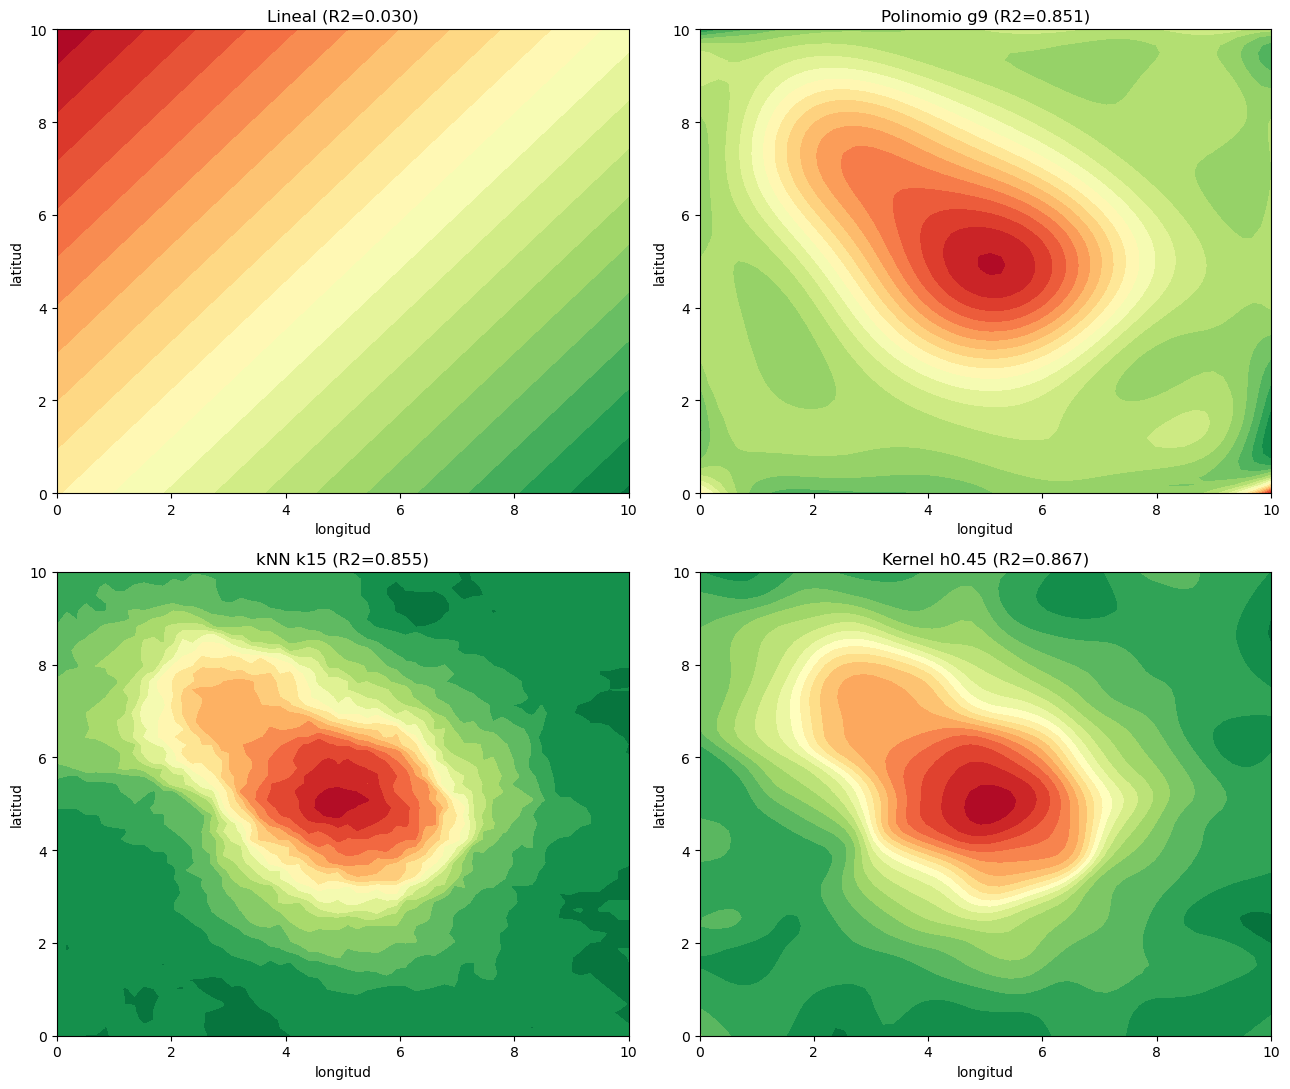
Ponemos a competir los cuatro enfoques sobre datos de prueba que no se usaron para elegir nada. Añadimos los k-vecinos (kNN), otro método local, para una comparación completa. Primero miramos los cuatro mapas de un mismo reparto de datos; después repetimos todo con varios repartos para ver cuánto de lo que observamos es real y cuánto es azar.
ks =list(range(3, 31))# Para cada número de vecinos k, medimos el error de validación en cada foldcv_k = []for k in ks: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): modelo_k = KNeighborsRegressor(n_neighbors=k) modelo_k.fit(Xtr[idx_tr], ytr[idx_tr]) pred_va = modelo_k.predict(Xtr[idx_va]) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_k.append(np.mean(errores_folds))k_opt = ks[int(np.argmin(cv_k))]knn = KNeighborsRegressor(n_neighbors=k_opt).fit(Xtr, ytr)r2_knn = r2_score(yte, knn.predict(Xte))r2_ker = r2_score(yte, kernel_2d(Xtr, ytr, Xte, h_opt))modelos = {f'Lineal (R2={r2_lin:.3f})': lin.predict(malla),f'Polinomio g{g_opt} (R2={r2_pol:.3f})': poli.predict(malla),f'kNN k{k_opt} (R2={r2_knn:.3f})': knn.predict(malla),f'Kernel h{h_opt:.2f} (R2={r2_ker:.3f})': kernel_2d(Xtr, ytr, malla, h_opt),}fig, ax = plt.subplots(2, 2, figsize=(13, 11))for a, (titulo, val) inzip(ax.ravel(), modelos.items()): a.contourf(GX, GY, val.reshape(GX.shape), levels=20, cmap='RdYlGn_r') a.set_title(titulo); a.set_xlabel('longitud'); a.set_ylabel('latitud')plt.tight_layout(); plt.show()
print(f'R2 en prueba, split con semilla {SEMILLA} (no usado para elegir parámetros)')print(f' Lineal: {r2_lin:.3f}')print(f' Polinomio 2D: {r2_pol:.3f}')print(f' kNN: {r2_knn:.3f}')print(f' Kernel 2D: {r2_ker:.3f}')
R2 en prueba, split con semilla 2026 (no usado para elegir parámetros)
  Lineal:          0.030
  Polinomio 2D:    0.851
  kNN:             0.855
  Kernel 2D:       0.867
¿Y si cambia el reparto? La comparación con varias semillas
Los R² de arriba salen de un solo reparto entrenamiento/prueba. Si otra semilla mandara otros puntos al conjunto de prueba, ¿el orden de los modelos seguiría igual? Diferencias de un centésimo pueden ser puro azar del reparto.
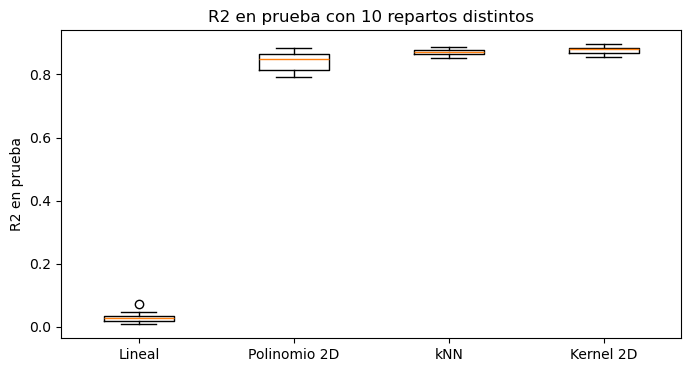
Para saberlo, repetimos todo el protocolo con 10 semillas distintas. En cada una: separamos, elegimos \(g\), \(k\) y \(h\) por validación cruzada solo con el entrenamiento de esa semilla, y medimos el R² en su prueba. Al final reportamos el promedio y la desviación de cada modelo. Para que no tarde demasiado, aquí usamos rejillas de hiperparámetros algo más gruesas que en las secciones anteriores.
semillas =list(range(10))grados_m =list(range(1, 11))ks_m =list(range(3, 31, 3))hs_m = np.linspace(0.3, 2.0, 10)r2_por_modelo = {'Lineal': [], 'Polinomio 2D': [], 'kNN': [], 'Kernel 2D': []}for semilla in semillas: Xtr_s, Xte_s, ytr_s, yte_s = train_test_split(X, y, test_size=0.3, random_state=semilla) kf_s = KFold(5, shuffle=True, random_state=semilla)# Lineal: no tiene hiperparámetros lin_s = LinearRegression().fit(Xtr_s, ytr_s) r2_por_modelo['Lineal'].append(r2_score(yte_s, lin_s.predict(Xte_s)))# Polinomio: elegir el grado por validación cruzada cv_grados = []for g in grados_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): m = make_pipeline(PolynomialFeatures(g), LinearRegression()) m.fit(Xtr_s[i_tr], ytr_s[i_tr]) errores.append(mean_squared_error(ytr_s[i_va], m.predict(Xtr_s[i_va]))) cv_grados.append(np.mean(errores)) g_s = grados_m[int(np.argmin(cv_grados))] poli_s = make_pipeline(PolynomialFeatures(g_s), LinearRegression()).fit(Xtr_s, ytr_s) r2_por_modelo['Polinomio 2D'].append(r2_score(yte_s, poli_s.predict(Xte_s)))# kNN: elegir k por validación cruzada cv_ks = []for k in ks_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): m = KNeighborsRegressor(n_neighbors=k).fit(Xtr_s[i_tr], ytr_s[i_tr]) errores.append(mean_squared_error(ytr_s[i_va], m.predict(Xtr_s[i_va]))) cv_ks.append(np.mean(errores)) k_s = ks_m[int(np.argmin(cv_ks))] knn_s = KNeighborsRegressor(n_neighbors=k_s).fit(Xtr_s, ytr_s) r2_por_modelo['kNN'].append(r2_score(yte_s, knn_s.predict(Xte_s)))# Kernel: elegir el radio h por validación cruzada cv_hs = []for h in hs_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): pred = kernel_2d(Xtr_s[i_tr], ytr_s[i_tr], Xtr_s[i_va], h) errores.append(mean_squared_error(ytr_s[i_va], pred)) cv_hs.append(np.mean(errores)) h_s = hs_m[int(np.argmin(cv_hs))] r2_por_modelo['Kernel 2D'].append(r2_score(yte_s, kernel_2d(Xtr_s, ytr_s, Xte_s, h_s)))print(f'R2 en prueba con {len(semillas)} semillas (promedio ± desviación)')for nombre, valores in r2_por_modelo.items():print(f' {nombre:<14s}{np.mean(valores):.3f} ± {np.std(valores, ddof=1):.3f}')# Diferencia kernel - kNN, semilla por semilla (mismo reparto para ambos)dif = np.array(r2_por_modelo['Kernel 2D']) - np.array(r2_por_modelo['kNN'])print(f'\nKernel - kNN: {dif.mean():+.3f} ± {dif.std(ddof=1):.3f} 'f'| el kernel gana en {int((dif >0).sum())} de {len(semillas)} semillas')dif_pol = np.array(r2_por_modelo['Kernel 2D']) - np.array(r2_por_modelo['Polinomio 2D'])print(f'Kernel - Polinomio: {dif_pol.mean():+.3f} ± {dif_pol.std(ddof=1):.3f} 'f'| el kernel gana en {int((dif_pol >0).sum())} de {len(semillas)} semillas')plt.figure(figsize=(8, 4))plt.boxplot(list(r2_por_modelo.values()))plt.xticks(range(1, 5), list(r2_por_modelo.keys()))plt.ylabel('R2 en prueba')plt.title(f'R2 en prueba con {len(semillas)} repartos distintos')plt.show()
R2 en prueba con 10 semillas (promedio ± desviación)
  Lineal         0.030 ± 0.018
  Polinomio 2D   0.843 ± 0.031
  kNN            0.871 ± 0.011
  Kernel 2D      0.876 ± 0.012

Kernel - kNN: +0.005 ± 0.005 | el kernel gana en 8 de 10 semillas
Kernel - Polinomio: +0.034 ± 0.035 | el kernel gana en 8 de 10 semillas
Cómo leer esta comparación
Los mapas (un solo reparto) ya cuentan la historia cualitativa: el plano lineal es ciego a las zonas lentas, el polinomio capta el centro pero se distorsiona en los bordes, el kNN reconoce las zonas con un mapa algo “escalonado” y el kernel da el mapa más suave. Pero para decidir con números conviene mirar el promedio de las 10 semillas:
Modelo
R² en prueba (promedio ± desviación)
Lineal
0.030 ± 0.018
Polinomio 2D
0.843 ± 0.031
kNN
0.871 ± 0.011
Kernel 2D
0.876 ± 0.012
Cómo separar lo real del ruido:
Lineal frente a todos los demás: diferencia real y enorme. Está a más de 0.8 de distancia, decenas de veces su variabilidad. Un plano no sirve para este problema, cambie la semilla que cambie.
Kernel frente a polinomio: diferencia real, pero moderada. El kernel promedia 0.034 más y gana en 8 de las 10 semillas. Además, el polinomio es el modelo más inestable (desviación de 0.031, casi el triple que los métodos locales): su resultado depende mucho de qué puntos caen en el entrenamiento, y ya viste que en los bordes produce valores imposibles.
Kernel frente a kNN: cae dentro de la variabilidad. La ventaja promedio es de apenas 0.005, menos de la mitad de lo que cada modelo se mueve de una semilla a otra (alrededor de 0.012). El kernel gana en 8 de 10 repartos, así que la dirección es consistente, pero la magnitud es tan pequeña que en la práctica es un empate en R². En el reparto con semilla 2026, en cambio, la brecha era 0.012 (0.867 frente a 0.855), más del doble que el promedio: un buen ejemplo de por qué un solo split puede exagerar una diferencia.
¿Con cuál te quedas entre kernel y kNN? No por el R², que no los separa, sino por lo que sí los distingue: el kernel entrega un mapa continuo y suave, y el kNN uno con escalones. Si vas a usar el mapa para decidir, esa suavidad importa.
Un último aviso honesto: las 10 semillas reparten los mismos 600 datos, así que esta variabilidad refleja el azar del reparto, no lo que pasaría con entregas nuevas. Con datos frescos la incertidumbre sería algo mayor.
Por qué el 2D cambió el resultado
En una sola dimensión, un spline bien afinado suele igualar al kernel; no hay un ganador claro. Pero al pasar a dos dimensiones la balanza se inclina: los métodos globales (polinomios) se vuelven inestables y necesitan muchísimos términos, y los splines requieren productos entre dimensiones que se complican rápido. El suavizado por kernel, en cambio, apenas cambia: sigue siendo “promedia lo cercano”, solo que ahora la cercanía se mide en el plano. Esa simplicidad que no se degrada al subir de dimensión es su gran fortaleza — y por eso los métodos de kernel son un pilar en problemas espaciales, de imágenes y de datos de alta dimensión.
Errores comunes en problemas espaciales con kernels
Síntoma
Causa probable
Solución
El mapa se ve manchado y ruidoso
radio h demasiado pequeño
súbelo; elígelo por validación
Las zonas se funden en una mancha
radio h demasiado grande
bájalo
Predicciones raras lejos de los datos
zonas del mapa sin entregas cercanas
no predigas donde no hay soporte
Una variable domina la distancia
lon y lat en escalas distintas
estandariza las coordenadas antes
Muy lento con muchos datos
el promedio recorre todos los puntos
usa estructuras de vecindad (árboles KD)
Lo que debes llevarte de este caso
Cuando el problema tiene estructura espacial (dos o más variables de entrada), los modelos globales —recta, polinomio— fracasan o se vuelven inestables.
El suavizado por kernel resuelve el problema con la misma idea de siempre (promediar lo cercano), y su simplicidad no se degrada al subir de dimensión.
El ancho de banda es, literalmente, el radio de influencia en el mapa, y se elige por validación.
Los métodos locales (kernel, kNN) superan con claridad a la recta y con margen moderado al polinomio, que además es el más inestable. Entre kernel y kNN el R² no decide (diferencia de 0.005 con 10 semillas); el kernel gana por dar el mapa más suave.
Antes de declarar un ganador, repite la comparación con varias semillas: una diferencia de un centésimo en un solo reparto puede ser puro azar.
¿Qué sigue?
Has visto la suavización por kernel llevar un problema real de una y dos dimensiones a un mapa útil para decidir. El siguiente tema cambia de pregunta: ¿y si lo que quieres predecir no es un número, sino una categoría (entrega a tiempo sí/no) o un conteo (número de incidencias)? Ahí entran los modelos lineales generalizados (GLM) y su extensión, los modelos aditivos (GAM), que combinan estas ideas con la regresión.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.