import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.metrics import accuracy_score, roc_auc_score, confusion_matrix, roc_curve
import statsmodels.api as sm

SEMILLA = 2026
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (8, 4)Análisis Avanzado de Datos — 8. Modelos lineales generalizados (GLM): regresión logística
estadistica
glm
regresion-logistica
Los modelos lineales generalizados a través de la regresión logística: probabilidades, odds ratios, umbrales de decisión y AUC para respuestas binarias.
Análisis Avanzado de Datos — 8. Modelos lineales generalizados (GLM): regresión logística

👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
Cuando la respuesta es sí o no
Hasta ahora, de la regresión lineal a los splines y los kernels, predijiste números continuos: un tiempo, un flujo, un costo. Pero muchas de las preguntas más importantes tienen respuesta binaria: ¿esta entrega llegará a tiempo o no? ¿este cliente se irá o se quedará? ¿esta transacción es fraude o no? Para eso, la regresión lineal no sirve: podría predecir una “probabilidad” de 1.4 o de −0.3, que no significan nada.
La regresión logística resuelve esto. Es el primer paso hacia los modelos lineales generalizados (GLM): en vez de predecir el valor directamente, predice la probabilidad de que ocurra el sí, garantizando que quede siempre entre 0 y 1. En este artículo la construimos sobre un caso de logística de entregas con datos simulados, la pregunta que dejó planteada el caso aplicado de entregas: predecir si una entrega llegará a tiempo.
Objetivos de aprendizaje
Al terminar este notebook vas a ser capaz de:
- Reconocer cuándo una variable respuesta es binaria y por qué una regresión lineal no respeta su distribución.
- Describir las tres piezas de un GLM logístico: respuesta Bernoulli, predictor lineal y función de enlace logit.
- Distinguir probabilidad, odds y log-odds, y convertir coeficientes en odds ratios.
- Ajustar una regresión logística y obtener probabilidades para observaciones nuevas.
- Explicar cómo un umbral convierte probabilidades en clases y cómo afecta los tipos de error.
- Evaluar el modelo con matriz de confusión, exactitud y área bajo la curva ROC (AUC).
- Distinguir el uso de
scikit-learnpara predicción y destatsmodelspara inferencia.
Preparación del entorno
Cargamos las librerías y fijamos una semilla global, SEMILLA = 2026, de la que salen la simulación de los datos y la partición en entrenamiento y prueba.
Los datos: ¿la entrega llega a tiempo?
Simulamos 800 entregas. De cada una conocemos la distancia (km) y si se hizo en hora pico, y queremos predecir si llegó a tiempo (1) o no (0). Por construcción, la probabilidad de llegar a tiempo baja con la distancia y baja también en hora pico. En la práctica no conocemos esa regla: la inferimos de los datos.
n = 800
distancia = rng.uniform(1, 25, n)          # km
hora_pico = rng.integers(0, 2, n)          # 1 = hora pico

# Regla oculta (log-odds de llegar a tiempo): baja con distancia y en hora pico
logit = 3.2 - 0.18 * distancia - 1.1 * hora_pico
prob = 1 / (1 + np.exp(-logit))
a_tiempo = rng.binomial(1, prob)

X = np.column_stack([distancia, hora_pico])
y = a_tiempo
print(f'{n} entregas | llegaron a tiempo: {y.mean():.1%}')
pd.DataFrame({'distancia': distancia[:5], 'hora_pico': hora_pico[:5], 'a_tiempo': y[:5]})
800 entregas | llegaron a tiempo: 56.4%| distancia | hora_pico | a_tiempo | |
|---|---|---|---|
| 0 | 5.294436 | 0 | 1 |
| 1 | 16.357916 | 1 | 0 |
| 2 | 12.214442 | 0 | 0 |
| 3 | 9.892013 | 1 | 0 |
| 4 | 9.518016 | 0 | 1 |
Cómo leer este resultado
El 56.4% de las entregas llega a tiempo, así que las clases están razonablemente equilibradas (ni todo sí ni todo no). La variable objetivo es 0 o 1: no hay valores intermedios. Ese es precisamente el problema que la regresión lineal no sabe manejar, como veremos ahora.
Por qué la regresión lineal no sirve aquí
Antes de buscar una solución, veamos el fracaso de la herramienta conocida. Para aislar el problema, usaremos únicamente las entregas realizadas fuera de hora pico y ajustaremos una regresión lineal de a_tiempo contra distancia. Así, la demostración es univariada y la forma del gráfico no mezcla el efecto de la segunda variable.
mascara_normal = hora_pico == 0
distancia_normal = distancia[mascara_normal]
y_normal = y[mascara_normal]

lin = LinearRegression().fit(distancia_normal.reshape(-1, 1), y_normal)
grid_lineal = np.linspace(0, 40, 250).reshape(-1, 1)
pred_grid_lineal = lin.predict(grid_lineal)

plt.scatter(distancia_normal, y_normal, s=12, alpha=0.3, label='entregas fuera de hora pico')
plt.plot(grid_lineal, pred_grid_lineal, color='firebrick', linewidth=2, label='regresión lineal')
plt.axhline(0, color='gray', ls=':'); plt.axhline(1, color='gray', ls=':')
plt.axvline(distancia_normal.max(), color='gray', ls='--', alpha=0.6, label='máximo observado')
plt.xlabel('distancia (km)'); plt.ylabel('¿llegó a tiempo?'); plt.legend(loc='center right')
plt.title('La recta produce "probabilidades" fuera de [0, 1]'); plt.show()

for km in [0, 30, 40]:
    print(f'Predicción de la recta a {km:>2} km: {lin.predict([[km]])[0]:.2f}')

print(f'Distancias observadas: {distancia_normal.min():.1f} a {distancia_normal.max():.1f} km')
print(f'La recta cruza 1 a {(1 - lin.intercept_) / lin.coef_[0]:.1f} km y 0 a {-lin.intercept_ / lin.coef_[0]:.1f} km')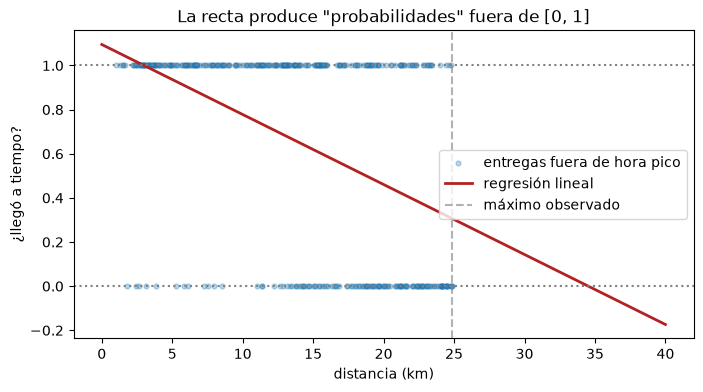
Predicción de la recta a  0 km: 1.10
Predicción de la recta a 30 km: 0.14
Predicción de la recta a 40 km: -0.17
Distancias observadas: 1.0 a 24.9 km
La recta cruza 1 a 3.0 km y 0 a 34.5 km
Cómo leer este resultado
La recta resume una tendencia descendente, pero no respeta los límites de una probabilidad. Ya dentro del rango observado (1.0 a 24.9 km) supera 1: cruza ese valor a 3.0 km, así que para las entregas más cortas predice más de 1 (1.10 si se prolonga hasta 0 km). Más allá de los datos sigue bajando y cruza 0 a 34.5 km: a 40 km predice −0.17. Ninguno de esos valores puede interpretarse como una probabilidad.
Ese es el fallo más visible, pero no el único. Cuando \(Y\) solo puede valer 0 o 1, su distribución es Bernoulli y su varianza depende de la probabilidad:
\[ Y\sim\operatorname{Bernoulli}(p), \qquad \mathbb{E}(Y)=p, \qquad \operatorname{Var}(Y)=p(1-p). \]
La varianza no es constante: es máxima en \(p=0.5\) y se reduce hacia los extremos, lo que contradice el supuesto de varianza constante (homocedasticidad) de la regresión lineal. Necesitamos un modelo que respete la distribución binaria y garantice \(0\leq p\leq1\). Antes de construirlo, separemos formalmente sus piezas.
La arquitectura formal del GLM logístico
Una regresión logística combina tres piezas:
- Distribución de la respuesta: cada entrega es un ensayo Bernoulli.
- Predictor lineal: las variables se combinan en una cantidad sin restricciones.
- Función de enlace: el logit conecta la media de la respuesta con el predictor.
\[ Y_i\sim\operatorname{Bernoulli}(p_i), \]
\[ \eta_i=\beta_0+\beta_1x_{i1}+\cdots+\beta_kx_{ik}=X_i\beta, \]
\[ \operatorname{logit}(p_i)=\log\!\left(\frac{p_i}{1-p_i}\right)=\eta_i. \]
| Pieza | Regresión logística |
|---|---|
| Respuesta | Bernoulli |
| Media | \(p_i\) |
| Predictor lineal | \(X_i\beta\) |
| Enlace | logit |
| Función inversa | sigmoide |
La parte lineal sigue ahí, pero ya no intenta predecir directamente un cero o un uno. Predice en la escala logit y después regresa a una probabilidad. Construyamos esa transformación paso a paso.
Paso 1: de la probabilidad a las odds
Las odds (en español, momios) expresan cuántas veces esperamos el evento por cada no evento:
\[ \operatorname{odds}(p)=\frac{p}{1-p}. \]
Si \(p=0.5\), las odds son 1: uno a uno. Si \(p=0.8\), las odds son 4: cuatro entregas puntuales por cada entrega tardía. Mientras \(p\) vive entre 0 y 1, las odds van de 0 a infinito.
probs = np.array([0.1, 0.25, 0.5, 0.75, 0.9])
odds_ejemplo = probs / (1 - probs)
pd.DataFrame({
    'probabilidad': probs,
    'odds = p/(1-p)': odds_ejemplo,
}).round(3)| probabilidad | odds = p/(1-p) | |
|---|---|---|
| 0 | 0.10 | 0.111 |
| 1 | 0.25 | 0.333 |
| 2 | 0.50 | 1.000 |
| 3 | 0.75 | 3.000 |
| 4 | 0.90 | 9.000 |
Cómo leer esta tabla
Cuando \(p=0.5\), las odds valen 1. Por encima de 0.5 crecen con rapidez: \(p=0.9\) equivale a odds de 9. Por debajo de 0.5 están entre 0 y 1. Nunca son negativas, así que no cubren todo el rango de valores que puede tomar un predictor lineal. Falta aplicar el logaritmo.
Paso 2: de las odds a los log-odds
El logaritmo de las odds se llama log-odds o logit. Aplicar el logaritmo transforma \((0,\infty)\) en toda la recta real:
\[ \operatorname{logit}(p)=\log\!\left(\frac{p}{1-p}\right). \]
Así, \(p=0.5\) corresponde a log-odds 0; probabilidades mayores producen valores positivos y probabilidades menores, negativos. Esta es la escala donde el modelo puede usar una combinación lineal sin restricciones.
grid_p = np.linspace(0.001, 0.999, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))
ax[0].plot(grid_p, grid_p / (1 - grid_p), color='steelblue', linewidth=2)
ax[0].set(title='Odds (eje cortado en 20)', xlabel='probabilidad', ylabel='p/(1-p)', ylim=(0, 20))
ax[1].plot(grid_p, np.log(grid_p / (1 - grid_p)), color='seagreen', linewidth=2)
ax[1].axhline(0, color='gray', ls=':')
ax[1].set(title='Log-odds o logit', xlabel='probabilidad', ylabel='log(p/(1-p))')
plt.tight_layout()
plt.show()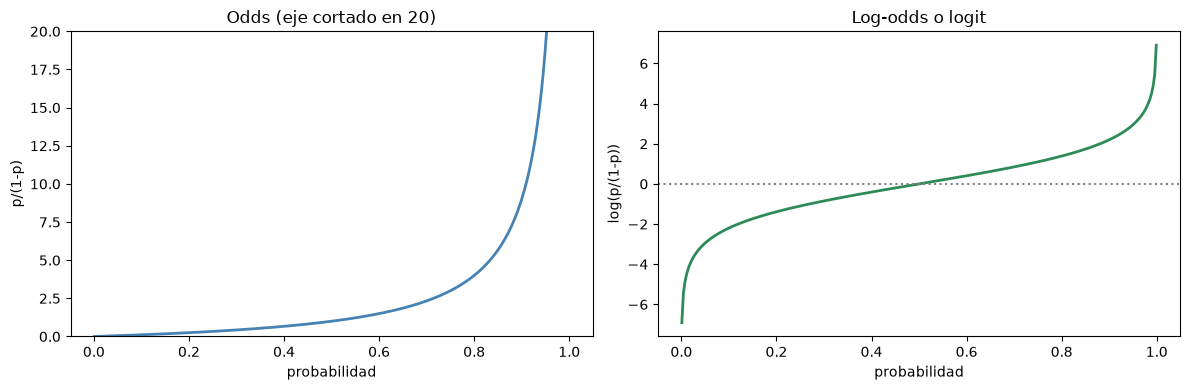
Cómo leer estas transformaciones
A la izquierda, las odds se disparan cuando \(p\) se acerca a 1: en \(p=0.999\) valen 999, por eso el eje se corta en 20. A la derecha, el logit reparte esa escala de forma simétrica alrededor de cero (\(p\) y \(1-p\) dan log-odds opuestos). El modelo trabaja en ese eje; falta el camino de vuelta a la probabilidad.
Paso 3: volver a la probabilidad con la sigmoide
La inversa del logit es la función logística:
\[ p_i=\operatorname{logit}^{-1}(\eta_i)=\frac{1}{1+e^{-\eta_i}}. \]
Esta transformación toma cualquier valor real de \(\eta_i=X_i\beta\) y lo devuelve al intervalo abierto \((0,1)\): se acerca a 0 y a 1 sin alcanzarlos. Esa es la curva en forma de S que reemplaza a la recta fallida del inicio.
z = np.linspace(-8, 8, 200)
plt.plot(z, 1 / (1 + np.exp(-z)), color='steelblue', linewidth=2)
plt.axhline(0, color='gray', ls=':'); plt.axhline(1, color='gray', ls=':')
plt.axhline(0.5, color='firebrick', ls='--', alpha=0.6)
plt.xlabel('η = combinación lineal'); plt.ylabel('probabilidad')
plt.title('La función logística (sigmoide): siempre entre 0 y 1'); plt.show()

eta_ejemplo = np.array([-2.0, 0.0, 2.0])
p_ejemplo = 1 / (1 + np.exp(-eta_ejemplo))
tabla_escalas = pd.DataFrame({
    'η = log-odds': eta_ejemplo,
    'odds = exp(η)': np.exp(eta_ejemplo),
    'probabilidad': p_ejemplo,
})
tabla_escalas.round(3)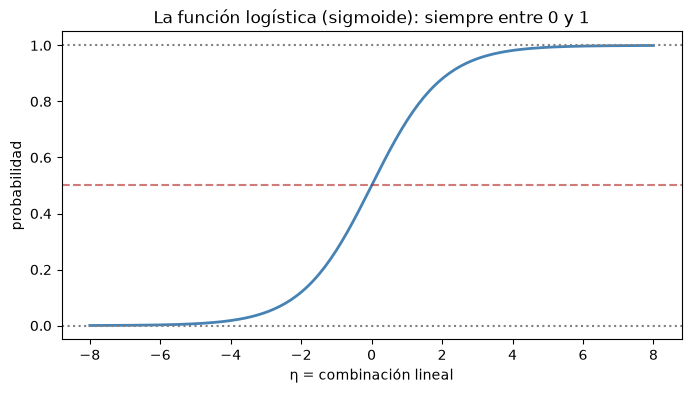
| η = log-odds | odds = exp(η) | probabilidad | |
|---|---|---|---|
| 0 | -2.0 | 0.135 | 0.119 |
| 1 | 0.0 | 1.000 | 0.500 |
| 2 | 2.0 | 7.389 | 0.881 |
Cómo leer este resultado
La curva en forma de S nunca sale del intervalo \((0,1)\). Cuando \(\eta=0\), las odds son \(e^0=1\): el evento y el no evento tienen la misma posibilidad, por lo que \(p=0.5\). Cuando \(\eta=2\), las odds son aproximadamente 7.39 a 1 y la probabilidad es cercana a 0.881. Cuando \(\eta=-2\), las odds son aproximadamente 0.135 y la probabilidad baja a 0.119.
Las tres escalas expresan la misma predicción, pero responden preguntas distintas:
| Escala | Expresión | Lectura |
|---|---|---|
| Probabilidad | \(p\) | proporción esperada de eventos |
| Odds | \(p/(1-p)\) | eventos esperados por cada no evento |
| Log-odds | \(\log(p/(1-p))\) | escala lineal donde actúan los coeficientes |
La probabilidad es la escala más natural para comunicar una predicción. Las odds y los log-odds son las escalas que permiten formular e interpretar el modelo.
Antes de seguir, pregúntate
Si el coeficiente que acompaña a una variable cambia de magnitud, ¿qué le ocurre a la inclinación de la sigmoide? ¿Y qué cambia cuando modificamos únicamente el intercepto? La siguiente figura aísla ambos efectos.
z_param = np.linspace(-6, 6, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))

for beta_1 in [0.5, 1.0, 3.0]:
    ax[0].plot(z_param, 1 / (1 + np.exp(-(beta_1 * z_param))), label=rf'$\beta_1={beta_1}$')
ax[0].set(title='La pendiente controla la transición', xlabel='x', ylabel='probabilidad')
ax[0].legend()

for beta_0 in [-3.0, 0.0, 3.0]:
    ax[1].plot(z_param, 1 / (1 + np.exp(-(z_param + beta_0))), label=rf'$\beta_0={beta_0}$')
ax[1].set(title='El intercepto desplaza el punto medio', xlabel='x', ylabel='probabilidad')
ax[1].legend()

plt.tight_layout()
plt.show()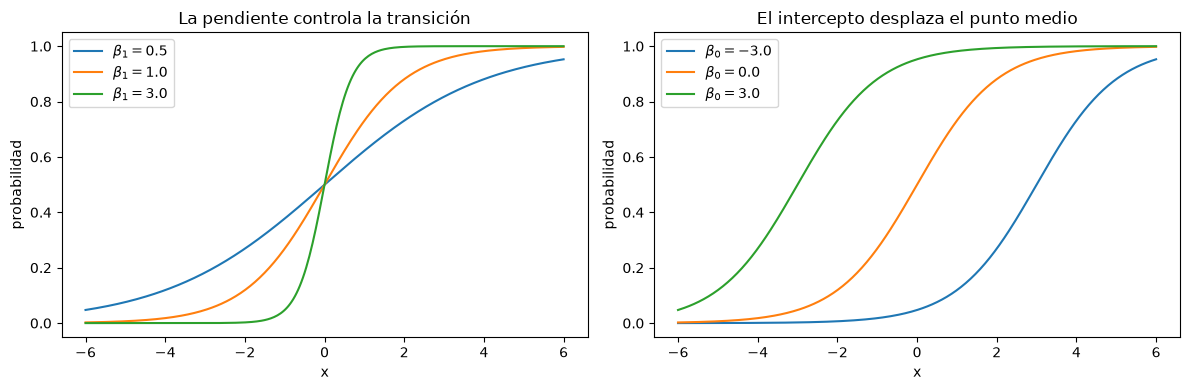
Cómo leer esta figura
En un modelo con una sola variable, una mayor magnitud de \(\beta_1\) hace más abrupta la transición; su signo determina si la probabilidad sube o baja. El intercepto \(\beta_0\) desplaza el punto donde \(p=0.5\). Ajustar la logística significa estimar esos parámetros en la escala logit por máxima verosimilitud: se eligen los valores de \(\beta\) que hacen más probables las respuestas 0/1 observadas. A diferencia de los mínimos cuadrados, no hay fórmula cerrada y la solución se obtiene de forma iterativa.
Ajustar el modelo predictivo
Separamos entrenamiento y prueba con estratificación para conservar aproximadamente la proporción de entregas puntuales en ambos conjuntos.
El modelo de scikit-learn tendrá un propósito predictivo: aprende únicamente con entrenamiento y se evalúa con probabilidades y decisiones sobre prueba. LogisticRegression aplica por defecto una penalización L2 (la misma de Ridge) con C=1.0, donde C es el inverso de la fuerza de la penalización; eso ayuda a estabilizar los coeficientes. Aquí no ajustamos C por validación cruzada porque el objetivo es ilustrar el modelo, no optimizarlo. Más adelante ajustaremos statsmodels sobre el mismo entrenamiento, pero con un propósito inferencial.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEMILLA, stratify=y
)

modelo_predictivo = LogisticRegression().fit(X_tr, y_tr)
prob_te = modelo_predictivo.predict_proba(X_te)[:, 1]
UMBRAL = 0.5
pred_te = (prob_te >= UMBRAL).astype(int)

print('Coeficientes predictivos (distancia, hora_pico):', modelo_predictivo.coef_[0].round(3))
print('Intercepto predictivo:', round(modelo_predictivo.intercept_[0], 3))
print(f'Probabilidades en prueba: {prob_te.min():.3f} a {prob_te.max():.3f}')
Coeficientes predictivos (distancia, hora_pico): [-0.171 -1.045]
Intercepto predictivo: 3.228
Probabilidades en prueba: 0.109 a 0.944Cómo leer estos coeficientes
Los signos son coherentes con el caso: una mayor distancia y estar en hora pico reducen el log-odds y, por tanto, la probabilidad de llegar a tiempo, manteniendo constante la otra variable.
No interpretes estos valores como puntos porcentuales. Además, son coeficientes del modelo predictivo regularizado. Para una lectura multiplicativa mediante odds ratios y para obtener p-valores ajustaremos después un modelo inferencial sobre el mismo conjunto de entrenamiento.
Visualizar el ajuste
Antes de interpretar los odds ratios, dibujemos la probabilidad estimada según la distancia para una entrega fuera de hora pico y para una entrega en hora pico. Las dos curvas proceden del mismo modelo; solo cambia el indicador hora_pico.
distancia_grid = np.linspace(0, 30, 300)
for indicador_pico, color, etiqueta in [
    (0, 'seagreen', 'fuera de hora pico'),
    (1, 'firebrick', 'hora pico'),
]:
    X_grid = np.column_stack([distancia_grid, np.full_like(distancia_grid, indicador_pico)])
    plt.plot(
        distancia_grid,
        modelo_predictivo.predict_proba(X_grid)[:, 1],
        color=color, linewidth=2, label=etiqueta,
    )

plt.axhline(0.5, color='gray', ls='--', alpha=0.6)
plt.xlabel('distancia (km)')
plt.ylabel('probabilidad de llegar a tiempo')
plt.title('Probabilidad estimada según distancia y hora pico')
plt.legend()
plt.show()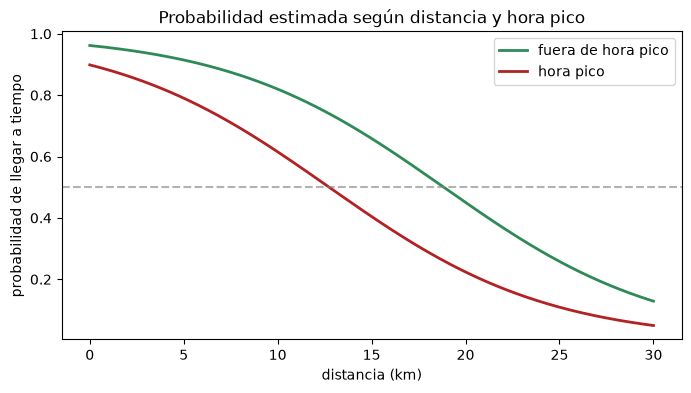
Cómo leer estas curvas
Son dos sigmoides con la misma pendiente en la escala logit y distinto intercepto. En la escala de probabilidad se ven desplazadas, pero su separación vertical no es constante. A igual distancia, la curva de hora pico asigna una menor probabilidad de llegar a tiempo. La línea horizontal marca el umbral 0.5: fuera de hora pico la curva lo cruza cerca de los 18.8 km y en hora pico cerca de los 12.7 km. Esos 6.1 km de diferencia son el efecto de hora_pico expresado en distancia: \(1.045/0.171\approx6.1\).
Modelo inferencial y odds ratios
Ahora ajustamos statsmodels sobre el mismo conjunto de entrenamiento. Su propósito es inferencial: obtener coeficientes, odds ratios y p-valores.
LogisticRegression usa regularización L2 por defecto; sm.Logit no regulariza. Por eso sus coeficientes pueden diferir aunque vean las mismas observaciones. Si necesitas coeficientes comparables, ajusta scikit-learn sin penalización con LogisticRegression(C=np.inf): desde la versión 1.8 el parámetro penalty está obsoleto (emite un aviso y se eliminará en la 1.10).
Para una variable \(x_j\), \(e^{\beta_j}\) es el odds ratio (razón de odds): el factor por el que se multiplican las odds cuando \(x_j\) aumenta una unidad, manteniendo constantes las demás variables. Para un cambio de \(d\) unidades, el factor acumulado es \((e^{\beta_j})^d\).
X_tr_sm = sm.add_constant(X_tr)
modelo_inferencial = sm.Logit(y_tr, X_tr_sm).fit(disp=0)

nombres = ['intercepto', 'distancia', 'hora_pico']
coeficientes = pd.Series(modelo_inferencial.params, index=nombres)
odds_ratios = np.exp(coeficientes)
p_valores = pd.Series(modelo_inferencial.pvalues, index=nombres)

ic_or = np.exp(modelo_inferencial.conf_int())   # IC 95% en escala de odds ratio

tabla_inferencia = pd.DataFrame({
    'coeficiente': coeficientes.round(4),
    'odds ratio': odds_ratios.round(4),
    'OR IC95% inf': ic_or[:, 0].round(3),
    'OR IC95% sup': ic_or[:, 1].round(3),
    'p-valor': p_valores.map(lambda v: f'{v:.1e}'),
})
display(tabla_inferencia)

or_distancia_10km = odds_ratios['distancia'] ** 10
print(f"OR acumulado para 10 km adicionales: {or_distancia_10km:.3f}")

perfiles = pd.DataFrame({
    'distancia_km': [5, 5, 15, 15, 25, 25],
    'hora_pico': [0, 1, 0, 1, 0, 1],
})
X_perfiles = perfiles[['distancia_km', 'hora_pico']].to_numpy()
perfiles['probabilidad_llegar_a_tiempo'] = modelo_predictivo.predict_proba(X_perfiles)[:, 1]
display(perfiles.round(3))| coeficiente | odds ratio | OR IC95% inf | OR IC95% sup | p-valor | |
|---|---|---|---|---|---|
| intercepto | 3.2675 | 26.2451 | 14.257 | 48.315 | 9.2e-26 |
| distancia | -0.1724 | 0.8416 | 0.814 | 0.870 | 1.2e-24 |
| hora_pico | -1.0893 | 0.3364 | 0.225 | 0.504 | 1.3e-07 |
OR acumulado para 10 km adicionales: 0.178| distancia_km | hora_pico | probabilidad_llegar_a_tiempo | |
|---|---|---|---|
| 0 | 5 | 0 | 0.915 |
| 1 | 5 | 1 | 0.790 |
| 2 | 15 | 0 | 0.659 |
| 3 | 15 | 1 | 0.404 |
| 4 | 25 | 0 | 0.258 |
| 5 | 25 | 1 | 0.109 |
Cómo leer la inferencia y los perfiles
- El odds ratio estimado para distancia es 0.8416 por kilómetro (IC 95%: 0.814 a 0.870): cada kilómetro adicional multiplica las odds de llegar a tiempo por 0.84, es decir, las reduce cerca de un 16%. Para 10 km, el efecto acumulado es \(0.8416^{10}\approx0.178\): las odds quedan en menos de una quinta parte.
- A igual distancia, hora pico multiplica las odds de llegar a tiempo por 0.336 (IC 95%: 0.225 a 0.504), una reducción cercana al 66%. El efecto acumulado de distancia depende de cuántos kilómetros compares, así que no corresponde ordenar ambos factores usando cambios en unidades distintas.
- Los p-valores, todos del orden de \(10^{-7}\) o menores, aportan evidencia contra la hipótesis de que el coeficiente sea cero, bajo los supuestos del modelo; no demuestran causalidad ni importancia práctica.
La tabla de perfiles, calculada con el modelo predictivo, devuelve la conversación a la escala más fácil de comunicar: a 5 km la probabilidad de llegar a tiempo es 0.915 fuera de hora pico y 0.790 en hora pico; a 25 km baja a 0.258 y 0.109. La brecha por hora pico es de 12.4 puntos porcentuales a 5 km, 25.4 a 15 km y 14.9 a 25 km: el mismo odds ratio produce diferencias distintas en la escala de probabilidad, como anticipaban las curvas. De paso, la penalización por defecto de scikit-learn casi no se nota con 560 observaciones de entrenamiento: su intercepto (3.228) y sus pendientes (−0.171 y −1.045) quedan muy cerca de los de statsmodels (3.268, −0.172 y −1.089).
De la probabilidad a la decisión
El modelo estima la probabilidad de que la entrega llegue a tiempo. Para convertirla en una decisión usamos un umbral: con 0.5, declaramos “llega a tiempo” cuando \(\hat p\geq0.5\).
- Falso positivo: prometimos “llega a tiempo”, pero llegó tarde. Es una falsa promesa.
- Falso negativo: predijimos “no llega a tiempo”, pero sí llegó. Es una alerta innecesaria.
Un umbral alto exige más evidencia antes de prometer puntualidad: reduce falsas promesas, pero genera más alertas innecesarias. Un umbral bajo declara más entregas como puntuales: aumenta la cobertura de los casos que sí llegan, pero puede producir más falsas promesas.
Primero compararemos la exactitud (proporción de entregas clasificadas correctamente) con una línea base (baseline): la regla ingenua que siempre predice la clase mayoritaria. Después observaremos cómo cambian los errores al mover el umbral y usaremos el AUC (área bajo la curva ROC) para evaluar la capacidad de ordenar casos sin fijar un único corte.
acc = accuracy_score(y_te, pred_te)
auc = roc_auc_score(y_te, prob_te)
accuracy_base = max(y_te.mean(), 1 - y_te.mean())

cm = confusion_matrix(y_te, pred_te)
print(f'Matriz de confusión con umbral = {UMBRAL:.2f}:')
display(pd.DataFrame(cm, index=['real: no', 'real: sí'], columns=['pred: no', 'pred: sí']))
print(f'Exactitud del modelo: {acc:.3f}')
print(f'Línea base (siempre la clase mayoritaria): {accuracy_base:.3f}')
print(f'Mejora absoluta sobre la línea base: {acc - accuracy_base:.3f}')
print(f'AUC: {auc:.3f}')

filas_umbral = []
for umbral in [0.3, 0.5, 0.7]:
    pred_umbral = (prob_te >= umbral).astype(int)
    tn, fp, fn, tp = confusion_matrix(y_te, pred_umbral).ravel()
    filas_umbral.append({
        'umbral': umbral,
        '% declarado puntual': pred_umbral.mean(),
        'falsas promesas (FP)': fp,
        'alertas innecesarias (FN)': fn,
        'exactitud': accuracy_score(y_te, pred_umbral),
    })

tabla_umbrales = pd.DataFrame(filas_umbral)
display(tabla_umbrales.round(3))
Matriz de confusión con umbral = 0.50:| pred: no | pred: sí | |
|---|---|---|
| real: no | 70 | 35 |
| real: sí | 35 | 100 |
Exactitud del modelo: 0.708
Línea base (siempre la clase mayoritaria): 0.562
Mejora absoluta sobre la línea base: 0.146
AUC: 0.800| umbral | % declarado puntual | falsas promesas (FP) | alertas innecesarias (FN) | exactitud | |
|---|---|---|---|---|---|
| 0 | 0.3 | 0.804 | 64 | 6 | 0.708 |
| 1 | 0.5 | 0.562 | 35 | 35 | 0.708 |
| 2 | 0.7 | 0.333 | 14 | 69 | 0.654 |
Cómo leer la línea base y los umbrales
La exactitud del modelo solo es informativa al compararla con una regla ingenua. La línea base responde: “¿qué lograría si siempre eligiera la clase más frecuente?”. Aquí el modelo acierta 0.708 frente a 0.562 de la línea base: 14.6 puntos porcentuales por encima de la regla ingenua.
La tabla de umbrales muestra que una misma exactitud puede esconder errores operativamente distintos: con umbral 0.3 y con umbral 0.5 el modelo acierta 0.708, pero el primero comete 64 falsas promesas y 6 alertas innecesarias, y el segundo 35 y 35. Subir el umbral reduce cuántas entregas declaramos puntuales (del 80.4% con 0.3 al 33.3% con 0.7) y nunca aumenta las falsas promesas (64 → 35 → 14), a costa de más alertas innecesarias (6 → 35 → 69). La elección debe reflejar cuál de esos errores cuesta más. Esta tabla se calcula sobre el conjunto de prueba solo para ilustrar: si quisieras elegir el umbral, hazlo con validación cruzada sobre el entrenamiento, como con cualquier hiperparámetro.
Evaluar sin fijar un único umbral: ROC y AUC
La curva ROC (receiver operating characteristic) recorre todos los umbrales y enfrenta dos tasas: la de verdaderos positivos, \(\text{TP}/(\text{TP}+\text{FN})\), que es la fracción de entregas puntuales que el modelo declara puntuales, y la de falsos positivos, \(\text{FP}/(\text{FP}+\text{TN})\), que es la fracción de entregas tardías que declara puntuales (las falsas promesas). Con umbral 0.5 valen 0.741 y 0.333. El AUC (área bajo esa curva) resume la capacidad del modelo para ordenar una entrega puntual por encima de una tardía según su probabilidad estimada.
fpr, tpr, _ = roc_curve(y_te, prob_te)
plt.plot(fpr, tpr, color='steelblue', linewidth=2, label=f'AUC = {auc:.3f}')
plt.plot([0, 1], [0, 1], 'k--', alpha=0.5, label='azar')
plt.xlabel('tasa de falsos positivos'); plt.ylabel('tasa de verdaderos positivos')
plt.title('Curva ROC'); plt.legend(); plt.show()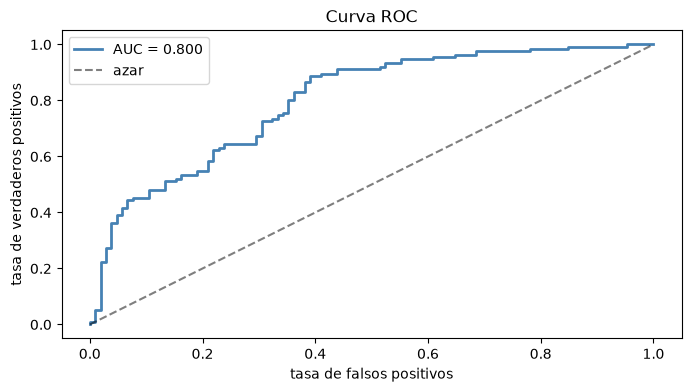
Cómo leer la curva ROC
Un AUC de 0.800 significa que, al elegir una entrega puntual y una tardía, el modelo asigna una probabilidad mayor de llegar a tiempo a la entrega puntual aproximadamente el 80% de las veces. Un AUC de 0.5 corresponde a un ordenamiento sin capacidad discriminativa.
La exactitud evalúa una decisión concreta bajo un umbral; el AUC evalúa el ordenamiento a través de todos los umbrales. Ninguna de las dos determina qué umbral conviene al negocio, y ninguna mide la calibración. Discriminación y calibración son preguntas distintas: el AUC responde si el modelo ordena bien los casos; la calibración, si cuando el modelo anuncia 0.80 aproximadamente 80 de cada 100 casos comparables llegan a tiempo. En este artículo usamos el AUC para medir discriminación; evaluar la calibración sería un paso adicional antes de desplegar probabilidades operativas.
Errores comunes en regresión logística
- Interpretar un coeficiente como cambio directo en probabilidad. \(\beta_j\) cambia los log-odds y \(e^{\beta_j}\) multiplica las odds.
- Confundir la clase positiva. Aquí 1 significa “llega a tiempo”; una probabilidad alta no significa “mayor riesgo de retraso”.
- Confundir probabilidad con decisión. El umbral convierte una estimación continua en una clase y debe responder al costo de los errores.
- Evaluar solamente con exactitud. Compárala con una línea base y revisa qué tipos de error produce cada umbral.
- Interpretar asociación como causalidad. Un coeficiente ajustado no demuestra que intervenir sobre la variable cause el cambio.
- Leer un p-valor como tamaño o importancia del efecto. El p-valor y el odds ratio responden preguntas diferentes.
- Comparar coeficientes regularizados y no regularizados como si fueran idénticos. scikit-learn y statsmodels pueden estimar valores distintos aun usando el mismo entrenamiento.
- Confundir discriminación con calibración. Un AUC alto no garantiza probabilidades bien calibradas.
Lo que debes llevarte de este artículo
La cadena completa es:
respuesta binaria
→ distribución Bernoulli
→ predictor lineal η = Xβ
→ enlace logit
→ probabilidad mediante la sigmoide
→ umbral elegido según costos
→ decisión: llega a tiempo / no llega a tiempo
Los coeficientes viven en log-odds; sus exponenciales son odds ratios. Para comunicar una predicción concreta usamos probabilidades por perfil. Para evaluar, comparamos contra una línea base, examinamos los errores del umbral y usamos AUC para medir discriminación.
La regresión logística conserva una estructura lineal, pero adapta la distribución y la función de enlace al tipo de respuesta. Esa es la idea general que reutilizaremos en los próximos artículos de la serie (Poisson y modelos aditivos): no forzar todas las respuestas a una recta gaussiana, sino elegir una distribución y un enlace coherentes con el fenómeno. De hecho, la regresión lineal de los primeros artículos es el GLM más simple: respuesta normal y enlace identidad.
¿Qué sigue?
El paralelo que prepara el siguiente artículo es directo:
| Modelo | Distribución de la respuesta | Función de enlace |
|---|---|---|
| Lineal | Normal | identidad |
| Logística | Bernoulli | logit |
| Poisson | Poisson | log |
En logística preguntamos si una entrega llega a tiempo. En Poisson preguntaremos cuántos eventos ocurren. Cambian la distribución y el enlace; permanece la arquitectura GLM.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.