import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.stats import poisson as poisson_dist
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression, PoissonRegressor
from sklearn.metrics import mean_absolute_error, mean_poisson_deviance
import statsmodels.api as sm

SEMILLA = 7
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (8, 4)
plt.rcParams['axes.spines.top'] = False
plt.rcParams['axes.spines.right'] = FalseAnálisis Avanzado de Datos — 9. GLM: regresión de Poisson
estadistica
glm
regresion-poisson
Regresión de Poisson para datos de conteo, otro miembro de la familia GLM.
Análisis Avanzado de Datos — 9. GLM: regresión de Poisson

👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
Cuando lo que cuentas son eventos
En el artículo anterior la respuesta era sí o no. Ahora la respuesta es un conteo: ¿cuántas incidencias tuvo una ruta? ¿cuántos pedidos llegaron en una hora? ¿cuántas llamadas recibió el centro de soporte? Son números enteros, nunca negativos, y a menudo con muchos ceros.
Usar una regresión lineal para conteos es un error clásico: puede predecir −1.5 incidencias, que es imposible. La regresión de Poisson —otro modelo lineal generalizado (GLM, por sus siglas en inglés)— está hecha justo para esto: modela la tasa a la que ocurren los eventos y garantiza predicciones positivas. La construimos sobre un caso de transporte: predecir el número de incidencias por ruta.
Objetivos de aprendizaje
Al terminar este notebook vas a ser capaz de:
- Reconocer cuándo una respuesta es un conteo y por qué una regresión lineal puede producir predicciones imposibles.
- Describir las tres piezas de un GLM de Poisson: distribución, predictor lineal y enlace log.
- Explicar por qué la función exponencial garantiza una tasa esperada positiva.
- Ajustar un modelo predictivo con
PoissonRegressor, elegir su regularización por validación cruzada y evaluarlo sobre datos de prueba. - Interpretar coeficientes como cocientes de tasas de incidencia (IRR), incluidos cambios de varias unidades.
- Distinguir el propósito predictivo de scikit-learn del propósito inferencial de statsmodels.
- Comparar el modelo con un baseline de media constante mediante deviance de Poisson.
- Reconocer el supuesto de equidispersión y la señal básica de sobredispersión.
Preparación del entorno
Los datos: incidencias por ruta
Simulamos 700 rutas. De cada una conocemos su longitud (km) y si tuvo clima adverso, y contamos cuántas incidencias (retrasos, fallos, novedades) ocurrieron. Por construcción, la tasa de incidencias sube con la longitud y con el mal clima.
n = 700
longitud = rng.uniform(5, 60, n)
clima_adverso = rng.integers(0, 2, n)

# Regla oculta: la tasa media crece con longitud y clima adverso.
tasa_real = np.exp(-1.0 + 0.045 * longitud + 0.6 * clima_adverso)
incidencias = rng.poisson(tasa_real)

X = np.column_stack([longitud, clima_adverso])
y = incidencias

print(f'Rutas: {n}')
print(f'Media de incidencias: {y.mean():.3f}')
print(f'Varianza de incidencias: {y.var(ddof=1):.3f}')
print(f'Máximo observado: {y.max()}')
print(f'Rutas sin incidencias: {np.mean(y == 0):.1%}')
pd.DataFrame({
    'longitud_km': longitud[:6],
    'clima_adverso': clima_adverso[:6],
    'incidencias': y[:6],
}).round(2)
Rutas: 700
Media de incidencias: 2.934
Varianza de incidencias: 7.544
Máximo observado: 19
Rutas sin incidencias: 16.1%| longitud_km | clima_adverso | incidencias | |
|---|---|---|---|
| 0 | 39.38 | 1 | 4 |
| 1 | 54.35 | 1 | 10 |
| 2 | 47.66 | 1 | 8 |
| 3 | 17.39 | 1 | 2 |
| 4 | 21.51 | 1 | 3 |
| 5 | 53.05 | 1 | 5 |
Cómo leer este resultado
Aquí verificamos primero la naturaleza de la respuesta: solo aparecen enteros no negativos, desde rutas sin incidencias hasta unas pocas rutas con conteos altos. La media global es 2.934 y la varianza 7.544, unas 2.6 veces mayor; pero ambas cifras resumen una mezcla de rutas cortas, largas y con climas distintos, así que no son todavía una prueba del supuesto de Poisson. Más adelante evaluaremos la dispersión después de explicar esas diferencias con el modelo.
La forma de una variable de conteo
Un conteo no llena una recta continua: toma valores \(0,1,2,\ldots\). Además, suele ser asimétrico, acumular observaciones cerca de cero y extender una cola hacia valores grandes. Veamos la distribución de incidencias antes de elegir un modelo.
valores = np.arange(y.max() + 1)
frecuencias = pd.Series(y).value_counts().reindex(valores, fill_value=0)

plt.bar(valores, frecuencias, color='steelblue', edgecolor='white')
plt.xlabel('número de incidencias')
plt.ylabel('número de rutas')
plt.title('Conteos discretos, asimétricos y con una cola a la derecha')
plt.xticks(valores)
plt.show()

print(f'Moda observada (número de incidencias): {frecuencias.idxmax()}')
print(f'Rutas con 0, 1 o 2 incidencias: {np.mean(y <= 2):.1%}')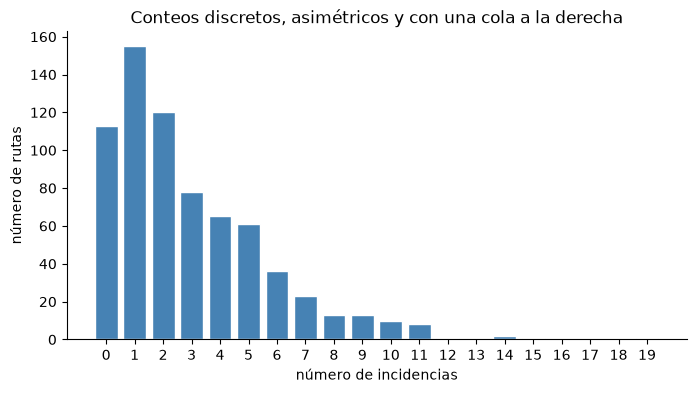
Moda observada (número de incidencias): 1
Rutas con 0, 1 o 2 incidencias: 55.4%
Cómo leer este resultado
El histograma no es una campana continua: son barras separadas para \(0,1,2,\ldots\), con mayor concentración en conteos bajos y una cola hacia la derecha. El conteo más frecuente es 1 y el 55.4% de las rutas tiene como máximo dos incidencias, mientras la cola llega hasta 19. Esa geometría pide una distribución definida sobre enteros no negativos.
La distribución de Poisson
Una variable Poisson cuenta eventos que ocurren en una unidad de exposición. Su parámetro \(\lambda>0\) es a la vez su media y su varianza. En un modelo de regresión, la condición se escribe dados los predictores \(X\):
\[ Y\mid X\sim\operatorname{Poisson}(\lambda), \qquad \mathbb{E}(Y\mid X)=\lambda, \qquad \operatorname{Var}(Y\mid X)=\lambda. \]
Esa igualdad entre media y varianza condicionales se llama equidispersión; al final del artículo verificamos si los datos la respetan.
No significa que todos los conteos tengan la misma media. En una regresión, cada ruta recibe su propia \(\lambda_i\) según sus características.
k = np.arange(0, 21)
for lambda_valor, color in [(1, 'steelblue'), (4, 'seagreen'), (10, 'firebrick')]:
    plt.plot(
        k, poisson_dist.pmf(k, mu=lambda_valor),
        marker='o', linewidth=2, color=color, label=rf'$\lambda={lambda_valor}$',
    )
plt.xlabel(r'conteo $y$')
plt.ylabel(r'$P(Y=y)$')
plt.title('La forma de Poisson cambia con la tasa esperada')
plt.legend()
plt.show()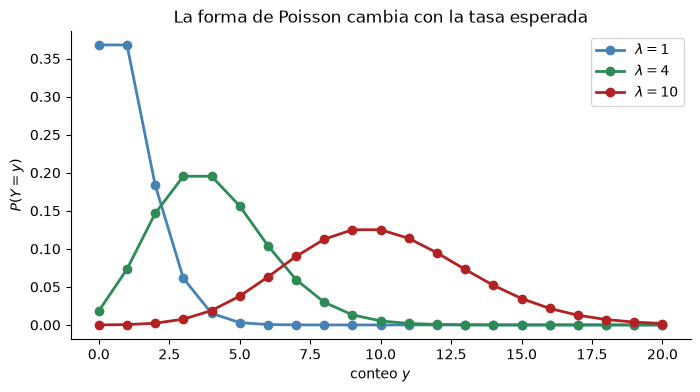
Cómo leer estas distribuciones
Con \(\lambda=1\), casi toda la masa está cerca de cero. Al subir a 4 y 10, el centro se desplaza a la derecha y la distribución se ensancha. En regresión no elegimos una sola de estas curvas para todas las rutas: estimamos una tasa \(\lambda_i\) distinta para cada combinación de longitud y clima.
Por qué la regresión lineal falla con conteos
Dividimos los datos en entrenamiento y prueba. Después ajustamos una regresión lineal ingenua con longitud y clima. Para visualizar el problema sin mezclar grupos, dibujamos su predicción para clima normal y la comparamos con rutas de entrenamiento bajo esa misma condición.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEMILLA
)

modelo_lineal = LinearRegression().fit(X_tr, y_tr)
pred_lineal_te = modelo_lineal.predict(X_te)

longitud_grid = np.linspace(0, 65, 300)
X_grid_normal = np.column_stack([longitud_grid, np.zeros_like(longitud_grid)])
pred_lineal_grid = modelo_lineal.predict(X_grid_normal)
mascara_normal_tr = X_tr[:, 1] == 0

plt.scatter(
    X_tr[mascara_normal_tr, 0], y_tr[mascara_normal_tr],
    s=14, alpha=0.25, color='steelblue', label='rutas con clima normal',
)
plt.plot(longitud_grid, pred_lineal_grid, color='firebrick', linewidth=2, label='regresión lineal')
plt.axhline(0, color='gray', ls=':')
plt.xlabel('longitud de la ruta (km)')
plt.ylabel('incidencias')
plt.title('La recta puede predecir conteos negativos')
plt.legend()
plt.show()

print(f'Predicción lineal a 0 km, clima normal: {modelo_lineal.predict([[0, 0]])[0]:.3f}')
print(f'Predicción mínima en prueba: {pred_lineal_te.min():.3f}')
print(f'Rutas de prueba con predicción negativa: {(pred_lineal_te < 0).sum()}')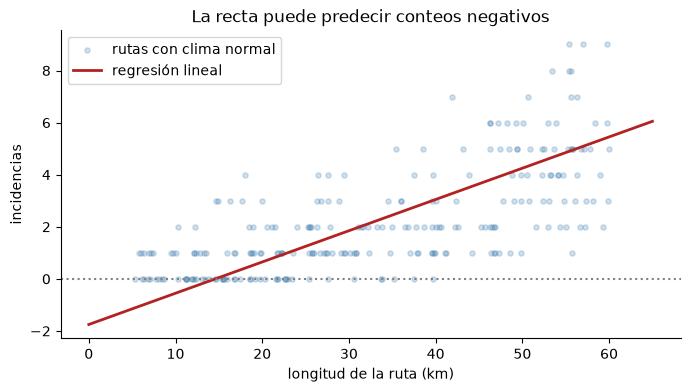
Predicción lineal a 0 km, clima normal: -1.752
Predicción mínima en prueba: -1.052
Rutas de prueba con predicción negativa: 16
Cómo leer este resultado
La recta no conoce la frontera natural en cero. Para rutas cortas con clima normal prolonga la tendencia hasta valores negativos: 16 rutas de prueba reciben predicciones imposibles, la menor de ellas −1.052 incidencias. El valor a 0 km (−1.752) es una extrapolación —ninguna ruta mide menos de 5 km—, pero las predicciones negativas de prueba sí ocurren dentro del rango observado. El problema no se resuelve recortando los negativos a cero: necesitamos una forma funcional cuya media sea positiva por construcción.
La arquitectura formal del GLM de Poisson
El modelo combina las mismas tres piezas que ya viste en logística:
- Distribución de la respuesta: cada conteo sigue una distribución Poisson condicional a sus predictores.
- Predictor lineal: longitud y clima se combinan sin restricciones en \(\eta_i\).
- Función de enlace: el logaritmo conecta la tasa media positiva con ese predictor.
\[ Y_i\sim\operatorname{Poisson}(\lambda_i), \]
\[ \eta_i=\beta_0+\beta_1x_{i1}+\cdots+\beta_kx_{ik}=X_i\beta, \]
\[ \log(\lambda_i)=\eta_i. \]
| Pieza | Regresión de Poisson |
|---|---|
| Respuesta | Poisson |
| Media | \(\lambda_i\) |
| Predictor lineal | \(X_i\beta\) |
| Enlace | log |
| Función inversa | exponencial |
Como \(\lambda_i=e^{\eta_i}\), la tasa esperada siempre es positiva.
El mismo esqueleto, otra respuesta
| Modelo | Distribución | Enlace | Inversa | Qué estima |
|---|---|---|---|---|
| Logística | Bernoulli | logit | sigmoide | probabilidad del sí |
| Poisson | Poisson | log | exponencial | tasa esperada de eventos |
La idea unificadora del GLM es mantener \(X\beta\) y adaptar la distribución y el enlace a la naturaleza de \(Y\).
Por qué modelamos el logaritmo de la tasa
La tasa \(\lambda\) no puede ser negativa, pero el predictor \(\eta=X\beta\) sí puede tomar cualquier valor real. El enlace log resuelve esa diferencia:
\[ \log(\lambda)=\eta \quad\Longleftrightarrow\quad \lambda=e^\eta. \]
La exponencial es la función inversa del enlace. Convierte toda la recta real en valores estrictamente positivos y transforma cambios aditivos en \(\eta\) en cambios multiplicativos sobre la tasa.
eta_grid = np.linspace(-3, 3, 300)
lambda_grid = np.exp(eta_grid)

plt.plot(eta_grid, lambda_grid, color='seagreen', linewidth=2)
plt.axhline(0, color='gray', ls=':')
plt.axvline(0, color='gray', ls=':')
plt.scatter([0], [1], color='firebrick', zorder=3, label=r'$e^0=1$')
plt.xlabel(r'predictor lineal $\eta=X\beta$')
plt.ylabel(r'tasa esperada $\lambda=e^\eta$')
plt.title('La exponencial transforma cualquier valor real en una tasa positiva')
plt.legend()
plt.show()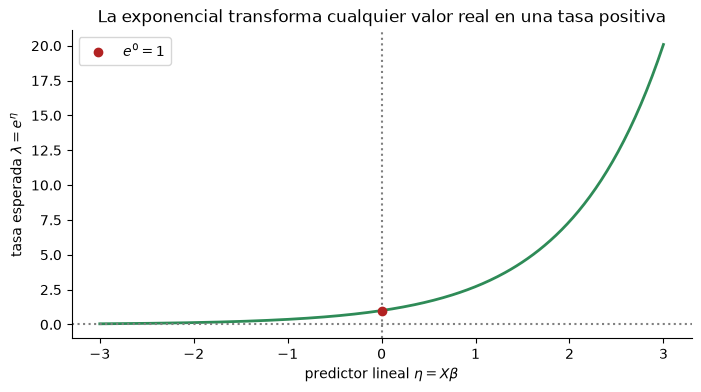
Cómo leer esta función
Cuando \(\eta=0\), la tasa esperada es 1. Valores negativos de \(\eta\) producen tasas entre 0 y 1; valores positivos producen tasas mayores que 1. La curva nunca cruza cero. Además, un incremento fijo en \(\eta\) multiplica la tasa, en lugar de sumarle siempre la misma cantidad.
Antes de seguir, pregúntate
Si \(\beta_1\) aumenta, ¿la tasa crece más rápido o más lento con la longitud? Si solo cambia \(\beta_0\), ¿cambia la forma del crecimiento o su nivel inicial? ¿Y qué efecto tendría sumar un coeficiente positivo cuando el clima es adverso?
x_coef = np.linspace(0, 60, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))

for beta_1 in [0.02, 0.045, 0.07]:
    ax[0].plot(x_coef, np.exp(-1 + beta_1 * x_coef), label=rf'$\beta_1={beta_1}$')
ax[0].set(title='La pendiente controla el ritmo de crecimiento', xlabel='longitud', ylabel='tasa esperada')
ax[0].legend()

for beta_0, etiqueta in [(-1.6, 'nivel bajo'), (-1.0, 'nivel medio'), (-0.4, 'nivel alto')]:
    ax[1].plot(x_coef, np.exp(beta_0 + 0.045 * x_coef), label=etiqueta)
ax[1].set(title='El intercepto cambia el nivel de la tasa', xlabel='longitud', ylabel='tasa esperada')
ax[1].legend()

plt.tight_layout()
plt.show()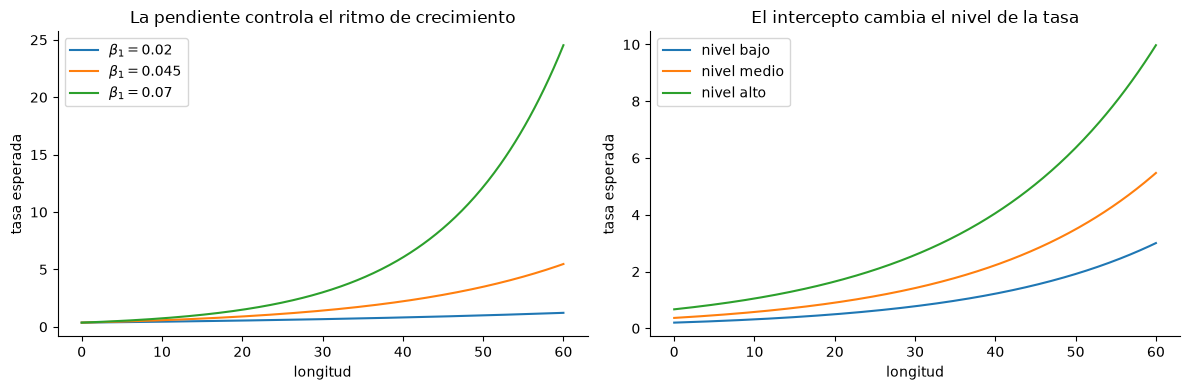
Cómo leer esta figura
Una pendiente mayor acelera el crecimiento multiplicativo de la tasa con la longitud. Cambiar el intercepto eleva o reduce toda la curva. Una variable binaria como clima adverso actúa de forma parecida a un cambio de nivel: cuando vale 1, suma su coeficiente en la escala log y multiplica la tasa por \(e^{\beta_{\text{clima}}}\).
Ajustar el modelo predictivo
El modelo de scikit-learn tendrá un propósito predictivo: aprende únicamente con entrenamiento y se evalúa sobre prueba. PoissonRegressor incluye una penalización L2 —la misma idea de Ridge del artículo de regularización— cuya intensidad controla alpha. Su valor por defecto, alpha=1.0, no tiene nada de especial para estos datos, así que lo tratamos como cualquier hiperparámetro: lo elegimos por validación cruzada (CV) con 5 particiones (folds) solo sobre el entrenamiento, en una malla de 11 valores entre \(10^{-4}\) y \(10\). Antes estandarizamos los predictores, porque la penalización L2 depende de la escala: sin estandarizar, contraería mucho más el coeficiente del clima (una variable 0/1) que el de la longitud (medida en km).
Para evaluar usamos la deviance media de Poisson, que compara cada conteo observado \(y_i\) con su tasa predicha \(\hat\lambda_i\):
\[ D=\frac{2}{n}\sum_{i=1}^{n}\left[y_i\log\frac{y_i}{\hat\lambda_i}-(y_i-\hat\lambda_i)\right], \]
con la convención \(y_i\log(y_i/\hat\lambda_i)=0\) cuando \(y_i=0\). Vale 0 si cada predicción coincide con su conteo y crece con la discrepancia: cuanto menor, mejor. La complementamos con el error absoluto medio (MAE), el promedio de \(|y_i-\hat\lambda_i|\), que se lee directamente en incidencias por ruta.
alphas = np.logspace(-4, 1, 11)
busqueda = GridSearchCV(
    make_pipeline(StandardScaler(), PoissonRegressor(max_iter=1000)),
    {'poissonregressor__alpha': alphas},
    cv=KFold(n_splits=5, shuffle=True, random_state=SEMILLA),
    scoring='neg_mean_poisson_deviance',
).fit(X_tr, y_tr)
modelo_predictivo = busqueda.best_estimator_
pred_poisson_te = modelo_predictivo.predict(X_te)

alpha_opt = busqueda.best_params_['poissonregressor__alpha']
print(f'alpha elegido por CV: {alpha_opt:.4g} (rango probado: {alphas[0]:.0e} a {alphas[-1]:.0e})')
print('¿Cae en el borde del rango?', alpha_opt in (alphas[0], alphas[-1]))
print(f'Deviance media de CV con ese alpha: {-busqueda.best_score_:.3f}')
print(f'Predicción mínima en prueba: {pred_poisson_te.min():.3f}')
print(f'Predicción máxima en prueba: {pred_poisson_te.max():.3f}')
print(f'Deviance de Poisson en prueba: {mean_poisson_deviance(y_te, pred_poisson_te):.3f}')
print(f'MAE en prueba: {mean_absolute_error(y_te, pred_poisson_te):.3f}')
alpha elegido por CV: 0.01 (rango probado: 1e-04 a 1e+01)
¿Cae en el borde del rango? False
Deviance media de CV con ese alpha: 1.052
Predicción mínima en prueba: 0.490
Predicción máxima en prueba: 10.140
Deviance de Poisson en prueba: 1.063
MAE en prueba: 1.216Cómo leer este resultado
La validación cruzada eligió \(\alpha=\) 0.01, dentro del rango probado y no en su borde: una penalización pequeña, razonable con solo dos predictores y 490 rutas de entrenamiento.
Todas las predicciones de prueba son positivas —entre 0.490 y 10.140 incidencias— porque el modelo regresa a la escala de conteos mediante la exponencial. En prueba, la deviance media es 1.063 y el MAE, 1.216 incidencias por ruta; en la sección del baseline veremos si eso es mucho o poco.
Este modelo sirve para generar predicciones, no para construir p-valores; de eso se encarga el modelo inferencial de más adelante.
Visualizar la tasa ajustada
Dibujaremos la tasa esperada según longitud para clima normal y adverso. Los puntos son conteos observados, por eso permanecen dispersos alrededor de cada curva: el modelo estima la media condicional, no pretende pasar por cada observación.
longitud_grid = np.linspace(5, 60, 300)
for indicador_clima, color, etiqueta in [
    (0, 'seagreen', 'clima normal'),
    (1, 'firebrick', 'clima adverso'),
]:
    X_grid = np.column_stack([longitud_grid, np.full_like(longitud_grid, indicador_clima)])
    tasa_grid = modelo_predictivo.predict(X_grid)
    plt.plot(longitud_grid, tasa_grid, color=color, linewidth=2.5, label=etiqueta)
    mascara = clima_adverso == indicador_clima
    plt.scatter(longitud[mascara], y[mascara], s=12, alpha=0.15, color=color)

plt.xlabel('longitud de la ruta (km)')
plt.ylabel('incidencias observadas / tasa esperada')
plt.title('Tasa estimada según longitud y clima')
plt.legend()
plt.show()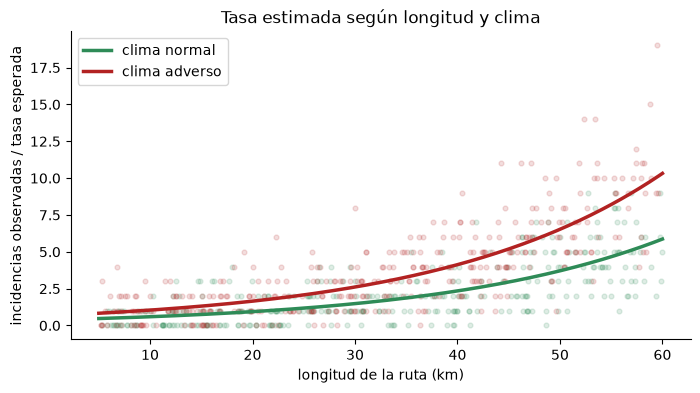
Cómo leer estas curvas
La tasa aumenta con la longitud y la curva de clima adverso queda por encima de la curva de clima normal. La separación es multiplicativa: a igual longitud, pasar a clima adverso multiplica la tasa por un factor constante, \(e^{\beta_{\text{clima}}}\). Como el eje vertical está en escala de conteos (no logarítmica), ese mismo factor se ve como una distancia entre curvas que crece con la longitud. La dispersión vertical de los puntos recuerda que una tasa esperada no es una predicción exacta del conteo individual.
Modelo inferencial y cocientes de tasas
Ajustamos con statsmodels un GLM de Poisson sobre el mismo conjunto de entrenamiento. Su propósito es inferencial: estimar coeficientes, cocientes de tasas de incidencia (IRR) y p-valores.
El modelo predictivo de scikit-learn usa una penalización L2 (pequeña, elegida por CV) sobre predictores estandarizados; este GLM de statsmodels no regulariza y trabaja con las variables en sus unidades originales. Aunque ambos reciben las mismas observaciones, sus coeficientes no son directamente comparables; lo comparable son sus predicciones. Para una variable \(x_j\):
\[ \operatorname{IRR}_j=e^{\beta_j}. \]
Un cambio de \(d\) unidades multiplica la tasa por \(e^{d\beta_j}=(e^{\beta_j})^d\).
X_tr_sm = sm.add_constant(X_tr)
modelo_inferencial = sm.GLM(
    y_tr, X_tr_sm, family=sm.families.Poisson()
).fit()

nombres = ['intercepto', 'longitud', 'clima_adverso']
coeficientes = pd.Series(modelo_inferencial.params, index=nombres)
irr = np.exp(coeficientes)
p_valores = pd.Series(modelo_inferencial.pvalues, index=nombres)

tabla_inferencia = pd.DataFrame({
    'coeficiente': coeficientes,
    'IRR': irr,
    'p-valor': p_valores,
})
display(tabla_inferencia.round(4))

irr_10_km = np.exp(10 * coeficientes['longitud'])
print(f'IRR acumulado para 10 km adicionales: {irr_10_km:.3f}')| coeficiente | IRR | p-valor | |
|---|---|---|---|
| intercepto | -0.9907 | 0.3713 | 0.0 |
| longitud | 0.0460 | 1.0471 | 0.0 |
| clima_adverso | 0.5675 | 1.7638 | 0.0 |
IRR acumulado para 10 km adicionales: 1.585Cómo leer estos cocientes de tasas
En el GLM inferencial, cada kilómetro adicional multiplica la tasa esperada por 1.047, es decir, la aumenta cerca de 4.7% manteniendo fijo el clima. Al acumular 10 km, el factor es 1.585: aproximadamente 58.5% más. A igual longitud, el clima adverso multiplica la tasa por 1.764, cerca de 76.4% más que el clima normal. Como los datos son simulados, puedes contrastarlo con la regla oculta: \(e^{0.045}\approx1.046\) por kilómetro y \(e^{0.6}\approx1.822\) para el clima; el modelo recupera ambos efectos con buena aproximación.
Los p-valores son tan pequeños que la tabla los muestra como 0.0 al redondear a cuatro decimales; aportan evidencia contra la hipótesis de coeficiente nulo bajo los supuestos del modelo; no demuestran causalidad ni importancia práctica. Tampoco corresponde ordenar cuál factor es “más importante” comparando cambios expresados en unidades diferentes.
Esta interpretación corresponde al modelo sin regularización ajustado en entrenamiento, y sus errores estándar y p-valores suponen equidispersión: la verificamos en la sección de dispersión. A continuación, los perfiles usan el modelo predictivo; como su penalización es pequeña, sus predicciones quedan muy cerca de las del GLM.
Tasas esperadas para rutas concretas
Comparamos rutas cortas, medias y largas bajo clima normal y adverso. Esta tabla lleva los coeficientes a la escala que necesita quien toma decisiones: número esperado de incidencias por ruta.
perfiles = pd.DataFrame({
    'tipo_ruta': ['corta', 'corta', 'media', 'media', 'larga', 'larga'],
    'longitud_km': [10, 10, 30, 30, 55, 55],
    'clima': ['normal', 'adverso', 'normal', 'adverso', 'normal', 'adverso'],
    'clima_adverso': [0, 1, 0, 1, 0, 1],
})
X_perfiles = perfiles[['longitud_km', 'clima_adverso']].to_numpy()
perfiles['incidencias_esperadas'] = modelo_predictivo.predict(X_perfiles)
display(perfiles[['tipo_ruta', 'longitud_km', 'clima', 'incidencias_esperadas']].round(3))| tipo_ruta | longitud_km | clima | incidencias_esperadas | |
|---|---|---|---|---|
| 0 | corta | 10 | normal | 0.594 |
| 1 | corta | 10 | adverso | 1.044 |
| 2 | media | 30 | normal | 1.484 |
| 3 | media | 30 | adverso | 2.611 |
| 4 | larga | 55 | normal | 4.665 |
| 5 | larga | 55 | adverso | 8.209 |
Cómo leer estos perfiles
En el modelo predictivo, una ruta de 30 km pasa de 1.484 incidencias esperadas con clima normal a 2.611 con clima adverso. Para 55 km, las predicciones son 4.665 y 8.209, respectivamente. En ambas longitudes el cociente adverso/normal es el mismo, cerca de 1.76, próximo al IRR de 1.764 del GLM: el clima actúa como un factor multiplicativo constante.
Estas cifras son medias esperadas: predecir 2.611 incidencias no significa observar una fracción de incidencia, sino que muchas rutas comparables promediarían aproximadamente 2.611 eventos.
Comparar contra un baseline
Una métrica aislada no dice si el modelo aporta valor. El baseline más simple ignora longitud y clima y predice para todas las rutas la media de conteos observada en entrenamiento. Compararemos ambos con la misma deviance de Poisson y con MAE sobre prueba.
pred_baseline = np.full(y_te.shape, y_tr.mean(), dtype=float)

deviance_modelo = mean_poisson_deviance(y_te, pred_poisson_te)
deviance_baseline = mean_poisson_deviance(y_te, pred_baseline)
mae_modelo = mean_absolute_error(y_te, pred_poisson_te)
mae_baseline = mean_absolute_error(y_te, pred_baseline)
reduccion_deviance = 1 - deviance_modelo / deviance_baseline

tabla_comparacion = pd.DataFrame({
    'modelo': ['media de entrenamiento', 'regresión de Poisson'],
    'deviance_poisson': [deviance_baseline, deviance_modelo],
    'MAE': [mae_baseline, mae_modelo],
})
display(tabla_comparacion.round(3))
print(f'Reducción relativa de deviance frente al baseline: {reduccion_deviance:.1%}')| modelo | deviance_poisson | MAE | |
|---|---|---|---|
| 0 | media de entrenamiento | 2.553 | 2.123 |
| 1 | regresión de Poisson | 1.063 | 1.216 |
Reducción relativa de deviance frente al baseline: 58.4%Cómo leer esta comparación
En prueba, la regresión de Poisson reduce la deviance de 2.553 a 1.063 y el MAE de 2.123 a 1.216 frente al baseline. La reducción relativa de deviance es 58.4%, de modo que longitud y clima sí aportan información predictiva fuera de entrenamiento.
Ese 58.4% mide mejora respecto a esta referencia concreta; no es un porcentaje de incidencias explicadas ni garantiza el mismo desempeño en otra población.
Revisar el supuesto de dispersión
En una Poisson ideal, la varianza condicional coincide con la media condicional. Una comprobación diagnóstica habitual es la razón de dispersión de Pearson:
\[ \widehat\phi=\frac{\chi^2_{\text{Pearson}}}{\text{grados de libertad residuales}}. \]
Valores cercanos a 1 son compatibles con la dispersión Poisson; valores claramente mayores sugieren sobredispersión y la necesidad de revisar el modelo o considerar alternativas como binomial negativa.
dispersion_pearson = modelo_inferencial.pearson_chi2 / modelo_inferencial.df_resid
ajuste_train = modelo_inferencial.fittedvalues
residuos_pearson = modelo_inferencial.resid_pearson

plt.scatter(ajuste_train, residuos_pearson, s=16, alpha=0.45, color='steelblue')
plt.axhline(0, color='firebrick', ls='--')
plt.xlabel('tasa ajustada en entrenamiento')
plt.ylabel('residuo de Pearson')
plt.title('Residuos de Pearson frente a la tasa ajustada')
plt.show()

print(f'Razón de dispersión de Pearson: {dispersion_pearson:.3f}')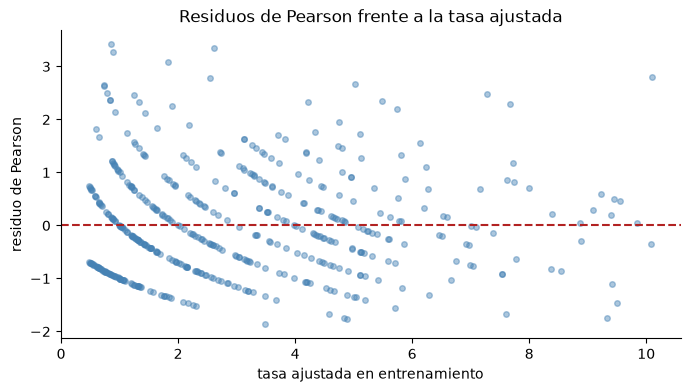
Razón de dispersión de Pearson: 0.983Cómo leer este diagnóstico
La razón de dispersión de Pearson es 0.983, muy próxima a 1; no aparece una señal global de sobredispersión en este ejemplo. Compárala con los datos crudos del inicio, donde la varianza (7.544) era unas 2.6 veces la media (2.934): ese exceso aparente venía de mezclar rutas con tasas distintas y desaparece cuando el modelo tiene en cuenta la longitud y el clima. Las bandas curvas del gráfico son esperables porque el conteo observado solo toma valores enteros, mientras la tasa ajustada es continua.
Este diagnóstico es orientativo, no una prueba automática. Una razón claramente superior a 1 o una estructura adicional de los residuos indicaría variabilidad o patrones que la Poisson no está capturando.
Errores comunes en regresión de Poisson
- Tratar cualquier entero como conteo Poisson. Debe representar eventos no negativos observados bajo una exposición comparable.
- Interpretar \(\beta_j\) como cambio aditivo en incidencias. El efecto es multiplicativo sobre la tasa; se interpreta con \(e^{\beta_j}\).
- Comparar IRR de variables con unidades distintas como si midieran importancia. Primero fija cambios relevantes, como 10 km frente a un cambio de clima.
- Reportar una deviance sin modelo de referencia (baseline). El modelo debe superar una predicción trivial sobre datos de prueba.
- Usar p-valores como prueba causal. Dependen de los supuestos y no sustituyen el tamaño ni la relevancia práctica del efecto.
- Ignorar la sobredispersión. Si la variabilidad excede claramente lo permitido por Poisson, los errores estándar y conclusiones pueden ser inadecuados.
- Confundir tasa esperada con conteo observado. Una predicción como 2.4 es una media para rutas comparables, no una incidencia fraccionaria.
- Olvidar la exposición. Si unas rutas representan más tiempo o distancia de observación que otras, puede necesitarse un offset.
Lo que debes llevarte de este artículo
La cadena completa es:
respuesta de conteo
→ distribución Poisson
→ predictor lineal η = Xβ
→ enlace log
→ tasa esperada λ = exp(η)
La exponencial garantiza tasas positivas. Los coeficientes se interpretan mediante IRR, el modelo predictivo se evalúa en prueba contra un baseline y el supuesto de dispersión debe revisarse antes de confiar en la inferencia.
Cierre técnico
La regresión de Poisson conserva el predictor lineal, pero adapta la distribución y el enlace a una respuesta de conteo. El paralelo queda así:
| Modelo | Distribución | Enlace | Escala de salida |
|---|---|---|---|
| Logística | Bernoulli | logit | probabilidad |
| Poisson | Poisson | log | tasa esperada |
Esa estructura común permite cambiar el tipo de respuesta sin abandonar el lenguaje de los GLM.
¿Qué sigue?
Hasta aquí, longitud y clima entran con efectos lineales en la escala log. Pero una relación real puede curvarse: quizá el riesgo crece lentamente en rutas medianas y se acelera en rutas muy largas.
Los modelos aditivos generalizados (GAM) combinan dos ideas que ya viste en la serie: la distribución y el enlace de un GLM con la flexibilidad local de los splines. El siguiente paso será permitir efectos no lineales sin perder la estructura interpretable del modelo.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.