import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.decomposition import PCA
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.model_selection import StratifiedKFold, cross_val_score, train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

SEMILLA = 2026
COLORES = ['#2A6F97', '#D97706', '#2D6A4F']
plt.rcParams.update({
    'figure.figsize': (9, 5),
    'axes.spines.top': False,
    'axes.spines.right': False,
    'axes.titleweight': 'bold',
})Análisis Avanzado de Datos — 11. Variables latentes I: Análisis de Componentes Principales (PCA)
estadistica
variables-latentes
pca
Análisis de Componentes Principales: reducción de dimensionalidad basada en varianza y componentes no correlacionados.
Análisis Avanzado de Datos — 11. Variables latentes I: Análisis de Componentes Principales (PCA)

👋 Sobre el autor
Wilder Ramírez Delgado convierte datos en decisiones. Científico de Datos, Arquitecto de IA y asesor tecnológico con más de 20 años de experiencia en analítica avanzada, machine learning, Big Data e IoT. Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), asesora a entidades gubernamentales y empresas privadas en Colombia y es referente en analítica y normatividad para los sectores postal y logístico del país. Una serie pensada para ir de la teoría a la práctica, con ejemplos concretos en cada paso.
📌 Parte de la serie Análisis Avanzado de Datos.
Un cambio de paradigma: de predecir a descubrir
Hasta ahora, de la regresión lineal a los GAM del artículo anterior, trabajaste en aprendizaje supervisado: tenías variables \(X\), una respuesta \(y\) y buscabas aprender una regla para predecir \(y\) a partir de \(X\). En este artículo cambia la pregunta: ya no buscas predecir una respuesta, sino encontrar variables latentes, es decir, estructura no observada directamente que organiza muchas variables a la vez.
El Análisis de Componentes Principales (PCA) es aprendizaje no supervisado. No recibe una variable objetivo. Examina únicamente las relaciones entre las variables de \(X\) para descubrir sus direcciones dominantes y representar los datos con menos dimensiones.
Usaremos las etiquetas reales de los vinos solo después, para colorear una figura y evaluar una aplicación predictiva. PCA no las verá al aprender sus componentes.
Objetivos de aprendizaje
Al terminar este notebook vas a ser capaz de:
- Explicar qué problema resuelve PCA y por qué sus componentes son ortogonales.
- Estandarizar las variables antes de aplicar PCA cuando sus escalas difieren.
- Interpretar la varianza explicada, el gráfico de sedimentación (scree plot) y la varianza acumulada.
- Elegir un número razonable de componentes mediante un umbral y contrastarlo con validación cruzada.
- Leer una proyección y las cargas de sus primeros componentes.
- Medir el compromiso entre compresión y error de reconstrucción.
- Distinguir PCA de un método supervisado y anticipar su diferencia con ICA (Análisis de Componentes Independientes), el próximo tema de la serie.
El problema formal: muchas coordenadas, estructura repetida
Cuando aumentan las variables, las observaciones se vuelven más dispersas y las distancias pierden contraste: es una cara de la maldición de la dimensionalidad. Además, si varias variables están correlacionadas, describen parte del mismo patrón y añaden redundancia.
PCA reemplaza las variables originales por nuevas coordenadas llamadas componentes principales. Cada componente es una combinación lineal de las variables; el primero busca la dirección de mayor dispersión, el segundo la mayor dispersión restante bajo la condición de ser perpendicular al primero, y así sucesivamente.
La optimización detrás de PCA
Sea \(X_c\) la matriz de datos centrada y sea \(w_1\) una dirección de longitud uno. La proyección de los datos sobre esa dirección es \(X_cw_1\). PCA elige:
\[ w_1=\underset{\lVert w\rVert_2=1}{\operatorname{arg\,max}}\;\operatorname{Var}(X_cw) =\underset{\lVert w\rVert_2=1}{\operatorname{arg\,max}}\;w^\top S w, \]
donde \(S=\frac{1}{n-1}X_c^\top X_c\) es la matriz de covarianza. Para el componente \(j\) se añade la restricción \(w_j^\top w_\ell=0\) para todo \(\ell<j\).
La solución conduce al problema de valores propios:
\[ Sw_j=\lambda_jw_j,\qquad \lambda_1\geq\lambda_2\geq\cdots\geq\lambda_p. \]
Como \(S\) es simétrica, sus vectores propios pueden elegirse ortonormales: \(W^\top W=I\). Los vectores \(w_j\) son las direcciones; los valores propios \(\lambda_j\) indican cuánta varianza captura cada dirección. Las nuevas coordenadas son las puntuaciones o scores \(Z=X_cW\) y quedan no correlacionadas entre sí.
Punto clave. PCA es no supervisado: encuentra direcciones de máxima varianza usando solo \(X\). No conoce las etiquetas, no intenta separar clases y una varianza grande no garantiza utilidad predictiva. Si luego coloreamos una proyección por clase, lo hacemos únicamente para interpretar una estructura que PCA descubrió sin esa información.
Qué significa girar el sistema de coordenadas
Imagina una nube alargada en diagonal. Los ejes horizontal y vertical no describen bien su forma. PCA gira los ejes: el primer eje queda sobre la dirección larga de la nube y el segundo, perpendicular, recoge la variación corta.
Este giro, por sí solo, no pierde información: con todos los ejes girados se recuperan exactamente los datos. La reducción ocurre cuando conservas las primeras \(k<p\) coordenadas y descartas las direcciones con poca varianza. Primero veremos esa idea con dos variables; solo después ajustaremos PCA sobre las trece.
Preparación del entorno
Los datos: trece mediciones químicas de vinos
Usaremos load_wine, un conjunto clásico incluido en scikit-learn y disponible sin internet. Cada fila es un vino; las 13 columnas son mediciones químicas como alcohol, magnesio, fenoles y prolina.
El conjunto también contiene tres clases de origen. Las guardaremos aparte: no entrarán al ajuste de PCA.
wine = load_wine(as_frame=True)
X = wine.data.copy()
y = wine.target.copy()
nombres_clase = wine.target_names

print(f'Observaciones: {X.shape[0]}')
print(f'Variables numéricas: {X.shape[1]}')
print('Observaciones por clase:', y.value_counts().sort_index().to_dict())
display(X.head().round(2))
display(X.describe().loc[['mean', 'std', 'min', 'max']].round(2))
Observaciones: 178
Variables numéricas: 13
Observaciones por clase: {0: 59, 1: 71, 2: 48}| alcohol | malic_acid | ash | alcalinity_of_ash | magnesium | total_phenols | flavanoids | nonflavanoid_phenols | proanthocyanins | color_intensity | hue | od280/od315_of_diluted_wines | proline | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 14.23 | 1.71 | 2.43 | 15.6 | 127.0 | 2.80 | 3.06 | 0.28 | 2.29 | 5.64 | 1.04 | 3.92 | 1065.0 |
| 1 | 13.20 | 1.78 | 2.14 | 11.2 | 100.0 | 2.65 | 2.76 | 0.26 | 1.28 | 4.38 | 1.05 | 3.40 | 1050.0 |
| 2 | 13.16 | 2.36 | 2.67 | 18.6 | 101.0 | 2.80 | 3.24 | 0.30 | 2.81 | 5.68 | 1.03 | 3.17 | 1185.0 |
| 3 | 14.37 | 1.95 | 2.50 | 16.8 | 113.0 | 3.85 | 3.49 | 0.24 | 2.18 | 7.80 | 0.86 | 3.45 | 1480.0 |
| 4 | 13.24 | 2.59 | 2.87 | 21.0 | 118.0 | 2.80 | 2.69 | 0.39 | 1.82 | 4.32 | 1.04 | 2.93 | 735.0 |
| alcohol | malic_acid | ash | alcalinity_of_ash | magnesium | total_phenols | flavanoids | nonflavanoid_phenols | proanthocyanins | color_intensity | hue | od280/od315_of_diluted_wines | proline | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| mean | 13.00 | 2.34 | 2.37 | 19.49 | 99.74 | 2.30 | 2.03 | 0.36 | 1.59 | 5.06 | 0.96 | 2.61 | 746.89 |
| std | 0.81 | 1.12 | 0.27 | 3.34 | 14.28 | 0.63 | 1.00 | 0.12 | 0.57 | 2.32 | 0.23 | 0.71 | 314.91 |
| min | 11.03 | 0.74 | 1.36 | 10.60 | 70.00 | 0.98 | 0.34 | 0.13 | 0.41 | 1.28 | 0.48 | 1.27 | 278.00 |
| max | 14.83 | 5.80 | 3.23 | 30.00 | 162.00 | 3.88 | 5.08 | 0.66 | 3.58 | 13.00 | 1.71 | 4.00 | 1680.00 |
Cómo leer este resultado
Tenemos 178 vinos y 13 variables. Las clases contienen 59, 71 y 48 observaciones, pero esas etiquetas quedan fuera de \(X\). Fíjate también en las escalas: nonflavanoid_phenols va de 0.13 a 0.66, mientras proline va de 278 a 1680. Esta diferencia será decisiva antes de calcular PCA.
Paso 1: detectar redundancia entre variables
Trece variables no parecen demasiadas, pero ya dificultan una inspección conjunta. Una matriz de correlaciones permite detectar pares que se mueven de forma parecida. Si abundan correlaciones altas, existe información compartida que unas pocas direcciones podrían resumir.
correlaciones = X.corr()
fig, ax = plt.subplots(figsize=(10, 8))
imagen = ax.imshow(correlaciones, cmap='RdBu_r', vmin=-1, vmax=1)
ax.set_xticks(range(X.shape[1]), X.columns, rotation=70, ha='right')
ax.set_yticks(range(X.shape[1]), X.columns)
ax.set_title('Correlación entre las 13 mediciones')
fig.colorbar(imagen, ax=ax, shrink=0.8, label='correlación')
plt.tight_layout()
plt.show()

triangulo = correlaciones.where(np.triu(np.ones(correlaciones.shape), k=1).astype(bool))
pares = triangulo.stack().rename('correlación').to_frame()
pares['magnitud'] = pares['correlación'].abs()
display(pares.sort_values('magnitud', ascending=False).head(6).round(3))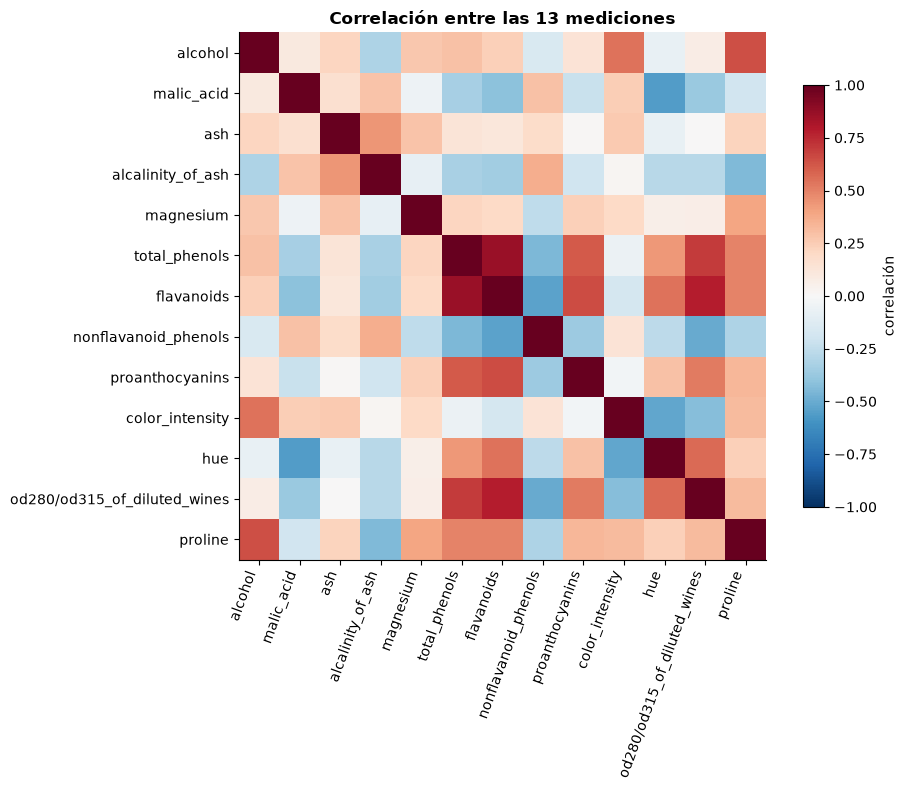
| correlación | magnitud | ||
|---|---|---|---|
| total_phenols | flavanoids | 0.865 | 0.865 |
| flavanoids | od280/od315_of_diluted_wines | 0.787 | 0.787 |
| total_phenols | od280/od315_of_diluted_wines | 0.700 | 0.700 |
| flavanoids | proanthocyanins | 0.653 | 0.653 |
| alcohol | proline | 0.644 | 0.644 |
| total_phenols | proanthocyanins | 0.612 | 0.612 |
Cómo leer este resultado
El mapa no es uniforme: hay un bloque rojo de variables fenólicas (total_phenols, flavanoids, proanthocyanins, od280/od315_of_diluted_wines) y varias celdas azules, que marcan correlaciones negativas. El par más correlacionado es total_phenols–flavanoids, con \(r=0.865\). También aparecen relaciones fuertes con od280/od315_of_diluted_wines: 0.787 con flavanoids y 0.700 con total_phenols. No necesitamos elegir una variable y borrar la otra: PCA puede condensar su movimiento compartido.
Paso 2: estandarizar antes de PCA
PCA maximiza varianza. Si una variable está medida con números mucho mayores, puede dominar el resultado solo por sus unidades. Aquí la prolina usa centenas y miles, mientras otras mediciones se mantienen por debajo de 1.
Por eso la estandarización es obligatoria en este ejemplo. StandardScaler, que ya conoces, transforma cada columna como
\[ z_{ij}=\frac{x_{ij}-\bar{x}_j}{\sigma_j}, \qquad \sigma_j=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_{ij}-\bar{x}_j)^2}. \]
Así, cada variable queda con media cercana a 0 y desviación estándar poblacional cercana a 1. PCA sobre datos estandarizados equivale a trabajar con la estructura de correlaciones, no con las unidades originales.
escalador = StandardScaler()
X_std = escalador.fit_transform(X)

pca_sin_escalar = PCA().fit(X)
pca_estandarizado_previo = PCA().fit(X_std)
variable_dominante = X.columns[np.argmax(np.abs(pca_sin_escalar.components_[0]))]

print(f'Máxima media estandarizada en valor absoluto: {np.abs(X_std.mean(axis=0)).max():.2e}')
print(f'Desviaciones estándar poblacionales: {X_std.std(axis=0).min():.3f} a {X_std.std(axis=0).max():.3f}')
print(f'Sin escalar, PC1 explica: {pca_sin_escalar.explained_variance_ratio_[0]:.2%}')
print(f'Variable dominante sin escalar: {variable_dominante}')
print(f'Estandarizado, PC1 explica: {pca_estandarizado_previo.explained_variance_ratio_[0]:.2%}')
Máxima media estandarizada en valor absoluto: 8.38e-16
Desviaciones estándar poblacionales: 1.000 a 1.000
Sin escalar, PC1 explica: 99.81%
Variable dominante sin escalar: proline
Estandarizado, PC1 explica: 36.20%Cómo leer este resultado
Tras escalar, las medias son numéricamente 0 y todas las desviaciones estándar poblacionales son 1.000. Sin estandarizar, PC1 (el primer componente principal; PC2 será el segundo, y así sucesivamente) atribuye 99.81% de la varianza a una dirección dominada por proline: el algoritmo está leyendo unidades. Estandarizado, PC1 explica 36.20% y combina varias mediciones.
La regla práctica es simple: si las unidades o escalas difieren, coloca StandardScaler antes de PCA. En un flujo predictivo ambos deben ir dentro del mismo Pipeline para evitar fuga de información.
Paso 3: intuición geométrica con dos variables
Tomemos las dos variables más correlacionadas. Después de estandarizarlas, una flecha mostrará el primer vector propio. Su orientación debe seguir el eje largo de la nube; una segunda dirección ortogonal recogería la dispersión restante.
variables_2d = ['total_phenols', 'flavanoids']
X_2d = StandardScaler().fit_transform(X[variables_2d])
pca_2d = PCA(n_components=2).fit(X_2d)
direccion_pc1 = pca_2d.components_[0]
longitud = 2.5 * np.sqrt(pca_2d.explained_variance_[0])

plt.scatter(X_2d[:, 0], X_2d[:, 1], s=28, alpha=0.55, color='#457B9D')
plt.arrow(0, 0, longitud * direccion_pc1[0], longitud * direccion_pc1[1],
          width=0.035, head_width=0.18, color='#C2410C', length_includes_head=True)
plt.axhline(0, color='gray', lw=0.8, alpha=0.5)
plt.axvline(0, color='gray', lw=0.8, alpha=0.5)
plt.xlabel('fenoles totales (estandarizada)')
plt.ylabel('flavonoides (estandarizada)')
plt.title('PC1 sigue la dirección de máxima varianza')
plt.axis('equal')
plt.show()

print(f'Correlación entre las variables: {X[variables_2d].corr().iloc[0, 1]:.3f}')
print(f'Varianza explicada por PC1 en este plano: {pca_2d.explained_variance_ratio_[0]:.2%}')
print('Dirección de PC1:', np.round(direccion_pc1, 3))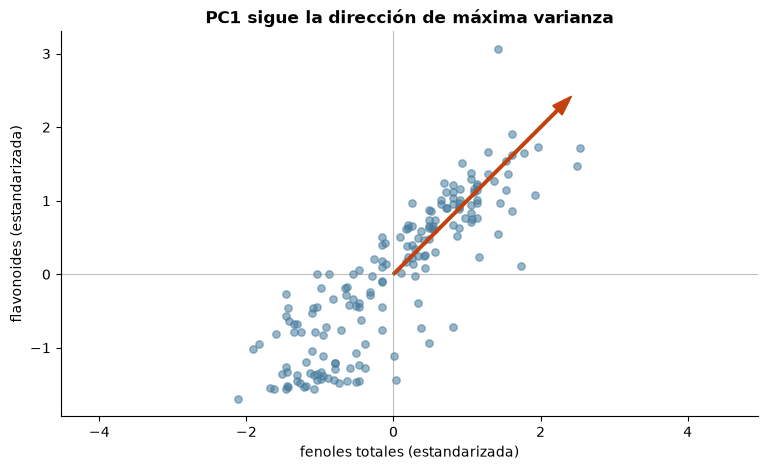
Correlación entre las variables: 0.865
Varianza explicada por PC1 en este plano: 93.23%
Dirección de PC1: [0.707 0.707]
Cómo leer este resultado
Las dos variables tienen correlación 0.865 y forman una nube alargada. La flecha de PC1 apunta en la dirección \((0.707, 0.707)=(1,1)/\sqrt{2}\): ambas variables contribuyen en el mismo sentido y con el mismo peso. Con dos variables estandarizadas y correlación positiva esto no es casualidad: la matriz de correlaciones \(\begin{pmatrix}1&r\\r&1\end{pmatrix}\) siempre tiene ese vector propio, con \(\lambda_1=1+r\). Por eso esa única dirección conserva \((1+r)/2=\) 93.23% de la varianza de este plano. Lo que los datos deciden es cuánta varianza captura PC1, no hacia dónde apunta; con más de dos variables, en cambio, la dirección sí depende de toda la estructura de correlaciones.
La ortogonalidad tiene una consecuencia útil: las coordenadas principales quedan no correlacionadas. Pero no confundas “no correlacionadas” con “independientes”; esa diferencia será central cuando lleguemos a ICA.
Antes de seguir, pregúntate
Si una sola dirección resume 93.23% de este plano, ¿qué esperas que ocurra al extender la idea a 13 variables? ¿Conservar dos componentes bastará, o necesitaremos más para retener el 90% de la información medida como varianza?
Paso 4: ajustar PCA completo
Ahora sí usamos las 13 variables estandarizadas. Ajustamos todos los componentes para observar cómo se reparte la varianza antes de decidir cuántos conservar. La proporción de varianza explicada (PVE) por el componente \(j\) es
\[ \text{PVE}_j=\frac{\lambda_j}{\sum_{\ell=1}^{p}\lambda_\ell}. \]
pca_completo = PCA()
scores = pca_completo.fit_transform(X_std)
varianza_explicada = pca_completo.explained_variance_ratio_
varianza_acumulada = np.cumsum(varianza_explicada)

W = pca_completo.components_.T
error_ortogonalidad = np.max(np.abs(W.T @ W - np.eye(X.shape[1])))
covarianza_scores = np.cov(scores, rowvar=False)
max_covarianza_cruzada = np.max(np.abs(covarianza_scores - np.diag(np.diag(covarianza_scores))))

tabla_varianza = pd.DataFrame({
    'componente': np.arange(1, X.shape[1] + 1),
    'varianza_explicada': varianza_explicada,
    'varianza_acumulada': varianza_acumulada,
})
display(tabla_varianza.style.format({
    'varianza_explicada': '{:.2%}',
    'varianza_acumulada': '{:.2%}',
}))
print(f'Error máximo en WᵀW = I: {error_ortogonalidad:.2e}')
print(f'Máxima covarianza cruzada entre scores: {max_covarianza_cruzada:.2e}')| componente | varianza_explicada | varianza_acumulada | |
|---|---|---|---|
| 0 | 1 | 36.20% | 36.20% |
| 1 | 2 | 19.21% | 55.41% |
| 2 | 3 | 11.12% | 66.53% |
| 3 | 4 | 7.07% | 73.60% |
| 4 | 5 | 6.56% | 80.16% |
| 5 | 6 | 4.94% | 85.10% |
| 6 | 7 | 4.24% | 89.34% |
| 7 | 8 | 2.68% | 92.02% |
| 8 | 9 | 2.22% | 94.24% |
| 9 | 10 | 1.93% | 96.17% |
| 10 | 11 | 1.74% | 97.91% |
| 11 | 12 | 1.30% | 99.20% |
| 12 | 13 | 0.80% | 100.00% |
Error máximo en WᵀW = I: 1.78e-15
Máxima covarianza cruzada entre scores: 7.43e-16
Cómo leer esta tabla
PC1 explica 36.20% y PC2, 19.21%. Juntas conservan 55.41% de la varianza total: resumen mucho, pero casi la mitad todavía queda en otras direcciones. PC3 añade 11.12% y lleva el acumulado a 66.53%.
Las contribuciones disminuyen porque PCA ordena los valores propios de mayor a menor. Además, el error máximo de \(1.78\times10^{-15}\) en \(W^\top W=I\) confirma que las direcciones son ortonormales, y la máxima covarianza cruzada de \(7.43\times10^{-16}\) confirma que los scores están no correlacionados, salvo precisión numérica.
No existe una frontera universal entre componente útil e inútil; necesitas una regla explícita ligada al propósito.
Cuántos componentes conservar
Dos criterios habituales son:
- Regla del codo: busca dónde las ganancias marginales del scree plot comienzan a aplanarse. Es visual y puede ser ambigua.
- Umbral acumulado: elige el menor \(k\) que alcance, por ejemplo, 90% o 95% de varianza. Es reproducible, pero el umbral depende del costo de perder información.
Para una tarea predictiva, \(k\) es un hiperparámetro: conviene contrastarlo mediante validación cruzada sobre entrenamiento, no escogerlo mirando el conjunto de prueba.
componentes = np.arange(1, X.shape[1] + 1)
k_90 = np.argmax(varianza_acumulada >= 0.90) + 1
k_95 = np.argmax(varianza_acumulada >= 0.95) + 1

fig, ax = plt.subplots(1, 2, figsize=(12, 4.5))
ax[0].bar(componentes, varianza_explicada, color='#457B9D')
ax[0].plot(componentes, varianza_explicada, color='#17324D', marker='o')
ax[0].set(title='Scree plot', xlabel='componente', ylabel='proporción de varianza')
ax[0].set_xticks(componentes)

ax[1].plot(componentes, varianza_acumulada, color='#2D6A4F', marker='o', lw=2)
ax[1].axhline(0.90, color='#D97706', ls='--', label='90%')
ax[1].axhline(0.95, color='#B42318', ls=':', label='95%')
ax[1].set(title='Varianza explicada acumulada', xlabel='número de componentes', ylabel='proporción acumulada', ylim=(0, 1.03))
ax[1].set_xticks(componentes)
ax[1].legend()
plt.tight_layout()
plt.show()

print(f'Mínimo para alcanzar 90%: {k_90} componentes ({varianza_acumulada[k_90 - 1]:.2%})')
print(f'Mínimo para alcanzar 95%: {k_95} componentes ({varianza_acumulada[k_95 - 1]:.2%})')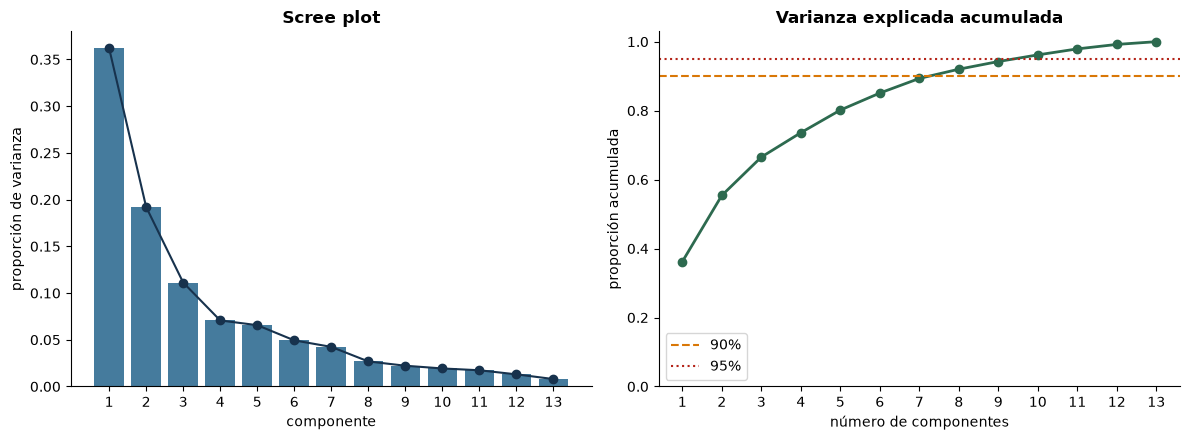
Mínimo para alcanzar 90%: 8 componentes (92.02%)
Mínimo para alcanzar 95%: 10 componentes (96.17%)
Cómo leer estas curvas
La pendiente cae con rapidez en los primeros componentes y luego se aplana: el codo visual está alrededor de 3 a 5 componentes. Con un criterio cuantitativo, necesitas 8 componentes para superar 90% (alcanzan 92.02%) y 10 para superar 95% (alcanzan 96.17%).
No hay contradicción: el codo favorece una representación compacta; el umbral exige conservar una fracción prefijada. La decisión final depende de si priorizas visualización, compresión o desempeño posterior.
Paso 5: proyectar los vinos en dos componentes
Para visualizar, conservamos PC1 y PC2. Cada punto seguirá siendo un vino, pero sus coordenadas ya no serán alcohol o magnesio: serán dos combinaciones de las 13 variables.
Colorearemos los puntos con la etiqueta real después de ajustar PCA. El color sirve para comprobar si la estructura no supervisada coincide con grupos conocidos; no participó en el cálculo de los ejes.
fig, ax = plt.subplots(figsize=(9, 6))
for clase, nombre, color in zip(np.unique(y), nombres_clase, COLORES):
    mascara = y.to_numpy() == clase
    ax.scatter(scores[mascara, 0], scores[mascara, 1], s=48, alpha=0.75,
               color=color, label=nombre, edgecolor='white', linewidth=0.4)
ax.axhline(0, color='gray', lw=0.8, alpha=0.5)
ax.axvline(0, color='gray', lw=0.8, alpha=0.5)
ax.set_xlabel(f'PC1 ({varianza_explicada[0]:.2%})')
ax.set_ylabel(f'PC2 ({varianza_explicada[1]:.2%})')
ax.set_title('Proyección no supervisada; color añadido solo para interpretar')
ax.legend(title='clase real')
plt.show()

centroides = pd.DataFrame(scores[:, :2], columns=['PC1', 'PC2']).assign(clase=y.to_numpy()).groupby('clase').mean()
centroides.index = nombres_clase
display(centroides.round(3))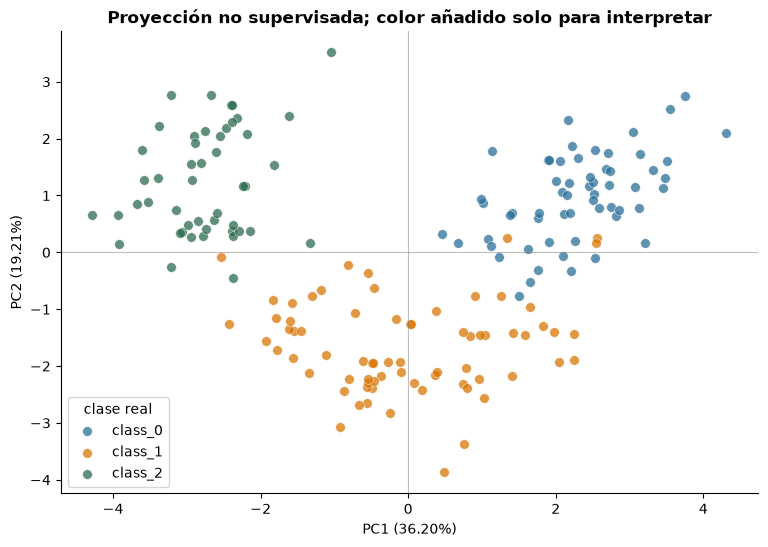
| PC1 | PC2 | |
|---|---|---|
| class_0 | 2.283 | 0.968 |
| class_1 | -0.039 | -1.643 |
| class_2 | -2.748 | 1.241 |
Cómo leer esta proyección
Aunque PCA nunca vio las etiquetas, aparecen tres regiones bastante claras. Los centroides de class_0, class_1 y class_2 están en PC1 en 2.283, -0.039 y -2.748, respectivamente. PC1 separa con fuerza las clases 0 y 2; PC2 ayuda especialmente a desplazar class_1, cuyo centro está en -1.643.
Esto muestra una alineación útil entre alta varianza y clases, no una garantía general. En otro conjunto, la señal que separa etiquetas podría estar en una dirección de baja varianza y PCA podría descartarla.
Qué representan PC1 y PC2: leer las cargas
Cada coeficiente de PCA.components_ indica cuánto participa una variable estandarizada en la dirección de un componente. En este notebook llamaremos cargas a esos coeficientes de los vectores propios unitarios: una magnitud grande implica mayor participación y el signo indica dirección relativa. En otros textos, “carga” puede referirse al coeficiente escalado por \(\sqrt{\lambda_j}\), que se relaciona con la correlación entre variable y componente.
El signo global es arbitrario: multiplicar un vector propio y sus scores por \(-1\) describe exactamente el mismo eje. Por eso interpreta patrones de magnitud y contraste, no etiquetas como “positivo” o “negativo” de forma aislada.
cargas = pd.DataFrame(
    pca_completo.components_[:2].T,
    index=X.columns,
    columns=['PC1', 'PC2'],
)

fig, ax = plt.subplots(1, 2, figsize=(13, 5))
for eje, componente, color in zip(ax, ['PC1', 'PC2'], ['#2A6F97', '#D97706']):
    orden = cargas[componente].abs().sort_values().index
    eje.barh(orden, cargas.loc[orden, componente], color=color)
    eje.axvline(0, color='black', lw=0.8)
    eje.set_title(f'Cargas de {componente}')
    eje.set_xlabel('carga')
plt.tight_layout()
plt.show()

for componente in ['PC1', 'PC2']:
    principales = cargas[componente].reindex(cargas[componente].abs().sort_values(ascending=False).index).head(5)
    print(f'Cinco mayores cargas absolutas de {componente}:')
    display(principales.to_frame('carga').round(3))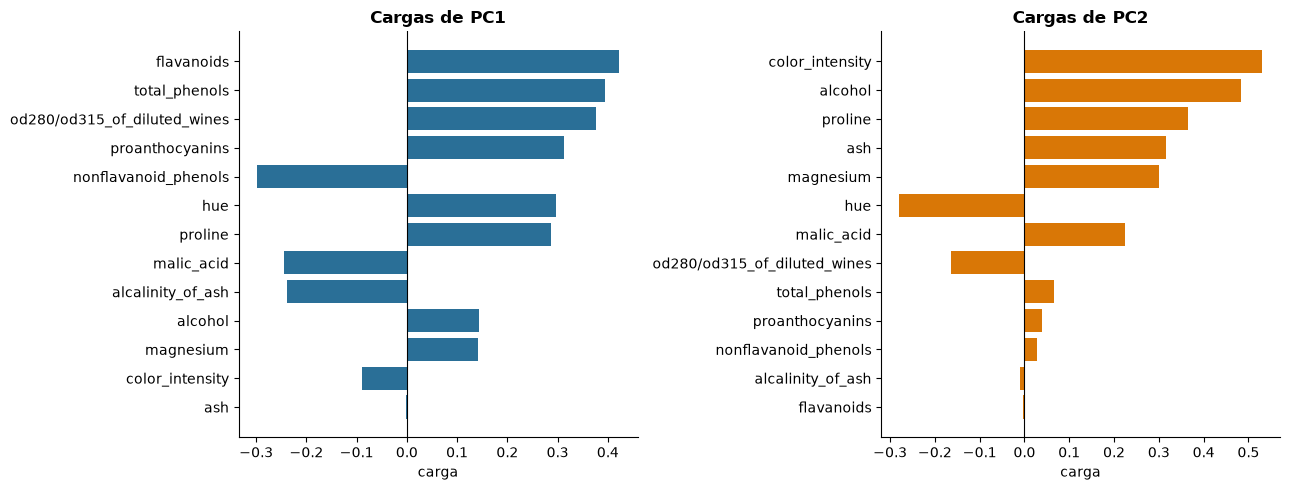
Cinco mayores cargas absolutas de PC1:| carga | |
|---|---|
| flavanoids | 0.423 |
| total_phenols | 0.395 |
| od280/od315_of_diluted_wines | 0.376 |
| proanthocyanins | 0.313 |
| nonflavanoid_phenols | -0.299 |
Cinco mayores cargas absolutas de PC2:| carga | |
|---|---|
| color_intensity | 0.530 |
| alcohol | 0.484 |
| proline | 0.365 |
| ash | 0.316 |
| magnesium | 0.300 |
Cómo leer las cargas
En PC1 destacan sobre todo flavanoids (0.423), total_phenols (0.395) y od280/od315_of_diluted_wines (0.376): el eje resume principalmente un patrón fenólico compartido. nonflavanoid_phenols apunta en sentido contrario (-0.299).
PC2 está marcado por color_intensity (0.530), alcohol (0.484) y proline (0.365). Recuerda que hablamos de variables estandarizadas: estas magnitudes son comparables y no favorecen a la prolina por estar medida en cientos.
Dos precauciones al interpretar
- PCA describe variación, no causalidad. Una carga alta no demuestra que una variable origine el patrón.
- Los componentes dependen del preprocesamiento. Cambiar variables, transformar distribuciones o no estandarizar puede rotar por completo la solución.
Las cargas son una traducción útil de los ejes, pero siempre deben leerse junto con el contexto de las mediciones.
Paso 6: reconstrucción y compresión
Con \(k\) componentes guardamos los scores \(Z_k=(X_{std}-\mu_{PCA})W_k\) en lugar de las 13 coordenadas originales, donde \(W_k\) reúne las primeras \(k\) columnas de \(W\) y \(\mu_{PCA}\) es la media que PCA resta (aquí prácticamente cero, porque los datos ya están estandarizados). Podemos aproximar los datos estandarizados mediante
\[ \widehat X_{std}=Z_kW_k^\top+\mu_{PCA}. \]
pca_4.inverse_transform realiza esa reconstrucción en el espacio estandarizado e incorpora la media \(\mu_{PCA}\). Después, escalador.inverse_transform deshace la estandarización para volver a las unidades originales. Si \(k<13\), la reconstrucción pierde información; el error cuadrático medio (MSE) cuantifica cuánto. Para ilustrarlo usaremos \(k=4\), un valor dentro del codo visual de 3 a 5 componentes.
k_compresion = 4
pca_4 = PCA(n_components=k_compresion).fit(X_std)
X_std_reconstruido_4 = pca_4.inverse_transform(pca_4.transform(X_std))
X_reconstruido_4 = escalador.inverse_transform(X_std_reconstruido_4)
mse_4 = np.mean((X_std - X_std_reconstruido_4) ** 2)

comparacion = pd.DataFrame({
    'original': X.iloc[0],
    'reconstruido_con_4_PC': X_reconstruido_4[0],
})
comparacion['error_absoluto'] = (comparacion['original'] - comparacion['reconstruido_con_4_PC']).abs()
display(comparacion.round(3))
print(f'Varianza conservada con 4 componentes: {varianza_acumulada[3]:.2%}')
print(f'MSE de reconstrucción en escala estandarizada: {mse_4:.4f}')
print(f'Reducción de dimensiones: {X.shape[1]} -> {k_compresion}')| original | reconstruido_con_4_PC | error_absoluto | |
|---|---|---|---|
| alcohol | 14.23 | 13.984 | 0.246 |
| malic_acid | 1.71 | 1.647 | 0.063 |
| ash | 2.43 | 2.474 | 0.044 |
| alcalinity_of_ash | 15.60 | 16.419 | 0.819 |
| magnesium | 127.00 | 113.381 | 13.619 |
| total_phenols | 2.80 | 3.129 | 0.329 |
| flavanoids | 3.06 | 3.364 | 0.304 |
| nonflavanoid_phenols | 0.28 | 0.246 | 0.034 |
| proanthocyanins | 2.29 | 2.153 | 0.137 |
| color_intensity | 5.64 | 6.167 | 0.527 |
| hue | 1.04 | 1.108 | 0.068 |
| od280/od315_of_diluted_wines | 3.92 | 3.279 | 0.641 |
| proline | 1065.00 | 1233.268 | 168.268 |
Varianza conservada con 4 componentes: 73.60%
MSE de reconstrucción en escala estandarizada: 0.2640
Reducción de dimensiones: 13 -> 4
Cómo leer esta reconstrucción
Cuatro números por vino reemplazan temporalmente las 13 mediciones: una reducción de 13 a 4 dimensiones. Al reconstruir, conservamos 73.60% de la varianza y obtenemos un MSE estandarizado de 0.2640.
No es coincidencia que \(0.2640 = 1 - 0.7360\): con variables estandarizadas, el MSE de reconstrucción es exactamente la fracción de varianza que descartan los componentes omitidos.
La tabla compara el primer vino con su aproximación. No esperes igualdad exacta: la compresión conserva las direcciones dominantes y sacrifica detalles. En unidades originales, proline pasa de 1065 a 1233.268 (error absoluto de 168.268) y magnesium de 127 a 113.381, mientras que las demás variables se desvían menos de 1 unidad. Medir el error en escala estandarizada evita que proline monopolice la métrica.
Experimento: error frente a número de componentes
Repetiremos la reconstrucción para \(k=1,\ldots,13\). Al añadir componentes, el subespacio disponible crece, así que el error no puede aumentar. Con los 13 componentes recuperamos toda la información salvo precisión numérica.
errores_reconstruccion = []
for k in range(1, X.shape[1] + 1):
    pca_k = PCA(n_components=k).fit(X_std)
    reconstruccion_k = pca_k.inverse_transform(pca_k.transform(X_std))
    errores_reconstruccion.append(np.mean((X_std - reconstruccion_k) ** 2))

fig, ax = plt.subplots(figsize=(9, 5))
ax.plot(componentes, errores_reconstruccion, marker='o', color='#B42318', lw=2)
ax.scatter([4, 8, 13], np.array(errores_reconstruccion)[[3, 7, 12]],
           s=90, color=['#D97706', '#2D6A4F', '#17324D'], zorder=3)
ax.set(title='Más componentes, menor error de reconstrucción',
       xlabel='número de componentes', ylabel='MSE en escala estandarizada')
ax.set_xticks(componentes)
plt.show()

for k in [1, 4, 8, 13]:
    print(f'k={k:>2}: MSE = {errores_reconstruccion[k - 1]:.4f}')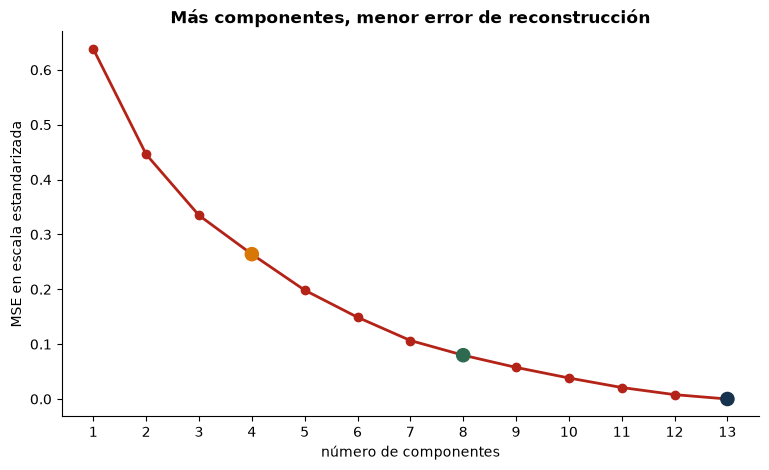
k= 1: MSE = 0.6380
k= 4: MSE = 0.2640
k= 8: MSE = 0.0798
k=13: MSE = 0.0000
Cómo leer este experimento
El MSE baja de 0.6380 con 1 componente a 0.2640 con 4 y 0.0798 con 8. Con los 13 componentes es 0.0000 porque ya no descartamos ninguna dirección. Cada valor es la varianza descartada de la tabla de varianza acumulada: \(0.6380 = 1 - 0.3620\) y \(0.0798 = 1 - 0.9202\).
La curva hace visible el precio de comprimir. Pasar de 4 a 8 componentes reduce el error de 0.2640 a 0.0798 (casi 70% menos), pero duplica el tamaño de la representación. Tu elección de \(k\) expresa qué pérdida toleras a cambio de simplicidad.
Utilidad práctica: un modelo predictivo de referencia
PCA no necesita etiquetas, pero sus componentes pueden alimentar un modelo supervisado. Compararemos una regresión logística con las 13 variables frente a otra que recibe solo los primeros \(k\) componentes.
El PCA anterior tuvo un propósito descriptivo y usó todo el conjunto para explicar su estructura; ninguno de sus objetos se reutiliza aquí. Para la comparación predictiva creamos una partición nueva, reservamos 30% para prueba y tomamos todas las decisiones con el 70% de entrenamiento.
En entrenamiento elegimos \(k\) por validación cruzada estratificada probando todos los valores de 1 a 13. Con \(k=13\), PCA solo gira los datos estandarizados y el modelo equivale al de referencia con las 13 variables, así que la misma tabla compara ambas opciones sin tocar la prueba. Tanto el escalado como PCA quedan dentro del Pipeline: cada fold (cada una de las cinco particiones de la validación cruzada) aprende sus transformaciones sin mirar su partición de validación, y el conjunto de prueba permanece intacto hasta el reporte final.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.30, random_state=SEMILLA, stratify=y
)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)
candidatos_k = list(range(1, X.shape[1] + 1))
resultados_cv = []

for k in candidatos_k:
    pipeline_pca = Pipeline([
        ('escalador', StandardScaler()),
        ('pca', PCA(n_components=k)),
        ('clasificador', LogisticRegression(max_iter=2000)),
    ])
    scores_cv = cross_val_score(pipeline_pca, X_train, y_train, cv=cv, scoring='accuracy')
    resultados_cv.append({
        'k': k,
        'exactitud_media_cv': scores_cv.mean(),
        'desviación_cv': scores_cv.std(),
    })

tabla_cv = pd.DataFrame(resultados_cv)
mejor_k = int(tabla_cv.loc[tabla_cv['exactitud_media_cv'].idxmax(), 'k'])

representacion_elegida = Pipeline([
    ('escalador', StandardScaler()),
    ('pca', PCA(n_components=mejor_k)),
]).fit(X_train)
varianza_mejor_k_train = representacion_elegida.named_steps['pca'].explained_variance_ratio_.sum()

display(tabla_cv.style.format({'exactitud_media_cv': '{:.3f}', 'desviación_cv': '{:.3f}'}))
print(f'k elegido solo con entrenamiento: {mejor_k}')
print(f'Varianza de entrenamiento conservada: {varianza_mejor_k_train:.2%}')

plt.errorbar(tabla_cv['k'], tabla_cv['exactitud_media_cv'], yerr=tabla_cv['desviación_cv'],
             marker='o', capsize=4, color='#2A6F97')
plt.xlabel('número de componentes')
plt.ylabel('exactitud en validación cruzada')
plt.title('Selección de k sin mirar el conjunto de prueba')
plt.xticks(candidatos_k)
plt.show()| k | exactitud_media_cv | desviación_cv | |
|---|---|---|---|
| 0 | 1 | 0.855 | 0.053 |
| 1 | 2 | 0.976 | 0.020 |
| 2 | 3 | 0.968 | 0.030 |
| 3 | 4 | 0.984 | 0.020 |
| 4 | 5 | 0.976 | 0.020 |
| 5 | 6 | 0.976 | 0.020 |
| 6 | 7 | 0.959 | 0.026 |
| 7 | 8 | 0.959 | 0.026 |
| 8 | 9 | 0.976 | 0.020 |
| 9 | 10 | 0.976 | 0.020 |
| 10 | 11 | 0.967 | 0.031 |
| 11 | 12 | 0.976 | 0.020 |
| 12 | 13 | 0.967 | 0.031 |
k elegido solo con entrenamiento: 4
Varianza de entrenamiento conservada: 73.91%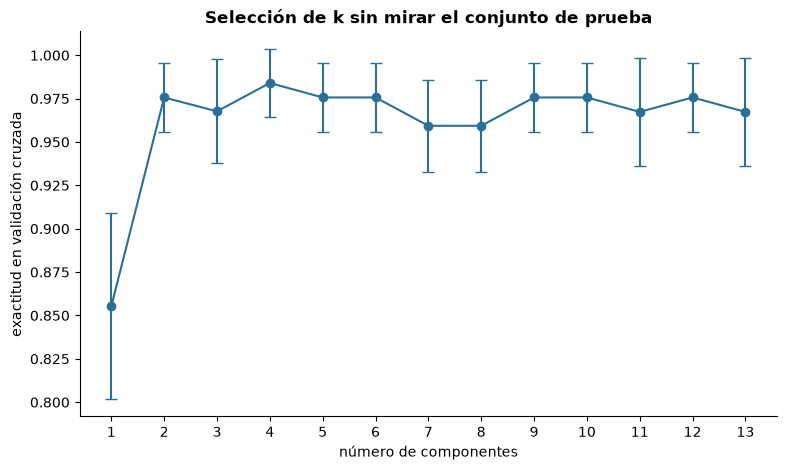
Cómo leer la selección de \(k\)
Al probar todos los valores de 1 a 13, la mayor exactitud media de validación es 0.984 con \(k=4\). El óptimo no cae en un borde. Con \(k=13\), equivalente al modelo con las 13 variables, la exactitud media es 0.967. Aun así, la ventaja de \(k=4\) sobre \(k=2\) es pequeña: 0.008, que equivale a un solo vino (2 errores frente a 3 entre los 124 vinos de entrenamiento) y es menor que la desviación de aproximadamente 0.020 entre folds. Por eso conviene leer \(k=4\) como la mejor media observada, no como una superioridad concluyente sobre toda alternativa compacta.
Al reajustar la representación elegida solo con entrenamiento, cuatro componentes conservan 73.91% de su varianza. Esta cifra predictiva se calcula sin usar el conjunto de prueba; el 73.60% visto antes pertenece al análisis descriptivo sobre todos los vinos. Ahora fijamos \(k=4\) y usamos el conjunto de prueba una sola vez.
Comparación final en datos no vistos
El modelo de referencia estandariza las 13 variables y ajusta regresión logística. La alternativa añade PCA con el \(k\) elegido. Ambos modelos usan la misma partición, el mismo clasificador y el mismo conjunto de prueba; así aislamos el efecto de reducir dimensiones.
modelo_completo = Pipeline([
    ('escalador', StandardScaler()),
    ('clasificador', LogisticRegression(max_iter=2000)),
])
modelo_reducido = Pipeline([
    ('escalador', StandardScaler()),
    ('pca', PCA(n_components=mejor_k)),
    ('clasificador', LogisticRegression(max_iter=2000)),
])

modelo_completo.fit(X_train, y_train)
modelo_reducido.fit(X_train, y_train)
acc_completo = accuracy_score(y_test, modelo_completo.predict(X_test))
acc_reducido = accuracy_score(y_test, modelo_reducido.predict(X_test))

comparacion_modelos = pd.DataFrame({
    'modelo': ['13 variables estandarizadas', f'{mejor_k} componentes principales'],
    'dimensiones': [X.shape[1], mejor_k],
    'exactitud_test': [acc_completo, acc_reducido],
})
display(comparacion_modelos.style.format({'exactitud_test': '{:.2%}'}))
print(f'Diferencia absoluta: {abs(acc_completo - acc_reducido):.2%}')
print(f'Reducción dimensional: {(1 - mejor_k / X.shape[1]):.2%}')| modelo | dimensiones | exactitud_test | |
|---|---|---|---|
| 0 | 13 variables estandarizadas | 13 | 98.15% |
| 1 | 4 componentes principales | 4 | 94.44% |
Diferencia absoluta: 3.70%
Reducción dimensional: 69.23%
Cómo leer la comparación final
Con las 13 variables, la exactitud de prueba es 98.15%. Con solo 4 componentes, es 94.44%: una diferencia de 3.70 puntos porcentuales a cambio de reducir la representación en 69.23%. Con 54 vinos de prueba, esa diferencia son dos vinos (53 frente a 51 aciertos).
En este conjunto pequeño, PCA conserva un desempeño cercano con muchas menos dimensiones. El modelo completo acierta dos vinos más en la prueba, mientras que en la validación cruzada el orden fue el inverso (0.967 frente a 0.984): con muestras de este tamaño, ninguna de las dos diferencias es concluyente. No concluyas que PCA siempre mejora la predicción: su valor puede estar en compresión, visualización, reducción de ruido o estabilidad ante variables correlacionadas. La comparación debe validarse en cada problema.
Qué hace y qué no hace PCA
PCA sí:
- encuentra combinaciones lineales que capturan máxima varianza;
- ordena componentes de mayor a menor varianza explicada;
- produce direcciones ortogonales y scores no correlacionados;
- permite visualizar, comprimir y reconstruir aproximadamente datos multivariados.
PCA no:
- usa etiquetas ni optimiza la separación entre clases;
- demuestra causalidad;
- garantiza que las direcciones de mayor varianza sean las más predictivas;
- separa fuentes estadísticamente independientes.
Ese último límite abre el próximo tema. ICA (Análisis de Componentes Independientes) no busca máxima varianza ni solo ausencia de correlación: intenta recuperar componentes independientes, una meta más fuerte y especialmente útil cuando observamos mezclas de señales.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.