Estadística para IA — 1. Introducción al análisis de datos
estadistica
eda
variables
Concepto de dato y variable, tipos de variables, población y muestra, y el rol de la estadística en la IA.
Author
Wilder Ramírez Delgado
Published
September 18, 2026
Sesión 1 — Introducción al Análisis de Datos
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Antes de promediar, hay que saber qué se está midiendo
Un modelo de IA recibe una matriz de números. Pero un int puede ser una edad, un código postal o un identificador; un "sin dato" puede ser un faltante que pandas no reconoce; un -999 puede ser un código de sistema que termina promediado como si fuera un valor real. Ninguno de esos errores produce una excepción: producen resultados equivocados que parecen correctos.
Este notebook construye el vocabulario mínimo del análisis de datos —dato, variable, observación, tipo de variable, población, muestra, parámetro y estadístico— y lo aplica con pandas sobre un dataset con errores sembrados a propósito.
Contexto de ejemplo: clientes de un comercio en Colombia (edad, ciudad, ingreso, compras, segmento). Primero un CSV de 6 filas para ver cada idea; luego un CSV sintético de 1000 clientes con nulos disfrazados, tipos mal leídos, valores imposibles e identificadores duplicados.
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 1 · Sesión 1
Objetivos
Explicar dato, variable y observación, y leer un dataset como una matriz.
Distinguir tipos de variables (cualitativas nominales/ordinales, cuantitativas discretas/continuas) y sus escalas de medición.
Separar el dtype de pandas (cómo se guarda) del tipo estadístico (cómo se interpreta).
Explorar un dataset con head, info, describe y detectar tipos mal interpretados, nulos disfrazados y valores imposibles.
Diferenciar población vs muestra y parámetro vs estadístico, y reconocer el sesgo de selección.
Redactar un diccionario de datos antes de calcular cualquier medida.
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX ($...$ y $$...$$); si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. El vocabulario mínimo del análisis de datos
1.1 Dato, variable y observación
Dato: un valor registrado o medido. Ejemplos: 23, "Bogotá", "sí", 2500.0.
Variable: la característica que se mide y que puede tomar valores distintos (edad, ciudad, ingreso, compra).
Observación: una unidad registrada: una persona, una transacción, un día, un sensor en un instante.
En un dataset tabular, filas = observaciones y columnas = variables.
Observación
edad
ciudad
ingreso_mensual
compra
Persona A
23
Bogotá
2500
sí
La granularidad (qué representa una fila) decide qué preguntas se pueden responder: una tabla por persona y una tabla por transacción describen la misma realidad, pero el mismo promedio significa cosas distintas en cada una.
1.2 El dataset como matriz
Con \(n\) observaciones y \(p\) variables, el dataset es una tabla de \(n\) filas y \(p\) columnas: cada fila \(x_i\) es el vector de características de una observación, y cada columna es una variable. En aprendizaje supervisado se separa además un vector objetivo \(y\) (lo que se quiere predecir) de la matriz de features\(X\).
Un modelo necesita que \(X\) sea numérica, \(X \in \mathbb{R}^{n \times p}\). Las columnas de texto (como la ciudad) primero se tipan y se codifican (sección 2); por eso esta sesión empieza por los tipos de variables.
1.3 Tipos de variables
Tipo
Subtipo
Ejemplos
Resúmenes válidos
Cualitativa
Nominal (sin orden)
ciudad, color, tipo de producto
frecuencias, proporciones, moda
Cualitativa
Ordinal (con orden)
bajo/medio/alto, satisfacción 1–5
lo anterior + mediana, percentiles
Cuantitativa
Discreta (conteos)
número de compras, número de hijos
media, mediana, desviación, cuartiles
Cuantitativa
Continua (mediciones)
ingreso, tiempo, temperatura
media, mediana, desviación, cuartiles
Una variable binaria (sí/no, 0/1) es un caso particular de nominal con dos categorías.
La edad es continua por naturaleza, pero suele registrarse en años cumplidos (enteros); en ese caso se trata como discreta. El tipo depende de qué mide la columna y de cómo se registró.
Las medidas de la última columna se definen más adelante: media, mediana y moda en la Sesión 2; desviación y cuartiles en las Sesiones 3 y 4. Aquí solo importa qué tipo de variable admite cada una.
1.4 Escalas de medición
Nominal: solo igualdad o diferencia (\(A \neq B\)).
Ordinal: orden (\(A < B\)), sin distancias interpretables.
Razón: distancias y proporciones interpretables, cero absoluto (peso, tiempo, ingreso).
Frases como “el doble” solo son válidas en escala de razón: 20 °C no es “el doble de calor” que 10 °C.
1.5 Tipo estadístico vs dtype
El dtype indica cómo está almacenada una columna (int64, float64, object, datetime64). El tipo estadístico indica cómo debe interpretarse. No siempre coinciden:
un identificador (id_cliente) suele ser int, pero es una etiqueta, no una magnitud;
un código postal es un número que se comporta como categoría;
una columna numérica aparece como object si trae texto, separadores o símbolos ("1.200", "$100", "sin dato");
las fechas llegan como texto hasta que se convierten con pd.to_datetime.
La pregunta clave es: ¿tiene sentido sumar, promediar o medir distancias con esta columna?
1.6 Población y muestra
Población: el conjunto completo de unidades sobre el que se quiere concluir (todos los clientes, todas las ventas del año).
Muestra: el subconjunto del que se tienen datos. Casi nunca se mide toda la población.
Una muestra es útil si es representativa. Cuando la forma de obtenerla deja fuera a ciertos grupos (encuestas solo por web, históricos que solo incluyen a quien ya compró), aparece el sesgo de selección: los resúmenes describen a la muestra, no a la población.
1.7 Parámetro y estadístico
Concepto
Parámetro (población)
Estadístico (muestra)
Media
\(\mu\)
\(\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\)
Proporción
\(p\)
\(\hat{p}\)
Varianza
\(\sigma^2\)
\(s^2\)
Desviación estándar
\(\sigma\)
\(s\)
El parámetro es fijo y casi siempre desconocido. El estadístico se calcula con la muestra, cambia de una muestra a otra y se usa para estimar el parámetro.
2. Por qué importa en IA y Machine Learning
Un modelo no sabe si una columna es un identificador o una magnitud: si recibe un número, lo usa como número. Todas las decisiones de preparación de datos dependen del tipo estadístico:
Tipo
Preparación típica antes de modelar
Nominal
Codificación: one-hot (una columna 0/1 por categoría), target encoding o embeddings si hay muchas categorías
Ordinal
Codificación ordenada (bajo=1, medio=2, alto=3) solo si el orden es real
Se excluye de las features; se usa para unir tablas o detectar duplicados
Fecha
Se convierte y se derivan variables (antigüedad, día de la semana, estacionalidad)
Un ID tratado como magnitud hace que el modelo aprenda patrones del orden de registro.
Un faltante disfrazado ("sin dato", -999) entra al entrenamiento como si fuera un valor real.
Un conjunto de entrenamiento es una muestra: si no representa a la población donde se usará el modelo, el desempeño en producción se degrada.
Idea central: la calidad de un modelo empieza antes del modelo. Tipar y revisar las variables no es burocracia; es la condición para que los números signifiquen lo que se cree que significan.
3. Flujo recomendado de trabajo
Cargar y mirar la estructura
shape, columns, head(). ¿Qué representa una fila? ¿Hay un identificador?
Comparar dtype con tipo estadístico
info() y dtypes. ¿Hay números guardados como texto, fechas como object, códigos guardados como int?
Buscar faltantes, reales y disfrazados
isna().sum() solo ve los NaN. Revisar value_counts() en busca de "sin dato", "-", -999 y similares.
Revisar rangos y duplicados
describe() para mínimos y máximos imposibles; duplicated() sobre el identificador.
Documentar antes de modelar
Un diccionario de datos: columna, tipo estadístico, rol (feature, target, identificador), problemas encontrados y decisión tomada.
Criterio general:cargar → inspeccionar → tipar y limpiar → revisar rangos y semántica → analizar o modelar. Saltar pasos no ahorra tiempo; lo traslada al momento en que el modelo falla.
4. Preparar el entorno
%matplotlib inlineimport sysprint("Python:", sys.version.split()[0])from io import StringIOimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.ticker import MaxNLocatorprint("pandas:", pd.__version__, "| numpy:", np.__version__)
Python: 3.13.9
pandas: 2.3.3 | numpy: 2.3.5
Funciones de visualización (definidas una sola vez)
Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, las funciones de graficación se definen aquí, una sola vez. Cada etapa solo llama a la función correspondiente.
def graficar_faltantes(faltantes_crudo, faltantes_reales, titulo):"""Faltantes por columna: lo que ve isna() tras read_csv frente a lo que hay de verdad.""" cols = faltantes_reales.index x = np.arange(len(cols)) w =0.4 fig, ax = plt.subplots(figsize=(10, 4)) b1 = ax.bar(x - w /2, faltantes_crudo.reindex(cols).values, width=w, label="isna() tras read_csv") b2 = ax.bar(x + w /2, faltantes_reales.values, width=w, label="tras normalizar faltantes disfrazados") ax.bar_label(b1, fontsize=9) ax.bar_label(b2, fontsize=9) ax.set_ylim(0, faltantes_reales.max() *1.2) ax.set_xticks(x) ax.set_xticklabels(cols, rotation=30, ha="right") ax.set_ylabel("Valores faltantes") ax.set_title(titulo) ax.grid(axis="y", alpha=0.25) ax.legend(fontsize=9) plt.tight_layout() plt.show()def graficar_rango_plausible(valores, lim_inf, lim_sup, variable, unidad):"""Puntos de una variable con la franja de valores plausibles; fuera de ella, en rojo.""" valores = np.asarray(valores, dtype=float) fuera = (valores < lim_inf) | (valores > lim_sup) rng_jit = np.random.default_rng(0) y = rng_jit.uniform(-0.25, 0.25, size=len(valores)) fig, ax = plt.subplots(figsize=(10, 3.2)) ax.axvspan(lim_inf, lim_sup, alpha=0.12, label=f"Rango plausible [{lim_inf}, {lim_sup}]") ax.scatter(valores[~fuera], y[~fuera], s=8, alpha=0.4, label="Valores plausibles") ax.scatter(valores[fuera], y[fuera], s=40, color="red", label=f"Fuera de rango ({fuera.sum()})") ax.set_yticks([]) ax.set_xlabel(f"{variable} ({unidad})") ax.set_title(f"{variable}: el dtype es numérico, pero no todos los valores son posibles") ax.legend(fontsize=8, loc="upper center") plt.tight_layout() plt.show()def graficar_por_tipo(serie_nominal, serie_discreta, serie_continua):"""Un gráfico adecuado para cada tipo: barras (nominal), barras por valor (discreta), histograma (continua).""" fig, axes = plt.subplots(1, 3, figsize=(13, 3.8), constrained_layout=True) conteo = serie_nominal.value_counts() axes[0].bar(conteo.index.astype(str), conteo.values) axes[0].set_title(f"{serie_nominal.name} (nominal): barras de frecuencia") axes[0].tick_params(axis="x", rotation=30) axes[0].set_ylabel("Frecuencia") conteo_d = serie_discreta.value_counts().sort_index() axes[1].bar(conteo_d.index, conteo_d.values, width=0.8) axes[1].set_title(f"{serie_discreta.name} (discreta): una barra por valor") axes[1].set_xlabel(f"{serie_discreta.name} (solo valores enteros)") axes[1].set_ylabel("Frecuencia") axes[1].xaxis.set_major_locator(MaxNLocator(integer=True)) axes[2].hist(serie_continua.dropna() /1e6, bins=30, edgecolor="white") axes[2].set_title(f"{serie_continua.name} (continua): histograma") axes[2].set_xlabel(f"{serie_continua.name} (millones)") axes[2].set_ylabel("Frecuencia") plt.show()def graficar_medias_muestrales(medias_por_n, mu, titulo):"""Histogramas de medias muestrales para varios tamaños n, con la media poblacional.""" fig, ax = plt.subplots(figsize=(9, 4)) todas = np.concatenate(list(medias_por_n.values())) /1e6 bins = np.linspace(todas.min(), todas.max(), 50) # mismos intervalos para comparar alturasfor n_muestra, medias in medias_por_n.items(): ax.hist(medias /1e6, bins=bins, alpha=0.55, label=f"n = {n_muestra}") ax.axvline(mu /1e6, color="black", linestyle="--", linewidth=1.5, label=f"μ (parámetro) = {mu /1e6:.2f} M") ax.set_xlabel("Media muestral x̄ del ingreso, en millones (estadístico)") ax.set_ylabel("Frecuencia") ax.set_title(titulo) ax.legend(fontsize=9) plt.tight_layout() plt.show()def graficar_sesgo_seleccion(tamanos, medias_aleatorias, medias_sesgadas, mu):"""Media estimada frente al tamaño de muestra: aleatoria vs sesgada.""" fig, ax = plt.subplots(figsize=(9, 4)) ax.plot(tamanos, np.array(medias_aleatorias) /1e6, marker="o", label="Muestra aleatoria de toda la población") ax.plot(tamanos, np.array(medias_sesgadas) /1e6, marker="s", label="Muestra solo de clientes web") ax.axhline(mu /1e6, color="black", linestyle="--", linewidth=1.5, label=f"μ = {mu /1e6:.2f} M") ax.set_xscale("log") ax.set_xticks(tamanos) ax.set_xticklabels([f"{t:,}"for t in tamanos]) ax.set_xlabel("Tamaño de muestra n (escala log)") ax.set_ylabel("Media muestral del ingreso (millones)") ax.set_title("Más datos reducen el ruido, no el sesgo") ax.legend(fontsize=9) plt.tight_layout() plt.show()
5. Desarrollo por etapas
El análisis avanza de lo pequeño a lo realista: primero un CSV de 6 filas para ver cada concepto, luego un CSV de 1000 clientes con errores sembrados para aplicar el flujo completo, y al final una población simulada para separar parámetro, estadístico y sesgo.
Etapa 1: Cargar un dataset pequeño
El CSV va embebido como texto para que el notebook sea reproducible. Con un archivo real, la línea equivalente es pd.read_csv("ruta/al/archivo.csv").
Lectura. Hay 6 observaciones (personas) y 6 columnas: un identificador (id) y 5 variables. Ya se ven dos problemas sin calcular nada: un ingreso_mensual vacío (se lee como NaN) y un score_texto con el valor "8n", que no es un número.
Etapa 2: Estructura — filas, columnas, \(X\) y \(y\)
Un modelo supervisado recibe una matriz de features\(X\) y un vector objetivo \(y\). El identificador no pertenece a ninguno de los dos.
print("Columnas:", df.columns.tolist())print("Una fila = una persona. Identificador:", "id")y = df["compra"]X = df.drop(columns=["id", "compra"])print("\nX (features):", X.shape, "->", X.columns.tolist())print("y (objetivo):", y.shape, "->", y.tolist())print("\nFila 0 como vector de características:")print(X.iloc[0].to_dict())
Columnas: ['id', 'edad', 'ciudad', 'ingreso_mensual', 'compra', 'score_texto']
Una fila = una persona. Identificador: id

X (features): (6, 4) -> ['edad', 'ciudad', 'ingreso_mensual', 'score_texto']
y (objetivo): (6,) -> ['si', 'no', 'si', 'no', 'si', 'si']

Fila 0 como vector de características:
{'edad': 23, 'ciudad': 'Bogota', 'ingreso_mensual': 2500.0, 'score_texto': '10'}
Lectura.\(X\) tiene 6 filas y 4 columnas; \(y\) tiene 6 valores. La fila 0 todavía no es un vector numérico: contiene texto ('Bogota') y un número guardado como texto ('10'). Para llegar a la matriz numérica de la sección 1.2 faltan dos pasos: tipar (etapas siguientes) y codificar (sección 2).
La granularidad cambia el promedio. Si la misma información se registra por transacción en lugar de por persona, quien compra más veces aparece en más filas y pesa más en cualquier resumen.
transacciones = pd.DataFrame({"id": [1, 1, 1, 1, 2, 3, 4, 5, 6],"monto": [120, 80, 95, 60, 300, 150, 410, 45, 220],})trans = transacciones.merge(df[["id", "edad"]], on="id")print("Filas por persona:", len(df), "| filas por transacción:", len(trans))print("Edad media por persona: ", round(df["edad"].mean(), 2))print("Edad media por transacción: ", round(trans["edad"].mean(), 2))
Filas por persona: 6 | filas por transacción: 9
Edad media por persona:      30.17
Edad media por transacción:  27.78
Lectura. La persona con id=1 (23 años) tiene 4 transacciones y arrastra el promedio hacia abajo: 30.17 años por persona frente a 27.78 por transacción. Ninguno de los dos números está “mal”; responden preguntas distintas (¿qué edad tiene el cliente típico? vs ¿qué edad tiene quien hace la compra típica?). Antes de promediar hay que saber qué es una fila.
Etapa 3: dtype vs tipo estadístico
info() dice cómo guardó pandas cada columna. El diccionario de datos dice cómo debe interpretarse. Se construye a mano, porque ese conocimiento no está en el archivo.
Lectura. Dos columnas tienen un dtype que no coincide con su significado: id es int64 pero es una etiqueta, y score_texto es object aunque su contenido es numérico. pandas no se equivoca al leer: guarda lo que encuentra. La interpretación es tarea del analista.
El diccionario también obliga a decidir casos dudosos: si score_texto fuera una calificación de satisfacción del 1 al 10, sería ordinal y no cuantitativa. El tipo no se deduce de los valores sino de qué mide la columna; por eso se documenta.
Etapa 4: describe() calcula todo lo que puede, tenga sentido o no
--- describe() numéricas ---
         id   edad  ingreso_mensual
count  6.00   6.00             5.00
mean   3.50  30.17          3640.00
std    1.87   8.54          1866.28
min    1.00  18.00          1200.00
25%    2.25  24.50          2500.00
50%    3.50  32.00          4200.00
75%    4.75  35.00          4200.00
max    6.00  41.00          6100.00

--- describe(include='object') ---
        ciudad compra score_texto
count        6      6           6
unique       4      2           6
top     Bogota     si          10
freq         2      4           1
Lectura.describe() informa que la “media del id” es 3.5 y su desviación estándar 1.87. Son números correctos y sin significado: promediar identificadores no describe a nadie. En cambio, ingreso_mensual cuenta 5 valores y no 6: el faltante aparece aquí antes que en ningún gráfico. Para las columnas object, describe entrega conteo, número de categorías distintas, la más frecuente (top) y su frecuencia (freq), que es lo que tiene sentido para variables nominales.
mean, std y los percentiles (25%, 50%, 75%) se estudian en las Sesiones 2 a 4. Por ahora basta con saber que describe() los calcula para toda columna numérica, tenga sentido o no.
Etapa 5: Números guardados como texto
Una columna numérica guardada como texto no falla: ordena y compara como texto.
print("Máximo de score_texto (como texto):", repr(df["score_texto"].max()))df["score"] = pd.to_numeric(df["score_texto"], errors="coerce")print("Máximo de score (como número): ", df["score"].max())print("\nValores que no se pudieron convertir:")print(df.loc[df["score"].isna(), ["id", "score_texto", "score"]])
Máximo de score_texto (como texto): '9'
Máximo de score (como número):      10.0

Valores que no se pudieron convertir:
   id score_texto  score
5   6          8n    NaN
Lectura. Como texto, "9" > "10" porque se compara carácter a carácter: el máximo “es” 9. Convertido, el máximo es 10. errors="coerce" convierte lo que puede y deja NaN en lo que no ("8n"), así que toda conversión debe ir seguida de un conteo de los NaN nuevos: son datos que se perdieron o que hay que corregir en origen.
Reto técnico
Clasificar cada columna de df como cualitativa (nominal/ordinal), cuantitativa (discreta/continua), identificador o fecha, y señalar las mal tipadas.
Calcular la proporción de observaciones con compra == "si". Escribir una frase que explique por qué ese valor es un estadístico\(\hat{p}\) y no un parámetro.
Etapa 6: Un CSV realista — 1000 clientes con errores sembrados
Se genera un dataset de clientes y se le insertan errores típicos de sistemas reales en una fracción de las filas: texto en columnas numéricas, faltantes disfrazados, códigos especiales, fechas en formatos mezclados, valores imposibles e identificadores duplicados. Luego se escribe como CSV y se vuelve a leer, igual que llegaría desde un archivo.
Forma: (1000, 10)

dtypes tras read_csv:
id                  int64
edad               object
genero             object
ciudad             object
ingreso_mensual    object
fecha_alta         object
compra             object
score_credito      object
num_compras         int64
segmento           object
dtype: object
id
edad
genero
ciudad
ingreso_mensual
fecha_alta
compra
score_credito
num_compras
segmento
0
1
22
F
Bogota
1577000.0
2021-05-04
no
856
6
B
1
2
58
F
Medellin
3762000.0
2022-09-17
no
810
2
C
2
3
52
F
Bogota
1455000.0
2021-07-11
no
546
7
B
3
4
40
F
Bogota
2198000.0
2021-12-10
si
740
5
B
4
5
40
M
Cali
sin dato
2022-03-31
si
318
6
B
Lectura.edad, ingreso_mensual y score_credito deberían ser numéricas y llegan como object: basta un texto en la columna para que pandas la guarde entera como texto. num_compras sí llega como int64, y eso es más peligroso: el código -999 es un número válido para el dtype y pasará a cualquier promedio sin aviso.
Etapa 7: Faltantes reales y faltantes disfrazados
read_csv ya convierte en NaN algunos marcadores comunes ("", "N/A", "NA", "null"). No reconoce los que cada sistema inventa: "sin dato", "-", -999.
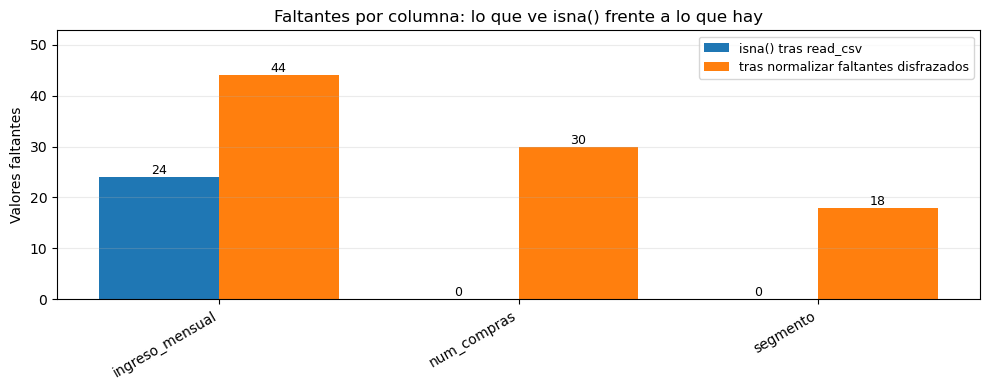
faltantes_crudo = df_clientes.isna().sum()DISFRAZADOS = ["sin dato", "-", "?"]df_norm = df_clientes.replace(DISFRAZADOS, np.nan)df_norm["num_compras"] = df_norm["num_compras"].replace(-999, np.nan)faltantes_reales = df_norm.isna().sum()tabla_faltantes = pd.DataFrame({"isna_tras_read_csv": faltantes_crudo,"faltantes_reales": faltantes_reales})tabla_faltantes = tabla_faltantes[tabla_faltantes.sum(axis=1) >0]print(tabla_faltantes)graficar_faltantes(tabla_faltantes["isna_tras_read_csv"], tabla_faltantes["faltantes_reales"],"Faltantes por columna: lo que ve isna() frente a lo que hay")
Lectura.isna() ve 24 faltantes en ingreso_mensual (los "N/A" que read_csv reconoce) y ninguno en num_compras ni en segmento. Tras normalizar los marcadores, los faltantes reales son 44, 30 y 18. En num_compras y segmento los faltantes eran invisibles: sin revisar value_counts(), el -999 habría bajado la media de compras y "-" habría aparecido como una categoría más. Un faltante disfrazado no es un problema de limpieza menor; es un valor falso dentro del análisis.
Etapa 8: Convertir tipos y contar lo que se pierde
Lectura. Cada conversión con errors="coerce" deja un rastro contable: 3 edades escritas con texto, 8 scores con "alto" y 14 fechas que no siguen el formato AAAA-MM-DD pasan a NaN. En ingreso_mensual no se pierde nada nuevo porque sus faltantes ya se habían normalizado en la etapa anterior. En fecha_alta se pierden las fechas en formato día/mes/año y las escritas como texto; son fechas reales que se podrían recuperar con reglas de parseo adicionales. Decidir entre recuperar, imputar o descartar es una decisión documentada, no un efecto secundario.
Etapa 9: Valores imposibles e identificadores duplicados
Un valor puede tener el dtype correcto y ser imposible. El dominio de la variable (lo que puede valer en la realidad) se revisa aparte.
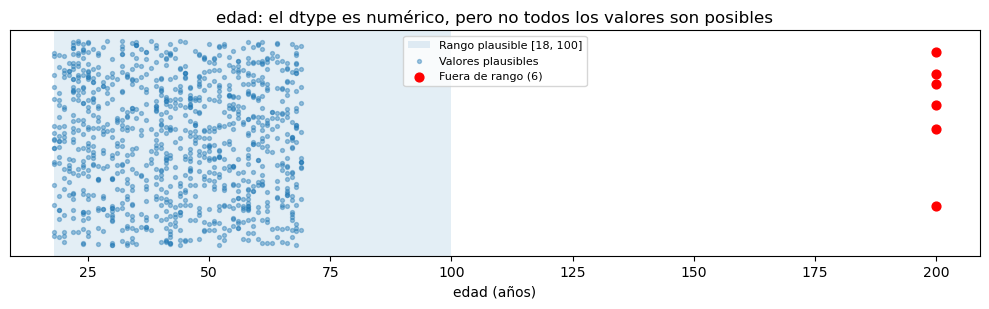
edad_fuera = ((df_tip["edad"] <18) | (df_tip["edad"] >100)).sum()ingreso_neg = (df_tip["ingreso_mensual"] <0).sum()ids_dup = df_tip["id"].duplicated(keep=False).sum()print("Edades fuera de [18, 100]:", edad_fuera)print("Ingresos negativos: ", ingreso_neg)print("Filas con id repetido: ", ids_dup)print("\nMáximo de edad (el que reportaría describe()):", df_tip["edad"].max())graficar_rango_plausible(df_tip["edad"].dropna(), 18, 100, "edad", "años")
Edades fuera de [18, 100]: 6
Ingresos negativos:        5
Filas con id repetido:     10

Máximo de edad (el que reportaría describe()): 200.0
Lectura.describe() habría reportado una edad máxima de 200 sin marcarla como error: calcula, no valida. Los 5 ingresos negativos y las 10 filas con id repetido (5 pares) tampoco generan ninguna advertencia. El identificador cumple aquí su función real: no es una feature, es la herramienta para detectar registros duplicados.
Reto técnico
Reemplazar las edades fuera de [18, 100] por NaN y recalcular la media de edad. ¿Cuánto cambia?
Decidir qué hacer con los id duplicados: ¿son la misma persona registrada dos veces o dos personas con el mismo código? Escribir qué información haría falta para decidirlo.
Etapa 10: Un gráfico adecuado para cada tipo de variable
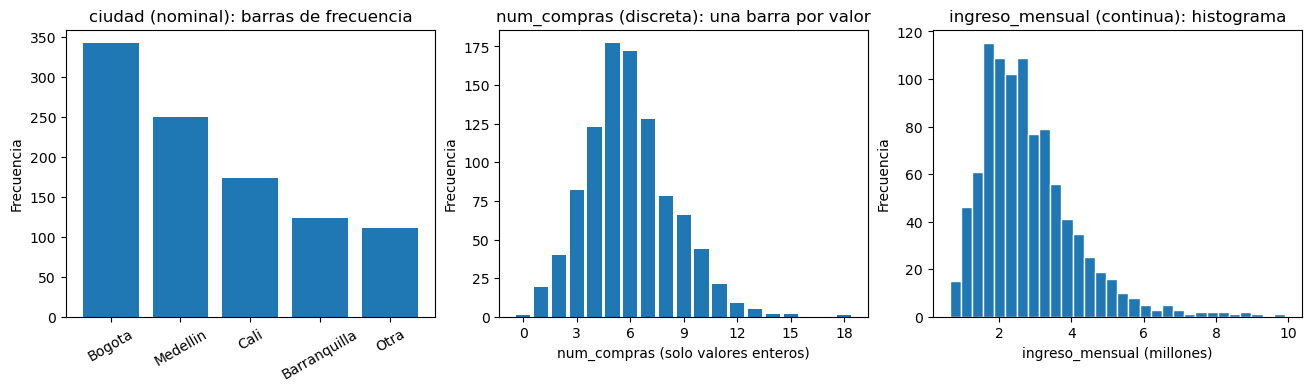
El tipo estadístico decide también la visualización: barras para categorías, barras por valor para conteos discretos e histograma para mediciones continuas.
ingreso_valido = df_tip["ingreso_mensual"].where(df_tip["ingreso_mensual"] >=0)graficar_por_tipo(df_tip["ciudad"], df_tip["num_compras"].dropna().astype(int), ingreso_valido.rename("ingreso_mensual"))codigos = df_tip["ciudad"].astype("category").cat.codesprint("Ciudad codificada como número (0, 1, 2...) -> 'media' =", round(codigos.mean(), 3))print("Ese número depende del orden alfabético de las categorías; no describe nada.")
Ciudad codificada como número (0, 1, 2...) -> 'media' = 1.884
Ese número depende del orden alfabético de las categorías; no describe nada.
Lectura. Las tres variables son columnas de la misma tabla y cada una pide un gráfico distinto. La “media” de las ciudades codificadas (1.884) es el ejemplo más claro de un número bien calculado y sin significado: con otro orden de las categorías daría otro valor. Para una variable nominal, el resumen válido es la frecuencia y la moda (Sesión 2).
Etapa 11: Población, muestra, parámetro y estadístico
Se simula una población de 50 000 clientes. Su media es el parámetro\(\mu\): en la práctica sería desconocido, aquí se conoce para poder comparar. Luego se toman muestras y se calcula la media de cada una: el estadístico\(\bar{x}\).
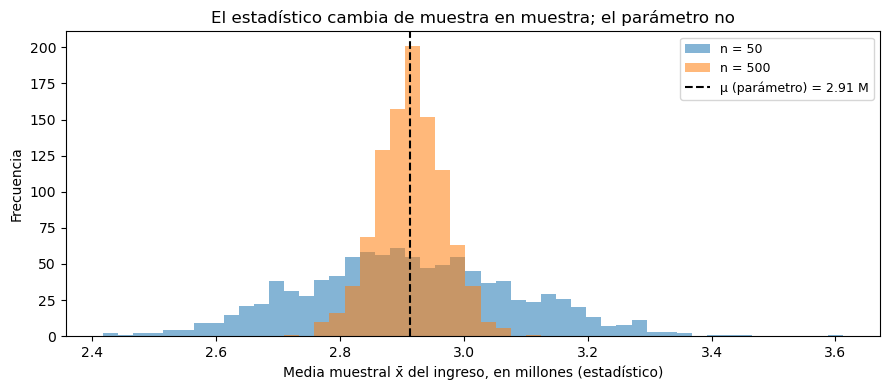
rng_pob = np.random.default_rng(7)N =50_000es_web = rng_pob.random(N) <0.40ingreso_pob = np.where( es_web, rng_pob.lognormal(np.log(3_400_000), 0.35, size=N), rng_pob.lognormal(np.log(2_300_000), 0.35, size=N),)mu = ingreso_pob.mean()muestra = rng_pob.choice(ingreso_pob, size=50, replace=False)print(f"Parámetro μ (media poblacional): {mu:,.0f}")print(f"Estadístico x̄ (una muestra, n=50): {muestra.mean():,.0f}")print(f"Diferencia: {muestra.mean() - mu:+,.0f}")medias_por_n = {}for n_muestra in [50, 500]: medias_por_n[n_muestra] = np.array([ rng_pob.choice(ingreso_pob, size=n_muestra, replace=False).mean() for _ inrange(1000) ]) m = medias_por_n[n_muestra]print(f"n = {n_muestra:>3}: 1000 medias muestrales entre {m.min():,.0f} y {m.max():,.0f}")graficar_medias_muestrales(medias_por_n, mu, "El estadístico cambia de muestra en muestra; el parámetro no")
Parámetro  μ (media poblacional): 2,913,342
Estadístico x̄ (una muestra, n=50): 2,895,410
Diferencia: -17,932
n =  50: 1000 medias muestrales entre 2,417,664 y 3,612,125
n = 500: 1000 medias muestrales entre 2,725,521 y 3,101,697
Lectura. Una sola muestra de 50 clientes da un \(\bar{x}\) que no coincide con \(\mu\) (2,895,410 frente a 2,913,342), y eso no es un error: es variabilidad muestral. Al repetir el muestreo 1000 veces, las medias se reparten alrededor de \(\mu\); con \(n=500\) la nube es mucho más estrecha que con \(n=50\). Lo correcto es decir “la media muestral es …”, no “la media es …”. Cuánto se puede confiar en un \(\bar{x}\) es el tema de la Sesión 9 (inferencia estadística).
Reto técnico
Repetir la simulación con n = 5 y n = 5000. ¿Qué pasa con el ancho del histograma?
Explicar con una frase por qué los coeficientes de un modelo entrenado son estadísticos y no parámetros.
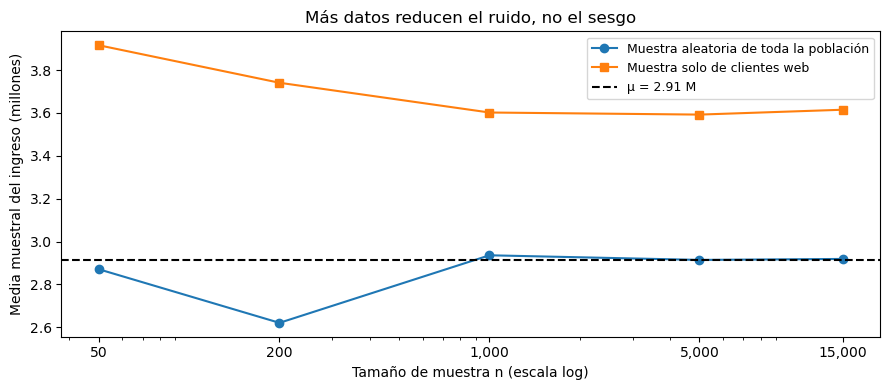
Etapa 12: El contraste que importa — más datos no corrigen una muestra sesgada
En la población simulada, el 40% son clientes que compran por web y tienen ingresos más altos. Una encuesta enviada solo por web no ve al otro 60%. Se compara esa muestra con una muestra aleatoria del mismo tamaño.
ingreso_web = ingreso_pob[es_web]tamanos = [50, 200, 1000, 5000, 15000]medias_aleatorias = [rng_pob.choice(ingreso_pob, size=t, replace=False).mean() for t in tamanos]medias_sesgadas = [rng_pob.choice(ingreso_web, size=t, replace=False).mean() for t in tamanos]tabla_sesgo = pd.DataFrame({"n": tamanos,"media_aleatoria": np.round(medias_aleatorias, -3),"media_solo_web": np.round(medias_sesgadas, -3),})tabla_sesgo["error_solo_web_%"] = (100* (tabla_sesgo["media_solo_web"] - mu) / mu).round(1)print(f"μ = {mu:,.0f}")print(tabla_sesgo.to_string(index=False))graficar_sesgo_seleccion(tamanos, medias_aleatorias, medias_sesgadas, mu)
Lectura. La muestra aleatoria se acerca a \(\mu\) a medida que crece \(n\), aunque no en línea recta: con \(n=200\) quedó un 10% por debajo, porque en muestras chicas el azar pesa. Desde \(n=1000\) queda a menos del 1% de \(\mu\). La muestra “solo web” también se estabiliza… alrededor de un valor equivocado: con \(n\) grande queda entre un 23% y un 24% por encima de \(\mu\) (con \(n=50\) el ruido la llevó al 34%), y seguir sumando registros no la acerca. El tamaño reduce el ruido; no corrige el sesgo. Lo mismo ocurre con un modelo entrenado con datos de un solo canal, una sola región o un solo periodo: más filas del mismo origen no lo vuelven representativo.
Caso aplicado: el diccionario de datos antes de cualquier análisis
Antes de calcular la primera media sobre df_clientes, se deja por escrito qué es cada columna, cómo llegó y qué se hizo con ella. Este es el entregable real de una exploración inicial.
tipo_estadistico = {"id": "identificador", "edad": "cuantitativa discreta", "genero": "cualitativa nominal","ciudad": "cualitativa nominal", "ingreso_mensual": "cuantitativa continua","fecha_alta": "fecha", "compra": "cualitativa binaria", "score_credito": "cuantitativa discreta","num_compras": "cuantitativa discreta", "segmento": "cualitativa ordinal/nominal",}rol = {c: "feature"for c in tipo_estadistico}rol.update({"id": "identificador", "compra": "objetivo (y)"})problemas = {"id": f"{ids_dup} filas con id repetido","edad": f"texto en la columna; {edad_fuera} valores > 100","ingreso_mensual": f"'N/A', 'sin dato'; {ingreso_neg} negativos","fecha_alta": "formatos mezclados (d/m/a, texto libre)","score_credito": "texto ('alto') en columna numérica","num_compras": "código -999 = no disponible","segmento": "'-' como faltante",}diccionario_clientes = pd.DataFrame({"dtype_crudo": df_clientes.dtypes.astype(str),"dtype_final": df_tip.dtypes.astype(str),"tipo_estadistico": pd.Series(tipo_estadistico),"rol": pd.Series(rol),"faltantes_reales": df_tip.isna().sum(),"problemas": pd.Series(problemas),}).reindex(df_clientes.columns).fillna({"problemas": "—"})display(diccionario_clientes)
dtype_crudo
dtype_final
tipo_estadistico
rol
faltantes_reales
problemas
id
int64
int64
identificador
identificador
0
10 filas con id repetido
edad
object
float64
cuantitativa discreta
feature
3
texto en la columna; 6 valores > 100
genero
object
object
cualitativa nominal
feature
0
—
ciudad
object
object
cualitativa nominal
feature
0
—
ingreso_mensual
object
float64
cuantitativa continua
feature
44
'N/A', 'sin dato'; 5 negativos
fecha_alta
object
datetime64[ns]
fecha
feature
14
formatos mezclados (d/m/a, texto libre)
compra
object
object
cualitativa binaria
objetivo (y)
0
—
score_credito
object
float64
cuantitativa discreta
feature
8
texto ('alto') en columna numérica
num_compras
int64
float64
cuantitativa discreta
feature
30
código -999 = no disponible
segmento
object
object
cualitativa ordinal/nominal
feature
18
'-' como faltante
Plantilla para describir un dataset:
Unidad de observación. Qué representa una fila y cuántas hay.
Variables. Tipo estadístico, unidad y rol (feature, objetivo, identificador, metadato).
Calidad. Faltantes reales (incluidos los disfrazados), tipos mal leídos, valores imposibles, duplicados.
Decisiones. Qué se convirtió, qué se marcó como faltante, qué se excluyó y por qué.
Representatividad. De qué población proviene la muestra y qué grupos podrían faltar.
“df_clientes tiene 1000 filas, una por cliente (salvo los id repetidos), y 9 variables más un identificador. El objetivo es compra (binaria). Se encontraron faltantes disfrazados en ingreso_mensual ("sin dato"), num_compras (-999) y segmento ("-"), edades de 200 años, ingresos negativos e identificadores repetidos. Se normalizaron los faltantes, se convirtieron los tipos contando los valores perdidos y se marcaron los valores imposibles para revisión. Limitación: los datos provienen de un solo sistema de registro; no se sabe si representan a todos los clientes.”
Errores que conviene nombrar
Tratar un identificador como magnitud. La “media del id” no describe a nadie.
Confiar en isna() para contar faltantes. Solo ve NaN; los faltantes disfrazados ("sin dato", -999, "-") pasan como datos.
Convertir con errors="coerce" sin contar. Los valores que no se pudieron convertir desaparecen en silencio.
Aceptar un dtype numérico como garantía. Una edad de 200 es un int válido.
Promediar códigos de categorías. El resultado depende del orden de codificación.
Olvidar la granularidad. Un promedio por transacción no es un promedio por cliente.
Llamar “la media” a una media muestral. Es un estadístico; otra muestra daría otro valor.
Creer que más datos corrigen el sesgo. Solo reducen el ruido alrededor del valor sesgado.
Idea clave
Un número calculado sobre datos mal tipados o mal muestreados es un número correcto que responde otra pregunta.pandas y cualquier modelo calculan lo que se les pide; la interpretación —qué es una fila, qué tipo tiene cada variable, qué es un faltante, de qué población viene la muestra— es trabajo del analista y va antes del primer promedio.
Síntesis
Se leyó un dataset como una matriz de observaciones y variables, y se separaron \(X\), \(y\) y el identificador. Se vio que la granularidad cambia el significado de un promedio y que el dtype no es el tipo estadístico. Sobre 1000 clientes con errores sembrados, isna() subestimó los faltantes, describe() reportó una edad de 200 sin advertir nada, y la conversión de tipos dejó un rastro que hubo que contar. Por último, una población simulada mostró que el estadístico varía de muestra en muestra y que una muestra sesgada sigue equivocada aunque crezca. El resultado es un diccionario de datos: el punto de partida de cualquier análisis de las próximas sesiones.
6. Guía rápida: ¿qué hacer con cada tipo de variable?
Tipo
Resumen válido
Gráfico
Preparación para un modelo
Nominal
Frecuencias, proporciones, moda
Barras
One-hot / embeddings
Ordinal
Lo anterior + mediana, percentiles
Barras ordenadas
Codificación ordenada
Cuantitativa discreta
Media, mediana, desviación, cuartiles
Barras por valor o histograma
Escalamiento
Cuantitativa continua
Media, mediana, desviación, cuartiles
Histograma, boxplot
Escalamiento
Identificador
Conteo de únicos y duplicados
—
Excluir de las features
Fecha
Mínimo, máximo, frecuencia por periodo
Serie temporal
Derivar variables (antigüedad, mes, día)
Regla de comunicación: antes de reportar un resumen, indicar la variable, su tipo, su unidad y cuántos valores válidos lo sostienen.
7. Guía práctica para la exploración inicial
Paso 1: estructura
shape, columns, head(). Qué representa una fila y cuál es el identificador.
Paso 2: tipos
info() y dtypes frente al tipo estadístico de cada columna. Convertir con pd.to_numeric o pd.to_datetime y contar los NaN nuevos.
Paso 3: faltantes
isna().sum() más value_counts() para encontrar marcadores disfrazados. Normalizarlos a NaN.
Paso 4: rangos y duplicados
describe() para mínimos y máximos, reglas de dominio (edad, ingresos, fechas) y duplicated() sobre el identificador.
Paso 5: redactar
“[dataset] tiene ___ filas (una por [unidad]) y ___ variables. El objetivo es [y]. Se encontraron [problemas] y se decidió [acciones]. Limitación: [representatividad de la muestra].”
8. Puente hacia las siguientes sesiones
Con las variables tipadas y los faltantes identificados, ya se puede resumir. En la Sesión 2 se calcula el centro de una variable —media, mediana y moda— y se ve por qué el tipo de variable decide cuál es válida. En la Sesión 3 se mide cuánto varían los datos alrededor de ese centro.
Esta sesión respondió qué es cada columna y si se puede confiar en ella. La siguiente responderá dónde está el centro de los datos.
9. Cierre
Este notebook deja una base aplicada sobre análisis de datos:
dato, variable y observación; el dataset como matriz \(X\) con objetivo \(y\),
tipos de variables, escalas de medición y la diferencia entre dtype y tipo estadístico,
exploración con head, info, describe y detección de tipos mal leídos,
faltantes reales y disfrazados, valores imposibles e identificadores duplicados,
población y muestra, parámetro y estadístico, y el efecto del sesgo de selección,
un diccionario de datos como entregable previo a cualquier análisis.
Resultado esperado: el estudiante no calcula una media sin antes saber qué representa la columna, cuántos valores válidos tiene y de qué población proviene la muestra.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.