%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
print("pandas:", pd.__version__, "| numpy:", np.__version__)
Python: 3.13.9
pandas: 2.3.3 | numpy: 2.3.5
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
¿Cuál es el “ingreso típico” de un grupo de personas? La respuesta cambia según si usas la media, la mediana o la moda, y elegir mal puede llevar a conclusiones equivocadas sobre un negocio, una política pública o un modelo de IA.
Este notebook trabaja media, mediana y moda de forma aplicada: definición, cálculo, comparación, sensibilidad a valores atípicos y un criterio contextual para decidir qué medida reportar.
Contexto de ejemplo: ingresos mensuales por ciudad en Colombia (dataset sintético, con valores extremos para observar su efecto sobre las medidas de centro).
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 1 · Sesión 2
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX (
$...$y$$...$$); si no se ven renderizadas, abre el notebook en Jupyter o Colab.
\[ \bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i \]
La media es el centro de gravedad: la suma de las desviaciones respecto a ella es cero (\(\sum (x_i - \bar{x}) = 0\)). Tiene sentido en variables cuantitativas; no se puede calcular sobre categorías nominales.
Es el valor que queda en la posición central una vez ordenados los datos. Si \(n\) es impar, es el valor en la posición \(\frac{n+1}{2}\); si es par, es el promedio de los dos valores centrales. Coincide con el percentil 50 (P50).
No depende de la magnitud de los extremos — solo de qué valor ocupa la posición central. Por eso es robusta ante valores atípicos, y es la medida preferida para variables ordinales o distribuciones asimétricas. En una variable ordinal con \(n\) par no se promedian categorías: si las dos centrales difieren, se reportan ambas.
Es el valor (o categoría) de mayor frecuencia. Es la única medida de tendencia central que tiene sentido para variables cualitativas nominales. Una distribución puede ser unimodal, bimodal o multimodal; en variables continuas, la moda exacta suele ser poco informativa (mejor hablar de “intervalo modal”).
| Tipo de variable | Media | Mediana | Moda |
|---|---|---|---|
| Cuantitativa (simétrica, sin valores atípicos) | ✓ Resumen principal | ✓ Complemento | Opcional |
| Cuantitativa (asimétrica o con valores atípicos) | Sensible | ✓ Preferible | Opcional |
| Ordinal | Poco recomendable | ✓ Preferible | ✓ Útil |
| Nominal | No tiene sentido | No tiene sentido | ✓ Única opción |
La media y la mediana no son solo “fórmulas de centro”: cada una es el valor \(c\) que mejor resume los datos según una forma distinta de medir el error.
\[ \bar{x} = \arg\min_{c} \frac{1}{n}\sum_{i=1}^{n} (x_i - c)^2 \qquad\qquad \text{mediana} = \arg\min_{c} \frac{1}{n}\sum_{i=1}^{n} |x_i - c| \]
La media minimiza el error cuadrático medio (MSE); la mediana, el error absoluto medio (MAE). Como el cuadrado castiga mucho los errores grandes, la media se desplaza hacia los extremos para no alejarse de ellos. Estas dos pérdidas reaparecen como métricas de error en la Sesión 11 (regresión lineal) y la Sesión 13 (validación).
\[ \bar{x}_w = \frac{\sum_{i} w_i\, x_i}{\sum_{i} w_i} \]
Se usa cuando las observaciones no pesan lo mismo; por ejemplo, al combinar las medias de grupos de tamaños distintos (\(w_i = n_i\)).
Se ordenan los datos, se descarta una proporción \(\alpha\) en cada extremo (por ejemplo 10%) y se promedia el resto. Es un punto intermedio: usa más información que la mediana y es menos sensible que la media.
La media incluye todos los valores: un solo dato muy grande puede arrastrar el promedio hacia arriba. La mediana, en cambio, depende de las posiciones centrales de los datos ordenados y suele cambiar mucho menos ante un valor extremo.
Considera los datos [2.5, 2.7, 2.8, 2.9, 3.0, 3.1, 3.2]. Su media y su mediana están cerca de 2.9. Si agregamos el valor 25, la media aumenta de forma marcada, mientras la mediana apenas cambia.
Esto no significa que todo valor extremo sea incorrecto. Puede ser un error de captura o una observación real. En esta sesión nos interesa comparar su efecto sobre las medidas de centro; en las sesiones 3 y 4 estudiaremos herramientas para cuantificar la dispersión, describir la forma de la distribución y detectar anomalías.
El punto de ruptura formaliza esta idea: es la fracción de datos contaminados a partir de la cual una medida puede tomar cualquier valor. Para la media es \(1/n\) (basta un dato); para la mediana es 50%.
Las medidas de tendencia central aparecen dentro de los modelos, no solo en los reportes:
Idea central: no existe una medida universalmente mejor. La elección depende del tipo de variable, los datos observados y la pregunta que queremos responder, y esa misma elección reaparece al entrenar y evaluar modelos.
¿Es cuantitativa, ordinal o nominal? Esto permite descartar medidas que no tienen una interpretación válida.
Para una variable cuantitativa, comparar media y mediana. Para una variable categórica nominal, revisar la moda y sus frecuencias.
No basta con obtener un número: hay que expresar qué representa, en qué unidad está y qué pregunta responde.
Comparar las medidas antes y después de introducir o retirar un valor extremo permite reconocer cuál es más sensible.
Criterio general: comprender cómo se calcula cada medida y qué información utiliza permite justificar la elección sin depender de una regla automática.
%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
print("pandas:", pd.__version__, "| numpy:", np.__version__)Python: 3.13.9
pandas: 2.3.3 | numpy: 2.3.5Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, todas las funciones de graficación se definen aquí, una sola vez. Más adelante, cada etapa solo llama a la función correspondiente.
from matplotlib.ticker import MaxNLocator


def graficar_centro(x, titulo, xlabel, bins=20, ax=None):
    """Histograma con líneas verticales en la media y la mediana."""
    standalone = ax is None
    if standalone:
        fig, ax = plt.subplots(figsize=(9, 4))
    x = np.asarray(x, dtype=float)
    ax.hist(x, bins=bins, alpha=0.75, edgecolor="white")
    ax.axvline(np.mean(x), color="C3", linestyle="--", linewidth=2, label=f"Media = {np.mean(x):,.0f}")
    ax.axvline(np.median(x), color="C2", linewidth=2, label=f"Mediana = {np.median(x):,.0f}")
    ax.set_xlabel(xlabel)
    ax.set_ylabel("Frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=9)
    if standalone:
        plt.tight_layout()
        plt.show()


def graficar_perdidas(x):
    """MSE(c) y MAE(c) al resumir los datos con una constante c: sus mínimos son la media y la mediana."""
    x = np.asarray(x, dtype=float)
    c = np.unique(np.concatenate([np.linspace(np.min(x), np.percentile(x, 95), 400),
                                  x, [np.mean(x), np.median(x)]]))
    c = c[c <= np.percentile(x, 95)]
    mse = ((x[None, :] - c[:, None]) ** 2).mean(axis=1)
    mae = np.abs(x[None, :] - c[:, None]).mean(axis=1)
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), constrained_layout=True)
    for ax, curva, nombre, centro, color, etiqueta in [
        (axes[0], mse, "MSE(c)", np.mean(x), "C3", "Media"),
        (axes[1], mae, "MAE(c)", np.median(x), "C2", "Mediana"),
    ]:
        ax.plot(c, curva)
        en_minimo = c[curva <= curva.min() * (1 + 1e-12)]
        if en_minimo.max() > en_minimo.min():
            ax.axvspan(en_minimo.min(), en_minimo.max(), color="0.6", alpha=0.35,
                       label=f"Tramo mínimo = [{en_minimo.min():,.0f}, {en_minimo.max():,.0f}]")
        else:
            ax.plot(en_minimo, [curva.min()], "ko", label=f"Mínimo de la curva = {en_minimo[0]:,.0f}")
        ax.axvline(centro, color=color, linestyle="--", label=f"{etiqueta} = {centro:,.0f}")
        ax.set_xlabel("Constante c usada como resumen")
        ax.set_ylabel(nombre)
        ax.set_title(f"{nombre}: el mínimo está en la {etiqueta.lower()}")
        ax.legend(fontsize=8)
    plt.show()


def graficar_frecuencias(series, ordenes=None):
    """Barras de frecuencia; la moda se resalta. Una variable ordinal se dibuja en su orden natural."""
    ordenes = ordenes or [None] * len(series)
    fig, axes = plt.subplots(1, len(series), figsize=(5.5 * len(series), 3.8), constrained_layout=True)
    for ax, s, orden in zip(np.atleast_1d(axes), series, ordenes):
        conteo = s.value_counts() if orden is None else s.value_counts().reindex(orden)
        colores = ["C1" if v == conteo.max() else "C0" for v in conteo.values]
        ax.bar(conteo.index.astype(str), conteo.values, color=colores)
        tipo = "nominal, ordenada por frecuencia" if orden is None else "ordinal, en su orden natural"
        ax.set_title(f"{s.name} ({tipo})\nla moda es la barra resaltada", fontsize=10)
        ax.set_ylabel("Frecuencia")
    plt.show()


def graficar_moda_discreta_continua(discreta, continua, ancho_intervalo):
    """Moda en una variable discreta (barras) frente a intervalo modal en una continua (histograma)."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), constrained_layout=True)
    conteo = discreta.value_counts().sort_index()
    colores = ["C1" if v == conteo.max() else "C0" for v in conteo.values]
    axes[0].bar(conteo.index, conteo.values, color=colores)
    axes[0].set_title(f"{discreta.name} (discreta): moda(s) resaltada(s)")
    axes[0].set_xlabel(discreta.name)
    axes[0].set_ylabel("Frecuencia")

    bordes = np.arange(0, continua.max() + ancho_intervalo, ancho_intervalo)
    frec, bordes, parches = axes[1].hist(continua, bins=bordes, edgecolor="white")
    parches[int(np.argmax(frec))].set_facecolor("C1")
    axes[1].set_title(f"{continua.name} (continua): intervalo modal resaltado")
    axes[1].set_xlabel(f"{continua.name} (intervalos de {ancho_intervalo:,})")
    axes[1].set_ylabel("Frecuencia")
    for ax in axes:
        ax.yaxis.set_major_locator(MaxNLocator(integer=True))
    plt.show()


def graficar_ruptura(porcentajes, medias, medianas, recortadas, referencia):
    """Cómo cambian media, mediana y media recortada al contaminar una fracción creciente de datos."""
    fig, ax = plt.subplots(figsize=(9, 4.2))
    ax.plot(porcentajes, medias, marker="o", color="C3", label="Media")
    ax.plot(porcentajes, recortadas, marker="^", color="C1", label="Media recortada 10%")
    ax.plot(porcentajes, medianas, marker="s", color="C2", label="Mediana")
    ax.axhline(referencia, color="0.3", linestyle=":", label=f"Mediana sin contaminar = {referencia:,.0f}")
    ax.set_yscale("log")
    ax.set_xlabel("% de datos reemplazados por valores extremos")
    ax.set_ylabel("Valor de la medida (escala log)")
    ax.set_title("Punto de ruptura: cuántos datos malos aguanta cada medida")
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_centro_por_grupo(tabla, mediana_global):
    """Media y mediana por grupo, con la mediana global como referencia."""
    x = np.arange(len(tabla))
    w = 0.38
    fig, ax = plt.subplots(figsize=(9, 4))
    ax.bar(x - w / 2, tabla["media"], width=w, color="C3", alpha=0.8, label="Media")
    ax.bar(x + w / 2, tabla["mediana"], width=w, color="C2", alpha=0.8, label="Mediana")
    for xi, n_i in zip(x, tabla["n"]):
        ax.text(xi, 150, f"n={n_i}", ha="center", color="white", fontsize=9)
    ax.axhline(mediana_global, color="0.3", linestyle=":", label=f"Mediana global = {mediana_global:,.0f}")
    ax.set_xticks(x)
    ax.set_xticklabels(tabla.index)
    ax.set_ylabel("Ingreso mensual")
    ax.set_title("Centro por ciudad: media y mediana")
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_imputacion(observado, imputado_media, imputado_mediana, bins):
    """Distribución observada frente a la distribución tras imputar con media o mediana."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), sharey=True, constrained_layout=True)
    for ax, imputado, nombre, color in [
        (axes[0], imputado_media, "media", "C3"),
        (axes[1], imputado_mediana, "mediana", "C2"),
    ]:
        ax.hist(imputado, bins=bins, color=color, alpha=0.55, label=f"Tras imputar con la {nombre}")
        ax.hist(observado, bins=bins, histtype="step", color="black", linewidth=1.5, label="Solo valores observados")
        ax.set_title(f"Imputación con la {nombre}: un pico artificial")
        ax.set_xlabel("Ingreso mensual")
        ax.yaxis.set_major_locator(MaxNLocator(integer=True))
        ax.legend(fontsize=8)
    axes[0].set_ylabel("Frecuencia")
    plt.show()


def graficar_salarios(salarios, etiquetas):
    """Salarios ordenados con media y mediana: ¿cuántas personas ganan 'el promedio'?"""
    orden = np.argsort(salarios)
    s = np.asarray(salarios)[orden]
    fig, ax = plt.subplots(figsize=(10, 4))
    ax.bar(np.arange(len(s)), s / 1e6, color=["C1" if e != "Equipo" else "C0" for e in np.asarray(etiquetas)[orden]])
    ax.axhline(np.mean(s) / 1e6, color="C3", linestyle="--", linewidth=2, label=f"Media = {np.mean(s)/1e6:.2f} M")
    ax.axhline(np.median(s) / 1e6, color="C2", linewidth=2, label=f"Mediana = {np.median(s)/1e6:.2f} M")
    ax.set_xlabel("25 empleados ordenados por salario (azul: equipo; naranja: directivos y fundador)")
    ax.set_ylabel("Salario mensual (millones)")
    ax.set_title("¿Cuántas personas ganan el 'salario promedio'?")
    ax.set_xticks([])
    ax.legend(fontsize=9)
    plt.tight_layout()
plt.show()El análisis se divide en etapas: construir los datos, calcular las medidas de centro, ver qué minimiza cada una, estudiar la moda en variables cualitativas, discretas y continuas, medir la sensibilidad y el punto de ruptura, comparar grupos y, al final, llevar la elección de la medida a dos decisiones de Machine Learning: la imputación y la función de pérdida. Cada etapa de código incluye una interpretación de los resultados.
rng = np.random.default_rng(7)
n = 60

ciudad = rng.choice(
    ["Bogotá", "Medellín", "Cali", "Barranquilla"],
    size=n, p=[0.40, 0.25, 0.20, 0.15]
)
segmento = rng.choice(
    ["Básico", "Estándar", "Premium"],
    size=n, p=[0.50, 0.30, 0.20]
)
edad = rng.integers(21, 56, size=n)

# La generación incluye algunos ingresos altos para comparar media y mediana
ingreso_mensual = np.round(rng.lognormal(mean=np.log(2750), sigma=0.62, size=n), -1)

df = pd.DataFrame({
    "ingreso_mensual": ingreso_mensual,
    "edad": edad,
    "ciudad": ciudad,
    "segmento": segmento,
})

print(f"Dataset: {len(df)} registros")
display(df.head(10))
Dataset: 60 registros| ingreso_mensual | edad | ciudad | segmento | |
|---|---|---|---|---|
| 0 | 2770.0 | 54 | Medellín | Estándar |
| 1 | 1790.0 | 21 | Barranquilla | Estándar |
| 2 | 2250.0 | 51 | Cali | Estándar |
| 3 | 1940.0 | 42 | Bogotá | Básico |
| 4 | 2760.0 | 37 | Bogotá | Básico |
| 5 | 2180.0 | 48 | Barranquilla | Básico |
| 6 | 2280.0 | 54 | Bogotá | Básico |
| 7 | 1170.0 | 38 | Cali | Básico |
| 8 | 1670.0 | 24 | Cali | Premium |
| 9 | 7670.0 | 46 | Medellín | Básico |
Conclusiones Etapa 1 (construcción del dataset)
ciudad es cualitativa nominal (las ciudades no tienen orden); segmento es cualitativa ordinal (Básico < Estándar < Premium); ingreso_mensual y edad son cuantitativas.ingreso_mensual — manual, NumPy y pandasvalores = df["ingreso_mensual"].to_numpy()
n_valores = len(valores)
media_manual = valores.sum() / n_valores
media_numpy = np.mean(valores)
ordenados = np.sort(valores)
mediana_manual = (
(ordenados[(n_valores - 1) // 2] + ordenados[n_valores // 2]) / 2
if n_valores % 2 == 0 else ordenados[n_valores // 2]
)
mediana_numpy = np.median(valores)
moda_ingreso = df["ingreso_mensual"].mode().tolist()
print("Media (manual):", round(media_manual, 2))
print("Media (NumPy):", round(media_numpy, 2))
print("Mediana (manual):", round(mediana_manual, 2))
print("Mediana (NumPy):", round(mediana_numpy, 2))
print("Moda (pandas):", moda_ingreso[:6], "..." if len(moda_ingreso) > 6 else "")
print("\nDiferencia media - mediana:", round(media_numpy - mediana_numpy, 2))
print("Diferencia relativa:", round((media_numpy - mediana_numpy) / mediana_numpy * 100, 1), "%")Media (manual): 3189.33
Media (NumPy): 3189.33
Mediana (manual): 2605.0
Mediana (NumPy): 2605.0
Moda (pandas): [1170.0, 1940.0, 2010.0, 2280.0, 2520.0]
Diferencia media - mediana: 584.33
Diferencia relativa: 22.4 %Conclusiones Etapa 2 (media, mediana y moda del ingreso)
Los números de la Etapa 2 se entienden mejor sobre el histograma. La pregunta es: ¿hacia dónde se inclina la distribución y dónde queda cada medida?
graficar_centro(df["ingreso_mensual"], "Ingreso mensual: dónde caen la media y la mediana", "Ingreso mensual", bins=15)

por_debajo_media = (df["ingreso_mensual"] < df["ingreso_mensual"].mean()).mean() * 100
print(f"Registros por debajo de la media:   {por_debajo_media:.1f}%")
print(f"Registros por debajo de la mediana: {(df['ingreso_mensual'] < df['ingreso_mensual'].median()).mean() * 100:.1f}%")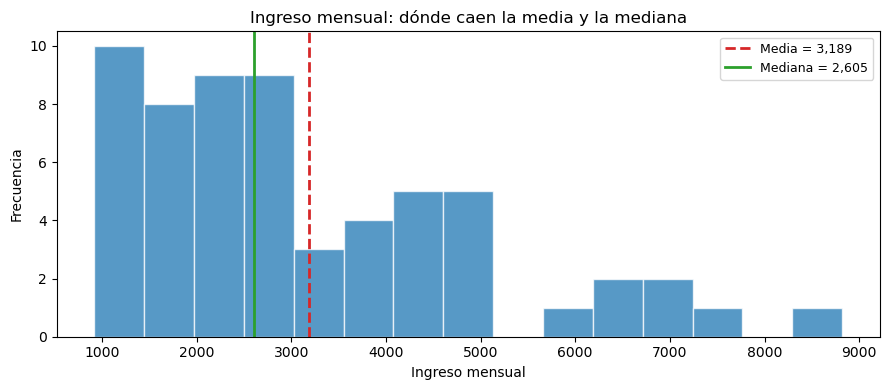
Registros por debajo de la media:   60.0%
Registros por debajo de la mediana: 50.0%
Conclusiones Etapa 3 (el centro sobre la distribución)
Si hubiera que resumir los 60 ingresos con un solo número \(c\), ¿cuál sería el mejor? Depende de cómo se mida el error. Se evalúan todos los \(c\) posibles con dos pérdidas:
\[ \text{MSE}(c) = \frac{1}{n}\sum_i (x_i - c)^2 \qquad \text{MAE}(c) = \frac{1}{n}\sum_i |x_i - c| \]
x_ing = df["ingreso_mensual"].to_numpy()
print("Suma de desviaciones respecto a la media:", round(np.sum(x_ing - x_ing.mean()), 6) + 0.0)
print("Suma de desviaciones respecto a la mediana:", round(np.sum(x_ing - np.median(x_ing)), 2))

graficar_perdidas(x_ing)
Suma de desviaciones respecto a la media: 0.0
Suma de desviaciones respecto a la mediana: 35060.0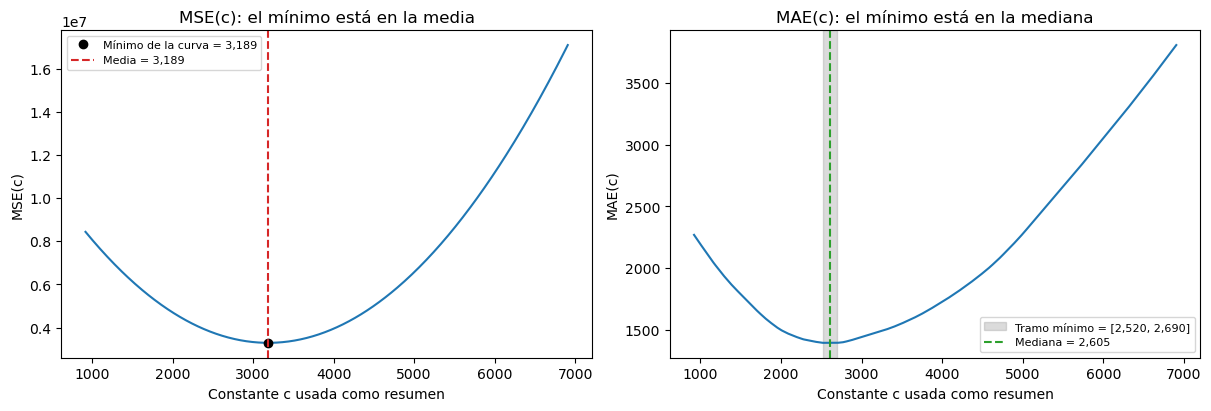
Conclusiones Etapa 4 (qué minimiza cada medida)
ciudad y segmento)print("Moda de ciudad:", df["ciudad"].mode().tolist())
print("Moda de segmento:", df["segmento"].mode().tolist())
print("\nFrecuencias por ciudad:")
print(df["ciudad"].value_counts())
print("\nFrecuencias por segmento:")
print(df["segmento"].value_counts())Moda de ciudad: ['Bogotá']
Moda de segmento: ['Básico']
Frecuencias por ciudad:
ciudad
Bogotá 25
Medellín 18
Cali 9
Barranquilla 8
Name: count, dtype: int64
Frecuencias por segmento:
segmento
Básico 28
Estándar 18
Premium 14
Name: count, dtype: int64# segmento es ordinal: además de la moda admite la mediana (la categoría en la posición central)
orden_segmento = ["Básico", "Estándar", "Premium"]
codigos_seg = np.sort(pd.Categorical(df["segmento"], categories=orden_segmento, ordered=True).codes)
n_seg = len(codigos_seg)
centrales = [orden_segmento[codigos_seg[n_seg // 2 - 1]], orden_segmento[codigos_seg[n_seg // 2]]]
print(f"segmento ordenado: categorías en las posiciones {n_seg // 2} y {n_seg // 2 + 1} ->", centrales)
graficar_frecuencias([df["ciudad"], df["segmento"]], ordenes=[None, orden_segmento])segmento ordenado: categorías en las posiciones 30 y 31 -> ['Estándar', 'Estándar']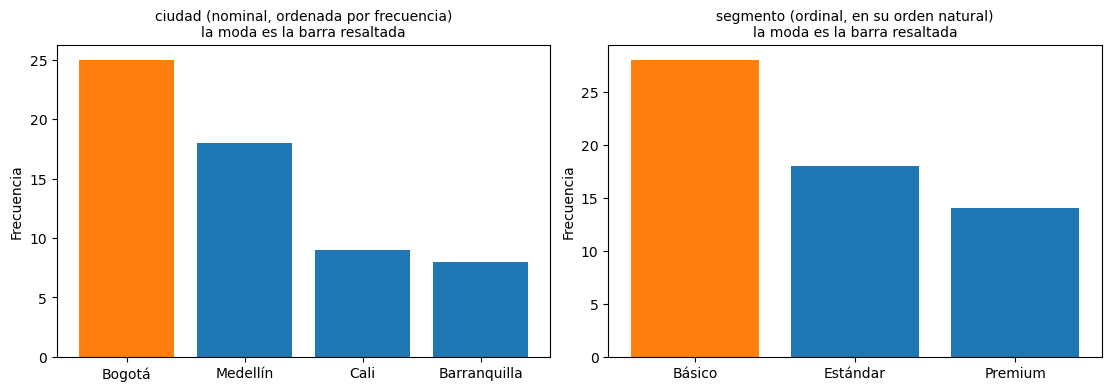
Conclusiones Etapa 5 (moda en variables cualitativas)
ciudad es Bogotá (25 de 60 registros, ~42%); la moda de segmento es Básico (28 de 60, ~47%).ciudad (nominal) la moda es la única medida de centro válida: no existe una “media” ni una “mediana” de ciudades, sin importar cómo se codifiquen las categorías.segmento es ordinal, así que además admite la mediana: al ordenar los 60 registros, las posiciones 30 y 31 caen en Estándar. Moda y mediana responden cosas distintas: el segmento más frecuente es Básico, pero la mitad de los clientes está en Estándar o por encima. Por eso el gráfico de segmento respeta el orden Básico → Estándar → Premium en lugar de ordenar por frecuencia.En una variable discreta, la moda es informativa cuando hay pocos valores posibles y muchos registros (número de hijos, número de compras). La edad en años cumplidos es discreta (Sesión 1), pero tiene 35 valores posibles para 60 registros: se verá qué tan informativa resulta. En una variable continua (ingreso) casi ningún valor se repite: la moda exacta es un accidente del redondeo. Lo útil es el intervalo modal: el intervalo del histograma con más observaciones.
print("Moda(s) de edad:", df["edad"].mode().tolist())
print("Frecuencia de la moda de edad:", df["edad"].value_counts().max(), "de", len(df))

ancho = 1000
intervalos = pd.cut(df["ingreso_mensual"], bins=np.arange(0, df["ingreso_mensual"].max() + ancho, ancho))
conteo_int = intervalos.value_counts().sort_index()
print("\nIngreso mensual agrupado en intervalos de", ancho)
print(conteo_int[conteo_int > 0])
print("\nIntervalo modal:", conteo_int.idxmax(), "con", conteo_int.max(), "registros")
print("Moda exacta de ingreso (pandas):", df["ingreso_mensual"].mode().tolist()[:5], "...")

graficar_moda_discreta_continua(df["edad"], df["ingreso_mensual"], ancho)
Moda(s) de edad: [54]
Frecuencia de la moda de edad: 7 de 60
Ingreso mensual agrupado en intervalos de 1000
ingreso_mensual
(0.0, 1000.0] 2
(1000.0, 2000.0] 16
(2000.0, 3000.0] 18
(3000.0, 4000.0] 6
(4000.0, 5000.0] 10
(5000.0, 6000.0] 2
(6000.0, 7000.0] 3
(7000.0, 8000.0] 2
(8000.0, 9000.0] 1
Name: count, dtype: int64
Intervalo modal: (2000.0, 3000.0] con 18 registros
Moda exacta de ingreso (pandas): [1170.0, 1940.0, 2010.0, 2280.0, 2520.0] ...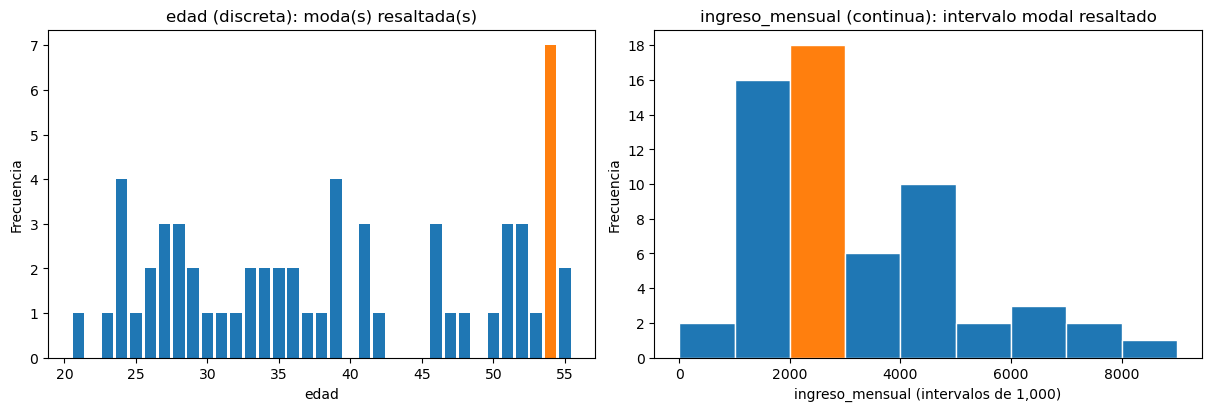
Conclusiones Etapa 6 (moda en variables discretas y continuas)
edad, la moda es 54 años, con 7 de 60 registros: un valor en el extremo superior del rango, lejos del centro del grupo. Con 60 registros y 35 edades posibles, la moda describe poco: es el valor que más se repitió por azar.ingreso_mensual, la moda exacta devuelve varios valores empatados (Etapa 2) y ninguno representa al grupo. El intervalo modal (2,000–3,000], con 18 de 60 registros, sí responde una pregunta útil: ¿dónde se concentra la mayoría?datos_sin_extremo = np.array([2.5, 3.0, 2.8, 3.2, 2.9, 3.1, 2.7])
datos_con_extremo = np.append(datos_sin_extremo, 25.0)
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
ax = axes[0]
ax.vlines(np.mean(datos_sin_extremo), 0, 1, colors="C3", label="Media", linewidth=2)
ax.vlines(np.median(datos_sin_extremo), 0, 0.7, colors="C2", label="Mediana", linewidth=2)
ax.scatter(datos_sin_extremo, np.zeros_like(datos_sin_extremo) + 0.3, alpha=0.7)
ax.set_title("Sin valor extremo")
ax.set_yticks([]) # el eje vertical no representa ninguna magnitud
ax.legend()
ax.set_xlabel("Valor")
ax = axes[1]
ax.vlines(np.mean(datos_con_extremo), 0, 1, colors="C3", label="Media", linewidth=2)
ax.vlines(np.median(datos_con_extremo), 0, 0.7, colors="C2", label="Mediana", linewidth=2)
ax.scatter(datos_con_extremo, np.zeros_like(datos_con_extremo) + 0.3, alpha=0.7)
ax.set_title("Con un valor extremo (25)")
ax.set_yticks([])
ax.legend()
ax.set_xlabel("Valor")
plt.tight_layout()
plt.show()
print("Sin valor extremo — Media:", round(np.mean(datos_sin_extremo), 2), "| Mediana:", np.median(datos_sin_extremo))
print("Con valor extremo — Media:", round(np.mean(datos_con_extremo), 2), "| Mediana:", round(np.median(datos_con_extremo), 2))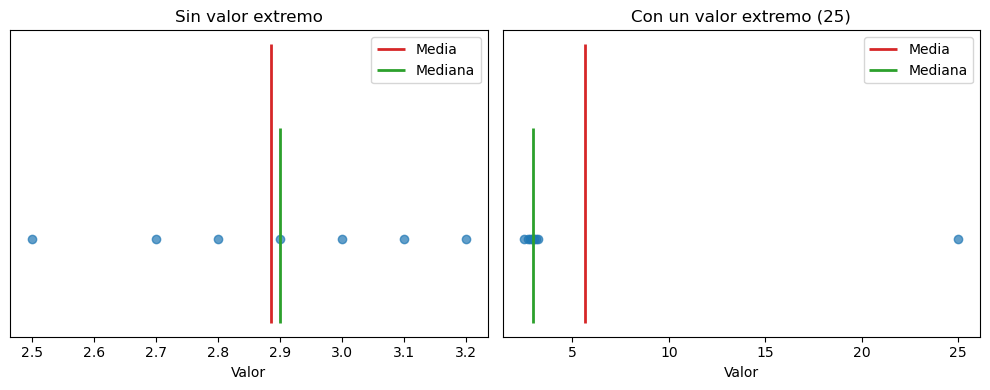
Sin valor extremo — Media: 2.89 | Mediana: 2.9
Con valor extremo — Media: 5.65 | Mediana: 2.95
Conclusiones Etapa 7 (sensibilidad ante un valor extremo)
La media recortada al 10% descarta el 10% más bajo y el 10% más alto de los datos ordenados y promedia el resto. Se compara con la media y la mediana sobre el ingreso, antes y después de agregar un ingreso extremo.
def media_recortada(x, proporcion=0.10):
    x = np.sort(np.asarray(x, dtype=float))
    k = int(np.floor(proporcion * len(x)))
    return x[k:len(x) - k].mean()

ingreso_con_extremo = np.append(x_ing, 250_000)

comparacion = pd.DataFrame({
    "sin extremo": [np.mean(x_ing), np.median(x_ing), media_recortada(x_ing)],
    "con un ingreso de 250,000": [np.mean(ingreso_con_extremo), np.median(ingreso_con_extremo),
                                  media_recortada(ingreso_con_extremo)],
}, index=["media", "mediana", "media recortada 10%"])
comparacion["cambio"] = comparacion.iloc[:, 1] - comparacion.iloc[:, 0]
print(comparacion.round(1))
sin extremo con un ingreso de 250,000 cambio
media 3189.3 7235.4 4046.1
mediana 2605.0 2690.0 85.0
media recortada 10% 2946.9 3015.1 68.2Conclusiones Etapa 8 (media recortada)
Se reemplaza una fracción creciente de los ingresos por un valor absurdo (100 veces el máximo, como un error de captura con ceros de más) y se sigue cada medida.
rng_rup = np.random.default_rng(11)
orden_contaminacion = rng_rup.permutation(len(x_ing))
valor_malo = x_ing.max() * 100

porcentajes, medias, medianas, recortadas = [], [], [], []
for k in [0, 1] + list(range(3, len(x_ing) // 2 + 1, 3)):
    x_cont = x_ing.copy()
    x_cont[orden_contaminacion[:k]] = valor_malo
    porcentajes.append(100 * k / len(x_ing))
    medias.append(np.mean(x_cont))
    medianas.append(np.median(x_cont))
    recortadas.append(media_recortada(x_cont))

tabla_ruptura = pd.DataFrame({"%_contaminado": porcentajes, "media": medias,
                              "media_recortada_10%": recortadas, "mediana": medianas})
print(f"Máximo de los datos buenos: {x_ing.max():,.0f} | valor contaminante: {valor_malo:,.0f}\n")
print(tabla_ruptura.round(1).to_string(index=False))

graficar_ruptura(porcentajes, medias, medianas, recortadas, np.median(x_ing))
Máximo de los datos buenos: 8,820 | valor contaminante: 882,000
%_contaminado media media_recortada_10% mediana
0.0 3189.3 2946.9 2605.0
1.7 17867.8 3051.0 2700.0
5.0 47165.8 3204.4 2735.0
10.0 91107.5 3496.5 2780.0
15.0 135065.2 58443.5 3085.0
20.0 178979.5 113336.5 3345.0
25.0 222881.5 168214.0 3570.0
30.0 266837.3 223158.8 4200.0
35.0 310752.2 278052.3 4530.0
40.0 354705.3 332989.4 4910.0
45.0 398665.2 387939.2 6740.0
50.0 442548.2 442782.5 445410.0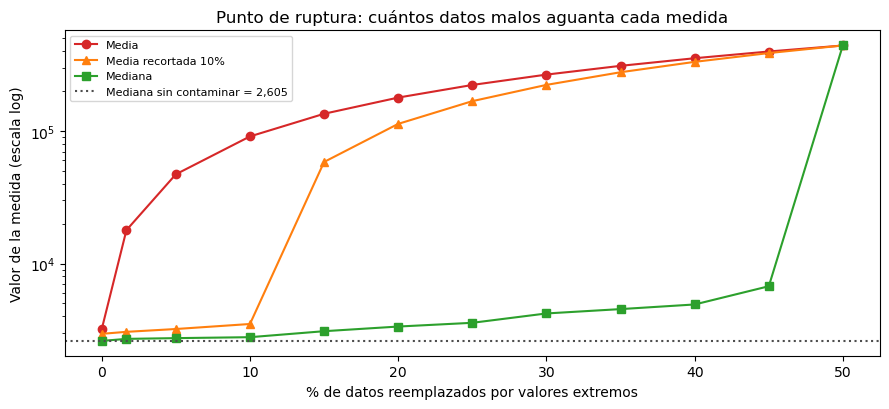
Conclusiones Etapa 9 (punto de ruptura)
Al comparar ciudades aparece un error frecuente: promediar las medias de cada grupo como si todos los grupos tuvieran el mismo tamaño.
por_ciudad = (df.groupby("ciudad")["ingreso_mensual"]
                .agg(n="count", media="mean", mediana="median")
                .sort_values("n", ascending=False))
print(por_ciudad.round(1))

promedio_de_promedios = por_ciudad["media"].mean()
media_ponderada = np.average(por_ciudad["media"], weights=por_ciudad["n"])
print(f"\nPromedio simple de las medias por ciudad: {promedio_de_promedios:,.1f}")
print(f"Media ponderada por n:                    {media_ponderada:,.1f}")
print(f"Media global de los 60 registros:         {df['ingreso_mensual'].mean():,.1f}")

graficar_centro_por_grupo(por_ciudad, df["ingreso_mensual"].median())
n media mediana
ciudad
Bogotá 25 3283.6 2760.0
Medellín 18 3443.9 3035.0
Cali 9 3137.8 2280.0
Barranquilla 8 2380.0 1965.0
Promedio simple de las medias por ciudad: 3,061.3
Media ponderada por n: 3,189.3
Media global de los 60 registros: 3,189.3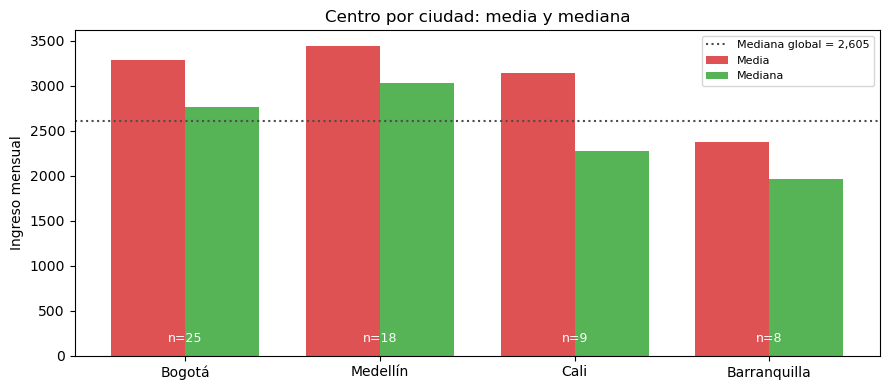
Conclusiones Etapa 10 (centro por grupos)
Antes de entrenar un modelo, los faltantes suelen rellenarse con una medida de centro. Se simula que el 25% de los ingresos no se registró y se comparan las dos opciones más comunes.
rng_imp = np.random.default_rng(3)
ingreso_obs = df["ingreso_mensual"].copy()
faltan = rng_imp.choice(len(ingreso_obs), size=15, replace=False)
ingreso_obs.iloc[faltan] = np.nan

observados = ingreso_obs.dropna()
imp_media = ingreso_obs.fillna(observados.mean())
imp_mediana = ingreso_obs.fillna(observados.median())

def resumen_centro(s):
    return pd.Series({"media": s.mean(), "mediana": s.median(),
                      "valor_mas_repetido": s.value_counts().index[0],
                      "repeticiones": s.value_counts().iloc[0]})

resumen_imp = pd.DataFrame({
    "completo (referencia)": resumen_centro(df["ingreso_mensual"]),
    "imputado con media": resumen_centro(imp_media),
    "imputado con mediana": resumen_centro(imp_mediana),
}).T
resumen_imp["repeticiones"] = resumen_imp["repeticiones"].astype(int)
print(f"Faltantes: {ingreso_obs.isna().sum()} de {len(ingreso_obs)}")
print(f"Valor usado — media: {observados.mean():,.1f} | mediana: {observados.median():,.1f}")
print()
print(resumen_imp.round(1))

graficar_imputacion(observados, imp_media, imp_mediana, bins=np.arange(0, 11000, 500))
Faltantes: 15 de 60
Valor usado — media: 3,225.3 | mediana: 2,710.0
media mediana valor_mas_repetido repeticiones
completo (referencia) 3189.3 2605.0 2010.0 2
imputado con media 3225.3 3225.3 3225.3 15
imputado con mediana 3096.5 2710.0 2710.0 16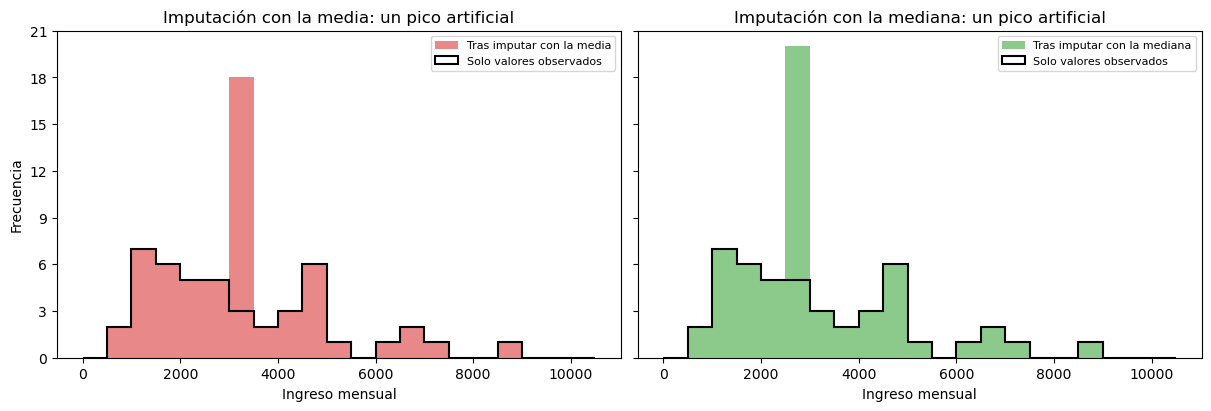
Conclusiones Etapa 11 (imputación con media o mediana)
Una empresa de 25 personas publica una oferta: “salario promedio del equipo: más de 6 millones”. Es verdad. La pregunta es si describe lo que ganará quien entre.
rng_sal = np.random.default_rng(5)
equipo = np.round(rng_sal.normal(3_600_000, 450_000, size=22), -4)
directivos = np.array([14_000_000, 16_000_000])
fundador = np.array([60_000_000])
salarios = np.concatenate([equipo, directivos, fundador])
etiquetas = ["Equipo"] * len(equipo) + ["Directivo"] * 2 + ["Fundador"]

media_sal, mediana_sal = salarios.mean(), np.median(salarios)
print(f"Media:   {media_sal:,.0f}")
print(f"Mediana: {mediana_sal:,.0f}")
print(f"Personas que ganan más que la media: {(salarios > media_sal).sum()} de {len(salarios)}")
print(f"Media sin el fundador: {salarios[:-1].mean():,.0f}")

graficar_salarios(salarios, etiquetas)
Media: 6,696,000
Mediana: 3,560,000
Personas que ganan más que la media: 3 de 25
Media sin el fundador: 4,475,000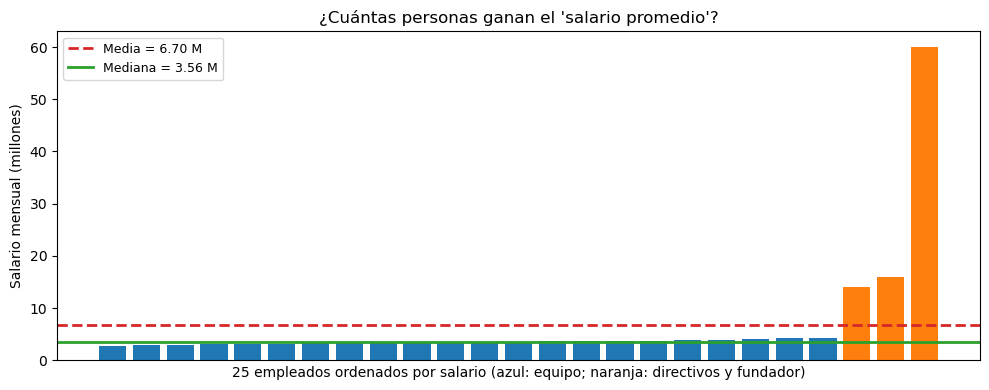
Conclusiones Etapa 12 (caso real)
Se aplica la guía de la sección 7 al ingreso mensual del dataset de la sesión.
media_i, mediana_i = df["ingreso_mensual"].mean(), df["ingreso_mensual"].median()
dif_rel = (media_i - mediana_i) / mediana_i * 100
medida = "mediana" if abs(dif_rel) > 10 else "media"

print("Variable: ingreso_mensual (cuantitativa continua, unidades monetarias)")
print(f"n = {df['ingreso_mensual'].count()} | media = {media_i:,.1f} | mediana = {mediana_i:,.1f} | "
      f"media recortada 10% = {media_recortada(df['ingreso_mensual']):,.1f}")
print(f"Diferencia relativa media vs mediana: {dif_rel:.1f}%")
print(f"Medida principal sugerida: {medida}")
Variable: ingreso_mensual (cuantitativa continua, unidades monetarias)
n = 60 | media = 3,189.3 | mediana = 2,605.0 | media recortada 10% = 2,946.9
Diferencia relativa media vs mediana: 22.4%
Medida principal sugerida: mediana“Para
ingreso_mensual(\(n=60\)), la media es 3,189.3 y la mediana es 2,605; la media está un 22.4% por encima porque la distribución tiene una cola de ingresos altos. Se reporta la mediana como medida principal, acompañada de la media recortada al 10% (2,946.9) como referencia. Por ciudad, se reportan medianas con el tamaño de cada grupo, y cualquier combinación de medias entre ciudades se pondera por \(n\). Limitación: datos sintéticos, 60 registros; con grupos de 8 o 9 personas, las medianas por ciudad son inestables.”
El umbral del 10% que usa el código es una regla práctica para esta sesión, no una norma: lo que se reporta es la razón de la elección.
La media, la mediana y la moda no son tres formas de calcular lo mismo: responden preguntas distintas. La media es el equilibrio y minimiza el error cuadrático; la mediana es la posición central y minimiza el error absoluto; la moda es lo más frecuente y es la única válida para categorías. Elegir entre ellas es elegir qué se quiere resumir, y esa elección reaparece en la pérdida de un modelo, en la imputación de faltantes y en cómo se combinan métricas entre grupos.
Se calcularon media, mediana y moda del ingreso a mano, con NumPy y con pandas, y se vio sobre el histograma que la cola de ingresos altos separa la media de la mediana. Las curvas de MSE y MAE mostraron que cada medida es el mejor resumen bajo una pérdida distinta. La moda resultó natural en variables nominales, poco informativa en una discreta con muchos valores y reemplazable por el intervalo modal en una continua. Un solo valor extremo movió la media y casi no movió la mediana; el punto de ruptura lo cuantificó (un dato frente a la mitad de los datos), y la media recortada quedó como punto intermedio. Por último, el promedio de promedios, la imputación y el “salario promedio” mostraron que la elección de la medida tiene consecuencias directas en análisis y en modelos.
| Situación | Medida principal | Justificación |
|---|---|---|
Variable nominal (ciudad) |
Moda | Identifica la categoría más frecuente; media y mediana no tienen interpretación. |
Variable ordinal (segmento, escala de satisfacción) |
Mediana o moda | Conservan el orden sin suponer distancias iguales entre categorías. |
| Variable cuantitativa sin valores extremos relevantes | Media | Utiliza todas las observaciones y representa el promedio aritmético. |
| Variable cuantitativa con valores extremos | Mediana, acompañada por la media | La mediana es menos sensible; comparar ambas muestra el efecto de los extremos. |
| Variable continua, pregunta “¿dónde se concentran?” | Intervalo modal | La moda exacta es un accidente del redondeo. |
| Se quiere un promedio sin depender de unos pocos extremos | Media recortada | Usa la mayoría de los datos y descarta los extremos con una regla fija. |
| Combinar medias de grupos de distinto tamaño | Media ponderada | El promedio simple de medias sobrerrepresenta a los grupos pequeños. |
Regla de comunicación: indicar siempre la variable, el valor, la unidad y la razón por la que se eligió esa medida.
Indica su nombre, tipo y unidad. Por ejemplo, ingreso_mensual es cuantitativa y está expresada en unidades monetarias.
En variables cuantitativas, observa si la media cambia mucho ante valores extremos y compárala con la mediana. No basta con afirmar que una cifra es mayor: explica qué significa en el contexto.
Elige la medida que responda mejor a la pregunta y justifica la decisión según el tipo de variable y la presencia de valores extremos.
“Para
[variable], la media es___y la mediana es___. Se reporta[medida]como medida principal porque[justificación contextual].”
Ejemplo aplicado: “Para ingreso_mensual, la media es 3,189.3 y la mediana es 2,605. Se reporta la mediana como medida principal porque los ingresos altos desplazan la media y la mediana representa mejor la posición central del grupo.”
En esta sesión vimos que los valores extremos afectan más a la media que a la mediana, y que imputar con una medida de centro concentra artificialmente los datos. Queda una pregunta abierta: dos conjuntos pueden tener la misma media y la misma mediana y, aun así, comportarse de manera muy diferente, porque el centro no dice nada sobre qué tan separados están los datos.
En la Sesión 3 aprenderemos a cuantificar qué tan separados están los datos mediante rango, varianza, desviación estándar y coeficiente de variación. En la Sesión 4 estudiaremos formalmente la forma de las distribuciones, la asimetría y la detección de anomalías.
La tendencia central responde dónde está el centro. Las próximas sesiones responderán qué tanto varían los datos y qué forma tiene su distribución.
Este notebook deja una base aplicada sobre tendencia central:
Resultado esperado: el estudiante no solo calcula una medida, sino que puede explicar qué representa, cuándo es válida y por qué la elegiría para resumir una variable.
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.