Estadística para IA — 3. Variabilidad y dispersión

estadistica
varianza
dispersion
Rango, varianza, desviación estándar y coeficiente de variación aplicados, con su efecto sobre la estabilidad de un modelo, incluyendo un caso real de validación de datos.
Author

Wilder Ramírez Delgado

Published

September 18, 2026

Sesión 3 — Variabilidad y Dispersión

Open in Colab

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Variabilidad y Dispersión Aplicadas

Dos conjuntos de datos pueden tener casi la misma media y, aun así, comportarse de forma completamente distinta. En uno, los valores están concentrados y estables; en otro, están muy separados, con más extremos y más incertidumbre. Esa diferencia es la dispersión.

Este notebook trabaja rango, varianza, desviación estándar y coeficiente de variación de forma aplicada: definición, cálculo, comparación visual y su efecto sobre la estabilidad de un modelo.

Contexto de ejemplo: notas de un examen (escala 0–100) y tiempos de respuesta en milisegundos (dataset sintético, diseñado para comparar baja vs alta dispersión y escalas distintas).

Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 1 · Sesión 3

Objetivos

  • Explicar con palabras sencillas qué mide la dispersión y por qué la media sola no basta.
  • Calcular e interpretar rango, varianza, desviación estándar y coeficiente de variación.
  • Comparar conjuntos con media parecida y variabilidad distinta.
  • Relacionar la dispersión con ruido, estabilidad de patrones y decisiones de preprocesamiento.
  • Visualizar cómo cambia un ajuste simple cuando aumenta el ruido de los datos.
  • Decidir qué medida de dispersión conviene reportar según la escala y la pregunta.

Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX ($...$ y $$...$$); si no se ven renderizadas, abre el notebook en Jupyter o Colab.

1. Dispersión: el ancho de los datos

La media resume el centro. La dispersión resume el ancho: cuánto se separan los valores alrededor de ese centro.

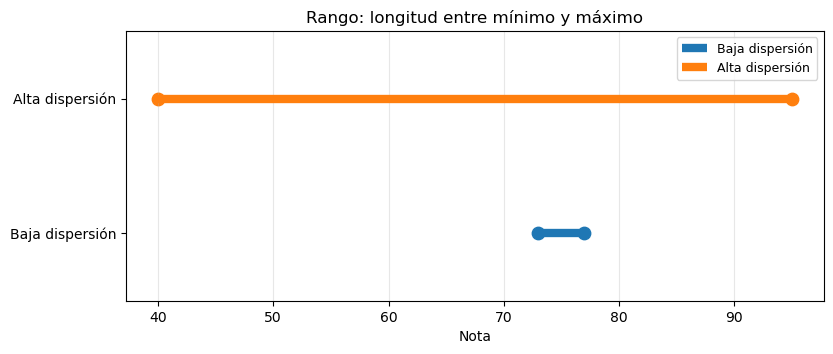
Rango

\[ \text{Rango} = \max(x_i) - \min(x_i) \]

Es la medida más simple: solo usa dos valores. Un solo extremo puede inflarlo, así que no describe la dispersión típica del conjunto.

Varianza

\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]

Promedia los cuadrados de las desviaciones respecto a la media. Las unidades quedan al cuadrado, por eso es menos intuitiva al leerla sola.

Desviación estándar

\[ s = \sqrt{s^2} \]

Es la raíz de la varianza y se expresa en las mismas unidades que los datos. Facilita interpretar cuánto suelen alejarse los valores de la media.

Coeficiente de variación

\[ \text{CV} = \frac{s}{\bar{x}} \]

Es una medida relativa: compara la desviación estándar con la media. Sirve para contrastar variables de escalas distintas (notas vs milisegundos), con precaución si la media está cerca de cero. Solo tiene sentido en variables con cero absoluto (escala de razón, Sesión 1): no se calcula sobre °C ni sobre datos estandarizados.

Pregunta Medida preferible
¿Cuál es la amplitud total? Rango
¿Cuánto se alejan, en promedio, de la media? Desviación estándar
¿Qué tan inestable es una variable respecto a su magnitud? Coeficiente de variación
¿Hay que comparar dos escalas distintas? Coeficiente de variación

2. Por qué importa en IA y Machine Learning

Los algoritmos aprenden patrones a partir de datos. Si los datos cambian mucho de un caso a otro, el patrón es más difícil de capturar; si son más estables, suele ser más fácil generalizar (con las validaciones correspondientes).

  • Más estables: los valores tienden a agruparse; hay menos sorpresas extremas.
  • Más variables: hay más diferencia entre casos; aparecen más oscilaciones, ruido o subgrupos.

Medir dispersión ayuda a explorar los datos, a preprocesarlos (por ejemplo, escalar variables) y a interpretar qué tan ruidoso es un fenómeno antes de entrenar un modelo.

Idea central: no existe una medida universalmente mejor. El rango avisa extremos; la desviación estándar describe el alejamiento típico; el CV permite comparar escalas distintas.

3. Flujo recomendado de trabajo

  1. Observar el centro y el ancho

Calcular la media no basta: hay que preguntar cuánto se mueven los datos alrededor de ese valor.

  1. Calcular las medidas de dispersión

Rango, varianza, desviación estándar y, cuando las escalas difieran, coeficiente de variación.

  1. Comparar conjuntos con media parecida

Si dos grupos tienen un centro similar y anchos distintos, la diferencia relevante está en la variabilidad.

  1. Interpretar en contexto

Indicar la unidad, si la medida es absoluta o relativa, y si un extremo está inflando el rango.

  1. Decidir implicaciones para el modelado
  • Rango o desviación alta: revisar extremos y, en algoritmos por distancia, escalar.
  • CV alto: la variable es inestable respecto a su magnitud.
  • Misma media, distinta dispersión: el modelo puede aprender bien en un caso y mal en el otro.

Criterio general: comprender qué información usa cada medida permite justificar cuál reportar, sin una regla automática.

4. Preparar el entorno

%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
print("pandas:", pd.__version__, "| numpy:", np.__version__)

# Para reproducibilidad de números aleatorios en este notebook
np.random.seed(42)
Python: 3.13.9
pandas: 2.3.3 | numpy: 2.3.5

Funciones de visualización (definidas una sola vez)

Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, todas las funciones de graficación se definen aquí, una sola vez. Más adelante, cada etapa solo llama a la función correspondiente en una línea — el foco queda en el concepto, no en el código del gráfico. Si quieres ver el detalle de cómo se construye cada figura, está todo en esta celda.

def histograma_doble_notas(ax, a, b, etiqueta_a, etiqueta_b, titulo):
    """Histograma superpuesto de dos grupos, con líneas verticales en cada media."""
    bins = np.linspace(0, 100, 21)  # intervalos de 5 puntos
    ax.hist(a, bins=bins, alpha=0.65, color="C0", label=etiqueta_a)
    ax.hist(b, bins=bins, alpha=0.65, color="C1", label=etiqueta_b)
    ax.axvline(np.mean(a), color="C0", linestyle="--", linewidth=1.5)
    ax.axvline(np.mean(b), color="C1", linestyle=":", linewidth=1.5)
    ax.set_xlim(30, 100)
    ax.set_xlabel("Nota (0–100)")
    ax.set_ylabel("Frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=9)


def graficar_panorama_inicial(notas_baja_hist, notas_alta_hist, media_baja_hist, media_alta_hist,
                                tiempos_ms):
    """Panorama de Etapa 1: histogramas de notas (misma media, distinta dispersión;
    medias similares, formas distintas) y de tiempos de respuesta."""
    fig, axes = plt.subplots(3, 1, figsize=(9, 8), constrained_layout=True)

    histograma_doble_notas(
        axes[0], notas_baja_hist, notas_alta_hist,
        "Baja dispersión (muestra amplia)", "Alta dispersión (muestra amplia)",
        "Histogramas: misma media aproximada, distinta dispersión",
    )
    histograma_doble_notas(
        axes[1], media_baja_hist, media_alta_hist,
        "Media similar · baja var.", "Media similar · alta var.",
        "Histogramas: medias cercanas (rayas), formas distintas",
    )

    axes[2].hist(tiempos_ms, bins=8, alpha=0.75, edgecolor="black")
    media_t = float(np.mean(tiempos_ms))
    axes[2].axvline(media_t, linestyle="--", linewidth=1.5, label=f"Media = {media_t:.1f} ms")
    axes[2].set_xlabel("Tiempo (ms)")
    axes[2].set_ylabel("Frecuencia")
    axes[2].set_title("Tiempos de respuesta: histograma y valor extremo")
    axes[2].legend(fontsize=9)

    plt.show()


def graficar_rango(a, b, etiqueta_a="Baja dispersión", etiqueta_b="Alta dispersión"):
    """Segmentos horizontales entre mínimo y máximo de dos grupos (Etapa 2: Rango)."""
    fig, ax = plt.subplots(figsize=(9, 3.5))
    min_a, max_a = np.min(a), np.max(a)
    min_b, max_b = np.min(b), np.max(b)

    ax.hlines(y=1, xmin=min_a, xmax=max_a, linewidth=6, color="C0", label=etiqueta_a)
    ax.hlines(y=2, xmin=min_b, xmax=max_b, linewidth=6, color="C1", label=etiqueta_b)
    ax.scatter([min_a, max_a], [1, 1], s=80, color="C0")
    ax.scatter([min_b, max_b], [2, 2], s=80, color="C1")
    ax.set_ylim(0.5, 2.5)

    ax.set_yticks([1, 2])
    ax.set_yticklabels([etiqueta_a, etiqueta_b])
    ax.set_xlabel('Nota')
    ax.set_title('Rango: longitud entre mínimo y máximo')
    ax.grid(axis='x', alpha=0.3)
    ax.legend(fontsize=9)
    plt.show()

    print(f"Rango {etiqueta_a.lower()}: {max_a - min_a}")
    print(f"Rango {etiqueta_b.lower()}: {max_b - min_b}")


def graficar_desviaciones(x, titulo, ax=None):
    """Distancia de cada punto a la media (base visual de la varianza, Etapa 3)."""
    standalone = ax is None
    if standalone:
        fig, ax = plt.subplots(figsize=(6, 4))
    m = np.mean(x)
    idx = np.arange(1, len(x) + 1)
    ax.scatter(idx, x, s=55, label='Datos')
    ax.hlines(m, 0.5, len(x) + 0.5, linestyle='--', linewidth=1.5, label=f'Media = {m:.2f}')
    for i, xi in zip(idx, x):
        ax.plot([i, i], [m, xi], color="C3", linewidth=2, alpha=0.8)
    ax.set_xticks(idx)
    ax.set_xlabel('Observación')
    ax.set_ylabel('Valor')
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    if standalone:
        plt.show()


def graficar_desviaciones_comparadas(a, b, titulo_a, titulo_b):
    # sharey=True: misma escala vertical; si no, las distancias chicas se verían tan largas como las grandes
    fig, axes = plt.subplots(1, 2, figsize=(11, 4), sharey=True, constrained_layout=True)
    graficar_desviaciones(a, titulo_a, ax=axes[0])
    graficar_desviaciones(b, titulo_b, ax=axes[1])
    plt.show()


def graficar_bandas_std(a, b, titulo_a="Baja desviación estándar", titulo_b="Alta desviación estándar"):
    """Bandas ±1σ alrededor de la media, comparando dos grupos (Etapa 4)."""
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True, constrained_layout=True)

    for ax, x, titulo in [(axes[0], a, titulo_a), (axes[1], b, titulo_b)]:
        idx = np.arange(1, len(x) + 1)
        m, s = np.mean(x), np.std(x, ddof=1)
        ax.plot(idx, x, marker='o', linewidth=2, label='Datos')
        ax.axhline(m, linestyle='--', linewidth=1.5, label=f'Media = {m:.2f}')
        ax.axhline(m + s, linestyle=':', linewidth=1.5, label=f'+1σ = {m+s:.2f}')
        ax.axhline(m - s, linestyle=':', linewidth=1.5, label=f'-1σ = {m-s:.2f}')
        ax.set_title(titulo)
        ax.set_xlabel('Observación')
        ax.set_ylabel('Valor')
        ax.set_xticks(idx)
        ax.grid(alpha=0.25)
        ax.legend(fontsize=8)

    plt.show()


def graficar_comparacion_distribuciones(dist_a, dist_b, titulo, etiqueta_a, etiqueta_b,
                                          bins_orig=None):
    """Histograma comparativo de dos distribuciones simuladas, con lectura de medias
    y desviaciones estándar impresas debajo. Se reutiliza tanto para 'misma media,
    distinta varianza' como para 'misma varianza, distinta media'."""
    if bins_orig is None:
        lo = min(dist_a.min(), dist_b.min())
        hi = max(dist_a.max(), dist_b.max())
        bins_orig = np.linspace(lo, hi, 26)

    fig, ax = plt.subplots(figsize=(8, 4))
    ax.hist(dist_a, bins=bins_orig, alpha=0.6, color='C0', label=etiqueta_a)
    ax.hist(dist_b, bins=bins_orig, alpha=0.6, color='C1', label=etiqueta_b)
    ax.axvline(np.mean(dist_a), color='C0', linestyle='--', linewidth=1.5)
    ax.axvline(np.mean(dist_b), color='C1', linestyle=':', linewidth=1.5)
    ax.set_title(titulo)
    ax.set_xlabel('Valor')
    ax.set_ylabel('Frecuencia')
    ax.legend(fontsize=9)
    plt.show()

    print(f"Media {etiqueta_a}: {np.mean(dist_a):.2f} | Desv. estándar: {np.std(dist_a, ddof=1):.2f}")
    print(f"Media {etiqueta_b}: {np.mean(dist_b):.2f} | Desv. estándar: {np.std(dist_b, ddof=1):.2f}")


def graficar_cv_barras(labels, valores):
    """Barras de coeficiente de variación (%) para varios conjuntos (Etapa 5)."""
    fig, ax = plt.subplots(figsize=(10, 4))
    ax.bar(labels, valores)
    ax.set_ylabel('CV (%)')
    ax.set_title('Coeficiente de variación: dispersión relativa')
    ax.tick_params(axis='x', rotation=20)
    ax.grid(axis='y', alpha=0.25)
    plt.tight_layout()
    plt.show()


def graficar_hist_boxplot(a, b, etiqueta_a, etiqueta_b, bins_a=None, bins_b=None):
    """Histograma + boxplot lado a lado para comparar dos grupos con media similar
    y dispersión distinta (Etapa 6)."""
    fig, axes = plt.subplots(1, 2, figsize=(10, 4))
    media_a, media_b = np.mean(a), np.mean(b)

    # Con 6 datos por grupo se dibuja cada nota (un histograma de 6 valores dice poco)
    for y, x, color, media in [(1, a, "C0", media_a), (2, b, "C1", media_b)]:
        axes[0].scatter(x, np.full(len(x), y), s=70, color=color, alpha=0.8)
        axes[0].vlines(media, y - 0.3, y + 0.3, color=color, linestyle="--", label=f"Media = {media:.2f}")
    axes[0].set_yticks([1, 2])
    axes[0].set_yticklabels([etiqueta_a, etiqueta_b])
    axes[0].set_ylim(0.4, 2.6)
    axes[0].set_xlabel("Nota")
    axes[0].set_title("Cada punto es una nota (rayas: medias)")
    axes[0].legend(fontsize=8)

    axes[1].boxplot([a, b], positions=[1, 2], orientation="horizontal")
    axes[1].set_yticks([1, 2])
    axes[1].set_yticklabels([etiqueta_a, etiqueta_b])
    axes[1].set_xlabel("Nota")
    axes[1].set_title("Boxplot: la caja contiene el 50% central")
    axes[1].set_xlim(axes[0].get_xlim())

    plt.tight_layout()
    plt.show()


def graficar_comparacion_modelos(x_test, y_test_dict, y_pred_dict):
    """Dispersión + línea de predicción para dos escenarios de ruido (Etapa 8)."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4.5), sharey=True, constrained_layout=True)
    orden = np.argsort(x_test)
    for ax, (nombre, y_test) in zip(axes, y_test_dict.items()):
        ax.scatter(x_test, y_test, alpha=0.6, label='Datos test')
        ax.plot(x_test[orden], y_pred_dict[nombre][orden], color='C3', linewidth=2, label='Predicción modelo')
        ax.set_title(f'ML con {nombre.lower()}')
        ax.set_xlabel('x')
        ax.set_ylabel('y')
        ax.legend(fontsize=8)
    plt.show()


def graficar_caso_real_validacion(tiempos_crudo, tiempos_validado, etiqueta_proveedor):
    """Boxplot comparando la métrica de dispersión antes/después de validar los datos
    (Caso real de cierre)."""
    fig, ax = plt.subplots(figsize=(7, 4))
    ax.boxplot([tiempos_crudo, tiempos_validado], positions=[1, 2])
    ax.set_xticks([1, 2])
    ax.set_xticklabels(["Sin validar", "Validado"])
    ax.set_ylabel("Tiempo de respuesta (ms)")
    ax.set_title(f"{etiqueta_proveedor}: efecto de validar los datos sobre la dispersión")
    plt.tight_layout()
    plt.show()

5. Desarrollo por etapas

El análisis se divide en etapas: construir los datos, calcular cada medida de dispersión, comparar visualmente los conjuntos y observar el efecto del ruido sobre un modelo simple. Cada etapa de código incluye una interpretación de los resultados.

Etapa 1: Dataset sintético de notas y tiempos

Se trabaja con datos sintéticos pero realistas: notas de un examen (escala 0–100) y tiempos de respuesta en milisegundos. Así se observa baja vs alta dispersión y también dos grupos con media parecida pero variabilidad distinta.

Interpretación breve: los conjuntos están diseñados para comparar medidas en la misma escala (notas) y entre escalas distintas (ms vs notas) usando el coeficiente de variación.

# Notas de examen: grupo A (poca dispersión) y grupo B (mucha dispersión)
notas_baja_dispersion = np.array([74, 76, 75, 73, 77, 75])
notas_alta_dispersion = np.array([40, 95, 60, 88, 52, 90])

# Dos grupos con media similar pero variabilidad distinta (ambos en escala 0-100)
notas_media_similar_baja_var = np.array([70, 72, 71, 73, 70, 74])
notas_media_similar_alta_var = np.array([55, 85, 60, 90, 65, 80])

# Tiempos de respuesta (ms) — otra escala, para comparar con CV
tiempos_ms = np.array([120, 135, 128, 400, 142, 130])

df = pd.DataFrame({
    "notas_baja_disp": notas_baja_dispersion,
    "notas_alta_disp": notas_alta_dispersion,
    "sim_media_baja_var": notas_media_similar_baja_var,
    "sim_media_alta_var": notas_media_similar_alta_var,
    "tiempo_ms": tiempos_ms,
})
print(df)
print("\nMedias (columnas):")
print(df.mean())
   notas_baja_disp  notas_alta_disp  sim_media_baja_var  sim_media_alta_var  \
0               74               40                  70                  55   
1               76               95                  72                  85   
2               75               60                  71                  60   
3               73               88                  73                  90   
4               77               52                  70                  65   
5               75               90                  74                  80   

   tiempo_ms  
0        120  
1        135  
2        128  
3        400  
4        142  
5        130  

Medias (columnas):
notas_baja_disp        75.000000
notas_alta_disp        70.833333
sim_media_baja_var     71.666667
sim_media_alta_var     72.500000
tiempo_ms             175.833333
dtype: float64

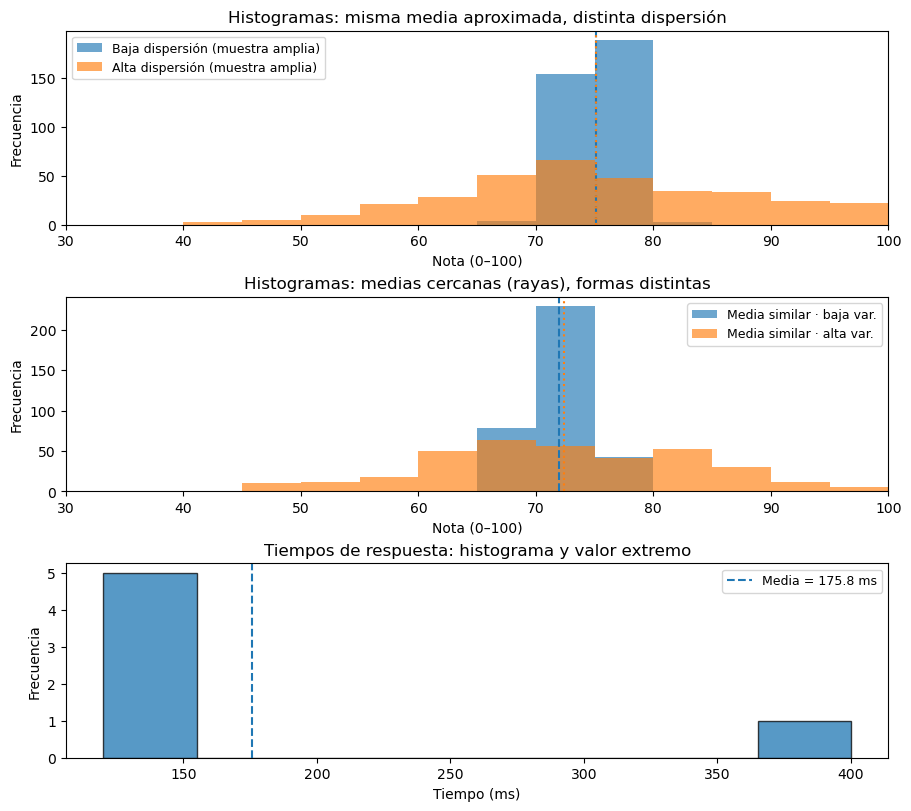
Figura siguiente: para que la forma se vea, las notas se simulan con una muestra más amplia (350 por grupo) con los mismos centros y anchos que la tabla anterior; los tiempos son los 6 valores de la tabla. Se dibujan como histogramas: la altura de cada barra indica cuántas observaciones caen en un intervalo de notas o de tiempos; dos histogramas superpuestos permiten comparar forma y anchura. Las líneas verticales marcan la media de cada grupo. En tiempos (ms), el histograma muestra dónde se concentran los valores y si hay colas o valores alejados.

# Muestra más amplia (solo para que el histograma tenga forma más clara)
np.random.seed(101)
notas_baja_dispersion_hist = np.clip(np.random.normal(loc=75, scale=2.0, size=350), 0, 100)
notas_alta_dispersion_hist = np.clip(np.random.normal(loc=75, scale=12.0, size=350), 0, 100)
notas_media_similar_baja_var_hist = np.clip(np.random.normal(loc=72, scale=2.5, size=350), 0, 100)
notas_media_similar_alta_var_hist = np.clip(np.random.normal(loc=72, scale=11.0, size=350), 0, 100)

graficar_panorama_inicial(
    notas_baja_dispersion_hist, notas_alta_dispersion_hist,
    notas_media_similar_baja_var_hist, notas_media_similar_alta_var_hist,
    tiempos_ms,
)
print(
    "\nLectura rápida: histograma más ancho => más dispersión; rayas verticales = medias; "
    "en tiempos, una cola o barra alejada sugiere valores atípicos."
)


Lectura rápida: histograma más ancho => más dispersión; rayas verticales = medias; en tiempos, una cola o barra alejada sugiere valores atípicos.

Lectura de la Etapa 1: importancia de la variabilidad en IA

¿Qué significa que los datos sean “estables” o “variables”?

  • Más estables: los valores tienden a agruparse cerca unos de otros; hay menos sorpresas extremas (aunque eso no garantiza que el fenómeno sea “fácil” en todos los sentidos).
  • Más variables: hay más diferencia entre casos; aparecen más oscilaciones y a veces más ruido o más factores que explicar.

¿Por qué la media sola no describe todo?

Dos conjuntos pueden tener la misma media y comportarse muy distinto: uno puede ser casi uniforme y otro con valores muy separados. La media resume el “centro”, pero no el ancho de la nube de datos.

Conexión con ML

  • Ruido e incertidumbre: alta variabilidad puede reflejar medición imperfecta, procesos complejos o mezcla de subgrupos.
  • Estabilidad de patrones: modelos buscan regularidades; si todo varía mucho, la señal útil puede quedar diluida.
  • Dificultad de aprendizaje: sin explorar dispersión, es fácil subestimar problemas de escala, outliers o heterogeneidad —temas que se abordarán más adelante en el curso.

Interpretación breve: antes de entrenar, conviene preguntarse no solo “¿cuál es el valor típico?” sino “¿cuánto se mueve la variable alrededor de ese valor?”.

Etapa 2: Rango

Idea: la dispersión más simple es la diferencia entre el máximo y el mínimo.

Fórmula (población o muestra, mismo cálculo en la práctica con datos observados):

\[\text{Rango} = \max(x_i) - \min(x_i)\]

Limitación: un solo valor extremo (outlier) puede inflar el rango; por eso no siempre refleja lo “típico”.

Importante: el rango no representa la dispersión típica del conjunto, porque solo depende de dos valores (mínimo y máximo). No incorpora cómo se distribuyen el resto de los datos entre esos extremos.

¿Por qué esto importa en Machine Learning?

  • El rango permite detectar rápidamente si una variable tiene una escala muy distinta a otra.
  • En algoritmos basados en distancia (como KNN o varios métodos de clustering), variables con rangos grandes pueden dominar el cálculo si no hay escalamiento.
  • Un rango muy amplio también puede sugerir presencia de extremos que afecten la estabilidad del modelo.

Cálculo manual simple (notas_baja_disp): máximo 77, mínimo 73 → rango = 77 − 73 = 4.

def rango_datos(x):
    return np.max(x) - np.min(x)

r_baja = rango_datos(notas_baja_dispersion)
r_alta = rango_datos(notas_alta_dispersion)
print(f"Rango notas baja dispersión: {r_baja}")
print(f"Rango notas alta dispersión: {r_alta}")
# Interpretación: el segundo grupo se extiende mucho más en la escala 0-100.


if r_alta > r_baja:
    print("Interpretación: un rango más alto indica menor estabilidad y mayor amplitud de valores.")
    print("Implicación ML: puede requerirse escalamiento y revisión de valores extremos.")
Rango notas baja dispersión: 4
Rango notas alta dispersión: 55
Interpretación: un rango más alto indica menor estabilidad y mayor amplitud de valores.
Implicación ML: puede requerirse escalamiento y revisión de valores extremos.

Visualización didáctica del rango: comparación de dos conjuntos con rangos diferentes (mínimo, máximo y amplitud total).

graficar_rango(notas_baja_dispersion, notas_alta_dispersion)
print('Interpretación: un segmento más largo indica mayor amplitud total de valores.')

Rango baja dispersión: 4
Rango alta dispersión: 55
Interpretación: un segmento más largo indica mayor amplitud total de valores.

Interpretación breve: el grupo con alta dispersión tiene un rango mucho mayor: las notas van de valores bajos a muy altos. El rango es sensible a un solo examen muy malo o muy bueno.

Pregunta de reflexión corta: el rango de notas_alta_dispersion es mucho mayor que el de notas_baja_dispersion, pero el rango solo usa dos valores (mínimo y máximo). ¿Qué pasaría con el rango si, en el grupo de alta dispersión, cambiaras un único dato (por ejemplo el 95) por un valor aún más extremo, sin tocar el resto? ¿Ese cambio diría algo sobre cómo se comporta la mayoría de los datos?

Etapa 3: Varianza

La varianza se entiende mejor en pasos cortos y ordenados.

Paso 1: ¿por qué no basta sumar desviaciones respecto a la media?

Si se calcula $ (x_i - {x}) $, aparecen valores positivos y negativos. Al sumarlos, tienden a cancelarse y el resultado puede ser cercano a 0, incluso cuando hay dispersión real.

Paso 2: ¿por qué se elevan al cuadrado?

Al elevar cada desviación al cuadrado:

  • todos los términos quedan positivos,
  • las desviaciones grandes pesan más,
  • se obtiene una medida sensible a la variabilidad total.

Paso 3: fórmula

Fórmula muestral (la más usada en práctica con datos observados):

\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]

Fórmula poblacional (cuando se tiene toda la población):

\[ \sigma^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \mu)^2 \]

¿Por qué dividir entre \(n-1\) y no entre \(n\)? Cuando se calcula la media muestral \(\bar{x}\) a partir de los mismos datos, esa media queda “ajustada” a la muestra — los datos, en promedio, terminan un poco más cerca de \(\bar{x}\) de lo que estarían de la verdadera media poblacional \(\mu\) (que no conocemos). Dividir entre \(n\) subestimaría sistemáticamente la varianza real. Dividir entre \(n-1\) corrige ese sesgo (se conoce como corrección de Bessel) y hace que \(s^2\) sea, en promedio, una estimación correcta de \(\sigma^2\). Por eso numpy usa ddof=1 para varianza muestral y ddof=0 (el valor por defecto) para varianza poblacional.

Paso 4: cálculo manual breve

Datos \(70, 80, 90\). Media \(\bar{x} = 80\).

Desviaciones: \(-10, 0, 10\). Cuadrados: \(100, 0, 100\). Suma: \(200\).

Con \(n = 3\), la varianza muestral queda:

\[ s^2 = \frac{200}{3-1} = 100 \]

Paso 5: cálculo en Python

Se calcula con numpy usando np.var(x, ddof=1) para varianza muestral.

Cuidado con el valor por defecto: np.var y np.std usan ddof=0 (poblacional), mientras que df.var() y df.std() de pandas usan ddof=1 (muestral). La misma columna da dos números distintos si no se indica ddof. En este notebook siempre se escribe explícito.

Paso 6: interpretación (en los datos)

  • Una varianza alta indica datos más dispersos y menor estabilidad alrededor de la media.
  • Una varianza baja indica valores más concentrados cerca de la media.

Relación con Machine Learning

Muchos modelos de regresión y varias redes neuronales se entrenan minimizando el error cuadrático medio (MSE): se promedian los cuadrados de los errores entre predicción y valor real. Esa lógica es la misma familia de ideas que subyace a la varianza: penalizar con más fuerza los desvíos grandes.

En la práctica, una alta varianza en los datos suele ir asociada a más ruido o a un fenómeno más heterogéneo, lo que puede hacer el aprendizaje más difícil o las predicciones más sensibles a pequeños cambios en los datos de entrenamiento. Un modelo muy flexible puede ajustarse demasiado a ese ruido: esta es la intuición del sobreajuste (alto ajuste en entrenamiento, peor generalización), que se relaciona con el equilibrio sesgo-varianza del modelo (tema que se profundizará más adelante).

# Varianza muestral (ddof=1) y poblacional (ddof=0)
v_baja = np.var(notas_baja_dispersion, ddof=1)
v_alta = np.var(notas_alta_dispersion, ddof=1)

print(f"Varianza muestral notas baja dispersión: {v_baja:.4f}")
print(f"Varianza muestral notas alta dispersión: {v_alta:.4f}")

# Misma media aproximada, distinta varianza
m1 = notas_media_similar_baja_var
m2 = notas_media_similar_alta_var
print(f"Medias: {m1.mean():.2f} vs {m2.mean():.2f}")
print(f"Varianzas: {np.var(m1, ddof=1):.4f} vs {np.var(m2, ddof=1):.4f}")


if v_alta > v_baja:
    print("Interpretación: la varianza alta sugiere mayor dispersión y posible mayor incertidumbre.")
    print("Implicación ML: podría aumentar sensibilidad del modelo al ruido y a errores grandes.")
Varianza muestral notas baja dispersión: 2.0000
Varianza muestral notas alta dispersión: 533.7667
Medias: 71.67 vs 72.50
Varianzas: 2.6667 vs 207.5000
Interpretación: la varianza alta sugiere mayor dispersión y posible mayor incertidumbre.
Implicación ML: podría aumentar sensibilidad del modelo al ruido y a errores grandes.

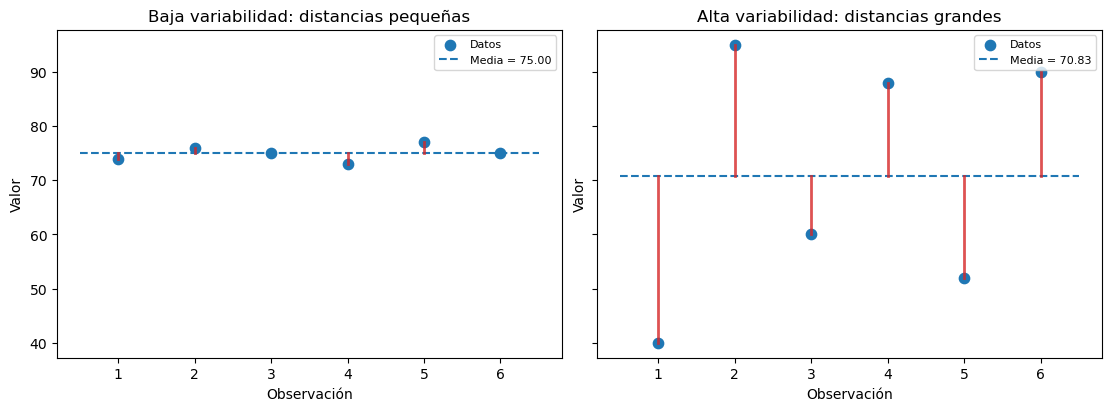
Visualización didáctica de varianza: distancia de cada dato a su media (desviación) y cómo cambia entre baja y alta variabilidad.

graficar_desviaciones_comparadas(
    notas_baja_dispersion, notas_alta_dispersion,
    'Baja variabilidad: distancias pequeñas', 'Alta variabilidad: distancias grandes',
)
print('Interpretación: cuando las distancias a la media son mayores, la varianza aumenta.')

Interpretación: cuando las distancias a la media son mayores, la varianza aumenta.

Interpretación breve: la varianza cuantifica cuán “ancha” es la nube de datos en unidades al cuadrado (para notas, serían “puntos al cuadrado”, poco intuitivo de leer sola). Por eso en la siguiente sección se usa la desviación estándar.

Etapa 4: Desviación estándar

Relación con la varianza: es la raíz cuadrada de la varianza (muestral o poblacional, según se use).

\[s = \sqrt{s^2}\]

¿Por qué se interpreta mejor? vuelve a las mismas unidades que los datos (por ejemplo, “puntos de examen” o “milisegundos”). Es un “alejamiento típico” respecto a la media.

¿Por qué esto importa en Machine Learning y Deep Learning?

  • Preprocesamiento: la desviación estándar se usa para estandarizar variables.
  • Z-score: \(z_i = \frac{x_i - \bar{x}}{s}\) permite medir cuán atípico es un valor.
  • Estabilidad del entrenamiento: en redes neuronales, entradas en escalas comparables suelen facilitar una optimización más estable.
  • Sensibilidad a extremos: una desviación estándar alta puede reflejar datos heterogéneos o con ruido.
s_baja = np.std(notas_baja_dispersion, ddof=1)
s_alta = np.std(notas_alta_dispersion, ddof=1)

print(f"Desviación estándar (notas baja dispersión): {s_baja:.4f} puntos")
print(f"Desviación estándar (notas alta dispersión): {s_alta:.4f} puntos")

# Z-score del primer dato del grupo de alta dispersión
x0 = notas_alta_dispersion[0]
z0 = (x0 - notas_alta_dispersion.mean()) / s_alta
print(f"\nEjemplo z-score para nota {x0}: {z0:.3f}")


if s_alta > s_baja:
    print("Interpretación: el grupo de alta dispersión se aleja más de su media en unidades originales.")
    print("Implicación ML/DL: estandarizar entradas puede mejorar estabilidad del entrenamiento.")
Desviación estándar (notas baja dispersión): 1.4142 puntos
Desviación estándar (notas alta dispersión): 23.1034 puntos

Ejemplo z-score para nota 40: -1.335
Interpretación: el grupo de alta dispersión se aleja más de su media en unidades originales.
Implicación ML/DL: estandarizar entradas puede mejorar estabilidad del entrenamiento.

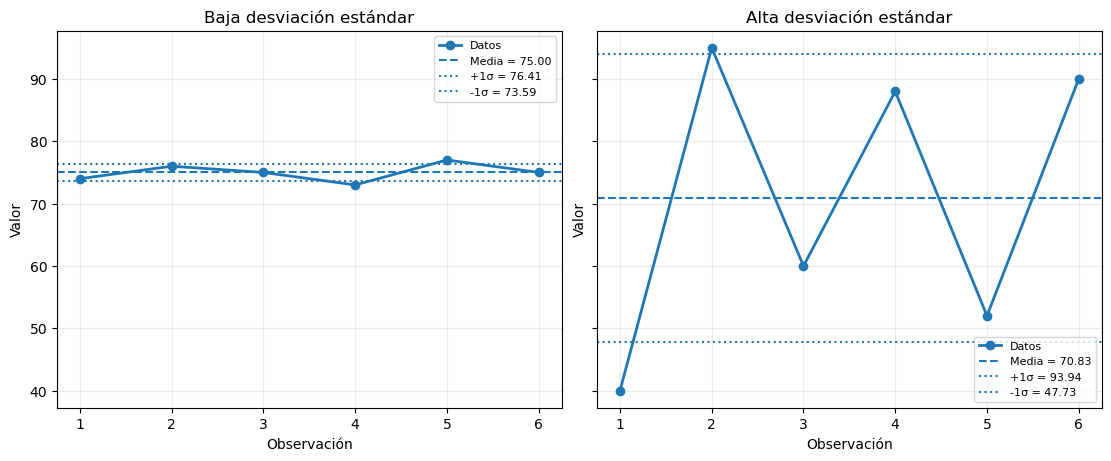
Visualización didáctica de desviación estándar: bandas alrededor de la media para comparar estabilidad en unidades originales.

graficar_bandas_std(notas_baja_dispersion, notas_alta_dispersion)
print('Interpretación: en baja desviación estándar, la línea de datos se mantiene cerca de la media.')
print('En alta desviación estándar, los puntos se alejan más de la media (bandas ±1σ más amplias).')

Interpretación: en baja desviación estándar, la línea de datos se mantiene cerca de la media.
En alta desviación estándar, los puntos se alejan más de la media (bandas ±1σ más amplias).

Interpretación breve: en el grupo heterogéneo, la desviación estándar es claramente mayor: las notas “típicamente” se alejan más de la media. El z-score indica cuán extremo es un valor en unidades de dispersión.

Conexión con la Sesión 2: imputar con la media reduce la dispersión. En la sesión anterior se vio que rellenar faltantes con la media crea un pico artificial. Ahora hay una herramienta para medir su efecto: la desviación estándar.

rng_imp = np.random.default_rng(3)
notas_completas = rng_imp.normal(70, 10, size=60).round(1)
faltan = rng_imp.choice(60, size=15, replace=False)
notas_imputadas = notas_completas.copy()
notas_imputadas[faltan] = np.nan
notas_imputadas[faltan] = np.nanmean(notas_imputadas)

print(f"Desv. estándar con los 60 datos reales:       {np.std(notas_completas, ddof=1):.2f}")
print(f"Desv. estándar tras imputar 15 con la media:  {np.std(notas_imputadas, ddof=1):.2f}")
Desv. estándar con los 60 datos reales:       10.81
Desv. estándar tras imputar 15 con la media:  8.81

Interpretación breve: la desviación estándar baja de 10.81 a 8.81 (casi un 20% menos), aunque los 45 valores observados no cambiaron. Los 15 valores imputados están exactamente en la media, a distancia cero de ella: no aportan nada a la suma de cuadrados y la desviación estándar baja. Un modelo entrenado con esos datos “cree” que la variable es más estable de lo que es.

Pregunta de reflexión corta: una nota de 40 parece muy baja, pero su z-score en el grupo de alta dispersión es solo −1.34: está a poco más de una desviación estándar de su media. En el grupo de baja dispersión (media 75, \(s \approx 1.41\)), ese mismo 40 tendría un z-score cercano a −25. ¿Por qué el mismo valor es “normal” en un grupo y absurdo en el otro? ¿Qué dice esto sobre juzgar valores atípicos solo por su magnitud?

Dos combinaciones que conviene distinguir: media y varianza son independientes

Media y varianza describen cosas distintas del mismo conjunto de datos, y pueden variar por separado. Vale la pena verificar las dos combinaciones posibles:

  1. Misma media, distinta varianza — el centro es igual, pero un grupo está mucho más disperso que el otro.
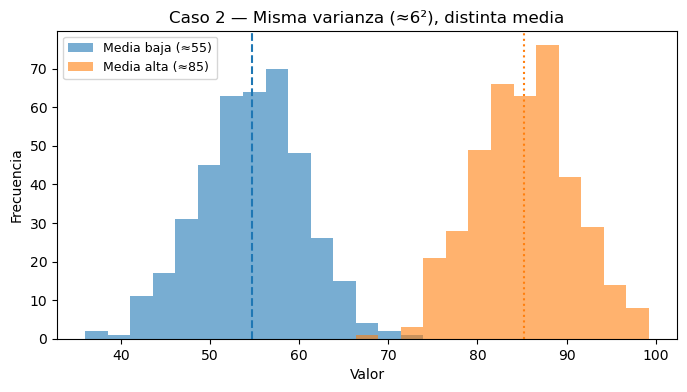
  2. Misma varianza, distinta media — el “ancho” de la nube de datos es igual, pero está centrada en lugares distintos.

Ambas se estandarizan con z-score para verlas en una escala común (media 0, desviación 1).

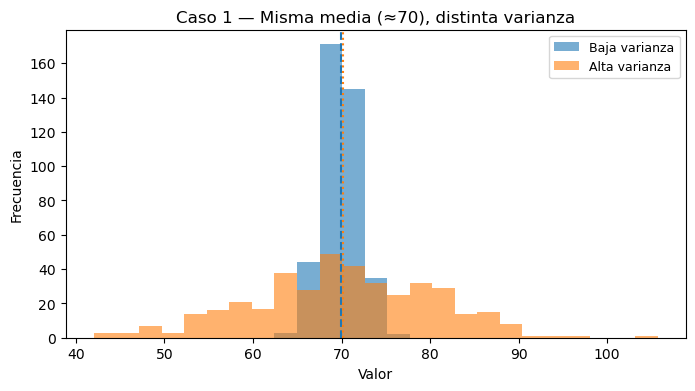
np.random.seed(123)

# Caso 1: misma media, distinta varianza
dist_misma_media_var_baja = np.random.normal(loc=70, scale=2.0, size=400)
dist_misma_media_var_alta = np.random.normal(loc=70, scale=10.0, size=400)

graficar_comparacion_distribuciones(
    dist_misma_media_var_baja, dist_misma_media_var_alta,
    "Caso 1 — Misma media (≈70), distinta varianza",
    "Baja varianza", "Alta varianza",
)

Media Baja varianza: 69.89 | Desv. estándar: 1.99
Media Alta varianza: 70.13 | Desv. estándar: 10.26
# Caso 2: misma varianza, distinta media
dist_media_baja = np.random.normal(loc=55, scale=6.0, size=400)
dist_media_alta = np.random.normal(loc=85, scale=6.0, size=400)

graficar_comparacion_distribuciones(
    dist_media_baja, dist_media_alta,
    "Caso 2 — Misma varianza (≈6²), distinta media",
    "Media baja (≈55)", "Media alta (≈85)",
)

print(
    "\nInterpretación conjunta: en el Caso 1, los histogramas se superponen en el centro pero uno es mucho "
    "más ancho. En el Caso 2, tienen el mismo ancho pero están desplazados. Un modelo que "
    "solo mire la media (Caso 1) o solo mire la dispersión (Caso 2) puede pasar por alto la mitad de la "
    "historia — por eso ambas medidas se reportan juntas, nunca una sin la otra."
)

# Z-score de ambos casos para verlos en escala común
z1a = (dist_misma_media_var_baja - dist_misma_media_var_baja.mean()) / dist_misma_media_var_baja.std(ddof=1)
z1b = (dist_misma_media_var_alta - dist_misma_media_var_alta.mean()) / dist_misma_media_var_alta.std(ddof=1)
z2a = (dist_media_baja - dist_media_baja.mean()) / dist_media_baja.std(ddof=1)
z2b = (dist_media_alta - dist_media_alta.mean()) / dist_media_alta.std(ddof=1)

print(f"\nCaso 1 tras z-score — medias: {z1a.mean():.3f}, {z1b.mean():.3f} | desv. est.: {z1a.std(ddof=1):.3f}, {z1b.std(ddof=1):.3f}")
print(f"Caso 2 tras z-score — medias: {z2a.mean():.3f}, {z2b.mean():.3f} | desv. est.: {z2a.std(ddof=1):.3f}, {z2b.std(ddof=1):.3f}")
print("Con z-score, las cuatro distribuciones terminan centradas en 0 con desviación 1 — el estandarizado")
print("borra tanto la diferencia de centro como la de escala original, dejando solo la forma relativa.")

Media Media baja (≈55): 54.71 | Desv. estándar: 5.82
Media Media alta (≈85): 85.28 | Desv. estándar: 5.44

Interpretación conjunta: en el Caso 1, los histogramas se superponen en el centro pero uno es mucho más ancho. En el Caso 2, tienen el mismo ancho pero están desplazados. Un modelo que solo mire la media (Caso 1) o solo mire la dispersión (Caso 2) puede pasar por alto la mitad de la historia — por eso ambas medidas se reportan juntas, nunca una sin la otra.

Caso 1 tras z-score — medias: 0.000, -0.000 | desv. est.: 1.000, 1.000
Caso 2 tras z-score — medias: 0.000, 0.000 | desv. est.: 1.000, 1.000
Con z-score, las cuatro distribuciones terminan centradas en 0 con desviación 1 — el estandarizado
borra tanto la diferencia de centro como la de escala original, dejando solo la forma relativa.
# Ejemplo equivalente en pandas: creación de una variable estandarizada
df_estandar = pd.DataFrame({'puntaje': dist_misma_media_var_alta})
df_estandar['z_puntaje'] = (df_estandar['puntaje'] - df_estandar['puntaje'].mean()) / df_estandar['puntaje'].std(ddof=1)

print("Primeras filas (pandas):")
print(df_estandar.head())
print(f"Media de z_puntaje: {df_estandar['z_puntaje'].mean():.4f}")
print(f"Desv. estándar de z_puntaje: {df_estandar['z_puntaje'].std(ddof=1):.4f}")
Primeras filas (pandas):
     puntaje  z_puntaje
0  85.340903   1.482070
1  64.700859  -0.528851
2  65.090277  -0.490911
3  56.908347  -1.288061
4  69.913395  -0.021003
Media de z_puntaje: -0.0000
Desv. estándar de z_puntaje: 1.0000

Etapa 5: Coeficiente de variación (CV)

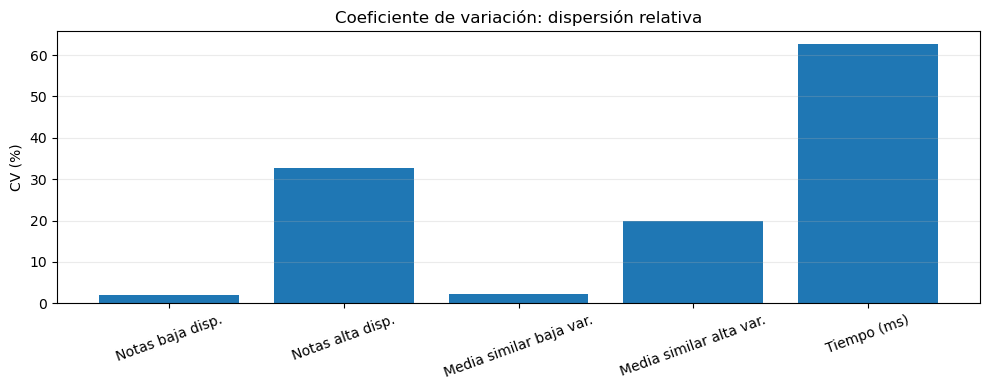
Definición: dispersión relativa respecto al tamaño típico de la variable. Se suele expresar en porcentaje.

\[\text{CV} = \frac{s}{\bar{x}} \quad (\text{si } \bar{x} \neq 0)\]

En porcentaje: multiplica por 100 el cociente \(s/\bar{x}\) (expresión habitual: CV en %).

Uso: comparar la “inestabilidad relativa” entre variables medidas en unidades distintas (notas vs milisegundos).

Requisito: la variable debe tener cero absoluto (escala de razón, Sesión 1) y media positiva. Con °C, con datos estandarizados (media 0) o con medias cercanas a cero, el CV no tiene interpretación.

Relación con Machine Learning

  • Ayuda a comparar qué variables son relativamente más inestables en el análisis exploratorio.
  • Puede orientar decisiones de selección de variables y preprocesamiento.
  • Un CV alto puede alertar sobre mayor variabilidad relativa, potencial ruido o menor estabilidad del patrón.
def coef_variacion(x, porcentaje=True):
    media = np.mean(x)
    s = np.std(x, ddof=1)
    if media == 0:
        return np.nan
    cv = s / media
    return 100 * cv if porcentaje else cv

cv_notas = coef_variacion(notas_baja_dispersion)
cv_tiempos = coef_variacion(tiempos_ms)

print(f"CV% notas (baja dispersión): {cv_notas:.2f}%")
print(f"CV% tiempos (ms): {cv_tiempos:.2f}%")
# Aunque la desviación en ms sea "grande" en valor absoluto, el CV compara con la media.


if cv_tiempos > cv_notas:
    print("Interpretación: el tiempo tiene variabilidad relativa mucho mayor que las notas.")
    print("Implicación ML: esta variable puede requerir más atención en preprocesamiento.")
CV% notas (baja dispersión): 1.89%
CV% tiempos (ms): 62.59%
Interpretación: el tiempo tiene variabilidad relativa mucho mayor que las notas.
Implicación ML: esta variable puede requerir más atención en preprocesamiento.

Visualización didáctica del coeficiente de variación (CV): comparación de variabilidad relativa en porcentaje.

cv_labels = ['Notas baja disp.', 'Notas alta disp.', 'Media similar baja var.', 'Media similar alta var.', 'Tiempo (ms)']
cv_vals = [
    coef_variacion(notas_baja_dispersion),
    coef_variacion(notas_alta_dispersion),
    coef_variacion(notas_media_similar_baja_var),
    coef_variacion(notas_media_similar_alta_var),
    coef_variacion(tiempos_ms),
]
graficar_cv_barras(cv_labels, cv_vals)
print('Interpretación: CV más alto => mayor variabilidad relativa respecto a la media.')

Interpretación: CV más alto => mayor variabilidad relativa respecto a la media.

Interpretación breve: el CV permite decir si la variabilidad es grande o chica en relación con la media. Así puedes comparar, con cautela, magnitudes en escalas diferentes.

Etapa 6: Comparación visual entre distribuciones

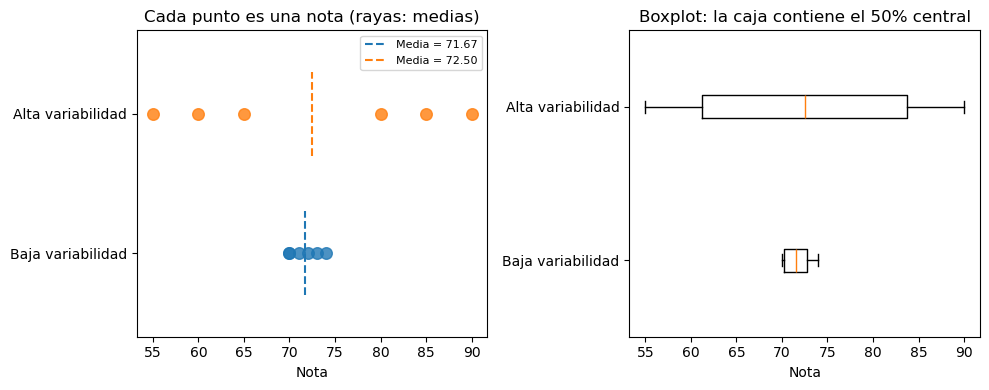
Pregunta guía (antes de ejecutar el gráfico): si dos grupos tienen medias parecidas, ¿cómo se distinguiría en un gráfico cuál es más estable y cuál más disperso? ¿Qué pista adicional aporta el boxplot sobre extremos y amplitud?

El boxplot resume una variable en cinco números: la línea central es la mediana, la caja contiene el 50% central de los datos y los bigotes llegan hasta los valores no atípicos. Sus cuartiles se estudian en la Sesión 4; aquí basta leer el ancho de la caja.

Antes de observar el gráfico: prestar atención a tres aspectos.

  1. Si las rayas de media quedan cercanas, pero los puntos ocupan anchos muy distintos.
  2. Si el boxplot muestra una caja más extendida y mayor separación entre valores.
  3. Si la desviación estándar reportada al final crece de forma clara en el grupo más disperso.

El objetivo es evidenciar que puede existir media similar con varianza y desviación estándar diferentes.

graficar_hist_boxplot(
    notas_media_similar_baja_var, notas_media_similar_alta_var,
    "Baja variabilidad", "Alta variabilidad",
    bins_a=np.arange(68, 76) - 0.5, bins_b=np.arange(50, 95, 5) - 2.5,
)

media_baja = notas_media_similar_baja_var.mean()
media_alta = notas_media_similar_alta_var.mean()
print(f"Medias: {media_baja:.2f} vs {media_alta:.2f}")
print(f"Desv. est.: {np.std(notas_media_similar_baja_var, ddof=1):.2f} vs {np.std(notas_media_similar_alta_var, ddof=1):.2f}")
print("Interpretación: medias cercanas no implican comportamiento similar.")
print("Implicación ML: la diferencia de dispersión cambia estabilidad y dificultad de modelado.")

Medias: 71.67 vs 72.50
Desv. est.: 1.63 vs 14.40
Interpretación: medias cercanas no implican comportamiento similar.
Implicación ML: la diferencia de dispersión cambia estabilidad y dificultad de modelado.

Interpretación visual: aunque las medias se parezcan, los puntos y el boxplot de alta variabilidad ocupan un tramo mucho más ancho de la misma escala; hay notas mucho más bajas y más altas. Eso implica menos estabilidad alrededor del centro —algo crucial si esos datos alimentan un modelo.

Tabla resumen comparativa

La siguiente tabla resume medidas de tendencia y dispersión para comparar estabilidad entre conjuntos.

def resumen_metricas(nombre, x):
    media = np.mean(x)
    rango = np.max(x) - np.min(x)
    varianza = np.var(x, ddof=1)
    desv = np.std(x, ddof=1)
    cv = (desv / media) * 100 if media != 0 else np.nan
    return {
        "conjunto": nombre,
        "media": media,
        "rango": rango,
        "varianza": varianza,
        "desviación_estándar": desv,
        "coef_variación_%": cv,
    }

resumen = pd.DataFrame([
    resumen_metricas("notas_baja_disp", notas_baja_dispersion),
    resumen_metricas("notas_alta_disp", notas_alta_dispersion),
    resumen_metricas("sim_media_baja_var", notas_media_similar_baja_var),
    resumen_metricas("sim_media_alta_var", notas_media_similar_alta_var),
]).set_index("conjunto")

print(resumen.round(3))
                     media  rango  varianza  desviación_estándar  \
conjunto                                                           
notas_baja_disp     75.000      4     2.000                1.414   
notas_alta_disp     70.833     55   533.767               23.103   
sim_media_baja_var  71.667      4     2.667                1.633   
sim_media_alta_var  72.500     35   207.500               14.405   

                    coef_variación_%  
conjunto                              
notas_baja_disp                1.886  
notas_alta_disp               32.617  
sim_media_baja_var             2.279  
sim_media_alta_var            19.869  

¿Cómo leer estas medidas?

  • Media: valor “de equilibrio”; dos conjuntos pueden tener medias parecidas y aun así ser muy distintos en dispersión.
  • Rango: amplitud entre el mínimo y el máximo; útil como aviso rápido de escala y extremos, pero no resume la dispersión típica de la mayoría de los datos.
  • Varianza: dispersión promedio en unidades al cuadrado; valores más altos indican más separación respecto a la media. Es menos intuitiva al leerla sola por las unidades.
  • Desviación estándar: misma información que la varianza, en unidades originales; facilita interpretar “cuánto suelen alejarse” los valores de la media.
  • Coeficiente de variación (CV %): dispersión relativa respecto a la media; sirve para comparar estabilidad entre variables de escalas distintas (con precaución si la media es muy cercana a cero).

Al comparar filas de la tabla, conviene fijarse sobre todo en desviación estándar y CV para interpretar estabilidad, y usar el rango como complemento sensible a extremos.

Interpretación comparativa:

  • Los conjuntos con mayor rango, varianza y desviación estándar muestran menor estabilidad.
  • sim_media_baja_var y sim_media_alta_var tienen medias parecidas, pero su dispersión es muy diferente.
  • Para ML, esta comparación permite anticipar variables con mayor sensibilidad al ruido y necesidad de preprocesamiento.

Pregunta de reflexión corta: ¿qué medida describe mejor este caso: rango, desviación estándar o coeficiente de variación? Justificar en una frase.

Pregunta de reflexión corta: ¿qué implicaría esta dispersión para un algoritmo basado en distancia como KNN si no se aplica escalamiento?

Etapa 7: Dispersión y estabilidad en modelos

Idea central: alta dispersión no es “mala” por sí sola —a veces refleja diversidad real— pero suele implicar más dificultad para encontrar un patrón simple o más riesgo de ruido si las mediciones son inestables.

Efectos prácticos

  • Variables muy dispersas pueden dominar métricas basadas en distancias si no se escalan.
  • Entrenamiento: optimizar con datos mal escalados puede hacer el aprendizaje más lento o inestable (especialmente en redes neuronales).

Conexiones breves (intuitivas)

  • KNN (k-vecinos más cercanos): decisiones por proximidad; si una variable tiene rango enorme, “pesa” demasiado sin escalado.
  • Clustering: grupos pueden verse estirados o mezclados si la escala y la dispersión no se consideran.
  • Regresión: errores grandes (cuadráticos) pueden venir de zonas muy variables o de outliers.
  • Redes neuronales: capas profundas suelen beneficiarse de entradas estandarizadas y de entender qué variables fluctúan más.

Mensaje para la práctica: medir y visualizar dispersión es parte del análisis exploratorio (EDA) antes de entrenar —junto con limpieza, escalamiento y, más adelante, manejo de outliers y validación.

Etapa 8: Ejemplo final en Machine Learning

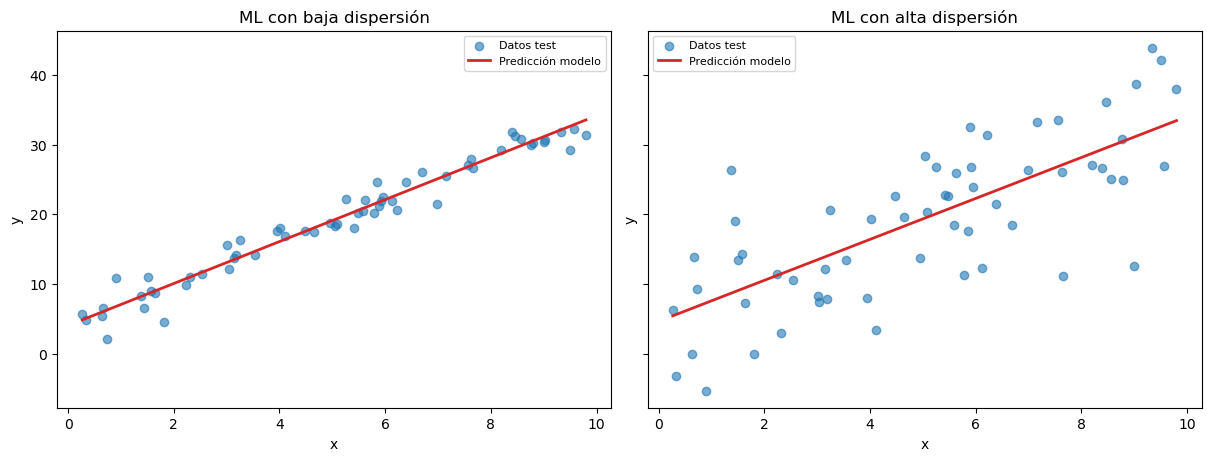
En este ejemplo se usa un modelo lineal simple con la misma relación base entre variable de entrada y salida, pero con dos escenarios:

  • Escenario A (baja dispersión): ruido pequeño alrededor de la tendencia.
  • Escenario B (alta dispersión): ruido grande alrededor de la misma tendencia.

La idea es comparar métricas para ver cómo la dispersión afecta la calidad del ajuste. La partición entrenamiento/prueba es aleatoria, para que la prueba cubra todo el rango de \(x\) (la Sesión 13 explica por qué).

Métricas que se comparan:

  • MSE (Error Cuadrático Medio): menor es mejor.
  • MAE (Error Absoluto Medio): menor es mejor.
  • R² (coeficiente de determinación): mayor es mejor.

Estas métricas se estudian a fondo en las Sesiones 11 a 13; aquí basta leer su dirección.

np.random.seed(2026)

# 1) Generación de datos sintéticos
n = 300
x = np.linspace(0, 10, n)
y_real = 4 + 3 * x  # relación real subyacente

# Dos niveles de dispersión (ruido)
ruido_bajo = np.random.normal(0, 1.5, n)
ruido_alto = np.random.normal(0, 8.0, n)
y_baja_disp = y_real + ruido_bajo
y_alta_disp = y_real + ruido_alto

# 2) Separación aleatoria train/test (80/20): la prueba cubre todo el rango de x
idx = np.random.permutation(n)
corte = int(0.8 * n)
tr, te = idx[:corte], idx[corte:]
x_train, x_test = x[tr], x[te]
yb_train, yb_test = y_baja_disp[tr], y_baja_disp[te]
ya_train, ya_test = y_alta_disp[tr], y_alta_disp[te]

# 3) Ajuste de regresión lineal por mínimos cuadrados (numpy.polyfit)
mb, bb = np.polyfit(x_train, yb_train, 1)
ma, ba = np.polyfit(x_train, ya_train, 1)
yb_pred = mb * x_test + bb
ya_pred = ma * x_test + ba

# 4) Métricas
def metricas(y_true, y_pred):
    mse = np.mean((y_true - y_pred) ** 2)
    mae = np.mean(np.abs(y_true - y_pred))
    sst = np.sum((y_true - np.mean(y_true)) ** 2)
    sse = np.sum((y_true - y_pred) ** 2)
    r2 = 1 - (sse / sst)
    return mse, mae, r2

mse_b, mae_b, r2_b = metricas(yb_test, yb_pred)
mse_a, mae_a, r2_a = metricas(ya_test, ya_pred)

comparacion_ml = pd.DataFrame({
    'escenario': ['Baja dispersión', 'Alta dispersión'],
    'MSE': [mse_b, mse_a], 'MAE': [mae_b, mae_a], 'R2': [r2_b, r2_a],
})
print(comparacion_ml.round(4))

# 5) Visualización comparativa
graficar_comparacion_modelos(
    x_test,
    {'Baja dispersión': yb_test, 'Alta dispersión': ya_test},
    {'Baja dispersión': yb_pred, 'Alta dispersión': ya_pred},
)

print("\nInterpretación didáctica:")
print('- En baja dispersión, el modelo sigue mejor la tendencia y las métricas suelen mejorar (MSE/MAE más bajos, R² más alto).')
print('- En alta dispersión, hay más ruido: el error aumenta y la capacidad explicativa del modelo suele disminuir.')
print('- Conclusión: analizar dispersión antes de entrenar ayuda a anticipar estabilidad y desempeño del modelo.')
         escenario      MSE     MAE      R2
0  Baja dispersión   2.8230  1.2150  0.9603
1  Alta dispersión  53.7844  5.9882  0.5725


Interpretación didáctica:
- En baja dispersión, el modelo sigue mejor la tendencia y las métricas suelen mejorar (MSE/MAE más bajos, R² más alto).
- En alta dispersión, hay más ruido: el error aumenta y la capacidad explicativa del modelo suele disminuir.
- Conclusión: analizar dispersión antes de entrenar ayuda a anticipar estabilidad y desempeño del modelo.

Cierre del ejemplo: el R² pasa de 0.96 (baja dispersión) a 0.57 (alta), y el MSE se multiplica por 19 (2.82 frente a 53.78). Con la misma estructura de modelo y la misma tendencia real, la diferencia en dispersión cambia notablemente las métricas. Los dos paneles comparten la escala vertical: la nube de alta dispersión ocupa un rango mucho mayor alrededor de la misma recta. Esta es una razón práctica para estudiar variabilidad en el análisis exploratorio previo al entrenamiento.

Caso real: cuando validar los datos cambia la decisión

Un equipo compara dos proveedores de un servicio (por ejemplo, dos APIs de pago) usando el tiempo de respuesta de cada uno, con la idea de quedarse con el más estable. La primera lectura de los datos, sin más, da esto:

  • Proveedor A: tiempos de respuesta relativamente consistentes.
  • Proveedor B: una desviación estándar mucho más alta — a primera vista, “menos confiable”.

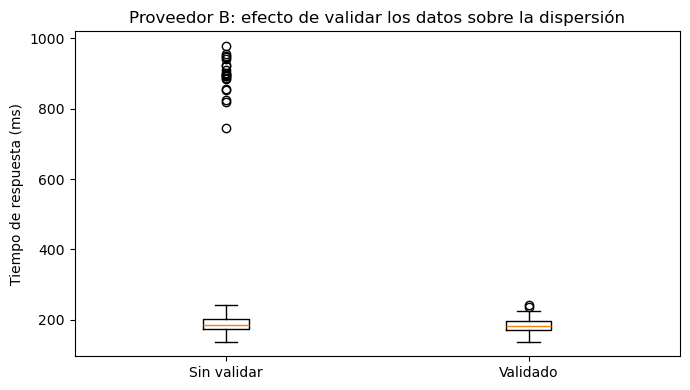
Con esa sola lectura, la decisión parecería obvia: quedarse con el Proveedor A. Pero antes de decidir, conviene validar los datos, no solo calcular la dispersión sobre lo que llegó tal cual. Al revisar el registro del Proveedor B se encuentra que un error de monitoreo duplicó por error un pequeño grupo de mediciones durante una ventana de mantenimiento — esos valores repetidos e inflados no reflejan tiempos de respuesta reales.

np.random.seed(7)

# Proveedor A: tiempos de respuesta estables
tiempos_proveedor_a = np.random.normal(loc=180, scale=15, size=200)

# Proveedor B "sin validar": tiempos normales + un grupo de mediciones duplicadas/infladas
# por un error de monitoreo durante una ventana de mantenimiento
tiempos_proveedor_b_real = np.random.normal(loc=185, scale=20, size=180)
mediciones_erroneas = np.random.normal(loc=900, scale=50, size=20)  # duplicadas por el bug
tiempos_proveedor_b_sin_validar = np.concatenate([tiempos_proveedor_b_real, mediciones_erroneas])

print("=== Antes de validar ===")
print(f"Proveedor A — media: {tiempos_proveedor_a.mean():.1f} ms | desv. estándar: {tiempos_proveedor_a.std(ddof=1):.1f} ms")
print(f"Proveedor B — media: {tiempos_proveedor_b_sin_validar.mean():.1f} ms | desv. estándar: {tiempos_proveedor_b_sin_validar.std(ddof=1):.1f} ms")
print("\nLectura superficial: el Proveedor B parece mucho menos estable. Decisión tentativa: quedarse con A.")
=== Antes de validar ===
Proveedor A — media: 179.6 ms | desv. estándar: 14.9 ms
Proveedor B — media: 254.7 ms | desv. estándar: 214.9 ms

Lectura superficial: el Proveedor B parece mucho menos estable. Decisión tentativa: quedarse con A.

Validación de los datos: al revisar el origen de cada medición (no solo el número final), se identifican las 20 mediciones de la ventana de mantenimiento como inválidas — no representan el comportamiento real del servicio. Se excluyen y se vuelve a calcular la dispersión sobre los datos validados.

# Después de validar: se excluyen las mediciones del error de monitoreo
tiempos_proveedor_b_validado = tiempos_proveedor_b_real

print("=== Después de validar ===")
print(f"Proveedor A — media: {tiempos_proveedor_a.mean():.1f} ms | desv. estándar: {tiempos_proveedor_a.std(ddof=1):.1f} ms")
print(f"Proveedor B — media: {tiempos_proveedor_b_validado.mean():.1f} ms | desv. estándar: {tiempos_proveedor_b_validado.std(ddof=1):.1f} ms")

graficar_caso_real_validacion(tiempos_proveedor_b_sin_validar, tiempos_proveedor_b_validado, "Proveedor B")

diferencia_pct = 100 * (tiempos_proveedor_b_validado.std(ddof=1) - tiempos_proveedor_a.std(ddof=1)) / tiempos_proveedor_a.std(ddof=1)
print(f"\nUna vez validados los datos, la desviación estándar del Proveedor B queda {diferencia_pct:+.1f}% respecto a la del Proveedor A.")
print("La diferencia real es mucho menor de lo que sugería la primera lectura — y podría no justificar, por sí sola,")
print("descartar al Proveedor B.")
=== Después de validar ===
Proveedor A — media: 179.6 ms | desv. estándar: 14.9 ms
Proveedor B — media: 183.7 ms | desv. estándar: 19.5 ms


Una vez validados los datos, la desviación estándar del Proveedor B queda +31.2% respecto a la del Proveedor A.
La diferencia real es mucho menor de lo que sugería la primera lectura — y podría no justificar, por sí sola,
descartar al Proveedor B.

La decisión cambia con los datos validados. Antes de validar, la desviación estándar del Proveedor B parecía varias veces mayor que la del Proveedor A — un argumento aparentemente contundente para descartarlo. Después de excluir las mediciones inválidas, la diferencia real es mucho más modesta, y la decisión de negocio ya no es tan obvia: puede depender de otros factores (costo, soporte, SLA) y no solo de esta métrica.

La lección no es solo estadística. Calcular varianza, desviación estándar o CV sobre datos sin validar puede llevar a una conclusión completamente distinta de la correcta. Antes de reportar una medida de dispersión — y sobre todo antes de tomar una decisión con ella — vale la pena preguntarse: ¿de dónde vino cada dato?, ¿hay algún proceso, error de captura o evento puntual que esté inflando o distorsionando los números? Esta es, en esencia, la misma disciplina que se aplicará más adelante en el curso al hablar de calidad del dato y gobernanza: la dispersión que calculas es tan confiable como los datos que la alimentan.

Errores que conviene nombrar

  1. Reportar la media sin una medida de dispersión. Dos grupos con la misma media pueden ser muy distintos.
  2. Usar el rango como dispersión típica. Depende de solo dos valores; un extremo lo infla.
  3. Leer la varianza en las unidades de los datos. Está al cuadrado; para interpretar se usa la desviación estándar.
  4. Mezclar ddof. np.std usa ddof=0 y pandas .std() usa ddof=1: la misma columna da dos números distintos.
  5. Comparar desviaciones estándar de variables en escalas distintas. Para eso está el CV.
  6. Calcular el CV sin cero absoluto o con media cercana a cero. El cociente pierde sentido.
  7. Calcular la dispersión sobre datos sin validar. El caso de los proveedores muestra cómo cambia la decisión.
  8. Comparar gráficos con escalas distintas. Si cada panel ajusta su propio eje, una dispersión pequeña se ve tan ancha como una grande.

Idea clave

En Machine Learning, conocer solo la media no alcanza para entender un conjunto de datos.
Dos variables pueden tener el mismo promedio y comportarse de forma muy diferente si su dispersión cambia.
Por eso, medir rango, varianza, desviación estándar y coeficiente de variación permite ver estabilidad, ruido y riesgo de error.
Cuando la variabilidad es alta, los modelos suelen aprender con más dificultad y pueden volverse menos precisos o menos estables.
Antes de entrenar, analizar dispersión es una decisión clave, no un paso opcional.

Síntesis de la sesión

En esta sesión se observó que la media resume el centro, pero la dispersión describe cuán ancha o inestable es la nube de datos: rango (simple pero sensible a extremos), varianza y desviación estándar (alejamiento típico en unidades originales), y coeficiente de variación (comparación relativa entre variables de distinta escala).

Para Machine Learning, conocer la dispersión no es un detalle estadístico: condiciona el ruido aparente, la necesidad de preprocesamiento (escalamiento, estandarización), el comportamiento de algoritmos por distancias y la dificultad de aprender un patrón estable a partir de los datos.

Intuición sesgo–varianza (modelo): un modelo puede quedar demasiado simple y no captar el patrón (mucho sesgo), o demasiado ajustado a los datos de entrenamiento y variar mucho si cambian esos datos (alta varianza del modelo, riesgo de sobreajuste). La varianza descriptiva de los datos y la varianza del error del modelo comparten vocabulario por una razón: ambas hablan de cuánto “se mueve” algo alrededor de un valor central.

Este análisis no es aislado: funciona como base directa para los siguientes temas del curso y de la línea de IA.

  • Outliers: detección de valores extremos que pueden sesgar métricas y modelos.
  • Correlación: relación entre variables, considerando también su dispersión.
  • Escalamiento y estandarización: requisito práctico para KNN, clustering, regresión y redes neuronales.
  • PCA: reducción de dimensionalidad basada en varianza y estructura de los datos.
  • Validación de modelos: análisis de estabilidad del desempeño entre particiones y datos nuevos.
  • Entrenamiento en redes neuronales: entradas bien escaladas favorecen mayor estabilidad de optimización.

Cierre: comprender la dispersión permite pasar de “describir datos” a “preparar datos con criterio” para Machine Learning y Deep Learning.

6. Guía rápida: ¿qué medida usar?

Situación Medida principal Justificación
Aviso rápido de amplitud o extremos Rango Solo usa mínimo y máximo; es simple, pero sensible a un solo valor atípico.
Variable cuantitativa en una sola escala Desviación estándar Describe el alejamiento típico en las mismas unidades que los datos.
Comparar variables o grupos de distinta magnitud Coeficiente de variación Relaciona la dispersión con la media y permite comparar escalas distintas.
Misma media y comportamiento distinto Desviación estándar o CV El centro no distingue los conjuntos; el ancho sí.

Regla de comunicación: indicar siempre la variable, el valor, la unidad y si la medida es absoluta o relativa.

7. Guía práctica para reportar dispersión

Paso 1: identificar la variable

Indica su nombre, tipo y unidad. Por ejemplo, notas está en escala 0–100 y tiempo_ms está en milisegundos.

Paso 2: calcular las medidas

Rango, desviación estándar y, si comparas escalas distintas, coeficiente de variación.

Paso 3: comparar e interpretar

Observa si dos grupos tienen medias parecidas y anchos distintos. No basta con decir que una cifra es mayor: explica qué significa en el contexto.

Paso 4: seleccionar la medida principal

  • Rango: aviso rápido de amplitud y extremos.
  • Desviación estándar: alejamiento típico en las unidades originales.
  • CV: comparación relativa entre variables o grupos de distinta magnitud.

Paso 5: redactar el reporte

“Para [variable], la media es ___ y la desviación estándar es ___. Se reporta [medida] como medida principal porque [justificación contextual].”

Ejemplo aplicado: “Para el tiempo de respuesta del Proveedor B (datos validados, \(n=180\)), la media es 183.7 ms y la desviación estándar 19.5 ms (CV 10.6%). Se reporta la desviación estándar porque ambos proveedores se miden en la misma unidad: B es algo menos estable que A (14.9 ms, CV 8.3%), pero la diferencia es mucho menor que la que sugerían los datos sin validar (214.9 ms).”

8. Puente hacia las siguientes sesiones

En esta sesión observamos que varios conjuntos pueden compartir un centro parecido y, aun así, comportarse de manera diferente. La dispersión cuantifica ese ancho: rango, varianza, desviación estándar y coeficiente de variación.

En la Sesión 4 estudiaremos formalmente la forma de las distribuciones, la asimetría, las colas y la detección de anomalías. Más adelante, la Sesión 5 conectará estas ideas con la relación entre variables.

La tendencia central responde dónde está el centro. Esta sesión respondió qué tanto varían los datos. La siguiente responderá qué forma tiene su distribución.

9. Cierre

Este notebook deja una base aplicada sobre variabilidad:

  • definición y cálculo de rango, varianza, desviación estándar y coeficiente de variación,
  • comparación de conjuntos con media parecida y dispersión distinta,
  • lectura de la dispersión en el contexto de ruido y preprocesamiento,
  • demostración visual de su efecto sobre un modelo lineal simple,
  • práctica para justificar qué medida conviene comunicar.

Resultado esperado: el estudiante no solo calcula una medida, sino que puede explicar qué representa, cuándo es válida y por qué la usaría antes de entrenar un modelo.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.