# Ejemplo: una variable discrimina la clase; otra tiene rango grande y es ruido
np.random.seed(42)
n = 200
x0 = np.random.rand(n)  # discriminativa: etiqueta según umbral en 0.5
x1 = np.random.uniform(0, 2000, size=n)  # rango grande, independiente de la clase (ruido)
y = (x0 >= 0.5).astype(int)
X = np.column_stack([x0, x1])

# Punto de consulta: cerca del umbral en x0 (debería parecerse más a la clase 0)
q = np.array([[0.48, 1000.0]])


def vecino_mas_cercano(X_train, y_train, punto):
    dist = np.sqrt(((X_train - punto) ** 2).sum(axis=1))
    i = int(np.argmin(dist))
    return y_train[i], i, dist[i]


pred_sin, idx_sin, d_sin = vecino_mas_cercano(X, y, q)
print('Sin estandarizar → clase predicha:', int(pred_sin),
      '| distancia mínima:', f'{d_sin:.1f}',
      '| x0 del vecino:', f'{X[idx_sin, 0]:.3f}', '| x1 del vecino:', f'{X[idx_sin, 1]:.1f}')

# Estandarización con estadísticos del entrenamiento (solo train; aquí todo es train de juguete)
media = X.mean(axis=0)
std = X.std(axis=0, ddof=0)
std = np.where(std < 1e-12, 1.0, std)
X_std = (X - media) / std
q_std = (q - media) / std

pred_std, idx_std, d_std = vecino_mas_cercano(X_std, y, q_std)
print('Estandarizado   → clase predicha:', int(pred_std),
      '| distancia mínima:', f'{d_std:.3f}',
      '| x0 del vecino:', f'{X[idx_std, 0]:.3f}', '| x1 del vecino:', f'{X[idx_std, 1]:.1f}')

print('\nEtiqueta de referencia (solo por x0 < 0.5): clase 0 para el punto de consulta.')

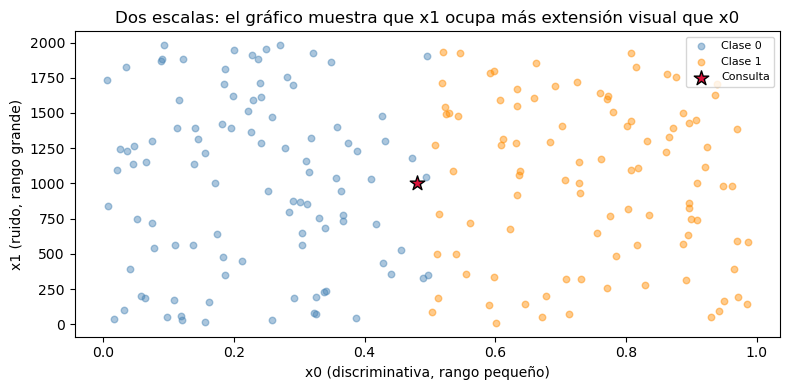
fig, ax = plt.subplots(1, 1, figsize=(8, 4))
ax.scatter(X[y == 0, 0], X[y == 0, 1], alpha=0.45, label='Clase 0', color='steelblue', s=22)
ax.scatter(X[y == 1, 0], X[y == 1, 1], alpha=0.45, label='Clase 1', color='darkorange', s=22)
ax.scatter(q[0, 0], q[0, 1], color='crimson', s=120, marker='*', edgecolors='black', label='Consulta', zorder=5)
ax.set_xlabel('x0 (discriminativa, rango pequeño)')
ax.set_ylabel('x1 (ruido, rango grande)')
ax.set_title('Dos escalas: el gráfico muestra que x1 ocupa más extensión visual que x0')
ax.legend(loc='upper right', fontsize=8)
plt.tight_layout()
plt.show()