Covarianza, correlación de Pearson, matriz de correlación, multicolinealidad y la diferencia entre correlación y causalidad.
Author
Wilder Ramírez Delgado
Published
September 18, 2026
Sesión 5 — Relación entre Variables
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Relación entre Variables Aplicada
En las sesiones anteriores se describió cada variable por separado: centro, dispersión y forma. En un problema real eso no basta. Los modelos aprenden del vector completo de features: cómo se mueven juntas, si se solapan y si una relación es lineal o solo aparente.
Este notebook trabaja covarianza, correlación de Pearson, fuerza y dirección, matriz de correlación, heatmap, multicolinealidad y la diferencia entre correlación y causalidad.
Contexto de ejemplo: hábitos de estudio, sueño, distracción y puntuación (dataset sintético semirrealista).
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 2 · Sesión 5
Objetivos
Explicar qué mide la covarianza y qué mide la correlación de Pearson.
Calcular e interpretar asociaciones con NumPy y pandas.
Construir y leer una matriz de correlación y un heatmap.
Identificar multicolinealidad y anticipar su efecto en algunos modelos.
Distinguir asociación de causalidad.
Relacionar estas ideas con EDA, selección de variables y modelado.
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. Dos variables se mueven juntas
Una variable aislada resume un eje. Una relación resume cómo cambian dos ejes al mismo tiempo.
Covarianza
Indica si, cuando una variable sube respecto a su media, la otra tiende a subir o a bajar. Sus unidades dependen del producto de las escalas: sirve para el signo, no para comparar magnitudes.
Correlación de Pearson
Estandariza la covarianza. Queda entre \(-1\) y \(1\) y describe dirección y fuerza lineal.
Advertencia
Una correlación alta no prueba un mecanismo. Puede haber redundancia, un tercero oculto o una relación no lineal.
2. Por qué importa en IA y Machine Learning
Los algoritmos no aprenden de columnas sueltas: operan sobre la geometría conjunta del espacio.
En regresión lineal, predictores muy correlacionados complican interpretar coeficientes.
En KNN y clustering, la redundancia y la escala cambian quién es “cercano”.
En PCA, la estructura compartida entre variables es precisamente lo que se comprime.
Idea central: medir relaciones orienta el EDA; no sustituye validación ni juicio de dominio.
3. Flujo recomendado de trabajo
Mirar el diagrama de dispersión antes de confiar en un coeficiente.
Calcular covarianza y correlación e interpretar signo y fuerza.
Leer la matriz y el heatmap para ver bloques redundantes.
Separar asociación de causa antes de recomendar una política o un feature.
Decidir si hace falta podar, regularizar, escalar o reducir dimensión.
4. Preparar el entorno
Si se trabaja en un entorno local, conviene tener instaladas las bibliotecas indicadas. En Colab suelen estar disponibles por defecto.
Interpretación breve: El objetivo de esta celda es garantizar que todas las figuras y tablas del notebook puedan reproducirse sin dependencias adicionales.
%matplotlib inlineimport sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as plt# Semilla para reproducibilidad de resultados sintéticosnp.random.seed(42)# Estilo simple y legible (compatible con Colab/Jupyter)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("Entorno listo: numpy, pandas, matplotlib.")print("pandas:", pd.__version__, "| numpy:", np.__version__)
A partir de aquí el notebook desarrolla el tema por etapas. Se recomienda ejecutar las celdas en orden: cada bloque de código incluye una interpretación.
Etapa 1: Dataset sintético de hábitos y desempeño
Se construye un conjunto de datos ficticio inspirado en un escenario de rendimiento académico y hábitos. La intención no es “predecir la realidad”, sino disponer de variables con relaciones controladas para ilustrar conceptos.
Variables incluidas (todas numéricas):
horas_lectura_semana: horas semanales dedicadas a lectura técnica.
horas_practica_semana: horas semanales de práctica (programación/ejercicios). Estará asociada a horas_lectura_semana para simular hábitos correlacionados.
horas_sueno_dia: horas de sueño promedio por día.
indice_distraccion: un índice proxy de distracción (mayor = más distracción).
puntuacion_examen: puntuación en un examen tipo taller (escala 0–100).
ruido_control: variable numérica no relacionada con el examen (sirve como contraste).
Las horas se recortan en 0 y la puntuación se mantiene en 0–100: un dataset sintético también debe respetar el dominio de cada variable (Sesión 1, valores imposibles).
Interpretación breve: Un dataset sintético permite conocer “la historia” detrás de los números y validar intuiciones (por ejemplo, multicolinealidad) sin ambigüedades del mundo real.
n =600# Hábitos de estudio: lectura y práctica tienden a ir de la mano (asociación positiva)horas_lectura_semana = np.random.normal(loc=6.0, scale=2.0, size=n)horas_lectura_semana = np.clip(horas_lectura_semana, 0, None) # no existen horas negativashoras_practica_semana =0.75* horas_lectura_semana + np.random.normal(loc=0.0, scale=1.2, size=n)horas_practica_semana = np.clip(horas_practica_semana, 0, None)# Sueño y distracción como factores adicionaleshoras_sueno_dia = np.random.normal(loc=7.0, scale=0.9, size=n)indice_distraccion = np.random.normal(loc=5.0, scale=1.5, size=n)# Puntuación: depende de hábitos y sueño; la distracción penalizapuntuacion_examen = (4.2* horas_lectura_semana+3.1* horas_practica_semana+2.0* horas_sueno_dia-1.8* indice_distraccion+ np.random.normal(loc=0.0, scale=6.0, size=n))puntuacion_examen = np.clip(puntuacion_examen, 0, 100) # escala 0–100# Variable de control: no interviene en la puntuación (debería dar r ≈ 0)ruido_control = np.random.normal(loc=100.0, scale=15.0, size=n)df = pd.DataFrame( {"horas_lectura_semana": horas_lectura_semana,"horas_practica_semana": horas_practica_semana,"horas_sueno_dia": horas_sueno_dia,"indice_distraccion": indice_distraccion,"puntuacion_examen": puntuacion_examen,"ruido_control": ruido_control, })df.head()
Interpretación breve:head() ayuda a inspeccionar filas representativas; info() confirma tipos y conteos; describe() entrega estadísticos univariados. Aun así, estos resúmenes no muestran por sí solos cómo “viajan” dos variables juntas.
Puente narrativo (de lo univariado a lo conjunto)
Hasta este punto se han revisado filas, tipos y estadísticos por columna. Ahora analizamos cómo se relacionan las variables entre sí. En ML, esa transición es operativa: la tabla es el mismo dataset, pero el objeto de estudio pasa a ser la estructura de dependencias entre columnas, que condiciona selección de variables, escalado y el comportamiento de muchos algoritmos.
Reto técnico
Ajustar n (por ejemplo, 200 vs 2000) y observar si los promedios y dispersiones cambian materialmente en describe().
Agregar una variable categórica simulada (por ejemplo, “modalidad”: 0/1) y analizar si conviene tratarla aparte; reflexionar sobre por qué este notebook se centra en relaciones numéricas.
Etapa 2: Por qué no basta mirar cada variable sola
Hasta ahora, incluso con tablas útiles, el foco podría describirse como columna por columna. A partir de aquí el análisis se vuelve bivariado (dos variables a la vez) y, más adelante, multivariado (varias relaciones simultáneas): lo que interesa es el comportamiento conjunto.
Dos variables pueden tener distribuciones “razonables” individualmente y, aun así, ocultar una estructura conjunta importante. En ML, esa estructura conjunta impacta:
la redundancia entre features;
la estabilidad de ciertos algoritmos ante pequeños cambios de datos;
el riesgo de interpretaciones engañosas si se ignoran asociaciones.
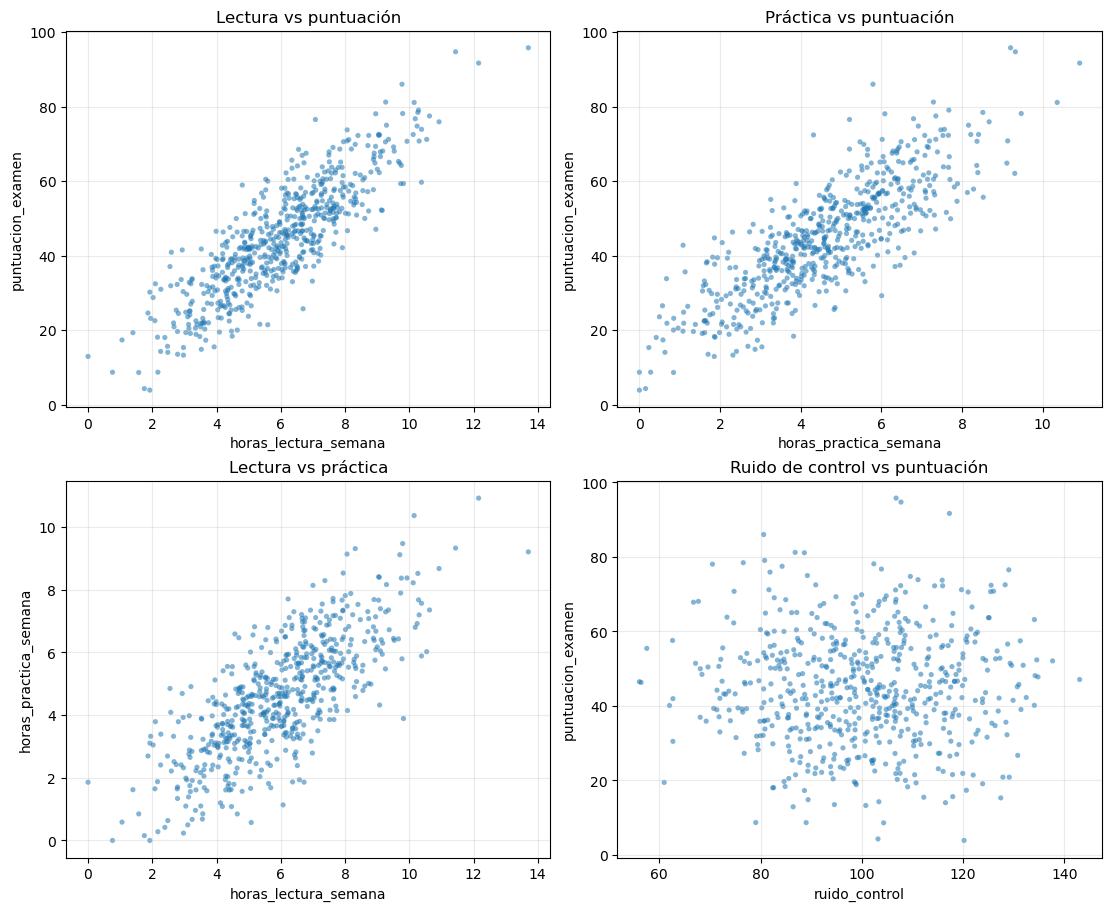
Un primer acercamiento gráfico consiste en el diagrama de dispersión (scatter plot): cada punto es un individuo (una fila), ubicado por el valor de dos variables.
Antes de ejecutar el gráfico: qué observar (guía de lectura)
Pregunta guía (cada panel):¿Qué patrón se observa en la relación entre estas variables?
Conviene detenerse en cada subfigura del bloque de código siguiente:
Lectura vs puntuación: ¿aparece una nube creciente? ¿es estrecha o ancha? ¿hay puntos extremos?
Práctica vs puntuación: ¿el patrón “se parece” al de lectura o cambia la pendiente aparente?
Lectura vs práctica: ¿se ve una dependencia casi lineal (pista de redundancia entre predictores)?
Ruido de control vs puntuación: ¿se aprecia ausencia de estructura (control negativo esperado)?
Interpretación breve: Si existe una asociación, suele observarse como una “nube” con tendencia (creciente o decreciente). Si no existe, la nube se ve más como un manchón sin estructura clara.
pares = [ ("horas_lectura_semana", "puntuacion_examen", "Lectura vs puntuación"), ("horas_practica_semana", "puntuacion_examen", "Práctica vs puntuación"), ("horas_lectura_semana", "horas_practica_semana", "Lectura vs práctica"), ("ruido_control", "puntuacion_examen", "Ruido de control vs puntuación"),]fig, axs = plt.subplots(2, 2, figsize=(11, 9), constrained_layout=True)axs = axs.ravel()for ax, (x, y, titulo) inzip(axs, pares): ax.scatter(df[x], df[y], s=14, alpha=0.55, edgecolors="none") ax.set_title(titulo) ax.set_xlabel(x) ax.set_ylabel(y)plt.show()
Interpretación breve: En los tres primeros gráficos suele apreciarse una tendencia positiva (a más horas, mayor puntuación, y lectura/práctica van juntas). El panel con ruido_control sirve como control: no debería mostrar una tendencia clara.
Después de observar los patrones (implicaciones en ML)
Pregunta guía (por cada patrón):¿Qué implicación tendría esta relación en un modelo de Machine Learning?
Una tendencia clara frente al objetivo sugiere señal potencial para muchos modelos, pero también invita a preguntarse si hay solapamiento informativo entre predictores (p. ej., lectura y práctica).
Un patrón “vacío” o muy difuso recuerda que no toda columna numérica aporta al target de forma lineal; aun así, no implica automáticamente que la variable sea inútil en general (podría haber no linealidad o interacciones).
En conjunto, estos gráficos apoyan decisiones de EDA: priorizar transformaciones, detectar outliers conjuntos y anticipar si un modelo lineal simple podría ser razonable como baseline.
Reto técnico
Graficar indice_distraccion vs puntuacion_examen y describir la dirección aparente.
Superponer una línea de tendencia simple (por ejemplo, ajuste polinomial de grado 1 con numpy.polyfit) en un par de variables y comparar visualmente con la nube de puntos.
Etapa 3: Covarianza
Tras visualizar pares de variables, el siguiente paso natural es cuantificar el co-movimiento. Ahora se introduce la covarianza como primer resumen numérico; más adelante se verá por qué conviene estandarizarla en correlación.
Idea central
La covarianza mide cómo dos variables “co-varían”: si cuando una se incrementa respecto a su media la otra tiende a incrementarse también (covarianza positiva), o a decrementarse (covarianza negativa). Si los incrementos no muestran una regularidad clara, la covarianza se acerca a cero.
Intuición: no es lo mismo que la pendiente de una recta, sino un resumen de concordancia de desviaciones respecto a la media.
En la práctica con muestras, a veces se usa \(n-1\) en el denominador (estimación insesgada de varianza/covarianza). Lo importante aquí no es memorizar el denominador exacto, sino entender qué se está promediando: el producto de desviaciones.
Lectura práctica (sin formalismo excesivo)
Covarianza positiva: las desviaciones tienden a tener el mismo signo.
Covarianza negativa: signos opuestos.
Magnitud: depende de las unidades y de la escala de las variables (por eso, comparar covarianzas entre pares distintos puede ser engañoso si las escalas difieren).
Limitación de escala y por qué no basta la covarianza (para comparar relaciones)
La covarianza mezcla “cuánto escala cada variable” con “cuán alineadas van”. Por ello, si una variable está en horas y otra en puntos de un índice, la magnitud absoluta de \(\mathrm{Cov}(X,Y)\) puede ser difícil de comparar con \(\mathrm{Cov}(U,V)\) entre otras dos variables con otras unidades.
Texto guía:La covarianza permite identificar dirección, pero no es adecuada para comparar relaciones entre variables con distintas unidades.
En otras palabras: la covarianza es útil como primer paso conceptual y aparece detrás de muchas operaciones matriciales, pero en EDA comparativo suele complementarse con una medida adimensional (Pearson), precisamente para comparar fuerzas relativas entre pares.
Conexión con ML
La covarianza resume asociación conjunta en el lenguaje de matrices centrados; es relevante para intuir geometría de datos y métodos lineales. Aun así, para selección de variables y lectura comparativa entre predictores de distinta escala, suele preferirse la correlación como “lengua común” entre pares.
Interpretación breve: La covarianza es un primer “termómetro” de co-movimiento, pero su magnitud absoluta no es tan interpretable entre variables con unidades diferentes; por eso no basta cuando se busca comparar relaciones en un tablero común de decisión.
# Covarianza muestral (pandas usa ddof=1 por defecto en .cov())cov_lp = df["horas_lectura_semana"].cov(df["puntuacion_examen"])cov_pr = df["horas_practica_semana"].cov(df["puntuacion_examen"])cov_lr = df["horas_lectura_semana"].cov(df["ruido_control"])print(f"Cov(lectura, puntuación) = {cov_lp: .3f}")print(f"Cov(práctica, puntuación) = {cov_pr: .3f}")print(f"Cov(lectura, ruido_control) = {cov_lr: .3f}")# Matriz de covarianza completacov_mat = df.cov(numeric_only=True)cov_mat
Interpretación breve: Se espera covarianza positiva entre hábitos de estudio y puntuación, y una covarianza cercana a cero entre ruido_control y variables relevantes (salvo fluctuaciones muestrales). La matriz completa muestra todas las parejas simultáneamente, aunque la lectura diagonal-versus-resto requiere práctica.
Reto técnico
Multiplicar puntuacion_examen por 10 y recalcular Cov(lectura, puntuación). Observar cómo cambia la magnitud aunque la relación “real” sea la misma en términos relativos.
Centrar manualmente dos columnas (restar la media) y verificar con numpy que el promedio del producto (x-mean(x))*(y-mean(y)) coincide con la definición (usando el mismo ddof que pandas).
Etapa 4: Correlación de Pearson
Idea central
La correlación de Pearson (\(r\)) estandariza la idea de covarianza para obtener un índice acotado entre -1 y 1 (en el caso típico de varianzas positivas). Mide el grado de asociación lineal entre dos variables.
donde \(\sigma_X\) y \(\sigma_Y\) son desviaciones estándar. Dividir por esas escalas “normaliza” el resultado: deja de depender tan fuertemente de las unidades de medida.
Signo y magnitud
\(r > 0\): relación lineal creciente.
\(r < 0\): relación lineal decreciente.
\(|r|\) cercano a 1: puntos alineados (muy “lineales”).
\(|r|\) cercano a 0: poca asociación lineal (puede haber asociación no lineal que Pearson no captura).
Interpretación guiada (qué preguntarse al ver \(r\))
Una lectura disciplinada conviene organizarla en tres pasos breves:
Dirección (signo): ¿cuando una variable aumenta, la otra tiende a aumentar o a disminuir?
Fuerza (magnitud): ¿la nube en el scatter es “estrecha” alrededor de una tendencia lineal o muy dispersa?
Sentido en el dominio: ¿tiene sentido esperar linealidad aquí, o sería más plausible una relación curva por mecanismos del problema?
Redundancia de variables (lectura de ingeniería)
En tableros con muchas columnas candidatas, Pearson entre predictores ayuda a detectar solapamiento informativo.
Texto guía:Una correlación alta puede indicar que dos variables aportan información similar en un modelo.
Eso no siempre implica eliminar una variable (a veces conviene conservar ambas con regularización o transformaciones), pero sí implica tomar una decisión explícita sobre redundancia, costo de medición e interpretabilidad.
Conexión con ML
Pearson orienta selección de variables y control de redundancia en modelos donde la linealidad importa (p. ej., baseline lineales) y anticipa riesgos de multicolinealidad en coeficientes interpretables. No reemplaza validación con métricas de desempeño, pero reduce el trabajo a ciegas.
Interpretación breve: Pearson responde a una pregunta acotada: “¿hay una tendencia lineal?” No responde: “¿cuál es la causa?” ni “¿la relación es no lineal?”.
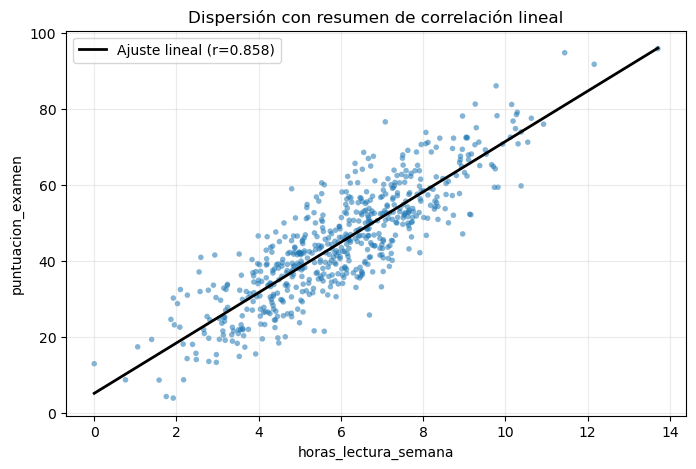
# Gráfico de apoyo: misma nube, pero con anotación del coeficientex = df["horas_lectura_semana"]y = df["puntuacion_examen"]r = x.corr(y)plt.figure(figsize=(8, 5))plt.scatter(x, y, s=16, alpha=0.55, edgecolors="none")plt.title("Dispersión con resumen de correlación lineal")plt.xlabel("horas_lectura_semana")plt.ylabel("puntuacion_examen")# Línea de regresión simple (grado 1) como apoyo visualm, b = np.polyfit(x, y, 1)xs = np.linspace(x.min(), x.max(), 200)plt.plot(xs, m * xs + b, color="black", linewidth=2, label=f"Ajuste lineal (r={r:.3f})")plt.legend()plt.show()
Interpretación breve: Un \(r\) alto en el par lectura–puntuación indica que una recta explica una parte considerable de la variación conjunta en sentido lineal. El contraste con ruido_control debería mostrar \(|r|\) pequeño.
Conexión con ML (toma de decisiones): un coeficiente alto con el target sugiere candidatura a features en modelos lineales o como entrada en pipelines; sin embargo, si dos predictores correlacionan fuerte entre sí, puede aumentar la redundancia y complicar la interpretación de modelos donde se lean coeficientes por separado.
Reto técnico
Calcular \(r\) entre horas_lectura_semana y horas_practica_semana y relacionar el valor con el panel de dispersión correspondiente.
Construir una variable transformada puntuacion_cuadrada = puntuacion_examen**2 y analizar si Pearson entre horas_lectura_semana y esa transformación es una métrica sensata para describir la relación (sugerencia: reflexionar sobre linealidad).
\(r^2\): proporción de varianza explicada linealmente
Si \(r\) es la correlación de Pearson, entonces
\[ r^2 = \bigl(\mathrm{Corr}(X,Y)\bigr)^2 \]
se lee como la proporción de varianza compartida en sentido lineal. Por ejemplo, \(r = 0{,}7\) implica \(r^2 \approx 0{,}49\): una recta da cuenta de cerca del 49 % de la variación de una variable a partir de la otra (el resto queda como residuo).
Eso no es “el modelo explica el fenómeno”, sino cuánto de la dispersión es linealmente asociable. Es el puente natural hacia la Sesión 11 (regresión lineal), donde \(R^2\) reaparece como bondad de ajuste de un modelo.
# r y r² para los pares ya calculados en esta etapapares_r2 = pd.DataFrame( {"par": ["lectura vs puntuación","práctica vs puntuación","lectura vs ruido_control", ],"r": [r_lp, r_pr, r_lr], })pares_r2["r2"] = pares_r2["r"] **2print(pares_r2.round(3).to_string(index=False))
                     par     r    r2
   lectura vs puntuación 0.858 0.737
  práctica vs puntuación 0.819 0.670
lectura vs ruido_control 0.006 0.000
Interpretación breve:\(r^2\) traduce el coeficiente a un porcentaje de variación lineal compartida. Un \(|r|\) “llamativo” puede corresponder a un \(r^2\) apenas moderado; conviene reportar ambos.
Conexión con ML: en un baseline lineal, \(r^2\) anticipa cuánta señal podría capturar una recta; no sustituye validación ni un modelo con más features.
Antes de ejecutar: ¿qué observar? (covarianza → Pearson)
La fórmula \(r = \mathrm{Cov}(X,Y)/(\sigma_X\sigma_Y)\) debería coincidir con pandas.Series.corr. Compara ambos números y el resultado de np.isclose.
cov(x,y) = 24.980718
s_x = 1.941806 | s_y = 14.987344
r manual  = 0.858370
r pandas  = 0.858370
¿Coinciden? True
Interpretación breve: si np.isclose es verdadero, la fórmula y la implementación de pandas están midiendo la misma cantidad. Pearson no es un número mágico: es la covarianza puesta en unidades de desviación estándar.
Etapa 5: Cuarteto de Anscombe — el mismo \(r\), cuatro historias
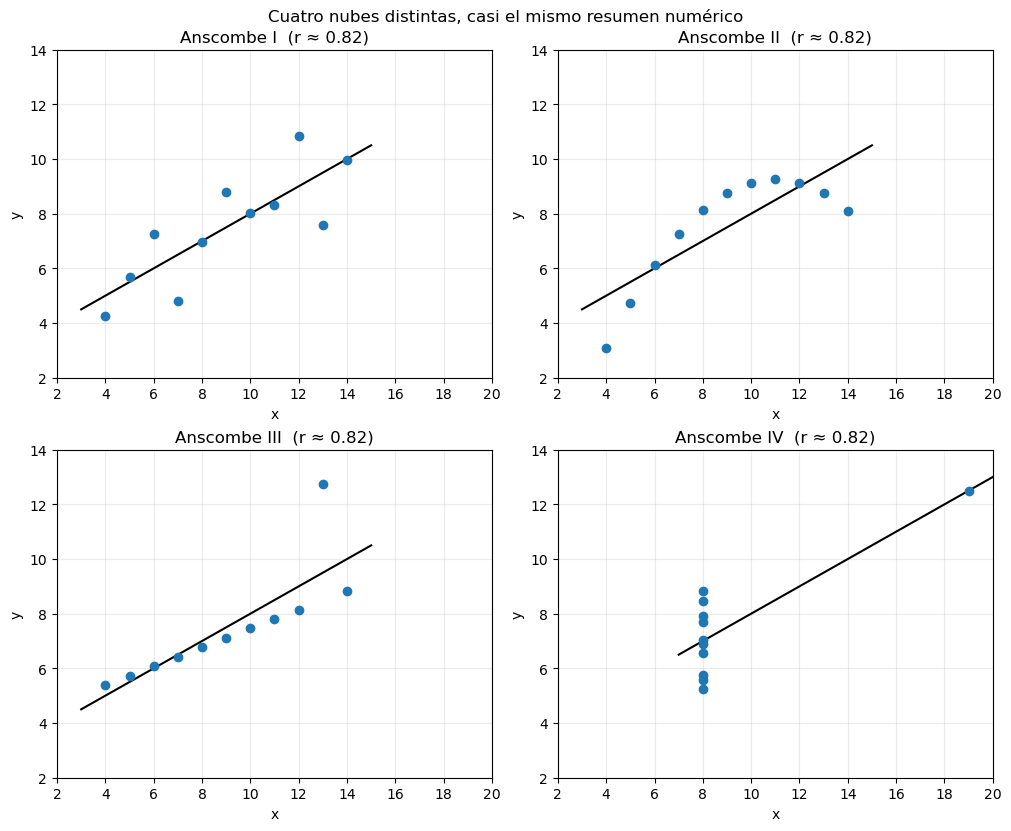
En 1973, Francis Anscombe construyó cuatro conjuntos de once puntos cada uno. Comparten (casi) la misma media de \(x\) y de \(y\), la misma varianza, la misma correlación de Pearson (\(r \approx 0{,}82\)) y la misma recta de regresión. Aun así, al graficarlos las formas son opuestas: nube lineal, curva, recta con un outlier vertical, y un cluster vertical con un punto lejano en \(x\).
Idea central: un resumen numérico puede ser idéntico y el fenómeno, distinto. Por eso el scatter no es un adorno: es parte de la medida.
Antes del gráfico del cuarteto de Anscombe —¿qué observar?
¿Los cuatro paneles parecen la misma relación?
¿En cuál una recta es un buen resumen y en cuál es engañosa?
Si solo leyeras \(r \approx 0{,}82\), ¿qué decisión de modelado tomarías por error?
conjunto  media_x  media_y     r  pendiente  intercepto
       I      9.0    7.501 0.816        0.5       3.000
      II      9.0    7.501 0.816        0.5       3.001
     III      9.0    7.500 0.816        0.5       3.002
      IV      9.0    7.501 0.817        0.5       3.002
Interpretación breve: I es aproximadamente lineal; II es una curva; III es una recta con un punto que tira de la pendiente; IV es un grupo vertical más un punto extremo en \(x\). El mismo \(r\) y la misma recta esconden esos patrones. Siempre graficar antes de confiar en el coeficiente.
Conexión con ML: un baseline lineal “bien ajustado” en resumen puede ser un mal mapa del dato; el diagnóstico visual evita entrenar sobre una historia que el \(r\) no cuenta.
Etapa 6: Relación fuerte con \(r \approx 0\) (Pearson solo capta lo lineal)
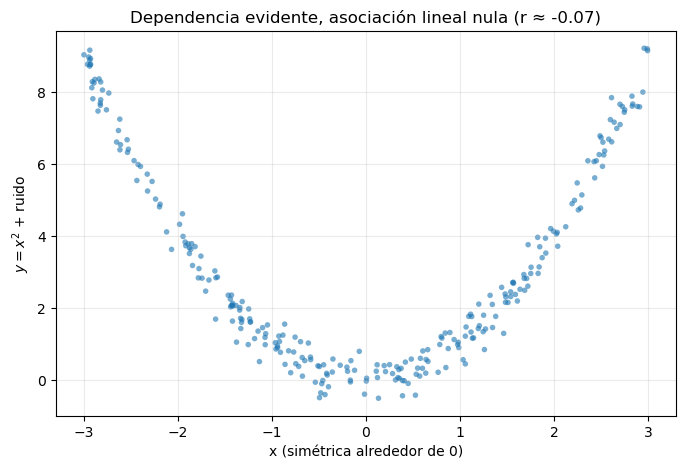
Pearson responde a una pregunta estrecha: ¿hay tendencia lineal? Una dependencia clara —por ejemplo una parábola— puede producir \(r\) cercano a 0 si \(x\) es simétrico alrededor de cero: las ramas izquierda y derecha se cancelan.
Idea central:\(r \approx 0\) no prueba independencia; prueba poca asociación lineal.
Antes del gráfico de la relación cuadrática (\(y = x^2\)) —¿qué observar?
¿La nube tiene forma de U (o de V)?
¿Una recta sería un resumen honesto?
Si \(r\) sale cercano a 0, ¿dirías que “no hay relación”?
# Relación determinista no lineal + ruido pequeño (no altera el np.random global)rng_u = np.random.default_rng(21)x_u = rng_u.uniform(-3.0, 3.0, size=280)y_u = x_u **2+ rng_u.normal(0.0, 0.35, size=x_u.size)r_u =float(np.corrcoef(x_u, y_u)[0, 1])print(f"r de Pearson (x vs x² + ruido) ≈ {r_u:.3f}")plt.figure(figsize=(8, 5))plt.scatter(x_u, y_u, s=16, alpha=0.6, edgecolors="none")plt.title(f"Dependencia evidente, asociación lineal nula (r ≈ {r_u:.2f})")plt.xlabel("x (simétrica alrededor de 0)")plt.ylabel(r"$y = x^2$+ ruido")plt.show()
r de Pearson (x vs x² + ruido) ≈ -0.075
Interpretación breve: hay una regla clara (\(y\) crece cuando \(|x|\) crece) y, sin embargo, Pearson ≈ 0 porque no hay recta que la resuma. El gráfico sí la muestra.
Conexión con ML: un filtro de features que descarte columnas con \(|r|\) bajo respecto al target puede borrar señal no lineal. De ahí visualizar y, cuando haga falta, otras medidas (p. ej. Spearman) o modelos que no asuman linealidad.
Etapa 7: Spearman frente a Pearson
La correlación de Spearman (\(\rho\)) es Pearson calculado sobre los rangos (el puesto de cada valor, no su magnitud). Por eso:
capta relaciones monótonas aunque no sean lineales (crece-crece o crece-baja, aunque la curva se acelere);
suele ser más robusta a outliers que Pearson, porque un extremo cambia poco el rango relativo comparado con cómo distorsiona la covarianza.
En pandas: df["a"].corr(df["b"], method="spearman") frente a method="pearson".
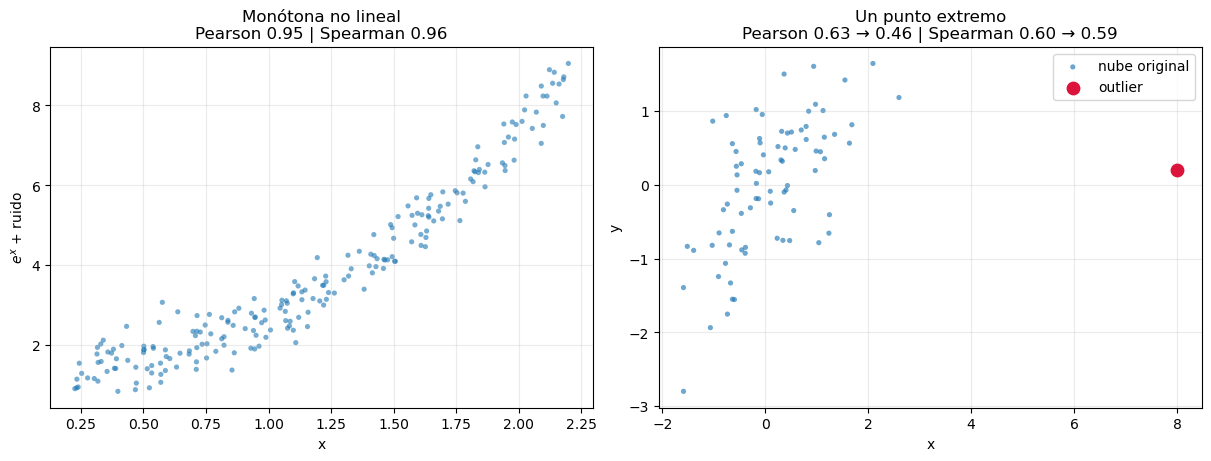
Antes de los gráficos Pearson vs Spearman —¿qué observar?
En el caso \(y = e^{x}\): ¿la nube es creciente pero curva? ¿Spearman queda más alto que Pearson?
En el caso con un outlier: ¿Pearson se mueve más que Spearman?
rng_s = np.random.default_rng(8)# (a) monótona no lineal: y = exp(x) + ruidox_m = rng_s.uniform(0.2, 2.2, size=220)y_m = np.exp(x_m) + rng_s.normal(0.0, 0.4, size=x_m.size)s_m = pd.Series(x_m)t_m = pd.Series(y_m)r_pear_m = s_m.corr(t_m, method="pearson")r_spear_m = s_m.corr(t_m, method="spearman")print("(a) monótona no lineal y = exp(x)")print(f" Pearson r = {r_pear_m:.3f}")print(f" Spearman ρ = {r_spear_m:.3f}")# (b) un par lineal + UN outlier extremo (la etapa siguiente repite el experimento con la recta ajustada)x_lin = rng_s.normal(0.0, 1.0, size=80)y_lin =0.55* x_lin + rng_s.normal(0.0, 0.7, size=80)x_out = np.append(x_lin, 8.0)y_out = np.append(y_lin, 0.2)r_pear_0 = pd.Series(x_lin).corr(pd.Series(y_lin), method="pearson")r_spear_0 = pd.Series(x_lin).corr(pd.Series(y_lin), method="spearman")r_pear_1 = pd.Series(x_out).corr(pd.Series(y_out), method="pearson")r_spear_1 = pd.Series(x_out).corr(pd.Series(y_out), method="spearman")print("(b) impacto de un outlier")print(f" sin outlier Pearson={r_pear_0:.3f} Spearman={r_spear_0:.3f}")print(f" con outlier Pearson={r_pear_1:.3f} Spearman={r_spear_1:.3f}")fig, axs = plt.subplots(1, 2, figsize=(12, 4.5), constrained_layout=True)axs[0].scatter(x_m, y_m, s=14, alpha=0.6, edgecolors="none")axs[0].set_title(f"Monótona no lineal\nPearson {r_pear_m:.2f} | Spearman {r_spear_m:.2f}")axs[0].set_xlabel("x")axs[0].set_ylabel(r"$e^{x}$+ ruido")axs[1].scatter(x_lin, y_lin, s=14, alpha=0.65, edgecolors="none", label="nube original")axs[1].scatter([8.0], [0.2], s=80, c="crimson", zorder=4, label="outlier")axs[1].set_title(f"Un punto extremo\nPearson {r_pear_0:.2f} → {r_pear_1:.2f} | Spearman {r_spear_0:.2f} → {r_spear_1:.2f}")axs[1].set_xlabel("x")axs[1].set_ylabel("y")axs[1].legend()plt.show()
(a) monótona no lineal  y = exp(x)
    Pearson  r = 0.951
    Spearman ρ = 0.963
(b) impacto de un outlier
    sin outlier  Pearson=0.626  Spearman=0.597
    con outlier  Pearson=0.458  Spearman=0.588
Interpretación breve: en (a), ambos signos coinciden (relación creciente), pero Spearman suele ser mayor porque la curva es monótona y Pearson “penaliza” la falta de recta. En (b), Pearson se mueve más al añadir un punto absurdo; Spearman, al trabajar con rangos, cambia menos.
Conexión con ML: si el mecanismo es monótono pero no lineal, Spearman (o un modelo no lineal) es más honesto que un umbral de Pearson para filtrar features. La robustez importa cuando hay extremos (Sesiones 3 y 4).
Etapa 8: Impacto de un outlier en \(r\)
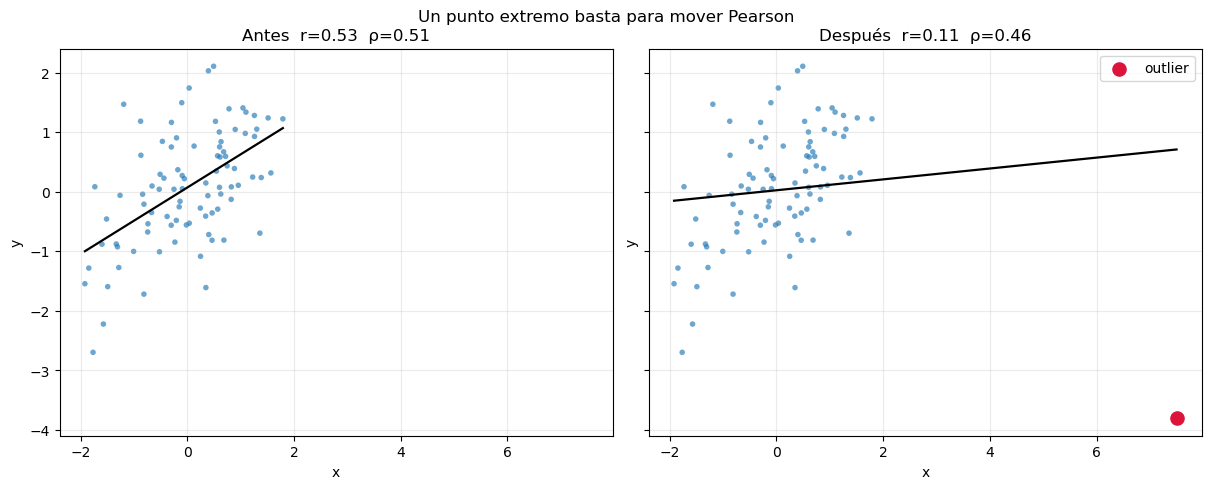
Un solo punto extremo puede crear una correlación de Pearson que no estaba o destruir una que sí lo estaba. Es el mismo fenómeno de sensibilidad de la media (Sesiones 3 y 4), ahora en una medida bivariada.
Spearman, al usar rangos, suele amortiguar ese golpe. El gráfico de antes/después hace visible qué punto está haciendo el trabajo sucio.
Antes del gráfico de Pearson con y sin outlier —¿qué observar?
Panel izquierdo: ¿la nube sugiere una asociación solo moderada?
Panel derecho: ¿un punto rojo basta para rotar la recta o inflar/hundir \(r\)?
Sin outlier: Pearson r=0.532 | Spearman ρ=0.509
Con outlier: Pearson r=0.106 | Spearman ρ=0.460
Cambio Pearson:  -0.425
Cambio Spearman: -0.049
Interpretación breve: el panel derecho muestra cómo un dato tira de la recta y de Pearson. Spearman suele moverse menos: el extremo cambia de rango, no de “peso cuadrático” como en la covarianza.
Conexión con ML: un feature con colas pesadas puede inflar o apagar \(|r|\) con el target; conviene inspeccionar outliers (Sesiones 3 y 4) antes de rankear variables solo con Pearson.
Etapa 9: Fuerza y dirección de la relación
Hasta aquí se definió Pearson como medida de asociación lineal. Ahora se separan dos lecturas que suelen confundirse: la dirección (signo) y la fuerza (qué tan “lineal” es la nube). Esto es clave en ML porque muchas decisiones de baseline y de comunicación con stakeholders dependen de no sobredimensionar una correlación “moderada” ni subestimar una relación débil que podría ser no lineal.
Dirección
La dirección se refiere al signo de la asociación lineal: positiva (sube-sube) o negativa (sube-baja).
Fuerza
La fuerza se refiere a qué tan “apretada” está la nube alrededor de una tendencia lineal: valores de \(|r|\) altos suelen verse como nubes delgadas; valores bajos, como nubes anchas.
Es importante evitar “tablas mágicas” rígidas. En ingeniería suele usarse una lectura prudente por rangos, solo como orientación:
\(|r|\) bajo: asociación lineal débil.
\(|r|\) medio: moderada.
\(|r|\) alto: fuerte.
La utilidad práctica depende del dominio, del tamaño muestral y del proceso de medición.
Escala orientativa de \(|r|\) (con advertencia de dominio)
\(|r|\)
Lectura orientativa
\(< 0{,}1\)
Nula o despreciable
\(0{,}1\)–\(0{,}3\)
Débil
\(0{,}3\)–\(0{,}5\)
Moderada
\(0{,}5\)–\(0{,}7\)
Considerable
\(0{,}7\)–\(0{,}9\)
Fuerte
\(> 0{,}9\)
Muy fuerte
Advertencia: estos umbrales no viajan entre disciplinas. En física o metrología, \(|r| = 0{,}9\) puede ser flojo (se esperan relaciones casi deterministas). En ciencias sociales o comportamiento, \(|r| = 0{,}4\) ya puede ser relevante. Usa la tabla para comunicar, no como ley.
Interpretación breve: Dos relaciones con el mismo signo pueden diferir radicalmente en fuerza: la dirección no lo dice todo.
Conexión con ML
En selección de variables, a veces se priorizan predictores con asociación moderada/fuerte con el objetivo siempre que el mecanismo y la validación lo respalden. Una correlación débil no implica “inutilidad” (puede haber señal no lineal o interacciones), pero sí ajusta expectativas sobre modelos lineales simples y sobre la lectura de importancia vía \(|r|\) únicamente.
Ejemplos visuales comparativos
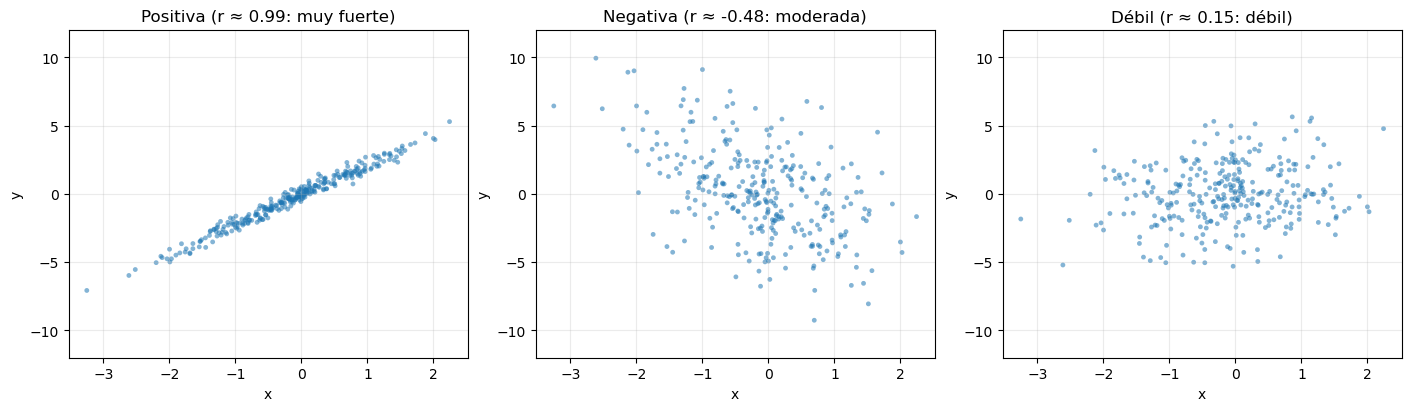
Para ilustrar positivo/negativo/débil, se generan tres nubes sintéticas controladas.
Antes de ejecutar el código: para cada panel, preguntarse: ¿Qué patrón se observa en la relación entre estas variables? (pendiente aproximada, dispersión, forma).
Panel “Positiva”: ¿nube creciente y relativamente delgada?
Panel “Negativa”: ¿nube decreciente con fuerza moderada?
Panel “Débil”: ¿ausencia de una estructura lineal clara a pesar de existir una pendiente numérica pequeña mezclada con ruido?
Después de ejecutar el código: preguntarse: ¿Qué implicación tendría esta diferencia de fuerza en un modelo de Machine Learning? (por ejemplo, cuánto explicaría un baseline lineal, o qué tan “visible” sería la señal en presencia de más variables ruidosas).
rng = np.random.default_rng(7)mue =300x0 = rng.normal(size=mue)# Positiva muy fuertey_pos =2.2* x0 + rng.normal(scale=0.35, size=mue)# Negativa moderaday_neg =-1.4* x0 + rng.normal(scale=3.0, size=mue)# Débil (mucho ruido)y_weak =0.15* x0 + rng.normal(scale=2.2, size=mue)def pearson(a, b):returnfloat(np.corrcoef(a, b)[0, 1])def lectura_r(r):"""Lectura orientativa de |r| según la tabla de esta etapa."""for limite, texto in [(0.1, "nula"), (0.3, "débil"), (0.5, "moderada"), (0.7, "considerable"), (0.9, "fuerte")]:ifabs(r) < limite:return textoreturn"muy fuerte"r_pos, r_neg, r_weak = pearson(x0, y_pos), pearson(x0, y_neg), pearson(x0, y_weak)fig, axs = plt.subplots(1, 3, figsize=(14, 4), constrained_layout=True)axs[0].scatter(x0, y_pos, s=12, alpha=0.55, edgecolors="none")axs[0].set_title(f"Positiva (r ≈ {r_pos:.2f}: {lectura_r(r_pos)})")axs[1].scatter(x0, y_neg, s=12, alpha=0.55, edgecolors="none")axs[1].set_title(f"Negativa (r ≈ {r_neg:.2f}: {lectura_r(r_neg)})")axs[2].scatter(x0, y_weak, s=12, alpha=0.55, edgecolors="none")axs[2].set_title(f"Débil (r ≈ {r_weak:.2f}: {lectura_r(r_weak)})")for ax in axs: ax.set_xlabel("x") ax.set_ylabel("y") ax.set_ylim(-12, 12) # misma escala: el ancho de la nube se compara a simple vistaplt.show()
Interpretación breve: El panel izquierdo muestra una estructura casi lineal ascendente; el central, descendente pero con una nube mucho más ancha; el derecho se asemeja a un manchón donde una recta explicaría poco.
Implicaciones en ML (lectura rápida): la fuerza de la asociación lineal condiciona la utilidad de un baseline lineal y la expectativa de estabilidad frente a ruido; en KNN o clustering, nubes “anchas” suelen implicar solapamiento de vecindades o grupos menos separables si esa variable participa en la métrica de distancia sin un escalado cuidadoso.
Reto técnico
Modificar scale en y_pos y observar cómo cambia \(|r|\) cuando la nube se “ensancha”.
Crear una relación no lineal clara (por ejemplo, \(y = x^2\) con \(x\) simétrico alrededor de \(0\)) y calcular Pearson: discutir por qué \(r\) puede ser cercano a 0 aun existiendo una regla determinista entre variables.
Etapa 10: Matriz de correlación
Puente narrativo
Ya se exploraron relaciones de a pares con dispersión y con \(r\). Ahora se adopta una vista sistémica: todas las correlaciones lineales pares-a-pares en una sola tabla. Esto es útil en ML porque el mapa de redundancias deja de estar “disperso entre gráficos” y se convierte en un objeto de decisión: selección, escalado y priorización de revisiones.
Qué es
La matriz de correlación es una tabla cuadrada donde el elemento \((i, j)\) es la correlación de Pearson entre la variable \(i\) y la variable \(j\). La diagonal principal típicamente vale 1 (correlación de una variable consigo misma).
Cómo interpretarla
Se buscan celdas fuera de diagonal con valores altos en valor absoluto: sugieren asociación lineal fuerte entre pares.
También importa el contexto: una correlación alta entre dos predictores sugiere redundancia potencial.
Conexión con ML
La matriz resume el “mapa” de redundancia lineal entre features: útil para selección de variables, podas conservadoras y discusiones de escalado. Además, anticipa comportamientos distintos por familia de modelo:
En regresión lineal y modelos interpretables, bloques de correlación alta entre predictores advierten inestabilidad en coeficientes.
En KNN, muchas variables redundantes pueden “encarecer” irrelevantemente la distancia si no se escala o no se pondera adecuadamente.
En clustering, correlaciones fuertes entre subconjuntos de variables pueden dominar la formación de grupos.
Interpretación breve: La matriz resume muchas relaciones simultáneamente, pero no reemplaza el juicio de dominio ni la validación con modelos.
R = df.corr(numeric_only=True, method="pearson")R
horas_lectura_semana
horas_practica_semana
horas_sueno_dia
indice_distraccion
puntuacion_examen
ruido_control
horas_lectura_semana
1.000000
0.759284
0.021951
-0.037549
0.858370
0.005604
horas_practica_semana
0.759284
1.000000
0.063972
-0.018526
0.818791
-0.011514
horas_sueno_dia
0.021951
0.063972
1.000000
0.029819
0.165725
-0.018211
indice_distraccion
-0.037549
-0.018526
0.029819
1.000000
-0.179776
-0.003937
puntuacion_examen
0.858370
0.818791
0.165725
-0.179776
1.000000
0.009557
ruido_control
0.005604
-0.011514
-0.018211
-0.003937
0.009557
1.000000
# Análisis de pares relevantes (fuera de diagonal, por magnitud)vars_ = R.columns.to_list()pares_corr = []for i, vi inenumerate(vars_):for j inrange(i +1, len(vars_)): vj = vars_[j] pares_corr.append((vi, vj, float(R.loc[vi, vj])))pares_df = pd.DataFrame(pares_corr, columns=["var_i", "var_j", "r"]).sort_values("r", key=lambda s: s.abs(), ascending=False)pares_df.head(10)
var_i
var_j
r
3
horas_lectura_semana
puntuacion_examen
0.858370
7
horas_practica_semana
puntuacion_examen
0.818791
0
horas_lectura_semana
horas_practica_semana
0.759284
12
indice_distraccion
puntuacion_examen
-0.179776
10
horas_sueno_dia
puntuacion_examen
0.165725
5
horas_practica_semana
horas_sueno_dia
0.063972
2
horas_lectura_semana
indice_distraccion
-0.037549
9
horas_sueno_dia
indice_distraccion
0.029819
1
horas_lectura_semana
horas_sueno_dia
0.021951
6
horas_practica_semana
indice_distraccion
-0.018526
Etapa 11: Heatmap de correlación
Puente narrativo
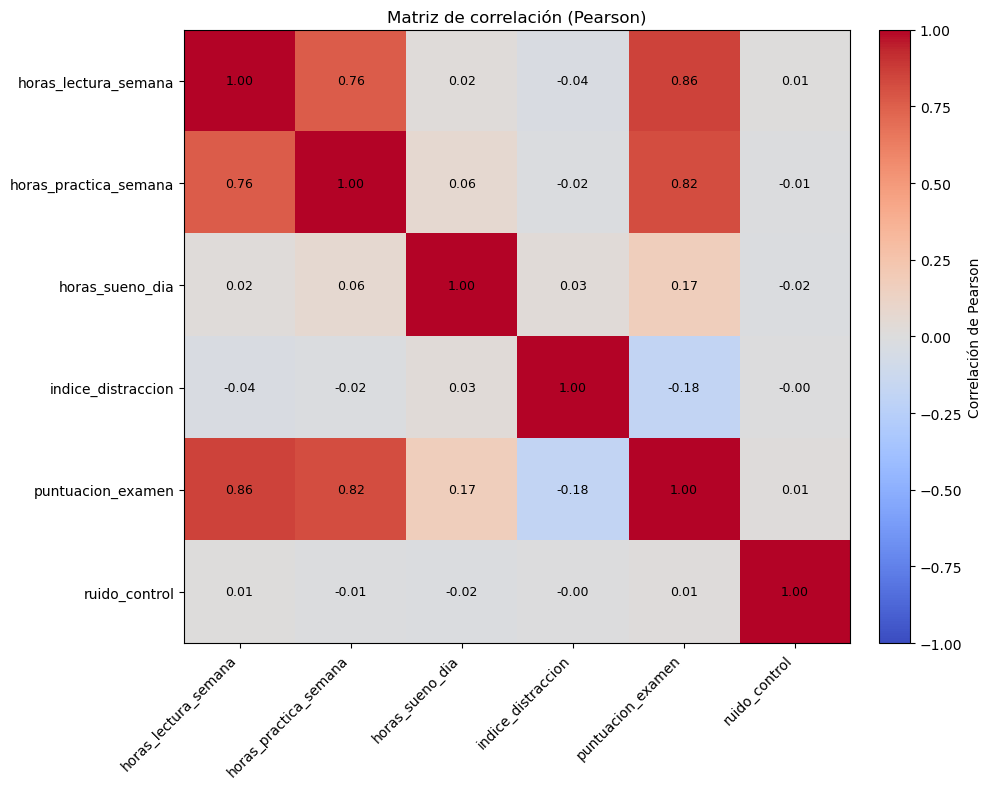
La matriz ya resume números; ahora se busca una lectura rápida y compartible con equipos: el heatmap convierte la tabla en una imagen donde el color guía la atención. En proyectos de ML, esta figura suele ser parte del “reporte de EDA” que acompaña a la primera versión de un modelo.
Objetivo del heatmap
Un mapa de calor convierte la tabla numérica en una imagen donde el color codifica magnitud. Para correlaciones, lo habitual es usar un mapa de color divergente (centro en 0) para distinguir asociaciones positivas y negativas.
Qué permite identificar rápidamente (y por qué importa en ML)
El heatmap permite identificar rápidamente:
Relaciones fuertes (colores intensos lejos del neutro): pares donde una recta explicaría buena parte de la variación conjunta lineal.
Posibles redundancias entre predictores: bloques “calientes” fuera de diagonal entre variables de entrada.
Grupos de variables relacionadas: conjuntos de columnas que tienden a correlacionar entre sí (a veces interpretables como un mismo constructo medido varias veces).
Cómo leerlo (paso a paso, sin quedarse en el color)
Diagonal: valores cercanos a 1 son esperables (una variable consigo misma); la diagonal no diagnostica redundancia por sí sola.
Fuera de diagonal: comparar simetría (Pearson produce matriz simétrica) y localizar pares con \(|r|\) alto.
Contexto predictor–predictor vs predictor–objetivo: la primera familia sugiere redundancia; la segunda sugiere candidatura de señal, sin garantizar utilidad causal ni ausencia de confusores.
Escala fija [-1, 1]: conviene mantener límites comparables entre proyectos para no “inflar” visualmente diferencias pequeñas.
Conexión con EDA y selección de variables
El heatmap acelera la lectura cuando hay muchas variables: el ojo humano detecta patrones (clusters de correlación). Esto orienta discusiones sobre redundancia, agrupamiento de variables o necesidad de regularización antes de entrenar.
Interpretación breve: El heatmap es una herramienta de comunicación y exploración; la decisión final sobre features debe apoyarse también en desempeño del modelo, costo de medición y validez del dominio.
def plot_corr_heatmap(corr: pd.DataFrame, title: str="Matriz de correlación (Pearson)"): labels = corr.columns.to_list() M = corr.to_numpy() fig, ax = plt.subplots(figsize=(10, 8))# Mapa divergente centrado en 0 im = ax.imshow(M, cmap="coolwarm", vmin=-1, vmax=1, aspect="auto") ax.grid(False) # la cuadrícula global cruzaría las celdas ax.set_xticks(np.arange(len(labels))) ax.set_yticks(np.arange(len(labels))) ax.set_xticklabels(labels, rotation=45, ha="right") ax.set_yticklabels(labels) ax.set_title(title)# Anotaciones numéricasfor i inrange(M.shape[0]):for j inrange(M.shape[1]): ax.text(j, i, f"{M[i, j]:.2f}", ha="center", va="center", color="black", fontsize=9) cbar = fig.colorbar(im, ax=ax, fraction=0.046, pad=0.04) cbar.set_label("Correlación de Pearson") plt.tight_layout() plt.show()plot_corr_heatmap(R)
Interpretación breve: Los bloques fuertes fuera de la diagonal evidencian pares con asociación lineal marcada. La diagonal intensa (+1) es esperable y no aporta información nueva por sí misma.
Lectura operativa: si varias variables de entrada forman un “bloque caliente” entre sí, suele convenir preguntarse si el modelo necesitará regularización, reducción de dimensionalidad o una política explícita de selección para evitar que un subconjunto redundante domine el resultado (especialmente en clustering o distancias).
Reto técnico
Reordenar filas/columnas por un criterio simple (por ejemplo, alfabético vs por cluster “manual”) y reflexionar sobre cómo el orden afecta la lectura visual.
Experimentar con otro colormap (RdBu_r, seismic) manteniendo vmin=-1 y vmax=1: evaluar accesibilidad perceptiva (contraste y lectura).
Etapa 12: Multicolinealidad
Idea central
La multicolinealidad ocurre cuando dos o más variables predictoras están fuertemente correlacionadas entre sí (asociación lineal alta). No es un “error” del dataset: puede ser una propiedad natural (por ejemplo, medidas redundantes del mismo constructo).
En términos de información, suele describirse como redundancia: distintas columnas aportan señales parcialmente repetidas sobre el mismo fenómeno.
Por qué importa en modelos lineales (y en la interpretación)
Texto guía:En modelos lineales, la multicolinealidad puede generar coeficientes inestables y dificultar la interpretación.
En regresión lineal y en modelos interpretables donde se leen coeficientes como “efectos” parciales, predictores colineales compiten por explicar la misma variación. Eso puede producir:
coeficientes inestables ante pequeños cambios de datos;
coeficientes con signo contraintuitivo si no se controla el contexto;
varianzas infladas en estimadores (en términos prácticos: incertidumbre grande).
Impacto real en modelos: la predicción puntual a veces sigue siendo aceptable, pero la atribución (“cuánto aporta cada variable”) se vuelve frágil. En proyectos donde la decisión depende de narrar coeficientes, esto es un riesgo de gobernanza, no solo de estadística.
Esto no implica que el modelo no “prediga”: a veces la predicción sigue siendo útil. El problema frecuente está en la interpretación causal o atribución de efectos a variables individuales.
Qué hacer cuando aparece (enfoque práctico)
Depende del objetivo:
Predicción: regularización (Ridge/Lasso), reducción de dimensionalidad, o conservar variables si el pipeline y la validación lo soportan.
Interpretación de coeficientes: eliminar/combinar variables redundantes, definir constructos, o usar métodos que separen componentes (por ejemplo, PCA como transformación de features).
Interpretación breve: Detectar multicolinealidad es un paso de diagnóstico; la acción correcta depende de si se prioriza interpretabilidad, costo de medición o desempeño predictivo.
Ejemplo claro con el dataset del notebook
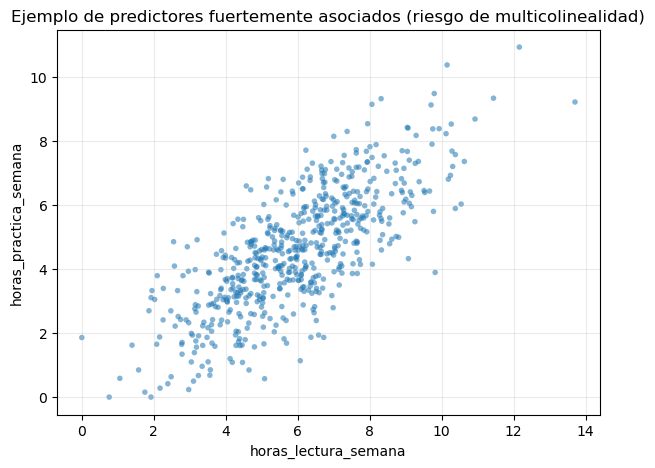
Se espera correlación alta entre lectura y práctica. Eso ilustra el fenómeno: ambas aportan información, pero parte de esa información es compartida.
r_lect_pract = df["horas_lectura_semana"].corr(df["horas_practica_semana"])print(f"r(lectura, práctica) = {r_lect_pract:.3f}")plt.figure(figsize=(7, 5))plt.scatter(df["horas_lectura_semana"], df["horas_practica_semana"], s=16, alpha=0.55, edgecolors="none")plt.title("Ejemplo de predictores fuertemente asociados (riesgo de multicolinealidad)")plt.xlabel("horas_lectura_semana")plt.ylabel("horas_practica_semana")plt.show()
r(lectura, práctica) = 0.759
Interpretación breve: Una nube alargada a lo largo de una dirección sugiere que una variable es casi una función afín de la otra más ruido: señal de redundancia lineal.
Reto técnico
Crear una tercera variable suma_estudio = horas_lectura_semana + horas_practica_semana y analizar cómo cambia el heatmap: identificar nuevos pares con correlación muy alta.
Redactar (en comentarios en markdown en una celda nueva) una política simple de “no usar dos variables redundantes” basada en un umbral de \(|r|\) y discutir sus límites.
Etapa 13: Correlación versus causalidad
Advertencia (lectura obligatoria en proyectos aplicados)
Una correlación alta no implica causalidad. Un scatter “muy lineal” tampoco prueba mecanismos: prueba co-movimiento (y, en el caso de Pearson, co-movimiento lineal) bajo las condiciones del dataset.
Distinción esencial
La correlación (en particular Pearson) cuantifica co-movimiento lineal observado en datos. La causalidad requiere un marco adicional: mecanismos, diseño experimental, control de confusores o supuestos explícitos que usualmente no están garantizados solo por una tabla de números.
Causas frecuentes de correlación sin relación causal directa
Variable oculta (confusor): dos variables suben o bajan porque ambas dependen de un tercer factor no incluido en el gráfico.
Coincidencia / asociación espuria: patrones que aparecen en una muestra o en series no estacionarias sin mecanismo estable.
Relación indirecta:\(A\) influye en \(B\) y \(B\) en \(C\), lo que puede hacer que \(A\) y \(C\) correlacionen aunque el camino “directo” no sea el que se imagina.
Ejemplos clásicos de confusión
Dos series temporales pueden correlacionarse porque ambas dependen de una tercera variable no modelada.
Variables que comparten una tendencia común (estacionalidad, crecimiento poblacional) pueden mostrar \(r\) alto sin relación directa.
Errores comunes en proyectos de ML
Atribuir a una feature un “efecto” solo porque correlaciona con el objetivo.
Intervenir (cambiar producto, política, precio) basándose en asociación espuria.
Ignorar fuga de información (data leakage): correlaciones infladas por contaminación entre entrenamiento y evaluación.
Interpretación breve: Un modelo puede aprender correlaciones útiles para predicción; eso no convierte automáticamente esas correlaciones en explicaciones causales válidas para acciones en el mundo real.
Ejemplo didáctico reproducible (espurio)
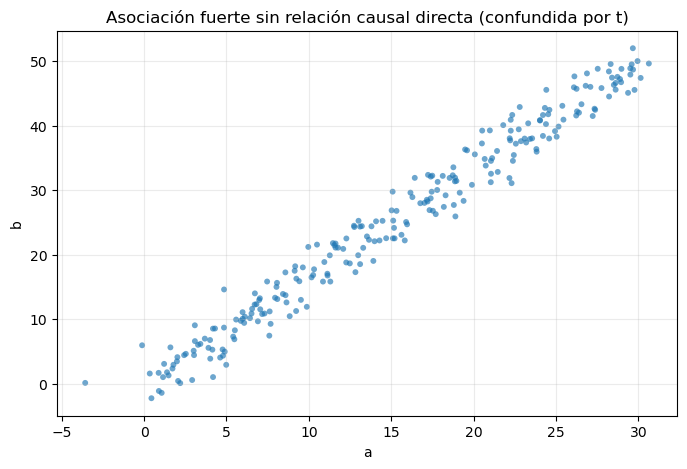
Se simulan dos variables que dependen de un tiempo oculto \(t\): ambas crecen con \(t\), por lo que correlacionan, aunque no haya un mecanismo directo de una sobre la otra.
# Generador aislado: no consume ni altera el np.random global (seed 42)rng_c = np.random.default_rng(13)t = np.linspace(0, 10, 250)a =3* t + rng_c.normal(scale=1.2, size=t.size)b =5* t + rng_c.normal(scale=1.2, size=t.size)r_spur =float(np.corrcoef(a, b)[0, 1])print(f"Correlación espuria (por variable oculta t): r ≈ {r_spur:.3f}")plt.figure(figsize=(8, 5))plt.scatter(a, b, s=18, alpha=0.65, edgecolors="none")plt.title("Asociación fuerte sin relación causal directa (confundida por t)")plt.xlabel("a")plt.ylabel("b")plt.show()
Correlación espuria (por variable oculta t): r ≈ 0.986
Interpretación breve: El gráfico puede verse “muy lineal” y, aun así, la acción correcta no sería manipular \(a\) esperando cambiar \(b\) como si \(a\) fuese la causa, sin modelar \(t\).
Toma de decisiones: antes de usar una correlación para políticas o diseño de producto, conviene contrastar si existe confusión, cadena indirecta o coincidencia; en ML, también si hay fuga que artificialmente alinea columnas.
Reto técnico
Incorporar \(t\) como columna y observar correlaciones parciales “a ojo” graficando a vs t y b vs t.
Investigar (lectura breve) la diferencia entre correlación y experimento aleatorizado: escribir tres frases explicando por qué el experimento apoya causalidad mejor que un scatterplot observacional.
Errores que conviene nombrar
Esta sección resume trampas frecuentes cuando se pasa de “calcular” a decidir con datos. No reemplaza el rigor matemático, pero sí alinea expectativas con la práctica de ingeniería de ML.
1) Asumir causalidad a partir de correlación o de un scatter “muy convincente”
Una correlación alta no implica causalidad. Incluso con \(r\) elevado, el patrón puede deberse a una variable oculta, a una relación indirecta o a una coincidencia en el muestreo. En ML, esto importa porque un modelo puede “explotar” una asociación espuria hasta que el sistema cambia y el patrón desaparece.
2) Ignorar multicolinealidad cuando el objetivo es interpretar coeficientes
En regresión lineal y modelos interpretables, la redundancia fuerte entre predictores puede producir coeficientes inestables y narrativas frágiles (“sube una variable y baja el coeficiente de otra”), aunque la predicción sea aceptable.
3) Descartar variables solo por baja correlación lineal con el objetivo
Pearson mide asociación lineal. Variables con \(|r|\) pequeño frente al target pueden ser relevantes en modelos no lineales (por ejemplo, árboles) o aparecer solo en interacción con otras columnas. Un filtro automático basado únicamente en correlación con el objetivo puede eliminar señal útil para KNN o clustering, donde la geometría conjunta no se resume en un solo coeficiente por variable.
Interpretación breve: el error típico no es “tocar mal el teclado”, sino concluir de más con una evidencia parcial. La correlación y el heatmap son brújulas del EDA, no veredictos de negocio ni pruebas causales.
Etapa 14: Integración con Machine Learning
Selección de variables y redundancia
La correlación ayuda a detectar redundancia lineal entre features. Si dos variables miden casi lo mismo, puede ser razonable conservar una, construir un índice compuesto, o aplicar regularización para estabilizar coeficientes. En la práctica, la selección no debería basarse solo en correlación: también importan costo de medición, riesgo de leakage y desempeño out-of-sample.
Impacto en modelos (más allá de “correlaciona con y”)
Regresión lineal / modelos interpretables: redundancia fuerte complica la lectura de coeficientes y puede volverlos sensibles al muestreo.
KNN y métodos basados en distancias: variables redundantes y escalas heterogéneas pueden distorsionar vecindades; el EDA de relaciones apoya decisiones de escalado y poda.
Clustering: correlaciones altas entre subconjuntos de variables pueden hacer que los grupos reflejen un bloque redundante; conviene preguntarse qué “distancia” se está representando realmente.
Modelos lineales: interpretación de coeficientes
En regresión lineal, la multicolinealidad afecta la interpretación de coeficientes individuales. En predicción pura, a veces se mitiga con Ridge (contracción de coeficientes) o con transformaciones.
PCA (idea operativa)
El Análisis de Componentes Principales (PCA) construye nuevas variables ortogonales (sin correlación lineal entre componentes) como combinaciones lineales de las originales. Es una forma de reparametrizar el espacio de features para concentrar varianza en menos dimensiones, útil cuando hay muchas variables correlacionadas.
Riesgo de interpretaciones erróneas
Un modelo puede explotar correlaciones por conveniencia matemática (minimizar error) aun cuando la estructura causal sea distinta. Por ello, en aplicaciones sensibles conviene separar:
desempeño predictivo (validación rigurosa), de
narrativas causales (diseño, conocimiento de dominio, pruebas adicionales).
Interpretación breve: El análisis de correlaciones es un puente entre estadística descriptiva y decisiones de modelado, pero no sustituye el protocolo de entrenamiento/evaluación ni el pensamiento crítico sobre el proceso generador de datos.
Ejemplo mínimo: “importancia lineal” vía correlación con el objetivo
No es una definición universal de importancia, pero es un ejercicio útil para conectar ideas: correlación absoluta con puntuacion_examen.
target ="puntuacion_examen"features = [c for c in df.columns if c != target]imp_lineal = pd.Series({f: abs(df[f].corr(df[target])) for f in features}, name="|r| con objetivo").sort_values( ascending=False)imp_lineal.to_frame()
|r| con objetivo
horas_lectura_semana
0.858370
horas_practica_semana
0.818791
indice_distraccion
0.179776
horas_sueno_dia
0.165725
ruido_control
0.009557
Interpretación breve: Las variables con mayor \(|r|\) suelen ser candidatas fuertes para modelos lineales simples, pero conviene recordar redundancia: dos features correlacionadas entre sí pueden ambas correlacionar con el objetivo.
Reto técnico
Construir una matriz \(X\) con tres columnas (lectura, práctica, distracción) y simular predicción por mínimos cuadrados con numpy.linalg.lstsq (opcional avanzado): observar si los coeficientes “saltan” al agregar/quitar columnas altamente correlacionadas.
Documentar en 5–8 líneas cómo se integraría este EDA en un README de proyecto: qué gráficos se guardarían y qué decisiones se tomarían antes de entrenar un modelo.
6. Guía rápida: ¿qué medida usar?
Situación
Qué reportar
Justificación
Signo de una asociación en la misma escala
Covarianza
Indica dirección, no magnitud comparable.
Fuerza lineal entre dos numéricas
Correlación de Pearson
Está acotada y es comparable.
Varias variables a la vez
Matriz y heatmap
Revela bloques redundantes.
Predictores muy alineados
Multicolinealidad
Afecta interpretación y, a veces, estabilidad.
Asociación monótona no lineal, o hay outliers
Spearman
Pearson sobre rangos; más robusta.
Cuánto de la varianza es linealmente compartida
\(r^2\)
Traduce \(r\) a proporción; puente a regresión.
Mismo \(r\), duda sobre la forma
Scatter (p. ej. Anscombe)
El coeficiente no sustituye al gráfico.
Relación alta y decisión de negocio
No inferir causa
Hace falta diseño, dominio y validación.
7. Guía práctica para reportar relaciones
Paso 1: identificar las variables y la pregunta
Indica nombres, unidades y qué decisión de modelado se quiere apoyar.
Paso 2: calcular y visualizar
Obtén las medidas del tema y un gráfico que las haga legibles.
Paso 3: interpretar en contexto
No basta el número: explica qué significa para el fenómeno y para el modelo.
Paso 4: redactar el reporte
“Para [variables], se observa [hallazgo]. Se reporta [medida/gráfico] porque [justificación]. Implicación para el modelo: [decisión].”
Ejemplo aplicado:“Para horas_lectura_semana y horas_practica_semana se observa una asociación lineal positiva y fuerte (\(r = 0.76\), \(r^2 = 0.58\)). Se reporta Pearson junto con el diagrama de dispersión porque la nube es alargada y sin curvatura. Implicación para el modelo: las dos variables correlacionan con la puntuación (0.86 y 0.82), pero comparten buena parte de la información; si se van a interpretar coeficientes, conviene combinarlas o regularizar.”
Síntesis de la sesión
Antes de esta síntesis, los retos técnicos de cada etapa permiten practicar remuestreo, poda por redundancia, lectura de no linealidad, heurísticas de ranking y comunicación gráfica.
Síntesis
Este notebook conectó la intuición gráfica (dispersión) con medidas de asociación (covarianza y correlación), y cerró con una lectura conjunta (matriz y heatmap) y advertencias profesionales (multicolinealidad y límites causales). En conjunto, estas herramientas forman parte del análisis exploratorio que antecede a decisiones de modelado en ML.
Idea clave con impacto
Las relaciones entre variables determinan qué tan útil será un conjunto de datos para un modelo, no solo por la presencia de “buenas columnas”, sino por cómo se combinan: redundancia, escala, solapamiento informativo y riesgos de interpretación condicionan desde un baseline lineal hasta métodos basados en distancias o agrupamiento.
Complementariamente, conviene recordar el contrapeso ético y técnico: medir relaciones no equivale a explicar mecanismos. La correlación ordena el caos inicial y orienta decisiones; no sustituye validación, diseño y juicio de dominio.
Preguntas de reflexión final (interpretativas, conectadas con ML)
Si se debiera entregar un modelo interpretable (coeficientes legibles) a un cliente, ¿qué decisiones se tomarían con el par horas_lectura_semana y horas_practica_semana dado su patrón de redundancia, y por qué podría cambiar la respuesta si el objetivo fuera solo predicción con validación cruzada?
¿En qué situaciones un KNN podría verse degradado por variables redundantes altamente correlacionadas, aun cuando cada variable tuviera correlación moderada con el target?
Para un problema de clustering exploratorio, ¿cómo se leería un bloque “caliente” en el heatmap entre variables de entrada, y qué riesgo existe si ese bloque domina la métrica de similitud?
¿Qué evidencia (no matemática) se requeriría para pasar de “esta correlación es alta” a “esta política de negocio debería cambiar”, sin caer en causalidad espuria?
8. Puente hacia las siguientes sesiones
Esta sesión preguntó cómo se mueven dos o más variables juntas. La Sesión 6 cambia el foco: cada fila se lee como un vector en \(\mathbb{R}^p\), y se comparan casos con producto interno, norma, distancia y coseno.
Además de Pearson, esta sesión dejó Spearman (asociación monótona y mayor robustez) y \(r^2\) (varianza linealmente compartida), que reaparece en la Sesión 11 como bondad de ajuste de un modelo de regresión.
9. Cierre
Este notebook deja una base aplicada sobre relaciones entre variables:
covarianza y correlación como medidas de asociación lineal,
lectura de matrices y heatmaps,
multicolinealidad y el límite entre asociación y causa,
implicaciones para EDA y modelado.
Resultado esperado: el estudiante puede justificar si dos variables se asocian, con qué fuerza, y qué haría con esa información antes de entrenar.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.