Estadística para IA — 6. Representación vectorial de datos
estadistica
algebra-lineal
vectores
El dataset como matriz, vectorización, producto punto, norma, distancia euclidiana, similitud coseno e interpretación geométrica.
Author
Wilder Ramírez Delgado
Published
September 25, 2026
Sesión 6 — Representación Vectorial de Datos
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Representación Vectorial de Datos Aplicada
Un modelo de Machine Learning no consume resúmenes sueltos: consume la fila completa. Esa fila es un vector en \(\mathbb{R}^p\). El dataset entero es una matriz.
Este notebook trabaja ese cambio de lenguaje: dataset como matriz, vectorización, producto punto, norma, distancia euclidiana, similitud coseno e interpretación geométrica.
Contexto de ejemplo: perfiles de hábitos de estudio. Cada estudiante es un punto en el plano lectura–práctica. El conjunto es sintético y diseñado a propósito, para que la geometría se lea a ojo: misma dirección con distinta magnitud, distinta dirección con magnitudes parecidas, y una consulta cuyo “vecino” cambia según la métrica.
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 2 · Sesión 6
Objetivos
Leer un dataset como matriz\(X\) de tamaño \(n \times p\) y un vector objetivo \(y\).
Interpretar cada fila como un vector en \(\mathbb{R}^p\).
Calcular e interpretar producto punto, norma y ángulo.
Distinguir distancia euclidiana (separación) de similitud coseno (orientación).
Ver por qué la escala de las features cambia quién es cercano.
Verificar la desigualdad de Cauchy–Schwarz y construir el vector unitario.
Interpretar ortogonalidad y la proyección ortogonal de un perfil sobre otro.
Relacionar esta geometría con KNN, embeddings y PCA.
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX ($...$ y $$...$$); si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. De la tabla al espacio
Una tabla tiene filas (observaciones) y columnas (variables). En álgebra, esa misma tabla es una matriz \(X \in \mathbb{R}^{n \times p}\):
\(n\) = número de observaciones,
\(p\) = número de features.
La fila \(i\) es el vector \(\mathbf{x}_i = (x_{i1},\ldots,x_{ip})\). Vectorizar no es “inventar números”: es dejar de leer celdas sueltas y leer la fila como un punto.
Suma productos coordenada a coordenada. Geométricamente combina magnitudes y alineación. Si el ángulo \(\theta\) es pequeño, el producto punto (con normas fijas) es grande y positivo.
Es la longitud del vector: qué tan intenso es el perfil, no hacia dónde apunta. Un estudiante que hace el doble de horas en las mismas proporciones tiene la misma dirección y el doble de norma.
Mide separación en el espacio. Es la métrica por defecto de muchos vecindarios (KNN, k-means). Crece si cambia la magnitud o la dirección, y se deja dominar por la feature de mayor rango.
Queda entre \(-1\) y \(1\). Ignora el tamaño global del vector: dos perfiles proporcionales tienen \(\cos\theta = 1\) aunque uno sea más “intenso”. Es la medida habitual en texto y embeddings.
La igualdad se da si y solo si los vectores son linealmente dependientes (uno es múltiplo del otro). El coseno no puede salir del intervalo \([-1,1]\) precisamente por esta desigualdad.
Tiene norma \(1\) y conserva la dirección. Dividir por la norma quita la intensidad y deja solo la orientación: es el paso algebraico detrás de la similitud coseno.
El ángulo es \(\pi/2\). En datos, dos perfiles ortogonales no comparten “empuje” en ninguna coordenada ponderada: saber uno no informa la magnitud del otro en la dirección del primero.
Es la sombra de \(\mathbf{a}\) sobre la recta de \(\mathbf{b}\): la parte de \(\mathbf{a}\) que se explica por esa dirección. El residual \(\mathbf{a}-\mathrm{proj}_{\mathbf{b}}(\mathbf{a})\) es ortogonal a \(\mathbf{b}\). Esa descomposición es el esqueleto de la regresión lineal simple y de PCA.
Pregunta
Herramienta
¿Cómo guardo el dataset para un modelo?
Matriz \(X\), vector \(y\)
¿Qué tan largo es un perfil?
Norma
¿Cuánto se alinean dos perfiles?
Producto punto / coseno
¿Qué tan lejos están dos observaciones?
Distancia euclidiana
¿Se parecen en forma, no en intensidad?
Similitud coseno
2. Por qué importa en IA y Machine Learning
El modelo no “ve” nombres de columnas: ve coordenadas.
En regresión y redes, \(X\) es la entrada; cada fila es un punto que se transforma.
En KNN y clustering, “parecido” significa cerca según una distancia. Si no se escala, una variable en milisegundos aplasta a otra en horas.
En texto, recomendaciones y embeddings, dos documentos pueden tener distinta longitud y el mismo tema: ahí suele importar más el ángulo (coseno) que la distancia bruta.
En PCA se buscan nuevas direcciones que capturen varianza en este espacio.
Idea central: distancia y ángulo no cuentan la misma historia. Dos observaciones pueden ser vecinas en dirección y lejanas en magnitud —o al revés— y el algoritmo tomará una decisión distinta según la métrica.
3. Flujo recomendado de trabajo
Escribir el dataset como \(X\)
Separar features del objetivo. Anotar \(n\) y \(p\).
Ver cada fila como un vector
Preguntar qué significa una coordenada y en qué unidad está.
Decidir si importa la magnitud o la dirección
Intensidad del perfil (norma, euclidiana) frente a forma del perfil (coseno).
Calcular las dos familias de medidas
Producto punto y norma primero; con ellas salen distancia y coseno.
Revisar la escala
Si las features no comparten unidad o rango, estandarizar antes de medir distancias.
Interpretar en el gráfico
Un coeficiente sin flechas o sin nube es fácil de malinterpretar.
Criterio general: la métrica es una decisión de modelado, no un detalle de implementación.
4. Preparar el entorno
%matplotlib inlineimport sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltnp.random.seed(42)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("Entorno listo: numpy, pandas, matplotlib.")print("pandas:", pd.__version__, "| numpy:", np.__version__)
Funciones de visualización (definidas una sola vez)
Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, las figuras se definen aquí. Más adelante cada etapa llama a la función en una o dos líneas.
def graficar_vectores_2d(nombres, X2, titulo, query=None, query_nombre="Consulta"):"""Flechas desde el origen: cada fila es un perfil en (lectura, práctica).""" fig, ax = plt.subplots(figsize=(7.5, 7.5)) colores = plt.cm.tab10(np.linspace(0, 0.7, len(nombres))) desplazamiento = {"Ana": (0.25, -0.45), "Elena": (-0.65, 0.25)} # evita que choquen las etiquetas# Se dibuja de la flecha más larga a la más corta: así Bruno no tapa a Ana (misma recta)for rango, i inenumerate(np.argsort(-np.linalg.norm(X2, axis=1))): nombre, color = nombres[i], colores[i] x, y = X2[i] ax.arrow(0, 0, x, y, head_width=0.18, head_length=0.18, length_includes_head=True, color=color, linewidth=2, zorder=2+ rango) dx, dy = desplazamiento.get(nombre, (0.15, 0.15)) ax.text(x + dx, y + dy, nombre, fontsize=10, color=color)if query isnotNone: ax.arrow(0, 0, query[0], query[1], head_width=0.18, head_length=0.18, length_includes_head=True, color="black", linewidth=2, linestyle="--") ax.text(query[0] +0.15, query[1] -0.35, query_nombre, fontsize=10) ax.axhline(0, color="0.6", linewidth=0.8) ax.axvline(0, color="0.6", linewidth=0.8) ax.set_aspect("equal", adjustable="box") ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) plt.tight_layout() plt.show()def graficar_puntos_y_consulta(nombres, X2, query, vecinos, titulo):"""Nube 2D: consulta + segmentos hacia los vecinos elegidos por una métrica.""" fig, ax = plt.subplots(figsize=(7.2, 6.2)) ax.scatter(X2[:, 0], X2[:, 1], s=70)for i, nombre inenumerate(nombres): ax.annotate(nombre, (X2[i, 0], X2[i, 1]), textcoords="offset points", xytext=(-40, -4) if nombre =="Elena"else (6, 6), fontsize=9) ax.scatter(query[0], query[1], s=110, marker="*", zorder=3, label="Consulta") ax.annotate("Consulta", (query[0], query[1]), textcoords="offset points", xytext=(6, -12), fontsize=9)for idx, estilo, etiqueta in vecinos: ax.plot([query[0], X2[idx, 0]], [query[1], X2[idx, 1]], linestyle=estilo, linewidth=1.8, label=etiqueta) ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) ax.legend(fontsize=9) plt.tight_layout() plt.show()def graficar_barras_metricas(nombres, euclidiana, coseno, titulo):"""Comparar distancia (menor = más cerca) y coseno (mayor = más parecido).""" fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) euclidiana, coseno = np.asarray(euclidiana), np.asarray(coseno) gana_d = np.isclose(euclidiana, euclidiana.min()) gana_c = np.isclose(coseno, coseno.max()) barras_d = axes[0].bar(nombres, euclidiana, color=np.where(gana_d, "C1", "C0")) axes[0].bar_label(barras_d, fmt="%.2f", fontsize=8) axes[0].set_ylabel("Distancia euclidiana") axes[0].set_title("Separación respecto a la consulta") axes[0].tick_params(axis="x", rotation=20) barras_c = axes[1].bar(nombres, coseno, color=np.where(gana_c, "C1", "C0")) axes[1].bar_label(barras_c, fmt="%.4f", fontsize=8) axes[1].set_ylim(0, 1.12) axes[1].set_ylabel("Similitud coseno") axes[1].set_title("Alineación respecto a la consulta") axes[1].tick_params(axis="x", rotation=20) fig.suptitle(titulo +" (naranja: el más cercano según cada medida)") plt.show()def graficar_proyeccion(a, b, nombre_a, nombre_b, titulo):"""Vector a, dirección b, proyección de a sobre b y residual.""" a = np.asarray(a, dtype=float) b = np.asarray(b, dtype=float) proj = (np.dot(a, b) / np.dot(b, b)) * b residual = a - proj fig, ax = plt.subplots(figsize=(7.2, 7.2))# La proyección va sobre la misma recta que b: se dibuja primero, ancha y translúcida ax.plot([0, proj[0]], [0, proj[1]], color="C1", linewidth=8, alpha=0.35, solid_capstyle="round", label=f"proj de {nombre_a} sobre {nombre_b}") ax.scatter(proj[0], proj[1], s=60, color="C1", zorder=4) ax.arrow(0, 0, b[0], b[1], head_width=0.18, head_length=0.18, length_includes_head=True, linewidth=2, color="C0", label=nombre_b, zorder=3) ax.arrow(0, 0, a[0], a[1], head_width=0.18, head_length=0.18, length_includes_head=True, linewidth=2, color="C2", label=nombre_a, zorder=3) ax.plot([a[0], proj[0]], [a[1], proj[1]], linestyle=":", linewidth=2, color="C3", label="residual") ax.axhline(0, color="0.6", linewidth=0.8) ax.axvline(0, color="0.6", linewidth=0.8) ax.set_aspect("equal", adjustable="box") ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) ax.legend(fontsize=8, loc="upper left") plt.tight_layout() plt.show()return proj, residual
5. Desarrollo por etapas
El hilo es uno solo: pasar de la tabla a la geometría, calcular las medidas a mano y con NumPy, y ver que la métrica decide quién es vecino. Cada etapa de código incluye una interpretación.
Etapa 1: Dataset como matriz
Se construye un conjunto pequeño y legible de seis estudiantes. Las features son horas_lectura y horas_practica. La puntuación del examen queda fuera de \(X\): es el objetivo \(y\), no una coordenada más del espacio de entrada.
Los perfiles están diseñados, no sorteados:
Ana y Bruno tienen la misma dirección; Bruno hace el doble de horas.
Camila lee mucho y practica poco; Diego hace lo contrario.
Elena está cerca de Ana en el plano.
Fabián tiene un perfil bajo y casi plano.
Interpretación breve: un dataset sintético controlado permite saber de antemano qué debería salir en distancia y en coseno, y luego verificarlo con NumPy.
nombres = ["Ana", "Bruno", "Camila", "Diego", "Elena", "Fabián"]X = np.array( [ [4.0, 4.0], # Ana: perfil equilibrado [8.0, 8.0], # Bruno: misma dirección, doble magnitud [8.0, 2.0], # Camila: lectora [2.0, 8.0], # Diego: práctica [3.6, 3.8], # Elena: cercana a Ana [1.0, 1.2], # Fabián: intensidad baja ])y = np.array([78.0, 91.0, 74.0, 80.0, 76.0, 58.0])df = pd.DataFrame(X, columns=["horas_lectura", "horas_practica"], index=nombres)df["puntuacion_examen"] = yprint("Tabla (lo que ve el analista):")display(df)print()print("Matriz X (lo que ve el modelo):")print(X)print("Forma de X:", X.shape, "→ n observaciones × p features")print("Vector y:", y)print("Forma de y:", y.shape)
Tabla (lo que ve el analista):
horas_lectura
horas_practica
puntuacion_examen
Ana
4.0
4.0
78.0
Bruno
8.0
8.0
91.0
Camila
8.0
2.0
74.0
Diego
2.0
8.0
80.0
Elena
3.6
3.8
76.0
Fabián
1.0
1.2
58.0
Matriz X (lo que ve el modelo):
[[4.  4. ]
 [8.  8. ]
 [8.  2. ]
 [2.  8. ]
 [3.6 3.8]
 [1.  1.2]]
Forma de X: (6, 2) → n observaciones × p features
Vector y: [78. 91. 74. 80. 76. 58.]
Forma de y: (6,)
Lectura de la Etapa 1.df es la vista humana: nombres, unidades, un objetivo. X es la vista del algoritmo: solo números, forma \((6, 2)\). Vectorizar, en la práctica, es elegir qué columnas entran a \(X\) y en qué orden. Cambiar el orden de las columnas no cambia las distancias si se aplica el mismo orden a todas las filas; mezclar el objetivo dentro de \(X\) sí cambia la geometría —y suele ser un error.
Conexión con ML: entrenar es, casi siempre, modelo.fit(X, y). Esta etapa nombra esos dos objetos.
Etapa 2: Vectorización — la fila es un punto
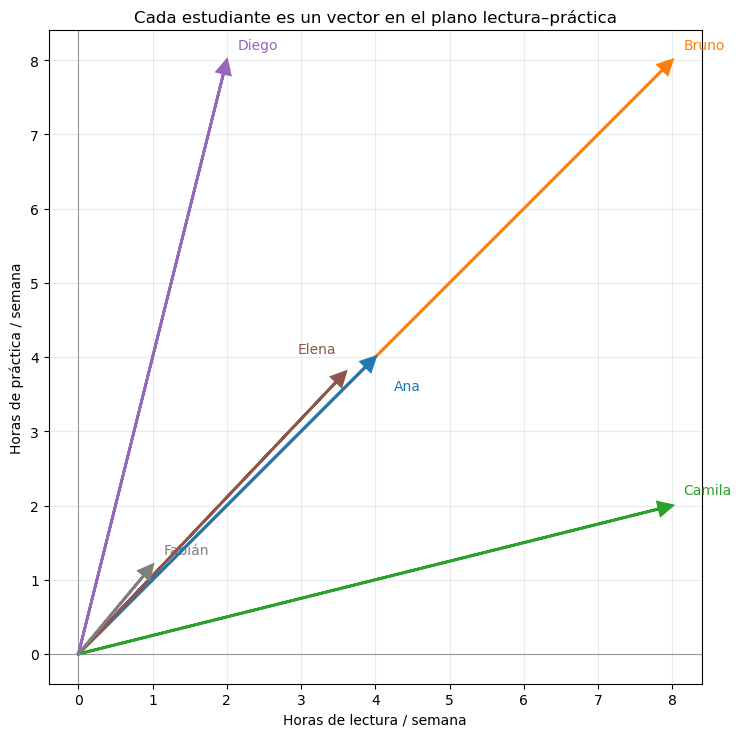
Cada fila \(\mathbf{x}_i\) se dibuja como una flecha desde el origen. El origen \((0,0)\) significa “cero horas de lectura y cero de práctica”: no es un estudiante real, es el ancla geométrica.
Pregunta guía (antes de ejecutar el gráfico): ¿qué flechas se ven sobre la misma recta? ¿cuáles apuntan a cuadrantes distintos aunque midan “muchas horas” en total?
graficar_vectores_2d( nombres, X,"Cada estudiante es un vector en el plano lectura–práctica",)print("Normas (longitud de cada flecha):")for nombre, vec inzip(nombres, X):print(f" {nombre:8s} ||x|| = {np.linalg.norm(vec):.3f} x = {vec}")
Normas (longitud de cada flecha):
  Ana       ||x|| = 5.657   x = [4. 4.]
  Bruno     ||x|| = 11.314   x = [8. 8.]
  Camila    ||x|| = 8.246   x = [8. 2.]
  Diego     ||x|| = 8.246   x = [2. 8.]
  Elena     ||x|| = 5.235   x = [3.6 3.8]
  Fabián    ||x|| = 1.562   x = [1.  1.2]
Después del gráfico. Ana y Bruno están sobre la misma semirrecta: \(8,8 = 2\times(4,4)\). Camila y Diego tienen longitudes parecidas entre sí, pero ángulos distintos. Elena casi coincide con Ana. Fabián apunta cerca de Ana y Bruno, pero es corto.
Vectorizar no añade información nueva; cambia la pregunta: ya no es “cuál es la media de lectura”, sino “dónde está esta observación en el espacio y a quién se parece”.
Reto técnico
Sin usar el gráfico, decide si np.array([6.0, 6.0]) quedaría sobre la recta de Ana–Bruno. Luego compruébalo: su coseno con Ana debe ser \(1\).
Etapa 3: Producto punto
Idea central. El producto punto resume, en un solo número, cuánto se empujan dos vectores en la misma dirección.
Cálculo coordenado para Ana \(\mathbf{a}=(4,4)\) y Bruno \(\mathbf{b}=(8,8)\):
Si \(\cos\theta=1\) (misma dirección), el producto punto es exactamente el producto de las longitudes.
Conexión con ML: el producto punto reaparece en proyección, en la capa lineal de una red ($ + b $) y en la atención de transformers. Aquí se queda en su versión descriptiva.
def producto_punto(a, b):returnfloat(np.dot(a, b))ana, bruno, camila = X[0], X[1], X[2]print("A mano (Ana · Bruno):", 4*8+4*8)print("NumPy (Ana · Bruno):", producto_punto(ana, bruno))print("Ana · Camila:", producto_punto(ana, camila))print("Ana · Diego :", producto_punto(ana, X[3]))print()print("Verificación geométrica Ana · Bruno:")na, nb = np.linalg.norm(ana), np.linalg.norm(bruno)print(f" ||Ana|| = {na:.4f}, ||Bruno|| = {nb:.4f}")print(f" ||Ana|| × ||Bruno|| × cos(0) = {na * nb *1:.4f}")print()print("Matriz de Gram G = X Xᵀ (producto interno entre cada par de estudiantes):")G = X @ X.Tgram = pd.DataFrame(np.round(G, 2), index=nombres, columns=nombres)display(gram)print("La diagonal de G son las normas al cuadrado: ||x_i||².")print("Diagonal:", np.round(np.diag(G), 2))
A mano (Ana · Bruno): 64
NumPy  (Ana · Bruno): 64.0
Ana · Camila: 40.0
Ana · Diego : 40.0

Verificación geométrica Ana · Bruno:
  ||Ana|| = 5.6569, ||Bruno|| = 11.3137
  ||Ana|| × ||Bruno|| × cos(0) = 64.0000

Matriz de Gram G = X Xᵀ  (producto interno entre cada par de estudiantes):
Ana
Bruno
Camila
Diego
Elena
Fabián
Ana
32.0
64.0
40.0
40.0
29.60
8.80
Bruno
64.0
128.0
80.0
80.0
59.20
17.60
Camila
40.0
80.0
68.0
32.0
36.40
10.40
Diego
40.0
80.0
32.0
68.0
37.60
11.60
Elena
29.6
59.2
36.4
37.6
27.40
8.16
Fabián
8.8
17.6
10.4
11.6
8.16
2.44
La diagonal de G son las normas al cuadrado: ||x_i||².
Diagonal: [ 32.   128.    68.    68.    27.4    2.44]
Interpretación. Ana·Bruno \(=64\) es grande porque están alineados y Bruno es largo. Ana·Camila \(=40\) es menor: Camila también “tiene horas”, pero parte de su vector apunta a un eje que Ana no comparte tanto. El producto punto mezcla tamaño y ángulo; por eso no basta para decir “se parecen” si las normas difieren.
La matriz de Gram\(G=XX^{\top}\) concentra todos los productos internos. \(G_{ik}=\mathbf{x}_i\cdot\mathbf{x}_k\). En la diagonal aparecen \(\|\mathbf{x}_i\|^2\). Es el objeto algebraico que luego reaparece en kernel methods. Su “pariente” \(X^{\top}X\) (\(p\times p\)) compara columnas en lugar de filas: con las columnas centradas y dividido por \(n-1\), es la matriz de covarianzas que usa PCA en la Sesión 7.
Etapa 4: Norma — el tamaño del perfil
Idea central. La norma euclidiana responde qué tan largo es el vector, no hacia dónde va.
\[ \|\mathbf{x}\|_2 = \sqrt{x_1^2 + x_2^2} \]
Ana: \(\sqrt{16+16}=\sqrt{32}\approx 5.66\). Bruno: \(\sqrt{64+64}=\sqrt{128}\approx 11.31\), el doble.
Dos vectores pueden tener la misma norma y direcciones opuestas en el trade-off lectura/práctica (Camila frente a Diego, aproximadamente).
Además de \(L_2\), la norma \(L_1\) suma valores absolutos:
\[ \|\mathbf{x}\|_1 = \sum_{j=1}^{p}|x_j| \]
\(L_2\) penaliza más las coordenadas grandes (por el cuadrado). \(L_1\) trata cada unidad por igual. En regularización, \(L_2\) (Ridge) encoge coeficientes; \(L_1\) (Lasso) favorece ceros.
Norma a mano (Ana): 5.656854249492381
Norma NumPy  (Ana): 5.656854249492381 | función propia: 5.656854249492381

Ana       norma = 5.657
Bruno     norma = 11.314
Camila    norma = 8.246
Diego     norma = 8.246
Elena     norma = 5.235
Fabián    norma = 1.562

Camila y Diego (normas parecidas, direcciones distintas):
  Camila [8. 2.] norma 8.246211251235321
  Diego  [2. 8.] norma 8.246211251235321

nombre    L2      L1      L1/L2
Ana        5.657   8.000   1.414
Bruno     11.314  16.000   1.414
Camila     8.246  10.000   1.213
Diego      8.246  10.000   1.213
Elena      5.235   7.400   1.414
Fabián     1.562   2.200   1.408
Después de los números. Bruno no es “otro tipo de estudiante”: es el mismo perfil, más intenso. Fabián sí comparte dirección con Ana, pero su norma es pequeña. Si un modelo usa solo la distancia euclidiana, Fabián puede quedar lejos de Ana aunque apunte igual. Esa distinción se vuelve precisa en las dos etapas siguientes.
Conexión con ML: regularización \(L_2\), normalización de embeddings y weight decay hablan de esta misma longitud.
Camila y Diego empatan en \(L_2\) y también en \(L_1\) (\(8+2=10\)): aquí el contraste no está en el tamaño, está en la dirección.
Etapa 5: Vector unitario y Cauchy–Schwarz
El vector unitario de \(\mathbf{a}\) es \(\hat{\mathbf{a}}=\mathbf{a}/\|\mathbf{a}\|\). Dos vectores en la misma semirrecta —Ana y Bruno— deben producir el mismo unitario.
Cauchy–Schwarz afirma \(|\mathbf{a}\cdot\mathbf{b}|\le\|\mathbf{a}\|\,\|\mathbf{b}\|\). El cociente es exactamente \(|\cos\theta|\). La igualdad vale cuando un vector es múltiplo del otro.
Antes de ejecutar: el unitario de Ana y el de Bruno deben coincidir; el de Camila, no. El valor \(|\mathbf{a}\cdot\mathbf{b}|/\|\mathbf{a}\|\|\mathbf{b}\|\) no puede superar \(1\).
def unitario(v): v = np.asarray(v, dtype=float) n = np.linalg.norm(v)if n ==0:raiseValueError("el vector nulo no tiene dirección")return v / nprint("Vectores unitarios (deben tener norma 1):")for nombre, vec inzip(nombres, X): u = unitario(vec)print(f" {nombre:8s} û = {np.round(u, 4)} ||û|| = {np.linalg.norm(u):.6f}")print()print("¿Ana y Bruno comparten dirección? ||û_Ana − û_Bruno|| =", np.linalg.norm(unitario(X[0]) - unitario(X[1])))print("¿Ana y Camila comparten dirección? ||û_Ana − û_Camila|| =", np.linalg.norm(unitario(X[0]) - unitario(X[2])))print()print("Cauchy–Schwarz: |a·b| ≤ ||a|| ||b||")pares = [("Ana", "Bruno", X[0], X[1]), ("Ana", "Camila", X[0], X[2]), ("Camila", "Diego", X[2], X[3])]for na, nb, a, b in pares: izq =abs(np.dot(a, b)) der = np.linalg.norm(a) * np.linalg.norm(b)print(f" {na}–{nb}: {izq:.4f} ≤ {der:.4f} holgura = {der - izq:.4f}")
Vectores unitarios (deben tener norma 1):
  Ana       û = [0.7071 0.7071]   ||û|| = 1.000000
  Bruno     û = [0.7071 0.7071]   ||û|| = 1.000000
  Camila    û = [0.9701 0.2425]   ||û|| = 1.000000
  Diego     û = [0.2425 0.9701]   ||û|| = 1.000000
  Elena     û = [0.6877 0.726 ]   ||û|| = 1.000000
  Fabián    û = [0.6402 0.7682]   ||û|| = 1.000000

¿Ana y Bruno comparten dirección?  ||û_Ana − û_Bruno|| = 0.0
¿Ana y Camila comparten dirección? ||û_Ana − û_Camila|| = 0.533867163791623

Cauchy–Schwarz: |a·b|  ≤  ||a|| ||b||
  Ana–Bruno:  64.0000  ≤  64.0000   holgura = 0.0000
  Ana–Camila:  40.0000  ≤  46.6476   holgura = 6.6476
  Camila–Diego:  32.0000  ≤  68.0000   holgura = 36.0000
Lectura. Ana y Bruno tienen holgura \(0\): son el caso de igualdad, \(\hat{\mathbf{a}}=\hat{\mathbf{b}}\). Camila–Diego dejan holgura positiva: no son múltiplos. El unitario es la versión académica de “quitar la norma”; el coseno es el producto punto de dos unitarios:
Mide el segmento que une dos puntos, no el ángulo entre flechas.
Pregunta guía (antes de los números): ¿quién debería quedar más cerca de Ana — Bruno (misma dirección, el doble de horas) o Elena (casi el mismo punto)?
def distancia_euclidiana(a, b):returnfloat(np.linalg.norm(np.asarray(a) - np.asarray(b)))print("Distancia a Ana")d_ana = []for nombre, vec inzip(nombres, X): d = distancia_euclidiana(ana, vec) d_ana.append(d)print(f" {nombre:8s} d = {d:.3f}")orden = np.argsort(d_ana)print()print("Ranking (más cercana → más lejana):")for k, idx inenumerate(orden, start=1):if nombres[idx] =="Ana":continueprint(f" {k-1}. {nombres[idx]:8s} d = {d_ana[idx]:.3f}")
Distancia a Ana
  Ana       d = 0.000
  Bruno     d = 5.657
  Camila    d = 4.472
  Diego     d = 4.472
  Elena     d = 0.447
  Fabián    d = 4.104

Ranking (más cercana → más lejana):
  1. Elena     d = 0.447
  2. Fabián    d = 4.104
  3. Camila    d = 4.472
  4. Diego     d = 4.472
  5. Bruno     d = 5.657
Interpretación. Elena gana de lejos: está a décimas de Ana. Bruno, pese a ser “el mismo perfil”, queda el más lejano de todos (5.66), más que Camila, Diego y Fabián, porque el doble de horas lo desplaza por el plano. La euclidiana penaliza la diferencia de intensidad.
Conexión con ML: un 1-NN euclidiano diría que el vecino de Ana es Elena, no Bruno. Eso puede ser correcto si “parecido” significa mismas horas, e incorrecto si significa misma receta de hábitos.
Etapa 7: Similitud coseno — y el contraste que importa
Idea central (el contraste de esta sesión). Ana y Bruno tienen \(\cos\theta = 1\) y, al mismo tiempo, una distancia euclidiana grande. Misma historia, dos métricas.
Pregunta guía (antes de ejecutar): si ordenas a los compañeros de Ana por coseno, ¿Bruno sube al primer lugar? ¿Fabián, tan corto, queda alto o bajo?
def similitud_coseno(a, b): a = np.asarray(a, dtype=float) b = np.asarray(b, dtype=float) denom = np.linalg.norm(a) * np.linalg.norm(b)if denom ==0:return np.nanreturnfloat(np.dot(a, b) / denom)print("Coseno con Ana")c_ana = []for nombre, vec inzip(nombres, X): c = similitud_coseno(ana, vec) c_ana.append(c)print(f" {nombre:8s} cos = {c:.4f}")print()print("Verificación Ana–Bruno (deben ser 1):", similitud_coseno(ana, bruno))print("Ángulo Ana–Bruno (grados):", np.degrees(np.arccos(np.clip(similitud_coseno(ana, bruno), -1, 1))))print("Ángulo Ana–Camila (grados):", np.degrees(np.arccos(np.clip(similitud_coseno(ana, camila), -1, 1))))tabla = pd.DataFrame( {"distancia_a_Ana": d_ana,"coseno_con_Ana": c_ana, }, index=nombres,)print()display(tabla.round(3))
Coseno con Ana
  Ana       cos = 1.0000
  Bruno     cos = 1.0000
  Camila    cos = 0.8575
  Diego     cos = 0.8575
  Elena     cos = 0.9996
  Fabián    cos = 0.9959

Verificación Ana–Bruno (deben ser 1): 0.9999999999999998
Ángulo Ana–Bruno (grados): 1.2074182697257333e-06
Ángulo Ana–Camila (grados): 30.963756532073536
distancia_a_Ana
coseno_con_Ana
Ana
0.000
1.000
Bruno
5.657
1.000
Camila
4.472
0.857
Diego
4.472
0.857
Elena
0.447
1.000
Fabián
4.104
0.996
Después de la tabla. Bruno empataría el primer lugar en coseno (con Ana misma) y queda lejos en distancia. Fabián, de norma chica, sí se parece en dirección a Ana: el coseno lo reconoce; la euclidiana lo aleja. Camila y Diego se separan de Ana en ángulo: el coseno baja aunque “sumen muchas horas”.
Ese es el análogo geométrico de “misma media, distinta dispersión” (Sesiones 2–4): el mismo par de personas, dos conclusiones.
Reto técnico
Calcula a mano el coseno entre Camila \((8,2)\) y Diego \((2,8)\). Interpreta el resultado en una frase: ¿comparten intensidad, dirección, ambas o ninguna?
Etapa 8: Ortogonalidad y proyección
Un par es ortogonal si su producto punto es cero. En el plano, \((1,0)\) y \((0,1)\) son el ejemplo canónico. Camila \((8,2)\) no es ortogonal a Diego \((2,8)\): \(16+16=32\neq 0\). Sí se puede construir un perfil ortogonal a Ana\((4,4)\): por ejemplo \(\mathbf{v}=(4,-4)\), porque \(16-16=0\).
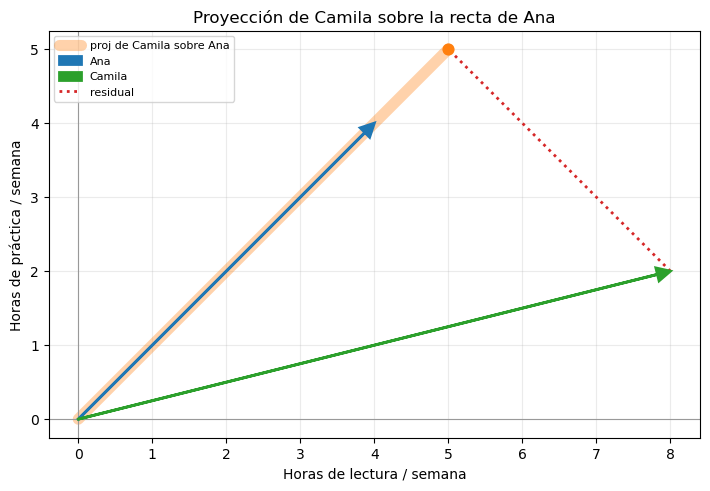
La proyección de Camila sobre la recta de Ana responde: si el único eje permitido fuera “equilibrio lectura–práctica”, ¿qué parte del perfil de Camila quedaría?
Antes del gráfico: el residual debe ser perpendicular a Ana (producto punto \(\approx 0\)).
ana, camila = X[0], X[2]ortogonal_a_ana = np.array([4.0, -4.0])print("Ana · (4, −4) =", np.dot(ana, ortogonal_a_ana), " (ortogonal si es 0)")print("Camila · Diego =", np.dot(X[2], X[3]), " (no son ortogonales)")proj, residual = graficar_proyeccion( camila, ana, "Camila", "Ana","Proyección de Camila sobre la recta de Ana",)print("proj_Ana(Camila) =", np.round(proj, 4))print("residual =", np.round(residual, 4))print("Ana · residual =", np.round(np.dot(ana, residual), 10), " (debe ser ~0)")print("Teorema de Pitágoras: ||Camila||² = ||proj||² + ||residual||²")print(" ", np.dot(camila, camila), "=", np.dot(proj, proj) + np.dot(residual, residual))
Ana · (4, −4) = 0.0   (ortogonal si es 0)
Camila · Diego = 32.0   (no son ortogonales)
proj_Ana(Camila) = [5. 5.]
residual         = [ 3. -3.]
Ana · residual   = 0.0   (debe ser ~0)
Teorema de Pitágoras: ||Camila||² = ||proj||² + ||residual||²
   68.0 = 68.0
Después del gráfico. La flecha punteada es lo que Ana “explica” de Camila: la componente alineada con el perfil equilibrado. El residual (puntos) es el exceso de lectura frente a práctica. Como \(\mathbf{a}\cdot\mathrm{residual}=0\), esa parte no se ve desde la recta de Ana.
En un modelo lineal, el residual es el error; en PCA, con los datos centrados (restando la media de cada columna), se elige el eje que maximiza la norma de las proyecciones, es decir, la varianza proyectada.
Etapa 9: Interpretación geométrica conjunta
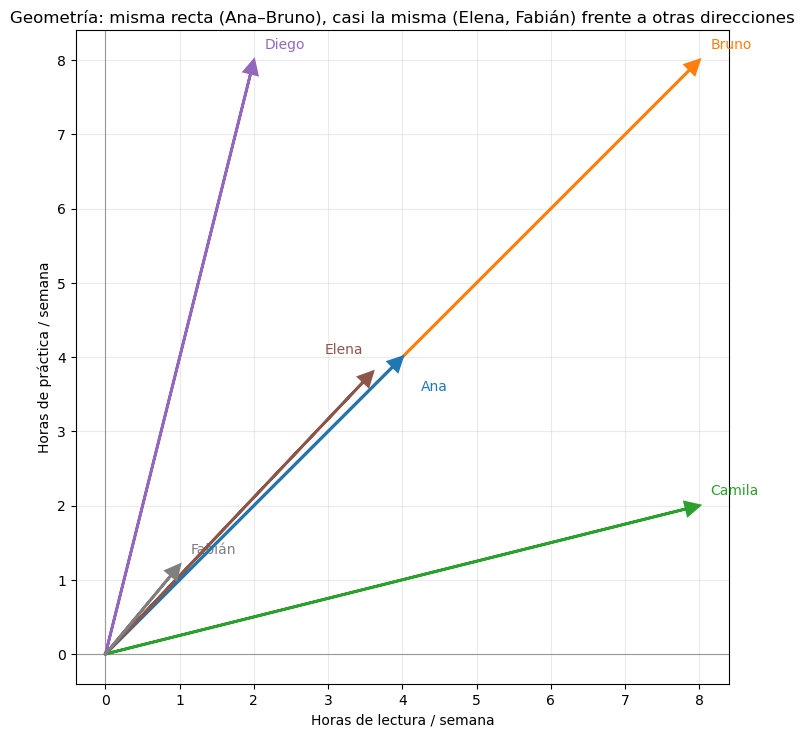
Se dibujan de nuevo las flechas y se resume el diccionario visual: longitud = norma, apertura = ángulo, segmento entre puntas = distancia.
graficar_vectores_2d( nombres, X,"Geometría: misma recta (Ana–Bruno), casi la misma (Elena, Fabián) frente a otras direcciones",)resumen = pd.DataFrame( {"par": ["Ana–Bruno", "Ana–Elena", "Ana–Fabián", "Ana–Camila", "Camila–Diego"],"euclidiana": [ distancia_euclidiana(X[0], X[1]), distancia_euclidiana(X[0], X[4]), distancia_euclidiana(X[0], X[5]), distancia_euclidiana(X[0], X[2]), distancia_euclidiana(X[2], X[3]), ],"coseno": [ similitud_coseno(X[0], X[1]), similitud_coseno(X[0], X[4]), similitud_coseno(X[0], X[5]), similitud_coseno(X[0], X[2]), similitud_coseno(X[2], X[3]), ],"lectura": ["Misma dirección; distinta intensidad","Cercanos en el plano","Casi la misma dirección; Fabián es corto","Ángulo abierto; Camila es lectora","Trade-off opuesto lectura/práctica", ], })display(resumen.round(3))
par
euclidiana
coseno
lectura
0
Ana–Bruno
5.657
1.000
Misma dirección; distinta intensidad
1
Ana–Elena
0.447
1.000
Cercanos en el plano
2
Ana–Fabián
4.104
0.996
Casi la misma dirección; Fabián es corto
3
Ana–Camila
4.472
0.857
Ángulo abierto; Camila es lectora
4
Camila–Diego
8.485
0.471
Trade-off opuesto lectura/práctica
Cómo leer la tabla. Si la pregunta es “¿quién estudia como Ana, aunque sea más o menos horas?”, mira el coseno. Si la pregunta es “¿quién tiene una carga horaria parecida a la de Ana?”, mira la euclidiana. No hay métrica universalmente mejor: hay pregunta.
Conexión con ML: en búsqueda de documentos, dos textos del mismo tema y distinta longitud suelen recuperarse mejor por coseno. En un sensor industrial, dos lecturas “parecidas en valor absoluto” suelen pedirse en distancia (tras escalar).
Etapa 10: La escala de las features cambia el espacio
Se añade una columna en otra unidad: minutos de pantalla al día. Los hábitos de Ana y Elena siguen cerca en horas; Fabián, que apenas se mueve en el plano original, ahora tiene \(240\) minutos. Sin escalar, esa columna domina la distancia.
Pregunta guía: ¿sigue Elena siendo la más cercana a Ana cuando entra minutos_pantalla sin estandarizar?
minutos_pantalla = np.array([90.0, 95.0, 80.0, 85.0, 88.0, 240.0])X_crudo = np.column_stack([X, minutos_pantalla])df_crudo = pd.DataFrame( X_crudo, columns=["horas_lectura", "horas_practica", "minutos_pantalla"], index=nombres,)print("X sin escalar (unidades mezcladas):")display(df_crudo)print("Distancia euclidiana a Ana en R^3 sin escalar")d_crudo = [distancia_euclidiana(X_crudo[0], fila) for fila in X_crudo]for nombre, d inzip(nombres, d_crudo):print(f" {nombre:8s} d = {d:.3f}")# Estandarización: (x - media) / desv. de cada columna (estadísticos del conjunto)medias = X_crudo.mean(axis=0)desv = X_crudo.std(axis=0, ddof=1)X_std = (X_crudo - medias) / desvprint()print("Distancia euclidiana a Ana después de estandarizar columnas")d_std = [distancia_euclidiana(X_std[0], fila) for fila in X_std]for nombre, d inzip(nombres, d_std):print(f" {nombre:8s} d = {d:.3f}")
X sin escalar (unidades mezcladas):
horas_lectura
horas_practica
minutos_pantalla
Ana
4.0
4.0
90.0
Bruno
8.0
8.0
95.0
Camila
8.0
2.0
80.0
Diego
2.0
8.0
85.0
Elena
3.6
3.8
88.0
Fabián
1.0
1.2
240.0
Distancia euclidiana a Ana en R^3 sin escalar
  Ana       d = 0.000
  Bruno     d = 7.550
  Camila    d = 10.954
  Diego     d = 6.708
  Elena     d = 2.049
  Fabián    d = 150.056

Distancia euclidiana a Ana después de estandarizar columnas
  Ana       d = 0.000
  Bruno     d = 1.926
  Camila    d = 1.521
  Diego     d = 1.532
  Elena     d = 0.155
  Fabián    d = 2.779
Interpretación. Sin escalar, Fabián se vuelve un extremo: \(240\) minutos pesan más que las horas de estudio. Tras estandarizar, cada feature aporta en unidades de desviación estándar y el vecindario de Ana deja de estar secuestrado por una sola columna.
El coseno tampoco salva este problema por sí solo: es invariante si multiplicas el vector entero por una constante, no si una coordenada vive en otra escala.
Conexión con ML: escalar no es cosmética. Es decidir que “1 hora de lectura” y “1 minuto de pantalla” no merecen el mismo voto en la distancia.
Etapa 11: Ejemplo final — el vecino de una consulta
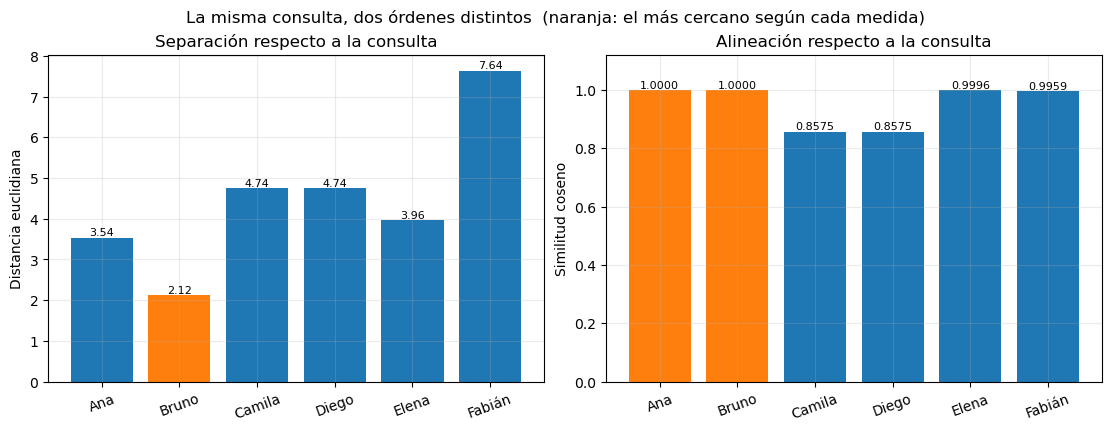
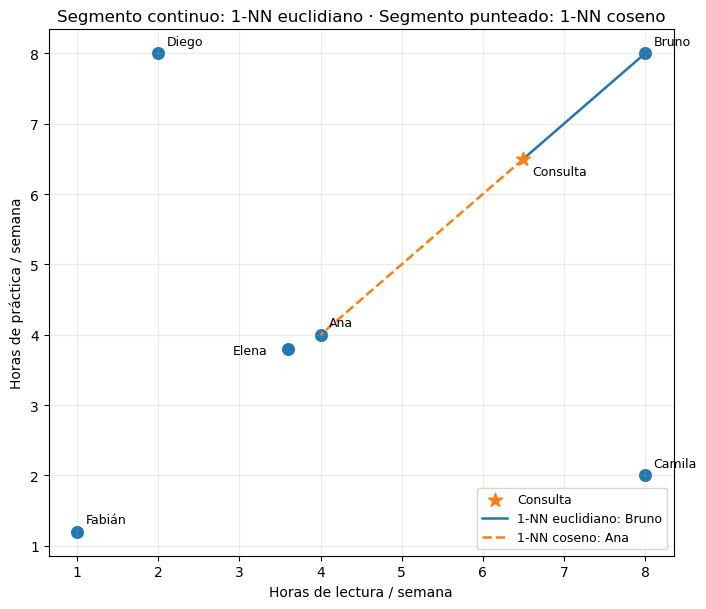
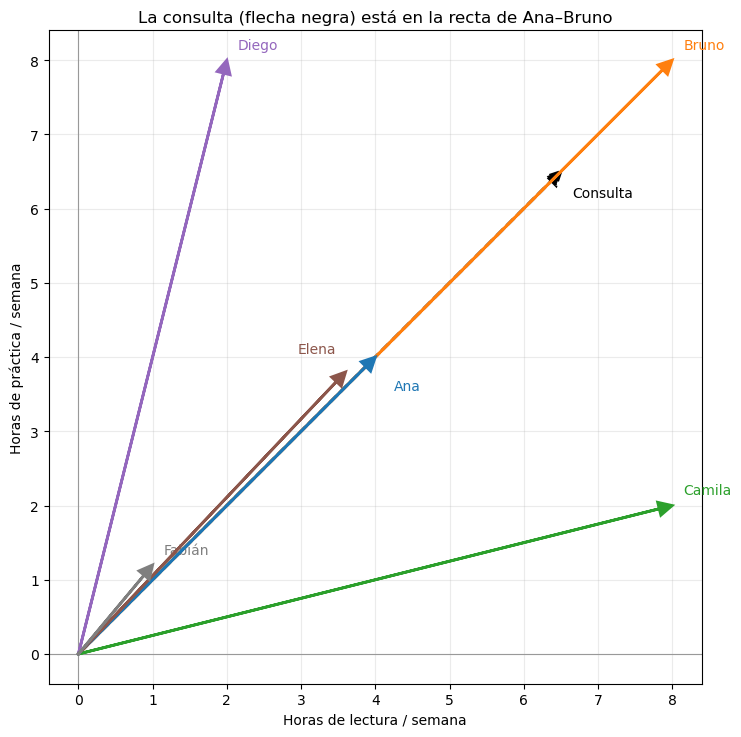
Llega un estudiante nuevo, la consulta\(\mathbf{q}=(6.5,\,6.5)\): misma dirección que Ana y Bruno, magnitud más cercana a Bruno. Se elige el vecino más cercano sin incluir a la consulta en \(X\), una vez por euclidiana y una vez por coseno.
Antes de ejecutar: ¿quién gana por distancia? ¿quién gana por ángulo? ¿pueden ser personas distintas?
consulta = np.array([6.5, 6.5])d_q = np.array([distancia_euclidiana(consulta, fila) for fila in X])c_q = np.array([similitud_coseno(consulta, fila) for fila in X])idx_euc =int(np.argmin(d_q))idx_cos =int(np.argmax(c_q))print("Consulta q =", consulta)print()print("Ranking euclidiano (menor distancia):")for idx in np.argsort(d_q):print(f" {nombres[idx]:8s} d = {d_q[idx]:.3f}")print("Vecino 1-NN euclidiano:", nombres[idx_euc])print()print("Ranking coseno (mayor similitud):")for idx in np.argsort(-c_q):print(f" {nombres[idx]:8s} cos = {c_q[idx]:.4f}")print("Vecino 1-NN coseno:", nombres[idx_cos])graficar_barras_metricas( nombres, d_q, c_q,"La misma consulta, dos órdenes distintos",)graficar_puntos_y_consulta( nombres, X, consulta, [(idx_euc, "-", f"1-NN euclidiano: {nombres[idx_euc]}"), (idx_cos, "--", f"1-NN coseno: {nombres[idx_cos]}")],"Segmento continuo: 1-NN euclidiano · Segmento punteado: 1-NN coseno",)graficar_vectores_2d( nombres, X,"La consulta (flecha negra) está en la recta de Ana–Bruno", query=consulta,)
Consulta q = [6.5 6.5]

Ranking euclidiano (menor distancia):
  Bruno     d = 2.121
  Ana       d = 3.536
  Elena     d = 3.962
  Camila    d = 4.743
  Diego     d = 4.743
  Fabián    d = 7.638
Vecino 1-NN euclidiano: Bruno

Ranking coseno (mayor similitud):
  Ana       cos = 1.0000
  Bruno     cos = 1.0000
  Elena     cos = 0.9996
  Fabián    cos = 0.9959
  Camila    cos = 0.8575
  Diego     cos = 0.8575
Vecino 1-NN coseno: Ana
Después de los gráficos. La consulta está sobre la recta de Ana–Bruno, así que Ana y Bruno empatan en coseno (\(1\)). argmax devuelve el primero: Ana. En distancia, \((6.5,6.5)\) está más cerca de Bruno \((8,8)\) que de Ana \((4,4)\). Las dos métricas eligen personas distintas.
Si este fuera un sistema de recomendación o un KNN, la métrica es el modelo: cambia el vecino, cambia la predicción.
Reto técnico
Cambia la consulta a \((7.5,\,2.2)\) (perfil lector). Vuelve a calcular ambos rankings. ¿El 1-NN euclidiano y el 1-NN coseno coinciden? Escribe en dos líneas qué política de “parecido” estarías usando en cada caso.
Errores que conviene nombrar
Meter el objetivo \(y\) dentro de \(X\). Cambia la geometría y filtra la respuesta hacia las features.
Leer el producto punto como similitud. Mezcla tamaño y ángulo: un vector largo “se parece” a todos.
Usar distancia euclidiana cuando la pregunta es la dirección (o coseno cuando importa la magnitud).
Medir distancias con columnas en unidades distintas. La columna de mayor rango decide quién es vecino.
Creer que el coseno corrige la escala. Es invariante a escalar el vector entero, no una sola coordenada.
Calcular el coseno con un vector nulo. No tiene dirección; el cociente no está definido.
Olvidar el empate. Con dos vecinos a igual similitud, argmax elige el primero: el resultado depende del orden de las filas.
Idea clave
La lección no es memorizar cuatro fórmulas. Es reconocer que, al vectorizar, se elige un espacio —y en ese espacio “cerca” no es un hecho, es una definición. Reportar solo \(d\) o solo \(\cos\theta\) sin decir qué pregunta se responde deja la geometría a medias.
En producción, esa definición tiene consecuencias: un buscador por coseno agrupa temas; un detector de anomalías por distancia (bien escalada) agrupa magnitudes; un pipeline sin escalar deja que la columna más ancha decida.
Síntesis de la sesión
Se pasó de la tabla a \(X\in\mathbb{R}^{n\times p}\), de la fila al vector, y de un número suelto a dos geometrías distintas: longitud (norma, distancia) y orientación (producto punto, coseno). El contraste Ana–Bruno concentra la idea; el 1-NN muestra por qué la métrica importa antes de entrenar.
PCA: nuevas direcciones en el mismo espacio.
KNN y clustering: vecindarios que heredan la métrica elegida.
Regularización y embeddings: normas y ángulos como piezas de modelo, no solo de EDA.
Quedó también el andamiaje algebraico: Cauchy–Schwarz acota el coseno, el unitario separa dirección de magnitud, y la proyección parte un vector en una componente explicada y un residual ortogonal.
6. Guía rápida: ¿qué medida usar?
Situación
Medida principal
Justificación
Guardar el dataset para un modelo
Matriz \(X\), vector \(y\)
Es el contrato de entrada de casi cualquier fit
¿Qué tan intenso es un perfil?
Norma
Longitud; no informa dirección
¿Dos perfiles apuntan igual?
Coseno
Invariante a escalar el vector completo
¿Dos observaciones están cerca en valor?
Distancia euclidiana
Penaliza magnitud y dirección
Features en unidades distintas
Estandarizar, luego distancia
Si no, gana la columna de mayor rango
Texto, embeddings, tema compartido
Coseno
La longitud del documento no debería decidir
Proyección, capa lineal, “alineación”
Producto punto
Mezcla norma y ángulo; hay que leerlo con cuidado
¿Un vector es múltiplo de otro?
Cauchy–Schwarz (holgura \(0\))
Igualdad \(\Leftrightarrow\) dependencia lineal
Quitar la intensidad, dejar la dirección
Vector unitario
\(\hat{x}=x/\|x\|\); el coseno es \(\hat{a}\cdot\hat{b}\)
¿Qué parte de A vive en la recta de B?
Proyección ortogonal
Residual \(\perp\) a la dirección de referencia
Regla de comunicación: indicar las variables que entran a \(X\), la métrica y si hubo escalamiento.
7. Guía práctica para reportar la geometría
Paso 1: identificar el espacio
Nombra las features, \(n\), \(p\) y las unidades. Separa \(y\) si existe.
Paso 2: calcular las medidas
Normas de los casos que importan; distancia y coseno del par (o del vecindario) que responde la pregunta.
Paso 3: comparar e interpretar
Si distancia y coseno ordenan distinto, dilo. Esa discrepancia es el hallazgo.
Paso 4: revisar escala
Si una columna tiene otro rango, reporta también la versión estandarizada.
Paso 5: redactar el reporte
“En el espacio [features], [caso A] y [caso B] tienen distancia ___ y coseno ___. Se reporta [métrica] porque [pregunta]. Implicación para el modelo: [KNN/embeddings/escalar].”
Ejemplo aplicado:“En el espacio (horas de lectura, horas de práctica), Ana y Bruno tienen distancia 5.66 y coseno 1.00. Se reporta el coseno porque la pregunta es quién estudia con la misma proporción de lectura y práctica, no quién dedica las mismas horas. Implicación para el modelo: un recomendador de rutinas debería usar coseno; un KNN que prediga la puntuación debería usar distancia, porque la cantidad de horas sí cambia el resultado.”
8. Puente hacia las siguientes sesiones
El espacio \(\mathbb{R}^p\) ya está nombrado: cada fila es un vector, con norma y dirección.
Lo que sigue es comprimir ese espacio: PCA busca ejes nuevos que conserven la mayor varianza posible. Sin norma, dirección y escala, PCA se reduce a una caja negra de sklearn.
9. Cierre
Este notebook deja una base aplicada sobre representación vectorial:
el dataset como matriz \(X\) y el objetivo como \(y\),
la fila como vector, con norma y dirección,
producto punto, matriz de Gram, normas \(L_1\) y \(L_2\),
vector unitario, Cauchy–Schwarz, ortogonalidad y proyección,
distancia euclidiana y similitud coseno,
el contraste “misma dirección, distinta magnitud”,
el efecto de mezclar escalas,
un 1-NN que cambia de vecino al cambiar de métrica.
Resultado esperado: el estudiante puede escribir \(X\), dibujar dos perfiles y justificar si “parecido” debe medirse en distancia o en ángulo —antes de entrenar.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.