Estadística para IA — 7. Reducción de dimensionalidad (PCA)

estadistica
pca
dimensionalidad
Alta dimensionalidad, centrado, covarianza, componentes principales, varianza explicada, proyección, reconstrucción e interpretación geométrica de PCA, a mano y con scikit-learn.
Author

Wilder Ramírez Delgado

Published

September 25, 2026

Sesión 7 — Reducción de Dimensionalidad (PCA)

Open in Colab

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Reducción de Dimensionalidad con PCA

Diez columnas no son diez historias. A menudo dos o tres direcciones bastan para describir la nube; el resto es ruido, redundancia o una escala mal elegida. PCA (análisis de componentes principales) busca esos ejes: los de máxima varianza, ortogonales entre sí y ordenados de mayor a menor.

Este notebook construye PCA desde la geometría. No parte de sklearn.decomposition.PCA sin mostrar el cálculo. Primero se ve por qué, con muchas variables, los puntos quedan aislados y con mucho vacío entre ellos; después, por qué hay que centrar; cómo la covarianza describe la forma de la nube; cómo un autovector se convierte en componente; cuánta varianza se conserva; cómo proyectar y reconstruir; y, al final, cuándo maximizar varianza es la pregunta equivocada.

Los datos son sintéticos y diseñados: una elipse, un plano en 3D, hábitos con dos factores latentes, una columna que, si no se escala, se queda con el primer componente, y un caso en el que la clase vive en la dirección delgada.

Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 2 · Sesión 7

Objetivos

  • Explicar el problema de la alta dimensionalidad (mucho vacío entre puntos; “el más cercano” deja de ser informativo).
  • Justificar el centrado y leer la matriz de covarianza como forma de la nube.
  • Formular PCA como un problema de máxima varianza con restricción \(\|\mathbf{w}\|=1\).
  • Obtener componentes principales por descomposición espectral y por SVD.
  • Calcular e interpretar varianza explicada, scree y varianza acumulada.
  • Proyectar observaciones, reconstruir y medir el error en función de \(k\).
  • Reproducir el mismo resultado con scikit-learn (incluido el signo arbitrario del eje).
  • Decidir cuándo estandarizar y cómo leer cargas (loadings).
  • Distinguir varianza de utilidad predictiva: cuándo PCA no es el método.

Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.

1. El problema y la solución, en el lenguaje del álgebra

1.1 Alta dimensionalidad

Sea \(X\in\mathbb{R}^{n\times p}\) la matriz de datos: \(n\) observaciones, \(p\) variables. Cada fila es un punto en \(\mathbb{R}^p\). Cuando \(p\) crece y \(n\) no crece al mismo ritmo ocurren tres fenómenos prácticos:

  1. Volumen: si fijas un radio, casi no cabe nadie: el espacio “se agranda” más rápido que el número de observaciones. Los puntos se alejan.
  2. Distancias: las distancias entre pares se parecen entre sí; el contraste entre “cerca” y “lejos” se comprime. KNN y el clustering por distancia dejan de distinguir bien quién está cerca.
  3. Redundancia: muchas columnas miden, con ruido, las mismas pocas causas. El rango efectivo de \(X\) es mucho menor que \(p\).

En dimensión alta las observaciones quedan aisladas, con mucho vacío entre ellas: hay tantas direcciones posibles que \(n\) puntos no alcanzan a llenarlas.

Reducir dimensión no es “borrar columnas al azar”. Es cambiar de base: pasar a un sistema de ejes donde las primeras coordenadas describen la forma de la nube y las últimas solo recogen una variación pequeña, casi ruido.

1.2 Qué pregunta responde PCA

PCA busca una dirección \(\mathbf{w}\in\mathbb{R}^p\), de norma \(1\), tal que la proyección de los datos centrados tenga varianza máxima:

\[ \max_{\mathbf{w}}\; \mathbf{w}^{\top}\Sigma\mathbf{w} \quad\text{sujeto a}\quad \mathbf{w}^{\top}\mathbf{w}=1. \]

\(\Sigma\) es la matriz de covarianzas muestral de las columnas:

\[ \Sigma = \frac{1}{n-1} X_c^{\top} X_c, \qquad X_c = X - \mathbf{1}\bar{\mathbf{x}}^{\top}. \]

El centrado \(X_c\) no es un detalle de implementación: PCA describe la nube alrededor de su centro de masa. Sin restar \(\bar{\mathbf{x}}\), el primer eje apuntaría hacia el origen del sistema de coordenadas, no hacia la dirección ancha de los datos.

1.3 La solución es un autovector

El lagrangiano de ese problema conduce a la ecuación espectral

\[ \Sigma\mathbf{w} = \lambda\mathbf{w}. \]

Los autovectores de \(\Sigma\) (ortonormales, porque \(\Sigma\) es simétrica y semidefinida positiva) son las componentes principales. El autovalor \(\lambda\) es la varianza de los datos proyectados sobre ese eje.

Se ordenan \(\lambda_1\ge\lambda_2\ge\cdots\ge\lambda_p\ge 0\). El primer componente \(\mathbf{w}_1\) es la dirección más ancha; \(\mathbf{w}_2\) es la más ancha entre las ortogonales a \(\mathbf{w}_1\); y así sucesivamente.

1.4 Varianza explicada

\[ \pi_k = \frac{\lambda_k}{\sum_{j=1}^{p}\lambda_j}, \qquad \Pi_k = \sum_{i=1}^{k}\pi_i. \]

\(\pi_k\) es la fracción de la varianza total que vive en el eje \(k\). \(\Pi_k\) es lo que se conserva al quedarse con los primeros \(k\) componentes. Un scree plot (autovalores frente a \(k\)) y la curva \(\Pi_k\) son las dos lecturas estándar para elegir \(k\). No hay umbral universal: \(80\%\) o \(90\%\) son convenciones; la pregunta de dominio manda.

1.5 Puntuaciones, cargas y reconstrucción

Sea \(W=(\mathbf{w}_1|\cdots|\mathbf{w}_p)\in\mathbb{R}^{p\times p}\) la matriz de autovectores. Las puntuaciones (scores) son las coordenadas en la nueva base:

\[ Z = X_c W. \]

Las cargas (loadings) son las entradas de \(W\) (o de \(W_k\sqrt{\lambda}\), según la convención): dicen cuánto aporta cada variable original a cada componente.

Si se retienen \(k<p\) ejes, \(W_k\) son las primeras \(k\) columnas y \(Z_k=X_c W_k\). La reconstrucción en el espacio original es

\[ \hat{X}^{(k)} = Z_k W_k^{\top} + \mathbf{1}\bar{\mathbf{x}}^{\top}. \]

El error \(\|X-\hat{X}^{(k)}\|_F^2\) es exactamente la suma de los autovalores no usados (salvo el factor \(n-1\)). Descartar un eje es descartar la varianza que había en esa dirección. Se hace a propósito: se sabe cuánto se pierde, porque ese monto es \(\lambda_{k+1}+\cdots+\lambda_p\).

1.6 SVD: la misma geometría, otra factorización

Si \(X_c=USV^{\top}\) es la descomposición en valores singulares,

\[ W=V, \qquad \lambda_j = \frac{s_j^2}{n-1}. \]

Eigendecomposición de \(\Sigma\) y SVD de \(X_c\) son dos caminos al mismo sistema de ejes. scikit-learn usa SVD internamente.

1.7 Geometría en una frase

PCA rota la nube para alinear los ejes coordenados con los ejes de la elipse de covarianza, ordena esos ejes por ancho y corta los más estrechos. No inventa variables mágicas: cambia de base y descarta coordenadas.

Pregunta Respuesta de PCA
¿Hacia dónde es ancha la nube? Primeros autovectores de \(\Sigma\)
¿Cuánto se conserva al bajar a \(k\) ejes? \(\Pi_k\)
¿Dónde está cada observación en esa base? Filas de \(Z_k\)
¿Qué variables originales empujan cada eje? Cargas (filas de \(W_k\))
¿Qué se perdió? Autovalores \(\lambda_{k+1}+\cdots+\lambda_p\)

2. Por qué importa en IA y Machine Learning

Un modelo lineal, un KNN o una red no “entienden” nombres de columnas: operan en un espacio. Si ese espacio tiene \(p\) grande, correlaciones fuertes y escalas distintas, el aprendizaje se encarece y se vuelve inestable.

  • Visualización. Proyectar a \(2\) o \(3\) componentes permite ver la nube que no cabe en un scatter de \(p\) ejes.
  • Compresión y ruido. Si las últimas componentes solo recogen variación mínima, descartarlas quita ruido.
  • Multicolinealidad. Predictores alineados hacen inestables los coeficientes; los PCs son ortogonales por construcción.
  • Preprocesamiento. Muchos flujos de modelado usan PCA como paso previo (con el riesgo de descartar la dirección que sí predice).

Idea central: PCA maximiza varianza, no relevancia para \(y\). Un eje de poca varianza puede separar dos clases; un eje de mucha varianza puede ser solo un efecto de las unidades. El método es poderoso cuando la pregunta es la forma de \(X\). Es peligroso cuando se usa como sustituto automático de la variable objetivo.

3. Flujo recomendado de trabajo

  1. Formular la pregunta. ¿Se quiere visualizar, comprimir, quitar ruido o preparar un modelo? PCA no responde “qué predice \(y\)” por sí solo.

  2. Inspeccionar unidades. Si las columnas no comparten escala, estandarizar antes. Si ya están en la misma unidad y la magnitud importa, no estandarizar por reflejo.

  3. Centrar siempre. Restar la media de cada columna. PCA sin centrar resuelve otro problema.

  4. Descomponer. Autovectores de \(\Sigma\) o SVD de \(X_c\). Ordenar por \(\lambda\) decreciente.

  5. Leer \(\pi_k\) y \(\Pi_k\). Scree y curva acumulada. Elegir \(k\) con un criterio explícito.

  6. Proyectar e interpretar cargas. \(Z_k\) son las nuevas coordenadas; \(W_k\) dice de qué están hechas.

  7. Reconstruir. Verificar qué patrón se perdió con \(k\) pequeño.

  8. Contrastar con el objetivo, si existe. Si hay \(y\), comprobar que la dirección útil no quedó en un PC descartado.

Criterio general: \(k\) es una decisión de modelado, no un número que el software “adivina”.

4. Preparar el entorno

%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D  # noqa: F401
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import pairwise_distances

rng = np.random.default_rng(42)
np.random.seed(42)

plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25

print("Entorno listo: numpy, pandas, matplotlib, scikit-learn.")
print("pandas:", pd.__version__, "| numpy:", np.__version__)
Python: 3.13.9
Entorno listo: numpy, pandas, matplotlib, scikit-learn.
pandas: 2.3.3 | numpy: 2.3.5

Funciones de visualización (definidas una sola vez)

Las figuras se definen aquí. Cada etapa solo llama a la función correspondiente.

def graficar_curse(ps, medias, contrastes):
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True)
    axes[0].plot(ps, medias, marker="o")
    axes[0].set_xlabel("Dimensión p")
    axes[0].set_ylabel("Distancia media entre pares")
    axes[0].set_title("Las distancias crecen con p")
    axes[1].plot(ps, contrastes, marker="o", color="C1")
    axes[1].set_xlabel("Dimensión p")
    axes[1].set_ylabel("(máx − mín) / media")
    axes[1].set_title("El contraste cerca/lejos se aplana")
    fig.suptitle("Alta dimensionalidad: n fijo, p creciente")
    plt.show()


def graficar_nube_2d(X, titulo, centro=None, clases=None, ejes=("x₁", "x₂")):
    fig, ax = plt.subplots(figsize=(6.6, 6.2))
    if clases is None:
        ax.scatter(X[:, 0], X[:, 1], s=18, alpha=0.65)
    else:
        for lab in np.unique(clases):
            m = clases == lab
            ax.scatter(X[m, 0], X[m, 1], s=18, alpha=0.7, label=f"Clase {lab}")
        ax.legend(fontsize=8)
    if centro is not None:
        ax.scatter(centro[0], centro[1], s=80, marker="x", zorder=3, label="centro")
    ax.set_aspect("equal", adjustable="box")
    ax.set_xlabel(ejes[0])
    ax.set_ylabel(ejes[1])
    ax.set_title(titulo)
    plt.tight_layout()
    plt.show()


def graficar_nube_con_pcs(Xc, W, lambdas, titulo, nombres_ejes=("x₁ centrada", "x₂ centrada")):
    fig, ax = plt.subplots(figsize=(6.8, 6.4))
    ax.scatter(Xc[:, 0], Xc[:, 1], s=16, alpha=0.55)
    escala = 2.4 * np.sqrt(lambdas)
    for j, color in enumerate(["C3", "C2"]):
        v = W[:, j] * escala[j]
        ax.arrow(0, 0, v[0], v[1], head_width=0.12, head_length=0.12,
                 length_includes_head=True, color=color, linewidth=2,
                 label=f"PC{j+1}  (λ={lambdas[j]:.2f})")
        ax.arrow(0, 0, -v[0], -v[1], head_width=0.08, head_length=0.08,
                 length_includes_head=True, color=color, linewidth=1.2, alpha=0.7)
    ax.axhline(0, color="0.6", linewidth=0.7)
    ax.axvline(0, color="0.6", linewidth=0.7)
    ax.set_aspect("equal", adjustable="box")
    ax.set_xlabel(nombres_ejes[0])
    ax.set_ylabel(nombres_ejes[1])
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_scree(lambdas, titulo="Varianza por componente"):
    p = len(lambdas)
    ks = np.arange(1, p + 1)
    pi = lambdas / lambdas.sum()
    acum = np.cumsum(pi)
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True)
    axes[0].bar(ks, lambdas)
    axes[0].plot(ks, lambdas, marker="o")
    axes[0].set_xticks(ks)
    axes[0].set_xlabel("Componente k")
    axes[0].set_ylabel("Autovalor λ_k")
    axes[0].set_title("Scree")
    axes[1].bar(ks, pi, alpha=0.7, label="π_k")
    axes[1].plot(ks, acum, marker="o", color="C1", label="Π_k acumulada")
    axes[1].axhline(0.9, linestyle="--", linewidth=1, color="0.4")
    axes[1].set_xticks(ks)
    axes[1].set_xlabel("Componente k")
    axes[1].set_ylabel("Fracción de varianza")
    axes[1].set_title("Varianza explicada")
    axes[1].legend(fontsize=8)
    fig.suptitle(titulo)
    plt.show()
    return pi, acum


def graficar_scores_1d(Z, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6), constrained_layout=True)
    for j, ax in enumerate(axes):
        ax.scatter(Z[:, j], np.zeros_like(Z[:, j]), s=16, alpha=0.55)
        ax.axhline(0, color="0.6", linewidth=0.6)
        ax.set_xlabel(f"PC{j+1}")
        ax.set_yticks([])
        ax.set_title(f"Proyección sobre PC{j+1}   var = {Z[:, j].var(ddof=1):.3f}")
    fig.suptitle(titulo)
    plt.show()


def graficar_3d(X, titulo, vistas):
    """Nube 3D vista desde varias direcciones; cada vista es (dirección de la cámara, subtítulo)."""
    fig = plt.figure(figsize=(6.0 * len(vistas), 5.4))
    for i, (direccion, subtitulo) in enumerate(vistas, start=1):
        d = np.asarray(direccion, dtype=float) / np.linalg.norm(direccion)
        ax = fig.add_subplot(1, len(vistas), i, projection="3d")
        ax.scatter(X[:, 0], X[:, 1], X[:, 2], s=10, alpha=0.5)
        ax.view_init(elev=np.degrees(np.arcsin(d[2])), azim=np.degrees(np.arctan2(d[1], d[0])))
        ax.set_xlabel("x")
        ax.set_ylabel("y")
        ax.set_zlabel("z")
        ax.set_title(subtitulo, fontsize=10)
    fig.suptitle(titulo)
    plt.tight_layout()
    plt.show()


def graficar_reconstruccion(X, Xhat, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), constrained_layout=True)
    axes[0].scatter(X[:, 0], X[:, 1], s=14, alpha=0.55)
    axes[0].set_title("Original")
    axes[1].scatter(Xhat[:, 0], Xhat[:, 1], s=14, alpha=0.55, color="C1")
    axes[1].set_title("Reconstrucción")
    for ax in axes:
        ax.set_aspect("equal", adjustable="box")
        ax.set_xlabel("x₁")
        ax.set_ylabel("x₂")
    fig.suptitle(titulo)
    plt.show()


def graficar_mse_k(ks, mses, titulo):
    fig, ax = plt.subplots(figsize=(7.2, 4.0))
    ax.plot(ks, mses, marker="o")
    ax.set_xticks(ks)
    ax.set_xlabel("k componentes retenidos")
    ax.set_ylabel("Error cuadrático medio de reconstrucción")
    ax.set_title(titulo)
    plt.tight_layout()
    plt.show()


def graficar_cargas(W, nombres, titulo, k=2):
    fig, axes = plt.subplots(1, k, figsize=(5.2 * k, 4.0), constrained_layout=True)
    if k == 1:
        axes = [axes]
    for j, ax in enumerate(axes):
        ax.barh(nombres, W[:, j])
        ax.axvline(0, color="0.4", linewidth=0.8)
        ax.set_title(f"Cargas PC{j+1}")
        ax.set_xlabel("peso en el componente")
    fig.suptitle(titulo)
    plt.show()


def graficar_escala_lado_a_lado(X_a, X_b, titulo_a, titulo_b):
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), constrained_layout=True)
    axes[0].scatter(X_a[:, 0], X_a[:, 1], s=14, alpha=0.55)
    axes[0].set_title(titulo_a)
    axes[1].scatter(X_b[:, 0], X_b[:, 1], s=14, alpha=0.55)
    axes[1].set_title(titulo_b)
    for ax in axes:
        ax.set_xlabel("PC1")
        ax.set_ylabel("PC2")
    fig.suptitle("La misma nube, dos decisiones de escala")
    plt.show()
def pca_manual(X, ddof=1):
    """PCA por eigendecomposición de la covarianza muestral.

    Devuelve media, datos centrados, autovalores (desc), W (columnas = PCs),
    puntuaciones Z y Σ.
    """
    X = np.asarray(X, dtype=float)
    media = X.mean(axis=0)
    Xc = X - media
    Sigma = np.cov(Xc, rowvar=False, ddof=ddof)
    lambdas, W = np.linalg.eigh(Sigma)
    orden = np.argsort(lambdas)[::-1]
    lambdas = lambdas[orden]
    W = W[:, orden]
    Z = Xc @ W
    return {
        "media": media,
        "Xc": Xc,
        "Sigma": Sigma,
        "lambdas": lambdas,
        "W": W,
        "Z": Z,
    }


def reconstruir(pca_dict, k):
    Wk = pca_dict["W"][:, :k]
    Zk = pca_dict["Z"][:, :k]
    return Zk @ Wk.T + pca_dict["media"]

5. Desarrollo por etapas

El argumento es único: del problema (muchas variables, nube difícil de leer) al objeto algebraico (\(\Sigma\), autovectores), a la lectura (\(\pi_k\), cargas), a la verificación (sklearn, SVD) y al límite (cuando la varianza no es la señal).

Etapa 1: El problema — el espacio se vacía

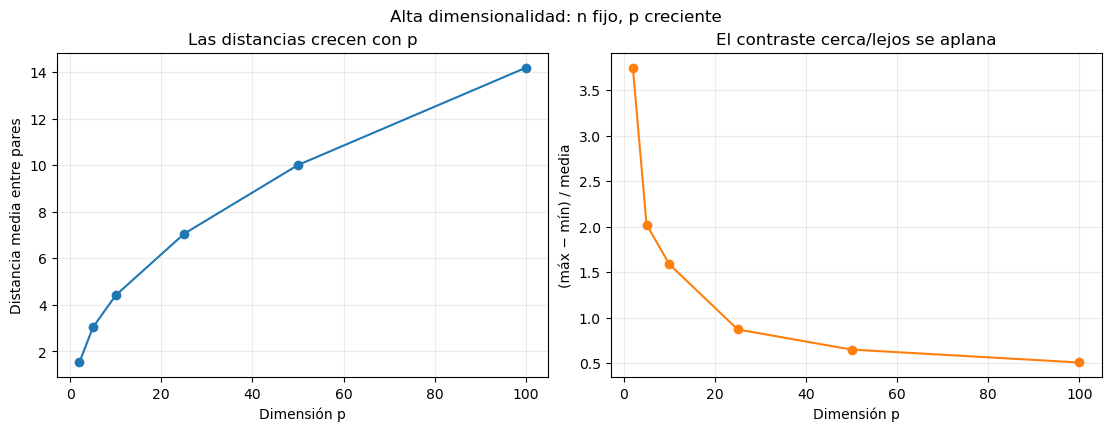
Se generan \(n=80\) puntos gaussianos independientes y se mide la distancia euclidiana entre todos los pares, para \(p\in\{2,5,10,25,50,100\}\).

Antes de ejecutar: si el contraste \((d_{\max}-d_{\min})/\bar{d}\) baja cuando \(p\) sube, “el vecino más cercano” deja de ser un concepto nítido. Eso es el corazón práctico de la curse of dimensionality.

n = 80
ps = [2, 5, 10, 25, 50, 100]
medias, contrastes = [], []
for p in ps:
    Xp = rng.normal(size=(n, p))
    D = pairwise_distances(Xp)
    d = D[np.triu_indices(n, k=1)]
    medias.append(d.mean())
    contrastes.append((d.max() - d.min()) / d.mean())

tabla_curse = pd.DataFrame(
    {"p": ps, "distancia_media": medias, "contraste_relativo": contrastes}
)
display(tabla_curse.round(3))
graficar_curse(ps, medias, contrastes)
p distancia_media contraste_relativo
0 2 1.528 3.745
1 5 3.042 2.023
2 10 4.416 1.587
3 25 7.055 0.871
4 50 10.007 0.650
5 100 14.183 0.509

Después del gráfico. La distancia media crece: en dimensión alta casi todo el mundo está lejos. El contraste se aplana: la diferencia entre el par más cercano y el más lejano se vuelve pequeña respecto a la escala típica. Un KNN en \(p=100\) con \(n=80\) distingue mucho peor quién está cerca: el par más cercano y el más lejano difieren en la mitad de la distancia típica, frente a casi cuatro veces en \(p=2\).

Reducir \(p\) no es solo para dibujar. Es recuperar un espacio donde “cerca” otra vez significa algo.

Etapa 2: Una nube que se puede leer a ojo

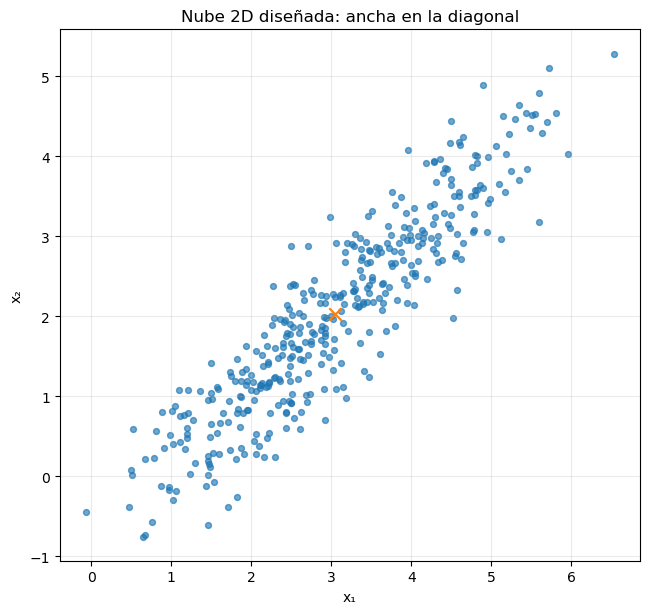
Antes de \(p\) grande, una elipse en el plano. \(n=400\) puntos con correlación fuerte: la dirección ancha es la diagonal \(x_1\approx x_2\); la dirección delgada es la anti-diagonal.

Pregunta guía: si hubiera que resumir cada punto con un solo número, ¿sobre qué recta lo proyectaría?

n = 400
z1 = rng.normal(0, 1.8, size=n)
z2 = rng.normal(0, 0.35, size=n)
# Rotación 45°: el eje ancho queda sobre la diagonal
c, s = np.cos(np.pi / 4), np.sin(np.pi / 4)
R = np.array([[c, -s], [s, c]])
X2 = np.column_stack([z1, z2]) @ R.T + np.array([3.0, 2.0])

df2 = pd.DataFrame(X2, columns=["x1", "x2"])
print(df2.describe().round(3))
print("Correlación x1, x2:", np.corrcoef(X2.T)[0, 1].round(3))
graficar_nube_2d(X2, "Nube 2D diseñada: ancha en la diagonal", centro=X2.mean(axis=0))
            x1       x2
count  400.000  400.000
mean     3.048    2.029
std      1.247    1.234
min     -0.065   -0.754
25%      2.153    1.092
50%      2.933    2.001
75%      3.972    2.920
max      6.529    5.284
Correlación x1, x2: 0.916

Lectura. El centro no está en el origen. La nube es una elipse inclinada. Cualquier resumen univariado por columna (media de \(x_1\), media de \(x_2\)) rompe esa diagonal: trata como independientes dos coordenadas que se mueven juntas. El eje útil no es \(x_1\) ni \(x_2\); es una combinación lineal.

Etapa 3: Centrar — el origen tiene que ser el centro de la nube

\[ X_c = X - \mathbf{1}\bar{\mathbf{x}}^{\top} \]

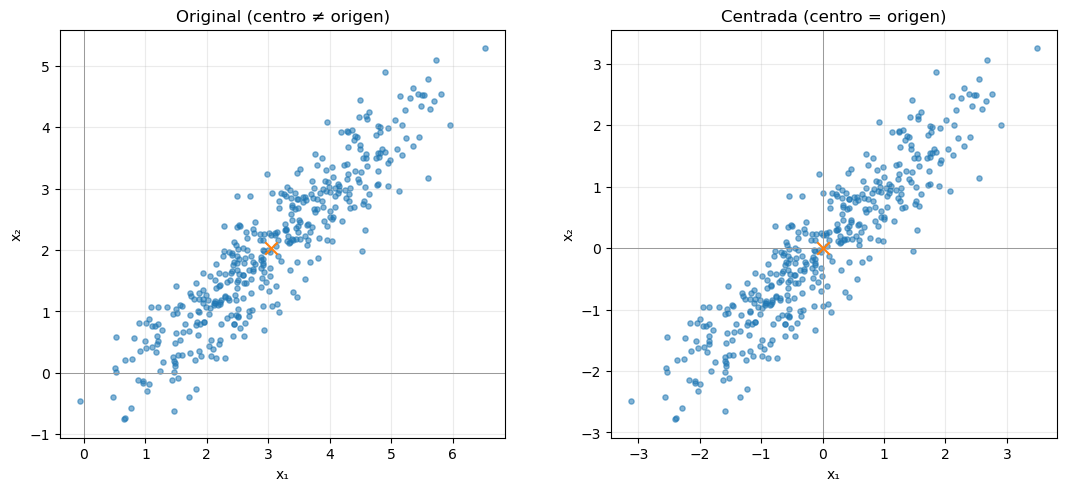
Antes de comparar los dos gráficos: el primero tiene el centro en \((3,2)\); el segundo, en \((0,0)\). PCA necesita el segundo. Si no, el “eje de máxima varianza” se confunde con el vector que apunta al centro de masa desde el origen.

media2 = X2.mean(axis=0)
Xc2 = X2 - media2
print("Media original:", np.round(media2, 4))
print("Media centrada (debe ser ~0):", np.round(Xc2.mean(axis=0), 12))

fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), constrained_layout=True)
axes[0].scatter(X2[:, 0], X2[:, 1], s=14, alpha=0.55)
axes[0].scatter(media2[0], media2[1], s=80, marker="x", zorder=3)
axes[0].axhline(0, color="0.6", linewidth=0.7)
axes[0].axvline(0, color="0.6", linewidth=0.7)
axes[0].set_title("Original (centro ≠ origen)")
axes[0].set_aspect("equal", adjustable="box")
axes[1].scatter(Xc2[:, 0], Xc2[:, 1], s=14, alpha=0.55)
axes[1].scatter(0, 0, s=80, marker="x", zorder=3)
axes[1].axhline(0, color="0.6", linewidth=0.7)
axes[1].axvline(0, color="0.6", linewidth=0.7)
axes[1].set_title("Centrada (centro = origen)")
axes[1].set_aspect("equal", adjustable="box")
for ax in axes:
    ax.set_xlabel("x₁")
    ax.set_ylabel("x₂")
plt.show()
Media original: [3.0478 2.0294]
Media centrada (debe ser ~0): [0. 0.]

Después. Centrar traslada; no rota ni cambia la forma. La covarianza, los ángulos y las distancias entre puntos se conservan. Solo se elige un origen honesto: el centro de la muestra (la media de cada columna).

Etapa 4: La covarianza es la forma de la nube

\[ \Sigma = \frac{1}{n-1} X_c^{\top} X_c \in\mathbb{R}^{p\times p} \]

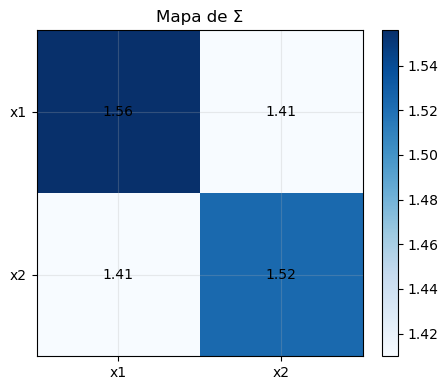
En la diagonal, varianzas. Fuera, covarianzas. Una \(\Sigma\) con fuera-diagonal grande (respecto a las varianzas) es una elipse inclinada. Una \(\Sigma\) diagonal es una elipse alineada con los ejes —o un círculo, si las varianzas coinciden.

Conexión algebraica: \(\mathbf{w}^{\top}\Sigma\mathbf{w}\) es exactamente la varianza muestral de la proyección \(X_c\mathbf{w}\).

Sigma2 = np.cov(Xc2, rowvar=False, ddof=1)
print("Σ (covarianza muestral):")
print(np.round(Sigma2, 3))
print()
print("Varianza total (traza):", np.trace(Sigma2).round(3))
print("w = (1,1)/√2  →  wᵀΣw =", (np.array([1, 1]) / np.sqrt(2) @ Sigma2 @ (np.array([1, 1]) / np.sqrt(2))).round(3))
print("w = (1,-1)/√2 →  wᵀΣw =", (np.array([1, -1]) / np.sqrt(2) @ Sigma2 @ (np.array([1, -1]) / np.sqrt(2))).round(3))

fig, ax = plt.subplots(figsize=(4.6, 4.0))
im = ax.imshow(Sigma2, cmap="Blues")
ax.set_xticks([0, 1], ["x1", "x2"])
ax.set_yticks([0, 1], ["x1", "x2"])
for i in range(2):
    for j in range(2):
        ax.text(j, i, f"{Sigma2[i, j]:.2f}", ha="center", va="center")
ax.set_title("Mapa de Σ")
fig.colorbar(im, ax=ax, fraction=0.046)
plt.tight_layout()
plt.show()
Σ (covarianza muestral):
[[1.556 1.41 ]
 [1.41  1.524]]

Varianza total (traza): 3.079
w = (1,1)/√2  →  wᵀΣw = 2.95
w = (1,-1)/√2 →  wᵀΣw = 0.13

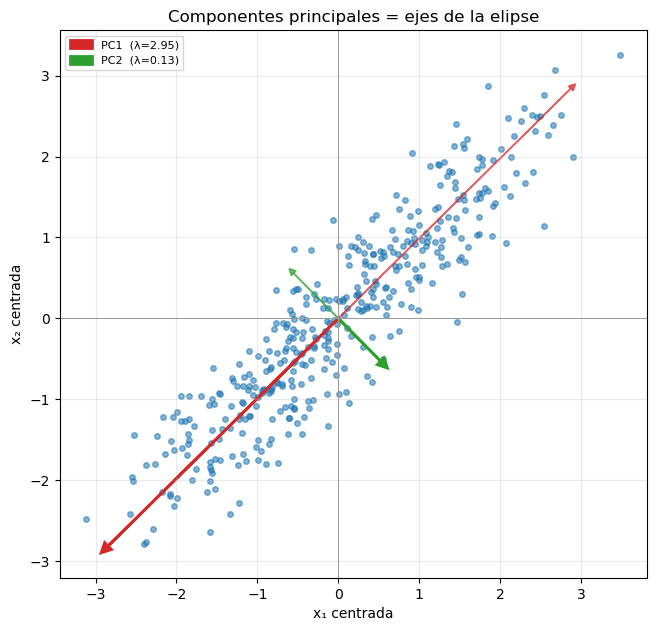
Lectura. La proyección sobre la diagonal \((1,1)\) tiene mucha más varianza que sobre la anti-diagonal \((1,-1)\). Eso es PCA, todavía sin nombrar autovectores: se probó a mano las dos direcciones naturales de esta elipse. El álgebra siguiente elige esas direcciones de forma sistemática, en cualquier \(p\).

Etapa 5: Autovectores — los ejes de la elipse

Se resuelve \(\Sigma\mathbf{w}=\lambda\mathbf{w}\) con np.linalg.eigh (estable para matrices simétricas) y se ordenan los pares \((\lambda,\mathbf{w})\) de mayor a menor autovalor.

Propiedades que hay que verificar, no creer:

  • \(\|\mathbf{w}_j\|=1\),
  • \(\mathbf{w}_1\cdot\mathbf{w}_2=0\),
  • \(\lambda_1+\lambda_2=\mathrm{tr}(\Sigma)\) (la traza se conserva al cambiar de base ortonormal).
pca2 = pca_manual(X2)
print("Autovalores λ:", np.round(pca2["lambdas"], 4))
print("Autovectores (columnas = PC1, PC2):")
print(np.round(pca2["W"], 4))
print()
print("||w1|| =", np.linalg.norm(pca2["W"][:, 0]).round(6))
print("||w2|| =", np.linalg.norm(pca2["W"][:, 1]).round(6))
print("w1 · w2 =", np.dot(pca2["W"][:, 0], pca2["W"][:, 1]).round(12))
print("λ1 + λ2 =", pca2["lambdas"].sum().round(4), "  tr(Σ) =", np.trace(pca2["Sigma"]).round(4))

graficar_nube_con_pcs(
    pca2["Xc"], pca2["W"], pca2["lambdas"],
    "Componentes principales = ejes de la elipse",
)
Autovalores λ: [2.9496 0.1297]
Autovectores (columnas = PC1, PC2):
[[-0.7111  0.7031]
 [-0.7031 -0.7111]]

||w1|| = 1.0
||w2|| = 1.0
w1 · w2 = 0.0
λ1 + λ2 = 3.0794   tr(Σ) = 3.0794

Después del gráfico. PC1 recorre el eje largo; PC2, el corto. El signo de \(\mathbf{w}_1\) (flecha hacia un sentido u otro de la misma recta) es convencional: \(\mathbf{w}\) y \(-\mathbf{w}\) definen el mismo componente. Eso reaparece al comparar con sklearn.

Formalmente se acaba de resolver el problema de la sección 1.2. No hay heurística: el primer eje es el maximizador de \(\mathbf{w}^{\top}\Sigma\mathbf{w}\) en la esfera unitaria.

Etapa 6: Proyectar — coordenadas en la base principal

\[ Z = X_c W \]

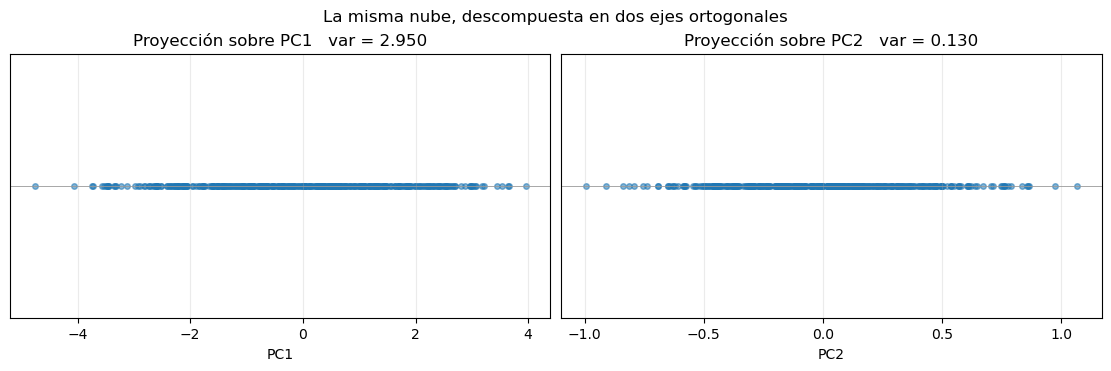
La columna \(j\) de \(Z\) es el score sobre \(\mathrm{PC}j\). Su varianza muestral debe coincidir con \(\lambda_j\).

Antes de los gráficos de proyección: el de PC1 debe verse mucho más extendido que el de PC2. Si no, el diseño de la elipse falló.

Z2 = pca2["Z"]
print("Var(PC1) =", Z2[:, 0].var(ddof=1).round(4), "  λ1 =", pca2["lambdas"][0].round(4))
print("Var(PC2) =", Z2[:, 1].var(ddof=1).round(4), "  λ2 =", pca2["lambdas"][1].round(4))
print("Cov(PC1, PC2) =", np.cov(Z2, rowvar=False, ddof=1)[0, 1].round(12), "  (ortogonalidad ⇒ 0)")

graficar_scores_1d(Z2, "La misma nube, descompuesta en dos ejes ortogonales")
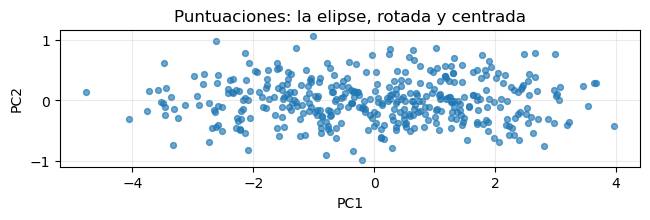
graficar_nube_2d(Z2, "Puntuaciones: la elipse, rotada y centrada", ejes=("PC1", "PC2"))
Var(PC1) = 2.9496   λ1 = 2.9496
Var(PC2) = 0.1297   λ2 = 0.1297
Cov(PC1, PC2) = 0.0   (ortogonalidad ⇒ 0)

Lectura. En el espacio de puntuaciones (las nuevas coordenadas) la elipse queda alineada con los ejes. Eso no añade información: es un cambio de coordenadas. El valor está en poder dejar de usar PC2 y quedarse con un número por observación (PC1) que conserva casi todo el ancho de la nube.

Etapa 7: Varianza explicada — cuánto se guarda al cortar

\[ \pi_k=\frac{\lambda_k}{\sum_j\lambda_j},\qquad \Pi_k=\sum_{i=1}^{k}\pi_i \]

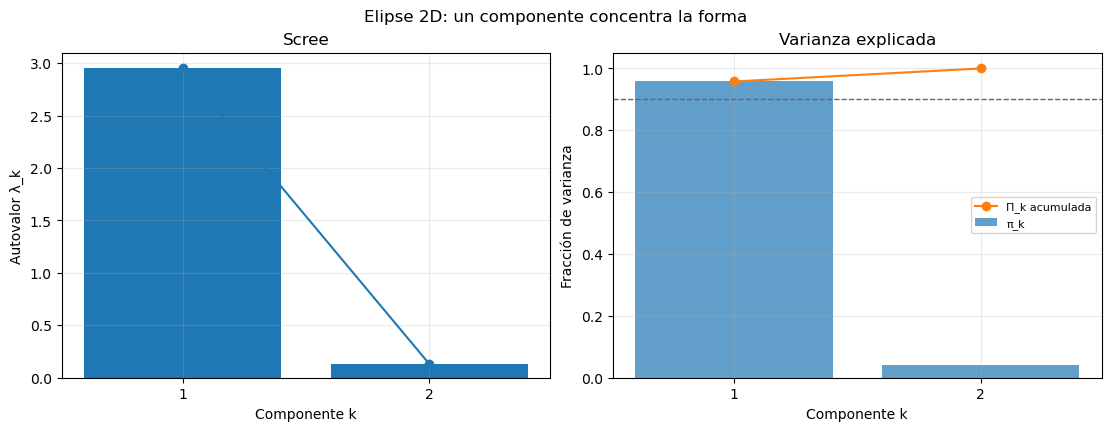
En esta elipse, \(\Pi_1\) debe ser alto: un solo eje basta. El scree (gráfico de \(\lambda_k\) frente a \(k\)) muestra un quiebre evidente: \(\lambda\) cae y después se aplana.

pi2, acum2 = graficar_scree(pca2["lambdas"], "Elipse 2D: un componente concentra la forma")
resumen2 = pd.DataFrame(
    {
        "k": [1, 2],
        "lambda": pca2["lambdas"],
        "pi": pi2,
        "Pi_acumulada": acum2,
    }
)
display(resumen2.round(4))
print(f"Con k=1 se conserva el {100*acum2[0]:.1f}% de la varianza.")

k lambda pi Pi_acumulada
0 1 2.9496 0.9579 0.9579
1 2 0.1297 0.0421 1.0000
Con k=1 se conserva el 95.8% de la varianza.

Cómo elegir \(k\) en general. El quiebre del scree es una pista visual, no un teorema. \(\Pi_k\ge 0.9\) es una convención de ingeniería. En un problema real se cruza con: ¿se puede interpretar el PC\(k\)? ¿baja el error de reconstrucción de forma material? ¿un modelo posterior mejora? El número \(k\) se argumenta, no se extrae de un umbral fijo.

Etapa 8: El mismo cálculo en scikit-learn

PCA siempre centra los datos (guarda la media en mean_) y usa SVD. Las ratios deben coincidir. Los vectores pueden salir multiplicados por \(-1\): es la misma recta.

Antes de comparar: si components_ es el opuesto de \(W^{\top}\), el resultado no está mal. Un componente es una dirección, no una flecha orientada.

sk = PCA(n_components=2, svd_solver="full")
Z_sk = sk.fit_transform(X2)

print("sklearn explained_variance_     :", np.round(sk.explained_variance_, 4))
print("manual λ                        :", np.round(pca2["lambdas"], 4))
print("sklearn explained_variance_ratio_:", np.round(sk.explained_variance_ratio_, 4))
print()
print("sklearn components_ (filas = PCs):")
print(np.round(sk.components_, 4))
print("manual W.T:")
print(np.round(pca2["W"].T, 4))
print()
print("Producto fila a fila (1 o −1 si son el mismo eje):")
for j in range(2):
    print(f"  PC{j+1}:", np.round(np.dot(sk.components_[j], pca2["W"][:, j]), 6))

print()
print("Medias usadas por sklearn (mean_):", np.round(sk.mean_, 4))
sklearn explained_variance_     : [2.9496 0.1297]
manual λ                        : [2.9496 0.1297]
sklearn explained_variance_ratio_: [0.9579 0.0421]

sklearn components_ (filas = PCs):
[[ 0.7111  0.7031]
 [-0.7031  0.7111]]
manual W.T:
[[-0.7111 -0.7031]
 [ 0.7031 -0.7111]]

Producto fila a fila (1 o −1 si son el mismo eje):
  PC1: -1.0
  PC2: -1.0

Medias usadas por sklearn (mean_): [3.0478 2.0294]

Después. Autovalores y ratios coinciden. El producto \(\mathbf{w}_{\mathrm{sklearn}}\cdot\mathbf{w}_{\mathrm{manual}}\) vale \(\pm 1\). Quien implemente un test numérico debe comparar ejes salvo signo, o fijar una convención (por ejemplo, que la carga de mayor valor absoluto sea positiva).

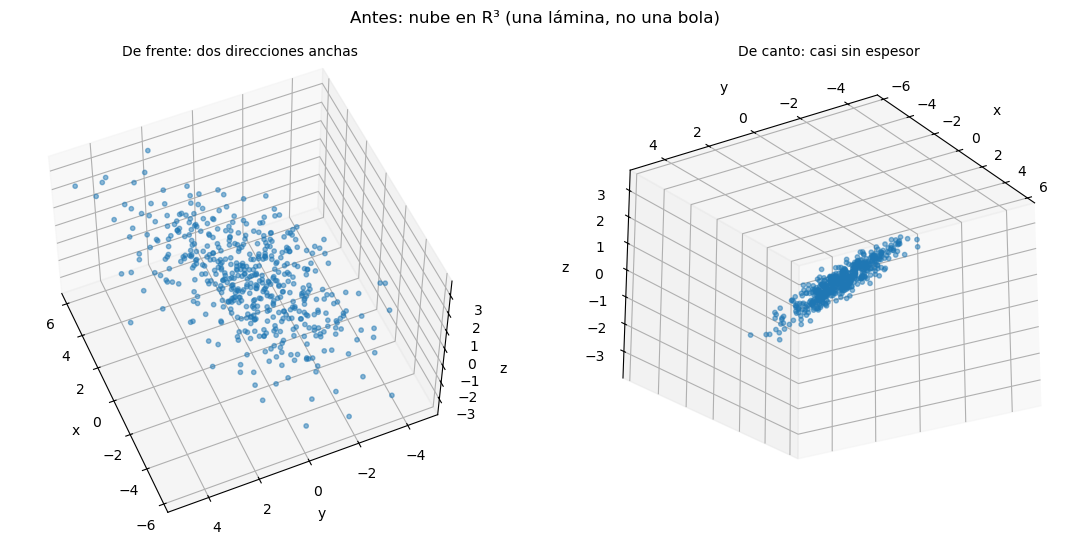
Etapa 9: De 3D a 2D — un plano con un poco de ruido perpendicular

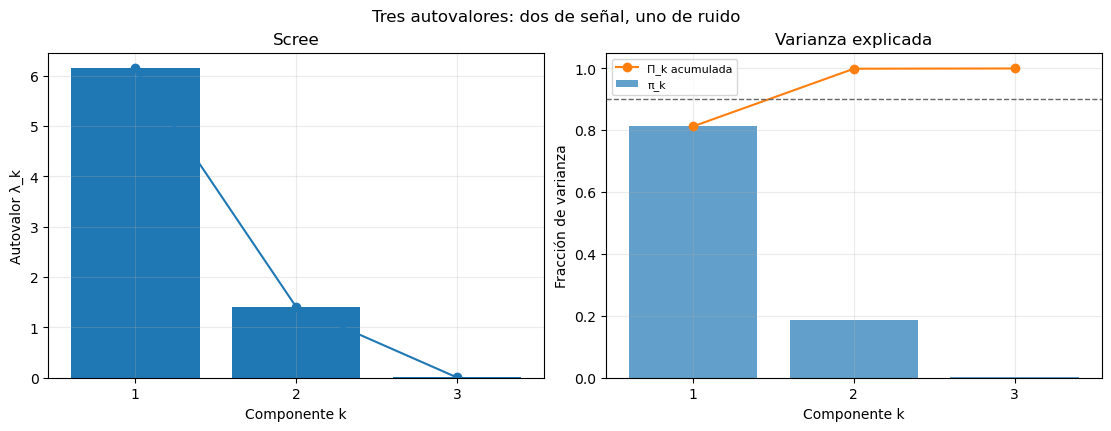
Se fabrica un plano en \(\mathbb{R}^3\) (dos factores latentes) y se añade ruido pequeño en la dirección normal. PCA debe reportar dos componentes grandes y un tercero casi nulo.

Pregunta guía (antes del 3D): si la nube es ancha en dos direcciones y muy delgada en la tercera (como una lámina), ¿cuántos números hacen falta para ubicar un punto “casi” bien?

n3 = 500
u = rng.normal(0, 1.6, size=n3)
v = rng.normal(0, 1.1, size=n3)
# Plano: x = u+v, y = u-0.3v, z = 0.4u+0.8v, más ruido normal
plano = np.column_stack([
    u + v,
    u - 0.3 * v,
    0.4 * u + 0.8 * v,
])
ruido = rng.normal(0, 0.08, size=plano.shape)
X3 = plano + ruido

pca3 = pca_manual(X3)
print("Autovalores 3D:", np.round(pca3["lambdas"], 4))
print("π:", np.round(pca3["lambdas"] / pca3["lambdas"].sum(), 4))
print("Π acumulada:", np.round(np.cumsum(pca3["lambdas"] / pca3["lambdas"].sum()), 4))

# Cámara perpendicular a la lámina (dirección del PC3) y en el plano de la lámina (PC1)
graficar_3d(X3, "Antes: nube en R³ (una lámina, no una bola)",
            vistas=[(pca3["W"][:, 2], "De frente: dos direcciones anchas"),
                    (pca3["W"][:, 0], "De canto: casi sin espesor")])
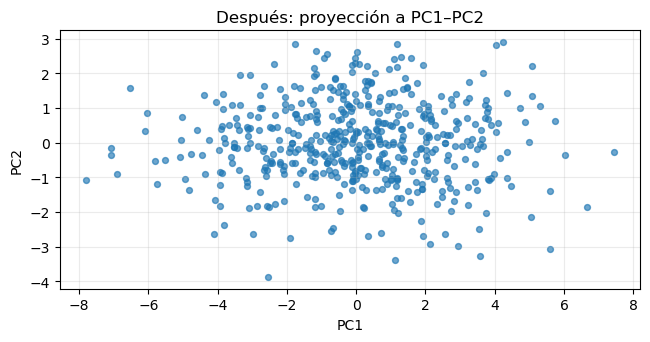
graficar_nube_2d(pca3["Z"][:, :2], "Después: proyección a PC1–PC2", ejes=("PC1", "PC2"))
graficar_scree(pca3["lambdas"], "Tres autovalores: dos de señal, uno de ruido")
Autovalores 3D: [6.1439e+00 1.4099e+00 6.0000e-03]
π: [8.127e-01 1.865e-01 8.000e-04]
Π acumulada: [0.8127 0.9992 1.    ]

(array([8.12698400e-01, 1.86502493e-01, 7.99106421e-04]),
 array([0.8126984 , 0.99920089, 1.        ]))

Antes / después. El gráfico 3D muestra una lámina: de frente ocupa dos direcciones; de canto casi no tiene espesor. El 2D de puntuaciones recupera las dos direcciones del plano. El tercer autovalor es el ruido perpendicular a esa lámina: descartarlo quita ruido, no estructura. Esa es la comparación del temario: la misma nube, compactada, con la forma intacta.

Etapa 10: La escala se queda con el primer componente

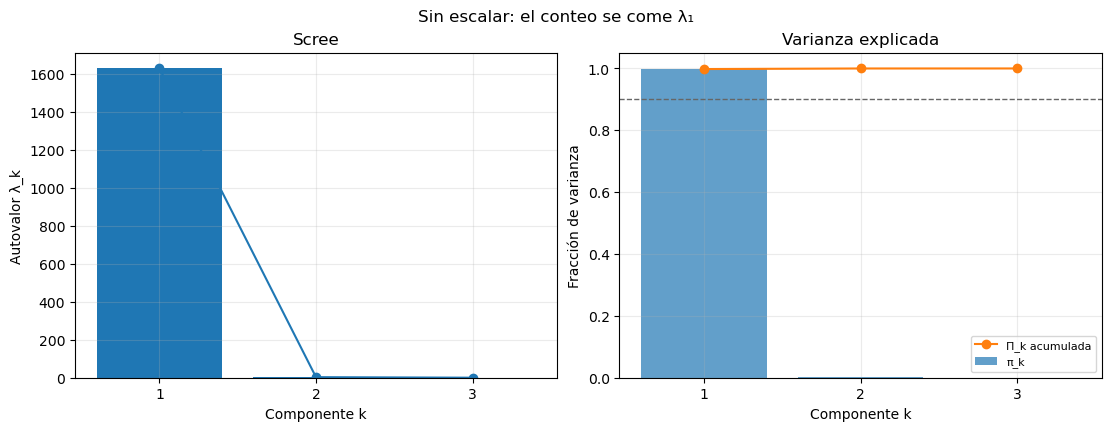
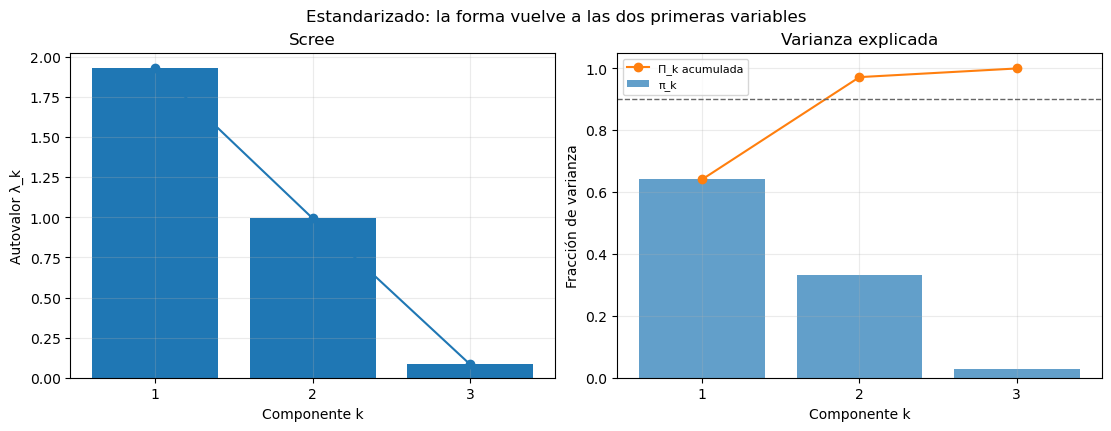
Se toma la elipse 2D y se añade una tercera columna en otra unidad y sin relación con la elipse: un “conteo” del orden de cientos. Sin estandarizar, \(\lambda_1\) se va con esa columna. Con StandardScaler, cada variable pesa lo mismo: se mide en desviaciones estándar.

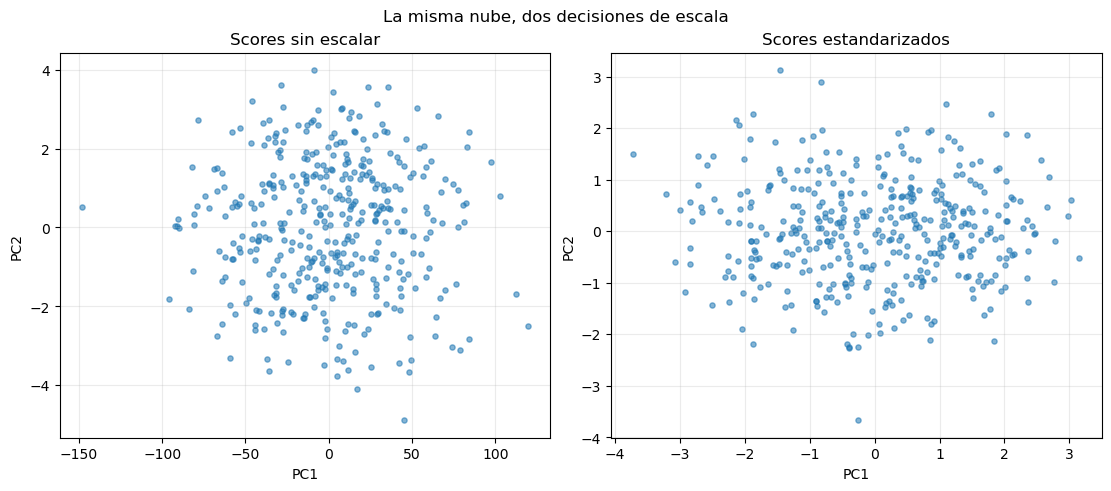
Antes de los dos scree: el primero debe tener un PC1 casi igual a la columna de mayor rango; el segundo debe devolver PC1 a la diagonal \(x_1\)–\(x_2\) de la elipse y dejar al conteo en un eje propio.

conteo = rng.normal(200, 40, size=n)   # otra unidad, sin relación con x1 ni x2
X_mix = np.column_stack([X2, conteo])

pca_crudo = pca_manual(X_mix)
X_std = StandardScaler().fit_transform(X_mix)
pca_std = pca_manual(X_std)

print("Sin escalar — cargas PC1 (x1, x2, conteo):")
print(np.round(pca_crudo["W"][:, 0], 4), "  π1 =", (pca_crudo["lambdas"][0] / pca_crudo["lambdas"].sum()).round(3))
print("Estandarizado — cargas PC1:")
print(np.round(pca_std["W"][:, 0], 4), "  π1 =", (pca_std["lambdas"][0] / pca_std["lambdas"].sum()).round(3))
print("Estandarizado — cargas PC2:")
print(np.round(pca_std["W"][:, 1], 4), "  π2 =", (pca_std["lambdas"][1] / pca_std["lambdas"].sum()).round(3))

graficar_scree(pca_crudo["lambdas"], "Sin escalar: el conteo se come λ₁")
graficar_scree(pca_std["lambdas"], "Estandarizado: la forma vuelve a las dos primeras variables")
graficar_escala_lado_a_lado(
    pca_crudo["Z"][:, :2], pca_std["Z"][:, :2],
    "Scores sin escalar", "Scores estandarizados",
)
Sin escalar — cargas PC1 (x1, x2, conteo):
[-0.0016 -0.0023  1.    ]   π1 = 0.998
Estandarizado — cargas PC1:
[-0.7032 -0.7045  0.0956]   π1 = 0.641
Estandarizado — cargas PC2:
[0.0812 0.054  0.9952]   π2 = 0.331

Interpretación. Sin escalar, PC1 es el conteo (carga 1.00) y concentra el 99.8% de la varianza: la elipse queda relegada a los ejes menores. Estandarizado, PC1 vuelve a la diagonal \(x_1\)–\(x_2\) (cargas −0.70 y −0.70, \(\pi_1=64\%\)) y el conteo pasa a PC2 (carga 0.995, \(\pi_2=33\%\)). PCA no es invariante a cambios de unidad. Multiplicar una columna por \(1000\) reescribe \(\Sigma\) y, con ella, los ejes. Estandarizar es declarar: todas las variables pesan igual a priori. No estandarizar es declarar: la variable de mayor rango merece el primer eje. Las dos decisiones son legítimas; la ilegítima es no saber cuál se tomó.

Etapa 11: Dos factores latentes y las cargas

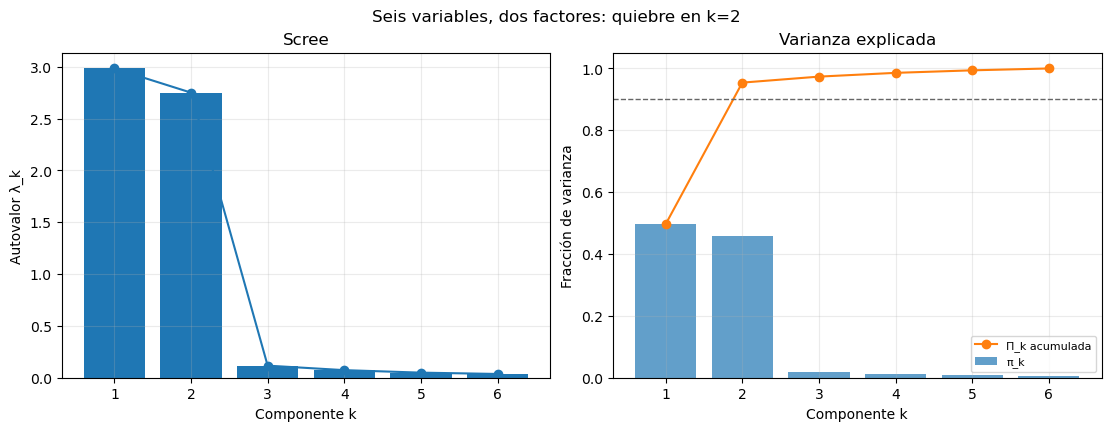
Se simula un cuestionario de \(p=6\) hábitos con dos causas: un factor estudio (lectura, práctica, ejercicios) y un factor agotamiento (pantalla, distracción, cafeína). PCA, bien escalado, debe recuperar dos componentes interpretables.

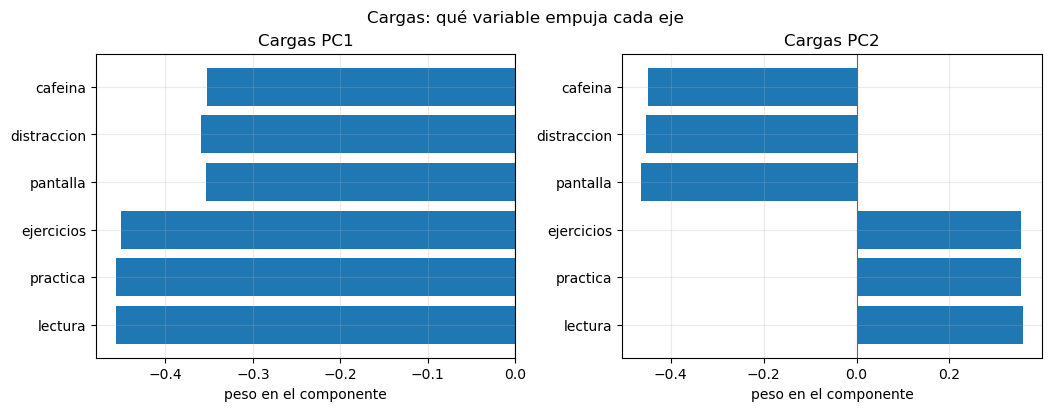
Las cargas son las coordenadas de cada variable original sobre los PCs: una barra larga en PC1 significa que esa columna define ese eje.

n6 = 600
estudio = rng.normal(0, 1, size=n6)
agotamiento = rng.normal(0, 1, size=n6)
nombres6 = ["lectura", "practica", "ejercicios", "pantalla", "distraccion", "cafeina"]
X6 = np.column_stack([
    1.2 * estudio + rng.normal(0, 0.25, n6),
    1.1 * estudio + rng.normal(0, 0.25, n6),
    0.9 * estudio + rng.normal(0, 0.30, n6),
    1.3 * agotamiento + rng.normal(0, 0.25, n6),
    1.0 * agotamiento + rng.normal(0, 0.30, n6),
    0.8 * agotamiento + rng.normal(0, 0.35, n6),
])
X6s = StandardScaler().fit_transform(X6)
pca6 = pca_manual(X6s)

print("π:", np.round(pca6["lambdas"] / pca6["lambdas"].sum(), 3))
print("Π:", np.round(np.cumsum(pca6["lambdas"] / pca6["lambdas"].sum()), 3))

cargas = pd.DataFrame(
    pca6["W"][:, :2], index=nombres6, columns=["PC1", "PC2"]
)
display(cargas.round(3))
graficar_scree(pca6["lambdas"], "Seis variables, dos factores: quiebre en k=2")
graficar_cargas(pca6["W"], nombres6, "Cargas: qué variable empuja cada eje", k=2)
π: [0.497 0.458 0.019 0.012 0.008 0.006]
Π: [0.497 0.954 0.974 0.986 0.994 1.   ]
PC1 PC2
lectura -0.456 0.358
practica -0.457 0.355
ejercicios -0.451 0.354
pantalla -0.354 -0.463
distraccion -0.360 -0.453
cafeina -0.353 -0.448

Cómo leer las cargas. Un componente no “es” una variable: es una combinación. Si PC1 agrupa lectura–práctica–ejercicios con el mismo signo, ese eje es el factor estudio. Si PC2 agrupa pantalla–distracción–cafeína, es el factor agotamiento. Los signos se interpretan juntos: invertir el PC entero (todas las cargas \(\times -1\)) no cambia el eje.

Regla práctica: no ponerle nombre a un PC solo por la variable de mayor carga si las demás del mismo signo son comparables. El nombre describe el bloque, no la columna ganadora.

Etapa 12: Reconstruir y medir lo que se tiró

\[ \hat{X}^{(k)} = Z_k W_k^{\top} + \mathbf{1}\bar{\mathbf{x}}^{\top} \]

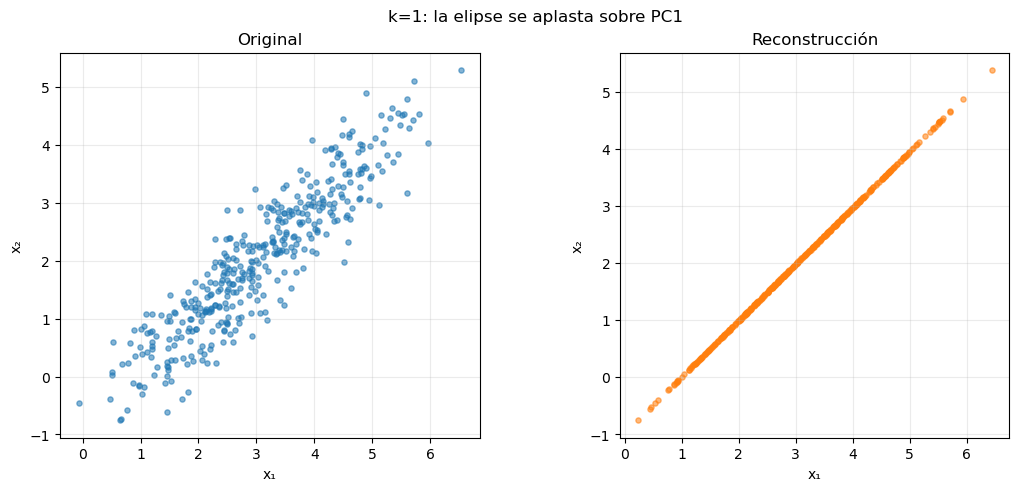
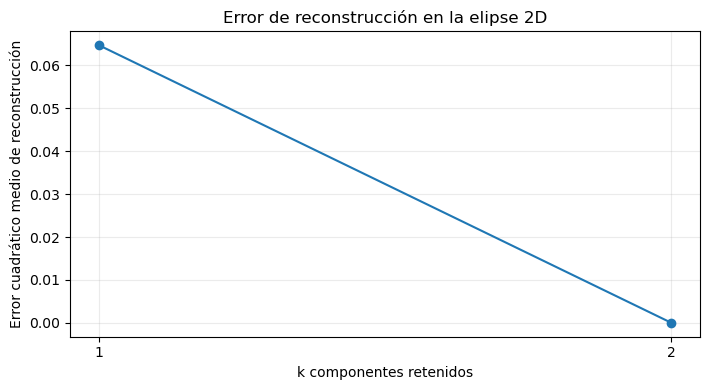
Para la elipse 2D, \(k=1\) aplasta la nube sobre la diagonal; \(k=2\) recupera todo (salvo error numérico). El MSE de reconstrucción debe caer a \(\approx 0\) cuando \(k=p\).

ks = [1, 2]
mses = []
for k in ks:
    Xhat = reconstruir(pca2, k)
    mse = np.mean((X2 - Xhat) ** 2)
    mses.append(mse)
    print(f"k={k}: MSE = {mse:.6f}")

Xhat1 = reconstruir(pca2, 1)
graficar_reconstruccion(X2, Xhat1, "k=1: la elipse se aplasta sobre PC1")
graficar_mse_k(ks, mses, "Error de reconstrucción en la elipse 2D")

print()
print("3D — MSE según k:")
mses3 = []
for k in range(1, 4):
    Xhat = reconstruir(pca3, k)
    mse = np.mean((X3 - Xhat) ** 2)
    mses3.append(mse)
    print(f"  k={k}: MSE = {mse:.5f}")
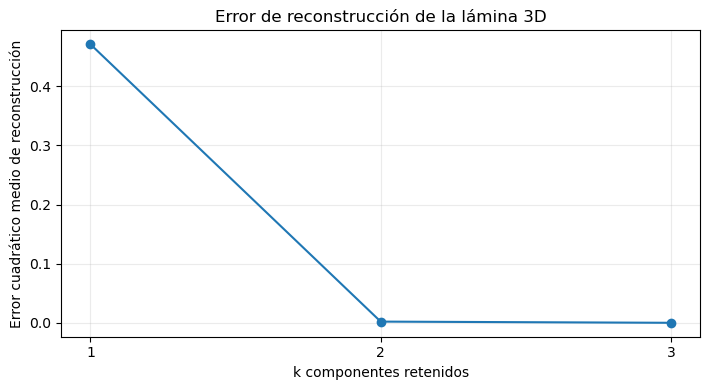
graficar_mse_k([1, 2, 3], mses3, "Error de reconstrucción de la lámina 3D")
k=1: MSE = 0.064707
k=2: MSE = 0.000000


3D — MSE según k:
  k=1: MSE = 0.47105
  k=2: MSE = 0.00201
  k=3: MSE = 0.00000

Lectura. En 2D, \(k=1\) pierde la variación de PC2 (el eje estrecho): la reconstrucción es un segmento grueso sobre la diagonal. En 3D, el salto grande de error está entre \(k=1\) y \(k=2\); de \(k=2\) a \(k=3\) se recupera solo el ruido. Elegir \(k=2\) ahí no es una moda: es el punto en el que el MSE deja de bajar de forma material.

Identidad útil: la varianza no capturada por los primeros \(k\) ejes es \(\sum_{j>k}\lambda_j\). El gráfico de MSE y el de \(\Pi_k\) cuentan la misma pérdida, en dos unidades.

Etapa 13: SVD — el segundo camino al mismo sitio

\[ X_c = U S V^{\top}, \qquad W = V, \qquad \lambda_j = \frac{s_j^2}{n-1}. \]

U son direcciones en el espacio de las \(n\) observaciones; V, en el de las \(p\) variables. PCA vive en \(V\).

U, s, Vt = np.linalg.svd(pca2["Xc"], full_matrices=False)
lambdas_svd = s ** 2 / (Xc2.shape[0] - 1)

print("λ por SVD:     ", np.round(lambdas_svd, 4))
print("λ por eigh(Σ): ", np.round(pca2["lambdas"], 4))
print()
print("V (filas de Vt) frente a W.T:")
print("Vt:")
print(np.round(Vt, 4))
print("W.T:")
print(np.round(pca2["W"].T, 4))
print()
print("Producto de ejes (otra vez ±1):")
for j in range(2):
    print(f"  eje {j+1}:", np.round(np.dot(Vt[j], pca2["W"][:, j]), 6))

# Puntuaciones vía SVD: U * s
Z_svd = U * s
print()
print("max |Z_svd − Z_eigh| (salvo posible signo por columna):")
for j in range(2):
    d1 = np.max(np.abs(Z_svd[:, j] - pca2["Z"][:, j]))
    d2 = np.max(np.abs(Z_svd[:, j] + pca2["Z"][:, j]))
    print(f"  PC{j+1}: {min(d1, d2):.2e}")
λ por SVD:      [2.9496 0.1297]
λ por eigh(Σ):  [2.9496 0.1297]

V (filas de Vt) frente a W.T:
Vt:
[[-0.7111 -0.7031]
 [-0.7031  0.7111]]
W.T:
[[-0.7111 -0.7031]
 [ 0.7031 -0.7111]]

Producto de ejes (otra vez ±1):
  eje 1: 1.0
  eje 2: -1.0

max |Z_svd − Z_eigh| (salvo posible signo por columna):
  PC1: 1.13e-14
  PC2: 8.16e-15

Por qué importan los dos caminos. \(\mathrm{eigh}(\Sigma)\) es el lenguaje de la covarianza: claro para demostrar \(\Sigma\mathbf{w}=\lambda\mathbf{w}\). SVD es el lenguaje numérico: no forma \(\Sigma\) explícita (útil si \(p\) es enorme) y es lo que usa sklearn. Quien entiende ambos no debate “cuál es el PCA verdadero”: son la misma rotación.

Etapa 14: El contrapunto — la clase vive en el eje delgado

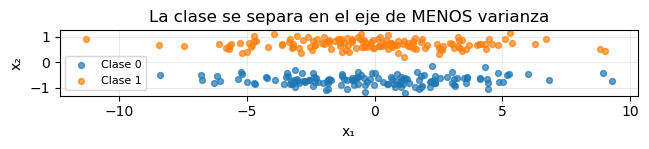
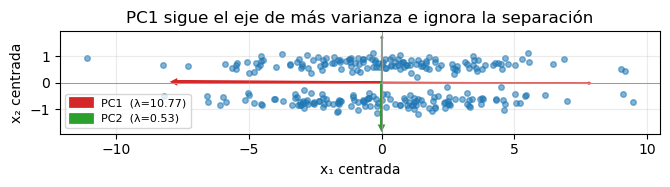
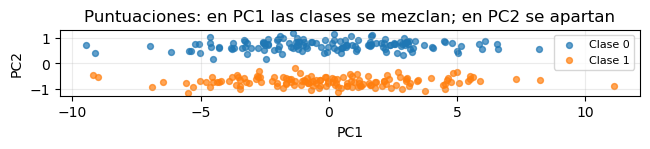
Se construye una nube muy alargada en \(x_1\) (mucha varianza, ninguna clase) y estrecha en \(x_2\), donde sí se separan dos grupos. PCA pondrá PC1 sobre \(x_1\) y, si alguien se queda solo con \(k=1\), descartará la dirección que clasifica.

Este es el experimento que impide tratar PCA como paso automático antes de un modelo supervisado.

n_c = 280
mitad = n_c // 2
x1 = rng.normal(0, 3.2, size=n_c)          # ancho, inútil para la clase
x2 = np.r_[rng.normal(-0.7, 0.18, mitad),  # delgado, sí separa
           rng.normal(0.7, 0.18, n_c - mitad)]
clases = np.r_[np.zeros(mitad, dtype=int), np.ones(n_c - mitad, dtype=int)]
Xcls = np.column_stack([x1, x2])

pca_cls = pca_manual(Xcls)
print("λ:", np.round(pca_cls["lambdas"], 3), "  π:", np.round(pca_cls["lambdas"] / pca_cls["lambdas"].sum(), 3))
print("PC1 (cargas x1, x2):", np.round(pca_cls["W"][:, 0], 3))
print("PC2 (cargas x1, x2):", np.round(pca_cls["W"][:, 1], 3))

# Umbral ingenuo sobre PC1 vs sobre x2
def acierto_umbral(v, y):
    # umbral en el punto medio de las medias de clase
    m0, m1 = v[y == 0].mean(), v[y == 1].mean()
    t = 0.5 * (m0 + m1)
    pred = (v > t).astype(int)
    if pred.mean() < 0.5 and y.mean() > 0.5:
        pred = 1 - pred
    # probar ambas orientaciones
    acc_a = (pred == y).mean()
    acc_b = ((1 - pred) == y).mean()
    return max(acc_a, acc_b)

acc_pc1 = acierto_umbral(pca_cls["Z"][:, 0], clases)
acc_pc2 = acierto_umbral(pca_cls["Z"][:, 1], clases)
acc_x2 = acierto_umbral(Xcls[:, 1], clases)
print()
print(f"Acierto umbral en PC1 (eje de más varianza): {acc_pc1:.3f}")
print(f"Acierto umbral en PC2 (eje de menos varianza): {acc_pc2:.3f}")
print(f"Acierto umbral en x2 original:     {acc_x2:.3f}")

graficar_nube_2d(Xcls, "La clase se separa en el eje de MENOS varianza", clases=clases)
graficar_nube_con_pcs(
    pca_cls["Xc"], pca_cls["W"], pca_cls["lambdas"],
    "PC1 sigue el eje de más varianza e ignora la separación",
)
graficar_nube_2d(pca_cls["Z"], "Puntuaciones: en PC1 las clases se mezclan; en PC2 se apartan", clases=clases, ejes=("PC1", "PC2"))
λ: [10.774  0.535]   π: [0.953 0.047]
PC1 (cargas x1, x2): [-1.     0.003]
PC2 (cargas x1, x2): [-0.003 -1.   ]

Acierto umbral en PC1 (eje de más varianza): 0.507
Acierto umbral en PC2 (eje de menos varianza): 1.000
Acierto umbral en x2 original:     1.000

La lección que no se puede saltar. \(\pi_1\) será alto y tentador. Un flujo que haga PCA(n_components=1) + clasificador descartará la señal. PCA no está “mal calculado”: respondió la pregunta que se le hizo (¿dónde hay varianza?) y no la que el modelo supervisado necesita (¿dónde hay clase?).

Cuando existe \(y\), la familia correcta de métodos se llama supervisada (LDA, PLS, selección por información mutua, regularización). PCA puede ser un paso exploratorio de \(X\); no es un sustituto de la función objetivo.

Etapa 15: Límites y buenas prácticas (sin folklore)

PCA asume que las direcciones útiles son lineales y que “útil” \(\approx\) “ancha”. Falla, o se malinterpreta, en al menos estos casos:

  1. Forma curva (no un plano). Si los datos se doblan en el espacio —como una U o un espiral—, su “dimensión verdadera” es baja, pero no caben en un plano. PCA los aplasta sobre una recta o un plano y pierde esa curva. Hay otros métodos para ese caso (isomap, t-SNE, UMAP, autoencoders); responden otra pregunta.
  2. Valores atípicos. Un extremo desplaza \(\Sigma\) y puede crear un componente que solo existe por ese punto. Conviene inspeccionar la nube y, si hace falta, una versión robusta.
  3. Variables categóricas sin preparar. Convertir una categoría con muchos niveles a columnas 0/1 (indicadoras) infla \(\Sigma\). PCA clásico es para \(X\) numérica, ya preparada.
  4. \(k\) como hiperparámetro oculto. Si hay \(y\), \(k\) es un hiperparámetro del modelo: se elige con validación dentro del entrenamiento. Elegirlo mirando el desempeño en el conjunto de prueba es fuga de información (Sesión 13).
  5. Interpretación causal. Un PC es una rotación, no un mecanismo. Bautizarlo (“el factor socioeconómico”) es una hipótesis, no un teorema.

La práctica sólida: centrar siempre; decidir la escala; mostrar scree y cargas; reconstruir; y, si hay objetivo, contrastar contra él.

Cálculo dirigido: una matriz \(5\times 2\) a mano

Antes de \(n=400\), cinco filas. Se puede seguir cada entrada de \(\bar{\mathbf{x}}\), \(X_c\), \(\Sigma\), el polinomio característico (o eigh) y la proyección. El objetivo no es el número: es ver que no hay un paso oculto entre la tabla y el primer componente.

X_mini = np.array(
    [
        [2.0, 1.0],
        [3.0, 2.0],
        [4.0, 2.5],
        [5.0, 3.5],
        [6.0, 4.0],
    ]
)
print("X")
print(X_mini)
media_m = X_mini.mean(axis=0)
Xc_m = X_mini - media_m
print("media =", np.round(media_m, 4))
print("X_c =")
print(np.round(Xc_m, 4))
Sigma_m = np.cov(Xc_m, rowvar=False, ddof=1)
print("Σ =")
print(np.round(Sigma_m, 4))
pca_m = pca_manual(X_mini)
print("λ =", np.round(pca_m["lambdas"], 4))
print("W =")
print(np.round(pca_m["W"], 4))
print("Z = X_c W =")
print(np.round(pca_m["Z"], 4))
print("Comprobación Z.T Z / (n-1) (debe ser diag(λ)):")
print(np.round(pca_m["Z"].T @ pca_m["Z"] / (len(X_mini) - 1), 4))
X
[[2.  1. ]
 [3.  2. ]
 [4.  2.5]
 [5.  3.5]
 [6.  4. ]]
media = [4.  2.6]
X_c =
[[-2.  -1.6]
 [-1.  -0.6]
 [ 0.  -0.1]
 [ 1.   0.9]
 [ 2.   1.4]]
Σ =
[[2.5   1.875]
 [1.875 1.425]]
λ = [3.913 0.012]
W =
[[-0.7986  0.6018]
 [-0.6018 -0.7986]]
Z = X_c W =
[[ 2.5602  0.0741]
 [ 1.1597 -0.1227]
 [ 0.0602  0.0799]
 [-1.3403 -0.1169]
 [-2.4398  0.0856]]
Comprobación Z.T Z / (n-1) (debe ser diag(λ)):
[[ 3.913 -0.   ]
 [-0.     0.012]]

Lectura. \(Z^{\top}Z/(n-1)=\mathrm{diag}(\lambda)\) es la identidad que cierra el círculo: las puntuaciones son incorreladas y sus varianzas son los autovalores. Si esta igualdad no se cumple, hay un error de orden, de centrado o de ddof.

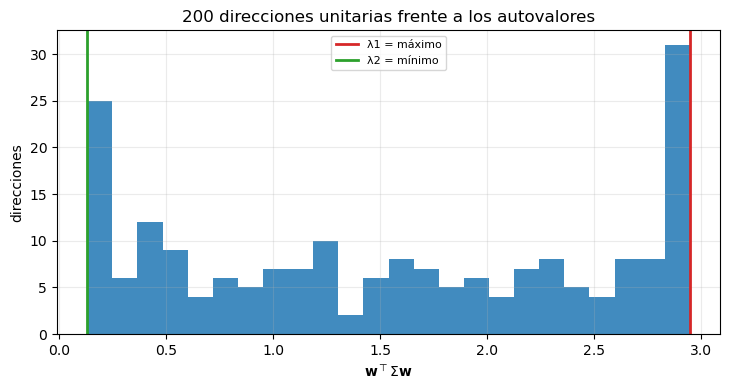
Etapa extra: PC1 gana a direcciones al azar

Se sortean \(200\) vectores unitarios en \(\mathbb{R}^2\) y se calcula \(\mathbf{w}^{\top}\Sigma\mathbf{w}\). Ninguno puede superar \(\lambda_1\). El histograma debe cortarse en \(\lambda_1\) y \(\lambda_2\) marca el otro extremo entre las direcciones del círculo (el mínimo es \(\lambda_2\) en 2D).

n_dir = 200
angs = rng.uniform(0, 2 * np.pi, size=n_dir)
Wrand = np.column_stack([np.cos(angs), np.sin(angs)])
vars_rand = np.einsum("ij,jk,ik->i", Wrand, pca2["Sigma"], Wrand)

print("max varianza aleatoria :", vars_rand.max().round(4))
print("λ1 (teórico máximo)    :", pca2["lambdas"][0].round(4))
print("min varianza aleatoria :", vars_rand.min().round(4))
print("λ2 (teórico mínimo 2D) :", pca2["lambdas"][1].round(4))
print("¿Alguna dirección supera λ1?", np.any(vars_rand > pca2["lambdas"][0] + 1e-10))

fig, ax = plt.subplots(figsize=(7.4, 4.0))
ax.hist(vars_rand, bins=24, alpha=0.85)
ax.axvline(pca2["lambdas"][0], color="C3", linewidth=2, label="λ1 = máximo")
ax.axvline(pca2["lambdas"][1], color="C2", linewidth=2, label="λ2 = mínimo")
ax.set_xlabel(r"$\mathbf{w}^\top \Sigma \mathbf{w}$")
ax.set_ylabel("direcciones")
ax.set_title("200 direcciones unitarias frente a los autovalores")
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()
max varianza aleatoria : 2.9494
λ1 (teórico máximo)    : 2.9496
min varianza aleatoria : 0.1299
λ2 (teórico mínimo 2D) : 0.1297
¿Alguna dirección supera λ1? False

Esto es la definición, no una analogía. El primer componente no es “una dirección que suele ir bien”: es el maximizador de esa forma cuadrática en la esfera. El experimento solo hace visible un teorema.

PCA sobre la matriz de correlaciones

Estandarizar columnas y hacer PCA es equivalente a descomponer la matriz de correlaciones \(R\) en lugar de \(\Sigma\). Útil cuando se quiere que cada variable tenga varianza \(1\) antes de buscar ejes. Se compara \(R\) con \(\Sigma\) sobre el cuestionario de hábitos.

R = np.corrcoef(X6, rowvar=False)
print("Matriz de correlaciones R:")
display(pd.DataFrame(np.round(R, 2), index=nombres6, columns=nombres6))

# PCA de R: equivalentes a pca_manual(X6s)
evals_R, evecs_R = np.linalg.eigh(R)
orden = np.argsort(evals_R)[::-1]
evals_R, evecs_R = evals_R[orden], evecs_R[:, orden]
print()
print("λ de R:           ", np.round(evals_R, 3))
print("λ de X estandarizada:", np.round(pca6["lambdas"], 3))
print("π de R:", np.round(evals_R / evals_R.sum(), 3))
print()
print("Criterio de Kaiser (λ > 1) sobre R: k =", int((evals_R > 1).sum()))
print("Ese k coincide con el quiebre del gráfico si los factores son dos y el resto es ruido.")
Matriz de correlaciones R:
lectura practica ejercicios pantalla distraccion cafeina
lectura 1.00 0.96 0.94 0.03 0.04 0.04
practica 0.96 1.00 0.93 0.03 0.05 0.04
ejercicios 0.94 0.93 1.00 0.03 0.04 0.04
pantalla 0.03 0.03 0.03 1.00 0.95 0.91
distraccion 0.04 0.05 0.04 0.95 1.00 0.89
cafeina 0.04 0.04 0.04 0.91 0.89 1.00

λ de R:            [2.979 2.746 0.116 0.073 0.049 0.036]
λ de X estandarizada: [2.984 2.751 0.117 0.073 0.049 0.036]
π de R: [0.497 0.458 0.019 0.012 0.008 0.006]

Criterio de Kaiser (λ > 1) sobre R: k = 2
Ese k coincide con el quiebre del gráfico si los factores son dos y el resto es ruido.

Kaiser (\(\lambda>1\) en la matriz de correlaciones) dice: un componente debe explicar más que una variable original estandarizada. Es una regla, no una demostración. Aquí debería sugerir \(k=2\), alineado con el diseño. En datos sucios el criterio se queda corto o se pasa; por eso se cruza con el scree y con la reconstrucción.

Biplot: puntuaciones y cargas en el mismo plano

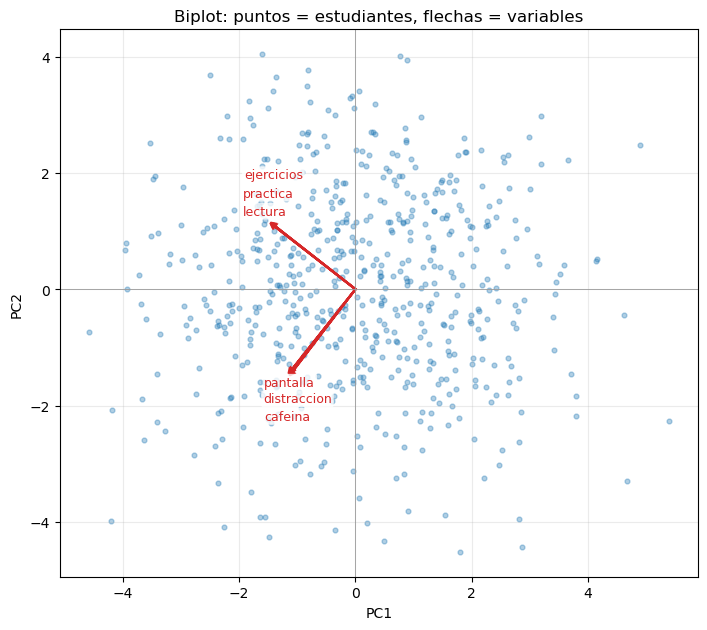
Un biplot superpone las observaciones (puntuaciones en PC1–PC2) y las variables (flechas = cargas). Una flecha larga y alineada con un grupo de puntos indica qué variable tira de ese grupo. Las flechas casi paralelas son variables redundantes; las ortogonales, bloques distintos.

fig, ax = plt.subplots(figsize=(7.4, 6.4))
Z6 = pca6["Z"][:, :2]
ax.scatter(Z6[:, 0], Z6[:, 1], s=12, alpha=0.35)
escala = 3.2
for j, nom in enumerate(nombres6):
    vx, vy = escala * pca6["W"][j, 0], escala * pca6["W"][j, 1]
    ax.arrow(0, 0, vx, vy, head_width=0.08, head_length=0.08,
             length_includes_head=True, color="C3", linewidth=1.6)
    desfase = np.sign(vy) * 0.32 * (j % 3)   # separa las etiquetas del mismo bloque
    ax.text(vx * 1.12 - 0.3, vy * 1.12 + desfase, nom, fontsize=9, color="C3",
            bbox=dict(boxstyle="round,pad=0.15", fc="white", ec="none", alpha=0.8))
ax.axhline(0, color="0.6", linewidth=0.6)
ax.axvline(0, color="0.6", linewidth=0.6)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_title("Biplot: puntos = estudiantes, flechas = variables")
ax.set_aspect("equal", adjustable="box")
plt.tight_layout()
plt.show()
Lectura del biplot. Las tres flechas de estudio deben apuntar juntas; las de agotamiento, en otra dirección (casi ortogonal si los factores se simularon independientes). Esa figura es la versión geométrica de la tabla de cargas: misma información, más rápida de comprobar.

Ajuste solo en entrenamiento — no filtrar con toda la muestra

Si \(Z\) se calcula con la media y los ejes de todas las filas, y después se parte train/test, el conjunto de prueba ya intervino en \(\bar{\mathbf{x}}\) y en \(W\). Eso es fuga. El protocolo correcto: fit en train, transform en test —y vale también para el escalado, no solo para PCA. (La partición entrenamiento/prueba se estudia a fondo en la Sesión 13.)

from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline

# Se parte X6 SIN escalar: el escalado también forma parte de lo que se ajusta
Xtr, Xte = train_test_split(X6, test_size=0.3, random_state=0)
pipe_tr = make_pipeline(StandardScaler(), PCA(n_components=2)).fit(Xtr)   # correcto
pipe_all = make_pipeline(StandardScaler(), PCA(n_components=2)).fit(X6)   # fuga: vio el test

Zte_ok = pipe_tr.transform(Xte)
Zte_leak = pipe_all.transform(Xte)
# Un eje y su opuesto son el mismo componente: se alinean los signos antes de comparar
signos = np.sign(np.sum(pipe_tr[-1].components_ * pipe_all[-1].components_, axis=1))
Zte_leak = Zte_leak * signos

print("media del escalador (train):", np.round(pipe_tr[0].mean_[:3], 4), "...")
print("media del escalador (todos):", np.round(pipe_all[0].mean_[:3], 4), "...")
print("π train:", np.round(pipe_tr[-1].explained_variance_ratio_, 3))
print("π todos:", np.round(pipe_all[-1].explained_variance_ratio_, 3))
print()
print("RMS diferencia de puntuaciones en test (fit-train vs fit-todos):",
      np.sqrt(np.mean((Zte_ok - Zte_leak) ** 2)).round(4))
print("La diferencia no es un bug: son dos espacios distintos.")
print("En un pipeline, solo el primero es válido.")
media del escalador (train): [0.022  0.0343 0.0431] ...
media del escalador (todos): [0.0511 0.0543 0.0511] ...
π train: [0.499 0.454]
π todos: [0.497 0.458]

RMS diferencia de puntuaciones en test (fit-train vs fit-todos): 0.0334
La diferencia no es un bug: son dos espacios distintos.
En un pipeline, solo el primero es válido.

Protocolo. StandardScaler y PCA se envuelven en un Pipeline de scikit-learn y se ajustan dentro de cada fold de validación. Tratar el escalado y PCA como un preprocesado “offline” sobre \(X\) completa, y validar después, deja que el conjunto de prueba influya en el modelo y vuelve optimistas las métricas de validación. Aquí la diferencia es pequeña (RMS ≈ 0.03) porque hay 600 filas y la estructura es fuerte; con pocos datos o muchas variables crece. En cualquier caso, un número calculado con un modelo que ya vio la prueba deja de ser una estimación honesta.

Derivación breve: de la varianza máxima al autovector

Se quiere \(\max_{\mathbf{w}} f(\mathbf{w})=\mathbf{w}^{\top}\Sigma\mathbf{w}\) con \(g(\mathbf{w})=\mathbf{w}^{\top}\mathbf{w}-1=0\). El lagrangiano es

\[ \mathcal{L}(\mathbf{w},\lambda)=\mathbf{w}^{\top}\Sigma\mathbf{w}-\lambda(\mathbf{w}^{\top}\mathbf{w}-1). \]

La condición \(\nabla_{\mathbf{w}}\mathcal{L}=0\) da \(2\Sigma\mathbf{w}-2\lambda\mathbf{w}=\mathbf{0}\), es decir \(\Sigma\mathbf{w}=\lambda\mathbf{w}\). Como \(\Sigma\) es simétrica, existe una base ortonormal de autovectores. El mayor \(\lambda\) es el máximo de \(f\) en la esfera; el segundo, el máximo en el subespacio ortogonal al primero (se añade \(\mathbf{w}^{\top}\mathbf{w}_1=0\)).

Eso es todo el “misterio” de los componentes: no hay un algoritmo distinto de la teoría espectral de matrices simétricas.

Errores que conviene nombrar

  1. No centrar. Sin restar la media, el primer eje apunta hacia el centro de la nube, no a su dirección ancha.
  2. Mezclar unidades sin decidir la escala. La columna de mayor rango se queda con PC1 (Etapa 10).
  3. Elegir \(k\) con un umbral fijo (80%, 90%) sin argumentarlo con el scree, la reconstrucción o el dominio.
  4. Usar PCA como sustituto de \(y\). La señal puede vivir en el eje de menos varianza (Etapa 14).
  5. Comparar componentes sin tolerar el signo. \(\mathbf{w}\) y \(-\mathbf{w}\) son el mismo eje.
  6. Ajustar el escalado o PCA con todos los datos y validar después: es fuga de información.
  7. Nombrar un componente por su variable de mayor carga cuando otras del mismo bloque pesan parecido.
  8. Leer un componente como una causa. Es una rotación de los datos, no un mecanismo.

Idea clave

PCA no reduce columnas: reduce direcciones. Cambia a la base de la elipse de covarianza, ordena por ancho y corta. Eso es geometría, no un truco de librería.

Dos números deciden si el recorte fue honesto: \(\Pi_k\) (cuánta forma se guardó) y, cuando existe, el desempeño sobre \(y\) (cuánta señal se guardó). Si solo se reporta el primero, se ha contado la mitad de la historia.

Síntesis

Se partió de un espacio que se vacía (\(p\) grande, distancias planas) y se llegó a un procedimiento completo: centrar, formar \(\Sigma\), extraer \((\lambda_j,\mathbf{w}_j)\), leer \(\pi_k\), proyectar, reconstruir, repetir con sklearn y SVD, estandarizar cuando la unidad lo exige, interpretar cargas, y negar el uso automático cuando la clase vive en un eje delgado.

El objeto central no es PCA.fit. Es la elipse. Quien ve la elipse puede comprobar cualquier implementación.

6. Guía rápida: ¿qué hacer en cada situación?

Situación Qué usar Por qué
Visualizar \(p>3\) Primeros 2–3 PCs + scree Son las coordenadas de máximo ancho
Muchas columnas correlacionadas PCA sobre \(X\) estandarizada Ortogonaliza y comprime redundancia
Unidades distintas StandardScaler y luego PCA Si no, gana la columna de mayor rango
¿Cuántos ejes retener? Codo, \(\Pi_k\), reconstrucción, dominio No hay umbral universal
¿De qué está hecho un PC? Cargas \(W_{\cdot k}\) El nombre es el bloque, no una sola variable
Comprobar la implementación \(\lambda\) y \(\pi\) vs sklearn; ejes salvo signo SVD y \(\mathrm{eigh}(\Sigma)\) coinciden
Hay \(y\) y se quiere predecir No elegir \(k\) solo con varianza La señal puede vivir en un eje delgado
Forma no lineal PCA no basta El subespacio lineal no es la variedad

Regla de comunicación: indicar si se estandarizó, el \(k\), \(\Pi_k\), y si se contrastó contra un objetivo.

7. Guía práctica para reportar un PCA

Paso 1: espacio

\(n\), \(p\), unidades, si se centró (sí) y si se estandarizó (decisión).

Paso 2: espectro

Tabla \(\lambda_k\), \(\pi_k\), \(\Pi_k\). Scree y curva acumulada.

Paso 3: ejes

Cargas de los \(k\) retenidos. Una frase por componente: qué bloque de variables lo define.

Paso 4: calidad

Error de reconstrucción o varianza no explicada \(\sum_{j>k}\lambda_j\). Si hay \(y\), una métrica simple sobre \(Z_k\) frente a \(X\).

Paso 5: redactar

“Sobre [variables], estandarizadas/no, los primeros \(k=\_\) componentes conservan [Π]% de la varianza. PC1 agrupa [bloque]; PC2 agrupa [bloque]. Se retiene \(k\) porque [quiebre del gráfico / reconstrucción / dominio]. Limitación: [varianza ≠ objetivo / linealidad / escala].”

Caso real: 178 vinos italianos (UCI Wine)

Se aplica la plantilla de arriba a un dataset real: 178 vinos de tres cepas de la misma región de Italia, con 13 medidas químicas (alcohol, ácidos, fenoles, color, prolina, etc.). Las unidades no son comparables: el alcohol va ~11–15 y la prolina, cientos o miles. Por eso se estandariza antes del PCA.

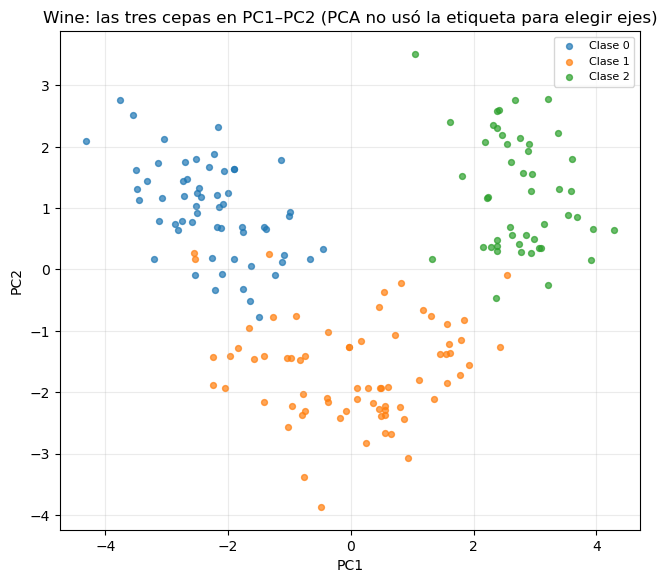
El cultivar (cepa) existe como etiqueta. Aquí no se usa para elegir los ejes —PCA no ve \(y\)—; solo se mira al final, para el paso 4.

from sklearn.datasets import load_wine

wine = load_wine()
X_wine = wine.data
y_wine = wine.target
nombres_wine = [
    "alcohol", "acido_malico", "cenizas", "alcalinidad_cenizas",
    "magnesio", "fenoles_totales", "flavonoides", "fenoles_no_flavonoides",
    "proantocianidinas", "intensidad_color", "tono", "od280_od315", "prolina",
]
print("n =", X_wine.shape[0], "  p =", X_wine.shape[1])
print("Unidades distintas: alcohol ~", X_wine[:, 0].min().round(1), "-", X_wine[:, 0].max().round(1),
      " | prolina ~", int(X_wine[:, -1].min()), "-", int(X_wine[:, -1].max()))

X_wine_s = StandardScaler().fit_transform(X_wine)
pca_wine = pca_manual(X_wine_s)
pi_w = pca_wine["lambdas"] / pca_wine["lambdas"].sum()
acum_w = np.cumsum(pi_w)

espectro = pd.DataFrame({
    "k": np.arange(1, 14),
    "lambda": pca_wine["lambdas"],
    "pi": pi_w,
    "Pi": acum_w,
})
print()
print("Paso 2 — espectro (primeros 6):")
display(espectro.head(6).round(3))
print(f"Π_2 = {100*acum_w[1]:.1f}%   Π_3 = {100*acum_w[2]:.1f}%   Π_5 = {100*acum_w[4]:.1f}%")

graficar_scree(pca_wine["lambdas"], "Wine: varianza por componente (datos reales, estandarizados)")

k_rep = 3
cargas_w = pd.DataFrame(
    pca_wine["W"][:, :k_rep],
    index=nombres_wine,
    columns=[f"PC{j+1}" for j in range(k_rep)],
)
print("Paso 3 — cargas de los 3 ejes retenidos:")
display(cargas_w.round(2))
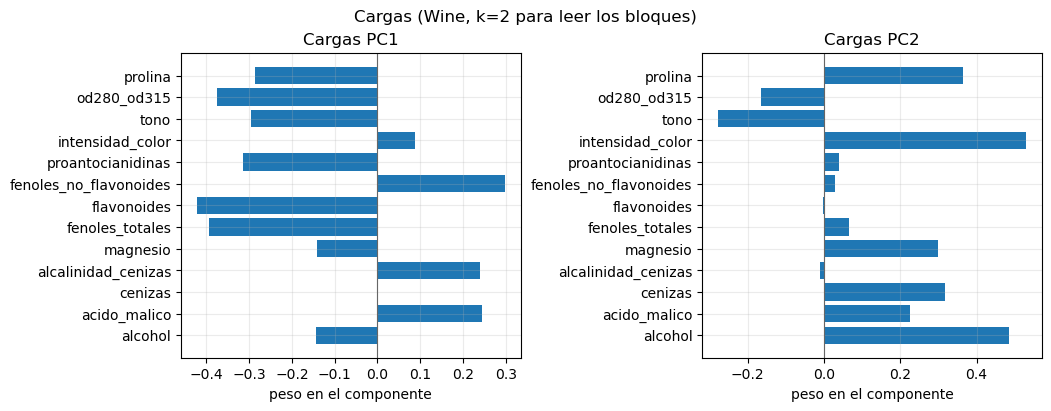
graficar_cargas(pca_wine["W"], nombres_wine, "Cargas (Wine, k=2 para leer los bloques)", k=2)

Xhat3 = reconstruir(pca_wine, 3)
mse3 = np.mean((X_wine_s - Xhat3) ** 2)
print(f"Paso 4 — MSE de reconstrucción con k=3: {mse3:.3f}")
print("Varianza no usada (1-Π_3):", f"{100*(1-acum_w[2]):.1f}%")
print("Media de PC1 por cepa:", np.round([pca_wine["Z"][y_wine==c, 0].mean() for c in (0, 1, 2)], 2))

graficar_nube_2d(
    pca_wine["Z"][:, :2],
    "Wine: las tres cepas en PC1–PC2 (PCA no usó la etiqueta para elegir ejes)",
    clases=y_wine,
    ejes=("PC1", "PC2"),
)
n = 178   p = 13
Unidades distintas: alcohol ~ 11.0 - 14.8  | prolina ~ 278 - 1680

Paso 2 — espectro (primeros 6):
k lambda pi Pi
0 1 4.732 0.362 0.362
1 2 2.511 0.192 0.554
2 3 1.454 0.111 0.665
3 4 0.924 0.071 0.736
4 5 0.858 0.066 0.802
5 6 0.645 0.049 0.851
Π_2 = 55.4%   Π_3 = 66.5%   Π_5 = 80.2%

Paso 3 — cargas de los 3 ejes retenidos:
PC1 PC2 PC3
alcohol -0.14 0.48 0.21
acido_malico 0.25 0.22 -0.09
cenizas 0.00 0.32 -0.63
alcalinidad_cenizas 0.24 -0.01 -0.61
magnesio -0.14 0.30 -0.13
fenoles_totales -0.39 0.07 -0.15
flavonoides -0.42 -0.00 -0.15
fenoles_no_flavonoides 0.30 0.03 -0.17
proantocianidinas -0.31 0.04 -0.15
intensidad_color 0.09 0.53 0.14
tono -0.30 -0.28 -0.09
od280_od315 -0.38 -0.16 -0.17
prolina -0.29 0.36 0.13

Paso 4 — MSE de reconstrucción con k=3: 0.335
Varianza no usada (1-Π_3): 33.5%
Media de PC1 por cepa: [-2.28  0.04  2.75]

Los cinco pasos, aplicados

  1. Espacio. \(n=178\), \(p=13\) medidas químicas de vinos (UCI Wine). Unidades distintas → se estandarizó. Se centró (siempre).
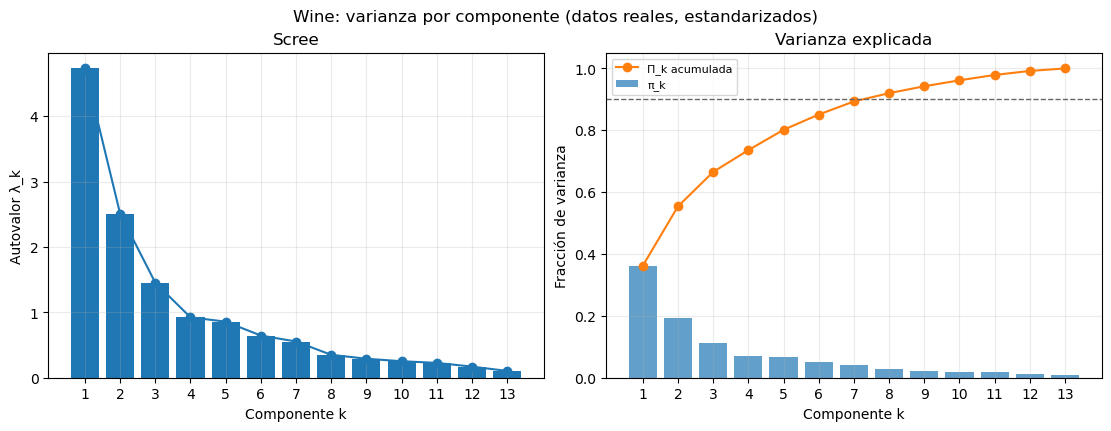
  2. Espectro. \(\pi_1=36.2\%\), \(\pi_2=19.2\%\), \(\pi_3=11.1\%\). Acumulado: \(\Pi_2=55.4\%\), \(\Pi_3=66.5\%\), \(\Pi_5=80.2\%\). El gráfico se aplana después de \(k=3\).
  3. Ejes. PC1 es el bloque fenólico (flavonoides, fenoles totales, OD280, proantocianidinas, tono; en sentido opuesto, ácido málico y fenoles no flavonoides). PC2 es cuerpo y color (intensidad de color, alcohol, prolina, cenizas, magnesio).
  4. Calidad. Con \(k=3\) queda fuera el \(33.5\%\) de la varianza. Las tres cepas se separan a ojo en PC1–PC2, aunque PCA no usó la etiqueta para construir los ejes.
  5. Reporte.

Sobre las 13 medidas químicas de 178 vinos italianos (UCI Wine), estandarizadas, los primeros \(k=3\) componentes conservan el \(66.5\%\) de la varianza. PC1 agrupa el bloque fenólico (flavonoides, fenoles, OD280, tono); PC2 agrupa cuerpo y color (intensidad de color, alcohol, prolina). Se retiene \(k=3\) porque el gráfico de \(\lambda_k\) se aplana después del tercer eje y \(k=2\) ya basta para ver las cepas; harían falta \(k=5\) si se exigiera la convención del \(80\%\). Limitación: el \(33.5\%\) no usado podría contener señal de cepa; PCA se usó para describir \(X\), no para predecir el cultivar.

8. Puente hacia las siguientes sesiones

El espacio \(\mathbb{R}^p\) ya no es un bloque rígido: se puede rotar, ordenar y cortar. La probabilidad y la inferencia que siguen trabajan sobre coordenadas —a veces las originales, a veces unas transformadas.

PCA no cierra el modelado. Deja un \(Z_k\) con el que más adelante se ajusta una recta, se clasifica o se valida. La precaución de la etapa 14 viaja con ese \(Z_k\): compactar \(X\) no autoriza a olvidar \(y\).

9. Cierre

Este notebook deja una construcción completa de PCA:

  • el problema de la alta dimensionalidad como pérdida de contraste entre distancias,
  • el centrado y \(\Sigma\) como forma de la nube,
  • componentes = autovectores, varianza = autovalores,
  • proyección, varianza explicada, reconstrucción,
  • equivalencia SVD / eigh / scikit-learn (salvo signo),
  • el efecto de la escala y la lectura de cargas,
  • el contrapunto: maximizar varianza no es maximizar señal,
  • un caso real (vinos UCI) reportado con la plantilla de la sección 7.

Resultado esperado: el estudiante puede dibujar la elipse, escribir \(\Sigma\mathbf{w}=\lambda\mathbf{w}\), elegir \(k\) con \(\Pi_k\) y con un argumento, reproducir el resultado en sklearn y explicar un caso en el que quedarse con PC1 sería un error.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.