Estadística para IA — 8. Fundamentos de probabilidad
estadistica
probabilidad
bayes
Experimento aleatorio, espacio muestral, eventos, probabilidad condicional, independencia, teorema de Bayes y un caso de clasificación binaria.
Author
Wilder Ramírez Delgado
Published
September 25, 2026
Sesión 8 — Fundamentos de Probabilidad
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Probabilidad Aplicada a la Incertidumbre
Un modelo no “sabe” el futuro: asigna números entre 0 y 1 a resultados posibles. Esa es la probabilidad. Sin ella no hay clasificación, no hay intervalos y no hay forma honesta de decir “estoy más seguro de A que de B”.
Este notebook construye el lenguaje mínimo: experimento aleatorio, espacio muestral, evento, probabilidad condicional, independencia y el teorema de Bayes. La práctica es simular: contar frecuencias y ver cómo se acercan a la fórmula. El contraste que importa es clásico y cruelmente útil: una prueba muy sensible no implica que un positivo sea casi seguro —si el caso es raro.
Contexto: monedas y dados para fijar las definiciones; después una prueba diagnóstica y un filtro de fraude (clasificación binaria).
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 3 · Sesión 8
Objetivos
Distinguir experimento, espacio muestral\(\Omega\) y evento.
Estimar una probabilidad por frecuencia relativa y compararla con la fórmula.
Calcular probabilidad condicional\(P(A\mid B)\) e interpretarla como un recorte del espacio.
Decidir si dos eventos son independientes (y no confundirlos con “no pueden ocurrir a la vez”).
Aplicar la probabilidad total y el teorema de Bayes.
Usar Bayes en un problema de clasificación binaria (prueba diagnóstica / alerta de fraude).
Redactar \(P(\text{clase}\mid \text{evidencia})\) sin invertir el condicional.
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. El lenguaje de lo incierto
1.1 Experimento aleatorio
Un experimento aleatorio es un procedimiento con más de un resultado posible, que se puede repetir en las mismas condiciones, y cuyo resultado individual no se conoce de antemano. Lanzar un dado, extraer un correo, medir si un cliente incumple: los tres caben.
1.2 Espacio muestral
El espacio muestral\(\Omega\) es el conjunto de todos los resultados simples que se consideran. Para un dado honesto, \(\Omega=\{1,2,3,4,5,6\}\). Cada elemento de \(\Omega\) se llama resultado (o punto muestral).
Definir \(\Omega\) es una decisión: si solo importa “par o impar”, se puede trabajar con \(\Omega=\{\text{par},\text{impar}\}\). El espacio no es la realidad; es el mapa que se eligió.
1.3 Evento
Un evento\(A\) es un subconjunto de \(\Omega\). “Sacar par” es \(A=\{2,4,6\}\). El evento ocurre si el resultado cae en \(A\).
Se lee: entre las veces en que ya ocurrió \(B\), qué fracción son también \(A\). El condicional recorta\(\Omega\) a \(B\) y vuelve a normalizar. No es “la probabilidad de A y después B” en el tiempo; es un cambio de denominador.
1.6 Independencia
\(A\) y \(B\) son independientes si saber uno no cambia la probabilidad del otro:
\[
P(A\mid B)=P(A) \iff P(A\cap B)=P(A)\,P(B).
\]
Disjuntos e independientes casi nunca coinciden: si son disjuntos y ambos tienen probabilidad positiva, saber que ocurrió \(A\)fuerza\(P(B\mid A)=0\neq P(B)\).
1.7 Probabilidad total y Bayes
Si \(H\) y \(H^c\) parten \(\Omega\),
\[
P(E)=P(E\mid H)P(H)+P(E\mid H^c)P(H^c).
\]
El teorema de Bayes invierte el condicional:
\[
P(H\mid E)=\frac{P(E\mid H)\,P(H)}{P(E)}.
\]
Nombres que usa la IA:
Símbolo
Nombre
Pregunta
\(P(H)\)
Prior
¿Qué tan frecuente es la clase antes de ver el dato?
\(P(E\mid H)\)
Verosimilitud
Si la clase es \(H\), ¿qué tan creíble es el dato?
\(P(H\mid E)\)
Posterior
Ya visto el dato, ¿qué tan creíble es la clase?
Un clasificador binario, en el fondo, compara \(P(H=1\mid x)\) con \(P(H=0\mid x)\). Bayes es esa comparación hecha explícita.
Pregunta
Herramienta
¿Qué resultados admito?
\(\Omega\)
¿Qué subconjunto me interesa?
Evento
¿Qué tan frecuente es, sin otra información?
\(P(A)\)
¿Y si ya sé que ocurrió \(B\)?
\(P(A\mid B)\)
¿Saber \(B\) cambia \(A\)?
Independencia
Tengo \(P(E\mid H)\) y quiero \(P(H\mid E)\)
Bayes
2. Por qué importa en IA y Machine Learning
El modelo no entrega una verdad: entrega una incertidumbre numérica.
En clasificación, la salida útil es \(P(y=1\mid x)\), no solo una etiqueta.
Un falso positivo y un falso negativo no pesan igual si la clase positiva es rara (fraude, enfermedad, spam agresivo). Bayes obliga a poner la frecuencia base\(P(y=1)\) sobre la mesa.
Naive Bayes asume independencia entre features dado \(y\). Esa hipótesis se entiende —y se critica— solo si se entiende independencia.
En calibración, “el modelo dijo 0.8” debería significar que, de cada 100 casos así, cerca de 80 son positivos. Eso es frecuencia relativa.
Idea central:\(P(A\mid B)\) y \(P(B\mid A)\) no son el mismo número. Confundirlos es el error que convierte una prueba buena en una alarma inútil.
3. Flujo recomendado de trabajo
Escribir \(\Omega\) y los eventos con palabras y con conjuntos.
Decidir si se calcula o se simula. Lo pequeño se cuenta; lo compuesto se simula y se contrasta con la fórmula.
Preguntar qué está a la derecha de la barra.\(P(A\mid B)\) condiciona a \(B\), no a \(A\).
Separar disjuntos de independientes antes de multiplicar o sumar.
Si se invierte un condicional, usar Bayes y escribir prior, verosimilitud y evidencia.
Traducir al problema: ¿qué es la clase? ¿qué es la evidencia? ¿cuál es la frecuencia base?
Criterio general: un número de probabilidad sin el evento escrito es un número suelto.
4. Preparar el entorno
%matplotlib inlineimport sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltrng = np.random.default_rng(42)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("Entorno listo: numpy, pandas, matplotlib.")print("pandas:", pd.__version__, "| numpy:", np.__version__)
Funciones de visualización (definidas una sola vez)
Cada etapa solo llama a la función. El detalle del gráfico queda aquí.
def graficar_estabilizacion(ocurrencias, p_teorica, titulo, etiqueta_p="P(A)"): n = np.arange(1, len(ocurrencias) +1) frec = np.cumsum(ocurrencias) / n fig, ax = plt.subplots(figsize=(8.2, 4.2)) ax.plot(n, frec, label="frecuencia relativa") ax.axhline(p_teorica, linestyle="--", color="C1", label=f"{etiqueta_p} = {p_teorica:.3f}") ax.set_xlabel("número de repeticiones n") ax.set_ylabel("fracción de éxitos") ax.set_title(titulo) ax.legend(fontsize=8) ax.set_ylim(-0.05, 1.05) plt.tight_layout() plt.show()def graficar_barras_probs(etiquetas, teoricas, estimadas, titulo): x = np.arange(len(etiquetas)) w =0.38 fig, ax = plt.subplots(figsize=(8.4, 4.2)) ax.bar(x - w /2, teoricas, w, label="fórmula") ax.bar(x + w /2, estimadas, w, label="simulación") ax.set_xticks(x, etiquetas) ax.set_ylim(0, 1) ax.set_ylabel("probabilidad") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_prior_vs_posterior(nombres, prior, posterior, titulo): x = np.arange(len(nombres)) w =0.38 fig, ax = plt.subplots(figsize=(7.6, 4.2)) ax.bar(x - w /2, prior, w, label="antes de la evidencia (prior)") ax.bar(x + w /2, posterior, w, label="después (posterior)") ax.set_xticks(x, nombres) ax.set_ylim(0, 1) ax.set_ylabel("probabilidad") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_conteos_prueba(enfermos_pos, sanos_pos, enfermos_neg, sanos_neg, titulo):"""Izquierda: toda la población. Derecha: solo los positivos (ahí se decide P(E | +)).""" fig, axes = plt.subplots(1, 2, figsize=(11, 4.4), constrained_layout=True) b1 = axes[0].bar([0, 1], [enfermos_pos, enfermos_neg], 0.4, label="enfermos") b2 = axes[0].bar([0.4, 1.4], [sanos_pos, sanos_neg], 0.4, label="sanos") axes[0].bar_label(b1, fontsize=8) axes[0].bar_label(b2, fontsize=8) axes[0].set_xticks([0.2, 1.2], ["prueba +", "prueba −"]) axes[0].set_ylabel("personas (simulación)") axes[0].set_title("Toda la población") axes[0].legend(fontsize=8) total_pos = enfermos_pos + sanos_pos b3 = axes[1].bar(["enfermos", "sanos"], [enfermos_pos, sanos_pos], color=["C0", "C1"]) axes[1].bar_label(b3, labels=[f"{enfermos_pos} ({enfermos_pos / total_pos:.0%})",f"{sanos_pos} ({sanos_pos / total_pos:.0%})"], fontsize=9) axes[1].set_ylabel("personas con prueba +") axes[1].set_title(f"Solo los {total_pos} positivos") fig.suptitle(titulo) plt.show()
5. Desarrollo por etapas
Se parte de un dado y una moneda —\(\Omega\) se puede listar— y se llega a Bayes con una prueba diagnóstica y un filtro de fraude. Cada simulación se contrasta con la fórmula.
Etapa 1: Experimento, \(\Omega\) y eventos
Se lanza un dado de seis caras. El espacio muestral es \(\Omega=\{1,2,3,4,5,6\}\). Tres eventos:
\(P\) = par \(=\{2,4,6\}\),
\(M\) = mayor que 4 \(=\{5,6\}\),
\(S\) = seis \(=\{6\}\).
Si el dado es honesto, cada cara tiene probabilidad \(1/6\). Entonces \(P(P)=3/6=1/2\), \(P(M)=2/6=1/3\), \(P(S)=1/6\).
Omega = np.array([1, 2, 3, 4, 5, 6])print("Espacio muestral Ω =", Omega)def P_dado(evento):returnlen(evento) /len(Omega)par = Omega[Omega %2==0]mayor4 = Omega[Omega >4]seis = Omega[Omega ==6]print("P = par ", par, " P(P) =", P_dado(par))print("M = mayor que 4 ", mayor4, " P(M) =", P_dado(mayor4))print("S = seis ", seis, " P(S) =", P_dado(seis))print("Complemento de P (impar):", Omega[Omega %2==1], " P =", 1- P_dado(par))
Espacio muestral Ω = [1 2 3 4 5 6]
P = par          [2 4 6]   P(P) = 0.5
M = mayor que 4  [5 6]   P(M) = 0.3333333333333333
S = seis         [6]   P(S) = 0.16666666666666666
Complemento de P (impar): [1 3 5]   P = 0.5
Lectura. Listar \(\Omega\) no es burocracia: fija el denominador. Si alguien dice “la probabilidad de par” sin decir de qué experimento, el número no está anclado.
Etapa 2: La frecuencia se parece a \(P\) cuando \(n\) crece
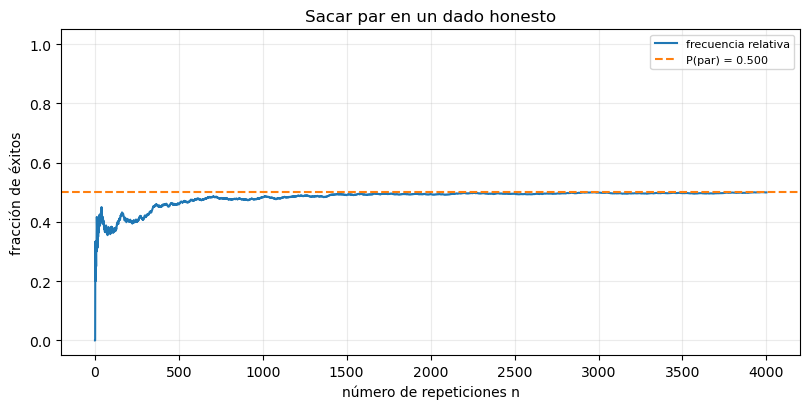
Se simulan \(n=4000\) lanzamientos. La fracción de pares debe acercarse a \(1/2\).
Antes del gráfico: al principio la línea tiembla; al final debe pegarse a la horizontal \(0.5\). Eso no es magia: es la ley de los grandes números, vista como conteo.
n =4000lanzamientos = rng.integers(1, 7, size=n)es_par = (lanzamientos %2==0).astype(int)print("Frecuencia relativa de par:", es_par.mean().round(4), " (teórica 0.5)")print("Frecuencia de mayor que 4:", (lanzamientos >4).mean().round(4), " (teórica 0.333)")graficar_estabilizacion(es_par, 0.5, "Sacar par en un dado honesto", "P(par)")
Frecuencia relativa de par: 0.4995   (teórica 0.5)
Frecuencia de mayor que 4: 0.3332   (teórica 0.333)
Después. Con pocos lanzamientos el azar manda; con miles, la fracción se estabiliza. En un dataset, una clase que aparece 7 veces en 10 no “tiene probabilidad 0.7” de forma estable: \(n\) es chico. La misma lección aplica a una métrica de clasificación calculada en una muestra corta.
Etapa 3: Unión e intersección
\[
P(P\cup M)=P(P)+P(M)-P(P\cap M)
\]
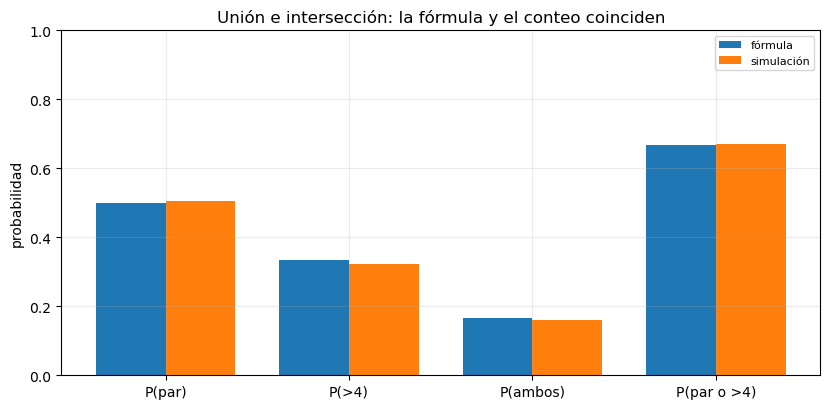
\(P\cap M=\{6\}\), así que \(1/2+1/3-1/6=2/3\). Si se sumara \(P(P)+P(M)\) sin restar la intersección, el 6 se contaría dos veces.
n =8000x = rng.integers(1, 7, size=n)f_union = np.mean((x %2==0) | (x >4))f_inter = np.mean((x %2==0) & (x >4))print("P(P ∪ M) teórica =", round(0.5+1/3-1/6, 4), " simulada =", round(f_union, 4))print("P(P ∩ M) teórica =", round(1/6, 4), " simulada =", round(f_inter, 4))print("P(P)+P(M) sin restar intersección =", round(0.5+1/3, 4), " (se pasa)")graficar_barras_probs( ["P(par)", "P(>4)", "P(ambos)", "P(par o >4)"], [0.5, 1/3, 1/6, 2/3], [np.mean(x %2==0), np.mean(x >4), f_inter, f_union],"Unión e intersección: la fórmula y el conteo coinciden",)
P(P ∪ M) teórica = 0.6667   simulada = 0.6701
P(P ∩ M) teórica = 0.1667   simulada = 0.1594
P(P)+P(M) sin restar intersección = 0.8333   (se pasa)
Lectura. Restar \(P(A\cap B)\) no es un truco algebraico: evita contar dos veces a quien está en los dos conjuntos. En un dashboard, sumar “% de clientes con impago” más “% con alerta” sin restar el cruce infla el total.
Etapa 4: Condicional — se cambia el denominador
¿Cuál es la probabilidad de sacar un 6 si ya sabemos que salió par?
El contraste.\(P(\text{seis}\mid \text{par})=1/3\) y \(P(\text{par}\mid \text{seis})=1\). Invertir la barra cambia el número. En un modelo: \(P(\text{enfermedad}\mid \text{test}+)\)no es \(P(\text{test}+\mid \text{enfermedad})\).
Etapa 5: Independencia — dos monedas
Se lanzan dos monedas honestas. \(\Omega=\{CC,CS,SC,SS\}\), cada uno con probabilidad \(1/4\).
\(A\) = “la primera es cara” \(=\{CC,CS\}\), \(P(A)=1/2\).
\(B\) = “la segunda es cara” \(=\{CC,SC\}\), \(P(B)=1/2\).
\(A\cap B=\{CC\}\), \(P(A\cap B)=1/4=P(A)P(B)\). Son independientes.
Ahora \(C\) = “sale exactamente una cara” \(=\{CS,SC\}\). La intuición dice que \(A\) y \(C\) dependen: si la primera fue cara, la segunda tiene que ser sello. Pero la cuenta dice otra cosa: \(P(C)=1/2\) y \(P(C\mid A)=P(\text{segunda sello})=1/2\). Son independientes.
En cambio, \(E\) = “salen dos caras” \(=\{CC\}\) sí depende de \(A\): \(P(E)=1/4\), pero \(P(E\mid A)=1/2\).
n =10000m1 = rng.integers(0, 2, size=n) # 1 = caram2 = rng.integers(0, 2, size=n)A = m1 ==1B = m2 ==1C = (m1 + m2) ==1# exactamente una caraE = (m1 + m2) ==2# dos carasprint("P(A)P(B) =", round(A.mean() * B.mean(), 4), " P(A ∩ B) =", round(np.mean(A & B), 4))print("¿A y B independientes (aprox.)?", abs(np.mean(A & B) - A.mean() * B.mean()) <0.02)print()print("C = exactamente una cara: P(C) =", round(C.mean(), 4), " P(C | A) =", round(np.mean(C[A]), 4)," → independientes (parecía que no)")print("E = dos caras: P(E) =", round(E.mean(), 4), " P(E | A) =", round(np.mean(E[A]), 4)," → no independientes")# Disjuntos: A y "ambas sellos"D = (m1 ==0) & (m2 ==0)print()print("A y 'ambas sellos' son disjuntos: P(A ∩ D) =", round(np.mean(A & D), 6))print("P(D | A) =", round(np.mean(D[A]) if A.any() else0, 4), "≠ P(D) =", round(D.mean(), 4))print("Disjuntos con P>0 ⇒ no independientes.")
P(A)P(B) = 0.2555   P(A ∩ B) = 0.2557
¿A y B independientes (aprox.)? True

C = exactamente una cara:  P(C) = 0.4995   P(C | A) = 0.4941   → independientes (parecía que no)
E = dos caras:             P(E) = 0.2557   P(E | A) = 0.5059   → no independientes

A y 'ambas sellos' son disjuntos: P(A ∩ D) = 0.0
P(D | A) = 0.0 ≠ P(D) = 0.2448
Disjuntos con P>0 ⇒ no independientes.
La independencia se comprueba con números, no con intuición:\(A\) y \(C\) parecían ligados y no lo están; \(A\) y \(E\) sí lo están.
Regla de bolsillo. Independiente = saber uno no mueve al otro. Disjunto = no caben los dos. Si caben los dos y ambos pueden ocurrir, no uses la intuición de “se excluyen” para multiplicar.
Etapa 6: Probabilidad total — dos máquinas
Una fábrica tiene dos líneas:
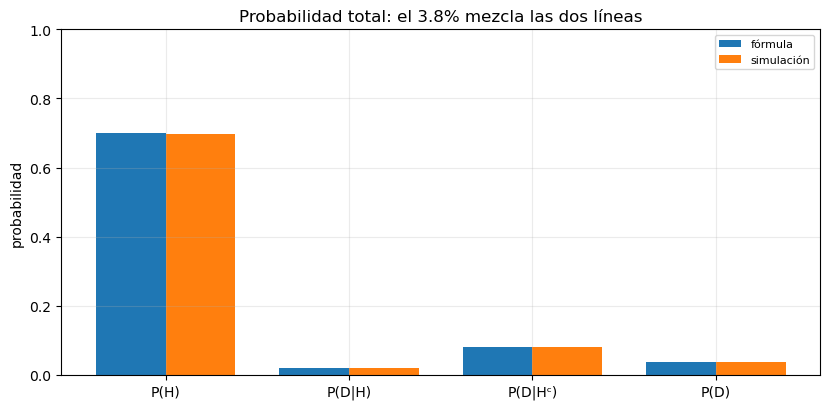
Línea \(H\): produce el \(70\%\) de las piezas; el \(2\%\) sale defectuosa.
Línea \(H^c\): produce el \(30\%\); el \(8\%\) sale defectuosa.
Lectura.\(P(D)\) es la evidencia que más tarde irá al denominador de Bayes. Si solo se reporta “esta línea tiene 2% de defectos”, se oculta que un tercio de la producción es la línea mala.
Etapa 7: Bayes — ¿de qué línea salió la pieza defectuosa?
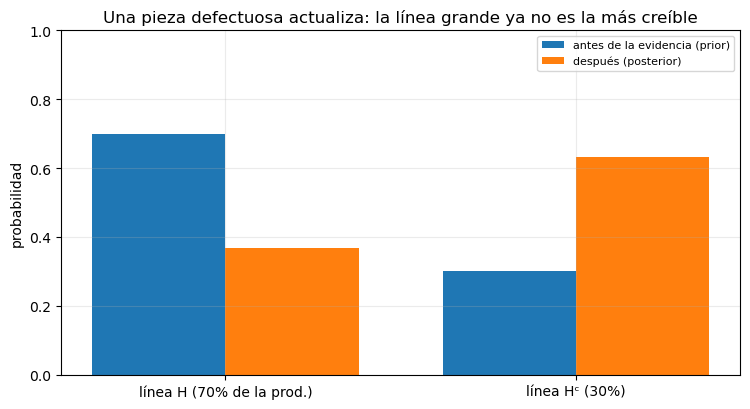
Aunque la línea \(H\) produce el \(70\%\) de las piezas, solo el \(37\%\) de los defectos vienen de ella. La línea chica es más sucia y se lleva la mayoría de las alertas.
p_h_dado_d = (0.02*0.70) /0.038print("P(H | D) teórica =", round(p_h_dado_d, 4))print("P(H | D) simulada =", round(linea[defectuosa].mean(), 4))print("P(H^c | D) =", round(1- p_h_dado_d, 4))graficar_prior_vs_posterior( ["línea H (70% de la prod.)", "línea Hᶜ (30%)"], [0.70, 0.30], [p_h_dado_d, 1- p_h_dado_d],"Una pieza defectuosa actualiza: la línea grande ya no es la más creíble",)
Idea de esta etapa. El prior \(0.70\) se actualiza con la verosimilitud \(0.02\) frente a \(0.08\). Bayes no “adivina”: repondera. Un clasificador hace lo mismo cuando combina \(P(y)\) con \(P(x\mid y)\).
Etapa 8: El contraste que importa — prueba diagnóstica
Se examinan \(10\,000\) personas.
Enfermedad rara: \(P(E)=0.01\) (1 de cada 100).
Sensibilidad: \(P(+\mid E)=0.99\) (casi no se escapa un enfermo).
Falsos positivos: \(P(+\mid E^c)=0.05\) (5 de cada 100 sanos dan +).
La pregunta incorrecta que suele hacerse: “la prueba acierta el 99%, ¿entonces un + es casi seguro enfermo?”.
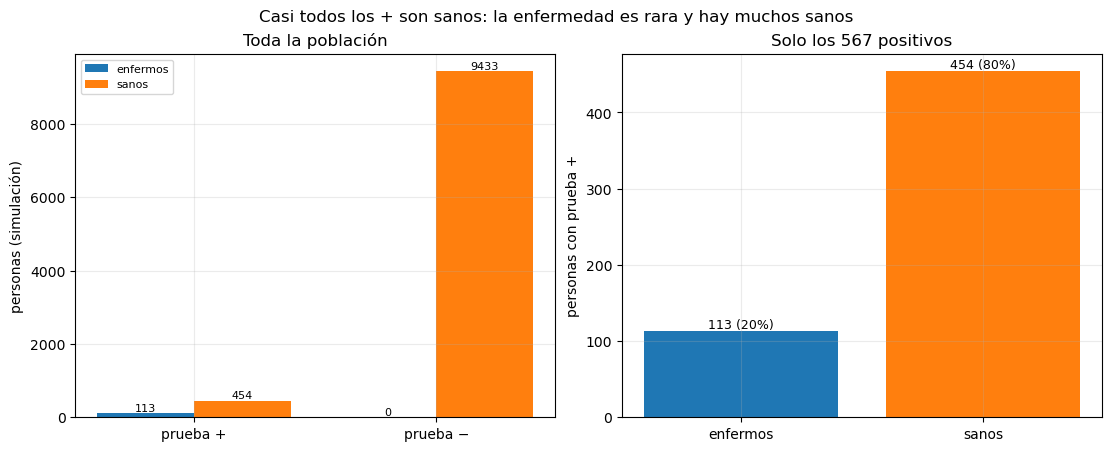
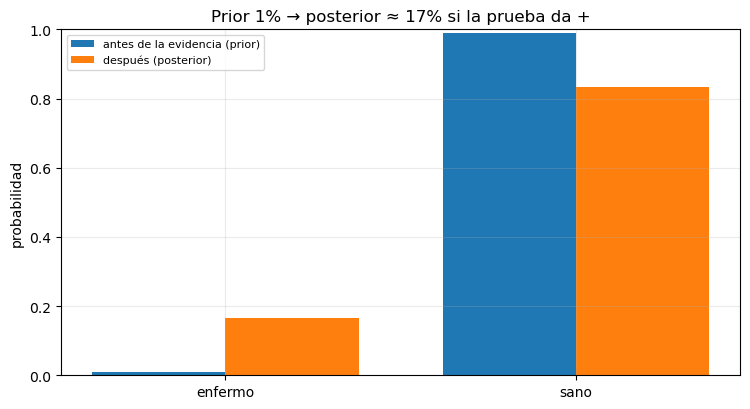
Un positivo es enfermo solo 1 de cada 6 veces. El 99% mide \(P(+\mid E)\), no \(P(E\mid +)\).
n =10000enfermo = rng.random(n) <0.01positivo = np.where(enfermo, rng.random(n) <0.99, rng.random(n) <0.05)n_e_pos =int((enfermo & positivo).sum())n_s_pos =int((~enfermo & positivo).sum())n_e_neg =int((enfermo &~positivo).sum())n_s_neg =int((~enfermo &~positivo).sum())print("Tabla de conteos:")print(pd.DataFrame( [[n_e_pos, n_e_neg], [n_s_pos, n_s_neg]], index=["enfermo", "sano"], columns=["prueba +", "prueba −"],))print()print("P(E | +) simulada =", round(n_e_pos / (n_e_pos + n_s_pos), 4), " teórica ≈ 0.167")print("La diferencia es variación de muestreo (n=10000, pocos enfermos); no un error de la fórmula.")print("P(+ | E) simulada =", round(n_e_pos / enfermo.sum(), 4), " (sensibilidad, ~0.99)")print("Entre los +, sanos / total + =", round(n_s_pos / (n_e_pos + n_s_pos), 4))graficar_conteos_prueba( n_e_pos, n_s_pos, n_e_neg, n_s_neg,"Casi todos los + son sanos: la enfermedad es rara y hay muchos sanos",)graficar_prior_vs_posterior( ["enfermo", "sano"], [0.01, 0.99], [0.99*0.01/0.0594, 1-0.99*0.01/0.0594],"Prior 1% → posterior ≈ 17% si la prueba da +",)
Tabla de conteos:
         prueba +  prueba −
enfermo       113         0
sano          454      9433

P(E | +) simulada = 0.1993   teórica ≈ 0.167
La diferencia es variación de muestreo (n=10000, pocos enfermos); no un error de la fórmula.
P(+ | E) simulada = 1.0   (sensibilidad, ~0.99)
Entre los +, sanos / total + = 0.8007
La simulación no tiene que dar 0.167 exacto. Con unos 100 enfermos en 10 000 filas, el posterior empírico tiembla (aquí puede salir ~0.20). La fórmula 16.7% es el valor de diseño.
Por qué el número es bajo. Hay 9900 sanos. El 5% de ellos son 495 falsos +. Hay ~100 enfermos y ~99 verdaderos +. En la canasta de positivos, 495 contra 99. La prueba es buena; la frecuencia base es pequeña. Un modelo de fraude o de enfermedad rara vive en este régimen.
En clasificación esto se llama desbalance. Accuracy “99% de sanos bien clasificados” puede convivir con un posterior miserable.
Etapa 9: Clasificación binaria — alerta de fraude
Cada transacción es \(y=1\) (fraude) o \(y=0\). Una regla simple dispara alerta si el monto es alto y el país no es el habitual. Números diseñados, no de un banco real:
\(P(y=1)=0.02\),
\(P(\text{alerta}\mid y=1)=0.80\),
\(P(\text{alerta}\mid y=0)=0.10\).
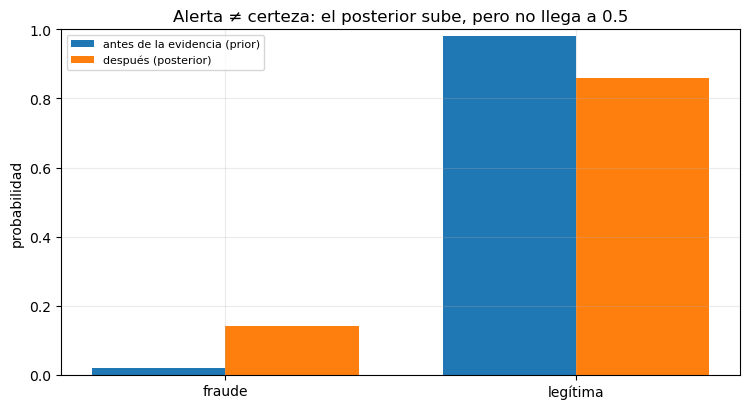
El sistema no entrega “es fraude”: entrega \(P(y=1\mid \text{alerta})\).
Traducción a métricas.\(P(y=1\mid \text{alerta})\) es la precisión de la alerta. \(P(\text{alerta}\mid y=1)\) es el recall. Una alerta con recall 80% y precisión ~14% es un filtro útil para revisar a mano, no un veredicto automático.
Un umbral de decisión (“si posterior \(>0.5\), bloquear”) aquí no bloquearía: \(0.14<0.5\). El umbral se elige con costos (¿cuánto cuesta molestar a un cliente honesto frente a dejar pasar un fraude?), no con el 50% por costumbre.
Etapa 10: Naive Bayes de una palabra — el mismo teorema
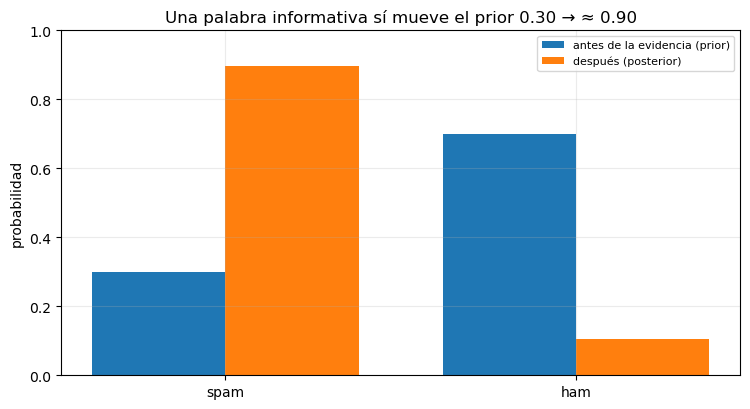
Un filtro de correo. Solo dos clases y una evidencia: si el asunto contiene la palabra “premio”.
Con una sola palabra bien dispar, el posterior sí cruza 0.5. Naive Bayes con muchas palabras multiplica verosimilitudes (asumiendo independencia dada la clase). Esa independencia es una hipótesis: “gratis” y “premio” no son independientes dentro de cada clase en la vida real, y aun así el clasificador suele funcionar como baseline.
Comparar las etapas 8, 9 y 10. El teorema es el mismo. Cambia la frecuencia base y cuánto separa la evidencia. En la prueba médica el prior es 1% y hay muchos falsos +; en el correo el prior es 30% y la palabra es rara en ham. El número que se reporta siempre es \(P(\text{clase}\mid \text{dato})\), no al revés.
Caso aplicado: reportar un posterior
Plantilla mínima (el análogo del reporte de PCA, para probabilidad):
Experimento y \(\Omega\): qué se observa, qué clases hay.
Prior:\(P(\text{clase})\) y de dónde sale (histórico, diseño).
Verosimilitud:\(P(\text{evidencia}\mid \text{clase})\) — sensibilidad, tasa de alerta, etc.
Evidencia:\(P(\text{dato})\) por probabilidad total.
Posterior y decisión:\(P(\text{clase}\mid \text{dato})\) y qué se hace con el umbral.
Se aplica a la prueba diagnóstica de la etapa 8.
Los cinco pasos, aplicados
Experimento. Persona de una población; \(\Omega\) se parte en enfermo / sano. Evidencia: prueba \(+\) o \(-\).
Prior.\(P(E)=0.01\) (1% de prevalencia, dato de diseño).
Evidencia.\(P(+)=0.0594\) (casi 6 de cada 100 dan +).
Posterior.\(P(E\mid +)\approx 0.167\).
En una población con 1% de prevalencia, una prueba con sensibilidad 99% y 5% de falsos positivos produce \(P(\text{enfermedad}\mid +)\approx 16.7\%\). Se informa ese posterior, no la sensibilidad. Decisión: un + no autoriza tratamiento por sí solo; autoriza una segunda prueba. Limitación: el 1% y el 5% son supuestos; si la prevalencia sube (un brote), el mismo test se vuelve más informativo.
Errores que conviene nombrar
Invertir el condicional. Reportar \(P(+\mid E)\) cuando la decisión pide \(P(E\mid +)\).
Ignorar la frecuencia base. Un test excelente en una clase rara genera más falsos + que verdaderos +.
Confundir disjuntos con independientes. “No pueden ser las dos” no autoriza a multiplicar \(P(A)P(B)\).
Tratar una frecuencia de \(n=20\) como \(P\) estable. La etapa 2 muestra el temblor.
Umbral 0.5 por costumbre. El umbral es un costo, no un teorema.
Decidir la independencia por intuición. “Primera cara” y “exactamente una cara” parecen ligados y son independientes; se comprueba con \(P(A\cap B)=P(A)P(B)\).
Idea clave
La barra del condicional elige el denominador. Bayes no crea información: cambia la pregunta de “si es de esta clase, ¿cómo se ve el dato?” a “visto el dato, ¿de qué clase es?”. En IA esa inversión es el clasificador.
Síntesis
Se definió \(\Omega\), se contaron eventos, se vio la frecuencia estabilizarse, se recortó el espacio (condicional), se separó independencia de exclusión, se mezclaron grupos (probabilidad total) y se invirtió el condicional (Bayes) en una fábrica, una prueba médica, un fraude y un correo. El objeto que queda para las sesiones de inferencia y de modelos es \(P(\text{hipótesis}\mid \text{datos})\).
6. Guía rápida: ¿qué fórmula usar?
Situación
Qué usar
Por qué
Listar resultados posibles
\(\Omega\)
Fija el denominador
“No ocurrió A”
\(1-P(A)\)
Complemento
A o B, pueden solaparse
\(P(A)+P(B)-P(A\cap B)\)
No contar dos veces
Ya sé que ocurrió B
\(P(A\mid B)=P(A\cap B)/P(B)\)
Recorta \(\Omega\) a \(B\)
Saber B no cambia A
\(P(A\cap B)=P(A)P(B)\)
Independencia
El dato puede salir de varios grupos
Probabilidad total
Promedio ponderado por el tamaño de cada grupo
Tengo \(P(\text{dato}\mid \text{clase})\) y quiero la clase
Bayes
Invierte el condicional
Clase rara + test imperfecto
Bayes con prior chico
El posterior suele ser mucho menor que la sensibilidad
Regla de comunicación: escribir el evento y qué está a la derecha de la barra.
7. Guía práctica para reportar una probabilidad
Paso 1: experimento y espacio
Qué se observa, cuáles son las clases o resultados.
Paso 2: prior
\(P(\text{clase})\) y la fuente (histórico, diseño, supuesto).
Paso 3: verosimilitud
\(P(\text{evidencia}\mid \text{clase})\) para cada clase.
Paso 4: evidencia y posterior
\(P(\text{dato})\) y \(P(\text{clase}\mid \text{dato})\).
Paso 5: redactar
“En [experimento], con prior [P], evidencia [...] y verosimilitud [...], el posterior es [P(clase|dato)]. Se decide [acción] porque [umbral / costo]. Limitación: [frecuencia base / independencia / n pequeño].”
El caso de la prueba diagnóstica (etapa 8) ya llenó esta plantilla.
8. Puente hacia las siguientes sesiones
La probabilidad ya no es un porcentaje suelto: es \(P(\cdot\mid \cdot)\) sobre un \(\Omega\) declarado. La inferencia (Sesión 9) usa la misma barra para hablar de un parámetro desconocido a partir de una muestra, y la Sesión 10 aplica Bayes al propio parámetro. La clasificación y la validación volverán a \(P(y\mid x)\) y a umbrales con costo.
9. Cierre
Este notebook deja el lenguaje mínimo de la incertidumbre:
experimento, \(\Omega\) y eventos,
probabilidad como frecuencia estable y como axioma,
condicional, independencia y la diferencia con “disjuntos”,
probabilidad total y teorema de Bayes,
tres clasificadores binarios (diagnóstico, fraude, spam) con el mismo teorema,
un reporte que escribe prior, verosimilitud y posterior.
Resultado esperado: el estudiante puede escribir \(P(A\mid B)\), no invertirlo por accidente, simular el conteo y explicar por qué un test del 99% puede dejar un posterior del 17%.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.