Estadística para IA — 10. Enfoques frecuentista y bayesiano
estadistica
bayesiano
mle
Máxima verosimilitud, MAP, posterior, evidencia, la diferencia entre el marco frecuentista y el bayesiano, y un caso de suavizado en clasificación.
Author
Wilder Ramírez Delgado
Published
September 25, 2026
Sesión 10 — Enfoques Frecuentista y Bayesiano
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Dos lecturas de la misma muestra
La sesión de inferencia ya dejó un aparato: estimador, error estándar, intervalo, prueba. Ese aparato es frecuentista: el parámetro \(\theta\) es un número fijo; lo aleatorio es la muestra. Otra lectura trata \(\theta\) como incierta antes de ver los datos y actualiza \(p(\theta\mid x)\) cuando llegan. No cambia el dado; cambia de qué es la probabilidad.
Este notebook construye los dos marcos sobre el mismo objeto: verosimilitud, máxima verosimilitud (MLE), prior, evidencia, posterior y MAP. El contraste que importa es operativo: con \(n\) chico un prior fuerte mueve el MAP; con \(n\) grande MLE y MAP coinciden. El MLE no es “más científico”; es el MAP de un prior plano.
Contexto: una moneda (Bernoulli) para ver las curvas, y un filtro de una palabra donde el MLE asigna probabilidad 0 a un token no visto (y el clasificador se rompe).
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 3 · Sesión 10
Objetivos
Distinguir qué pregunta hace el marco frecuentista y cuál el bayesiano.
Escribir la verosimilitud\(\mathcal L(\theta;x)=p(x\mid\theta)\) y no tratarla como \(p(\theta\mid x)\).
Calcular el MLE (a mano y sobre la curva de \(\ell(\theta)\)).
Actualizar un prior a un posterior y nombrar la evidencia\(p(x)\).
Obtener el MAP y verlo como MLE penalizado por \(\log p(\theta)\).
Contrastar un intervalo de confianza con un intervalo creíble sobre la misma muestra.
Usar el MAP (suavizado de Laplace) en un clasificador que el MLE deja en cero.
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. Dos ontologías de \(\theta\)
1.1 La pregunta no es la misma
Hay un parámetro \(\theta\) (una \(p\) de Bernoulli, una media, un peso). Se observa \(x=(x_1,\ldots,x_n)\).
Frecuentista:\(\theta\) es fijo y desconocido. \(x\) es aleatoria. Se pregunta: si \(\theta\) fuera este valor, ¿qué tan rara sería esta muestra? De ahí salen el MLE, el error estándar, el IC y el p-value.
Bayesiano:\(\theta\) tiene una distribución previa\(p(\theta)\) (el prior: creencia o regularidad antes del dato). Tras ver \(x\), se pregunta: ¿cómo se actualiza la creencia? La respuesta es el posterior\(p(\theta\mid x)\).
No son dos algoritmos para el mismo número. Son dos respuestas a “qué es una probabilidad”.
1.2 Verosimilitud
\[
\mathcal L(\theta;x)=p(x\mid\theta).
\]
Es función de \(\theta\), con \(x\) fija. No integra a 1 en \(\theta\). No es “la probabilidad del parámetro”. Es qué tan compatible es \(\theta\) con lo que se vio.
En Bernoulli(\(p\)), \(k=\sum x_i\) caras en \(n\) lanzamientos,
\[
\hat p_{\mathrm{MLE}}=\frac{k}{n}.
\]
El MLE usa solo la muestra. Si \(k=0\), \(\hat p=0\): el modelo afirma que el próximo resultado es imposible. En un clasificador, un token no visto en spam deja \(P(\text{palabra}\mid\text{spam})=0\) y tumba el producto de Naive Bayes.
El MAP es un MLE con penalización\(\log p(\theta)\). Prior plano \(\Rightarrow\) MAP \(=\) MLE. Prior concentrado \(\Rightarrow\) el máximo se corre hacia la creencia previa.
Para \(\mathrm{Beta}(\alpha,\beta)\) y Bernoulli, el modo del posterior (definido si \(\alpha+k>1\) y \(\beta+n-k>1\)) es
Con \(\alpha=\beta=1\) (uniforme) coincide con \(k/n\). El suavizado de Laplace \(\hat p=(k+1)/(n+2)\) es el posterior mean de \(\mathrm{Beta}(1,1)\), no el modo; en la práctica de texto se usa esa media (o \(\alpha\) pequeño) para nunca escribir un 0.
1.6 Intervalo de confianza vs intervalo creíble
IC frecuentista
Intervalo creíble
Aleatorio
Los extremos (la muestra)
\(\theta\) (según el posterior)
Lectura
El procedimiento cubre \(\theta\) el 95% de las réplicas
El 95% de la masa posterior vive aquí
Usa prior
No
Sí
El mismo \(x\) produce dos rangos que no tienen por qué coincidir. Llamarlos “el 95%” sin decir cuál es mezclar escuelas.
1.7 El contraste que importa
\(n\)
Prior
Qué se ve
Chico
Fuerte (p. ej. \(\mathrm{Beta}(20,20)\))
MAP lejos del MLE
Grande
El que sea
MAP \(\approx\) MLE: el dato gana
Cualquiera
Plano
MAP \(=\) MLE
El prior no es “hacer trampa”. Es declarar información (o regularizar). Un prior oculto (un 0.5 por costumbre, un class_weight) sigue siendo prior.
Pregunta
Marco
Herramienta
¿Qué \(\theta\) hace más creíble \(x\)?
Frecuentista
MLE
¿Qué \(\theta\) es más creíble después de \(x\)?
Bayesiano
MAP / posterior
¿Qué tan compatible es \(\theta\) con \(x\)?
Ambos
Verosimilitud
¿Cuánto pesaba la creencia previa?
Bayesiano
Prior
¿Cómo se predice un \(x\) nuevo?
Bayesiano
\(p(x_{\mathrm{nuevo}}\mid x)\) (predicitiva)
2. Por qué importa en IA y Machine Learning
Casi todo fit que maximiza una log-verosimilitud es MLE. Casi toda regularización (una penalización sobre pesos, un suavizado de conteos) es un MAP con el prior escrito como término extra.
La regresión lineal por OLS es el MLE de \(y\sim\mathcal N(X\beta,\sigma^2 I)\).
Un Naive Bayes con \(P(w\mid c)=0\) para una palabra nueva es un MLE crudo. El “add-one” es MAP / media posterior.
El prior de clase \(P(y=1)\) es exactamente la frecuencia base: sin él, precisión y posterior se leen mal.
Un IC y un intervalo creíble no se comunican igual a un comité: “el procedimiento cubre” frente a “creo que \(\theta\) está aquí”.
Idea central: elegir MLE o MAP no es elegir librería; es decidir si \(\theta\) se estima solo con \(x\) o también con una creencia (o una penalización) que hay que escribir.
3. Flujo recomendado de trabajo
Nombrar \(\theta\) y el modelo \(p(x\mid\theta)\).
Escribir \(\ell(\theta)\) y, si el marco es frecuentista, el MLE y su incertidumbre (SE / IC).
Si hay información previa o hay que evitar ceros, escribir el prior y el posterior (o el MAP).
Separar “este rango es un IC” de “este rango es creíble”.
Predecir un dato nuevo con \(p(x_{\mathrm{nuevo}}\mid x)\), no con \(\hat\theta\) a ciegas si \(n\) es chico.
Traducir al modelo: ¿el 0 de un conteo es MLE? ¿el +1 es un prior?
Criterio general: un \(\hat\theta\) sin decir si es MLE o MAP, y sin \(n\), es un número suelto.
Funciones de visualización (definidas una sola vez)
def logverosimilitud_bernoulli(p, k, n): p = np.clip(np.asarray(p, dtype=float), 1e-12, 1-1e-12)return k * np.log(p) + (n - k) * np.log(1- p)def mle_bernoulli(k, n):return k / ndef map_beta(k, n, alpha, beta):return (alpha + k -1) / (alpha + beta + n -2)def media_posterior_beta(k, n, alpha, beta):return (alpha + k) / (alpha + beta + n)def graficar_loglik(k, n, titulo): p = np.linspace(0.01, 0.99, 400) ell = logverosimilitud_bernoulli(p, k, n) fig, ax = plt.subplots(figsize=(8.0, 4.1)) ax.plot(p, ell, color="C0") ax.axvline(k / n, color="C3", linestyle="--", label=fr"MLE = {k / n:.3f}") ax.set_xlabel("p") ax.set_ylabel(r"$\ell(p)$") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_prior_post(k, n, alpha, beta, titulo): p = np.linspace(0.001, 0.999, 500) prior = stats.beta.pdf(p, alpha, beta) post = stats.beta.pdf(p, alpha + k, beta + n - k) lik = np.exp(logverosimilitud_bernoulli(p, k, n) - logverosimilitud_bernoulli(k / n, k, n)) fig, ax = plt.subplots(figsize=(8.2, 4.3)) ax.plot(p, prior / prior.max(), linestyle="--", label=fr"prior Beta({alpha:g},{beta:g})") ax.plot(p, lik, color="C0", alpha=0.85, label="verosimilitud (escala 1)") ax.plot(p, post / post.max(), color="C2", label=fr"posterior Beta({alpha+k:g},{beta+n-k:g})") ax.axvline(k / n, color="C3", linestyle=":", label=f"MLE = {k / n:.3f}") ax.set_xlabel("p") ax.set_ylabel("escala relativa (máximo = 1)") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_mle_vs_map(ns, k_de_n, alpha, beta, p_true, titulo): mles = np.array([k / n for n, k inzip(ns, k_de_n)]) maps = np.array([map_beta(k, n, alpha, beta) for n, k inzip(ns, k_de_n)]) fig, ax = plt.subplots(figsize=(8.0, 4.2)) ax.plot(ns, mles, marker="o", label="MLE") ax.plot(ns, maps, marker="s", label=fr"MAP (Beta({alpha:g},{beta:g}))") ax.axhline(p_true, color="0.3", linestyle="--", label=fr"$p$ de diseño = {p_true}") ax.set_xlabel("n") ax.set_ylabel("estimación de p") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()
5. Desarrollo por etapas
Se fabrica una moneda con \(p=0.62\) conocida en el laboratorio. Así se ve cuándo el MLE acierta por muestreo y cuándo el prior corre el MAP. El caso de clasificación usa conteos de una palabra: el cero del MLE frente al suavizado.
Etapa 1: El dato y el MLE
\(n=40\) lanzamientos de una moneda con \(p=0.62\). \(k\) es el número de caras. El MLE es \(k/n\). No usa el 0.62: el ajuste no “ve” el laboratorio.
p_true =0.62n =40x = rng.binomial(1, p_true, size=n)k =int(x.sum())p_mle = mle_bernoulli(k, n)print("k =", k, " n =", n)print("MLE p̂ = k/n =", round(p_mle, 4), " (diseño p = 0.62)")print("No coincide al milímetro: n es finito.")
k = 21   n = 40
MLE  p̂ = k/n = 0.525    (diseño p = 0.62)
No coincide al milímetro: n es finito.
Lectura.\(\hat p_{\mathrm{MLE}}\) es un estadístico. El 0.62 es el parámetro. Confundirlos es el error de la Sesión 9 (inferencia), ahora con una \(p\) de Bernoulli.
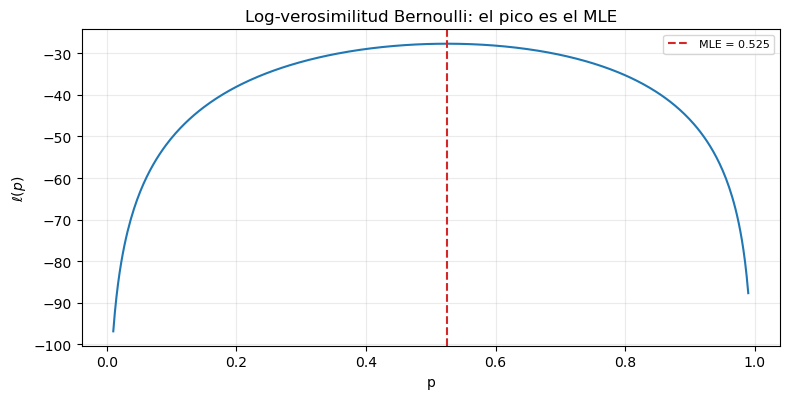
Etapa 2: La curva de \(\ell(p)\) — el máximo se ve
\[
\ell(p)=k\log p+(n-k)\log(1-p).
\]
El MLE es el \(p\) donde esa curva alcanza el pico. No hace falta derivar a mano si se evalúa la grilla; la derivada confirma \(k/n\).
p_grid = np.linspace(0.05, 0.95, 181)ell = logverosimilitud_bernoulli(p_grid, k, n)p_max_num = p_grid[int(np.argmax(ell))]print("Máximo numérico de ℓ en la grilla =", round(p_max_num, 4))print("MLE analítico k/n =", round(p_mle, 4))graficar_loglik(k, n, r"Log-verosimilitud Bernoulli: el pico es el MLE")
Máximo numérico de ℓ en la grilla = 0.525
MLE analítico k/n                 = 0.525
Lectura. La verosimilitud no es una densidad sobre \(p\): el área bajo \(\ell\) no vale 1 (ni siquiera está en escala de densidad). El pico responde “qué \(p\) hace más creíble esta\(x\)”, no “cuánta masa creo en cada \(p\)”.
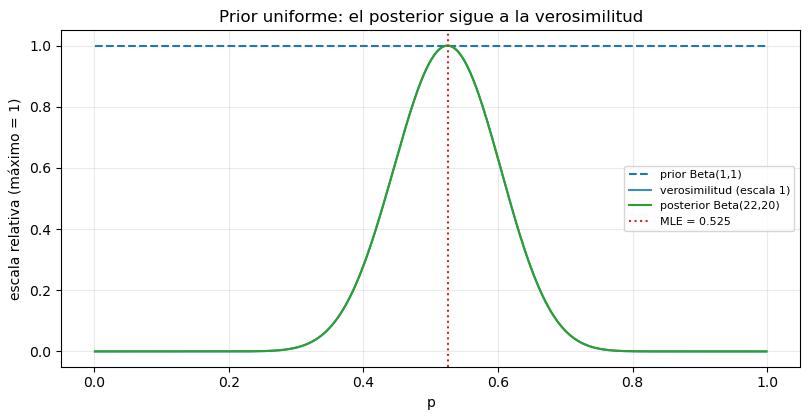
Etapa 3: Prior plano — el posterior se parece a la verosimilitud
\(\mathrm{Beta}(1,1)\) es uniforme en \((0,1)\). El posterior es \(\mathrm{Beta}(1+k,\,1+n-k)\). El modo coincide con el MLE.
print("Prior Beta(1,1) → posterior Beta(", 1+ k, ",", 1+ n - k, ")", sep="")print("MAP (modo) =", round(map_beta(k, n, 1, 1), 4), " MLE =", round(p_mle, 4))print("Media posterior =", round(media_posterior_beta(k, n, 1, 1), 4), " (Laplace: (k+1)/(n+2))")graficar_prior_post(k, n, 1, 1, "Prior uniforme: el posterior sigue a la verosimilitud")
Lectura. Con prior plano, actualizar es reescalar la verosimilitud hasta que integre 1. El MAP no aporta otra historia que el MLE. La media posterior sí se corre un poco hacia 0.5: \((k+1)/(n+2)\) no es \(k/n\).
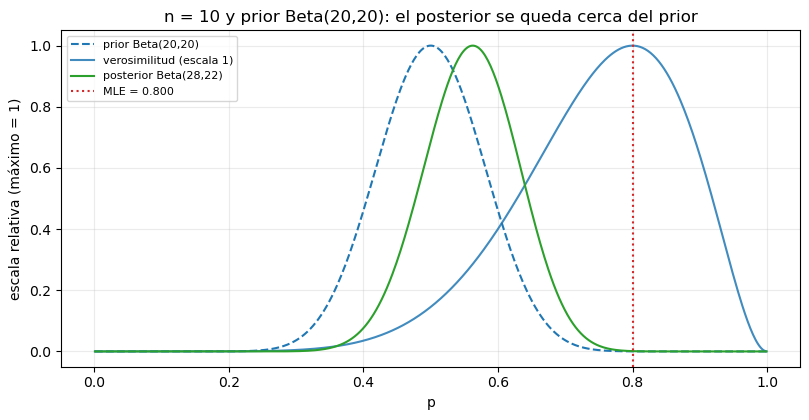
Etapa 4: El contraste — prior fuerte y \(n\) chico
Prior \(\mathrm{Beta}(20,20)\): mucha masa cerca de \(1/2\) (“creo que la moneda es casi honesta”); pesa como 40 tiradas imaginarias. El MAP debe acercarse a 0.5 respecto del MLE.
Se aplica a la muestra de la etapa 1 (\(n=40\)) y a una muestra chica —8 caras en 10 tiradas—, cuyo MLE (0.8) está lejos de 0.5. Ahí se ve el contraste.
a_f, b_f =20, 20print("Muestra de la etapa 1 (k=21, n=40):")print(" MLE =", round(p_mle, 4), " MAP prior fuerte =", round(map_beta(k, n, a_f, b_f), 4))print(" El prior pesa como 40 tiradas: el MAP queda a mitad de camino entre el MLE y 0.5.")print(" Casi no se nota porque el MLE ya estaba cerca de 0.5.")print()k_c, n_c =8, 10# muestra chica y lejos de 0.5print("Muestra chica (k=8, n=10):")print(" MLE =", round(mle_bernoulli(k_c, n_c), 4))print(" MAP prior plano =", round(map_beta(k_c, n_c, 1, 1), 4))print(" MAP prior fuerte =", round(map_beta(k_c, n_c, a_f, b_f), 4), " (se desplaza hacia 0.5)")print(" Media post fuerte=", round(media_posterior_beta(k_c, n_c, a_f, b_f), 4))graficar_prior_post(k_c, n_c, a_f, b_f, "n = 10 y prior Beta(20,20): el posterior se queda cerca del prior")
Muestra de la etapa 1 (k=21, n=40):
  MLE = 0.525   MAP prior fuerte = 0.5128
  El prior pesa como 40 tiradas: el MAP queda a mitad de camino entre el MLE y 0.5.
  Casi no se nota porque el MLE ya estaba cerca de 0.5.

Muestra chica (k=8, n=10):
  MLE              = 0.8
  MAP prior plano  = 0.8
  MAP prior fuerte = 0.5625   (se desplaza hacia 0.5)
  Media post fuerte= 0.56
El contraste. Con 8 caras en 10 tiradas, el MLE dice 0.80 y el MAP con prior fuerte, 0.56: diez datos no alcanzan para mover una creencia que vale por cuarenta. El dato no cambió. Cambió la pregunta: “qué \(p\) maximiza \(x\)” frente a “qué \(p\) es más creíble si yo ya creía en ~0.5”. Ninguna de las dos es trampa. Ocultar el \(\mathrm{Beta}(20,20)\) y publicar solo el MAP sí lo es.
Pregunta de análisis. Si el negocio sabe que las monedas de esta máquina salen cerca de 0.5, ¿publicas el MLE o el MAP? ¿Qué escribes junto al número?
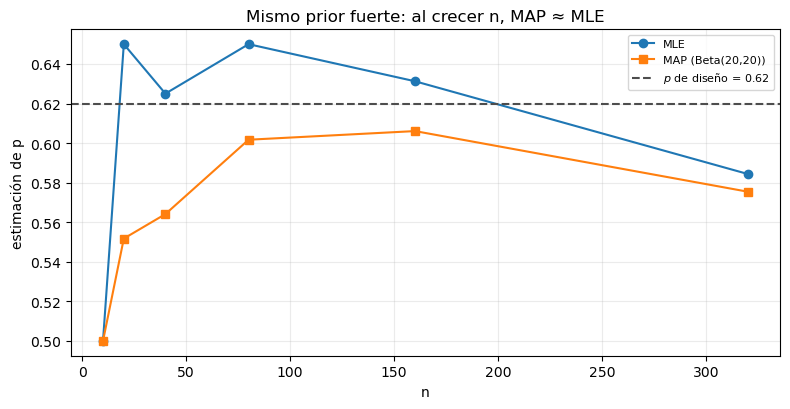
Etapa 5: \(n\) grande — el dato gana
Se simulan muestras crecientes de la misma moneda. Prior fuerte fijo \(\mathrm{Beta}(20,20)\). MLE y MAP deben juntarse.
ns = np.array([10, 20, 40, 80, 160, 320])ks = []for ni in ns: ks.append(int(rng.binomial(1, p_true, size=int(ni)).sum()))graficar_mle_vs_map(ns, ks, 20, 20, p_true, "Mismo prior fuerte: al crecer n, MAP ≈ MLE")print(pd.DataFrame({"n": ns,"k": ks,"MLE": [round(k_ / n_, 3) for n_, k_ inzip(ns, ks)],"MAP": [round(map_beta(k_, n_, 20, 20), 3) for n_, k_ inzip(ns, ks)],}).to_string(index=False))
Lectura. El prior no se “apaga” por decreto: se diluye porque \(\alpha+k\) y \(\beta+n-k\) los termina mandando \(n\). Con \(n=20\), MLE y MAP difieren en casi 0.10 (0.650 frente a 0.552); con \(n=320\), en menos de 0.01 (0.584 frente a 0.575). Con \(n=10\) coinciden por azar: salieron 5 caras, justo el centro del prior. A partir de unos cientos de datos, discutir el prior de \(p\) es, para el punto, pedantería; para las colas del posterior, todavía no.
Etapa 6: El 95% no es el mismo objeto
Misma muestra \((n,k)\) de la etapa 1.
IC de Wald (frecuentista, aproximación normal): \(\hat p\pm 1.96\sqrt{\hat p(1-\hat p)/n}\).
Intervalo creíble central 95%: cuantiles 2.5% y 97.5% del \(\mathrm{Beta}(1+k,1+n-k)\).
Se imprimen los dos. No se pide que coincidan.
se = np.sqrt(p_mle * (1- p_mle) / n)z = stats.norm.ppf(0.975)ic_lo, ic_hi = p_mle - z * se, p_mle + z * secred_lo, cred_hi = stats.beta.ppf([0.025, 0.975], 1+ k, 1+ n - k)print("Muestra: k =", k, " n =", n, " MLE =", round(p_mle, 4))print("IC Wald 95% = [", round(ic_lo, 3), ",", round(ic_hi, 3), "] ← cobertura del procedimiento")print("Creíble 95% (plano) = [", round(cred_lo, 3), ",", round(cred_hi, 3), "] ← masa del posterior")cred2 = stats.beta.ppf([0.025, 0.975], 20+ k, 20+ n - k)print("Creíble 95% (fuerte) = [", round(cred2[0], 3), ",", round(cred2[1], 3), "] ← el prior encoge el rango")print()print("El 95% no se copia de un renglón a otro. Se declara el marco.")
Muestra: k = 21  n = 40   MLE = 0.525
IC Wald 95%          = [ 0.37 , 0.68 ]  ← cobertura del procedimiento
Creíble 95% (plano)  = [ 0.374 , 0.671 ]  ← masa del posterior
Creíble 95% (fuerte) = [ 0.404 , 0.621 ]  ← el prior encoge el rango

El 95% no se copia de un renglón a otro. Se declara el marco.
Lectura. El IC no afirma \(P(\theta\in[a,b]\mid x)=0.95\). El creíble, sí (bajo el prior). El prior fuerte estrecha el creíble: eso no es más dato; es más creencia. Mezclar las dos frases en un informe es el error de la etapa.
Con prior plano y \(n=40\), el IC de Wald y el creíble casi coinciden en números (\([0.37,\,0.68]\) frente a \([0.374,\,0.671]\)). Lo que cambia no es el rango, es la frase que se puede escribir junto a él.
Etapa 7: Evidencia y predicción del próximo lanzamiento
La predicativa posterior de una moneda Beta–Bernoulli es la media del posterior:
No es \(k/n\) salvo prior plano en el límite. La evidencia \(p(x)\) de una secuencia concreta es el valor de la Beta-binomial; aquí basta la predicción de un ensayo más, que es lo que un modelo usa.
def pred_cara(k, n, alpha, beta):return (alpha + k) / (alpha + beta + n)print("P(próxima = cara | x)")print(" con MLE (plug-in) =", round(p_mle, 4), " ← trata p̂ como si fuera p")print(" predicativa, prior 1,1 =", round(pred_cara(k, n, 1, 1), 4))print(" predicativa, prior 20,20 =", round(pred_cara(k, n, 20, 20), 4))print()print("Si k=0, n=8:")print(" MLE plug-in =", 0.0, " ← 'la próxima cara es imposible'")print(" predicativa Laplace =", round(pred_cara(0, 8, 1, 1), 4), " ← nunca 0")
P(próxima = cara | x)
  con MLE (plug-in)     = 0.525   ← trata p̂ como si fuera p
  predicativa, prior 1,1 = 0.5238
  predicativa, prior 20,20 = 0.5125

Si k=0, n=8:
  MLE plug-in           = 0.0   ← 'la próxima cara es imposible'
  predicativa Laplace   = 0.1   ← nunca 0
Lectura. El MLE enchufado a \(P(X_{\mathrm{nuevo}}\mid\hat p)\) ignora que \(\hat p\) tiembla. La predicativa promedia esa incertidumbre. Con \(k=0\) la diferencia no es cosmética: un 0 y un \(1/10\) deciden si un clasificador sobrevive a un token nuevo.
Etapa 8: Clasificación — el MLE pone un 0 y se rompe
Filtro de una palabra. Clase \(y=1\) = spam. En entrenamiento, la palabra “premio” aparece 8 veces en 40 spam y 0 veces en 80 ham. Un correo de prueba trae “premio”.
Naive Bayes (una palabra):
\[
P(y\mid w)\propto P(w\mid y)\,P(y).
\]
\(P(w\mid y=0)_{\mathrm{MLE}}=0/80=0\). El ham queda anulado: el correo tiene que ser spam, aunque el prior de spam sea bajo. El MAP / Laplace usa \((c+1)/(n+2)\).
# Conteos de diseño (una palabra)c_spam, n_spam =8, 40c_ham, n_ham =0, 80prior_spam =0.30prior_ham =0.70p_w_spam_mle = c_spam / n_spamp_w_ham_mle = c_ham / n_ham# Laplace = media posterior Beta(1,1)p_w_spam_map = media_posterior_beta(c_spam, n_spam, 1, 1)p_w_ham_map = media_posterior_beta(c_ham, n_ham, 1, 1)def posterior_spam(p_w_spam, p_w_ham): num = p_w_spam * prior_spam den = num + p_w_ham * prior_hamreturn num / den if den >0else np.nanprint("P(palabra | spam) MLE =", p_w_spam_mle, " Laplace =", round(p_w_spam_map, 4))print("P(palabra | ham) MLE =", p_w_ham_mle, " Laplace =", round(p_w_ham_map, 4))print()print("P(spam | palabra) MLE =", posterior_spam(p_w_spam_mle, p_w_ham_mle)," ← 1.0 forzado: ham quedó en 0")print("P(spam | palabra) Laplace =", round(posterior_spam(p_w_spam_map, p_w_ham_map), 4))print()print("El 1.0 del MLE no es certeza: es un cero en el denominador del ham.")
P(palabra | spam)  MLE = 0.2   Laplace = 0.2143
P(palabra | ham)   MLE = 0.0   Laplace = 0.0122

P(spam | palabra)  MLE     = 1.0   ← 1.0 forzado: ham quedó en 0
P(spam | palabra)  Laplace = 0.8828

El 1.0 del MLE no es certeza: es un cero en el denominador del ham.
El contraste en producto. El MLE “ganó” una certeza falsa. El Laplace no inventa que la palabra sea frecuente en ham: pone \(1/82\). Eso basta para que el prior 0.30 y la verosimilitud en spam (alta) produzcan un posterior alto pero no 1. El suavizado es el prior \(\mathrm{Beta}(1,1)\) escrito como +1 en el código.
Veredicto parcial. En texto, el MLE crudo de \(P(w\mid c)\)no es aceptable. El MAP/Laplace es el mínimo oficio.
Etapa 9: Simular el filtro — los correos que traen la palabra
Se generan 400 correos con las tasas verdaderas de diseño: “premio” aparece en el 20% del spam y en el 1% del ham (el 0 del entrenamiento fue mala suerte de muestra, con \(n\) chico). Entre los correos que traen la palabra se compara la probabilidad que afirma cada regla con la frecuencia real de spam, y la decisión al umbral habitual \(\tau=0.5\).
n_mail =400es_spam = rng.random(n_mail) <0.30tiene = np.where(es_spam, rng.random(n_mail) <0.20, rng.random(n_mail) <0.01)y = es_spam[tiene].astype(int) # solo los correos que traen la palabrapost_l = posterior_spam(p_w_spam_map, p_w_ham_map)print("Correos con la palabra:", len(y), " spam:", int(y.sum()), " ham:", int(len(y) - y.sum()))print("Frecuencia real de spam entre ellos =", round(y.mean(), 3))print("MLE afirma P(spam | palabra) = 1.0 ← declara imposibles a los ham")print("Laplace afirma P(spam | palabra) =", round(post_l, 3))print()tau =0.5yhat = np.full_like(y, int(post_l >= tau)) # a τ = 0.5, MLE (1.0) y Laplace (0.883) alertan igualvp =int(((y ==1) & (yhat ==1)).sum())fp =int(((y ==0) & (yhat ==1)).sum())print(f"A τ = {tau}, las dos reglas alertan en los {len(y)} correos: VP = {vp}, FP = {fp}")print("La decisión es la misma; lo que difiere es la probabilidad que se reporta.")
Correos con la palabra: 30   spam: 28   ham: 2
Frecuencia real de spam entre ellos  = 0.933
MLE afirma     P(spam | palabra) = 1.0   ← declara imposibles a los ham
Laplace afirma P(spam | palabra) = 0.883

A τ = 0.5, las dos reglas alertan en los 30 correos: VP = 28, FP = 2
La decisión es la misma; lo que difiere es la probabilidad que se reporta.
Lectura. Entre los 30 correos con la palabra, 28 eran spam (93%). El MLE afirma certeza (1.0) y declara imposibles a los 2 ham que sí aparecieron; Laplace afirma 0.88, una cifra discutible pero posible. A \(\tau=0.5\) las dos reglas deciden igual, así que la diferencia no se ve en la matriz de confusión. Se ve cuando la probabilidad se usa como probabilidad: al combinar varias palabras (un solo 0 anula todo el producto), al fijar el umbral por costos o al medir calibración. Una métrica de probabilidad como la pérdida logarítmica castiga con un error infinito a quien dijo 1.0 y se equivocó.
Qué no se concluye. Que Laplace sea el mejor prior. Es el prior mínimo que impide el colapso. Un \(\mathrm{Beta}(2,8)\) en ham sería otra creencia, otra probabilidad.
Caso aplicado: reportar un MLE o un MAP
Plantilla:
Parámetro y modelo. Qué es \(\theta\), qué \(p(x\mid\theta)\).
Prior, si existe. Familia, parámetros, justificación (plano, regularización, dominio).
Números.\(\hat\theta\), \(n\), intervalo (y de qué tipo).
Predicción. Plug-in vs predicativa; ¿hay ceros?
Decisión y límite. Para qué uso sirve; qué pasa si \(n\) cambia.
Los seis pasos, aplicados al filtro (etapas 8–9)
Parámetro.\(P(\text{“premio”}\mid \text{spam})\) y \(P(\text{“premio”}\mid \text{ham})\), Bernoulli / multinomial de una palabra.
Marco. Se comparan MLE y media posterior \(\mathrm{Beta}(1,1)\) (Laplace).
Prior. Plano en \(p\); equivale a un conteo ficticio \((1,1)\). Justificación: evitar probabilidad 0, no un estudio de dominio.
Números. MLE ham \(=0\); Laplace ham \(=(0+1)/(80+2)\). Posterior \(P(\text{spam}\mid\text{palabra})\): 1.0 (MLE) frente a 0.883 (Laplace).
Predicción. El MLE no puede predecir ham si la palabra aparece. Laplace sí.
Decisión.Rechazar el MLE crudo para este clasificador. Aceptar Laplace (o un prior mejor) como suelo. Limitación: una palabra, prior no elicitado con negocio, \(\tau=0.5\) por costumbre.
En un filtro con una palabra nunca vista en ham, el MLE asigna \(P(w\mid\mathrm{ham})=0\) y fuerza posterior 1. Con suavizado de Laplace el posterior es 0.883 y el modelo deja de colapsar. Se reporta el prior \((1,1)\), \(n_{\mathrm{ham}}=80\) y que el 1.0 del MLE no es certeza, es un cero. Limitación: una feature, sin calibración de \(\tau\).
Errores que conviene nombrar
Tratar \(\mathcal L(\theta;x)\) como \(p(\theta\mid x)\). La primera no integra a 1 en \(\theta\).
Publicar un MAP sin el prior. Es un MLE disfrazado o una creencia oculta.
Leer el IC como “\(\theta\) está aquí con probabilidad 0.95”.
Leer el creíble como cobertura de un procedimiento que se repite.
MLE con \(k=0\) como “imposible”. En texto, tumba el clasificador.
“Bayesiano = más moderno.” Es otra pregunta, no una medalla.
Reusar el 16.7% de la prueba médica como si fuera este tema. Ahí se invierte un condicional; aquí se elige un marco para \(\theta\).
Idea clave
El MLE responde “qué \(\theta\) hace más creíble \(x\)”. El posterior responde “qué creo de \(\theta\) después de \(x\)”. El MAP está en medio: un punto del posterior, un MLE con prior. El oficio es nombrar cuál se publica y, si hay prior, escribirlo.
Síntesis
Se escribió \(\ell(p)\) y se vio el pico (MLE). Un prior plano no cambió el modo; uno fuerte sí, y \(n\) grande lo diluyó. El 95% de Wald y el 95% creíble no se copiaron. La predicativa evitó el 0 que el plug-in fabrica. En el filtro, el MLE impuso spam; Laplace dejó un posterior usable. El objeto que queda es \(p(\theta\mid x)\)o\(\hat\theta_{\mathrm{MLE}}\), declarado, no un \(\hat p\) anónimo.
6. Guía rápida: ¿qué marco usar?
Situación
Qué usar
Por qué
Solo la muestra, un punto
MLE
Maximiza \(p(x\mid\theta)\)
Hay creencia o hay que regularizar
MAP / posterior
Suma \(\log p(\theta)\)
Evitar \(P=0\) en conteos
Laplace / \(\mathrm{Beta}(1,1)\)
Media posterior, no un 0
Rango “el procedimiento cubre”
IC
Frecuentista
Rango “creo que \(\theta\) está aquí”
Intervalo creíble
Posterior
Predecir el próximo \(x\) con \(n\) chico
Predicativa
Promedia \(\theta\), no enchufa \(\hat\theta\)
\(n\) enorme, prior razonable
MLE \(\approx\) MAP
El dato manda
Regla de comunicación:\(\hat\theta\), \(n\), si es MLE o MAP, el prior si existe, y el tipo de intervalo.
7. Guía práctica para reportar MLE o MAP
Paso 1: \(\theta\) y \(p(x\mid\theta)\)
Qué se estima y con qué modelo.
Paso 2: marco y prior
MLE solo, o prior (familia, parámetros, por qué).
Paso 3: punto, \(n\), intervalo
Declarar si el rango es IC o creíble.
Paso 4: redactar
“Se modeló [X] como [Bernoulli/…]. \(n=\)[...]. MLE = […]. MAP con prior [Beta(α,β) / …] = […]. Intervalo [IC Wald / creíble 95%] = […]. Para predecir se usó [plug-in / predicativa]. Veredicto:[basta el MLE / hace falta prior porque…]. Limitación: [n chico / prior no elicitado].”
El filtro de la etapa 8 ya llenó esta plantilla.
8. Puente hacia las siguientes sesiones
La recta de mínimos cuadrados es el MLE de un ruido gaussiano. Un clasificador que multiplica \(P(x\mid y)\) hereda el 0 del MLE o el +1 del MAP. Las métricas (precisión, recall) y la validación (no elegir el prior en la prueba) se aplican igual: el marco de \(\theta\) no sustituye el conjunto no visto.
9. Cierre
Este notebook deja los dos marcos sobre la misma muestra:
verosimilitud frente a posterior,
MLE y su curva \(\ell(\theta)\),
prior, evidencia y actualización Beta–Bernoulli,
MAP como MLE penalizado,
IC frente a intervalo creíble,
predicativa frente a plug-in,
un clasificador que el MLE rompe y el Laplace sostiene.
Resultado esperado: el estudiante escribe \(\hat p_{\mathrm{MLE}}\) o \(\hat p_{\mathrm{MAP}}\) con el prior a la vista, no publica un 0 de conteo como certeza, y no llama “95%” a dos objetos distintos.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.