Estadística para IA — 11. Regresión lineal

estadistica
regresion-lineal
scikit-learn
Modelo lineal simple, supuestos, mínimos cuadrados, MSE, interpretación de coeficientes y un caso de latencia frente a tamaño de lote.
Author

Wilder Ramírez Delgado

Published

September 25, 2026

Sesión 11 — Regresión Lineal

Open in Colab

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Una recta no es la nube

Predecir un número —latencia, precio, puntuación— a partir de otro es la tarea más corta del modelado: una recta. El modelo lineal simple escribe esa recta, la ajusta por mínimos cuadrados y resume el error con el MSE. El coeficiente que sale no es un hechizo: es cuánto cambia \(y\) por cada unidad de \(x\), dentro del modelo y del rango observado.

Este notebook construye el modelo, sus supuestos, el ajuste a mano y con scikit-learn, el MSE y la lectura de \(\beta_0\) y \(\beta_1\). El contraste que importa es clásico y todavía se ignora: cuatro nubes distintas pueden compartir la misma pendiente y el mismo error (cuartetos de Anscombe). Sin el diagrama y sin los residuos, el coeficiente miente con educación.

Contexto: una nube diseñada \(y=\beta_0+\beta_1 x+\varepsilon\) y un caso de latencia (ms) frente a tamaño de lote.

Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 4 · Sesión 11

Objetivos

  • Escribir el modelo lineal simple \(y=\beta_0+\beta_1 x+\varepsilon\) y nombrar cada pieza.
  • Enunciar los supuestos (linealidad, independencia, varianza constante; normalidad para inferir).
  • Ajustar por mínimos cuadrados a mano y reproducir el resultado con LinearRegression.
  • Calcular el MSE (y distinguirlo de \(s^2\) residual).
  • Interpretar \(\hat\beta_0\) y \(\hat\beta_1\) en unidades del problema, sin convertirlos en causa.
  • Diagnosticar con residuos y no fiarse de una recta que comparte números con otra nube.

Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.

1. El modelo y la recta

1.1 Modelo lineal simple

Se observa un par \((x_i,\,y_i)\). El modelo afirma

\[ y_i=\beta_0+\beta_1 x_i+\varepsilon_i,\qquad i=1,\ldots,n. \]

  • \(\beta_0\) (intercepto): valor esperado de \(y\) cuando \(x=0\), si \(x=0\) tiene sentido en el problema.
  • \(\beta_1\) (pendiente): cambio esperado de \(y\) por una unidad de \(x\).
  • \(\varepsilon_i\) (error): lo que el modelo no explica. No es un fallo de Python; es la parte no lineal, no medida o aleatoria.

La predicción en un \(x\) es \(\hat y=\hat\beta_0+\hat\beta_1 x\). El residuo es \(e_i=y_i-\hat y_i\): lo que quedó sin explicar en esta muestra, después de ajustar.

\(x\) es la variable explicativa (feature). \(y\) es la respuesta (target). El modelo es simple porque hay una sola \(x\). Varias \(x\) son regresión múltiple: misma idea, otra geometría.

1.2 Qué se minimiza: mínimos cuadrados

Los mínimos cuadrados ordinarios (OLS) eligen \(\hat\beta_0,\hat\beta_1\) que minimizan la suma de residuos al cuadrado:

\[ S(\beta_0,\beta_1)=\sum_{i=1}^{n}(y_i-\beta_0-\beta_1 x_i)^2. \]

La solución (si \(x\) no es constante) es

\[ \hat\beta_1=\frac{\sum_i (x_i-\bar x)(y_i-\bar y)}{\sum_i (x_i-\bar x)^2},\qquad \hat\beta_0=\bar y-\hat\beta_1\bar x. \]

La recta pasa por el punto \((\bar x,\bar y)\). Elevar al cuadrado penaliza más los residuos grandes: un solo punto extremo puede inclinar la pendiente. Eso no es un defecto oculto; es la función objetivo.

En forma matricial, con \(X\) la matriz \(n\times 2\) de unos y la columna \(x\),

\[ \hat{\boldsymbol\beta}=(X^\top X)^{-1}X^\top \mathbf{y}. \]

Es la misma solución.

1.3 MSE

\[ \mathrm{MSE}=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat y_i)^2. \]

Está en unidades de \(y\) al cuadrado. Su raíz (RMSE) vuelve a las unidades de \(y\) y se compara con el rango de la respuesta. scikit-learn reporta el MSE con divisor \(n\).

La varianza residual que usa la inferencia divide por \(n-2\) (se perdieron dos grados de libertad: intercepto y pendiente):

\[ s^2=\frac{1}{n-2}\sum_i e_i^2. \]

No son el mismo número. El MSE mide ajuste; \(s^2\) estima \(\mathrm{Var}(\varepsilon)\) bajo el modelo.

1.4 Supuestos (lo que la recta pide)

OLS siempre produce una recta. Los supuestos dicen cuándo esa recta es una descripción honesta y cuándo un intervalo o una prueba sobre \(\beta_1\) es legible.

Supuesto En palabras Cómo se mira
Linealidad \(E[y\mid x]=\beta_0+\beta_1 x\) Residuos contra \(\hat y\) o contra \(x\): no debe quedar una curva
Independencia Los \(\varepsilon_i\) no se arrastran (tiempo, grupos) Residuos contra el orden; el modelo simple no “sabe” de series
Varianza constante (homocedasticidad) \(\mathrm{Var}(\varepsilon\mid x)\) no crece ni se estrecha con \(x\) Residuos contra \(\hat y\): la nube no debe abrirse en embudo
Normalidad de \(\varepsilon\) Necesaria para inferir con \(t\) sobre \(\beta\); no para obtener \(\hat\beta\) Histograma o gráfico Q-Q de residuos

Homocedasticidad = varianza de los residuos más o menos igual a lo largo de \(x\). Lo contrario es heterocedasticidad: el error es chico a la izquierda y ancho a la derecha (o al revés).

Gauss–Markov: si la media es lineal, los errores son independientes y de varianza constante, OLS es el mejor estimador lineal e insesgado. La normalidad no entra en esa frase.

1.5 Interpretar coeficientes

\(\hat\beta_1=1.8\) con \(x\) = tamaño de lote y \(y\) = latencia en ms se lee: en esta muestra, y bajo este modelo, un lote una unidad mayor se asocia a \(1.8\) ms más de latencia media.

No se lee: si yo aumento el lote, la latencia subirá \(1.8\) ms. Eso es una afirmación causal. La recta no la otorga.

\(\hat\beta_0\) es la latencia predicha en lote \(0\). Si lote \(0\) no existe, el intercepto es un ancla algebraica, no un experimento.

1.6 El contraste que importa

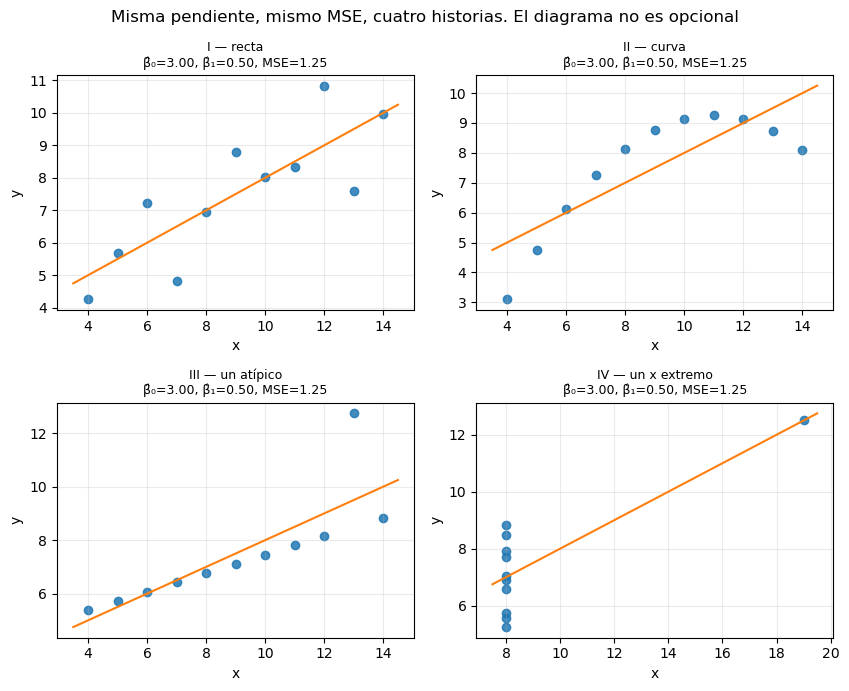
Pendiente, intercepto y MSE son resúmenes. El cuarteto de Anscombe (1973) construye cuatro nubes con los mismos resúmenes y cuatro geometrías: recta, curva, recta más un atípico, y un \(x\) constante salvo un punto que apalanca la pendiente (un \(x\) muy lejos de \(\bar x\)).

Pregunta Herramienta
¿Qué recta resume \(y\) frente a \(x\)? Modelo lineal simple
¿Cómo se eligen \(\beta_0,\beta_1\)? Mínimos cuadrados
¿Cuánto error queda, en \(y^2\)? MSE
¿La recta es la forma de la nube? Residuos + diagrama
¿Cuánto cambia \(y\) por unidad de \(x\)? \(\hat\beta_1\) (asociación, no causa)

2. Por qué importa en IA y Machine Learning

Casi todo modelo paramétrico que se enseña después empieza aquí: una predicción que es combinación lineal de features. La logística es una recta en el logit; una red sin activación es una recta en muchas dimensiones.

  • Baseline. Antes de un modelo complejo, la recta (o un lineal con las \(x\) crudas) fija el MSE a vencer.
  • Interpretación. En producto se pregunta “¿cuánto mueve \(y\) esta feature?”. \(\hat\beta_1\) es la respuesta más corta —y la más fácil de sobreleer.
  • Diagnóstico. Un residuo en U delata que el lineal es el modelo equivocado, no que “falta un hiperparámetro”.
  • MSE. Es la función de pérdida \(L_2\). Entenderla en una recta es entender qué minimizan muchos ajustes.

Idea central: el coeficiente resume una recta; los residuos dicen si esa recta era la pregunta correcta.

3. Flujo recomendado de trabajo

  1. Dibujar \((x,y)\) antes de ajustar. Si no hay nube, no hay recta que contar.
  2. Ajustar OLS (fórmula o LinearRegression) y anotar \(\hat\beta_0\), \(\hat\beta_1\) con unidades.
  3. Predecir \(\hat y\) y calcular MSE (y RMSE, para leerlo en unidades de \(y\)).
  4. Diagnosticar residuos contra \(\hat y\) y, si se va a inferir, la forma de \(e_i\).
  5. Interpretar la pendiente como asociación en el rango de \(x\). No extrapolar a \(x=0\) si \(0\) no existe.
  6. Desconfiar de un MSE o una pendiente sin el diagrama (Anscombe).

Criterio general: un \(\beta\) sin scatter y sin residuos es un número suelto.

4. Preparar el entorno

%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

rng = np.random.default_rng(42)

plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25

print("Entorno listo: numpy, pandas, matplotlib, scipy, sklearn.")
print("sklearn:", __import__("sklearn").__version__, "| numpy:", np.__version__)
Python: 3.13.9
Entorno listo: numpy, pandas, matplotlib, scipy, sklearn.
sklearn: 1.8.0 | numpy: 2.3.5

Funciones de visualización (definidas una sola vez)

Cada etapa solo llama a la función. El detalle del gráfico queda aquí.

def ajustar_ols(x, y):
    x = np.asarray(x, dtype=float)
    y = np.asarray(y, dtype=float)
    xm, ym = x.mean(), y.mean()
    beta1 = np.sum((x - xm) * (y - ym)) / np.sum((x - xm) ** 2)
    beta0 = ym - beta1 * xm
    yhat = beta0 + beta1 * x
    e = y - yhat
    mse = np.mean(e ** 2)
    return {"beta0": beta0, "beta1": beta1, "yhat": yhat, "e": e, "mse": mse}


def graficar_recta(x, y, beta0, beta1, titulo, xlabel="x", ylabel="y"):
    xs = np.linspace(x.min(), x.max(), 80)
    fig, ax = plt.subplots(figsize=(8.0, 4.4))
    ax.scatter(x, y, alpha=0.65, s=32, label="observaciones")
    ax.plot(xs, beta0 + beta1 * xs, color="C1", label=fr"$\hat y = {beta0:.2f} + {beta1:.2f}\,x$")
    ax.set_xlabel(xlabel)
    ax.set_ylabel(ylabel)
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_residuos(yhat, e, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(9.2, 3.8))
    axes[0].scatter(yhat, e, alpha=0.7, s=28)
    axes[0].axhline(0, color="C3", linestyle="--")
    axes[0].set_xlabel(r"ajustado $\hat y$")
    axes[0].set_ylabel("residuo")
    axes[0].set_title("Residuos contra ajustados")
    axes[1].hist(e, bins=18, color="C0", alpha=0.8)
    axes[1].set_xlabel("residuo")
    axes[1].set_title("Histograma de residuos")
    fig.suptitle(titulo, y=1.02, fontsize=11)
    plt.tight_layout()
    plt.show()


def graficar_curva_vs_recta(x, y, beta0, beta1, titulo):
    orden = np.argsort(x)
    fig, ax = plt.subplots(figsize=(8.0, 4.4))
    ax.scatter(x, y, alpha=0.65, s=32, label="nube (curva + ruido)")
    xs = np.linspace(x.min(), x.max(), 80)
    ax.plot(xs, beta0 + beta1 * xs, color="C1", label="recta OLS")
    ax.plot(x[orden], y[orden], color="0.5", alpha=0.25)
    ax.set_xlabel("x")
    ax.set_ylabel("y")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_anscombe(conjuntos, ajustes, titulo):
    fig, axes = plt.subplots(2, 2, figsize=(8.6, 7.0), sharex=False, sharey=False)
    nombres = ["I — recta", "II — curva", "III — un atípico", "IV — un x extremo"]
    for ax, (x, y), fit, nom in zip(axes.ravel(), conjuntos, ajustes, nombres):
        ax.scatter(x, y, s=36, alpha=0.85)
        xs = np.linspace(min(x) - 0.5, max(x) + 0.5, 50)
        ax.plot(xs, fit["beta0"] + fit["beta1"] * xs, color="C1")
        ax.set_title(
            f"{nom}\nβ̂₀={fit['beta0']:.2f}, β̂₁={fit['beta1']:.2f}, MSE={fit['mse']:.2f}",
            fontsize=9,
        )
        ax.set_xlabel("x")
        ax.set_ylabel("y")
    fig.suptitle(titulo, fontsize=12)
    plt.tight_layout()
    plt.show()

5. Desarrollo por etapas

Primero una nube diseñada para que la recta sea la respuesta correcta. Después se rompe un supuesto a la vez y se mira el cuarteto de Anscombe. El caso aplicado es latencia frente a tamaño de lote.

Etapa 1: La nube que sí es una recta

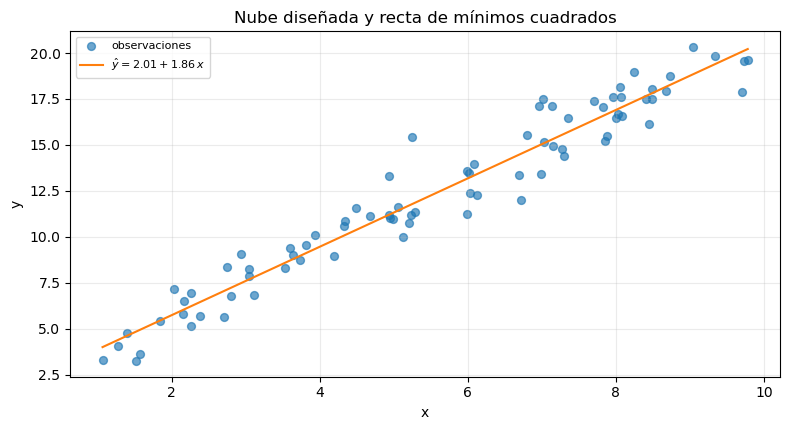
Se generan \(n=80\) puntos

\[ y=2.5+1.8\,x+\varepsilon,\qquad \varepsilon\sim\mathcal N(0,\,1.2^2),\quad x\sim\mathrm{Unif}(1,10). \]

Los parámetros verdaderos se conocen porque el laboratorio los eligió. El ajuste no los “ve”: solo ve la muestra.

n = 80
x = rng.uniform(1, 10, size=n)
y = 2.5 + 1.8 * x + rng.normal(0, 1.2, size=n)
df = pd.DataFrame({"x": x, "y": y})
print(df.describe().round(3))
print()
print("Parámetros de diseño: β0 = 2.5,  β1 = 1.8,  σ = 1.2")
            x       y
count  80.000  80.000
mean    5.559  12.358
std     2.447   4.690
min     1.066   3.235
25%     3.579   8.899
50%     5.632  12.159
75%     7.830  16.606
max     9.781  20.328

Parámetros de diseño: β0 = 2.5,  β1 = 1.8,  σ = 1.2

Lectura. \(x\) vive entre 1 y 10: el intercepto \(\beta_0=2.5\) es una extrapolación a \(x=0\), fuera del soporte. Ya queda anunciado que \(\hat\beta_0\) se leerá con cuidado.

Etapa 2: Mínimos cuadrados a mano

Se aplican las fórmulas de \(\hat\beta_1\) y \(\hat\beta_0\), y la vía matricial. Deben coincidir.

fit = ajustar_ols(x, y)
print("Fórmulas:   β̂0 =", round(fit["beta0"], 4), "  β̂1 =", round(fit["beta1"], 4))

X = np.column_stack([np.ones(n), x])
beta_mat = np.linalg.inv(X.T @ X) @ (X.T @ y)
print("Matricial:  β̂0 =", round(beta_mat[0], 4), "  β̂1 =", round(beta_mat[1], 4))
print()
print("Diseño:     β0 = 2.5         β1 = 1.8")
print("La muestra no recupera el diseño al milímetro: n es finito y hay ruido.")
Fórmulas:   β̂0 = 2.0071   β̂1 = 1.8621
Matricial:  β̂0 = 2.0071   β̂1 = 1.8621

Diseño:     β0 = 2.5         β1 = 1.8
La muestra no recupera el diseño al milímetro: n es finito y hay ruido.

Lectura. \(\hat\beta_1\) quedó cerca de \(1.8\). Esa cercanía es muestreo, no magia de la librería. Con \(n\) chico o \(\sigma\) grande, el mismo diseño produce pendientes más lejos.

Etapa 3: La misma recta con scikit-learn

LinearRegression estima el intercepto por defecto. coef_ es \(\hat\beta_1\); intercept_ es \(\hat\beta_0\). \(x\) entra como matriz \((n,1)\).

modelo = LinearRegression()
modelo.fit(x.reshape(-1, 1), y)
print("sklearn  β̂0 =", round(modelo.intercept_, 4), "  β̂1 =", round(float(modelo.coef_[0]), 4))
print("a mano   β̂0 =", round(fit["beta0"], 4), "  β̂1 =", round(fit["beta1"], 4))
print("¿Coinciden?", np.allclose([modelo.intercept_, modelo.coef_[0]], [fit["beta0"], fit["beta1"]]))

graficar_recta(
    x, y, fit["beta0"], fit["beta1"],
    "Nube diseñada y recta de mínimos cuadrados",
)
sklearn  β̂0 = 2.0071   β̂1 = 1.8621
a mano   β̂0 = 2.0071   β̂1 = 1.8621
¿Coinciden? True

Después. La librería no inventa otro criterio: OLS es OLS. scikit-learn aporta API, predicción y (más adelante) pipelines. El número de la pendiente ya estaba en la etapa 2.

Etapa 4: Predicción, residuo y MSE

\[ \hat y_i=\hat\beta_0+\hat\beta_1 x_i,\qquad e_i=y_i-\hat y_i,\qquad \mathrm{MSE}=\frac{1}{n}\sum e_i^2. \]

mean_squared_error usa el divisor \(n\). \(s^2\) usa \(n-2\).

yhat = modelo.predict(x.reshape(-1, 1))
e = y - yhat
mse_mano = np.mean(e ** 2)
mse_sk = mean_squared_error(y, yhat)
s2 = np.sum(e ** 2) / (n - 2)
rmse = np.sqrt(mse_sk)
r2 = r2_score(y, yhat)

print("MSE a mano     =", round(mse_mano, 4))
print("MSE sklearn    =", round(mse_sk, 4))
print("s² (divisor n-2) =", round(s2, 4), "  ← no es el MSE")
print("RMSE           =", round(rmse, 4), "  (unidades de y)")
print("R²             =", round(r2, 4), "  (1 − SCres/SCtot; no sustituye al diagrama)")
print("σ de diseño    = 1.2;  RMSE debería vivir cerca de ese orden.")
MSE a mano     = 1.23
MSE sklearn    = 1.23
s² (divisor n-2) = 1.2615   ← no es el MSE
RMSE           = 1.109   (unidades de y)
R²             = 0.9434   (1 − SCres/SCtot; no sustituye al diagrama)
σ de diseño    = 1.2;  RMSE debería vivir cerca de ese orden.

Lectura. El RMSE es comparable con \(\sigma=1.2\): el modelo no puede bajar de la niebla que se inyectó. Un MSE cercano a \(0\) aquí sería sospechoso (sobreajuste a \(n=80\) puntos ruidosos), no un triunfo. \(R^2\) se menciona porque aparece en todos los reportes; no se usa como sello de calidad sin residuos.

Etapa 5: Residuos cuando el modelo es el correcto

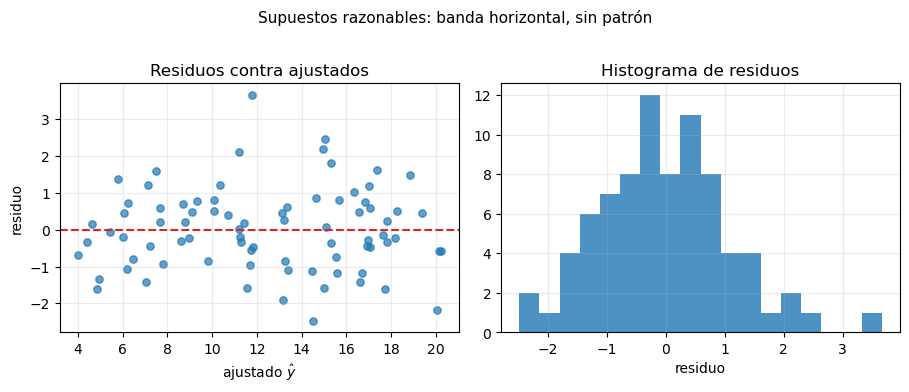
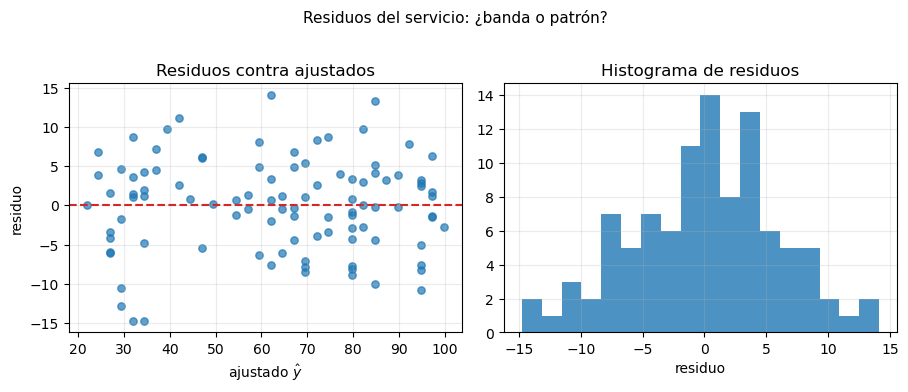
Si \(E[y\mid x]\) es lineal y la varianza es constante, los residuos contra \(\hat y\) son una banda horizontal alrededor de 0, sin curva y sin embudo.

graficar_residuos(yhat, e, "Supuestos razonables: banda horizontal, sin patrón")
print("Media de residuos (debe ~ 0):", round(e.mean(), 6))
print("Correlación(x, e) (OLS la anula):", round(np.corrcoef(x, e)[0, 1], 8))

Media de residuos (debe ~ 0): -0.0
Correlación(x, e) (OLS la anula): -0.0

Lectura. La media de \(e\) es \(0\) por construcción del intercepto. \(\mathrm{corr}(x,e)=0\) también: OLS gasta la pendiente hasta agotar la asociación lineal con \(x\). Eso no prueba que no quede estructura no lineal. En esta etapa no queda, porque el diseño era lineal.

Etapa 6: Interpretar \(\hat\beta_0\) y \(\hat\beta_1\)

\(x\) está en “unidades de \(x\)” y \(y\) en “unidades de \(y\)”. La pendiente hereda \(y/x\).

b0, b1 = fit["beta0"], fit["beta1"]
print(f"β̂0 = {b0:.3f}  → predicción en x = 0 (fuera del rango [{x.min():.2f}, {x.max():.2f}])")
print(f"β̂1 = {b1:.3f}  → Δŷ por cada +1 en x")
print()
x0 = 4.0
print(f"ŷ(x={x0}) = {b0 + b1 * x0:.3f}")
print("No se afirma: 'si yo fuerzo x = 4, y valdrá ese número'.")
print("Se afirma: 'en nubes como esta, en x = 4, la recta predice ese número'.")
β̂0 = 2.007  → predicción en x = 0 (fuera del rango [1.07, 9.78])
β̂1 = 1.862  → Δŷ por cada +1 en x

ŷ(x=4.0) = 9.455
No se afirma: 'si yo fuerzo x = 4, y valdrá ese número'.
Se afirma: 'en nubes como esta, en x = 4, la recta predice ese número'.

Regla de bolsillo. La pendiente es una asociación condicional al modelo. Cambiar \(x\) en el mundo puede mover otras variables (confusores) que la recta simple no ve. Sin diseño experimental o un argumento causal, \(\hat\beta_1\) no es un efecto de intervención.

Etapa 7: Cuando la nube es una curva — la recta igual se dibuja

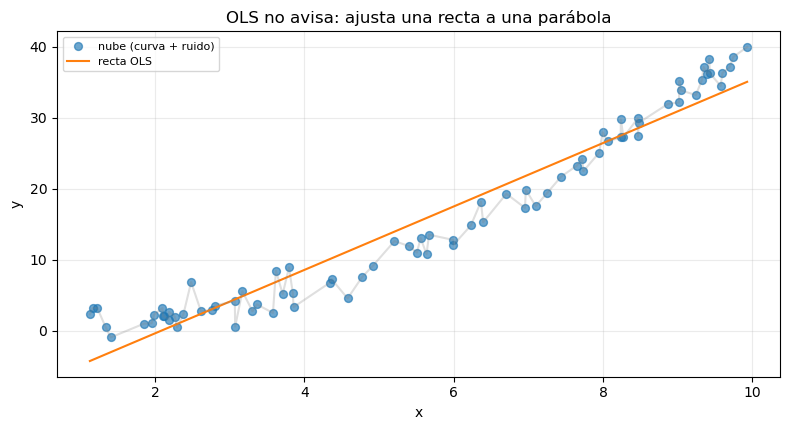
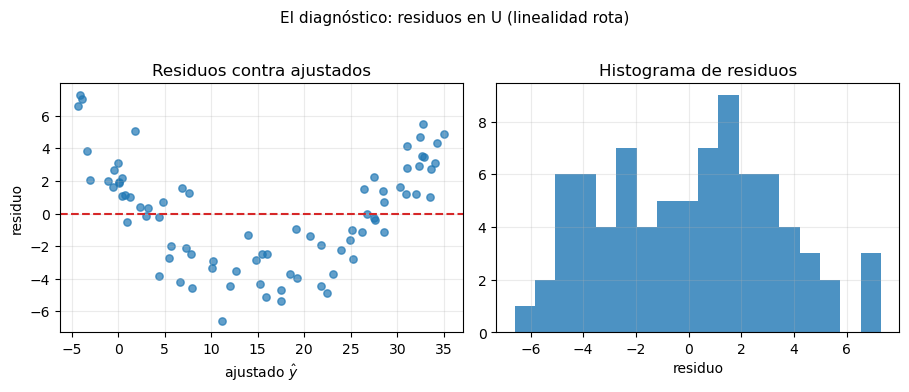
Se genera \(y=0.4\,x^2+\varepsilon\) en el mismo rango de \(x\). OLS no se niega: entrega una pendiente. El MSE puede parecer “aceptable”. Los residuos quedan en U.

x_c = rng.uniform(1, 10, size=n)
y_c = 0.4 * x_c ** 2 + rng.normal(0, 1.5, size=n)
fit_c = ajustar_ols(x_c, y_c)
print("Curva ajustada con una recta: β̂0 =", round(fit_c["beta0"], 3), "  β̂1 =", round(fit_c["beta1"], 3))
print("MSE (recta sobre curva) =", round(fit_c["mse"], 3))
print("MSE de la nube lineal (etapa 4) =", round(mse_sk, 3), "  ← no son comparables: y distinta")

graficar_curva_vs_recta(
    x_c, y_c, fit_c["beta0"], fit_c["beta1"],
    "OLS no avisa: ajusta una recta a una parábola",
)
graficar_residuos(fit_c["yhat"], fit_c["e"], "El diagnóstico: residuos en U (linealidad rota)")
Curva ajustada con una recta: β̂0 = -9.327   β̂1 = 4.47
MSE (recta sobre curva) = 10.297
MSE de la nube lineal (etapa 4) = 1.23   ← no son comparables: y distinta

El contraste (primera mitad). Un \(\hat\beta_1\) positivo y un MSE finito no certifican linealidad. El gráfico de residuos es parte del modelo, no un adorno. En IA: un lineal sobre una relación umbral o saturada produce el mismo U (o un embudo) y un coeficiente que “parece” interpretable.

Etapa 8: El contraste que importa — cuarteto de Anscombe

Cuatro conjuntos. Mismos \(n=11\), casi la misma \(\hat\beta_0\approx 3\), \(\hat\beta_1\approx 0.5\) y el mismo MSE. Cuatro geometrías. Los números son los de Anscombe (1973).

anscombe = [
    (
        np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]),
        np.array([8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]),
    ),
    (
        np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]),
        np.array([9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74]),
    ),
    (
        np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]),
        np.array([7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73]),
    ),
    (
        np.array([8.0, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8]),
        np.array([6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]),
    ),
]
fits_a = [ajustar_ols(x_a, y_a) for x_a, y_a in anscombe]
tab = pd.DataFrame(
    {
        "conjunto": ["I", "II", "III", "IV"],
        "beta0": [f["beta0"] for f in fits_a],
        "beta1": [f["beta1"] for f in fits_a],
        "MSE": [f["mse"] for f in fits_a],
        "R2": [r2_score(y_a, f["yhat"]) for (x_a, y_a), f in zip(anscombe, fits_a)],
    }
)
print(tab.round(3).to_string(index=False))

graficar_anscombe(
    anscombe, fits_a,
    "Misma pendiente, mismo MSE, cuatro historias. El diagrama no es opcional",
)
conjunto  beta0  beta1   MSE    R2
       I  3.000    0.5 1.251 0.667
      II  3.001    0.5 1.252 0.666
     III  3.002    0.5 1.251 0.666
      IV  3.002    0.5 1.249 0.667

El contraste. I es una recta ruidosa. II es una curva: la pendiente es un promedio que no existe en ningún tramo. III es una recta más un punto que inclina \(\hat\beta_1\) (OLS eleva al cuadrado). IV tiene \(x\) casi constante: un solo \(x=19\) apalanca la pendiente —sin ese punto no hay recta que estimar.

Reportar \(\hat\beta_1=0.5\) sin decir cuál de las cuatro nubes es una forma de mentir con el resumen correcto.

Etapa 9: Un punto extremo inclina la recta

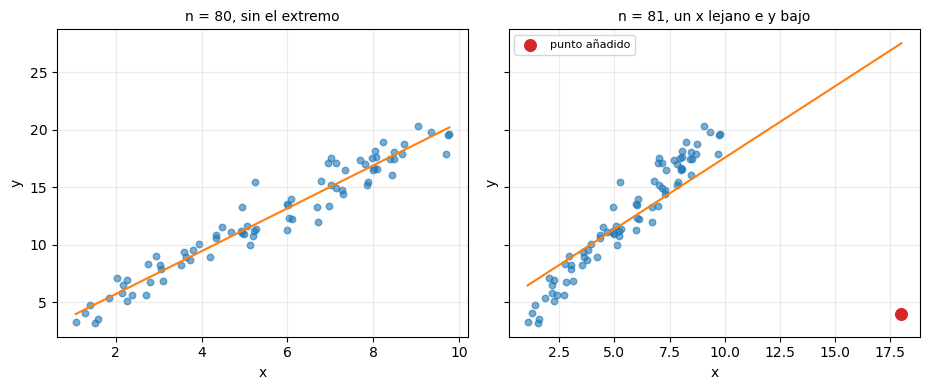
Se parte de la nube lineal de la etapa 1 y se añade un punto \((x,y)=(18,\,4)\): \(x\) lejos de \(\bar x\), \(y\) bajo. Se comparan pendientes.

x_ext = np.append(x, 18.0)
y_ext = np.append(y, 4.0)
fit_ext = ajustar_ols(x_ext, y_ext)
print("Sin el punto:  β̂1 =", round(fit["beta1"], 3), "  MSE =", round(fit["mse"], 3))
print("Con el punto:  β̂1 =", round(fit_ext["beta1"], 3), "  MSE =", round(fit_ext["mse"], 3))
print("Δβ̂1 =", round(fit_ext["beta1"] - fit["beta1"], 3))

fig, axes = plt.subplots(1, 2, figsize=(9.4, 4.0), sharey=True)
for ax, xx, yy, ft, tit in [
    (axes[0], x, y, fit, "n = 80, sin el extremo"),
    (axes[1], x_ext, y_ext, fit_ext, "n = 81, un x lejano e y bajo"),
]:
    ax.scatter(xx, yy, s=22, alpha=0.6)
    xs = np.linspace(xx.min(), xx.max(), 60)
    ax.plot(xs, ft["beta0"] + ft["beta1"] * xs, color="C1")
    ax.set_title(tit, fontsize=10)
    ax.set_xlabel("x")
    ax.set_ylabel("y")
axes[1].scatter([18], [4], s=70, color="C3", zorder=3, label="punto añadido")
axes[1].legend(fontsize=8)
plt.tight_layout()
plt.show()
Sin el punto:  β̂1 = 1.862   MSE = 1.23
Con el punto:  β̂1 = 1.243   MSE = 10.372
Δβ̂1 = -0.619

Lectura. Un solo par \((x,y)\) lejos en \(x\) tiene apalancamiento: mueve \(\hat\beta_1\) más que un punto cerca de \(\bar x\). No se borra por reflejo (puede ser un fallo real del sistema). Se reporta y se ajusta también sin él, para ver cuánto depende la historia de esa fila.

Etapa 10: Caso — latencia frente a tamaño de lote

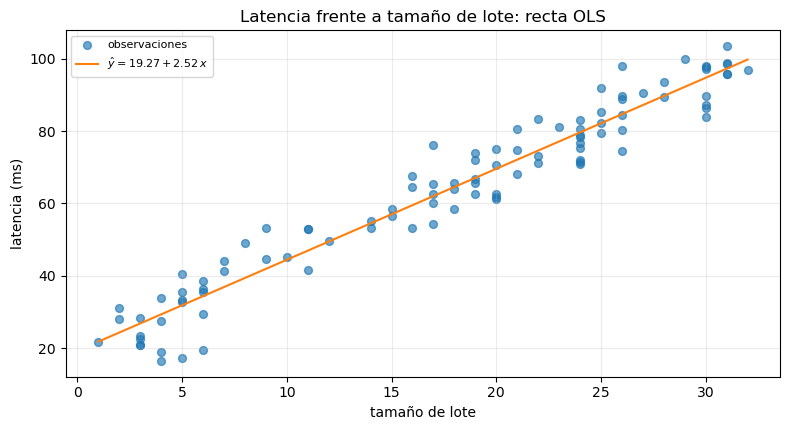
Un servicio de inferencia. \(x\) = tamaño de lote (1 a 32). \(y\) = latencia en ms. Diseño:

\[ \text{latencia}=18+2.6\cdot\text{lote}+\varepsilon,\qquad \varepsilon\sim\mathcal N(0,\,6^2). \]

\(n=100\). Se ajusta con scikit-learn y se lee \(\hat\beta_1\) en ms por unidad de lote.

n_lat = 100
lote = rng.integers(1, 33, size=n_lat).astype(float)
latencia = 18 + 2.6 * lote + rng.normal(0, 6.0, size=n_lat)

mod_lat = LinearRegression()
mod_lat.fit(lote.reshape(-1, 1), latencia)
yhat_lat = mod_lat.predict(lote.reshape(-1, 1))
e_lat = latencia - yhat_lat
mse_lat = mean_squared_error(latencia, yhat_lat)
rmse_lat = float(np.sqrt(mse_lat))

print("β̂0 (ms, lote=0) =", round(mod_lat.intercept_, 3))
print("β̂1 (ms por +1 de lote) =", round(float(mod_lat.coef_[0]), 3), "  (diseño 2.6)")
print("MSE =", round(mse_lat, 3), "  RMSE =", round(rmse_lat, 3), "ms  (σ diseño = 6)")
print("R² =", round(r2_score(latencia, yhat_lat), 3))
print()
print("Predicción en lote 8: ", round(float(mod_lat.predict([[8]])[0]), 2), "ms")
print("Predicción en lote 32:", round(float(mod_lat.predict([[32]])[0]), 2), "ms")
print("No extrapolar a lote 256: está fuera del rango observado.")

graficar_recta(
    lote, latencia, mod_lat.intercept_, float(mod_lat.coef_[0]),
    "Latencia frente a tamaño de lote: recta OLS",
    xlabel="tamaño de lote",
    ylabel="latencia (ms)",
)
graficar_residuos(yhat_lat, e_lat, "Residuos del servicio: ¿banda o patrón?")
β̂0 (ms, lote=0) = 19.274
β̂1 (ms por +1 de lote) = 2.516   (diseño 2.6)
MSE = 35.311   RMSE = 5.942 ms  (σ diseño = 6)
R² = 0.939

Predicción en lote 8:  39.4 ms
Predicción en lote 32: 99.78 ms
No extrapolar a lote 256: está fuera del rango observado.

Traducción. \(\hat\beta_1\approx 2.6\) ms por unidad de lote es una asociación en el rango 1–32. El intercepto (~18 ms) se parece a una latencia fija (carga del modelo, red), pero lote \(0\) no se midió: es ancla, no experimento. El RMSE ~6 ms es el ruido de diseño; un modelo más flexible no debería “ganar” por debajo de eso sin inventar estructura.

Caso aplicado: reportar una recta

Plantilla mínima:

  1. Respuesta y explicativa. \(y\), \(x\), unidades, rango de \(x\).
  2. Modelo y ajuste. Lineal simple, OLS, \(n\).
  3. Coeficientes. \(\hat\beta_0\), \(\hat\beta_1\) en unidades, con la frase de asociación.
  4. Error. MSE y RMSE.
  5. Diagnóstico. Residuos: ¿banda, U, embudo, un punto que apalanca?
  6. Límite. Causalidad, extrapolación, una sola \(x\).

Se aplica a la etapa 10.

Los seis pasos, aplicados

  1. Variables. \(y\) = latencia de inferencia (ms). \(x\) = tamaño de lote (1 a 32). \(n=100\).
  2. Modelo. \(y=\beta_0+\beta_1 x+\varepsilon\), OLS con LinearRegression.
  3. Coeficientes. \(\hat\beta_1\) ≈ 2.6 ms por +1 de lote (el print de la etapa 10). \(\hat\beta_0\) es la predicción en lote 0, no observado.
  4. Error. RMSE del orden de 6 ms, coherente con el ruido del diseño.
  5. Diagnóstico. Si los residuos son banda horizontal, la recta es una descripción honesta en este rango. (Ver figura de la etapa 10.)
  6. Límite. No se afirma que subir el lote cause +2.6 ms (puede haber colas, GPU, otro tráfico). No se predice lote 256. Una sola feature.

En \(n=100\) requests, la latencia media se asocia a \(+\,\hat\beta_1\) ms por cada unidad de lote (OLS). RMSE ≈ 6 ms. Se usa la recta para interpolar entre lotes 1 y 32, no para decidir un cambio de infraestructura sin un experimento. Limitación: una \(x\), ruido gaussiano de diseño, sin cola p95.

Errores que conviene nombrar

  1. Leer \(\hat\beta_1\) como efecto causal sin diseño que lo sostenga.
  2. Extrapolar a \(x=0\) o más allá del rango (el intercepto, el lote 256).
  3. Reportar MSE o \(R^2\) sin el scatter (Anscombe).
  4. Ignorar residuos en U o en embudo. La recta se calcula igual; el modelo está mal especificado.
  5. Confundir MSE (\(/n\)) con \(s^2\) (\(/(n-2)\)).
  6. Borrar el atípico por costumbre. Se informa el ajuste con y sin él.
  7. Tratar \(R^2\) alto como “el modelo es bueno”. \(R^2\) no ve sesgo de forma ni utilidad de la predicción fuera de muestra.

Idea clave

OLS responde a una pregunta: qué recta deja la menor suma de cuadrados. No responde a si la nube era una recta, ni a si mover \(x\) moverá \(y\). Eso lo dicen el diagrama, los residuos y el diseño del dato.

Síntesis

Se escribió \(y=\beta_0+\beta_1 x+\varepsilon\), se minimizó \(S\) a mano y con scikit-learn, se separó MSE de \(s^2\) y se leyó la pendiente en unidades. Los residuos validaron el caso lineal y delataron la parábola. Anscombe y el punto de alto apalancamiento mostraron que el mismo resumen numérico no fija la historia. El servicio de inferencia aplicó la plantilla: \(\hat\beta_1\) en ms/lote, RMSE, rango, y la negativa a causalidad automática.

6. Guía rápida: ¿qué fórmula usar?

Situación Qué usar Por qué
Una \(x\), una \(y\) numérica, forma de recta \(y=\beta_0+\beta_1 x+\varepsilon\) Modelo lineal simple
Elegir la recta OLS: fórmulas o LinearRegression Minimiza \(\sum e_i^2\)
Error de ajuste en \(y^2\) MSE \(=n^{-1}\sum e_i^2\) Pérdida \(L_2\)
Error en unidades de \(y\) RMSE \(=\sqrt{\mathrm{MSE}}\) Comparable con \(\sigma\) y con \(y\)
¿La nube es recta? Residuos vs \(\hat y\) U / embudo / atípico
¿Cuánto se asocia \(y\) a +1 de \(x\)? \(\hat\beta_1\) Asociación, no causa
Cuatro nubes, mismos \(\beta\) Diagrama (Anscombe) El resumen no basta

Regla de comunicación: unidades de \(\hat\beta_1\), rango de \(x\), RMSE y una frase sobre residuos.

7. Guía práctica para reportar una recta

Paso 1: \(y\), \(x\) y rango

Respuesta, explicativa, unidades, \(n\), mínimo y máximo de \(x\).

Paso 2: ajuste

OLS, \(\hat\beta_0\), \(\hat\beta_1\).

Paso 3: error y diagnóstico

MSE, RMSE, residuos (banda / U / embudo / apalancamiento).

Paso 4: frase de asociación

“+1 en \(x\) se asocia a \(\hat\beta_1\) en \(y\), en este rango.”

Paso 5: redactar

“En [población], \(n=\)[...], se ajustó \(y=\beta_0+\beta_1 x+\varepsilon\) por OLS. \(\hat\beta_1=\)[...] [unidades de y] por [unidad de x]. RMSE=[...]. Residuos: [banda / U / embudo]. Se interpreta como asociación en \(x\in\)[rango], no como efecto causal. Limitación: [una x / atípico / extrapolación].”

El caso de latencia (etapa 10) ya llenó esta plantilla.

8. Puente hacia las siguientes sesiones

La recta predice un número. La clasificación predice una clase: la pérdida deja de ser MSE y pasan a importar umbrales y costos de error. La validación dirá que el MSE de esta muestra es optimista: hay que medirlo fuera de las filas que ajustaron \(\hat\beta\). Varias \(x\) a la vez son la misma pérdida \(L_2\) en un plano; los supuestos y los residuos no se jubilan.

9. Cierre

Este notebook deja el modelo numérico más corto:

  • \(y=\beta_0+\beta_1 x+\varepsilon\) y los supuestos que lo hacen honesto,
  • mínimos cuadrados a mano y con scikit-learn,
  • MSE, RMSE y \(s^2\),
  • interpretación de coeficientes sin causalidad automática,
  • residuos, curva mal especificada, apalancamiento y Anscombe,
  • un servicio de inferencia reportado en ms por lote.

Resultado esperado: el estudiante puede ajustar una recta, leer \(\hat\beta_1\) en unidades, calcular el MSE y negarse a publicar la pendiente sin el diagrama de la nube y de los residuos.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.