Estadística para IA — 12. Clasificación y métricas de evaluación

estadistica
clasificacion
metricas
Clasificación binaria, matriz de confusión, exactitud, precisión, recall, F1, ROC, AUC, desbalance y un protocolo para decidir si el clasificador sirve.
Author

Wilder Ramírez Delgado

Published

September 25, 2026

Sesión 12 — Clasificación y Métricas de Evaluación

Open in Colab

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Un 99% de aciertos puede ser un modelo inútil

Clasificar no es “acertar filas”. Es decidir, con un umbral, qué casos merecen la etiqueta positiva —fraude, enfermedad, spam— sabiendo que los dos errores no pesan igual y que la clase que importa suele ser la rara. Un clasificador que nunca alerta acierta el 97% si solo el 3% es positivo. Ese 97% no es un modelo: es la frecuencia base.

Este notebook construye el lenguaje para leer un clasificador: matriz de confusión, exactitud (accuracy), precisión, recall (sensibilidad), F1, curva ROC, AUC y los tipos de desbalance. El contraste que importa es el mismo de la prueba diagnóstica: \(P(+\mid E)\) no es \(P(E\mid +)\). Aquí se llaman recall y precisión.

Contexto: un filtro de fraude diseñado (clase positiva \(\approx 4.6\%\) en prueba) y el conjunto Breast cancer de scikit-learn para aplicar el veredicto a un \(y\) real.

Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 4 · Sesión 12

Objetivos

  • Plantear la clasificación binaria como \(P(y=1\mid x)\) más un umbral.
  • Construir y leer la matriz de confusión (VP, FP, FN, VN).
  • Calcular exactitud, precisión, recall y F1, y saber cuándo cada una miente.
  • No usar la exactitud como veredicto cuando hay desbalance o costos asimétricos.
  • Leer la curva ROC y el AUC; contrastarlos con la curva precisión–recall.
  • Elegir el umbral según el costo de un falso positivo frente a un falso negativo.
  • Redactar un veredicto: ¿el clasificador sirve para este uso?

Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.

1. El clasificador es un umbral sobre una probabilidad

1.1 Clasificación binaria

Cada fila tiene una etiqueta \(y\in\{0,1\}\). El modelo no “es” 0 o 1: entrega un score \(s(x)\in[0,1]\) (o un logit). La etiqueta predicha es

\[ \hat y = \mathbf{1}\{s(x)\ge \tau\}. \]

\(\tau=0.5\) es costumbre, no teorema. Mover \(\tau\) cambia todos los conteos de la matriz. Un modelo y un umbral son un par; reportar métricas sin \(\tau\) es reportar a medias.

1.2 Matriz de confusión

Se compara \(\hat y\) con \(y\) en un conjunto no usado para ajustar (si se valida; si no, se está midiendo memoria). Cuatro conteos:

\(\hat y=1\) (alerta) \(\hat y=0\)
\(y=1\) VP (verdadero positivo) FN (falso negativo)
\(y=0\) FP (falso positivo) VN (verdadero negativo)

scikit-learn, con etiquetas [0, 1], imprime

\[ \begin{bmatrix} \mathrm{VN} & \mathrm{FP} \\ \mathrm{FN} & \mathrm{VP} \end{bmatrix}. \]

La esquina que se mira primero no es la diagonal completa: es quién paga el error. En fraude, un FN es un cargo que pasó; un FP es un cliente molesto. En cribado médico, un FN es un enfermo no visto.

1.3 Exactitud (accuracy)

\[ \mathrm{exactitud}=\frac{\mathrm{VP}+\mathrm{VN}}{n}. \]

Es la fracción de filas bien etiquetadas. Es una métrica simétrica: trata los dos errores igual y trata las dos clases igual. Cuando \(P(y=1)\) es 0.03, predecir siempre \(0\) da exactitud \(0.97\). Ese número no informa sobre el fraude.

Baseline de exactitud: la frecuencia de la clase mayoritaria. Si el modelo no la supera, las features no están trabajando para esa métrica —y a veces no hay que superarlas, porque la métrica está mal elegida.

1.4 Precisión, recall y F1

\[ \mathrm{precisión}=\frac{\mathrm{VP}}{\mathrm{VP}+\mathrm{FP}}=P(y=1\mid \hat y=1), \]

\[ \mathrm{recall}=\frac{\mathrm{VP}}{\mathrm{VP}+\mathrm{FN}}=P(\hat y=1\mid y=1). \]

La precisión es, entre las alertas, qué fracción era positiva. El recall (sensibilidad, exhaustividad) es, entre los positivos reales, qué fracción se alertó.

\[ F_1=2\cdot\frac{\mathrm{precisión}\cdot\mathrm{recall}}{\mathrm{precisión}+\mathrm{recall}} \]

es la media armónica: castiga que una de las dos sea cercana a 0. No incorpora costos. No sustituye elegir \(\tau\).

Especificidad \(= \mathrm{VN}/(\mathrm{VN}+\mathrm{FP})=P(\hat y=0\mid y=0)\). El FPR (tasa de falsos positivos) es \(1\) menos eso: \(\mathrm{FP}/(\mathrm{FP}+\mathrm{VN})\).

1.5 ROC y AUC

Se barre \(\tau\) de \(1\) a \(0\). En cada umbral se anota

\[ \mathrm{TPR}=\mathrm{recall},\qquad \mathrm{FPR}=\frac{\mathrm{FP}}{\mathrm{FP}+\mathrm{VN}}. \]

La curva ROC es TPR frente a FPR. El AUC (area under the curve) es el área bajo esa curva: probabilidad de que un positivo al azar tenga score mayor que un negativo al azar. AUC \(=0.5\) es el clasificador aleatorio; \(1\) es separación perfecta.

El AUC no elige umbral. Un AUC de 0.92 puede convivir con precisión 0.08 en el \(\tau\) de operación si la clase es rara: el ranking es bueno y la canasta de alertas sigue llena de negativos.

Cuando hay desbalance extremo, la curva precisión–recall (PR) y su área (AP) suelen ser más honestas: el eje \(y\) es precisamente \(P(y=1\mid \hat y=1)\), que es lo que el negocio ve.

1.6 Tipos de desbalance

No hay un solo “desbalance”:

Tipo Qué ocurre Qué miente
De clase \(P(y=1)\ll 0.5\) (fraude, rareza clínica) Exactitud; a veces el AUC
De costo FN y FP no valen lo mismo \(F_1\) y \(\tau=0.5\)
De prevalencia El 3% del train no es el 3% de producción Precisión (cambia con la frecuencia base)

La precisión depende de la prevalencia. El recall, no (si el score se calibra igual). Por eso un modelo “preciso” en un banco de prueba con 20% de positivos se derrumba cuando en producción hay 2%. Es el mismo fenómeno de la prueba diagnóstica: bajar \(P(E)\) baja \(P(E\mid +)\).

1.7 Protocolo: ¿el clasificador es aceptable?

  1. ¿Cuál es \(P(y=1)\) en el conjunto que se reporta?
  2. ¿Qué cuesta un FP y un FN en este uso?
  3. ¿La exactitud gana a la clase mayoritaria? Si esa es la única cifra, no hay veredicto.
  4. Precisión, recall, \(F_1\) en el \(\tau\) de operación, no solo el “óptimo” de un notebook.
  5. ROC y, si hay rareza, PR. El AUC no se cita solo.
  6. ¿El umbral se eligió con la prueba? Si sí, la cifra ya no es independiente.
Pregunta Métrica
¿Aciertos globales? Exactitud (solo si clases y costos son simétricos)
¿Las alertas son confiables? Precisión
¿Se escapan pocos positivos? Recall
¿Un solo número de compromiso? \(F_1\) (sin costos)
¿El ranking separa? AUC-ROC
¿La canasta de alertas, con rareza? Curva PR / AP

2. Por qué importa en IA y Machine Learning

El predict de scikit-learn usa \(\tau=0.5\). El negocio casi nunca vive ahí.

  • Un detector de fraude con recall 0.15 “deja pasar” el 85% de los casos; la exactitud puede seguir por encima de 0.96.
  • Un filtro de spam con precisión 0.40 mete correo legítimo en cuarentena: el costo es reputación, no un \(F_1\).
  • Calibrar \(s(x)\) (que “0.8” signifique 80 de cada 100) es otra pregunta; aquí se evalúa el corte y el ranking.
  • Elegir \(\tau\) mirando la prueba y citar esa misma prueba es la fuga de siempre, ahora en el umbral.

Idea central: la métrica correcta es la que refleja el error que duele. La exactitud refleja el error que abunda.

3. Flujo recomendado de trabajo

  1. Declarar la clase positiva, la prevalencia y el costo relativo FN/FP.
  2. Reservar prueba. Ajustar el modelo en entrenamiento. El umbral se elige en desarrollo (o con costos), no recorriendo la prueba.
  3. Matriz de confusión en prueba, en el \(\tau\) de operación.
  4. Exactitud contra el baseline mayoritario. Precisión, recall, \(F_1\).
  5. ROC y PR. No vender solo el AUC.
  6. Veredicto para un uso: “sirve para priorizar revisión”, “no sirve para bloqueo automático”, etc.

Criterio general: un clasificador sin prevalencia, sin matriz y sin umbral declarado no se puede aceptar. Solo se puede aplaudir un porcentaje.

4. Preparar el entorno

%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification, load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.metrics import (
    confusion_matrix,
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    roc_curve,
    roc_auc_score,
    precision_recall_curve,
    average_precision_score,
    classification_report,
)

rng = np.random.default_rng(42)

plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25

print("Entorno listo: numpy, pandas, matplotlib, sklearn.")
print("sklearn:", __import__("sklearn").__version__)
Python: 3.13.9
Entorno listo: numpy, pandas, matplotlib, sklearn.
sklearn: 1.8.0

Funciones de métricas y gráficos (una sola vez)

def conteos(y_true, y_pred):
    vn, fp, fn, vp = confusion_matrix(y_true, y_pred, labels=[0, 1]).ravel()
    return {"VN": int(vn), "FP": int(fp), "FN": int(fn), "VP": int(vp)}


def ficha_clf(y_true, y_pred, etiqueta, y_score=None):
    prev = float(np.mean(y_true))
    fila = {
        "modelo": etiqueta,
        "prevalencia": prev,
        "exactitud": accuracy_score(y_true, y_pred),
        "precisión": precision_score(y_true, y_pred, zero_division=0),
        "recall": recall_score(y_true, y_pred, zero_division=0),
        "F1": f1_score(y_true, y_pred, zero_division=0),
    }
    if y_score is not None:
        fila["AUC"] = roc_auc_score(y_true, y_score)
        fila["AP"] = average_precision_score(y_true, y_score)
    return fila


def graficar_matriz(y_true, y_pred, titulo):
    M = confusion_matrix(y_true, y_pred, labels=[0, 1])
    fig, ax = plt.subplots(figsize=(4.6, 4.0))
    im = ax.imshow(M, cmap="Blues")
    ax.set_xticks([0, 1], ["ŷ = 0", "ŷ = 1"])
    ax.set_yticks([0, 1], ["y = 0", "y = 1"])
    for (i, j), val in np.ndenumerate(M):
        ax.text(j, i, str(val), ha="center", va="center", fontsize=14, color="0.1")
    ax.set_title(titulo)
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    return M


def graficar_roc_pr(y_true, y_score, titulo):
    fpr, tpr, _ = roc_curve(y_true, y_score)
    p, r, _ = precision_recall_curve(y_true, y_score)
    auc = roc_auc_score(y_true, y_score)
    ap = average_precision_score(y_true, y_score)
    prev = float(np.mean(y_true))
    fig, axes = plt.subplots(1, 2, figsize=(9.4, 3.9))
    axes[0].plot(fpr, tpr, label=f"AUC = {auc:.3f}")
    axes[0].plot([0, 1], [0, 1], linestyle="--", color="0.5", label="azar")
    axes[0].set_xlabel("FPR")
    axes[0].set_ylabel("TPR (recall)")
    axes[0].set_title("ROC")
    axes[0].legend(fontsize=8)
    axes[1].plot(r, p, label=f"AP = {ap:.3f}")
    axes[1].axhline(prev, color="0.5", linestyle="--", label=f"baseline PR = {prev:.3f}")
    axes[1].set_xlabel("recall")
    axes[1].set_ylabel("precisión")
    axes[1].set_title("Precisión–recall")
    axes[1].set_ylim(-0.05, 1.05)
    axes[1].legend(fontsize=8)
    fig.suptitle(titulo, y=1.02)
    plt.tight_layout()
    plt.show()


def graficar_umbral(y_true, y_score, titulo):
    taus = np.linspace(0.05, 0.95, 19)
    filas = []
    for t in taus:
        yp = (y_score >= t).astype(int)
        filas.append(
            {
                "τ": t,
                "precisión": precision_score(y_true, yp, zero_division=0),
                "recall": recall_score(y_true, yp, zero_division=0),
                "F1": f1_score(y_true, yp, zero_division=0),
                "exactitud": accuracy_score(y_true, yp),
            }
        )
    df = pd.DataFrame(filas)
    fig, ax = plt.subplots(figsize=(8.2, 4.2))
    ax.plot(df["τ"], df["precisión"], marker="o", label="precisión")
    ax.plot(df["τ"], df["recall"], marker="s", label="recall")
    ax.plot(df["τ"], df["F1"], marker="^", label="F1")
    ax.axvline(0.5, color="0.4", linestyle=":", label="τ = 0.5")
    ax.set_xlabel("umbral τ")
    ax.set_ylabel("métrica")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()
    return df

5. Desarrollo por etapas

Primero un fraude diseñado con prevalencia \(\approx 4.6\%\): ahí la exactitud se derrumba como argumento. Después, Breast cancer: prevalencia más alta, y el veredicto cambia de forma.

Etapa 1: El dato y la frecuencia base

\(n=4000\) filas, \(8\) features, clase positiva (fraude) alrededor del \(3\%\). Se reserva \(30\%\) de prueba. El primer número que se escribe no es un modelo: es \(P(y=1)\).

X, y = make_classification(
    n_samples=4000,
    n_features=8,
    n_informative=5,
    n_redundant=1,
    n_clusters_per_class=1,
    weights=[0.97, 0.03],
    class_sep=0.62,
    flip_y=0.03,
    random_state=42,
)
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.30, random_state=42, stratify=y
)
print("n train =", len(y_tr), "  n test =", len(y_te))
print("P(y=1) train =", round(y_tr.mean(), 4), "  P(y=1) test =", round(y_te.mean(), 4))
print("Positivos en test =", int(y_te.sum()), "de", len(y_te))
print()
print("Baseline de exactitud (siempre ŷ=0) =", round(1 - y_te.mean(), 4))
n train = 2800   n test = 1200
P(y=1) train = 0.0454   P(y=1) test = 0.0458
Positivos en test = 55 de 1200

Baseline de exactitud (siempre ŷ=0) = 0.9542

Cómo leer esto. Hay 55 positivos en test (el print manda). Cualquier métrica de la clase positiva se calcula con decenas de filas, no con miles. La exactitud, en cambio, se calcula con 1200: por eso se ve “estable” y miente.

Veredicto parcial. Ya existe un clasificador: “nadie es fraude”. Su exactitud es \(1-\pi\). Ese es el piso que hay que dejar de citar como éxito.

Etapa 2: El espejismo de la exactitud

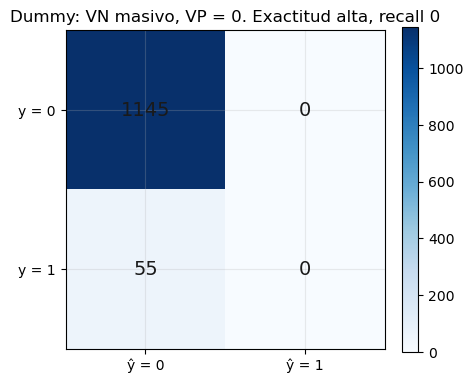
DummyClassifier(strategy="most_frequent") predice siempre la clase mayoritaria. No usa \(x\). Su exactitud en prueba es, por diseño, \(\approx 0.954\) (el print de la etapa 1).

dummy = DummyClassifier(strategy="most_frequent")
dummy.fit(X_tr, y_tr)
yp_d = dummy.predict(X_te)
print(pd.DataFrame([ficha_clf(y_te, yp_d, "dummy mayoritaria", y_score=np.zeros(len(y_te)))]).round(4).to_string(index=False))
print()
print("Conteos:", conteos(y_te, yp_d))
graficar_matriz(y_te, yp_d, "Dummy: VN masivo, VP = 0. Exactitud alta, recall 0")
           modelo  prevalencia  exactitud  precisión  recall  F1  AUC     AP
dummy mayoritaria       0.0458     0.9542        0.0     0.0 0.0  0.5 0.0458

Conteos: {'VN': 1145, 'FP': 0, 'FN': 55, 'VP': 0}

array([[1145,    0],
       [  55,    0]])

Cómo leer la matriz. Casi toda la masa está en VN. VP \(=0\), FN \(=\) todos los fraudes, FP \(=0\). Precisión \(0\) (no hubo alerta), recall \(0\), \(F_1=0\). Exactitud \(\approx 0.954\).

Qué no se concluye. Que “no hay señal en \(x\)”. El dummy no miró \(x\). Se concluye que la exactitud, sola, no distingue a este dummy de un detector útil.

Pregunta de análisis. Si un informe solo trae “accuracy 95.4%”, ¿qué pregunta haces antes de felicitar al equipo?

Etapa 3: Un modelo que sí usa \(x\) — logística con scikit-learn

LogisticRegression + estandarización. Umbral por defecto \(\tau=0.5\). Se compara con el dummy en la misma prueba.

clf = Pipeline(
    [
        ("esc", StandardScaler()),
        ("log", LogisticRegression(max_iter=500, class_weight=None)),
    ]
)
clf.fit(X_tr, y_tr)
yp = clf.predict(X_te)
ys = clf.predict_proba(X_te)[:, 1]

tab = pd.DataFrame(
    [
        ficha_clf(y_te, yp_d, "dummy mayoritaria", y_score=np.zeros(len(y_te))),
        ficha_clf(y_te, yp, "logística τ=0.5", ys),
    ]
)
print(tab.round(3).to_string(index=False))
print()
print("Conteos logística:", conteos(y_te, yp))
print()
print(classification_report(y_te, yp, digits=3, zero_division=0))
graficar_matriz(y_te, yp, "Logística, τ=0.5: aparecen VP, y también FP")
           modelo  prevalencia  exactitud  precisión  recall    F1   AUC    AP
dummy mayoritaria        0.046      0.954        0.0   0.000 0.000 0.500 0.046
  logística τ=0.5        0.046      0.964        1.0   0.218 0.358 0.735 0.420

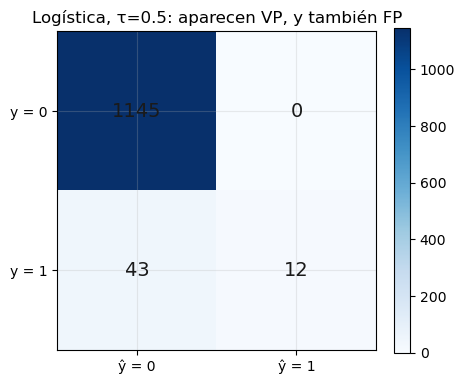
Conteos logística: {'VN': 1145, 'FP': 0, 'FN': 43, 'VP': 12}

              precision    recall  f1-score   support

           0      0.964     1.000     0.982      1145
           1      1.000     0.218     0.358        55

    accuracy                          0.964      1200
   macro avg      0.982     0.609     0.670      1200
weighted avg      0.965     0.964     0.953      1200

array([[1145,    0],
       [  43,   12]])

Cómo leer la comparación. La exactitud no es el juez. Puede quedar por debajo del dummy (el modelo se atreve a alertar y fabrica FP) o por encima (como a veces ocurre si separa bien). El dummy tiene VP \(=0\). La logística, no. Se compara recall y precisión, no el 96%.

Mira, en este orden: recall (¿cuántos fraudes pescó?), precisión (¿qué tan sucia es la lista?), exactitud (al final, si acaso).

Qué no se concluye. Que \(\tau=0.5\) sea el corte de operación. La etapa 6 lo mueve.

Veredicto parcial. Si la logística no gana al dummy en recall o en \(F_1\), \(x\) no está separando. Si gana ahí y pierde una décima de exactitud, se prefiere la logística para este uso.

Etapa 4: Las cuatro celdas, en palabras

Se toman los conteos de la logística y se traducen. Sin esta frase, la matriz es decoración.

c = conteos(y_te, yp)
n = len(y_te)
print(f"De {n} transacciones de prueba:")
print(f"  {c['VP']} fraudes bien alertados (VP)")
print(f"  {c['FN']} fraudes que pasaron (FN)  ← costo de 'dejar pasar'")
print(f"  {c['FP']} legítimas alertadas (FP)  ← costo de 'molestar'")
print(f"  {c['VN']} legítimas en paz (VN)")
print()
print("precisión = VP / (VP+FP) =", round(c["VP"] / max(c["VP"] + c["FP"], 1), 3))
print("recall    = VP / (VP+FN) =", round(c["VP"] / max(c["VP"] + c["FN"], 1), 3))
print("exactitud = (VP+VN) / n  =", round((c["VP"] + c["VN"]) / n, 3))
De 1200 transacciones de prueba:
  12 fraudes bien alertados (VP)
  43 fraudes que pasaron (FN)  ← costo de 'dejar pasar'
  0 legítimas alertadas (FP)  ← costo de 'molestar'
  1145 legítimas en paz (VN)

precisión = VP / (VP+FP) = 1.0
recall    = VP / (VP+FN) = 0.218
exactitud = (VP+VN) / n  = 0.964

Cómo leer las frases. “Hay \(a\) fraudes bien alertados y \(b\) que se escaparon” es el recall en humano. “De cada 10 alertas, \(c\) eran fraude” es la precisión. El comité de producto entiende esas dos oraciones. No entiende “\(F_1=0.41\)” si no las ha oído antes.

Pregunta de análisis. Si cada FN cuesta 20 veces un FP, ¿miras primero el recall o la precisión?

Etapa 5: El mismo modelo, dos usos, dos veredictos

No se reentrena. Se lee la misma matriz con dos costos.

  • Uso A — bloqueo automático. Un FP cobra cara (cliente bloqueado). Se exige precisión alta; se tolera perder fraude.
  • Uso B — cola de revisión. Un FN cobra cara (fraude no visto). Se exige recall alto; se acepta una cola sucia.
print("Misma matriz, dos lecturas (τ = 0.5)")
print(pd.Series(c).to_string())
print()
print("Uso A (bloqueo):  precisión =", round(precision_score(y_te, yp, zero_division=0), 3),
      "  → 0 FP: lista limpia. El hueco no es suciedad; son los FN que se escapan.")
print("Uso B (revisión): recall    =", round(recall_score(y_te, yp, zero_division=0), 3),
      "  → ¿qué fracción del fraude llega a la cola?")
print()
print("El F1 =", round(f1_score(y_te, yp, zero_division=0), 3),
      "promedia las dos y no sabe cuál uso es el de hoy.")
Misma matriz, dos lecturas (τ = 0.5)
VN    1145
FP       0
FN      43
VP      12

Uso A (bloqueo):  precisión = 1.0   → 0 FP: lista limpia. El hueco no es suciedad; son los FN que se escapan.
Uso B (revisión): recall    = 0.218   → ¿qué fracción del fraude llega a la cola?

El F1 = 0.358 promedia las dos y no sabe cuál uso es el de hoy.

Cómo leer el desdoble. El modelo no cambió. El veredicto sí. “¿Es bueno?” sin el uso es la pregunta mal hecha de siempre. \(F_1\) es un compromiso ciego: útil para ordenar modelos en un ranking, insuficiente para desplegar.

Veredicto parcial. A \(\tau=0.5\) casi nunca se firman los dos usos a la vez. Hace falta mover el umbral (etapa 6) o declarar uno solo.

Etapa 6: Mover \(\tau\) — precisión y recall no se maximizan juntos

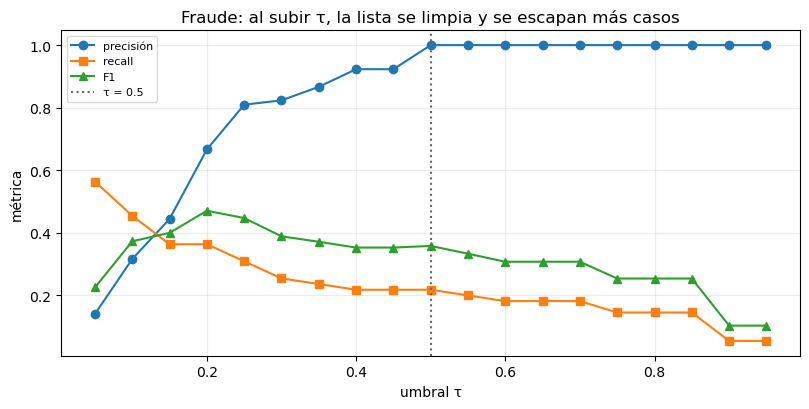
Se barre el umbral. Subir \(\tau\) exige más certeza para alertar: sube la precisión y baja el recall. Bajar \(\tau\) hace lo contrario.

df_tau = graficar_umbral(y_te, ys, "Fraude: al subir τ, la lista se limpia y se escapan más casos")
print(df_tau.round(3).to_string(index=False))
print()
print("Máximo F1 en esta parrilla: τ =", float(df_tau.loc[df_tau["F1"].idxmax(), "τ"]))
print("Ese τ máximo-F1 se eligió MIRANDO la prueba: en un protocolo estricto no se publica como operación.")

   τ  precisión  recall    F1  exactitud
0.05      0.141   0.564 0.225      0.822
0.10      0.316   0.455 0.373      0.930
0.15      0.444   0.364 0.400      0.950
0.20      0.667   0.364 0.471      0.962
0.25      0.810   0.309 0.447      0.965
0.30      0.824   0.255 0.389      0.963
0.35      0.867   0.236 0.371      0.963
0.40      0.923   0.218 0.353      0.963
0.45      0.923   0.218 0.353      0.963
0.50      1.000   0.218 0.358      0.964
0.55      1.000   0.200 0.333      0.963
0.60      1.000   0.182 0.308      0.962
0.65      1.000   0.182 0.308      0.962
0.70      1.000   0.182 0.308      0.962
0.75      1.000   0.145 0.254      0.961
0.80      1.000   0.145 0.254      0.961
0.85      1.000   0.145 0.254      0.961
0.90      1.000   0.055 0.103      0.957
0.95      1.000   0.055 0.103      0.957

Máximo F1 en esta parrilla: τ = 0.2
Ese τ máximo-F1 se eligió MIRANDO la prueba: en un protocolo estricto no se publica como operación.

Cómo leer la parrilla. Cada fila es un clasificador distinto (mismo \(s(x)\), otro corte). La exactitud apenas se mueve: está dominada por los VN. Precisión y recall se cruzan. El \(\tau\) que maximiza \(F_1\) en esta prueba ya usó \(y\) de test: si se cita, hay fuga de umbral. En trabajo real ese máximo se busca en desarrollo.

Qué no se concluye. Que exista un \(\tau\) “correcto”. Existe un \(\tau\) para un costo. Si FN vale 20·FP, se baja \(\tau\) aunque el \(F_1\) empeore.

Veredicto parcial. Reportar métricas implica reportar \(\tau\). “Logística, \(\tau=0.5\)” y “logística, \(\tau=0.20\)” no son el mismo producto.

Etapa 7: ROC y AUC — el ranking, no el corte

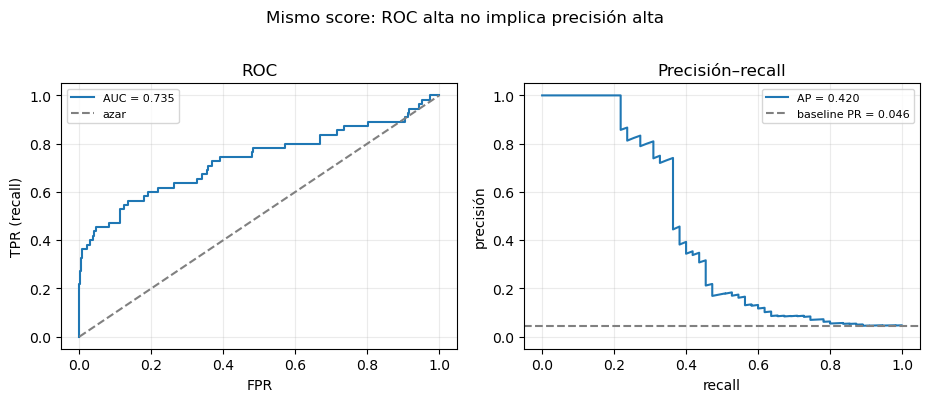
La ROC resume todos los umbrales. El AUC dice si los fraudes tienden a tener \(s(x)\) mayor que las legítimas.

print("AUC-ROC =", round(roc_auc_score(y_te, ys), 3))
print("AP (área bajo PR) =", round(average_precision_score(y_te, ys), 3),
      "   baseline PR = prevalencia =", round(y_te.mean(), 3))
graficar_roc_pr(y_te, ys, "Mismo score: ROC alta no implica precisión alta")
AUC-ROC = 0.735
AP (área bajo PR) = 0.42    baseline PR = prevalencia = 0.046

Cómo leer las dos curvas. La ROC puede verse “buena” (lejos de la diagonal) mientras la PR vive cerca de una precisión mediocre: hay pocos positivos, y cualquier FPR no nulo inunda la canasta de alertas (muchos negativos \(\times\) un FPR chico \(=\) muchos FP).

El AP se compara con la prevalencia, no con \(0.5\). Un AP de \(0.25\) con \(\pi=0.03\) es una mejora grande; un AUC de \(0.80\) no dice cuán sucia es la lista en operación.

Qué no se concluye. Que AUC \(>0.9\) autorice bloqueo automático. El AUC no conoce \(\tau\) ni el costo.

Veredicto parcial. Se citan las dos curvas cuando \(\pi\) es chico. Solo ROC es el retrato de estudio; PR es la foto del mostrador.

Etapa 8: Desbalance de clase — class_weight="balanced"

La logística sin pesos trata cada fila igual: como hay 30 negativos por positivo, el ajuste se acomoda a acertar negativos. class_weight="balanced" pondera al revés de la frecuencia. Cambia \(s(x)\) y, a \(\tau=0.5\), suele subir recall y bajar precisión.

clf_b = Pipeline(
    [
        ("esc", StandardScaler()),
        ("log", LogisticRegression(max_iter=500, class_weight="balanced")),
    ]
)
clf_b.fit(X_tr, y_tr)
yp_b = clf_b.predict(X_te)
ys_b = clf_b.predict_proba(X_te)[:, 1]

tab_b = pd.DataFrame(
    [
        ficha_clf(y_te, yp, "logística (sin pesos) τ=0.5", ys),
        ficha_clf(y_te, yp_b, "logística balanced τ=0.5", ys_b),
    ]
)
print(tab_b.round(3).to_string(index=False))
print()
print("Conteos sin pesos:", conteos(y_te, yp))
print("Conteos balanced: ", conteos(y_te, yp_b))
                     modelo  prevalencia  exactitud  precisión  recall    F1   AUC    AP
logística (sin pesos) τ=0.5        0.046      0.964      1.000   0.218 0.358 0.735 0.420
   logística balanced τ=0.5        0.046      0.803      0.134   0.600 0.219 0.744 0.373

Conteos sin pesos: {'VN': 1145, 'FP': 0, 'FN': 43, 'VP': 12}
Conteos balanced:  {'VN': 931, 'FP': 214, 'FN': 22, 'VP': 33}

Cómo leer el cambio. No es “un modelo mejor”: es otro punto del compromiso. Balanced empuja a encontrar positivos. El AUC a veces se mueve poco (el ranking no cambia tanto); precisión y recall en \(\tau=0.5\) sí. Eso confirma que el umbral y los pesos son palancas de operación, no milagros de ajuste.

Veredicto parcial. Elegir balanced es elegir un uso (cola de revisión), no una medalla. Se compara en la métrica del uso, no en exactitud.

Etapa 9: Desbalance de prevalencia — la precisión se mueve sola

Se submuestrea la prueba para fabricar una prevalencia del 15% (mismo modelo, mismo \(\tau=0.5\), mismos pesos originales). El recall debería parecerse; la precisión sube porque hay más positivos en la canasta.

rng_loc = np.random.default_rng(0)
pos = np.where(y_te == 1)[0]
neg = np.where(y_te == 0)[0]
n_pos = len(pos)
n_neg_objetivo = int(n_pos * (1 - 0.15) / 0.15)
neg_s = rng_loc.choice(neg, size=min(n_neg_objetivo, len(neg)), replace=False)
idx = np.concatenate([pos, neg_s])
print("Prevalencia original test =", round(y_te.mean(), 3), "  n =", len(y_te))
print("Prevalencia recortada     =", round(y_te[idx].mean(), 3), "  n =", len(idx))
print()
print(
    pd.DataFrame(
        [
            ficha_clf(y_te, yp, "π ≈ 0.05, τ=0.5", ys),
            ficha_clf(y_te[idx], yp[idx], "π ≈ 0.15, τ=0.5", ys[idx]),
        ]
    ).round(3).to_string(index=False)
)
Prevalencia original test = 0.046   n = 1200
Prevalencia recortada     = 0.15   n = 366

         modelo  prevalencia  exactitud  precisión  recall    F1   AUC    AP
π ≈ 0.05, τ=0.5        0.046      0.964        1.0   0.218 0.358 0.735 0.420
π ≈ 0.15, τ=0.5        0.150      0.883        1.0   0.218 0.358 0.737 0.569

Cómo leer las dos filas. El recall se mantiene en el mismo orden (depende de \(P(\hat y=1\mid y=1)\), no de \(\pi\)). La precisión tiende a subir al inflar \(\pi\) (Bayes: más positivos en la canasta). Si hay poquísimos FP, el cambio puede ser chico en esta semilla; el AP y el baseline de la curva PR sí se mueven. Un proveedor que mide precisión en un conjunto enriquecido (muchos fraudes a propósito) vende un número que no se verá en producción.

Veredicto parcial. Toda precisión se publica con su prevalencia. Sin \(\pi\), el 80% no se puede traducir.

Etapa 10: Caso real — Breast cancer (Wisconsin)

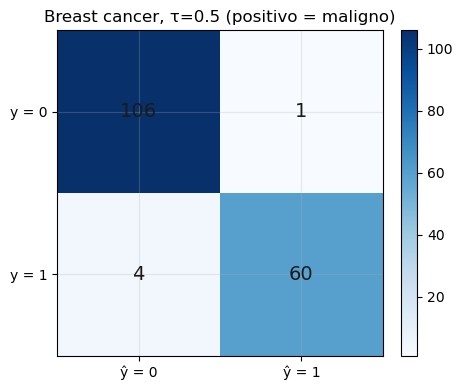
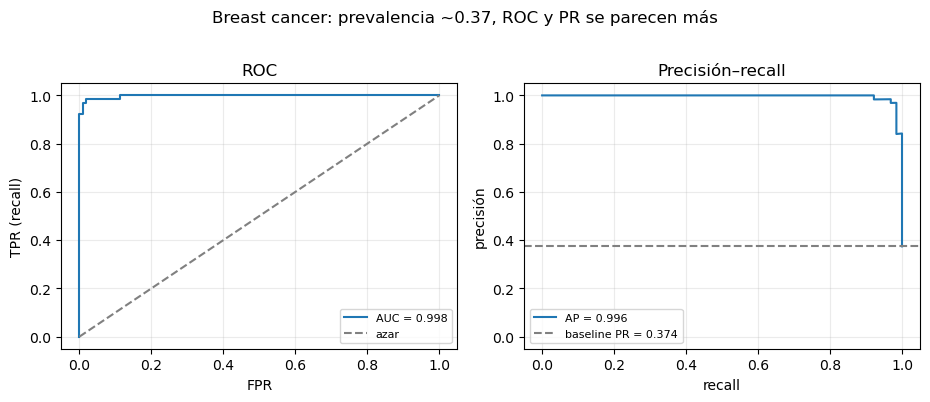
\(n=569\), \(p=30\) atributos del núcleo celular. En load_breast_cancer la etiqueta 0 es malignant y la 1 es benign: se invierte \(y\) para que \(y=1\) sea maligno. Prevalencia ~37%: no es el fraude al 4.6%. El mismo aparato debe dar otro veredicto, no el mismo párrafo recortado.

Partición estratificada 30% prueba. Logística estandarizada, \(\tau=0.5\). Matriz, métricas, ROC/PR, umbrales.

bc = load_breast_cancer()
Xb, yb = bc.data, bc.target
print("clases (orden sklearn):", list(bc.target_names), "  conteos [0, 1] =", np.bincount(yb))
print("En load_breast_cancer: 0 = malignant, 1 = benign.")
print("Para el oficio clínico la clase positiva debe ser el maligno. Se invierte y.")
y_mal = (yb == 0).astype(int)
print("P(maligno) =", round(y_mal.mean(), 3), "  n =", len(y_mal), "  p =", Xb.shape[1])

Xb_tr, Xb_te, yb_tr, yb_te = train_test_split(
    Xb, y_mal, test_size=0.30, random_state=42, stratify=y_mal
)
clf_bc = Pipeline(
    [("esc", StandardScaler()), ("log", LogisticRegression(max_iter=500))]
)
clf_bc.fit(Xb_tr, yb_tr)
yp_bc = clf_bc.predict(Xb_te)
ys_bc = clf_bc.predict_proba(Xb_te)[:, 1]
yp_maj = DummyClassifier(strategy="most_frequent").fit(Xb_tr, yb_tr).predict(Xb_te)

print()
print(
    pd.DataFrame(
        [
            ficha_clf(yb_te, yp_maj, "dummy mayoritaria", y_score=np.zeros(len(yb_te))),
            ficha_clf(yb_te, yp_bc, "logística τ=0.5", ys_bc),
        ]
    ).round(3).to_string(index=False)
)
print()
print("Conteos:", conteos(yb_te, yp_bc))
print(classification_report(yb_te, yp_bc, target_names=["benigno", "maligno"], digits=3))
graficar_matriz(yb_te, yp_bc, "Breast cancer, τ=0.5 (positivo = maligno)")
graficar_roc_pr(yb_te, ys_bc, "Breast cancer: prevalencia ~0.37, ROC y PR se parecen más")
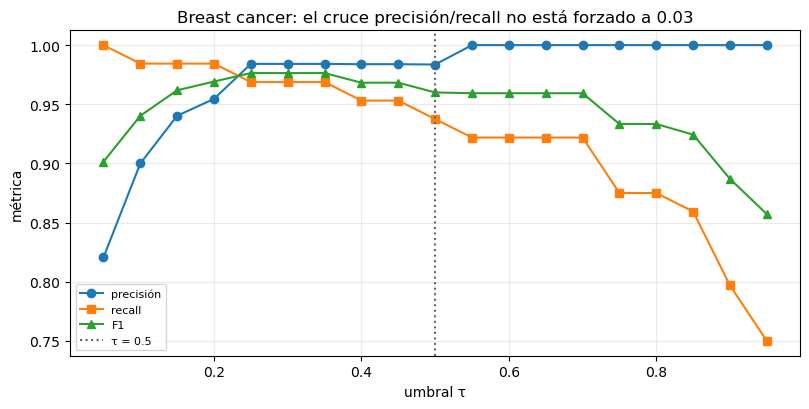
_ = graficar_umbral(yb_te, ys_bc, "Breast cancer: el cruce precisión/recall no está forzado a 0.03")
clases (orden sklearn): [np.str_('malignant'), np.str_('benign')]   conteos [0, 1] = [212 357]
En load_breast_cancer: 0 = malignant, 1 = benign.
Para el oficio clínico la clase positiva debe ser el maligno. Se invierte y.
P(maligno) = 0.373   n = 569   p = 30

           modelo  prevalencia  exactitud  precisión  recall   F1   AUC    AP
dummy mayoritaria        0.374      0.626      0.000   0.000 0.00 0.500 0.374
  logística τ=0.5        0.374      0.971      0.984   0.938 0.96 0.998 0.996

Conteos: {'VN': 106, 'FP': 1, 'FN': 4, 'VP': 60}
              precision    recall  f1-score   support

     benigno      0.964     0.991     0.977       107
     maligno      0.984     0.938     0.960        64

    accuracy                          0.971       171
   macro avg      0.974     0.964     0.968       171
weighted avg      0.971     0.971     0.971       171

Cómo leer Breast cancer frente al fraude.

  1. Prevalencia ~0.37. El dummy mayoritario ya no vive en 0.95. La exactitud vuelve a ser informativa como complemento, no como única cifra.
  2. FN es un maligno no alertado. En cribado se suele bajar \(\tau\) para subir recall, a costa de FP (biopsias de más). El veredicto no es el \(F_1\) máximo.
  3. ROC y PR se acercan porque \(\pi\) no es extrema. Aun así se publican las dos.
  4. \(n_{\mathrm{test}}\approx 170\). Un recall de 0.95 son conteos chicos: un FN más mueve la cifra. No vender milímetros.

Preguntas de análisis.

  • ¿El AUC alto autoriza a omitir la matriz? (No.)
  • Si el hospital acepta como mucho 2 FN en este test, ¿qué \(\tau\) de la parrilla lo cumple y a cuántos FP?
  • ¿Elegirías \(\tau\) en esta prueba para el informe final?

Caso aplicado: reportar un clasificador

Plantilla:

  1. Uso y clase positiva. Qué se alerta y qué cuesta FN vs FP.
  2. Prevalencia en el conjunto citado.
  3. Protocolo. Train/test, \(\tau\), si el umbral se eligió fuera de la prueba.
  4. Matriz y las cuatro frases (VP, FN, FP, VN).
  5. Métricas. Exactitud junto al baseline mayoritario; precisión, recall, \(F_1\); AUC y AP.
  6. Decisión. Aceptar para un uso, rechazar para otro. Límite.

Los seis pasos, aplicados al fraude (etapas 1–8)

  1. Uso. Alerta de transacción anómala. FN = fraude no visto; FP = revisión o bloqueo injusto. Dos usos posibles (bloqueo vs cola).
  2. Prevalencia. \(\pi\approx 0.046\) en prueba (print etapa 1).
  3. Protocolo. Logística estandarizada, test 30% estratificado, \(\tau=0.5\) por defecto (no es el de operación).
  4. Matriz. Conteos de la etapa 3–4: traducir a “\(a\) fraudes pescados, \(b\) escapados, \(c\) falsas alertas”.
  5. Métricas. Exactitud \(\approx 0.954\) igualable por el dummy; por eso se citan precisión, recall, \(F_1\), AUC y AP (AP contra \(\pi\), no contra 0.5).
  6. Decisión. A \(\tau=0.5\) la precisión es \(1.0\) (0 FP: la lista no está sucia) y el recall es \(0.218\) (43 FN). Se pueden bloquear esas 12 alertas sin molestar inocentes; el sistema no cubre el fraude. Sirve como priorizador de un puñado de casos, no como único control. El dummy se rechaza pese a su exactitud.

En un test con prevalencia 4.6%, la logística a \(\tau=0.5\) supera al dummy en recall y \(F_1\); la exactitud se cita solo contra el baseline mayoritario, no como veredicto. El AUC describe el ranking; la curva PR describe el compromiso cobertura–suciedad si se baja \(\tau\). A \(0.5\) no hay suciedad: hay agujeros. Se recomienda revisar las pocas alertas y no tratar el modelo como único control: la mayoría del fraude no dispara. Limitación: datos sintéticos, un split, umbral no calibrado a un costo en dinero.

Breast cancer (etapa 10) se llena igual, con otra conclusión típica: prevalencia alta, FN clínico caro, exactitud ya no es farsa, y el debate pasa al umbral de cribado, no a “¿hay señal?”.

Errores que conviene nombrar

  1. Citar solo exactitud con clase rara o costos asimétricos.
  2. Olvidar la prevalencia al publicar precisión.
  3. Tratar \(\tau=0.5\) como parte del modelo y no como una decisión.
  4. Elegir \(\tau\) en la prueba y vender esas métricas.
  5. AUC alto = modelo desplegable. El AUC no es la cola de alertas.
  6. \(F_1\) como función de costo. No conoce FN vs FP en dinero.
  7. Invertir el positivo (benigno como \(1\)) y reportar un recall clínico al revés.
  8. Comparar precisión entre conjuntos con \(\pi\) distinta como si fuera calidad del modelo.

Idea clave

La métrica es una pregunta, no una medalla. Exactitud pregunta “¿cuántas filas?”. Precisión pregunta “¿la alerta es limpia?”. Recall pregunta “¿se escapó el caso que importaba?”. El clasificador aceptable es el que responde la pregunta del uso, no el que gana el porcentaje más redondo.

Síntesis

Se partió de un dummy con exactitud 95.4% y recall 0. La logística usó \(x\) y se leyó la matriz en frases. El mismo corte sirvió para un uso y no para el otro. Mover \(\tau\) dibujó el compromiso. ROC y PR no contaron la misma historia bajo rareza. Los pesos y la prevalencia movieron la precisión sin “mejorar el fenómeno”. Breast cancer mostró el aparato cuando \(\pi\) ya no es extrema. El objeto que queda es un veredicto con matriz, \(\pi\), \(\tau\) y uso, no un accuracy.

6. Guía rápida: ¿qué métrica usar?

Situación Qué usar Por qué
Clases y costos simétricos Exactitud + matriz El 97% ya no es trampa
“¿La alerta es confiable?” Precisión \(P(y=1\mid \hat y=1)\)
“¿Se nos escapa el positivo?” Recall \(P(\hat y=1\mid y=1)\)
Ranking de modelos, sin costos \(F_1\) Castiga el extremo 0
¿Separan los scores? AUC-ROC Independiente de \(\tau\)
Clase rara, calidad de la cola Curva PR / AP El eje es la precisión
Elegir corte Barrido de \(\tau\) + costo \(0.5\) no es ley
¿Hay señal alguna? Dummy mayoritario Piso de exactitud y de PR

Regla de comunicación: clase positiva, \(\pi\), \(\tau\), matriz, precisión, recall, y el uso para el que se acepta.

7. Guía práctica para reportar un clasificador

Paso 1: uso, positivo, costos

Qué se alerta; qué vale un FN frente a un FP.

Paso 2: \(\pi\), \(n\), \(\tau\)

Prevalencia del conjunto citado, tamaño, umbral.

Paso 3: matriz y métricas

Cuatro conteos; exactitud vs dummy; precisión, recall, \(F_1\); AUC y AP.

Paso 4: redactar

“Para [uso], positivo = [...], \(\pi=\)[...] en TEST (\(n=\)[...]). Modelo [...], \(\tau=\)[...]. Matriz: VP=[...], FN=[...], FP=[...], VN=[...]. Exactitud=[...] (dummy=[...]). Precisión=[...], recall=[...], \(F_1=\)[...]. AUC=[...], AP=[...]. Veredicto: [aceptar para… / rechazar para…]. Limitación: [split / τ elegido en test / π distinta en producción].”

El fraude (etapas 1–8) y Breast cancer (etapa 10) ya llenaron esta plantilla.

8. Puente hacia las siguientes sesiones

Las métricas de esta sesión son la pérdida \(L\) de un problema de clase. La validación (particiones, pliegues, no elegir \(\tau\) en la prueba) es el protocolo que las hace honestas: un \(F_1\) de entrenamiento no vale más que un RMSE de entrenamiento. El proyecto integrador pedirá las dos cosas a la vez: un modelo y un párrafo que se atreva a rechazarlo para un uso aunque el accuracy luzca.

9. Cierre

Este notebook deja el criterio para no aplaudir un porcentaje:

  • clasificación como score + umbral,
  • matriz de confusión en palabras,
  • exactitud y su baseline mayoritario,
  • precisión, recall, \(F_1\),
  • ROC/AUC y la curva PR bajo rareza,
  • tres desbalances (clase, costo, prevalencia),
  • dos casos (fraude sintético, Breast cancer) con veredicto por uso.

Resultado esperado: el estudiante mira una matriz y un 95%, pregunta \(\pi\) y \(\tau\), y decide si el clasificador sirve para bloquear, para revisar o para ninguna de las dos.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.