Estadística para IA — 13. Validación y desempeño del modelo
estadistica
validacion-cruzada
overfitting
Sobreajuste, subajuste, sesgo-varianza, train/test, validación cruzada, bootstrap y un protocolo para decidir si un modelo es aceptable.
Author
Wilder Ramírez Delgado
Published
September 25, 2026
Sesión 13 — Validación y Desempeño del Modelo
Open in Colab
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Un número de entrenamiento no es un modelo
Ajustar es fácil. Decidir si el ajuste sirve es el oficio. Un RMSE de 0.04 en las mismas filas que entrenaron el modelo no afirma nada sobre el siguiente lote de usuarios. Puede ser memoria. Puede ser un modelo demasiado rígido. Puede ser un split afortunado. Puede ser que se usó el conjunto de prueba para elegir el grado y ya no es prueba.
Este notebook construye el aparato para medir fuera de la muestra y, sobre todo, para leer lo que sale: sobreajuste, subajuste, sesgo y varianza, train/test, validación cruzada y bootstrap. El contraste que importa es operativo: el modelo que “gana” en entrenamiento es a menudo el que pierde en producción. El producto de la sesión no es una librería; es un veredicto con evidencia.
Contexto: una curva diseñada (seno + tendencia) donde se ve el sobreajuste, y el conjunto Diabetes de scikit-learn para aplicar el protocolo a un \(y\) real.
Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 4 · Sesión 13
Objetivos
Distinguir error de entrenamiento, error de prueba y error de generalización.
Reconocer sobreajuste y subajuste en números y en la gráfica.
Explicar el compromiso sesgo–varianza sin convertirlo en una etiqueta vacía.
Partir en entrenamiento / prueba y no reutilizar la prueba para elegir el modelo.
Implementar validación cruzada (\(k\) bloques) a mano y con scikit-learn, y leer la dispersión entre pliegues, no solo la media.
Usar bootstrap para un intervalo de la métrica, no para “inventar más datos”.
Aplicar un protocolo de veredicto: ¿mejor que el baseline? ¿hueco train–test? ¿error en unidades del problema? ¿estable? ¿hubo fuga?
Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.
1. Qué se está midiendo cuando se dice “el modelo es bueno”
1.1 Tres errores que no son el mismo
Sea \(L\) una pérdida (aquí, casi siempre el error cuadrático). Hay tres promedios distintos:
Nombre
Sobre qué filas
Qué afirma
Error de entrenamiento
Las que usó el ajuste
Cómo de bien memorizó o resumió esta muestra
Error de prueba
Filas no usadas para ajustar ni para elegir complejidad
Estimación honesta de \(L\) en datos de la misma población
Error de generalización
La población (no se observa)
El número que en verdad importa; se estima, no se ve
El error de entrenamiento es un estadístico de las mismas observaciones que definieron \(\hat\theta\). Está sesgado hacia abajo. Tratarlo como desempeño es el error profesional más frecuente del curso.
1.2 Sobreajuste y subajuste
Sobreajuste (overfitting): el modelo es tan flexible que captura ruido de la muestra. El error de entrenamiento baja; el de prueba sube. La curva “pasa por los puntos” y oscila entre ellos.
Subajuste (underfitting): el modelo es demasiado rígido (una recta sobre un seno). Entrenamiento y prueba quedan altos y parecidos. No hay milagro de más datos que convierta una recta en un seno, salvo que se cambie la clase de modelo.
Diagnóstico
Train
Test
Hueco train–test
Lectura
Subajuste
Alto
Alto
Chico
El modelo no puede representar \(f\)
Ajuste razonable
Bajo o medio
Cercano al train
Chico
Candidato a veredicto
Sobreajuste
Muy bajo
Alto
Grande
Memoria, no regularidad
Split ruidoso
Cualquiera
Cualquiera
Inestable entre semillas
\(n\) de prueba chico; no decidir aún
“Alto” y “bajo” no son absolutos: se miden contra un baseline (predecir la media de \(y\)) y contra las unidades del problema (¿6 ms de RMSE es grave en latencia de 120 ms?).
1.3 Sesgo y varianza
Se imagina el experimento repetido: muchas muestras del mismo tamaño, cada una produce un \(\hat f\).
Sesgo:\(E[\hat f(x)]-f(x)\). El modelo simple se equivoca siempre en la misma dirección. Es subajuste sistemático.
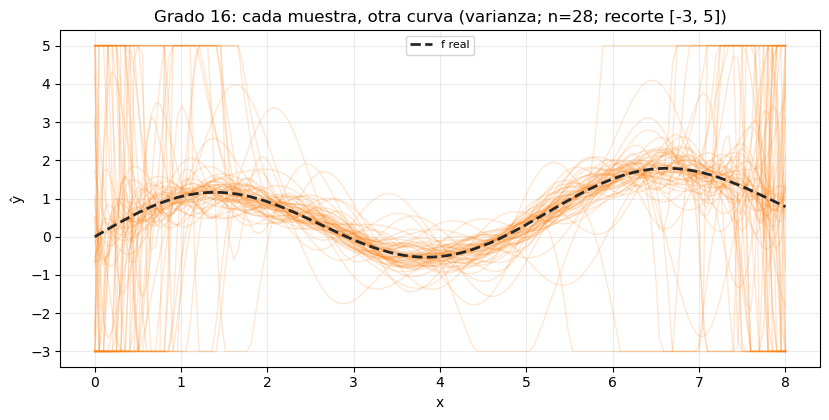
Varianza: cuánto cambia\(\hat f\) cuando cambia la muestra. El polinomio de grado 18 dibuja un abanico: cada muestra, otra montaña rusa.
El error de generalización esperado se descompone (para pérdida \(L_2\), en lo esencial) en
Bajar el sesgo (más flexibilidad) sube la varianza. No se “elimina” el compromiso: se elige un punto. La validación es el instrumento para verlo con números, no con fe.
El \(\sigma^2\) no se vence con un modelo más grande. Si el laboratorio inyectó ruido de desviación 0.25, un RMSE de prueba de 0.05 es, casi seguro, sobreajuste o una prueba demasiado chica.
1.4 Train / test
Se reserva una fracción (típicamente 20–30%) que no entra al ajuste. El resto entrena. La métrica de prueba es la primera cifra honesta.
Condiciones para que siga siendo honesta:
Las filas de prueba no se usaron para elegir el grado, el umbral ni las features.
Prueba y entrenamiento son la misma población (no un mes distinto sin decirlo).
\(n\) de prueba no es ridículo: un RMSE con 12 filas tiembla.
Si se prueba un grado 1, luego 2, …, luego 20 y se elige el que ganó en test, esa cifra de test ya es un error de entrenamiento disfrazado. Eso se llama fuga de información (el investigador filtró la prueba hacia la decisión).
1.5 Validación cruzada
Con \(n\) chico, un solo corte desperdicia datos y produce un test nervioso. La validación cruzada en \(k\) pliegues (\(k\)-fold):
Parte en \(k\) bloques (p. ej. \(k=5\) o \(10\)).
Entrena en \(k-1\), evalúa en el que queda.
Rota, \(k\) veces.
Reporta media y desviación de las \(k\) métricas.
La desviación entre pliegues es parte del resultado. Una media de RMSE \(=8.1\) con pliegues \(\{4,\,7,\,8,\,18,\,6\}\) no es “8.1”: es “no sabemos aún; un bloque se fue a 18”.
Elegir hiperparámetros (el grado del polinomio) se hace con CV en el conjunto de entrenamiento. El test final se toca una vez, al final.
1.6 Bootstrap
El bootstrap remuestrea con reemplazo la muestra (o las filas de prueba) muchas veces y recalcula el estadístico. Produce una distribución empírica del RMSE (o de \(R^2\)): un histograma y un intervalo, p. ej. los percentiles 2.5 y 97.5.
No crea observaciones nuevas del fenómeno. No sustituye un test no visto. Estima qué tan precisa es la métrica dada esta muestra. Un modelo con RMSE 7.0 y bootstrap \((6.6,\,7.5)\) es un número estable; otro con 7.0 y \((3.1,\,14.8)\) no autoriza un despliegue.
1.7 Protocolo: ¿el modelo es aceptable?
Seis preguntas, en este orden. Si alguna falla, el veredicto no es “sí” aunque el \(R^2\) de train sea 0.99.
¿Respecto a qué? ¿Gana al baseline (media de \(y\), modelo actual en producción, regla de negocio)?
¿En qué conjunto? El número que se cita es de prueba o de CV, no de entrenamiento.
¿El hueco train–test es razonable? Un train 0.99 y un test 0.40 es sobreajuste, no un “buen modelo con mala suerte”.
¿El error en unidades del problema es tolerable? RMSE 12 ms en latencia de 80 ms no es el mismo juicio que RMSE 12 en una escala de 0 a 10 000.
¿Es estable? Dispersión de pliegues, intervalo bootstrap, otro random_state.
¿Hubo fuga? ¿Se eligió el modelo mirando la prueba?
Pregunta
Herramienta
¿Memorizó la muestra?
Train vs test / residuos del test
¿Es demasiado rígido?
Train y test altos; gráfico del ajuste
¿El split miente?
Varios splits o \(k\)-fold
¿Qué complejidad elegir?
CV dentro del train
¿Cuánto tiembla la métrica?
Bootstrap o \(\sigma\) de pliegues
¿Se despliega?
Las seis preguntas, no un \(p\) ni un \(R^2\)
2. Por qué importa en IA y Machine Learning
Entrenar hasta \(R^2=1\) en el notebook es un botón. El costo está en creerse ese botón.
Un ranking de modelos hecho sobre el conjunto de prueba elige al que más se adaptó a esas filas. En la siguiente semana deja de ganar.
Las redes y los polinomios de grado alto son máquinas de varianza: sin validación, el sobreajuste es el estado por defecto.
En producto, “el modelo es bueno” es una decisión de riesgo: falso despliegue (tipo I de negocio) frente a matar un modelo útil por un split miserable (tipo II).
El baseline obliga a la humildad: si el lineal no gana a predecir la media, no hay feature que esté trabajando.
Idea central: validar no es imprimir score. Es argumentar, con conjuntos distintos y con incertidumbre, que el error será aceptable la próxima vez.
3. Flujo recomendado — de los números al veredicto
Fijar la pérdida y el baseline. RMSE (o la métrica del negocio) y el predictor ingenuo.
Reservar una prueba y no tocarla. El resto es entrenamiento.
Ajustar candidatos solo en entrenamiento. Complejidad distinta (grados, regularización).
Elegir con CV (media y dispersión de pliegues).
Medir una vez en prueba. Ese es el número que se cita.
Cuantificar temblor (bootstrap o \(\sigma\) de CV) y traducir a unidades.
Veredicto con las seis preguntas. Escribir límites (población, rango de \(x\), \(n\)).
Criterio general: un modelo sin baseline, sin conjunto no visto y sin intervalo de la métrica no se puede aceptar. Solo se puede creer.
Primero una curva con \(f\) conocida: se ve el sobreajuste. Cada tabla se lee con el protocolo. Al final, Diabetes: \(f\) ya no se conoce y hay que decidir.
El predictor más corto: ignorar \(x\) y devolver \(\bar y\) del entrenamiento (DummyRegressor). Todo modelo que se tome en serio debe ganar a este número en prueba. Si no gana, las features no están trabajando o el split es un accidente.
x, y, f = generar_curva(70, seed=42)x_tr, x_te, y_tr, y_te = train_test_split(x, y, test_size=0.35, random_state=42)dummy = DummyRegressor(strategy="mean")dummy.fit(x_tr.reshape(-1, 1), y_tr)base_tr = ficha(y_tr, dummy.predict(x_tr.reshape(-1, 1)), "baseline (media) / train")base_te = ficha(y_te, dummy.predict(x_te.reshape(-1, 1)), "baseline (media) / test")print(pd.DataFrame([base_tr, base_te]).round(3).to_string(index=False))print()print("σ del laboratorio = 0.28. El baseline no usa x: su RMSE de prueba es, más o menos, la DE de y.")print("DE de y (toda la muestra) =", round(y.std(ddof=1), 3))
                  modelo  RMSE   MSE   R2
baseline (media) / train 0.838 0.703  0.0
 baseline (media) / test 0.804 0.647 -0.0

σ del laboratorio = 0.28. El baseline no usa x: su RMSE de prueba es, más o menos, la DE de y.
DE de y (toda la muestra) = 0.832
Cómo leer esta tabla. El \(R^2\) del baseline en entrenamiento es \(0\) por construcción (predecir la media). En prueba puede ser negativo: significa peor que predecir la media de la prueba. Eso no es un bug; es la métrica diciendo “esta regla no generaliza ni el centro”.
Qué no se concluye. Todavía no hay modelo. Hay un piso de referencia. A partir de aquí, “bueno” quiere decir mejor que esta fila, en prueba, por un margen que importe.
Veredicto parcial. El baseline está listo. Quien reporte un modelo sin esta fila no puede afirmar mejora.
Etapa 2: El espejismo del error de entrenamiento
Se ajustan tres polinomios solo en entrenamiento: grado 1 (rígido), grado 4 (flexible y razonable para un seno suave), grado 16 (muy flexible). Se imprime únicamente el RMSE de entrenamiento. Es el número que tienta a desplegar.
grados = [1, 4, 16]modelos = {}solo_train = []for g in grados: m = pipe_poli(g) m.fit(x_tr.reshape(-1, 1), y_tr) modelos[f"grado {g}"] = m solo_train.append(ficha(y_tr, m.predict(x_tr.reshape(-1, 1)), f"grado {g}"))print(pd.DataFrame(solo_train).round(3).to_string(index=False))print()print("Si el criterio fuera 'el train más bajo gana', el ganador es el grado 16.")
  modelo  RMSE   MSE    R2
 grado 1 0.742 0.550 0.217
 grado 4 0.289 0.084 0.881
grado 16 0.159 0.025 0.964

Si el criterio fuera 'el train más bajo gana', el ganador es el grado 16.
Cómo leer esta tabla. El grado 16 tiene que ganar en train: tiene coeficientes de sobra para pasar cerca de cada punto. El grado 1 tiene que perder: una recta no es un seno.
Qué no se concluye. Que el 16 sea el mejor modelo. Todavía no se miró ninguna fila no usada. Esta tabla, sola, es publicidad.
Pregunta de análisis. Si solo leyeras la columna RMSE de train, ¿qué modelo elegirías? Anótalo. La etapa 3 existe para contradecirte.
Etapa 3: El primer número honesto — la prueba
Las mismas tres rectas/curvas, evaluadas en el 35% que no entrenó.
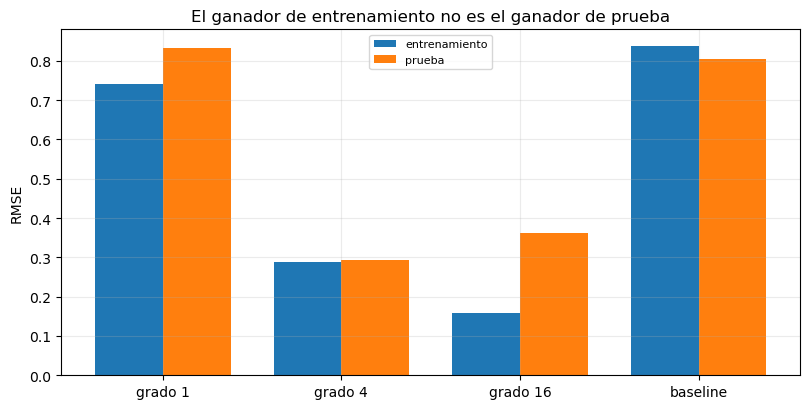
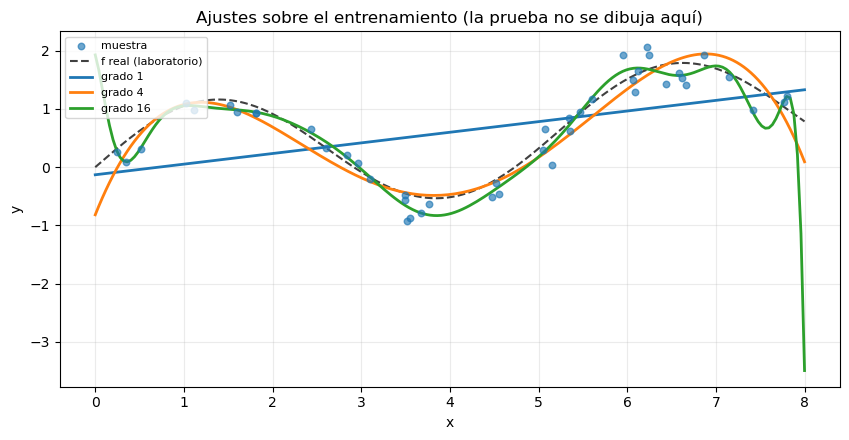
filas_tt = []for g in grados: m = modelos[f"grado {g}"] filas_tt.append( {"modelo": f"grado {g}","RMSE_train": rmse(y_tr, m.predict(x_tr.reshape(-1, 1))),"RMSE_test": rmse(y_te, m.predict(x_te.reshape(-1, 1))),"R2_train": r2_score(y_tr, m.predict(x_tr.reshape(-1, 1))),"R2_test": r2_score(y_te, m.predict(x_te.reshape(-1, 1))),"hueco": rmse(y_te, m.predict(x_te.reshape(-1, 1))) - rmse(y_tr, m.predict(x_tr.reshape(-1, 1))), } )filas_tt.append( {"modelo": "baseline","RMSE_train": base_tr["RMSE"],"RMSE_test": base_te["RMSE"],"R2_train": base_tr["R2"],"R2_test": base_te["R2"],"hueco": base_te["RMSE"] - base_tr["RMSE"], })tab_tt = pd.DataFrame(filas_tt)print(tab_tt.round(3).to_string(index=False))graficar_barras_train_test(filas_tt, "El ganador de entrenamiento no es el ganador de prueba")graficar_ajustes(x_tr, y_tr, f, modelos, "Ajustes sobre el entrenamiento (la prueba no se dibuja aquí)")
Cómo leer esta tabla. Tres columnas deciden, no una:
RMSE_test vs baseline. Si no gana, se descarta.
Hueco train–test. Grande y test peor \(\Rightarrow\) sobreajuste. Ambos altos y hueco chico \(\Rightarrow\) subajuste.
Proximidad a \(\sigma=0.28\). Un test mucho menor que el ruido del laboratorio es sospechoso (poca prueba, o se evaluó mal).
Qué no se concluye aún. Que el grado 4 sea “el” modelo de la población: es un split. La etapa 6 muestra que ese RMSE_test se mueve al cambiar la semilla.
Veredicto parcial. El grado 16 se rechaza por el hueco train–test (aquí RMSE 0.16 frente a 0.36) aunque el \(R^2\) de prueba aún se vea alto: memorizó el train. El grado 1 gana al baseline por poco o queda corto: subajuste. El grado 4 es el candidato. Todavía no se despliega: falta estabilidad.
Etapa 4: Ver el diagnóstico, no solo la tabla
El gráfico de la etapa 3 ya muestra las tres curvas sobre el train. Aquí se fuerza la lectura geométrica: dónde falla cada uno. Un veredicto que no puede señalar el gráfico es un veredicto de catálogo.
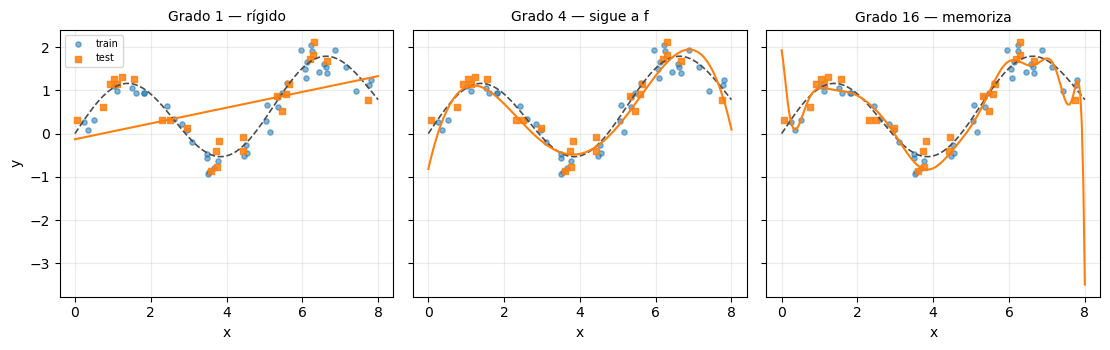
xs = np.linspace(0, 8, 200)fig, axes = plt.subplots(1, 3, figsize=(11.2, 3.6), sharey=True)for ax, g, tit inzip( axes, [1, 4, 16], ["Grado 1 — rígido", "Grado 4 — sigue a f", "Grado 16 — memoriza"],): ax.scatter(x_tr, y_tr, s=14, alpha=0.55, label="train") ax.scatter(x_te, y_te, s=18, alpha=0.85, marker="s", label="test") ax.plot(xs, np.sin(1.2* xs) +0.12* xs, color="0.3", linestyle="--", linewidth=1.2) ax.plot(xs, modelos[f"grado {g}"].predict(xs.reshape(-1, 1)), color="C1") ax.set_title(tit, fontsize=10) ax.set_xlabel("x")axes[0].set_ylabel("y")axes[0].legend(fontsize=7, loc="upper left")plt.tight_layout()plt.show()print("Puntos cuadrados = prueba. Si la curva los deja fuera y persigue a los redondos, hay sobreajuste.")
Puntos cuadrados = prueba. Si la curva los deja fuera y persigue a los redondos, hay sobreajuste.
Cómo leer las tres viñetas.
Izquierda: la recta corta el seno. Train y test se equivocan en las mismas zonas (crestas y valles). Sesgo.
Centro: la curva sigue a \(f\) sin perseguir cada residuo. Los cuadrados (test) no quedan sistemáticamente fuera.
Derecha: interpola el train y oscila. Los cuadrados caen donde la oscilación inventó un valle que \(f\) no tiene. Varianza.
Pregunta de análisis. Si te dieran solo el panel derecho y el \(R^2\) de train, ¿firmarías el modelo? ¿Qué evidencia te falta?
Etapa 5: Sesgo y varianza se ven al repetir la muestra
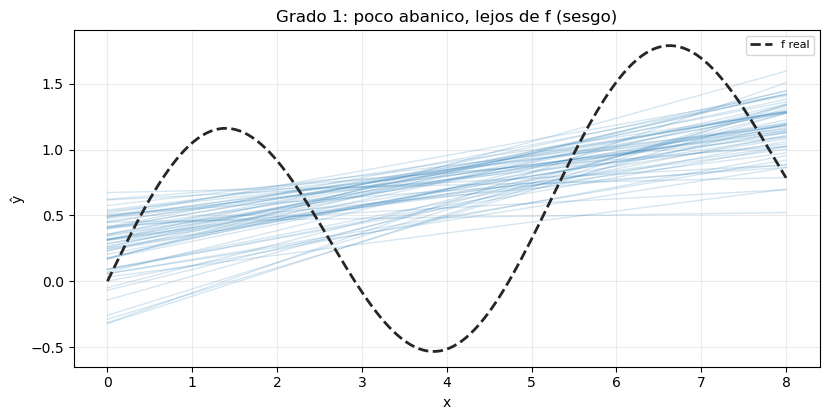
Se generan \(60\) muestras de \(n=28\) (chico a propósito). En cada una se ajusta grado 1 y grado 16 (el mismo flexible de las etapas 2–4). Se dibujan las \(60\) curvas. Las predicciones del 16 se recortan a \([-3,5]\): con \(n\) chico el polinomio se dispara; el recorte evita un eje en millones y deja ver el abanico. El laboratorio conoce \(f\).
xs = np.linspace(0, 8, 160)f_xs = np.sin(1.2* xs) +0.12* xscurvas_1, curvas_hi = [], []for i inrange(60): xi, yi, _ = generar_curva(28, seed=100+ i) m1 = pipe_poli(1).fit(xi.reshape(-1, 1), yi) m_hi = pipe_poli(16).fit(xi.reshape(-1, 1), yi) curvas_1.append(m1.predict(xs.reshape(-1, 1))) curvas_hi.append(np.clip(m_hi.predict(xs.reshape(-1, 1)), -3, 5))graficar_abanico(xs, curvas_1, f_xs, "Grado 1: poco abanico, lejos de f (sesgo)", color="C0")graficar_abanico(xs, curvas_hi, f_xs, "Grado 16: cada muestra, otra curva (varianza; n=28; recorte [-3, 5])", color="C1")sesgo2_1 = np.mean((np.mean(curvas_1, axis=0) - f_xs) **2)var_1 = np.mean(np.var(curvas_1, axis=0))sesgo2_hi = np.mean((np.mean(curvas_hi, axis=0) - f_xs) **2)var_hi = np.mean(np.var(curvas_hi, axis=0))print("Grado 1: sesgo² medio =", round(sesgo2_1, 3), " varianza media =", round(var_1, 3))print("Grado 16: sesgo² medio =", round(sesgo2_hi, 3), " varianza media =", round(var_hi, 3))print("El 16 se pega más a f en promedio (sesgo baja) y se desordena entre muestras (varianza sube).")
Grado 1:    sesgo² medio = 0.447   varianza media = 0.029
Grado 16:   sesgo² medio = 0.024   varianza media = 2.01
El 16 se pega más a f en promedio (sesgo baja) y se desordena entre muestras (varianza sube).
Cómo leer los abanicos. El de la izquierda es una cinta estrecha que no cubre las crestas de \(f\): se equivoca siempre igual. El de la derecha cubre \(f\)a veces y se dispara en los extremos: cada muestra manda. Eso es el compromiso.
Qué no se concluye. Que “hay que quedarse en el medio” por estética. El punto se elige con CV (etapa 8), no con el dibujo solo. El dibujo enseña por qué el CV va a preferir un grado moderado cuando \(n\) es chico.
Veredicto parcial. Flexibilidad no es calidad. Calidad es sesgo y varianza conjuntos más \(\sigma^2\).
Etapa 6: Un solo train/test tiembla
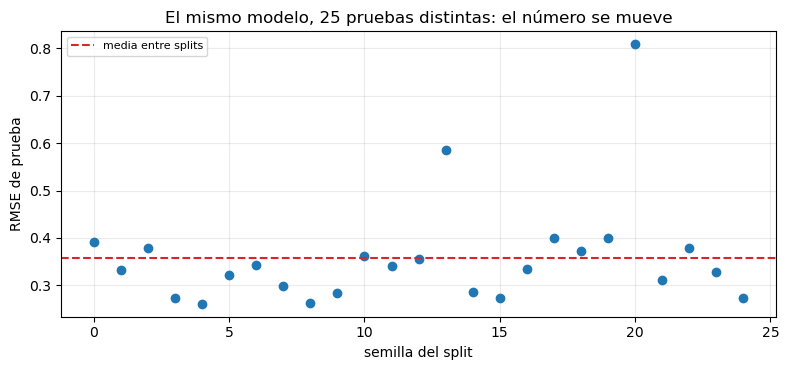
El RMSE de prueba del grado 4, con 25 cortes distintos (misma \(n\), otras filas). Si el veredicto cambia de un corte a otro, untrain_test_split no basta.
rmses_split = []for seed inrange(25): xa, xb, ya, yb = train_test_split(x, y, test_size=0.35, random_state=seed) m = pipe_poli(4).fit(xa.reshape(-1, 1), ya) rmses_split.append(rmse(yb, m.predict(xb.reshape(-1, 1))))rmses_split = np.array(rmses_split)print("RMSE test (grado 4) en 25 splits")print(" media =", round(rmses_split.mean(), 3), " DE =", round(rmses_split.std(ddof=1), 3))print(" min =", round(rmses_split.min(), 3), " max =", round(rmses_split.max(), 3))print(" rango =", round(rmses_split.max() - rmses_split.min(), 3))fig, ax = plt.subplots(figsize=(8.0, 3.8))ax.plot(rmses_split, marker="o", linestyle="none")ax.axhline(rmses_split.mean(), color="C3", linestyle="--", label="media entre splits")ax.set_xlabel("semilla del split")ax.set_ylabel("RMSE de prueba")ax.set_title("El mismo modelo, 25 pruebas distintas: el número se mueve")ax.legend(fontsize=8)plt.tight_layout()plt.show()
RMSE test (grado 4) en 25 splits
  media = 0.358   DE = 0.116
  min  = 0.261   max = 0.809
  rango = 0.548
Cómo leer el gráfico. Cada punto es un “RMSE de test” publicable si uno se queda con una semilla. La vertical entre el mínimo y el máximo es incertidumbre del protocolo, no del fenómeno. Con \(n\) de prueba ~25, esa banda es ancha.
Qué no se concluye. Que train/test “no sirve”. Sirve como una medición. No sirve como la medición si de ella depende un despliegue.
Veredicto parcial. Hace falta agregar pliegues (CV) o declarar un intervalo. El punto suelto de la etapa 3 queda degradado a “orden de magnitud”.
Etapa 7: Validación cruzada a mano y con scikit-learn
\(k=5\). En cada pliegue se entrena en 4/5 y se mide RMSE en 1/5. Se implementa el bucle; después se contrasta con cross_val_score. Las dos vías deben coincidir (misma partición).
def rmse_kfold(grado, X, y, k=5, seed=0): kf = KFold(n_splits=k, shuffle=True, random_state=seed) puntos = []for tr, te in kf.split(X): m = pipe_poli(grado).fit(X[tr], y[tr]) puntos.append(rmse(y[te], m.predict(X[te])))return np.array(puntos)X_all = x.reshape(-1, 1)manual = {g: rmse_kfold(g, X_all, y, k=5, seed=0) for g in grados}kf = KFold(n_splits=5, shuffle=True, random_state=0)sk = {}for g in grados: scores =-cross_val_score( pipe_poli(g), X_all, y, cv=kf, scoring="neg_root_mean_squared_error" ) sk[g] = scoresfilas_cv = []for g in grados: filas_cv.append( {"grado": g,"RMSE_pliegues (mano)": np.round(manual[g], 3),"media_mano": manual[g].mean(),"DE_mano": manual[g].std(ddof=1),"media_sklearn": sk[g].mean(),"¿coinciden?": np.allclose(manual[g], sk[g]), } )print(pd.DataFrame(filas_cv).to_string(index=False))print()print("Pliegues grado 4:", np.round(manual[4], 3))print("Pliegues grado 16:", np.round(manual[16], 3))
Cómo leer los pliegues. La media ordena candidatos. La DE (y el peor pliegue) dice si esa media es una cifra o un promedio de accidentes. La media del 16 puede quedar parecida o incluso mejor que la del 4 (el print manda). Eso no autoriza al 16: la DE es mayor y un pliegue se dispara. Se rechaza por inestabilidad, no porque la media pierda.
Qué no se concluye. Que \(k=5\) sea sagrado. \(k=10\) usa más train en cada ronda y produce pliegues más chicos (más ruidosos). \(k=n\) (leave-one-out) es otro extremo. Aquí \(k=5\) es el compromiso de trabajo.
Veredicto parcial. Reportar solo cross_val_score(...).mean() es recortar la evidencia. La lista de pliegues entra al párrafo.
Etapa 8: Elegir la complejidad dentro del entrenamiento
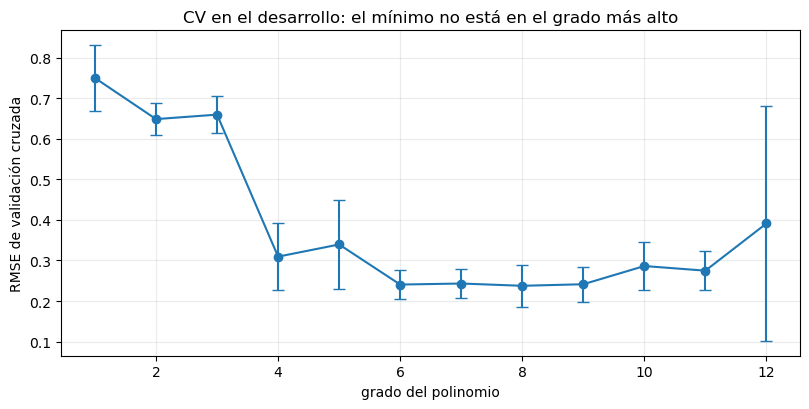
Se reserva un test final (30%) y no se toca. Sobre el 70% restante se recorre el grado \(1,\ldots,12\) con CV \(k=5\). Se elige el grado de menor RMSE-CV. Después se mide una vez en el test final.
x_dev, x_final, y_dev, y_final = train_test_split(x, y, test_size=0.30, random_state=7)grilla =list(range(1, 13))medias, desvs = [], []for g in grilla: sc = rmse_kfold(g, x_dev.reshape(-1, 1), y_dev, k=5, seed=1) medias.append(sc.mean()) desvs.append(sc.std(ddof=1))medias, desvs = np.array(medias), np.array(desvs)g_star = grilla[int(np.argmin(medias))]print("Grado elegido por CV (solo conjunto de desarrollo):", g_star)print(pd.DataFrame({"grado": grilla, "RMSE_CV": medias.round(3), "DE_pliegues": desvs.round(3)}).to_string(index=False))m_star = pipe_poli(g_star).fit(x_dev.reshape(-1, 1), y_dev)print()print("RMSE desarrollo (reajuste en todo el 70%) =", round(rmse(y_dev, m_star.predict(x_dev.reshape(-1, 1))), 3))print("RMSE TEST FINAL (una vez) =", round(rmse(y_final, m_star.predict(x_final.reshape(-1, 1))), 3))print("RMSE baseline en test final =", round(rmse(y_final, np.full_like(y_final, y_dev.mean())), 3))graficar_cv_grados(grilla, medias, desvs, "CV en el desarrollo: el mínimo no está en el grado más alto")
Grado elegido por CV (solo conjunto de desarrollo): 8
 grado  RMSE_CV  DE_pliegues
     1    0.750        0.081
     2    0.649        0.039
     3    0.660        0.045
     4    0.310        0.083
     5    0.340        0.110
     6    0.241        0.035
     7    0.243        0.035
     8    0.238        0.052
     9    0.241        0.043
    10    0.286        0.060
    11    0.275        0.048
    12    0.391        0.290

RMSE desarrollo (reajuste en todo el 70%) = 0.193
RMSE TEST FINAL (una vez)               = 0.245
RMSE baseline en test final             = 0.943
Cómo leer la curva en U (o en J). A la izquierda, sesgo: el grado 1 no llega a \(f\). A la derecha, varianza: el CV detecta que los pliegues se rompen. El mínimo es el compromiso estimado sin mirar el test final.
Qué no se concluye. Que ese grado sea el verdadero orden de \(f\). Es el grado que, con este\(n\) y este ruido, generaliza mejor según el protocolo. Si \(n\) crece, el mínimo puede correrse a la derecha (más flexibilidad se vuelve pagable).
Veredicto parcial. El número que se publica es el RMSE del test final, junto al grado y a la curva de CV. El RMSE del 70% reajustado no se publica como desempeño.
Etapa 9: Fuga — elegir el grado mirando la prueba
Se hace lo prohibido: se recorre el grado \(1,\ldots,12\) y se elige el de menor RMSE de test. Luego se evalúa en un tercer conjunto (simula “la semana siguiente”). El grado fugado parece mejor en test y suele empeorar fuera.
x_a, x_rest, y_a, y_rest = train_test_split(x, y, test_size=0.50, random_state=3)x_b, x_c, y_b, y_c = train_test_split(x_rest, y_rest, test_size=0.50, random_state=4)rmse_b = []for g in grilla: m = pipe_poli(g).fit(x_a.reshape(-1, 1), y_a) rmse_b.append(rmse(y_b, m.predict(x_b.reshape(-1, 1))))g_fuga = grilla[int(np.argmin(rmse_b))]g_cv_dev = g_stardef eval_grado(g, x_tr, y_tr, x_ev, y_ev): m = pipe_poli(g).fit(x_tr.reshape(-1, 1), y_tr)return rmse(y_ev, m.predict(x_ev.reshape(-1, 1)))print("Grado que 'gana' en el conjunto B (fuga):", g_fuga, " RMSE_B =", round(min(rmse_b), 3))print("Grado que ganó por CV en la etapa 8: ", g_cv_dev)print()print("RMSE en C (no visto), grado fugado: ", round(eval_grado(g_fuga, x_a, y_a, x_c, y_c), 3))print("RMSE en C (no visto), grado por CV: ", round(eval_grado(g_cv_dev, x_a, y_a, x_c, y_c), 3))print()print("El RMSE_B del fugado no se puede citar: ya se usó para elegir.")
Grado que 'gana' en el conjunto B (fuga): 6   RMSE_B = 0.221
Grado que ganó por CV en la etapa 8:      8

RMSE en C (no visto), grado fugado:      0.264
RMSE en C (no visto), grado por CV:      0.257

El RMSE_B del fugado no se puede citar: ya se usó para elegir.
Cómo leer el truco. El investigador que publica RMSE_B del grado fugado está publicando un mínimo de muchos intentos. El mínimo de muchos errores de prueba es un estadístico sesgado hacia abajo. El conjunto C —el que no participó en la elección— corrige el cuento.
Qué no se concluye. Que CV siempre gane a la fuga en una réplica. A veces, por azar, coinciden. El argumento es de protocolo: el número de B ya no es independiente de la decisión.
Veredicto parcial. Si el grado (o el umbral, o las features) se eligió con la prueba, no hay cifra de prueba. Hay que volver a reservar un conjunto o declarar el sesgo.
Etapa 10: Bootstrap — cuánto tiembla el RMSE de prueba
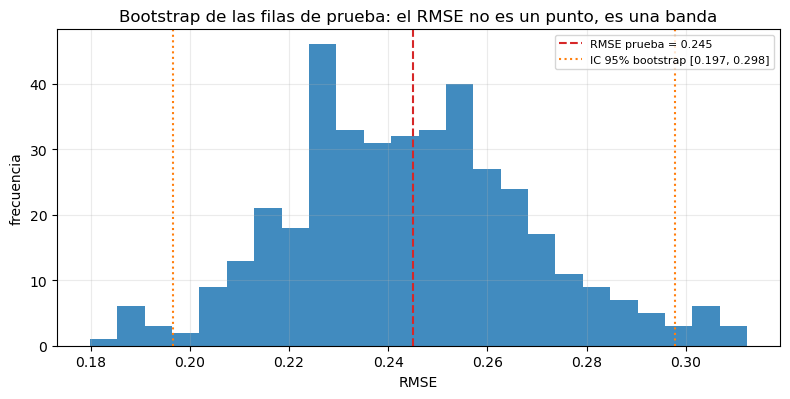
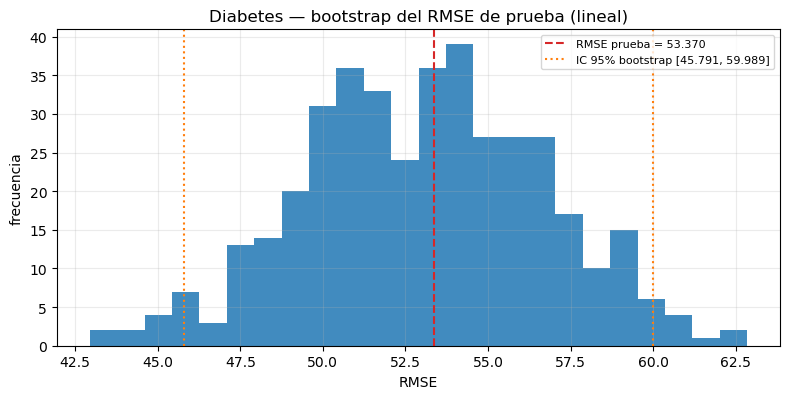
Modelo: el grado elegido por CV (etapa 8), ya ajustado en el desarrollo. Se remuestrean las filas de prueba con reemplazo, \(B=400\) veces, y se recalcula el RMSE. Intervalo: percentiles 2.5 y 97.5.
Eso responde: si la prueba hubiera sido otra muestra de este tamaño, de esta población, ¿en qué rango cae el RMSE?
yhat_final = m_star.predict(x_final.reshape(-1, 1))rmse_puntual = rmse(y_final, yhat_final)B =400boot = []for _ inrange(B): idx = rng.integers(0, len(y_final), size=len(y_final)) boot.append(rmse(y_final[idx], yhat_final[idx]))boot = np.array(boot)lo_b, hi_b = graficar_hist_bootstrap( boot, rmse_puntual,"Bootstrap de las filas de prueba: el RMSE no es un punto, es una banda",)print("RMSE puntual (test final) =", round(rmse_puntual, 3))print("IC 95% bootstrap = [", round(lo_b, 3), ",", round(hi_b, 3), "]")print("Anchura del IC =", round(hi_b - lo_b, 3))print("σ laboratorio = 0.28")print()print("Si el IC cubre al baseline, la 'victoria' todavía no está clara.")print("Baseline en ese test =", round(rmse(y_final, np.full_like(y_final, y_dev.mean())), 3))
RMSE puntual (test final) = 0.245
IC 95% bootstrap          = [ 0.197 , 0.298 ]
Anchura del IC            = 0.101
σ laboratorio             = 0.28

Si el IC cubre al baseline, la 'victoria' todavía no está clara.
Baseline en ese test     = 0.943
Cómo leer el histograma. El RMSE puntual es el centro de esta prueba. El IC es la honestidad: con \(n\) de prueba moderado la banda es ancha. Un despliegue que exige “RMSE \(<0.30\)” no se sostiene si el IC es \((0.22,\,0.41)\).
Qué no es el bootstrap. No es más dato de usuarios. No reemplaza un test de otro mes. No arregla un sesgo de fuga.
Veredicto parcial. Se cita: RMSE \(= a\) (IC bootstrap 95% \([b,\,c]\)), \(n_{\mathrm{test}}=m\). Sin la banda, \(a\) finge más precisión que la que hay.
Etapa 11: Curvas de aprendizaje — ¿falta modelo o faltan filas?
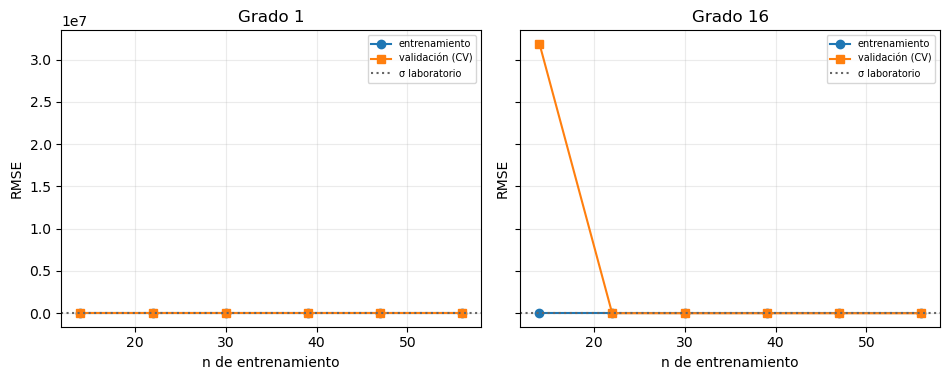
Se varía el tamaño del entrenamiento y se mira RMSE de train y de validación (CV). Tres lecturas:
Train bajo y validación alta, paralelas al crecer \(n\): sobreajuste que más datos pueden cerrar.
Ambas altas y ya juntas: subajuste; más filas no salvan la clase de modelo.
Las dos bajan y se acercan a \(\sigma\): régimen sano.
def curva_aprendizaje(grado, X, y, seed=0): sizes, tr_sc, va_sc = learning_curve( pipe_poli(grado), X, y, cv=KFold(5, shuffle=True, random_state=seed), train_sizes=np.linspace(0.25, 1.0, 6), scoring="neg_root_mean_squared_error", shuffle=True, random_state=seed, )return sizes, -tr_sc.mean(axis=1), -va_sc.mean(axis=1)fig, axes = plt.subplots(1, 2, figsize=(9.6, 3.9), sharey=True)for ax, g, tit in [(axes[0], 1, "Grado 1"), (axes[1], 16, "Grado 16")]: sizes, tr_m, va_m = curva_aprendizaje(g, X_all, y) ax.plot(sizes, tr_m, marker="o", label="entrenamiento") ax.plot(sizes, va_m, marker="s", label="validación (CV)") ax.axhline(0.28, color="0.4", linestyle=":", label="σ laboratorio") ax.set_title(tit) ax.set_xlabel("n de entrenamiento") ax.set_ylabel("RMSE") ax.legend(fontsize=7)plt.tight_layout()plt.show()print("Izquierda: las dos curvas altas y juntas → más n no arregla el sesgo.")print("Derecha: train bajo, validación alta → el hueco es varianza; n ayuda, el grado 16 pide demasiado.")
Izquierda: las dos curvas altas y juntas → más n no arregla el sesgo.
Derecha: train bajo, validación alta → el hueco es varianza; n ayuda, el grado 16 pide demasiado.
Cómo leer las curvas. La pregunta de producto “¿compro más datos o cambio el modelo?” se responde aquí. Si las curvas ya se juntaron arriba del error tolerable, el cuello es el modelo. Si hay un foso entre train y validación que se estrecha con \(n\), el cuello es el tamaño de muestra.
Veredicto parcial. Un sobreajuste con \(n\) minúsculo no condena la clase de modelo; condena el tamaño. Un subajuste con \(n\) grande sí condena la clase.
Etapa 12: Caso real — Diabetes (scikit-learn)
\(n=442\) pacientes, \(p=10\) variables clínicas (ya numéricas), \(y\) = progresión de la enfermedad a un año (escala continua). No se conoce \(f\). El oficio es el protocolo.
Candidatos, todos con estandarización ajustada solo en entrenamiento:
Baseline: media de \(y\).
Lineal:LinearRegression en las 10 features.
Polinomio grado 2: todas las interacciones y cuadrados (muchas columnas: riesgo de varianza).
Partición: 25% prueba, una vez. Elección entre lineal y poli-2: CV \(k=5\)en el 75%. Bootstrap del RMSE en la prueba del modelo elegido.
diab = load_diabetes()Xd, yd = diab.data, diab.targetprint("n =", Xd.shape[0], " p =", Xd.shape[1], " y: min/mediana/max =",int(yd.min()), int(np.median(yd)), int(yd.max()))print("Unidades de y: índice de progresión (no son 'puntos porcentuales').")Xd_dev, Xd_te, yd_dev, yd_te = train_test_split(Xd, yd, test_size=0.25, random_state=42)def pipe_lin():return Pipeline([("esc", StandardScaler()), ("lin", LinearRegression())])def pipe_poly2():return Pipeline( [ ("esc", StandardScaler()), ("poli", PolynomialFeatures(2, include_bias=False)), ("lin", LinearRegression()), ] )kf = KFold(n_splits=5, shuffle=True, random_state=42)def cv_rmse(estimator, X, y): sc =-cross_val_score(estimator, X, y, cv=kf, scoring="neg_root_mean_squared_error")return sccv_lin = cv_rmse(pipe_lin(), Xd_dev, yd_dev)cv_p2 = cv_rmse(pipe_poly2(), Xd_dev, yd_dev)print()print("CV en desarrollo (no se tocó la prueba)")print(" lineal pliegues =", np.round(cv_lin, 2), " media =", round(cv_lin.mean(), 2), " DE =", round(cv_lin.std(ddof=1), 2))print(" poli-2 pliegues =", np.round(cv_p2, 2), " media =", round(cv_p2.mean(), 2), " DE =", round(cv_p2.std(ddof=1), 2))print(" p del poli-2 (columnas) =", pipe_poly2().fit(Xd_dev, yd_dev).named_steps["poli"].n_output_features_)
n = 442   p = 10   y: min/mediana/max = 25 140 346
Unidades de y: índice de progresión (no son 'puntos porcentuales').

CV en desarrollo (no se tocó la prueba)
  lineal  pliegues = [57.28 58.26 49.9  57.24 57.91]   media = 56.12   DE = 3.5
  poli-2  pliegues = [70.69 58.28 54.61 72.93 64.66]   media = 64.23   DE = 7.84
  p del poli-2 (columnas) = 65
Pausa de análisis (antes de la prueba). El poli-2 explota \(p\): decenas de columnas contra ~300 filas de desarrollo. Si su media de CV es peor o su DE es mayor, no se elige aunque en train vaya a brillar. El lineal es el candidato por defecto en este régimen.
Siguiente celda: se elige por la media de CV (y se mira la DE). Luego una evaluación en prueba, baseline incluido, y bootstrap.
elegido_nombre ="lineal"if cv_lin.mean() <= cv_p2.mean() else"poli-2"elegido = pipe_lin() if elegido_nombre =="lineal"else pipe_poly2()print("Elegido por CV:", elegido_nombre, "(menor RMSE medio en desarrollo)")dummy_d = DummyRegressor(strategy="mean").fit(Xd_dev, yd_dev)elegido.fit(Xd_dev, yd_dev)p2_ref = pipe_poly2().fit(Xd_dev, yd_dev)filas_d = [ ficha(yd_dev, dummy_d.predict(Xd_dev), "baseline / dev"), ficha(yd_te, dummy_d.predict(Xd_te), "baseline / TEST"), ficha(yd_dev, elegido.predict(Xd_dev), f"{elegido_nombre} / dev"), ficha(yd_te, elegido.predict(Xd_te), f"{elegido_nombre} / TEST"), ficha(yd_dev, p2_ref.predict(Xd_dev), "poli-2 / dev (referencia)"), ficha(yd_te, p2_ref.predict(Xd_te), "poli-2 / TEST (no elegido si CV lo perdió)"),]print(pd.DataFrame(filas_d).round(2).to_string(index=False))yhat_te = elegido.predict(Xd_te)rmse_te = rmse(yd_te, yhat_te)boot_d = []for _ inrange(400): idx = rng.integers(0, len(yd_te), size=len(yd_te)) boot_d.append(rmse(yd_te[idx], yhat_te[idx]))boot_d = np.array(boot_d)lo_d, hi_d = graficar_hist_bootstrap( boot_d, rmse_te,f"Diabetes — bootstrap del RMSE de prueba ({elegido_nombre})",)# residuos de pruebafig, axes = plt.subplots(1, 2, figsize=(9.2, 3.7))axes[0].scatter(yhat_te, yd_te - yhat_te, s=18, alpha=0.7)axes[0].axhline(0, color="C3", linestyle="--")axes[0].set_xlabel("ŷ (prueba)")axes[0].set_ylabel("residuo")axes[0].set_title("Residuos en TEST")axes[1].scatter(yd_te, yhat_te, s=18, alpha=0.7)mn, mx = yd_te.min(), yd_te.max()axes[1].plot([mn, mx], [mn, mx], color="C3", linestyle="--")axes[1].set_xlabel("y (prueba)")axes[1].set_ylabel("ŷ")axes[1].set_title("Calibración grosera: ¿sobre la diagonal?")plt.tight_layout()plt.show()print("RMSE TEST", elegido_nombre, "=", round(rmse_te, 2), " IC bootstrap 95% [", round(lo_d, 2), ",", round(hi_d, 2), "]")print("RMSE TEST baseline =", round(rmse(yd_te, dummy_d.predict(Xd_te)), 2))print("R2 TEST", elegido_nombre, "=", round(r2_score(yd_te, yhat_te), 3))print("DE de y (desarrollo) =", round(yd_dev.std(ddof=1), 2), " → el baseline vive cerca de ese orden")
Elegido por CV: lineal (menor RMSE medio en desarrollo)
                                    modelo  RMSE     MSE    R2
                            baseline / dev 77.75 6044.62  0.00
                           baseline / TEST 74.88 5607.20 -0.01
                              lineal / dev 53.92 2907.26  0.52
                             lineal / TEST 53.37 2848.31  0.48
                 poli-2 / dev (referencia) 48.87 2388.74  0.60
poli-2 / TEST (no elegido si CV lo perdió) 56.42 3183.76  0.42
RMSE TEST lineal = 53.37   IC bootstrap 95% [ 45.79 , 59.99 ]
RMSE TEST baseline = 74.88
R2 TEST lineal = 0.485
DE de y (desarrollo) = 77.86   → el baseline vive cerca de ese orden
Cómo leer el caso Diabetes, número por número.
Escala de \(y\). El índice vive, más o menos, entre 25 y 350. Un RMSE de ~55 no es “55% de error”; es ~55 puntos de ese índice. Hay que preguntar al dominio si 55 puntos importan clínicamente. La estadística no responde esa frase; la prepara.
Baseline. El RMSE de predecir la media ronda la desviación de \(y\) (~70–80). Si el lineal no baja de forma clara en TEST, no hay modelo.
Hueco dev vs TEST. Si el lineal tiene RMSE de desarrollo y de prueba cercanos, no hay sobreajuste grosero. Si el poli-2 brilla en desarrollo y empeora en prueba, es el grado 16 de las etapas 2–4, ahora en \(p\) alto.
Pliegues. Una DE de CV de varios puntos sobre una media de ~55 dice que el “55” no es un milímetro. El bootstrap de la prueba debe contar la misma historia (banda ancha).
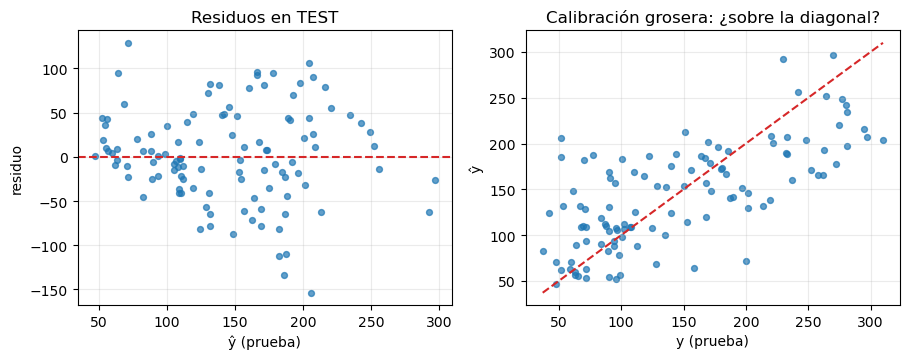
Residuos de TEST. Embudo o curva: el lineal es un baseline útil, no la \(f\) del fenómeno. Nube alrededor de 0, sin estructura fuerte: el lineal es una descripción honesta dentro de su clase.
\(R^2\) de TEST ~ 0.4–0.5 (orden típico de este conjunto). Traducción: se explica una fracción moderada de la varianza. No es un sistema de decisión clínica. Sí es evidencia de señal lineal y un suelo para modelos posteriores.
Qué no se concluye. Que el lineal “falle” porque \(R^2<0.9\). El umbral 0.9 no es de este \(y\). Que el poli-2 sea superior por tener más parámetros. Que el IC bootstrap autorice un protocolo médico.
Preguntas de análisis (escríbelas antes de mirar el reporte modelo).
¿El elegido gana al baseline en TEST por un margen mayor que la anchura del IC?
¿Elegirías poli-2 si solo vieras el RMSE de desarrollo?
Si el peor pliegue de CV es mucho peor que la media, ¿firmas un despliegue?
Caso aplicado: ficha de veredicto
Plantilla (se llena; no se deja en abstracto):
Problema y unidad. Qué es \(y\), qué sería un error tolerable.
Baseline. Número de referencia y conjunto.
Candidatos y protocolo. Qué se comparó; dónde se eligió (CV en desarrollo, no en test).
Cifra que se cita. Métrica de prueba, \(n_{\mathrm{test}}\), IC (bootstrap o DE de CV).
Hueco y residuos. ¿Sobreajuste? ¿Forma mal especificada?
Decisión. Rechazar / iterar / aceptar con límites. Una frase de límite (población, \(p\), no clínico, etc.).
Los seis pasos, aplicados a Diabetes
Problema. Predecir la progresión a un año (índice continuo). Un error tolerable lo fija el clínico; aquí se usa la escala observada (DE de \(y\) ≈ 70–80) como ancla.
Baseline. Media de \(y\) en desarrollo; RMSE de TEST del DummyRegressor (print de la etapa 12).
Candidatos. Lineal vs poli-2, ambos con StandardScaler. Elección por RMSE-CV \(k=5\) en el 75%. La prueba (25%) no eligió.
Cifra. RMSE de TEST del modelo elegido + IC bootstrap 95% + \(R^2\) de TEST. \(n_{\mathrm{test}}\approx 110\).
Hueco. El lineal suele tener dev y TEST cercanos; el poli-2, si empeora en TEST, se documenta como varianza por \(p\) inflado. Residuos de TEST: ver figura.
Decisión.Aceptar como baseline estadístico, no como herramienta clínica. Gana a la media, el hueco no denuncia sobreajuste grosero, el \(R^2\) es moderado y el IC impide vender una precisión milimétrica. Iterar: más features de dominio, otro modelo, otro \(n\) —no un poli-2 por costumbre.
En \(n=442\) pacientes (\(p=10\)), un lineal estandarizado se eligió por CV frente a un polinomio de grado 2. El RMSE de prueba es \(53.4\) con IC bootstrap 95% \([45.8,\,60.0]\) (\(R^2=0.485\)). Supera al baseline de la media. El \(R^2\) de prueba es moderado: hay señal, no hay modelo de decisión médica. Limitación: una partición, \(y\) de índice no calibrado a unidades clínicas en este notebook, sin validación temporal.
Esa última frase es el oficio. El modelo es aceptable para un fin (suelo, comparación, enseñanza) y no es aceptable para otro (tratar a un paciente). “¿Es bueno?” sin el fin es una pregunta mal hecha.
Errores que conviene nombrar
Publicar el error de entrenamiento como desempeño.
Elegir el modelo con la prueba y citar esa misma prueba (fuga).
Declarar ganador sin baseline.
Ignorar la dispersión de pliegues o del bootstrap: tratar la media como exacta.
Confundir \(R^2\) alto con utilidad. El \(R^2\) no conoce el costo de un error de 50 puntos.
Más flexibilidad como plan A cuando las curvas de aprendizaje ya se juntaron arriba (subajuste).
Más datos como plan A cuando el modelo es una recta sobre un seno (la clase está mal).
Bootstrap = más \(n\). Es remuestreo, no reclutamiento.
Idea clave
Un modelo es aceptable solo respecto a un baseline, un conjunto no visto, una unidad de error y un uso. El resto —\(R^2\) de train, un split afortunado, un grado que ganó en test— es teatro de ajuste.
Síntesis
Se partió de un baseline y se dejó que el grado 16 ganara en entrenamiento para contradecirlo en prueba. El abanico de 60 muestras hizo visible el sesgo y la varianza. Un split único tembló; la CV juntó pliegues y eligió complejidad sin tocar el test final. La fuga mostró cómo se fabrica un RMSE optimista. El bootstrap convirtió el RMSE en una banda. Las curvas de aprendizaje separaron “faltan filas” de “falla la clase de modelo”. En Diabetes se llenó la ficha: el lineal es un suelo honesto, no un oráculo. El objeto que queda es el veredicto con evidencia, no el score_.
6. Guía rápida: ¿qué protocolo usar?
Situación
Qué usar
Qué mirar
¿Hay señal alguna?
Baseline (media / modelo actual)
El candidato debe ganar en prueba
Primera cifra honesta
Train / test, una vez
Hueco y unidades
\(n\) chico o split nervioso
\(k\)-fold CV
Media y DE / peor pliegue
Elegir grado o hiperparámetro
CV en desarrollo
El test no vota
¿Cuánto precisa es la cifra?
Bootstrap de la métrica
Anchura del IC
¿Más datos o otro modelo?
Curvas de aprendizaje
¿Se juntan arriba o hay foso?
¿Memorizó?
Train \(\ll\) test
Sobreajuste
¿No puede aprender \(f\)?
Train ≈ test, ambos altos
Subajuste
Regla de comunicación: métrica, conjunto (test o CV), \(n\), intervalo o DE, baseline, y el uso para el que se acepta o se rechaza.
7. Guía práctica para reportar un veredicto
Paso 1: \(y\), unidad, uso
Qué se predice, qué error sería tolerable, para qué decisión.
Paso 2: protocolo
Baseline, partición, dónde se eligió el modelo, \(k\), \(B\) del bootstrap.
Paso 3: cifras
Tabla train/dev vs test; pliegues; IC.
Paso 4: diagnóstico
Hueco, residuos de test, curva de aprendizaje si hace falta.
Paso 5: redactar
“Para [uso], \(y=\)[unidad]. Baseline [...] en TEST = [métrica]. El modelo [...] se eligió por [CV / ...] en desarrollo (\(n=\)[...]). En TEST (\(n=\)[...]) la métrica es [...] (IC [...]). Hueco train–test: [...]. Residuos: [banda / patrón]. Veredicto:[rechazar / iterar / aceptar para este uso]. No se acepta para [uso que el número no sostiene]. Limitación: [split único / p alto / sin validación temporal].”
Diabetes (etapa 12) ya llenó esta plantilla.
8. Puente hacia las siguientes sesiones
Validar es el lastre que convierte un ajuste (la recta de la sesión de regresión; un clasificador, si ya se midió precisión y recall) en una afirmación sobre datos no vistos. El proyecto integrador pide exactamente esto: no un fit brillante, un párrafo de veredicto con baseline, conjunto no visto e incertidumbre. Si la métrica cambia (F1, AUC), el protocolo no cambia: solo la pérdida \(L\).
9. Cierre
Este notebook deja el criterio para no confundir ajuste con modelo:
tres errores (train, test, generalización),
sobreajuste y subajuste, leídos en tabla y en figura,
sesgo frente a varianza (abanico de réplicas),
train/test, su temblor y la fuga al elegir con la prueba,
validación cruzada a mano y con scikit-learn,
bootstrap de la métrica,
curvas de aprendizaje,
una ficha de veredicto aplicada a Diabetes.
Resultado esperado: el estudiante puede mirar una tabla train/test, una lista de pliegues y un IC, y decidir —aceptar para un uso, iterar o rechazar— sin que un \(R^2\) de entrenamiento le dicte la frase.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.