Estadística para IA — 14. Proyecto integrador final

estadistica
proyecto
evaluacion
EDA, correlación, modelo lineal, métricas, validación train/test y un veredicto escrito sobre si el modelo es aceptable.
Author

Wilder Ramírez Delgado

Published

September 25, 2026

Sesión 14 — Proyecto Integrador Final

Open in Colab

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Un cuaderno que se atreve a concluir

Este cierre no introduce una técnica nueva. Recorre, sobre un solo dataset diseñado, lo que el curso ya enseñó: leer variables, ver forma y relación, ajustar una recta, no fiarse del error de entrenamiento y escribir un veredicto. El producto no es un fit brillante: es un párrafo que dice para qué sirve el modelo y para qué no.

Contexto: una plataforma de práctica. Cada fila es un estudiante. Se predice puntuacion (0–100) a partir de hábitos. Los datos son sintéticos y diseñados: hay señal, hay una feature inútil y hay dos hábitos correlacionados a propósito.

Electiva I — Estadística Aplicada a la Inteligencia Artificial · Módulo 4 · Sesión 14

Objetivos

  • Recorrer un EDA mínimo (tipos, centro, dispersión, forma) sin sustituirlo por el modelo.
  • Leer una matriz de correlación sin convertir \(r\) en causa.
  • Ajustar un lineal con scikit-learn y un baseline (media).
  • Medir en prueba, no solo en entrenamiento.
  • Diagnosticar residuos.
  • Redactar el veredicto con unidad, \(n\), hueco y límite.

Nota: se recomienda ejecutar las celdas en orden. Las fórmulas usan LaTeX; si no se ven renderizadas, abre el notebook en Jupyter o Colab.

1. El rol de la estadística en este cierre

El curso dejó un orden. Aquí se usa, no se vuelve a derivar.

Bloque Qué se hace aquí
Dato y tipos info, dtypes, qué se puede promediar
Centro y dispersión media, mediana, DE de puntuacion
Forma histograma de \(y\) (¿asimetría?)
Relación correlación; dos hábitos redundantes
Recta OLS, \(\hat\beta\), RMSE
Validación train/test, baseline, hueco
Comunicación ficha de veredicto

Idea central: cada número pide un conjunto (toda la muestra, train o test) y una pregunta. Mezclarlos es el fallo que este notebook evita a propósito.

2. Por qué este proyecto importa en IA

Un pipeline real no es “cargar y fit”. Es decidir si el error en unidades de \(y\) justifica un despliegue. Aquí \(y\) es una puntuación: RMSE 8 no es lo mismo que RMSE 25. El baseline (predecir la media) impide felicitarse por un \(R^2\) de train.

3. Flujo del proyecto

  1. Generar / cargar y conocer columnas.
  2. Describir \(y\) y las \(x\).
  3. Correlación y scatter de las relaciones diseñadas.
  4. Partir train/test antes de elegir el modelo.
  5. Baseline → lineal → RMSE y \(R^2\) en ambos conjuntos.
  6. Residuos de prueba.
  7. Veredicto escrito.

4. Preparar el entorno

%matplotlib inline
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.dummy import DummyRegressor
from sklearn.metrics import mean_squared_error, r2_score

rng = np.random.default_rng(42)
plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25
print("Entorno listo.")
Python: 3.13.9
Entorno listo.

Funciones (una sola vez)

def rmse(y_true, y_pred):
    return float(np.sqrt(mean_squared_error(y_true, y_pred)))


def ficha(y_true, y_pred, etiqueta):
    return {
        "conjunto": etiqueta,
        "RMSE": round(rmse(y_true, y_pred), 3),
        "R2": round(float(r2_score(y_true, y_pred)), 3),
    }


def graficar_hist_y(y, titulo):
    fig, ax = plt.subplots(figsize=(7.6, 3.8))
    ax.hist(y, bins=18, color="C0", alpha=0.85)
    ax.axvline(np.mean(y), color="C3", linestyle="--", label=f"media = {np.mean(y):.1f}")
    ax.axvline(np.median(y), color="C1", linestyle=":", label=f"mediana = {np.median(y):.1f}")
    ax.set_xlabel("puntuación")
    ax.set_ylabel("frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_corr(df, titulo):
    cols = list(df.columns)
    R = df.corr()
    fig, ax = plt.subplots(figsize=(6.4, 5.2))
    im = ax.imshow(R, vmin=-1, vmax=1, cmap="coolwarm")
    ax.set_xticks(range(len(cols)), cols, rotation=35, ha="right", fontsize=8)
    ax.set_yticks(range(len(cols)), cols, fontsize=8)
    for i in range(len(cols)):
        for j in range(len(cols)):
            ax.text(j, i, f"{R.iloc[i, j]:.2f}", ha="center", va="center", fontsize=7)
    fig.colorbar(im, ax=ax, fraction=0.046)
    ax.set_title(titulo)
    plt.tight_layout()
    plt.show()


def graficar_residuos(yhat, e, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(9.0, 3.7))
    axes[0].scatter(yhat, e, s=16, alpha=0.7)
    axes[0].axhline(0, color="C3", linestyle="--")
    axes[0].set_xlabel("ŷ prueba")
    axes[0].set_ylabel("residuo")
    axes[0].set_title("Residuos vs ajustados (TEST)")
    axes[1].scatter(yhat + e, yhat, s=16, alpha=0.7)
    lo, hi = (yhat + e).min(), (yhat + e).max()
    axes[1].plot([lo, hi], [lo, hi], color="C3", linestyle="--")
    axes[1].set_xlabel("y prueba")
    axes[1].set_ylabel("ŷ")
    axes[1].set_title("Calibración grosera (TEST)")
    fig.suptitle(titulo, y=1.02)
    plt.tight_layout()
    plt.show()

5. Desarrollo del proyecto

Etapa 1: El dataset (diseñado)

\(n=280\). La puntuación se fabrica así:

\[ \text{puntuacion}=42+2.1\cdot\text{practica}+1.4\cdot\text{lectura}+3.0\cdot\text{sueno}-0.35\cdot\text{distraccion}+\varepsilon. \]

lectura y practica están correlacionadas (hábitos que se mueven juntos). ruido no entra en \(y\).

n = 280
lectura = rng.normal(6.0, 2.0, n).clip(0.5, 14)
practica = (0.75 * lectura + rng.normal(0, 1.4, n)).clip(0.5, 16)
sueno = rng.normal(7.0, 1.1, n).clip(4.0, 10.0)
distraccion = rng.normal(35, 12, n).clip(5, 90)
ruido = rng.normal(50, 15, n)
eps = rng.normal(0, 7.5, n)
puntuacion = (42 + 2.1 * practica + 1.4 * lectura + 3.0 * sueno - 0.35 * distraccion + eps).clip(20, 100)

df = pd.DataFrame({
    "lectura_h": lectura,
    "practica_h": practica,
    "sueno_h": sueno,
    "distraccion": distraccion,
    "ruido": ruido,
    "puntuacion": puntuacion,
})
print(df.head(3).round(2).to_string(index=False))
print()
print(df.dtypes)
print("n =", len(df), "  nulos =", int(df.isna().sum().sum()))
 lectura_h  practica_h  sueno_h  distraccion  ruido  puntuacion
      6.61        5.63     6.92        57.86  56.75       72.46
      3.92        0.50     7.37        35.43  50.05       55.81
      7.50        6.92     7.06        56.04  38.75       67.06

lectura_h      float64
practica_h     float64
sueno_h        float64
distraccion    float64
ruido          float64
puntuacion     float64
dtype: object
n = 280   nulos = 0

Lectura. No hay nulos. Todas las columnas son numéricas de verdad (magnitudes), no IDs. puntuacion es \(y\).

Etapa 2: Centro, dispersión y forma de \(y\)

y = df["puntuacion"]
print(y.describe().round(2))
print("media =", round(y.mean(), 2), "  mediana =", round(y.median(), 2), "  DE =", round(y.std(ddof=1), 2))
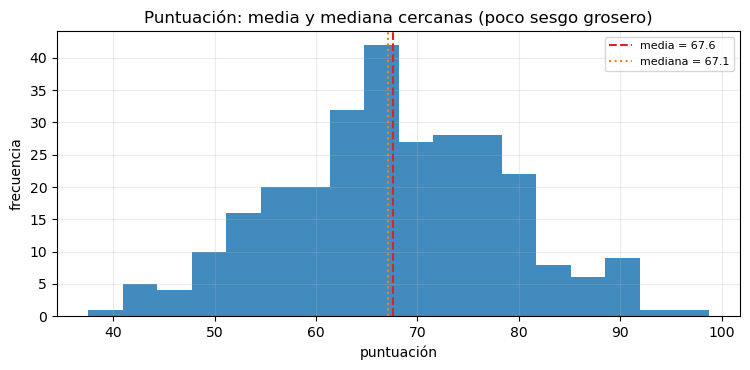
graficar_hist_y(y.to_numpy(), "Puntuación: media y mediana cercanas (poco sesgo grosero)")
count    280.00
mean      67.55
std       11.18
min       37.53
25%       59.66
50%       67.14
75%       75.57
max       98.76
Name: puntuacion, dtype: float64
media = 67.55   mediana = 67.14   DE = 11.18

Lectura. El baseline ingenuo (predecir la media) tendrá RMSE del orden de la DE. Un modelo útil debe bajar de ese piso en prueba.

Etapa 3: Relaciones — correlación no es causa

print(df.corr(numeric_only=True).round(2).to_string())
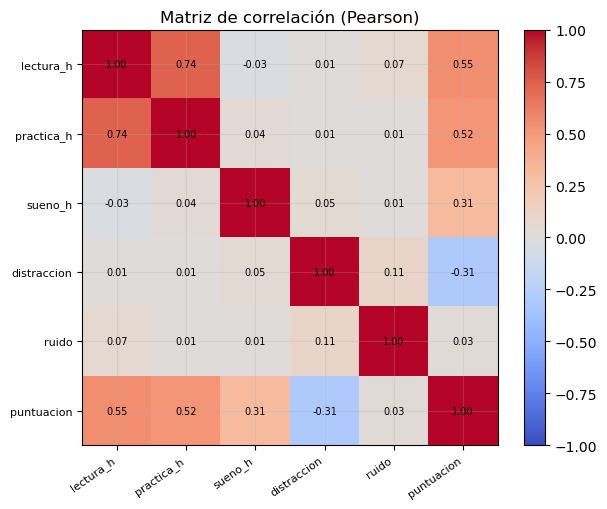
graficar_corr(df, "Matriz de correlación (Pearson)")
print()
print("lectura vs practica (diseñadas juntas):", round(df["lectura_h"].corr(df["practica_h"]), 3))
print("ruido vs puntuacion (debe ~ 0):", round(df["ruido"].corr(df["puntuacion"]), 3))
             lectura_h  practica_h  sueno_h  distraccion  ruido  puntuacion
lectura_h         1.00        0.74    -0.03         0.01   0.07        0.55
practica_h        0.74        1.00     0.04         0.01   0.01        0.52
sueno_h          -0.03        0.04     1.00         0.05   0.01        0.31
distraccion       0.01        0.01     0.05         1.00   0.11       -0.31
ruido             0.07        0.01     0.01         0.11   1.00        0.03
puntuacion        0.55        0.52     0.31        -0.31   0.03        1.00


lectura vs practica (diseñadas juntas): 0.742
ruido vs puntuacion (debe ~ 0): 0.026

Lectura. lectura y practica se solapan: en un lineal los \(\hat\beta\) de esas dos se reparten la señal (no se leen como efectos aislados). ruido no debe ganar peso. Nada de esto prueba que “estudiar más causa” la nota: el laboratorio lo fabricó.

Etapa 4: Partición — la prueba no se toca para elegir

features = ["lectura_h", "practica_h", "sueno_h", "distraccion", "ruido"]
X = df[features]
y = df["puntuacion"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.30, random_state=42)
print("n train =", len(y_tr), "  n test =", len(y_te))
n train = 196   n test = 84

Etapa 5: Baseline y lineal

dummy = DummyRegressor(strategy="mean").fit(X_tr, y_tr)
lin = LinearRegression().fit(X_tr, y_tr)

filas = [
    ficha(y_tr, dummy.predict(X_tr), "baseline / train"),
    ficha(y_te, dummy.predict(X_te), "baseline / TEST"),
    ficha(y_tr, lin.predict(X_tr), "lineal / train"),
    ficha(y_te, lin.predict(X_te), "lineal / TEST"),
]
print(pd.DataFrame(filas).to_string(index=False))
print()
print("Intercepto =", round(float(lin.intercept_), 3))
print(pd.Series(lin.coef_, index=features).round(3).to_string())
        conjunto   RMSE     R2
baseline / train 10.846  0.000
 baseline / TEST 11.896 -0.016
  lineal / train  7.320  0.545
   lineal / TEST  8.231  0.514

Intercepto = 37.18
lectura_h      2.200
practica_h     1.264
sueno_h        3.048
distraccion   -0.326
ruido          0.043

Cómo leer la tabla. El lineal debe ganar al baseline en TEST. El hueco train–test debe ser chico (modelo rígido, \(n\) no minúsculo). ruido debe quedar cerca de 0. lectura y practica pueden verse “débiles” por separado aunque juntas sí importen.

Etapa 6: Residuos en prueba

yhat_te = lin.predict(X_te)
e_te = y_te.to_numpy() - yhat_te
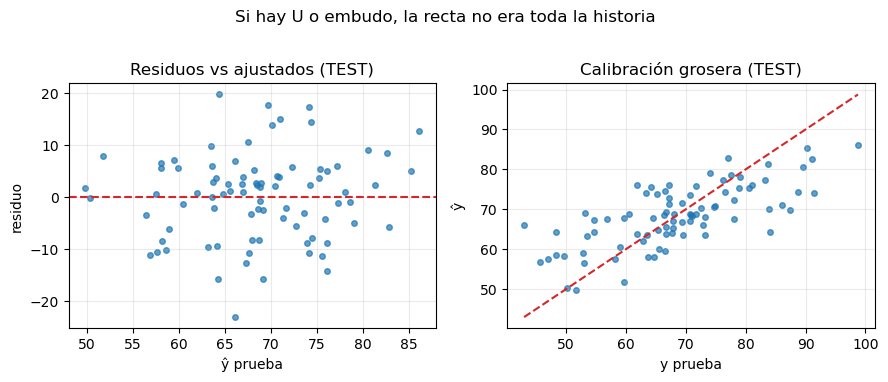
print("Media de residuos TEST =", round(float(e_te.mean()), 3), "  (debe ~ 0)")
print("RMSE TEST =", round(rmse(y_te, yhat_te), 3), "  DE de y (train) =", round(float(y_tr.std(ddof=1)), 3))
graficar_residuos(yhat_te, e_te, "Si hay U o embudo, la recta no era toda la historia")
Media de residuos TEST = 0.056   (debe ~ 0)
RMSE TEST = 8.231   DE de y (train) = 10.874

Lectura. Banda horizontal: el lineal es una descripción honesta en esta clase de modelo. Un U delataría que faltaba un término no lineal. RMSE se compara con la DE de \(y\) y con el rango 20–100.

Etapa 7: ¿Hace falta ruido?

Se reajusta sin ruido, misma partición (no se vuelve a mirar la prueba para elegir a ciegas: aquí es un contraste de diseño).

feats2 = ["lectura_h", "practica_h", "sueno_h", "distraccion"]
lin2 = LinearRegression().fit(X_tr[feats2], y_tr)
print("RMSE TEST con ruido    =", round(rmse(y_te, lin.predict(X_te)), 3))
print("RMSE TEST sin ruido    =", round(rmse(y_te, lin2.predict(X_te[feats2])), 3))
print("El ruido no debería mejorar el test de forma estable. Si baja por azar, es n de prueba.")
RMSE TEST con ruido    = 8.231
RMSE TEST sin ruido    = 8.152
El ruido no debería mejorar el test de forma estable. Si baja por azar, es n de prueba.

Caso aplicado: ficha de veredicto

  1. Uso. Estimar la puntuación de un estudiante a partir de hábitos (prioridad pedagógica, no un ranking oficial).
  2. \(y\) y unidad. Puntos de 20 a 100. Un error de ~8 puntos es del orden del ruido de diseño (\(\sigma=7.5\)).
  3. Protocolo. Test 30%, una vez. Baseline = media de train. Lineal OLS.
  4. Cifras. RMSE y \(R^2\) de TEST (print etapa 5). Hueco train–test.
  5. Diagnóstico. Residuos de TEST (etapa 6). ruido no aporta (etapa 7).
  6. Decisión. Aceptar como baseline estadístico de la plataforma de práctica, no como sistema de calificación automática. Gana a la media, el hueco no denuncia sobreajuste grosero, el RMSE vive cerca del \(\sigma\) inyectado. No se usa para decidir becas: \(n\) es de laboratorio y \(y\) es sintética.

En \(n=280\) estudiantes sintéticos, un lineal con hábitos predice puntuacion con RMSE de TEST \(8.23\) (baseline de la media, más alto; print de la etapa 5), cerca del ruido de diseño. Residuos sin patrón grosero. Se acepta como suelo descriptivo. Limitación: datos diseñados, una partición, dos features colineales, sin validación temporal.

Errores que este proyecto no debe repetir

  1. Publicar el RMSE de train.
  2. Leer \(\hat\beta\) de lectura como “efecto causal de leer”.
  3. Dejar ruido porque “más columnas es más modelo”.
  4. Declarar “bueno” sin baseline.
  5. Olvidar las unidades de \(y\).

Idea clave

El proyecto termina cuando hay un veredicto con conjunto no visto, no cuando LinearRegression corre.

6. Guía rápida del cierre

Paso Pregunta Si falla
EDA ¿Sé qué es cada columna? No modelar
\(y\) ¿Cuál es la unidad y la DE? No hay “alto/bajo”
\(r\) ¿Hay redundancia o una \(x\) muerta? Podar o no sobreinterpretar \(\beta\)
Split ¿La prueba votó el modelo? Hay fuga
Baseline ¿Gano a la media en TEST? No hay señal usable
Residuos ¿U / embudo? La recta no basta

7. Plantilla para el informe final

“Dataset […], \(n=\)[...], \(y=\)[unidad]. Baseline TEST = [RMSE]. Modelo […], TEST \(n=\)[...]: RMSE=[...], \(R^2=\)[...]. Hueco train–test: […]. Residuos: [banda / patrón]. Veredicto: [aceptar para… / rechazar]. Limitación: […].”

8. Puente

El avanzado del sitio retoma la recta con más \(x\), regularización y remuestreo. El criterio no cambia: baseline, conjunto no visto, unidades, límite.

9. Cierre

Este notebook cierra el básico con un ciclo completo: dato, descripción, relación, modelo, prueba y frase de decisión. El estudiante que puede llenar la plantilla de la sección 7 sin inventar un \(R^2\) de entrenamiento terminó el arco.

Resultado esperado: un veredicto de diez líneas, no un screenshot del score de train.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.