Perceptrón y MLP: de la neurona simple a las redes multicapa

deep-learning
perceptron
mlp
Implementación del perceptrón desde cero, compuertas lógicas y el problema XOR, resuelto con un Perceptrón Multicapa (MLP) aplicado a Iris, dígitos escritos a mano y reconocimiento de rostros.
Author

Wilder Ramírez Delgado

Published

August 31, 2026

Perceptrón y MLP: de la neurona simple a las redes multicapa

Open in Colab

En este notebook exploramos los fundamentos de las redes neuronales artificiales, desde su inspiración en las neuronas biológicas hasta su implementación computacional. Analizamos el modelo del Perceptrón, su estructura y funcionamiento, así como su capacidad para resolver problemas linealmente separables. También discutimos sus limitaciones y la evolución hacia redes neuronales multicapa, que permiten abordar problemas más complejos mediante funciones de activación no lineales y algoritmos de optimización avanzados.

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Ejemplo introductorio: Implementación de un perceptrón simple desde cero

# Comentario: Implementa un perceptron desde cero, lo entrena con OR y muestra predicciones.

# Ejemplo introductorio: Implementación de un perceptrón simple desde cero

import numpy as np

# Función de activación escalón
def step_function(x):
    return 1 if x >= 0 else 0

# Implementación de una neurona Perceptrón
class PerceptronSimple:
    def __init__(self, learning_rate=0.1, epochs=10):
        self.learning_rate = learning_rate
        self.epochs = epochs
        self.weights = None
        self.bias = None

    def fit(self, X, y):
        """Entrena el perceptrón."""
        n_features = X.shape[1]
        self.weights = np.zeros(n_features)
        self.bias = 0

        for _ in range(self.epochs):
            for xi, target in zip(X, y):
                output = self.predict(xi)
                error = target - output
                self.weights += self.learning_rate * error * xi
                self.bias += self.learning_rate * error

    def predict(self, X):
        """Realiza predicciones con la función escalón."""
        linear_output = np.dot(X, self.weights) + self.bias
        return step_function(linear_output)

# Datos de entrenamiento: Tabla OR
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y = np.array([0, 1, 1, 1])  # Salidas esperadas para la función OR

# Crear y entrenar el perceptrón
perceptron = PerceptronSimple(learning_rate=0.1, epochs=10)
perceptron.fit(X, y)

# Probar predicciones
predictions = [perceptron.predict(x) for x in X]

# Mostrar resultados
for i, (x, pred) in enumerate(zip(X, predictions)):
    print(f"Entrada: {x} -> Predicción: {pred}")
Entrada: [0 0] -> Predicción: 0
Entrada: [0 1] -> Predicción: 1
Entrada: [1 0] -> Predicción: 1
Entrada: [1 1] -> Predicción: 1

Explicación del ejemplo introductorio (Perceptrón desde cero con OR)

Esta explicación corresponde solo al bloque anterior, donde se entrena un perceptrón desde cero para aprender la compuerta OR.

1. Implementación del perceptrón simple

Primero se define la función de activación escalón: devuelve 1 si la entrada es positiva y 0 en caso contrario.

Luego se crea la clase PerceptronSimple con estos elementos: - Pesos (weights), inicializados en 0. - Bias, inicializado en 0. - Tasa de aprendizaje (learning_rate), que se puede ajustar. - Número de iteraciones (epochs) para el entrenamiento.

En términos simples: ¿qué es la tasa de ajuste?

La tasa de ajuste (learning_rate) indica qué tan grande es cada corrección cuando el modelo se equivoca. - Si es alta, corrige con pasos grandes (puede pasarse). - Si es baja, corrige con pasos pequeños (aprende más lento).

¿Qué es cada cosa?

  • X: matriz de entradas (cada fila es un ejemplo y cada columna una característica).
  • y: salida esperada para cada ejemplo.
  • weights: importancia de cada característica de entrada.
  • bias: término independiente que desplaza la frontera de decisión.
  • learning_rate: tamaño del ajuste en cada actualización.
  • epochs: cuántas veces se recorre todo el conjunto de entrenamiento.
  • xi: una fila de X (un ejemplo individual).
  • target: valor real esperado para xi.
  • predict(xi): salida estimada por el modelo para xi.
  • error = target - output: diferencia entre valor real y valor predicho.

2. Entrenamiento del perceptrón

Se recorren los datos de entrenamiento varias veces (epochs).

En cada iteración: - Se calcula la salida de la neurona (predict). - Se compara con la salida esperada (y). - Se actualizan los pesos y el bias según el error de predicción.

3. Predicción y evaluación

Se entrena el modelo con la tabla OR (X e y).

Luego se prueba con los mismos datos y se imprime la predicción para cada entrada.

Ejemplo 1: Iris - Clasificación de Setosa vs No Setosa

A partir de aquí empieza un ejemplo distinto al de OR.

El conjunto de datos Iris es un dataset clásico de aprendizaje automático que contiene mediciones de flores de tres especies de iris (Setosa, Versicolor y Virginica). Cada registro incluye variables como largo y ancho del sépalo y del pétalo, y se usa para practicar tareas de clasificación.

# Comentario (Ejemplo 1 - parte A): Carga Iris, entrena un perceptron binario (Setosa vs no Setosa) y realiza una prediccion puntual.

# 1) Importar librerias necesarias
import numpy as np
from sklearn.datasets import load_iris
from sklearn.linear_model import Perceptron

# 2) Cargar el dataset Iris (150 flores, 3 especies)
iris = load_iris()

# 3) Definir variables de entrada (X)
# Usamos solo 2 caracteristicas para simplificar:
# - columna 2: longitud del petalo
# - columna 3: ancho del petalo
X = iris.data[:, (2, 3)]

# 4) Definir la variable objetivo (y) en formato binario
# y = 1 si la flor es Setosa
# y = 0 si la flor NO es Setosa (Versicolor o Virginica)
y = (iris.target == 0).astype(int)

# 5) Crear y entrenar el modelo Perceptron
# random_state fija la semilla para reproducibilidad
per_clf = Perceptron(random_state=42)
per_clf.fit(X, y)

# 6) Probar el modelo con una flor nueva
# Ejemplo: petalo de longitud 2.0 cm y ancho 0.5 cm
muestra_nueva = [[2.0, 0.5]]
prediccion = per_clf.predict(muestra_nueva)[0]

# 7) Mostrar resultado numerico y su interpretacion
etiqueta = "Setosa" if prediccion == 1 else "No Setosa"
print("Entrada:", muestra_nueva[0])
print("Prediccion numerica:", prediccion)
print("Interpretacion:", etiqueta)
Entrada: [2.0, 0.5]
Prediccion numerica: 1
Interpretacion: Setosa

Ejemplo 1 (continuación): Visualización de la frontera de decisión en Iris

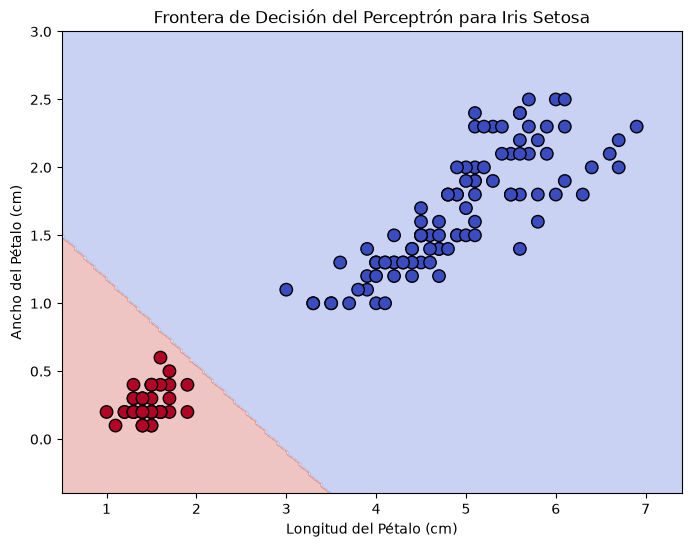
Objetivo Entrenar un Perceptrón con Iris para clasificar si una flor es Setosa (1) o no Setosa (0), y visualizar cómo el modelo separa ambas clases.

¿Qué se hizo en este ejemplo? (paso a paso)

  1. Se cargó el dataset Iris Se usó load_iris() de scikit-learn, que trae 150 flores etiquetadas en 3 especies.

  2. Se seleccionaron 2 variables de entrada De las 4 variables originales, se tomaron solo:

  • Longitud del pétalo
  • Ancho del pétalo

Esto se hace para poder graficar en 2D y entender mejor la frontera de decisión.

  1. Se convirtió el problema a clasificación binaria La variable objetivo se transformó así:
  • 1 si la flor es Iris Setosa
  • 0 si es Versicolor o Virginica
  1. Se creó y entrenó el modelo Se entrenó Perceptron(random_state=42) con X e y. El modelo aprende una combinación lineal de las variables para separar las dos clases.

  2. Se probó una predicción puntual Se evaluó el modelo con una flor de ejemplo [[2, 0.5]] para ver si la clasifica como Setosa o no.

  3. Se construyó una malla de puntos para visualizar Se generó una cuadrícula (meshgrid) que cubre el rango de los datos. En cada punto de esa malla, el modelo predice clase 0 o 1.

  4. Se graficó la frontera de decisión

  • El fondo coloreado muestra la clase que el modelo asigna en cada zona.
  • Los puntos reales del dataset muestran dónde caen las flores observadas.
  • La transición de color entre zonas representa la frontera de decisión lineal del Perceptrón.

Lectura rápida del resultado

Si la mayoría de puntos Setosa quedan en una zona y los no Setosa en otra, el modelo está separando bien para este caso. Si hay mezcla fuerte de colores y puntos, la separación no es buena con un modelo lineal.

Ejemplo 1 - parte B: Entrena perceptron en Iris y visualiza su frontera de decision en 2D.

# Comentario (Ejemplo 1 - parte B): Entrena perceptron en Iris y visualiza su frontera de decision en 2D.

# Importar librerías necesarias
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.linear_model import Perceptron

# Cargar el conjunto de datos Iris
iris = load_iris()
X = iris.data[:, (2, 3)]  # Seleccionar características: Longitud y Ancho del pétalo
y = (iris.target == 0).astype(int)  # Convertir a clasificación binaria: 1 si es Setosa, 0 en otro caso

# Crear y entrenar el modelo Perceptrón con hiperparámetros ajustados
per_clf = Perceptron(eta0=0.1, max_iter=1000, random_state=42)
per_clf.fit(X, y)

# Crear una malla para visualizar la frontera de decisión
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))

# Predecir sobre la malla
Z = per_clf.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# Graficar la frontera de decisión
plt.figure(figsize=(8, 6))
plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolors="k", s=80)
plt.title("Frontera de Decisión del Perceptrón para Iris Setosa")
plt.xlabel("Longitud del Pétalo (cm)")
plt.ylabel("Ancho del Pétalo (cm)")
plt.show()

Explicación Simple del Concepto de Frontera de Decisión

La frontera de decisión es la línea (o superficie) que separa diferentes categorías en un problema de clasificación.

¿Cómo funciona?

Imagina que tienes un conjunto de datos con dos tipos de puntos:
🔴 Rojos (Clase A)
🔵 Azules (Clase B)

Un modelo de clasificación, como un Perceptrón, intenta encontrar una línea que divida los puntos rojos de los azules. Esta línea es la frontera de decisión.

🖼 Ejemplo Visual

Si los datos son simples y pueden separarse con una línea recta, la frontera de decisión luce así:

🔴 🔴 🔴 | 🔵 🔵 🔵
🔴 🔴 🔴 | 🔵 🔵 🔵
🔴 🔴 🔴 | 🔵 🔵 🔵

La línea vertical | es la frontera de decisión, que divide las dos clases.

Aplicación en Machine Learning

  • Perceptrón → Encuentra una línea recta como frontera de decisión.
  • Redes Neuronales → Pueden aprender fronteras curvas y complejas.
  • SVM (Máquinas de Soporte Vectorial) → Encuentran la mejor frontera con el mayor margen entre clases.

Conclusión:
🔹 La frontera de decisión es la separación matemática entre clases.
🔹 En datos simples, es una línea recta.
🔹 En problemas complejos, puede ser una curva o superficie tridimensional.

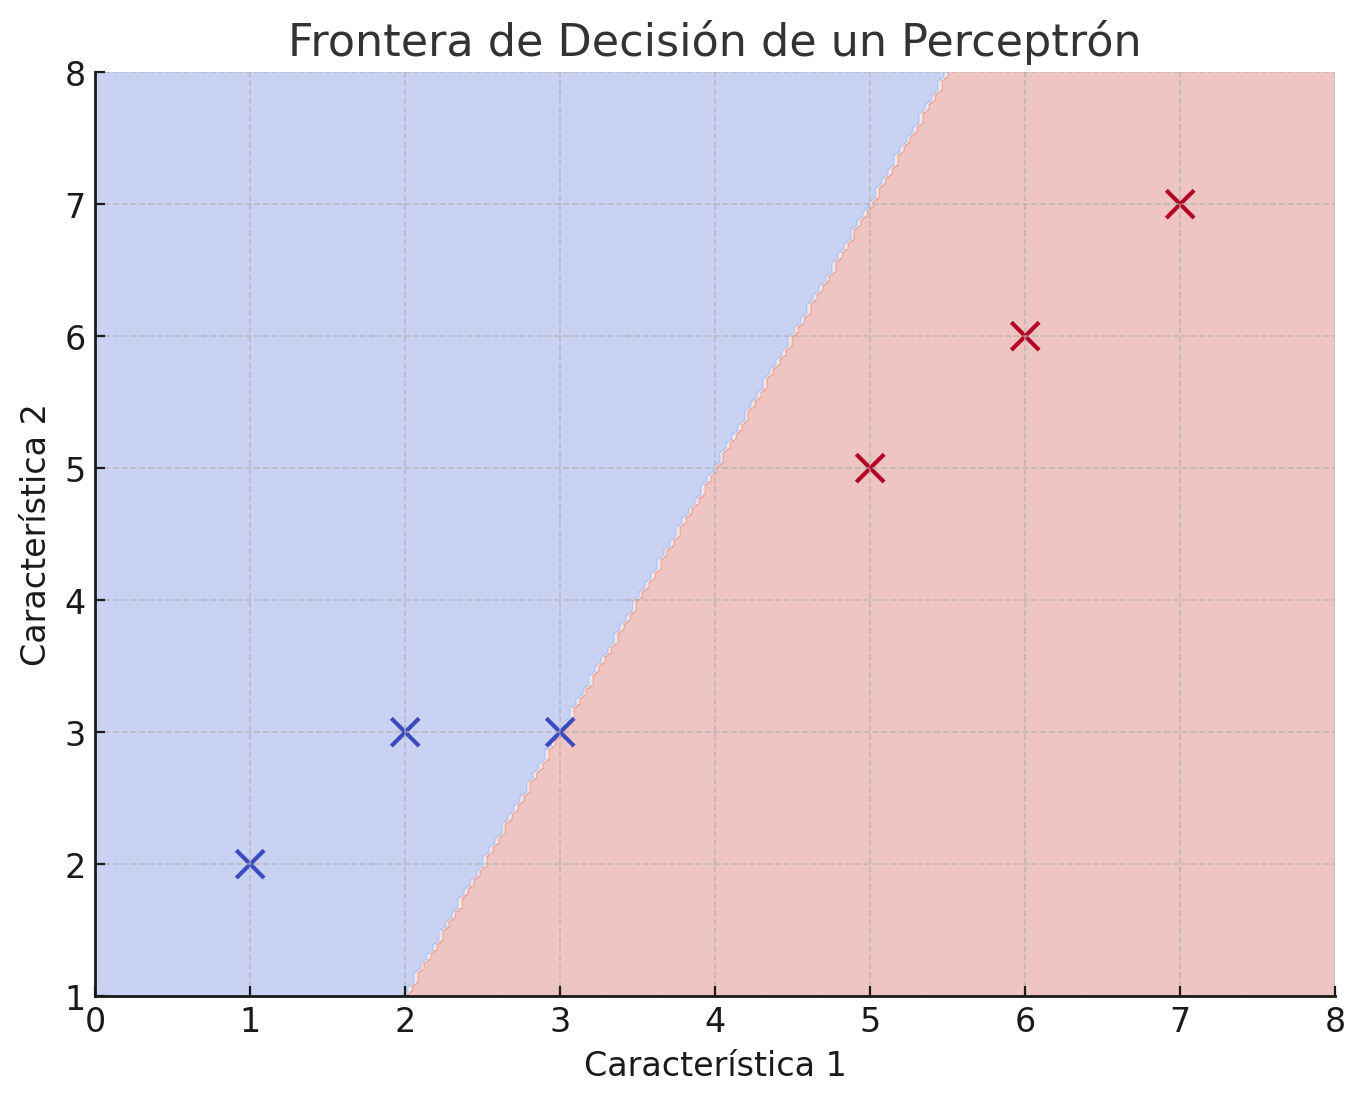
image.png

Explicación del Gráfico

1️⃣ Los puntos representan datos:
- 🔴 Rojos (Clase 0)
- 🔵 Azules (Clase 1)

2️⃣ La frontera de decisión es la línea que separa ambas clases.
- Todo lo que cae en un lado de la línea se clasifica como Clase 0.
- Todo lo que cae en el otro lado se clasifica como Clase 1.

3️⃣ La región sombreada indica cómo el modelo divide el espacio:
- Rojo claro → Zonas donde el modelo predice Clase 0.
- Azul claro → Zonas donde el modelo predice Clase 1.

Interpretación

Si los datos son linealmente separables, el Perceptrón puede encontrar una línea recta para dividirlos.

Si los datos no son separables linealmente, el Perceptrón fallará, y será necesario usar un Perceptrón Multicapa (MLP).

Conclusión:

La frontera de decisión es la separación matemática entre las clases. Este gráfico nos permite ver cómo un modelo divide los datos en función de su aprendizaje. 🚀

Implementación de la Neurona de McCulloch-Pitts para la función AND

# Comentario: Simula una neurona de McCulloch-Pitts para la compuerta logica AND.

import numpy as np

def mcculloch_pitts_neuron(inputs, weights, threshold=1):
    """
    Implementa la neurona de McCulloch-Pitts con función escalón.
    """
    weighted_sum = np.dot(inputs, weights)  # Producto punto entre entradas y pesos
    return 1 if weighted_sum >= threshold else 0

# Prueba con la compuerta lógica AND
weights = [0.5, 0.5]  # Pesos asignados a las entradas
test_cases = [(0, 0), (0, 1), (1, 0), (1, 1)]  # Entradas posibles

print("Entrada  ->  Salida")
for x in test_cases:
    output = mcculloch_pitts_neuron(x, weights)
    print(f"{x} -> {output}")
Entrada  ->  Salida
(0, 0) -> 0
(0, 1) -> 0
(1, 0) -> 0
(1, 1) -> 1

Explicación del Código: Implementación de la Neurona de McCulloch-Pitts para la función AND

Este código implementa una neurona de McCulloch-Pitts, un modelo simple de neurona artificial basado en cálculo de sumas ponderadas y una función escalón para la activación.

¿Cómo Funciona?

1️⃣ Define la función mcculloch_pitts_neuron, que:
- Calcula el producto punto entre las entradas y los pesos.
- Aplica la función de activación escalón (si la suma ponderada es mayor o igual al umbral, devuelve 1, si no, 0).

2️⃣ Asigna pesos y define casos de prueba:
- Usa la compuerta lógica AND, con pesos [0.5, 0.5].
- Prueba con todas las combinaciones posibles de 0 y 1 en las entradas.

3️⃣ Ejecuta el modelo y muestra los resultados:
- Para cada combinación de entrada (x1, x2), calcula la salida de la neurona y la imprime.

Resultado Esperado (Compuerta Lógica AND)

Entrada (x1, x2) Salida y
(0, 0) 0
(0, 1) 0
(1, 0) 0
(1, 1) 1

Explicación de los Resultados

El código sigue el funcionamiento de la compuerta AND, que devuelve 1 solo cuando ambas entradas son 1.

Ejemplo de Cálculo para (1,1):

Producto punto:

(1 * 0.5) + (1 * 0.5) = 0.5 + 0.5 = 1

Comparación con el umbral (threshold=1):
1 >= 1 → Se activa la neurona (Salida = 1)

🔴 Para todas las demás combinaciones, la suma ponderada es menor a 1, por lo que la salida es 0.

Conclusión

  • Este código implementa una neurona artificial básica siguiendo el modelo de McCulloch-Pitts.
  • Solo puede resolver problemas linealmente separables, como la compuerta AND.
  • No puede aprender porque los pesos son fijos (no hay retropropagación ni ajuste de pesos).
  • Si se usara para XOR, fallaría, ya que XOR no es linealmente separable.

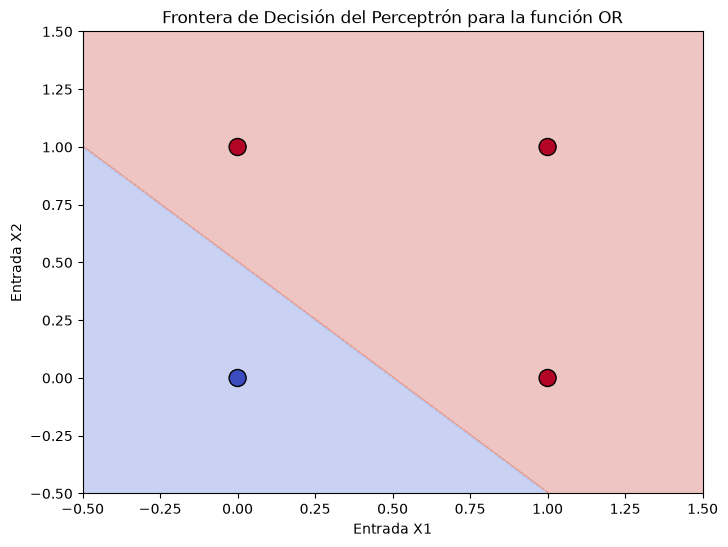
Perceptrón entrenado con la función lógica OR

# Comentario: Entrena un perceptron para OR y grafica la frontera de decision lineal.

#  Implementación de un Perceptrón para la Función OR con Visualización de la Frontera de Decisión

import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import Perceptron

#  1. Datos de entrada (X) y etiquetas esperadas (y) para la compuerta OR
X = np.array([[0,0], [0,1], [1,0], [1,1]])  # Entradas binarias
y = np.array([0, 1, 1, 1])  # Salidas esperadas (función OR)

#  2. Crear y entrenar el perceptrón
perceptron = Perceptron(max_iter=100, eta0=0.1, random_state=42)
perceptron.fit(X, y)

#  3. Evaluación del modelo
predictions = perceptron.predict(X)

#  4. Imprimir resultados de las predicciones
print("Entrada -> Salida (predicción)")
for i in range(len(X)):
    print(f"{X[i]} -> {predictions[i]}")

#  5. Crear una malla para visualizar la frontera de decisión
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
# 6. Predecir sobre la malla
Z = perceptron.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

#  7. Graficar la frontera de decisión
plt.figure(figsize=(8, 6))
plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolors="k", s=150)
plt.title("Frontera de Decisión del Perceptrón para la función OR")
plt.xlabel("Entrada X1")
plt.ylabel("Entrada X2")
plt.show()
Entrada -> Salida (predicción)
[0 0] -> 0
[0 1] -> 1
[1 0] -> 1
[1 1] -> 1

# Comentario: Intenta resolver XOR con perceptron lineal para evidenciar su limitacion.

# Implementación de un Perceptrón para la Función XOR con Visualización de la Frontera de Decisión

import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import Perceptron

# 1. Datos de entrada (X) y etiquetas esperadas (y) para la compuerta XOR
X = np.array([[0,0], [0,1], [1,0], [1,1]])  # Entradas binarias
y = np.array([0, 1, 1, 0])  # Salidas esperadas (función XOR)

# 2. Crear y entrenar el perceptrón
perceptron = Perceptron(max_iter=100, eta0=0.1, random_state=42)
perceptron.fit(X, y)

# 3. Evaluación del modelo
predictions = perceptron.predict(X)

# 4. Imprimir resultados de las predicciones
print("Entrada -> Salida (predicción)")
for i in range(len(X)):
    print(f"{X[i]} -> {predictions[i]}")

# 5. Crear una malla para visualizar la frontera de decisión
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
# 6. Predecir sobre la malla
Z = perceptron.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 7. Graficar la frontera de decisión
plt.figure(figsize=(8, 6))
plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolors="k", s=150)
plt.title("Frontera de Decisión del Perceptrón para la función XOR")
plt.xlabel("Entrada X1")
plt.ylabel("Entrada X2")
plt.show()
Entrada -> Salida (predicción)
[0 0] -> 0
[0 1] -> 0
[1 0] -> 0
[1 1] -> 0

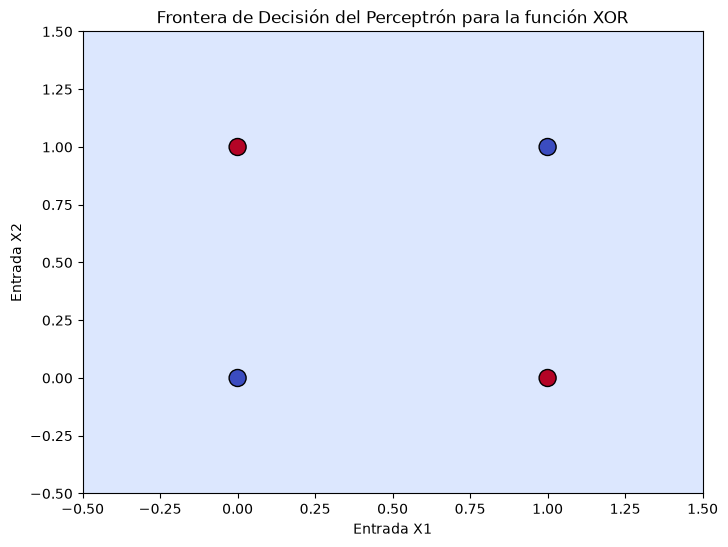
Explicación del Resultado: Perceptrón en la Función XOR

🔴 El Perceptrón falla en aprender la función XOR.


¿Qué está pasando?

1️⃣ Resultados esperados de la función XOR
| Entrada (x1, x2) | Salida esperada y | Predicción del Perceptrón | |——————–|——————|———————-| | (0,0) | 0 | 0 ✅ | | (0,1) | 1 | 0 ❌ | | (1,0) | 1 | 0 ❌ | | (1,1) | 0 | 0 ✅ |

2️⃣ La frontera de decisión es incorrecta
- El Perceptrón clasifica todas las entradas como 0.
- No separa correctamente las clases, porque XOR no es linealmente separable.

3️⃣ ¿Por qué falla el Perceptrón?
- El Perceptrón solo puede aprender fronteras de decisión lineales.
- XOR requiere una frontera de decisión más compleja (no lineal).
- Se necesita una Red Neuronal con más de una capa (Perceptrón Multicapa - MLP).


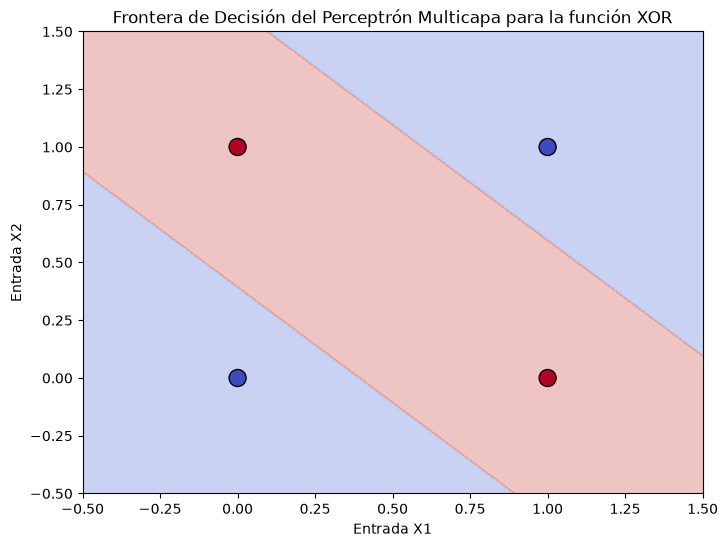
Solución: Usar un Perceptrón Multicapa (MLP)

✅ Para resolver XOR, usar una red neuronal con capas ocultas y activaciones no lineales como ReLU o Sigmoid.

# Comentario: Usa un MLP para resolver XOR y mostrar una frontera no lineal.

# Implementación de un Perceptrón Multicapa (MLP) para la Función XOR

import numpy as np
import matplotlib.pyplot as plt
from sklearn.neural_network import MLPClassifier

# 1. Datos de entrada (X) y etiquetas esperadas (y) para la compuerta XOR
X = np.array([[0,0], [0,1], [1,0], [1,1]])  # Entradas binarias
y = np.array([0, 1, 1, 0])  # Salidas esperadas (función XOR)

# 2. Crear y entrenar un Perceptrón Multicapa (MLP) con parámetros ajustados
mlp = MLPClassifier(hidden_layer_sizes=(8, 4), activation='tanh', solver='adam', 
                    alpha=0.001, max_iter=20000, random_state=42, tol=1e-7)
mlp.fit(X, y)

# 3. Evaluación del modelo
predictions = mlp.predict(X)

# 4. Imprimir resultados de las predicciones
print("Entrada -> Salida (predicción)")
for i in range(len(X)):
    print(f"{X[i]} -> {predictions[i]}")

# 5. Crear una malla para visualizar la frontera de decisión
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))

# 6. Predecir sobre la malla
Z = mlp.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 7. Graficar la frontera de decisión
plt.figure(figsize=(8, 6))
plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolors="k", s=150)
plt.title("Frontera de Decisión del Perceptrón Multicapa para la función XOR")
plt.xlabel("Entrada X1")
plt.ylabel("Entrada X2")
plt.show()
Entrada -> Salida (predicción)
[0 0] -> 0
[0 1] -> 1
[1 0] -> 1
[1 1] -> 0

Ejemplos varios con perceptrones

Clasificación Binaria con Perceptrón Simple

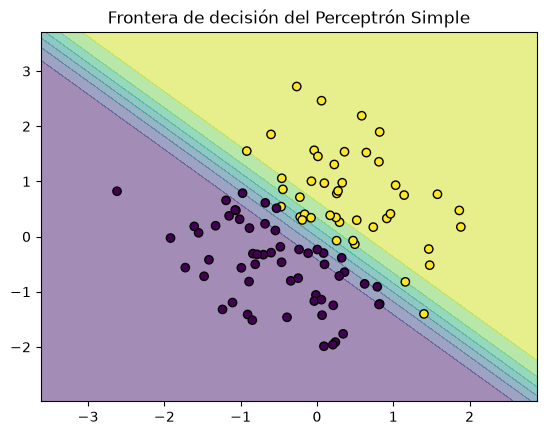
Usar el perceptrón para resolver un problema de clasificación binaria simple: la clasificación de puntos en el plano (2D) según si están por encima o por debajo de una línea recta

# Comentario: Entrena un perceptron simple en PyTorch con datos 2D y visualiza resultados.

import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torch.optim as optim

# Generación de datos de ejemplo
np.random.seed(42)
X = np.random.randn(100, 2)
y = np.array([1 if x[0] + x[1] > 0 else 0 for x in X])

# Convertir a tensores
X_tensor = torch.tensor(X, dtype=torch.float32)
y_tensor = torch.tensor(y, dtype=torch.float32).view(-1, 1)

# Definición del perceptrón simple
class Perceptron(nn.Module):
    def __init__(self):
        super(Perceptron, self).__init__()
        self.linear = nn.Linear(2, 1)

    def forward(self, x):
        return torch.sigmoid(self.linear(x))

model = Perceptron()
criterion = nn.BCELoss()
optimizer = optim.SGD(model.parameters(), lr=0.1)

# Entrenamiento del perceptrón
epochs = 1000
for epoch in range(epochs):
    optimizer.zero_grad()
    outputs = model(X_tensor)
    loss = criterion(outputs, y_tensor)
    loss.backward()
    optimizer.step()

# Visualización de resultados
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.1), np.arange(y_min, y_max, 0.1))
grid = torch.tensor(np.c_[xx.ravel(), yy.ravel()], dtype=torch.float32)
probs = model(grid).detach().numpy().reshape(xx.shape)

plt.contourf(xx, yy, probs, alpha=0.5)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolor='k')
plt.title('Frontera de decisión del Perceptrón Simple')
plt.show()

En este ejemplo, se crea un Perceptrón Simple usando PyTorch para clasificar puntos en un plano según si están por encima o por debajo de una línea. Primero, se generan datos aleatorios en 2D y se asigna una etiqueta (0 o 1) según la posición del punto. Luego, se define el modelo del perceptrón como una red muy simple que toma dos números como entrada y devuelve una probabilidad usando la función sigmoide. El entrenamiento se realiza ajustando los pesos para que el modelo acierte lo más posible, usando una técnica llamada Gradiente Descendente Estocástico (SGD). PyTorch facilita el manejo de estos cálculos automáticamente. Finalmente, se visualiza cómo el modelo aprendió a separar los puntos mostrando una línea de decisión en el gráfico.

Proceso de datos en forma de espiral

# Comentario: Genera datos en espiral y entrena un MLP en PyTorch para clasificacion no lineal.

import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torch.optim as optim

# Generación de datos en forma de espiral
def generate_spiral_data(points, classes):
    X = np.zeros((points * classes, 2), dtype=np.float32)
    y = np.zeros((points * classes, 1), dtype=np.float32)
    for class_number in range(classes):
        ix = range(points * class_number, points * (class_number + 1))
        r = np.linspace(0.0, 1, points)  # Radio
        t = np.linspace(class_number * 4, (class_number + 1) * 4, points) + np.random.randn(points) * 0.2  # Ángulo
        X[ix] = np.c_[r * np.sin(t), r * np.cos(t)]
        y[ix] = class_number % 2
    return X, y

# Crear el conjunto de datos
X, y = generate_spiral_data(100, 2)
X_tensor = torch.tensor(X, dtype=torch.float32)
y_tensor = torch.tensor(y, dtype=torch.float32)

# Definición del MLP para clasificar los puntos en espiral
class SpiralMLP(nn.Module):
    def __init__(self):
        super(SpiralMLP, self).__init__()
        self.hidden = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 8),
            nn.ReLU(),
            nn.Linear(8, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        return self.hidden(x)

model = SpiralMLP()
criterion = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

# Entrenamiento del modelo
for epoch in range(3000):
    optimizer.zero_grad()
    outputs = model(X_tensor)
    loss = criterion(outputs, y_tensor)
    loss.backward()
    optimizer.step()

# Visualización de la frontera de decisión
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
grid = torch.tensor(np.c_[xx.ravel(), yy.ravel()], dtype=torch.float32)
probs = model(grid).detach().numpy().reshape(xx.shape)

plt.figure(figsize=(8, 8))
plt.contourf(xx, yy, probs, alpha=0.6, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y.ravel(), cmap=plt.cm.coolwarm, edgecolor="k")
plt.title("Frontera de Decisión del Perceptrón Multicapa para Datos en Espiral")
plt.show()

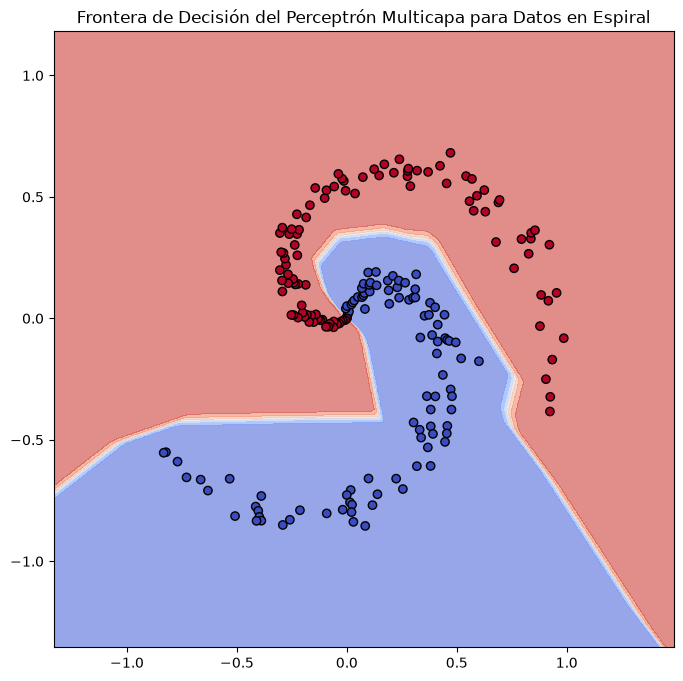
Ejemplo Práctico: Clasificación de Puntos en Espiral usando un Perceptrón Multicapa (MLP)

¿Qué queremos lograr?

Resolver un problema complejo de clasificación en el que los puntos de diferentes clases están dispuestos en forma de espiral. Este tipo de datos es un ejemplo típico de problema no lineal donde un perceptrón simple falla, pero un MLP con múltiples capas ocultas puede tener éxito.


Paso 1: Generación de Datos en Forma de Espiral

El objetivo es crear dos conjuntos de puntos que forman espirales intercaladas. Esto crea un problema de clasificación difícil porque las clases están enredadas entre sí.

Código: Generación de datos
def generate_spiral_data(points, classes):
    X = np.zeros((points * classes, 2), dtype=np.float32)
    y = np.zeros((points * classes, 1), dtype=np.float32)
    for class_number in range(classes):
        ix = range(points * class_number, points * (class_number + 1))
        r = np.linspace(0.0, 1, points)  # Radio creciente
        t = np.linspace(class_number * 4, (class_number + 1) * 4, points) + np.random.randn(points) * 0.2  # Ángulo
        X[ix] = np.c_[r * np.sin(t), r * np.cos(t)]
        y[ix] = class_number % 2  # Alterna entre 0 y 1
    return X, y
  • Datos en espiral: Los puntos están organizados en dos espirales intercaladas.
  • Radio: Aumenta progresivamente para formar una curva.
  • Ángulo: Se desplaza según la clase, más un pequeño ruido para aleatoriedad.

Paso 2: Definición del Perceptrón Multicapa (MLP)

El modelo consta de tres capas:
1. Capa oculta 1: 16 neuronas con activación ReLU.
2. Capa oculta 2: 8 neuronas con activación ReLU.
3. Capa de salida: 1 neurona con activación Sigmoid (para clasificación binaria).

Código: Modelo MLP
class SpiralMLP(nn.Module):
    def __init__(self):
        super(SpiralMLP, self).__init__()
        self.hidden = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 8),
            nn.ReLU(),
            nn.Linear(8, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        return self.hidden(x)
  • Arquitectura en capas: El modelo tiene múltiples capas ocultas para aprender la complejidad de la forma de espiral.
  • Funciones de activación ReLU: Proporcionan no linealidad, esencial para aprender el patrón complejo.
  • Salida Sigmoid: Devuelve una probabilidad entre 0 y 1.

Paso 3: Entrenamiento del Modelo

  • Optimización: Se utiliza el optimizador Adam para mejorar la eficiencia.
  • Función de pérdida: BCELoss (Binary Cross Entropy) para problemas de clasificación binaria.
  • Iteraciones: Entrenamiento durante 3000 épocas para garantizar la convergencia.
Código: Entrenamiento
model = SpiralMLP()
criterion = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

for epoch in range(3000):
    optimizer.zero_grad()
    outputs = model(X_tensor)
    loss = criterion(outputs, y_tensor)
    loss.backward()
    optimizer.step()
  • Gradiente descendente: El modelo ajusta los pesos para minimizar la pérdida en cada época.
  • Optimizador Adam: Ajusta el aprendizaje adaptativamente.

Paso 4: Visualización de la Frontera de Decisión

Creamos una malla de puntos en el espacio de entrada para visualizar cómo el MLP separa las dos clases en espiral.

Código: Visualización
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
grid = torch.tensor(np.c_[xx.ravel(), yy.ravel()], dtype=torch.float32)
probs = model(grid).detach().numpy().reshape(xx.shape)

plt.figure(figsize=(8, 8))
plt.contourf(xx, yy, probs, alpha=0.6, cmap=plt.cm.coolwarm)
plt.scatter(X[:, 0], X[:, 1], c=y.ravel(), cmap=plt.cm.coolwarm, edgecolor="k")
plt.title("Frontera de Decisión del Perceptrón Multicapa para Datos en Espiral")
plt.show()
  • Frontera de decisión: Visualiza cómo el modelo clasifica cada punto en la espiral.
  • Colores: Diferencian las clases en el gráfico.

Conclusión

Este ejemplo muestra cómo un Perceptrón Multicapa (MLP) puede resolver problemas complejos como la clasificación de datos en espiral, que no pueden ser separados por un modelo lineal. Gracias a sus capas ocultas y funciones de activación no lineales, el MLP logra aprender la compleja estructura de los datos.

Generación de datos sintéticos

# Comentario: Genera y visualiza varios datasets sinteticos para clasificacion.

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons, make_circles, make_classification, make_blobs, make_gaussian_quantiles, make_multilabel_classification

# Función para visualizar los datos con categorías destacadas
def plot_dataset(X, y, title):
    plt.figure(figsize=(6, 6))
    cmap = plt.get_cmap("Set1", np.unique(y).size)
    scatter = plt.scatter(X[:, 0], X[:, 1], c=y, cmap=cmap, edgecolor='k', s=100, alpha=0.7)
    plt.title(title, fontsize=14)
    plt.xlabel("X1")
    plt.ylabel("X2")
    plt.colorbar(scatter, ticks=range(np.unique(y).size))
    plt.grid(True)
    plt.show()

# Generación y visualización de datos usando diferentes métodos

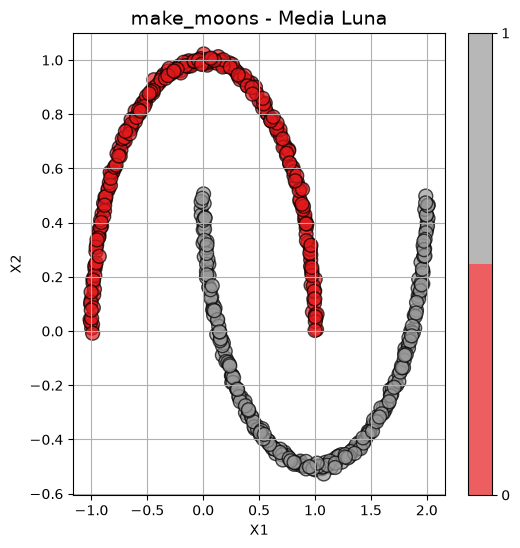
# 1. make_moons - Genera dos conjuntos de datos en forma de media luna.
#    - n_samples: número total de puntos (aumentado a 500 para mejor separación)
#    - noise: cantidad de ruido aleatorio (0.2 para mantener variabilidad realista)
X, y = make_moons(n_samples=500, noise=0.01, random_state=0)
plot_dataset(X, y, "make_moons - Media Luna")

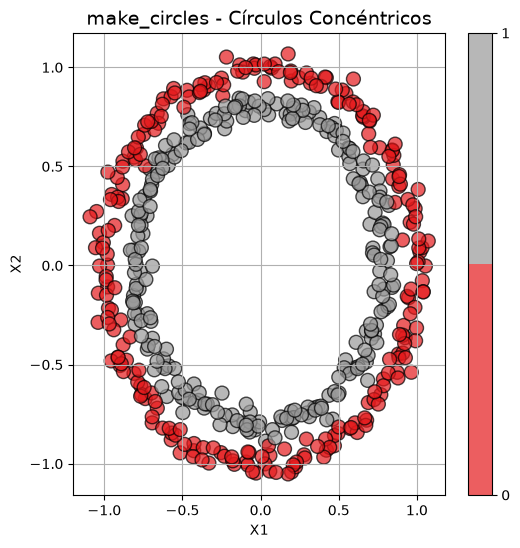
# 2. make_circles - Genera dos círculos concéntricos.
#    - n_samples: número total de puntos (aumentado a 500)
#    - noise: ruido aleatorio (0.04 para mantener variabilidad moderada)
#    - factor: radio del círculo interno respecto al externo (0.8 para mejor visualización)
X, y = make_circles(n_samples=500, noise=0.04, factor=0.8, random_state=0)
plot_dataset(X, y, "make_circles - Círculos Concéntricos")

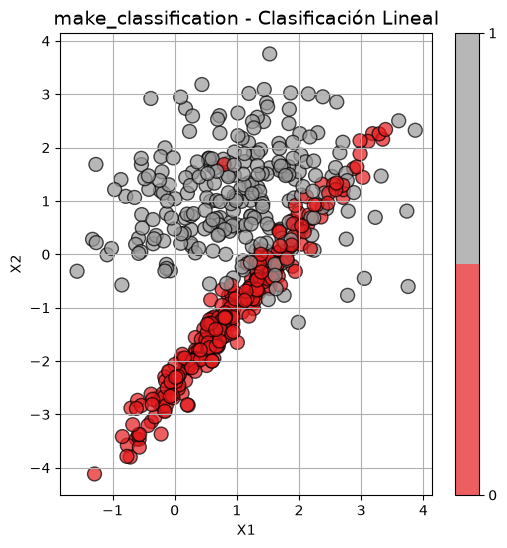
# 3. make_classification - Genera datos para clasificación lineal.
#    - n_samples: número de muestras (500)
#    - n_features: número de características (2 para visualización 2D)
#    - n_redundant: características redundantes (0 para simplicidad)
#    - n_informative: características útiles (2 para el problema)
#    - n_clusters_per_class: número de grupos por clase (1 para mejor separación)
X, y = make_classification(n_samples=500, n_features=2, n_redundant=0, n_informative=2, n_clusters_per_class=1, random_state=0)
plot_dataset(X, y, "make_classification - Clasificación Lineal")

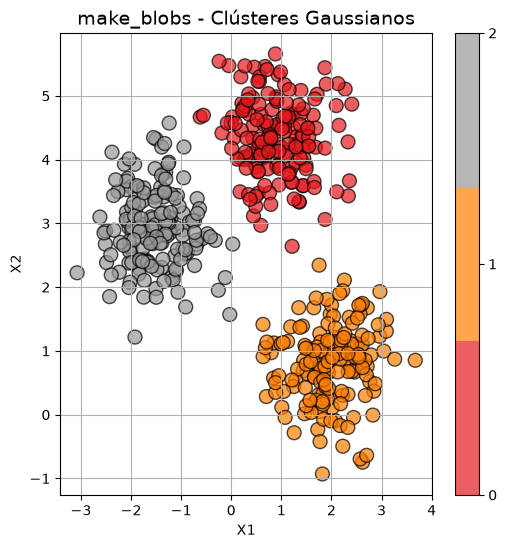
# 4. make_blobs - Genera varios grupos de puntos alrededor de centros.
#    - n_samples: número de puntos (500)
#    - centers: cantidad de grupos (3)
#    - cluster_std: desviación estándar del grupo (0.6 para menos solapamiento)
X, y = make_blobs(n_samples=500, centers=3, cluster_std=0.6, random_state=0)
plot_dataset(X, y, "make_blobs - Clústeres Gaussianos")

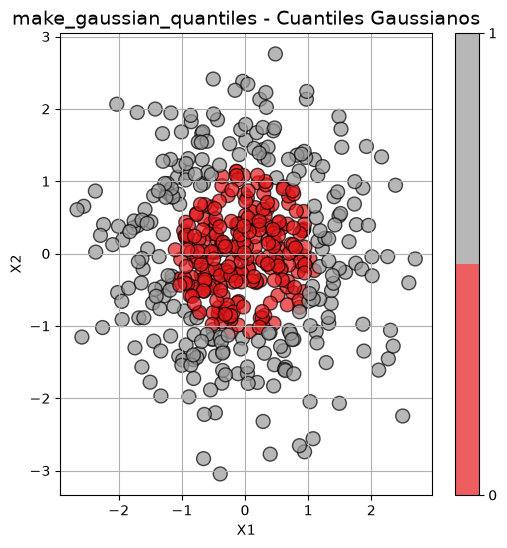
# 5. make_gaussian_quantiles - Genera datos agrupados según cuantiles gaussianos.
#    - n_samples: número de muestras (500)
#    - n_classes: número de clases (2 para clasificación binaria)
X, y = make_gaussian_quantiles(n_samples=500, n_classes=2, random_state=0)
plot_dataset(X, y, "make_gaussian_quantiles - Cuantiles Gaussianos")

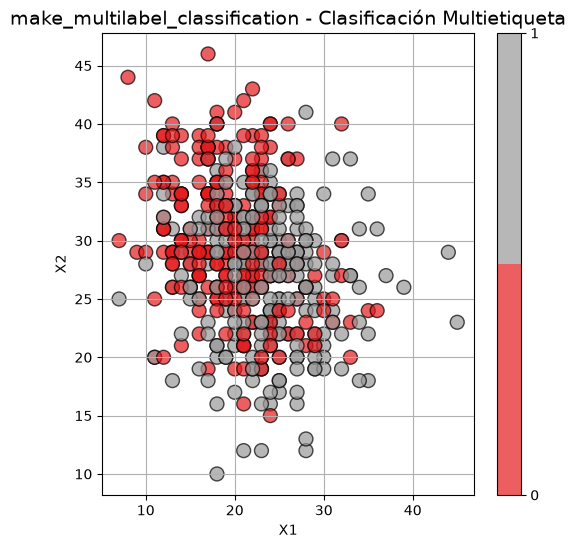
# 6. make_multilabel_classification - Genera datos para problemas multietiqueta.
#    - n_samples: número de muestras (500)
#    - n_features: número de características (2 para visualización)
#    - n_classes: número de etiquetas posibles (3)
#    - n_labels: promedio de etiquetas por instancia (2)
X, y = make_multilabel_classification(n_samples=500, n_features=2, n_classes=3, n_labels=2, random_state=0)
plot_dataset(X, y[:, 0], "make_multilabel_classification - Clasificación Multietiqueta")

Perceptrón y make_moons

# Comentario: Entrena y evalua un MLP con make_moons usando separacion train/test.

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

# Generación de datos make_moons
X, y = make_moons(n_samples=500, noise=0.2, random_state=0)

# Separación en entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Creación del Perceptrón Multicapa (MLP)
mlp = MLPClassifier(
    hidden_layer_sizes=(10, 5),
    activation='relu',
    solver='adam',
    max_iter=3000,
    random_state=42
)

# Entrenamiento del modelo
mlp.fit(X_train, y_train)

# Predicción en datos de prueba
y_pred = mlp.predict(X_test)

# Visualización de la frontera de decisión
def plot_decision_boundary(X, y, model):
    x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
    y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
    xx, yy = np.meshgrid(np.linspace(x_min, x_max, 100), np.linspace(y_min, y_max, 100))
    Z = model.predict(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
    plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
    plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolor='k')
    plt.title("Frontera de Decisión del Perceptrón Multicapa - make_moons")
    plt.xlabel("X1")
    plt.ylabel("X2")
    plt.show()

# Llamada a la función de visualización (sobre todo el dataset)
plot_decision_boundary(X, y, mlp)

# Imprimir precisión en entrenamiento y prueba
print(f"Precisión en entrenamiento: {mlp.score(X_train, y_train) * 100:.2f}%")
print(f"Precisión en prueba: {mlp.score(X_test, y_test) * 100:.2f}%")

Precisión en entrenamiento: 96.50%
Precisión en prueba: 91.00%

Perceptrón Multicapa usando Make Moons

Introducción

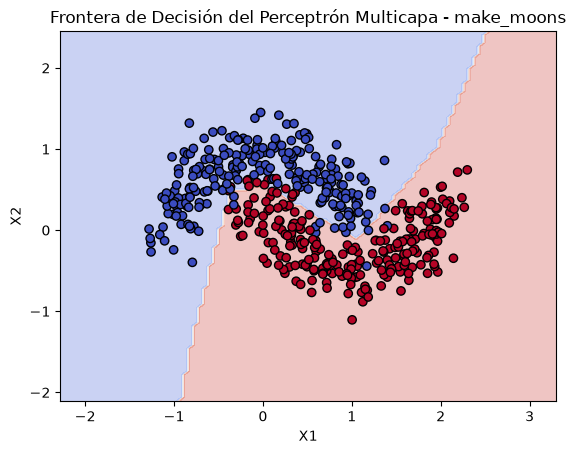
Este ejemplo utiliza un Perceptrón Multicapa (MLP) para clasificar datos generados con la función make_moons, que produce dos conjuntos de puntos en forma de media luna intercalados. Este tipo de datos no es linealmente separable, por lo que un perceptrón simple no es suficiente. El MLP permite aprender fronteras de decisión no lineales.


1. Generación de Datos - Make Moons

X, y = make_moons(n_samples=500, noise=0.1, random_state=0)
  • n_samples=500: más datos para entrenar mejor.
  • noise=0.1: mantiene cierta dificultad sin perder separación visual.
  • random_state=0: garantiza reproducibilidad.

2. Separación en Entrenamiento y Prueba

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
  • test_size=0.2: usa 80% para entrenar y 20% para evaluar generalización.
  • stratify=y: conserva la proporción de clases en ambos conjuntos.

3. Creación del Perceptrón Multicapa (MLP)

mlp = MLPClassifier(
    hidden_layer_sizes=(10, 5),
    activation='relu',
    solver='adam',
    max_iter=3000,
    random_state=42
)
  • hidden_layer_sizes=(10, 5): dos capas ocultas para capturar no linealidad.
  • activation=‘relu’: mejora aprendizaje en fronteras complejas.
  • solver=‘adam’: optimizador eficiente para este problema.
  • max_iter=3000: más iteraciones para reducir riesgo de no convergencia.
  • random_state=42: resultados reproducibles.

4. Entrenamiento y Evaluación

mlp.fit(X_train, y_train)
print(f"Precisión en entrenamiento: {mlp.score(X_train, y_train) * 100:.2f}%")
print(f"Precisión en prueba: {mlp.score(X_test, y_test) * 100:.2f}%")
  • La precisión en entrenamiento indica qué tan bien ajusta los datos vistos.
  • La precisión en prueba mide capacidad de generalización.

5. Visualización de la Frontera de Decisión

def plot_decision_boundary(X, y, model):
    x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
    y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
    xx, yy = np.meshgrid(np.linspace(x_min, x_max, 100), np.linspace(y_min, y_max, 100))
    Z = model.predict(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
    plt.contourf(xx, yy, Z, alpha=0.3, cmap=plt.cm.coolwarm)
    plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, edgecolor='k')
    plt.title("Frontera de Decisión del Perceptrón Multicapa - make_moons")
    plt.xlabel("X1")
    plt.ylabel("X2")
    plt.show()
  • Muestra cómo el modelo separa ambas clases en el plano.

Conclusión

El Perceptrón Multicapa (MLP) aprende una frontera no lineal adecuada para make_moons. La separación train/test permite una evaluación más realista del modelo y evita sobreestimar su desempeño.

Dígitos escritos a mano

# Comentario: Explora el dataset de digitos y visualiza ejemplos.

import matplotlib.pyplot as plt
from sklearn.datasets import load_digits

# Cargar el dataset de dígitos escritos a mano
digits = load_digits()

# Mostrar información básica del dataset
print(f"Número de imágenes: {len(digits.images)}")
print(f"Dimensiones de cada imagen: {digits.images[0].shape}")
print(f"Etiquetas disponibles: {set(digits.target)}")

# Visualizar los primeros 10 dígitos con tamaño más pequeño
plt.figure(figsize=(2, 1.5))
for i in range(10):
    plt.subplot(1, 10, i + 1)
    plt.imshow(digits.images[i], cmap='gray')
    plt.title(f"{digits.target[i]}")
    plt.axis('off')

plt.suptitle("Primeros 10 dígitos del dataset")
plt.show()
Número de imágenes: 1797
Dimensiones de cada imagen: (8, 8)
Etiquetas disponibles: {np.int64(0), np.int64(1), np.int64(2), np.int64(3), np.int64(4), np.int64(5), np.int64(6), np.int64(7), np.int64(8), np.int64(9)}

Caras

Nota: los siguientes ejemplos descargan datasets desde internet la primera vez. Si no hay conexión, pueden fallar temporalmente.

# Comentario: Carga y visualiza el dataset Olivetti de rostros.

import matplotlib.pyplot as plt
from sklearn.datasets import fetch_olivetti_faces

# Nota: este dataset se descarga de internet en la primera ejecución.
# Cargar el dataset de caras humanas
dataset = fetch_olivetti_faces()
X, y = dataset.images, dataset.target

# Mostrar información básica del dataset
print(f"Número de imágenes: {len(X)}")
print(f"Dimensiones de cada imagen: {X[0].shape}")
print(f"Número de personas: {len(set(y))}")

# Visualizar las primeras 10 caras con tamaño pequeño
plt.figure(figsize=(8, 1.5))
for i in range(10):
    plt.subplot(1, 10, i + 1)
    plt.imshow(X[i], cmap='gray')
    plt.title(f"{y[i]}")
    plt.axis('off')

plt.suptitle("Primeras 10 caras del dataset")
plt.show()
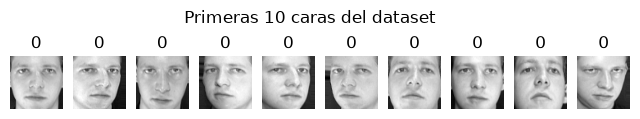
Número de imágenes: 400
Dimensiones de cada imagen: (64, 64)
Número de personas: 40

# Comentario: Carga y visualiza el dataset LFW de rostros etiquetados.

import matplotlib.pyplot as plt
from sklearn.datasets import fetch_lfw_people

# Nota: este dataset se descarga de internet en la primera ejecución.
# Cargar el dataset de caras etiquetadas en la naturaleza (LFW)
faces = fetch_lfw_people(min_faces_per_person=70, resize=0.4)
X, y = faces.images, faces.target

# Mostrar información básica del dataset
print(f"Número de imágenes: {len(X)}")
print(f"Dimensiones de cada imagen: {X[0].shape}")
print(f"Número de personas: {len(faces.target_names)}")
print(f"Personas identificadas: {faces.target_names}")

# Visualizar las primeras 10 caras con tamaño pequeño
plt.figure(figsize=(12, 4))
for i in range(10):
    plt.subplot(2, 5, i + 1)
    plt.imshow(X[i], cmap='gray')
    plt.title(faces.target_names[y[i]])
    plt.axis('off')

plt.suptitle("Primeras 10 caras del dataset LFW")
plt.show()
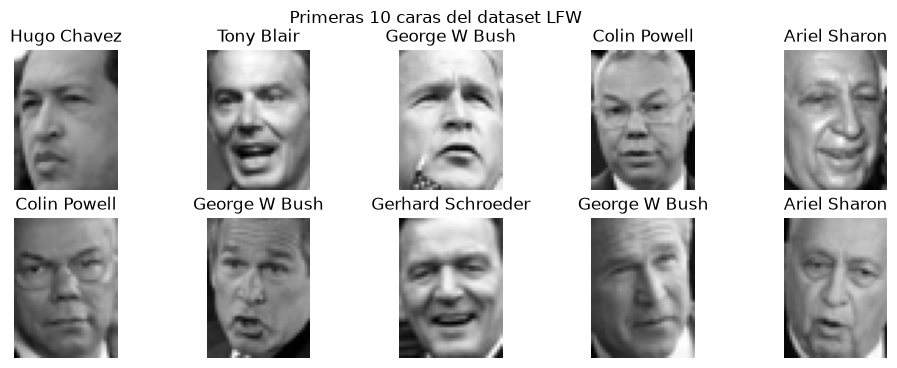
Número de imágenes: 1288
Dimensiones de cada imagen: (50, 37)
Número de personas: 7
Personas identificadas: ['Ariel Sharon' 'Colin Powell' 'Donald Rumsfeld' 'George W Bush'
 'Gerhard Schroeder' 'Hugo Chavez' 'Tony Blair']

Identificando patrones escritos a mano con un perceptrón

# Comentario: Entrena un MLP para reconocer digitos y reporta metricas de desempeno.

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# Cargar el conjunto de datos de dígitos escritos a mano
digits = load_digits()
X, y = digits.data, digits.target

# Dividir el conjunto de datos en entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Crear el Perceptrón Multicapa (MLP) para clasificación de dígitos
mlp = MLPClassifier(hidden_layer_sizes=(64, 32), activation='tanh', solver='adam', max_iter=500, random_state=42)

# Entrenar el modelo
mlp.fit(X_train, y_train)

# Realizar predicciones
y_pred = mlp.predict(X_test)

# Evaluación del modelo
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del Perceptrón Multicapa: {accuracy * 100:.2f}%")
print("\nReporte de Clasificación:\n", classification_report(y_test, y_pred))

# Matriz de confusión
conf_matrix = confusion_matrix(y_test, y_pred)
print("\nMatriz de Confusión:\n", conf_matrix)

# Visualización de algunas predicciones
fig, axes = plt.subplots(2, 5, figsize=(10, 5))
for i, ax in enumerate(axes.ravel()):
    ax.imshow(X_test[i].reshape(8, 8), cmap='gray')
    ax.set_title(f"Pred: {y_pred[i]}")
    ax.axis('off')
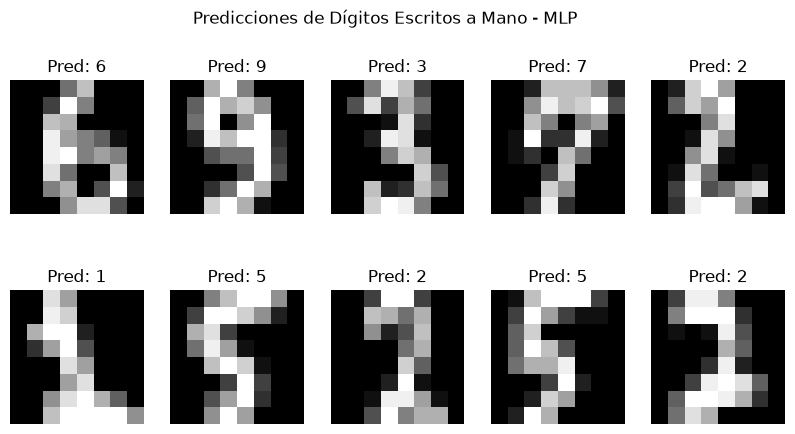
plt.suptitle("Predicciones de Dígitos Escritos a Mano - MLP")
plt.show()
Precisión del Perceptrón Multicapa: 98.06%

Reporte de Clasificación:
               precision    recall  f1-score   support

           0       1.00      0.97      0.98        33
           1       1.00      1.00      1.00        28
           2       1.00      1.00      1.00        33
           3       1.00      0.97      0.99        34
           4       1.00      1.00      1.00        46
           5       0.92      0.98      0.95        47
           6       0.97      0.97      0.97        35
           7       0.97      0.97      0.97        34
           8       0.97      0.97      0.97        30
           9       1.00      0.97      0.99        40

    accuracy                           0.98       360
   macro avg       0.98      0.98      0.98       360
weighted avg       0.98      0.98      0.98       360


Matriz de Confusión:
 [[32  0  0  0  0  0  0  1  0  0]
 [ 0 28  0  0  0  0  0  0  0  0]
 [ 0  0 33  0  0  0  0  0  0  0]
 [ 0  0  0 33  0  1  0  0  0  0]
 [ 0  0  0  0 46  0  0  0  0  0]
 [ 0  0  0  0  0 46  1  0  0  0]
 [ 0  0  0  0  0  1 34  0  0  0]
 [ 0  0  0  0  0  1  0 33  0  0]
 [ 0  0  0  0  0  1  0  0 29  0]
 [ 0  0  0  0  0  0  0  0  1 39]]

Taller

# Comentario: Celda de taller para ejercicios practicos de clase.

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.