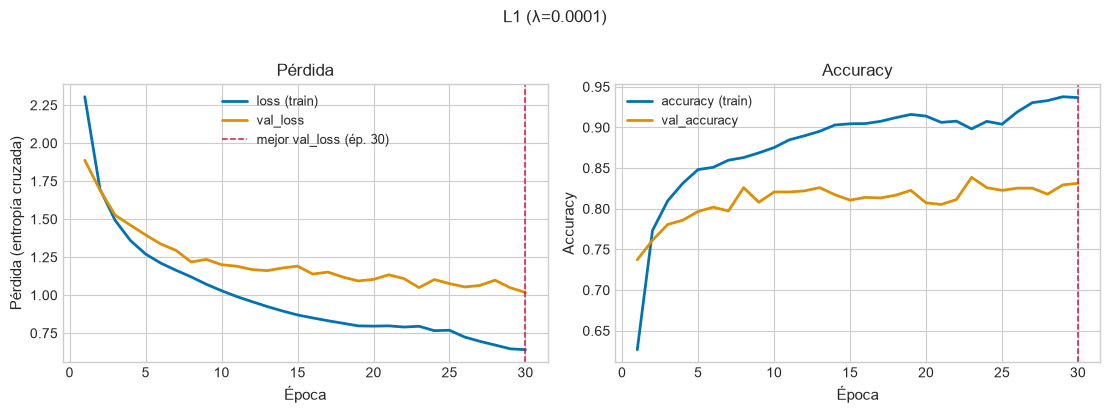
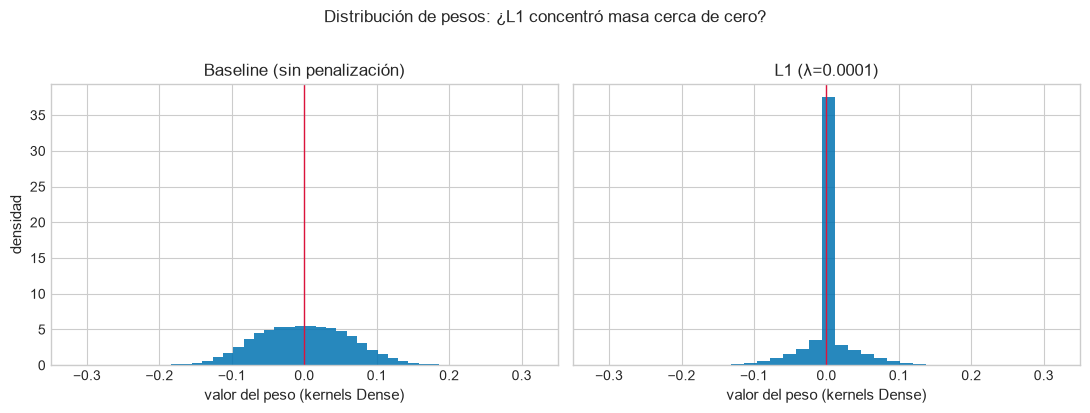
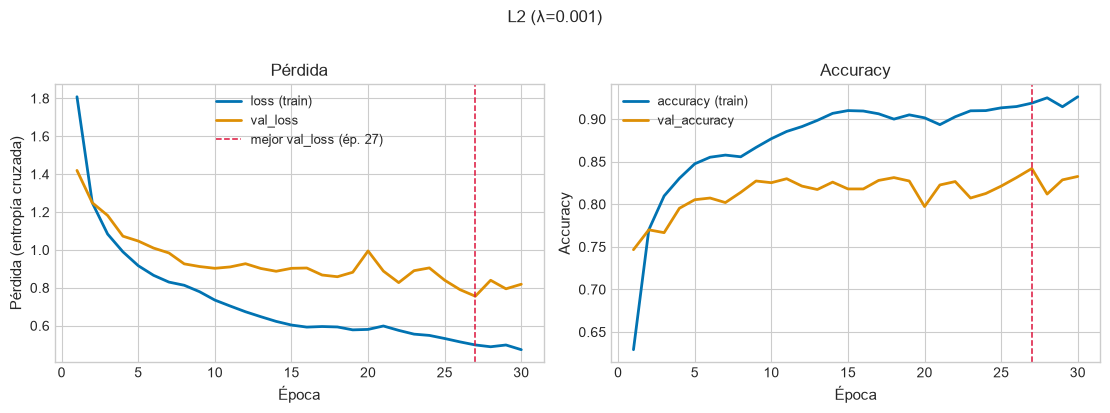
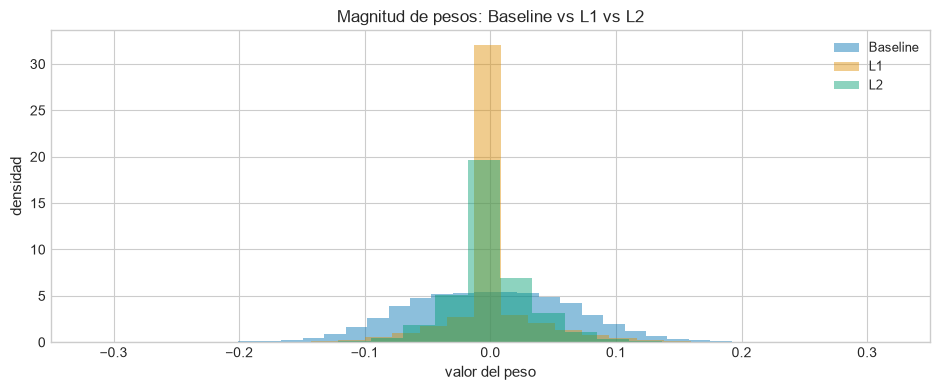
Técnicas para mejorar la generalización

deep-learning
regularizacion
generalizacion
L1, L2, Dropout, Batch Normalization, Early Stopping y comparación de hiperparámetros.
Author

Wilder Ramírez Delgado

Published

September 1, 2026

Técnicas para mejorar la generalización

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este notebook revisamos L1, L2, Dropout, Batch Normalization, Early Stopping y la comparación de hiperparámetros para mejorar la generalización, midiendo cada intervención sobre datos que el modelo no usó para entrenar.

1. Introducción

Pregunta que organiza toda la sesión

Ya sabemos construir, entrenar y evaluar una red neuronal. ¿Qué podemos hacer cuando el modelo aprende muy bien los datos de entrenamiento pero no logra generalizar correctamente a datos nuevos?

Esta no es una sesión sobre cómo escribir Dropout(...), kernel_regularizer=... o EarlyStopping(...). Esas líneas son instrumentos. El aprendizaje central es el proceso de decisión que las justifica:

observar → medir → interpretar → diagnosticar → intervenir → volver a medir → comparar → concluir.

Al terminar, usted debería poder mirar un history, un par de curvas, una tabla de resultados, una matriz de confusión o un classification_report y construir una conclusión razonada —no un veredicto automático— sobre underfitting, overfitting, estabilidad y el efecto de una intervención.

Qué ya se da por conocido

Perceptrón, neurona, MLP, activaciones, forward propagation, funciones de pérdida, descenso de gradiente, backpropagation, clasificación, matriz de confusión, accuracy, precision, recall, F1, probabilidades, umbral, ROC y AUC. Cuando alguno de estos conceptos sea decisivo para leer un resultado, se recordará brevemente.

Cómo leer este notebook

Cada resultado importante se interroga con las mismas seis preguntas:

  1. ¿Qué estamos viendo?
  2. ¿Qué valores son importantes?
  3. ¿Qué comparación debemos realizar?
  4. ¿Qué podemos inferir?
  5. ¿Qué no podemos afirmar solamente con esta evidencia?
  6. ¿Cuál sería el siguiente paso razonable?

Las cifras concretas (época de menor val_loss, gaps, accuracies) no se anticipan en el texto. Se calculan en código a partir de history, evaluate(), reportes y tablas. Si re-ejecuta el notebook, el análisis se actualiza con esos resultados.

Tres distinciones que usaremos una y otra vez:

Nivel Pregunta Ejemplo
Observación ¿Qué ocurrió en los números o en la gráfica? “val_loss aumenta después de cierta época mientras loss sigue bajando.”
Inferencia ¿Qué hipótesis es compatible con eso? “El patrón es compatible con sobreajuste.”
Decisión ¿Qué haríamos ahora y por qué? “Probar Early Stopping, regularización o reducir capacidad.”

Observar no es inferir. Inferir no es decidir.

Una métrica no es una conclusión. Es evidencia para construir una conclusión.

La secuencia de trabajo es medir → observar → comparar → inferir → decidir → volver a medir.

Mapa de la sesión

  1. El problema de generalizar
  2. Underfitting, buen ajuste y overfitting
  3. Bias–variance tradeoff
  4. Dataset y diseño experimental
  5. Modelo baseline
  6. Cómo leer un history de Keras
  7. Regularización L1
  8. Regularización L2
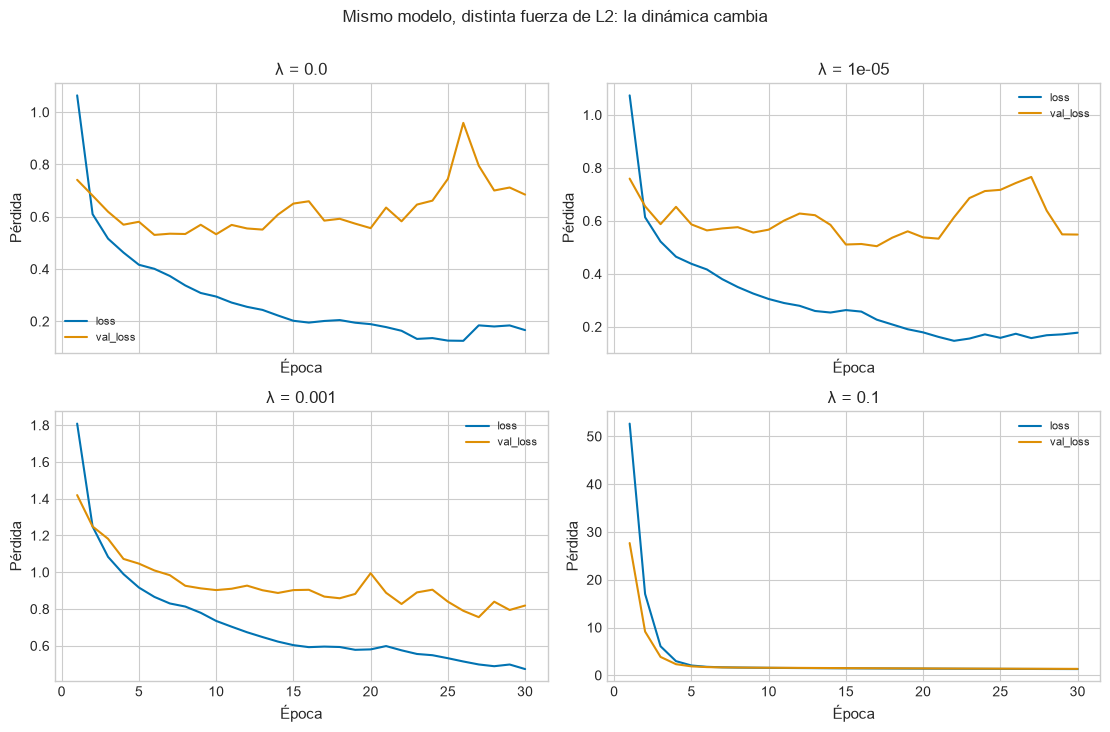
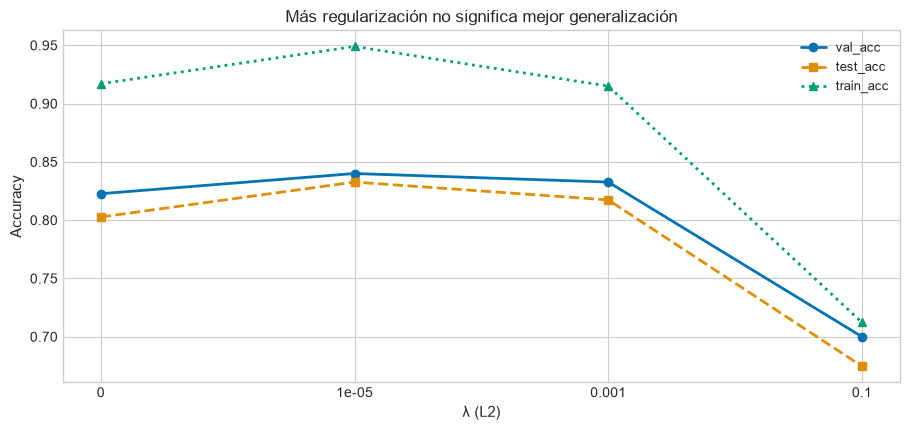
  9. Experimento sobre \(\lambda\)
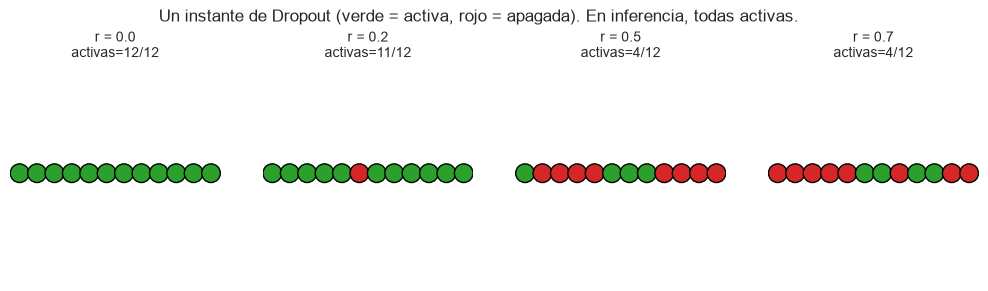
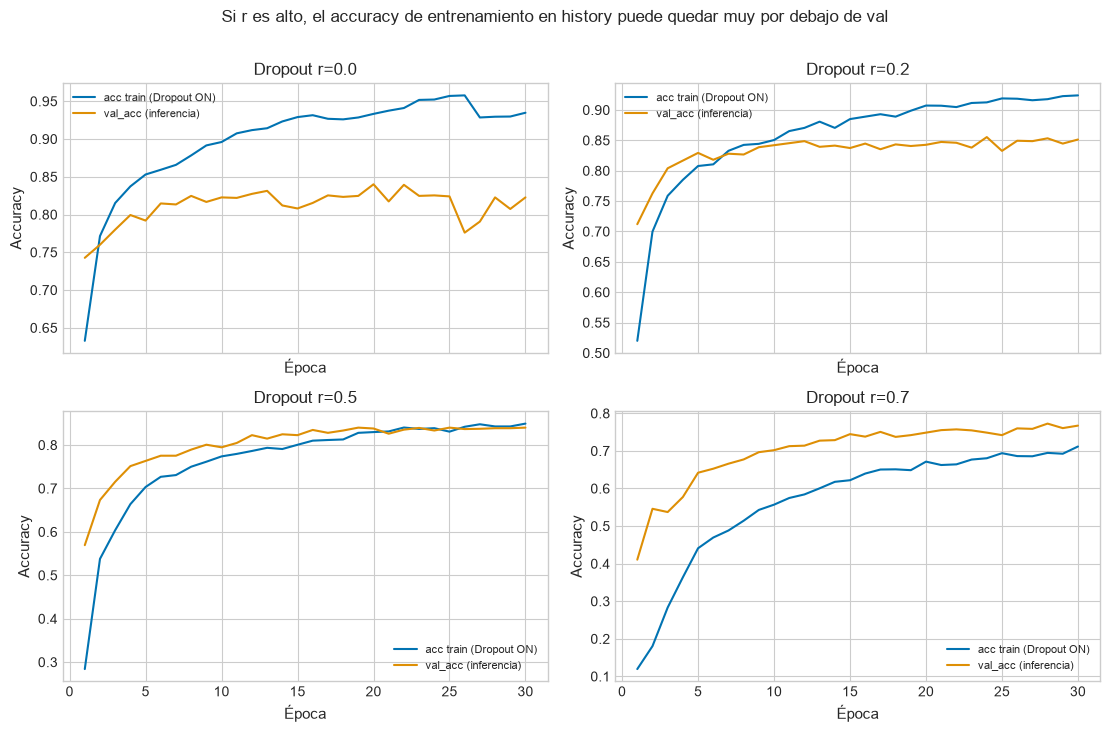
  10. Dropout
  11. Batch Normalization
  12. Early Stopping
  13. Parámetros e hiperparámetros
  14. Ajuste de hiperparámetros
  15. Comparación general
  16. Reportes de evaluación final
  17. Guía diagnóstica, conclusión y ejercicios

0. Entorno, reproducibilidad y criterio experimental

Un experimento de Deep Learning no comienza en la arquitectura. Comienza en el control de condiciones: semillas, particiones, métricas y el registro de lo que se modifica. Sin eso, dos curvas distintas pueden deberse al azar de la inicialización y no a la técnica que pretendemos evaluar.

Fijar semillas no elimina toda la variabilidad (el orden de los lotes, implementaciones de GPU y operaciones no deterministas pueden persistir), pero reduce una fuente importante de ruido y hace las comparaciones más interpretables. Cuando una diferencia entre modelos sea pequeña, la trataremos como evidencia débil, no como demostración.

# Entorno, semillas y configuración experimental
import os
import time
import random
import warnings

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

from sklearn.model_selection import train_test_split
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    accuracy_score,
    precision_recall_fscore_support,
    roc_auc_score,
    roc_curve,
    auc,
)
from sklearn.preprocessing import label_binarize
from sklearn.datasets import make_moons
from sklearn.neural_network import MLPClassifier

from IPython.display import display

import tensorflow as tf
from tensorflow.keras import Sequential, regularizers, callbacks
from tensorflow.keras.layers import Dense, Dropout, BatchNormalization, Activation, Input
from tensorflow.keras.optimizers import Adam

# ------------------------------------------------------------------
# Reproducibilidad
# ------------------------------------------------------------------
SEED = 42
os.environ["PYTHONHASHSEED"] = str(SEED)
random.seed(SEED)
np.random.seed(SEED)
tf.keras.utils.set_random_seed(SEED)

# ------------------------------------------------------------------
# Hiperparámetros de cómputo (CPU-friendly)
# ------------------------------------------------------------------
# Corpus reducido de Fashion-MNIST: suficiente para provocar sobreajuste
# y comparar técnicas sin exigir GPU.
N_TRAIN = 4000
N_VAL = 1500
N_TEST = 1500

BATCH_SIZE = 128
EPOCHS_FULL = 30          # evolucion completa del baseline
EPOCHS_SCENARIOS = 25     # escenarios A/B
EPOCHS_COMPARE = 30       # L1, L2, Dropout, BatchNorm (comparable al baseline)
EPOCHS_EARLY = 60         # techo alto para Early Stopping
EPOCHS_SEARCH = 12        # busqueda pequena de hiperparametros
PATIENCE = 8

LEARNING_RATE = 1e-3

plt.style.use("seaborn-v0_8-whitegrid")
plt.rcParams.update({
    "figure.figsize": (10, 4.2),
    "axes.titlesize": 12,
    "axes.labelsize": 11,
    "legend.fontsize": 9,
    "font.size": 10,
})
sns.set_palette("colorblind")

print("TensorFlow:", tf.__version__)
print("GPU visible:", tf.config.list_physical_devices("GPU"))
print("Semilla:", SEED)
print(f"Particiones experimentales -> train={N_TRAIN}, val={N_VAL}, test={N_TEST}")
print(f"Epocas baseline: {EPOCHS_FULL} | Early Stopping techo: {EPOCHS_EARLY}")
print("Tiempo estimado en CPU (notebook completo): 15-30 minutos.")
print("Si necesita acortar, reduzca EPOCHS_FULL / EPOCHS_COMPARE; las tendencias suelen preservarse.")
TensorFlow: 2.21.0
GPU visible: []
Semilla: 42
Particiones experimentales -> train=4000, val=1500, test=1500
Epocas baseline: 30 | Early Stopping techo: 60
Tiempo estimado en CPU (notebook completo): 15-30 minutos.
Si necesita acortar, reduzca EPOCHS_FULL / EPOCHS_COMPARE; las tendencias suelen preservarse.

Lectura de este bloque

No hay todavía un modelo que interpretar. Lo que queda fijado es el marco: misma semilla, mismos tamaños de partición, mismo batch_size de referencia y un presupuesto de épocas explícito. Si más adelante una técnica termina antes (Early Stopping) o usa un \(\lambda\) distinto, eso será la intervención, no un cambio silencioso del protocolo.

Qué no afirma este bloque. Que los resultados serán idénticos bit a bit en cualquier máquina. Afirma que las condiciones son lo bastante controladas para comparar direcciones (¿redujo el gap? ¿apareció underfitting?) con criterio académico.


1. El problema de generalizar

1.1. ¿Qué significa aprender?

En aprendizaje supervisado, aprender no es almacenar la tabla \((x_i, y_i)\) del conjunto de entrenamiento. Es estimar, a partir de una muestra finita, una función \(f_\theta\) —parametrizada por pesos y sesgos— que aproxime la relación subyacente entre entradas y salidas.

Formalmente, si los datos se asumen generados por una distribución conjunta \(p(x,y)\), el objetivo teórico es minimizar el riesgo esperado

\[ R(\theta) = \mathbb{E}_{(x,y)\sim p}\big[\ell\big(y, f_\theta(x)\big)\big], \]

donde \(\ell\) es la función de pérdida (en clasificación, típicamente la entropía cruzada). \(R(\theta)\) no es observable: no tenemos acceso a \(p\). Lo que sí podemos calcular es el riesgo empírico sobre una muestra.

1.2. ¿Qué significa generalizar?

Generalizar es que el desempeño de \(f_\theta\) se mantenga, de manera comparable, sobre observaciones nuevas extraídas de la misma distribución. Un modelo que reproduce con exactitud el entrenamiento y falla fuera de él no ha aprendido la relación: ha memorizado particularidades (ruido de etiqueta, artefactos de la muestra, combinaciones de píxeles que no volverán a ocurrir).

La distinción no es moral (“memorizar es malo”). Es estadística: los patrones idiosincráticos del conjunto de entrenamiento no son estables bajo \(p(x,y)\). Los patrones generalizables sí lo son.

1.3. Tres errores que no miden lo mismo

Error ¿Sobre qué datos? ¿Para qué sirve? ¿Se usa para actualizar \(\theta\)?
Entrenamiento \(D_{\mathrm{train}}\) Diagnosticar si el modelo puede ajustar Sí
Validación \(D_{\mathrm{val}}\) Estimar generalización durante el desarrollo y decidir (época, \(\lambda\), arquitectura) No
Test \(D_{\mathrm{test}}\) Estimación final, usada pocas veces No

El error de entrenamiento responde: ¿el optimizador está reduciendo \(J(\theta)\) sobre los datos que ve?
El error de validación responde: ¿esas actualizaciones están produciendo una función que funciona fuera de \(D_{\mathrm{train}}\)?
El error de test responde: ¿cuál es nuestra mejor estimación no contaminada del riesgo, una vez terminado el desarrollo?

Si usamos \(D_{\mathrm{test}}\) una y otra vez para elegir hiperparámetros, deja de ser un conjunto de evaluación y se convierte en un segundo conjunto de validación. El número que reportemos entonces ya no es una estimación honesta de generalización: ha participado en las decisiones.

1.4. Capacidad, complejidad y generalization gap

La capacidad de un modelo es, informalmente, la riqueza de la familia de funciones que puede representar. En una MLP crece con el número de capas, el número de unidades y, en la práctica, con el tiempo de entrenamiento (una red grande entrenada 2 épocas no “usa” la misma capacidad efectiva que la misma red entrenada 200 épocas).

Más capacidad no es automáticamente mejor. Aumenta el riesgo de ajustar estructura y ruido.

Definimos dos indicadores diagnósticos, no leyes universales:

\[ \mathrm{Gap}_{\mathrm{acc}} = \mathrm{acc}_{\mathrm{train}} - \mathrm{acc}_{\mathrm{val}} \qquad \text{(mayor es mejor en accuracy)} \]

\[ \mathrm{Gap}_{\ell} = \ell_{\mathrm{val}} - \ell_{\mathrm{train}} \qquad \text{(menor es mejor en pérdida)} \]

Un \(\mathrm{Gap}_{\mathrm{acc}}\) grande sugiere que el modelo se desempeña mejor en datos que ya usó para actualizar pesos que en datos que no usó. Un \(\mathrm{Gap}_{\ell}\) grande apunta en la misma dirección desde la pérdida.

Por qué no son reglas universales.

  • Un gap pequeño con accuracy de 0.45 en un problema de 10 clases no es “buena generalización”: es mal ajuste en ambos conjuntos (underfitting).
  • Un gap moderado con accuracy de validación alta puede ser preferible a un gap nulo con desempeño pobre.
  • Accuracy y pérdida no siempre cuentan la misma historia: la pérdida es más sensible a la confianza de las probabilidades; la accuracy solo mira el \(\arg\max\).
  • El gap depende del tamaño de muestra, del desbalance y de la semilla.

Por eso el gap es un indicador, no un veredicto.

1.5. Idea que atraviesa la sesión

El objetivo del entrenamiento no es maximizar el desempeño sobre los datos que el modelo ya conoce. Es aprender una representación que conserve capacidad predictiva sobre observaciones nuevas. Todas las técnicas que siguen —L1, L2, Dropout, Batch Normalization, Early Stopping, búsqueda de hiperparámetros— se evalúan con esa vara, no con el accuracy de entrenamiento.

# Ilustración numérica de los dos gaps (no es un experimento del dataset todavía)
# Usamos cifras hipotéticas SOLO para mostrar el cálculo, no para concluir nada empírico.

def gap_accuracy(acc_train, acc_val):
    # Gap cuando mayor es mejor. Positivo: train superior a validación.
    return acc_train - acc_val


def gap_loss(loss_val, loss_train):
    # Gap cuando menor es mejor. Positivo: validación peor (mayor pérdida).
    return loss_val - loss_train


ejemplos = pd.DataFrame([
    {"escenario": "posible underfitting", "acc_train": 0.52, "acc_val": 0.50, "loss_train": 1.40, "loss_val": 1.42},
    {"escenario": "posible buen ajuste", "acc_train": 0.86, "acc_val": 0.84, "loss_train": 0.38, "loss_val": 0.44},
    {"escenario": "posible overfitting", "acc_train": 0.99, "acc_val": 0.78, "loss_train": 0.05, "loss_val": 0.72},
])
ejemplos["gap_acc"] = gap_accuracy(ejemplos["acc_train"], ejemplos["acc_val"])
ejemplos["gap_loss"] = gap_loss(ejemplos["loss_val"], ejemplos["loss_train"])

print("Cálculo ilustrativo de gaps (cifras HIPOTÉTICAS, no del experimento):")
display(ejemplos.style.format({
    "acc_train": "{:.2f}", "acc_val": "{:.2f}",
    "loss_train": "{:.2f}", "loss_val": "{:.2f}",
    "gap_acc": "{:.2f}", "gap_loss": "{:.2f}",
}))

print(
    "\nLectura: el tercer escenario tiene gap_acc grande y gap_loss grande; "
    "el primero tiene gaps pequeños PERO desempeño bajo. "
    "El gap solo es interpretable junto con el nivel absoluto de las métricas."
)
Cálculo ilustrativo de gaps (cifras HIPOTÉTICAS, no del experimento):
  escenario acc_train acc_val loss_train loss_val gap_acc gap_loss
0 posible underfitting 0.52 0.50 1.40 1.42 0.02 0.02
1 posible buen ajuste 0.86 0.84 0.38 0.44 0.02 0.06
2 posible overfitting 0.99 0.78 0.05 0.72 0.21 0.67

Lectura: el tercer escenario tiene gap_acc grande y gap_loss grande; el primero tiene gaps pequeños PERO desempeño bajo. El gap solo es interpretable junto con el nivel absoluto de las métricas.

Observación, inferencia y decisión (I)

Observación (sobre la tabla ilustrativa, no sobre Fashion-MNIST): el escenario 3 combina \(\mathrm{acc}_{\mathrm{train}}\approx 0.99\) con \(\mathrm{acc}_{\mathrm{val}}\approx 0.78\).

Inferencia: ese patrón es compatible con sobreajuste. No “demuestra” que cualquier red con gap \(0.21\) esté sobreajustada: el umbral depende del problema.

Decisión: en un caso real, no nos detendríamos en el gap. Miraríamos las curvas (¿cuándo empezó la divergencia?), el test (una sola vez, al final) y decidiríamos si regularizar, recortar épocas o cambiar capacidad.

A partir de aquí, los números dejarán de ser hipotéticos.


2. Underfitting, buen ajuste y overfitting

2.1. Tres regímenes, no dos etiquetas

Underfitting. El modelo no captura suficientemente la estructura del problema. El error de entrenamiento permanece alto y el de validación también. Causas típicas: capacidad insuficiente, entrenamiento demasiado corto, learning rate inadecuado, representación pobre de la entrada, o una regularización tan fuerte que impide aprender.

Buen ajuste. El modelo aprende patrones que también funcionan fuera de \(D_{\mathrm{train}}\). Las curvas de entrenamiento y validación evolucionan de forma coherente y la brecha se mantiene razonable para el problema. No existe un umbral universal de “brecha razonable”: en Fashion-MNIST con 4 000 ejemplos no esperamos la misma brecha que en el conjunto completo, ni la misma que en un problema binario linealmente separable.

Overfitting. El modelo ajusta particularidades de \(D_{\mathrm{train}}\) que no generalizan. El síntoma clásico no es “train alto”, sino divergencia: el entrenamiento sigue mejorando mientras la validación se estanca o empeora.

Underfitting y overfitting no son simétricos. El primero es un fallo de ajuste; el segundo es un fallo de transferencia. Un modelo puede, además, pasar de un régimen al otro a lo largo de las épocas: primero no ha aprendido lo suficiente y después memoriza.

2.2. Cómo reconocerlos visualmente (sin umbrales universales)

En las curvas \(\ell\) / \(\ell_{\mathrm{val}}\) y \(\mathrm{acc}\) / \(\mathrm{acc}_{\mathrm{val}}\):

  • Underfitting: ambas curvas de pérdida se quedan altas, o ambas accuracies se quedan bajas. No hay un “milagro” en validación: el modelo no está resolviendo el problema ni siquiera donde actualiza pesos.
  • Overfitting: \(\ell_{\mathrm{train}}\) continúa bajando (o \(\mathrm{acc}_{\mathrm{train}}\) subiendo) mientras \(\ell_{\mathrm{val}}\) deja de mejorar o sube. La divergencia es la evidencia, no un número mágico de gap.
  • Buena generalización: las dos curvas bajan (o suben) juntas durante un tramo largo; la brecha existe —casi siempre existe— pero no se abre de forma sistemática a costa de la validación.

El experimento que provoca deliberadamente los tres regímenes usa el mismo dataset y las mismas particiones que el resto de la sesión. Se ejecuta en la sección 4, después de fijar los datos: de lo contrario estaríamos comparando regímenes sobre muestras distintas, que es precisamente lo que queremos evitar.

2.3. Pregunta para responder más adelante

Cuando vea las tres curvas, no busque la etiqueta primero. Pregúntese:

  1. ¿El modelo A es incapaz de bajar la pérdida de entrenamiento?
  2. ¿En el modelo C hay una época a partir de la cual las curvas se separan?
  3. ¿El modelo B es “perfecto” o simplemente menos extremo que A y C?

3. Bias–variance tradeoff

3.1. Dos fuentes de error que no son sinónimos de under/overfitting

En el análisis clásico del error de predicción, para un estimador \(\hat{f}\) y un punto \(x\),

\[ \mathbb{E}\big[(y - \hat{f}(x))^2\big] = \underbrace{\big(\mathbb{E}[\hat{f}(x)] - f(x)\big)^2}_{\mathrm{bias}^2} + \underbrace{\mathbb{E}\big[\big(\hat{f}(x) - \mathbb{E}[\hat{f}(x)]\big)^2\big]}_{\mathrm{variance}} + \sigma^2, \]

donde \(f\) es la función objetivo (en regresión) y \(\sigma^2\) es ruido irreducible. El promedio \(\mathbb{E}[\cdot]\) es respecto a conjuntos de entrenamiento distintos extraídos de \(p\).

Bias (sesgo). Distancia sistemática entre lo que el modelo tiende a aprender y la función objetivo. Un modelo demasiado rígido (poca capacidad, hipótesis lineal para un fenómeno no lineal, regularización extrema) suele tener sesgo alto: se equivoca de manera parecida aunque cambie la muestra.

Variance (varianza). Sensibilidad del modelo a la muestra concreta de entrenamiento. Un modelo muy flexible puede cambiar mucho su frontera si se reemplaza \(D_{\mathrm{train}}\) por otro \(D'_{\mathrm{train}}\).

3.2. Relación con underfitting y overfitting — y por qué no son idénticos

Concepto Pregunta que responde Se observa típicamente como
Alto bias ¿La clase de funciones puede representar el fenómeno? Underfitting persistente
Alta variance ¿El ajuste depende demasiado de esta muestra? Overfitting, inestabilidad entre semillas
Underfitting ¿Falló el ajuste en train y en val? Curvas malas en ambos
Overfitting ¿El ajuste de train no se transfiere? Divergencia train/val

Bias \(\neq\) underfitting. Un modelo de alto sesgo suele underfittear, pero un underfitting también puede venir de optimizar mal (learning rate destructivo, pocas épocas, bugs de preprocesamiento) con una clase de funciones que sí sería suficiente. En ese caso el sesgo de la arquitectura no es el diagnóstico correcto.

Variance \(\neq\) overfitting. El overfitting que vemos en una corrida (train excelente, val peor) es compatible con alta varianza, pero la varianza, en sentido estricto, se define entre realizaciones del conjunto de entrenamiento. Con una sola semilla y un solo split, no medimos varianza: inferimos un patrón compatible con ella.

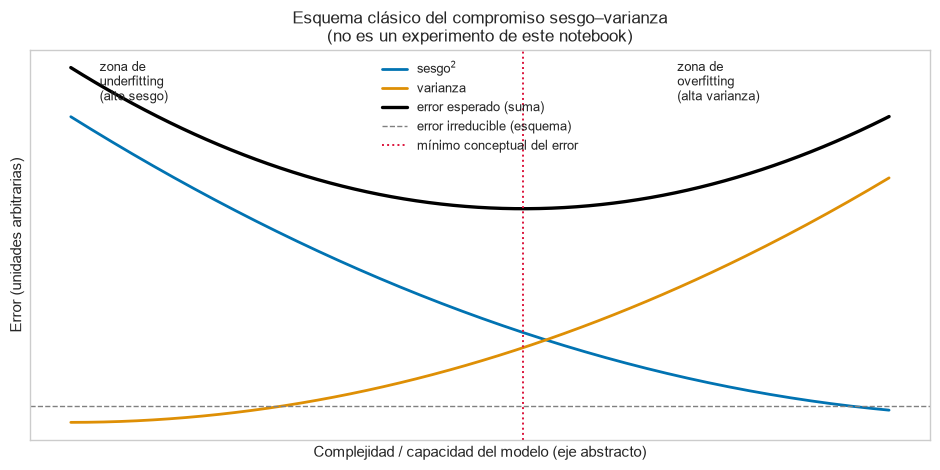
3.3. Complejidad y el U clásico

De manera esquemática:

  • modelo demasiado simple \(\rightarrow\) alto bias, baja capacidad efectiva \(\rightarrow\) underfitting;
  • modelo excesivamente complejo \(\rightarrow\) alta variance, gran sensibilidad a \(D_{\mathrm{train}}\) \(\rightarrow\) overfitting;
  • modelo apropiado \(\rightarrow\) compromiso entre capacidad y generalización.

La gráfica que sigue es conceptual. No proviene de Fashion-MNIST ni de un barrido real de arquitecturas. Sirve para organizar ideas, no para leer un número.

# Gráfica CONCEPTUAL de complejidad vs error (no es un resultado empírico)
complejidad = np.linspace(0.15, 1.0, 200)
bias2 = 0.55 * (1.15 - complejidad) ** 2 + 0.04
variance = 0.62 * (complejidad - 0.15) ** 2 + 0.03
irreducible = np.full_like(complejidad, 0.06)
error_total = bias2 + variance + irreducible
i_opt = int(np.argmin(error_total))

fig, ax = plt.subplots(figsize=(9.5, 4.8))
ax.plot(complejidad, bias2, label=r"sesgo$^{2}$", lw=2)
ax.plot(complejidad, variance, label="varianza", lw=2)
ax.plot(complejidad, error_total, label="error esperado (suma)", lw=2.4, color="black")
ax.axhline(0.06, ls="--", color="gray", lw=1, label="error irreducible (esquema)")
ax.axvline(complejidad[i_opt], color="crimson", ls=":", lw=1.4,
           label="mínimo conceptual del error")
ax.set_xlabel("Complejidad / capacidad del modelo (eje abstracto)")
ax.set_ylabel("Error (unidades arbitrarias)")
ax.set_title("Esquema clásico del compromiso sesgo–varianza\n(no es un experimento de este notebook)")
ax.legend(loc="upper center")
ax.set_xticks([])
ax.set_yticks([])
ax.text(0.18, 0.62, "zona de\nunderfitting\n(alto sesgo)", fontsize=9)
ax.text(0.78, 0.62, "zona de\noverfitting\n(alta varianza)", fontsize=9)
plt.tight_layout()
plt.show()

print(
    "Esta figura NO estima el sesgo ni la varianza de nuestros modelos. "
    "No identifica cuántas neuronas son 'las correctas' en Fashion-MNIST. "
    "Solo organiza la idea de que aumentar capacidad empuja el error de "
    "un régimen (sesgo) hacia otro (varianza)."
)

Esta figura NO estima el sesgo ni la varianza de nuestros modelos. No identifica cuántas neuronas son 'las correctas' en Fashion-MNIST. Solo organiza la idea de que aumentar capacidad empuja el error de un régimen (sesgo) hacia otro (varianza).

Qué puede y qué no puede inferirse de la gráfica conceptual

Sí puede: recordar que el error de generalización no es monótono en la complejidad; que “más grande” no implica “mejor”; que el mínimo es un compromiso, no la anulación del sesgo ni de la varianza.

No puede: fijar el número de neuronas del experimento; afirmar que Batch Normalization “reduce la varianza” en el sentido de esta descomposición; leer un \(\lambda\) óptimo; concluir que el modelo B de la próxima sección está en el mínimo de esa U.

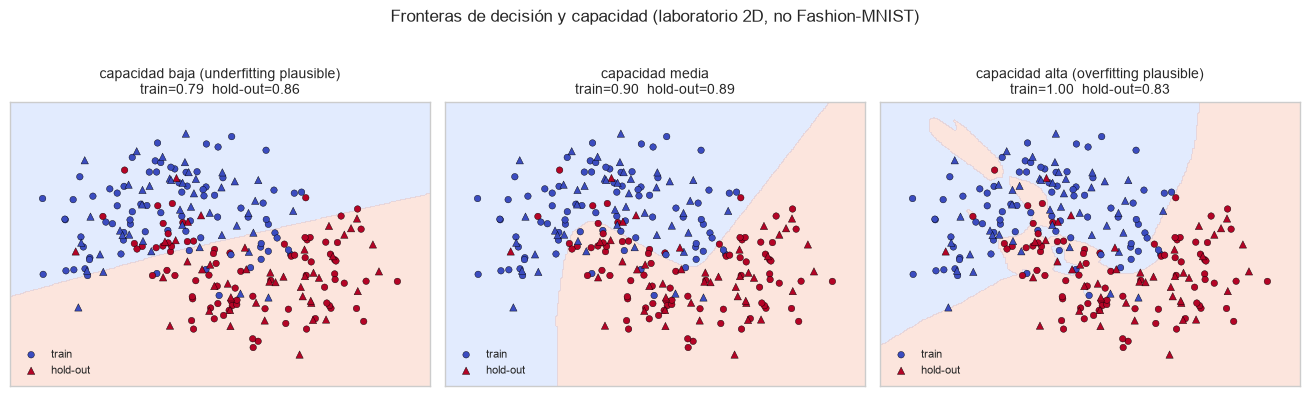
Para anclar la intuición con un problema visible, el siguiente bloque ajusta tres MLP de distinta capacidad sobre un make_moons bidimensional. Es un laboratorio geométrico, no el dataset oficial de la sesión. Las fronteras se interpretan cualitativamente.

# Laboratorio geométrico (NO es el dataset oficial): tres capacidades sobre make_moons
X_m, y_m = make_moons(n_samples=250, noise=0.35, random_state=SEED)
X_m_tr, X_m_te, y_m_tr, y_m_te = train_test_split(
    X_m, y_m, test_size=0.35, random_state=SEED, stratify=y_m
)

caps = {
    "capacidad baja (underfitting plausible)": (4,),
    "capacidad media": (16, 8),
    "capacidad alta (overfitting plausible)": (128, 128, 64),
}

xx, yy = np.meshgrid(
    np.linspace(X_m[:, 0].min() - 0.4, X_m[:, 0].max() + 0.4, 250),
    np.linspace(X_m[:, 1].min() - 0.4, X_m[:, 1].max() + 0.4, 250),
)
grid = np.c_[xx.ravel(), yy.ravel()]

fig, axes = plt.subplots(1, 3, figsize=(13.2, 3.8))
for ax, (titulo, hidden) in zip(axes, caps.items()):
    clf = MLPClassifier(
        hidden_layer_sizes=hidden,
        activation="relu",
        solver="adam",
        max_iter=2500,
        random_state=SEED,
        alpha=0.0,
    )
    clf.fit(X_m_tr, y_m_tr)
    Z = clf.predict(grid).reshape(xx.shape)
    acc_tr = clf.score(X_m_tr, y_m_tr)
    acc_te = clf.score(X_m_te, y_m_te)
    ax.contourf(xx, yy, Z, alpha=0.25, levels=[-0.5, 0.5, 1.5], cmap="coolwarm")
    ax.scatter(X_m_tr[:, 0], X_m_tr[:, 1], c=y_m_tr, cmap="coolwarm",
               edgecolor="k", s=22, linewidth=0.3, label="train")
    ax.scatter(X_m_te[:, 0], X_m_te[:, 1], c=y_m_te, cmap="coolwarm",
               marker="^", edgecolor="k", s=28, linewidth=0.3, label="hold-out")
    ax.set_title(f"{titulo}\ntrain={acc_tr:.2f}  hold-out={acc_te:.2f}", fontsize=10)
    ax.set_xticks([]); ax.set_yticks([])
    ax.legend(loc="lower left", fontsize=8)

fig.suptitle("Fronteras de decisión y capacidad (laboratorio 2D, no Fashion-MNIST)", y=1.03)
plt.tight_layout()
plt.show()

print(
    "Observe la frontera, no solo el número: una red diminuta no puede seguir las lunas; "
    "una red enorme puede recortar islas alrededor de puntos ruidosos. "
    "El hold-out de este toy no es el test oficial de la sesión."
)

Observe la frontera, no solo el número: una red diminuta no puede seguir las lunas; una red enorme puede recortar islas alrededor de puntos ruidosos. El hold-out de este toy no es el test oficial de la sesión.

Preguntas (responda mentalmente antes de seguir)

  1. En el panel de capacidad alta, ¿la frontera se pega a puntos que parecen ruido?
  2. ¿Un accuracy de entrenamiento más alto en ese panel implica, por sí solo, un mejor modelo?
  3. ¿Qué decidiría: subir capacidad, bajarla, o regularizar?

Una respuesta razonable: si la frontera fragmenta el espacio alrededor de puntos aislados, hay evidencia geométrica compatible con overfitting. El accuracy de entrenamiento alto no autoriza a preferir ese modelo; el hold-out y la simplicidad de la frontera importan. La decisión podría ser reducir capacidad o introducir regularización —eso es lo que haremos, ya en el dataset oficial, a partir de la sección 4.


4. Dataset y diseño experimental

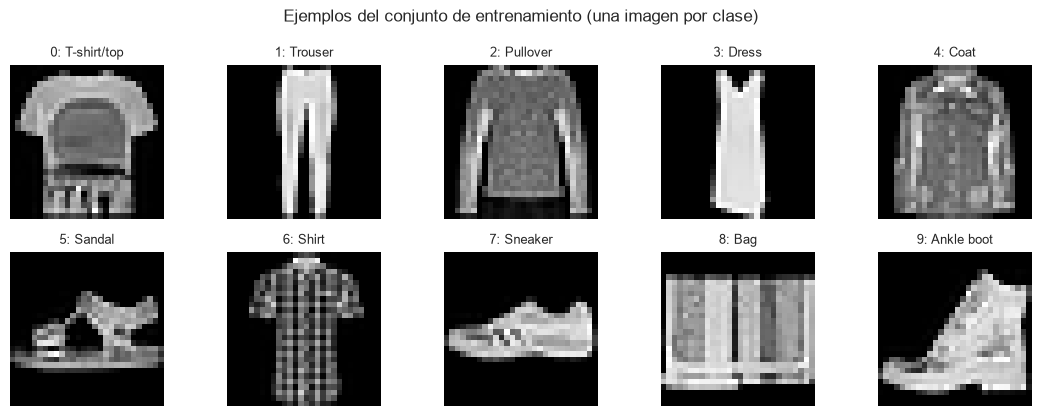
4.1. Por qué Fashion-MNIST (y por qué un subconjunto)

El dataset oficial de la sesión es Fashion-MNIST: 70 000 imágenes 28×28 en escala de grises, 10 clases de prendas. Es más exigente que MNIST de dígitos —camisa, polo y abrigo se parecen— y sigue siendo manejable en CPU.

Usamos un corpus reducido (los tamaños exactos están en N_TRAIN, N_VAL y N_TEST de la celda de entorno) por tres razones pedagógicas, no por pereza:

  1. Con pocos ejemplos y una MLP ancha, el sobreajuste aparece y se puede ver en las curvas.
  2. Podemos entrenar muchos modelos comparables en un computador personal, sin GPU.
  3. El problema sigue siendo lo bastante rico: hay confusiones sistemáticas entre clases, no un toy lineal.

El precio: los accuracies absolutos no son comparables a artículos que usan los 60 000 ejemplos. Eso no invalida las comparaciones internas (mismo split, misma semilla, misma métrica).

Cada imagen se aplana a un vector de 784 píxeles en \([0,1]\). No usamos CNN a propósito: la sesión evalúa regularización sobre una MLP, que es el modelo que el curso ya sabe construir.

4.2. Papel de cada partición

\[ D_{\mathrm{train}} \xrightarrow{\text{actualiza }\theta} \quad D_{\mathrm{val}} \xrightarrow{\text{observa y decide}} \quad D_{\mathrm{test}} \xrightarrow{\text{evalúa al final}} \]

La proporción exacta se imprime al cargar los datos (típicamente cerca de 57 % / 21 % / 21 % con los tamaños por defecto). El test oficial de Fashion-MNIST no se usa completo: tomamos un subconjunto estratificado para que la evaluación final sea estable y barata.

4.3. Reglas que no vamos a romper

  1. Mismo dataset, mismas particiones, misma semilla de split.
  2. Métricas equivalentes (pérdida de entropía cruzada dispersa y accuracy; más adelante precision/recall/F1).
  3. Una intervención principal por experimento cuando comparemos técnicas (salvo el modelo combinado, que se declara como tal).
  4. Registrar resultados en una tabla común para no comparar de memoria.
  5. No usar test para elegir \(\lambda\), dropout, épocas ni arquitectura.
  6. Condiciones de entrenamiento comparables: mismo optimizador de referencia (Adam), mismo batch_size, mismo learning rate salvo cuando el experimento sea el learning rate.
# Carga, partición estratificada y preprocesamiento
# Fashion-MNIST: 10 clases de prendas, imágenes 28×28 en uint8.

CLASS_NAMES = [
    "T-shirt/top", "Trouser", "Pullover", "Dress", "Coat",
    "Sandal", "Shirt", "Sneaker", "Bag", "Ankle boot",
]
N_CLASSES = 10
INPUT_DIM = 28 * 28

(x_tr_full, y_tr_full), (x_te_full, y_te_full) = tf.keras.datasets.fashion_mnist.load_data()

# Subconjunto estratificado del train oficial → train + val
x_pool, _, y_pool, _ = train_test_split(
    x_tr_full, y_tr_full,
    train_size=N_TRAIN + N_VAL,
    stratify=y_tr_full,
    random_state=SEED,
)
X_train_img, X_val_img, y_train, y_val = train_test_split(
    x_pool, y_pool,
    train_size=N_TRAIN,
    stratify=y_pool,
    random_state=SEED,
)

# Subconjunto estratificado del test oficial
X_test_img, _, y_test, _ = train_test_split(
    x_te_full, y_te_full,
    train_size=N_TEST,
    stratify=y_te_full,
    random_state=SEED,
)


def aplanar_normalizar(imgs):
    # uint8 [0,255], (N,28,28) -> float32 [0,1], (N,784).
    return imgs.reshape(len(imgs), -1).astype("float32") / 255.0


X_train = aplanar_normalizar(X_train_img)
X_val = aplanar_normalizar(X_val_img)
X_test = aplanar_normalizar(X_test_img)

y_train = y_train.astype("int32")
y_val = y_val.astype("int32")
y_test = y_test.astype("int32")

print("Formas:")
print(f"  X_train {X_train.shape}  y_train {y_train.shape}")
print(f"  X_val   {X_val.shape}  y_val   {y_val.shape}")
print(f"  X_test  {X_test.shape}  y_test  {y_test.shape}")
print(f"Rango de X_train: [{X_train.min():.1f}, {X_train.max():.1f}]")
n_total = len(X_train) + len(X_val) + len(X_test)
print("Proporcion train/val/test:",
      f"{len(X_train)/n_total:.1%} / {len(X_val)/n_total:.1%} / {len(X_test)/n_total:.1%}")
print("\nSoporte por clase (train):")
print(pd.Series(y_train).value_counts().sort_index().rename(lambda i: CLASS_NAMES[i]))
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/train-labels-idx1-ubyte.gz

29515/29515 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/train-images-idx3-ubyte.gz

26421880/26421880 ━━━━━━━━━━━━━━━━━━━━ 4s 0us/step

Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/t10k-labels-idx1-ubyte.gz

5148/5148 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/t10k-images-idx3-ubyte.gz

4422102/4422102 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

Formas:

  X_train (4000, 784)  y_train (4000,)

  X_val   (1500, 784)  y_val   (1500,)

  X_test  (1500, 784)  y_test  (1500,)

Rango de X_train: [0.0, 1.0]

Proporcion train/val/test: 57.1% / 21.4% / 21.4%


Soporte por clase (train):

T-shirt/top    400

Trouser        400

Pullover       400

Dress          400

Coat           400

Sandal         400

Shirt          400

Sneaker        400

Bag            400

Ankle boot     400

Name: count, dtype: int64

Lectura de las particiones

Debemos verificar tres cosas antes de entrenar:

  1. Formas coherentes: 784 columnas, etiquetas enteras en \(\{0,\ldots,9\}\).
  2. Escala: píxeles en \([0,1]\). Entrenar en \(\{0,\ldots,255\}\) desplaza la escala de los pesos y complica la comparación entre técnicas.
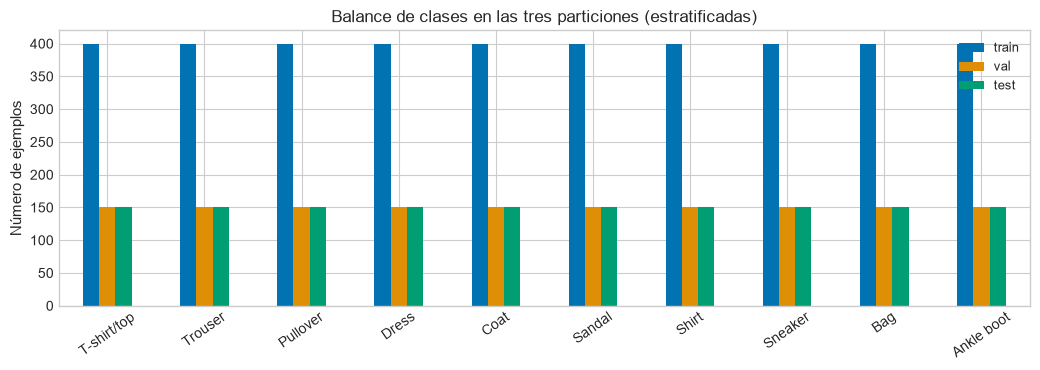
  3. Soporte por clase: el split estratificado busca frecuencias parecidas. Si una clase quedara vacía en validación, accuracy y F1 dejarían de ser comparables.
# Exploración visual: una prenda por clase y balance de las tres particiones
fig, axes = plt.subplots(2, 5, figsize=(11, 4.2))
for k, ax in enumerate(axes.ravel()):
    idx = np.where(y_train == k)[0][0]
    ax.imshow(X_train_img[idx], cmap="gray")
    ax.set_title(f"{k}: {CLASS_NAMES[k]}", fontsize=9)
    ax.axis("off")
fig.suptitle("Ejemplos del conjunto de entrenamiento (una imagen por clase)")
plt.tight_layout()
plt.show()

fig, ax = plt.subplots(figsize=(10.5, 3.8))
conteos = pd.DataFrame({
    "train": pd.Series(y_train).value_counts().sort_index(),
    "val": pd.Series(y_val).value_counts().sort_index(),
    "test": pd.Series(y_test).value_counts().sort_index(),
})
conteos.index = CLASS_NAMES
conteos.plot(kind="bar", ax=ax)
ax.set_ylabel("Número de ejemplos")
ax.set_title("Balance de clases en las tres particiones (estratificadas)")
ax.tick_params(axis="x", rotation=35)
plt.tight_layout()
plt.show()

print(
    "Observación: las barras de cada clase deberían ser proporcionales entre "
    "train, val y test. Si lo son, las diferencias posteriores entre modelos "
    "no se podrán atribuir a un desbalance accidental del split."
)

Observación: las barras de cada clase deberían ser proporcionales entre train, val y test. Si lo son, las diferencias posteriores entre modelos no se podrán atribuir a un desbalance accidental del split.

4.4. Instrumental: funciones que usaremos en toda la sesión

Definimos ahora las herramientas de medición y lectura. No ocultan el entrenamiento: model.fit seguirá siendo visible en el baseline. Lo que evitan es copiar quince veces el mismo gráfico sin eje ni interpretación.

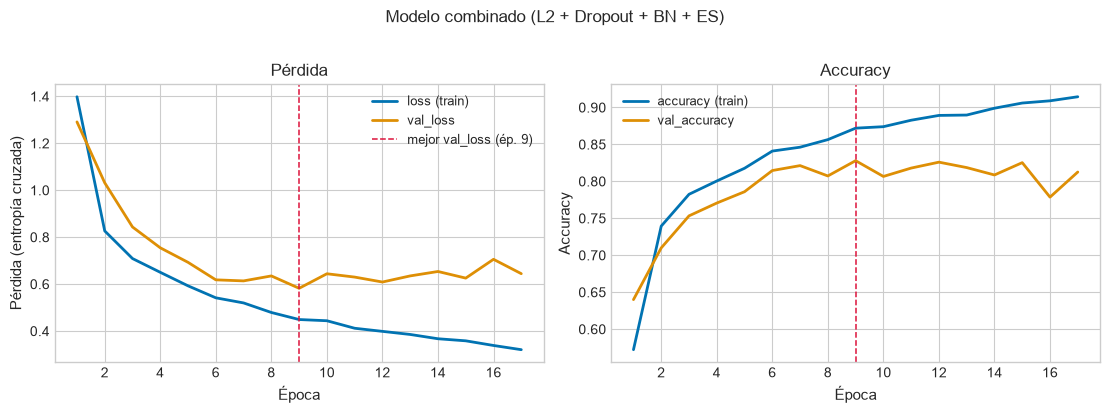
  • plot_history — curvas \(\ell\)/\(\ell_{\mathrm{val}}\) y \(\mathrm{acc}\)/\(\mathrm{acc}_{\mathrm{val}}\), con la mejor época según validación.
  • analyze_history — reporte automático a partir del history (época, tendencias, lenguaje prudente).
  • evaluar_conjuntos — evaluate() en train, val y test (modo inferencia).
  • registrar — una fila en la tabla comparativa.
  • analizar_generalizacion, comparar_modelos, interpretar_classification_report — diagnósticos auxiliares, no un juez automático.
# Funciones reutilizables de medición, visualización y diagnóstico
RESULTADOS = []  # tabla viva de la sesión


def _series(history):
    h = history.history
    return {
        "loss": np.asarray(h["loss"], dtype=float),
        "val_loss": np.asarray(h["val_loss"], dtype=float),
        "acc": np.asarray(h["accuracy"], dtype=float),
        "val_acc": np.asarray(h["val_accuracy"], dtype=float),
    }


def plot_history(history, titulo="", marcar_mejor=True, ax=None):
    # Grafica perdida y accuracy de entrenamiento frente a validacion.
    s = _series(history)
    ep = np.arange(1, len(s["loss"]) + 1)
    best = int(np.argmin(s["val_loss"])) + 1

    fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.0))
    axes[0].plot(ep, s["loss"], label="loss (train)", lw=2)
    axes[0].plot(ep, s["val_loss"], label="val_loss", lw=2)
    axes[0].set_xlabel("Época")
    axes[0].set_ylabel("Pérdida (entropía cruzada)")
    axes[0].set_title("Pérdida")
    axes[0].legend()
    if marcar_mejor:
        axes[0].axvline(best, color="crimson", ls="--", lw=1.1,
                        label=f"mejor val_loss (ép. {best})")
        axes[0].legend()

    axes[1].plot(ep, s["acc"], label="accuracy (train)", lw=2)
    axes[1].plot(ep, s["val_acc"], label="val_accuracy", lw=2)
    axes[1].set_xlabel("Época")
    axes[1].set_ylabel("Accuracy")
    axes[1].set_title("Accuracy")
    axes[1].legend()
    if marcar_mejor:
        axes[1].axvline(best, color="crimson", ls="--", lw=1.1)

    fig.suptitle(titulo if titulo else "Evolución del entrenamiento", y=1.02)
    plt.tight_layout()
    plt.show()
    return best


def clasificar_patron_curvas(train_bajo, n_despues, train_despues, val_despues):
    # Casos A-D: descriptores de evidencia, no etiquetas juridicas.
    if train_bajo:
        return (
            "D",
            "Train y validation permanecen en un desempeno bajo.",
            "Los resultados son compatibles con underfitting, o con un problema de "
            "optimizacion/representacion. Esto NO es, por si solo, evidencia de sobreajuste.",
            "Antes de regularizar, convendria revisar capacidad, learning rate, epocas o la escala de X.",
        )
    if n_despues >= 2 and train_despues < -1e-3 and val_despues > 1e-3:
        return (
            "C",
            "Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.",
            "Este patron es compatible con evidencia de sobreajuste: las mejoras de "
            "entrenamiento dejan de trasladarse a validacion.",
            "Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.",
        )
    if n_despues >= 2 and train_despues < -1e-3 and abs(val_despues) <= 1e-3:
        return (
            "B",
            "Train continua mejorando mientras validation se estabiliza.",
            "Las mejoras adicionales sobre entrenamiento parecen dejar de trasladarse "
            "al conjunto de validacion. Puede ser el inicio de un sobreajuste; no es una demostracion.",
            "Conviene vigilar val_loss y considerar Early Stopping si la meseta persiste.",
        )
    if n_despues == 0 or (train_despues <= 1e-3 and val_despues <= 1e-3):
        return (
            "A",
            "Train y validation evolucionan en la misma direccion, o el optimo de val_loss esta al final.",
            "El modelo parece seguir aprendiendo patrones que tambien funcionan fuera de D_train. "
            "Eso no demuestra que el nivel absoluto sea satisfactorio.",
            "Revisar el nivel absoluto de las metricas. No celebrar solo la ausencia de divergencia.",
        )
    return (
        "mixto",
        "El history no encaja de forma nitida en un unico patron A-D.",
        "Con esta evidencia unicamente no podemos etiquetar el regimen de forma tajante.",
        "Combinar con el gap, el nivel absoluto y evaluate() en los tres conjuntos.",
    )


def analyze_history(history, nombre="modelo", verbose=True):
    # Lee un history y produce un reporte prudente (evidencia, no veredicto).
    s = _series(history)
    n = len(s["loss"])
    best_i = int(np.argmin(s["val_loss"]))
    best_ep = best_i + 1
    n_despues = n - best_ep

    train_despues = s["loss"][-1] - s["loss"][best_i]
    val_despues = s["val_loss"][-1] - s["val_loss"][best_i]
    gap_acc_best = s["acc"][best_i] - s["val_acc"][best_i]
    gap_acc_final = s["acc"][-1] - s["val_acc"][-1]
    gap_loss_best = s["val_loss"][best_i] - s["loss"][best_i]
    gap_loss_final = s["val_loss"][-1] - s["loss"][-1]

    # Tendencia posterior: pendiente de un ajuste lineal si hay suficientes épocas
    if n_despues >= 3:
        t = np.arange(n_despues + 1)
        pendiente_val = float(np.polyfit(t, s["val_loss"][best_i:], 1)[0])
        pendiente_tr = float(np.polyfit(t, s["loss"][best_i:], 1)[0])
    else:
        pendiente_val = float(val_despues)
        pendiente_tr = float(train_despues)

    # Diagnóstico prudente (indicadores, no umbrales universales)
    train_bajo = s["acc"][best_i] < 0.62 and s["val_acc"][best_i] < 0.62
    divergencia = (train_despues < -1e-3) and (val_despues > 1e-3) and n_despues >= 2
    val_mejora_poco = abs(val_despues) <= 1e-3 and n_despues >= 2 and train_despues < -1e-3

    if verbose:
        _imprimir_reporte_history(
            nombre, n, s, best_i, best_ep, n_despues,
            train_despues, val_despues, gap_acc_best, gap_acc_final,
            gap_loss_best, gap_loss_final, pendiente_tr, pendiente_val,
            train_bajo, divergencia, val_mejora_poco,
        )

    return {
        "nombre": nombre,
        "epocas": n,
        "mejor_epoca_val_loss": best_ep,
        "min_val_loss": float(s["val_loss"][best_i]),
        "train_loss_en_mejor": float(s["loss"][best_i]),
        "train_acc_en_mejor": float(s["acc"][best_i]),
        "val_acc_en_mejor": float(s["val_acc"][best_i]),
        "train_acc_mejor": float(s["acc"].max()),
        "val_acc_mejor": float(s["val_acc"].max()),
        "train_loss_final": float(s["loss"][-1]),
        "val_loss_final": float(s["val_loss"][-1]),
        "train_acc_final": float(s["acc"][-1]),
        "val_acc_final": float(s["val_acc"][-1]),
        "gap_acc_mejor_epoca": float(gap_acc_best),
        "gap_acc_final": float(gap_acc_final),
        "gap_loss_final": float(gap_loss_final),
        "n_despues": n_despues,
        "delta_train_despues": float(train_despues),
        "delta_val_despues": float(val_despues),
    }


def _imprimir_reporte_history(
    nombre, n, s, best_i, best_ep, n_despues,
    train_despues, val_despues, gap_acc_best, gap_acc_final,
    gap_loss_best, gap_loss_final, pendiente_tr, pendiente_val,
    train_bajo, divergencia, val_mejora_poco,
):
    print("=" * 72)
    print(f"REPORTE DE HISTORY — {nombre}")
    print("=" * 72)
    print(f"Épocas ejecutadas: {n}")
    print(f"Mejor val_loss: {s['val_loss'][best_i]:.4f}  en la época {best_ep}")
    print(f"  loss (train) en esa época:     {s['loss'][best_i]:.4f}")
    print(f"  accuracy (train) en esa época: {s['acc'][best_i]:.4f}")
    print(f"  val_accuracy en esa época:     {s['val_acc'][best_i]:.4f}")
    print(f"  Gap_acc (train - val):         {gap_acc_best:+.4f}")
    print(f"  Gap_loss (val - train):        {gap_loss_best:+.4f}")
    print(f"Valores FINALES (época {n}):")
    print(f"  loss={s['loss'][-1]:.4f}  val_loss={s['val_loss'][-1]:.4f}  "
          f"acc={s['acc'][-1]:.4f}  val_acc={s['val_acc'][-1]:.4f}")
    print(f"  Gap_acc final: {gap_acc_final:+.4f}   Gap_loss final: {gap_loss_final:+.4f}")

    if n_despues == 0:
        print("La mejor val_loss ocurrió en la última época: no hay tramo posterior que analizar.")
    else:
        print(f"Después de la época {best_ep} hay {n_despues} época(s) adicionales.")
        print(f"  Δ loss train (final - mejor): {train_despues:+.4f}  "
              f"(negativo = el entrenamiento SIGUIÓ bajando la pérdida)")
        print(f"  Δ val_loss   (final - mejor): {val_despues:+.4f}  "
              f"(positivo = la validación EMPEORÓ)")
        if n_despues >= 3:
            print(f"  Pendiente lineal post-óptimo: train={pendiente_tr:+.5f}, val={pendiente_val:+.5f}")

    caso, obs, inf, dec = clasificar_patron_curvas(
        train_bajo, n_despues, train_despues, val_despues
    )
    print("\n--- Observacion / inferencia / decision (curvas) ---")
    print(f"Patron compatible con el caso {caso} (guia, no regla absoluta).")
    print(f"OBSERVACION: {obs}")
    if n_despues > 0:
        print(
            f"  Numeros: mejor epoca={best_ep}, "
            f"Delta train_loss={train_despues:+.4f}, "
            f"Delta val_loss={val_despues:+.4f}, "
            f"tramo posterior={n_despues} epocas."
        )
    print(f"INFERENCIA:  {inf}")
    print(
        "LIMITACION: un solo history no mide varianza entre semillas "
        "ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto."
    )
    print(f"DECISION:    {dec}")
    print("=" * 72)


def evaluar_conjuntos(model):
    # evaluate() en los tres conjuntos (modo inferencia: Dropout inactivo).
    tr = model.evaluate(X_train, y_train, verbose=0)
    va = model.evaluate(X_val, y_val, verbose=0)
    te = model.evaluate(X_test, y_test, verbose=0)
    return {
        "train_loss": float(tr[0]), "train_acc": float(tr[1]),
        "val_loss": float(va[0]), "val_acc": float(va[1]),
        "test_loss": float(te[0]), "test_acc": float(te[1]),
    }


def recolectar_pesos(model):
    vectores = []
    for layer in model.layers:
        pesos = layer.get_weights()
        if not pesos:
            continue
        # El primer arreglo de Dense es el kernel
        if isinstance(layer, Dense):
            vectores.append(pesos[0].ravel())
    if not vectores:
        return np.array([])
    return np.concatenate(vectores)


def registrar(nombre, model, history, tiempo, hparams=None, extra=None):
    # Anade una fila a RESULTADOS con metricas de history y de evaluate().
    info = analyze_history(history, nombre=nombre)
    ev = evaluar_conjuntos(model)
    n_params = int(model.count_params())
    fila = {
        "modelo": nombre,
        "parametros": n_params,
        "tiempo_s": float(tiempo),
        "epocas_ejecutadas": info["epocas"],
        "mejor_epoca": info["mejor_epoca_val_loss"],
        "mejor_val_loss": info["min_val_loss"],
        "train_acc_hist_mejor": info["train_acc_mejor"],
        "val_acc_hist_mejor": info["val_acc_mejor"],
        "train_acc": ev["train_acc"],
        "val_acc": ev["val_acc"],
        "test_acc": ev["test_acc"],
        "train_loss": ev["train_loss"],
        "val_loss": ev["val_loss"],
        "test_loss": ev["test_loss"],
        "gap_acc": ev["train_acc"] - ev["val_acc"],
        "gap_loss": ev["val_loss"] - ev["train_loss"],
        "hparams": hparams or {},
    }
    if extra:
        fila.update(extra)
    RESULTADOS.append(fila)
    print(f"\n[registro] {nombre}: test_acc={fila['test_acc']:.4f}  "
          f"val_acc={fila['val_acc']:.4f}  gap_acc={fila['gap_acc']:+.4f}  "
          f"params={n_params}  tiempo={tiempo:.1f}s")
    return fila


def diagnosticar_modelo(fila):
    # Recibe metricas train/val/test y produce evidencia, no un veredicto.
    ta, va, te = fila["train_acc"], fila["val_acc"], fila["test_acc"]
    gap = fila["gap_acc"]
    d_vt = abs(va - te)
    print(f"\n--- Diagnostico: {fila['modelo']} ---")
    print("OBSERVACION:")
    print(f"  train_acc={ta:.3f}  val_acc={va:.3f}  test_acc={te:.3f}")
    print(f"  gap_acc (train-val)={gap:+.3f}  |val-test|={d_vt:.3f}")
    if "train_loss" in fila:
        tl, vl = fila["train_loss"], fila["val_loss"]
        tesl = fila.get("test_loss", float("nan"))
        print(f"  train_loss={tl:.3f}  val_loss={vl:.3f}  test_loss={tesl:.3f}")
    print("COMPARACION:")
    print("  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.")
    print("  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.")
    print("INFERENCIA:")
    if ta < 0.62 and va < 0.62:
        print("  Desempeno bajo en train y val. Existe evidencia compatible con underfitting,")
        print("  o con optimizacion/representacion insuficiente. Regularizar ahora podria empeorar el ajuste.")
    elif gap > 0.10 and ta > 0.85:
        print("  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia")
        print("  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.")
    elif abs(gap) <= 0.06 and va < 0.62:
        print("  Gap pequeno con desempeno pobre: NO es buena generalizacion; es mal ajuste simetrico.")
    elif abs(gap) <= 0.06 and va >= 0.70:
        print("  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable")
        print("  en ESTE corpus. Con una sola semilla no medimos varianza.")
    else:
        print("  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.")
        print("  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.")
    if d_vt <= 0.03:
        print("  Validation y test son relativamente consistentes: evidencia de comportamiento")
        print("  similar sobre datos no usados para actualizar pesos.")
    elif te + 0.03 < va:
        print("  Test quedo por debajo de validacion. La validacion pudo ser algo optimista;")
        print("  no implica, por si sola, que el protocolo este roto.")
    print("LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.")
    print("DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA")
    print("  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.")


def analizar_generalizacion(fila):
    diagnosticar_modelo(fila)


def comparar_modelos(df, referencia=None):
    # Produce evidencia para decidir. NO declara mecanicamente 'el mejor'.
    print("\n--- Comparacion de modelos (evidencia, no veredicto) ---")
    if df is None or len(df) == 0:
        print("No hay filas que comparar.")
        return
    d = df.copy().reset_index(drop=True)
    i_tr = d["train_acc"].idxmax()
    i_va = d["val_acc"].idxmax()
    i_te = d["test_acc"].idxmax()
    i_gp = d["gap_acc"].abs().idxmin()
    print("1. Mayor train_acc:", f"{d.loc[i_tr, 'modelo']} ({d.loc[i_tr, 'train_acc']:.3f}).")
    print("   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.")
    print("2. Mayor val_acc:", f"{d.loc[i_va, 'modelo']} ({d.loc[i_va, 'val_acc']:.3f}).")
    print("   Este es el criterio honesto de seleccion en desarrollo.")
    print("3. Menor |gap_acc|:", f"{d.loc[i_gp, 'modelo']} ({d.loc[i_gp, 'gap_acc']:+.3f}),",
          f"val_acc={d.loc[i_gp, 'val_acc']:.3f}.")
    print("   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.")
    pobres = d[(d["gap_acc"].abs() <= 0.06) & (d["val_acc"] < 0.62)]
    if len(pobres):
        print("   Filas con gap pequeno y desempeno pobre:",
              ", ".join(pobres["modelo"].astype(str)))
    print("4. Mayor test_acc:", f"{d.loc[i_te, 'modelo']} ({d.loc[i_te, 'test_acc']:.3f}).")
    print("   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.")
    print("5. Coherencia val/test: si el ganador de val no coincide con el de test,")
    print("   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.")
    if str(d.loc[i_va, "modelo"]) != str(d.loc[i_te, "modelo"]):
        print(f"   En esta tabla, val apunta a {d.loc[i_va, 'modelo']} y test a {d.loc[i_te, 'modelo']}.")
        print("   La seleccion de desarrollo sigue siendo la de validacion.")
    else:
        print("   En esta tabla, validacion y test senalan el mismo modelo. Evidencia coherente, no prueba.")
    if "parametros" in d.columns:
        cand = d.loc[i_va]
        print(f"6. Equilibrio desempeno/complejidad (ganador de val): "
              f"{int(cand['parametros']):,} parametros, "
              f"epocas={cand.get('epocas_ejecutadas', '?')}, "
              f"tiempo={cand.get('tiempo_s', float('nan')):.1f}s.")
    print("7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.")
    if referencia is not None and referencia in set(d["modelo"]):
        ref = d.set_index("modelo").loc[referencia]
        print(f"\nRespecto de '{referencia}':")
        for _, row in d.iterrows():
            if row["modelo"] == referencia:
                continue
            dval = row["val_acc"] - ref["val_acc"]
            dtr = row["train_acc"] - ref["train_acc"]
            dgap = row["gap_acc"] - ref["gap_acc"]
            dte = row["test_acc"] - ref["test_acc"]
            nota = ""
            if dtr < -0.03 and dval < -0.03:
                nota = "  -> posible perdida excesiva de capacidad."
            elif dtr < -0.03 and dval > 0.005:
                nota = "  -> se sacrifica train y validation mejora: puede ser regularizacion util."
            print(f"  {row['modelo']}: Dtrain={dtr:+.3f} Dval={dval:+.3f} "
                  f"Dgap={dgap:+.3f} Dtest={dte:+.3f} (test no decide).{nota}")
    print("LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.")
    print("DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.")


def interpretar_intervencion(ref, nueva, nombre="intervencion"):
    # L1/L2/Dropout vs baseline: responder con numeros reales.
    dtr = nueva["train_acc"] - ref["train_acc"]
    dva = nueva["val_acc"] - ref["val_acc"]
    dte = nueva["test_acc"] - ref["test_acc"]
    dgap = nueva["gap_acc"] - ref["gap_acc"]
    print(f"\n--- Lectura de la intervencion: {nombre} vs {ref['modelo']} ---")
    print("OBSERVACION:")
    print(f"  train {ref['train_acc']:.3f}->{nueva['train_acc']:.3f} ({dtr:+.3f})")
    print(f"  val   {ref['val_acc']:.3f}->{nueva['val_acc']:.3f} ({dva:+.3f})")
    print(f"  test  {ref['test_acc']:.3f}->{nueva['test_acc']:.3f} ({dte:+.3f})")
    print(f"  gap   {ref['gap_acc']:+.3f}->{nueva['gap_acc']:+.3f} ({dgap:+.3f})")
    print("INFERENCIA:")
    if dtr < -0.01:
        print("  El accuracy de entrenamiento bajo: la intervencion redujo capacidad efectiva.")
        if dva > 0.005:
            print("  Validation mejoro: sacrificar train puede ser aceptable si generaliza mejor.")
        elif dva < -0.01:
            print("  Validation tambien bajo: evidencia compatible con regularizacion excesiva.")
        else:
            print("  Validation no mejoro de forma clara: la perdida de capacidad podria ser innecesaria.")
    else:
        print("  El entrenamiento no se deterioro de forma clara.")
        if dva > 0.005:
            print("  Validation mejoro sin un sacrificio evidente de train.")
        else:
            print("  Validation no mejoro de forma clara en esta corrida.")
    if dgap < -0.01 and dva <= 0:
        print("  El gap se redujo pero validation no mejoro: reducir el gap no es, por si solo, exito.")
    print("LIMITACION: un lambda/r distinto podria cambiar el signo de estas diferencias.")
    print("DECISION: si val mejoro, la tecnica es candidata; si no, ajustar intensidad o probar otra.")
    print("  Test se reporta para inspeccion, no para elegir.")


def interpretar_barrido(df, col_x, nombre_eje="intensidad"):
    print(f"\n--- Lectura del barrido ({nombre_eje}) ---")
    print("OBSERVACION: train/val/test en cada nivel (evaluate, inferencia).")
    d = df.sort_values(col_x).reset_index(drop=True)
    for _, r in d.iterrows():
        print(f"  {nombre_eje}={r[col_x]}: train={r['train_acc']:.3f}  "
              f"val={r['val_acc']:.3f}  test={r['test_acc']:.3f}  gap={r['gap_acc']:+.3f}")
    i_best = d["val_acc"].idxmax()
    i_low, i_high = 0, len(d) - 1
    print(f"COMPARACION: el mejor val_acc de la grilla es {nombre_eje}={d.loc[i_best, col_x]} "
          f"({d.loc[i_best, 'val_acc']:.3f}).")
    print("INFERENCIA:")
    if d.loc[i_low, "val_acc"] + 0.01 < d.loc[i_best, "val_acc"] and i_best != i_low:
        print(f"  El nivel mas bajo ({d.loc[i_low, col_x]}) no es el de mayor val: "
              "regularizacion nula/debil pudo ser insuficiente.")
    if d.loc[i_high, "train_acc"] < 0.70 and d.loc[i_high, "val_acc"] < 0.70:
        print(f"  El nivel mas alto ({d.loc[i_high, col_x]}) deja train y val bajos: "
              "evidencia compatible con intensidad excesiva / underfitting inducido.")
    elif i_best == i_high:
        print("  El nivel mas alto gano en validacion en ESTA grilla. No generaliza a 'mas es mejor'.")
    print("  Mas regularizacion no significa automaticamente mejor modelo.")
    print("LIMITACION: la grilla es discreta y pedagogica; un valor no explorado podria ser preferible.")
    print("DECISION: elegir el nivel por VALIDACION. test_acc se grafica para inspeccion, no para seleccionar.")


def interpretar_early_stopping(techo, ejecutadas, mejor_epoca, fila_es, fila_base=None):
    ahorradas = techo - ejecutadas
    pct = 100.0 * ahorradas / techo if techo else 0.0
    print("\n--- Lectura de Early Stopping ---")
    print("OBSERVACION (tres relojes):")
    print(f"  maximo permitido = {techo}")
    print(f"  epocas ejecutadas = {ejecutadas}")
    print(f"  mejor epoca segun val_loss = {mejor_epoca}")
    print(f"  epocas_ahorradas = {ahorradas}   porcentaje_ahorro = {pct:.1f}%")
    print("  restore_best_weights=True: los pesos finales son los de la mejor epoca monitorizada,")
    print("  no los de la ultima epoca ejecutada.")
    print("INFERENCIA:")
    if ahorradas > 0:
        print("  Se evito entrenamiento posterior al criterio de parada. Compatible con")
        print("  que continuar hasta el techo no aportaba (o no aportaba lo suficiente) segun val_loss.")
    else:
        print("  Se alcanzo el techo: la validacion aun mejoraba o el ruido supero min_delta.")
    if mejor_epoca + 3 < ejecutadas:
        print(f"  El optimo ocurrio {ejecutadas - mejor_epoca} epocas antes del corte (patience).")
    if fila_base is not None:
        dval = fila_es["val_acc"] - fila_base["val_acc"]
        print(f"  Frente al baseline largo: Dval_acc={dval:+.3f}, "
              f"Depocas={fila_es['epocas_ejecutadas'] - fila_base['epocas_ejecutadas']:+.0f}.")
    print("LIMITACION: monitor=val_loss no maximiza necesariamente val_accuracy.")
    print("DECISION: si el optimo esta claramente antes del techo, Early Stopping es una")
    print("  intervencion barata y combinable. No sustituye a un lambda bien elegido.")


def interpretar_batchnorm(fila_sin, fila_con, hist_sin, hist_con, e_sin, e_con):
    print("\n--- Lectura de Batch Normalization ---")
    print("OBSERVACION:")
    print(f"  sin BN: val_acc={fila_sin['val_acc']:.3f}  train_acc={fila_sin['train_acc']:.3f}  "
          f"tiempo={fila_sin['tiempo_s']:.1f}s  epoca_mitad_val={e_sin}")
    print(f"  con BN: val_acc={fila_con['val_acc']:.3f}  train_acc={fila_con['train_acc']:.3f}  "
          f"tiempo={fila_con['tiempo_s']:.1f}s  epoca_mitad_val={e_con}")
    print("INFERENCIA:")
    dval = fila_con["val_acc"] - fila_sin["val_acc"]
    if e_con < e_sin:
        print("  Con BN, val_loss cruzo antes el punto medio inicio-minimo: compatible con")
        print("  una dinamica de optimizacion mas favorable, no automaticamente con menos overfitting.")
    elif e_con > e_sin:
        print("  En esta corrida BN no acelero ese cruce. Tampoco 'refuta' a BatchNorm en general.")
    else:
        print("  La epoca de cruce fue similar. El valor de BN, si existe, habria que buscarlo")
        print("  en la estabilidad de las curvas o en el accuracy, no en un atajo universal.")
    if abs(dval) < 0.01:
        print("  El accuracy final es similar. Eso NO vacia de informacion a BN: convergencia")
        print("  o estabilidad tambien son resultados relevantes.")
    elif dval > 0:
        print("  Validation mejoro en ESTA configuracion. No se convierte en teorema.")
    else:
        print("  Validation no mejoro. BatchNorm no debe venderse solo como anti-overfitting.")
    print("LIMITACION: BN anade parametros (gamma, beta) y cambia el regimen train/inferencia.")
    print("DECISION: incluir BN si aporta estabilidad o val; no incluirlo por catalogo.")


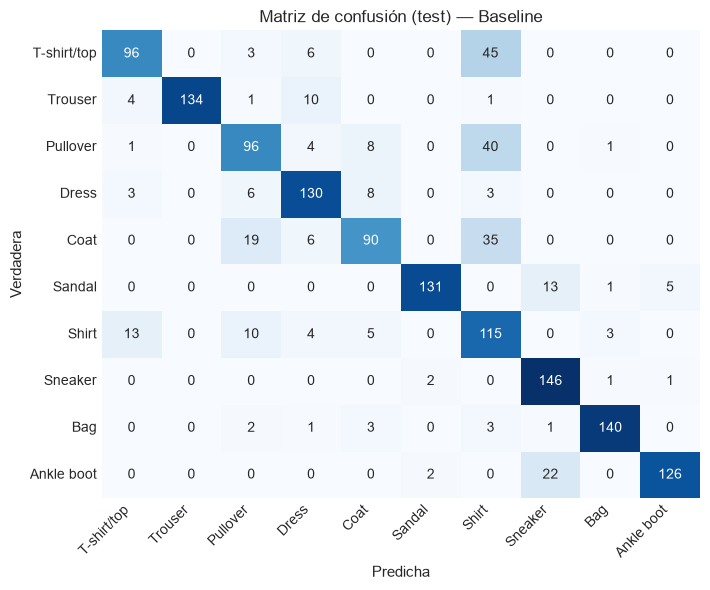
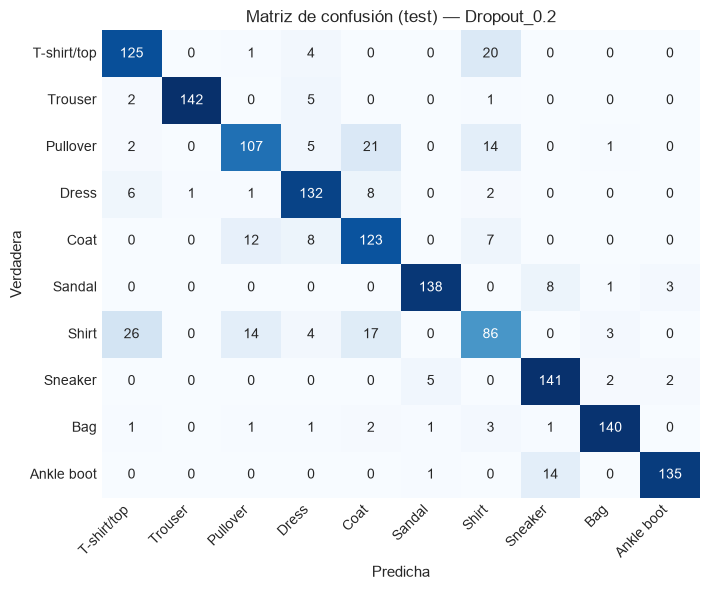
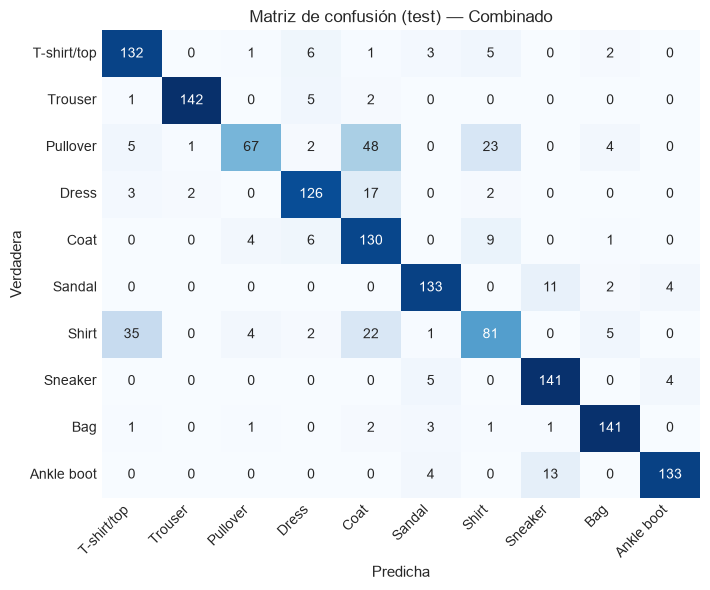
def interpretar_matriz_confusion(cm, nombres=None):
    nombres = list(nombres if nombres is not None else CLASS_NAMES)
    cm_off = cm.copy().astype(int)
    np.fill_diagonal(cm_off, 0)
    pares = []
    for i in range(cm.shape[0]):
        for j in range(cm.shape[1]):
            if i != j and cm_off[i, j] > 0:
                pares.append((int(cm_off[i, j]), i, j))
    pares.sort(reverse=True)
    print("OBSERVACION (matriz): la diagonal son aciertos; fuera de ella, confusiones.")
    if not pares:
        print("  No hay confusiones extra-diagonales en este conjunto.")
        return
    print("  Confusiones mas frecuentes:")
    for n, i, j in pares[:3]:
        sim = abs(cm[j, i] - n) <= max(2, 0.35 * n)
        sim_txt = "asimetrica" if not sim else f"relativamente simetrica (el inverso es {int(cm[j, i])})"
        print(f"    {nombres[i]} -> {nombres[j]}: {n} casos ({sim_txt}).")
    top_n, i0, j0 = pares[0]
    proximas = {"T-shirt/top", "Pullover", "Coat", "Shirt"}
    print("INFERENCIA:")
    if nombres[i0] in proximas and nombres[j0] in proximas:
        print(f"  {nombres[i0]} vs {nombres[j0]} son categorias visualmente proximas en Fashion-MNIST.")
        print("  El error es compatible con solapamiento del problema; no demuestra un bug de codigo.")
    else:
        print("  La celda dominante no se interpreta aqui como error tipico de prendas parecidas.")
        print("  No inventamos una causa visual si las clases no son las usualmente solapadas.")
    print("LIMITACION: la matriz no dice si el umbral argmax es el adecuado para una clase;")
    print("  precision y recall del reporte complementan esta lectura.")
    print("DECISION: si una confusion domina, regularizar el promedio puede no resolverla;")
    print("  habria que mirar esas dos clases en el classification_report.")


def interpretar_classification_report(y_true, y_pred, nombres=CLASS_NAMES):
    rep = classification_report(
        y_true, y_pred, target_names=nombres, digits=3, output_dict=True, zero_division=0
    )
    print(classification_report(y_true, y_pred, target_names=nombres,
                                digits=3, zero_division=0))
    print("Como leer este reporte (y que inferir de ESTOS numeros):")
    print("  precision = entre las veces que el modelo dijo k, cuantas acerto.")
    print("  recall    = entre los ejemplos que SI son k, cuantos recupero.")
    print("  f1        = media armonica (penaliza el desequilibrio precision/recall).")
    print("  support   = ejemplos verdaderos de esa clase en ESTE conjunto.")
    print("  macro avg = media no ponderada (cada clase pesa igual).")
    print("  weighted  = media ponderada por support.")
    print("OBSERVACION / INFERENCIA por clase:")
    hallazgo = False
    for c in nombres:
        if c not in rep:
            continue
        p, r = rep[c]["precision"], rep[c]["recall"]
        if p >= 0.70 and r <= 0.55:
            hallazgo = True
            print(f"  {c}: precision={p:.3f}, recall={r:.3f}. Cuando predice {c} suele acertar,")
            print("    pero deja escapar una proporcion importante de los casos reales (conservador).")
        elif r >= 0.70 and p <= 0.55:
            hallazgo = True
            print(f"  {c}: precision={p:.3f}, recall={r:.3f}. Recupera gran parte de los casos reales,")
            print("    pero genera mas falsos positivos (agresivo).")
    if not hallazgo:
        print("  Ninguna clase muestra un desequilibrio extremo precision/recall con los umbrales")
        print("  usados aqui (0.70/0.55). Eso no implica que no haya clases mas debiles en F1.")
    f1s = {c: rep[c]["f1-score"] for c in nombres if c in rep}
    peores = sorted(f1s, key=f1s.get)[:3]
    print(f"  F1 mas bajos: {peores} -> {[round(f1s[c], 3) for c in peores]}")
    macro, weighted = rep["macro avg"]["f1-score"], rep["weighted avg"]["f1-score"]
    print(f"  macro F1={macro:.3f} | weighted F1={weighted:.3f}")
    if abs(macro - weighted) > 0.02:
        print("  La diferencia macro vs weighted sugiere desempeno no uniforme entre clases")
        print("  (o supports distintos). Con split estratificado, lo mas plausible es heterogeneidad de F1,")
        print("  no un desbalance grave. No afirmamos causalidad solo por esa diferencia.")
    else:
        print("  Macro y weighted proximos: no hay una discrepancia fuerte atribuible a desbalance.")
    print("LIMITACION: accuracy global puede ocultar una clase (p. ej. Shirt) que no generaliza.")
    print("  Precision alta no implica recall alto. AUC, si se usa, no sustituye este perfil.")
    return rep


def entrenar(model, epochs, nombre, callbacks_list=None, verbose=0):
    # Envuelve fit() midiendo tiempo. El baseline tambien mostrara fit explicito.
    t0 = time.perf_counter()
    history = model.fit(
        X_train, y_train,
        validation_data=(X_val, y_val),
        epochs=epochs,
        batch_size=BATCH_SIZE,
        callbacks=callbacks_list or [],
        verbose=verbose,
    )
    tiempo = time.perf_counter() - t0
    print(f"{nombre}: {tiempo:.1f} s, {len(history.history['loss'])} épocas ejecutadas")
    return history, tiempo


print("Funciones listas. RESULTADOS tiene", len(RESULTADOS), "filas.")
Funciones listas. RESULTADOS tiene 0 filas.

4.5. Experimento: tres regímenes sobre el mismo dataset

Construimos tres MLP que comparten particiones, pérdida, optimizador y preprocesamiento. Solo cambia la capacidad (y, en A, un presupuesto de épocas deliberadamente corto):

Modelo Arquitectura Épocas Intención
A 8 unidades, 1 capa oculta pocas capacidad e hipótesis de entrenamiento insuficientes
B 64 y 32 unidades presupuesto medio capacidad moderada
C 256, 256 y 128 presupuesto completo capacidad alta, susceptible de memorizar

No afirmamos de antemano que B será “el bueno”. Eso lo dirán las curvas. C será, además, el baseline de las secciones siguientes: la red que sabemos propensa a sobreajustar y sobre la que intervendremos.

Construcción explícita

Mostramos las tres arquitecturas en código, sin regularización, sin Dropout, sin Batch Normalization y sin Early Stopping.

# Tres capacidades, mismas particiones. Sin L1/L2, Dropout, BatchNorm ni Early Stopping.

def compilar(model, lr=LEARNING_RATE):
    model.compile(
        optimizer=Adam(learning_rate=lr),
        loss="sparse_categorical_crossentropy",
        metrics=["accuracy"],
    )
    return model


tf.keras.utils.set_random_seed(SEED)
modelo_A = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(8, activation="relu", name="oculta_estrecha"),
    Dense(N_CLASSES, activation="softmax", name="salida"),
], name="modelo_A")
compilar(modelo_A)

tf.keras.utils.set_random_seed(SEED)
modelo_B = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(64, activation="relu", name="oculta_1"),
    Dense(32, activation="relu", name="oculta_2"),
    Dense(N_CLASSES, activation="softmax", name="salida"),
], name="modelo_B")
compilar(modelo_B)

tf.keras.utils.set_random_seed(SEED)
modelo_C = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, activation="relu", name="oculta_1"),
    Dense(256, activation="relu", name="oculta_2"),
    Dense(128, activation="relu", name="oculta_3"),
    Dense(N_CLASSES, activation="softmax", name="salida"),
], name="modelo_C_baseline")
compilar(modelo_C)

print("Parámetros A/B/C:", modelo_A.count_params(), modelo_B.count_params(), modelo_C.count_params())
print("\nEl modelo C (baseline) tiene aproximadamente "
      f"{modelo_C.count_params()/modelo_A.count_params():.0f} veces más parámetros que A.")
Parámetros A/B/C: 6370 52650 300938

El modelo C (baseline) tiene aproximadamente 47 veces más parámetros que A.
# Entrenamiento de los tres escenarios
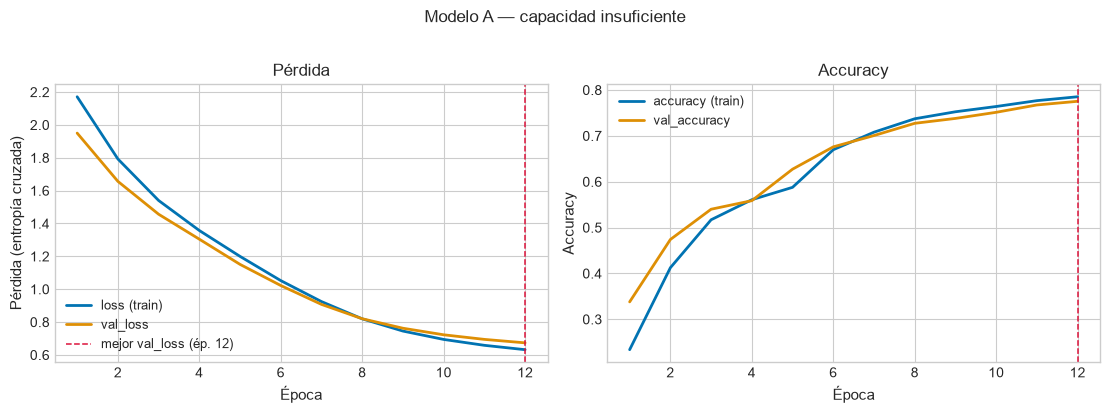
history_A, tiempo_A = entrenar(modelo_A, epochs=12, nombre="Modelo A")
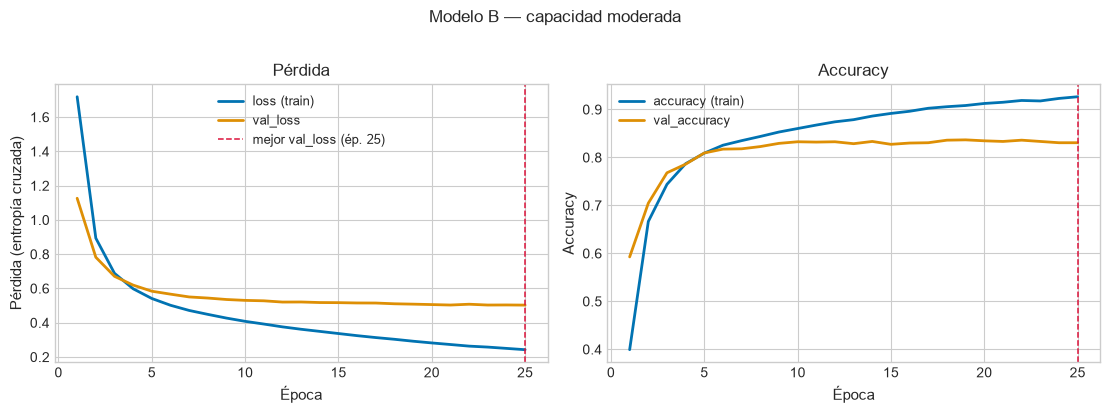
history_B, tiempo_B = entrenar(modelo_B, epochs=EPOCHS_SCENARIOS, nombre="Modelo B")
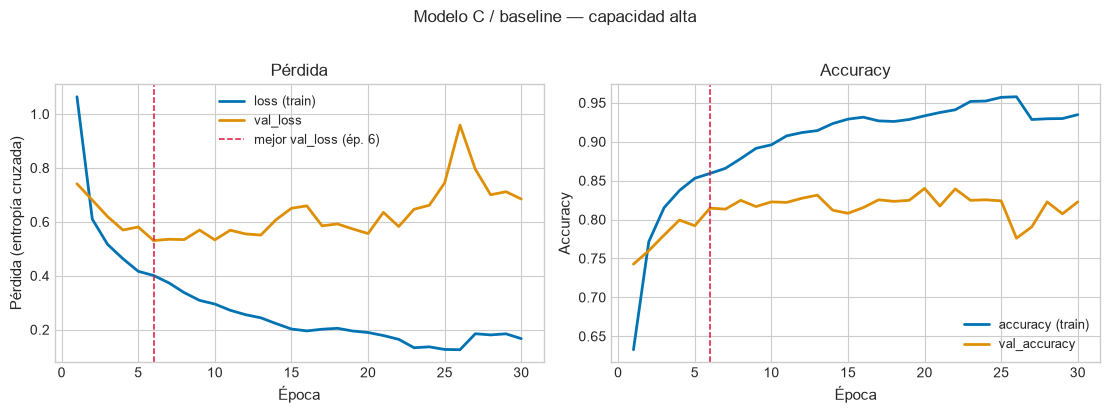
history_C, tiempo_C = entrenar(modelo_C, epochs=EPOCHS_FULL, nombre="Modelo C / baseline")

# El baseline oficial de la sesión ES el modelo C
modelo_baseline = modelo_C
history_baseline = history_C
tiempo_baseline = tiempo_C
Modelo A: 1.7 s, 12 épocas ejecutadas
Modelo B: 3.3 s, 25 épocas ejecutadas
Modelo C / baseline: 5.3 s, 30 épocas ejecutadas

Preguntas — observe las curvas antes de leer el reporte automático

Ejecute la siguiente celda (solo gráficos) y deténgase:

  1. ¿En qué modelo train y val permanecen ambos en un desempeño pobre?
  2. ¿En qué modelo aparece una divergencia: loss baja y val_loss deja de bajar o sube?
  3. ¿En qué época aproximada empezaría usted a dudar del modelo C?
  4. ¿Detendría el entrenamiento de C? ¿Con qué criterio?
  5. ¿Qué técnica probaría primero: reducir capacidad, regularizar o Early Stopping?

No busque un umbral universal. Busque el patrón.

# Solo gráficas — interprete usted antes de ejecutar analyze_history
plot_history(history_A, titulo="Modelo A — capacidad insuficiente")
plot_history(history_B, titulo="Modelo B — capacidad moderada")
plot_history(history_C, titulo="Modelo C / baseline — capacidad alta")

6

Ahora sí: medición e interpretación calculadas

Las siguientes celdas no inventan la época de corte: la leen de val_loss.

# Reportes automáticos + registro. C se registra como baseline.
fila_A = registrar("A_under", modelo_A, history_A, tiempo_A,
                   hparams={"unidades": [8], "epocas": 12})
fila_B = registrar("B_medio", modelo_B, history_B, tiempo_B,
                   hparams={"unidades": [64, 32], "epocas": EPOCHS_SCENARIOS})
fila_baseline = registrar(
    "Baseline", modelo_baseline, history_baseline, tiempo_baseline,
    hparams={"unidades": [256, 256, 128], "epocas": EPOCHS_FULL,
             "l1": 0.0, "l2": 0.0, "dropout": 0.0, "batchnorm": False},
)

tabla_abc = pd.DataFrame([fila_A, fila_B, fila_baseline])[
    ["modelo", "parametros", "epocas_ejecutadas", "mejor_epoca",
     "train_loss", "val_loss", "train_acc", "val_acc", "test_acc", "gap_acc", "tiempo_s"]
]
print("\nComparación de los tres regímenes (métricas de evaluate, modo inferencia):")
display(tabla_abc.style.format({
    "train_loss": "{:.3f}", "val_loss": "{:.3f}",
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))

for fila in (fila_A, fila_B, fila_baseline):
    analizar_generalizacion(fila)
comparar_modelos(pd.DataFrame([fila_A, fila_B, fila_baseline]), referencia="Baseline")
========================================================================
REPORTE DE HISTORY — A_under
========================================================================
Épocas ejecutadas: 12
Mejor val_loss: 0.6736  en la época 12
  loss (train) en esa época:     0.6319
  accuracy (train) en esa época: 0.7853
  val_accuracy en esa época:     0.7753
  Gap_acc (train - val):         +0.0099
  Gap_loss (val - train):        +0.0416
Valores FINALES (época 12):
  loss=0.6319  val_loss=0.6736  acc=0.7853  val_acc=0.7753
  Gap_acc final: +0.0099   Gap_loss final: +0.0416
La mejor val_loss ocurrió en la última época: no hay tramo posterior que analizar.

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso A (guia, no regla absoluta).
OBSERVACION: Train y validation evolucionan en la misma direccion, o el optimo de val_loss esta al final.
INFERENCIA:  El modelo parece seguir aprendiendo patrones que tambien funcionan fuera de D_train. Eso no demuestra que el nivel absoluto sea satisfactorio.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Revisar el nivel absoluto de las metricas. No celebrar solo la ausencia de divergencia.
========================================================================

[registro] A_under: test_acc=0.7633  val_acc=0.7753  gap_acc=+0.0184  params=6370  tiempo=1.7s
========================================================================
REPORTE DE HISTORY — B_medio
========================================================================
Épocas ejecutadas: 25
Mejor val_loss: 0.5028  en la época 25
  loss (train) en esa época:     0.2426
  accuracy (train) en esa época: 0.9265
  val_accuracy en esa época:     0.8307
  Gap_acc (train - val):         +0.0958
  Gap_loss (val - train):        +0.2602
Valores FINALES (época 25):
  loss=0.2426  val_loss=0.5028  acc=0.9265  val_acc=0.8307
  Gap_acc final: +0.0958   Gap_loss final: +0.2602
La mejor val_loss ocurrió en la última época: no hay tramo posterior que analizar.

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso A (guia, no regla absoluta).
OBSERVACION: Train y validation evolucionan en la misma direccion, o el optimo de val_loss esta al final.
INFERENCIA:  El modelo parece seguir aprendiendo patrones que tambien funcionan fuera de D_train. Eso no demuestra que el nivel absoluto sea satisfactorio.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Revisar el nivel absoluto de las metricas. No celebrar solo la ausencia de divergencia.
========================================================================

[registro] B_medio: test_acc=0.8373  val_acc=0.8307  gap_acc=+0.0966  params=52650  tiempo=3.3s
========================================================================
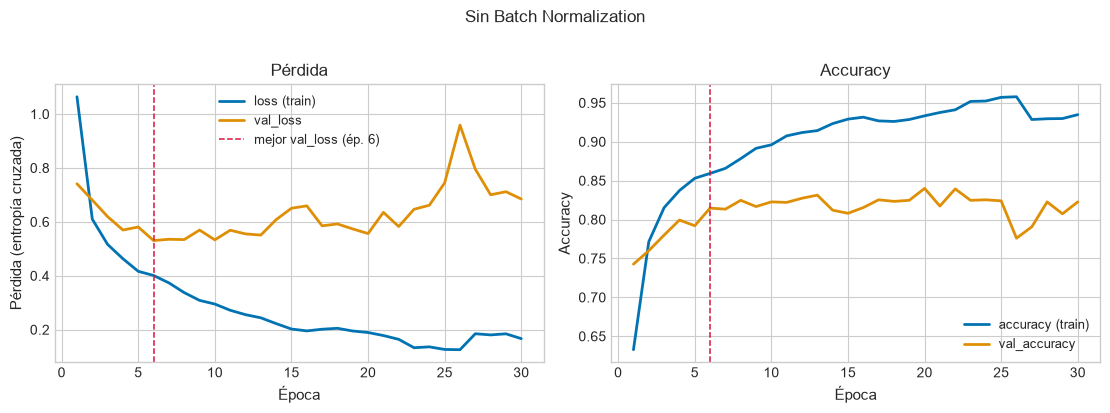
REPORTE DE HISTORY — Baseline
========================================================================
Épocas ejecutadas: 30
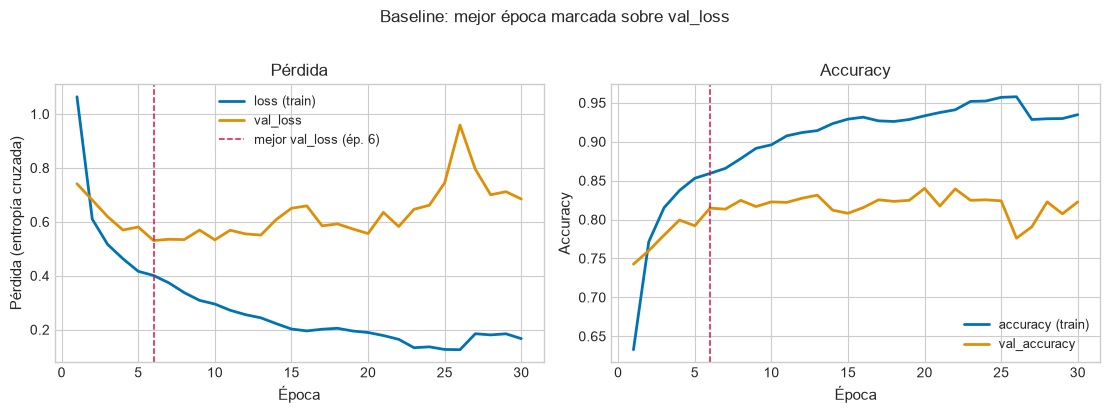
Mejor val_loss: 0.5305  en la época 6
  loss (train) en esa época:     0.4009
  accuracy (train) en esa época: 0.8593
  val_accuracy en esa época:     0.8147
  Gap_acc (train - val):         +0.0446
  Gap_loss (val - train):        +0.1296
Valores FINALES (época 30):
  loss=0.1665  val_loss=0.6847  acc=0.9348  val_acc=0.8227
  Gap_acc final: +0.1121   Gap_loss final: +0.5182
Después de la época 6 hay 24 época(s) adicionales.
  Δ loss train (final - mejor): -0.2344  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.1542  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00888, val=+0.00991

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.2344, Delta val_loss=+0.1542, tramo posterior=24 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] Baseline: test_acc=0.8027  val_acc=0.8227  gap_acc=+0.0943  params=300938  tiempo=5.3s

Comparación de los tres regímenes (métricas de evaluate, modo inferencia):
  modelo parametros epocas_ejecutadas mejor_epoca train_loss val_loss train_acc val_acc test_acc gap_acc tiempo_s
0 A_under 6370 12 12 0.617 0.674 0.794 0.775 0.763 +0.018 1.7
1 B_medio 52650 25 25 0.226 0.503 0.927 0.831 0.837 +0.097 3.3
2 Baseline 300938 30 6 0.211 0.685 0.917 0.823 0.803 +0.094 5.3

--- Diagnostico: A_under ---
OBSERVACION:
  train_acc=0.794  val_acc=0.775  test_acc=0.763
  gap_acc (train-val)=+0.018  |val-test|=0.012
  train_loss=0.617  val_loss=0.674  test_loss=0.680
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: B_medio ---
OBSERVACION:
  train_acc=0.927  val_acc=0.831  test_acc=0.837
  gap_acc (train-val)=+0.097  |val-test|=0.007
  train_loss=0.226  val_loss=0.503  test_loss=0.499
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.
  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: Baseline ---
OBSERVACION:
  train_acc=0.917  val_acc=0.823  test_acc=0.803
  gap_acc (train-val)=+0.094  |val-test|=0.020
  train_loss=0.211  val_loss=0.685  test_loss=0.676
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.
  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Comparacion de modelos (evidencia, no veredicto) ---
1. Mayor train_acc: B_medio (0.927).
   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.
2. Mayor val_acc: B_medio (0.831).
   Este es el criterio honesto de seleccion en desarrollo.
3. Menor |gap_acc|: A_under (+0.018), val_acc=0.775.
   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.
4. Mayor test_acc: B_medio (0.837).
   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.
5. Coherencia val/test: si el ganador de val no coincide con el de test,
   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.
   En esta tabla, validacion y test senalan el mismo modelo. Evidencia coherente, no prueba.
6. Equilibrio desempeno/complejidad (ganador de val): 52,650 parametros, epocas=25, tiempo=3.3s.
7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.

Respecto de 'Baseline':
  A_under: Dtrain=-0.123 Dval=-0.047 Dgap=-0.076 Dtest=-0.039 (test no decide).  -> posible perdida excesiva de capacidad.
  B_medio: Dtrain=+0.010 Dval=+0.008 Dgap=+0.002 Dtest=+0.035 (test no decide).
LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.
DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.

Cierre del experimento de regímenes

Observación. Tres redes, un solo split, tres dinámicas. Los reportes de la celda anterior dicen en qué época se minimizó val_loss y si, después, el entrenamiento siguió bajando mientras la validación subía.

Inferencia. Si A tiene train y val bajos, la evidencia es compatible con underfitting por capacidad/tiempo. Si C muestra divergencia, la evidencia es compatible con overfitting. B puede quedar en un punto intermedio —o no: si B también diverge, el corpus es lo bastante pequeño como para que cualquier MLP con suficientes épocas memorize.

Decisión. El baseline de las técnicas de regularización será C: intervendremos sobre una red que puede sobreajustar. Elegir como baseline una red que ya no aprende nos impediría ver el efecto de L2 o Dropout.

Qué no afirmar. Que 256-256-128 sea “demasiada capacidad” en general, ni que 8 unidades sean siempre insuficientes. Eso es relativo a este corpus de 4 000 ejemplos.


5. Modelo baseline: leer la capacidad antes de regularizar

El baseline ya está entrenado (modelo C). No le añadimos L1, L2, Dropout, Batch Normalization ni Early Stopping. Su papel es ser el referente injusto consigo mismo: si una técnica no lo mejora en validación, no hay motivo para preferirla.

5.1. model.summary() no es un trámite

El resumen de Keras responde tres preguntas de diseño:

  1. ¿Cuántas capas transforman la representación? Cada Dense es una proyección afín más no linealidad (salvo la softmax de salida).
  2. ¿Cuántos parámetros se aprenden? En una capa densa de \(n_{\mathrm{in}}\) a \(n_{\mathrm{out}}\),
    \(\#\{W,b\} = n_{\mathrm{in}}\cdot n_{\mathrm{out}} + n_{\mathrm{out}}\).
  3. ¿Qué relación hay entre esa cifra y el tamaño de \(D_{\mathrm{train}}\)?
    Una heurística tosca —no una ley— es comparar el número de parámetros con el número de ejemplos. Si hay muchísimos más parámetros que ejemplos, el modelo puede interpolar el entrenamiento. Puede, no debe: la dinámica del SGD y la estructura de los datos a veces regularizan de facto. Por eso medimos, no suponemos.
# Lectura pedagógica del summary del baseline
modelo_baseline.summary()

def explicar_summary(model):
    print("\n--- Cómo leer este summary ---")
    densas = [L for L in model.layers if isinstance(L, Dense)]
    print(f"Capas Dense: {len(densas)} (la última es la clasificación a {N_CLASSES} clases).")
    total = int(model.count_params())
    entrenables = int(np.sum([np.prod(v.shape) for v in model.trainable_weights]))
    print(f"Parámetros totales: {total:,}  |  entrenables: {entrenables:,}")
    print(f"Ejemplos de entrenamiento: {len(X_train):,}")
    print(f"Razón parámetros / ejemplos: {total / len(X_train):.1f}")
    print("\nDesglose de cada Dense:")
    # reconstruir n_in desde INPUT_DIM
    n_in = INPUT_DIM
    for L in densas:
        n_out = int(L.units)
        n_w = n_in * n_out
        n_b = n_out
        print(f"  {L.name}: {n_in} → {n_out}  |  W={n_w:,}  b={n_b:,}  total={n_w+n_b:,}")
        n_in = n_out
    print(
        "\nRelación con el riesgo de sobreajuste: una razón alta significa que el modelo "
        "*tiene capacidad* de memorizar D_train. No implica que lo haya hecho: eso se "
        "lee en las curvas y en el gap, no en el summary."
    )

explicar_summary(modelo_baseline)

print("\nMétricas ya registradas del baseline:")
for k in ["parametros", "mejor_epoca", "train_acc", "val_acc", "test_acc",
          "train_loss", "val_loss", "gap_acc", "tiempo_s", "epocas_ejecutadas"]:
    print(f"  {k}: {fila_baseline[k]}")
Model: "modelo_C_baseline"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ oculta_1 (Dense)                │ (None, 256)            │       200,960 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ oculta_2 (Dense)                │ (None, 256)            │        65,792 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ oculta_3 (Dense)                │ (None, 128)            │        32,896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ salida (Dense)                  │ (None, 10)             │         1,290 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 902,816 (3.44 MB)
 Trainable params: 300,938 (1.15 MB)
 Non-trainable params: 0 (0.00 B)
 Optimizer params: 601,878 (2.30 MB)

--- Cómo leer este summary ---
Capas Dense: 4 (la última es la clasificación a 10 clases).
Parámetros totales: 300,938  |  entrenables: 300,938
Ejemplos de entrenamiento: 4,000
Razón parámetros / ejemplos: 75.2

Desglose de cada Dense:
  oculta_1: 784 → 256  |  W=200,704  b=256  total=200,960
  oculta_2: 256 → 256  |  W=65,536  b=256  total=65,792
  oculta_3: 256 → 128  |  W=32,768  b=128  total=32,896
  salida: 128 → 10  |  W=1,280  b=10  total=1,290

Relación con el riesgo de sobreajuste: una razón alta significa que el modelo *tiene capacidad* de memorizar D_train. No implica que lo haya hecho: eso se lee en las curvas y en el gap, no en el summary.

Métricas ya registradas del baseline:
  parametros: 300938
  mejor_epoca: 6
  train_acc: 0.9169999957084656
  val_acc: 0.8226666450500488
  test_acc: 0.8026666641235352
  train_loss: 0.21125812828540802
  val_loss: 0.684710681438446
  gap_acc: 0.09433335065841675
  tiempo_s: 5.290996499999892
  epocas_ejecutadas: 30

6. Cómo leer un history de Keras

model.fit devuelve un objeto History. Su atributo .history es un diccionario de listas, una entrada por época. Entender las claves es el alfabeto de toda la sesión.

# Anatomía de history.history
print("Claves de history_baseline.history:", list(history_baseline.history.keys()))
print("Longitud de cada serie:", {k: len(v) for k, v in history_baseline.history.items()})

print("Que representa cada serie")
print("-------------------------")
print("loss         : promedio de la perdida SOBRE LOS LOTES DE ENTRENAMIENTO")
print("               de esa epoca. Es la cantidad que el descenso de gradiente")
print("               esta minimizando (mas L1/L2 si las hubiera).")
print("accuracy     : fraccion de aciertos en esos mismos lotes, con las")
print("               regularizaciones estocasticas ACTIVAS (p. ej. Dropout).")
print("val_loss     : perdida media en D_val al CIERRE de la epoca, en modo")
print("               inferencia (Dropout apagado; BatchNorm usa medias moviles).")
print("val_accuracy : aciertos en D_val en las mismas condiciones de inferencia.")
print("Implicacion: comparar history['accuracy'] con history['val_accuracy'] cuando")
print("hay Dropout NO es comparar dos numeros en el mismo regimen. Por eso, en las")
print("tablas finales usamos evaluate() —siempre en inferencia— para train, val y test.")

# Reporte ya definido: lo reejecutamos para anclar la lectura
info_base = analyze_history(history_baseline, nombre="Baseline (relectura)")
plot_history(history_baseline, titulo="Baseline: mejor época marcada sobre val_loss")
Claves de history_baseline.history: ['accuracy', 'loss', 'val_accuracy', 'val_loss']
Longitud de cada serie: {'accuracy': 30, 'loss': 30, 'val_accuracy': 30, 'val_loss': 30}
Que representa cada serie
-------------------------
loss         : promedio de la perdida SOBRE LOS LOTES DE ENTRENAMIENTO
               de esa epoca. Es la cantidad que el descenso de gradiente
               esta minimizando (mas L1/L2 si las hubiera).
accuracy     : fraccion de aciertos en esos mismos lotes, con las
               regularizaciones estocasticas ACTIVAS (p. ej. Dropout).
val_loss     : perdida media en D_val al CIERRE de la epoca, en modo
               inferencia (Dropout apagado; BatchNorm usa medias moviles).
val_accuracy : aciertos en D_val en las mismas condiciones de inferencia.
Implicacion: comparar history['accuracy'] con history['val_accuracy'] cuando
hay Dropout NO es comparar dos numeros en el mismo regimen. Por eso, en las
tablas finales usamos evaluate() —siempre en inferencia— para train, val y test.
========================================================================
REPORTE DE HISTORY — Baseline (relectura)
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 0.5305  en la época 6
  loss (train) en esa época:     0.4009
  accuracy (train) en esa época: 0.8593
  val_accuracy en esa época:     0.8147
  Gap_acc (train - val):         +0.0446
  Gap_loss (val - train):        +0.1296
Valores FINALES (época 30):
  loss=0.1665  val_loss=0.6847  acc=0.9348  val_acc=0.8227
  Gap_acc final: +0.1121   Gap_loss final: +0.5182
Después de la época 6 hay 24 época(s) adicionales.
  Δ loss train (final - mejor): -0.2344  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.1542  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00888, val=+0.00991

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.2344, Delta val_loss=+0.1542, tramo posterior=24 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

6

Observación · inferencia · decisión (II) — baseline

Use los números impresos por la celda anterior, no un recuerdo:

  • Observación. Enuncie en una frase qué hacen loss y val_loss después de la mejor época que el código calculó.
  • Inferencia. Si loss sigue bajando y val_loss sube, el patrón es compatible con sobreajuste. Si ambas bajan hasta el final, la evidencia de overfitting en este run es débil (aún podría haber gap de accuracy).
  • Decisión. Un siguiente paso razonable es una intervención: L2, Dropout o Early Stopping, no las tres a la vez. Así sabremos a cuál atribuir el cambio.

Qué no afirmar. Que el baseline “no sirve”. Sirve precisamente como testigo. Tampoco que el test_acc del registro sea el criterio para elegir la próxima técnica: esa elección se hace con validación.


7. Regularización L1

7.1. Qué le hacemos a la función objetivo

La pérdida que el optimizador ve deja de ser solo \(J(\theta)\) (entropía cruzada empírica) y pasa a ser

\[ J_{L1}(\mathbf{w}) = J(\mathbf{w}) + \lambda \sum_i |w_i|. \]

\(\lambda \ge 0\) es un hiperparámetro: no se aprende por backpropagation en este esquema; lo elegimos nosotros (con validación). \(\lambda = 0\) recupera el baseline. \(\lambda\) grande hace que disminuir la magnitud de los pesos compita, en cada paso, con disminuir el error de entrenamiento.

7.2. Por qué penalizar pesos

Cada peso es un grado de libertad para ajustar \(D_{\mathrm{train}}\). Pesos grandes permiten fronteras muy flexibles y respuestas muy confiadas a patrones idiosincráticos. Penalizar \(\sum |w_i|\) encarece esa flexibilidad.

L1, además, no es rotacionalmente invariante de la misma manera que L2 y tiende a soluciones dispersas: muchos \(w_i\) cerca de cero, unos pocos distintos de cero. Intuición de subgradiente: \(\partial |w|/\partial w = \mathrm{sign}(w)\) para \(w \neq 0\), una fuerza constante hacia el origen, no proporcional a \(|w|\). Eso “apaga” pesos pequeños con más decisión que L2.

Un peso \(\approx 0\) se interpreta como: esta conexión apenas participa en la función implementada. No implica causalidad (“ese píxel no importa en la moda”): implica parsimonia en esta solución.

7.3. Costo esperado

Si \(\lambda\) es excesivo, \(J_{L1}\) se minimiza achicando pesos aunque \(J\) quede alta: underfitting inducido. Por eso no preguntamos solo “¿bajó el gap?” sino “¿subió o bajó la validación? ¿y el test, al final?”.

# Modelo L1: misma capacidad que el baseline, una sola intervención (penalización L1)
LAMBDA_L1 = 1e-4

tf.keras.utils.set_random_seed(SEED)
modelo_L1 = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, activation="relu", kernel_regularizer=regularizers.l1(LAMBDA_L1)),
    Dense(256, activation="relu", kernel_regularizer=regularizers.l1(LAMBDA_L1)),
    Dense(128, activation="relu", kernel_regularizer=regularizers.l1(LAMBDA_L1)),
    Dense(N_CLASSES, activation="softmax"),
], name="modelo_L1")
compilar(modelo_L1)

modelo_L1.summary()
print(f"\nIntervención: kernel_regularizer=L1(λ={LAMBDA_L1})")
print("Todo lo demás se mantiene comparable: capacidad, lr, batch, épocas, split, semilla.")

history_L1, tiempo_L1 = entrenar(modelo_L1, epochs=EPOCHS_COMPARE, nombre="L1")
Model: "modelo_L1"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 256)            │       200,960 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 256)            │        65,792 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense)                 │ (None, 128)            │        32,896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_3 (Dense)                 │ (None, 10)             │         1,290 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 300,938 (1.15 MB)
 Trainable params: 300,938 (1.15 MB)
 Non-trainable params: 0 (0.00 B)

Intervención: kernel_regularizer=L1(λ=0.0001)
Todo lo demás se mantiene comparable: capacidad, lr, batch, épocas, split, semilla.
L1: 5.8 s, 30 épocas ejecutadas

Preguntas antes del reporte

  1. ¿val_loss de L1 es más estable que la del baseline, o simplemente más alta?
  2. ¿El accuracy de entrenamiento bajó? Si bajó mucho, ¿estamos mirando menos overfitting o más underfitting?
  3. ¿Reducir el gap bastaría para declarar éxito?
plot_history(history_L1, titulo=f"L1 (λ={LAMBDA_L1})")
fila_L1 = registrar("L1", modelo_L1, history_L1, tiempo_L1,
                    hparams={"l1": LAMBDA_L1, "unidades": [256, 256, 128]})

# Comparación de magnitudes de pesos: baseline vs L1
w_base = recolectar_pesos(modelo_baseline)
w_l1 = recolectar_pesos(modelo_L1)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.0), sharey=True)
for ax, w, titulo in [
    (axes[0], w_base, "Baseline (sin penalización)"),
    (axes[1], w_l1, f"L1 (λ={LAMBDA_L1})"),
]:
    ax.hist(w, bins=60, density=True, alpha=0.85)
    ax.axvline(0, color="crimson", lw=1)
    ax.set_title(titulo)
    ax.set_xlabel("valor del peso (kernels Dense)")
    ax.set_xlim(-0.35, 0.35)
axes[0].set_ylabel("densidad")
fig.suptitle("Distribución de pesos: ¿L1 concentró masa cerca de cero?", y=1.02)
plt.tight_layout()
plt.show()

frac_base = np.mean(np.abs(w_base) < 1e-3)
frac_l1 = np.mean(np.abs(w_l1) < 1e-3)
print(f"Fracción de pesos con |w| < 1e-3  |  baseline={frac_base:.3f}  L1={frac_l1:.3f}")
print(f"Mediana |w|  |  baseline={np.median(np.abs(w_base)):.4f}  L1={np.median(np.abs(w_l1)):.4f}")

print("Las preguntas de regularizacion se responden abajo con los numeros de ESTA corrida.")
print(f"  ¿Disminuyó el gap_acc respecto al baseline?  "
      f"baseline={fila_baseline['gap_acc']:+.3f}  L1={fila_L1['gap_acc']:+.3f}")
print(f"  ¿Subió o bajó val_acc?  baseline={fila_baseline['val_acc']:.3f}  L1={fila_L1['val_acc']:.3f}")
print(f"  ¿Mejoró test_acc?       baseline={fila_baseline['test_acc']:.3f}  L1={fila_L1['test_acc']:.3f}")
print("  La reducción del gap NO implica, por sí sola, un mejor modelo.")
interpretar_intervencion(fila_baseline, fila_L1, nombre="L1")
diagnosticar_modelo(fila_L1)

========================================================================
REPORTE DE HISTORY — L1
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 1.0177  en la época 30
  loss (train) en esa época:     0.6413
  accuracy (train) en esa época: 0.9367
  val_accuracy en esa época:     0.8313
  Gap_acc (train - val):         +0.1054
  Gap_loss (val - train):        +0.3764
Valores FINALES (época 30):
  loss=0.6413  val_loss=1.0177  acc=0.9367  val_acc=0.8313
  Gap_acc final: +0.1054   Gap_loss final: +0.3764
La mejor val_loss ocurrió en la última época: no hay tramo posterior que analizar.

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso A (guia, no regla absoluta).
OBSERVACION: Train y validation evolucionan en la misma direccion, o el optimo de val_loss esta al final.
INFERENCIA:  El modelo parece seguir aprendiendo patrones que tambien funcionan fuera de D_train. Eso no demuestra que el nivel absoluto sea satisfactorio.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Revisar el nivel absoluto de las metricas. No celebrar solo la ausencia de divergencia.
========================================================================

[registro] L1: test_acc=0.8307  val_acc=0.8313  gap_acc=+0.1009  params=300938  tiempo=5.8s

Fracción de pesos con |w| < 1e-3  |  baseline=0.011  L1=0.516
Mediana |w|  |  baseline=0.0471  L1=0.0009
Las preguntas de regularizacion se responden abajo con los numeros de ESTA corrida.
  ¿Disminuyó el gap_acc respecto al baseline?  baseline=+0.094  L1=+0.101
  ¿Subió o bajó val_acc?  baseline=0.823  L1=0.831
  ¿Mejoró test_acc?       baseline=0.803  L1=0.831
  La reducción del gap NO implica, por sí sola, un mejor modelo.

--- Lectura de la intervencion: L1 vs Baseline ---
OBSERVACION:
  train 0.917->0.932 (+0.015)
  val   0.823->0.831 (+0.009)
  test  0.803->0.831 (+0.028)
  gap   +0.094->+0.101 (+0.007)
INFERENCIA:
  El entrenamiento no se deterioro de forma clara.
  Validation mejoro sin un sacrificio evidente de train.
LIMITACION: un lambda/r distinto podria cambiar el signo de estas diferencias.
DECISION: si val mejoro, la tecnica es candidata; si no, ajustar intensidad o probar otra.
  Test se reporta para inspeccion, no para elegir.

--- Diagnostico: L1 ---
OBSERVACION:
  train_acc=0.932  val_acc=0.831  test_acc=0.831
  gap_acc (train-val)=+0.101  |val-test|=0.001
  train_loss=0.649  val_loss=1.018  test_loss=1.014
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

Observación · inferencia · decisión (III) — L1

Observación. Compare gap, val_acc y la fracción de pesos pequeños impresos arriba.

Inferencia. - Gap menor y val_acc mayor: evidencia compatible con regularización útil. - Gap menor y val_acc menor: evidencia compatible con regularización excesiva (se “arregló” el gap empobreciendo ambos conjuntos). - Pesos más concentrados en cero: compatible con el efecto de dispersión de L1; no prueba que las conexiones nulas sean las “correctas”.

Decisión. Si L1 ayudó en validación, es una candidata. Si no, no la descartamos para siempre: quizá \(\lambda\) era inadecuado. Eso se investiga en la sección 9, con L2, porque el barrido de \(\lambda\) es más estable y habitual en MLP.


8. Regularización L2

8.1. Penalización cuadrática

\[ J_{L2}(\mathbf{w}) = J(\mathbf{w}) + \lambda \sum_i w_i^2. \]

El subgradiente (gradiente) de \(w_i^2\) es \(2w_i\): la fuerza hacia el origen es proporcional a la magnitud. Los pesos grandes se contraen con más energía; los ya pequeños, poco. Por eso L2 encoge pero no induce dispersión tan marcada como L1.

8.2. Diferencia conceptual con L1

L1 L2
Penalización \(\sum |w_i|\) \(\sum w_i^2\)
Efecto típico soluciones más dispersas pesos pequeños en conjunto
Gradiente cerca de 0 constante en magnitud \(\to 0\)
Uso frecuente en DL selección implícita / sparsidad default de “weight decay”

8.3. \(\lambda\) y weight decay

En SGD clásico, añadir \(\lambda \|\mathbf{w}\|_2^2\) a la pérdida es equivalente (salvo factores 2) a un paso de weight decay: \(w \leftarrow (1 - \eta\lambda') w\) antes o junto con el gradiente de \(J\). En Adam, la equivalencia no es exacta: Adam adapta momentos por coordenada, y el decoupled weight decay (AdamW) no es idéntico a L2-en-la-pérdida. En este notebook usamos kernel_regularizer=l2(...), es decir, L2 en la función objetivo, compilada con Adam. No afirmamos que sea AdamW.

\(\lambda\) pequeño: apenas se nota. \(\lambda\) grande: el modelo no se atreve a usar pesos y underfittea.

# Modelo L2: misma capacidad, una sola intervención
LAMBDA_L2 = 1e-3

tf.keras.utils.set_random_seed(SEED)
modelo_L2 = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, activation="relu", kernel_regularizer=regularizers.l2(LAMBDA_L2)),
    Dense(256, activation="relu", kernel_regularizer=regularizers.l2(LAMBDA_L2)),
    Dense(128, activation="relu", kernel_regularizer=regularizers.l2(LAMBDA_L2)),
    Dense(N_CLASSES, activation="softmax"),
], name="modelo_L2")
compilar(modelo_L2)

print(f"Intervención: kernel_regularizer=L2(λ={LAMBDA_L2})")
history_L2, tiempo_L2 = entrenar(modelo_L2, epochs=EPOCHS_COMPARE, nombre="L2")
plot_history(history_L2, titulo=f"L2 (λ={LAMBDA_L2})")
fila_L2 = registrar("L2", modelo_L2, history_L2, tiempo_L2,
                    hparams={"l2": LAMBDA_L2, "unidades": [256, 256, 128]})
Intervención: kernel_regularizer=L2(λ=0.001)
L2: 5.9 s, 30 épocas ejecutadas

========================================================================
REPORTE DE HISTORY — L2
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 0.7557  en la época 27
  loss (train) en esa época:     0.4984
  accuracy (train) en esa época: 0.9187
  val_accuracy en esa época:     0.8420
  Gap_acc (train - val):         +0.0767
  Gap_loss (val - train):        +0.2573
Valores FINALES (época 30):
  loss=0.4734  val_loss=0.8189  acc=0.9262  val_acc=0.8327
  Gap_acc final: +0.0936   Gap_loss final: +0.3455
Después de la época 27 hay 3 época(s) adicionales.
  Δ loss train (final - mejor): -0.0250  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0632  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00657, val=+0.01445

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=27, Delta train_loss=-0.0250, Delta val_loss=+0.0632, tramo posterior=3 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] L2: test_acc=0.8173  val_acc=0.8327  gap_acc=+0.0823  params=300938  tiempo=5.9s
# Tabla Baseline vs L1 vs L2  +  pesos
tabla_reg = pd.DataFrame([fila_baseline, fila_L1, fila_L2])[
    ["modelo", "parametros", "mejor_epoca", "train_acc", "val_acc", "test_acc",
     "train_loss", "val_loss", "gap_acc", "gap_loss", "tiempo_s"]
]
print("Comparación Baseline / L1 / L2")
display(tabla_reg.style.format({
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_loss": "{:.3f}", "val_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "gap_loss": "{:+.3f}", "tiempo_s": "{:.1f}",
}).background_gradient(subset=["val_acc"], cmap="Greens"))

w_l2 = recolectar_pesos(modelo_L2)
fig, ax = plt.subplots(figsize=(9.5, 4.0))
ax.hist(w_base, bins=50, density=True, alpha=0.45, label="Baseline")
ax.hist(w_l1, bins=50, density=True, alpha=0.45, label="L1")
ax.hist(w_l2, bins=50, density=True, alpha=0.45, label="L2")
ax.set_xlim(-0.35, 0.35)
ax.set_xlabel("valor del peso")
ax.set_ylabel("densidad")
ax.set_title("Magnitud de pesos: Baseline vs L1 vs L2")
ax.legend()
plt.tight_layout()
plt.show()

print(f"Mediana |w|: baseline={np.median(np.abs(w_base)):.4f}  "
      f"L1={np.median(np.abs(w_l1)):.4f}  L2={np.median(np.abs(w_l2)):.4f}")
print("Antes de la lectura automatica: ¿quien gana en val? ¿bajar train fue costo o dano?")
interpretar_intervencion(fila_baseline, fila_L2, nombre="L2")
comparar_modelos(pd.DataFrame([fila_baseline, fila_L1, fila_L2]), referencia="Baseline")
print(
    "\nNo concluimos que L2 sea superior por principio. "
    "Si en ESTA tabla L1 gana en val_acc, esa es la evidencia de este corpus y este λ. "
    "Si L2 gana, tampoco se vuelve teorema."
)
diagnosticar_modelo(fila_L2)
Comparación Baseline / L1 / L2
  modelo parametros mejor_epoca train_acc val_acc test_acc train_loss val_loss gap_acc gap_loss tiempo_s
0 Baseline 300938 6 0.917 0.823 0.803 0.211 0.685 +0.094 +0.473 5.3
1 L1 300938 30 0.932 0.831 0.831 0.649 1.018 +0.101 +0.369 5.8
2 L2 300938 27 0.915 0.833 0.817 0.495 0.819 +0.082 +0.324 5.9

Mediana |w|: baseline=0.0471  L1=0.0009  L2=0.0123
Antes de la lectura automatica: ¿quien gana en val? ¿bajar train fue costo o dano?

--- Lectura de la intervencion: L2 vs Baseline ---
OBSERVACION:
  train 0.917->0.915 (-0.002)
  val   0.823->0.833 (+0.010)
  test  0.803->0.817 (+0.015)
  gap   +0.094->+0.082 (-0.012)
INFERENCIA:
  El entrenamiento no se deterioro de forma clara.
  Validation mejoro sin un sacrificio evidente de train.
LIMITACION: un lambda/r distinto podria cambiar el signo de estas diferencias.
DECISION: si val mejoro, la tecnica es candidata; si no, ajustar intensidad o probar otra.
  Test se reporta para inspeccion, no para elegir.

--- Comparacion de modelos (evidencia, no veredicto) ---
1. Mayor train_acc: L1 (0.932).
   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.
2. Mayor val_acc: L2 (0.833).
   Este es el criterio honesto de seleccion en desarrollo.
3. Menor |gap_acc|: L2 (+0.082), val_acc=0.833.
   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.
4. Mayor test_acc: L1 (0.831).
   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.
5. Coherencia val/test: si el ganador de val no coincide con el de test,
   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.
   En esta tabla, val apunta a L2 y test a L1.
   La seleccion de desarrollo sigue siendo la de validacion.
6. Equilibrio desempeno/complejidad (ganador de val): 300,938 parametros, epocas=30, tiempo=5.9s.
7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.

Respecto de 'Baseline':
  L1: Dtrain=+0.015 Dval=+0.009 Dgap=+0.007 Dtest=+0.028 (test no decide).
  L2: Dtrain=-0.002 Dval=+0.010 Dgap=-0.012 Dtest=+0.015 (test no decide).
LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.
DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.

No concluimos que L2 sea superior por principio. Si en ESTA tabla L1 gana en val_acc, esa es la evidencia de este corpus y este λ. Si L2 gana, tampoco se vuelve teorema.

--- Diagnostico: L2 ---
OBSERVACION:
  train_acc=0.915  val_acc=0.833  test_acc=0.817
  gap_acc (train-val)=+0.082  |val-test|=0.015
  train_loss=0.495  val_loss=0.819  test_loss=0.805
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.
  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

Lectura de la comparación L1 / L2

La columna que decide entre estas tres filas, en desarrollo, es val_acc (o mejor_val_loss), no test_acc. El test se mira para no autoengañarnos después, y para el análisis retrospectivo de la sesión.

Si el ganador en validación no coincide con el ganador en test, eso es información: el conjunto de validación es finito (1 500 ejemplos) y puede ordenar mal modelos cercanos. No se “corrige” entonces eligiendo por test: se acepta la incertidumbre o se amplia validación / se repite con otras semillas.

Una bajada del accuracy de entrenamiento puede ser aceptable si validación mejora: se sacrificó capacidad de memorizar a cambio de generalizar. Lo problemático es bajar train y validation a la vez, o reducir el gap sin subir validation.

Gap pequeño ≠ modelo bueno. Hay que leerlo con el nivel absoluto.


9. Experimento sobre \(\lambda\): más regularización no es mejor generalización

Fijamos L2 y variamos solo \(\lambda\) en una grilla pedagógica:

\(\lambda\) Intención
\(0\) sin regularización (control; arquitectura idéntica, menos épocas que el baseline largo)
\(10^{-5}\) débil: puede no corregir el problema
\(10^{-3}\) moderada: candidata a mejorar validación
\(10^{-1}\) agresiva: candidata a underfitting

Todas las demás condiciones se mantienen. El gráfico \(\lambda\) frente a desempeño no es un resultado teórico: es lo que salga de estas cuatro corridas.

# Barrido de lambda (L2). Una intervención: la fuerza de la penalización.
lambdas = [0.0, 1e-5, 1e-3, 1e-1]
filas_lambda = []
historias_lambda = {}

for lam in lambdas:
    tf.keras.utils.set_random_seed(SEED)
    m = Sequential([
        Input(shape=(INPUT_DIM,)),
        Dense(256, activation="relu", kernel_regularizer=regularizers.l2(lam)),
        Dense(256, activation="relu", kernel_regularizer=regularizers.l2(lam)),
        Dense(128, activation="relu", kernel_regularizer=regularizers.l2(lam)),
        Dense(N_CLASSES, activation="softmax"),
    ])
    compilar(m)
    hist, t = entrenar(m, epochs=EPOCHS_COMPARE, nombre=f"L2 λ={lam}")
    historias_lambda[lam] = hist
    ev = evaluar_conjuntos(m)
    info = analyze_history(hist, nombre=f"L2 λ={lam}", verbose=False)
    filas_lambda.append({
        "lambda": lam,
        "log10_lambda": np.log10(lam) if lam > 0 else -np.inf,
        "val_acc": ev["val_acc"],
        "test_acc": ev["test_acc"],
        "train_acc": ev["train_acc"],
        "val_loss": ev["val_loss"],
        "train_loss": ev["train_loss"],
        "gap_acc": ev["train_acc"] - ev["val_acc"],
        "mejor_epoca": info["mejor_epoca_val_loss"],
        "tiempo_s": t,
    })

df_lambda = pd.DataFrame(filas_lambda)
print("Barrido de λ (L2)")
display(df_lambda.style.format({
    "lambda": "{:.0e}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_acc": "{:.3f}", "val_loss": "{:.3f}", "train_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))
L2 λ=0.0: 5.8 s, 30 épocas ejecutadas
L2 λ=1e-05: 5.9 s, 30 épocas ejecutadas
L2 λ=0.001: 6.3 s, 30 épocas ejecutadas
L2 λ=0.1: 5.9 s, 30 épocas ejecutadas
Barrido de λ (L2)
  lambda log10_lambda val_acc test_acc train_acc val_loss train_loss gap_acc mejor_epoca tiempo_s
0 0e+00 -inf 0.823 0.803 0.917 0.685 0.211 +0.094 6 5.8
1 1e-05 -5.000000 0.840 0.833 0.949 0.548 0.143 +0.109 17 5.9
2 1e-03 -3.000000 0.833 0.817 0.915 0.819 0.495 +0.082 27 6.3
3 1e-01 -1.000000 0.700 0.675 0.712 1.345 1.299 +0.012 30 5.9
# Curvas de los cuatro λ y gráfica λ vs desempeño
fig, axes = plt.subplots(2, 2, figsize=(11.2, 7.2), sharex=True)
for ax, lam in zip(axes.ravel(), lambdas):
    s = _series(historias_lambda[lam])
    ep = np.arange(1, len(s["loss"]) + 1)
    ax.plot(ep, s["loss"], label="loss")
    ax.plot(ep, s["val_loss"], label="val_loss")
    ax.set_title(f"λ = {lam}")
    ax.legend(fontsize=8)
    ax.set_xlabel("Época")
    ax.set_ylabel("Pérdida")
fig.suptitle("Mismo modelo, distinta fuerza de L2: la dinámica cambia", y=1.01)
plt.tight_layout()
plt.show()

# Para el eje x, representamos λ=0 a la izquierda con una etiqueta
x_plot = np.arange(len(df_lambda))
fig, ax = plt.subplots(figsize=(9.2, 4.4))
ax.plot(x_plot, df_lambda["val_acc"], "o-", lw=2, label="val_acc")
ax.plot(x_plot, df_lambda["test_acc"], "s--", lw=2, label="test_acc")
ax.plot(x_plot, df_lambda["train_acc"], "^:", lw=2, label="train_acc")
ax.set_xticks(x_plot)
ax.set_xticklabels([f"{lam:g}" for lam in df_lambda["lambda"]])
ax.set_xlabel("λ (L2)")
ax.set_ylabel("Accuracy")
ax.set_title("Más regularización no significa mejor generalización")
ax.legend()
plt.tight_layout()
plt.show()

mejor_lam = df_lambda.loc[df_lambda["val_acc"].idxmax()]
peor_val = df_lambda.loc[df_lambda["val_acc"].idxmin()]
print(
    f"Según VALIDACIÓN, el λ más favorable en esta grilla es {mejor_lam['lambda']} "
    f"(val_acc={mejor_lam['val_acc']:.3f})."
)
print(
    f"El λ con peor val_acc es {peor_val['lambda']} "
    f"(val_acc={peor_val['val_acc']:.3f}, train_acc={peor_val['train_acc']:.3f})."
)
print(
    "Si el λ grande derrumba train y val a la vez, la evidencia es compatible con "
    "underfitting por regularización excesiva. Si el λ nulo tiene el mayor train y "
    "un val peor que un λ intermedio, la evidencia es compatible con el relato clásico "
    "de 'poca / adecuada / demasiada' regularización."
)
print("Observe la grafica: ¿val sube y luego cae al crecer lambda?")
interpretar_barrido(df_lambda, col_x="lambda", nombre_eje="lambda")
print("test_acc se grafica para inspección, no para elegir λ.")

Según VALIDACIÓN, el λ más favorable en esta grilla es 1e-05 (val_acc=0.840).
El λ con peor val_acc es 0.1 (val_acc=0.700, train_acc=0.712).
Si el λ grande derrumba train y val a la vez, la evidencia es compatible con underfitting por regularización excesiva. Si el λ nulo tiene el mayor train y un val peor que un λ intermedio, la evidencia es compatible con el relato clásico de 'poca / adecuada / demasiada' regularización.
Observe la grafica: ¿val sube y luego cae al crecer lambda?

--- Lectura del barrido (lambda) ---
OBSERVACION: train/val/test en cada nivel (evaluate, inferencia).
  lambda=0.0: train=0.917  val=0.823  test=0.803  gap=+0.094
  lambda=1e-05: train=0.949  val=0.840  test=0.833  gap=+0.109
  lambda=0.001: train=0.915  val=0.833  test=0.817  gap=+0.082
  lambda=0.1: train=0.712  val=0.700  test=0.675  gap=+0.012
COMPARACION: el mejor val_acc de la grilla es lambda=1e-05 (0.840).
INFERENCIA:
  El nivel mas bajo (0.0) no es el de mayor val: regularizacion nula/debil pudo ser insuficiente.
  Mas regularizacion no significa automaticamente mejor modelo.
LIMITACION: la grilla es discreta y pedagogica; un valor no explorado podria ser preferible.
DECISION: elegir el nivel por VALIDACION. test_acc se grafica para inspeccion, no para seleccionar.
test_acc se grafica para inspección, no para elegir λ.

Idea que debe quedar grabada

Más regularización no significa mejor generalización.

\(\lambda\) es un control de preferencia en la función objetivo, no un interruptor de calidad. El valor adecuado es empírico y se elige con validación. El gráfico de esta sección es la versión experimental de la U conceptual de sesgo–varianza: a la izquierda, poca penalización; a la derecha, tanta que el modelo no aprende.


10. Dropout

10.1. Qué significa “apagar” unidades

Durante entrenamiento, Dropout pone a cero, de forma independiente, cada unidad de una capa con probabilidad \(r\) (el argumento de Dropout(r) en Keras). Las unidades que sobreviven se reescalan (esquema invertido) para que la esperanza de la activación se mantenga.

\[ \tilde{h}_j = \frac{m_j}{1-r}\, h_j, \qquad m_j \sim \mathrm{Bernoulli}(1-r). \]

La red no es una sola función: en cada lote es una subred aleatoria. Eso dificulta que una unidad se especialice en corregir a otra de manera idiosincrática (co-adaptación). La representación tiene que ser útil en muchos subconjuntos de neuronas.

10.2. Entrenamiento \(\neq\) inferencia

En inferencia no se apaga nadie: se usa la red completa. El reescalado (o, en la formulación original, el promediado implícito) hace que la magnitud de las activaciones sea comparable a la del entrenamiento. Por eso history['accuracy'] (Dropout activo) y evaluate() sobre train (Dropout inactivo) pueden diferir, a veces bastante. No es un bug: es el método.

10.3. Relación con generalización — y el costo

Dropout es una regularización estocástica. No penaliza \(\|w\|\) de forma explícita; penaliza la dependencia frágil entre unidades. El costo: si \(r\) es muy alto, en cada paso la red tiene demasiado poca capacidad efectiva y puede underfittear. \(r=0\) es el control. \(r=0.7\) en una MLP ya es agresivo.

# Esquema conceptual: una capa con unidades activas / inactivas
rng = np.random.default_rng(SEED)
n_u = 12
tasas = [0.0, 0.2, 0.5, 0.7]
fig, axes = plt.subplots(1, 4, figsize=(12.5, 2.8))
for ax, r in zip(axes, tasas):
    mask = rng.random(n_u) >= r
    colores = ["#2ca02c" if m else "#d62728" for m in mask]
    ax.scatter(np.arange(n_u), np.zeros(n_u), c=colores, s=180, edgecolor="k")
    ax.set_ylim(-1, 1)
    ax.axis("off")
    ax.set_title(f"r = {r}\nactivas={mask.sum()}/{n_u}", fontsize=10)
fig.suptitle("Un instante de Dropout (verde = activa, rojo = apagada). En inferencia, todas activas.", y=1.08)
plt.show()
print("Esta figura es un sorteo didáctico, no el estado interno de Keras en una época concreta.")

Esta figura es un sorteo didáctico, no el estado interno de Keras en una época concreta.
# Experimento: Dropout 0.0 / 0.2 / 0.5 / 0.7  (misma capacidad, una intervención)
tasas_dropout = [0.0, 0.2, 0.5, 0.7]
filas_do = []
historias_do = {}
modelos_do = {}

for r in tasas_dropout:
    tf.keras.utils.set_random_seed(SEED)
    m = Sequential([
        Input(shape=(INPUT_DIM,)),
        Dense(256, activation="relu"),
        Dropout(r),
        Dense(256, activation="relu"),
        Dropout(r),
        Dense(128, activation="relu"),
        Dropout(r),
        Dense(N_CLASSES, activation="softmax"),
    ])
    compilar(m)
    hist, t = entrenar(m, epochs=EPOCHS_COMPARE, nombre=f"Dropout {r}")
    historias_do[r] = hist
    modelos_do[r] = m
    ev = evaluar_conjuntos(m)
    info = analyze_history(hist, nombre=f"Dropout r={r}", verbose=False)
    filas_do.append({
        "dropout": r,
        "train_acc_hist_final": info["train_acc_final"],
        "val_acc_hist_final": info["val_acc_final"],
        "train_acc": ev["train_acc"],
        "val_acc": ev["val_acc"],
        "test_acc": ev["test_acc"],
        "train_loss": ev["train_loss"],
        "val_loss": ev["val_loss"],
        "gap_acc": ev["train_acc"] - ev["val_acc"],
        "mejor_epoca": info["mejor_epoca_val_loss"],
        "tiempo_s": t,
    })

df_do = pd.DataFrame(filas_do)
print("Barrido de tasa de Dropout")
print("Nota: train_acc_hist_final es CON dropout activo; train_acc de evaluate() es SIN dropout.")
display(df_do.style.format({
    "dropout": "{:.1f}",
    "train_acc_hist_final": "{:.3f}", "val_acc_hist_final": "{:.3f}",
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_loss": "{:.3f}", "val_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))
Dropout 0.0: 5.7 s, 30 épocas ejecutadas
Dropout 0.2: 6.1 s, 30 épocas ejecutadas
Dropout 0.5: 6.3 s, 30 épocas ejecutadas
Dropout 0.7: 6.2 s, 30 épocas ejecutadas
Barrido de tasa de Dropout
Nota: train_acc_hist_final es CON dropout activo; train_acc de evaluate() es SIN dropout.
  dropout train_acc_hist_final val_acc_hist_final train_acc val_acc test_acc train_loss val_loss gap_acc mejor_epoca tiempo_s
0 0.0 0.935 0.823 0.917 0.823 0.803 0.211 0.685 +0.094 6 5.7
1 0.2 0.924 0.851 0.956 0.851 0.846 0.125 0.506 +0.105 11 6.1
2 0.5 0.849 0.840 0.894 0.840 0.843 0.285 0.480 +0.054 23 6.3
3 0.7 0.712 0.767 0.783 0.767 0.758 0.542 0.633 +0.015 30 6.2
# Curvas y dropout vs desempeño
fig, axes = plt.subplots(2, 2, figsize=(11.2, 7.2), sharex=True)
for ax, r in zip(axes.ravel(), tasas_dropout):
    s = _series(historias_do[r])
    ep = np.arange(1, len(s["acc"]) + 1)
    ax.plot(ep, s["acc"], label="acc train (Dropout ON)")
    ax.plot(ep, s["val_acc"], label="val_acc (inferencia)")
    ax.set_title(f"Dropout r={r}")
    ax.set_xlabel("Época")
    ax.set_ylabel("Accuracy")
    ax.legend(fontsize=8)
fig.suptitle("Si r es alto, el accuracy de entrenamiento en history puede quedar muy por debajo de val", y=1.01)
plt.tight_layout()
plt.show()

fig, ax = plt.subplots(figsize=(8.8, 4.4))
ax.plot(df_do["dropout"], df_do["train_acc"], "o-", lw=2, label="train_acc (evaluate, inferencia)")
ax.plot(df_do["dropout"], df_do["val_acc"], "s-", lw=2, label="val_acc")
ax.plot(df_do["dropout"], df_do["test_acc"], "^--", lw=2, label="test_acc")
ax.set_xlabel("Tasa de Dropout r")
ax.set_ylabel("Accuracy")
ax.set_title("Dropout vs desempeño: r excesivo puede impedir aprender")
ax.legend()
plt.tight_layout()
plt.show()

# Registramos un Dropout "razonable" (el de mejor val_acc, excluyendo o incluyendo 0)
mejor_do = df_do.loc[df_do["val_acc"].idxmax()]
r_star = float(mejor_do["dropout"])
print(f"Según VALIDACIÓN, la tasa con mayor val_acc en esta grilla es r={r_star} "
      f"(val_acc={mejor_do['val_acc']:.3f}).")

# Si el mejor es 0.0, igualmente registramos r=0.2 como 'Dropout' típico para la tabla final,
# y dejamos constancia. Preferimos registrar el de mejor val.
history_do = historias_do[r_star]
modelo_do = modelos_do[r_star]
# Evitar doble registro si r=0 coincide conceptualmente con un MLP sin dropout
# (condiciones casi idénticas al control). Aun así lo registramos con nombre claro.
fila_do = registrar(
    f"Dropout_{r_star}", modelo_do, history_do, float(mejor_do["tiempo_s"]),
    hparams={"dropout": r_star},
)
# Alias pedagógico
if abs(r_star - 0.2) > 1e-9 and 0.2 in historias_do:
    # también dejamos modelo_dropout apuntando al r=0.2 para reportes posteriores
    pass
modelo_dropout = modelo_do
history_dropout = history_do

alto = df_do.loc[df_do["dropout"] == 0.7].iloc[0]
print(
    f"\nCuando r=0.7: train_acc(eval)={alto['train_acc']:.3f}, "
    f"val_acc={alto['val_acc']:.3f}, test_acc={alto['test_acc']:.3f}."
)
print(
    "Si esas tres cifras son bajas a la vez, los resultados sugieren que la "
    "regularización estocástica fue tan fuerte que el modelo no alcanzó a aprender "
    "una representación suficiente (underfitting inducido)."
)
print("Antes del reporte: ¿r=0.7 derrumba train y val?")
interpretar_barrido(df_do, col_x="dropout", nombre_eje="dropout")
interpretar_intervencion(fila_baseline, fila_do, nombre=f"Dropout r={r_star}")
diagnosticar_modelo(fila_do)

Según VALIDACIÓN, la tasa con mayor val_acc en esta grilla es r=0.2 (val_acc=0.851).
========================================================================
REPORTE DE HISTORY — Dropout_0.2
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 0.4670  en la época 11
  loss (train) en esa época:     0.3757
  accuracy (train) en esa época: 0.8652
  val_accuracy en esa época:     0.8453
  Gap_acc (train - val):         +0.0199
  Gap_loss (val - train):        +0.0913
Valores FINALES (época 30):
  loss=0.1978  val_loss=0.5059  acc=0.9240  val_acc=0.8513
  Gap_acc final: +0.0727   Gap_loss final: +0.3080
Después de la época 11 hay 19 época(s) adicionales.
  Δ loss train (final - mejor): -0.1779  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0388  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00841, val=+0.00228

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=11, Delta train_loss=-0.1779, Delta val_loss=+0.0388, tramo posterior=19 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] Dropout_0.2: test_acc=0.8460  val_acc=0.8513  gap_acc=+0.1049  params=300938  tiempo=6.1s

Cuando r=0.7: train_acc(eval)=0.783, val_acc=0.767, test_acc=0.758.
Si esas tres cifras son bajas a la vez, los resultados sugieren que la regularización estocástica fue tan fuerte que el modelo no alcanzó a aprender una representación suficiente (underfitting inducido).
Antes del reporte: ¿r=0.7 derrumba train y val?

--- Lectura del barrido (dropout) ---
OBSERVACION: train/val/test en cada nivel (evaluate, inferencia).
  dropout=0.0: train=0.917  val=0.823  test=0.803  gap=+0.094
  dropout=0.2: train=0.956  val=0.851  test=0.846  gap=+0.105
  dropout=0.5: train=0.894  val=0.840  test=0.843  gap=+0.054
  dropout=0.7: train=0.783  val=0.767  test=0.758  gap=+0.015
COMPARACION: el mejor val_acc de la grilla es dropout=0.2 (0.851).
INFERENCIA:
  El nivel mas bajo (0.0) no es el de mayor val: regularizacion nula/debil pudo ser insuficiente.
  Mas regularizacion no significa automaticamente mejor modelo.
LIMITACION: la grilla es discreta y pedagogica; un valor no explorado podria ser preferible.
DECISION: elegir el nivel por VALIDACION. test_acc se grafica para inspeccion, no para seleccionar.

--- Lectura de la intervencion: Dropout r=0.2 vs Baseline ---
OBSERVACION:
  train 0.917->0.956 (+0.039)
  val   0.823->0.851 (+0.029)
  test  0.803->0.846 (+0.043)
  gap   +0.094->+0.105 (+0.011)
INFERENCIA:
  El entrenamiento no se deterioro de forma clara.
  Validation mejoro sin un sacrificio evidente de train.
LIMITACION: un lambda/r distinto podria cambiar el signo de estas diferencias.
DECISION: si val mejoro, la tecnica es candidata; si no, ajustar intensidad o probar otra.
  Test se reporta para inspeccion, no para elegir.

--- Diagnostico: Dropout_0.2 ---
OBSERVACION:
  train_acc=0.956  val_acc=0.851  test_acc=0.846
  gap_acc (train-val)=+0.105  |val-test|=0.005
  train_loss=0.125  val_loss=0.506  test_loss=0.504
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

Preguntas

  1. ¿En \(r=0.5\) o \(r=0.7\) el accuracy de history quedó muy por debajo de val_accuracy? ¿Por qué eso no es, automáticamente, “buena generalización”?
  2. ¿Qué haría si \(r=0.7\) destruye train y val: subir \(r\) o bajarlo?
  3. Observación / inferencia / decisión: escriba una terna para el \(r\) ganador en validación.

Respuesta al punto 1 (después de mirar sus números): en entrenamiento las unidades se apagan; en validación no. Una val “más alta” que el acc de history puede ser solo la diferencia de régimen, no una victoria. Por eso las tablas usan evaluate() en los tres conjuntos.


11. Batch Normalization

11.1. No es “una técnica para evitar overfitting”

Batch Normalization (Ioffe y Szegedy, 2015) normaliza, para cada dimensión, las activaciones dentro del lote y luego permite reescalar y trasladar:

\[ \hat{x} = \frac{x - \mu_{\mathcal{B}}}{\sqrt{\sigma_{\mathcal{B}}^2 + \varepsilon}}, \qquad y = \gamma\hat{x} + \beta. \]

\(\mu_{\mathcal{B}},\sigma_{\mathcal{B}}^2\) se calculan en el batch. \(\gamma,\beta\) se aprenden. \(\varepsilon\) evita divisiones por cero.

El objetivo declarado fue estabilizar la distribución de activaciones a lo largo del entrenamiento (el argumento original de “internal covariate shift” es hoy discutido). En la práctica, BatchNorm suele:

  • hacer el paisaje de optimización más benigno;
  • permitir, en muchos problemas, learning rates más agresivos;
  • reducir la sensibilidad a la inicialización;
  • a veces producir un efecto regularizador secundario, porque cada ejemplo se normaliza con estadísticas que dependen de quiénes cayeron en su lote (ruido).

Ese último punto no convierte a BatchNorm en un sustituto de Dropout o L2. No garantiza mejor accuracy. Puede incluso interactuar mal con Dropout si se combinan sin criterio (el orden Dense → BatchNorm → activación → Dropout es una convención frecuente; no es un teorema).

11.2. Train vs inference

Entrenamiento Inferencia
Estadísticas \(\mu_{\mathcal{B}},\sigma_{\mathcal{B}}\) del lote actual medias móviles estimadas durante el train
\(\gamma,\beta\) se actualizan fijos

Si uno evalúa en un lote de tamaño 1 usando estadísticas de batch (mal configurado), las activaciones se vuelven inestables. Keras, en evaluate/predict, usa las medias móviles: es el régimen correcto de inferencia.

# Comparación controlada: misma capacidad, con / sin BatchNorm. Sin Dropout ni L2.
tf.keras.utils.set_random_seed(SEED)
modelo_sin_bn = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, activation="relu"),
    Dense(256, activation="relu"),
    Dense(128, activation="relu"),
    Dense(N_CLASSES, activation="softmax"),
], name="sin_batchnorm")
compilar(modelo_sin_bn)

tf.keras.utils.set_random_seed(SEED)
modelo_con_bn = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, use_bias=False),
    BatchNormalization(),
    Activation("relu"),
    Dense(256, use_bias=False),
    BatchNormalization(),
    Activation("relu"),
    Dense(128, use_bias=False),
    BatchNormalization(),
    Activation("relu"),
    Dense(N_CLASSES, activation="softmax"),
], name="con_batchnorm")
compilar(modelo_con_bn)

print("Sin BatchNorm — parámetros:", modelo_sin_bn.count_params())
print("Con BatchNorm — parámetros:", modelo_con_bn.count_params(),
      "(suben γ, β y las estadísticas móviles; no es la misma cifra que el baseline).")

history_sin_bn, tiempo_sin_bn = entrenar(modelo_sin_bn, epochs=EPOCHS_COMPARE, nombre="sin BatchNorm")
history_con_bn, tiempo_con_bn = entrenar(modelo_con_bn, epochs=EPOCHS_COMPARE, nombre="con BatchNorm")
Sin BatchNorm — parámetros: 300938
Con BatchNorm — parámetros: 302858 (suben γ, β y las estadísticas móviles; no es la misma cifra que el baseline).
sin BatchNorm: 5.7 s, 30 épocas ejecutadas
con BatchNorm: 6.5 s, 30 épocas ejecutadas
plot_history(history_sin_bn, titulo="Sin Batch Normalization")
plot_history(history_con_bn, titulo="Con Batch Normalization")

fila_sin_bn = registrar("Sin_BN", modelo_sin_bn, history_sin_bn, tiempo_sin_bn,
                        hparams={"batchnorm": False})
fila_bn = registrar("BatchNorm", modelo_con_bn, history_con_bn, tiempo_con_bn,
                    hparams={"batchnorm": True})

# Convergencia: época en la que val_loss baja de un umbral relativo
def epoca_alcanza(history, umbral_rel=0.55):
    v = _series(history)["val_loss"]
    objetivo = v[0] * umbral_rel + v.min() * (1 - umbral_rel)
    idxs = np.where(v <= (v[0] + v.min()) / 2)[0]
    return int(idxs[0] + 1) if len(idxs) else len(v)

e_sin = epoca_alcanza(history_sin_bn)
e_con = epoca_alcanza(history_con_bn)
print(f"\nÉpoca en la que val_loss cruza el punto medio entre inicio y mínimo: "
      f"sin BN={e_sin}, con BN={e_con}")
print(f"Tiempo: sin BN={tiempo_sin_bn:.1f}s, con BN={tiempo_con_bn:.1f}s")
print(
    "BatchNorm no garantiza mejor accuracy. Si en esta corrida gana en val, es evidencia "
    "de ESTA configuración; si pierde o empata, también es un resultado válido."
)
print("Antes del reporte: ¿BN estabiliza o acelera? ¿cambio val_acc?")
interpretar_batchnorm(fila_sin_bn, fila_bn, history_sin_bn, history_con_bn, e_sin, e_con)
comparar_modelos(pd.DataFrame([fila_sin_bn, fila_bn]), referencia="Sin_BN")
diagnosticar_modelo(fila_bn)

========================================================================
REPORTE DE HISTORY — Sin_BN
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 0.5305  en la época 6
  loss (train) en esa época:     0.4009
  accuracy (train) en esa época: 0.8593
  val_accuracy en esa época:     0.8147
  Gap_acc (train - val):         +0.0446
  Gap_loss (val - train):        +0.1296
Valores FINALES (época 30):
  loss=0.1665  val_loss=0.6847  acc=0.9348  val_acc=0.8227
  Gap_acc final: +0.1121   Gap_loss final: +0.5182
Después de la época 6 hay 24 época(s) adicionales.
  Δ loss train (final - mejor): -0.2344  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.1542  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00888, val=+0.00991

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.2344, Delta val_loss=+0.1542, tramo posterior=24 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] Sin_BN: test_acc=0.8027  val_acc=0.8227  gap_acc=+0.0943  params=300938  tiempo=5.7s
========================================================================
REPORTE DE HISTORY — BatchNorm
========================================================================
Épocas ejecutadas: 30
Mejor val_loss: 0.6126  en la época 6
  loss (train) en esa época:     0.1298
  accuracy (train) en esa época: 0.9663
  val_accuracy en esa época:     0.8060
  Gap_acc (train - val):         +0.1603
  Gap_loss (val - train):        +0.4828
Valores FINALES (época 30):
  loss=0.0117  val_loss=1.1262  acc=0.9973  val_acc=0.8040
  Gap_acc final: +0.1933   Gap_loss final: +1.1145
Después de la época 6 hay 24 época(s) adicionales.
  Δ loss train (final - mejor): -0.1181  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.5136  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.00368, val=+0.01264

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.1181, Delta val_loss=+0.5136, tramo posterior=24 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] BatchNorm: test_acc=0.8227  val_acc=0.8040  gap_acc=+0.1320  params=302858  tiempo=6.5s

Época en la que val_loss cruza el punto medio entre inicio y mínimo: sin BN=3, con BN=3
Tiempo: sin BN=5.7s, con BN=6.5s
BatchNorm no garantiza mejor accuracy. Si en esta corrida gana en val, es evidencia de ESTA configuración; si pierde o empata, también es un resultado válido.
Antes del reporte: ¿BN estabiliza o acelera? ¿cambio val_acc?

--- Lectura de Batch Normalization ---
OBSERVACION:
  sin BN: val_acc=0.823  train_acc=0.917  tiempo=5.7s  epoca_mitad_val=3
  con BN: val_acc=0.804  train_acc=0.936  tiempo=6.5s  epoca_mitad_val=3
INFERENCIA:
  La epoca de cruce fue similar. El valor de BN, si existe, habria que buscarlo
  en la estabilidad de las curvas o en el accuracy, no en un atajo universal.
  Validation no mejoro. BatchNorm no debe venderse solo como anti-overfitting.
LIMITACION: BN anade parametros (gamma, beta) y cambia el regimen train/inferencia.
DECISION: incluir BN si aporta estabilidad o val; no incluirlo por catalogo.

--- Comparacion de modelos (evidencia, no veredicto) ---
1. Mayor train_acc: BatchNorm (0.936).
   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.
2. Mayor val_acc: Sin_BN (0.823).
   Este es el criterio honesto de seleccion en desarrollo.
3. Menor |gap_acc|: Sin_BN (+0.094), val_acc=0.823.
   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.
4. Mayor test_acc: BatchNorm (0.823).
   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.
5. Coherencia val/test: si el ganador de val no coincide con el de test,
   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.
   En esta tabla, val apunta a Sin_BN y test a BatchNorm.
   La seleccion de desarrollo sigue siendo la de validacion.
6. Equilibrio desempeno/complejidad (ganador de val): 300,938 parametros, epocas=30, tiempo=5.7s.
7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.

Respecto de 'Sin_BN':
  BatchNorm: Dtrain=+0.019 Dval=-0.019 Dgap=+0.038 Dtest=+0.020 (test no decide).
LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.
DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.

--- Diagnostico: BatchNorm ---
OBSERVACION:
  train_acc=0.936  val_acc=0.804  test_acc=0.823
  gap_acc (train-val)=+0.132  |val-test|=0.019
  train_loss=0.240  val_loss=1.126  test_loss=0.937
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

Observación · inferencia · decisión (IV) — BatchNorm

Observación. ¿Las curvas con BatchNorm son más suaves? ¿Llega antes al valle de val_loss? ¿El val_acc final es mayor, menor o indistinguible?

Inferencia. Una convergencia más rápida es compatible con un paisaje de optimización más estable. Un val_acc peor no “refuta” BatchNorm como idea: refuta la afirmación de que en este protocolo mejora la métrica.

Decisión. Si solo buscamos accuracy de validación y BatchNorm no ayuda, no hay obligación de incluirlo en el modelo combinado. Si ayuda a la estabilidad, puede merecer su lugar aunque el accuracy sea similar.


12. Early Stopping

12.1. Dejar de optimizar cuando la validación ya no mejora

Entrenar \(T\) épocas es un hiperparámetro más. Muy a menudo el mínimo de \(\ell_{\mathrm{val}}\) no está en \(T\), sino antes. Early Stopping trata el número de épocas como algo que se decide con \(D_{\mathrm{val}}\):

  • monitor: cantidad vigilada (val_loss en este notebook).
  • patience: cuántas épocas consecutivas sin mejora se toleran antes de parar.
  • min_delta: mejora mínima para considerar que hubo mejora (evita parar por ruido numérico).
  • restore_best_weights: si es verdadero, al terminar se restauran los pesos de la mejor época monitorizada, no los de la última.

\[ t^\star = \arg\min_{t \le T} \ell_{\mathrm{val}}(t) \]

Con patience \(P\), el entrenamiento se detiene si durante \(P\) épocas \(\ell_{\mathrm{val}}\) no mejora en al menos min_delta. El techo \(T\) sigue existiendo: si la validación mejora hasta el final, se usan las \(T\) épocas.

12.2. Mensaje

Entrenar durante más épocas no significa necesariamente obtener un mejor modelo.

El baseline largo ya ilustró (si divergía) que las últimas épocas pueden empeorar la validación. Early Stopping automatiza la decisión que usted ensayó a ojo en la sección 6.

Antes de ejecutar, deje escritas tres preguntas que el history deberá responder:

  1. ¿El techo de épocas coincide con la mejor val_loss?
  2. ¿Cuántas épocas se ahorran respecto del máximo?
  3. ¿Los pesos finales son los de la última época o los de la mejor?
# Early Stopping: techo alto (EPOCHS_EARLY), parada según val_loss
early_cb = callbacks.EarlyStopping(
    monitor="val_loss",
    patience=PATIENCE,
    min_delta=1e-4,
    restore_best_weights=True,
    verbose=1,
)

tf.keras.utils.set_random_seed(SEED)
modelo_es = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, activation="relu"),
    Dense(256, activation="relu"),
    Dense(128, activation="relu"),
    Dense(N_CLASSES, activation="softmax"),
], name="early_stopping")
compilar(modelo_es)

history_es, tiempo_es = entrenar(
    modelo_es, epochs=EPOCHS_EARLY, nombre="Early Stopping",
    callbacks_list=[early_cb],
)

epocas_ejecutadas_es = len(history_es.history["loss"])
info_es = analyze_history(history_es, nombre="Early Stopping")
mejor_es = info_es["mejor_epoca_val_loss"]

print("\nTres relojes que no coinciden necesariamente:")
print(f"  Época máxima PERMITIDA:     {EPOCHS_EARLY}")
print(f"  Época en que TERMINÓ:       {epocas_ejecutadas_es}")
print(f"  Mejor época (val_loss):     {mejor_es}")
print(f"  Épocas evitadas respecto del techo: {EPOCHS_EARLY - epocas_ejecutadas_es}")
print(f"  Épocas evitadas respecto del baseline largo ({EPOCHS_FULL}): "
      f"{max(EPOCHS_FULL - epocas_ejecutadas_es, 0)}")
Epoch 14: early stopping
Restoring model weights from the end of the best epoch: 6.
Early Stopping: 3.1 s, 14 épocas ejecutadas
========================================================================
REPORTE DE HISTORY — Early Stopping
========================================================================
Épocas ejecutadas: 14
Mejor val_loss: 0.5305  en la época 6
  loss (train) en esa época:     0.4009
  accuracy (train) en esa época: 0.8593
  val_accuracy en esa época:     0.8147
  Gap_acc (train - val):         +0.0446
  Gap_loss (val - train):        +0.1296
Valores FINALES (época 14):
  loss=0.2223  val_loss=0.6081  acc=0.9233  val_acc=0.8120
  Gap_acc final: +0.1113   Gap_loss final: +0.3858
Después de la época 6 hay 8 época(s) adicionales.
  Δ loss train (final - mejor): -0.1786  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0776  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.02173, val=+0.00665

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.1786, Delta val_loss=+0.0776, tramo posterior=8 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

Tres relojes que no coinciden necesariamente:
  Época máxima PERMITIDA:     60
  Época en que TERMINÓ:       14
  Mejor época (val_loss):     6
  Épocas evitadas respecto del techo: 46
  Épocas evitadas respecto del baseline largo (30): 16
# Visualizar la mejor época sobre val_loss y comparar con el baseline completo
plot_history(history_es, titulo="Early Stopping: la línea roja es el óptimo de val_loss")

fila_es = registrar("EarlyStopping", modelo_es, history_es, tiempo_es,
                    hparams={"patience": PATIENCE, "monitor": "val_loss",
                             "techo": EPOCHS_EARLY})

print("\nBaseline entrenado hasta el final vs Early Stopping")
comp_es = pd.DataFrame([fila_baseline, fila_es])[
    ["modelo", "epocas_ejecutadas", "mejor_epoca", "train_acc", "val_acc",
     "test_acc", "val_loss", "gap_acc", "tiempo_s"]
]
display(comp_es.style.format({
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "val_loss": "{:.3f}", "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))

print(
    f"Tiempo baseline: {fila_baseline['tiempo_s']:.1f}s  |  "
    f"tiempo ES: {fila_es['tiempo_s']:.1f}s  |  "
    f"ahorro aparente: {fila_baseline['tiempo_s'] - fila_es['tiempo_s']:+.1f}s"
)
print(
    "Si ES termina mucho antes y mantiene o mejora val_acc, hay evidencia de "
    "entrenamiento más eficiente. Si val_acc empeora, patience o min_delta pueden "
    "haber sido inadecuados, o el mínimo de val_loss no coincidir con el de val_acc."
)
print("Antes del reporte: techo vs corte vs mejor epoca.")
interpretar_early_stopping(
    EPOCHS_EARLY, int(fila_es["epocas_ejecutadas"]), int(fila_es["mejor_epoca"]),
    fila_es, fila_base=fila_baseline,
)
diagnosticar_modelo(fila_es)
comparar_modelos(pd.DataFrame([fila_baseline, fila_es]), referencia="Baseline")

========================================================================
REPORTE DE HISTORY — EarlyStopping
========================================================================
Épocas ejecutadas: 14
Mejor val_loss: 0.5305  en la época 6
  loss (train) en esa época:     0.4009
  accuracy (train) en esa época: 0.8593
  val_accuracy en esa época:     0.8147
  Gap_acc (train - val):         +0.0446
  Gap_loss (val - train):        +0.1296
Valores FINALES (época 14):
  loss=0.2223  val_loss=0.6081  acc=0.9233  val_acc=0.8120
  Gap_acc final: +0.1113   Gap_loss final: +0.3858
Después de la época 6 hay 8 época(s) adicionales.
  Δ loss train (final - mejor): -0.1786  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0776  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.02173, val=+0.00665

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=6, Delta train_loss=-0.1786, Delta val_loss=+0.0776, tramo posterior=8 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] EarlyStopping: test_acc=0.8160  val_acc=0.8147  gap_acc=+0.0433  params=300938  tiempo=3.1s

Baseline entrenado hasta el final vs Early Stopping
  modelo epocas_ejecutadas mejor_epoca train_acc val_acc test_acc val_loss gap_acc tiempo_s
0 Baseline 30 6 0.917 0.823 0.803 0.685 +0.094 5.3
1 EarlyStopping 14 6 0.858 0.815 0.816 0.531 +0.043 3.1
Tiempo baseline: 5.3s  |  tiempo ES: 3.1s  |  ahorro aparente: +2.2s
Si ES termina mucho antes y mantiene o mejora val_acc, hay evidencia de entrenamiento más eficiente. Si val_acc empeora, patience o min_delta pueden haber sido inadecuados, o el mínimo de val_loss no coincidir con el de val_acc.
Antes del reporte: techo vs corte vs mejor epoca.

--- Lectura de Early Stopping ---
OBSERVACION (tres relojes):
  maximo permitido = 60
  epocas ejecutadas = 14
  mejor epoca segun val_loss = 6
  epocas_ahorradas = 46   porcentaje_ahorro = 76.7%
  restore_best_weights=True: los pesos finales son los de la mejor epoca monitorizada,
  no los de la ultima epoca ejecutada.
INFERENCIA:
  Se evito entrenamiento posterior al criterio de parada. Compatible con
  que continuar hasta el techo no aportaba (o no aportaba lo suficiente) segun val_loss.
  El optimo ocurrio 8 epocas antes del corte (patience).
  Frente al baseline largo: Dval_acc=-0.008, Depocas=-16.
LIMITACION: monitor=val_loss no maximiza necesariamente val_accuracy.
DECISION: si el optimo esta claramente antes del techo, Early Stopping es una
  intervencion barata y combinable. No sustituye a un lambda bien elegido.

--- Diagnostico: EarlyStopping ---
OBSERVACION:
  train_acc=0.858  val_acc=0.815  test_acc=0.816
  gap_acc (train-val)=+0.043  |val-test|=0.001
  train_loss=0.380  val_loss=0.531  test_loss=0.523
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Comparacion de modelos (evidencia, no veredicto) ---
1. Mayor train_acc: Baseline (0.917).
   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.
2. Mayor val_acc: Baseline (0.823).
   Este es el criterio honesto de seleccion en desarrollo.
3. Menor |gap_acc|: EarlyStopping (+0.043), val_acc=0.815.
   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.
4. Mayor test_acc: EarlyStopping (0.816).
   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.
5. Coherencia val/test: si el ganador de val no coincide con el de test,
   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.
   En esta tabla, val apunta a Baseline y test a EarlyStopping.
   La seleccion de desarrollo sigue siendo la de validacion.
6. Equilibrio desempeno/complejidad (ganador de val): 300,938 parametros, epocas=30, tiempo=5.3s.
7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.

Respecto de 'Baseline':
  EarlyStopping: Dtrain=-0.059 Dval=-0.008 Dgap=-0.051 Dtest=+0.013 (test no decide).
LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.
DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.

Preguntas — Early Stopping (antes de dar por cerrada la lectura)

Con los tres relojes y las curvas a la vista:

  1. ¿En qué época parece comenzar la divergencia, si la hay?
  2. ¿Train sigue mejorando después de esa época?
  3. ¿Detendría usted el entrenamiento con otro patience?
  4. ¿El ahorro de épocas se tradujo en un val_acc comparable al baseline largo?

Observación · inferencia · decisión (V) — Early Stopping

Observación. Anote los tres relojes que imprimió el código: techo, corte y mejor época.

Inferencia. Si el corte es \(P\) épocas después del óptimo, el callback hizo lo que promete: esperó a que no hubiera mejora y restauró los mejores pesos. Si se llegó al techo, la validación aún mejoraba (o el ruido superaba min_delta de forma intermitente).

Decisión. Early Stopping es barato de probar y no introduce un sesgo de arquitectura. Es compatible con L2 o Dropout: se puede (y se suele) combinar. No sustituye a un \(\lambda\) bien elegido si el problema es capacidad excesiva desde el inicio.

Matiz. Detener según val_loss no maximiza necesariamente val_accuracy. Son criterios distintos: la pérdida mira la calidad de las probabilidades; la accuracy, el \(\arg\max\).


13. Parámetros vs hiperparámetros

13.1. Quién decide qué, y cuándo

Parámetros aprendidos (\(\theta\)): se actualizan por descenso de gradiente a partir de \(D_{\mathrm{train}}\).

  • Pesos \(W^{(\ell)}\) de cada capa.
  • Sesgos \(b^{(\ell)}\).
  • En BatchNorm, \(\gamma\) y \(\beta\) (y se estiman, no por gradiente, las medias móviles).

Hiperparámetros: se fijan antes (o se buscan con \(D_{\mathrm{val}}\)). El optimizador no los trata como \(\theta\).

Hiperparámetro Qué controla Quién lo elige
learning rate tamaño de paso en \(\theta\) diseñador / búsqueda
batch size ruido y frecuencia de actualización diseñador
número de capas / neuronas capacidad diseñador / búsqueda
función de activación no linealidad diseñador
dropout \(r\) regularización estocástica diseñador / búsqueda
\(\lambda\) (L1/L2) fuerza de la penalización diseñador / búsqueda
optimizer regla de actualización diseñador
patience / min_delta cuándo parar diseñador
épocas máximas techo de cómputo diseñador

Una confusión frecuente: “el modelo aprendió el dropout”. No. Aprendió \(W,b\) bajo un dropout que usted impuso. Cambiar \(r\) cambia el problema de optimización.

Otra: el learning rate no es un parámetro de la red; es un parámetro del algoritmo. Un lr inadecuado puede parecer underfitting (no baja \(J\)) o inestabilidad (curvas que rebotan), sin que la arquitectura sea la culpable.


14. Ajuste de hiperparámetros

14.1. Tres familias, un mismo riesgo

Grid search. Se enumera un producto cartesiano. Exhaustivo en la grilla, ciego entre los nodos. El costo crece exponencialmente con el número de ejes.

Random search. Se muestrean configuraciones de una distribución (Bergstra y Bengio, 2012). Suele ser más eficiente que la grilla cuando solo algunos hiperparámetros importan: no se malgasta presupuesto en un eje irrelevante.

Optimización bayesiana. Se modela \(g(\text{hparams})\approx \ell_{\mathrm{val}}\) y se elige el siguiente punto equilibrando exploración y explotación. Más muestra-eficiente; más compleja de implementar y de explicar. Fuera del alcance de implementación de esta sesión.

En los tres casos, el objetivo interno es una métrica de validación. Si optimizamos test, el test deja de ser test.

14.2. Búsqueda pequeña y pedagógica

Implementamos un random search de 8 configuraciones sobre:

  • unidades de la primera capa oculta \(\{64, 128, 256\}\),
  • learning rate \(\{5\cdot 10^{-4}, 10^{-3}, 3\cdot 10^{-3}\}\),
  • dropout \(\{0.0, 0.2, 0.4\}\),
  • \(\lambda_{L2}\) \(\{0, 10^{-4}, 10^{-3}\}\).

No es un intento de récer. Es un laboratorio para ver qué se registra, cómo se ordena y por qué la fila ganadora se elige sin mirar la columna test.

# Random search pequeño: 8 configuraciones, mismo split, semilla de muestreo fija
rng_hs = np.random.default_rng(SEED)
espacio = {
    "unidades": [64, 128, 256],
    "lr": [5e-4, 1e-3, 3e-3],
    "dropout": [0.0, 0.2, 0.4],
    "l2": [0.0, 1e-4, 1e-3],
}

# Evitar duplicados exactos
vistos = set()
configs = []
while len(configs) < 8:
    cfg = (
        int(rng_hs.choice(espacio["unidades"])),
        float(rng_hs.choice(espacio["lr"])),
        float(rng_hs.choice(espacio["dropout"])),
        float(rng_hs.choice(espacio["l2"])),
    )
    if cfg not in vistos:
        vistos.add(cfg)
        configs.append({
            "unidades": cfg[0], "lr": cfg[1], "dropout": cfg[2], "l2": cfg[3]
        })

print("Configuraciones sorteadas:")
display(pd.DataFrame(configs))

filas_hs = []
historias_hs = []
modelos_hs = []

for i, cfg in enumerate(configs, start=1):
    nombre = f"HS_{i}"
    tf.keras.utils.set_random_seed(SEED)
    reg = regularizers.l2(cfg["l2"]) if cfg["l2"] > 0 else None
    m = Sequential([
        Input(shape=(INPUT_DIM,)),
        Dense(cfg["unidades"], activation="relu", kernel_regularizer=reg),
        Dropout(cfg["dropout"]),
        Dense(max(cfg["unidades"] // 2, 32), activation="relu", kernel_regularizer=reg),
        Dropout(cfg["dropout"]),
        Dense(N_CLASSES, activation="softmax"),
    ], name=nombre)
    m.compile(optimizer=Adam(learning_rate=cfg["lr"]),
              loss="sparse_categorical_crossentropy",
              metrics=["accuracy"])
    t0 = time.perf_counter()
    hist = m.fit(
        X_train, y_train, validation_data=(X_val, y_val),
        epochs=EPOCHS_SEARCH, batch_size=BATCH_SIZE, verbose=0,
    )
    t = time.perf_counter() - t0
    ev = evaluar_conjuntos(m)
    info = analyze_history(hist, nombre=nombre, verbose=False)
    filas_hs.append({
        "experimento": nombre,
        "unidades": cfg["unidades"],
        "lr": cfg["lr"],
        "dropout": cfg["dropout"],
        "lambda_l2": cfg["l2"],
        "mejor_val_loss": info["min_val_loss"],
        "val_accuracy": ev["val_acc"],
        "test_accuracy": ev["test_acc"],
        "gap": ev["train_acc"] - ev["val_acc"],
        "epocas_entrenadas": info["epocas"],
        "tiempo": t,
    })
    historias_hs.append(hist)
    modelos_hs.append(m)
    print(f"{nombre} listo — val_acc={ev['val_acc']:.3f}  (test_acc se registra, no se usa para elegir)")

df_hs = pd.DataFrame(filas_hs)
Configuraciones sorteadas:
unidades lr dropout l2
0 64 0.0030 0.2 0.0001
1 128 0.0030 0.0 0.0010
2 64 0.0005 0.2 0.0010
3 256 0.0030 0.4 0.0010
4 128 0.0005 0.4 0.0001
5 128 0.0010 0.0 0.0010
6 256 0.0010 0.2 0.0010
7 128 0.0010 0.2 0.0000
HS_1 listo — val_acc=0.836  (test_acc se registra, no se usa para elegir)
HS_2 listo — val_acc=0.811  (test_acc se registra, no se usa para elegir)
HS_3 listo — val_acc=0.815  (test_acc se registra, no se usa para elegir)
HS_4 listo — val_acc=0.820  (test_acc se registra, no se usa para elegir)
HS_5 listo — val_acc=0.799  (test_acc se registra, no se usa para elegir)
HS_6 listo — val_acc=0.835  (test_acc se registra, no se usa para elegir)
HS_7 listo — val_acc=0.835  (test_acc se registra, no se usa para elegir)
HS_8 listo — val_acc=0.832  (test_acc se registra, no se usa para elegir)
# Ordenar por VALIDACIÓN. El test viaja en la tabla pero no manda.
print("Ordenado por mejor_val_loss (criterio de selección):")
display(df_hs.sort_values("mejor_val_loss").style.format({
    "lr": "{:.1e}", "dropout": "{:.1f}", "lambda_l2": "{:.0e}",
    "mejor_val_loss": "{:.3f}", "val_accuracy": "{:.3f}",
    "test_accuracy": "{:.3f}", "gap": "{:+.3f}", "tiempo": "{:.1f}",
}))

print("\nOrdenado por val_accuracy:")
display(df_hs.sort_values("val_accuracy", ascending=False).style.format({
    "lr": "{:.1e}", "dropout": "{:.1f}", "lambda_l2": "{:.0e}",
    "mejor_val_loss": "{:.3f}", "val_accuracy": "{:.3f}",
    "test_accuracy": "{:.3f}", "gap": "{:+.3f}", "tiempo": "{:.1f}",
}))

idx_sel = df_hs["mejor_val_loss"].idxmin()
sel = df_hs.loc[idx_sel]
print("=" * 72)
print("CONFIGURACIÓN SELECCIONADA (solo validación):", sel["experimento"])
print(sel[["unidades", "lr", "dropout", "lambda_l2", "mejor_val_loss", "val_accuracy"]].to_string())
print("=" * 72)
print(
    f"Su test_accuracy, que NO se usó para elegir, es {sel['test_accuracy']:.3f}. "
    "Si otra fila tiene test más alto, eso NO autoriza a cambiar la selección: "
    "haría que el número de test deje de ser una evaluación y pase a ser un criterio de diseño."
)

# Guardamos el modelo seleccionado para reportes
modelo_hs = modelos_hs[int(idx_sel)]
history_hs = historias_hs[int(idx_sel)]
fila_hs = registrar(
    "RandomSearch_sel", modelo_hs, history_hs, float(sel["tiempo"]),
    hparams={"unidades": int(sel["unidades"]), "lr": float(sel["lr"]),
             "dropout": float(sel["dropout"]), "l2": float(sel["lambda_l2"])},
)
print("\n--- Como leer esta tabla de busqueda ---")
print("OBSERVACION: cada fila es una configuracion; test viaja pero no manda.")
print("COMPARACION: se ordeno por mejor_val_loss / val_accuracy. Esa es la seleccion.")
print("INFERENCIA: otra fila con mayor test_accuracy NO autoriza a cambiar la eleccion.")
print("LIMITACION: 8 sorteos no exploran el espacio; una diferencia pequena puede ser ruido.")
print("DECISION: fijar la configuracion de validacion y usar test como evaluacion final.")
Ordenado por mejor_val_loss (criterio de selección):
  experimento unidades lr dropout lambda_l2 mejor_val_loss val_accuracy test_accuracy gap epocas_entrenadas tiempo
7 HS_8 128 1.0e-03 0.2 0e+00 0.482 0.832 0.831 +0.044 12 3.1
0 HS_1 64 3.0e-03 0.2 1e-04 0.528 0.836 0.827 +0.037 12 2.2
4 HS_5 128 5.0e-04 0.4 1e-04 0.604 0.799 0.786 +0.023 12 3.5
1 HS_2 128 3.0e-03 0.0 1e-03 0.630 0.811 0.833 +0.074 12 2.8
5 HS_6 128 1.0e-03 0.0 1e-03 0.688 0.835 0.825 +0.050 12 3.0
3 HS_4 256 3.0e-03 0.4 1e-03 0.700 0.820 0.819 +0.038 12 4.3
2 HS_3 64 5.0e-04 0.2 1e-03 0.717 0.815 0.799 +0.014 12 3.0
6 HS_7 256 1.0e-03 0.2 1e-03 0.748 0.835 0.829 +0.055 12 3.8

Ordenado por val_accuracy:
  experimento unidades lr dropout lambda_l2 mejor_val_loss val_accuracy test_accuracy gap epocas_entrenadas tiempo
0 HS_1 64 3.0e-03 0.2 1e-04 0.528 0.836 0.827 +0.037 12 2.2
5 HS_6 128 1.0e-03 0.0 1e-03 0.688 0.835 0.825 +0.050 12 3.0
6 HS_7 256 1.0e-03 0.2 1e-03 0.748 0.835 0.829 +0.055 12 3.8
7 HS_8 128 1.0e-03 0.2 0e+00 0.482 0.832 0.831 +0.044 12 3.1
3 HS_4 256 3.0e-03 0.4 1e-03 0.700 0.820 0.819 +0.038 12 4.3
2 HS_3 64 5.0e-04 0.2 1e-03 0.717 0.815 0.799 +0.014 12 3.0
1 HS_2 128 3.0e-03 0.0 1e-03 0.630 0.811 0.833 +0.074 12 2.8
4 HS_5 128 5.0e-04 0.4 1e-04 0.604 0.799 0.786 +0.023 12 3.5
========================================================================
CONFIGURACIÓN SELECCIONADA (solo validación): HS_8
unidades               128
lr                   0.001
dropout                0.2
lambda_l2              0.0
mejor_val_loss    0.481726
val_accuracy         0.832
========================================================================
Su test_accuracy, que NO se usó para elegir, es 0.831. Si otra fila tiene test más alto, eso NO autoriza a cambiar la selección: haría que el número de test deje de ser una evaluación y pase a ser un criterio de diseño.
========================================================================
REPORTE DE HISTORY — RandomSearch_sel
========================================================================
Épocas ejecutadas: 12
Mejor val_loss: 0.4817  en la época 11
  loss (train) en esa época:     0.4318
  accuracy (train) en esa época: 0.8413
  val_accuracy en esa época:     0.8427
  Gap_acc (train - val):         -0.0014
  Gap_loss (val - train):        +0.0499
Valores FINALES (época 12):
  loss=0.4229  val_loss=0.4871  acc=0.8450  val_acc=0.8320
  Gap_acc final: +0.0130   Gap_loss final: +0.0642
Después de la época 11 hay 1 época(s) adicionales.
  Δ loss train (final - mejor): -0.0089  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0054  (positivo = la validación EMPEORÓ)

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso mixto (guia, no regla absoluta).
OBSERVACION: El history no encaja de forma nitida en un unico patron A-D.
  Numeros: mejor epoca=11, Delta train_loss=-0.0089, Delta val_loss=+0.0054, tramo posterior=1 epocas.
INFERENCIA:  Con esta evidencia unicamente no podemos etiquetar el regimen de forma tajante.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Combinar con el gap, el nivel absoluto y evaluate() en los tres conjuntos.
========================================================================

[registro] RandomSearch_sel: test_acc=0.8313  val_acc=0.8320  gap_acc=+0.0440  params=109386  tiempo=3.1s

--- Como leer esta tabla de busqueda ---
OBSERVACION: cada fila es una configuracion; test viaja pero no manda.
COMPARACION: se ordeno por mejor_val_loss / val_accuracy. Esa es la seleccion.
INFERENCIA: otra fila con mayor test_accuracy NO autoriza a cambiar la eleccion.
LIMITACION: 8 sorteos no exploran el espacio; una diferencia pequena puede ser ruido.
DECISION: fijar la configuracion de validacion y usar test como evaluacion final.

Por qué está prohibido elegir con test_accuracy

Cada vez que miramos \(D_{\mathrm{test}}\) para decidir, le transferimos información del conjunto que debía permanecer ciego. Con 8 configuraciones el daño es limitado; con 800, el máximo de test es un estadístico extremadamente sesgado. El protocolo honesto:

  1. Explorar con \(D_{\mathrm{val}}\).
  2. Fijar la configuración.
  3. Entonces evaluar \(D_{\mathrm{test}}\) (idealmente una vez).

En un notebook didáctico evaluamos test en cada fila para enseñar la tentación y la discrepancia. En un artículo o un producto, esa columna no existiría durante la búsqueda.


15. Experimento comparativo general

Comparamos, sobre el mismo split, intervenciones que ya corrimos y un modelo combinado que no se asume ganador:

  1. Baseline
  2. L1
  3. L2
  4. Dropout (el \(r\) seleccionado por validación en la grilla de la sección 10)
  5. Batch Normalization
  6. Early Stopping
  7. Combinado razonable: L2 + Dropout + BatchNorm + EarlyStopping

El combinado puede ser peor que sus partes: las técnicas no son aditivas. Dropout + BatchNorm + L2 fuerte es una forma clásica de matar la capacidad.

El combinado no se asume ganador. Apilar técnicas puede matar capacidad.

Tras la tabla final, responda antes de leer el reporte automático:

  • ¿Qué modelo tiene mayor train accuracy? ¿Eso lo hace el mejor?
  • ¿Cuál tiene mayor validation accuracy?
  • ¿Hay gap pequeño con desempeño pobre?
  • ¿Validation y test cuentan una historia coherente?
  • ¿Qué evidencia —no qué preferencia— respaldaría su elección?
# Modelo combinado: L2 + Dropout + BatchNorm + EarlyStopping
# No es una receta mágica; es UNA hipótesis de diseño.
L2_COMB = 1e-4
DROP_COMB = 0.3

tf.keras.utils.set_random_seed(SEED)
modelo_comb = Sequential([
    Input(shape=(INPUT_DIM,)),
    Dense(256, use_bias=False, kernel_regularizer=regularizers.l2(L2_COMB)),
    BatchNormalization(),
    Activation("relu"),
    Dropout(DROP_COMB),
    Dense(256, use_bias=False, kernel_regularizer=regularizers.l2(L2_COMB)),
    BatchNormalization(),
    Activation("relu"),
    Dropout(DROP_COMB),
    Dense(128, use_bias=False, kernel_regularizer=regularizers.l2(L2_COMB)),
    BatchNormalization(),
    Activation("relu"),
    Dropout(DROP_COMB),
    Dense(N_CLASSES, activation="softmax"),
], name="combinado")
compilar(modelo_comb)

early_comb = callbacks.EarlyStopping(
    monitor="val_loss", patience=PATIENCE, min_delta=1e-4,
    restore_best_weights=True, verbose=0,
)
history_comb, tiempo_comb = entrenar(
    modelo_comb, epochs=EPOCHS_EARLY, nombre="Combinado",
    callbacks_list=[early_comb],
)
plot_history(history_comb, titulo="Modelo combinado (L2 + Dropout + BN + ES)")
fila_comb = registrar(
    "Combinado", modelo_comb, history_comb, tiempo_comb,
    hparams={"l2": L2_COMB, "dropout": DROP_COMB, "batchnorm": True, "early": True},
)
analizar_generalizacion(fila_comb)
Combinado: 7.1 s, 17 épocas ejecutadas

========================================================================
REPORTE DE HISTORY — Combinado
========================================================================
Épocas ejecutadas: 17
Mejor val_loss: 0.5821  en la época 9
  loss (train) en esa época:     0.4491
  accuracy (train) en esa época: 0.8720
  val_accuracy en esa época:     0.8280
  Gap_acc (train - val):         +0.0440
  Gap_loss (val - train):        +0.1331
Valores FINALES (época 17):
  loss=0.3206  val_loss=0.6444  acc=0.9145  val_acc=0.8127
  Gap_acc final: +0.1018   Gap_loss final: +0.3238
Después de la época 9 hay 8 época(s) adicionales.
  Δ loss train (final - mejor): -0.1285  (negativo = el entrenamiento SIGUIÓ bajando la pérdida)
  Δ val_loss   (final - mejor): +0.0623  (positivo = la validación EMPEORÓ)
  Pendiente lineal post-óptimo: train=-0.01614, val=+0.00783

--- Observacion / inferencia / decision (curvas) ---
Patron compatible con el caso C (guia, no regla absoluta).
OBSERVACION: Tras la mejor epoca, train_loss siguio disminuyendo mientras val_loss aumento.
  Numeros: mejor epoca=9, Delta train_loss=-0.1285, Delta val_loss=+0.0623, tramo posterior=8 epocas.
INFERENCIA:  Este patron es compatible con evidencia de sobreajuste: las mejoras de entrenamiento dejan de trasladarse a validacion.
LIMITACION: un solo history no mide varianza entre semillas ni el riesgo verdadero. El gap debe leerse junto al nivel absoluto.
DECISION:    Un siguiente paso razonable es Early Stopping, regularizacion o reducir capacidad; luego volver a medir.
========================================================================

[registro] Combinado: test_acc=0.8173  val_acc=0.8280  gap_acc=+0.0565  params=302858  tiempo=7.1s

--- Diagnostico: Combinado ---
OBSERVACION:
  train_acc=0.885  val_acc=0.828  test_acc=0.817
  gap_acc (train-val)=+0.057  |val-test|=0.011
  train_loss=0.400  val_loss=0.582  test_loss=0.594
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.
# Tabla final: modelos principales de la sesión
nombres_finales = [
    "Baseline", "L1", "L2",
    "BatchNorm", "EarlyStopping", "Combinado",
]
# Dropout se registró como Dropout_{r}
nombres_do = [f["modelo"] for f in RESULTADOS if str(f["modelo"]).startswith("Dropout")]
nombres_finales = nombres_finales + nombres_do + ["RandomSearch_sel"]

df_all = pd.DataFrame(RESULTADOS)
df_final = df_all[df_all["modelo"].isin(nombres_finales)].drop_duplicates("modelo").copy()

cols = [
    "modelo", "parametros", "mejor_epoca", "epocas_ejecutadas",
    "train_acc", "val_acc", "test_acc",
    "train_loss", "val_loss", "test_loss",
    "gap_acc", "tiempo_s",
]

print("Ordenado por val_acc (criterio de desarrollo):")
display(df_final[cols].sort_values("val_acc", ascending=False).style.format({
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_loss": "{:.3f}", "val_loss": "{:.3f}", "test_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}).background_gradient(subset=["val_acc", "test_acc"], cmap="YlGn"))

print("\nOrdenado por |gap_acc| (no es el criterio de selección):")
display(df_final[cols].assign(abs_gap=lambda d: d["gap_acc"].abs())
        .sort_values("abs_gap")[cols].style.format({
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_loss": "{:.3f}", "val_loss": "{:.3f}", "test_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))

print("\nOrdenado por test_acc (solo inspección retrospectiva):")
display(df_final[cols].sort_values("test_acc", ascending=False).style.format({
    "train_acc": "{:.3f}", "val_acc": "{:.3f}", "test_acc": "{:.3f}",
    "train_loss": "{:.3f}", "val_loss": "{:.3f}", "test_loss": "{:.3f}",
    "gap_acc": "{:+.3f}", "tiempo_s": "{:.1f}",
}))

print("Antes de la lectura automatica, intente responder con la tabla:")
print("  1) Mayor train_acc: ¿eso lo hace el mejor?")
print("  2) Mayor val_acc")
print("  3) Menor |gap|: ¿viene con buen nivel absoluto?")
print("  4) ¿Val y test cuentan la misma historia?")
print("  5) ¿Alguna tecnica regulariza en exceso (train y val bajan juntos)?")
print("  6) ¿Que evidencia respaldaria su eleccion?")
comparar_modelos(df_final, referencia="Baseline")
Ordenado por val_acc (criterio de desarrollo):
  modelo parametros mejor_epoca epocas_ejecutadas train_acc val_acc test_acc train_loss val_loss test_loss gap_acc tiempo_s
5 Dropout_0.2 300938 11 30 0.956 0.851 0.846 0.125 0.506 0.504 +0.105 6.1
4 L2 300938 27 30 0.915 0.833 0.817 0.495 0.819 0.805 +0.082 5.9
9 RandomSearch_sel 109386 11 12 0.876 0.832 0.831 0.347 0.487 0.487 +0.044 3.1
3 L1 300938 30 30 0.932 0.831 0.831 0.649 1.018 1.014 +0.101 5.8
10 Combinado 302858 9 17 0.885 0.828 0.817 0.400 0.582 0.594 +0.057 7.1
2 Baseline 300938 6 30 0.917 0.823 0.803 0.211 0.685 0.676 +0.094 5.3
8 EarlyStopping 300938 6 14 0.858 0.815 0.816 0.380 0.531 0.523 +0.043 3.1
7 BatchNorm 302858 6 30 0.936 0.804 0.823 0.240 1.126 0.937 +0.132 6.5

Ordenado por |gap_acc| (no es el criterio de selección):
  modelo parametros mejor_epoca epocas_ejecutadas train_acc val_acc test_acc train_loss val_loss test_loss gap_acc tiempo_s
8 EarlyStopping 300938 6 14 0.858 0.815 0.816 0.380 0.531 0.523 +0.043 3.1
9 RandomSearch_sel 109386 11 12 0.876 0.832 0.831 0.347 0.487 0.487 +0.044 3.1
10 Combinado 302858 9 17 0.885 0.828 0.817 0.400 0.582 0.594 +0.057 7.1
4 L2 300938 27 30 0.915 0.833 0.817 0.495 0.819 0.805 +0.082 5.9
2 Baseline 300938 6 30 0.917 0.823 0.803 0.211 0.685 0.676 +0.094 5.3
3 L1 300938 30 30 0.932 0.831 0.831 0.649 1.018 1.014 +0.101 5.8
5 Dropout_0.2 300938 11 30 0.956 0.851 0.846 0.125 0.506 0.504 +0.105 6.1
7 BatchNorm 302858 6 30 0.936 0.804 0.823 0.240 1.126 0.937 +0.132 6.5

Ordenado por test_acc (solo inspección retrospectiva):
  modelo parametros mejor_epoca epocas_ejecutadas train_acc val_acc test_acc train_loss val_loss test_loss gap_acc tiempo_s
5 Dropout_0.2 300938 11 30 0.956 0.851 0.846 0.125 0.506 0.504 +0.105 6.1
9 RandomSearch_sel 109386 11 12 0.876 0.832 0.831 0.347 0.487 0.487 +0.044 3.1
3 L1 300938 30 30 0.932 0.831 0.831 0.649 1.018 1.014 +0.101 5.8
7 BatchNorm 302858 6 30 0.936 0.804 0.823 0.240 1.126 0.937 +0.132 6.5
10 Combinado 302858 9 17 0.885 0.828 0.817 0.400 0.582 0.594 +0.057 7.1
4 L2 300938 27 30 0.915 0.833 0.817 0.495 0.819 0.805 +0.082 5.9
8 EarlyStopping 300938 6 14 0.858 0.815 0.816 0.380 0.531 0.523 +0.043 3.1
2 Baseline 300938 6 30 0.917 0.823 0.803 0.211 0.685 0.676 +0.094 5.3
Antes de la lectura automatica, intente responder con la tabla:
  1) Mayor train_acc: ¿eso lo hace el mejor?
  2) Mayor val_acc
  3) Menor |gap|: ¿viene con buen nivel absoluto?
  4) ¿Val y test cuentan la misma historia?
  5) ¿Alguna tecnica regulariza en exceso (train y val bajan juntos)?
  6) ¿Que evidencia respaldaria su eleccion?

--- Comparacion de modelos (evidencia, no veredicto) ---
1. Mayor train_acc: Dropout_0.2 (0.956).
   Ese NO es necesariamente el mejor: el objetivo no es memorizar D_train.
2. Mayor val_acc: Dropout_0.2 (0.851).
   Este es el criterio honesto de seleccion en desarrollo.
3. Menor |gap_acc|: EarlyStopping (+0.043), val_acc=0.815.
   Gap pequeno + val bajo no es 'buena generalizacion'; es mal ajuste simetrico.
4. Mayor test_acc: Dropout_0.2 (0.846).
   Se reporta para evaluacion retrospectiva; NO debio usarse para elegir.
5. Coherencia val/test: si el ganador de val no coincide con el de test,
   D_val es finito y puede ordenar mal modelos cercanos. No se 'corrige' con test.
   En esta tabla, validacion y test senalan el mismo modelo. Evidencia coherente, no prueba.
6. Equilibrio desempeno/complejidad (ganador de val): 300,938 parametros, epocas=30, tiempo=6.1s.
7. Regularizacion excesiva (hipotesis): train y val bajan juntos respecto de la referencia.

Respecto de 'Baseline':
  L1: Dtrain=+0.015 Dval=+0.009 Dgap=+0.007 Dtest=+0.028 (test no decide).
  L2: Dtrain=-0.002 Dval=+0.010 Dgap=-0.012 Dtest=+0.015 (test no decide).
  Dropout_0.2: Dtrain=+0.039 Dval=+0.029 Dgap=+0.011 Dtest=+0.043 (test no decide).
  BatchNorm: Dtrain=+0.019 Dval=-0.019 Dgap=+0.038 Dtest=+0.020 (test no decide).
  EarlyStopping: Dtrain=-0.059 Dval=-0.008 Dgap=-0.051 Dtest=+0.013 (test no decide).
  RandomSearch_sel: Dtrain=-0.041 Dval=+0.009 Dgap=-0.050 Dtest=+0.029 (test no decide).  -> se sacrifica train y validation mejora: puede ser regularizacion util.
  Combinado: Dtrain=-0.032 Dval=+0.005 Dgap=-0.038 Dtest=+0.015 (test no decide).  -> se sacrifica train y validation mejora: puede ser regularizacion util.
LIMITACION: diferencias de ~1 punto en 1500 ejemplos pueden ser ruido.
DECISION: elegir por validacion; usar test una vez; no apilar tecnicas por fe.
# Visualizaciones comparativas
fig, axes = plt.subplots(1, 2, figsize=(12.2, 4.6))
dplot = df_final.sort_values("val_acc")
axes[0].barh(dplot["modelo"], dplot["val_acc"], color="C0", alpha=0.85, label="val")
axes[0].barh(dplot["modelo"], dplot["test_acc"], color="C1", alpha=0.45, label="test")
axes[0].set_xlabel("Accuracy")
axes[0].set_title("Validación vs test (la selección se hizo sin usar test)")
axes[0].legend()

axes[1].barh(dplot["modelo"], dplot["gap_acc"], color="C2")
axes[1].axvline(0, color="k", lw=0.8)
axes[1].set_xlabel("Gap_acc = train − val")
axes[1].set_title("Generalization gap (evaluate)")
fig.suptitle("Comparación final de intervenciones", y=1.02)
plt.tight_layout()
plt.show()

ganador_val = df_final.loc[df_final["val_acc"].idxmax()]
print(
    f"El modelo con mayor val_acc en la tabla final es '{ganador_val['modelo']}' "
    f"({ganador_val['val_acc']:.3f}). Ese es el que un protocolo honesto declararía "
    f"ganador de desarrollo. Su test_acc={ganador_val['test_acc']:.3f}."
)
print(
    "Si el Combinado no es el primero, ese resultado es pedagógicamente valioso: "
    "apilar técnicas no es una estrategia dominante."
)

El modelo con mayor val_acc en la tabla final es 'Dropout_0.2' (0.851). Ese es el que un protocolo honesto declararía ganador de desarrollo. Su test_acc=0.846.
Si el Combinado no es el primero, ese resultado es pedagógicamente valioso: apilar técnicas no es una estrategia dominante.

16. Reportes de evaluación final

Elegimos tres modelos para un análisis fino sobre \(D_{\mathrm{test}}\):

  • el baseline (testigo),
  • el de mayor val_acc en la tabla final (selección honesta),
  • el combinado (aunque no gane), para ver si la complejidad extra cambió el perfil por clase.

Accuracy global puede ocultar que Shirt se confunde con T-shirt/top mientras Trouser es trivial. Ahí entran la matriz de confusión y el classification_report.

# Selección de modelos para el reporte fino
objetos = {
    "Baseline": modelo_baseline,
    "L1": modelo_L1,
    "L2": modelo_L2,
    "BatchNorm": modelo_con_bn,
    "EarlyStopping": modelo_es,
    "Combinado": modelo_comb,
    "RandomSearch_sel": modelo_hs,
    fila_do["modelo"]: modelo_dropout,
}

ganador_nombre = str(ganador_val["modelo"])
seleccionados = ["Baseline", ganador_nombre, "Combinado"]
# unique preservando orden
seleccionados = list(dict.fromkeys(seleccionados))
print("Modelos a reportar en test:", seleccionados)


def predecir(model, X):
    proba = model.predict(X, verbose=0)
    return proba, proba.argmax(axis=1)


def matriz_y_leyenda(y_true, y_pred, titulo):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(7.2, 6.0))
    sns.heatmap(cm, annot=True, fmt="d", cmap="Blues", cbar=False, ax=ax,
                xticklabels=CLASS_NAMES, yticklabels=CLASS_NAMES)
    ax.set_xlabel("Predicha")
    ax.set_ylabel("Verdadera")
    ax.set_title(titulo)
    plt.xticks(rotation=45, ha="right")
    plt.yticks(rotation=0)
    plt.tight_layout()
    plt.show()
    return cm


reportes = {}
for nom in seleccionados:
    if nom not in objetos:
        print(f"No se encontró el objeto '{nom}', se omite.")
        continue
    model = objetos[nom]
    proba, yhat = predecir(model, X_test)
    print("\n" + "#" * 72)
    print(f"EVALUACIÓN EN TEST — {nom}")
    print("#" * 72)
    acc = accuracy_score(y_test, yhat)
    print(f"Accuracy (test) = {acc:.3f}")
    print(
        "La accuracy es el promedio de aciertos. No distingue si el error "
        "se concentra en dos prendas parecidas o se reparte."
    )
    cm = matriz_y_leyenda(y_test, yhat, f"Matriz de confusión (test) — {nom}")
    interpretar_matriz_confusion(cm, nombres=CLASS_NAMES)
    print("\nClassification report:")
    reportes[nom] = interpretar_classification_report(y_test, yhat)
    reportes[nom]["_proba"] = proba
    reportes[nom]["_yhat"] = yhat
Modelos a reportar en test: ['Baseline', 'Dropout_0.2', 'Combinado']

########################################################################
EVALUACIÓN EN TEST — Baseline
########################################################################
Accuracy (test) = 0.803
La accuracy es el promedio de aciertos. No distingue si el error se concentra en dos prendas parecidas o se reparte.

OBSERVACION (matriz): la diagonal son aciertos; fuera de ella, confusiones.
  Confusiones mas frecuentes:
    T-shirt/top -> Shirt: 45 casos (asimetrica).
    Pullover -> Shirt: 40 casos (asimetrica).
    Coat -> Shirt: 35 casos (asimetrica).
INFERENCIA:
  T-shirt/top vs Shirt son categorias visualmente proximas en Fashion-MNIST.
  El error es compatible con solapamiento del problema; no demuestra un bug de codigo.
LIMITACION: la matriz no dice si el umbral argmax es el adecuado para una clase;
  precision y recall del reporte complementan esta lectura.
DECISION: si una confusion domina, regularizar el promedio puede no resolverla;
  habria que mirar esas dos clases en el classification_report.

Classification report:
              precision    recall  f1-score   support

 T-shirt/top      0.821     0.640     0.719       150
     Trouser      1.000     0.893     0.944       150
    Pullover      0.701     0.640     0.669       150
       Dress      0.807     0.867     0.836       150
        Coat      0.789     0.600     0.682       150
      Sandal      0.970     0.873     0.919       150
       Shirt      0.475     0.767     0.587       150
     Sneaker      0.802     0.973     0.880       150
         Bag      0.959     0.933     0.946       150
  Ankle boot      0.955     0.840     0.894       150

    accuracy                          0.803      1500
   macro avg      0.828     0.803     0.807      1500
weighted avg      0.828     0.803     0.807      1500

Como leer este reporte (y que inferir de ESTOS numeros):
  precision = entre las veces que el modelo dijo k, cuantas acerto.
  recall    = entre los ejemplos que SI son k, cuantos recupero.
  f1        = media armonica (penaliza el desequilibrio precision/recall).
  support   = ejemplos verdaderos de esa clase en ESTE conjunto.
  macro avg = media no ponderada (cada clase pesa igual).
  weighted  = media ponderada por support.
OBSERVACION / INFERENCIA por clase:
  Shirt: precision=0.475, recall=0.767. Recupera gran parte de los casos reales,
    pero genera mas falsos positivos (agresivo).
  F1 mas bajos: ['Shirt', 'Pullover', 'Coat'] -> [0.587, 0.669, 0.682]
  macro F1=0.807 | weighted F1=0.807
  Macro y weighted proximos: no hay una discrepancia fuerte atribuible a desbalance.
LIMITACION: accuracy global puede ocultar una clase (p. ej. Shirt) que no generaliza.
  Precision alta no implica recall alto. AUC, si se usa, no sustituye este perfil.

########################################################################
EVALUACIÓN EN TEST — Dropout_0.2
########################################################################
Accuracy (test) = 0.846
La accuracy es el promedio de aciertos. No distingue si el error se concentra en dos prendas parecidas o se reparte.

OBSERVACION (matriz): la diagonal son aciertos; fuera de ella, confusiones.
  Confusiones mas frecuentes:
    Shirt -> T-shirt/top: 26 casos (relativamente simetrica (el inverso es 20)).
    Pullover -> Coat: 21 casos (asimetrica).
    T-shirt/top -> Shirt: 20 casos (relativamente simetrica (el inverso es 26)).
INFERENCIA:
  Shirt vs T-shirt/top son categorias visualmente proximas en Fashion-MNIST.
  El error es compatible con solapamiento del problema; no demuestra un bug de codigo.
LIMITACION: la matriz no dice si el umbral argmax es el adecuado para una clase;
  precision y recall del reporte complementan esta lectura.
DECISION: si una confusion domina, regularizar el promedio puede no resolverla;
  habria que mirar esas dos clases en el classification_report.

Classification report:
              precision    recall  f1-score   support

 T-shirt/top      0.772     0.833     0.801       150
     Trouser      0.993     0.947     0.969       150
    Pullover      0.787     0.713     0.748       150
       Dress      0.830     0.880     0.854       150
        Coat      0.719     0.820     0.766       150
      Sandal      0.952     0.920     0.936       150
       Shirt      0.647     0.573     0.608       150
     Sneaker      0.860     0.940     0.898       150
         Bag      0.952     0.933     0.943       150
  Ankle boot      0.964     0.900     0.931       150

    accuracy                          0.846      1500
   macro avg      0.848     0.846     0.845      1500
weighted avg      0.848     0.846     0.845      1500

Como leer este reporte (y que inferir de ESTOS numeros):
  precision = entre las veces que el modelo dijo k, cuantas acerto.
  recall    = entre los ejemplos que SI son k, cuantos recupero.
  f1        = media armonica (penaliza el desequilibrio precision/recall).
  support   = ejemplos verdaderos de esa clase en ESTE conjunto.
  macro avg = media no ponderada (cada clase pesa igual).
  weighted  = media ponderada por support.
OBSERVACION / INFERENCIA por clase:
  Ninguna clase muestra un desequilibrio extremo precision/recall con los umbrales
  usados aqui (0.70/0.55). Eso no implica que no haya clases mas debiles en F1.
  F1 mas bajos: ['Shirt', 'Pullover', 'Coat'] -> [0.608, 0.748, 0.766]
  macro F1=0.845 | weighted F1=0.845
  Macro y weighted proximos: no hay una discrepancia fuerte atribuible a desbalance.
LIMITACION: accuracy global puede ocultar una clase (p. ej. Shirt) que no generaliza.
  Precision alta no implica recall alto. AUC, si se usa, no sustituye este perfil.

########################################################################
EVALUACIÓN EN TEST — Combinado
########################################################################
Accuracy (test) = 0.817
La accuracy es el promedio de aciertos. No distingue si el error se concentra en dos prendas parecidas o se reparte.

OBSERVACION (matriz): la diagonal son aciertos; fuera de ella, confusiones.
  Confusiones mas frecuentes:
    Pullover -> Coat: 48 casos (asimetrica).
    Shirt -> T-shirt/top: 35 casos (asimetrica).
    Pullover -> Shirt: 23 casos (asimetrica).
INFERENCIA:
  Pullover vs Coat son categorias visualmente proximas en Fashion-MNIST.
  El error es compatible con solapamiento del problema; no demuestra un bug de codigo.
LIMITACION: la matriz no dice si el umbral argmax es el adecuado para una clase;
  precision y recall del reporte complementan esta lectura.
DECISION: si una confusion domina, regularizar el promedio puede no resolverla;
  habria que mirar esas dos clases en el classification_report.

Classification report:
              precision    recall  f1-score   support

 T-shirt/top      0.746     0.880     0.807       150
     Trouser      0.979     0.947     0.963       150
    Pullover      0.870     0.447     0.590       150
       Dress      0.857     0.840     0.848       150
        Coat      0.586     0.867     0.699       150
      Sandal      0.893     0.887     0.890       150
       Shirt      0.669     0.540     0.598       150
     Sneaker      0.849     0.940     0.892       150
         Bag      0.910     0.940     0.925       150
  Ankle boot      0.943     0.887     0.914       150

    accuracy                          0.817      1500
   macro avg      0.830     0.817     0.813      1500
weighted avg      0.830     0.817     0.813      1500

Como leer este reporte (y que inferir de ESTOS numeros):
  precision = entre las veces que el modelo dijo k, cuantas acerto.
  recall    = entre los ejemplos que SI son k, cuantos recupero.
  f1        = media armonica (penaliza el desequilibrio precision/recall).
  support   = ejemplos verdaderos de esa clase en ESTE conjunto.
  macro avg = media no ponderada (cada clase pesa igual).
  weighted  = media ponderada por support.
OBSERVACION / INFERENCIA por clase:
  Pullover: precision=0.870, recall=0.447. Cuando predice Pullover suele acertar,
    pero deja escapar una proporcion importante de los casos reales (conservador).
  F1 mas bajos: ['Pullover', 'Shirt', 'Coat'] -> [0.59, 0.598, 0.699]
  macro F1=0.813 | weighted F1=0.813
  Macro y weighted proximos: no hay una discrepancia fuerte atribuible a desbalance.
LIMITACION: accuracy global puede ocultar una clase (p. ej. Shirt) que no generaliza.
  Precision alta no implica recall alto. AUC, si se usa, no sustituye este perfil.

Cómo leer precision, recall y los promedios — con calma

  • Precision alta, recall bajo en una clase: el modelo casi solo la nombra cuando está seguro, pero se le escapan muchos positivos. Es un clasificador conservador para esa clase.
  • Recall alto, precision baja: la nombra a menudo, incluyendo falsos positivos. Es agresivo.
  • F1 resume el conflicto; no elige por usted. En un cribado médico se priorizaría recall; en una alarma costosa, precision. Aquí no hay costo explícito: reportamos F1 y el par crudo.
  • macro avg: media de las 10 clases. Una clase difícil pesa tanto como una fácil.
  • weighted avg: pondera por support. Si todas las clases tienen soporte similar (nuestro split estratificado), macro y weighted deben parecerse. Una brecha grande con soportes iguales no se explica por desbalance: se explica por heterogeneidad de F1.

Relación con generalización. Un modelo puede tener accuracy de test aceptable y, aun así, no generalizar a la clase Shirt. La generalización no es un escalar único: es un perfil. Regularizar a veces mejora el promedio y empeora una clase. Eso debe decirse, no ocultarse bajo un único test_acc.

# ROC one-vs-rest para el ganador de validación (multiclase)
# No es un ROC binario clásico: hay una curva por clase contra el resto.
if ganador_nombre in reportes:
    proba = reportes[ganador_nombre]["_proba"]
else:
    proba, _ = predecir(objetos[ganador_nombre], X_test)

Y_bin = label_binarize(y_test, classes=list(range(N_CLASSES)))
fig, ax = plt.subplots(figsize=(8.8, 6.2))
aucs = []
# Mostramos 4 clases: dos fáciles típicas y dos difíciles típicas
clases_plot = [1, 8, 0, 6]  # Trouser, Bag, T-shirt, Shirt
for k in range(N_CLASSES):
    fpr, tpr, _ = roc_curve(Y_bin[:, k], proba[:, k])
    a = auc(fpr, tpr)
    aucs.append(a)
    if k in clases_plot:
        ax.plot(fpr, tpr, lw=2, label=f"{CLASS_NAMES[k]} (AUC={a:.3f})")
ax.plot([0, 1], [0, 1], "--", color="gray", label="azar")
ax.set_xlabel("False Positive Rate")
ax.set_ylabel("True Positive Rate")
ax.set_title(f"ROC one-vs-rest (test) — {ganador_nombre}\n"
             "se grafican 4 clases; el AUC macro usa las 10")
ax.legend(loc="lower right", fontsize=8)
plt.tight_layout()
plt.show()

auc_macro = roc_auc_score(y_test, proba, multi_class="ovr", average="macro")
print(f"ROC-AUC macro (OVR, test) = {auc_macro:.3f}")
print("AUC por clase:", {CLASS_NAMES[i]: round(aucs[i], 3) for i in range(N_CLASSES)})
print(
    "Interpretación: un AUC de 0.5 es un ranking al azar para esa clase frente al resto. "
    "AUC alto no implica accuracy alto si el umbral implícito del argmax es inadecuado "
    "para esa clase; son lecturas complementarias. En 10 clases el azar de accuracy "
    "es 0.10, no 0.50; no mezcle esos pisos."
)
print("Que aporta el AUC: ranking de la clase frente al resto a lo largo de umbrales.")
print("Que NO aporta: el umbral operativo del argmax, ni precision/recall de una clase dificil.")
print("AUC alto no implica que el umbral de decision sea el correcto, ni sustituye al F1.")
print("Cadena: modelo -> probabilidad -> umbrales -> TPR/FPR -> ROC -> AUC.")

ROC-AUC macro (OVR, test) = 0.985
AUC por clase: {'T-shirt/top': 0.985, 'Trouser': 0.997, 'Pullover': 0.971, 'Dress': 0.993, 'Coat': 0.974, 'Sandal': 0.997, 'Shirt': 0.942, 'Sneaker': 0.995, 'Bag': 0.994, 'Ankle boot': 0.998}
Interpretación: un AUC de 0.5 es un ranking al azar para esa clase frente al resto. AUC alto no implica accuracy alto si el umbral implícito del argmax es inadecuado para esa clase; son lecturas complementarias. En 10 clases el azar de accuracy es 0.10, no 0.50; no mezcle esos pisos.
Que aporta el AUC: ranking de la clase frente al resto a lo largo de umbrales.
Que NO aporta: el umbral operativo del argmax, ni precision/recall de una clase dificil.
AUC alto no implica que el umbral de decision sea el correcto, ni sustituye al F1.
Cadena: modelo -> probabilidad -> umbrales -> TPR/FPR -> ROC -> AUC.

17. Amenazas a la validez: comparaciones justas

Que dos números difieran no implica que la técnica difiera. Amenazas típicas:

Amenaza Cómo la controlamos aquí Qué queda abierto
Distinto split Un solo train_test_split con SEED Otro split podría reordenar modelos cercanos
Distinta semilla de pesos set_random_seed antes de cada construcción Una sola semilla no estima varianza
Distinto preprocesamiento Una sola función aplanar_normalizar —
Distinto número de épocas Presupuestos declarados; ES recorta de forma explícita Comparar ES (20 épocas) con baseline (40) es justo como protocolos, no como “misma duración”
Distinta métrica Tablas con las mismas columnas val_loss y val_acc pueden desacordar
Hardware Mismo proceso Tiempos no son portables
Pesca en test Selección por validación En el notebook vemos test más de lo recomendable, con fines didácticos

Variabilidad aleatoria. Si dos modelos difieren en \(0.5\) puntos de accuracy sobre 1 500 ejemplos, esa diferencia puede ser ruido. Un intervalo tosco de Bernoulli: \(\sqrt{p(1-p)/n}\approx 0.01\) cuando \(p\approx 0.8\). Diferencias de un punto porcentual son evidencia débil salvo que se repitan con otras semillas.

No repetimos cada experimento \(k\) veces para no hacer el notebook impracticable. El precio es honestidad en el lenguaje: sugieren, compatible con, no demuestran.


18. Guía diagnóstica (no es un algoritmo infalible)

Use esta guía como mapa de hipótesis, no como árbol de decisión jurídico.

Observación persistente Inferencia plausible Decisiones a considerar
Train malo y val malo Underfitting: capacidad, features, lr, épocas o regularización excesiva Subir capacidad, entrenar más, bajar \(\lambda\)/\(r\), revisar escala de \(X\)
Train excelente y val claramente peor Overfitting L2/L1, Dropout, menos capacidad, más datos, Early Stopping
Train y val inestables (rebotan) Optimización inestable Bajar lr, subir batch, BatchNorm, otro optimizer
Train mejora y val se estanca Empieza a no transferir Early Stopping; no celebrar el acc de train
Regularizar derrumba train y val Regularización demasiado fuerte Bajar \(\lambda\) o \(r\)
Gap pequeño con acc bajo No es “buena generalización” Es mal ajuste simétrico
val_loss empeora pero val_acc no Las probabilidades se calibran peor Decidir qué monitor importa para el uso
History-train \(\ll\) evaluate-train con Dropout Regímenes distintos No interpretar eso como milagro de generalización

Vuelva a la terna:

  1. Observación (frase descriptiva, con números del run).
  2. Inferencia (hipótesis compatible).
  3. Decisión (una intervención, luego volver a medir).
# Diagnóstico automático de la tabla final (auxiliar, no veredicto)
print("Guía aplicada a los modelos registrados (lenguaje prudente):\n")
for _, row in df_final.iterrows():
    diagnosticar_modelo(row.to_dict())
Guía aplicada a los modelos registrados (lenguaje prudente):


--- Diagnostico: Baseline ---
OBSERVACION:
  train_acc=0.917  val_acc=0.823  test_acc=0.803
  gap_acc (train-val)=+0.094  |val-test|=0.020
  train_loss=0.211  val_loss=0.685  test_loss=0.676
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.
  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: L1 ---
OBSERVACION:
  train_acc=0.932  val_acc=0.831  test_acc=0.831
  gap_acc (train-val)=+0.101  |val-test|=0.001
  train_loss=0.649  val_loss=1.018  test_loss=1.014
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: L2 ---
OBSERVACION:
  train_acc=0.915  val_acc=0.833  test_acc=0.817
  gap_acc (train-val)=+0.082  |val-test|=0.015
  train_loss=0.495  val_loss=0.819  test_loss=0.805
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Patron mixto. Con estas metricas unicamente no podemos etiquetar el regimen.
  Conviene mirar las curvas de loss y el test como evaluacion, no como selector.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: Dropout_0.2 ---
OBSERVACION:
  train_acc=0.956  val_acc=0.851  test_acc=0.846
  gap_acc (train-val)=+0.105  |val-test|=0.005
  train_loss=0.125  val_loss=0.506  test_loss=0.504
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: BatchNorm ---
OBSERVACION:
  train_acc=0.936  val_acc=0.804  test_acc=0.823
  gap_acc (train-val)=+0.132  |val-test|=0.019
  train_loss=0.240  val_loss=1.126  test_loss=0.937
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train alto y brecha amplia respecto a validacion. Esto constituye evidencia
  compatible con sobreajuste. No 'demuestra' que cualquier gap>0.10 sea inaceptable.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: EarlyStopping ---
OBSERVACION:
  train_acc=0.858  val_acc=0.815  test_acc=0.816
  gap_acc (train-val)=+0.043  |val-test|=0.001
  train_loss=0.380  val_loss=0.531  test_loss=0.523
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: RandomSearch_sel ---
OBSERVACION:
  train_acc=0.876  val_acc=0.832  test_acc=0.831
  gap_acc (train-val)=+0.044  |val-test|=0.001
  train_loss=0.347  val_loss=0.487  test_loss=0.487
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

--- Diagnostico: Combinado ---
OBSERVACION:
  train_acc=0.885  val_acc=0.828  test_acc=0.817
  gap_acc (train-val)=+0.057  |val-test|=0.011
  train_loss=0.400  val_loss=0.582  test_loss=0.594
COMPARACION:
  El gap mide si el modelo rinde mejor donde actualizo pesos que en validacion.
  Un gap pequeno NO implica automaticamente un buen modelo: hay que mirar el nivel absoluto.
INFERENCIA:
  Train y val proximos en un nivel no trivial. Compatible con generalizacion razonable
  en ESTE corpus. Con una sola semilla no medimos varianza.
  Validation y test son relativamente consistentes: evidencia de comportamiento
  similar sobre datos no usados para actualizar pesos.
LIMITACION: una metrica no es una conclusion. Es evidencia para construir una conclusion.
DECISION: si hay divergencia train/val, revisar curvas; si confirman, probar UNA
  intervencion (regularizar, Early Stopping o reducir capacidad) y volver a medir.

19. Conclusión conceptual

El objetivo del entrenamiento no es maximizar el desempeño sobre los datos que el modelo ya conoce. El objetivo es aprender una representación que mantenga su capacidad predictiva sobre observaciones nuevas.

El ciclo que esta sesión entrenó no es “añadir Dropout”. Es:

medir → observar → comparar → inferir → decidir → volver a medir.

En la práctica del módulo: diagnosticar → regularizar (o recortar, o simplificar) → validar → comparar → decidir.

Tres afirmaciones que deben sobrevivir al cierre del kernel:

  1. El mejor modelo no es necesariamente el de mayor accuracy de entrenamiento.
  2. Un gap pequeño no es un certificado de calidad; hay que leerlo junto al nivel absoluto y al test una vez.
  3. Las técnicas no se apilan por fe. L2, Dropout, BatchNorm y Early Stopping responden a hipótesis distintas (norma de pesos, co-adaptación, dinámica de activaciones, presupuesto de épocas). Se evalúan. A veces el combinado pierde.

Si usted puede mirar un history y producir una terna observación / inferencia / decisión sin pedirle a nadie que le diga “hay overfitting”, la sesión cumplió su objetivo. Las líneas de Keras eran el medio.

Una métrica no es una conclusión. Es evidencia para construir una conclusión.


20. Ejercicios

No se incluyen soluciones inmediatamente. El valor está en escribir la terna y, en los de código, en medir de nuevo.

A. Interpretación (sin programar todavía)

A1. Le muestran dos curvas de val_loss. La de la izquierda baja hasta la época 40. La de la derecha baja hasta la 12 y luego sube, mientras loss sigue bajando. Diagnostique cada una. ¿Detendría alguna? ¿Con qué monitor?

A2. Modelo P: train acc \(0.97\), val acc \(0.81\), test acc \(0.80\). Modelo Q: train \(0.84\), val \(0.83\), test \(0.82\). ¿Cuál generaliza mejor? ¿Con qué métricas justifica? ¿En qué escenario preferiría P?

A3. Un classification_report tiene Shirt con precision \(0.45\) y recall \(0.71\), y T-shirt/top con precision \(0.70\) y recall \(0.48\). ¿Qué patrón de confusión es compatible? ¿Subiría el umbral de Shirt si pudiera (en binario)? Aquí el umbral es un \(\arg\max\) entre 10 logits: ¿qué implica eso para “subir el umbral”?

A4. \(\lambda=0\) da val \(0.80\); \(\lambda=10^{-3}\) da \(0.83\); \(\lambda=10^{-1}\) da \(0.55\) con train \(0.54\). ¿Aumentaría o reduciría \(\lambda\) si parte de \(10^{-1}\)? ¿Y si parte de \(0\)?

A5. Train acc \(0.58\), val acc \(0.57\) después de 40 épocas, red 256-256-128, \(\lambda=0\). ¿Es overfitting? Proponga dos hipótesis rivales y un experimento que las separe.

A6. Debe entregar un modelo. Tiene la tabla de la sección 15. Escriba un párrafo de selección que use al menos tres columnas y que no use test como criterio. Después, en un segundo párrafo, comente el test como evaluación.

A7. Explique, en cinco líneas, por qué buscar hiperparámetros con test_accuracy invalida el número que luego se reporta como “generalización”.

A8. val_loss sube desde la época 20; val_acc sigue plano-alto. ¿Qué observación, qué inferencia, qué decisión?

B. Código (vuelva a medir)

B1. Reentrene el baseline con \(\lambda_{L2}\in\{10^{-4},5\cdot 10^{-3}\}\) (un valor que no haya sido el ganador de la sección 9, si es posible). Compare gap y val_acc con la fila L2 ya registrada.

B2. Fije la arquitectura del combinado y cambie solo Dropout a \(0.1\) y a \(0.5\). ¿Se reproduce la lección de “r excesivo”?

B3. En Early Stopping, ponga patience=2 y patience=20. Compare épocas ejecutadas y val_acc. ¿Un patience mínimo siempre ahorra tiempo útil?

B4. Construya un modelo D de capacidad intermedia entre B y C (p. ej. 128-64). Ubíquelo en la tabla de regímenes. ¿El relato A/B/C se sostiene?

B5. (Opcional, más largo.) Repita el baseline con tres semillas \(\{0,1,2\}\) y reporte media y desviación de val_acc. ¿La ventaja de su técnica favorita supera esa desviación?

C. Meta-pregunta

C1. Si solo pudiera llevarse una práctica a un proyecto real, ¿cuál: leer history con la terna observación/inferencia/decisión, o conocer la API de Dropout? Justifique en términos del objetivo de la sesión.

## Referencias mínimas (para profundizar, no para citar de oídas)- Goodfellow, Bengio y Courville, Deep Learning, caps. de regularización y optimización.- Srivastava et al., “Dropout: A Simple Way to Prevent Neural Networks from Overfitting”, JMLR 2014.- Ioffe y Szegedy, “Batch Normalization”, ICML 2015.- Bergstra y Bengio, “Random Search for Hyper-Parameter Optimization”, JMLR 2012.- Prechelt, “Early Stopping — But When?”, en Neural Networks: Tricks of the Trade.El criterio no es la métrica suelta: es la lectura, la inferencia y la decisión justificada.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.