Convoluciones, filtros, pooling, mapas de activación y comparación entre CNN y MLP.
Author
Wilder Ramírez Delgado
Published
September 2, 2026
Fundamentos de Redes Convolucionales (CNN)
Serie Deep Learning · del perceptrón a los transformers.
En este notebook estudiamos convoluciones, filtros, pooling, mapas de activación y la comparación entre CNN y MLP, para entender por qué una arquitectura espacial es necesaria cuando el dato es una imagen.
1. Introducción
Este notebook continúa el camino del curso (Perceptrón → MLP → Backpropagation → Generalización) y responde una pregunta central:
¿Por qué necesitamos una arquitectura especializada para imágenes si una MLP ya puede clasificarlas?
La respuesta no está en «más capas» ni en «más neuronas». Está en la estructura espacial del dato visual y en los sesgos inductivos que una CNN introduce de forma explícita: localidad, compartición de pesos y aprendizaje jerárquico de representaciones.
Una métrica no es una conclusión. Es evidencia para construir una conclusión.
Qué ya se conoce (y no se volverá a explicar)
Perceptrón, MLP, activaciones, pérdida, backpropagation, Train / Validation / Test, matriz de confusión, Accuracy, Precision, Recall, F1, ROC/AUC, generalización, underfitting, overfitting y regularización. Aquí se aplican para comparar MLP y CNN.
Objetivo general
Construir una comprensión profunda y aplicada de las CNN: motivación, mecanismo interno, flujo de información, entrenamiento y análisis interpretativo de resultados.
Competencias que se desarrollan
Explicar por qué una imagen es un tensor con estructura espacial.
Justificar técnicamente las limitaciones de una MLP en visión (sin afirmar que «se pierde toda la información»).
Entender la convolución como detector local antes de usar Conv2D.
Distinguir kernel, feature map y activación.
Interpretar filtros, stride, padding y pooling.
Calcular parámetros de Conv2D y Dense y leer model.summary().
Construir, entrenar y evaluar una CNN simple.
Comparar MLP y CNN con evidencia experimental, no con eslóganes.
Analizar errores y activaciones internas con criterio prudente.
Este bloque inicial carga librerías, fija semillas y prepara datasets de referencia para que todas las secciones posteriores sean reproducibles y coherentes.
Su significado pedagógico es que un experimento de Deep Learning no comienza en la arquitectura, sino en una configuración controlada de datos y entorno.
El aprendizaje esperado es valorar la reproducibilidad y la preparación de insumos como parte formal del flujo de trabajo.
La conexión con la siguiente sección es que, con los datos cargados, se puede analizar primero la estructura espacial de las imágenes y luego motivar la necesidad de CNN.
Los datasets cargados se reutilizan: MNIST y la imagen RGB para entender convolución; Fashion-MNIST para el experimento comparable MLP vs CNN.
2. Introducción: por qué una red densa no es suficiente para imágenes
Una imagen, vista como dato, es un tensor cuyos valores tienen significado junto con su posición. Dos píxeles con el mismo valor pueden representar cosas distintas si están en lugares diferentes del objeto.
Esa propiedad se llama estructura espacial: patrones como bordes, esquinas y texturas emergen de relaciones locales entre vecinos, no de valores aislados.
Qué ocurre al hacer Flatten
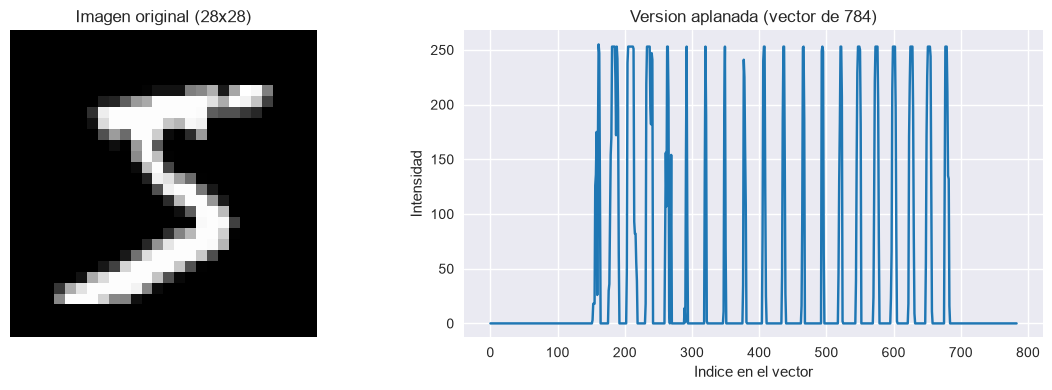
Una MLP requiere vectorizar la entrada. Al aplanar 28 × 28 se obtiene un vector de 784 valores.
Flatten no destruye los valores. El vector conserva todas las intensidades. Lo que desaparece es la representación explícita de vecindad en la arquitectura: la red ya no trata al píxel (i, j) como vecino de (i, j+1), salvo que aprenda esa relación de forma indirecta a partir de los datos.
Una MLP podría aprender relaciones entre píxeles, pero no incorpora de fábrica sesgos inductivos útiles para visión:
localidad (conectividad local): lo relevante suele estar cerca;
compartición de pesos (weight sharing): el mismo detector se reutiliza en toda la imagen;
cierta equivarianza a traslaciones: un patrón desplazado tiende a producir una respuesta desplazada.
Además, en redes densas la cantidad de parámetros crece rápido. Incluso en imágenes pequeñas, la primera capa puede concentrar cientos de miles de pesos, aumentando costo computacional y riesgo de sobreajuste.
La motivación de las CNN nace aquí: usar conectividad local y pesos compartidos para aprender patrones visuales de forma más coherente con la geometría de la imagen.
La diferencia no es «CNN tiene más capas». Es cuándo y cómo se aplana: en la CNN, Flatten ocurre después de haber extraído evidencia espacial.
Intuición conceptual
En visión, detectar un borde no debería depender de su ubicación exacta. La arquitectura ideal debe reutilizar el mismo detector en toda la imagen.
Idea clave
En imágenes, no basta con aprender una función: se necesita una arquitectura que respete estructura espacial.
Aquí es donde nacen las CNN.
# Visualizacion: imagen original vs imagen aplanadaimg_gray = x_train_mnist[0]flat = img_gray.flatten()fig, axes = plt.subplots(1, 2, figsize=(12, 4))axes[0].imshow(img_gray, cmap="gray")axes[0].set_title("Imagen original (28x28)")axes[0].axis("off")axes[1].plot(flat, color="tab:blue")axes[1].set_title("Version aplanada (vector de 784)")axes[1].set_xlabel("Indice en el vector")axes[1].set_ylabel("Intensidad")plt.tight_layout()plt.show()print("Valores conservados al aplanar:", img_gray.size, "==", flat.size)print("Flatten conserva intensidades; elimina la grilla de vecindad explicita.")# Comparacion de parametros: capa densa vs un kernel compartidoparams_dense_28 =28*28*256+256params_dense_64 =64*64*512+512params_kernel_3x3 =3*3*1+1# un filtro, 1 canal, con biasprint(f"Capa densa 784 -> 256 (con bias): {params_dense_28:,}")print(f"Capa densa 64x64 -> 512 (con bias): {params_dense_64:,}")print(f"Un kernel 3x3 + bias (1 canal, 1 filtro): {params_kernel_3x3}")print("Ese kernel se reutiliza en todas las posiciones (weight sharing).")print("Una CNN con muchos filtros y una cabeza densa amplia PUEDE tener mas parametros que una MLP pequena.")print("El numero de parametros se mide; no se asume.")
Valores conservados al aplanar: 784 == 784
Flatten conserva intensidades; elimina la grilla de vecindad explicita.
Capa densa 784 -> 256 (con bias): 200,960
Capa densa 64x64 -> 512 (con bias): 2,097,664
Un kernel 3x3 + bias (1 canal, 1 filtro): 10
Ese kernel se reutiliza en todas las posiciones (weight sharing).
Una CNN con muchos filtros y una cabeza densa amplia PUEDE tener mas parametros que una MLP pequena.
El numero de parametros se mide; no se asume.
Interpretación
La comparación entre imagen y vector no muestra que «se pierda toda la información». Los 784 valores siguen ahí. Lo que se pierde es la representación explícita de vecindad: la MLP recibe una lista, no una grilla.
Ese detalle es determinante porque en visión los patrones relevantes nacen de relaciones de proximidad (bordes, trazos, contornos). Una MLP puede, en principio, redescubrir esas relaciones, pero lo hace sin los sesgos de localidad y compartición de pesos.
El cálculo de parámetros ilustra otro costo: 784 × N crece rápido. Un kernel 3 × 3 tiene pocos pesos, pero se aplica en muchas posiciones. Eso no garantiza que toda CNN tenga menos parámetros que toda MLP: depende de filtros, canales y capas densas finales.
Idea clave
Aplanar una imagen facilita el cómputo en MLP, pero retira de la arquitectura la estructura espacial que la CNN va a explotar de forma explícita.
Reto técnico
Si una imagen 64 × 64 en escala de grises se conecta a una capa densa de 512 neuronas, ¿cuántos parámetros aparecen en esa capa? Compáralo con 32 kernels 3 × 3 de 1 canal. ¿Qué cambia si la cabeza densa de la CNN es muy ancha?
3. Representación de imágenes como tensores
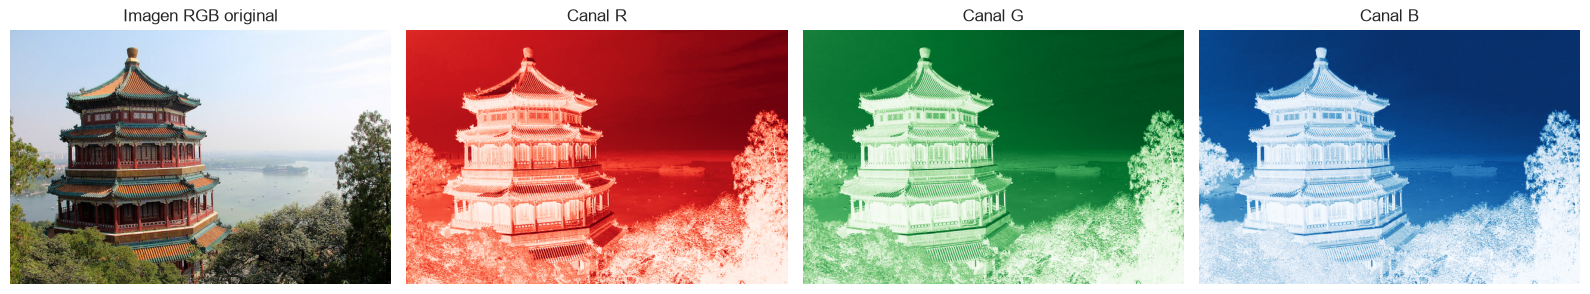
En Deep Learning, una imagen se modela como tensor porque cada eje tiene significado:
Escala de grises: (alto, ancho).
RGB: (alto, ancho, canales) con canales R, G y B.
Un valor alto en un píxel no tiene significado aislado; adquiere sentido al compararse con su entorno local y con sus canales asociados. Por eso, preservar dimensiones y orden es fundamental para que la red procese correctamente la información visual.
En práctica, muchas implementaciones convierten datos de uint8 (0 a 255) a float32 normalizado (0 a 1), lo que estabiliza el entrenamiento.
Intuición conceptual
Una imagen RGB puede entenderse como tres “capas transparentes” superpuestas. Cambiar una capa modifica la apariencia final, lo cual muestra por qué el eje de canales no se puede ignorar.
Idea clave
Trabajar con imágenes en CNN exige respetar la semántica de cada dimensión del tensor: alto, ancho y canales.
Separar canales permite ver que una imagen RGB no es un bloque indivisible, sino una composición de tres fuentes de información alineadas espacialmente.
Esto importa porque una CNN procesa esa estructura multicanal para aprender patrones que dependen tanto de intensidad como de color relativo.
El aprendizaje esperado es comprender que definir correctamente la forma de entrada (alto, ancho, canales) es una decisión conceptual, no solo sintáctica.
La conexión con convolución es que los filtros actuarán precisamente sobre este tensor para producir mapas de activación.
Idea clave
Una imagen RGB se aprende como tensor estructurado, no como lista plana de valores.
Reto técnico
Tomar una imagen RGB y construir una versión de un solo canal (por ejemplo solo R). Comparar visualmente con la imagen original y explicar qué información cromática se pierde.
4. Convolución: intuición antes de la fórmula
La convolución es el núcleo operativo de una CNN. Consiste en mover una ventana pequeña (kernel) por la imagen para responder una pregunta local en cada posición.
En cada desplazamiento ocurre una secuencia fija: 1. Se toma un bloque local de la imagen (ventana). 2. Se compara con el kernel mediante multiplicación elemento a elemento. 3. Se suman los productos para producir un valor de salida. 4. El kernel se desplaza (según el stride) y se repite el proceso.
Al recorrer toda la imagen aparece un feature map: el mapa de respuestas del kernel.
Formalmente, para entrada X y kernel K:
Y(i,j) = Σu Σv X(i+u, j+v) * K(u,v)
Tres términos que no deben confundirse
Concepto
Qué es
Kernel
Matriz de pesos. En visión clásica se diseña a mano; en una CNN se aprende.
Feature map
Resultado de aplicar el kernel sobre la entrada (o sobre un mapa previo).
Activación
Feature map después de la no linealidad (ReLU, etc.), cuando esta existe.
Conv2D(..., activation="relu") combina convolución y activación en una sola capa. Conceptualmente siguen siendo dos operaciones.
Intuición conceptual
Un kernel no «entiende» objetos completos; detecta regularidades locales (transiciones, orientaciones, texturas). Varias capas y varios filtros permiten construir patrones cada vez más complejos.
Idea clave
Convolucionar es evaluar, posición por posición, si un patrón local está presente en la imagen.
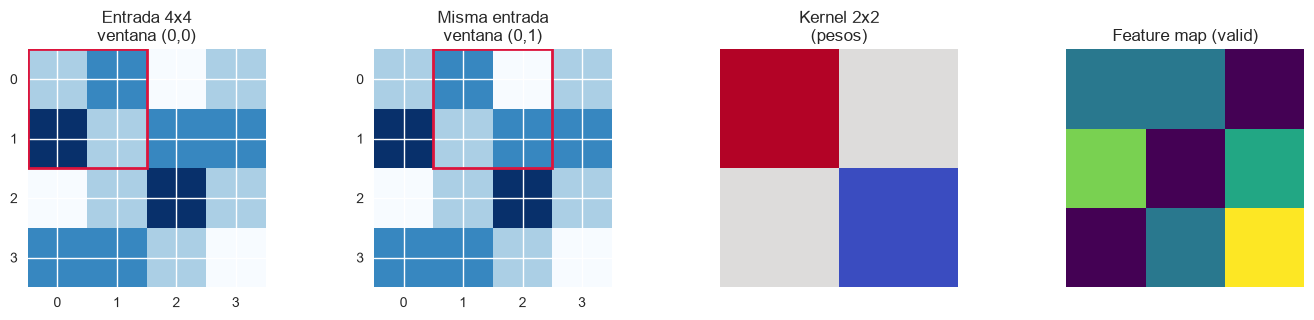
# Ejemplo didactico de convolucion: calculo manual + implementacionsmall_img = np.array([ [1, 2, 0, 1], [3, 1, 2, 2], [0, 1, 3, 1], [2, 2, 1, 0]], dtype=float)kernel = np.array([ [1, 0], [0, -1]], dtype=float)def conv2d_valid(image, k): h, w = image.shape kh, kw = k.shape out = np.zeros((h - kh +1, w - kw +1))for i inrange(out.shape[0]):for j inrange(out.shape[1]): region = image[i:i + kh, j:j + kw] out[i, j] = np.sum(region * k)return outconv_result = conv2d_valid(small_img, kernel)# Calculo manual paso a paso para la posicion (0, 0)region_00 = small_img[0:2, 0:2]product_00 = region_00 * kernelmanual_00 = np.sum(product_00)# Segunda posicion para ver el desplazamientoregion_01 = small_img[0:2, 1:3]manual_01 = np.sum(region_01 * kernel)print("Matriz de entrada:\n", small_img)print("\nKernel:\n", kernel)print("\nRegion local (0,0):\n", region_00)print("\nProducto elemento a elemento region * kernel:\n", product_00)print("\nSuma de productos -> salida(0,0):", manual_00)print("\nRegion local (0,1) [el kernel se desplazo 1 columna]:\n", region_01)print("Suma de productos -> salida(0,1):", manual_01)print("\nSalida completa de la convolucion (valid):\n", conv_result)print("Este mapa de salida ES el feature map del kernel (antes de una activacion).")fig, axes = plt.subplots(1, 4, figsize=(14, 3.2))axes[0].imshow(small_img, cmap="Blues")axes[0].add_patch(Rectangle((-0.5, -0.5), 2, 2, fill=False, edgecolor="crimson", linewidth=2))axes[0].set_title("Entrada 4x4\nventana (0,0)")axes[0].set_xticks(range(4))axes[0].set_yticks(range(4))axes[1].imshow(small_img, cmap="Blues")axes[1].add_patch(Rectangle((0.5, -0.5), 2, 2, fill=False, edgecolor="crimson", linewidth=2))axes[1].set_title("Misma entrada\nventana (0,1)")axes[1].set_xticks(range(4))axes[1].set_yticks(range(4))axes[2].imshow(kernel, cmap="coolwarm")axes[2].set_title("Kernel 2x2\n(pesos)")axes[2].axis("off")axes[3].imshow(conv_result, cmap="viridis")axes[3].set_title("Feature map (valid)")axes[3].axis("off")plt.tight_layout()plt.show()
Matriz de entrada:
 [[1. 2. 0. 1.]
 [3. 1. 2. 2.]
 [0. 1. 3. 1.]
 [2. 2. 1. 0.]]

Kernel:
 [[ 1.  0.]
 [ 0. -1.]]

Region local (0,0):
 [[1. 2.]
 [3. 1.]]

Producto elemento a elemento region * kernel:
 [[ 1.  0.]
 [ 0. -1.]]

Suma de productos -> salida(0,0): 0.0

Region local (0,1) [el kernel se desplazo 1 columna]:
 [[2. 0.]
 [1. 2.]]
Suma de productos -> salida(0,1): 0.0

Salida completa de la convolucion (valid):
 [[ 0.  0. -2.]
 [ 2. -2.  1.]
 [-2.  0.  3.]]
Este mapa de salida ES el feature map del kernel (antes de una activacion).
Interpretación
El cálculo manual y el cálculo programado produjeron el mismo principio: cada valor de salida se obtiene evaluando una región local con una regla fija. El recuadro rojo muestra qué zona está procesando el kernel en cada paso.
Eso significa que la convolución transforma la imagen en un feature map: un mapa de evidencia, no una copia modificada de los píxeles. El kernel es la regla; el feature map es el resultado.
Todavía no hay aprendizaje: este kernel fue escrito a mano. En una CNN, esos números se convierten en pesos ajustables y se actualizan por backpropagation.
¿Qué está pasando realmente?
Cada elemento de la salida responde a una pregunta local: «¿este patrón está aquí?».
Cuando la respuesta es alta, el patrón del kernel coincide con la región observada; cuando es baja, la coincidencia es débil. Así comienza la detección automática de rasgos visuales.
Idea clave
Primero se entiende la operación (ventana → producto → suma → desplazamiento). Después se usará Conv2D.
Ejemplos reales de convolución (TensorFlow)
Para cerrar el puente entre el ejemplo matricial y el uso en visión, conviene observar la misma operación sobre imágenes reales importadas al inicio del notebook.
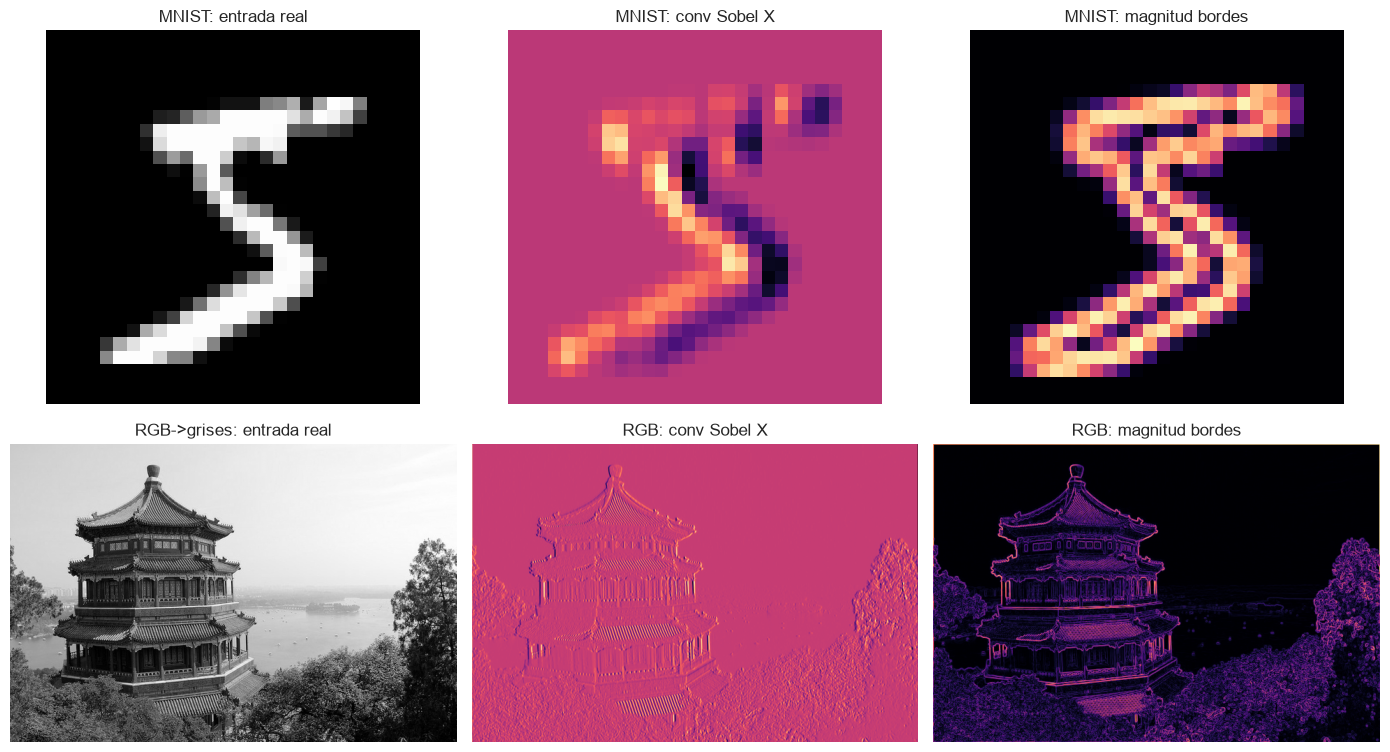
Se usa tf.nn.conv2d con kernels fijos de Sobel. Esto replica el tipo de operación que una CNN ejecuta internamente cuando aprende filtros.
Intuición conceptual
Sobel estima gradientes de intensidad: responde fuerte donde hay cambios bruscos (bordes) y responde débil donde la imagen es casi uniforme.
Los mapas generados por Sobel no son meras visualizaciones: son respuestas de convolución que miden cambios de intensidad. En el dígito MNIST, los bordes del trazo aparecen como curvas de alta magnitud. En la fotografía RGB, la magnitud resalta contornos de objetos y transiciones de iluminación.
Esto significa que la convolución transforma la entrada en una representación donde lo relevante ya no es el nivel de gris absoluto, sino la presencia de estructuras locales (gradientes).
El aprendizaje esperado es reconocer que una CNN aprende filtros para producir mapas similares en espíritu, pero adaptados a la tarea mediante entrenamiento.
La conexión con el curso es directa: lo que aquí se fija manualmente (Sobel), en una CNN se aprende por backpropagation.
La conexión con la siguiente sección es que los kernels clásicos (borde, blur, sharpen) son el mismo mecanismo convolucional, solo que con distintos patrones numéricos.
Idea clave
Una convolución real convierte intensidades en evidencia de estructura local (bordes, texturas, transiciones).
Reto técnico
Repetir el experimento con padding="VALID" y explicar qué cambia en el tamaño del mapa y en la información de bordes.
Modificar un coeficiente del kernel Sobel y explicar cómo cambia la sensibilidad del detector (qué tipo de bordes se enfatiza más o menos).
Kernel manual frente a kernel aprendido
Kernel manual (Sobel, blur, sharpen): un humano elige los coeficientes para un efecto conocido (bordes, suavizado, realce).
Kernel aprendido: los coeficientes son parámetros. Empiezan aleatorios y se ajustan para reducir la pérdida de la tarea.
La operación es la misma. Cambia quién elige los números y con qué criterio.
Ejemplo adicional: efecto del kernel de forma más evidente
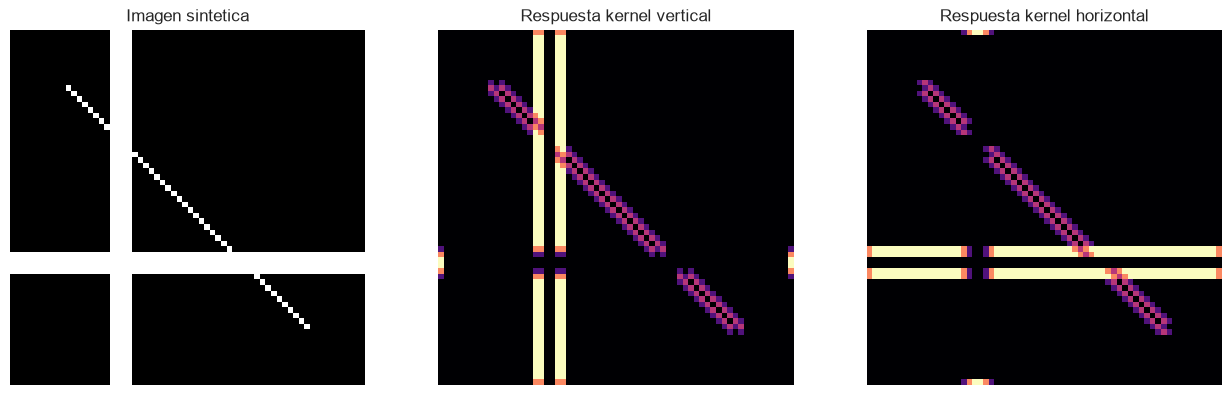
Para aislar el efecto del kernel, se construirá una imagen sintética con patrones controlados: una línea vertical, una línea horizontal y una diagonal. Luego se aplicarán detectores orientados para observar qué patrón responde más en cada caso.
Intuición conceptual
Si un kernel está diseñado para detectar bordes verticales, su respuesta debe ser alta en estructuras verticales y más baja en otras orientaciones.
Idea clave
El kernel actúa como un detector selectivo: no responde igual a todos los patrones.
La salida confirma la selectividad del kernel: el detector vertical activa con mayor intensidad alrededor de la línea vertical, mientras el detector horizontal responde con más fuerza cerca de la línea horizontal.
Esto significa que el valor de activación no depende solo de la intensidad del píxel, sino de la coincidencia estructural entre patrón local y kernel.
El aprendizaje esperado es comprender por qué una CNN puede combinar muchos filtros: cada uno aporta evidencia distinta sobre la misma imagen.
La conexión con la siguiente sección es directa: los filtros clásicos y aprendidos se diferencian en sus coeficientes, pero comparten exactamente este comportamiento selectivo.
Idea clave
Un kernel no “ve” todo por igual; responde preferentemente al patrón para el cual fue diseñado.
Reto técnico
Cambiar la diagonal por una línea diagonal más gruesa y analizar cuál de los dos kernels (vertical/horizontal) responde más y por qué.
5. Filtros y kernels
En términos operativos, un kernel es una pequeña matriz de pesos. Cuando ese kernel se desplaza por toda la imagen produciendo un mapa de respuesta, se habla de un filtro aplicado sobre la entrada. El mapa de respuesta es el feature map.
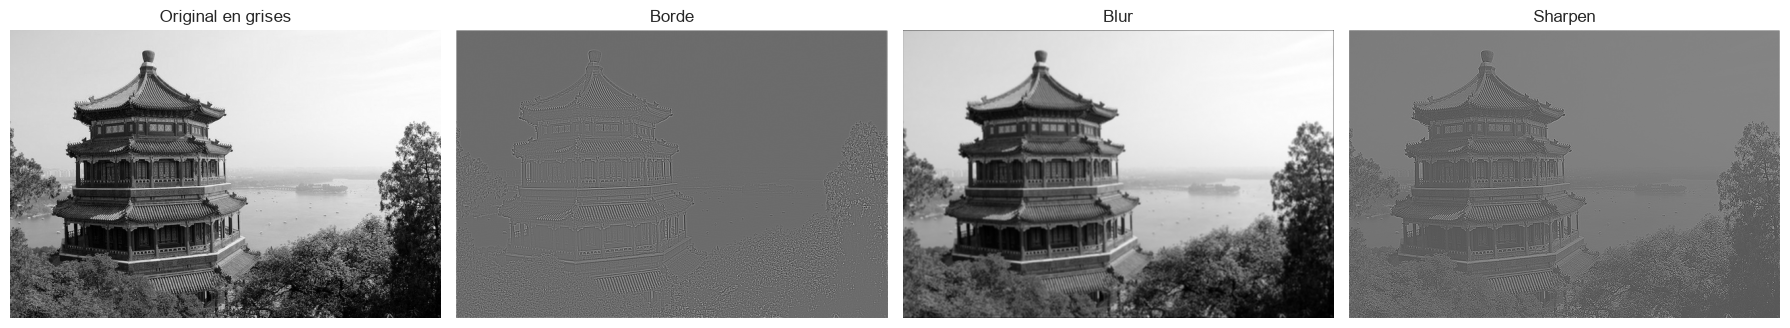
La elección de valores del kernel define qué patrón se destaca: - kernels de borde responden a cambios bruscos de intensidad, - kernels de blur promedian vecinos para suavizar, - kernels de sharpen incrementan contraste local para realzar detalle.
Kernel manual frente a kernel aprendido
En visión clásica estos kernels se diseñaban a mano. En Deep Learning, una CNN inicia con pesos aleatorios y los ajusta por backpropagation para aprender filtros útiles para la tarea.
No son dos operaciones distintas: son la misma convolución con distinto origen de los pesos.
Intuición conceptual
Un filtro puede verse como un detector especializado. Si la imagen contiene el patrón que ese detector espera, la respuesta aumenta; si no, permanece baja. Tras ReLU, esa respuesta se convierte en activación.
Idea clave
La potencia de una CNN no depende de un único filtro, sino de aprender muchos detectores locales complementarios.
# Aplicacion de kernels clasicos a una imagen en escala de grisesimg_gray_large = np.mean(img_rgb, axis=2) # conversion simple a griseskernels = {"Borde": np.array([[-1, -1, -1], [-1, 8, -1], [-1, -1, -1]], dtype=float),"Blur": (1/9) * np.ones((3, 3), dtype=float),"Sharpen": np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]], dtype=float)}def conv2d_same(image, k): kh, kw = k.shape ph, pw = kh //2, kw //2 padded = np.pad(image, ((ph, ph), (pw, pw)), mode="constant") out = np.zeros_like(image, dtype=float)for i inrange(image.shape[0]):for j inrange(image.shape[1]): region = padded[i:i+kh, j:j+kw] out[i, j] = np.sum(region * k)return outresults = {name: conv2d_same(img_gray_large, k) for name, k in kernels.items()}fig, axes = plt.subplots(1, 4, figsize=(18, 4))axes[0].imshow(img_gray_large, cmap="gray")axes[0].set_title("Original en grises")axes[0].axis("off")for ax, (name, res) inzip(axes[1:], results.items()): ax.imshow(res, cmap="gray") ax.set_title(name) ax.axis("off")plt.tight_layout()plt.show()
Interpretación
Aplicar varios kernels sobre la misma entrada demuestra que cada filtro actúa como un detector especializado: unos resaltan cambios bruscos, otros suavizan y otros realzan detalles.
Ese comportamiento explica por qué los kernels funcionan: convierten comparaciones locales en respuestas numéricas que cuantifican presencia de patrones.
El aprendizaje esperado es reconocer que la CNN construye su comprensión visual sobre estas transformaciones, no sobre la imagen original sin procesar.
La conexión con aprendizaje automático es directa: en una CNN real, estos filtros no se programan a mano, se aprenden para maximizar desempeño en la tarea.
Idea clave
Un filtro útil es aquel que transforma píxeles en evidencia discriminativa para clasificar.
Reto técnico
Añadir un cuarto kernel diseñado manualmente (por ejemplo detector horizontal) y explicar qué tipo de patrón enfatiza respecto a los tres ya mostrados.
6. Stride y padding
Al aplicar convolución, dos decisiones de diseño afectan directamente la geometría de salida:
Stride (S): número de píxeles que avanza el kernel en cada desplazamiento.
Padding (P): borde artificial agregado alrededor de la imagen (usualmente ceros).
Si el stride aumenta, la salida se reduce porque se evalúan menos posiciones. Si se usa padding, se preserva mejor información en bordes y se controla el tamaño del mapa resultante.
Fórmula de dimensiones
Para alto (el ancho es análogo):
[ H_{out} = + 1 ]
donde H es el alto de entrada, K el tamaño del kernel, P el padding por lado y S el stride.
En Keras: - padding="valid" equivale a P = 0 (sin borde extra). - padding="same" elige P para que, con stride=1, la salida conserve alto y ancho de la entrada.
Estas decisiones no son meramente técnicas: alteran cuánta información espacial llega a las capas siguientes, el costo computacional y la resolución de los feature maps.
Intuición conceptual
Stride alto equivale a muestrear la imagen con menor densidad. Padding, en cambio, evita que las zonas cercanas al borde queden sistemáticamente subrepresentadas.
Idea clave
Stride y padding definen el equilibrio entre eficiencia computacional y conservación de detalle espacial.
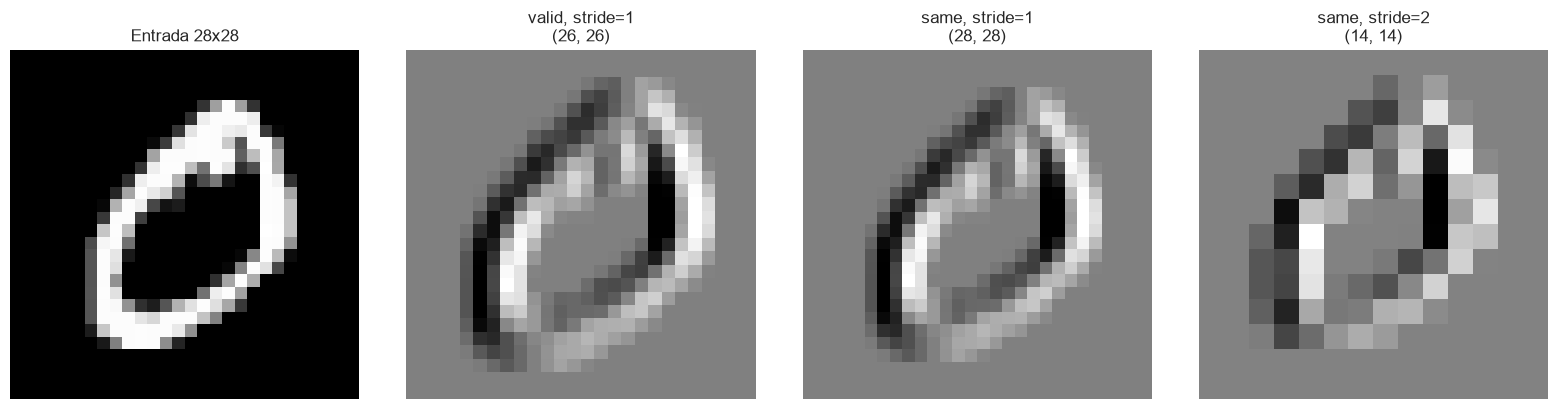
Los tamaños impresos deben coincidir con la fórmula. Si no coinciden, hay que revisar P (en same con kernel 3 × 3, Keras usa P = 1).
Cambiar padding y stride altera la cantidad y la resolución de la información que atraviesa la red:
valid reduce el mapa (aquí, 28 → 26): se pierde un marco de borde.
same con stride 1 conserva 28 × 28: útil cuando se quiere mantener resolución.
stride 2 reduce a la mitad (28 → 14): menos costo, menos detalle fino.
No es un ajuste menor: modifica la resolución de las representaciones internas y el costo de las capas siguientes.
Idea clave
Stride y padding determinan cuánto detalle espacial conserva la red antes de clasificar.
Reto técnico
Probar kernel_size=5, stride=1 y comparar con kernel_size=3, stride=2. Predice H_out con la fórmula antes de ejecutar.
7. Mapas de activación y jerarquía espacial
Un feature map es la salida de un filtro aplicado sobre la entrada (o sobre una activación previa). Cada mapa indica dónde y con qué intensidad aparece el patrón al que responde ese kernel.
Una capa Conv2D(filters=32, ...) no aplica «un» filtro 32 veces: aprende 32 kernels distintos. Cada kernel produce un feature map. La salida es un tensor
alto × ancho × canales
donde canales = número de filtros.
En una CNN, las primeras capas suelen capturar regularidades locales relativamente simples. Al apilar capas, esas respuestas se combinan y dan lugar a representaciones más abstractas. Esta es la jerarquía espacial de características: de lo local y elemental hacia lo estructural.
Esa descripción es conceptual y general. No implica que cada filtro tenga una interpretación humana simple («este canal detecta mangas»). Un canal puede responder con intensidad en ciertas regiones sin que podamos nombrarlo con precisión.
Intuición conceptual
Una capa temprana puede responder a transiciones locales; una capa posterior combina esas respuestas. La red compone patrones gradualmente.
Idea clave
Los feature maps son evidencia observable de cómo la red transforma píxeles en características. El kernel es el detector; el mapa es la respuesta.
# Visualizacion de feature maps con una capa convolucional simplesample_img = x_train_mnist[2].astype("float32") /255.0sample_img_4d = sample_img[np.newaxis, ..., np.newaxis]n_filtros =4conv_demo = models.Sequential([ layers.Input(shape=(28, 28, 1)), layers.Conv2D(n_filtros, (3, 3), activation="relu", padding="same")])feature_maps = conv_demo.predict(sample_img_4d, verbose=0)[0]print("Entrada:", sample_img_4d.shape, " -> (batch, alto, ancho, canales)")print("Salida Conv2D(filters=%d):"% n_filtros, feature_maps.shape)print("Hay %d kernels y, por tanto, %d feature maps."% (n_filtros, feature_maps.shape[-1]))print("Parametros de esta capa:", conv_demo.count_params()," (calculo: (3*3*1 + 1) * %d = %d)"% (n_filtros, (3*3*1+1) * n_filtros))print("Estos kernels son aleatorios: aun no hay aprendizaje. Solo ilustran la geometria.")fig, axes = plt.subplots(1, 5, figsize=(16, 3))axes[0].imshow(sample_img, cmap="gray")axes[0].set_title("Entrada")axes[0].axis("off")for i inrange(n_filtros): axes[i +1].imshow(feature_maps[:, :, i], cmap="viridis") axes[i +1].set_title(f"Mapa {i +1}") axes[i +1].axis("off")plt.tight_layout()plt.show()
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
Entrada: (1, 28, 28, 1)   ->  (batch, alto, ancho, canales)
Salida Conv2D(filters=4): (28, 28, 4)
Hay 4 kernels y, por tanto, 4 feature maps.
Parametros de esta capa: 40   (calculo: (3*3*1 + 1) * 4 = 40)
Estos kernels son aleatorios: aun no hay aprendizaje. Solo ilustran la geometria.
Interpretación
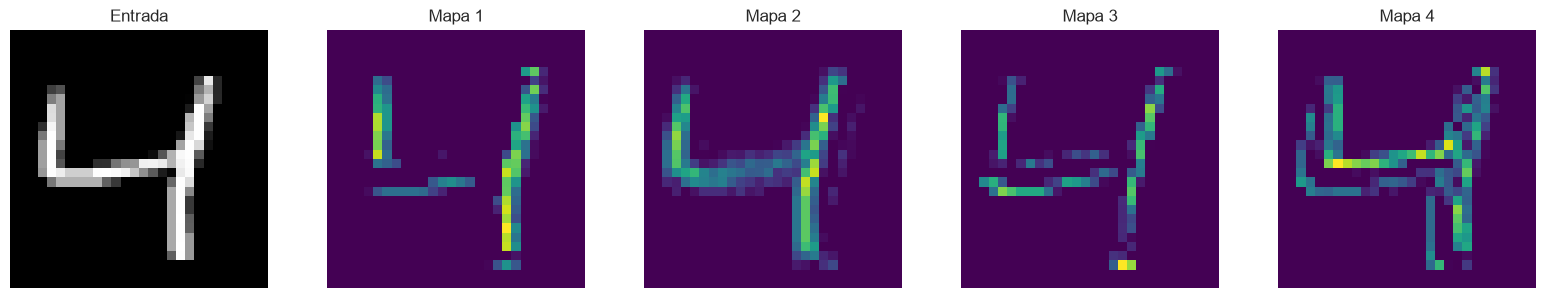
Los feature maps muestran que una sola capa puede generar múltiples representaciones de la misma imagen. Cada canal es la respuesta de un kernel distinto.
Como los pesos aún son aleatorios, no debemos afirmar «este filtro detecta bordes» o «este filtro detecta un dígito». Lo observable es más modesto: unos canales responden con mayor intensidad en ciertas regiones; otros pueden quedar casi inactivos tras ReLU.
El aprendizaje esperado es comprender que la potencia de una CNN surge de combinar detectores en paralelo (filters) y apilarlos en profundidad (jerarquía).
Idea clave
Un feature map es evidencia espacial de la respuesta de un kernel. Interpretar qué detecta exige prudencia, sobre todo antes de entrenar.
Reto técnico
Seleccionar dos mapas con patrones visualmente distintos. Describe dónde se activan, no qué objeto crees que detectan.
8. Pooling
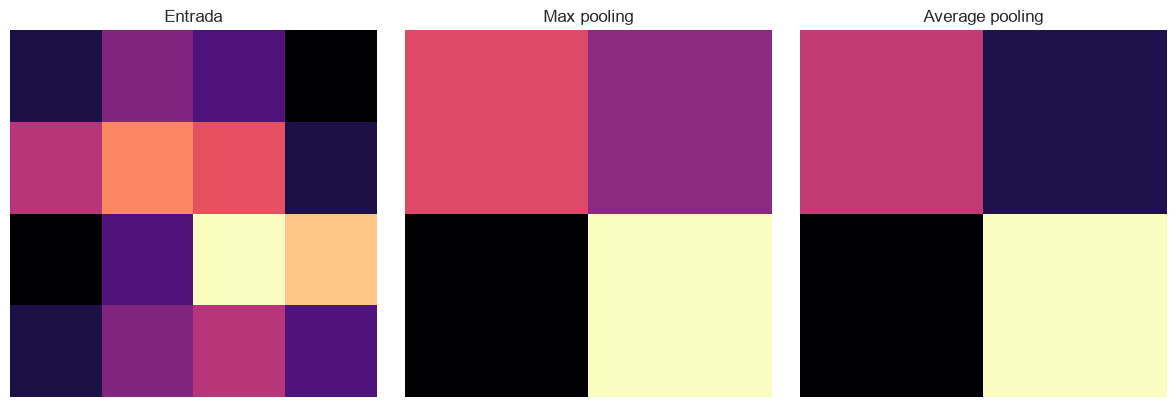
Pooling es una operación de resumen espacial aplicada sobre feature maps. No aprende nuevos patrones: comprime los ya detectados.
Max pooling conserva la activación más fuerte de cada ventana.
Average pooling conserva el promedio de la ventana.
¿Para qué sirve? - Reducir dimensionalidad y costo computacional. - Conservar respuestas relevantes (sobre todo con max). - Introducir cierta tolerancia a pequeñas variaciones de posición. - Controlar la cantidad de información que avanza a capas profundas.
Qué se conserva y qué se pierde: - Se conserva información de presencia de rasgos fuertes (por ejemplo, si hubo una activación alta en una región). - Se pierde resolución espacial: la localización dentro de cada ventana se vuelve más gruesa.
Precisión conceptual. Pooling no hace al modelo completamente invariante a traslaciones. Aporta una tolerancia local limitada. Un desplazamiento grande sigue pudiendo cambiar la representación y, con ella, la predicción.
Intuición conceptual
Si un patrón importante aparece ligeramente desplazado, max pooling puede mantener su señal dominante. Eso no equivale a «la red ya no depende de la posición».
Idea clave
Pooling resume, reduce costo y suaviza variaciones pequeñas. No extrae nuevos patrones y no otorga invariancia total.
El experimento muestra dos estrategias de resumen distintas sobre el mismo mapa de activación: max conserva la evidencia dominante y average conserva tendencia media.
Esto impacta directamente en la representación que recibe la red: una más selectiva y otra más suavizada.
El aprendizaje esperado es comprender que el tipo de pooling afecta qué señales sobreviven al flujo hacia capas profundas.
La conexión con arquitectura es crítica: una compresión excesiva en etapas tempranas puede eliminar detalles relevantes para la clasificación.
¿Qué estamos perdiendo?
Precisión espacial fina dentro de cada ventana.
Información exacta de distribución local de activaciones.
¿Qué estamos ganando?
Reducción de dimensionalidad y costo computacional.
Mayor robustez ante desplazamientos pequeños o ruido local.
Menor sensibilidad a variaciones irrelevantes de posición.
Idea clave
Pooling define un compromiso entre detalle espacial y robustez representacional.
Reto técnico
Construir un caso de entrada donde max y average den decisiones cualitativamente distintas sobre qué región parece más importante y justificar por qué ocurre.
Nota. «Mayor robustez ante desplazamientos pequeños» no significa invariancia completa. El pooling opera sobre ventanas locales; un cambio grande de posición sigue siendo un cambio de representación.
9. Arquitectura básica conv-pool-flatten-dense
Una CNN de clasificación suele organizarse en dos bloques funcionales:
Extracción de características (Conv + activación + Pool): transforma la imagen en mapas que capturan patrones relevantes.
Decisión de clase (Flatten + Dense): convierte esa representación en probabilidades por clase.
Flujo conceptual: - La convolución detecta patrones locales (kernels aprendibles). - La activación introduce no linealidad. - El pooling compacta la representación y reduce resolución. - Flatten linealiza los mapas después de la extracción espacial. - La salida softmax expresa la probabilidad estimada por clase.
Dense concentra la mayoría de los parámetros: aquí suele estar el bloque más costoso en una CNN pequeña.
Si el cálculo manual no coincide con Param #, revisa canales de entrada, bias y número de filtros antes de dudar de Keras.
Idea clave
Conv y Pool construyen evidencia; Flatten y Dense convierten esa evidencia en decisión. Saber de dónde sale cada número de summary() es parte de saber diseñar.
Reto técnico
Si cambias a Conv2D(16, (5, 5), padding="valid"), predice shape de salida y parámetros antes de modificar el modelo.
10. CNN vs MLP (experimento central)
Esta sección formaliza la pregunta de la sesión con un experimento comparable.
MLP en imágenes
28×28 → Flatten → 784 → Dense → Dense → 10 clases
Conserva los valores, pero no la vecindad explícita.
Cada neurona densa se conecta a todas las entradas (784 × N parámetros en la primera capa).
No incorpora, por arquitectura, localidad ni compartición de pesos.
CNN en imágenes
28×28×1 → Conv → ReLU → Pool → Conv → ReLU → Pool → Flatten → Dense → 10 clases
Opera sobre vecindades locales.
Reutiliza el mismo kernel en todas las posiciones (weight sharing).
Construye una jerarquía de representaciones antes de aplanar.
Estas diferencias son sesgos inductivos: supuestos que la arquitectura impone antes de ver los datos. No garantizan, por sí solos, que la CNN gane siempre.
Diseño experimental (comparación razonable)
Se entrenan modelo_mlp y modelo_cnn con:
el mismo Fashion-MNIST;
el mismo preprocessing (normalización a [0, 1] y canal explícito);
los mismos conjuntos Train / Validation / Test;
las mismas clases;
el mismo optimizador, pérdida, batch y número máximo de épocas;
la misma semilla.
La variable que se quiere observar es, principalmente, la arquitectura.
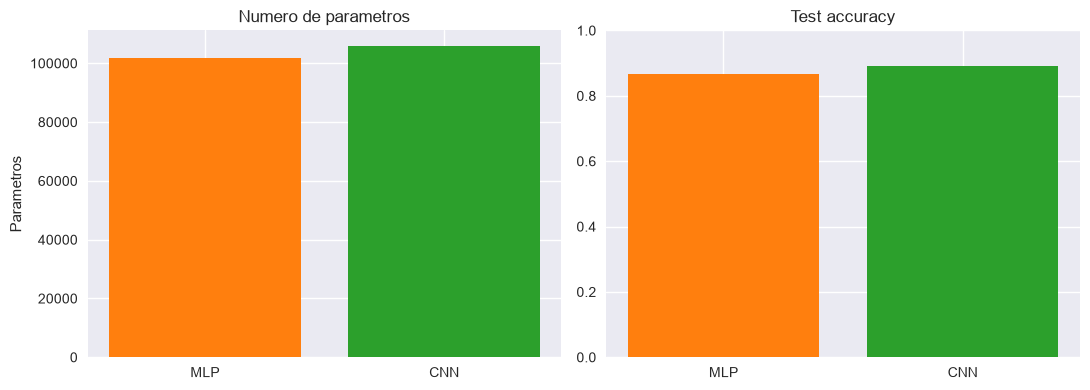
No se afirma de antemano que la CNN tenga menos parámetros ni mejor accuracy. Eso se mide.
Idea clave
CNN no es «una MLP con más capas». Cambia cómo el modelo usa la estructura espacial.
Los números de la celda anterior salen de count_params(), fit(), evaluate() y el cronómetro. No hay cifras escritas a mano.
Responde con evidencia de este experimento:
¿Cuál modelo obtiene mayor Train Accuracy?
¿Cuál obtiene mayor Validation Accuracy?
¿Cuál obtiene mayor Test Accuracy?
¿Cuál presenta mayor generalization gap (train − val)?
¿Cuál utiliza más parámetros?
¿Cuál tarda más?
¿El modelo con mayor Train Accuracy es necesariamente el mejor?
¿La CNN ofrece evidencia de mejor generalización en este experimento?
¿El incremento de costo computacional (si lo hay) está acompañado de una mejora útil?
¿Qué evidencia adicional necesitarías antes de afirmar que una arquitectura es superior?
Recuerda: una métrica no es una conclusión. Un modelo puede ser más preciso y mucho más caro; otro puede tener menos parámetros y peor test; otro puede lucir bien en train y fallar en val.
La siguiente celda construye la interpretación a partir de df_mlp_cnn. No adelantes un ganador genérico («las CNN siempre son mejores»).
# Interpretacion dinamica de df_mlp_cnn (RESULTADO -> DECISION)assert"df_mlp_cnn"inglobals(), "Ejecuta antes la celda del experimento MLP vs CNN."fila_mlp = df_mlp_cnn.set_index("Modelo").loc["MLP"]fila_cnn = df_mlp_cnn.set_index("Modelo").loc["CNN"]def mejor(col, mayor=True): a, b = fila_mlp[col], fila_cnn[col]if np.isclose(a, b):return"empate practico"if mayor:return"MLP"if a > b else"CNN"return"MLP"if a < b else"CNN"print("RESULTADO (medido)")print(df_mlp_cnn[["Modelo", "Parametros", "Train_acc", "Val_acc", "Test_acc","Gap", "Tiempo_s", "Train_loss", "Val_loss", "Test_loss"]] .to_string(index=False, float_format=lambda v: f"{v:.4f}"))print("\nOBSERVACION")print(f"- Mayor Train Acc: {mejor('Train_acc')}")print(f"- Mayor Val Acc: {mejor('Val_acc')}")print(f"- Mayor Test Acc: {mejor('Test_acc')}")print(f"- Mayor gap: {mejor('Gap')}")print(f"- Mas parametros: {mejor('Parametros')}")print(f"- Mas tiempo: {mejor('Tiempo_s')}")print("\nCOMPARACION")d_test = fila_cnn["Test_acc"] - fila_mlp["Test_acc"]d_gap = fila_cnn["Gap"] - fila_mlp["Gap"]d_par = fila_cnn["Parametros"] - fila_mlp["Parametros"]d_t = fila_cnn["Tiempo_s"] - fila_mlp["Tiempo_s"]print(f"Diferencia Test Acc (CNN - MLP): {d_test:+.4f}")print(f"Diferencia Gap (CNN - MLP): {d_gap:+.4f}")print(f"Diferencia params (CNN - MLP): {d_par:+,.0f}")print(f"Diferencia tiempo (CNN - MLP): {d_t:+.2f} s")print("\nINFERENCIA")if fila_cnn["Test_acc"] > fila_mlp["Test_acc"] and fila_cnn["Gap"] <= fila_mlp["Gap"]:print("En este experimento, la CNN obtiene mejor test y un gap no peor.")print("Hay evidencia de que la arquitectura convolucional aprovecha mejor")print("la estructura espacial de estas imagenes, no solo de que 'aprende mas train'.")elif fila_cnn["Test_acc"] > fila_mlp["Test_acc"] and fila_cnn["Gap"] > fila_mlp["Gap"]:print("En este experimento, la CNN mejora test pero con mayor gap.")print("La mejora no se lee automaticamente como mejor generalizacion.")elif fila_mlp["Test_acc"] > fila_cnn["Test_acc"]:print("En este experimento, la MLP obtiene mayor test accuracy.")print("Eso no refuta las CNN en general; cuestiona *esta* comparacion")print("(capacidad, epocas, inicializacion).")else:print("Las diferencias de test son nulas o minimas. La arquitectura no")print("quedo separada con claridad bajo este presupuesto experimental.")if fila_cnn["Train_acc"] > fila_mlp["Train_acc"] and fila_cnn["Test_acc"] < fila_mlp["Test_acc"]:print("Ademas: mayor train no coincidio con mayor test. El modelo que mas")print("ajusta no es, por ese hecho, el mejor.")print("\nLIMITACION")print("Una semilla, un dataset, un numero de epocas y dos arquitecturas concretas.")print("No se concluye que 'las CNN siempre son mejores que las MLP'.")print("\nDECISION")if fila_cnn["Test_acc"] >= fila_mlp["Test_acc"]:print("Con esta evidencia, se adopta la CNN como arquitectura base para")print("el resto del notebook (evaluacion por clase y activaciones).")else:print("La evidencia no favorece de forma clara a la CNN. Aun asi se usa")print("modelo_cnn en las secciones siguientes porque el objetivo es")print("aprender a leer convoluciones, no coronar un ganador.")
RESULTADO (medido)
Modelo  Parametros  Train_acc  Val_acc  Test_acc    Gap  Tiempo_s  Train_loss  Val_loss  Test_loss
   MLP      101770     0.8911   0.8829    0.8653 0.0082    4.2400      0.3060    0.3308     0.3709
   CNN      105866     0.9085   0.9041    0.8926 0.0044   11.8500      0.2530    0.2695     0.2969

OBSERVACION
- Mayor Train Acc: CNN
- Mayor Val Acc:   CNN
- Mayor Test Acc:  CNN
- Mayor gap:       MLP
- Mas parametros:  CNN
- Mas tiempo:      CNN

COMPARACION
Diferencia Test Acc (CNN - MLP): +0.0273
Diferencia Gap     (CNN - MLP): -0.0039
Diferencia params  (CNN - MLP): +4,096
Diferencia tiempo  (CNN - MLP): +7.61 s

INFERENCIA
En este experimento, la CNN obtiene mejor test y un gap no peor.
Hay evidencia de que la arquitectura convolucional aprovecha mejor
la estructura espacial de estas imagenes, no solo de que 'aprende mas train'.

LIMITACION
Una semilla, un dataset, un numero de epocas y dos arquitecturas concretas.
No se concluye que 'las CNN siempre son mejores que las MLP'.

DECISION
Con esta evidencia, se adopta la CNN como arquitectura base para
el resto del notebook (evaluacion por clase y activaciones).
11. Lectura de la CNN ya construida
La CNN del experimento (modelo_cnn) ya está entrenada con el mismo pipeline que la MLP. No se vuelve a entrenar: se lee.
Dónde aparece Flatten (después de la extracción espacial, no al inicio).
Qué fracción de parámetros vive en la cabeza densa.
Idea clave
Una CNN didáctica bien construida conecta preparación, arquitectura y evaluación en un único flujo reproducible. El summary() se interpreta; no se deja como adorno.
# Verificacion de datos y lectura de modelo_cnn (sin reentrenar)print("Conjuntos (los mismos del experimento MLP vs CNN):")print("Train:", x_train.shape, y_train.shape)print("Val: ", x_val.shape, y_val.shape)print("Test: ", x_test.shape, y_test.shape)print("Rango de pixeles train: [%.3f, %.3f]"% (x_train.min(), x_train.max()))print("\n--- model.summary() de la CNN del experimento ---")modelo_cnn.summary()filas_capas = []for layer in modelo_cnn.layers: n_filt =getattr(layer, "filters", None) n_units =getattr(layer, "units", None) filas_capas.append({"Capa": layer.__class__.__name__,"Nombre": layer.name,"Shape_salida": str(getattr(layer, "output_shape", None) ortuple(getattr(layer.output, "shape", ()))) ,"Filtros_o_unidades": n_filt if n_filt isnotNoneelse n_units,"Parametros": int(layer.count_params()), })df_capas_cnn = pd.DataFrame(filas_capas)print("\nCapa | shape de salida | filtros/unidades | parametros")print(df_capas_cnn.to_string(index=False))# Calculo manual de una Conv2D y de una Dense (para contrastar con Param #)conv1 =next(l for l in modelo_cnn.layers ifisinstance(l, layers.Conv2D))dense_hid = [l for l in modelo_cnn.layers ifisinstance(l, layers.Dense)][0]p_conv1_manual = (3*3*1+1) *16print("\nConv2D 16 filtros 3x3, 1 canal, bias:")print(" manual (3*3*1 + 1)*16 =", p_conv1_manual)print(" summary / count_params =", int(conv1.count_params()))# Tras dos poolings 2x2 sobre 28x28 same: 7x7x32 = 1568p_dense_manual =7*7*32*64+64print("Dense 64 sobre 7x7x32:")print(" manual 1568*64 + 64 =", p_dense_manual)print(" summary / count_params =", int(dense_hid.count_params()))
Conjuntos (los mismos del experimento MLP vs CNN):
Train: (51000, 28, 28, 1) (51000,)
Val:   (9000, 28, 28, 1) (9000,)
Test:  (10000, 28, 28, 1) (10000,)
Rango de pixeles train: [0.000, 1.000]

--- model.summary() de la CNN del experimento ---
El reporte de capas convierte la arquitectura en geometría visible:
Primera Conv2D: 28 × 28 × 1 → 28 × 28 × 16. Suben canales; se mantiene resolución (same).
Primer pooling: 28 × 28 → 14 × 14. Bajan alto y ancho; 0 parámetros.
Segunda Conv2D: 14 × 14 × 16 → 14 × 14 × 32. Otra vez más canales, misma resolución espacial.
Segundo pooling: 14 × 14 → 7 × 7.
Flatten transforma la representación espacial 7 × 7 × 32 en un vector de 1568 valores. Los valores se conservan, pero la organización espacial deja de estar representada explícitamente para las capas densas posteriores. A partir de este punto, la arquitectura ya no aplica operaciones locales sobre regiones vecinas ni compartición espacial de pesos, como sí lo hacen las capas convolucionales.
Dense: concentra una fracción grande de los parámetros. En CNN pequeñas, la cabeza densa suele ser más cara que las convoluciones.
Si el cálculo manual coincidió con Param #, ya puedes explicar de dónde salen esos números. Si no coincidió, el error está en canales de entrada, bias o el shape que llega a Dense.
Idea clave
Saber leer summary() es saber argumentar una arquitectura, no solo ejecutarla.
Reto técnico
¿Qué pasaría con el shape y con los parámetros si eliminaras el segundo pooling? Predice antes de experimentar.
12. Curvas de entrenamiento (MLP y CNN)
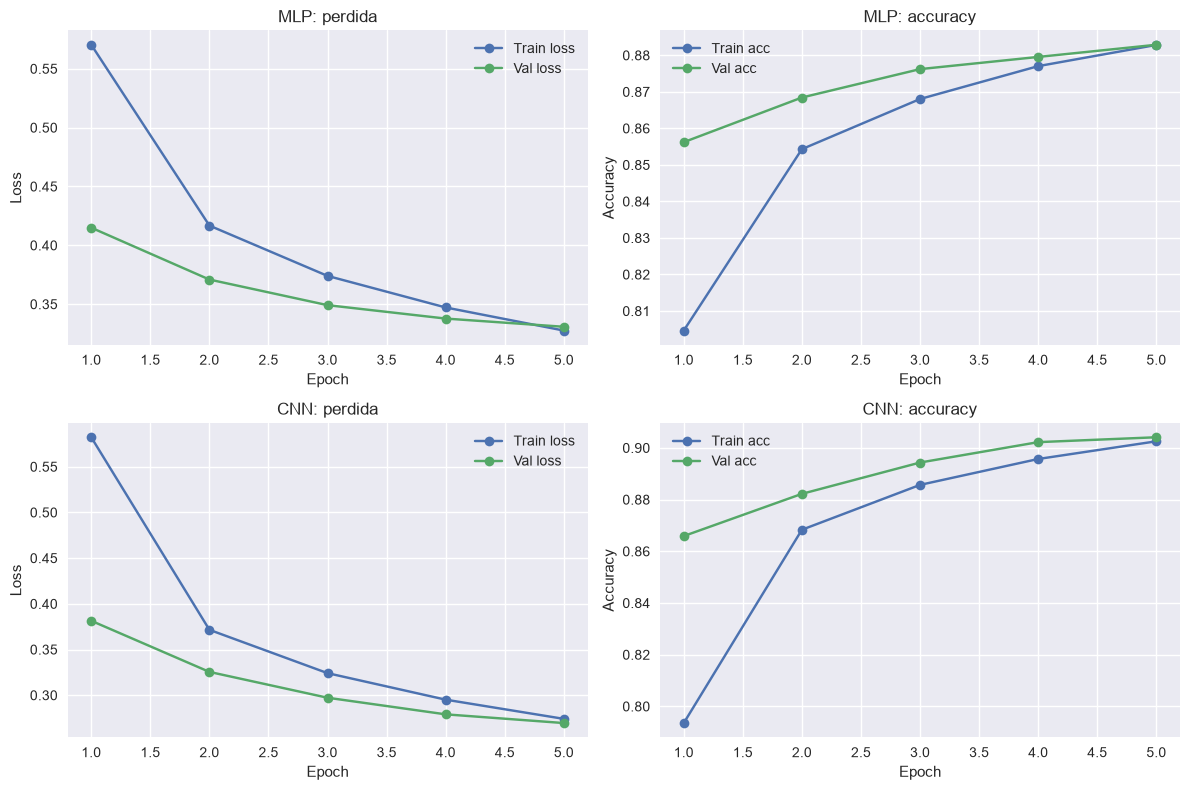
El entrenamiento no se evalúa solo al final. Las curvas permiten observar convergencia, velocidad, estabilidad y gap.
Se grafican, para ambos modelos:
train loss y validation loss;
train accuracy y validation accuracy.
Se aplican (sin volver a desarrollar) las ideas de la sesión de generalización:
underfitting: train y val bajos, poco aprendizaje;
overfitting: train mejora y val se estanca o empeora (gap creciente);
ajuste razonable: ambas curvas mejoran y el gap se mantiene moderado.
Una buena métrica final con mala dinámica puede ocultar problemas. El gap se interpreta junto con el nivel absoluto de accuracy, no aislado.
Última época ≠ mejor época observada en validación. Que el modelo siga mejorando en TRAIN no implica que siga mejorando su capacidad de generalizar. Un gap pequeño tampoco selecciona, por sí solo, al mejor modelo.
Idea clave
Interpretar curvas es parte de comparar arquitecturas: no basta la última fila de la tabla.
# Curvas de MLP y CNN a partir de history (sin numeros inventados)def plot_dos_historiales(h_mlp, h_cnn): fig, axes = plt.subplots(2, 2, figsize=(12, 8)) pares = [ (h_mlp, "MLP", axes[0, 0], axes[0, 1]), (h_cnn, "CNN", axes[1, 0], axes[1, 1]), ]for hist, titulo, ax_l, ax_a in pares: ep =range(1, len(hist.history["loss"]) +1) ax_l.plot(ep, hist.history["loss"], marker="o", label="Train loss") ax_l.plot(ep, hist.history["val_loss"], marker="o", label="Val loss") ax_l.set_title(f"{titulo}: perdida") ax_l.set_xlabel("Epoch") ax_l.set_ylabel("Loss") ax_l.legend() ax_a.plot(ep, hist.history["accuracy"], marker="o", label="Train acc") ax_a.plot(ep, hist.history["val_accuracy"], marker="o", label="Val acc") ax_a.set_title(f"{titulo}: accuracy") ax_a.set_xlabel("Epoch") ax_a.set_ylabel("Accuracy") ax_a.legend() plt.tight_layout() plt.show()plot_dos_historiales(history_mlp, history_cnn)def resumir_curvas(hist, nombre):"""Compara la mejor epoca segun val_loss con la ultima epoca. Indices 0-based; reporte en 1-based.""" h = hist.history tr_acc = h["accuracy"] va_acc = h["val_accuracy"] tr_loss = h["loss"] va_loss = h["val_loss"] n =len(va_loss) i_best =int(np.argmin(va_loss)) i_last = n -1def paquete(i):return {"epoca": i +1,"train_loss": float(tr_loss[i]),"val_loss": float(va_loss[i]),"train_acc": float(tr_acc[i]),"val_acc": float(va_acc[i]),"gap": float(tr_acc[i] - va_acc[i]), } mejor = paquete(i_best) ultima = paquete(i_last)print(f"\nMODELO: {nombre}")print(f"Epocas ejecutadas: {n}")print(f"Mejor epoca segun validation loss: {mejor['epoca']}")print("Ultima epoca:", ultima["epoca"])print("Recordatorio: ultima epoca != mejor epoca observada en validacion.")print("\nEn la mejor epoca:")print(f" Train Loss: {mejor['train_loss']:.4f}")print(f" Validation Loss: {mejor['val_loss']:.4f}")print(f" Train Accuracy: {mejor['train_acc']:.4f}")print(f" Validation Accuracy: {mejor['val_acc']:.4f}")print(f" Generalization Gap: {mejor['gap']:+.4f}")print("\nEn la ultima epoca:")print(f" Train Loss: {ultima['train_loss']:.4f}")print(f" Validation Loss: {ultima['val_loss']:.4f}")print(f" Train Accuracy: {ultima['train_acc']:.4f}")print(f" Validation Accuracy: {ultima['val_acc']:.4f}")print(f" Generalization Gap: {ultima['gap']:+.4f}") mejoro_train = ultima["train_loss"] < mejor["train_loss"] subio_val = ultima["val_loss"] > mejor["val_loss"] bajo_val = ultima["val_loss"] < mejor["val_loss"] poco_avance = (tr_acc[-1] <= tr_acc[0]) and (va_acc[-1] <= va_acc[0])print("\nInterpretacion")if poco_avance:print(" Los resultados sugieren que no hay evidencia suficiente para atribuir")print(" el problema unicamente a sobreajuste; podria existir falta de capacidad,")print(" optimizacion insuficiente u otras causas.")elif i_best < i_last and mejoro_train and subio_val:print(" Despues de la mejor epoca de validacion, el modelo continuo mejorando")print(" su ajuste sobre entrenamiento, pero esa mejora dejo de trasladarse al")print(" conjunto de validacion. Este comportamiento es compatible con evidencia")print(" de sobreajuste posterior.")elif (bajo_val or i_best == i_last) and (ultima["val_acc"] >= mejor["val_acc"] ornot subio_val):print(" Entrenamiento y validacion continuan mostrando una evolucion coherente,")print(" por lo que no existe evidencia clara de divergencia en este intervalo.")else:print(" Los resultados sugieren un comportamiento mixto entre la mejor epoca")print(" y la ultima: conviene leer juntas val_loss, val_acc y el gap, no una")print(" sola de esas senales.")return {"nombre": nombre, "n": n, "mejor": mejor, "ultima": ultima, "i_best": i_best}def interpretar_curvas_comparadas(rep_mlp, rep_cnn):print("\n"+"="*60)print("COMPARACION DE CURVAS: MLP vs CNN")print("="*60)print("Preguntas (responde con los numeros del reporte, no de memoria):")print("1. Cual modelo alcanza antes su mejor val_loss?")print("2. Cual mantiene mejor coherencia entre entrenamiento y validacion?")print("3. Cual presenta menor gap en su mejor epoca?")print("4. La ultima epoca representa realmente el mejor estado de cada modelo?")print("5. Alguno muestra evidencia de continuar aprendiendo el entrenamiento")print(" sin mejorar validacion?")print("Un gap pequeno no implica, por si solo, que el modelo sea el mejor.")print("\nRESULTADO")for r in (rep_mlp, rep_cnn):print(f"- {r['nombre']}: mejor epoca {r['mejor']['epoca']}/{r['n']} "f"(val_loss={r['mejor']['val_loss']:.4f}, val_acc={r['mejor']['val_acc']:.4f}, "f"gap={r['mejor']['gap']:+.4f}); "f"ultima epoca {r['ultima']['epoca']} "f"(val_loss={r['ultima']['val_loss']:.4f}, val_acc={r['ultima']['val_acc']:.4f}, "f"gap={r['ultima']['gap']:+.4f})" )print("\nOBSERVACION")if rep_mlp["mejor"]["epoca"] < rep_cnn["mejor"]["epoca"]:print("- El mejor val_loss de la MLP ocurre antes que el de la CNN.")elif rep_cnn["mejor"]["epoca"] < rep_mlp["mejor"]["epoca"]:print("- El mejor val_loss de la CNN ocurre antes que el de la MLP.")else:print("- Ambos modelos alcanzan su mejor val_loss en la misma epoca.")for r in (rep_mlp, rep_cnn):if r["mejor"]["epoca"] == r["ultima"]["epoca"]:print(f"- En {r['nombre']}, la ultima epoca coincide con la mejor segun val_loss.")else:print(f"- En {r['nombre']}, la ultima epoca ({r['ultima']['epoca']}) "f"no es la mejor observada ({r['mejor']['epoca']})." )print("\nCOMPARACION")ifabs(rep_mlp["mejor"]["gap"] - rep_cnn["mejor"]["gap"]) <1e-6:print("- El gap en la mejor epoca es practicamente el mismo.")elif rep_cnn["mejor"]["gap"] < rep_mlp["mejor"]["gap"]:print("- La CNN presenta menor gap en su mejor epoca.")else:print("- La MLP presenta menor gap en su mejor epoca.")print("- Ese gap debe leerse junto a val_acc, val_loss, test, parametros y tiempo.")if"df_mlp_cnn"inglobals():print("- La tabla df_mlp_cnn aporta test y costo; no se elige un modelo solo por el gap.")print("\nINFERENCIA")print("Que un modelo continue mejorando sobre TRAIN no significa que continue")print("mejorando su capacidad de generalizacion. En este experimento, la evidencia")print("de las curvas se combina con df_mlp_cnn; no se declara un ganador por una metrica.")print("\nLIMITACION")print("Una semilla, un presupuesto de epocas y dos arquitecturas concretas.")print("La mejor epoca segun val_loss no se usa aqui para detener el entrenamiento;")print("solo para analizar si la ultima epoca era el mejor estado observado.")print("\nDECISION")print("Para el resto del notebook se sigue usando el modelo ya entrenado (ultima epoca),")print("conscientes de que ese estado puede no coincidir con el de menor val_loss.")rep_mlp = resumir_curvas(history_mlp, "MLP")rep_cnn = resumir_curvas(history_cnn, "CNN")interpretar_curvas_comparadas(rep_mlp, rep_cnn)
MODELO: MLP
Epocas ejecutadas: 5
Mejor epoca segun validation loss: 5
Ultima epoca: 5
Recordatorio: ultima epoca != mejor epoca observada en validacion.

En la mejor epoca:
  Train Loss: 0.3276
  Validation Loss: 0.3308
  Train Accuracy: 0.8828
  Validation Accuracy: 0.8829
  Generalization Gap: -0.0000

En la ultima epoca:
  Train Loss: 0.3276
  Validation Loss: 0.3308
  Train Accuracy: 0.8828
  Validation Accuracy: 0.8829
  Generalization Gap: -0.0000

Interpretacion
  Entrenamiento y validacion continuan mostrando una evolucion coherente,
  por lo que no existe evidencia clara de divergencia en este intervalo.

MODELO: CNN
Epocas ejecutadas: 5
Mejor epoca segun validation loss: 5
Ultima epoca: 5
Recordatorio: ultima epoca != mejor epoca observada en validacion.

En la mejor epoca:
  Train Loss: 0.2741
  Validation Loss: 0.2695
  Train Accuracy: 0.9025
  Validation Accuracy: 0.9041
  Generalization Gap: -0.0016

En la ultima epoca:
  Train Loss: 0.2741
  Validation Loss: 0.2695
  Train Accuracy: 0.9025
  Validation Accuracy: 0.9041
  Generalization Gap: -0.0016

Interpretacion
  Entrenamiento y validacion continuan mostrando una evolucion coherente,
  por lo que no existe evidencia clara de divergencia en este intervalo.

============================================================
COMPARACION DE CURVAS: MLP vs CNN
============================================================
Preguntas (responde con los numeros del reporte, no de memoria):
1. Cual modelo alcanza antes su mejor val_loss?
2. Cual mantiene mejor coherencia entre entrenamiento y validacion?
3. Cual presenta menor gap en su mejor epoca?
4. La ultima epoca representa realmente el mejor estado de cada modelo?
5. Alguno muestra evidencia de continuar aprendiendo el entrenamiento
   sin mejorar validacion?
Un gap pequeno no implica, por si solo, que el modelo sea el mejor.

RESULTADO
- MLP: mejor epoca 5/5 (val_loss=0.3308, val_acc=0.8829, gap=-0.0000); ultima epoca 5 (val_loss=0.3308, val_acc=0.8829, gap=-0.0000)
- CNN: mejor epoca 5/5 (val_loss=0.2695, val_acc=0.9041, gap=-0.0016); ultima epoca 5 (val_loss=0.2695, val_acc=0.9041, gap=-0.0016)

OBSERVACION
- Ambos modelos alcanzan su mejor val_loss en la misma epoca.
- En MLP, la ultima epoca coincide con la mejor segun val_loss.
- En CNN, la ultima epoca coincide con la mejor segun val_loss.

COMPARACION
- La CNN presenta menor gap en su mejor epoca.
- Ese gap debe leerse junto a val_acc, val_loss, test, parametros y tiempo.
- La tabla df_mlp_cnn aporta test y costo; no se elige un modelo solo por el gap.

INFERENCIA
Que un modelo continue mejorando sobre TRAIN no significa que continue
mejorando su capacidad de generalizacion. En este experimento, la evidencia
de las curvas se combina con df_mlp_cnn; no se declara un ganador por una metrica.

LIMITACION
Una semilla, un presupuesto de epocas y dos arquitecturas concretas.
La mejor epoca segun val_loss no se usa aqui para detener el entrenamiento;
solo para analizar si la ultima epoca era el mejor estado observado.

DECISION
Para el resto del notebook se sigue usando el modelo ya entrenado (ultima epoca),
conscientes de que ese estado puede no coincidir con el de menor val_loss.
Interpretación
Compara las cuatro curvas con la tabla df_mlp_cnn y con el reporte de resumir_curvas():
¿Qué modelo desciende más rápido en loss?
¿El gap se abre, se mantiene o se cierra?
¿Hay señales de underfitting (ambas curvas bajas) o de overfitting (train alto, val estancado)?
¿La última época es la de menor val_loss en cada modelo?
Aplica el esquema:
OBSERVACIÓN → lo que muestran las curvas (nivel, velocidad, estabilidad, gap, mejor época vs última). COMPARACIÓN → MLP y CNN en su mejor época y en la última; no solo el gap. INFERENCIA → qué sugiere eso sobre generalización en este experimento. LIMITACIÓN → pocas épocas, una semilla, un dataset, dos arquitecturas concretas. DECISIÓN → no elegir un modelo solo porque tenga menor gap. Combinar val_acc, val_loss, test, parámetros, tiempo y la forma de las curvas.
No se reexplica Early Stopping ni overfitting: se reutilizan como herramientas de lectura. Un gap pequeño no implica un modelo bueno.
Idea clave
Una buena métrica final sin buena dinámica de entrenamiento puede ocultar problemas de generalización. Que TRAIN siga bajando no significa que la validación siga mejorando.
13. Evaluación de la CNN en TEST
La tabla MLP vs CNN ya incluyó test loss y test accuracy. Ahora se descompone el comportamiento de modelo_cnn por clase.
Se calcularán, todos por código:
test loss y test accuracy (otra vez, para fijar el punto de evaluación);
precision, recall y F1 (macro y por clase);
classification_report;
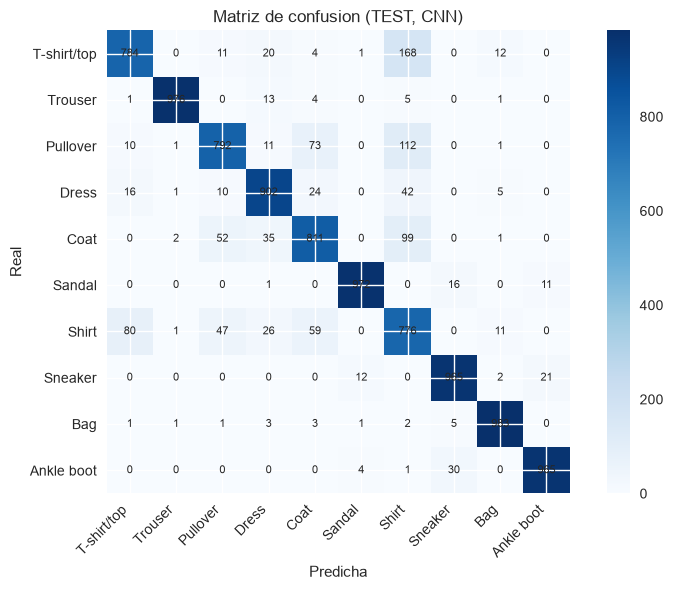
matriz de confusión;
las confusiones más frecuentes fuera de la diagonal;
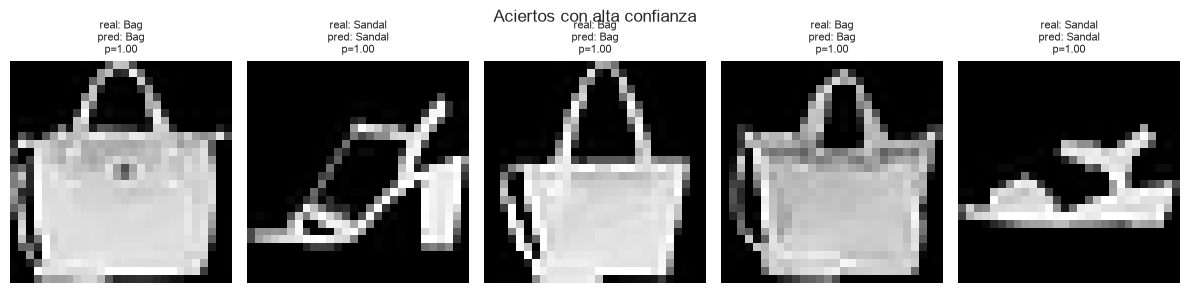
ejemplos de aciertos y errores, con la confianza del modelo (probabilidad de la clase predicha).
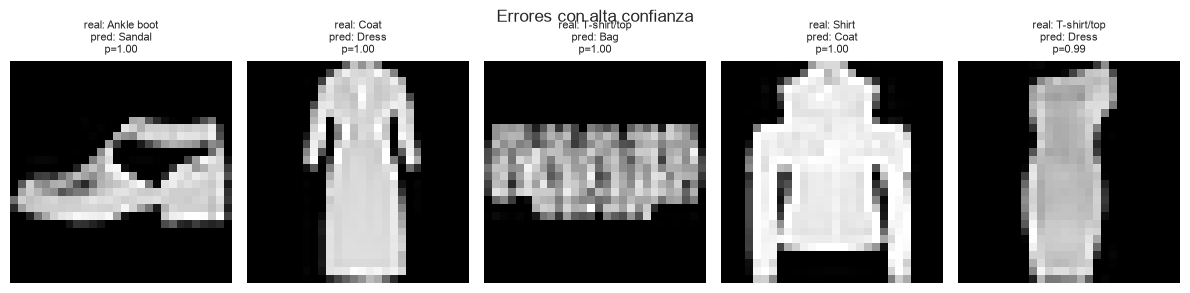
Confianza no es certeza: un modelo puede asignar 0.99 a una clase incorrecta. Eso es un error seguro, no una verdad.
Antes de la interpretación automática, observa el reporte y pregunta:
¿Qué clase tiene mejor F1? ¿Cuál el peor?
¿Hay una clase con recall alto y precision baja (o al revés)?
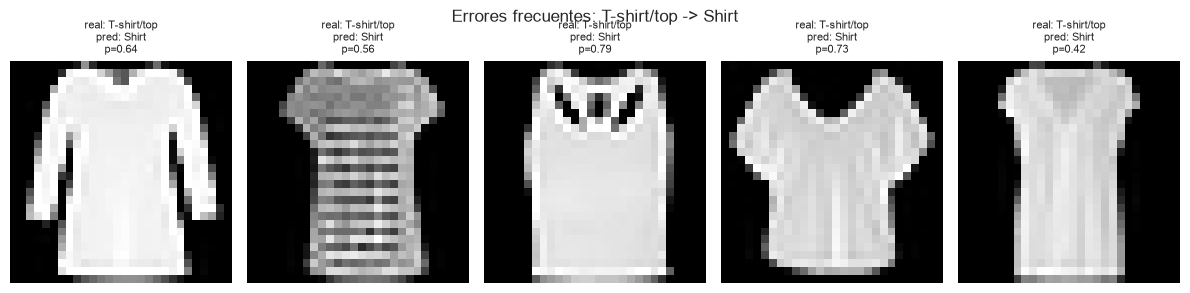
¿Las confusiones frecuentes coinciden con prendas visualmente parecidas? Formúlalo como posible explicación y contrástalo con imágenes reales.
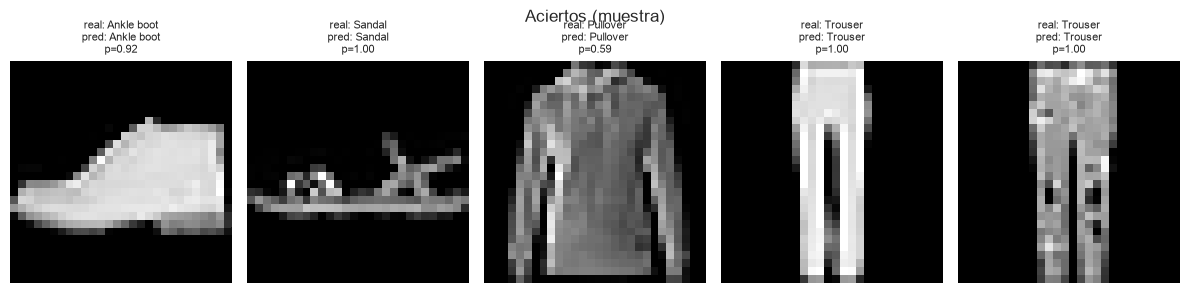
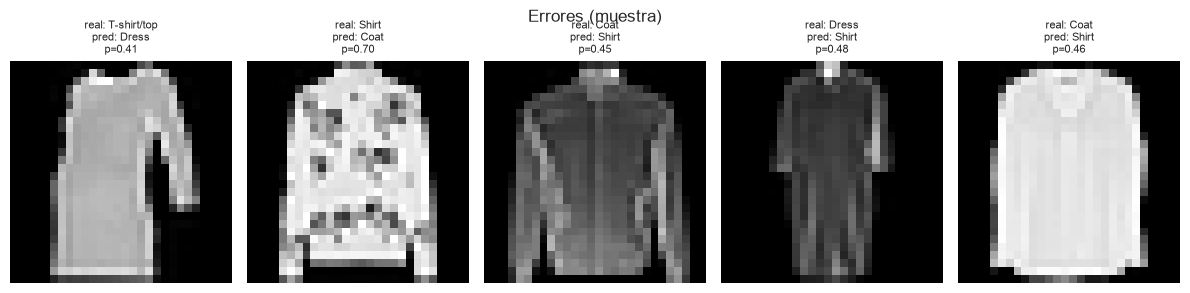
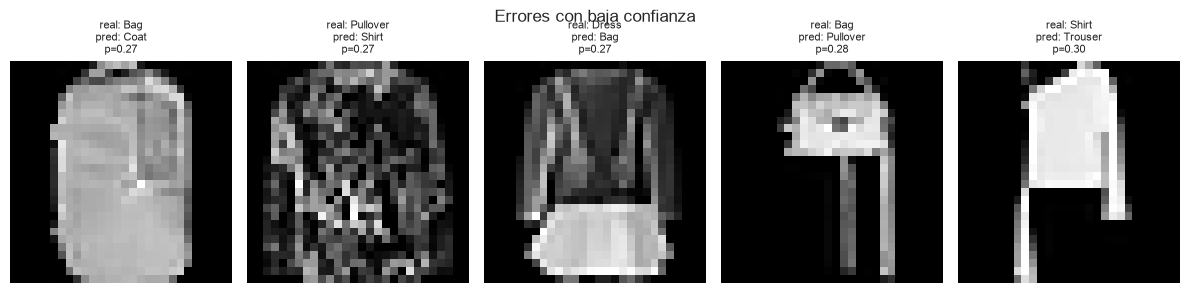
# Evaluacion TEST de la CNN: reporte, matriz, errores y ejemplostest_loss_cnn, test_acc_cnn = modelo_cnn.evaluate(x_test, y_test, verbose=0)print(f"TEST CNN loss={test_loss_cnn:.4f} accuracy={test_acc_cnn:.4f}")y_prob = modelo_cnn.predict(x_test, verbose=0)y_pred = np.argmax(y_prob, axis=1)y_conf = y_prob.max(axis=1)print("\nclassification_report:")print(classification_report(y_test, y_pred, target_names=class_names, digits=4))prec, rec, f1, supp = precision_recall_fscore_support( y_test, y_pred, labels=np.arange(len(class_names)), zero_division=0)df_clases = pd.DataFrame({"Clase": class_names,"Precision": prec,"Recall": rec,"F1": f1,"Support": supp,})print("\nMetricas por clase:")print(df_clases.to_string(index=False, float_format=lambda v: f"{v:.4f}"))i_best =int(np.argmax(f1))i_worst =int(np.argmin(f1))i_low_rec =int(np.argmin(rec))i_low_prec =int(np.argmin(prec))print("\nClase con mejor F1:", class_names[i_best], f"{f1[i_best]:.4f}")print("Clase con peor F1:", class_names[i_worst], f"{f1[i_worst]:.4f}")print("Clase con menor recall:", class_names[i_low_rec], f"{rec[i_low_rec]:.4f}")print("Clase con menor precision:", class_names[i_low_prec], f"{prec[i_low_prec]:.4f}")print("Una sola metrica no basta: combina F1, precision, recall y support.")cm = confusion_matrix(y_test, y_pred)fig, ax = plt.subplots(figsize=(8, 6))im = ax.imshow(cm, cmap="Blues")ax.set_title("Matriz de confusion (TEST, CNN)")ax.set_xlabel("Predicha")ax.set_ylabel("Real")ax.set_xticks(range(len(class_names)))ax.set_xticklabels(class_names, rotation=45, ha="right")ax.set_yticks(range(len(class_names)))ax.set_yticklabels(class_names)for i inrange(cm.shape[0]):for j inrange(cm.shape[1]): ax.text(j, i, int(cm[i, j]), ha="center", va="center", fontsize=8)fig.colorbar(im, ax=ax, fraction=0.046)plt.tight_layout()plt.show()pares = []for i inrange(cm.shape[0]):for j inrange(cm.shape[1]):if i != j and cm[i, j] >0: pares.append({"Clase_real": class_names[i],"Clase_predicha": class_names[j],"Errores": int(cm[i, j]), })df_confusiones = pd.DataFrame(pares).sort_values("Errores", ascending=False).reset_index(drop=True)print("\nConfusiones fuera de la diagonal (mayor a menor):")print(df_confusiones.head(8).to_string(index=False))# Simetria de la confusion mas frecuenteiflen(df_confusiones) >0: top = df_confusiones.iloc[0] inv = df_confusiones[ (df_confusiones["Clase_real"] == top["Clase_predicha"])& (df_confusiones["Clase_predicha"] == top["Clase_real"]) ]print("\nConfusion mas frecuente:", dict(top))iflen(inv):print("En sentido inverso:", int(inv.iloc[0]["Errores"]), "errores.")else:print("No hay errores en el sentido inverso de ese par.")def mostrar_casos(indices, titulo): n =min(5, len(indices))if n ==0:print(titulo, ": no hay ejemplos en este conjunto.")return fig, axes = plt.subplots(1, n, figsize=(2.4* n, 3))if n ==1: axes = [axes] fig.suptitle(titulo)for ax, idx inzip(axes, indices[:n]): ax.imshow(x_test[idx, :, :, 0], cmap="gray") real = class_names[int(y_test[idx])] pred = class_names[int(y_pred[idx])] ax.set_title(f"real: {real}\npred: {pred}\np={y_conf[idx]:.2f}", fontsize=8) ax.axis("off") plt.tight_layout() plt.show()ok = np.where(y_pred == y_test)[0]err = np.where(y_pred != y_test)[0]rng = np.random.default_rng(42)mostrar_casos(rng.choice(ok, size=min(5, len(ok)), replace=False) iflen(ok) else np.array([]),"Aciertos (muestra)")mostrar_casos(rng.choice(err, size=min(5, len(err)), replace=False) iflen(err) else np.array([]),"Errores (muestra)")iflen(err): mostrar_casos(err[np.argsort(y_conf[err])[::-1][:5]], "Errores con alta confianza") mostrar_casos(err[np.argsort(y_conf[err])[:5]], "Errores con baja confianza")iflen(ok): mostrar_casos(ok[np.argsort(y_conf[ok])[::-1][:5]], "Aciertos con alta confianza")# Imagenes de la confusion mas frecuente (si existe)iflen(df_confusiones): r_name, p_name = df_confusiones.iloc[0]["Clase_real"], df_confusiones.iloc[0]["Clase_predicha"] r_id, p_id = class_names.index(r_name), class_names.index(p_name) mask = (y_test == r_id) & (y_pred == p_id) idxs = np.where(mask)[0] mostrar_casos(idxs[:5], f"Errores frecuentes: {r_name} -> {p_name}")print("Una posible explicacion visual debe contrastarse con estas imagenes; no se inventa.")
TEST CNN  loss=0.2969  accuracy=0.8926

classification_report:
              precision    recall  f1-score   support

 T-shirt/top     0.8789    0.7840    0.8288      1000
     Trouser     0.9939    0.9760    0.9849      1000
    Pullover     0.8675    0.7920    0.8280      1000
       Dress     0.8922    0.9020    0.8971      1000
        Coat     0.8292    0.8110    0.8200      1000
      Sandal     0.9818    0.9720    0.9769      1000
       Shirt     0.6440    0.7760    0.7039      1000
     Sneaker     0.9498    0.9650    0.9573      1000
         Bag     0.9675    0.9830    0.9752      1000
  Ankle boot     0.9679    0.9650    0.9664      1000

    accuracy                         0.8926     10000
   macro avg     0.8973    0.8926    0.8938     10000
weighted avg     0.8973    0.8926    0.8938     10000


Metricas por clase:
      Clase  Precision  Recall     F1  Support
T-shirt/top     0.8789  0.7840 0.8288     1000
    Trouser     0.9939  0.9760 0.9849     1000
   Pullover     0.8675  0.7920 0.8280     1000
      Dress     0.8922  0.9020 0.8971     1000
       Coat     0.8292  0.8110 0.8200     1000
     Sandal     0.9818  0.9720 0.9769     1000
      Shirt     0.6440  0.7760 0.7039     1000
    Sneaker     0.9498  0.9650 0.9573     1000
        Bag     0.9675  0.9830 0.9752     1000
 Ankle boot     0.9679  0.9650 0.9664     1000

Clase con mejor F1: Trouser 0.9849
Clase con peor F1: Shirt 0.7039
Clase con menor recall: Shirt 0.7760
Clase con menor precision: Shirt 0.6440
Una sola metrica no basta: combina F1, precision, recall y support.
Confusiones fuera de la diagonal (mayor a menor):
 Clase_real Clase_predicha  Errores
T-shirt/top          Shirt      168
   Pullover          Shirt      112
       Coat          Shirt       99
      Shirt    T-shirt/top       80
   Pullover           Coat       73
      Shirt           Coat       59
       Coat       Pullover       52
      Shirt       Pullover       47

Confusion mas frecuente: {'Clase_real': 'T-shirt/top', 'Clase_predicha': 'Shirt', 'Errores': np.int64(168)}
En sentido inverso: 80 errores.
Una posible explicacion visual debe contrastarse con estas imagenes; no se inventa.
Interpretación de la evaluación (RESULTADO → OBSERVACIÓN → COMPARACIÓN → INFERENCIA → LIMITACIÓN → DECISIÓN)
Usa los objetos df_clases, df_confusiones y las figuras, no cifras memorizadas.
RESULTADO. El classification_report descompone el test accuracy global. Macro avg trata cada clase igual; weighted avg pondera por support.
OBSERVACIÓN. Identifica la mejor y la peor clase según F1, y si el peor F1 coincide o no con el menor recall o la menor precision. Una clase puede tener precision alta y recall bajo: el modelo es cauto al predecirla, pero se le escapan muchos positivos.
COMPARACIÓN. Las filas altas de df_confusiones deben leerse junto a precision/recall de esas dos clases. Si A se predice como B con frecuencia, ¿B «roba» recall a A? ¿El par es simétrico?
INFERENCIA. En Fashion-MNIST es plausible que prendas de silueta parecida se confundan. Eso es una hipótesis visual: solo se sostiene si las imágenes mostradas la hacen creíble. No concluyas que una clase es «difícil» por una sola columna del reporte.
LIMITACIÓN. Un test fijo, una semilla y una arquitectura no separan «la clase es intrínsecamente difícil» de «este modelo no aprendió un rasgo útil».
DECISIÓN. Si una confusión domina el error, el siguiente experimento (más filtros, otro kernel, más datos de esa clase) debería atacar esa evidencia, no el accuracy global en abstracto.
Preguntas sobre las imágenes:
¿Los errores parecen simétricos?
¿Hay errores de alta confianza? Eso muestra que confianza ≠ certeza.
¿Los aciertos de alta confianza se ven «fáciles» o también hay casos ambiguos bien resueltos?
14. Visualización de activaciones internas
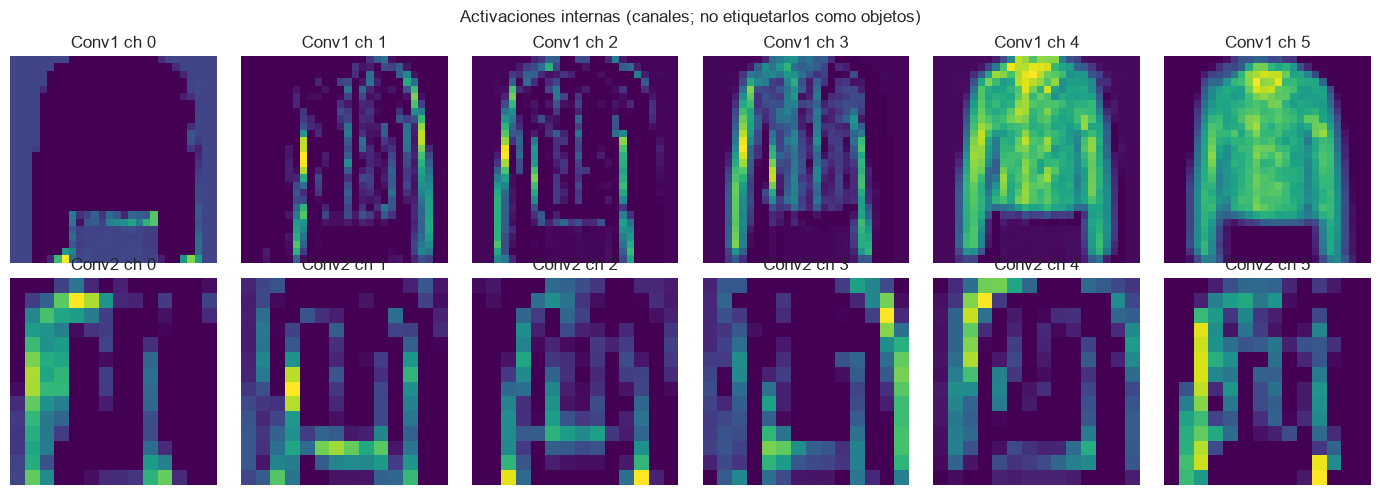
Las métricas globales indican rendimiento, pero no muestran cómo la red construye representaciones. Para eso se inspeccionan salidas de capas convolucionales.
Recordatorio:
Kernel: pesos de la capa.
Feature map: respuesta de aplicar esos pesos.
Activación: esa respuesta tras la no linealidad (aquí, ReLU ya va incluida en Conv2D).
Al visualizar:
capas tempranas suelen responder a patrones locales relativamente simples;
capas posteriores combinan representaciones anteriores y pueden responder a estructuras más abstractas.
Eso es una descripción conceptual. No afirma que un canal «detecta mangas», «detecta zapatos» o «detecta bordes» salvo que la evidencia visual sea muy clara y, aun así, se formule como hipótesis.
Idea clave
Mirar activaciones ayuda a entender la jerarquía espacial. No sustituye a la evaluación ni autoriza narrativas antropomórficas.
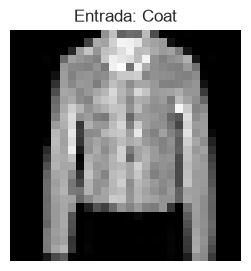
# Extraccion y visualizacion de activaciones de dos capas convolucionalessample_idx =10sample_input = x_test[sample_idx:sample_idx +1]_ = modelo_cnn(sample_input, training=False)conv_layers = [layer for layer in modelo_cnn.layers ifisinstance(layer, tf.keras.layers.Conv2D)]iflen(conv_layers) <2:raiseValueError("Se requieren al menos dos capas Conv2D para visualizar activaciones.")layer_outputs = [conv_layers[0].output, conv_layers[1].output]try: _ins = modelo_cnn.inputsexceptException: _ins = modelo_cnn.inputactivation_model = tf.keras.Model(inputs=_ins, outputs=layer_outputs)act1, act2 = activation_model.predict(sample_input, verbose=0)print("Imagen de entrada:", sample_input.shape)print("Activacion capa temprana:", act1.shape, " (batch, alto, ancho, canales)")print("Activacion capa posterior:", act2.shape)print("La resolucion espacial suele bajar; el numero de canales suele subir.")def resumen_canales(act, nombre): energia = act[0].mean(axis=(0, 1)) inactivos =int(np.sum(energia <1e-5))print(f"{nombre}: media por canal (primeros 8): {np.round(energia[:8], 4)}")print(f"{nombre}: canales casi inactivos (media < 1e-5): {inactivos} / {act.shape[-1]}")resumen_canales(act1, "Capa temprana")resumen_canales(act2, "Capa posterior")n_show =6fig, axes = plt.subplots(2, n_show, figsize=(14, 5))fig.suptitle("Activaciones internas (canales; no etiquetarlos como objetos)")for i inrange(n_show): axes[0, i].imshow(act1[0, :, :, i], cmap="viridis") axes[0, i].set_title(f"Conv1 ch {i}") axes[0, i].axis("off") axes[1, i].imshow(act2[0, :, :, i], cmap="viridis") axes[1, i].set_title(f"Conv2 ch {i}") axes[1, i].axis("off")plt.tight_layout()plt.show()plt.figure(figsize=(3, 3))plt.imshow(sample_input[0, :, :, 0], cmap="gray")plt.title(f"Entrada: {class_names[int(y_test[sample_idx])]}")plt.axis("off")plt.show()
Imagen de entrada: (1, 28, 28, 1)
Activacion capa temprana: (1, 28, 28, 16)   (batch, alto, ancho, canales)
Activacion capa posterior: (1, 14, 14, 32)
La resolucion espacial suele bajar; el numero de canales suele subir.
Capa temprana: media por canal (primeros 8): [0.0305 0.0343 0.0322 0.1098 0.2126 0.294  0.0658 0.0489]
Capa temprana: canales casi inactivos (media < 1e-5): 0 / 16
Capa posterior: media por canal (primeros 8): [0.0946 0.1135 0.1434 0.1244 0.1406 0.078  0.0585 0.1684]
Capa posterior: canales casi inactivos (media < 1e-5): 0 / 32
Preguntas (antes de leer la explicación)
¿Todos los canales responden igual?
¿Hay mapas casi inactivos?
¿Qué regiones producen mayor activación?
¿Cómo cambia la resolución espacial entre la capa temprana y la posterior?
¿Cómo cambia el número de canales?
¿Las representaciones posteriores son directamente interpretables como objetos?
¿Qué limitaciones tiene interpretar feature maps de esta manera?
Explicación
Lo habitual es que no todos los canales respondan igual: unos se encienden en ciertas regiones, otros quedan cerca de cero (sobre todo tras ReLU). Las regiones de mayor activación indican dónde ese canal es sensible, no qué concepto humano representa.
Entre capas, la resolución espacial suele bajar (por el pooling intermedio) y el número de canales suele subir. Las representaciones posteriores son combinaciones de las anteriores: más abstractas y, a menudo, menos legibles como imagen.
Limitaciones de esta inspección:
vemos unos pocos canales, no todos;
ReLU apaga valores negativos, así que el mapa no es el feature map lineal crudo;
un canal intenso no equivale a un detector semántico;
la visualización no explica, por sí sola, un error de clasificación.
Fórmulas prudentes: «este canal responde con mayor intensidad en determinadas regiones»; «parece sensible a ciertas estructuras locales». Evita: «este filtro detecta zapatos».
Idea clave
Cuanto más profunda la capa, más abstracta suele ser la representación. Eso no autoriza a ponerle nombre de prenda a cada mapa.
15. Cierre: ¿por qué CNN para imágenes?
Porque introduce sesgos inductivos adecuados para datos espaciales:
conectividad local (el detector mira una vecindad, no los 784 píxeles a la vez);
compartición de pesos (el mismo kernel se reutiliza en todo el plano);
aprendizaje jerárquico de representaciones (de patrones locales a combinaciones más abstractas).
Una CNN no es simplemente una MLP con más capas. Su arquitectura cambia la forma en que el modelo utiliza la estructura espacial de los datos.
Flatten al inicio conserva valores y elimina la vecindad explícita. Flatten al final, después de conv/pool, linealiza evidencia ya extraída.
El experimento de esta sesión aporta evidencia sobre MLP frente a CNN en Fashion-MNIST, con una semilla y un presupuesto de épocas. Esa evidencia informa una decisión de diseño; no demuestra un teorema («CNN siempre gana»).
Próximos pasos (no se implementan aquí)
Arquitecturas más profundas, transferencia de aprendizaje, visualizaciones tipo Grad-CAM y aumento de datos avanzado quedan para sesiones posteriores.
Idea clave
En visión, mejorar resultados no consiste solo en aumentar neuronas; consiste en utilizar una arquitectura cuyo sesgo inductivo coincida con la geometría del dato.
16. Amenazas a la validez
La comparación MLP vs CNN de este notebook depende de decisiones que no son la arquitectura:
la profundidad y el ancho concretos de cada modelo;
la inicialización y la semilla;
el número de épocas y el batch;
el optimizador y el learning rate;
el preprocessing y el split;
el hardware (el tiempo no es una constante física);
la variabilidad aleatoria de una sola corrida.
Por tanto:
«La CNN fue mejor en este experimento» no significa «la CNN siempre será mejor».
Un único dataset (Fashion-MNIST), una única semilla y un presupuesto corto de épocas no autorizan a generalizar a fotografías naturales, a otras resoluciones ni a otras familias de modelos.
Esquema que debe quedar instalado:
OBSERVACIÓN → qué midieron la tabla, las curvas y la matriz. INFERENCIA → qué sugiere eso sobre el uso de la estructura espacial aquí. LIMITACIÓN → qué no cubre el diseño. DECISIÓN → si adoptamos la CNN como base para seguir experimentando en visión, no como verdada universal.
17. Ejercicios (sin soluciones completas)
Trabaja sobre el notebook. No copies cifras de memoria: mídalas.
Cambia el número de filtros de la primera Conv2D (por ejemplo 8 y 32) y analiza parámetros y desempeño. ¿Más filtros implica automáticamente mejor test?
Sustituye kernels 3 × 3 por 5 × 5. Predice el cambio de parámetros y de H_out (si pasas a valid). Luego mide.
Compara padding="same" frente a "valid" en la primera capa. ¿Qué cambia en bordes, shape y accuracy?
Prueba strides=2 en una convolución. Relaciona resolución, tiempo y métricas.
Elimina un pooling. ¿Qué ocurre con el shape, los parámetros de la Dense y el riesgo de sobreajuste?
Compara dos CNN que difieran en un solo factor (filtros o pooling o padding). Reporta la tabla con valores programáticos.
Identifica la confusión más frecuente fuera de la diagonal. ¿Es simétrica? Contrástala con precision/recall de esas clases.
Elige una predicción incorrecta de alta confianza. ¿La imagen es ambigua para un humano? Una posible explicación visual no es una prueba.
Interpreta un feature map de la capa temprana: describe regiones de alta respuesta, no nombres de prendas.
Explica, en un párrafo, por qué un Flatten temprano cambia el tratamiento de la estructura espacial aunque conserve los 784 valores.
Criterio: medir → observar → comparar → inferir → decidir. Una métrica aislada no cierra el ejercicio.
💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.