Clasificación de dígitos manuscritos (MNIST) con CNN

deep-learning
cnn
mnist
Aplicación complementaria de la sesión 6: entrenamiento, evaluación, guardado del modelo e inferencia.
Author

Wilder Ramírez Delgado

Published

September 3, 2026

Clasificación de dígitos manuscritos (MNIST) con CNN

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo entrenamos, evaluamos, guardamos y usamos una CNN sobre MNIST: de la imagen al dígito predicho, incluyendo inferencia con un modelo serializado.

1. Introducción

Este artículo guía, con nivel universitario de profundidad, un experimento completo: problema, mecanismo de convolución, contraste con MLP/perceptrón, arquitectura entrenable, interpretación (métricas, mapas, errores) y serialización + inferencia. El objetivo es razonar el porqué, no ejecutar ciegamente.

Contexto y motivación

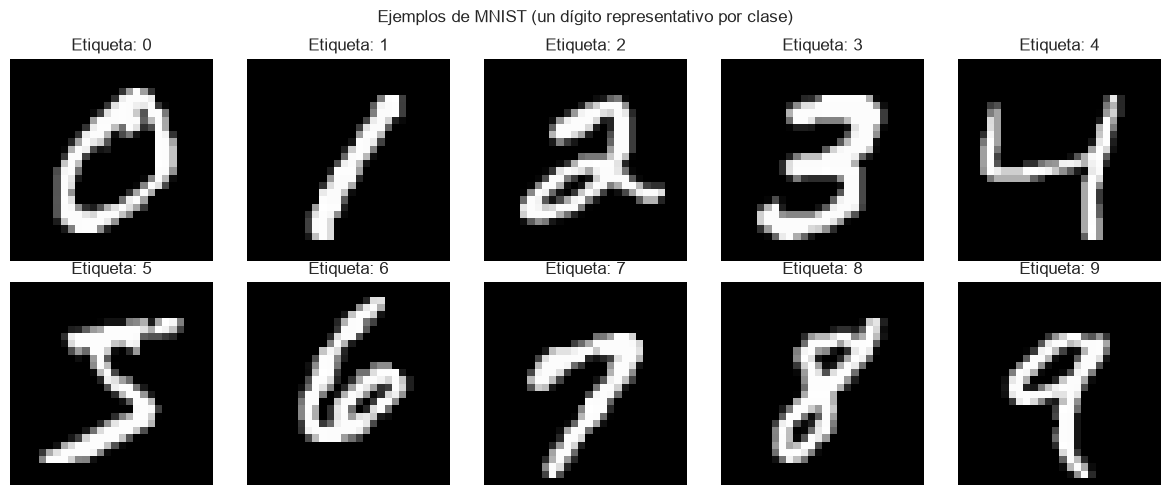
MNIST (Modified National Institute of Standards and Technology) concentra 70,000 imágenes 28×28 en gris, etiquetadas 0–9. Su valor docente: aislar cuestiones de modelo y entrenamiento de la complejidad dataset (color, oclusión, background rich). Las CNN son el default de imagen al codificar priors espaciales (parche, composición, peso compartido) que una MLP s/plantilla no fija a priori.

Objetivos de aprendizaje

Al cierre, debería poder:

  1. Plantear un problema de clasificación multiclase con tensores de imagen.
  2. Distinguir convolución vs. capa densa aplanada (localidad, compartición, sample complexity).
  3. Preprocesar (escala, canal, one-hot) y particionar train/val/test con papeles distintos.
  4. Leer un summary (parámetros, flujo espacial) y conectar bloque conv con receptive field.
  5. Explicar loss y accuracy y la diferencia tren/validación (generalización, no cosmética).
  6. Leer mapas de activación como evidencia interna, no decorado.
  7. Sintetizar accuracy, matriz de confusión y errores; argumentar limitation MNIST.
  8. Serializar, cargar e inferir softmax con trazabilidad de pre.

Estructura del documento

  1. Entorno y reproducibilidad
  2. Carga y exploración (MNIST)
  3. Preprocesamiento y partición
  4. Mecánica e intuición de la convolución (NumPy)
  5. CNN vs. MLP (y puente a perceptrón)
  6. Arquitectura (Keras)
  7. Compilación, callbacks, entrenamiento, curvas
  8. Representaciones (mapas de la primera conv)
  9. Evaluación hold-out, matriz, errores
  10. Conclusiones y extensiones
  11. Guardado, carga, inferencia (y disco)

2. Entorno, librerías y reproducibilidad

¿Qué estamos haciendo y por qué?

Fijar semilla (NumPy, TensorFlow) y registrar el entorno (versiones) para que otra ejecución o otro curso reproduzca el mismo comportamiento cualitativo del entrenamiento. Sin semillas, dos corridas idénticas en código difieren en inicialización, orden de lotes, etc., y comparar hiperparámetros se vuelve ambiguo (la varianza estocástica nubla la conclusión).

En informes: cite TensorFlow, Keras, Python y hardware. En este artículo se imprime la versión de Keras/TensorFlow como ancla mínima.

La pérdida será entropía cruzada categórica, coherente con salida softmax y etiquetas one-hot: el gradiente penaliza con fuerza asignar probabilidad a clases erróneas y empuja la representación hacia fronteras de decisión que separan clases en el espacio de logits.

# Reproducibilidad: fija la semilla de NumPy y TensorFlow
import os
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers, models, callbacks
from sklearn.metrics import classification_report, confusion_matrix
import seaborn as sns

SEMILLA = 42
np.random.seed(SEMILLA)
tf.random.set_seed(SEMILLA)

plt.style.use("seaborn-v0_8-whitegrid")
plt.rcParams["figure.figsize"] = (8, 4)
plt.rcParams["font.size"] = 10

print(f"TensorFlow: {tf.__version__}")
print(f"Keras: {keras.__version__}")
print(f"GPU disponible: {len(tf.config.list_physical_devices('GPU')) > 0}")
TensorFlow: 2.21.0
Keras: 3.15.1
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU disponible: False

Nota metodológica

El registro de versiones (TensorFlow, Python, SO) debería incluirse en un informe académico; aquí basta con imprimir tf.__version__ para anclar el experimento a un stack concreto.

3. Carga y exploración de datos (MNIST)

¿Qué estamos haciendo y por qué?

Instanciar el dataset y fijar notación de tensores: quién indexa a qué, rango uint8 original vs. reescala posterior, y por qué reservar validación sobre los 60,000. Esto condiciona toda inferencia sobre generalización: el 10k hold-out nunca ajusta hiperparámetros en este lab básico.

mnist.load_data() devuelve pares (entrenamiento) y (prueba). Código: x_entrenamiento_completo, y_entrenamiento_completo, x_prueba, y_prueba.

  • Eje de datos: (N, 28, 28); píxeles 0…255 antes de normalizar.
  • Etiquetas: enteros 0…9.

Papeles: entrenamiento (gradiente, pesos), validación (early stopping, no tocar test), prueba (único estimador imparcial del riesgo out-of-fit bajo protocol).

# Datos: 60 000 imágenes de entrenamiento y 10 000 de prueba (etiquetadas 0–9)
(x_entrenamiento_completo, y_entrenamiento_completo), (x_prueba, y_prueba) = keras.datasets.mnist.load_data()

print("Forma x_entrenamiento_completo:", x_entrenamiento_completo.shape, "dtype:", x_entrenamiento_completo.dtype)
print("Forma y_entrenamiento_completo:", y_entrenamiento_completo.shape)
print("Forma x_prueba:", x_prueba.shape)
print("Rango píxeles: [", x_entrenamiento_completo.min(), ",", x_entrenamiento_completo.max(), "]")

# Muestras: un ejemplo por cada dígito (búsqueda del primer índice por clase)
fig, axes = plt.subplots(2, 5, figsize=(12, 5))
axes = axes.ravel()
for digito in range(10):
    indice = np.where(y_entrenamiento_completo == digito)[0][0]
    axes[digito].imshow(x_entrenamiento_completo[indice], cmap="gray")
    axes[digito].set_title(f"Etiqueta: {digito}")
    axes[digito].axis("off")
plt.suptitle("Ejemplos de MNIST (un dígito representativo por clase)")
plt.tight_layout()
plt.show()

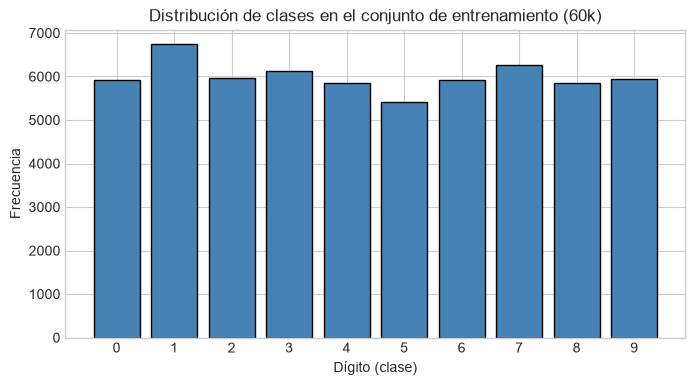
# Frecuencia de clases (balance aproximado: condición adecuada para la métrica de exactitud)
clases, conteos = np.unique(y_entrenamiento_completo, return_counts=True)
fig2, ax = plt.subplots()
ax.bar(clases.astype(str), conteos, color="steelblue", edgecolor="black")
ax.set_xlabel("Dígito (clase)")
ax.set_ylabel("Frecuencia")
ax.set_title("Distribución de clases en el conjunto de entrenamiento (60k)")
plt.show()
Forma x_entrenamiento_completo: (60000, 28, 28) dtype: uint8
Forma y_entrenamiento_completo: (60000,)
Forma x_prueba: (10000, 28, 28)
Rango píxeles: [ 0 , 255 ]

Interpretación

La distribución por clase en MNIST es casi uniforme; en ese régimen, la exactitud agregada resumen el error sin distorsionar demasiado hacia la clase mayor. En dominios reales con desbalance, la exactitud sería un espejismo: entonces se pondera la función de coste, se usan macro-F1, recall por clase, u otras métricas alineadas con el coste asimétrico del error. Aun con MNIST, la matriz de confusión y los ejemplos de error aportan más que un único escalar: revelan qué pares de dígitos se mezclan, no solo cuánto.

4. Preprocesamiento

¿Qué estamos haciendo y por qué?

Alinear el tensor con el cálculo (tipo flotante, rango de píxeles, canal) y con la función de riesgo (etiquetas one-hot frente a softmax + entropía cruzada). Reservar validación dentro de los 60,000 asegura señal para criterios de early stopping sin tocar el conjunto de prueba (10,000) que se reserva a la estimación final de generalización.

  1. Normalización: píxeles a [0, 1] (dividir por 255) para acotar magnitudes y estabilizar el entrenamiento con gradiente.
  2. Eje de canal: forma (N, 28, 28, 1); Conv2D de Keras espera cuatro dimensiones.
  3. One-hot: codificar 0…9 en vectores de 10 entradas mutuamente excluyentes, coherentes con la capa softmax y la categorical crossentropy.
  4. Partición: 5,000 imágenes de validación extraídas del bloque de 60,000; 55,000 + 5,000 + 10,000 = protocolo train / val / test con roles separados.
# Escala de grises: normalización a [0, 1] e inclusión del eje de canal (N, 28, 28, 1)
x_entrenamiento_completo = x_entrenamiento_completo.astype("float32") / 255.0
x_prueba = x_prueba.astype("float32") / 255.0

x_entrenamiento_completo = np.expand_dims(x_entrenamiento_completo, -1)
x_prueba = np.expand_dims(x_prueba, -1)

N_MUESTRAS_VALIDACION = 5000
x_validacion = x_entrenamiento_completo[:N_MUESTRAS_VALIDACION]
y_validacion = y_entrenamiento_completo[:N_MUESTRAS_VALIDACION]
x_entrenamiento = x_entrenamiento_completo[N_MUESTRAS_VALIDACION:]
y_entrenamiento = y_entrenamiento_completo[N_MUESTRAS_VALIDACION:]

n_clases = 10
y_entrenamiento_onehot = keras.utils.to_categorical(y_entrenamiento, n_clases)
y_validacion_onehot = keras.utils.to_categorical(y_validacion, n_clases)
y_prueba_onehot = keras.utils.to_categorical(y_prueba, n_clases)

print("Entrenamiento:", x_entrenamiento.shape, y_entrenamiento_onehot.shape)
print("Validación:   ", x_validacion.shape, y_validacion_onehot.shape)
print("Prueba:      ", x_prueba.shape, y_prueba_onehot.shape)
Entrenamiento: (55000, 28, 28, 1) (55000, 10)
Validación:    (5000, 28, 28, 1) (5000, 10)
Prueba:       (10000, 28, 28, 1) (10000, 10)

5. ¿Qué hace realmente una convolución?

De cara al perceptrón y a la MLP, un patrón recurrente en visión es: la entrada es una rejilla (píxeles) en la que el vecindario importa: un trazo, un borde o un remate son relaciones locales entre píxeles cercanos. La convolución traduce eso a una operación algebraica que el gradiente pueda ajustar.

Fijamos una ventana (p. ej. 3×3) que se desliza sobre la imagen. En cada posición, la ventana aplica un mismo conjunto de pesos (el kernel o filtro) a los píxeles bajo ella, suma los producto-peso, y deja un único valor en un mapa de características. Al desplazar la ventana, el filtro reutiliza sus pesos en todo el plano: la invariancia a la traslación con peso compartido hace de la convolución el análogo local y eficiente de un detector de un patrón en muchas posiciones a la vez.

Cálculo mínimo (a mano). Tómese una matriz 5×5 (valores en [0,1]) y un kernel 3×3. En el primer renglón, la ventana 3×3 recubre filas 0–2 y columnas 0–2; el valor en la esquina superior izquierda del mapa 3×3 es (z_{0,0} = {u,v} w{u,v} x_{u,v}). Deslizando la ventana, cada (z_{i,j}) responde a: «¿hasta qué punto este parche coincide con el patrón fijado por (w)?». Con muchos kernels y no linealidades, la pila de capas compone esas respuestas: de bordes a texturas, y de texturas a partes y clases.

¿Qué estamos haciendo y por qué?

Antes de fijar la arquitectura en Keras, aíslamos el núcleo matemático: el mismo cálculo que luego se paraleliza con millones de operaciones. El fin es no confundir la librería con el mecanismo; conectar con el producto matricial del perceptrón, pero restringido a parches y reutilización de pesos frente a un vector aplanado completo.

# Ilustración numérica: convolución 2D "valid" (sin padding) con doble bucle, como en aula
# Misma lógica que un Conv2D con stride 1, un canal y un filtro.

import numpy as np

imagen_5x5 = np.array(
    [
        [0.0, 0.0, 0.2, 0.0, 0.0],
        [0.0, 0.2, 0.8, 0.2, 0.0],
        [0.2, 0.8, 1.0, 0.8, 0.2],
        [0.0, 0.2, 0.8, 0.2, 0.0],
        [0.0, 0.0, 0.2, 0.0, 0.0],
    ],
    dtype=np.float32,
)

kernel_3x3 = np.array(
    [
        [-1.0, 0.0, 1.0],
        [-1.0, 0.0, 1.0],
        [-1.0, 0.0, 1.0],
    ],
    dtype=np.float32,
)


def convolucion_valid(matriz, kernel):
    h, w = matriz.shape
    kh, kw = kernel.shape
    out_h, out_w = h - kh + 1, w - kw + 1
    salida = np.zeros((out_h, out_w), dtype=matriz.dtype)
    for i in range(out_h):
        for j in range(out_w):
            parche = matriz[i : i + kh, j : j + kw]
            salida[i, j] = float(np.sum(parche * kernel))
    return salida


mapa = convolucion_valid(imagen_5x5, kernel_3x3)
print("Imagen 5x5 (entrada):")
print(np.round(imagen_5x5, 2))
print("\nKernel 3x3 (un filtro; en Keras, muchos filtros = profundidad del mapa):")
print(np.round(kernel_3x3, 2))
print("\nMapa 3x3 (cada célula: respuesta bajo '¿el patrón w encaja aquí?'):")
print(np.round(mapa, 2))
parche00 = imagen_5x5[0:3, 0:3]
z00 = float(np.sum(parche00 * kernel_3x3))
print(f"\nCálculo en (0,0): suma(p_ij * w_ij) = {z00:.4f}")
Imagen 5x5 (entrada):
[[0.  0.  0.2 0.  0. ]
 [0.  0.2 0.8 0.2 0. ]
 [0.2 0.8 1.  0.8 0.2]
 [0.  0.2 0.8 0.2 0. ]
 [0.  0.  0.2 0.  0. ]]

Kernel 3x3 (un filtro; en Keras, muchos filtros = profundidad del mapa):
[[-1.  0.  1.]
 [-1.  0.  1.]
 [-1.  0.  1.]]

Mapa 3x3 (cada célula: respuesta bajo '¿el patrón w encaja aquí?'):
[[ 1.8  0.  -1.8]
 [ 2.4  0.  -2.4]
 [ 1.8  0.  -1.8]]

Cálculo en (0,0): suma(p_ij * w_ij) = 1.8000

Interpretación

Cada posición del mapa de salida mide la alineación entre un parche de la imagen y el patrón fijado por el kernel. Magnitudes altas (en módulo) indican que, en esa ventana, el contraste o estructura que el filtro codifica coincide con el aprendizaje. En la primera capa, los filtros suelen aproximar detectores de bordes o trazos; en profundidad, el mismo mecanismo ensambla pistas hacia partes y decisiones de clase. La conexión con el perceptrón: sigue siendo un producto interno, pero sobre un parche y con pesos compartidos al deslizar, no 784 conexiones libres por neurona aplanada.

Idea clave

La convolución responde a «en este vecindario, ¿hasta dónde está el patrón asociado a estos pesos?» con reutilización del mismo detector en toda la imagen: prior de localidad + compartición, base del control paramétrico frente a una MLP densa aplanada.

Reto técnico

  • Si aumenta el tamaño del kernel (3×3 → 5×5) en modo valid, cada unidad mira un receptive field inmediatamente más amplio, pero añade parámetros por filtro; el alcanz global aún lo atizan capas o el pooling.

  • Si fija stride=2 en stride puro, el mapa baja de resolución: menos celdas, muestreo más áspero, coste menor; compárelo con max-pooling (¿saturación? ¿traslación?).

6. ¿Por qué una CNN y no una MLP?

Perceptrón (una capa): mapea un vector de características a una regla (hiper)lineal. MLP (varias densas): gana expresividad con no linealidades, pero, si aplanas 28×28 en 784, el modelo pierde el orden 2D: píxel i y vecino i+1 no están ligados por arquitectura salvo a través de pesos libres en todas las conexiones: muchos parámetros y criterio sample complexity poco afortunado en imagen.

MLP densa (sobre aplanado) CNN
Qué hace Cada píxel acoplado ampliamente; la vecindad no es prior. Cada kernel mira un parche y comparte pesos.
Parámetros Típicamente (O(H N)) vs. (O(k^2 F )) controlado. Crecen con filtros, no con cada enlace a cada píxel.
Imagen Tabulares con vecinos “mezclados”. Local → compuesto → semántica.

No se trata de “más capas o más parámetros” sin más: a menudo la CNN es más adecuada e incluso más frugal en bits de modelo respecto a la tarea, porque inyecta localidad y compartición (equivarianzas aproximadas). En imagen, tamaño sustituyendo estructura paga data o overfitting.

👉 Frase a defender oralmente: la CNN no gana por ser más gigante sino por restringir y compartir conexiones con sentido geométrico; la MLP, sin ese bias, frecuentemente **gasta* parámetros en lo que un kernel ya restringe.

Puente con el perceptrón / MLP: la neurona densa hace (y = (_i w_i x_i + b)). Un canal convolucional hace el mismo bloque, pero con (x) = parche, (w) = compartido al deslizar, de modo que un template barre toda la imagen.

Reto técnico

  • Quitar MaxPool2D (restante idéntica): resolución espacial más alta en capas medias, más coste y **más* riesgo de sobreajuste; qué añadiría (regularizador, data aug, criterio de parada) para compensar.

  • Duplicar el número de filtros del primer Conv2D: más vías paralelas de mapas, más parámetros; en qué términos podría overfit si el conjunto fuese pequeño.

7. Arquitectura de la red convolucional

¿Qué estamos haciendo y por qué?

Fijar en código la narrativa de las secciones 4 y 5: pila conv → no linealidad → pool que extrae y submuestrea mapas; aplanado y capas Dense que combinan la información en un código de decisión; dropout como regularización; softmax para una distribución de probabilidad sobre 10 clases. El summary() permite cotejar el número de parámetros con la intuición CNN vs. MLP densa.

Esquema: bloques convolucionales detectan estructura local; el max-pooling reduce resolución espacial y aporta cierta invariancia local a traslación; el bloque Dense mapea el vector a logits; la salida softmax entrega beliefs multiclase.

Parámetros: en la conv, compartir peso en el plano suele exigir menos conexiones entrenables que conectar cada píxel a cada unidad de una capa densa a partir del vector aplanado, sin estructurar el vecindario 2D.

Guía didáctica: qué significa cada Output Shape en el summary()

Cada fila Output Shape de la tabla es la forma del tensor (orden de las dimensiones) a la salida de esa capa. Si piensa qué entra y qué sale, deja de ser un misterio y pasa a ser un inventario de tamaños en el pipeline.

1. Convención channels last (forma N–H–W–C** en Keras) para imágenes 2D**
En bloques conv / pool suele verse algo como (None, alto, ancho, canales) (última dimensión = profundidad de mapas, no “RGB forzado”: en gris, también es el eje de canales de la capa, aunque haya 1 filtro o 32 apilados).

  • None en el primer eje: Keras aún no fija (o hace dinámica) el tamaño de lote (batch). En la práctica, si mete 128 imágenes, ese eje pasa a ser 128. Significa: “esta capa acepta cualquier lote; el primer número es cuántas imágenes van juntas en un paso de entrenamiento o inferencia”.

  • Segundo y tercer número (H, W): altura y anchura del mapa de activación en celdas (no en milímetros: son celdas de la rejilla después de esa operación). Si bajan, la imagen “semántica” se representa con menos posiciones en el plano, pero a cambio (en profundidad) con más canales (mapas) que en capas anteriores.

  • Cuarto número (C): cántos mapas (filtros) salen de esa capa. Cada mapa es una “foto” distinta: el filtro k responde en cada (fila, col) a qué tan presente está su patrón allí. Por eso la profundidad crece cuando sube el número de filtros (32, 64, …).

2. Lectura línea a línea con esta** arquitectura (entrada 28×28, Conv2D 3×3 valid, MaxPool 2×2)**

Palabras “hojas” o “transparencias” en la tabla = metáfora: no es papel, son mapas 2D apilados (también se dicen canales* de salida). Cada “hoja” / mapa = una rejilla del mismo ancho y alto, con un número en cada casilla. La red pide 32, luego 64, rejillas en paralelo, cada una generada por un filtro distinto (un detector de patrón).*

Capa (nombre típico) Output Shape (idea) Qué significa (lenguaje básico)
conv2d_1 (None, 26, 26, 32) La imagen de entrada mide 28 celdas de alto por 28 de ancho. Con una ventanita 3×3 que se recorre la imagen, la cuadrícula se achica a 26×26 (pierdes un borde de un píxel a cada lado). El 32 = 32 mapas a la vez (32 rejillas, una por filtro; a veces se dice hojas o transparencias apiladas). En cada mapa, cada casilla = “¿aquí vio este filtro su patrón?”.
pool1 (None, 13, 13, 32) Ahora la cuadrícula es más chica en alto y ancho: 13×13 (se toma un máximo en bloques 2×2, como “resumir” la imagen). Sigue habiendo 32 mapas; el 32 no cambia.
conv2d_2 (None, 11, 11, 64) Otra convolución: la red vuelve a mirar con ventanas, y el tablero queda 11×11. Ahora se apilan 64 mapas (antes 32; 64 canales o “hojas” en la imagen de la pila) = la red pide más tipos de detección al mismo tiempo.
pool2 (None, 5, 5, 64) Otra reducción: la cuadrícula baja a 5×5. Siguen 64 mapas; cada uno es una rejilla 5×5.
flatten (None, 1600) Se doblan todas las celdas de todos los mapas en una sola tira de números. Cuenta: 5 filas × 5 columnas × 64 mapas = 1600 números por imagen, uno detrás de otro. Ya no se “ve” el cuadro, solo la tira.
dense1 / output (None, 128) / (None, 10) 128 = cuántas “bombillas ocultas” resumen la tira de 1600. 10 = 10 números de salida (uno por dígito 0, 1, …, 9). Después la capa softmax transforma esos 10 en porcentajes (probabilidades) de cada clase.

3. Cierre
El primer None = “tantas filas de imagen en el lote”. En capas 2D, lea (lote) × (rejilla) × (profundidad de mapas). Tras Flatten, lea (lote) × (largo del vector): ahí el modelo ya mezcló toda la información espacial en un código listo para capas Dense y para la decisión de clase.

def construir_cnn(
    forma_entrada=(28, 28, 1),
    n_clases: int = 10,
    tasa_dropout: float = 0.5,
):
    """
    Arquitectura convolucional para MNIST: extracción espacial (conv+pool) y
    capas densas con dropout como regularización frente al sobreajuste.
    """
    modelo = models.Sequential(name="mnist_cnn")
    # Bloque 1: características de bajo nivel
    modelo.add(layers.Input(shape=forma_entrada))
    modelo.add(layers.Conv2D(32, kernel_size=(3, 3), padding="valid", name="conv2d_1"))
    modelo.add(layers.Activation("relu"))
    modelo.add(layers.MaxPooling2D(pool_size=(2, 2), name="pool1"))
    # Bloque 2: patrones compuestos
    modelo.add(layers.Conv2D(64, kernel_size=(3, 3), padding="valid", name="conv2d_2"))
    modelo.add(layers.Activation("relu"))
    modelo.add(layers.MaxPooling2D(pool_size=(2, 2), name="pool2"))
    # Clasificador: vector denso, dropout y salida soft-max
    modelo.add(layers.Flatten(name="flatten"))
    modelo.add(layers.Dense(128, activation="relu", name="dense1"))
    modelo.add(layers.Dropout(tasa_dropout, name="dropout"))
    modelo.add(layers.Dense(n_clases, activation="softmax", name="output"))
    return modelo

modelo = construir_cnn()
modelo.summary()
print("\nParámetros entrenables totales:", f"{modelo.count_params():,}")
Model: "mnist_cnn"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d_1 (Conv2D)               │ (None, 26, 26, 32)     │           320 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ activation (Activation)         │ (None, 26, 26, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ pool1 (MaxPooling2D)            │ (None, 13, 13, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_2 (Conv2D)               │ (None, 11, 11, 64)     │        18,496 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ activation_1 (Activation)       │ (None, 11, 11, 64)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ pool2 (MaxPooling2D)            │ (None, 5, 5, 64)       │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten)               │ (None, 1600)           │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense1 (Dense)                  │ (None, 128)            │       204,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout)               │ (None, 128)            │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ output (Dense)                  │ (None, 10)             │         1,290 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 225,034 (879.04 KB)
 Trainable params: 225,034 (879.04 KB)
 Non-trainable params: 0 (0.00 B)

Parámetros entrenables totales: 225,034

Reto técnico

  • Compare orden de magnitud de parámetros: esta CNN vs. una MLP 784–800 (una oculta). Argüe qué prior espacial paga la segunda.

  • Stride 2 sin pool : deduzca* en papel la forma del mapa 3×3 sobre 7×7 (una* sola conv a modo valid ) *.

8. Compilación, callbacks y entrenamiento

¿Qué estamos haciendo y por qué?

Fijar el criterio de optimización (pérdida = entropía cruzada frente a etiquetas one-hot; minimizar su media sobre minibatch alinea el gradiente con el error de clasificación suave antes del argmax), el optimizador (Adam adapta tasas de forma efectiva en la práctica) y un criterio de parada basado en validación (no en el conjunto de prueba), que es lo que hace EarlyStopping con restore_best_weights=True.

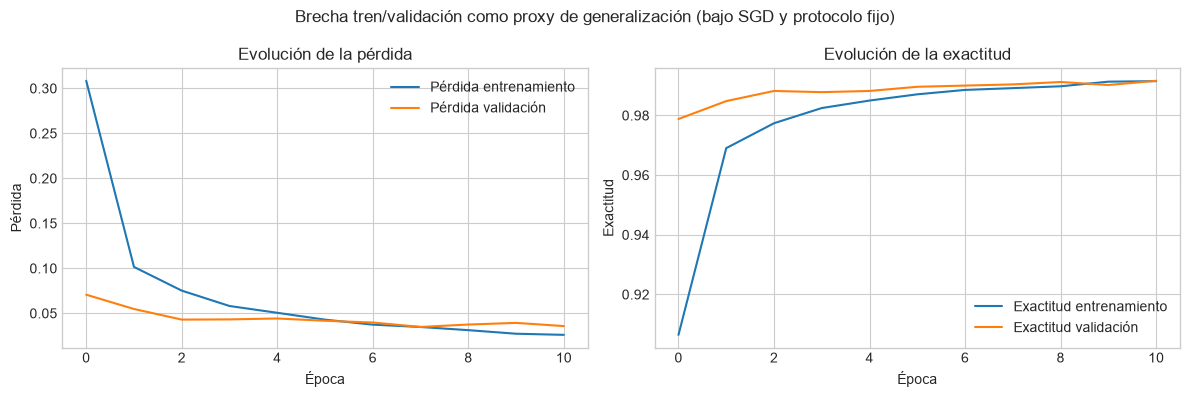
  • Pérdida baja en entrenamiento: la red ajusta los logits para asignar más masa de probabilidad a la clase anotada en los ejemplos del lote. No garantiza, por sí sola, buen desempeño fuera de ese muestreo.
  • Exactitud (accuracy) sube si el argmax de la softmax coincide con la etiqueta; mide tasa de aciertos, no la forma completa de la distribución.
  • Brecha tren / validación: si la pérdida de entrenamiento baja mientras la de validación empeora, el modelo está especializando detalles del conjunto de ajuste; si ambas se estancan en valores altos, es señal de subajuste o de hiperparámetros (p. ej. tasa de aprendizaje) poco adecuados.

Reto técnico

  • Si duplica TASA_APRENDIZAJE, qué espera respecto a la suavidad de las curvas y al riesgo de no converger o de sobrepasar mínimos.

  • Si desactiva detencion_temprana y fija EPOCAS muy altas, qué señal en tren vs. validación argumentaría overfitting aun con exactitud de prueba aún desconocida.

# Hiperparámetros: lote, épocas y tasa de aprendizaje del optimizador Adam
TAMANO_LOTE = 128
EPOCAS = 20
TASA_APRENDIZAJE = 1e-3

modelo.compile(
    optimizer=keras.optimizers.Adam(learning_rate=TASA_APRENDIZAJE),
    loss="categorical_crossentropy",
    metrics=["accuracy"],
)

detencion_temprana = callbacks.EarlyStopping(
    monitor="val_loss", patience=3, restore_best_weights=True, verbose=1
)

historial_entrenamiento = modelo.fit(
    x_entrenamiento, y_entrenamiento_onehot,
    batch_size=TAMANO_LOTE,
    epochs=EPOCAS,
    validation_data=(x_validacion, y_validacion_onehot),
    callbacks=[detencion_temprana],
    verbose=1,
)
Epoch 1/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9065 - loss: 0.3084 - val_accuracy: 0.9788 - val_loss: 0.0707

Epoch 2/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9690 - loss: 0.1015 - val_accuracy: 0.9848 - val_loss: 0.0548

Epoch 3/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9774 - loss: 0.0752 - val_accuracy: 0.9882 - val_loss: 0.0430

Epoch 4/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9825 - loss: 0.0581 - val_accuracy: 0.9878 - val_loss: 0.0432

Epoch 5/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9850 - loss: 0.0505 - val_accuracy: 0.9882 - val_loss: 0.0442

Epoch 6/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 8ms/step - accuracy: 0.9871 - loss: 0.0429 - val_accuracy: 0.9896 - val_loss: 0.0417

Epoch 7/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 9ms/step - accuracy: 0.9885 - loss: 0.0374 - val_accuracy: 0.9900 - val_loss: 0.0397

Epoch 8/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 9ms/step - accuracy: 0.9891 - loss: 0.0348 - val_accuracy: 0.9904 - val_loss: 0.0348

Epoch 9/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 9ms/step - accuracy: 0.9898 - loss: 0.0312 - val_accuracy: 0.9912 - val_loss: 0.0375

Epoch 10/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 9ms/step - accuracy: 0.9913 - loss: 0.0273 - val_accuracy: 0.9902 - val_loss: 0.0393

Epoch 11/20

430/430 ━━━━━━━━━━━━━━━━━━━━ 4s 9ms/step - accuracy: 0.9915 - loss: 0.0260 - val_accuracy: 0.9916 - val_loss: 0.0358

Epoch 11: early stopping

Restoring model weights from the end of the best epoch: 8.
# Pérdida y exactitud por época: tren (ajuste) frente a validación (señal out-of-fit)
metricas = historial_entrenamiento.history
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))
ax1.plot(metricas["loss"], label="Pérdida entrenamiento")
ax1.plot(metricas["val_loss"], label="Pérdida validación")
ax1.set_xlabel("Época")
ax1.set_ylabel("Pérdida")
ax1.legend()
ax1.set_title("Evolución de la pérdida")
ax2.plot(metricas["accuracy"], label="Exactitud entrenamiento")
ax2.plot(metricas["val_accuracy"], label="Exactitud validación")
ax2.set_xlabel("Época")
ax2.set_ylabel("Exactitud")
ax2.legend()
ax2.set_title("Evolución de la exactitud")
plt.suptitle("Brecha tren/validación como proxy de generalización (bajo SGD y protocolo fijo)")
plt.tight_layout()
plt.show()

print("\n**Lectura de curvas (concepto):**")
print(
    "Si val_loss sube mientras la pérdida de tren baja, el ajuste memoriza el entrenamiento. "
    "Si ambas bajan, el patrón aprendido también reduce error en validación. "
    "Si ambas se estancan en valores altos, considere tasa de aprendizaje o capacidad arquitectónica."
)


**Lectura de curvas (concepto):**
Si val_loss sube mientras la pérdida de tren baja, el ajuste memoriza el entrenamiento. Si ambas bajan, el patrón aprendido también reduce error en validación. Si ambas se estancan en valores altos, considere tasa de aprendizaje o capacidad arquitectónica.

9. Representaciones intermedias: activaciones de la primera convolución

¿Qué estamos haciendo y por qué?

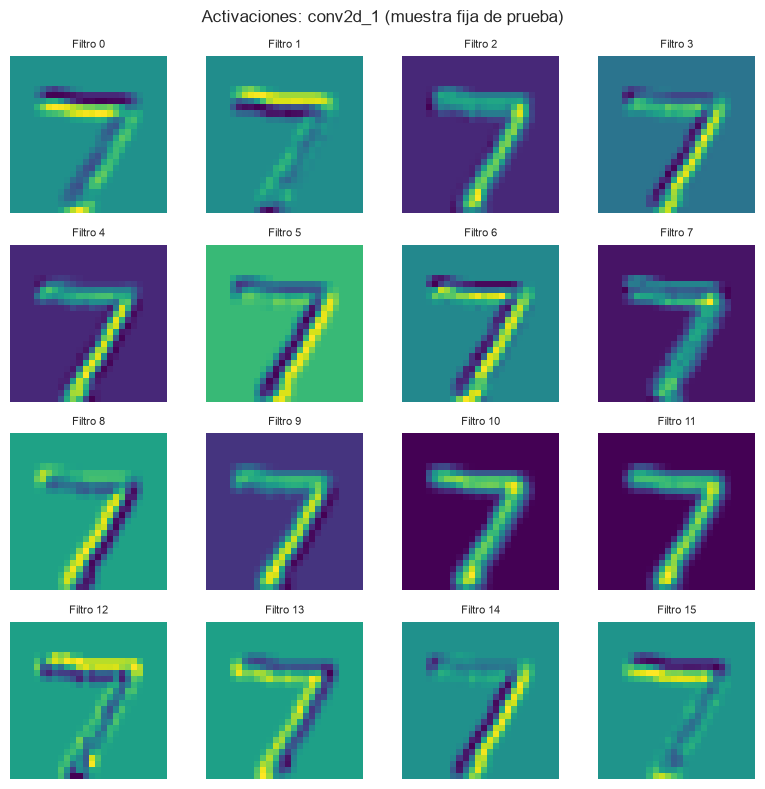
Tras el entrenamiento, las salidas de conv2d_1 son mapas (canales): en cada posición, el valor indica cuánto “encaja” el patrón aprendido por ese filtro con el trazo local bajo la ventana. Complementa las curvas de loss y accuracy: pasa de métricas globales a evidencia interna de qué estructura visual activa la red en un ejemplo. Requiere modelo entrenado con modelo.fit (o pesos equivalentes recargados).

En la literatura se profundiza con técnicas de feature visualization; aquí, una lectura directa sin optimizar imágenes sintéticas.

# Mapas de la primera Conv2D: salida de la capa "conv2d_1"
# Keras 3: un Model(inputs,outputs) a partir de capas de un Sequential a veces no conecta
# el grafo (ValueError: inputs not connected to outputs). Recorremos las capas con los
# MISMOS pesos hasta "conv2d_1" (forward explícito, sin submodelo Funcional).
indice_muestra = 0
tensor_ejemplo = x_prueba[indice_muestra : indice_muestra + 1]

x = tf.cast(tensor_ejemplo, tf.float32)
for capa in modelo.layers:
    # Sin Dropout/BatchNorm antes de conv2d_1: `capa(x)` basta; evita `training=` en Input.
    x = capa(x)
    if capa.name == "conv2d_1":
        break
mapas = x.numpy()  # forma (1, 26, 26, 32) con el diseño actual
n_mostrados = min(16, mapas.shape[-1])
fig, axes = plt.subplots(4, 4, figsize=(8, 8))
for k, ax in enumerate(axes.ravel()[:n_mostrados]):
    ax.imshow(mapas[0, :, :, k], cmap="viridis")
    ax.set_title(f"Filtro {k}", fontsize=8)
    ax.axis("off")
plt.suptitle("Activaciones: conv2d_1 (muestra fija de prueba)")
plt.tight_layout()
plt.show()

Interpretación

Cada recuadro localiza dónde un filtro disparó con intensidad. Canales apagados sugieren poca alineación con el patrón aprendido; regiones brillantes indican coincidencia con bordes, trazos o texturas útiles para capas superiores. El flujo es: píxel bruto → stack de mapas → aplanar → Dense → softmax: la decisión no mira píxel a píxel de forma libre, sino a través de códigos intermedios. Compare, conceptualmente, con pesos aleatorios (mismo grafo, misma forward): el entrenamiento es lo que estructura los mapas; la sintaxis Conv2D sola no.

Reto (una pregunta de examen): ¿por qué un mapa entrenado suele parecer más coherente que bajo inicio aleatorio? (Idea: el riesgo empírico y las etiquetas empujan los pesos a explicar la variación entre clases bajo SGD).

10. Evaluación en el conjunto de prueba (hold-out)

¿Qué estamos haciendo y por qué?

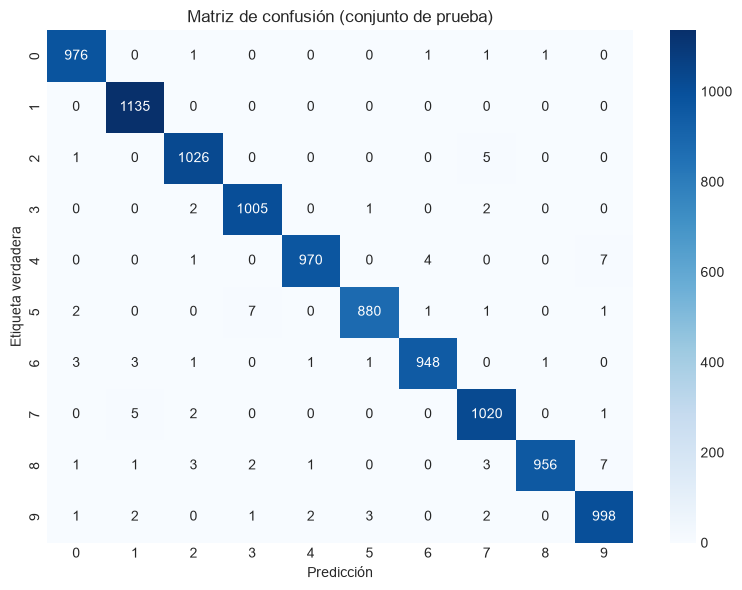
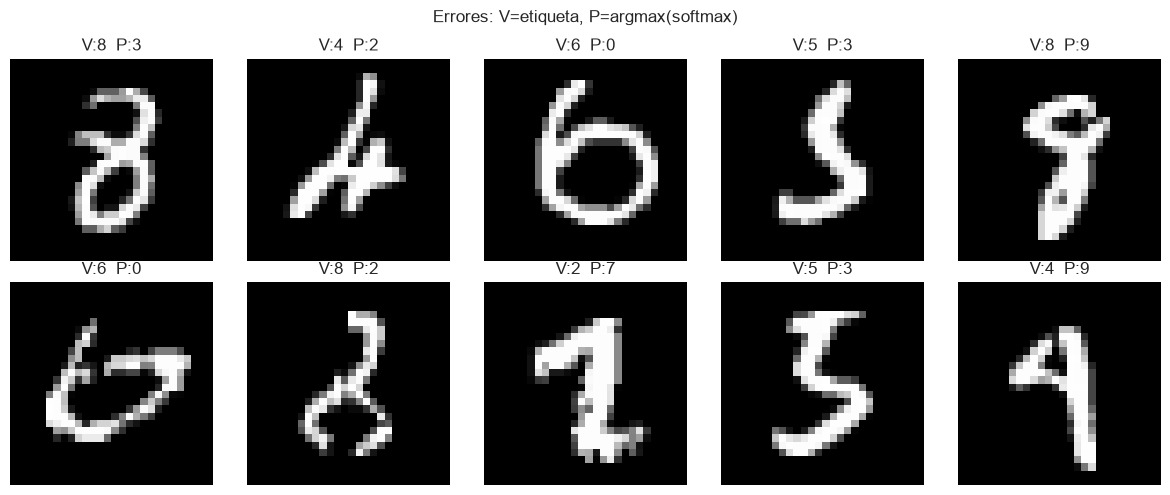
Estimar el error de generalización con 10,000 imágenes que nunca recibieron gradiente, ni criterio de early stopping, en este script. El reporte por clase y la matriz de confusión localizan dónde se confunde el modelo; la galería de errores da caras a los hard examples bajo el inductive bias actual.

Interpretación reforzada

La exactitud agregada es un resumen; la matriz revela la estructura de sustituciones (p. ej. 4 con 9, 3 con 5). Pares frecuentes fuera de la diagonal indican qué patrones compartidos o qué invariancias faltan (poco augmentation, geometría rígida, etc.): la diagonal sola no basta para argumentar el límite del modelo.

Reto técnico

Elija un par de clases (i, j) con confusión visible en la matriz. Proponga una hipótesis geométrica o caligráfica sobre por qué el modelo sustituye i por j, sin añadir más datos a la análisis que los ya previstos en el protocolo (evitar peeking informal en prueba).

# *Hold-out* final: riesgo empírico + predicción *a posteriori* (softmax + argmax)
perdida_prueba, exactitud_prueba = modelo.evaluate(x_prueba, y_prueba_onehot, verbose=0)
print(f"Pérdida en prueba: {perdida_prueba:.4f}")
print(f"Exactitud en prueba: {exactitud_prueba * 100:.2f} %")

probabilidades_prueba = modelo.predict(x_prueba, batch_size=256, verbose=0)
predicciones = np.argmax(probabilidades_prueba, axis=1)

print("\nReporte de clasificación (prueba):")
print(classification_report(y_prueba, predicciones, digits=4))
Pérdida en prueba: 0.0263
Exactitud en prueba: 99.14 %

Reporte de clasificación (prueba):
              precision    recall  f1-score   support

           0     0.9919    0.9959    0.9939       980
           1     0.9904    1.0000    0.9952      1135
           2     0.9903    0.9942    0.9923      1032
           3     0.9901    0.9950    0.9926      1010
           4     0.9959    0.9878    0.9918       982
           5     0.9944    0.9865    0.9904       892
           6     0.9937    0.9896    0.9916       958
           7     0.9865    0.9922    0.9893      1028
           8     0.9979    0.9815    0.9896       974
           9     0.9842    0.9891    0.9867      1009

    accuracy                         0.9914     10000
   macro avg     0.9915    0.9912    0.9913     10000
weighted avg     0.9914    0.9914    0.9914     10000
# Frecuencia conjunta (verdadero, predicho); fuera de diagonal = reemplazos de etiqueta
matriz_confusion = confusion_matrix(y_prueba, predicciones)
plt.figure(figsize=(8, 6))
sns.heatmap(
    matriz_confusion, annot=True, fmt="d", cmap="Blues", cbar=True,
    xticklabels=range(10), yticklabels=range(10),
)
plt.xlabel("Predicción")
plt.ylabel("Etiqueta verdadera")
plt.title("Matriz de confusión (conjunto de prueba)")
plt.tight_layout()
plt.show()

indices_prediccion_erronea = np.where(predicciones != y_prueba)[0]
n_muestras = min(10, len(indices_prediccion_erronea))
if n_muestras > 0:
    fig, axes = plt.subplots(2, 5, figsize=(12, 5))
    axes = axes.ravel()
    for i in range(n_muestras):
        j = indices_prediccion_erronea[i]
        axes[i].imshow(x_prueba[j].squeeze(), cmap="gray")
        axes[i].set_title(f"V:{y_prueba[j]}  P:{predicciones[j]}")
        axes[i].axis("off")
    plt.suptitle("Errores: V=etiqueta, P=argmax(softmax)")
    plt.tight_layout()
    plt.show()
else:
    print("Cero errores bajo argmax (posible, raro, en MNIST con esta pila).")

11. Conclusiones, limitaciones y extensiones

Síntesis (argumentada, no inventario de secciones)

  • Local → global: los kernels compartidos responden por parche; el pooling y la profundidad ensamblan evidencia; Dense + softmax deciden la clase. Primero la red “ve” candidatos de patrón; después “reconoce” un código discriminativo.

  • CNN vs MLP: no es un concurso de número de parámetros sin contexto; es alinear el sesgo inductivo con la geometría 2D.

  • Límite MNIST: baja resolución y poca variabilidad real. Es un buen laboratorio; no basta como única certificación de robustez.

Cierre fuerte: una CNN bien diseñada y entrenada no produce solo un escalar de test; produce mapas intermedios que se pueden defender en un examen oral. El código es medio para una tesis sobre representación, no un fin en sí.

Extensiones típicas (sin diluir el mensaje): data augmentation; arquitecturas más profundas con residuo; export TFLite / ONNX para MLOps. Siempre con hipótesis y riesgo evaluado.

12. Guardado del modelo, carga e inferencia sobre un ejemplo aleatorio

¿Qué estamos haciendo y por qué?

Cerrar el ciclo propio de machine learning reproducible: serializar el grafo y los pesos (artefacto versionable, p. ej. .keras en Keras o SavedModel de TensorFlow), cargar en otra sesión o proceso y ejecutar inferencia leyendo el vector softmax completo, no solo el argmax (la distribución entera informa de incertidumbre y admite umbrales de rechazo de predicción en aplicaciones sensibles).

Reto técnico

  • Relacione entropía de softmax baja vs. alta con un criterio de confianza mínima (reject option): cuándo tendría sentido abstenerse de decidir.
# Formato Keras: carpeta fija bajo el directorio de trabajo del cuaderno
carpeta_modelos = os.path.join(os.getcwd(), "saved_models")
os.makedirs(carpeta_modelos, exist_ok=True)
ruta_modelo = os.path.join(carpeta_modelos, "mnist_cnn.keras")

modelo.save(ruta_modelo)
print(f"Modelo guardado en: {ruta_modelo}")
print(f"Tamaño en disco (aprox.): {os.path.getsize(ruta_modelo) / 1024:.1f} KiB")
Modelo guardado en: c:\Users\wilde\Dropbox\bit-blog\deep-learning\06b-cnn-mnist\saved_models\mnist_cnn.keras
Tamaño en disco (aprox.): 2680.4 KiB
# Deserialización: nuevo objeto de modelo, sin requerir el grafo aún en memoria
modelo_cargado = keras.models.load_model(ruta_modelo)
print("Modelo cargado. Nombre:", modelo_cargado.name)
modelo_cargado.summary()
Modelo cargado. Nombre: mnist_cnn
Model: "mnist_cnn"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d_1 (Conv2D)               │ (None, 26, 26, 32)     │           320 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ activation (Activation)         │ (None, 26, 26, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ pool1 (MaxPooling2D)            │ (None, 13, 13, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_2 (Conv2D)               │ (None, 11, 11, 64)     │        18,496 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ activation_1 (Activation)       │ (None, 11, 11, 64)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ pool2 (MaxPooling2D)            │ (None, 5, 5, 64)       │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten)               │ (None, 1600)           │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense1 (Dense)                  │ (None, 128)            │       204,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout)               │ (None, 128)            │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ output (Dense)                  │ (None, 10)             │         1,290 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 675,104 (2.58 MB)
 Trainable params: 225,034 (879.04 KB)
 Non-trainable params: 0 (0.00 B)
 Optimizer params: 450,070 (1.72 MB)
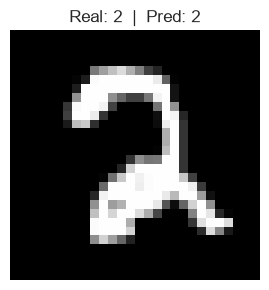
# Inferencia en una fila al azar de x_prueba (misma normalización y forma que en el entrenamiento)
generador_aleatorio = np.random.default_rng(SEMILLA)
indice_aleatorio = int(generador_aleatorio.integers(0, len(x_prueba)))

tensor_muestra_aleatoria = x_prueba[indice_aleatorio:indice_aleatorio + 1]  # (1, 28, 28, 1)
etiqueta_real = int(y_prueba[indice_aleatorio])

probabilidades = modelo_cargado.predict(tensor_muestra_aleatoria, verbose=0)[0]
digito_predicho = int(np.argmax(probabilidades))
confianza = float(probabilidades[digito_predicho])

print("--- Inferencia (modelo cargado desde disco) ---")
print(f"Índice en x_prueba: {indice_aleatorio}")
print(f"Etiqueta verdadera: {etiqueta_real}")
print(f"Dígito predicho:   {digito_predicho}   (confianza: {confianza:.4f})")
print("\nProbabilidades por clase 0–9:")
for d in range(10):
    print(f"  {d}: {probabilidades[d]:.4f}")

fig, ax = plt.subplots(figsize=(3, 3))
ax.imshow(tensor_muestra_aleatoria[0].squeeze(), cmap="gray")
ax.set_title(f"Real: {etiqueta_real}  |  Pred: {digito_predicho}")
ax.axis("off")
plt.tight_layout()
plt.show()
--- Inferencia (modelo cargado desde disco) ---
Índice en x_prueba: 892
Etiqueta verdadera: 2
Dígito predicho:   2   (confianza: 1.0000)

Probabilidades por clase 0–9:
  0: 0.0000
  1: 0.0000
  2: 1.0000
  3: 0.0000
  4: 0.0000
  5: 0.0000
  6: 0.0000
  7: 0.0000
  8: 0.0000
  9: 0.0000

Imagen propia leída desde disco

¿Qué estamos haciendo y por qué?

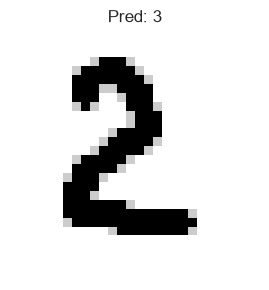
Llevar el mismo preprocesado (tamaño 28×28, escala de grises, rango [0, 1]) a un archivo en disco: cualquier inversión de contraste afecta al vector softmax; el parámetro invertir_fondo solo corrige estilo de trazo, no añade conocimiento a priori al modelo.

Coloque allí un PNG o JPG con un único dígito, estilo MNIST: fondo claro y trazo oscuro. La celda siguiente carga la imagen, la redimensiona a 28×28 y normaliza. Si el dibujo fuese claro sobre oscuro, use invertir_fondo=True en cargar_y_normalizar_imagen_mnist.

Reto técnico

  • Añada un píxel de ruido al tensor normalizado y observe el efecto (si es posible) en el argmax: vincule con sensibilidad local de la frontera y con literatura de ejemplos adversarios de baja norma.
from tensorflow.keras.utils import load_img, img_to_array

RUTA_IMAGEN = os.path.join(os.getcwd(), "mi_digito_mnist.png")


def cargar_y_normalizar_imagen_mnist(ruta, invertir_fondo=False):
    """Alinea la imagen con la representación (1, 28, 28, 1) y rango [0, 1] usados en el entrenamiento."""
    imagen = load_img(ruta, color_mode="grayscale", target_size=(28, 28))
    tensor = img_to_array(imagen).astype("float32") / 255.0
    if invertir_fondo:
        tensor = 1.0 - tensor
    return np.expand_dims(tensor, axis=0)


if not os.path.isfile(RUTA_IMAGEN):
    print(
        f"No se encontró: {RUTA_IMAGEN}\n"
        "Guarde allí su imagen o cambie la variable RUTA_IMAGEN y vuelva a ejecutar."
    )
else:
    tensor_desde_archivo = cargar_y_normalizar_imagen_mnist(RUTA_IMAGEN, invertir_fondo=False)
    probabilidades_desde_archivo = modelo_cargado.predict(tensor_desde_archivo, verbose=0)[0]
    digito_predicho_desde_archivo = int(np.argmax(probabilidades_desde_archivo))
    print(f"Archivo: {RUTA_IMAGEN}")
    print(
        f"Dígito predicho: {digito_predicho_desde_archivo}  "
        f"(confianza: {probabilidades_desde_archivo[digito_predicho_desde_archivo]:.4f})"
    )
    print("Probabilidades 0–9:", np.round(probabilidades_desde_archivo, 4))
    fig, ax = plt.subplots(figsize=(3, 3))
    ax.imshow(tensor_desde_archivo[0].squeeze(), cmap="gray")
    ax.set_title(f"Pred: {digito_predicho_desde_archivo}")
    ax.axis("off")
    plt.tight_layout()
    plt.show()
Archivo: c:\Users\wilde\Dropbox\bit-blog\deep-learning\06b-cnn-mnist\mi_digito_mnist.png
Dígito predicho: 3  (confianza: 0.4086)
Probabilidades 0–9: [1.300e-03 3.500e-03 1.460e-01 4.086e-01 3.869e-01 2.000e-04 5.000e-04
 5.240e-02 4.000e-04 3.000e-04]

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.