import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


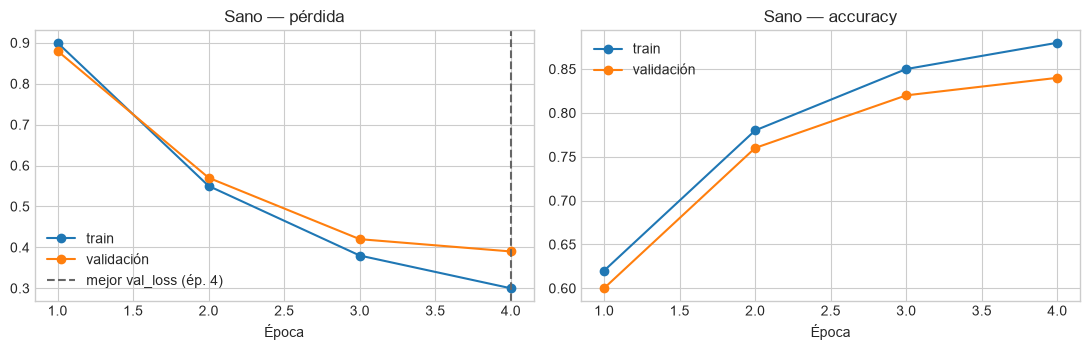
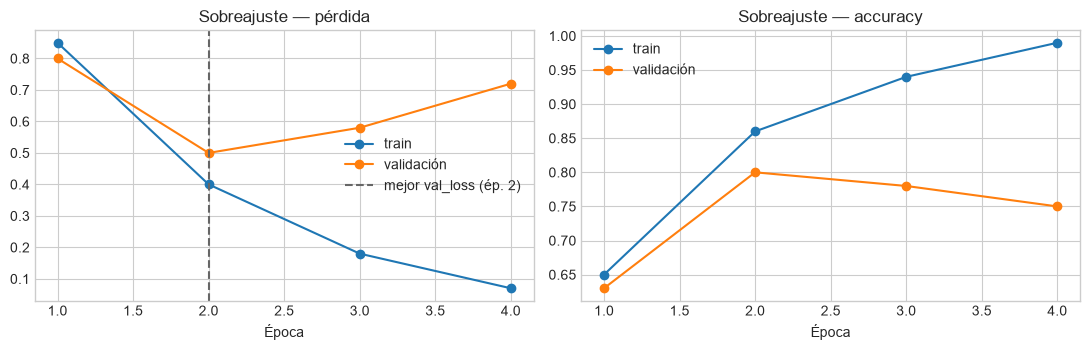
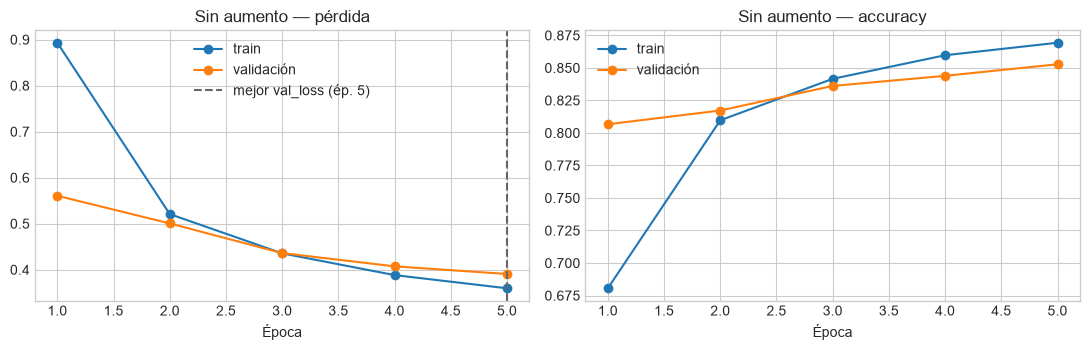
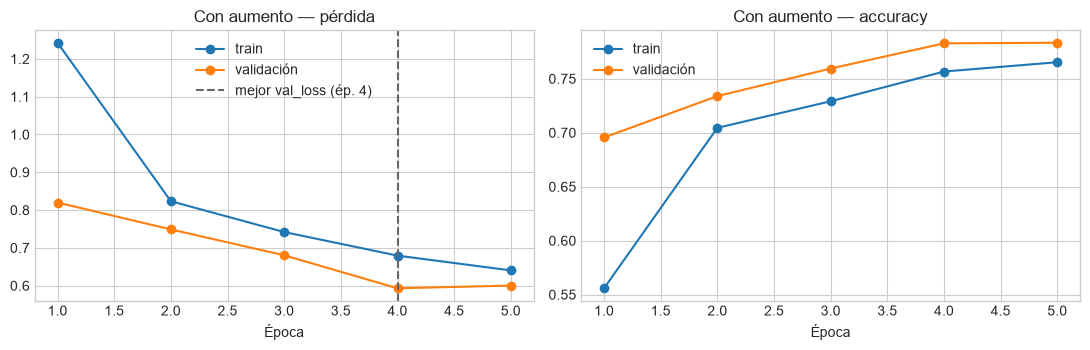
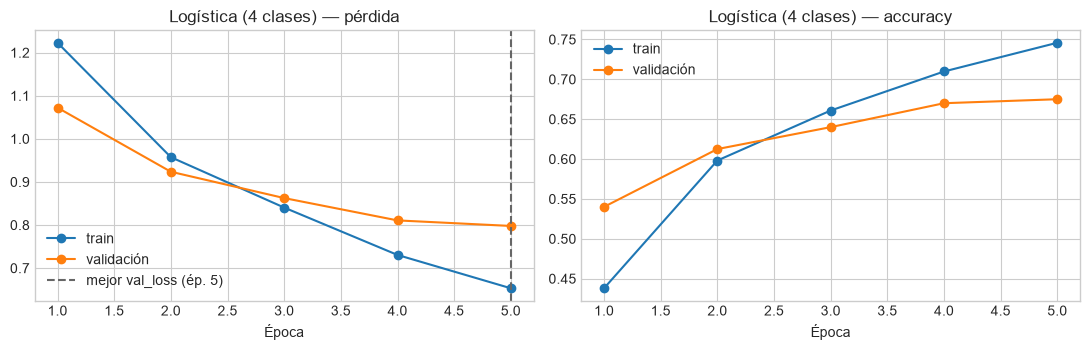
def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


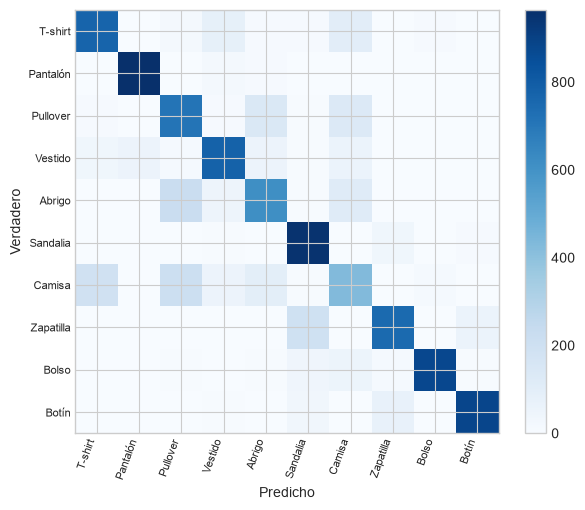
def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
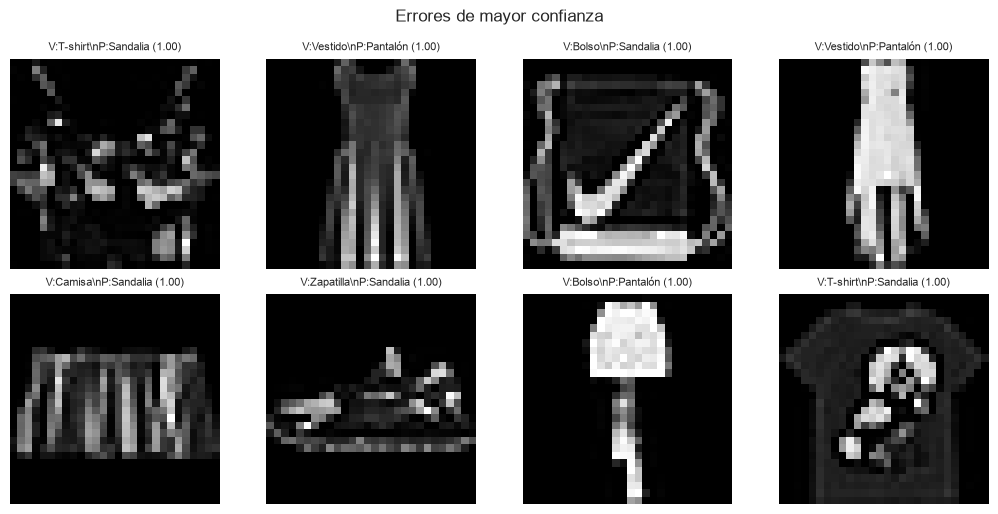
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm