Redes Recurrentes (RNN)

deep-learning
rnn
secuencias
Secuencias, estado oculto y lectura de curvas en predicción temporal y texto.
Author

Wilder Ramírez Delgado

Published

September 6, 2026

Redes Recurrentes (RNN)

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo pasamos de vectores fijos a secuencias: definimos el estado oculto, entrenamos predicciones temporales y de texto, y leemos pérdidas y reportes como se leería un tablero de operaciones.

1. Introducción

Una MLP recibe forma fija. Ventas diarias, sensores y reseñas tienen orden. La RNN comparte pesos en el tiempo y comprime el pasado en un estado h_t.

Pregunta: qué gana la memoria compartida frente a aplanar la ventana, y cómo se ve eso en el history.

2. Qué ya se conoce

Neurona, MLP, pérdida, backpropagation, Train/Val/Test. Se extiende a BPTT; no se vuelve a derivar el SGD.

3. Protocolo de lectura de métricas

Mejor val_loss, gap train−val, reporte por clase o MSE de test, y solo después una decisión. El último print de fit no es el acta.

import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm
TensorFlow: 2.21.0
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU: ninguna (CPU)

Idea clave

Una curva sin el índice de la mejor época es un dibujo. El informe empieza cuando se declara qué época se está reportando.

4. Laboratorio de lectura (history sintético)

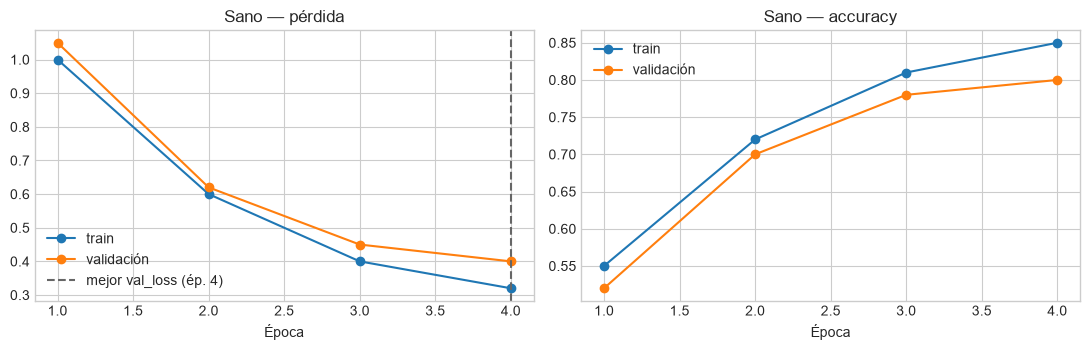
sano={'loss':[1.0,0.6,0.4,0.32],'val_loss':[1.05,0.62,0.45,0.40],'accuracy':[0.55,0.72,0.81,0.85],'val_accuracy':[0.52,0.70,0.78,0.80]}
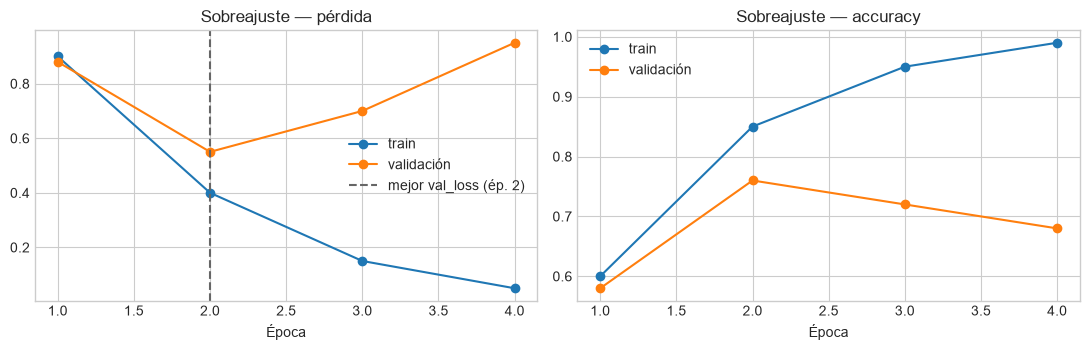
sobre={'loss':[0.9,0.4,0.15,0.05],'val_loss':[0.88,0.55,0.70,0.95],'accuracy':[0.6,0.85,0.95,0.99],'val_accuracy':[0.58,0.76,0.72,0.68]}
print('SANO'); diagnostico_entrenamiento(sano,'sano'); curvas_entrenamiento(sano,'Sano')
print('SOBRE'); diagnostico_entrenamiento(sobre,'sobre'); curvas_entrenamiento(sobre,'Sobreajuste')
SANO
modelo                  sano
epocas_corridas            4
mejor_epoca_val_loss       4
min_val_loss             0.4
val_loss_final           0.4
train_loss_en_mejor     0.32
train_loss_final        0.32
delta_val_tras_mejor     0.0
gap_loss_mejor          0.08
gap_loss_final          0.08
train_acc_mejor         0.85
val_acc_mejor            0.8
train_acc_final         0.85
val_acc_final            0.8
gap_acc_mejor           0.05
gap_acc_final           0.05

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

SOBRE
modelo                  sobre
epocas_corridas             4
mejor_epoca_val_loss        2
min_val_loss             0.55
val_loss_final           0.95
train_loss_en_mejor       0.4
train_loss_final         0.05
delta_val_tras_mejor      0.4
gap_loss_mejor           0.15
gap_loss_final            0.9
train_acc_mejor          0.85
val_acc_mejor            0.76
train_acc_final          0.99
val_acc_final            0.68
gap_acc_mejor            0.09
gap_acc_final            0.31

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

Interpretación

En el sobreajuste, reportar la época 4 como si fuera el modelo es un error de gobernanza. El checkpoint razonable es la época de mínima val_loss.

5. Datos secuenciales en la práctica

Ventas, IoT y texto no son ‘otro dataset’: son otro contrato de independencia. El día t no es i.i.d. respecto del día t−1. Por eso el split se hace en el tiempo, no al azar entre ventanas solapadas sin cuidado.

Idea clave

El sesgo de una RNN: la misma regla en cada instante y un estado de tamaño fijo. Si el estado es pequeño o inestable, olvida.

6. Caso 1 — Demanda diaria de un SKU (serie sintética)

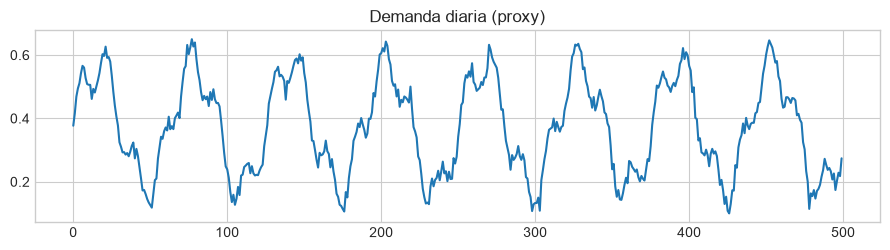
Una senoide con ruido y una cresta semanal es el análogo de un producto con estacionalidad. Predicción: el siguiente día a partir de 20 previos. En retail esto alimenta reposición, no un leaderboard.

T=500
t=np.linspace(0,50,T)
demanda=np.sin(t)+0.35*np.sin(t*3.5)+0.08*np.random.default_rng(0).normal(size=T)
demanda=0.55*(demanda-demanda.min())/(demanda.max()-demanda.min())+0.1
VENTANA=20
def ventanas(y,L):
    X=np.array([y[i:i+L] for i in range(len(y)-L)],dtype='float32')[...,None]
    dest=np.array(y[L:],dtype='float32')
    return X,dest
X,y=ventanas(demanda,VENTANA)
n=int(0.7*len(X))
Xtr,Xte,ytr,yte=X[:n],X[n:],y[:n],y[n:]
print(Xtr.shape,Xte.shape)
plt.figure(figsize=(9,2.6)); plt.plot(demanda); plt.title('Demanda diaria (proxy)'); plt.tight_layout(); plt.show()
(336, 20, 1) (144, 20, 1)

Interpretación de la gráfica

La cresta periódica es el ‘fin de semana’. Si el modelo solo aprende el seno lento, el MSE puede verse decente y aun así fallar el pico de reposición.

7. RNN de demanda y entrenamiento

rnn=tf.keras.Sequential([tf.keras.layers.SimpleRNN(16,input_shape=(VENTANA,1)),tf.keras.layers.Dense(1)])
rnn.compile(optimizer='adam',loss='mse',metrics=[tf.keras.metrics.RootMeanSquaredError(name='rmse')])
h_dem=rnn.fit(Xtr,ytr,validation_split=0.15,epochs=12,batch_size=32,verbose=1)
Epoch 1/12
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
1/9 ━━━━━━━━━━━━━━━━━━━━ 18s 2s/step - loss: 0.1577 - rmse: 0.3971

9/9 ━━━━━━━━━━━━━━━━━━━━ 3s 70ms/step - loss: 0.0723 - rmse: 0.2689 - val_loss: 0.0058 - val_rmse: 0.0761

Epoch 2/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 64ms/step - loss: 0.0054 - rmse: 0.0738

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 22ms/step - loss: 0.0091 - rmse: 0.0953 - val_loss: 0.0120 - val_rmse: 0.1096

Epoch 3/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 48ms/step - loss: 0.0121 - rmse: 0.1098

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - loss: 0.0055 - rmse: 0.0740 - val_loss: 0.0032 - val_rmse: 0.0565

Epoch 4/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 68ms/step - loss: 0.0036 - rmse: 0.0598

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - loss: 0.0037 - rmse: 0.0612 

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - loss: 0.0037 - rmse: 0.0612 - val_loss: 0.0037 - val_rmse: 0.0607

Epoch 5/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 45ms/step - loss: 0.0045 - rmse: 0.0671

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - loss: 0.0031 - rmse: 0.0559 

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 22ms/step - loss: 0.0031 - rmse: 0.0559 - val_loss: 0.0030 - val_rmse: 0.0546

Epoch 6/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 53ms/step - loss: 0.0031 - rmse: 0.0554

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - loss: 0.0026 - rmse: 0.0512 - val_loss: 0.0032 - val_rmse: 0.0562

Epoch 7/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 50ms/step - loss: 0.0031 - rmse: 0.0552

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 21ms/step - loss: 0.0024 - rmse: 0.0495 - val_loss: 0.0027 - val_rmse: 0.0519

Epoch 8/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 77ms/step - loss: 0.0027 - rmse: 0.0517

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - loss: 0.0023 - rmse: 0.0475 - val_loss: 0.0026 - val_rmse: 0.0506

Epoch 9/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 56ms/step - loss: 0.0025 - rmse: 0.0504

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 26ms/step - loss: 0.0022 - rmse: 0.0464 - val_loss: 0.0025 - val_rmse: 0.0497

Epoch 10/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 65ms/step - loss: 0.0024 - rmse: 0.0488

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - loss: 0.0021 - rmse: 0.0454 - val_loss: 0.0024 - val_rmse: 0.0488

Epoch 11/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 44ms/step - loss: 0.0023 - rmse: 0.0478

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - loss: 0.0020 - rmse: 0.0446 - val_loss: 0.0023 - val_rmse: 0.0479

Epoch 12/12


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 44ms/step - loss: 0.0022 - rmse: 0.0469

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - loss: 0.0019 - rmse: 0.0439 - val_loss: 0.0022 - val_rmse: 0.0471

8. Informe de la RNN de demanda

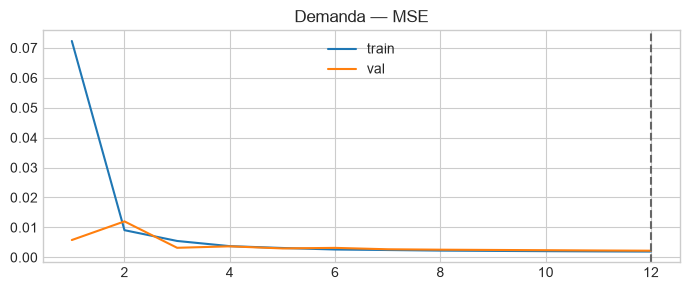
En regresión no hay accuracy. Se lee mse/val_mse (o loss) y RMSE en la misma escala que la demanda normalizada.

print('claves history', list(h_dem.history.keys()))
s=series_history(h_dem)
i=int(np.argmin(s['val_loss']))
print(pd.Series({
 'mejor_epoca_val_loss':i+1,'min_val_loss':s['val_loss'][i],
 'val_loss_final':s['val_loss'][-1],'train_loss_final':s['loss'][-1],
 'gap_final':s['val_loss'][-1]-s['loss'][-1],
}).to_string())
ep=np.arange(1,len(s['loss'])+1)
plt.figure(figsize=(7,3)); plt.plot(ep,s['loss'],label='train'); plt.plot(ep,s['val_loss'],label='val')
plt.axvline(i+1,ls='--',color='0.4'); plt.legend(); plt.title('Demanda — MSE');
plt.tight_layout(); plt.show()
pred=rnn.predict(Xte,verbose=0).ravel()
rmse=float(np.sqrt(np.mean((pred-yte)**2)))
print(f'RMSE test={rmse:.4f}  (demanda en [0.1,0.65] aprox.)')
claves history ['loss', 'rmse', 'val_loss', 'val_rmse']
mejor_epoca_val_loss    12.000000
min_val_loss             0.002221
val_loss_final           0.002221
train_loss_final         0.001928
gap_final                0.000293

RMSE test=0.0421  (demanda en [0.1,0.65] aprox.)
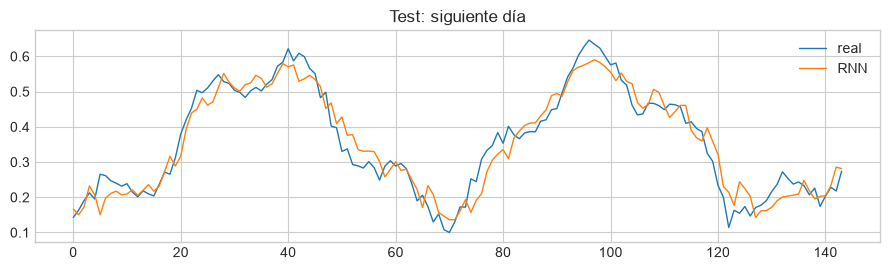
fig,ax=plt.subplots(figsize=(9,2.8))
ax.plot(yte,label='real',lw=1); ax.plot(pred,label='RNN',lw=1)
ax.set_title('Test: siguiente día'); ax.legend(); plt.tight_layout(); plt.show()
print('Si los picos quedan sistemáticamente bajos, el MSE global esconde el error que duele a inventario.')

Si los picos quedan sistemáticamente bajos, el MSE global esconde el error que duele a inventario.

Interpretación

Un RMSE de 0.05 sobre una serie en [0.1, 0.65] es otra cosa que 0.05 sobre precios en miles. Siempre ancle la métrica a la unidad de negocio (aquí, fracción de demanda normalizada).

9. Baseline ingenuo: repetir el último día

Toda RNN de series debe ganar a «mañana = hoy». Si no gana, el fit no justificó la arquitectura.

naive=Xte[:,-1,0]
rmse_n=float(np.sqrt(np.mean((naive-yte)**2)))
print(f'RMSE naive (último valor)={rmse_n:.4f}  RMSE RNN={rmse:.4f}  delta={rmse_n-rmse:+.4f}')
print('Delta positivo: la RNN aportó. Delta ≈ 0: suficiente una regla de persistencia.')
RMSE naive (último valor)=0.0313  RMSE RNN=0.0421  delta=-0.0108
Delta positivo: la RNN aportó. Delta ≈ 0: suficiente una regla de persistencia.

10. Arquitectura: estado oculto

h_t = tanh(W_x x_t + W_h h_{t-1} + b). W_h se reutiliza. El estado no guarda la secuencia: la comprime.

11. BPTT y el producto de jacobianos

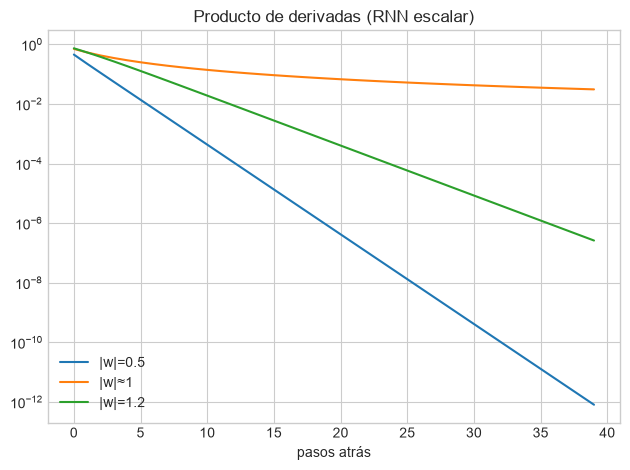
El error en T atraviesa W_h T veces. Si los factores son < 1, el pasado lejano deja de actualizarse.

def prod(w,pasos,h0=0.6):
    h=h0; acc=1.0; hist=[]
    for _ in range(pasos):
        h=np.tanh(w*h); acc*= (1-h**2)*w; hist.append(acc)
    return np.array(hist)
for w,lab in [(0.5,'|w|=0.5'),(0.99,'|w|≈1'),(1.2,'|w|=1.2')]:
    plt.semilogy(np.abs(prod(w,40))+1e-15,label=lab)
plt.legend(); plt.title('Producto de derivadas (RNN escalar)'); plt.xlabel('pasos atrás')
plt.tight_layout(); plt.show()

Idea clave

El olvido no es un bug de Keras. Es un producto de jacobianos. LSTM/GRU (sesión 10) alivian ese producto; no lo derogan por decreto.

12. Caso 2 — Sensor de temperatura de cámara fría

Misma RNN, otra semántica: un sensor con deriva lenta + picos de apertura de puerta. El MSE ahora se lee como riesgo de cadena de frío.

tt=np.linspace(0,80,480)
base=4+0.4*np.sin(tt/6)
picos=(np.sin(tt*2.2)>0.92)*2.5
temp=base+picos+0.15*np.random.default_rng(1).normal(size=len(tt))
Xs,ys=ventanas(temp,VENTANA)
ns=int(0.7*len(Xs))
rnn2=tf.keras.Sequential([tf.keras.layers.SimpleRNN(16,input_shape=(VENTANA,1)),tf.keras.layers.Dense(1)])
rnn2.compile(optimizer='adam',loss='mse')
h_s=rnn2.fit(Xs[:ns],ys[:ns],validation_split=0.15,epochs=10,batch_size=32,verbose=1)
Epoch 1/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 16s 2s/step - loss: 18.3212

6/9 ━━━━━━━━━━━━━━━━━━━━ 0s 11ms/step - loss: 17.8642

9/9 ━━━━━━━━━━━━━━━━━━━━ 3s 71ms/step - loss: 17.8345 - val_loss: 18.4456

Epoch 2/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 50ms/step - loss: 15.5919

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 22ms/step - loss: 15.0930 - val_loss: 15.4456

Epoch 3/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 48ms/step - loss: 12.8716

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - loss: 12.2059 - val_loss: 11.9119

Epoch 4/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 71ms/step - loss: 9.7760

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 24ms/step - loss: 8.7398 - val_loss: 8.0893

Epoch 5/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 72ms/step - loss: 6.3683

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 26ms/step - loss: 5.8563 - val_loss: 6.1327

Epoch 6/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 73ms/step - loss: 4.5919

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - loss: 4.4544 

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 22ms/step - loss: 4.4544 - val_loss: 5.0530

Epoch 7/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 53ms/step - loss: 3.6502

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 21ms/step - loss: 3.6038 - val_loss: 4.2744

Epoch 8/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 48ms/step - loss: 2.9936

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - loss: 2.9723 - val_loss: 3.6520

Epoch 9/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 64ms/step - loss: 2.4898

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - loss: 2.4719 

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 24ms/step - loss: 2.4719 - val_loss: 3.1384

Epoch 10/10


1/9 ━━━━━━━━━━━━━━━━━━━━ 0s 56ms/step - loss: 2.0947

9/9 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - loss: 2.0720 - val_loss: 2.7160
s=series_history(h_s); i=int(np.argmin(s['val_loss']))
print('mejor epoca',i+1,'min val_mse',float(s['val_loss'][i]),'final',float(s['val_loss'][-1]))
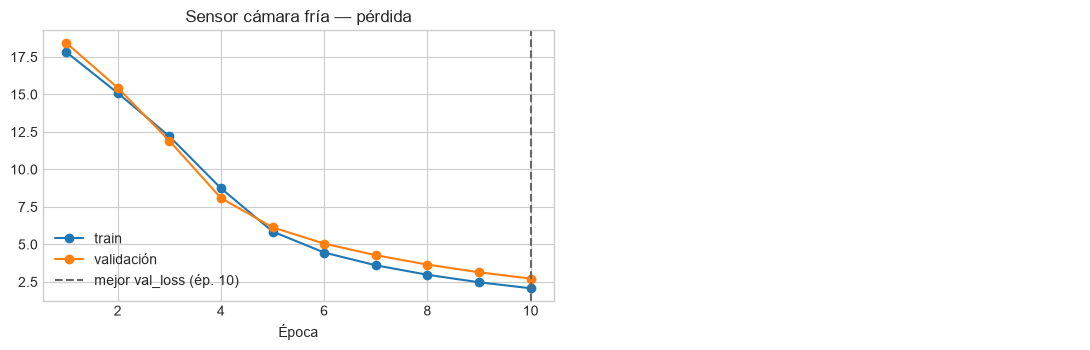
curvas_entrenamiento({'loss':s['loss'],'val_loss':s['val_loss']},'Sensor cámara fría')
ps=rnn2.predict(Xs[ns:],verbose=0).ravel()
print('RMSE test sensor', float(np.sqrt(np.mean((ps-ys[ns:])**2))))
mejor epoca 10 min val_mse 2.7159829139709473 final 2.7159829139709473

RMSE test sensor 1.2111884355545044

Interpretación

Si el modelo suaviza los picos de apertura, el RMSE puede ser aceptable y el evento (puerta abierta) quedar invisible. En frío, el error de los picos pesa más que el de la noche estable: conviene un MAE de cola o un umbral de alarma, no solo el MSE medio.

13. Caso 3 — Polaridad de reseñas (IMDB recortado)

Muchos a uno: 80 tokens, vocabulario 4000. Análogo a moderar opiniones de un marketplace. El recorte tira el final de reseñas largas: eso es una amenaza, no un detalle.

vocab,maxlen=4000,80
(xtr_t,ytr_t),(xte_t,yte_t)=tf.keras.datasets.imdb.load_data(num_words=vocab)
xtr_t=tf.keras.preprocessing.sequence.pad_sequences(xtr_t,maxlen=maxlen)
xte_t=tf.keras.preprocessing.sequence.pad_sequences(xte_t,maxlen=maxlen)
print(xtr_t.shape,'balance train',ytr_t.mean())
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/imdb.npz


       0/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0s/step

   16384/17464789 ━━━━━━━━━━━━━━━━━━━━ 1:03 4us/step

   49152/17464789 ━━━━━━━━━━━━━━━━━━━━ 50s 3us/step 

   81920/17464789 ━━━━━━━━━━━━━━━━━━━━ 47s 3us/step

  147456/17464789 ━━━━━━━━━━━━━━━━━━━━ 33s 2us/step

  221184/17464789 ━━━━━━━━━━━━━━━━━━━━ 25s 2us/step

  344064/17464789 ━━━━━━━━━━━━━━━━━━━━ 19s 1us/step

  507904/17464789 ━━━━━━━━━━━━━━━━━━━━ 14s 1us/step

  835584/17464789 ━━━━━━━━━━━━━━━━━━━━ 9s 1us/step 

 1302528/17464789 ━━━━━━━━━━━━━━━━━━━━ 6s 0us/step

 1900544/17464789 ━━━━━━━━━━━━━━━━━━━━ 4s 0us/step

 2506752/17464789 ━━━━━━━━━━━━━━━━━━━━ 3s 0us/step

 3096576/17464789 ━━━━━━━━━━━━━━━━━━━━ 3s 0us/step

 3694592/17464789 ━━━━━━━━━━━━━━━━━━━━ 2s 0us/step

 4284416/17464789 ━━━━━━━━━━━━━━━━━━━━ 2s 0us/step

 4882432/17464789 ━━━━━━━━━━━━━━━━━━━━ 2s 0us/step

 5480448/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 6086656/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 6684672/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 7282688/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 7888896/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 8495104/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 9093120/17464789 ━━━━━━━━━━━━━━━━━━━━ 1s 0us/step

 9691136/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

10297344/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

10903552/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

11493376/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

12099584/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

12689408/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

13295616/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

13901824/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

14499840/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

15097856/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

15687680/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

16293888/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

16883712/17464789 ━━━━━━━━━━━━━━━━━━━━ 0s 0us/step

17464789/17464789 ━━━━━━━━━━━━━━━━━━━━ 2s 0us/step

(25000, 80) balance train 0.5

14. Entrenamiento de la RNN de texto

txt=tf.keras.Sequential([
 tf.keras.layers.Embedding(vocab,32),
 tf.keras.layers.SimpleRNN(32),
 tf.keras.layers.Dense(1,activation='sigmoid')])
txt.compile(optimizer='adam',loss='binary_crossentropy',metrics=['accuracy'])
h_t=txt.fit(xtr_t[:8000],ytr_t[:8000],validation_split=0.15,epochs=4,batch_size=64,verbose=1)
Epoch 1/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 5:12 3s/step - accuracy: 0.5312 - loss: 0.6902

  3/107 ━━━━━━━━━━━━━━━━━━━━ 2s 25ms/step - accuracy: 0.4844 - loss: 0.6988

  6/107 ━━━━━━━━━━━━━━━━━━━━ 2s 22ms/step - accuracy: 0.4896 - loss: 0.6950

 10/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5109 - loss: 0.6943

 15/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.5115 - loss: 0.6947

 20/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5188 - loss: 0.6939

 24/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5150 - loss: 0.6943

 28/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5084 - loss: 0.6955

 32/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5078 - loss: 0.6952

 36/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5061 - loss: 0.6950

 40/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5059 - loss: 0.6950

 44/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5082 - loss: 0.6950

 48/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5088 - loss: 0.6949

 52/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5069 - loss: 0.6948

 56/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5053 - loss: 0.6948

 60/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5047 - loss: 0.6944

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5085 - loss: 0.6939

 68/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5124 - loss: 0.6934

 71/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5134 - loss: 0.6932

 75/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5146 - loss: 0.6930

 79/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5164 - loss: 0.6928

 83/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5200 - loss: 0.6921

 87/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5187 - loss: 0.6925

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5196 - loss: 0.6923

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5194 - loss: 0.6922

 97/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5208 - loss: 0.6920

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5217 - loss: 0.6917

105/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5240 - loss: 0.6913

107/107 ━━━━━━━━━━━━━━━━━━━━ 5s 22ms/step - accuracy: 0.5238 - loss: 0.6912 - val_accuracy: 0.5442 - val_loss: 0.6850

Epoch 2/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 8s 80ms/step - accuracy: 0.7812 - loss: 0.6379

  4/107 ━━━━━━━━━━━━━━━━━━━━ 2s 20ms/step - accuracy: 0.8203 - loss: 0.6296

  7/107 ━━━━━━━━━━━━━━━━━━━━ 2s 20ms/step - accuracy: 0.8237 - loss: 0.6259

 11/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.8111 - loss: 0.6233

 15/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8062 - loss: 0.6164

 19/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.7821 - loss: 0.6143

 23/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.7683 - loss: 0.6136

 27/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.7564 - loss: 0.6121

 32/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.7412 - loss: 0.6128

 36/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.7348 - loss: 0.6124

 40/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7273 - loss: 0.6131

 44/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7266 - loss: 0.6127

 48/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7223 - loss: 0.6134

 52/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7169 - loss: 0.6149

 55/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7119 - loss: 0.6169

 59/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7060 - loss: 0.6193

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.7014 - loss: 0.6207

 69/107 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.7018 - loss: 0.6207

 73/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6973 - loss: 0.6225

 77/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6960 - loss: 0.6227

 81/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6966 - loss: 0.6225

 85/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6958 - loss: 0.6226

 89/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6938 - loss: 0.6236

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6920 - loss: 0.6242

 98/107 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.6931 - loss: 0.6239

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6931 - loss: 0.6235

105/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.6936 - loss: 0.6223

107/107 ━━━━━━━━━━━━━━━━━━━━ 2s 17ms/step - accuracy: 0.6938 - loss: 0.6218 - val_accuracy: 0.5608 - val_loss: 0.6830

Epoch 3/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 1:23 783ms/step - accuracy: 0.8594 - loss: 0.5103

  4/107 ━━━━━━━━━━━━━━━━━━━━ 2s 23ms/step - accuracy: 0.8516 - loss: 0.4952   

  7/107 ━━━━━━━━━━━━━━━━━━━━ 2s 23ms/step - accuracy: 0.8616 - loss: 0.4977

 11/107 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.8679 - loss: 0.4871

 15/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.8667 - loss: 0.4607

 19/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.8758 - loss: 0.4324

 23/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.8825 - loss: 0.4173

 27/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8744 - loss: 0.4231

 31/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8745 - loss: 0.4190

 35/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8719 - loss: 0.4133

 38/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8746 - loss: 0.4087

 42/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8728 - loss: 0.4074

 46/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8716 - loss: 0.4072

 50/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8712 - loss: 0.4064

 54/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8669 - loss: 0.4113

 58/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8648 - loss: 0.4120

 63/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8641 - loss: 0.4131

 66/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8620 - loss: 0.4151

 70/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8580 - loss: 0.4176

 75/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8527 - loss: 0.4210

 79/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8509 - loss: 0.4218

 83/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8483 - loss: 0.4233

 87/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8450 - loss: 0.4260

 91/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8439 - loss: 0.4268

 95/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8419 - loss: 0.4279

 99/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8433 - loss: 0.4273

103/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8439 - loss: 0.4267

105/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.8446 - loss: 0.4256

107/107 ━━━━━━━━━━━━━━━━━━━━ 3s 18ms/step - accuracy: 0.8451 - loss: 0.4246 - val_accuracy: 0.5583 - val_loss: 0.7323

Epoch 4/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 6s 57ms/step - accuracy: 0.9844 - loss: 0.2695

  4/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.9414 - loss: 0.2837

  8/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9238 - loss: 0.2904

 11/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9332 - loss: 0.2818

 15/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9375 - loss: 0.2598

 19/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9359 - loss: 0.2493

 22/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9268 - loss: 0.2558

 25/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9256 - loss: 0.2510

 29/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9310 - loss: 0.2431

 33/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9328 - loss: 0.2417

 37/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9299 - loss: 0.2435

 41/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.9268 - loss: 0.2468

 45/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9170 - loss: 0.2579

 49/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9123 - loss: 0.2649

 53/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9104 - loss: 0.2688

 57/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9093 - loss: 0.2710

 61/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9103 - loss: 0.2696

 65/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9111 - loss: 0.2689

 69/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9119 - loss: 0.2691

 73/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9129 - loss: 0.2698

 77/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9127 - loss: 0.2704

 80/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9121 - loss: 0.2716

 83/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9123 - loss: 0.2723

 87/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9125 - loss: 0.2729

 91/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9131 - loss: 0.2725

 95/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9125 - loss: 0.2729

 98/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9136 - loss: 0.2710

102/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9154 - loss: 0.2684

106/107 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.9172 - loss: 0.2658

107/107 ━━━━━━━━━━━━━━━━━━━━ 2s 17ms/step - accuracy: 0.9174 - loss: 0.2653 - val_accuracy: 0.5850 - val_loss: 0.7808

15. Informe de polaridad

fila=diagnostico_entrenamiento(h_t,'RNN IMDB')
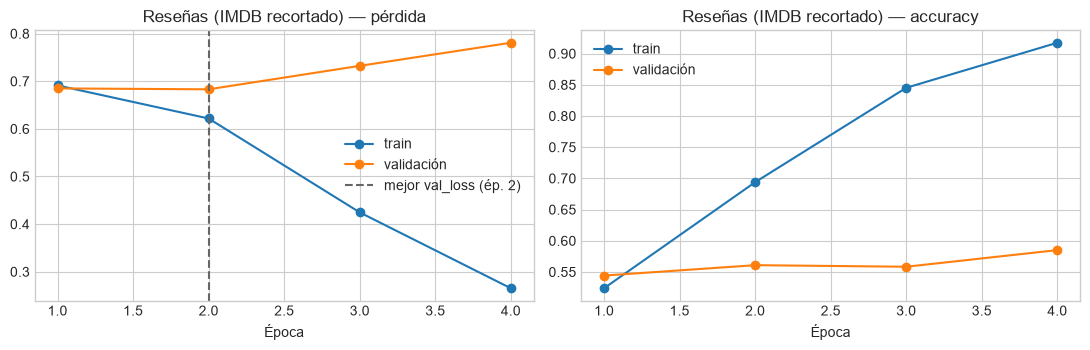
curvas_entrenamiento(h_t,'Reseñas (IMDB recortado)')
loss,acc=txt.evaluate(xte_t[:4000],yte_t[:4000],verbose=0)
print(f'TEST acc={acc:.4f} loss={loss:.4f}  azar=0.50  delta={acc-0.5:+.4f}')
probs=txt.predict(xte_t[:4000],verbose=0).ravel()
hat=(probs>=0.5).astype(int)
print(classification_report(yte_t[:4000],hat,target_names=['neg','pos'],digits=4))
modelo                  RNN IMDB
epocas_corridas                4
mejor_epoca_val_loss           2
min_val_loss            0.683038
val_loss_final          0.780828
train_loss_en_mejor     0.621781
train_loss_final        0.265252
delta_val_tras_mejor     0.09779
gap_loss_mejor          0.061257
gap_loss_final          0.515576
train_acc_mejor         0.693824
val_acc_mejor           0.560833
train_acc_final         0.917353
val_acc_final              0.585
gap_acc_mejor            0.13299
gap_acc_final           0.332353

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

TEST acc=0.5675 loss=0.8019  azar=0.50  delta=+0.0675
WARNING:tensorflow:5 out of the last 11 calls to <function TensorFlowTrainer.make_predict_function.<locals>.one_step_on_data_distributed at 0x000002292F427920> triggered tf.function retracing. Tracing is expensive and the excessive number of tracings could be due to (1) creating @tf.function repeatedly in a loop, (2) passing tensors with different shapes, (3) passing Python objects instead of tensors. For (1), please define your @tf.function outside of the loop. For (2), @tf.function has reduce_retracing=True option that can avoid unnecessary retracing. For (3), please refer to https://www.tensorflow.org/guide/function#controlling_retracing and https://www.tensorflow.org/api_docs/python/tf/function for  more details.
              precision    recall  f1-score   support

         neg     0.5878    0.5514    0.5690      2071
         pos     0.5484    0.5848    0.5660      1929

    accuracy                         0.5675      4000
   macro avg     0.5681    0.5681    0.5675      4000
weighted avg     0.5688    0.5675    0.5675      4000

Interpretación

Accuracy 0.70 con maxlen=80 no se compara con BERT. Se compara con 0.50 y con el gap. Si train_acc 0.95 y val 0.70, la RNN memoriza prefijos; el final recortado era, a menudo, el veredicto.

16. Confianza en reseñas

err=hat!=yte_t[:4000]
print('conf media aciertos', float(np.where(hat==1,probs,1-probs)[~err].mean()))
print('errores con p>0.9 o p<0.1 (seguros y mal):', int(((err)&((probs>0.9)|(probs<0.1))).sum()))
conf media aciertos 0.7562175393104553
errores con p>0.9 o p<0.1 (seguros y mal): 207

17. Tres dominios, un mismo hábito de lectura

Demanda (RMSE vs naive), sensor (picos), texto (F1). La arquitectura es la misma familia; el acta cambia de unidad.

print('DEMANDA RMSE RNN vs naive: ya impreso arriba')
print('IMDB test acc', acc)
print('Regla: no se exporta un unico accuracy de la RNN. Se exporta la metrica del dominio.')
DEMANDA RMSE RNN vs naive: ya impreso arriba
IMDB test acc 0.5674999952316284
Regla: no se exporta un unico accuracy de la RNN. Se exporta la metrica del dominio.

18. Cuándo no usar una SimpleRNN

Dependencias largas (sesión 10), textos con contexto a ambos lados (sesión 11), series donde un rezago tabular ya gana.

19. Error en los picos de demanda

El RMSE global no basta para reposición. Medimos el error solo en los días de test cuya demanda real está por encima del percentil 80.

umbral = np.quantile(yte, 0.80)
alta = yte >= umbral
rmse_alta = float(np.sqrt(np.mean((pred[alta] - yte[alta]) ** 2))) if alta.any() else float("nan")
rmse_resto = float(np.sqrt(np.mean((pred[~alta] - yte[~alta]) ** 2)))
print(f"días alta demanda: {alta.sum()}  RMSE picos={rmse_alta:.4f}  RMSE resto={rmse_resto:.4f}")
print("Si RMSE picos >> RMSE resto, el modelo es inútil justo cuando inventario más lo necesita.")
días alta demanda: 29  RMSE picos=0.0382  RMSE resto=0.0430
Si RMSE picos >> RMSE resto, el modelo es inútil justo cuando inventario más lo necesita.

Interpretación

Un modelo «bueno en media» y ciego al pico es el clásico fracaso de forecast en retail. El acta lleva las dos cifras, no el promedio que queda bien en la diapositiva.

20. Otra ventana, mismo SKU

VENTANA=10 vs la de 20: menos contexto, menos parámetros temporales. Se reentrena una RNN gemela y se compara RMSE de test (mismo corte cronológico).

X10, y10 = ventanas(demanda, 10)
n10 = int(0.7 * len(X10))
# alinear test al mismo origen temporal aproximado (último 30%)
rnn10 = tf.keras.Sequential([tf.keras.layers.SimpleRNN(16, input_shape=(10, 1)), tf.keras.layers.Dense(1)])
rnn10.compile(optimizer="adam", loss="mse")
h10 = rnn10.fit(X10[:n10], y10[:n10], validation_split=0.15, epochs=10, batch_size=32, verbose=0)
p10 = rnn10.predict(X10[n10:], verbose=0).ravel()
rmse10 = float(np.sqrt(np.mean((p10 - y10[n10:]) ** 2)))
print(f"RMSE ventana 10={rmse10:.4f}  ventana 20={rmse:.4f}")
print("mejor val_loss v10", min(h10.history["val_loss"]), "v20 (ver informe anterior)")
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
RMSE ventana 10=0.0509  ventana 20=0.0421
mejor val_loss v10 0.0031013113912194967 v20 (ver informe anterior)

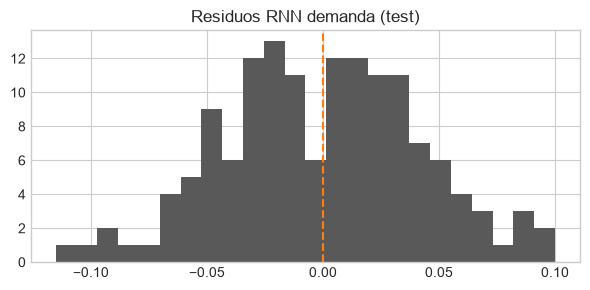
21. Histograma de residuos (demanda)

Los residuos deben centrarse en 0. Una cola larga a la derecha significa subestimar picos; a la izquierda, sobrestimar valles.

res = pred - yte
print(pd.Series(res).describe().to_string())
plt.figure(figsize=(6, 3))
plt.hist(res, bins=24, color="0.35")
plt.axvline(0, color="C1", ls="--")
plt.title("Residuos RNN demanda (test)")
plt.tight_layout()
plt.show()
count    144.000000
mean      -0.001152
std        0.042217
min       -0.115126
25%       -0.029227
50%        0.001296
75%        0.028595
max        0.100003

22. Umbral de alarma en el sensor

Sobre el test del sensor, marcamos «apertura» si la temperatura real supera un corte. Accuracy de detectar el evento no es el MSE: es otra pregunta operativa.

corte = np.quantile(ys[ns:], 0.90)
evt = ys[ns:] >= corte
hat_evt = ps >= corte
print("eventos reales", int(evt.sum()), "predichos", int(hat_evt.sum()))
print(classification_report(evt.astype(int), hat_evt.astype(int), target_names=["estable", "pico"], digits=3, zero_division=0))
eventos reales 14 predichos 0
              precision    recall  f1-score   support

     estable      0.899     1.000     0.947       124
        pico      0.000     0.000     0.000        14

    accuracy                          0.899       138
   macro avg      0.449     0.500     0.473       138
weighted avg      0.807     0.899     0.851       138

Amenazas a la validez

La senoide es regular; IMDB recortado no es NLU; una semilla; SimpleRNN en CPU es frágil.

Lectura del RMSE en inventario

Si el error medio es bajo y el error en los 10 días de mayor demanda es alto, el modelo es inútil para stock. Reporte ambas colas.

Split temporal

Mezclar ventanas de enero y diciembre en train y test filtra el futuro. En este artículo el corte es cronológico (70/30 sobre el índice).

Estado inicial

h_0=0 es una convención. En un sensor real a veces se calienta el estado con una ventana previa no evaluada.

Cierre

La RNN introduce memoria compartida. El valor está en leer MSE o el reporte frente a un naive y frente al gap, no en declarar que ‘ya sabemos secuencias’.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.