LSTM y GRU aplicadas

deep-learning
lstm
gru
Puertas LSTM/GRU y comparación con RNN leyendo curvas y accuracy de dependencia larga.
Author

Wilder Ramírez Delgado

Published

September 7, 2026

LSTM y GRU aplicadas

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo abrimos las puertas de una LSTM, compactamos la idea en una GRU y medimos, con el mismo protocolo de informe, si recuerdan lo que una SimpleRNN ya olvidó.

1. Introducción

La sesión 9 dejó un hecho: el gradiente de una RNN se desvanece cuando el pasado está lejos. LSTM y GRU cambian el camino del gradiente con puertas y un atajo aditivo.

Pregunta: cuándo el extra de parámetros se justifica en el val_acc y en el gap.

2. Qué ya se conoce

Estado oculto, BPTT, MSE y clasificación de secuencias.

3. Protocolo de lectura de métricas

Mejor val_loss, gap train−val, reporte por clase o MSE de test, y solo después una decisión. El último print de fit no es el acta.

import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm
TensorFlow: 2.21.0
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU: ninguna (CPU)

Idea clave

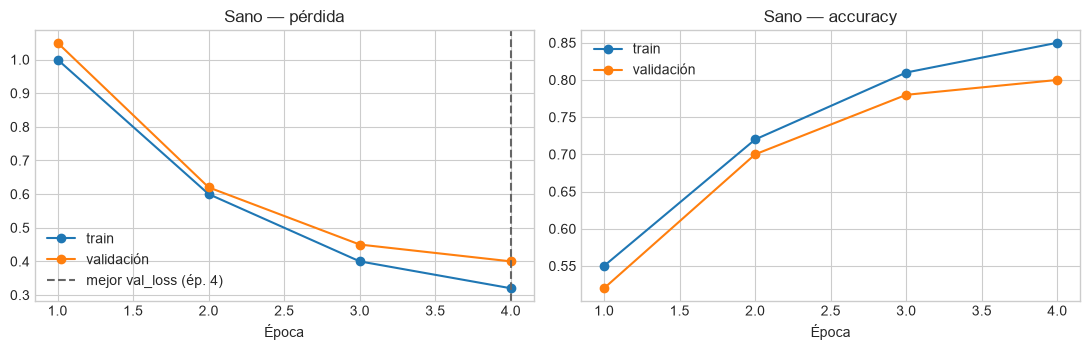
Una curva sin el índice de la mejor época es un dibujo. El informe empieza cuando se declara qué época se está reportando.

4. Laboratorio de lectura (history sintético)

sano={'loss':[1.0,0.6,0.4,0.32],'val_loss':[1.05,0.62,0.45,0.40],'accuracy':[0.55,0.72,0.81,0.85],'val_accuracy':[0.52,0.70,0.78,0.80]}
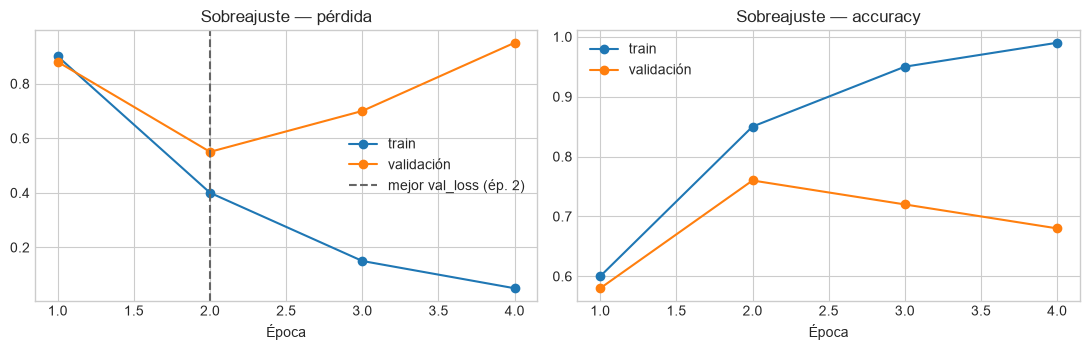
sobre={'loss':[0.9,0.4,0.15,0.05],'val_loss':[0.88,0.55,0.70,0.95],'accuracy':[0.6,0.85,0.95,0.99],'val_accuracy':[0.58,0.76,0.72,0.68]}
print('SANO'); diagnostico_entrenamiento(sano,'sano'); curvas_entrenamiento(sano,'Sano')
print('SOBRE'); diagnostico_entrenamiento(sobre,'sobre'); curvas_entrenamiento(sobre,'Sobreajuste')
SANO
modelo                  sano
epocas_corridas            4
mejor_epoca_val_loss       4
min_val_loss             0.4
val_loss_final           0.4
train_loss_en_mejor     0.32
train_loss_final        0.32
delta_val_tras_mejor     0.0
gap_loss_mejor          0.08
gap_loss_final          0.08
train_acc_mejor         0.85
val_acc_mejor            0.8
train_acc_final         0.85
val_acc_final            0.8
gap_acc_mejor           0.05
gap_acc_final           0.05

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

SOBRE
modelo                  sobre
epocas_corridas             4
mejor_epoca_val_loss        2
min_val_loss             0.55
val_loss_final           0.95
train_loss_en_mejor       0.4
train_loss_final         0.05
delta_val_tras_mejor      0.4
gap_loss_mejor           0.15
gap_loss_final            0.9
train_acc_mejor          0.85
val_acc_mejor            0.76
train_acc_final          0.99
val_acc_final            0.68
gap_acc_mejor            0.09
gap_acc_final            0.31

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

Interpretación

En el sobreajuste, reportar la época 4 como si fuera el modelo es un error de gobernanza. El checkpoint razonable es la época de mínima val_loss.

5. Puertas de una LSTM

Forget, input y output. c_t = f_t ⊙ c_{t-1} + i_t ⊙ candidata. Si f≈1 e i≈0, la celda copia el pasado. Ese es el atajo que la RNN no tiene.

Idea clave

La puerta forget no olvida por defecto. Aprende cuándo borrar. El sesgo de olvido inicial suele favorecer conservar.

6. GRU

Update y reset. Menos parámetros. En muchas series empata a la LSTM; en copiado largo a veces pierde. Se decide con la tarea, no con la marca.

7. Caso 1 — Bit de control al inicio de un lote

Secuencias binarias de longitud L. La etiqueta es el primer bit (un código de turno que aparece al empezar la cinta). Una RNN que solo mire el final falla. Es el análogo de un identificador que no se vuelve a repetir.

def dataset_primer(n,L,seed):
    rng=np.random.default_rng(seed)
    X=rng.integers(0,2,size=(n,L,1)).astype('float32')
    return X, X[:,0,0]
L=30
Xtr,ytr=dataset_primer(4000,L,0); Xva,yva=dataset_primer(800,L,1); Xte,yte=dataset_primer(800,L,2)
print(Xtr.shape,'media etiqueta',ytr.mean())
(4000, 30, 1) media etiqueta 0.5065

8. Tres modelos, un protocolo

Misma dimensión oculta, mismas épocas, mismo Adam. No igualamos parámetros: LSTM/GRU tienen más, y eso entra al acta.

def arma(capa,nombre):
    m=tf.keras.Sequential([capa,tf.keras.layers.Dense(1,activation='sigmoid')],name=nombre)
    m.compile(optimizer=tf.keras.optimizers.Adam(1e-3),loss='binary_crossentropy',metrics=['accuracy'])
    return m
U=16
mods={'RNN':arma(tf.keras.layers.SimpleRNN(U,input_shape=(L,1)),'rnn'),
      'LSTM':arma(tf.keras.layers.LSTM(U,input_shape=(L,1)),'lstm'),
      'GRU':arma(tf.keras.layers.GRU(U,input_shape=(L,1)),'gru')}
hists={}; filas=[]
for nom,m in mods.items():
    print('===',nom,'params',m.count_params())
    h=m.fit(Xtr,ytr,validation_data=(Xva,yva),epochs=8,batch_size=64,verbose=1)
    hists[nom]=h
    te=m.evaluate(Xte,yte,verbose=0)
    d=diagnostico_entrenamiento(h,nom)
    filas.append({'modelo':nom,'params':m.count_params(),'acc_test':te[1],'loss_test':te[0],
                  'mejor_epoca':d.get('mejor_epoca_val_loss'),'gap_final':d.get('gap_acc_final')})
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
=== RNN params 305

Epoch 1/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 2:33 2s/step - accuracy: 0.5938 - loss: 0.7391

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5347 - loss: 0.7346 

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5244 - loss: 0.7272

23/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5183 - loss: 0.7302

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5161 - loss: 0.7283

41/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5206 - loss: 0.7195

50/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.5294 - loss: 0.7111

60/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.5523 - loss: 0.6953

63/63 ━━━━━━━━━━━━━━━━━━━━ 4s 17ms/step - accuracy: 0.5592 - loss: 0.6899 - val_accuracy: 0.7950 - val_loss: 0.5141

Epoch 2/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 60ms/step - accuracy: 0.7812 - loss: 0.5260

 7/63 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 0.7835 - loss: 0.5007 

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.8359 - loss: 0.4460

23/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.8709 - loss: 0.3923

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9006 - loss: 0.3440

41/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9184 - loss: 0.3135

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9297 - loss: 0.2894

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9384 - loss: 0.2686

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9457 - loss: 0.2505

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 10ms/step - accuracy: 0.9457 - loss: 0.2505 - val_accuracy: 1.0000 - val_loss: 0.0984

Epoch 3/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 72ms/step - accuracy: 1.0000 - loss: 0.0961

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0937 

15/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0905

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0865

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0820

37/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0776

47/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0729

58/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0680

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 9ms/step - accuracy: 1.0000 - loss: 0.0663 - val_accuracy: 1.0000 - val_loss: 0.0410

Epoch 4/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 63ms/step - accuracy: 1.0000 - loss: 0.0416

 7/63 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 1.0000 - loss: 0.0408 

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0387

24/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0374

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0357

43/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0343

53/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0327

62/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0317

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 8ms/step - accuracy: 1.0000 - loss: 0.0316 - val_accuracy: 1.0000 - val_loss: 0.0227

Epoch 5/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 2s 48ms/step - accuracy: 1.0000 - loss: 0.0237

11/63 ━━━━━━━━━━━━━━━━━━━━ 0s 5ms/step - accuracy: 1.0000 - loss: 0.0223 

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 5ms/step - accuracy: 1.0000 - loss: 0.0214

28/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0209

36/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0203

45/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0197

54/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0190

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 8ms/step - accuracy: 1.0000 - loss: 0.0186 - val_accuracy: 1.0000 - val_loss: 0.0143

Epoch 6/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 77ms/step - accuracy: 1.0000 - loss: 0.0149

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0139 

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0138

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0135

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0131

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0127

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0124

60/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0122

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 10ms/step - accuracy: 1.0000 - loss: 0.0121 - val_accuracy: 1.0000 - val_loss: 0.0097

Epoch 7/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 67ms/step - accuracy: 1.0000 - loss: 0.0102

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0095 

15/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0095

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0093

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0092

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0090

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0089

49/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0087

56/63 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0086

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 11ms/step - accuracy: 1.0000 - loss: 0.0085 - val_accuracy: 1.0000 - val_loss: 0.0071

Epoch 8/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 54ms/step - accuracy: 1.0000 - loss: 0.0074

11/63 ━━━━━━━━━━━━━━━━━━━━ 0s 5ms/step - accuracy: 1.0000 - loss: 0.0071 

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0070

25/63 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 1.0000 - loss: 0.0068

32/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0067

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0066

49/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0065

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 1.0000 - loss: 0.0064

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 9ms/step - accuracy: 1.0000 - loss: 0.0063 - val_accuracy: 1.0000 - val_loss: 0.0055

modelo                       RNN

epocas_corridas                8

mejor_epoca_val_loss           8

min_val_loss            0.005459

val_loss_final          0.005459

train_loss_en_mejor     0.006348

train_loss_final        0.006348

delta_val_tras_mejor         0.0

gap_loss_mejor          -0.00089

gap_loss_final          -0.00089

train_acc_mejor              1.0

val_acc_mejor                1.0

train_acc_final              1.0

val_acc_final                1.0

gap_acc_mejor                0.0

gap_acc_final                0.0


LECTURA

La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

=== LSTM params 1169

Epoch 1/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 2:35 3s/step - accuracy: 0.5938 - loss: 0.6854

 4/63 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.5391 - loss: 0.6876

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5176 - loss: 0.6958

12/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5208 - loss: 0.6931

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5264 - loss: 0.6925

20/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5203 - loss: 0.6932

24/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5065 - loss: 0.6942

28/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5006 - loss: 0.6945

32/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4990 - loss: 0.6946

37/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5021 - loss: 0.6943

43/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5015 - loss: 0.6943

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5033 - loss: 0.6940

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5036 - loss: 0.6940

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.4995 - loss: 0.6943

62/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.4992 - loss: 0.6943

63/63 ━━━━━━━━━━━━━━━━━━━━ 4s 24ms/step - accuracy: 0.5000 - loss: 0.6942 - val_accuracy: 0.4850 - val_loss: 0.6945

Epoch 2/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 79ms/step - accuracy: 0.4688 - loss: 0.6962

 4/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5586 - loss: 0.6900

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5399 - loss: 0.6920

12/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5312 - loss: 0.6916

17/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5239 - loss: 0.6922

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5170 - loss: 0.6925

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5048 - loss: 0.6930

30/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5010 - loss: 0.6935

34/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5064 - loss: 0.6930

38/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5058 - loss: 0.6931

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5037 - loss: 0.6932

47/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5063 - loss: 0.6930

53/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5053 - loss: 0.6932

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5014 - loss: 0.6935

61/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5005 - loss: 0.6935

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5002 - loss: 0.6935 - val_accuracy: 0.4812 - val_loss: 0.6943

Epoch 3/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 5s 81ms/step - accuracy: 0.4844 - loss: 0.6954

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5562 - loss: 0.6900

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5347 - loss: 0.6919

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5134 - loss: 0.6923

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5191 - loss: 0.6923

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5163 - loss: 0.6924

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5048 - loss: 0.6929

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.4985 - loss: 0.6934

36/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5065 - loss: 0.6931

40/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5051 - loss: 0.6931

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5028 - loss: 0.6932

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5059 - loss: 0.6930

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5063 - loss: 0.6930

56/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5031 - loss: 0.6934

59/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5029 - loss: 0.6933

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5008 - loss: 0.6934

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5008 - loss: 0.6934 - val_accuracy: 0.4775 - val_loss: 0.6942

Epoch 4/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 56ms/step - accuracy: 0.4844 - loss: 0.6951

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5531 - loss: 0.6901

10/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5219 - loss: 0.6925

15/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5167 - loss: 0.6918

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5134 - loss: 0.6928

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5048 - loss: 0.6928

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.4990 - loss: 0.6934

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5103 - loss: 0.6928

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5076 - loss: 0.6930

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5043 - loss: 0.6931

49/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5073 - loss: 0.6929

53/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5083 - loss: 0.6930

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5038 - loss: 0.6933

61/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5036 - loss: 0.6933

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5035 - loss: 0.6933 - val_accuracy: 0.4712 - val_loss: 0.6941

Epoch 5/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 61ms/step - accuracy: 0.4844 - loss: 0.6949

 6/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5547 - loss: 0.6903

10/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5234 - loss: 0.6925

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5145 - loss: 0.6923

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5182 - loss: 0.6922

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5185 - loss: 0.6924

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5054 - loss: 0.6928

30/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5016 - loss: 0.6932

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5107 - loss: 0.6928

40/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5059 - loss: 0.6930

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5046 - loss: 0.6931

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5072 - loss: 0.6929

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5075 - loss: 0.6929

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5082 - loss: 0.6930

58/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5035 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.5033 - loss: 0.6932 - val_accuracy: 0.4712 - val_loss: 0.6940

Epoch 6/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 76ms/step - accuracy: 0.4688 - loss: 0.6947

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5469 - loss: 0.6903

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5260 - loss: 0.6919

13/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5168 - loss: 0.6919

17/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5221 - loss: 0.6920

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5149 - loss: 0.6927

25/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5094 - loss: 0.6926

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5027 - loss: 0.6931

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5047 - loss: 0.6930

37/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5084 - loss: 0.6929

40/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5063 - loss: 0.6930

45/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5052 - loss: 0.6930

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5080 - loss: 0.6929

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5038 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5058 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5058 - loss: 0.6932 - val_accuracy: 0.4663 - val_loss: 0.6940

Epoch 7/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 69ms/step - accuracy: 0.4844 - loss: 0.6945

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5375 - loss: 0.6903

10/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5156 - loss: 0.6924

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5123 - loss: 0.6923

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5122 - loss: 0.6922

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5128 - loss: 0.6923

27/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5029 - loss: 0.6928

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4965 - loss: 0.6932

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5076 - loss: 0.6927

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5056 - loss: 0.6929

43/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5036 - loss: 0.6930

47/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5093 - loss: 0.6927

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5070 - loss: 0.6928

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5077 - loss: 0.6930

59/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5053 - loss: 0.6931

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5048 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5048 - loss: 0.6932 - val_accuracy: 0.4638 - val_loss: 0.6939

Epoch 8/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 79ms/step - accuracy: 0.4844 - loss: 0.6944

 4/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5312 - loss: 0.6903

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5078 - loss: 0.6927

12/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5221 - loss: 0.6917

17/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5193 - loss: 0.6920

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5112 - loss: 0.6926

24/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5065 - loss: 0.6926

28/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5033 - loss: 0.6928

32/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5015 - loss: 0.6930

36/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5056 - loss: 0.6929

40/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5035 - loss: 0.6929

45/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5049 - loss: 0.6930

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5086 - loss: 0.6928

57/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5033 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5052 - loss: 0.6931

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.5052 - loss: 0.6931 - val_accuracy: 0.4712 - val_loss: 0.6939

modelo                      LSTM

epocas_corridas                8

mejor_epoca_val_loss           8

min_val_loss            0.693874

val_loss_final          0.693874

train_loss_en_mejor     0.693132

train_loss_final        0.693132

delta_val_tras_mejor         0.0

gap_loss_mejor          0.000742

gap_loss_final          0.000742

train_acc_mejor          0.50525

val_acc_mejor            0.47125

train_acc_final          0.50525

val_acc_final            0.47125

gap_acc_mejor              0.034

gap_acc_final              0.034


LECTURA

La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

=== GRU params 929

Epoch 1/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3:04 3s/step - accuracy: 0.4688 - loss: 0.6926

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5219 - loss: 0.6901

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5122 - loss: 0.6923

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5134 - loss: 0.6924

19/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5082 - loss: 0.6934

23/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5115 - loss: 0.6933

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5060 - loss: 0.6938

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5005 - loss: 0.6941

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5014 - loss: 0.6939

37/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5000 - loss: 0.6939

41/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4996 - loss: 0.6939

46/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4966 - loss: 0.6939

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5025 - loss: 0.6936

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5026 - loss: 0.6936

58/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4995 - loss: 0.6937

62/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4965 - loss: 0.6938

63/63 ━━━━━━━━━━━━━━━━━━━━ 5s 26ms/step - accuracy: 0.4967 - loss: 0.6937 - val_accuracy: 0.4913 - val_loss: 0.6935

Epoch 2/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 5s 92ms/step - accuracy: 0.4531 - loss: 0.6935

 4/63 ━━━━━━━━━━━━━━━━━━━━ 1s 23ms/step - accuracy: 0.5352 - loss: 0.6915

 8/63 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5156 - loss: 0.6930

13/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5144 - loss: 0.6920

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5104 - loss: 0.6927

23/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5061 - loss: 0.6930

27/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4994 - loss: 0.6935

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4960 - loss: 0.6938

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5045 - loss: 0.6934

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5020 - loss: 0.6935

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4986 - loss: 0.6936

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5007 - loss: 0.6934

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5036 - loss: 0.6934

56/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4980 - loss: 0.6935

61/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4985 - loss: 0.6935

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.4967 - loss: 0.6935 - val_accuracy: 0.4850 - val_loss: 0.6935

Epoch 3/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 80ms/step - accuracy: 0.5000 - loss: 0.6930

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5406 - loss: 0.6911

 8/63 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.5156 - loss: 0.6929

12/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5208 - loss: 0.6920

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5215 - loss: 0.6920

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5126 - loss: 0.6928

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5018 - loss: 0.6932

30/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4969 - loss: 0.6936

33/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5000 - loss: 0.6934

36/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4991 - loss: 0.6933

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4996 - loss: 0.6933

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4967 - loss: 0.6934

46/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4969 - loss: 0.6933

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4975 - loss: 0.6932

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4974 - loss: 0.6933

59/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4947 - loss: 0.6934

62/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4937 - loss: 0.6934

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.4938 - loss: 0.6934 - val_accuracy: 0.4825 - val_loss: 0.6935

Epoch 4/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 52ms/step - accuracy: 0.5312 - loss: 0.6928

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5562 - loss: 0.6911

10/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5172 - loss: 0.6927

14/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5179 - loss: 0.6924

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5182 - loss: 0.6924

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5164 - loss: 0.6926

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5048 - loss: 0.6931

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.4980 - loss: 0.6935

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5058 - loss: 0.6931

39/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5036 - loss: 0.6932

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5041 - loss: 0.6932

45/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5052 - loss: 0.6932

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5072 - loss: 0.6931

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5043 - loss: 0.6932

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5045 - loss: 0.6932

60/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5018 - loss: 0.6933

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.5020 - loss: 0.6933 - val_accuracy: 0.4850 - val_loss: 0.6935

Epoch 5/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 51ms/step - accuracy: 0.5156 - loss: 0.6927

 5/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5469 - loss: 0.6911

 9/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5139 - loss: 0.6922

12/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5169 - loss: 0.6920

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5244 - loss: 0.6919

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5141 - loss: 0.6925

25/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5050 - loss: 0.6928

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4995 - loss: 0.6932

32/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5015 - loss: 0.6932

35/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5071 - loss: 0.6930

38/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5029 - loss: 0.6931

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5033 - loss: 0.6931

47/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5103 - loss: 0.6930

52/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5048 - loss: 0.6931

56/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5006 - loss: 0.6933

59/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5037 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5035 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.5035 - loss: 0.6932 - val_accuracy: 0.4750 - val_loss: 0.6935

Epoch 6/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 3s 49ms/step - accuracy: 0.5156 - loss: 0.6926

 6/63 ━━━━━━━━━━━━━━━━━━━━ 0s 11ms/step - accuracy: 0.5469 - loss: 0.6911

11/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5099 - loss: 0.6924

15/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5250 - loss: 0.6919

18/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5165 - loss: 0.6923

22/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5099 - loss: 0.6924

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5018 - loss: 0.6929

30/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.4958 - loss: 0.6932

34/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5064 - loss: 0.6930

38/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5033 - loss: 0.6930

42/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5030 - loss: 0.6930

46/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5068 - loss: 0.6930

50/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5078 - loss: 0.6930

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5034 - loss: 0.6931

60/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5023 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.5042 - loss: 0.6932 - val_accuracy: 0.4812 - val_loss: 0.6935

Epoch 7/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 4s 80ms/step - accuracy: 0.5156 - loss: 0.6925

 6/63 ━━━━━━━━━━━━━━━━━━━━ 0s 11ms/step - accuracy: 0.5521 - loss: 0.6911

10/63 ━━━━━━━━━━━━━━━━━━━━ 0s 12ms/step - accuracy: 0.5266 - loss: 0.6925

13/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5312 - loss: 0.6921

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5342 - loss: 0.6919

19/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5181 - loss: 0.6926

24/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5111 - loss: 0.6926

29/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5032 - loss: 0.6930

34/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5083 - loss: 0.6929

38/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5066 - loss: 0.6929

43/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5073 - loss: 0.6930

47/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5133 - loss: 0.6928

51/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5070 - loss: 0.6930

55/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5054 - loss: 0.6931

58/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5046 - loss: 0.6932

62/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5060 - loss: 0.6932

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.5063 - loss: 0.6931 - val_accuracy: 0.4787 - val_loss: 0.6935

Epoch 8/8


 1/63 ━━━━━━━━━━━━━━━━━━━━ 5s 81ms/step - accuracy: 0.5156 - loss: 0.6925

 4/63 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.5664 - loss: 0.6906

 7/63 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.5357 - loss: 0.6920

11/63 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5185 - loss: 0.6924

16/63 ━━━━━━━━━━━━━━━━━━━━ 0s 16ms/step - accuracy: 0.5322 - loss: 0.6919

21/63 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.5193 - loss: 0.6923

26/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.5060 - loss: 0.6927

31/63 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.4995 - loss: 0.6931

36/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5061 - loss: 0.6929

40/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5039 - loss: 0.6929

44/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5064 - loss: 0.6929

48/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5101 - loss: 0.6928

53/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5044 - loss: 0.6930

58/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5022 - loss: 0.6931

63/63 ━━━━━━━━━━━━━━━━━━━━ 0s 13ms/step - accuracy: 0.5038 - loss: 0.6931

63/63 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.5038 - loss: 0.6931 - val_accuracy: 0.4825 - val_loss: 0.6936

modelo                       GRU

epocas_corridas                8

mejor_epoca_val_loss           3

min_val_loss            0.693511

val_loss_final          0.693553

train_loss_en_mejor     0.693375

train_loss_final        0.693102

delta_val_tras_mejor    0.000042

gap_loss_mejor          0.000136

gap_loss_final           0.00045

train_acc_mejor          0.49375

val_acc_mejor             0.4825

train_acc_final          0.50375

val_acc_final             0.4825

gap_acc_mejor            0.01125

gap_acc_final            0.02125


LECTURA

La mejor val_loss no es la última época (3 de 8). Si restore_best_weights=True, el modelo guardado no es el del último paso.

9. Curvas de validación superpuestas

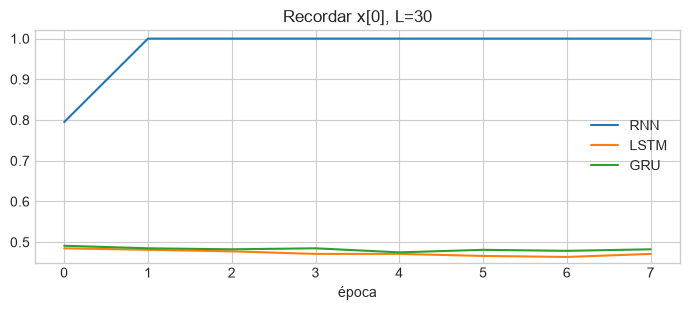
fig,ax=plt.subplots(figsize=(7,3.2))
for nom,h in hists.items():
    ax.plot(h.history['val_accuracy'],label=nom)
ax.set_ylim(0.45,1.02); ax.legend(); ax.set_title(f'Recordar x[0], L={L}'); ax.set_xlabel('época')
plt.tight_layout(); plt.show()
print(pd.DataFrame(filas).to_string(index=False,float_format=lambda v:f'{v:.4f}'))

modelo  params  acc_test  loss_test  mejor_epoca  gap_final
   RNN     305    1.0000     0.0055            8     0.0000
  LSTM    1169    0.4650     0.6950            8     0.0340
   GRU     929    0.4600     0.6943            3     0.0213

Interpretación

El azar es 0.50. Si la RNN se queda ahí y LSTM/GRU suben, la diferencia es conservar el bit, no ‘más deep learning’. Si las tres llegan a 1, L=30 ya es corto: el acta debe decirlo.

10. Informe por modelo (test)

for nom,m in mods.items():
    p=m.predict(Xte,verbose=0).ravel(); hat=(p>=0.5).astype(int)
    print('\n',nom); print(classification_report(yte,hat,target_names=['bit0','bit1'],digits=3))

 RNN
              precision    recall  f1-score   support

        bit0      1.000     1.000     1.000       365
        bit1      1.000     1.000     1.000       435

    accuracy                          1.000       800
   macro avg      1.000     1.000     1.000       800
weighted avg      1.000     1.000     1.000       800


 LSTM
              precision    recall  f1-score   support

        bit0      0.395     0.323     0.355       365
        bit1      0.507     0.584     0.543       435

    accuracy                          0.465       800
   macro avg      0.451     0.454     0.449       800
weighted avg      0.456     0.465     0.457       800


 GRU
              precision    recall  f1-score   support

        bit0      0.379     0.288     0.327       365
        bit1      0.503     0.605     0.549       435

    accuracy                          0.460       800
   macro avg      0.441     0.446     0.438       800
weighted avg      0.446     0.460     0.448       800

11. Caso 2 — El identificador está al final

Misma L, etiqueta = último bit. Aquí la RNN no debería pagar un peaje de memoria. Si LSTM sigue ‘ganando’, estamos midiendo capacidad extra, no dependencia larga.

def dataset_ultimo(n,L,seed):
    rng=np.random.default_rng(seed)
    X=rng.integers(0,2,size=(n,L,1)).astype('float32')
    return X, X[:,-1,0]
X2,y2=dataset_ultimo(3000,L,3); X2te,y2te=dataset_ultimo(600,L,4)
filas2=[]
for nom in ['RNN','LSTM']:
    m=arma(tf.keras.layers.SimpleRNN(U,input_shape=(L,1)) if nom=='RNN' else tf.keras.layers.LSTM(U,input_shape=(L,1)),nom+'2')
    h=m.fit(X2,y2,validation_split=0.15,epochs=5,batch_size=64,verbose=0)
    te=m.evaluate(X2te,y2te,verbose=0)[1]
    filas2.append({'modelo':nom,'acc_test_ultimo_bit':te,'mejor_val':max(h.history['val_accuracy'])})
print(pd.DataFrame(filas2).to_string(index=False,float_format=lambda v:f'{v:.4f}'))
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
modelo  acc_test_ultimo_bit  mejor_val
   RNN               0.9917     0.9756
  LSTM               1.0000     1.0000

Interpretación

Si el gap RNN−LSTM se cierra al mover la etiqueta al final, la ventaja de las puertas era memoria, no un optimizador milagroso.

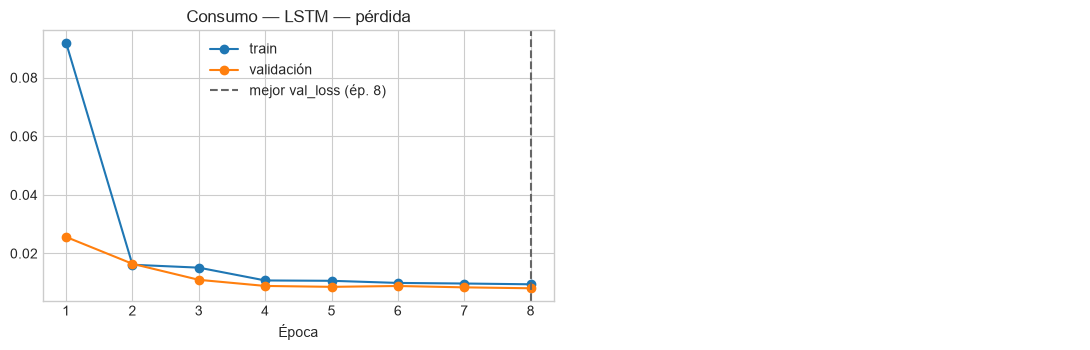
12. Caso 3 — Consumo horario (serie) con LSTM vs RNN

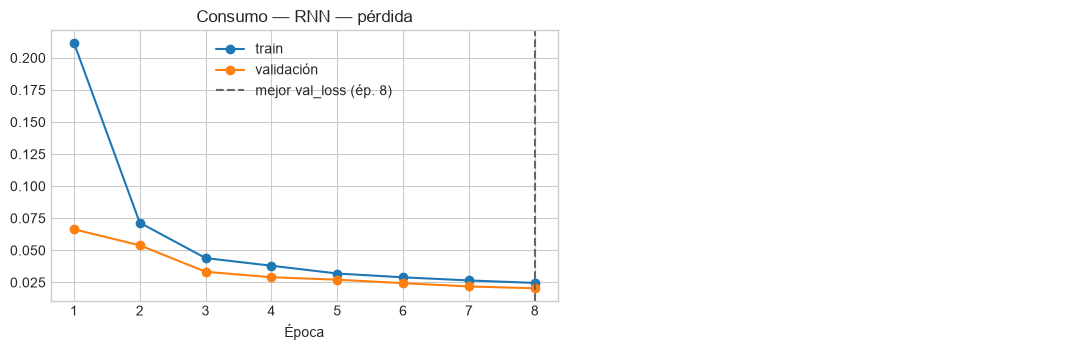
Proxy de un medidor: tendencia + ciclo de 24 pasos + ruido. Ventana 36, predecir el siguiente. Lectura: RMSE y curva val.

th=np.linspace(0,40,600)
cons=0.4+0.15*np.sin(th*2*np.pi/24*10)+0.05*th/40+0.04*np.random.default_rng(2).normal(size=600)
def vent(y,L=36):
    X=np.array([y[i:i+L] for i in range(len(y)-L)],'float32')[...,None]
    return X, np.array(y[L:],'float32')
Xc,yc=vent(cons); n=int(0.7*len(Xc))
def reg(capa):
    m=tf.keras.Sequential([capa,tf.keras.layers.Dense(1)])
    m.compile('adam','mse'); return m
hr=reg(tf.keras.layers.SimpleRNN(16,input_shape=(36,1))).fit(Xc[:n],yc[:n],validation_split=0.15,epochs=8,verbose=0)
hl=reg(tf.keras.layers.LSTM(16,input_shape=(36,1))).fit(Xc[:n],yc[:n],validation_split=0.15,epochs=8,verbose=0)
print('RNN min val',min(hr.history['val_loss']),'LSTM min val',min(hl.history['val_loss']))
curvas_entrenamiento(hr,'Consumo — RNN'); curvas_entrenamiento(hl,'Consumo — LSTM')
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
RNN min val 0.02040274813771248 LSTM min val 0.008103691972792149

13. Tabla unificada de los tres casos

print('CASO bit inicial (L=30)')
print(pd.DataFrame(filas).to_string(index=False,float_format=lambda v:f'{v:.4f}'))
print('\nCASO bit final')
print(pd.DataFrame(filas2).to_string(index=False,float_format=lambda v:f'{v:.4f}'))
print('\nCASO consumo: compare min val_loss de las curvas (ya impresas).')
CASO bit inicial (L=30)
modelo  params  acc_test  loss_test  mejor_epoca  gap_final
   RNN     305    1.0000     0.0055            8     0.0000
  LSTM    1169    0.4650     0.6950            8     0.0340
   GRU     929    0.4600     0.6943            3     0.0213

CASO bit final
modelo  acc_test_ultimo_bit  mejor_val
   RNN               0.9917     0.9756
  LSTM               1.0000     1.0000

CASO consumo: compare min val_loss de las curvas (ya impresas).

14. Cuándo elegir cada una

Corta + presupuesto bajo: GRU o RNN. Rezagos largos: medir LSTM y GRU. Latencia: GRU suele ser más barata. A veces un lag en un DataFrame gana a ambas.

15. Afianzamiento: más épocas no sustituyen la puerta

Si la RNN no sube tras 8 épocas, insistir hasta 40 rara vez recupera un bit a distancia 80. El acta debe separar ‘poco entrenamiento’ de ‘camino de gradiente inadecuado’.

print('Épocas corridas bit inicial:')
for nom,h in hists.items():
    print(nom, len(h.history['loss']), 'val_acc final', h.history['val_accuracy'][-1])
Épocas corridas bit inicial:
RNN 8 val_acc final 1.0
LSTM 8 val_acc final 0.4712499976158142
GRU 8 val_acc final 0.48249998688697815

16. Alargar L: dónde se rompe la RNN

Repetimos el bit inicial con L=50. Si solo la RNN cae hacia 0.5, el acta confirma dependencia larga, no «LSTM es mejor en general».

L50 = 50
Xtr50, ytr50 = dataset_primer(3500, L50, 7)
Xte50, yte50 = dataset_primer(700, L50, 8)
filas50 = []
for nom, capa in [
    ("RNN", tf.keras.layers.SimpleRNN(16, input_shape=(L50, 1))),
    ("LSTM", tf.keras.layers.LSTM(16, input_shape=(L50, 1))),
    ("GRU", tf.keras.layers.GRU(16, input_shape=(L50, 1))),
]:
    m = arma(capa, nom + "L50")
    h = m.fit(Xtr50, ytr50, validation_split=0.15, epochs=6, batch_size=64, verbose=0)
    acc = m.evaluate(Xte50, yte50, verbose=0)[1]
    filas50.append({"modelo": nom, "L": L50, "acc_test": acc, "min_val_loss": min(h.history["val_loss"])})
    print(nom, acc)
print(pd.DataFrame(filas50).to_string(index=False, float_format=lambda v: f"{v:.4f}"))
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
RNN 0.49714285135269165
LSTM 0.4942857027053833
GRU 0.488571435213089
modelo  L  acc_test  min_val_loss
   RNN 50    0.4971        0.6971
  LSTM 50    0.4943        0.6939
   GRU 50    0.4886        0.6933

Interpretación

Compare esta tabla con la de L=30. El dato interesante es el delta de accuracy de la RNN, no el ranking de logos.

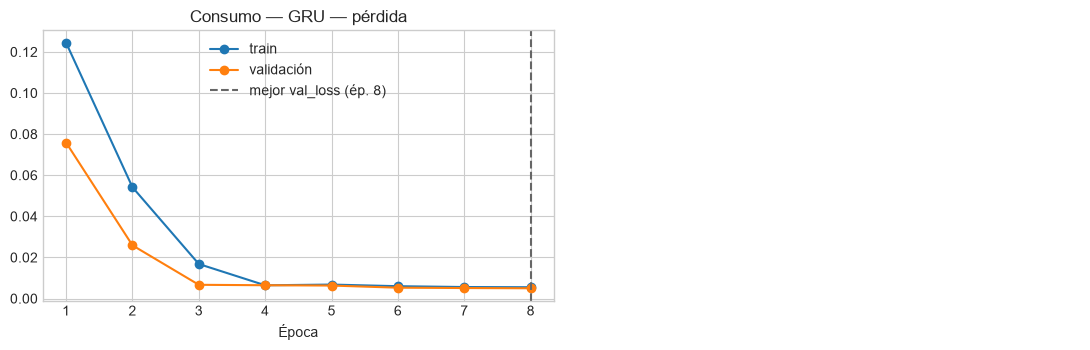
17. GRU en el medidor de consumo

Misma serie horaria, tercera arquitectura. Tres min val_loss en una fila.

hg = reg(tf.keras.layers.GRU(16, input_shape=(36, 1))).fit(
    Xc[:n], yc[:n], validation_split=0.15, epochs=8, verbose=0
)
print("min val_loss  RNN", min(hr.history["val_loss"]),
      "LSTM", min(hl.history["val_loss"]),
      "GRU", min(hg.history["val_loss"]))
curvas_entrenamiento(hg, "Consumo — GRU")
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\layers\rnn\rnn.py:199: UserWarning: Do not pass an `input_shape`/`input_dim` argument to a layer. When using Sequential models, prefer using an `Input(shape)` object as the first layer in the model instead.
  super().__init__(**kwargs)
min val_loss  RNN 0.02040274813771248 LSTM 0.008103691972792149 GRU 0.004978159908205271

18. Parámetros frente a test (bit inicial)

Una LSTM que gana 0.02 con el triple de pesos se declara en el acta; no se oculta.

print(pd.DataFrame(filas).to_string(index=False, float_format=lambda v: f"{v:.4f}"))
print("params/acc_test (menor es más barato por punto, solo orientativo)")
for row in filas:
    print(row["modelo"], row["params"] / max(row["acc_test"], 1e-6))
modelo  params  acc_test  loss_test  mejor_epoca  gap_final
   RNN     305    1.0000     0.0055            8     0.0000
  LSTM    1169    0.4650     0.6950            8     0.0340
   GRU     929    0.4600     0.6943            3     0.0213
params/acc_test (menor es más barato por punto, solo orientativo)
RNN 305.0
LSTM 2513.9784752888436
GRU 2019.565180755293

Amenazas a la validez

L=30 puede ser fácil; 8 épocas; el bit único no es lenguaje; no medimos latencia.

unit_forget_bias

Keras inicializa la forget gate para conservar. Cambiarlo altera el arranque del val_loss. Es un detalle de afianzamiento, no de arquitectura filosófica.

Parámetros vs accuracy

Una LSTM con 3× parámetros que gana 0.01 en un L fácil no se vende sola. Incluya params en la tabla, como en este artículo.

Validación en series

El validation_split de Keras toma el final del array. En el caso de consumo eso es correcto (futuro). En datos barajados sería un error.

Cierre

LSTM y GRU se justifican cuando el informe muestra memoria útil. Si el naive o la RNN empatan, el extra de puertas es costo, no virtud.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.