Transformers y modelos de lenguaje

deep-learning
transformers
nlp
Atención, encoder mínimo y lectura de curvas frente a una LSTM en clasificación de texto.
Author

Wilder Ramírez Delgado

Published

September 8, 2026

Transformers y modelos de lenguaje

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo construimos la atención escalada, entrenamos un encoder mínimo y una LSTM de control, y leemos ambos informes (curvas, F1, confianza) antes de hablar de BERT o GPT.

1. Introducción

LSTM lee en orden. El Transformer atiende en paralelo. Cambia cómputo, gradiente y escala.

Pregunta: qué calcula un head y si, en un IMDB recortado, el encoder mejora el acta respecto a una LSTM.

2. Qué ya se conoce

Embeddings, clasificación de texto, RNN/LSTM, softmax, la idea de Transfer Learning.

3. Protocolo de lectura de métricas

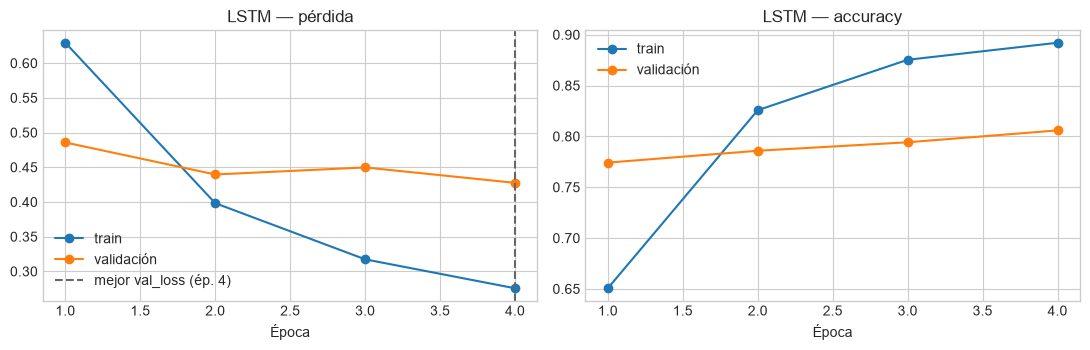
Mejor val_loss, gap train−val, reporte por clase o MSE de test, y solo después una decisión. El último print de fit no es el acta.

import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm
TensorFlow: 2.21.0
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU: ninguna (CPU)

Idea clave

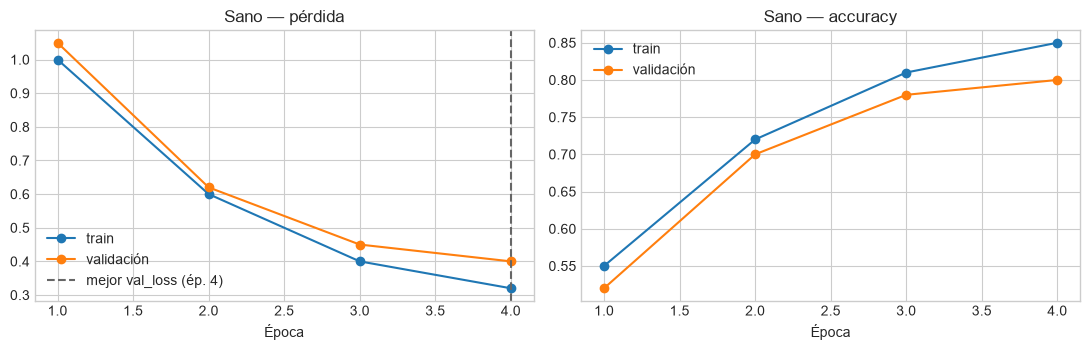
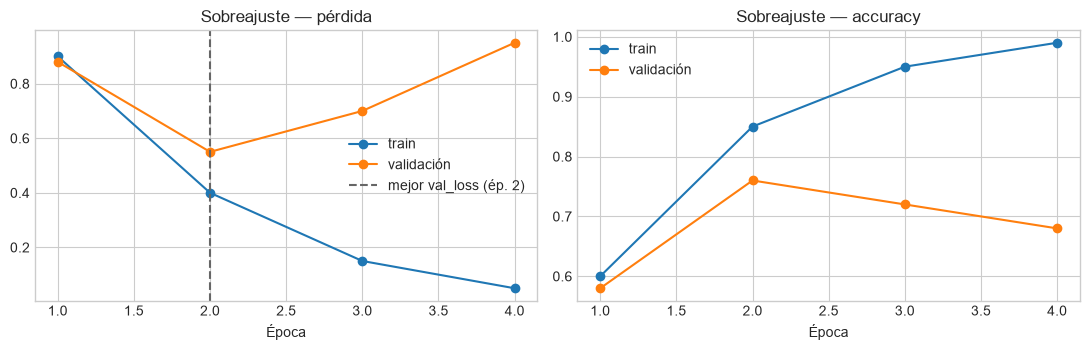
Una curva sin el índice de la mejor época es un dibujo. El informe empieza cuando se declara qué época se está reportando.

4. Laboratorio de lectura (history sintético)

sano={'loss':[1.0,0.6,0.4,0.32],'val_loss':[1.05,0.62,0.45,0.40],'accuracy':[0.55,0.72,0.81,0.85],'val_accuracy':[0.52,0.70,0.78,0.80]}
sobre={'loss':[0.9,0.4,0.15,0.05],'val_loss':[0.88,0.55,0.70,0.95],'accuracy':[0.6,0.85,0.95,0.99],'val_accuracy':[0.58,0.76,0.72,0.68]}
print('SANO'); diagnostico_entrenamiento(sano,'sano'); curvas_entrenamiento(sano,'Sano')
print('SOBRE'); diagnostico_entrenamiento(sobre,'sobre'); curvas_entrenamiento(sobre,'Sobreajuste')
SANO
modelo                  sano
epocas_corridas            4
mejor_epoca_val_loss       4
min_val_loss             0.4
val_loss_final           0.4
train_loss_en_mejor     0.32
train_loss_final        0.32
delta_val_tras_mejor     0.0
gap_loss_mejor          0.08
gap_loss_final          0.08
train_acc_mejor         0.85
val_acc_mejor            0.8
train_acc_final         0.85
val_acc_final            0.8
gap_acc_mejor           0.05
gap_acc_final           0.05

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

SOBRE
modelo                  sobre
epocas_corridas             4
mejor_epoca_val_loss        2
min_val_loss             0.55
val_loss_final           0.95
train_loss_en_mejor       0.4
train_loss_final         0.05
delta_val_tras_mejor      0.4
gap_loss_mejor           0.15
gap_loss_final            0.9
train_acc_mejor          0.85
val_acc_mejor            0.76
train_acc_final          0.99
val_acc_final            0.68
gap_acc_mejor            0.09
gap_acc_final            0.31

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

Interpretación

En el sobreajuste, reportar la época 4 como si fuera el modelo es un error de gobernanza. El checkpoint razonable es la época de mínima val_loss.

5. Embeddings

Tabla V×d. El significado operativo aparece cuando la tarea tira de esos vectores. Sin posición, la atención es una bolsa de palabras.

Idea clave

El embedding no ‘conoce’. Es un vector ajustable.

6. Atención escalada (NumPy)

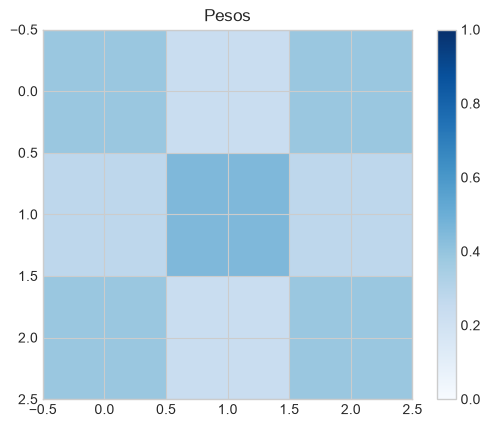
softmax(QK^T/√d) V. Promedio ponderado de valores, no una neurona recurrente.

def attn(Q,K,V):
    d=Q.shape[-1]; sc=Q@K.T/np.sqrt(d)
    w=np.exp(sc-sc.max(axis=-1,keepdims=True)); w=w/w.sum(axis=-1,keepdims=True)
    return w@V,w
Q=np.array([[1,0,0,0],[0,1,0,0],[1,0,0,0]],'float32'); K=Q.copy()
V=np.array([[10,0],[0,7],[1,1]],'float32')
sal,w=attn(Q,K,V)
print('pesos\n',np.round(w,3),'\nsalida\n',np.round(sal,3))
plt.imshow(w,cmap='Blues',vmin=0,vmax=1); plt.colorbar(); plt.title('Pesos'); plt.show()
pesos
 [[0.384 0.233 0.384]
 [0.274 0.452 0.274]
 [0.384 0.233 0.384]] 
salida
 [[4.22  2.013]
 [3.015 3.437]
 [4.22  2.013]]

Interpretación

q3 es paralela a k1: el tercer token toma el valor de v1. No hay un if: hay un producto interno.

7. Encoder–decoder, BERT y GPT

BERT ve ambos lados (MLM). GPT solo la izquierda (causal). No son el mismo contrato con otro logo.

8. Caso — Moderación de reseñas con dos arquitecturas

Mismo IMDB recortado (80 tokens, 4000 palabras). Encoder (MultiHeadAttention) vs LSTM. Mismo N de train. El acta compara val_loss, test acc, F1 y tiempo.

vocab,maxlen,d=4000,80,32
(xtr,ytr),(xte,yte)=tf.keras.datasets.imdb.load_data(num_words=vocab)
xtr=tf.keras.preprocessing.sequence.pad_sequences(xtr,maxlen=maxlen)
xte=tf.keras.preprocessing.sequence.pad_sequences(xte,maxlen=maxlen)
xtr,ytr,xte,yte=xtr[:8000],ytr[:8000],xte[:4000],yte[:4000]
print(xtr.shape,ytr.mean())
(8000, 80) 0.504625

9. LSTM de control

lstm=tf.keras.Sequential([
 tf.keras.layers.Embedding(vocab,d),
 tf.keras.layers.LSTM(32),
 tf.keras.layers.Dense(1,activation='sigmoid')])
lstm.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
t0=time.perf_counter()
h_l=lstm.fit(xtr,ytr,validation_split=0.15,epochs=4,batch_size=64,verbose=1)
t_l=time.perf_counter()-t0
Epoch 1/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 6:25 4s/step - accuracy: 0.5625 - loss: 0.6925

  3/107 ━━━━━━━━━━━━━━━━━━━━ 4s 41ms/step - accuracy: 0.5729 - loss: 0.6924

  5/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.5094 - loss: 0.6938

  7/107 ━━━━━━━━━━━━━━━━━━━━ 4s 40ms/step - accuracy: 0.5156 - loss: 0.6935

  9/107 ━━━━━━━━━━━━━━━━━━━━ 4s 43ms/step - accuracy: 0.5226 - loss: 0.6932

 11/107 ━━━━━━━━━━━━━━━━━━━━ 3s 42ms/step - accuracy: 0.5256 - loss: 0.6930

 13/107 ━━━━━━━━━━━━━━━━━━━━ 3s 40ms/step - accuracy: 0.5240 - loss: 0.6928

 15/107 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - accuracy: 0.5208 - loss: 0.6928

 17/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.5147 - loss: 0.6929

 18/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.5113 - loss: 0.6929

 20/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.5055 - loss: 0.6931

 22/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.5099 - loss: 0.6929

 24/107 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - accuracy: 0.5059 - loss: 0.6929

 26/107 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - accuracy: 0.5066 - loss: 0.6928

 28/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5128 - loss: 0.6927

 30/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5193 - loss: 0.6926

 31/107 ━━━━━━━━━━━━━━━━━━━━ 2s 38ms/step - accuracy: 0.5217 - loss: 0.6925

 33/107 ━━━━━━━━━━━━━━━━━━━━ 2s 38ms/step - accuracy: 0.5270 - loss: 0.6924

 35/107 ━━━━━━━━━━━━━━━━━━━━ 2s 38ms/step - accuracy: 0.5335 - loss: 0.6922

 37/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5410 - loss: 0.6920

 39/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5409 - loss: 0.6919

 41/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5503 - loss: 0.6915

 43/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5556 - loss: 0.6912

 45/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5615 - loss: 0.6908

 47/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5672 - loss: 0.6904

 49/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5746 - loss: 0.6895

 51/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5778 - loss: 0.6888

 53/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.5772 - loss: 0.6883

 55/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5810 - loss: 0.6860

 57/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5844 - loss: 0.6837

 59/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5866 - loss: 0.6816

 61/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5876 - loss: 0.6796

 63/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5878 - loss: 0.6787

 65/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5930 - loss: 0.6753

 66/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5933 - loss: 0.6764

 68/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5954 - loss: 0.6747

 70/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.5989 - loss: 0.6727

 72/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.6039 - loss: 0.6707

 74/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.6075 - loss: 0.6694

 76/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.6112 - loss: 0.6675

 78/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.6164 - loss: 0.6647

 80/107 ━━━━━━━━━━━━━━━━━━━━ 1s 38ms/step - accuracy: 0.6205 - loss: 0.6616

 82/107 ━━━━━━━━━━━━━━━━━━━━ 0s 37ms/step - accuracy: 0.6227 - loss: 0.6588

 84/107 ━━━━━━━━━━━━━━━━━━━━ 0s 37ms/step - accuracy: 0.6269 - loss: 0.6547

 87/107 ━━━━━━━━━━━━━━━━━━━━ 0s 37ms/step - accuracy: 0.6286 - loss: 0.6523

 89/107 ━━━━━━━━━━━━━━━━━━━━ 0s 37ms/step - accuracy: 0.6306 - loss: 0.6503

 91/107 ━━━━━━━━━━━━━━━━━━━━ 0s 37ms/step - accuracy: 0.6326 - loss: 0.6479

 93/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6366 - loss: 0.6442

 95/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6383 - loss: 0.6423

 97/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6406 - loss: 0.6395

 99/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6427 - loss: 0.6379

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6450 - loss: 0.6352

103/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6465 - loss: 0.6331

105/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6491 - loss: 0.6307

107/107 ━━━━━━━━━━━━━━━━━━━━ 0s 36ms/step - accuracy: 0.6506 - loss: 0.6293

107/107 ━━━━━━━━━━━━━━━━━━━━ 8s 44ms/step - accuracy: 0.6506 - loss: 0.6293 - val_accuracy: 0.7742 - val_loss: 0.4856

Epoch 2/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 9s 88ms/step - accuracy: 0.7812 - loss: 0.4174

  3/107 ━━━━━━━━━━━━━━━━━━━━ 3s 36ms/step - accuracy: 0.7760 - loss: 0.4431

  5/107 ━━━━━━━━━━━━━━━━━━━━ 3s 35ms/step - accuracy: 0.7844 - loss: 0.4483

  7/107 ━━━━━━━━━━━━━━━━━━━━ 3s 34ms/step - accuracy: 0.7857 - loss: 0.4545

  9/107 ━━━━━━━━━━━━━━━━━━━━ 3s 33ms/step - accuracy: 0.7899 - loss: 0.4545

 11/107 ━━━━━━━━━━━━━━━━━━━━ 3s 33ms/step - accuracy: 0.7869 - loss: 0.4582

 13/107 ━━━━━━━━━━━━━━━━━━━━ 3s 32ms/step - accuracy: 0.7897 - loss: 0.4544

 15/107 ━━━━━━━━━━━━━━━━━━━━ 2s 32ms/step - accuracy: 0.7937 - loss: 0.4499

 17/107 ━━━━━━━━━━━━━━━━━━━━ 2s 32ms/step - accuracy: 0.7904 - loss: 0.4515

 19/107 ━━━━━━━━━━━━━━━━━━━━ 2s 32ms/step - accuracy: 0.7936 - loss: 0.4499

 21/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7894 - loss: 0.4524

 23/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7846 - loss: 0.4565

 25/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7894 - loss: 0.4516

 27/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7888 - loss: 0.4527

 29/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7872 - loss: 0.4552

 31/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7843 - loss: 0.4592

 33/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7850 - loss: 0.4596

 35/107 ━━━━━━━━━━━━━━━━━━━━ 2s 33ms/step - accuracy: 0.7893 - loss: 0.4547

 37/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7893 - loss: 0.4533

 39/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7877 - loss: 0.4531

 41/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7889 - loss: 0.4520

 43/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7900 - loss: 0.4511

 45/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7944 - loss: 0.4462

 47/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.7939 - loss: 0.4462

 49/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.7978 - loss: 0.4422

 51/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.7984 - loss: 0.4417

 53/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.7986 - loss: 0.4414

 55/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8011 - loss: 0.4385

 57/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8037 - loss: 0.4339

 59/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8067 - loss: 0.4284

 61/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8079 - loss: 0.4271

 63/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8093 - loss: 0.4263

 65/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8113 - loss: 0.4228

 67/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8120 - loss: 0.4207

 69/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8130 - loss: 0.4196

 71/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8132 - loss: 0.4198

 73/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8149 - loss: 0.4179

 75/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8158 - loss: 0.4166

 77/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8180 - loss: 0.4147

 79/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8198 - loss: 0.4115

 81/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8206 - loss: 0.4087

 83/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8223 - loss: 0.4057

 84/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8227 - loss: 0.4043

 86/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8241 - loss: 0.4021

 88/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8235 - loss: 0.4029

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8238 - loss: 0.4023

 92/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8244 - loss: 0.4009

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 33ms/step - accuracy: 0.8250 - loss: 0.3997

 96/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8254 - loss: 0.3984

 98/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8254 - loss: 0.3980

100/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8255 - loss: 0.3978

102/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8251 - loss: 0.3985

104/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8253 - loss: 0.3985

106/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8255 - loss: 0.3988

107/107 ━━━━━━━━━━━━━━━━━━━━ 4s 38ms/step - accuracy: 0.8257 - loss: 0.3982 - val_accuracy: 0.7858 - val_loss: 0.4395

Epoch 3/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 11s 108ms/step - accuracy: 0.9375 - loss: 0.2292

  2/107 ━━━━━━━━━━━━━━━━━━━━ 5s 51ms/step - accuracy: 0.9062 - loss: 0.2852  

  3/107 ━━━━━━━━━━━━━━━━━━━━ 5s 51ms/step - accuracy: 0.9115 - loss: 0.2668

  4/107 ━━━━━━━━━━━━━━━━━━━━ 5s 52ms/step - accuracy: 0.9141 - loss: 0.2551

  5/107 ━━━━━━━━━━━━━━━━━━━━ 5s 52ms/step - accuracy: 0.9125 - loss: 0.2676

  7/107 ━━━━━━━━━━━━━━━━━━━━ 4s 44ms/step - accuracy: 0.9040 - loss: 0.2887

  9/107 ━━━━━━━━━━━━━━━━━━━━ 3s 40ms/step - accuracy: 0.8906 - loss: 0.3020

 11/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.8864 - loss: 0.3062

 12/107 ━━━━━━━━━━━━━━━━━━━━ 3s 40ms/step - accuracy: 0.8867 - loss: 0.3107

 14/107 ━━━━━━━━━━━━━━━━━━━━ 3s 40ms/step - accuracy: 0.8884 - loss: 0.3074

 15/107 ━━━━━━━━━━━━━━━━━━━━ 3s 41ms/step - accuracy: 0.8854 - loss: 0.3098

 17/107 ━━━━━━━━━━━━━━━━━━━━ 3s 40ms/step - accuracy: 0.8805 - loss: 0.3129

 19/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.8816 - loss: 0.3123

 21/107 ━━━━━━━━━━━━━━━━━━━━ 3s 39ms/step - accuracy: 0.8847 - loss: 0.3067

 23/107 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - accuracy: 0.8764 - loss: 0.3189

 25/107 ━━━━━━━━━━━━━━━━━━━━ 3s 37ms/step - accuracy: 0.8763 - loss: 0.3156

 27/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8738 - loss: 0.3187

 28/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8728 - loss: 0.3213

 30/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8687 - loss: 0.3282

 32/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8672 - loss: 0.3326

 34/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8667 - loss: 0.3329

 36/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8685 - loss: 0.3308

 38/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8713 - loss: 0.3286

 40/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8707 - loss: 0.3275

 42/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8713 - loss: 0.3263

 44/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8714 - loss: 0.3263

 46/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8733 - loss: 0.3220

 48/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8717 - loss: 0.3254

 50/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8737 - loss: 0.3221

 51/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8732 - loss: 0.3229

 53/107 ━━━━━━━━━━━━━━━━━━━━ 1s 37ms/step - accuracy: 0.8726 - loss: 0.3236

 55/107 ━━━━━━━━━━━━━━━━━━━━ 1s 36ms/step - accuracy: 0.8724 - loss: 0.3236

 57/107 ━━━━━━━━━━━━━━━━━━━━ 1s 36ms/step - accuracy: 0.8734 - loss: 0.3206

 59/107 ━━━━━━━━━━━━━━━━━━━━ 1s 36ms/step - accuracy: 0.8766 - loss: 0.3151

 61/107 ━━━━━━━━━━━━━━━━━━━━ 1s 36ms/step - accuracy: 0.8768 - loss: 0.3156

 63/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8772 - loss: 0.3157

 65/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8781 - loss: 0.3141

 67/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8778 - loss: 0.3126

 69/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8775 - loss: 0.3133

 71/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8768 - loss: 0.3147

 73/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8778 - loss: 0.3131

 75/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8773 - loss: 0.3133

 77/107 ━━━━━━━━━━━━━━━━━━━━ 1s 35ms/step - accuracy: 0.8782 - loss: 0.3124

 79/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8790 - loss: 0.3113

 81/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8796 - loss: 0.3102

 83/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8806 - loss: 0.3081

 85/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8813 - loss: 0.3067

 87/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8793 - loss: 0.3103

 89/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8790 - loss: 0.3109

 91/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8774 - loss: 0.3133

 93/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8775 - loss: 0.3134

 95/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8773 - loss: 0.3137

 97/107 ━━━━━━━━━━━━━━━━━━━━ 0s 34ms/step - accuracy: 0.8779 - loss: 0.3132

 99/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8772 - loss: 0.3148

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8772 - loss: 0.3147

103/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8752 - loss: 0.3167

105/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8757 - loss: 0.3168

107/107 ━━━━━━━━━━━━━━━━━━━━ 0s 35ms/step - accuracy: 0.8753 - loss: 0.3173

107/107 ━━━━━━━━━━━━━━━━━━━━ 4s 39ms/step - accuracy: 0.8753 - loss: 0.3173 - val_accuracy: 0.7942 - val_loss: 0.4496

Epoch 4/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 12s 121ms/step - accuracy: 0.9531 - loss: 0.1736

  3/107 ━━━━━━━━━━━━━━━━━━━━ 4s 42ms/step - accuracy: 0.9271 - loss: 0.1992  

  4/107 ━━━━━━━━━━━━━━━━━━━━ 4s 45ms/step - accuracy: 0.9219 - loss: 0.2041

  6/107 ━━━━━━━━━━━━━━━━━━━━ 4s 41ms/step - accuracy: 0.9219 - loss: 0.2066

  8/107 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - accuracy: 0.9043 - loss: 0.2438

 10/107 ━━━━━━━━━━━━━━━━━━━━ 3s 36ms/step - accuracy: 0.9094 - loss: 0.2327

 12/107 ━━━━━━━━━━━━━━━━━━━━ 3s 34ms/step - accuracy: 0.9049 - loss: 0.2369

 14/107 ━━━━━━━━━━━━━━━━━━━━ 3s 34ms/step - accuracy: 0.9029 - loss: 0.2443

 16/107 ━━━━━━━━━━━━━━━━━━━━ 3s 35ms/step - accuracy: 0.9033 - loss: 0.2466

 18/107 ━━━━━━━━━━━━━━━━━━━━ 3s 36ms/step - accuracy: 0.9062 - loss: 0.2419

 20/107 ━━━━━━━━━━━━━━━━━━━━ 3s 36ms/step - accuracy: 0.9078 - loss: 0.2374

 22/107 ━━━━━━━━━━━━━━━━━━━━ 3s 37ms/step - accuracy: 0.9013 - loss: 0.2485

 24/107 ━━━━━━━━━━━━━━━━━━━━ 3s 37ms/step - accuracy: 0.9004 - loss: 0.2465

 26/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.9008 - loss: 0.2480

 28/107 ━━━━━━━━━━━━━━━━━━━━ 2s 38ms/step - accuracy: 0.8973 - loss: 0.2537

 30/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8943 - loss: 0.2622

 32/107 ━━━━━━━━━━━━━━━━━━━━ 2s 38ms/step - accuracy: 0.8921 - loss: 0.2652

 34/107 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - accuracy: 0.8902 - loss: 0.2685

 36/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8898 - loss: 0.2683

 39/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8906 - loss: 0.2677

 41/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8921 - loss: 0.2651

 43/107 ━━━━━━━━━━━━━━━━━━━━ 2s 36ms/step - accuracy: 0.8935 - loss: 0.2651

 46/107 ━━━━━━━━━━━━━━━━━━━━ 2s 35ms/step - accuracy: 0.8971 - loss: 0.2577

 48/107 ━━━━━━━━━━━━━━━━━━━━ 2s 34ms/step - accuracy: 0.8955 - loss: 0.2640

 51/107 ━━━━━━━━━━━━━━━━━━━━ 1s 34ms/step - accuracy: 0.8971 - loss: 0.2624

 53/107 ━━━━━━━━━━━━━━━━━━━━ 1s 34ms/step - accuracy: 0.8971 - loss: 0.2634

 55/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8960 - loss: 0.2643

 57/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8969 - loss: 0.2620

 59/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.8996 - loss: 0.2580

 62/107 ━━━━━━━━━━━━━━━━━━━━ 1s 33ms/step - accuracy: 0.9010 - loss: 0.2578

 65/107 ━━━━━━━━━━━━━━━━━━━━ 1s 32ms/step - accuracy: 0.9012 - loss: 0.2582

 67/107 ━━━━━━━━━━━━━━━━━━━━ 1s 32ms/step - accuracy: 0.9021 - loss: 0.2570

 69/107 ━━━━━━━━━━━━━━━━━━━━ 1s 32ms/step - accuracy: 0.9019 - loss: 0.2581

 72/107 ━━━━━━━━━━━━━━━━━━━━ 1s 32ms/step - accuracy: 0.9006 - loss: 0.2604

 74/107 ━━━━━━━━━━━━━━━━━━━━ 1s 31ms/step - accuracy: 0.8999 - loss: 0.2601

 77/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.9004 - loss: 0.2598

 80/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.9010 - loss: 0.2583

 82/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.9002 - loss: 0.2603

 84/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.9012 - loss: 0.2594

 86/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.9012 - loss: 0.2598

 88/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.8981 - loss: 0.2638

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 31ms/step - accuracy: 0.8969 - loss: 0.2647

 92/107 ━━━━━━━━━━━━━━━━━━━━ 0s 30ms/step - accuracy: 0.8971 - loss: 0.2652

 95/107 ━━━━━━━━━━━━━━━━━━━━ 0s 30ms/step - accuracy: 0.8959 - loss: 0.2676

 98/107 ━━━━━━━━━━━━━━━━━━━━ 0s 30ms/step - accuracy: 0.8951 - loss: 0.2692

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 30ms/step - accuracy: 0.8954 - loss: 0.2698

104/107 ━━━━━━━━━━━━━━━━━━━━ 0s 30ms/step - accuracy: 0.8938 - loss: 0.2731

107/107 ━━━━━━━━━━━━━━━━━━━━ 0s 29ms/step - accuracy: 0.8921 - loss: 0.2756

107/107 ━━━━━━━━━━━━━━━━━━━━ 4s 33ms/step - accuracy: 0.8921 - loss: 0.2756 - val_accuracy: 0.8058 - val_loss: 0.4275

10. Informe LSTM

fl=diagnostico_entrenamiento(h_l,'LSTM reseñas')
curvas_entrenamiento(h_l,'LSTM')
el=lstm.evaluate(xte,yte,verbose=0)
print('TEST LSTM',el,'tiempo',round(t_l,1))
modelo                  LSTM reseñas
epocas_corridas                    4
mejor_epoca_val_loss               4
min_val_loss                0.427502
val_loss_final              0.427502
train_loss_en_mejor         0.275594
train_loss_final            0.275594
delta_val_tras_mejor             0.0
gap_loss_mejor              0.151908
gap_loss_final              0.151908
train_acc_mejor             0.892059
val_acc_mejor               0.805833
train_acc_final             0.892059
val_acc_final               0.805833
gap_acc_mejor               0.086226
gap_acc_final               0.086226

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.

TEST LSTM [0.45472025871276855, 0.7917500138282776] tiempo 20.5

11. Encoder mínimo (atención + posiciones)

inp=tf.keras.Input((maxlen,),dtype='int32')
pos=tf.range(0,maxlen)
x=tf.keras.layers.Embedding(vocab,d)(inp)+tf.keras.layers.Embedding(maxlen,d)(pos)
x=tf.keras.layers.MultiHeadAttention(4,8)(x,x)
x=tf.keras.layers.GlobalAveragePooling1D()(x)
x=tf.keras.layers.Dropout(0.2)(x)
enc=tf.keras.Model(inp,tf.keras.layers.Dense(1,activation='sigmoid')(x))
enc.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
t0=time.perf_counter()
h_e=enc.fit(xtr,ytr,validation_split=0.15,epochs=4,batch_size=64,verbose=1)
t_e=time.perf_counter()-t0
Epoch 1/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 5:16 3s/step - accuracy: 0.5469 - loss: 0.6932

  3/107 ━━━━━━━━━━━━━━━━━━━━ 3s 31ms/step - accuracy: 0.5573 - loss: 0.6925

  6/107 ━━━━━━━━━━━━━━━━━━━━ 2s 28ms/step - accuracy: 0.5026 - loss: 0.6944

  9/107 ━━━━━━━━━━━━━━━━━━━━ 2s 24ms/step - accuracy: 0.5156 - loss: 0.6931

 13/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.5168 - loss: 0.6928

 17/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5101 - loss: 0.6928

 20/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5016 - loss: 0.6931

 23/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5027 - loss: 0.6929

 26/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.4982 - loss: 0.6929

 29/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5086 - loss: 0.6926

 32/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5161 - loss: 0.6925

 35/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5188 - loss: 0.6922

 38/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5238 - loss: 0.6918

 42/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5335 - loss: 0.6913

 46/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.5486 - loss: 0.6905

 50/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.5572 - loss: 0.6897

 54/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5645 - loss: 0.6891

 58/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5700 - loss: 0.6882

 61/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5743 - loss: 0.6877

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5786 - loss: 0.6870

 67/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5837 - loss: 0.6857

 70/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5882 - loss: 0.6846

 74/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5938 - loss: 0.6828

 78/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.5984 - loss: 0.6805

 82/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6048 - loss: 0.6773

 86/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6090 - loss: 0.6739

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6137 - loss: 0.6711

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6197 - loss: 0.6667

 97/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6234 - loss: 0.6630

100/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6266 - loss: 0.6602

103/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6296 - loss: 0.6570

107/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.6334 - loss: 0.6535

107/107 ━━━━━━━━━━━━━━━━━━━━ 5s 24ms/step - accuracy: 0.6334 - loss: 0.6535 - val_accuracy: 0.7533 - val_loss: 0.5132

Epoch 2/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 9s 92ms/step - accuracy: 0.7969 - loss: 0.4479

  4/107 ━━━━━━━━━━━━━━━━━━━━ 2s 24ms/step - accuracy: 0.8008 - loss: 0.4640

  7/107 ━━━━━━━━━━━━━━━━━━━━ 2s 23ms/step - accuracy: 0.7857 - loss: 0.4771

 10/107 ━━━━━━━━━━━━━━━━━━━━ 2s 23ms/step - accuracy: 0.7859 - loss: 0.4816

 13/107 ━━━━━━━━━━━━━━━━━━━━ 2s 22ms/step - accuracy: 0.7861 - loss: 0.4754

 17/107 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.7895 - loss: 0.4685

 21/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.7887 - loss: 0.4659

 25/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7881 - loss: 0.4616

 29/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7877 - loss: 0.4586

 32/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7832 - loss: 0.4636

 35/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7853 - loss: 0.4566

 39/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7861 - loss: 0.4520

 42/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7894 - loss: 0.4470

 46/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7928 - loss: 0.4396

 49/107 ━━━━━━━━━━━━━━━━━━━━ 1s 18ms/step - accuracy: 0.7921 - loss: 0.4380

 53/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.7930 - loss: 0.4352

 57/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.7961 - loss: 0.4305

 61/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.7992 - loss: 0.4247

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8013 - loss: 0.4240

 67/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8018 - loss: 0.4216

 70/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8031 - loss: 0.4227

 73/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8046 - loss: 0.4201

 76/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8072 - loss: 0.4165

 79/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8095 - loss: 0.4129

 82/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8115 - loss: 0.4095

 86/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8143 - loss: 0.4055

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8141 - loss: 0.4056

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8168 - loss: 0.4018

 97/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8183 - loss: 0.3995

100/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8192 - loss: 0.3980

103/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8190 - loss: 0.3970

106/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8191 - loss: 0.3974

107/107 ━━━━━━━━━━━━━━━━━━━━ 2s 20ms/step - accuracy: 0.8193 - loss: 0.3971 - val_accuracy: 0.7992 - val_loss: 0.4078

Epoch 3/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 8s 82ms/step - accuracy: 0.8750 - loss: 0.2924

  3/107 ━━━━━━━━━━━━━━━━━━━━ 3s 31ms/step - accuracy: 0.8802 - loss: 0.2717

  5/107 ━━━━━━━━━━━━━━━━━━━━ 2s 29ms/step - accuracy: 0.8781 - loss: 0.2821

  7/107 ━━━━━━━━━━━━━━━━━━━━ 3s 33ms/step - accuracy: 0.8683 - loss: 0.3039

  9/107 ━━━━━━━━━━━━━━━━━━━━ 3s 31ms/step - accuracy: 0.8715 - loss: 0.3089

 12/107 ━━━━━━━━━━━━━━━━━━━━ 2s 28ms/step - accuracy: 0.8620 - loss: 0.3080

 15/107 ━━━━━━━━━━━━━━━━━━━━ 2s 26ms/step - accuracy: 0.8625 - loss: 0.3083

 19/107 ━━━━━━━━━━━━━━━━━━━━ 2s 23ms/step - accuracy: 0.8660 - loss: 0.3064

 23/107 ━━━━━━━━━━━━━━━━━━━━ 1s 22ms/step - accuracy: 0.8573 - loss: 0.3187

 26/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.8654 - loss: 0.3075

 29/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.8669 - loss: 0.3091

 31/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.8639 - loss: 0.3170

 33/107 ━━━━━━━━━━━━━━━━━━━━ 1s 22ms/step - accuracy: 0.8641 - loss: 0.3173

 36/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.8637 - loss: 0.3158

 40/107 ━━━━━━━━━━━━━━━━━━━━ 1s 21ms/step - accuracy: 0.8672 - loss: 0.3128

 45/107 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.8694 - loss: 0.3072

 49/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.8693 - loss: 0.3071

 52/107 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.8684 - loss: 0.3084

 54/107 ━━━━━━━━━━━━━━━━━━━━ 1s 20ms/step - accuracy: 0.8695 - loss: 0.3062

 57/107 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - accuracy: 0.8701 - loss: 0.3048

 60/107 ━━━━━━━━━━━━━━━━━━━━ 0s 20ms/step - accuracy: 0.8729 - loss: 0.3014

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - accuracy: 0.8738 - loss: 0.3003

 68/107 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - accuracy: 0.8739 - loss: 0.2992

 72/107 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - accuracy: 0.8741 - loss: 0.3005

 76/107 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - accuracy: 0.8756 - loss: 0.2981

 80/107 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - accuracy: 0.8785 - loss: 0.2943

 84/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8798 - loss: 0.2909

 88/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8784 - loss: 0.2943

 92/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8798 - loss: 0.2914

 96/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8800 - loss: 0.2903

100/107 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - accuracy: 0.8802 - loss: 0.2901

104/107 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - accuracy: 0.8798 - loss: 0.2906

107/107 ━━━━━━━━━━━━━━━━━━━━ 2s 19ms/step - accuracy: 0.8790 - loss: 0.2918 - val_accuracy: 0.8125 - val_loss: 0.4204

Epoch 4/4


  1/107 ━━━━━━━━━━━━━━━━━━━━ 6s 59ms/step - accuracy: 0.9062 - loss: 0.2383

  4/107 ━━━━━━━━━━━━━━━━━━━━ 2s 20ms/step - accuracy: 0.8984 - loss: 0.2242

  7/107 ━━━━━━━━━━━━━━━━━━━━ 1s 19ms/step - accuracy: 0.8906 - loss: 0.2508

 11/107 ━━━━━━━━━━━━━━━━━━━━ 1s 17ms/step - accuracy: 0.8892 - loss: 0.2478

 15/107 ━━━━━━━━━━━━━━━━━━━━ 1s 16ms/step - accuracy: 0.8896 - loss: 0.2511

 19/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.8964 - loss: 0.2451

 23/107 ━━━━━━━━━━━━━━━━━━━━ 1s 15ms/step - accuracy: 0.8913 - loss: 0.2588

 28/107 ━━━━━━━━━━━━━━━━━━━━ 1s 14ms/step - accuracy: 0.8968 - loss: 0.2517

 32/107 ━━━━━━━━━━━━━━━━━━━━ 1s 14ms/step - accuracy: 0.8955 - loss: 0.2605

 36/107 ━━━━━━━━━━━━━━━━━━━━ 1s 14ms/step - accuracy: 0.8967 - loss: 0.2583

 40/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8984 - loss: 0.2565

 43/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.8986 - loss: 0.2557

 47/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9006 - loss: 0.2519

 51/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9023 - loss: 0.2488

 55/107 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.9006 - loss: 0.2508

 60/107 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.9031 - loss: 0.2459

 64/107 ━━━━━━━━━━━━━━━━━━━━ 0s 14ms/step - accuracy: 0.9038 - loss: 0.2455

 67/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9042 - loss: 0.2438

 70/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9038 - loss: 0.2465

 74/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9052 - loss: 0.2437

 78/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9073 - loss: 0.2402

 82/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9080 - loss: 0.2382

 86/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9086 - loss: 0.2365

 90/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9080 - loss: 0.2379

 94/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9084 - loss: 0.2366

 98/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9090 - loss: 0.2360

101/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9092 - loss: 0.2364

104/107 ━━━━━━━━━━━━━━━━━━━━ 0s 15ms/step - accuracy: 0.9087 - loss: 0.2368

107/107 ━━━━━━━━━━━━━━━━━━━━ 2s 17ms/step - accuracy: 0.9081 - loss: 0.2381 - val_accuracy: 0.8083 - val_loss: 0.4672

12. Informe del encoder

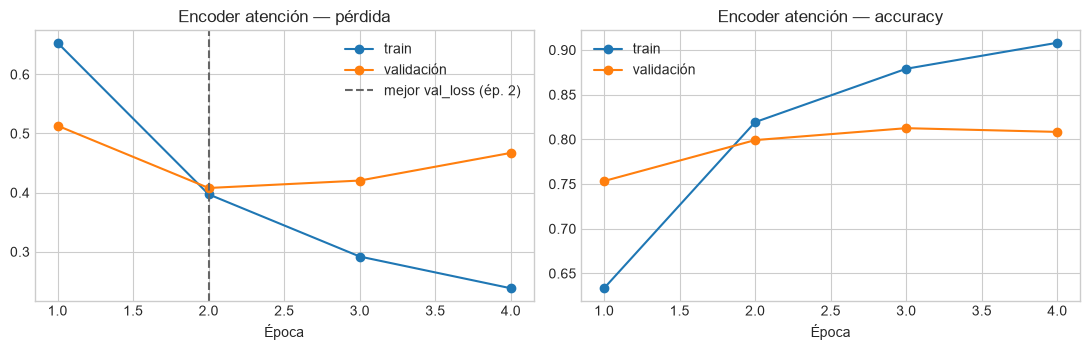
fe=diagnostico_entrenamiento(h_e,'encoder')
curvas_entrenamiento(h_e,'Encoder atención')
ee=enc.evaluate(xte,yte,verbose=0)
print('TEST ENC',ee,'tiempo',round(t_e,1))
modelo                   encoder
epocas_corridas                4
mejor_epoca_val_loss           2
min_val_loss             0.40779
val_loss_final           0.46716
train_loss_en_mejor     0.397077
train_loss_final        0.238133
delta_val_tras_mejor    0.059369
gap_loss_mejor          0.010714
gap_loss_final          0.229027
train_acc_mejor         0.819265
val_acc_mejor           0.799167
train_acc_final         0.908088
val_acc_final           0.808333
gap_acc_mejor           0.020098
gap_acc_final           0.099755

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

TEST ENC [0.471636027097702, 0.8112499713897705] tiempo 11.8

13. Tabla LSTM vs encoder

df=pd.DataFrame([
 {'modelo':'LSTM','test_acc':el[1],'test_loss':el[0],'tiempo':t_l,'params':lstm.count_params(),
  'mejor_epoca':fl.get('mejor_epoca_val_loss'),'gap':fl.get('gap_acc_final')},
 {'modelo':'encoder','test_acc':ee[1],'test_loss':ee[0],'tiempo':t_e,'params':enc.count_params(),
  'mejor_epoca':fe.get('mejor_epoca_val_loss'),'gap':fe.get('gap_acc_final')},
])
print(df.to_string(index=False,float_format=lambda v:f'{v:.4f}'))
print('Si el encoder no gana, el modelo es pequeño o el recorte 80 tokens no premia el acceso global.')
 modelo  test_acc  test_loss  tiempo  params  mejor_epoca    gap
   LSTM    0.7918     0.4547 20.4639  136353            4 0.0862
encoder    0.8112     0.4716 11.7671  132257            2 0.0998
Si el encoder no gana, el modelo es pequeño o el recorte 80 tokens no premia el acceso global.

Interpretación

No se refute Vaswani 2017 con 4 épocas. Se decida si, en este presupuesto, la atención mejoró el acta.

14. Reportes de clasificación lado a lado

for nom,m in [('LSTM',lstm),('encoder',enc)]:
    p=m.predict(xte,verbose=0).ravel(); h=(p>=0.5).astype(int)
    print('\n',nom); print(classification_report(yte,h,target_names=['neg','pos'],digits=3))

 LSTM
              precision    recall  f1-score   support

         neg      0.776     0.840     0.807      2071
         pos      0.811     0.740     0.774      1929

    accuracy                          0.792      4000
   macro avg      0.794     0.790     0.790      4000
weighted avg      0.793     0.792     0.791      4000


 encoder
              precision    recall  f1-score   support

         neg      0.821     0.813     0.817      2071
         pos      0.801     0.809     0.805      1929

    accuracy                          0.811      4000
   macro avg      0.811     0.811     0.811      4000
weighted avg      0.811     0.811     0.811      4000

15. Encoder sin posiciones (ablación)

Si el accuracy cae, la posición era información, no adorno.

inp=tf.keras.Input((maxlen,),dtype='int32')
x=tf.keras.layers.Embedding(vocab,d)(inp)
x=tf.keras.layers.MultiHeadAttention(4,8)(x,x)
x=tf.keras.layers.GlobalAveragePooling1D()(x)
ab=tf.keras.Model(inp,tf.keras.layers.Dense(1,activation='sigmoid')(x))
ab.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
h_ab=ab.fit(xtr,ytr,validation_split=0.15,epochs=3,batch_size=64,verbose=0)
print('TEST sin pos', ab.evaluate(xte,yte,verbose=0), 'con pos', ee)
diagnostico_entrenamiento(h_ab,'sin posiciones')
TEST sin pos [0.43026256561279297, 0.8177499771118164] con pos [0.471636027097702, 0.8112499713897705]
modelo                  sin posiciones
epocas_corridas                      3
mejor_epoca_val_loss                 2
min_val_loss                  0.404755
val_loss_final                0.423966
train_loss_en_mejor           0.378427
train_loss_final              0.283263
delta_val_tras_mejor          0.019211
gap_loss_mejor                0.026328
gap_loss_final                0.140703
train_acc_mejor               0.828676
val_acc_mejor                 0.808333
train_acc_final               0.882206
val_acc_final                    0.815
gap_acc_mejor                 0.020343
gap_acc_final                 0.067206

LECTURA
La mejor val_loss no es la última época (2 de 3). Si restore_best_weights=True, el modelo guardado no es el del último paso.
{'modelo': 'sin posiciones',
 'epocas_corridas': 3,
 'mejor_epoca_val_loss': 2,
 'min_val_loss': 0.4047550857067108,
 'val_loss_final': 0.42396610975265503,
 'train_loss_en_mejor': 0.3784268796443939,
 'train_loss_final': 0.28326261043548584,
 'delta_val_tras_mejor': 0.019211024045944214,
 'gap_loss_mejor': 0.026328206062316895,
 'gap_loss_final': 0.1407034993171692,
 'train_acc_mejor': 0.8286764621734619,
 'val_acc_mejor': 0.8083333373069763,
 'train_acc_final': 0.8822059035301208,
 'val_acc_final': 0.8149999976158142,
 'gap_acc_mejor': 0.020343124866485596,
 'gap_acc_final': 0.06720590591430664}

16. Fine-tuning en producción (contrato, no descarga)

Tokenizer del modelo, pesos BERT/GPT, congelar o no según N (sesión 7). Este artículo no baja un checkpoint de 400 MB: el contrato es el mismo que MobileNet.

Idea clave

Elegir BERT o GPT es elegir qué información puede usar cada token.

17. Histogramas de confianza: LSTM vs encoder

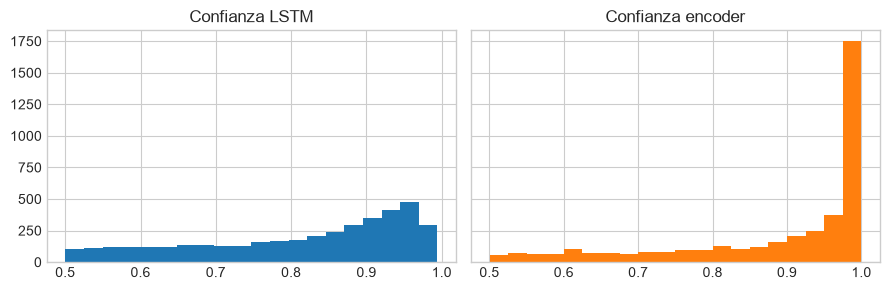
Dos modelos pueden empatar en accuracy y disentir en si están seguros. Eso importa para moderación automática (umbral de envío a humano).

pl = lstm.predict(xte, verbose=0).ravel()
pe = enc.predict(xte, verbose=0).ravel()
fig, ax = plt.subplots(1, 2, figsize=(9, 3), sharey=True)
ax[0].hist(np.where(pl >= 0.5, pl, 1 - pl), bins=20, color="C0")
ax[0].set_title("Confianza LSTM")
ax[1].hist(np.where(pe >= 0.5, pe, 1 - pe), bins=20, color="C1")
ax[1].set_title("Confianza encoder")
plt.tight_layout()
plt.show()
print("media conf LSTM", float(np.where(pl >= 0.5, pl, 1 - pl).mean()),
      "encoder", float(np.where(pe >= 0.5, pe, 1 - pe).mean()))

media conf LSTM 0.8122921586036682 encoder 0.888777494430542

Interpretación

Si el encoder apila masa en 0.95 y se equivoca igual, está mal calibrado. Un moderador humano prefiere menos confianza y más rechazo que errores seguros.

18. Desacuerdo entre arquitecturas

Casos en que LSTM y encoder no coinciden: ahí el «acceso global» de la atención, si existe, debería verse.

hl = (pl >= 0.5).astype(int)
he = (pe >= 0.5).astype(int)
disc = hl != he
print("desacuerdos", int(disc.sum()), "de", len(hl))
print("cuando desacuerdan, acierta LSTM", float((hl[disc] == yte[disc]).mean()) if disc.any() else "n/a")
print("cuando desacuerdan, acierta encoder", float((he[disc] == yte[disc]).mean()) if disc.any() else "n/a")
desacuerdos 568 de 4000
cuando desacuerdan, acierta LSTM 0.43133802816901406
cuando desacuerdan, acierta encoder 0.5686619718309859

19. Atención sobre una reseña corta (tokens numéricos)

No hay tokenizer de palabras aquí (IMDB viene indexado). Mostramos la fila de pesos del primer head aproximando con un forward de MultiHeadAttention no es trivial sin extraer pesos. En su lugar, medimos la entropía media de la softmax de atención en NumPy sobre 3 tokens sintéticos con distinta alineación: baja entropía = head colapsado.

def entropia(w):
    w = np.clip(w, 1e-12, 1)
    return float(-(w * np.log(w)).sum(axis=-1).mean())

_, w_alinea = attn(Q, K, V)
Q2 = np.eye(3, 4, dtype="float32")
_, w_disp = attn(Q2, Q2, V[:3] if False else np.random.default_rng(0).normal(size=(3, 2)).astype("float32"))
# V para Q2
V2 = np.random.default_rng(0).normal(size=(3, 2)).astype("float32")
_, w_disp = attn(Q2, Q2, V2)
print("entropía atención alineada", entropia(w_alinea), "dispersa", entropia(w_disp))
print("Entropía baja: un token se lleva la masa. Alta: el head mezcla.")
entropía atención alineada 1.0723940339972688 dispersa 1.0684453884788403
Entropía baja: un token se lleva la masa. Alta: el head mezcla.

20. Tiempo por época en el acta

LSTM y encoder no se comparan solo en F1. El tiempo de fit ya se midió; aquí se reduce a segundos por época para no premiar al que hizo una época extra por EarlyStopping.

print(f"LSTM  {t_l/len(h_l.history['loss']):.2f} s/época  ({len(h_l.history['loss'])} épocas)")
print(f"Enc   {t_e/len(h_e.history['loss']):.2f} s/época  ({len(h_e.history['loss'])} épocas)")
LSTM  5.12 s/época  (4 épocas)
Enc   2.94 s/época  (4 épocas)

Amenazas a la validez

80 tokens no es NLU; un bloque no es un Transformer de 12 capas; sin tokenizer original no hay BERT.

Temperatura del softmax de atención

√d evita saturación. Scores enormes → un token se lleva toda la masa → el head deja de mezclar.

Máscara causal

GPT no puede ‘mirar’ el final de la frase para predecir el medio. Eso no es una limitación menor: es el oficio de generar.

Calibración

Igual que en visión, p=0.99 en una reseña irónica puede ser un error seguro. Cuente esos casos.

Cierre

La atención es un promedio ponderado. El valor se demuestra en el informe frente a una LSTM, no en el nombre del paper.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.