Redes Generativas Adversarias (GANs)

deep-learning
gan
modelos-generativos
GAN mínima en dígitos y moda: lectura de pérdidas D/G y de diversidad de muestras.
Author

Wilder Ramírez Delgado

Published

September 9, 2026

Redes Generativas Adversarias (GANs)

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo planteamos el juego generador–discriminador, entrenamos una GAN mínima y leemos las pérdidas adversarias con el mismo rigor que un val_loss: no como accuracy disfrazado.

1. Introducción

Hasta ahora los modelos discriminan. Una GAN muestrea x nuevos. El equilibrio teórico es frágil: colapso de modos, oscilación, un D que gana demasiado pronto.

Pregunta: qué está optimizando cada red y qué no garantiza una grilla ‘bonita’.

2. Qué ya se conoce

CNN, pérdida binaria, entrenamiento por épocas, la idea de distribución.

3. Protocolo de lectura de métricas

Mejor val_loss, gap train−val, reporte por clase o MSE de test, y solo después una decisión. El último print de fit no es el acta.

import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm
TensorFlow: 2.21.0
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU: ninguna (CPU)

Idea clave

Una curva sin el índice de la mejor época es un dibujo. El informe empieza cuando se declara qué época se está reportando.

4. Laboratorio de lectura (history sintético)

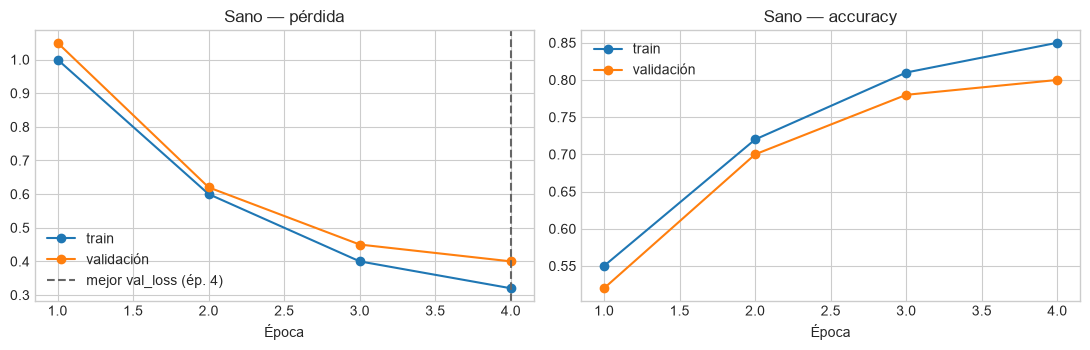
sano={'loss':[1.0,0.6,0.4,0.32],'val_loss':[1.05,0.62,0.45,0.40],'accuracy':[0.55,0.72,0.81,0.85],'val_accuracy':[0.52,0.70,0.78,0.80]}
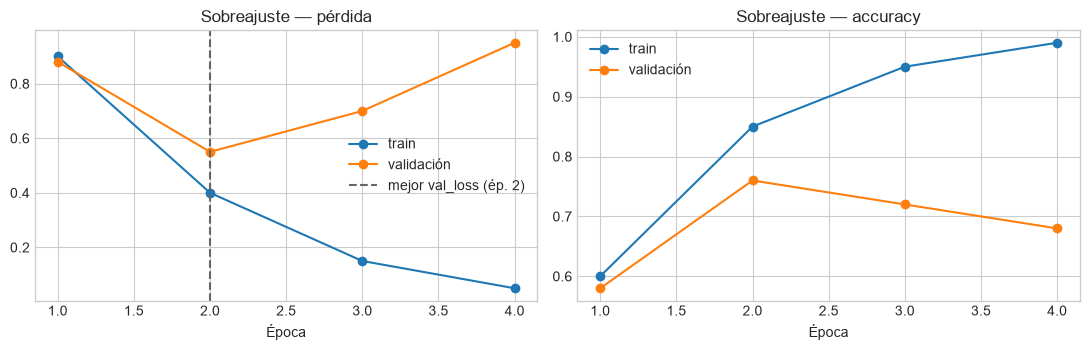
sobre={'loss':[0.9,0.4,0.15,0.05],'val_loss':[0.88,0.55,0.70,0.95],'accuracy':[0.6,0.85,0.95,0.99],'val_accuracy':[0.58,0.76,0.72,0.68]}
print('SANO'); diagnostico_entrenamiento(sano,'sano'); curvas_entrenamiento(sano,'Sano')
print('SOBRE'); diagnostico_entrenamiento(sobre,'sobre'); curvas_entrenamiento(sobre,'Sobreajuste')
SANO
modelo                  sano
epocas_corridas            4
mejor_epoca_val_loss       4
min_val_loss             0.4
val_loss_final           0.4
train_loss_en_mejor     0.32
train_loss_final        0.32
delta_val_tras_mejor     0.0
gap_loss_mejor          0.08
gap_loss_final          0.08
train_acc_mejor         0.85
val_acc_mejor            0.8
train_acc_final         0.85
val_acc_final            0.8
gap_acc_mejor           0.05
gap_acc_final           0.05

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

SOBRE
modelo                  sobre
epocas_corridas             4
mejor_epoca_val_loss        2
min_val_loss             0.55
val_loss_final           0.95
train_loss_en_mejor       0.4
train_loss_final         0.05
delta_val_tras_mejor      0.4
gap_loss_mejor           0.15
gap_loss_final            0.9
train_acc_mejor          0.85
val_acc_mejor            0.76
train_acc_final          0.99
val_acc_final            0.68
gap_acc_mejor            0.09
gap_acc_final            0.31

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

Interpretación

En el sobreajuste, reportar la época 4 como si fuera el modelo es un error de gobernanza. El checkpoint razonable es la época de mínima val_loss.

5. Generativo vs discriminativo

Discriminativo: p(y|x). Generativo: p(x). Una CNN que clasifica un 3 no necesita dibujarlo.

6. Pérdida adversaria

D maximiza acertar real vs falso. G maximiza que D(G(z)) se acerque a 1. G no ve imágenes reales: ve el gradiente que pasa por D.

Idea clave

Bajar la pérdida de G no equivale a mejores imágenes. Hay que mirar las muestras y, en papers, FID. Aquí el acta es pérdida + grilla + repetición visual.

7. Caso 1 — Dígitos de un captcha interno (MNIST)

8 000 muestras, MLP, pocas épocas. Objetivo: el mecanismo, no StyleGAN.

(x,_),_=tf.keras.datasets.mnist.load_data()
x=(x.astype('float32')/255.0)[:8000].reshape(-1,28*28)
LAT,LOTE=64,128
G=tf.keras.Sequential([tf.keras.layers.Input((LAT,)),tf.keras.layers.Dense(128,activation='relu'),tf.keras.layers.Dense(784,activation='sigmoid')],name='G')
D=tf.keras.Sequential([tf.keras.layers.Input((784,)),tf.keras.layers.Dense(128,activation='relu'),tf.keras.layers.Dense(1,activation='sigmoid')],name='D')
bce=tf.keras.losses.BinaryCrossentropy()
optg,optd=tf.keras.optimizers.Adam(2e-4),tf.keras.optimizers.Adam(2e-4)
@tf.function
def paso(reales):
    z=tf.random.normal((tf.shape(reales)[0],LAT))
    with tf.GradientTape() as td:
        f=G(z,training=True); pr=D(reales,training=True); pf=D(f,training=True)
        ld=bce(tf.ones_like(pr),pr)+bce(tf.zeros_like(pf),pf)
    optd.apply_gradients(zip(td.gradient(ld,D.trainable_variables),D.trainable_variables))
    z=tf.random.normal((tf.shape(reales)[0],LAT))
    with tf.GradientTape() as tg:
        f=G(z,training=True); pf=D(f,training=True); lg=bce(tf.ones_like(pf),pf)
    optg.apply_gradients(zip(tg.gradient(lg,G.trainable_variables),G.trainable_variables))
    return ld,lg
ds=tf.data.Dataset.from_tensor_slices(x).shuffle(8000).batch(LOTE)
hist_d,hist_g=[],[]
for e in range(1,13):
    accd=accg=n=0
    for lote in ds:
        ld,lg=paso(lote); accd+=float(ld); accg+=float(lg); n+=1
    hist_d.append(accd/n); hist_g.append(accg/n)
    print(f'Época {e:02d}  D={hist_d[-1]:.3f}  G={hist_g[-1]:.3f}')
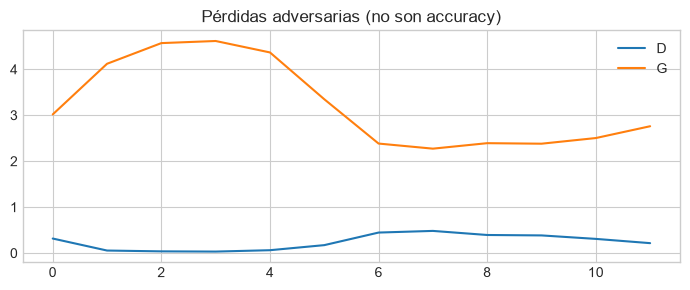
Época 01  D=0.316  G=3.016
Época 02  D=0.054  G=4.118
Época 03  D=0.037  G=4.568
Época 04  D=0.032  G=4.613
Época 05  D=0.062  G=4.364
Época 06  D=0.172  G=3.346
Época 07  D=0.446  G=2.382
Época 08  D=0.482  G=2.271
Época 09  D=0.393  G=2.390
Época 10  D=0.383  G=2.379
Época 11  D=0.308  G=2.502
Época 12  D=0.215  G=2.759

8. Informe de pérdidas adversarias

No use diagnostico_entrenamiento como si hubiera accuracy. Aquí el ‘sobreajuste’ es un D en cero y un G sin gradiente útil.

print(pd.DataFrame({'epoca':range(1,len(hist_d)+1),'loss_D':hist_d,'loss_G':hist_g}).tail(5).to_string(index=False,float_format=lambda v:f'{v:.3f}'))
plt.figure(figsize=(7,3)); plt.plot(hist_d,label='D'); plt.plot(hist_g,label='G'); plt.legend(); plt.title('Pérdidas adversarias (no son accuracy)')
plt.tight_layout(); plt.show()
print('D→0 y G alta: D ganó. Ambas oscilando: inestable. G baja y muestras colapsadas: modo colapsado.')
 epoca  loss_D  loss_G
     8   0.482   2.271
     9   0.393   2.390
    10   0.383   2.379
    11   0.308   2.502
    12   0.215   2.759

D→0 y G alta: D ganó. Ambas oscilando: inestable. G baja y muestras colapsadas: modo colapsado.

9. Muestras G(z)

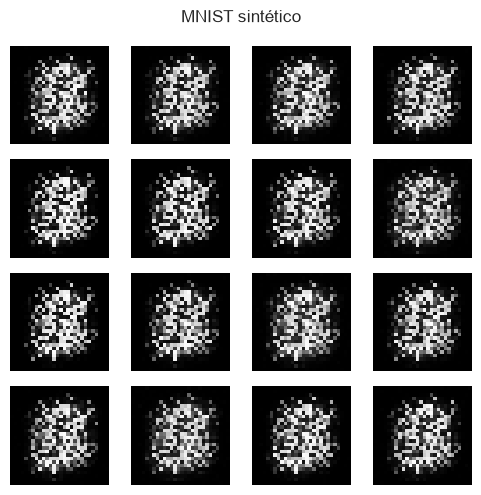
z=tf.random.normal((16,LAT)); imgs=G(z,training=False).numpy().reshape(-1,28,28)
fig,ax=plt.subplots(4,4,figsize=(5,5))
for a,im in zip(ax.ravel(),imgs):
    a.imshow(im,cmap='gray'); a.axis('off')
plt.suptitle('MNIST sintético'); plt.tight_layout(); plt.show()

Interpretación

Borrosos o repetidos son esperables. 16 caras idénticas = colapso. El acta: ‘diversidad visual baja’, no ‘GAN fallida como idea’.

10. Caso 2 — Ficha de accesorio (Fashion, clase Bolso)

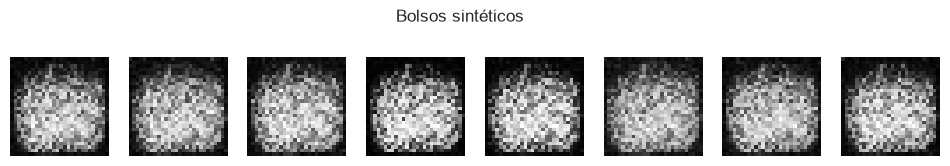
Mismo G/D, otro dominio. Un catálogo que quiere ‘más fotos de bolsos’ sin sesión de estudio. Éticamente más sensible que un dígito.

(xf,yf),_=tf.keras.datasets.fashion_mnist.load_data()
xb=(xf[yf==8][:4000].astype('float32')/255.0).reshape(-1,784)
print('n bolsos',len(xb))
G2=tf.keras.models.clone_model(G); D2=tf.keras.models.clone_model(D)
G2.build((None,LAT)); D2.build((None,784))
og,od=tf.keras.optimizers.Adam(2e-4),tf.keras.optimizers.Adam(2e-4)
@tf.function
def paso2(reales):
    z=tf.random.normal((tf.shape(reales)[0],LAT))
    with tf.GradientTape() as td:
        f=G2(z,training=True); ld=bce(tf.ones((len(reales),1)),D2(reales,training=True))+bce(tf.zeros((len(reales),1)),D2(f,training=True))
    od.apply_gradients(zip(td.gradient(ld,D2.trainable_variables),D2.trainable_variables))
    z=tf.random.normal((tf.shape(reales)[0],LAT))
    with tf.GradientTape() as tg:
        lg=bce(tf.ones((len(reales),1)),D2(G2(z,training=True),training=True))
    og.apply_gradients(zip(tg.gradient(lg,G2.trainable_variables),G2.trainable_variables))
    return ld,lg
hd,hg=[],[]
for e in range(8):
    a=c=n=0
    for lote in tf.data.Dataset.from_tensor_slices(xb).shuffle(4000).batch(128):
        ld,lg=paso2(lote); a+=float(ld); c+=float(lg); n+=1
    hd.append(a/n); hg.append(c/n); print(e+1,hd[-1],hg[-1])
n bolsos 4000
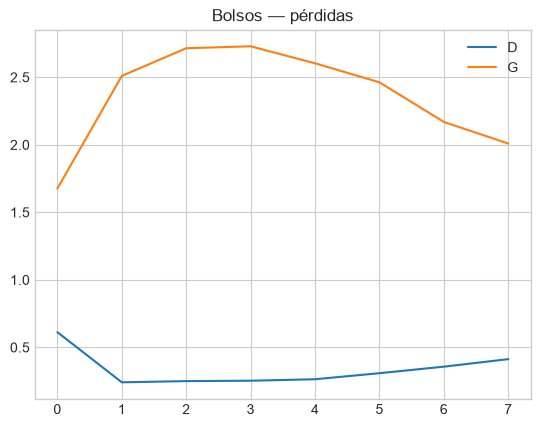
1 0.6124469460919499 1.6765229403972626
2 0.24132420495152473 2.510003946721554
3 0.2501209694892168 2.7149335518479347
4 0.2530767759308219 2.729180186986923
5 0.2639583609998226 2.6034027487039566
6 0.3088362468406558 2.4623997434973717
7 0.35713869985193014 2.168957658112049
8 0.41293442249298096 2.009084191173315
plt.plot(hd,label='D'); plt.plot(hg,label='G'); plt.legend(); plt.title('Bolsos — pérdidas'); plt.show()
imgs=G2(tf.random.normal((8,LAT)),training=False).numpy().reshape(-1,28,28)
fig,ax=plt.subplots(1,8,figsize=(12,2))
for a,im in zip(ax,imgs):
    a.imshow(im,cmap='gray'); a.axis('off')
plt.suptitle('Bolsos sintéticos'); plt.show()

11. Métrica tosca de colapso: varianza entre muestras

Si 64 z distintos producen imágenes casi iguales, la varianza espacial media entre muestras cae.

Z=tf.random.normal((64,LAT))
A=G(Z,training=False).numpy(); B=G2(Z,training=False).numpy()
print('std media entre muestras MNIST', A.std(axis=0).mean())
print('std media entre muestras bolsos', B.std(axis=0).mean())
print('Un std muy bajo es un proxy de colapso. No es FID.')
std media entre muestras MNIST 0.03031463
std media entre muestras bolsos 0.063929595
Un std muy bajo es un proxy de colapso. No es FID.

12. Ética

Deepfakes, consentimiento, sesgo del corpus, atribución. La pregunta no es ‘¿podemos?’. Es quién aparece en el entrenamiento y quién puede ser engañado.

13. Lectura conjunta de ambos entrenamientos

print('MNIST últimas D/G', hist_d[-1], hist_g[-1])
print('Bolsos últimas D/G', hd[-1], hg[-1])
print('Compare std entre muestras (celda anterior) antes de declarar un ganador visual.')
MNIST últimas D/G 0.21524113227450659 2.758811973390125
Bolsos últimas D/G 0.41293442249298096 2.009084191173315
Compare std entre muestras (celda anterior) antes de declarar un ganador visual.

14. Recorrido en el espacio latente

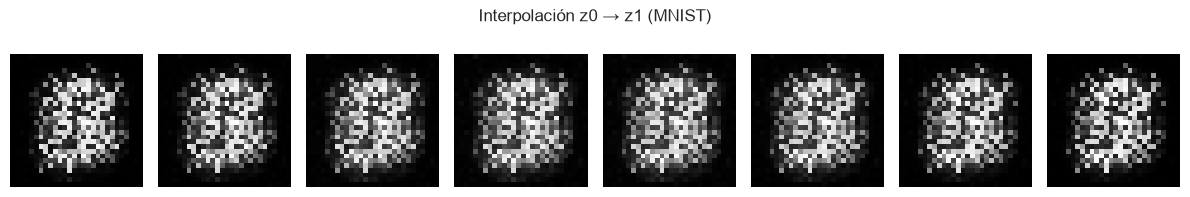
Interpolamos dos z y generamos 8 pasos. Si las caras intermedias son el mismo dígito borroso, hay colapso; si cruzan identidades, hay al menos un camino en p_g.

z0 = tf.random.normal((1, LAT))
z1 = tf.random.normal((1, LAT))
alphas = tf.linspace(0.0, 1.0, 8)[:, None]
z = z0 * (1 - alphas) + z1 * alphas
seq = G(z, training=False).numpy().reshape(-1, 28, 28)
fig, ax = plt.subplots(1, 8, figsize=(12, 2))
for a, im in zip(ax, seq):
    a.imshow(im, cmap="gray")
    a.axis("off")
plt.suptitle("Interpolación z0 → z1 (MNIST)")
plt.tight_layout()
plt.show()

15. Qué tan seguro está D en reales vs falsos

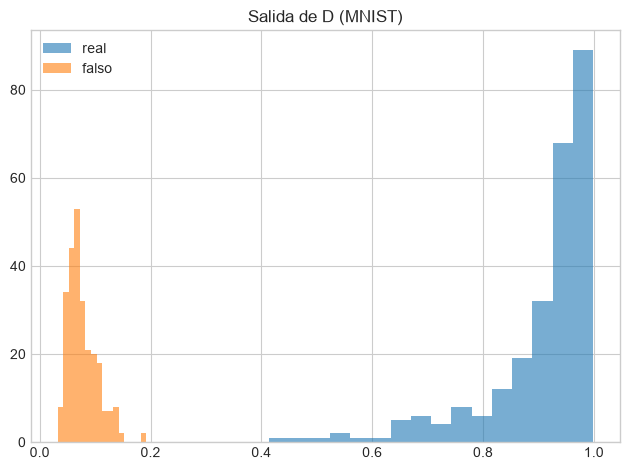
Un discriminador que pone 0.99 a todo lo real y 0.01 a todo lo falso deja a G sin gradiente útil. Se mide la media de D(x) en un lote.

reales = x[:256]
falsos = G(tf.random.normal((256, LAT)), training=False)
d_r = D(reales, training=False).numpy().ravel()
d_f = D(falsos, training=False).numpy().ravel()
print(f"D(real)  media={d_r.mean():.3f}  std={d_r.std():.3f}")
print(f"D(falso) media={d_f.mean():.3f}  std={d_f.std():.3f}")
plt.hist(d_r, bins=16, alpha=0.6, label="real")
plt.hist(d_f, bins=16, alpha=0.6, label="falso")
plt.legend()
plt.title("Salida de D (MNIST)")
plt.tight_layout()
plt.show()
D(real)  media=0.907  std=0.103
D(falso) media=0.077  std=0.027

Interpretación

Si ambos histogramas se separan por completo, G ya no aprende. Si se solapan demasiado, D no está enseñando. El acta de una GAN es esta separación, no un accuracy de clasificación.

16. Semillas fijas: ¿cambia la identidad?

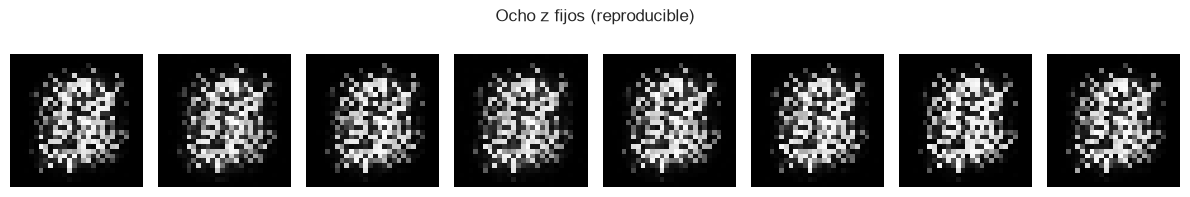
Ocho z guardados al final. No hay «antes» de época 1 en memoria, pero la repetición de la celda en otra corrida permite ver si el colapso es estable.

tf.random.set_seed(0)
zf = tf.random.normal((8, LAT))
g1 = G(zf, training=False).numpy().reshape(8, 28, 28)
fig, ax = plt.subplots(1, 8, figsize=(12, 2))
for a, im in zip(ax, g1):
    a.imshow(im, cmap="gray")
    a.axis("off")
plt.suptitle("Ocho z fijos (reproducible)")
plt.tight_layout()
plt.show()
print("std entre estas 8", g1.reshape(8, -1).std(axis=0).mean())

std entre estas 8 0.026323162

Amenazas a la validez

12 épocas y MLP: subentrenamiento; no hay FID; una grilla no estima diversidad.

WGAN-GP

Cambia la métrica para suavizar gradientes. No la implementamos: el acta de este artículo usa BCE clásica, más frágil y más transparente.

Un z fijo a lo largo de las épocas

Permite ver si ‘el mismo’ dígito se define o se desvanece. Es un control visual de trayectoria, no una métrica.

Evaluación cualitativa

Diversidad, artefactos, test ciego pequeño. ‘Se ve nítido’ no es FID bajo.

Cierre

Una GAN se informa con pérdidas y muestras. Tratar loss_G como val_acc es el error más frecuente de este tema.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.