Optimización avanzada y entrenamiento en GPU

deep-learning
gpu
optimizacion
Batch, dispositivo y búsqueda de hiperparámetros: el acta incluye tiempo, val_loss y no solo accuracy.
Author

Wilder Ramírez Delgado

Published

September 10, 2026

Optimización avanzada y entrenamiento en GPU

Serie Deep Learning · del perceptrón a los transformers.

Open in Colab

En este artículo medimos dispositivos, relacionamos batch con tiempo y memoria, y buscamos hiperparámetros leyendo cada fit como un experimento: val_loss, gap y segundos entran al mismo informe.

1. Introducción

Antes el cuello era entender. Aquí es capacidad: dónde corre el grafo, cuánta memoria ocupa un lote y cómo explorar tasas sin lotería.

Pregunta: qué medimos para decidir batch, dispositivo y la siguiente configuración.

2. Qué ya se conoce

CNN, history, EarlyStopping, la diferencia train/val.

3. Protocolo de lectura de métricas

Mejor val_loss, gap train−val, reporte por clase o MSE de test, y solo después una decisión. El último print de fit no es el acta.

import os
import time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    precision_recall_fscore_support,
)
import tensorflow as tf

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"
SEED = 42
tf.keras.utils.set_random_seed(SEED)
plt.style.use("seaborn-v0_8-whitegrid")

print("TensorFlow:", tf.__version__)
print("GPU:", tf.config.list_physical_devices("GPU") or "ninguna (CPU)")


def series_history(hist):
    h = hist.history if hasattr(hist, "history") else hist
    return {k: np.asarray(v, dtype=float) for k, v in h.items()}


def diagnostico_entrenamiento(hist, nombre="modelo"):
    """Resume un history como se leería en un informe técnico."""
    s = series_history(hist)
    loss = s["loss"]
    n = len(loss)
    tiene_val = "val_loss" in s
    fila = {"modelo": nombre, "epocas_corridas": n}
    if tiene_val:
        i = int(np.argmin(s["val_loss"]))
        fila.update({
            "mejor_epoca_val_loss": i + 1,
            "min_val_loss": float(s["val_loss"][i]),
            "val_loss_final": float(s["val_loss"][-1]),
            "train_loss_en_mejor": float(loss[i]),
            "train_loss_final": float(loss[-1]),
            "delta_val_tras_mejor": float(s["val_loss"][-1] - s["val_loss"][i]),
            "gap_loss_mejor": float(s["val_loss"][i] - loss[i]),
            "gap_loss_final": float(s["val_loss"][-1] - loss[-1]),
        })
        if "accuracy" in s and "val_accuracy" in s:
            fila["train_acc_mejor"] = float(s["accuracy"][i])
            fila["val_acc_mejor"] = float(s["val_accuracy"][i])
            fila["train_acc_final"] = float(s["accuracy"][-1])
            fila["val_acc_final"] = float(s["val_accuracy"][-1])
            fila["gap_acc_mejor"] = float(s["accuracy"][i] - s["val_accuracy"][i])
            fila["gap_acc_final"] = float(s["accuracy"][-1] - s["val_accuracy"][-1])
    print(pd.Series(fila).to_string())
    if tiene_val:
        print()
        print("LECTURA")
        if fila["mejor_epoca_val_loss"] < n:
            print(
                f"La mejor val_loss no es la última época "
                f"({fila['mejor_epoca_val_loss']} de {n}). "
                "Si restore_best_weights=True, el modelo guardado no es el del último paso."
            )
        else:
            print("La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.")
        if fila.get("gap_acc_final", 0) > 0.08:
            print("Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.")
        elif fila.get("gap_acc_final", 0) < -0.02:
            print("Val > train: regularización fuerte, aumento de datos o validación más fácil.")
        if fila.get("delta_val_tras_mejor", 0) > 0.05:
            print("val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.")
    return fila


def curvas_entrenamiento(hist, titulo):
    s = series_history(hist)
    ep = np.arange(1, len(s["loss"]) + 1)
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
    axes[0].plot(ep, s["loss"], marker="o", label="train")
    if "val_loss" in s:
        axes[0].plot(ep, s["val_loss"], marker="o", label="validación")
        i = int(np.argmin(s["val_loss"]))
        axes[0].axvline(i + 1, ls="--", color="0.4", label=f"mejor val_loss (ép. {i+1})")
    axes[0].set_title(f"{titulo} — pérdida")
    axes[0].set_xlabel("Época")
    axes[0].legend()
    if "accuracy" in s:
        axes[1].plot(ep, s["accuracy"], marker="o", label="train")
        if "val_accuracy" in s:
            axes[1].plot(ep, s["val_accuracy"], marker="o", label="validación")
        axes[1].set_title(f"{titulo} — accuracy")
        axes[1].set_xlabel("Época")
        axes[1].legend()
    else:
        axes[1].axis("off")
    plt.tight_layout()
    plt.show()


def informe_clasificacion(y_true, y_pred, nombres, titulo=""):
    print(titulo)
    print(classification_report(y_true, y_pred, target_names=nombres, digits=4, zero_division=0))
    p, r, f1, sop = precision_recall_fscore_support(
        y_true, y_pred, average=None, zero_division=0
    )
    df = pd.DataFrame({
        "clase": nombres,
        "precision": p,
        "recall": r,
        "f1": f1,
        "soporte": sop,
    }).sort_values("f1")
    print("Clases ordenadas por F1 (las de abajo son las más débiles):")
    print(df.to_string(index=False, float_format=lambda v: f"{v:.4f}"))
    return df


def matriz_y_errores(y_true, y_pred, nombres, x=None, probs=None, k=8):
    cm = confusion_matrix(y_true, y_pred)
    fig, ax = plt.subplots(figsize=(6.2, 5.2))
    im = ax.imshow(cm, cmap="Blues")
    ax.set_xticks(range(len(nombres)), nombres, rotation=70, ha="right", fontsize=8)
    ax.set_yticks(range(len(nombres)), nombres, fontsize=8)
    ax.set_xlabel("Predicho")
    ax.set_ylabel("Verdadero")
    fig.colorbar(im, ax=ax, fraction=0.046)
    plt.tight_layout()
    plt.show()
    if x is None:
        return cm
    conf = probs[np.arange(len(y_pred)), y_pred] if probs is not None else np.ones(len(y_pred))
    err = np.where(y_true != y_pred)[0]
    if len(err) == 0:
        print("Cero errores en el recorte analizado.")
        return cm
    orden = err[np.argsort(-conf[err])]
    n = min(k, len(orden))
    cols = min(4, n)
    rows = int(np.ceil(n / cols))
    fig, axes = plt.subplots(rows, cols, figsize=(2.6 * cols, 2.6 * rows))
    axes = np.atleast_1d(axes).ravel()
    for ax, j in zip(axes, orden[:n]):
        img = x[j]
        if img.ndim == 3 and img.shape[-1] == 1:
            img = img.squeeze()
        ax.imshow(img, cmap="gray" if np.ndim(img) == 2 else None)
        ax.set_title(
            f"V:{nombres[int(y_true[j])]}\\nP:{nombres[int(y_pred[j])]} ({conf[j]:.2f})",
            fontsize=8,
        )
        ax.axis("off")
    for ax in axes[n:]:
        ax.axis("off")
    plt.suptitle("Errores de mayor confianza")
    plt.tight_layout()
    plt.show()
    return cm
TensorFlow: 2.21.0
WARNING:tensorflow:TensorFlow GPU support is not available on native Windows for TensorFlow >= 2.11. Even if CUDA/cuDNN are installed, GPU will not be used. Please use WSL2 or the TensorFlow-DirectML plugin.
GPU: ninguna (CPU)

Idea clave

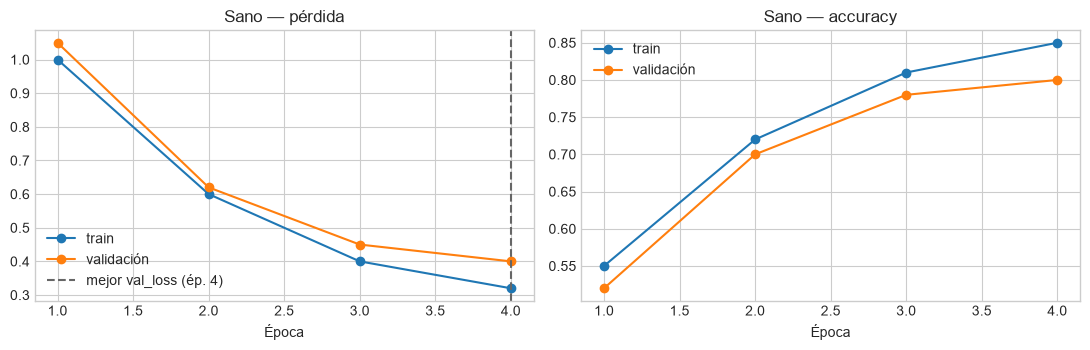
Una curva sin el índice de la mejor época es un dibujo. El informe empieza cuando se declara qué época se está reportando.

4. Laboratorio de lectura (history sintético)

sano={'loss':[1.0,0.6,0.4,0.32],'val_loss':[1.05,0.62,0.45,0.40],'accuracy':[0.55,0.72,0.81,0.85],'val_accuracy':[0.52,0.70,0.78,0.80]}
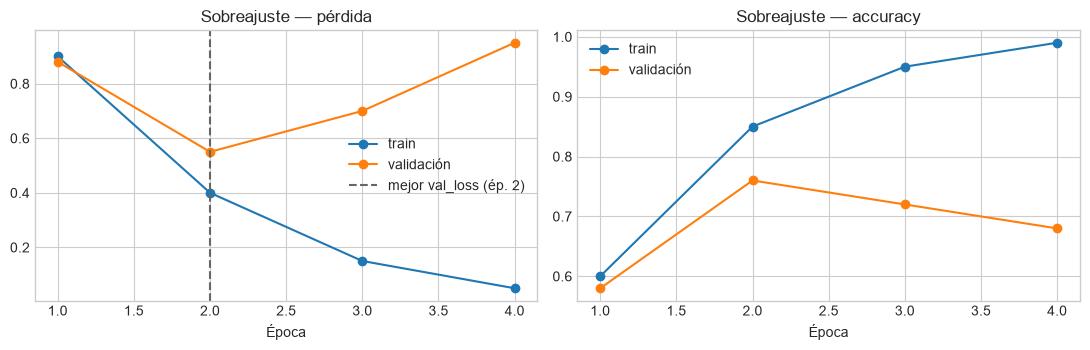
sobre={'loss':[0.9,0.4,0.15,0.05],'val_loss':[0.88,0.55,0.70,0.95],'accuracy':[0.6,0.85,0.95,0.99],'val_accuracy':[0.58,0.76,0.72,0.68]}
print('SANO'); diagnostico_entrenamiento(sano,'sano'); curvas_entrenamiento(sano,'Sano')
print('SOBRE'); diagnostico_entrenamiento(sobre,'sobre'); curvas_entrenamiento(sobre,'Sobreajuste')
SANO
modelo                  sano
epocas_corridas            4
mejor_epoca_val_loss       4
min_val_loss             0.4
val_loss_final           0.4
train_loss_en_mejor     0.32
train_loss_final        0.32
delta_val_tras_mejor     0.0
gap_loss_mejor          0.08
gap_loss_final          0.08
train_acc_mejor         0.85
val_acc_mejor            0.8
train_acc_final         0.85
val_acc_final            0.8
gap_acc_mejor           0.05
gap_acc_final           0.05

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.

SOBRE
modelo                  sobre
epocas_corridas             4
mejor_epoca_val_loss        2
min_val_loss             0.55
val_loss_final           0.95
train_loss_en_mejor       0.4
train_loss_final         0.05
delta_val_tras_mejor      0.4
gap_loss_mejor           0.15
gap_loss_final            0.9
train_acc_mejor          0.85
val_acc_mejor            0.76
train_acc_final          0.99
val_acc_final            0.68
gap_acc_mejor            0.09
gap_acc_final            0.31

LECTURA
La mejor val_loss no es la última época (2 de 4). Si restore_best_weights=True, el modelo guardado no es el del último paso.
Gap train-val de accuracy notable: posible sobreajuste o desajuste de dificultad.
val_loss subió tras el mínimo: el entrenamiento extra no estaba ayudando.

Interpretación

En el sobreajuste, reportar la época 4 como si fuera el modelo es un error de gobernanza. El checkpoint razonable es la época de mínima val_loss.

5. GPU: ocupación, no vanidad

Brilla con matmul densos y dato ya en VRAM. Kernels minúsculos o copias CPU↔︎GPU la dejan esperando.

Idea clave

Eficiencia no es ‘tengo GPU’. Es ocupación: calcular, no esperar al bus.

print('TF',tf.__version__)
for d in tf.config.list_physical_devices():
    print(' ',d)
gpus=tf.config.list_physical_devices('GPU')
if gpus:
    try:
        for g in gpus: tf.config.experimental.set_memory_growth(g,True)
        print('memory growth ON')
    except RuntimeError as e:
        print(e)
TF 2.21.0
  PhysicalDevice(name='/physical_device:CPU:0', device_type='CPU')

6. Caso — Entrenar un clasificador de ficha textil bajo distintas capacidades

Fashion-MNIST recortado. Cada batch size es un presupuesto. El acta: segundos/época, pasos, val_acc de un fit corto.

(x,y),_=tf.keras.datasets.fashion_mnist.load_data()
x=x.astype('float32')/255.0; x=x[...,None]; x,y=x[:8000],y[:8000]
def cnn():
    m=tf.keras.Sequential([
      tf.keras.layers.Input((28,28,1)),tf.keras.layers.Conv2D(32,3,activation='relu'),
      tf.keras.layers.MaxPool2D(),tf.keras.layers.Conv2D(64,3,activation='relu'),
      tf.keras.layers.MaxPool2D(),tf.keras.layers.Flatten(),
      tf.keras.layers.Dense(64,activation='relu'),tf.keras.layers.Dense(10,activation='softmax')])
    m.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy']); return m

7. Curva batch–tiempo–val

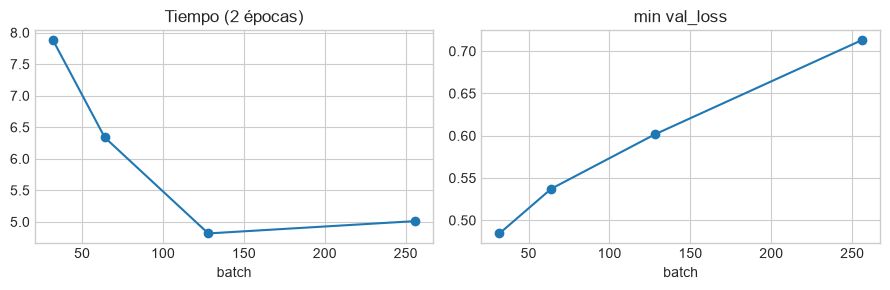
No solo cronómetro: un lote enorme puede bajar el tiempo y subir val_loss (menos ruido de SGD).

lotes=[32,64,128,256]; filas=[]
for b in lotes:
    tf.keras.backend.clear_session(); m=cnn()
    t0=time.perf_counter()
    h=m.fit(x,y,validation_split=0.2,epochs=2,batch_size=b,verbose=0)
    filas.append({'batch':b,'seg_tot':time.perf_counter()-t0,'pasos':int(np.ceil(0.8*len(x)/b)),
                  'min_val_loss':min(h.history['val_loss']),'val_acc_final':h.history['val_accuracy'][-1],
                  'gap':h.history['accuracy'][-1]-h.history['val_accuracy'][-1]})
    print(filas[-1])
print(pd.DataFrame(filas).to_string(index=False,float_format=lambda v:f'{v:.4f}'))
WARNING:tensorflow:From C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\keras\src\backend\common\global_state.py:82: The name tf.reset_default_graph is deprecated. Please use tf.compat.v1.reset_default_graph instead.

{'batch': 32, 'seg_tot': 7.880898600000364, 'pasos': 200, 'min_val_loss': 0.48450222611427307, 'val_acc_final': 0.8106250166893005, 'gap': 0.007031261920928955}
{'batch': 64, 'seg_tot': 6.338130699994508, 'pasos': 100, 'min_val_loss': 0.5373147130012512, 'val_acc_final': 0.7931249737739563, 'gap': -0.002968728542327881}
{'batch': 128, 'seg_tot': 4.816776500003471, 'pasos': 50, 'min_val_loss': 0.6015918850898743, 'val_acc_final': 0.7581250071525574, 'gap': 0.00875002145767212}
{'batch': 256, 'seg_tot': 5.012139499995101, 'pasos': 25, 'min_val_loss': 0.7130491733551025, 'val_acc_final': 0.7174999713897705, 'gap': -0.00015622377395629883}
 batch  seg_tot  pasos  min_val_loss  val_acc_final     gap
    32   7.8809    200        0.4845         0.8106  0.0070
    64   6.3381    100        0.5373         0.7931 -0.0030
   128   4.8168     50        0.6016         0.7581  0.0088
   256   5.0121     25        0.7130         0.7175 -0.0002
df=pd.DataFrame(filas)
fig,ax=plt.subplots(1,2,figsize=(9,3))
ax[0].plot(df.batch,df.seg_tot,marker='o'); ax[0].set_title('Tiempo (2 épocas)'); ax[0].set_xlabel('batch')
ax[1].plot(df.batch,df.min_val_loss,marker='o'); ax[1].set_title('min val_loss'); ax[1].set_xlabel('batch')
plt.tight_layout(); plt.show()

Interpretación

Si el tiempo baja y min_val_loss empeora, barateó cómputo a costa de generalización. El acta debe tener las dos columnas. Un speedup que degrada val no es una victoria de infraestructura.

8. CPU vs GPU en el mismo fit

Sin anclar N, batch y modelo, ‘va más rápido en Colab’ no es resultado.

def fit_dev(dev,n=2048,b=128):
    with tf.device(dev):
        tf.keras.backend.clear_session(); m=cnn()
        t0=time.perf_counter(); m.fit(x[:n],y[:n],epochs=1,batch_size=b,verbose=0)
        return time.perf_counter()-t0
print('CPU',fit_dev('/CPU:0'))
print('GPU', fit_dev('/GPU:0') if tf.config.list_physical_devices('GPU') else 'no hay dispositivo — no se inventa speedup')
CPU 2.3009404000040377
GPU no hay dispositivo — no se inventa speedup

9. Monitoreo de memoria

def mem():
    if not tf.config.list_physical_devices('GPU'): return 'sin GPU'
    try: return {k:int(v) for k,v in tf.config.experimental.get_memory_info('GPU:0').items()}
    except Exception as e: return type(e).__name__
print('antes',mem()); tf.keras.backend.clear_session(); m=cnn(); m.fit(x[:1024],y[:1024],epochs=1,verbose=0)
print('después',mem())
antes sin GPU
después sin GPU

10. Búsqueda aleatoria de hiperparámetros (6 configs)

Cada config es un fit de 3 épocas. El ganador se elige por min val_loss, no por el accuracy de la última época. Bayesiano (TPE) usaría estas seis para proponer la séptima; no las sustituye.

espacio=[{'lr':1e-3,'u':32,'b':64},{'lr':1e-3,'u':64,'b':128},{'lr':3e-4,'u':32,'b':64},
         {'lr':3e-4,'u':64,'b':128},{'lr':1e-2,'u':32,'b':256},{'lr':1e-4,'u':96,'b':64}]
xtr,xva,ytr,yva=x[:6000],x[6000:8000],y[:6000],y[6000:8000]
res=[]
for hp in espacio:
    tf.keras.backend.clear_session()
    m=tf.keras.Sequential([
      tf.keras.layers.Input((28,28,1)),tf.keras.layers.Conv2D(32,3,activation='relu'),
      tf.keras.layers.MaxPool2D(),tf.keras.layers.Flatten(),
      tf.keras.layers.Dense(hp['u'],activation='relu'),tf.keras.layers.Dense(10,activation='softmax')])
    m.compile(tf.keras.optimizers.Adam(hp['lr']), loss='sparse_categorical_crossentropy', metrics=['accuracy'])
    t0=time.perf_counter()
    h=m.fit(xtr,ytr,validation_data=(xva,yva),epochs=3,batch_size=hp['b'],verbose=0)
    d=diagnostico_entrenamiento(h,str(hp))
    res.append({**hp,'min_val_loss':d['min_val_loss'],'val_acc_mejor':d.get('val_acc_mejor'),
                'gap':d.get('gap_acc_final'),'seg':time.perf_counter()-t0})
print(pd.DataFrame(res).sort_values('min_val_loss').to_string(index=False,float_format=lambda v:f'{v:.4f}'))
modelo                  {'lr': 0.001, 'u': 32, 'b': 64}
epocas_corridas                                       3
mejor_epoca_val_loss                                  3
min_val_loss                                   0.476793
val_loss_final                                 0.476793
train_loss_en_mejor                            0.463561
train_loss_final                               0.463561
delta_val_tras_mejor                                0.0
gap_loss_mejor                                 0.013232
gap_loss_final                                 0.013232
train_acc_mejor                                0.837333
val_acc_mejor                                    0.8315
train_acc_final                                0.837333
val_acc_final                                    0.8315
gap_acc_mejor                                  0.005833
gap_acc_final                                  0.005833

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  {'lr': 0.001, 'u': 64, 'b': 128}
epocas_corridas                                        3
mejor_epoca_val_loss                                   3
min_val_loss                                    0.497261
val_loss_final                                  0.497261
train_loss_en_mejor                             0.453986
train_loss_final                                0.453986
delta_val_tras_mejor                                 0.0
gap_loss_mejor                                  0.043275
gap_loss_final                                  0.043275
train_acc_mejor                                   0.8475
val_acc_mejor                                     0.8265
train_acc_final                                   0.8475
val_acc_final                                     0.8265
gap_acc_mejor                                      0.021
gap_acc_final                                      0.021

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  {'lr': 0.0003, 'u': 32, 'b': 64}
epocas_corridas                                        3
mejor_epoca_val_loss                                   3
min_val_loss                                    0.524649
val_loss_final                                  0.524649
train_loss_en_mejor                             0.521616
train_loss_final                                0.521616
delta_val_tras_mejor                                 0.0
gap_loss_mejor                                  0.003032
gap_loss_final                                  0.003032
train_acc_mejor                                 0.823833
val_acc_mejor                                     0.8075
train_acc_final                                 0.823833
val_acc_final                                     0.8075
gap_acc_mejor                                   0.016333
gap_acc_final                                   0.016333

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  {'lr': 0.0003, 'u': 64, 'b': 128}
epocas_corridas                                         3
mejor_epoca_val_loss                                    3
min_val_loss                                     0.601855
val_loss_final                                   0.601855
train_loss_en_mejor                              0.577268
train_loss_final                                 0.577268
delta_val_tras_mejor                                  0.0
gap_loss_mejor                                   0.024586
gap_loss_final                                   0.024586
train_acc_mejor                                  0.803167
val_acc_mejor                                       0.776
train_acc_final                                  0.803167
val_acc_final                                       0.776
gap_acc_mejor                                    0.027167
gap_acc_final                                    0.027167

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  {'lr': 0.01, 'u': 32, 'b': 256}
epocas_corridas                                       3
mejor_epoca_val_loss                                  3
min_val_loss                                   0.436752
val_loss_final                                 0.436752
train_loss_en_mejor                            0.377826
train_loss_final                               0.377826
delta_val_tras_mejor                                0.0
gap_loss_mejor                                 0.058926
gap_loss_final                                 0.058926
train_acc_mejor                                0.868333
val_acc_mejor                                     0.845
train_acc_final                                0.868333
val_acc_final                                     0.845
gap_acc_mejor                                  0.023333
gap_acc_final                                  0.023333

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  {'lr': 0.0001, 'u': 96, 'b': 64}
epocas_corridas                                        3
mejor_epoca_val_loss                                   3
min_val_loss                                    0.626472
val_loss_final                                  0.626472
train_loss_en_mejor                             0.643358
train_loss_final                                0.643358
delta_val_tras_mejor                                 0.0
gap_loss_mejor                                 -0.016885
gap_loss_final                                 -0.016885
train_acc_mejor                                    0.794
val_acc_mejor                                       0.78
train_acc_final                                    0.794
val_acc_final                                       0.78
gap_acc_mejor                                      0.014
gap_acc_final                                      0.014

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
    lr  u   b  min_val_loss  val_acc_mejor    gap    seg
0.0100 32 256        0.4368         0.8450 0.0233 4.1740
0.0010 32  64        0.4768         0.8315 0.0058 6.3314
0.0010 64 128        0.4973         0.8265 0.0210 4.6748
0.0003 32  64        0.5246         0.8075 0.0163 6.5146
0.0003 64 128        0.6019         0.7760 0.0272 4.3998
0.0001 96  64        0.6265         0.7800 0.0140 5.8679

Interpretación

La fila ganadora es la mejor en esta val de 2000 y 3 épocas. Si dos empatan en val_acc, desempate con min_val_loss y con segundos. El hiperparámetro también tiene costo.

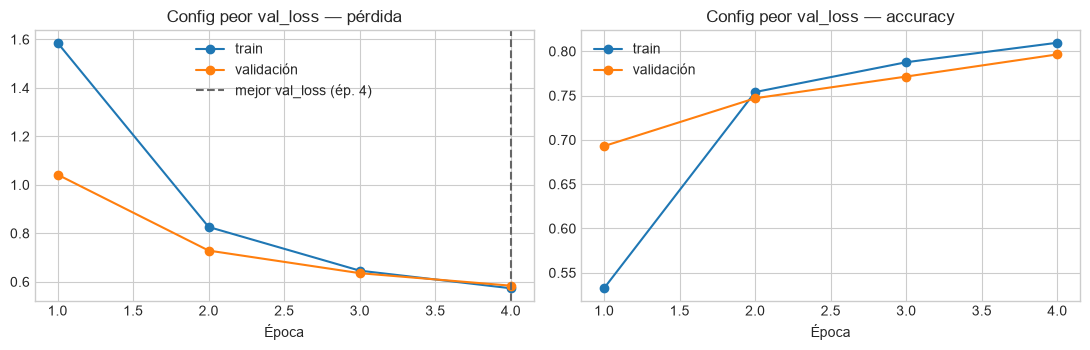
11. Curvas de la config ganadora vs una mala

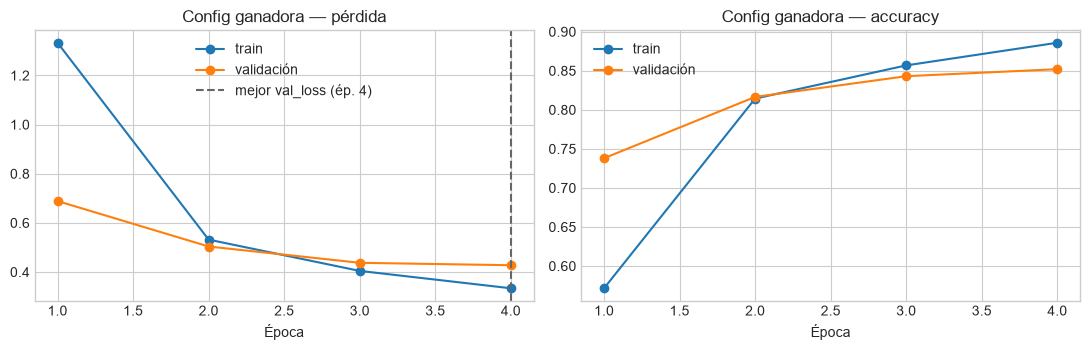
Reentrenamos las dos extremas para ver forma, no solo el escalar.

tab=pd.DataFrame(res).sort_values('min_val_loss')
best,worst=tab.iloc[0],tab.iloc[-1]
print('BEST',best.to_dict()); print('WORST',worst.to_dict())
def fit_hp(hp):
    tf.keras.backend.clear_session()
    m=tf.keras.Sequential([
      tf.keras.layers.Input((28,28,1)),tf.keras.layers.Conv2D(32,3,activation='relu'),
      tf.keras.layers.MaxPool2D(),tf.keras.layers.Flatten(),
      tf.keras.layers.Dense(int(hp['u']),activation='relu'),tf.keras.layers.Dense(10,activation='softmax')])
    m.compile(tf.keras.optimizers.Adam(float(hp['lr'])), loss='sparse_categorical_crossentropy', metrics=['accuracy'])
    return m.fit(xtr,ytr,validation_data=(xva,yva),epochs=4,batch_size=int(hp['b']),verbose=0)
hb,hw=fit_hp(best),fit_hp(worst)
curvas_entrenamiento(hb,'Config ganadora'); curvas_entrenamiento(hw,'Config peor val_loss')
BEST {'lr': 0.01, 'u': 32.0, 'b': 256.0, 'min_val_loss': 0.43675172328948975, 'val_acc_mejor': 0.8450000286102295, 'gap': 0.023333311080932617, 'seg': 4.173954600002617}
WORST {'lr': 0.0001, 'u': 96.0, 'b': 64.0, 'min_val_loss': 0.6264722943305969, 'val_acc_mejor': 0.7799999713897705, 'gap': 0.0140000581741333, 'seg': 5.867925500002457}

12. Informe de clasificación de la ganadora (test oficial recortado)

El HP se eligió con val interna. Confirmamos en las 2000 siguientes del train original… usamos el test MNIST fashion oficial recortado.

(_, _),(xt,yt)=tf.keras.datasets.fashion_mnist.load_data()
xt=xt.astype('float32')/255.0; xt=xt[...,None]; xt,yt=xt[:2000],yt[:2000]
tf.keras.backend.clear_session()
m=tf.keras.Sequential([
  tf.keras.layers.Input((28,28,1)),tf.keras.layers.Conv2D(32,3,activation='relu'),
  tf.keras.layers.MaxPool2D(),tf.keras.layers.Flatten(),
  tf.keras.layers.Dense(int(best['u']),activation='relu'),tf.keras.layers.Dense(10,activation='softmax')])
m.compile(tf.keras.optimizers.Adam(float(best['lr'])), loss='sparse_categorical_crossentropy', metrics=['accuracy'])
m.fit(xtr,ytr,validation_data=(xva,yva),epochs=4,batch_size=int(best['b']),verbose=0)
print('TEST',m.evaluate(xt,yt,verbose=0))
pr=m.predict(xt,verbose=0); print(classification_report(yt,pr.argmax(1),digits=3))
TEST [0.39991652965545654, 0.8694999814033508]
              precision    recall  f1-score   support

           0      0.881     0.815     0.847       200
           1      0.985     0.966     0.975       203
           2      0.761     0.864     0.810       214
           3      0.807     0.926     0.863       190
           4      0.863     0.630     0.728       219
           5      0.954     0.954     0.954       195
           6      0.665     0.726     0.694       197
           7      0.930     0.935     0.933       200
           8      0.959     0.959     0.959       194
           9      0.942     0.952     0.947       188

    accuracy                          0.870      2000
   macro avg      0.875     0.873     0.871      2000
weighted avg      0.874     0.870     0.869      2000

13. Grid vs azar vs bayesiano

Grid explota. Azar gana a grid en espacios grandes. Bayes modela f(λ) y equilibra explorar/explotar. Si la val está mal partida, el óptimo bayesiano es el óptimo de un error.

14. Mixed precision (solo si hay GPU)

No se finge un speedup en CPU. Se documenta el intento.

print('mixed_float16 solo se activa con GPU. Entorno actual:', 'GPU' if tf.config.list_physical_devices('GPU') else 'CPU')
mixed_float16 solo se activa con GPU. Entorno actual: CPU

15. Segundos por paso, no solo por época

Un batch grande tiene menos pasos. El tiempo/paso dice si la GPU saturó; el tiempo/época dice si el presupuesto de clase alcanza.

dfp = pd.DataFrame(filas)
dfp["seg_por_paso"] = dfp["seg_tot"] / dfp["pasos"]
print(dfp[["batch", "pasos", "seg_tot", "seg_por_paso", "min_val_loss"]].to_string(index=False, float_format=lambda v: f"{v:.4f}"))
 batch  pasos  seg_tot  seg_por_paso  min_val_loss
    32    200   7.8809        0.0394        0.4845
    64    100   6.3381        0.0634        0.5373
   128     50   4.8168        0.0963        0.6016
   256     25   5.0121        0.2005        0.7130

Interpretación

seg_por_paso que deja de bajar al subir el batch es saturación (o CPU). min_val_loss que empeora al mismo tiempo es el precio estadístico del lote grande.

16. Segunda semilla sobre las dos configs extremas

Un campeón de una sola semilla es un candidato. Reentrenamos best y worst con semilla 1 y miramos si el orden de min_val_loss se sostiene.

tf.keras.utils.set_random_seed(1)
hb2, hw2 = fit_hp(best), fit_hp(worst)
print("semilla 1  best min_val", min(hb2.history["val_loss"]), "worst", min(hw2.history["val_loss"]))
print("semilla 0  (ver celdas anteriores) — si se invierte el orden, el HP no era robusto.")
semilla 1  best min_val 0.384394109249115 worst 0.569864809513092
semilla 0  (ver celdas anteriores) — si se invierte el orden, el HP no era robusto.

17. Dropout como hiperparámetro extra

Fijamos la config ganadora y variamos solo dropout {0, 0.2, 0.5}. El acta: min_val_loss y gap.

def fit_drop(rate):
    tf.keras.backend.clear_session()
    m = tf.keras.Sequential([
        tf.keras.layers.Input((28, 28, 1)),
        tf.keras.layers.Conv2D(32, 3, activation="relu"),
        tf.keras.layers.MaxPool2D(),
        tf.keras.layers.Flatten(),
        tf.keras.layers.Dense(int(best["u"]), activation="relu"),
        tf.keras.layers.Dropout(rate),
        tf.keras.layers.Dense(10, activation="softmax"),
    ])
    m.compile(tf.keras.optimizers.Adam(float(best["lr"])), loss="sparse_categorical_crossentropy", metrics=["accuracy"])
    return m.fit(xtr, ytr, validation_data=(xva, yva), epochs=3, batch_size=int(best["b"]), verbose=0)

filas_d = []
for r in (0.0, 0.2, 0.5):
    hd = fit_drop(r)
    d = diagnostico_entrenamiento(hd, f"dropout={r}")
    filas_d.append({"dropout": r, "min_val_loss": d["min_val_loss"], "gap": d.get("gap_acc_final")})
print(pd.DataFrame(filas_d).to_string(index=False, float_format=lambda v: f"{v:.4f}"))
modelo                  dropout=0.0
epocas_corridas                   3
mejor_epoca_val_loss              3
min_val_loss               0.409636
val_loss_final             0.409636
train_loss_en_mejor        0.372749
train_loss_final           0.372749
delta_val_tras_mejor            0.0
gap_loss_mejor             0.036888
gap_loss_final             0.036888
train_acc_mejor            0.869167
val_acc_mejor                 0.856
train_acc_final            0.869167
val_acc_final                 0.856
gap_acc_mejor              0.013167
gap_acc_final              0.013167

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  dropout=0.2
epocas_corridas                   3
mejor_epoca_val_loss              3
min_val_loss               0.416121
val_loss_final             0.416121
train_loss_en_mejor          0.4375
train_loss_final             0.4375
delta_val_tras_mejor            0.0
gap_loss_mejor            -0.021379
gap_loss_final            -0.021379
train_acc_mejor            0.839333
val_acc_mejor                 0.857
train_acc_final            0.839333
val_acc_final                 0.857
gap_acc_mejor             -0.017667
gap_acc_final             -0.017667

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
modelo                  dropout=0.5
epocas_corridas                   3
mejor_epoca_val_loss              3
min_val_loss               0.473169
val_loss_final             0.473169
train_loss_en_mejor        0.678864
train_loss_final           0.678864
delta_val_tras_mejor            0.0
gap_loss_mejor            -0.205696
gap_loss_final            -0.205696
train_acc_mejor            0.745167
val_acc_mejor                0.8245
train_acc_final            0.745167
val_acc_final                0.8245
gap_acc_mejor             -0.079333
gap_acc_final             -0.079333

LECTURA
La mejor val_loss coincide con la última época: no hay tramo posterior de deterioro.
Val > train: regularización fuerte, aumento de datos o validación más fácil.
 dropout  min_val_loss     gap
  0.0000        0.4096  0.0132
  0.2000        0.4161 -0.0177
  0.5000        0.4732 -0.0793

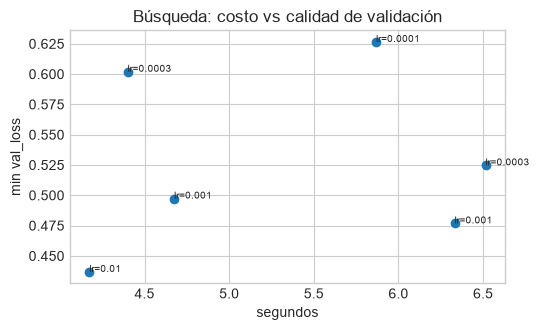
18. Relación tiempo–calidad en la búsqueda

Seis configs: un scatter de segundos vs min_val_loss. Lo deseable está abajo a la izquierda. Lo caro e inútil, arriba a la derecha.

tab = pd.DataFrame(res)
plt.figure(figsize=(5.5, 3.4))
plt.scatter(tab["seg"], tab["min_val_loss"])
for _, r in tab.iterrows():
    plt.text(r["seg"], r["min_val_loss"], f"lr={r['lr']}", fontsize=7)
plt.xlabel("segundos")
plt.ylabel("min val_loss")
plt.title("Búsqueda: costo vs calidad de validación")
plt.tight_layout()
plt.show()

Amenazas a la validez

8000 imágenes no saturan una A100; 6 puntos no son TPE; la primera época incluye compilación.

Calentar el grafo

La primera época incluye tracing. Para un benchmark serio, descarte esa época del promedio.

Memory growth

No se cambia a mitad de proceso. Decídalo al inicio del artículo, como aquí.

Documente la máquina

Sin CPU/GPU/RAM al lado de los segundos, el número no viaja al laboratorio vecino.

Cierre

Optimizar es un informe con tiempo, val_loss y gap. Acelerar un modelo que no generaliza solo adelanta el error.

💬 ¿Te sirvió?Deja en los comentarios una duda o un caso donde aplicarías esto —respondo todos. Sígueme para no perderte el próximo artículo de la serie ycomparte con alguien que esté aprendiendo deep learning.👉 El código completo está disponible para ejecutar directamente.