Análisis Avanzado de Datos — 1. Regresión Lineal Múltiple
estadistica
analisis-multivariado
regresion-multiple
Guía completa de análisis multivariado: supuestos de la regresión múltiple, multicolinealidad y VIF, cuándo regularizar y cómo diagnosticar los residuos paso a paso.
Author
Wilder Ramírez Delgado
Published
August 27, 2026
Análisis Avanzado de Datos — 1. Regresión Lineal Múltiple
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
Análisis Multivariado Aplicado
Este notebook introduce el análisis multivariado de forma enfocada: concepto, supuestos, flujo de modelado e interpretación.
Contexto de ejemplo: consumo energético residencial (sin relación con ventas).
1. Qué es análisis multivariado
En análisis univariado observamos una variable a la vez. En bivariado estudiamos la relación entre dos.
En multivariado analizamos varias variables simultáneamente para:
Explicar una variable objetivo con múltiples predictores: en lugar de asumir que un solo factor determina el resultado, modelamos la contribución conjunta de varias variables. Esto permite representar mejor fenómenos reales, que casi siempre son multifactoriales.
Controlar factores de confusión: algunas variables pueden distorsionar una relación aparente entre predictor y respuesta. Incluirlas en el modelo ayuda a aislar relaciones más limpias y evita conclusiones engañosas.
Estimar efectos parciales (manteniendo constantes otras variables): cada coeficiente se interpreta como el cambio esperado en la respuesta cuando una variable aumenta una unidad y las demás permanecen fijas. Esta idea es clave para interpretar impactos individuales.
Mejorar capacidad predictiva y toma de decisiones: combinar información de varias fuentes suele reducir error de predicción y producir recomendaciones más útiles para la acción (priorizar variables, diseñar intervenciones o asignar recursos).
\(\beta_j\) representa el cambio esperado en \(y\) por una unidad adicional de \(x_j\), manteniendo las demás variables constantes,
\(\varepsilon\) captura variación no explicada.
3. Ejemplo de contexto (energía residencial)
Objetivo: explicar el consumo mensual de energía (kWh) a partir de variables como:
temperatura promedio exterior,
número de ocupantes,
área de la vivienda (m2),
índice de aislamiento térmico,
cantidad de electrodomésticos intensivos.
Este tipo de problema es naturalmente multivariado: una sola variable rara vez explica por completo el consumo.
pip install seaborn
Requirement already satisfied: seaborn in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (0.13.2)
Requirement already satisfied: numpy!=1.24.0,>=1.20 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from seaborn) (2.5.1)
Requirement already satisfied: pandas>=1.2 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from seaborn) (3.0.5)
Requirement already satisfied: matplotlib!=3.6.1,>=3.4 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from seaborn) (3.11.1)
Requirement already satisfied: contourpy>=1.0.1 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (1.3.3)
Requirement already satisfied: cycler>=0.10 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (0.12.1)
Requirement already satisfied: fonttools>=4.28.2 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (4.63.0)
Requirement already satisfied: kiwisolver>=1.3.1 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (1.5.0)
Requirement already satisfied: packaging>=20.0 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (26.0)
Requirement already satisfied: pillow>=9 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (12.3.0)
Requirement already satisfied: pyparsing>=3 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (3.3.2)
Requirement already satisfied: python-dateutil>=2.7 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from matplotlib!=3.6.1,>=3.4->seaborn) (2.9.0.post0)
Requirement already satisfied: tzdata in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from pandas>=1.2->seaborn) (2026.3)
Requirement already satisfied: six>=1.5 in c:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages (from python-dateutil>=2.7->matplotlib!=3.6.1,>=3.4->seaborn) (1.17.0)
Note: you may need to restart the kernel to use updated packages.
# Librerias base para analisis multivariadoimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as snsfrom sklearn.model_selection import train_test_split, cross_val_scorefrom sklearn.linear_model import LinearRegression, Ridge, Lassofrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import mean_squared_error, mean_absolute_error, r2_scoreimport statsmodels.api as smfrom statsmodels.stats.outliers_influence import variance_inflation_factor# Estilo visual base para mantener uniformidad en todas las graficassns.set_theme(style="whitegrid", context="notebook")plt.rcParams["axes.titlesize"] =12plt.rcParams["axes.labelsize"] =10
Este paso responde: “¿Qué quiero entender o predecir exactamente?”. Si la pregunta es difusa, el modelo también lo será. La variable objetivo es el resultado final que intentamos explicar.
Términos clave: - Variable objetivo: el resultado principal del estudio. - Unidad de análisis: sobre quién se mide (hogar, persona, empresa, etc.). - Horizonte temporal: en qué período se mide (día, mes, año).
Por qué importa: este paso pone límites claros al análisis y evita mezclar objetivos distintos en un mismo modelo.
Revisar calidad de datos (nulos, atípicos, escalas, codificación)
Aquí verificamos si los datos son confiables antes de sacar conclusiones. Si hay valores faltantes, errores extremos o categorías mal registradas, el modelo aprende “ruido” en lugar de aprender patrones reales.
Términos clave: - Nulos: datos faltantes. - Atípicos (outliers): valores muy alejados del comportamiento normal. - Escala: tamaño numérico de una variable (por ejemplo 0-1 versus 0-10000). - Codificación: forma de representar texto o categorías en formato útil para análisis.
Por qué importa: un modelo no corrige automáticamente datos mal preparados; solo amplifica sus problemas.
Explorar relaciones entre predictores y objetivo
Antes de modelar, observamos cómo se mueven las variables entre sí. Este paso ayuda a detectar relaciones claras, relaciones débiles, posibles efectos no lineales y variables redundantes.
Términos clave: - Predictor: variable usada para explicar la objetivo. - Relación lineal: cuando el cambio entre variables sigue una tendencia aproximadamente recta. - Interacción: cuando el efecto de una variable depende del nivel de otra.
Por qué importa: evita construir un modelo “a ciegas” y orienta mejores decisiones de modelado.
Partir datos en entrenamiento y prueba
Separamos los datos en dos grupos: uno para aprender y otro para evaluar. El modelo se ajusta con entrenamiento y se pone a prueba con datos que no vio.
Términos clave: - Entrenamiento (train): datos para ajustar el modelo. - Prueba (test): datos reservados para medir desempeño real. - Generalización: capacidad de funcionar bien en datos nuevos.
Por qué importa: sin esta separación, es fácil creer que el modelo es bueno cuando solo está memorizando.
Ajustar modelo base (OLS o equivalente)
Construimos primero una versión simple y explicable del modelo. Ese modelo base funciona como punto de partida para comparar mejoras posteriores.
Términos clave: - OLS: método clásico que ajusta la mejor línea/plano minimizando errores al cuadrado. - Coeficiente: cuánto cambia la variable objetivo si un predictor sube una unidad (manteniendo lo demás constante). - Intercepto: valor esperado de la variable objetivo cuando los predictores valen cero (si tiene interpretación en el contexto).
Por qué importa: un buen modelo base permite saber si la complejidad adicional realmente aporta valor.
Diagnosticar supuestos y multicolinealidad
Este paso es un control de calidad del modelo ya entrenado. La pregunta aquí no es solo “¿cuánto acierta?”, sino también “¿es confiable lo que dice?”.
En lenguaje simple: un modelo puede dar buenas predicciones promedio y aun así estar mal calibrado para interpretar efectos. Por ejemplo, si los residuos muestran patrón (en vez de dispersarse de forma aleatoria), el modelo está dejando estructura sin explicar. Si dos predictores dicen casi lo mismo, los coeficientes pueden volverse inestables y cambiar de signo entre muestras parecidas.
Términos clave: - Residuo: diferencia entre valor real y valor predicho. - Homoscedasticidad: variabilidad de residuos parecida a lo largo del rango de predicciones. - Multicolinealidad: solapamiento fuerte de información entre predictores. - VIF: indicador de cuánto se infla la incertidumbre de un coeficiente por colinealidad.
Regla práctica: si esta etapa falla, no conviene interpretar coeficientes como si fueran firmes, aunque el error global parezca bueno.
Por qué importa: protege contra conclusiones frágiles y mejora la credibilidad técnica del análisis.
Evaluar con métricas y validación cruzada
Evaluar bien significa mirar el desempeño desde tres ángulos: magnitud del error, sensibilidad a errores grandes y estabilidad del modelo.
Primero, las métricas sobre test te dicen “cómo le fue” en una partición concreta. Luego, la validación cruzada responde “si repito el proceso, ¿se mantiene el resultado o cambia mucho?”. Esa segunda pregunta es clave para confiar en que el modelo no depende de una sola muestra afortunada.
Términos clave: - MAE: error promedio absoluto; se interpreta fácil porque está en unidades reales. - RMSE: parecido al MAE, pero castiga más los errores grandes. - R2: porcentaje de variabilidad explicado por el modelo. - Validación cruzada: repetir entrenamiento/evaluación en varios pliegues para medir robustez.
Lectura recomendada: no decidir con una sola métrica. Un modelo puede tener buen R2 y aun así cometer errores absolutos demasiado altos para el contexto de decisión.
Por qué importa: permite seleccionar modelos por desempeño real y estable, no por resultados puntuales.
Iterar (transformaciones, regularización, selección de variables)
Con los resultados en mano, se mejora el modelo paso a paso. La idea es simplificar lo necesario y ganar estabilidad sin perder interpretabilidad.
Términos clave: - Transformación: cambiar la escala o forma de una variable para capturar mejor su relación con la objetivo. - Regularización: técnica para evitar sobreajuste penalizando complejidad excesiva. - Ridge/Lasso: métodos comunes para estabilizar o simplificar coeficientes cuando hay muchas variables o colinealidad.
Por qué importa: el primer modelo rara vez es el mejor; iterar con criterio mejora calidad y confiabilidad.
Comunicar resultados con interpretación y límites
El trabajo termina cuando el resultado se puede entender y usar para decidir. Se debe explicar qué se encontró, con qué confianza, bajo qué condiciones y con qué restricciones.
Términos clave: - Significancia estadística: evidencia de que una relación no parece producto del azar, bajo supuestos. - Relevancia práctica: si el efecto encontrado realmente importa en la realidad. - Limitaciones: lo que el modelo no cubre o no puede asegurar.
Por qué importa: un análisis serio no solo reporta aciertos; también declara alcances, riesgos y límites de uso.
Criterio general: en análisis multivariado, la claridad de la pregunta y la calidad de los datos suelen influir más en el resultado que elegir un algoritmo más sofisticado.
5. Exploración multivariada
La exploración multivariada es el puente entre “tener datos” y “construir un modelo con criterio”. Su objetivo no es solo describir, sino detectar señales útiles y riesgos metodológicos antes del entrenamiento formal.
En esta etapa buscamos responder preguntas prácticas como: - ¿Qué variables parecen realmente informativas? - ¿Cuáles variables parecen duplicar información? - ¿Hay patrones no lineales que un modelo lineal simple no capturaría bien? - ¿Existen grupos atípicos que puedan sesgar conclusiones?
5.1 Distribuciones marginales
Una distribución marginal muestra el comportamiento de cada variable por separado. Aquí observamos centro (media/mediana), dispersión (rango, desviación), asimetría y presencia de valores extremos.
Por qué importa: si una variable tiene cola muy larga o fuerte asimetría, puede requerir transformación para modelar mejor.
5.2 Relación predictor-objetivo
Luego observamos cada predictor contra la variable objetivo. No buscamos perfección, buscamos forma general de relación: creciente, decreciente, curvilínea o casi nula.
Por qué importa: ayuda a priorizar variables y evita asumir linealidad donde no la hay.
5.3 Relación entre predictores
También analizamos cómo se relacionan los predictores entre sí. Si dos variables se mueven casi juntas, pueden aportar información redundante.
Por qué importa: la redundancia puede inflar incertidumbre de coeficientes y dificultar interpretación.
5.4 Matriz de correlaciones: qué sí y qué no
La correlación resume asociación lineal entre pares de variables. Es útil como mapa rápido, pero no reemplaza la inspección visual ni implica causalidad.
Lectura prudente: - Correlación alta sugiere relación lineal fuerte, no necesariamente utilidad causal. - Correlación baja no descarta relación no lineal. - Correlación entre predictores alerta posible colinealidad.
5.5 Patrones no lineales
En multivariado real, muchas relaciones no son rectas. Puede haber umbrales, saturaciones o efectos en U.
Por qué importa: si forzamos linealidad cuando la relación es curvilínea, aumentan residuos sistemáticos y baja capacidad explicativa.
5.6 Segmentos y heterogeneidad
A veces el mismo fenómeno se comporta distinto en subgrupos (por zona, tipo de hogar, estrato de consumo, etc.). Esto se llama heterogeneidad estructural.
Por qué importa: un solo modelo global puede ocultar patrones opuestos entre segmentos.
5.7 Outliers con contexto
No todo outlier es error. Algunos son errores de captura; otros son casos reales raros pero informativos.
Buena práctica: diferenciar outlier técnico (dato incorrecto) de outlier sustantivo (caso extremo real). La decisión de tratar o conservar debe quedar justificada.
5.8 Resultado esperado de esta fase
Una buena exploración multivariada produce tres entregables concretos: 1. Hipótesis de trabajo sobre qué variables deberían entrar al modelo base. 2. Lista de riesgos (colinealidad, no linealidad, outliers, posibles segmentos). 3. Plan de modelado (transformaciones, interacciones y pruebas diagnósticas a ejecutar).
5.9 Ejemplo guiado con dataset sintético y validación
En las celdas siguientes vamos a crear un dataset sintético y validar cada punto anterior de forma observable: - distribuciones marginales, - relación predictor-objetivo, - relación entre predictores y posible colinealidad, - matriz de correlaciones (y su interpretación), - evidencia de no linealidad, - diferencias por segmento, - detección de outliers con criterio.
Idea central: no es solo “mirar gráficos”; es transformar observaciones en decisiones de modelado.
Se creó una muestra sintética con estructura controlada, suficiente para demostrar fenómenos multivariados reales: colinealidad, heterogeneidad, no linealidad y outliers.
Esta etapa no busca probar hipótesis, sino garantizar un “laboratorio” donde cada patrón aparezca de forma observable.
Conclusión metodológica: antes de interpretar resultados, siempre verifica que entiendes cómo fue generado o recolectado el dato.
5.9 Desarrollo por etapas (enfoque didáctico)
En lugar de un script único, separamos el análisis en etapas para validar cada idea por separado.
Etapa 1: crear datos sintéticos con patrones controlados.
Etapa 2: revisar distribuciones marginales.
Etapa 3: medir correlación de predictores con la variable objetivo.
Etapa 4: estudiar correlación entre predictores (aquí está el foco principal).
Etapa 5: confirmar redundancia con VIF.
Etapa 6: comprobar no linealidad.
Etapa 7: evaluar heterogeneidad por segmento.
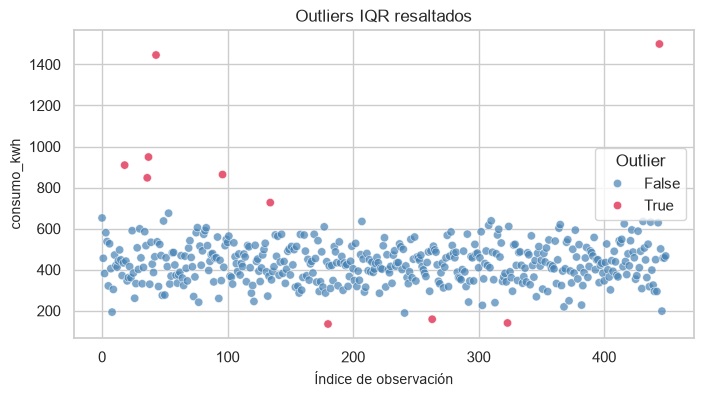
Etapa 8: detectar outliers con criterio IQR.
Sugerencia: ejecuta en orden para que cada etapa use objetos creados en las anteriores.
Una aclaración antes de empezar: para que estos patrones (colinealidad fuerte, heterogeneidad clara, outliers marcados) se vean con nitidez, el dataset que vas a construir en la Etapa 1 es distinto del de energía residencial de la sección 3 — tiene variables propias (ingreso, tamano_hogar, gasto_electrico_base, segmento urbano/rural) diseñadas a propósito para ilustrar cada fenómeno con claridad. Cuando lleguemos a la sección 6 y construyamos el modelo completo, vas a volver al dataset original de la sección 3.
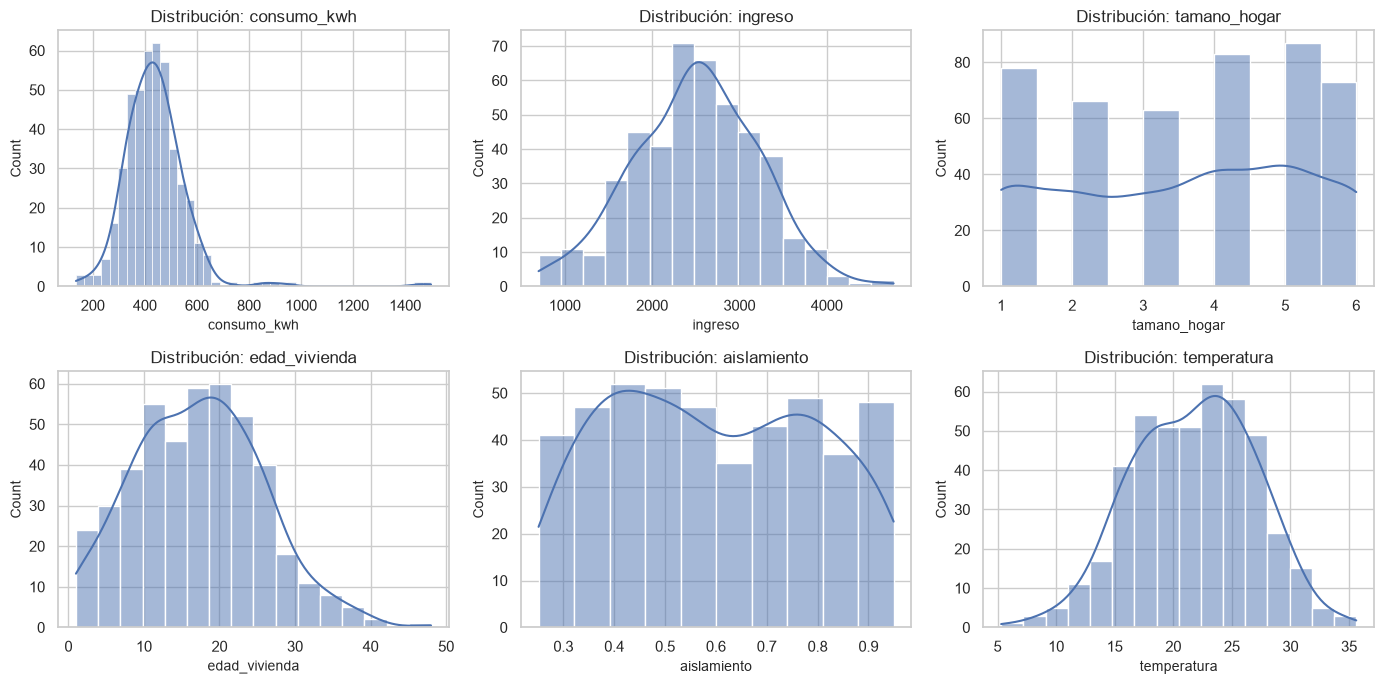
La asimetría de consumo_kwh es claramente mayor que la de la mayoría de predictores, lo que sugiere presencia de cola derecha (consumos extremos).
Los predictores principales muestran formas razonables y no patológicas en comparación con la variable objetivo.
Conclusión analítica: ya hay evidencia temprana de observaciones extremas en la respuesta; esto justifica revisar outliers más adelante (Etapa 8).
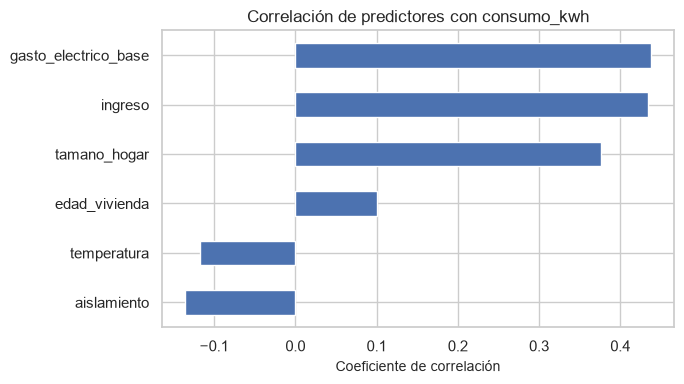
# Etapa 3: correlación de cada predictor con la variable objetivocorr_target = df_demo[preds + ["consumo_kwh"]].corr()["consumo_kwh"].drop("consumo_kwh")corr_target = corr_target.sort_values(key=np.abs, ascending=False)print("Correlación predictor -> consumo (ordenada por magnitud absoluta):")display(corr_target.to_frame("corr_con_consumo"))plt.figure(figsize=(7, 4))corr_target.sort_values().plot(kind="barh")plt.title("Correlación de predictores con consumo_kwh")plt.xlabel("Coeficiente de correlación")plt.tight_layout()plt.show()print("Interpretación: magnitud más alta = asociación lineal más fuerte (no implica causalidad).")
Correlación predictor -> consumo (ordenada por magnitud absoluta):
corr_con_consumo
gasto_electrico_base
0.437479
ingreso
0.434257
tamano_hogar
0.375648
aislamiento
-0.135343
temperatura
-0.117516
edad_vivienda
0.099901
Interpretación: magnitud más alta = asociación lineal más fuerte (no implica causalidad).
Los predictores con mayor correlación absoluta con consumo_kwh son ingreso y gasto_electrico_base; por tanto, son candidatos fuertes para el modelo base.
tamano_hogar también aporta señal útil, aunque menor.
Variables con correlación baja no se descartan automáticamente: podrían actuar de forma no lineal o en interacción con otras.
Conclusión clave para estudiantes: correlación alta prioriza, no sentencia causalidad.
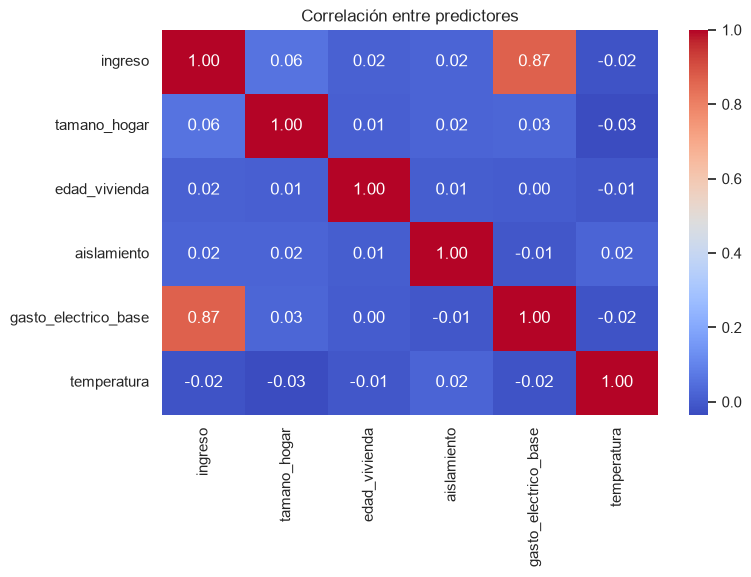
# Etapa 4: correlación entre predictores (foco principal)corr_preds = df_demo[preds].corr()print("Matriz de correlación entre predictores:")display(corr_preds)plt.figure(figsize=(8, 5))sns.heatmap(corr_preds, annot=True, cmap="coolwarm", fmt=".2f")plt.title("Correlación entre predictores")plt.show()# Ranking de pares con mayor correlación absolutapairs = ( corr_preds.where(np.triu(np.ones(corr_preds.shape), k=1).astype(bool)) .stack() .reset_index() .rename(columns={"level_0": "var_1", "level_1": "var_2", 0: "corr"}))pairs["abs_corr"] = pairs["corr"].abs()pairs = pairs.sort_values("abs_corr", ascending=False)print("Top 8 pares más correlacionados (en valor absoluto):")display(pairs.head(8))print("Lectura clave: una correlación alta entre predictores sugiere posible redundancia de información.")
Matriz de correlación entre predictores:
ingreso
tamano_hogar
edad_vivienda
aislamiento
gasto_electrico_base
temperatura
ingreso
1.000000
0.058265
0.015557
0.022029
0.869356
-0.015021
tamano_hogar
0.058265
1.000000
0.010388
0.023812
0.026014
-0.034876
edad_vivienda
0.015557
0.010388
1.000000
0.005575
0.003494
-0.008368
aislamiento
0.022029
0.023812
0.005575
1.000000
-0.008215
0.022293
gasto_electrico_base
0.869356
0.026014
0.003494
-0.008215
1.000000
-0.017753
temperatura
-0.015021
-0.034876
-0.008368
0.022293
-0.017753
1.000000
Top 8 pares más correlacionados (en valor absoluto):
var_1
var_2
corr
abs_corr
4
ingreso
gasto_electrico_base
0.869356
0.869356
1
ingreso
tamano_hogar
0.058265
0.058265
11
tamano_hogar
temperatura
-0.034876
0.034876
10
tamano_hogar
gasto_electrico_base
0.026014
0.026014
9
tamano_hogar
aislamiento
0.023812
0.023812
23
aislamiento
temperatura
0.022293
0.022293
3
ingreso
aislamiento
0.022029
0.022029
29
gasto_electrico_base
temperatura
-0.017753
0.017753
Lectura clave: una correlación alta entre predictores sugiere posible redundancia de información.
Conclusiones Etapa 4 (correlación entre predictores, foco principal)
La matriz y el ranking de pares muestran una correlación muy alta entre ingreso y gasto_electrico_base (alrededor de 0.87).
Esto indica redundancia informativa: ambas variables están capturando, en parte, el mismo fenómeno.
Riesgo práctico: si ambas entran juntas al modelo, los coeficientes pueden volverse menos estables y más difíciles de interpretar.
Regla didáctica: correlación cercana a 0 implica bajo riesgo; correlación moderada exige revisar VIF; correlación alta casi obliga a validar colinealidad y evaluar simplificación.
# Etapa 5: cuantificar redundancia entre predictores con VIFX_vif_demo = sm.add_constant(df_demo[preds])vif_demo = pd.DataFrame({"variable": X_vif_demo.columns,"VIF": [variance_inflation_factor(X_vif_demo.values, i) for i inrange(X_vif_demo.shape[1])]})display(vif_demo.sort_values("VIF", ascending=False))print("Guia rapida: VIF < 5 usualmente aceptable; 5-10 zona de alerta; > 10 problema serio.")
variable
VIF
0
const
46.990296
1
ingreso
4.132227
5
gasto_electrico_base
4.119082
2
tamano_hogar
1.007616
4
aislamiento
1.004502
6
temperatura
1.002103
3
edad_vivienda
1.000809
Guia rapida: VIF < 5 usualmente aceptable; 5-10 zona de alerta; > 10 problema serio.
Conclusiones Etapa 5 (VIF y colinealidad)
El VIF de ingreso y gasto_electrico_base confirma lo visto en correlación: hay solapamiento de información.
Aunque no parece un caso extremo, sí es suficiente para advertir que la interpretación simultánea de ambos coeficientes debe hacerse con cuidado.
Conclusión metodológica: correlación alta sugiere, VIF confirma el nivel del problema.
# Etapa 6: validar no linealidad (lineal vs polinomial en temperatura)X_lin = df_demo[["temperatura"]]y_lin = df_demo["consumo_kwh"]m_lin = LinearRegression().fit(X_lin, y_lin)r2_lin = m_lin.score(X_lin, y_lin)poly = PolynomialFeatures(degree=2, include_bias=False)X_poly = poly.fit_transform(X_lin)m_poly = LinearRegression().fit(X_poly, y_lin)r2_poly = m_poly.score(X_poly, y_lin)print(f"R2 lineal (temperatura -> consumo): {r2_lin:.3f}")print(f"R2 polinomial grado 2: {r2_poly:.3f}")print("Si el polinomial mejora de forma clara, hay evidencia de curvatura.")
R2 lineal (temperatura -> consumo): 0.014
R2 polinomial grado 2:             0.014
Si el polinomial mejora de forma clara, hay evidencia de curvatura.
Conclusiones Etapa 6 (no linealidad)
La comparación lineal vs polinomial muestra si temperatura aporta curvatura útil.
Si el cambio en desempeño es pequeño, la relación puede tratarse como aproximadamente lineal para fines prácticos.
Si la mejora fuera clara, sería señal de incluir términos no lineales o transformaciones en el modelo final.
Conclusión para clase: no se asume no linealidad por intuición; se valida con evidencia comparativa.
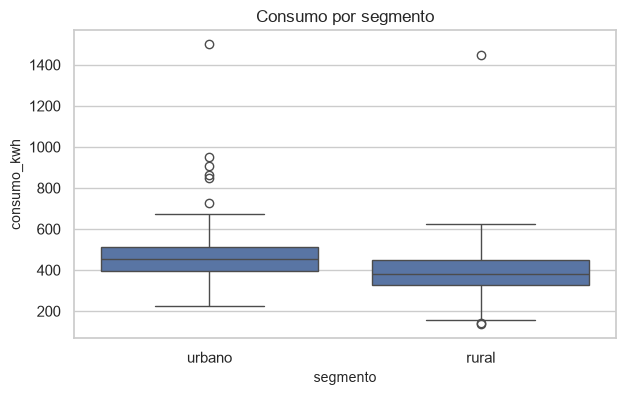
# Etapa 7: validar heterogeneidad por segmentoresumen_segmento = df_demo.groupby("segmento")["consumo_kwh"].agg(["mean", "median", "std", "count"])print("Resumen por segmento:")display(resumen_segmento)plt.figure(figsize=(7, 4))sns.boxplot(data=df_demo, x="segmento", y="consumo_kwh")plt.title("Consumo por segmento")plt.show()print("Si las medias/medianas difieren de forma consistente, hay heterogeneidad estructural.")
Resumen por segmento:
mean
median
std
count
segmento
rural
390.330223
382.678209
124.188189
153
urbano
462.614223
455.502952
117.755586
297
Si las medias/medianas difieren de forma consistente, hay heterogeneidad estructural.
Conclusiones Etapa 7 (heterogeneidad por segmento)
Las diferencias entre urbano y rural en media/mediana de consumo indican que no todo el comportamiento se explica igual para todos los grupos.
Conclusión analítica: existe heterogeneidad estructural; por tanto, el segmento puede ser variable relevante o puede justificar modelos con interacción.
Lección para estudiantes: promediar todo sin segmentar puede ocultar patrones importantes.
Outliers detectados por IQR: 10 (2.22%)
Primeros casos para inspección contextual:
segmento
ingreso
temperatura
consumo_kwh
18
urbano
2538.787656
21.959488
909.347068
36
urbano
2634.936971
18.557640
847.581914
37
urbano
878.806315
17.065044
948.831839
43
rural
3251.097441
24.611346
1445.817729
96
urbano
1553.545359
16.699184
863.513000
134
urbano
4299.768079
30.301488
726.822478
180
rural
1570.405241
22.073216
135.410652
263
rural
1816.872298
18.462113
158.588262
323
rural
1752.390752
25.020978
140.435608
444
urbano
2564.273788
15.801986
1499.488896
Conclusiones Etapa 8 (outliers con IQR)
El porcentaje detectado de outliers sugiere que hay casos extremos suficientes para revisar, pero no tantos como para invalidar todo el dataset.
Conclusión práctica: antes de eliminar puntos, distinguir entre error técnico y caso real extremo con valor analítico.
Decisión recomendada: documentar criterio de tratamiento de outliers y luego comparar métricas con y sin esos casos para medir impacto.
5.9.8 Cierre de validación
Si quieres priorizar la parte de correlación, el orden sugerido es: 1. Ejecutar Etapa 3 (objetivo vs predictores). 2. Ejecutar Etapa 4 (correlación entre predictores). 3. Ejecutar Etapa 5 (VIF).
Con esas tres etapas puedes justificar si existe redundancia, qué variable aporta señal útil y dónde hay riesgo de interpretación inestable.
6. Supuestos clave en regresión múltiple
La regresión múltiple no se evalúa solo por el R2. Para interpretar coeficientes, p-valores e intervalos de confianza con rigor, hay supuestos que deben revisarse.
6.1 Linealidad
La relación esperada entre cada predictor y la respuesta (controlando los demás) debe ser aproximadamente lineal.
Si falla: aparecen patrones sistemáticos en residuos y sesgo en coeficientes.
6.2 Independencia de errores
Los residuos deben ser aproximadamente independientes entre observaciones.
Si falla: errores estándar mal estimados, pruebas t/F menos confiables.
6.3 Homoscedasticidad
La varianza de residuos debe ser parecida a lo largo del rango de predicción.
Si falla: puede no afectar tanto la predicción media, pero sí compromete inferencia (p-valores e intervalos).
6.4 Normalidad aproximada de residuos
No es el supuesto más crítico para predecir, pero sí para inferencia clásica, sobre todo en muestras pequeñas.
Si falla con fuerza: intervalos y contrastes pueden ser inestables.
6.5 Baja multicolinealidad
Los predictores no deben ser casi copias entre sí.
Si falla: coeficientes inestables, signos que cambian entre muestras y mayor incertidumbre en cada beta.
6.6 Especificación del modelo
El modelo debe incluir variables relevantes y forma funcional razonable (por ejemplo, incluir no linealidad si existe).
Si falla: sesgo por variable omitida o mala forma del modelo.
Idea docente clave: un modelo puede tener buen R2 y aun así tener problemas de interpretación si no cumple supuestos básicos.
A partir de aquí volvemos al dataset de energía residencial de la sección 3 (df, con temperatura, ocupantes, area_m2, aislamiento y electrodomesticos) — el dataset de las Etapas 1-8 (df_demo) fue solo para ilustrar los fenómenos de exploración multivariada, y ya cumplió su función. Ahora construyes el modelo completo con inferencia formal (statsmodels), VIF, evaluación predictiva y diagnóstico de residuos.
# Separación train/test y ajuste con statsmodels para inferenciaX = df.drop(columns=["consumo_kwh"])y = df["consumo_kwh"]X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=24)X_train_sm = sm.add_constant(X_train)modelo_ols = sm.OLS(y_train, X_train_sm).fit()print(modelo_ols.summary())
Interpretación detallada de la salida OLS (ejemplo de clase)
1) Calidad global del modelo - R-squared = 0.823: el modelo explica 82.3% de la variabilidad de consumo_kwh. - Adj. R-squared = 0.821: ajuste alto y muy cercano a R2, sin señal fuerte de sobreparametrización. - F-statistic = 367.6 y Prob(F) = 6.43e-146: en conjunto, los predictores aportan explicación estadísticamente significativa.
2) Tamaño muestral y grados de libertad - No. Observations = 400: se ajustó con 400 observaciones. - Df Model = 5: hay cinco predictores en el modelo. - Df Residuals = 394: consistente con 400 - 5 - 1 (intercepto).
3) Coeficientes (interpretación ceteris paribus) - const = 161.9641: consumo esperado cuando los predictores valen 0 (interpretación contextual limitada). - temperatura = -1.8394: al aumentar 1 unidad de temperatura, el consumo disminuye ~1.84 unidades, manteniendo lo demás constante. - ocupantes = 18.9569: cada ocupante adicional aumenta el consumo en ~18.96 unidades. - area_m2 = 1.8394: cada m2 adicional aumenta consumo en ~1.84 unidades. - aislamiento = -58.7356: mayor aislamiento reduce consumo de forma importante. - electrodomesticos = 8.9760: cada equipo adicional aumenta el consumo en ~8.98 unidades.
4) Significancia individual de predictores - Todos los p-valores reportados son ~0.000 (prácticamente < 0.001). - Los intervalos de confianza al 95% no cruzan 0 en ningún coeficiente. - Lectura: cada predictor muestra evidencia de aporte estadístico en presencia de los demás.
5) Diagnósticos de residuos y supuestos - Durbin-Watson = 1.889: cercano a 2, sin evidencia fuerte de autocorrelación residual. - Omnibus p = 0.513 y JB p = 0.535: no hay evidencia para rechazar normalidad de residuos. - Skew = -0.137 y Kurtosis = 3.015: forma residual bastante cercana a normalidad.
6) Complejidad y comparación de modelos - AIC = 3762 y BIC = 3786: útiles para comparar con modelos alternativos; menor valor indica mejor equilibrio ajuste-complejidad.
7) Señal de colinealidad / condición numérica - Cond. No. = 686: sugiere revisar escalas y posible colinealidad moderada. - No implica por sí solo un problema grave, pero justifica complementar con VIF y chequeo de estabilidad.
8) Nota de inferencia - Covariance Type: nonrobust indica que los errores estándar asumen homoscedasticidad correctamente especificada. - Si sospechas heteroscedasticidad, conviene contrastar con errores robustos (por ejemplo HC3).
Cierre didáctico El modelo luce fuerte en ajuste global y consistente en signos/efectos. La lectura profesional no termina en R2: siempre se cierra con diagnóstico de supuestos, colinealidad y estabilidad inferencial.
7. Multicolinealidad y VIF
La multicolinealidad es el solapamiento de información entre predictores: varias variables explicativas aportan casi la misma señal dentro del modelo. El VIF (Variance Inflation Factor) es el indicador que cuantifica ese problema, midiendo cuánto se infla la varianza de cada coeficiente por depender linealmente de los demás predictores. Sí, está relacionado con la correlación: correlaciones altas entre predictores suelen ser una alerta inicial, pero el VIF es más completo porque evalúa la colinealidad conjunta (no solo pares aislados).
Diferencia clave: la correlación describe asociación lineal entre dos variables a la vez (visión bivariada), mientras que el VIF evalúa para cada predictor cuánta redundancia tiene respecto al conjunto de todos los demás predictores (visión multivariada). Por eso, puede haber casos con correlaciones por pares moderadas pero VIF elevado, si la combinación de varias variables juntas explica casi la misma información.
7.1 Por qué ocurre
Variables que miden casi el mismo fenómeno (ejemplo: ingreso y gasto base).
Variables derivadas entre sí.
Escenarios donde varias variables crecen/disminuyen juntas por diseño del proceso.
7.2 Qué problema genera
Coeficientes inestables: cambian mucho entre muestras parecidas.
Errores estándar inflados: baja precisión en cada beta.
p-valores menos informativos para decidir qué variable “importa”.
Signos contraintuitivos en algunos coeficientes.
7.3 Qué NO hace la multicolinealidad
No significa automáticamente que el modelo prediga mal.
No implica que haya error en los datos.
No invalida por completo el ajuste global (R2 puede seguir alto).
7.4 VIF como herramienta práctica
El VIF (Variance Inflation Factor) cuantifica cuánto se infla la varianza de un coeficiente por colinealidad con los demás predictores.
Regla orientativa (no absoluta): - VIF < 5: zona normalmente aceptable. - 5 <= VIF < 10: zona de alerta, revisar con criterio. - VIF >= 10: riesgo alto de inestabilidad interpretativa.
7.5 Cómo decidir en clase/proyecto
Mirar pares de correlación altos entre predictores.
Confirmar con VIF.
Si hay problema:
quitar o combinar variables redundantes,
usar regularización (Ridge/Lasso),
priorizar interpretabilidad según objetivo del estudio.
Idea clave: en análisis explicativo, la multicolinealidad es sobre todo un problema de interpretación de coeficientes, no solo de ajuste.
Frase clave
“la correlación mira relaciones de a pares; el VIF cuantifica la colinealidad de una variable frente al bloque completo de predictores.”
# Cálculo e interpretación práctica de VIFX_vif = sm.add_constant(X_train).copy()vif_df = pd.DataFrame({"variable": X_vif.columns,"VIF": [variance_inflation_factor(X_vif.values, i) for i inrange(X_vif.shape[1])]})# El intercepto no se interpreta para colinealidad, se excluye en el semaforo.vif_eval = vif_df[vif_df["variable"] !="const"].copy()def clasificar_vif(v):if v <5:return"OK (<5)"if v <10:return"Alerta (5-10)"return"Alto (>=10)"vif_eval["lectura"] = vif_eval["VIF"].apply(clasificar_vif)vif_eval = vif_eval.sort_values("VIF", ascending=False).reset_index(drop=True)display(vif_eval)n_alerta = (vif_eval["VIF"] >=5).sum()n_alto = (vif_eval["VIF"] >=10).sum()print(f"Variables en alerta (VIF >= 5): {n_alerta}")print(f"Variables en riesgo alto (VIF >= 10): {n_alto}")
variable
VIF
lectura
0
ocupantes
1.014488
OK (<5)
1
temperatura
1.010758
OK (<5)
2
aislamiento
1.007479
OK (<5)
3
electrodomesticos
1.005178
OK (<5)
4
area_m2
1.003686
OK (<5)
Variables en alerta (VIF >= 5): 0
Variables en riesgo alto (VIF >= 10): 0
# Conclusiones automáticas según resultados VIFvif_max =float(vif_eval["VIF"].max())var_max =str(vif_eval.loc[vif_eval["VIF"].idxmax(), "variable"])print("Resumen automático de colinealidad:")print(f"- VIF máximo: {vif_max:.3f} ({var_max})")print(f"- Variables en alerta (VIF >= 5): {int(n_alerta)}")print(f"- Variables en riesgo alto (VIF >= 10): {int(n_alto)}")if n_alto >0:print("Conclusión: hay multicolinealidad alta; revisar selección/transformación de variables antes de interpretar coeficientes.")elif n_alerta >0:print("Conclusión: existe colinealidad moderada; interpretar coeficientes con cautela y considerar regularización.")else:print("Conclusión: no hay evidencia relevante de multicolinealidad según VIF; la interpretación de coeficientes es estable en este aspecto.")
Resumen automático de colinealidad:
- VIF máximo: 1.014 (ocupantes)
- Variables en alerta (VIF >= 5): 0
- Variables en riesgo alto (VIF >= 10): 0
Conclusión: no hay evidencia relevante de multicolinealidad según VIF; la interpretación de coeficientes es estable en este aspecto.
Conclusiones Cap. 7 (Multicolinealidad y VIF)
Cómo se calcula e interpreta el VIF en este notebook
Se toma la matriz de predictores de entrenamiento (X_train) y se agrega constante para el ajuste auxiliar.
Para cada predictor \(X_j\), se estima una regresión auxiliar donde \(X_j\) es respuesta y los demás predictores explican su variación.
De esa regresión se obtiene \(R_j^2\) y se calcula: \(VIF_j = \frac{1}{1-R_j^2}\).
Se repite para todos los predictores y se clasifican en:
OK (<5)
Alerta (5-10)
Alto (>=10)
Lectura de resultados obtenidos
VIF máximo observado: 1.014 (variable ocupantes).
Variables en alerta (\(VIF \geq 5\)): 0.
Variables en riesgo alto (\(VIF \geq 10\)): 0.
Conclusión metodológica
No hay evidencia relevante de multicolinealidad en este modelo. Por tanto, la interpretación de coeficientes es estable desde el punto de vista de colinealidad. Se puede continuar con el conjunto actual de predictores, manteniendo monitoreo de VIF si se agregan nuevas variables o interacciones.
8. Evaluación predictiva
La evaluación predictiva responde dos preguntas: 1. ¿Qué tan grande es el error en unidades reales? 2. ¿Qué tan estable es el desempeño cuando cambia la muestra?
Primero definimos el error por observación (residuo de predicción):
\[e_i = y_i - \hat{y}_i\]
Con esos residuos, las métricas principales son:
MAE (Mean Absolute Error): \[\text{MAE} = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat{y}_i|\]
Interpretación conceptual: - MAE: error promedio en unidades originales; fácil de explicar a negocio/política pública. - MSE: error cuadrático promedio; amplifica errores grandes y es muy útil para comparar modelos durante optimización matemática. - RMSE: raíz del MSE; conserva la sensibilidad a errores grandes pero vuelve a la escala original de la variable objetivo. - R2: proporción de variabilidad explicada; útil para comparar ajuste global.
La validación cruzada complementa la foto de test único: en lugar de depender de una sola partición, mide robustez en varios pliegues.
Idea clave: no conviene decidir con una sola métrica. Un modelo puede tener buen R2 y aun así un error absoluto demasiado alto para el contexto de decisión.
Guía rápida de lectura de métricas
Métrica
Qué penaliza más
Cuándo priorizarla
Si el valor es X, tener cuidado porque probablemente significa…
Qué se debería verificar / hacer / comparar
MAE
Penaliza todos los errores de forma lineal
Cuando quieres una medida robusta y fácil de comunicar en unidades reales
MAE alto respecto a la escala de y: el error promedio ya es grande para la decisión práctica. MAE bajo: error promedio manejable.
Verificar MAE contra una tolerancia de negocio/operación (ej.: porcentaje del valor medio de y) y comparar con baseline de la media.
MSE
Penaliza cuadráticamente, castiga fuerte los errores grandes
Cuando quieres sensibilidad alta a outliers y función de costo para optimización
MSE muy alto: existen errores grandes que dominan el desempeño. MSE bajo: menos impacto de errores extremos.
Revisar observaciones con error grande, detectar outliers y comparar antes/después de limpieza o transformaciones.
RMSE
Penaliza más fuerte los errores grandes (vía cuadrado) y vuelve a escala original
Cuando los errores extremos son costosos y necesitas interpretación en unidades reales
RMSE mucho mayor que MAE: hay cola de errores grandes y conviene revisar outliers/no linealidad. RMSE cercano a MAE: error más homogéneo.
Comparar RMSE vs MAE y revisar residuales: si RMSE >> MAE, verificar no linealidad, segmentación o variables omitidas.
R2
No mide error absoluto; mide varianza explicada
Cuando comparas ajuste global entre modelos sobre el mismo problema
R2 cercano a 1: buena explicación global. R2 cerca de 0: el modelo mejora poco frente a predecir la media. R2 negativo: peor que la referencia de la media.
Comparar R2 en train/test/CV y con modelos alternativos; confirmar que la mejora sea estable y no sobreajuste.
Regla práctica docente: interpreta MAE/RMSE siempre en la unidad real de la variable objetivo y valida estabilidad con CV, no solo con una sola partición de test.
# Modelo base con sklearn + lectura de estabilidadlr = LinearRegression()lr.fit(X_train, y_train)pred_test = lr.predict(X_test)mae = mean_absolute_error(y_test, pred_test)rmse = np.sqrt(mean_squared_error(y_test, pred_test))r2 = r2_score(y_test, pred_test)cv_r2 = cross_val_score(lr, X, y, cv=5, scoring="r2")cv_r2_mean =float(cv_r2.mean())cv_r2_std =float(cv_r2.std())print(f"MAE : {mae:.2f}")print(f"RMSE: {rmse:.2f}")print(f"R2 test: {r2:.3f}")print(f"R2 CV (media): {cv_r2_mean:.3f}")print(f"R2 CV (desv): {cv_r2_std:.3f}")# Brecha test vs CV como chequeo rapido de estabilidadgap_test_cv = r2 - cv_r2_meanprint(f"Brecha R2 test - R2 CV media: {gap_test_cv:+.3f}")
En esta corrida: MAE=22.40 y RMSE=27.66 (error en la escala real de consumo_kwh); R2 test=0.820, el modelo explica el 82% de la variabilidad.
R2 CV (media)=0.808 con desviación=0.037 entre folds. La brecha test-CV es de apenas +0.012.
Brecha pequeña: el modelo generaliza de forma consistente, sin señal de sobreajuste al conjunto de test.
9. Cuándo usar regularización
Definición breve (antes del detalle): Regularizar significa entrenar el modelo minimizando no solo el error de ajuste, sino también una penalización por coeficientes grandes. En práctica, es una forma de controlar complejidad para reducir sobreajuste y mejorar generalización.
En palabras simples, así funciona el proceso matemático:
Qué hace OLS (sin regularización) - Solo intenta minimizar el error de predicción. - Si hay ruido o variables muy parecidas, puede asignar coeficientes grandes e inestables para “perseguir” detalles de la muestra.
Qué agrega la regularización - Además de minimizar error, agrega un “costo” por coeficientes grandes. - Eso obliga al modelo a preferir soluciones más sobrias.
Ridge (penalización \(L_2\))
Idea en palabras:encoge todos los coeficientes, pero casi nunca los vuelve exactamente cero.
Qué hace en la práctica: 1. Recorta suavemente magnitudes grandes. 2. Reparte mejor el peso cuando hay variables correlacionadas. 3. Estabiliza coeficientes entre distintas muestras. 4. No filtra variables de forma dura: normalmente todas quedan, pero con menos peso.
Si quieres una frase tipo aula: - Ridge es como bajar el volumen general del modelo, no apagar parlantes.
Lasso (penalización \(L_1\))
Idea en palabras:encoge y además puede apagar algunos coeficientes (dejarlos en cero).
Qué hace en la práctica: 1. Recorta coeficientes. 2. Filtra variables: algunas quedan exactamente en 0. 3. Simplifica el modelo (selección automática de predictores). 4. Puede ser menos estable si hay muchas variables muy correlacionadas entre sí, porque “elige” algunas y descarta otras.
Frase tipo aula: - Lasso no solo baja volumen, también mutea algunos canales.
Filtra, recorta, promedia
Ridge: recorta y estabiliza, no filtra duro.
Lasso: recorta y filtra.
Promediar: no es lo principal aquí; la validación cruzada sí promedia desempeño para elegir hiperparámetros (como \(\alpha\)).
Rol de \(\alpha\)
\(\alpha\) pequeño: casi como OLS.
\(\alpha\) grande: más recorte.
En Ridge: más contracción global.
En Lasso: más coeficientes llevados a cero.
Mensaje final para la sección: regularizar no busca maquillar resultados, busca reducir sensibilidad al ruido y mejorar generalización fuera de muestra.
# Comparación: OLS vs Ridge vs Lasso con validación cruzadamodelos = {"OLS": LinearRegression(),"Ridge(alpha=1.0)": Pipeline([("scaler", StandardScaler()), ("m", Ridge(alpha=1.0))]),"Lasso(alpha=0.05)": Pipeline([("scaler", StandardScaler()), ("m", Lasso(alpha=0.05, max_iter=10000))]),}res_reg = []for nombre, modelo in modelos.items(): scores = cross_val_score(modelo, X, y, cv=5, scoring="r2") res_reg.append({"modelo": nombre,"r2_cv_mean": float(scores.mean()),"r2_cv_std": float(scores.std()) })res_reg_df = pd.DataFrame(res_reg).sort_values("r2_cv_mean", ascending=False).reset_index(drop=True)display(res_reg_df)mejor_modelo =str(res_reg_df.loc[0, "modelo"])mejor_r2 =float(res_reg_df.loc[0, "r2_cv_mean"])print(f"Mejor modelo por R2 CV medio: {mejor_modelo} ({mejor_r2:.3f})")
modelo
r2_cv_mean
r2_cv_std
0
Ridge(alpha=1.0)
0.808210
0.037045
1
Lasso(alpha=0.05)
0.808183
0.037127
2
OLS
0.808125
0.037456
Mejor modelo por R2 CV medio: Ridge(alpha=1.0) (0.808)
Conclusiones Cap. 9 (Regularización)
Comparación por validación cruzada (R2 CV medio): Ridge(alpha=1.0)=0.8082, Lasso(alpha=0.05)=0.8082, OLS=0.8081 — prácticamente empatados, diferencias en la 4ª-5ª cifra decimal.
Ridge quedó primero por un margen mínimo (0.0001 sobre Lasso, 0.0001 sobre OLS): no hay evidencia de que regularizar aporte una mejora real en este dataset.
Con VIF máximo de 1.014 (ver Cap. 7), no hay multicolinealidad que justifique Ridge, ni un exceso de variables que justifique la selección de Lasso: OLS sin regularizar es una elección razonable aquí.
10. Diagnóstico de residuos (capítulo clave)
El residuo es la parte que el modelo no logra explicar:
\[e_i = y_i - \hat{y}_i\]
Mirar residuos permite detectar problemas que no se ven en una sola métrica de desempeño. Un modelo puede tener buen R2 y, aun así, mostrar fallas estructurales en residuos.
Qué se debe revisar (versión simple)
Que los residuos estén alrededor de 0 Si la mayoría está cerca de 0, el modelo no tiene sesgo fuerte.
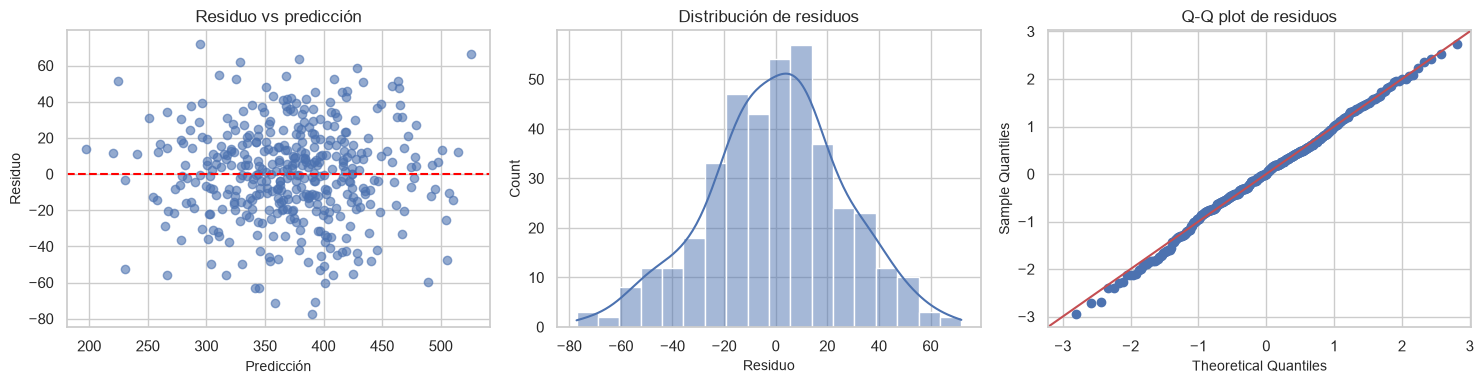
Que no haya patrón en residuo vs predicción Debe verse una nube desordenada. Si aparece curva, pendiente o forma clara, el modelo está dejando estructura sin explicar.
Que la dispersión sea parecida en todo el rango Si al aumentar la predicción los residuos se abren como embudo, hay varianza no constante.
Que no haya demasiados casos extremos Muchos residuos muy grandes pueden distorsionar resultados y conclusiones.
Que la forma general sea razonable Con histograma y Q-Q plot revisamos si los residuos se parecen de forma aproximada a una distribución normal.
Un cuidado importante: entrenamiento vs. prueba
Dos de los chequeos numéricos más comunes —la media de los residuos y la correlación entre predicción y residuo— dan exactamente 0 por construcción cuando se calculan sobre los mismos datos con los que se ajustó un modelo OLS con intercepto. No es que el modelo sea bueno: es una propiedad algebraica de mínimos cuadrados (las ecuaciones normales obligan a que los residuos sean ortogonales a las columnas de \(X\), incluida la de unos). Por eso, esos dos chequeos solo aportan información real si se calculan sobre datos de prueba, que el modelo no vio al ajustarse.
Si aparece una alerta, qué hacer
Probar transformaciones (por ejemplo log).
Agregar términos no lineales o interacciones.
Revisar outliers y calidad de datos.
Considerar segmentar el análisis o usar errores robustos.
Idea clave: el diagnóstico de residuos conecta ajuste predictivo con validez estadística de la interpretación.
# Diagnóstico de residuos: gráfico + resumen numéricofrom statsmodels.stats.stattools import durbin_watsonpred_train = modelo_ols.predict(X_train_sm)resid = y_train - pred_train# Prediccion y residuos sobre el conjunto de PRUEBA: el modelo no los vio al ajustarse,# por eso son los unicos que permiten un chequeo no tautologico de media y correlacion (ver nota arriba).X_test_sm = sm.add_constant(X_test)pred_test = modelo_ols.predict(X_test_sm)resid_test = y_test - pred_testfig, axes = plt.subplots(1, 3, figsize=(15, 4))# 1) Residuo vs predicciónaxes[0].scatter(pred_train, resid, alpha=0.6)axes[0].axhline(0, color="red", linestyle="--")axes[0].set_xlabel("Predicción")axes[0].set_ylabel("Residuo")axes[0].set_title("Residuo vs predicción")# 2) Histograma de residuossns.histplot(resid, kde=True, ax=axes[1])axes[1].set_title("Distribución de residuos")axes[1].set_xlabel("Residuo")# 3) Q-Q plotsm.qqplot(resid, line="45", ax=axes[2], fit=True)axes[2].set_title("Q-Q plot de residuos")plt.tight_layout()plt.show()# Resumen numerico rapido (sobre train, para escala/forma) mas el chequeo no tautologico (sobre test)resid_mean =float(resid.mean())resid_std =float(resid.std())corr_pred_resid =float(np.corrcoef(pred_train, resid)[0, 1])pct_extremos =float((np.abs(resid) >2* resid_std).mean() *100)dw =float(durbin_watson(resid))resid_test_mean =float(resid_test.mean())corr_pred_resid_test =float(np.corrcoef(pred_test, resid_test)[0, 1])print(f"Media de residuos (train, ~0 por construccion, no es diagnostico): {resid_mean:.3f}")print(f"Media de residuos (test, chequeo real): {resid_test_mean:.3f}")print(f"Desv. estandar de residuos: {resid_std:.3f}")print(f"Correlacion prediccion-residuo (train, ~0 por construccion, no es diagnostico): {corr_pred_resid:.3f}")print(f"Correlacion prediccion-residuo (test, chequeo real): {corr_pred_resid_test:.3f}")print(f"% residuos extremos (|resid| > 2*std): {pct_extremos:.2f}%")print(f"Durbin-Watson: {dw:.3f}")# Lectura automatica orientativa (usa el chequeo de test, el unico no tautologico)ifabs(corr_pred_resid_test) >0.2:print("Alerta: hay dependencia notable entre prediccion y residuo en test; revisar especificacion.")else:print("OK: no hay dependencia lineal fuerte entre prediccion y residuo en test.")if pct_extremos >8:print("Alerta: porcentaje alto de residuos extremos; revisar outliers y no linealidad.")else:print("OK: porcentaje de residuos extremos en rango razonable.")
Media de residuos (train, ~0 por construccion, no es diagnostico): 0.000
Media de residuos (test, chequeo real):                          2.371
Desv. estandar de residuos: 26.319
Correlacion prediccion-residuo (train, ~0 por construccion, no es diagnostico): -0.000
Correlacion prediccion-residuo (test, chequeo real):                            0.088
% residuos extremos (|resid| > 2*std): 5.25%
Durbin-Watson: 1.889
OK: no hay dependencia lineal fuerte entre prediccion y residuo en test.
OK: porcentaje de residuos extremos en rango razonable.
Conclusiones Cap. 10 (Diagnóstico de residuos)
Definición explícita de Durbin-Watson - Durbin-Watson mide si los residuos consecutivos están correlacionados (autocorrelación). - Su rango aproximado es 0 a 4. - Cerca de 2: independencia razonable de errores (deseable). - Menor que 2: autocorrelación positiva. - Mayor que 2: autocorrelación negativa.
Lectura de esta ejecución (qué significa y por qué es bueno)
Media de residuos (train) = 0.000 vs. media de residuos (test) = 2.371
Significa: en train, la media da exactamente 0 por construcción de OLS (no es un hallazgo); el valor que sí informa es el de test, y ahí el error promedio es de apenas 2.4 unidades sobre un rango de consumo que va de cientos a miles de kWh.
Por qué es bueno: un sesgo promedio tan pequeño en datos no vistos indica que el modelo no está sistemáticamente sobreestimando ni subestimando fuera de la muestra de entrenamiento.
Desv. estándar de residuos = 26.319
Significa: tamaño típico de la dispersión del error.
Por qué es bueno: en conjunto con R2 alto y buenos diagnósticos, sugiere un nivel de error razonable para este ejemplo.
Correlación predicción-residuo (train) = -0.000 vs. (test) = 0.088
Significa: en train, esta correlación es cero por construcción (ortogonalidad de mínimos cuadrados), no un hallazgo; el valor que sí informa es el de test, y ahí sale 0.088 — muy por debajo del umbral de alerta (0.2).
Por qué es bueno: en datos que el modelo no vio al ajustarse, tampoco aparece una relación lineal apreciable entre lo que predice y su error, lo que reduce evidencia de patrón sistemático omitido.
% residuos extremos = 5.25%
Significa: hay pocos casos con error muy grande (umbral 2*desv. estándar).
Por qué es bueno: no parece existir una cola extrema dominante que distorsione todo el modelo.
Durbin-Watson = 1.889
Significa: valor cercano a 2, sin evidencia fuerte de autocorrelación residual.
Por qué es bueno: respalda mejor la validez de la inferencia estadística.
Mensajes automáticos: OK y OK
Significa: el sistema no detecta, sobre el conjunto de prueba, dependencia lineal fuerte ni exceso de extremos bajo los umbrales definidos.
Por qué es bueno: confirma que, en chequeo básico sobre datos no vistos, la salud residual es adecuada.
Lectura de las gráficas - Residuo vs predicción: nube sin patrón claro y centrada en 0, lo cual es favorable. - Histograma: forma aproximadamente simétrica, compatible con normalidad aproximada. - Q-Q plot: puntos cercanos a la diagonal, con desviaciones leves aceptables en colas.
Cierre docente - El diagnóstico residual de esta corrida es saludable: no hay alertas fuertes de sesgo, autocorrelación ni exceso de extremos. - Se puede continuar con interpretación del modelo, manteniendo monitoreo si se cambian variables o se usa otro dataset.
11. Guía práctica para interpretar resultados (paso a paso)
Usa esta guía cada vez que termines un modelo. La idea es responder: - qué tan bien predice, - si es estable, - y si se puede interpretar con confianza.
Paso 1: mirar error en unidades reales
Revisa MAE y RMSE. - Si son bajos para el contexto, el modelo es útil en términos prácticos. - Si RMSE es mucho mayor que MAE, hay errores grandes que debes investigar.
Paso 2: mirar capacidad explicativa
Revisa R2 en test. - R2 alto: el modelo explica gran parte de la variabilidad. - R2 bajo: faltan variables, forma funcional o calidad de datos.
Paso 3: revisar estabilidad
Compara R2 test con R2 promedio de validación cruzada. - Si son parecidos, buena estabilidad. - Si hay brecha grande, posible sobreajuste o partición poco representativa.
Paso 4: revisar salud de residuos
Confirma 4 cosas mínimas: 1. residuos centrados en 0, 2. sin patrón claro en residuo vs predicción, 3. dispersión parecida (sin embudo fuerte), 4. porcentaje de extremos razonable.
Paso 5: revisar independencia de errores
Mira Durbin-Watson. - Cerca de 2: bien (independencia razonable). - Muy lejos de 2: alerta de autocorrelación.
Paso 6: revisar multicolinealidad
Mira VIF de predictores. - VIF < 5: normalmente aceptable. - 5 a 10: alerta. - >= 10: problema serio de interpretación.
Paso 7: decidir acción
Si métricas y diagnósticos son buenos: reportar y usar.
Si predice bien pero falla diagnóstico: ajustar modelo (transformaciones, no linealidad, segmentación, robustez).
Si predice mal: volver a variables, datos y especificación.
Semáforo de decisión rápido
Verde: R2 estable + residuos sanos + VIF sano.
Amarillo: predice razonable, pero con alguna alerta diagnóstica.
Rojo: baja estabilidad o diagnósticos con fallas fuertes; no interpretar coeficientes sin corregir.
Plantilla corta mejorada (lista para copiar)
Desempeño “MAE = , RMSE = , R2 test = . Interpretación: el error en escala real es y la capacidad explicativa es ___.”
Estabilidad “R2 CV medio = , desviación CV = , brecha (R2 test - R2 CV) = . Interpretación: la estabilidad es (alta/media/baja).”
Colinealidad “VIF max = ___ (variable: ). Interpretación: colinealidad (baja/moderada/alta).”
Decisión final “Decisión: ___ (usar / ajustar / replantear). Justificación: se decide esto porque ___.”
Criterio de cierre rápido
Si 4 o 5 bloques salen favorables: modelo útil para reporte final.
Si 2 o más bloques salen en alerta: ajustar antes de cerrar conclusiones.
Idea clave: interpretar un modelo no es mirar un solo número; es seguir una guía completa y consistente.
12. Cierre
Este notebook deja una base clara de análisis multivariado:
marco teórico breve,
flujo de trabajo reproducible,
ejemplo alternativo al contexto comercial,
herramientas para inferencia, predicción y diagnóstico.
Siguiente paso sugerido: adaptar este esqueleto a un dataset real del curso y comparar un modelo lineal simple frente a uno multivariado.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.