De datos dispersos a información en la que se puede confiar.
ETL, arquitecturas distribuidas y gobierno del dato — la disciplina que hace que todo lo demás, IA incluida, sea defendible.
Antes de analizar, hay que poder confiar en el dato.
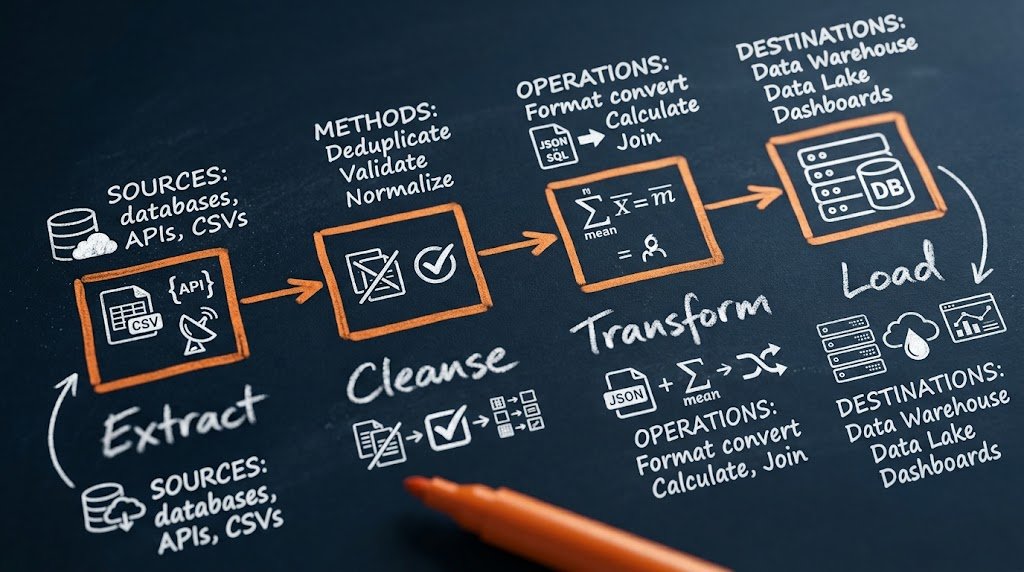
Integración y ETL
Consolidamos datos dispersos en múltiples fuentes y formatos en un proceso único, documentado y repetible.
Arquitecturas a escala
Desde ETL puntual hasta clústeres distribuidos (Hadoop/HDFS, PySpark) cuando el volumen supera lo que las herramientas tradicionales pueden procesar.
Calidad y trazabilidad
Cada transformación queda documentada — se puede explicar de dónde salió cada cifra, no solo mostrarla.
Data es la etapa que casi nadie audita. Nosotros empezamos por ahí.
La mayoría de los problemas de IA que después salen caros no nacen en el modelo — nacen en los datos que lo alimentan. Por eso tratamos la integración y el ETL como una disciplina de ingeniería con estándares propios, no como un paso intermedio sin importancia. Cada pipeline que construimos queda documentado de forma que, meses después, cualquiera pueda explicar de dónde salió cada cifra y por qué se transformó así.
Ver el flujo completoProyectos reales donde esto ya se puso a prueba.
Clúster Hadoop/HDFS + PySpark
Un volumen de datos que superaba lo que las herramientas tradicionales podían procesar de forma eficiente.
Arquitectura de procesamiento distribuido validada; impacto cuantitativo en producción pendiente de precisar con el proyecto específico que la puso en marcha.
ETL de datos contables masivos para una empresa de logística
Una empresa de logística tenía años de información contable y financiera dispersa en múltiples fuentes, sin un proceso unificado para consolidarla ni explotarla.
Ahorros importantes de tiempo y dinero para la empresa, al eliminar el procesamiento manual y disperso de la información contable.
SIAT — Sistema de Auditoría Técnica del MinTIC
El MinTIC necesitaba auditar y supervisar a escala nacional proyectos y sistemas TIC, con información técnica dispersa entre múltiples entidades.
Más de 750 auditorías técnicas ejecutadas de forma acumulada entre los distintos roles del equipo en el proyecto.
SIBI — Sistema Empresarial
BI LTDA necesitaba un sistema empresarial propio para su operación e infraestructura de TI.
Sistema en operación desde 2011; alcance funcional actual y métricas de uso pendientes de confirmar con el cliente.