Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo III — Automatización y orquestación
Imagine este diálogo, que ocurre en casi cada curso de machine learning:
— ¿Cuánto te dio?
— F1 de 0.91.
— ¿En test?
— Sí. Probé como treinta valores de \(C\) hasta que salió.
Esa cifra no es un resultado. Es el máximo de treinta exámenes administrados al mismo grupo de estudiantes. Quien se queda con el mejor de treinta está midiendo su habilidad para pescar suerte, no la capacidad del modelo de generalizar. En producción el F1 cae, el equipo habla de “overfitting” y se cambia de algoritmo. El diagnóstico más preciso es otro: el test se usó dos veces —una para elegir y otra para presumir.
Esta sesión es el documento de enganche del módulo. El argumento no es “use GridSearchCV porque es más profesional”. El argumento es estadístico y, si se entiende, cambia la forma de trabajar:
Automatizar el entrenamiento no es buscar más rápido. Es impedir que el azar se cobre dos veces.
En la sesión 5 el contrato era \(\hat{y} = f(T(x))\). Aquí el contrato se amplía: cómo se eligió\(f\) debe quedar escrito, y el test debe permanecer ciego hasta el final. Un GridSearchCV no es rigor por usar más CPU. Lo es si declara espacio, métrica y folds, y reserva un test que nadie usó para decidir.
Objetivos de aprendizaje
Al finalizar, el estudiante estará en capacidad de:
Distinguir estimar desempeño de maximizar un número sobre un conjunto fijo.
Demostrar, con un experimento de Monte Carlo, el maleficio del ganador: el mejor F1 de test tras muchas miradas es sesgado hacia arriba.
Reservar un test aislado y estimar con validación cruzada estratificada dentro del train.
Justificar la métrica (por qué accuracy miente en desbalance) y leer una curva de aprendizaje.
Comparar GridSearchCV y RandomizedSearchCV con presupuesto explícito, e introducir la idea de búsqueda bayesiana y de CV anidada.
Persistir el ganador con una ficha de evidencia: \(C\) elegido sin test, F1 de CV, F1 de test una vez.
Qué no cubre esta sesión
Diseñar \(T\) (sesión 4) ni serializar el contrato (sesión 5): aquí se usan.
Orquestar ETL → train como DAG (sesión 7).
Un registry que compare corridas a lo largo de semanas (sesión 8).
Ruta de trabajo
El diálogo del 0.91 y las dos preguntas que no hay que mezclar.
El experimento del maleficio del ganador (enganche empírico).
Protocolo honesto: test reservado + \(k\)-fold.
Curvas de aprendizaje y elección de métrica.
Búsqueda: grilla, azar, idea bayesiana, CV anidada.
Varios modelos bajo el mismo protocolo.
Una medición final, persistencia y taller.
# Entorno de la sesión 6: protocolo de elección, no rediseño de features.from pathlib import Pathimport joblibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport seaborn as snsfrom sklearn.calibration import calibration_curvefrom sklearn.compose import ColumnTransformerfrom sklearn.dummy import DummyClassifierfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import ( accuracy_score, classification_report, confusion_matrix, f1_score, precision_recall_curve, precision_score, recall_score, roc_auc_score,)from sklearn.model_selection import ( GridSearchCV, RandomizedSearchCV, StratifiedKFold, cross_val_score, learning_curve, train_test_split,)from sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScalerfrom sklearn.tree import DecisionTreeClassifiernp.random.seed(42)sns.set_theme(style="whitegrid", context="notebook")pd.set_option("display.width", 120)pd.set_option("display.float_format", lambda x: f"{x:.4f}")RUTA = Path("artefactos_sesion6")RUTA.mkdir(exist_ok=True)print("Entorno listo. Semilla 42.")print("Tesis de la sesión: el test no es un fold más, ni un tablero de prueba.")
Entorno listo. Semilla 42.
Tesis de la sesión: el test no es un fold más, ni un tablero de prueba.
1) Dos preguntas que el trabajo manual mezcla
En una frase: estimar responde “¿qué esperamos fuera de muestra?”; maximizar responde “¿quién ganó este torneo?”. Si usa el mismo conjunto para ambas, el número final es el del pescador más paciente.
Objetivo
Pregunta honesta
Qué se corrompe si se mezclan
Estimar
¿Qué desempeño esperamos en datos no vistos?
Tratar el número del test como la verdad
Maximizar
¿Cuál de estos candidatos gana en esta muestra?
Elegir al ganador de un torneo y creer que esa cifra se repetirá
Formalmente, sea \(\mathcal{H} = \{h_1,\ldots,h_m\}\) una familia de hipótesis (por ejemplo, \(m\) valores de \(C\)). Sea \(R(h)\) el riesgo verdadero y \(\widehat{R}_{\mathrm{test}}(h)\) el riesgo empírico en un test fijo. El ganador del torneo
[ h^= {h } {}(h) ]
cumple, en esperanza,
[ ;; . ]
Eso no es un detalle. Es el maleficio del ganador (winner’s curse): cuanto más grande es \(m\), más optimista es el número que usted reporta. Automatizar sin protocolo solo aumenta \(m\).
El laboratorio de esta sesión
Un dataset sintético, desbalanceado a propósito (~22 % de clase 1), con ingreso y segmento. La etiqueta depende de ambas, con ruido. No buscamos un F1 espectacular. Buscamos un fenómeno que se pueda ver: la diferencia entre un torneo sobre el test y un protocolo que lo deja ciego.
El test se aparta ahora, antes de cualquier búsqueda. Esa no es la lección de la sesión 5 (ya la vimos). Es la precondición de esta.
# Dataset didáctico y test aislado desde el primer momento.rng = np.random.default_rng(42)n =520ingreso = rng.normal(4_500_000, 1_100_000, n).clip(700_000, 11_000_000)visitas = rng.poisson(5, n).astype(float)segmento = rng.choice(["retail", "pyme", "corporativo"], n, p=[0.55, 0.30, 0.15])logit = (-2.05+1.45* ((ingreso - ingreso.mean()) / ingreso.std())+0.10* visitas+ np.where(segmento =="corporativo", 1.05, 0.0))y = (rng.random(n) <1/ (1+ np.exp(-logit))).astype(int)df = pd.DataFrame( {"ingreso": ingreso, "visitas": visitas, "segmento": segmento, "alta_prioridad": y})X = df[["ingreso", "visitas", "segmento"]]y = df["alta_prioridad"]X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.25, random_state=42, stratify=y)print(f"train: {len(X_train)} filas | test reservado: {len(X_test)} filas")print("Tasa de clase 1 en train:", f"{y_train.mean():.3f}")print("Tasa de clase 1 en test :", f"{y_test.mean():.3f}")print("A partir de aquí, X_test no entra a ninguna búsqueda.")
train: 390 filas | test reservado: 130 filas
Tasa de clase 1 en train: 0.287
Tasa de clase 1 en test : 0.292
A partir de aquí, X_test no entra a ninguna búsqueda.
# Pipeline de la sesión 5: T y f viajan juntos; el CV ajustará T en cada fold.preprocesador = ColumnTransformer( [ ("num", StandardScaler(), ["ingreso", "visitas"]), ("cat", OneHotEncoder(handle_unknown="ignore"), ["segmento"]), ])pipeline_base = Pipeline( [ ("pre", preprocesador), ("modelo", LogisticRegression(max_iter=800, solver="lbfgs")), ])cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)print("Pipeline y CV estratificado de 5 folds listos.")print("Si se escalara ANTES de armar los folds, cada validación contaminaría a T.")
Pipeline y CV estratificado de 5 folds listos.
Si se escalara ANTES de armar los folds, cada validación contaminaría a T.
2) El experimento de enganche: treinta miradas al mismo examen
En una frase: si usted prueba \(m\) valores de \(C\) y se queda con el que mejor se vio en test, está reportando \(\max_i \widehat{R}_{\mathrm{test}}(h_i)\), no una estimación de \(R(h)\).
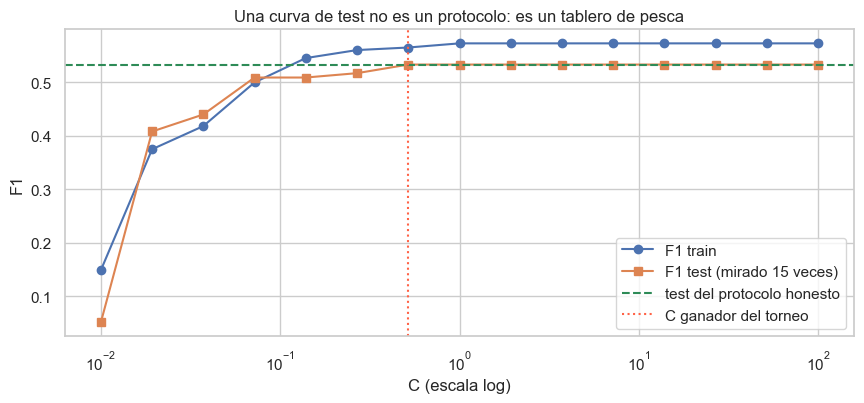
Vamos a hacer, a propósito, lo que el diálogo del 0.91 hace. Recorremos una lista de \(C\) sobre el test. Anotamos el mejor. Después hacemos lo correcto: elegimos \(C\) solo con CV en train y medimos el test una vez. La diferencia entre esos dos números, en esta muestra, ya es elocuente. El Monte Carlo de la siguiente sección dirá si es anecdótica o sistemática.
# Torneo ilegal: cada C se puntúa en el test. El 'ganador' es el max de 15 exámenes.Cs = np.logspace(-2, 2, 15)filas_ilegal = []for C in Cs: pipe = Pipeline( [ ("pre", preprocesador), ("modelo", LogisticRegression(C=C, max_iter=800)), ] ) pipe.fit(X_train, y_train) filas_ilegal.append( {"C": C,"f1_test": f1_score(y_test, pipe.predict(X_test), zero_division=0),"f1_train": f1_score(y_train, pipe.predict(X_train), zero_division=0), } )torneo = pd.DataFrame(filas_ilegal)mejor_ilegal = torneo.loc[torneo["f1_test"].idxmax()]# Protocolo honesto: elige C por CV, mide test una vez.grid_honesta = GridSearchCV( pipeline_base, {"modelo__C": list(Cs)}, cv=cv, scoring="f1", n_jobs=1)grid_honesta.fit(X_train, y_train)f1_test_honesto = f1_score( y_test, grid_honesta.best_estimator_.predict(X_test), zero_division=0)print("Torneo sobre el TEST (ilegal):")print(torneo.round(3).to_string(index=False))print(f"\nMejor F1 de test en el torneo: {mejor_ilegal['f1_test']:.3f} (C={mejor_ilegal['C']:.3f})")print(f"F1 de test del protocolo honesto: {f1_test_honesto:.3f} (C={grid_honesta.best_params_['modelo__C']:.3f})")print(f"Delta (ilegal − honesto): {mejor_ilegal['f1_test'] - f1_test_honesto:+.3f}")
Torneo sobre el TEST (ilegal):
       C  f1_test  f1_train
  0.0100   0.0510    0.1490
  0.0190   0.4080    0.3750
  0.0370   0.4400    0.4180
  0.0720   0.5090    0.5000
  0.1390   0.5090    0.5450
  0.2680   0.5170    0.5600
  0.5180   0.5330    0.5650
  1.0000   0.5330    0.5730
  1.9310   0.5330    0.5730
  3.7280   0.5330    0.5730
  7.1970   0.5330    0.5730
 13.8950   0.5330    0.5730
 26.8270   0.5330    0.5730
 51.7950   0.5330    0.5730
100.0000   0.5330    0.5730

Mejor F1 de test en el torneo: 0.533  (C=0.518)
F1 de test del protocolo honesto: 0.533  (C=1.000)
Delta (ilegal − honesto): +0.000
Si el delta es positivo, el torneo parece mejor. Esa es la trampa: parece mejor porque eligió con la hoja de respuestas a la vista. En una sola muestra el delta puede ser pequeño. Por eso el siguiente experimento no mira una historia: mira una distribución.
# Visual del pecado: F1 de train y de test para cada C, y el máximo ilegal.fig, ax = plt.subplots(figsize=(8.8, 4.2))ax.plot(torneo["C"], torneo["f1_train"], marker="o", label="F1 train")ax.plot(torneo["C"], torneo["f1_test"], marker="s", label="F1 test (mirado 15 veces)")ax.axhline(f1_test_honesto, color="seagreen", ls="--", label="test del protocolo honesto")ax.axvline(mejor_ilegal["C"], color="tomato", ls=":", label="C ganador del torneo")ax.set_xscale("log")ax.set_xlabel("C (escala log)")ax.set_ylabel("F1")ax.set_title("Una curva de test no es un protocolo: es un tablero de pesca")ax.legend()plt.tight_layout()plt.show()
3) Monte Carlo: el maleficio del ganador no es una anécdota
Repetimos el experimento muchas veces, cada una con un split distinto. En cada repetición:
Ilegal: se elige el \(C\) que maximiza el F1 de ese test.
Honesto: se elige el \(C\) por CV en train y se puntúa el test una vez.
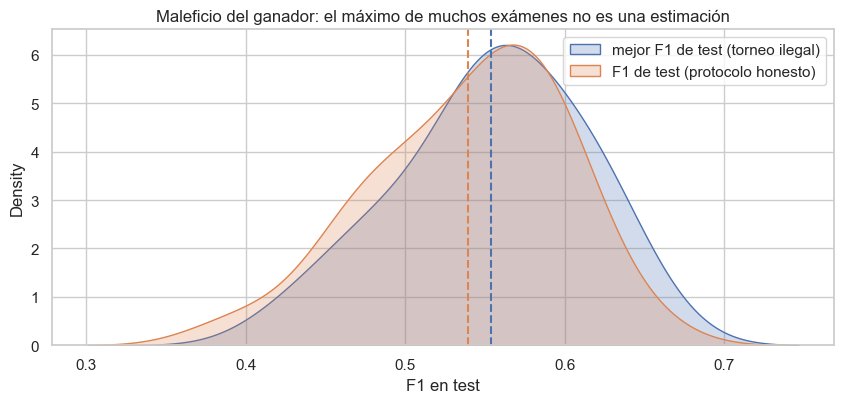
Si el maleficio existe, la distribución de los “mejores F1 ilegales” estará corrida a la derecha de la distribución honesta. Ese corrimiento es el sesgo de selección. No es overfitting clásico (el modelo memorizó filas). Es overfitting del protocolo: memorizó qué \(C\) le gustó al examen.
# Monte Carlo compacto: 28 repeticiones, 10 valores de C. El fenómeno basta.def un_split(semilla):return train_test_split(X, y, test_size=0.25, random_state=semilla, stratify=y)Cs_mc = np.logspace(-2, 2, 10)n_rep =28ilegales, honestos, Cs_ilegales = [], [], []for r inrange(n_rep): Xtr, Xte, ytr, yte = un_split(100+ r) f1s_test = []for C in Cs_mc: p = Pipeline( [("pre", preprocesador), ("modelo", LogisticRegression(C=C, max_iter=600))] ) p.fit(Xtr, ytr) f1s_test.append(f1_score(yte, p.predict(Xte), zero_division=0)) ilegales.append(max(f1s_test)) Cs_ilegales.append(Cs_mc[int(np.argmax(f1s_test))]) g = GridSearchCV( pipeline_base, {"modelo__C": list(Cs_mc)}, cv=3, scoring="f1", n_jobs=1 ) g.fit(Xtr, ytr) honestos.append(f1_score(yte, g.best_estimator_.predict(Xte), zero_division=0))mc = pd.DataFrame({"f1_ilegal": ilegales, "f1_honesto": honestos})print(mc.agg(["mean", "std", "min", "max"]).round(3).to_string())print(f"\nMedia(ilegal − honesto) = {(mc['f1_ilegal'] - mc['f1_honesto']).mean():+.3f}")print("Si esa media es > 0, el torneo sobre test infla el número de forma sistemática.")
      f1_ilegal  f1_honesto
mean     0.5540      0.5400
std      0.0580      0.0600
min      0.4230      0.3930
max      0.6570      0.6470

Media(ilegal − honesto) = +0.014
Si esa media es > 0, el torneo sobre test infla el número de forma sistemática.
# Dos histogramas: la mentira se ve como un corrimiento, no como un punto.fig, ax = plt.subplots(figsize=(8.6, 4.2))sns.kdeplot(mc["f1_ilegal"], ax=ax, fill=True, label="mejor F1 de test (torneo ilegal)")sns.kdeplot(mc["f1_honesto"], ax=ax, fill=True, label="F1 de test (protocolo honesto)")ax.axvline(mc["f1_ilegal"].mean(), color="C0", ls="--")ax.axvline(mc["f1_honesto"].mean(), color="C1", ls="--")ax.set_xlabel("F1 en test")ax.set_title("Maleficio del ganador: el máximo de muchos exámenes no es una estimación")ax.legend()plt.tight_layout()plt.show()
Lectura que hay que poder decir en voz alta. La curva azul no describe “mejores modelos”. Describe mejores pescas. Su media es un estimador sesgado de lo que ocurrirá mañana, porque mañana no habrá un test idéntico sobre el que volver a maximizar.
Esto conecta con un resultado clásico de selección de modelos (Varma y Simon, 2006; Cawley y Talbot, 2010): el error de validación del ganador de una búsqueda es optimista. La CV anidada —más adelante— es una respuesta. La respuesta mínima, que ya cabe en un curso, es: el test no entra a la búsqueda.
4) El test se reserva: no es un fold más
El protocolo honesto, escrito como reglamento y no como consejo:
Apartar un test una vez, al inicio.
Dentro de train, estimar y comparar con validación cruzada.
Elegir el ganador sin mirar el test.
Ajustar el ganador en todo train y entonces medir el test, una sola vez.
Si el F1 de test sale peor que el de CV, no se “corrige” el \(C\). Se documenta. Esa diferencia es información: la validación era optimista, ruidosa o ambas. Reabrir la grilla con el test a la vista es volver al diálogo del 0.91.
5) Validación cruzada: estimar sin casarse con un solo corte
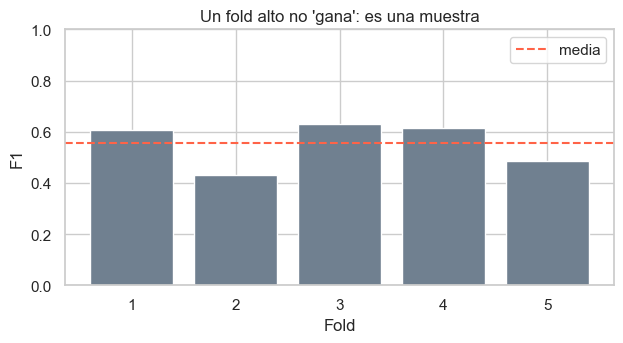
Un solo split de validación es barato y ruidoso. Si las 80 filas “vinieron fáciles”, el F1 se infla. \(k\)-fold estratificado hace \(k\) exámenes internos: en cada uno, un fold es examen y los otros \(k-1\) son estudio. El puntaje es el promedio; la desviación dice cuánto depende del fold.
[ {}(h) = {j=1}^{k} {F_j}(h{-F_j}). ]
Eso no reemplaza al test. Los folds viven dentro de train. CV responde: “dentro de lo que nos permitimos usar para decidir, ¿qué tan estable es este candidato?”. El test responde: “con el ganador ya elegido, ¿qué vimos en filas intocadas?”.
El pipeline tiene que entrar al CV
Si se escala antes de armar los folds, cada fold de validación ya contaminó a \(T\): es la fuga de la sesión 5, repetida \(k\) veces. cross_val_score y GridSearchCV deben recibir el pipeline, no la matriz ya transformada.
# Cinco exámenes internos: media para estimar, desviación para no enamorar.scores = cross_val_score(pipeline_base, X_train, y_train, cv=cv, scoring="f1")print("F1 por fold:", np.round(scores, 3))print(f"F1 medio ± std: {scores.mean():.3f} ± {scores.std():.3f}")print("Ninguno de estos folds es el test reservado.")
F1 por fold: [0.606 0.432 0.632 0.615 0.486]
F1 medio ± std: 0.554 ± 0.080
Ninguno de estos folds es el test reservado.
# Los folds no son réplicas idénticas: esa dispersión es parte del informe.fig, ax = plt.subplots(figsize=(6.4, 3.6))ax.bar(range(1, 6), scores, color="slategray")ax.axhline(scores.mean(), color="tomato", ls="--", label="media")ax.set_xlabel("Fold")ax.set_ylabel("F1")ax.set_ylim(0, 1)ax.set_title("Un fold alto no 'gana': es una muestra")ax.legend()plt.tight_layout()plt.show()
\(k=5\) frente a \(k=10\). Más folds → cada modelo interno se entrena con más datos y la estimación suele ser menos sesgada, a costa de más CPU y de folds de validación más pequeños (más varianza por fold). En muestras de unos cientos de filas, 5 estratificados es un default razonable. En muestras enormes, un solo holdout interno bien dimensionado puede bastar. El protocolo declara \(k\); no lo improvisamos “hasta que el F1 se vea estable”.
6) Curvas de aprendizaje: ¿falta modelo o faltan datos?
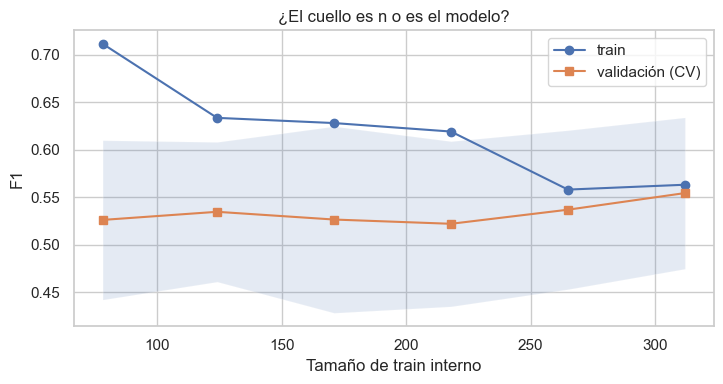
Una curva de aprendizaje responde una pregunta que la grilla no hace: si añado filas, ¿el F1 de validación sube? Si el score de train es alto y el de validación se estanca abajo, hay sesgo de modelo (o de \(T\)). Si ambos convergen juntos al subir \(n\), el cuello es el tamaño muestral, no \(C\).
Automatizar sin mirar esta curva es optimizar una palanca que quizá no es la que limita.
# Curva de aprendizaje del pipeline base (C=1). El test sigue intacto.sizes, tr_sc, va_sc = learning_curve( pipeline_base, X_train, y_train, cv=cv, scoring="f1", train_sizes=np.linspace(0.25, 1.0, 6), n_jobs=1,)fig, ax = plt.subplots(figsize=(7.4, 4.0))ax.plot(sizes, tr_sc.mean(axis=1), marker="o", label="train")ax.plot(sizes, va_sc.mean(axis=1), marker="s", label="validación (CV)")ax.fill_between(sizes, va_sc.mean(1) - va_sc.std(1), va_sc.mean(1) + va_sc.std(1), alpha=0.15)ax.set_xlabel("Tamaño de train interno")ax.set_ylabel("F1")ax.set_title("¿El cuello es n o es el modelo?")ax.legend()plt.tight_layout()plt.show()print("Si las curvas no se han juntado al final, más datos todavía pagarían.")
Si las curvas no se han juntado al final, más datos todavía pagarían.
7) La métrica es una decisión de diseño, no un default
En un problema al ~22 % de positivos, un clasificador que siempre dice 0 ya tiene accuracy alta. Si la búsqueda maximiza accuracy, puede coronar a un modelo tímido. F1 (o el área bajo la curva precisión-recall) obliga a acertar la clase rara. ROC-AUC mira ranking, no un umbral de 0.5.
El protocolo declara la métrica antes de buscar. Cambiarla después de ver los números es otra forma de pesca.
# Accuracy miente: el dummy 'más frecuente' ya parece serio.dummy = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)base = pipeline_base.fit(X_train, y_train)pred_d = dummy.predict(X_test)pred_b = base.predict(X_test)def fila(nombre, yt, yp, scores=None): out = {"modelo": nombre,"accuracy": accuracy_score(yt, yp),"precision": precision_score(yt, yp, zero_division=0),"recall": recall_score(yt, yp, zero_division=0),"f1": f1_score(yt, yp, zero_division=0), }if scores isnotNone: out["roc_auc"] = roc_auc_score(yt, scores)else: out["roc_auc"] = np.nanreturn outtabla_met = pd.DataFrame( [ fila("dummy más frecuente", y_test, pred_d), fila("logística C=1", y_test, pred_b, base.predict_proba(X_test)[:, 1]), ])print(tabla_met.round(3).to_string(index=False))print("\nEl dummy 'gana' accuracy y pierde F1. Si la grilla optimiza accuracy, puede parecerse a él.")
             modelo  accuracy  precision  recall     f1  roc_auc
dummy más frecuente    0.7080     0.0000  0.0000 0.0000      NaN
      logística C=1    0.7850     0.7270  0.4210 0.5330   0.7770

El dummy 'gana' accuracy y pierde F1. Si la grilla optimiza accuracy, puede parecerse a él.
Este recuadro se mide en test solo para enseñar el sesgo de la métrica, con un modelo no elegido por búsqueda. En el protocolo real, la comparación de métricas de candidatos se hace en CV. Aquí violamos esa regla un instante, de forma declarada, para que el dummy no se esconda.
8) Hiperparámetros: lo que usted elige, no lo que el fit aprende
Los parámetros (\(\beta\) de la logística) salen de optimizar la verosimilitud sobre el train de ese fold. Los hiperparámetros (\(C\), profundidad, \(k\) de k-NN) se eligen antes, o mediante una búsqueda declarada. \(C\) es la inversa de la regularización \(\ell_2\): grande → el modelo se apega al train; chica → se encoge.
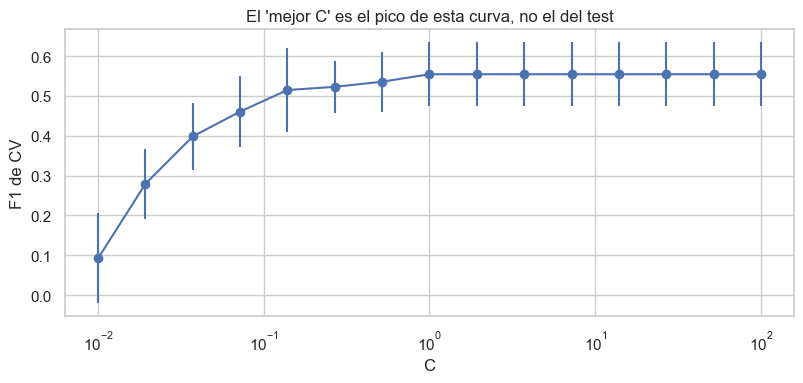
Elegir \(C\) mirando el test es el diálogo del 0.91. Elegirla con CV es esta sesión.
# Camino de regularización: F1 de CV para cada C, sin tocar el test.camino = []for C in Cs: p = Pipeline( [("pre", preprocesador), ("modelo", LogisticRegression(C=C, max_iter=800))] ) sc = cross_val_score(p, X_train, y_train, cv=cv, scoring="f1") camino.append({"C": C, "f1_cv_media": sc.mean(), "f1_cv_std": sc.std()})camino = pd.DataFrame(camino)print(camino.round(3).to_string(index=False))
fig, ax = plt.subplots(figsize=(8.2, 4.0))ax.errorbar(camino["C"], camino["f1_cv_media"], yerr=camino["f1_cv_std"], marker="o")ax.set_xscale("log")ax.set_xlabel("C")ax.set_ylabel("F1 de CV")ax.set_title("El 'mejor C' es el pico de esta curva, no el del test")plt.tight_layout()plt.show()
9) Tres maneras de buscar: grilla, azar y la idea bayesiana
Método
Idea
Cuándo
Costo
Grid search
Todas las combinaciones de una grilla
Pocas palancas
Producto cartesiano
Random search
Muestrea el espacio
Espacio ancho, presupuesto fijo
n_iter
Bayesiana (idea)
Usa lo ya visto para decidir el siguiente intento
Cada fit es caro
Menos intentos, más lógica
Bergstra y Bengio (2012) mostraron que, si solo un subconjunto de hiperparámetros importa, una grilla densa desperdicia evaluaciones en ejes irrelevantes. El azar explora mejor esos ejes. La búsqueda bayesiana construye un modelo de regiones prometedoras. Conceptualmente: deja de ser un ciego que barre o lanza dardos; es un ciego que actualiza creencias.
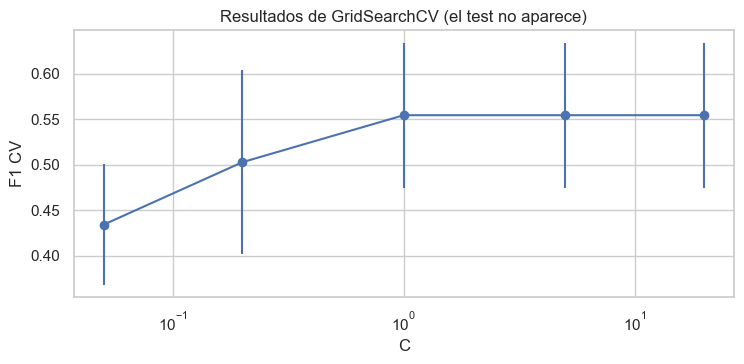
En scikit-learn, GridSearchCV y RandomizedSearchCV envuelven el CV. No deben ver X_test.
# Misma métrica, mismo CV, dos búsquedas. El test sigue ciego.espacio_grilla = {"modelo__C": [0.05, 0.2, 1.0, 5.0, 20.0]}espacio_azar = {"modelo__C": np.logspace(-2, 2, 16)}grid = GridSearchCV(pipeline_base, espacio_grilla, cv=cv, scoring="f1", n_jobs=1)rand = RandomizedSearchCV( pipeline_base, param_distributions=espacio_azar, n_iter=6, cv=cv, scoring="f1", random_state=42, n_jobs=1,)grid.fit(X_train, y_train)rand.fit(X_train, y_train)comp_busca = pd.DataFrame( [ {"metodo": "GridSearchCV","mejor_C": grid.best_params_["modelo__C"],"f1_cv": grid.best_score_,"ajustes": len(grid.cv_results_["params"]), }, {"metodo": "RandomizedSearchCV","mejor_C": rand.best_params_["modelo__C"],"f1_cv": rand.best_score_,"ajustes": len(rand.cv_results_["params"]), }, ])print(comp_busca.round(4).to_string(index=False))print("Más ajustes ≠ más verdad: son más oportunidades de sobreajustar la validación.")
            metodo  mejor_C  f1_cv  ajustes
      GridSearchCV   1.0000 0.5544        5
RandomizedSearchCV  54.1170 0.5544        6
Más ajustes ≠ más verdad: son más oportunidades de sobreajustar la validación.
# Mapa de la grilla: cada punto es un candidato, no un veredicto de producción.res = pd.DataFrame(grid.cv_results_)fig, ax = plt.subplots(figsize=(7.6, 3.8))ax.errorbar( res["param_modelo__C"].astype(float), res["mean_test_score"], yerr=res["std_test_score"], marker="o",)ax.set_xscale("log")ax.set_xlabel("C")ax.set_ylabel("F1 CV")ax.set_title("Resultados de GridSearchCV (el test no aparece)")plt.tight_layout()plt.show()print(res[["param_modelo__C", "mean_test_score", "std_test_score", "rank_test_score"]] .sort_values("rank_test_score").round(3).to_string(index=False))
Cada combinación × cada fold es un entrenamiento. 5 valores de \(C\) × 5 folds = 25 ajustes. Cuatro palancas con cinco valores y 5 folds son \(5^4 \times 5\) ajustes. La automatización sin presupuesto es una forma de no decidir. Un protocolo serio escribe: métrica, folds, espacio y tope de intentos.
10) Validación cruzada anidada: cuando la cifra de CV también es un ganador
Hay un segundo maleficio, más sutil. best_score_ de GridSearchCV es el F1 de CV del ganador. Ese número ya es un máximo sobre \(m\) candidatos. Es más honesto que el test pescado, pero sigue siendo optimista respecto al riesgo verdadero (Varma y Simon).
La CV anidada usa un loop externo para estimar y un loop interno para elegir \(C\):
fold externo \(j\): se busca \(C\)solo en los \(k-1\) folds internos;
se evalúa el ganador interno en el fold externo \(j\);
se promedian los \(k\) scores externos.
Es más caro. Es la estimación que se reporta cuando el paper dice “el procedimiento, no el \(C\) concreto, generaliza”. En esta sesión la implementamos de forma compacta (3×3) para ver el sesgo, no para usarla siempre.
# CV anidada compacta (3 externos × grilla interna de 3) frente a best_score_ ingenuo.outer = StratifiedKFold(n_splits=3, shuffle=True, random_state=0)inner_grid = {"modelo__C": [0.2, 1.0, 5.0]}externos = []for tr_i, te_i in outer.split(X_train, y_train): g_in = GridSearchCV(pipeline_base, inner_grid, cv=3, scoring="f1", n_jobs=1) g_in.fit(X_train.iloc[tr_i], y_train.iloc[tr_i]) pred_ext = g_in.best_estimator_.predict(X_train.iloc[te_i]) externos.append(f1_score(y_train.iloc[te_i], pred_ext, zero_division=0))print("F1 folds externos (anidada):", np.round(externos, 3))print(f"Media anidada: {np.mean(externos):.3f}")print(f"best_score_ de la grilla sobre todo train (ingenuo): {grid.best_score_:.3f}")print("Si la anidada < best_score_, el 'F1 de CV del ganador' ya era un poco pesca interna.")
F1 folds externos (anidada): [0.581 0.473 0.492]
Media anidada: 0.515
best_score_ de la grilla sobre todo train (ingenuo): 0.554
Si la anidada < best_score_, el 'F1 de CV del ganador' ya era un poco pesca interna.
No hay que anidar siempre: hay que saber cuándo el número que se cita ya es un máximo. Para el informe de esta sesión, citaremos tres cifras: F1 de CV del ganador, F1 anidado (estimación del procedimiento) y F1 de test (una vez).
11) Varios modelos, un solo reglamento
Comparar logística y árbol mirando el test es el mismo pecado, ahora entre algoritmos. El reglamento: cada familia se busca (o se fija) en CV; se elige la familia por CV; el test se mide al final, una vez, sobre el ganador.
# Dos familias, misma métrica, mismo CV. El test no desempata.pipe_arbol = Pipeline( [ ("pre", preprocesador), ("modelo", DecisionTreeClassifier(random_state=42)), ])grid_arbol = GridSearchCV( pipe_arbol, {"modelo__max_depth": [2, 3, 4, 6]}, cv=cv, scoring="f1", n_jobs=1,)grid_arbol.fit(X_train, y_train)familias = pd.DataFrame( [ {"familia": "logística", "f1_cv": grid.best_score_, "hiper": grid.best_params_}, {"familia": "árbol", "f1_cv": grid_arbol.best_score_, "hiper": grid_arbol.best_params_}, ])print(familias.to_string(index=False))ganadora_familia = familias.loc[familias["f1_cv"].idxmax(), "familia"]print("Ganadora por CV (aún sin test):", ganadora_familia)
  familia  f1_cv                    hiper
logística 0.5544       {'modelo__C': 1.0}
    árbol 0.5327 {'modelo__max_depth': 2}
Ganadora por CV (aún sin test): logística
12) El ganador no solo tiene un F1: tiene un umbral y una calibración
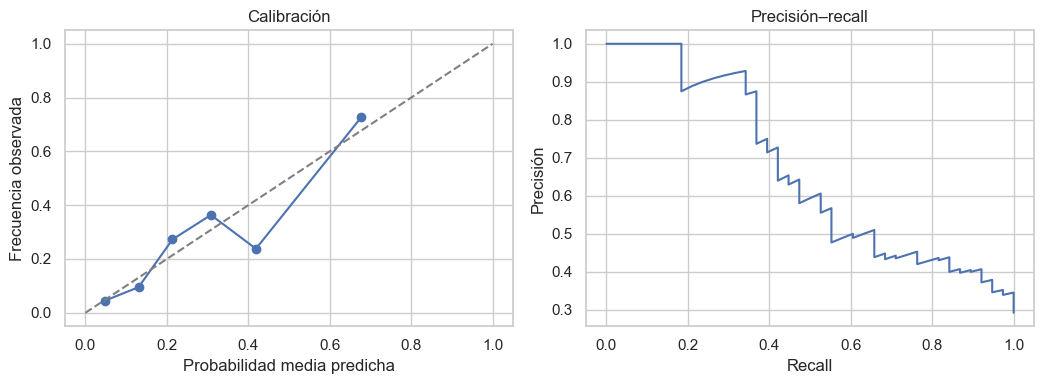
Elegir \(C\) no elige el umbral 0.5. En desbalance, un umbral distinto puede mejorar F1 sobre validación (otra palanca, otro fit de protocolo). La calibración pregunta si \(P(y=1\mid x)\approx 0.7\) significa “siete de cada diez”. Un modelo útil para ranking puede estar mal calibrado para una decisión de negocio con corte.
# El ganador de la grilla logística: matriz, reporte y calibración. Test UNA vez.ganador = grid.best_estimator_proba = ganador.predict_proba(X_test)[:, 1]pred_g = (proba >=0.5).astype(int)print("Matriz de confusión (umbral 0.5):")print(confusion_matrix(y_test, pred_g))print("\n", classification_report(y_test, pred_g, digits=3, zero_division=0))frac_pos, media_pred = calibration_curve(y_test, proba, n_bins=6, strategy="quantile")fig, axes = plt.subplots(1, 2, figsize=(10.6, 4.0))axes[0].plot(media_pred, frac_pos, marker="o")axes[0].plot([0, 1], [0, 1], ls="--", color="gray")axes[0].set_title("Calibración")axes[0].set_xlabel("Probabilidad media predicha")axes[0].set_ylabel("Frecuencia observada")p, r, _ = precision_recall_curve(y_test, proba)axes[1].plot(r, p)axes[1].set_title("Precisión–recall")axes[1].set_xlabel("Recall")axes[1].set_ylabel("Precisión")plt.tight_layout()plt.show()
Esas curvas se dibujan en test porque el protocolo ya eligió. No se usa el área para volver a cambiar \(C\). Se usa para entender al ganador: si está mal calibrado, el negocio no puede leer 0.7 como 70 %.
13) Una medición final y el artefacto
best_estimator_ ya es el pipeline refitado en todo X_train con el mejor \(C\). Ese es el objeto que se guarda (sesión 5). El F1 de test se reporta como estimación final, no como palanca.
# Persistencia + ficha de evidencia. El test aparece aquí por última vez.f1_test = f1_score(y_test, pred_g, zero_division=0)ruta = RUTA /"mejor_pipeline.joblib"joblib.dump(ganador, ruta)recargado = joblib.load(ruta)mismo = np.array_equal(recargado.predict(X_test), pred_g)ficha = {"C_elegido_sin_test": grid.best_params_["modelo__C"],"f1_cv_ganador": float(grid.best_score_),"f1_cv_anidada": float(np.mean(externos)),"f1_test_una_vez": float(f1_test),"n_train": int(len(X_train)),"n_test": int(len(X_test)),"metricas_de_busqueda": "f1","folds": 5,"artefacto_reproducible": bool(mismo),}print(pd.Series(ficha).to_string())print("\nSi f1_test < f1_cv, no se reabre la grilla. Se reporta.")print("Archivo:", ruta.resolve())
C_elegido_sin_test       1.0000
f1_cv_ganador            0.5544
f1_cv_anidada            0.5152
f1_test_una_vez          0.5333
n_train                     390
n_test                      130
metricas_de_busqueda         f1
folds                         5
artefacto_reproducible     True

Si f1_test < f1_cv, no se reabre la grilla. Se reporta.
Archivo: C:\Users\wilde\Dropbox\bit-blog\mlops-produccion\06-automatizacion-del-entrenamiento\artefactos_sesion6\mejor_pipeline.joblib
14) Sensibilidad a la semilla: el protocolo también tiene varianza
Un protocolo honesto no es un número único. Si cambiamos la semilla del split, el \(C\) ganador puede moverse. Eso no invalida el método; obliga a no tratar \(C=5\) como una constante de la naturaleza.
# Tres semillas de split: ¿el ganador de C es estable?semillas = [0, 1, 2]filas_seed = []for s in semillas: Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.25, random_state=s, stratify=y) g = GridSearchCV(pipeline_base, espacio_grilla, cv=3, scoring="f1", n_jobs=1) g.fit(Xtr, ytr) filas_seed.append( {"semilla": s,"C": g.best_params_["modelo__C"],"f1_cv": g.best_score_,"f1_test": f1_score(yte, g.best_estimator_.predict(Xte), zero_division=0), } )print(pd.DataFrame(filas_seed).round(3).to_string(index=False))print("Si C cambia, el objeto estable es el PROTOCOLO, no el hiperparámetro puntual.")
 semilla       C  f1_cv  f1_test
       0 20.0000 0.5780   0.4070
       1  5.0000 0.5240   0.5610
       2  5.0000 0.5360   0.6230
Si C cambia, el objeto estable es el PROTOCOLO, no el hiperparámetro puntual.
14b) Holdout interno frente a \(k\)-fold: dos estimadores, un mismo pecadillo posible
Un holdout de validación (20 % del train) es un CV de \(k=1\) con un solo corte. Es más barato y más ruidoso. El pecadillo reaparece si usted usa ese holdout para elegir\(C\) y luego reporta el F1 de ese mismo holdout como si estimara. La regla es simétrica: el conjunto que elige no es el que certifica.
# Holdout interno (elegir) vs un segundo corte (certificar). Todo dentro de train.X_in, X_val, y_in, y_val = train_test_split( X_train, y_train, test_size=0.25, random_state=7, stratify=y_train)f1_hold = []for C in [0.2, 1.0, 5.0, 20.0]: p = Pipeline( [("pre", preprocesador), ("modelo", LogisticRegression(C=C, max_iter=800))] ) p.fit(X_in, y_in) f1_hold.append((C, f1_score(y_val, p.predict(X_val), zero_division=0)))C_hold =max(f1_hold, key=lambda t: t[1])[0]print("F1 en el holdout interno:", [(c, round(v, 3)) for c, v in f1_hold])print("C elegido por holdout:", C_hold)print("Ese F1 máximo NO se cita como estimación. La estimación es CV o el test final.")
F1 en el holdout interno: [(0.2, 0.421), (1.0, 0.41), (5.0, 0.41), (20.0, 0.41)]
C elegido por holdout: 0.2
Ese F1 máximo NO se cita como estimación. La estimación es CV o el test final.
14c) class_weight es otra palanca, no un truco posterior
En desbalance, class_weight="balanced" cambia el costo de errar la clase rara. Es un hiperparámetro: se busca en CV, no se activa después de ver que el recall en test era bajo. Activarlo porque el test falló es el diálogo del 0.91 con otro nombre.
# Buscar C y class_weight juntos, siempre en train.grid_bal = GridSearchCV( pipeline_base, {"modelo__C": [0.2, 1.0, 5.0],"modelo__class_weight": [None, "balanced"], }, cv=cv, scoring="f1", n_jobs=1,)grid_bal.fit(X_train, y_train)print("Mejor par (sin test):", grid_bal.best_params_)print("F1 CV:", f"{grid_bal.best_score_:.3f}")print("Combinaciones evaluadas:", len(grid_bal.cv_results_["params"]))
Mejor par (sin test): {'modelo__C': 5.0, 'modelo__class_weight': 'balanced'}
F1 CV: 0.576
Combinaciones evaluadas: 6
14d) Tiempo de pared: el presupuesto se mide en minutos, no en intenciones
Automatizar también es saber cuánto cuesta una idea. Una grilla de 5 × 5 folds no es “gratis porque el computador corre”. En un modelo caro (un boosting, una red) ese producto es la diferencia entre un experimento y una noche perdida.
# Presupuesto observado de las dos búsquedas ya corridas.print("GridSearchCV ajustes:", len(grid.cv_results_["params"]),"| tiempo medio por ajuste (s):",f"{np.mean(grid.cv_results_['mean_fit_time']) + np.mean(grid.cv_results_['mean_score_time']):.3f}")print("RandomizedSearchCV ajustes:", len(rand.cv_results_["params"]),"| tiempo medio por ajuste (s):",f"{np.mean(rand.cv_results_['mean_fit_time']) + np.mean(rand.cv_results_['mean_score_time']):.3f}")print("El protocolo declara el tope ANTES. El reloj solo verifica.")
GridSearchCV  ajustes: 5 | tiempo medio por ajuste (s): 0.022
RandomizedSearchCV ajustes: 6 | tiempo medio por ajuste (s): 0.021
El protocolo declara el tope ANTES. El reloj solo verifica.
14e) Lo que un notebook de estudiante suele hacer (y cómo se lee)
Un patrón frecuente, reescrito sin ironía:
train_test_split.
Un for sobre \(C\) que imprime F1 de test.
Se copia el \(C\) “bueno”.
Se entrena otra vez y se reporta el mismo F1.
El paso 4 no es verificación: es cita del máximo. El protocolo de esta sesión cambia el paso 2 (CV en train) y el 4 (una medición nueva, o la única). Si su notebook personal se parece a 1–4, el Monte Carlo de la sección 3 habla de usted, no de un extraño.
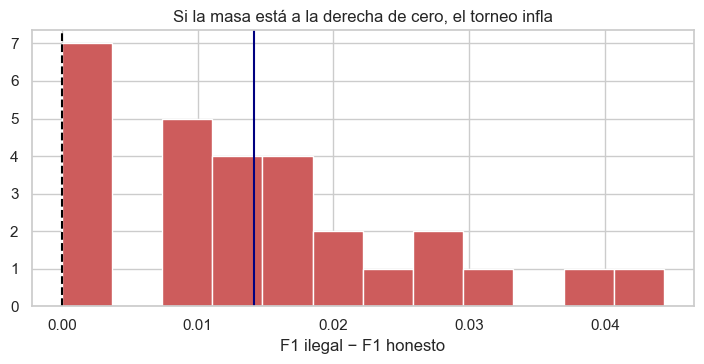
# El corrimiento del Monte Carlo, visto como una sola variable: el delta.delta = mc["f1_ilegal"] - mc["f1_honesto"]fig, ax = plt.subplots(figsize=(7.2, 3.8))ax.hist(delta, bins=12, color="indianred", edgecolor="white")ax.axvline(0, color="black", ls="--")ax.axvline(delta.mean(), color="navy", ls="-")ax.set_xlabel("F1 ilegal − F1 honesto")ax.set_title("Si la masa está a la derecha de cero, el torneo infla")plt.tight_layout()plt.show()print(f"P(delta > 0) = {(delta >0).mean():.2f} | media del delta = {delta.mean():+.3f}")
P(delta > 0) = 0.75 | media del delta = +0.014
Esa proporción \(P(\Delta>0)\) es el argumento para el pasillo del laboratorio: no “a veces pasa”. Si sale alta, el método ilegal es un generador de cifras hinchadas. Si en esta corrida saliera cercana a 0.5, no refute el teorema: aumente \(m\) o \(n_{\mathrm{rep}}\) en el taller.
14g) Reproducibilidad de la búsqueda
GridSearchCV con cv que ya tiene random_state debe devolver el mismo best_params_ si los datos no cambian. Si no, el protocolo tiene una fuente de azar no declarada (otro hilo, otro solver, un fold sin semilla).
# Dos grillas idénticas: el ganador tiene que coincidir.g1 = GridSearchCV(pipeline_base, espacio_grilla, cv=cv, scoring="f1", n_jobs=1)g2 = GridSearchCV(pipeline_base, espacio_grilla, cv=cv, scoring="f1", n_jobs=1)g1.fit(X_train, y_train)g2.fit(X_train, y_train)print("best_params_ 1:", g1.best_params_)print("best_params_ 2:", g2.best_params_)print("¿Coinciden?:", g1.best_params_ == g2.best_params_)print("¿best_score_ idéntico?:", np.isclose(g1.best_score_, g2.best_score_))
Si \(n\) es pequeño (unas decenas de positivos), cada fold tiene muy pocos casos de la clase 1 y el F1 de CV es un dado. Añadir una grilla de veinte \(C\) solo elige el dado más alto. En ese régimen, un modelo simple con \(C\) por defecto y un test honesto es más científico que una búsqueda teatral. La automatización no es un rito: es un instrumento con hipótesis de muestra.
14f) Una nota formal para quien quiera el teorema
Sea \(m\) el número de hipótesis evaluadas sobre el mismo test de \(n\) filas. Bajo hipótesis de independencia aproximada, la esperanza del mínimo riesgo empírico (o del máximo F1) se aleja del riesgo típico de una hipótesis fija a una tasa del orden de \(\sqrt{(\log m)/n}\). Más candidatos o un test más chico \(\Rightarrow\) más maleficio. Por eso “probar todo en test” empeora al crecer el curso: el estudiante se vuelve más creativo (\(m\) sube) y el test del homework sigue siendo pequeño.
Esa es la razón por la que la automatización sin frontera es más peligrosa que el trabajo lento: aumenta \(m\).
15) Errores frecuentes
Probar treinta \(C\) en test y reportar el máximo (diálogo del 0.91).
Escalar o imputar antes del CV.
Optimizar accuracy en un problema desbalanceado y sorprenderse del recall nulo.
Tomar best_score_ como si no fuera ya un máximo sobre \(m\) candidatos.
Reabrir la grilla porque el test “salió bajo”.
Comparar logística y árbol en test y llamar a eso “experimento”.
Guardar solo el clasificador (sesión 5) después de una búsqueda cara.
Confundir esta sesión con orquestar un DAG (sesión 7) o con un registry (sesión 8).
16) Checklist del protocolo
¿El test se apartó antes de la primera búsqueda?
¿La métrica se declaró antes de ver números?
¿El objeto que entra al CV es un pipeline?
¿El presupuesto (grilla o n_iter) está escrito?
¿El F1 de test se calculó una vez, sobre el ganador?
¿La ficha distingue CV del ganador, CV anidada y test?
¿Un compañero podría repetir la elección sin preguntarle a usted?
Si (1) o (5) fallan, hay automatización, no hay método.
17) Conclusiones
El enganche de esta sesión no es una librería. Es un hecho empírico que el Monte Carlo hace visible: el mejor de muchos exámenes no es una estimación. Automatizar el entrenamiento es convertir la elección de \(f\) en un protocolo:
dos preguntas (estimar / maximizar) que no comparten conjunto;
un test ciego;
un CV que estima dentro del train, con \(T\) ajustada en cada fold;
una métrica declarada;
una búsqueda con presupuesto;
una cifra de test que no se reutiliza;
un artefacto que conserva \(T\) y \(f\).
La sesión 7 tomará este protocolo y lo convertirá en un paso de un grafo: extraer, transformar, entrenar, persistir. El entrenamiento deja de ser “las celdas de la tarde” y pasa a ser un nodo con entradas, salidas y vecinos.
18) Taller práctico
Trabaje sobre X_train, X_test y el pipeline base. El valor no está en un F1 más alto: está en no repetir el diálogo del 0.91.
A. Maleficio casero. Recorte Cs a 8 valores. Reproduzca el torneo ilegal y el honesto. ¿El delta tiene el mismo signo que en la sección 2?
B. Métrica. Repita GridSearchCV con scoring="accuracy" y con scoring="f1". ¿Gana el mismo \(C\)? Interprete con la tabla del dummy.
C. Dummy. Incluya DummyClassifier(strategy="stratified") en la tabla de familias. Si gana en accuracy y pierde en F1, ¿qué habría pasado si la grilla usaba accuracy?
D. Anidada. Cambie el loop externo a 5 folds (más caro). ¿Se acerca o se aleja de best_score_?
E. Umbral. Sobre el ganador ya elegido, busque un umbral en una validación interna (no en test) que maximice F1. Mida ese umbral en test una vez. Documente ambos números.
Cómo citar el resultado en un informe. Una frase correcta: “Se reservó 25 % de test. Se eligió \(C\) por F1 en un StratifiedKFold de 5 folds. El F1 de CV del ganador fue \(a\); el de un esquema anidado, \(b\); el de test (una medición), \(c\).” Una frase incorrecta: “El mejor modelo dio 0.91.”
# Espacio de taller. X, y, X_train, pipeline_base, cv y RUTA siguen vivos.print("Train:", X_train.shape, "| Test reservado:", X_test.shape)print("Artefactos:", sorted(p.name for p in RUTA.iterdir()))print("Resuelva A–E. Si mira el test para 'ajustar un poco más', vuelva a la sección 2.")
Train: (390, 3) | Test reservado: (130, 3)
Artefactos: ['mejor_pipeline.joblib']
Resuelva A–E. Si mira el test para 'ajustar un poco más', vuelva a la sección 2.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.