Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo III — Automatización y orquestación
La sesión 6 eligió un ganador dentro de una corrida. La sesión 7 ejecutó un flujo. Falta la pregunta de la semana siguiente: ¿esta corrida es la misma que la del martes? ¿Usó los mismos datos? ¿El F1 del chat corresponde a este.joblib?
Este artículo trata datos, procedimiento y artefactos como objetos versionables. No instalamos MLflow. Construimos el esqueleto que MLflow automatiza: hash del dataset, registro por corrida, tabla comparativa y un registry con etapas staging y production.
Objetivos de aprendizaje
Explicar por qué versionar solo el código no basta.
Identificar un dataset con un hash estable.
Registrar varias corridas (métricas, hiperparámetros, artefacto).
Comparar corridas con el mismo identificador de datos.
Promover una corrida a un registry conceptual con criterio escrito.
Qué no cubre esta sesión
Orquestar el DAG (sesión 7): aquí registramos el resultado.
Servir el modelo por HTTP (sesión 9).
CI/CD (sesión 11).
Ruta de trabajo
El experimento como triple.
Hash de datos.
Registro de corridas.
Comparación y linaje.
Registry y promoción.
Taller.
# Entorno: hashes, runs y registry en carpetas.import hashlibimport jsonimport shutilfrom pathlib import Pathimport joblibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import f1_scorefrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.tree import DecisionTreeClassifiernp.random.seed(42)ROOT_ART = Path("artefactos_sesion8")RUNS = ROOT_ART /"runs"REG = ROOT_ART /"registry"for p in (RUNS, REG /"staging", REG /"production"): p.mkdir(parents=True, exist_ok=True)print("Entorno listo.")print("runs/ guarda corridas. registry/ guarda *punteros* a un ganador.")
Entorno listo.
runs/ guarda corridas. registry/ guarda *punteros* a un ganador.
1) El experimento no es el notebook
En una frase: un experimento de ML queda determinado por datos + procedimiento + azar declarado; si alguno cambia sin nombre, la métrica deja de ser comparable.
Git versiona el código. Eso es necesario y no es suficiente. El mismo notebook con un CSV sobrescrito es otro experimento. El mismo CSV con otra semilla, también. Sin identificadores, “el modelo bueno” es una frase, no un puntero.
Tres versiones que hay que poder nombrar
Qué
Por qué cambia el resultado
Identificador mínimo
Datos
Filas nuevas, columnas, filtros
Hash del archivo o de la consulta
Procedimiento
Pipeline, \(C\), semilla, métrica
JSON de la corrida
Artefacto
El .joblib concreto
Nombre + etapa en el registry
MLflow, DVC o W&B automatizan esto. El concepto cabe en carpetas y hashes. Quien no entiende el concepto usa la herramienta como álbum de capturas.
2) Versionar datos: el hash como nombre honesto
En una frase: un hash del contenido responde “¿es este archivo?”, no “¿se llama igual?”.
datos.csv es un nombre sociable y mentiroso. SHA-256 del contenido es tosco y suficiente: si una fila cambia, el hash cambia. En equipos reales se versionan consultas (SQL, fecha de corte) o se usa DVC. El hábito es el mismo: la métrica viaja con el identificador de los datos.
# Hash estable del contenido, no del nombre.def hash_archivo(ruta: Path) ->str: h = hashlib.sha256() h.update(ruta.read_bytes())return h.hexdigest()[:12]def fabricar(n, semilla, nombre): rng = np.random.default_rng(semilla) x = rng.normal(0, 1, n) z = rng.normal(0, 1, n) y = (rng.random(n) <1/ (1+ np.exp(-(1.1* x +0.4* z)))).astype(int) df = pd.DataFrame({"x": x, "z": z, "y": y}) ruta = ROOT_ART / nombre df.to_csv(ruta, index=False)return rutap1 = fabricar(400, 1, "datos_v1.csv")p2 = fabricar(400, 2, "datos_v2.csv")p1b = fabricar(400, 1, "datos_v1_copia.csv")print("v1 ", hash_archivo(p1))print("v1 copia", hash_archivo(p1b), "← mismo contenido, otro nombre")print("v2 ", hash_archivo(p2), "← otro contenido")print("¿v1 == v1_copia?:", hash_archivo(p1) == hash_archivo(p1b))print("¿v1 == v2?: ", hash_archivo(p1) == hash_archivo(p2))
v1       d9200b4ce0e4
v1 copia d9200b4ce0e4 ← mismo contenido, otro nombre
v2       d15c3bb9703c ← otro contenido
¿v1 == v1_copia?: True
¿v1 == v2?:       False
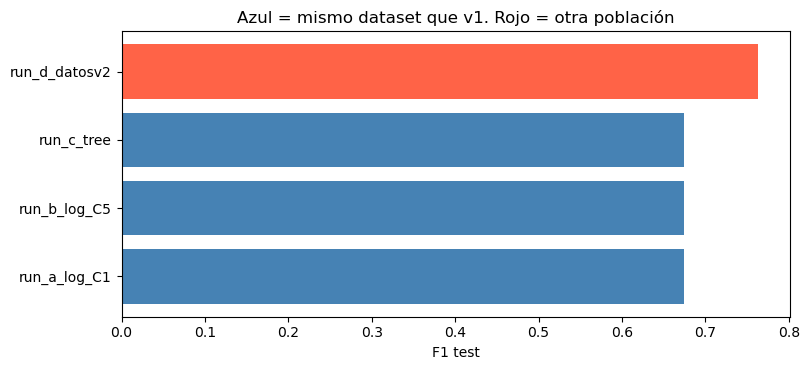
Lectura. Comparar el F1 de v1 y v2 sin el hash es comparar dos exámenes. El nombre datos.csv habría mentido en los tres casos.
3) Registrar una corrida
Una corrida es un directorio con: meta.json, modelo.joblib y, si aplica, el hash de datos. El run_id es el nombre. No se reutiliza.
# Barras: el color avisa si el hash coincide.fig, ax = plt.subplots(figsize=(8.2, 3.8))colores = np.where(tablero["data_hash"] == hash_v1, "steelblue", "tomato")ax.barh(tablero["run_id"], tablero["f1_test"], color=colores)ax.set_xlabel("F1 test")ax.set_title("Azul = mismo dataset que v1. Rojo = otra población")plt.tight_layout()plt.show()
5) Linaje: quién nació de qué
El linaje es la cadena datos(hash) → procedimiento → artefacto. Si se pierde el eslabón, el .joblib es un objeto huérfano: se puede predecir, no se puede defender ante un auditor.
La diferencia de F1 no es automáticamente “mejor modelo”. En test chicos, 0.03 puede ser ruido. Esta sesión no hace un test de McNemar completo; sí obliga a no promover por un delta minúsculo sin criterio.
# Delta entre logística C=1 y C=5, mismo hash.fa, fb = m_a["f1_test"], m_b["f1_test"]print(f"run_a F1={fa:.3f} | run_b F1={fb:.3f} | delta={fb-fa:+.3f}")print("Criterio didáctico de promoción: delta >= 0.02 Y mismo data_hash.")print("¿b supera a a?:", (fb - fa) >=0.02)
run_a F1=0.674 | run_b F1=0.674 | delta=+0.000
Criterio didáctico de promoción: delta >= 0.02 Y mismo data_hash.
¿b supera a a?: False
7) Semilla: el tercer eje del triple
Dos corridas con mismos datos y mismo \(C\) pero distinta semilla son experimentos distintos. Si el F1 se mueve mucho, el protocolo (sesión 6) era ruidoso, no “el modelo es inestable por magia”.
# Misma v1, mismo C, otra semilla.m_e = registrar("run_e_seed99", p1, C=1.0, seed=99)print("seed 42:", m_a["f1_test"], "seed 99:", m_e["f1_test"])print("delta por semilla:", f"{m_e['f1_test'] - m_a['f1_test']:+.3f}")
seed 42: 0.6744186046511628 seed 99: 0.6521739130434783
delta por semilla: -0.022
8) El registry no es una carpeta de descargas
staging y production no guardan “el último archivo que alguien copió”. Guardan una promoción: un run_id que cumplió un criterio, con copia del artefacto y un promocion.json que cita el hash.
# Promoción explícita.def promover(run_id, etapa, criterio): src = RUNS / run_id dest = REG / etapa dest.mkdir(parents=True, exist_ok=True) shutil.copy2(src /"modelo.joblib", dest /"modelo.joblib") shutil.copy2(src /"meta.json", dest /"origen.json") promo = {"etapa": etapa,"run_id": run_id,"criterio": criterio,"data_hash": json.loads((src /"meta.json").read_text(encoding="utf-8"))["data_hash"], } (dest /"promocion.json").write_text(json.dumps(promo, indent=2), encoding="utf-8")return promoganador = mismo.iloc[0]["run_id"]print(promover(ganador, "staging", "mejor F1 entre corridas del hash v1"))
{'etapa': 'staging', 'run_id': 'run_a_log_C1', 'criterio': 'mejor F1 entre corridas del hash v1', 'data_hash': 'd9200b4ce0e4'}
Staging no es producción. Es el lugar donde un revisor (o un test de la sesión 11) mira el artefacto antes de que un servicio lo cargue. Promover a production es un segundo acto, no un rename.
# Segunda promoción, con criterio más estricto.print(promover(ganador, "production", "aprobado para el servicio (sesión 9)"))print("production/origen.json:")print((REG /"production"/"origen.json").read_text(encoding="utf-8"))
Si cualquiera puede copiar un .joblib a production/, el registry es teatro. El criterio de esta sesión es deliberadamente simple (mejor F1 del hash). En la vida real se añade: no peor recall que el actual, mismo esquema de columnas, test de humo del servicio.
# ¿Qué hay en cada etapa?for etapa in ("staging", "production"):print("===", etapa, "===")for p insorted((REG / etapa).iterdir()):print(" ", p.name, p.stat().st_size, "bytes")
10) Reproducir una corrida es copiar su meta, no su F1
Dado meta.json, deberíamos poder reentrenar y acercarnos a la métrica (en este sintético, reproducirla). Si no se puede, el registro mentía: faltó semilla, librería o hash.
# Reentrenamiento a partir de la ficha, sin mirar el joblib.meta_a = json.loads((RUNS /"run_a_log_C1"/"meta.json").read_text(encoding="utf-8"))df_a = pd.read_csv(ROOT_ART / meta_a["data_file"])_, f1_rep = entrenar(df_a, C=meta_a["C_o_depth"], seed=meta_a["seed"], modelo=meta_a["modelo"])print("F1 registrado:", meta_a["f1_test"])print("F1 reproducido:", f1_rep)print("¿Cerca?:", abs(f1_rep - meta_a["f1_test"]) <1e-12)
F1 registrado: 0.6744186046511628
F1 reproducido: 0.6744186046511628
¿Cerca?: True
11) Inmutabilidad: un run no se edita, se crea otro
Si “corriges” el meta.json de run_a porque el F1 “estaba mal”, rompiste la auditoría. El hábito correcto: run_a2 con el procedimiento corregido. Los registries serios tratan los runs como apéndices, no como celdas de Excel.
12) Código y datos: dos relojes
Git etiqueta el procedimiento. El hash etiqueta los datos. Un commit nuevo con el mismo hash es otro procedimiento sobre el mismo examen. Un mismo commit con otro hash es el mismo procedimiento sobre otro examen. El F1 no se interpreta sin ambos relojes.
# Relojes de esta sesión (didácticos).print("hash v1:", hash_v1)print("hash v2:", hash_archivo(p2))print("runs sobre v1:", list(tablero.loc[tablero["data_hash"]==hash_v1, "run_id"]))print("runs sobre v2:", list(tablero.loc[tablero["data_hash"]==hash_archivo(p2), "run_id"]))
hash v1: d9200b4ce0e4
hash v2: d15c3bb9703c
runs sobre v1: ['run_a_log_C1', 'run_b_log_C5', 'run_c_tree']
runs sobre v2: ['run_d_datosv2']
13) Lo que MLflow añade (y lo que no sustituye)
MLflow Tracking escribe estos JSON automáticamente. Model Registry nombra etapas. El concepto es esta carpeta. Si un equipo instala MLflow y sigue comparando F1 de datasets distintos, la herramienta no los salvó.
14) Relación con 6, 7 y 9
Sesión 6: el F1 de test de cada run debe ser una medición, no un torneo.
Sesión 7: el DAG produce el run (nodo persistir escribe aquí).
Sesión 9: el servicio carga registry/production/modelo.joblib, no “el último experimento del viernes”.
14b) Un contraejemplo: el F1 huérfano
# Un joblib sin meta: se puede predecir, no se puede defender.huerfano = ROOT_ART /"modelo_sin_ficha.joblib"joblib.dump(joblib.load(RUNS /"run_a_log_C1"/"modelo.joblib"), huerfano)print("Existe:", huerfano.exists(), "| ¿tiene meta?:", (ROOT_ART /"meta.json").exists())print("Pregunta de auditoría: ¿con qué datos se entrenó? Respuesta: no está.")
Existe: True | ¿tiene meta?: False
Pregunta de auditoría: ¿con qué datos se entrenó? Respuesta: no está.
14c) Tamaño y fecha no son identidad
Dos archivos pueden pesar igual y no ser el mismo. El hash no se sustituye por st_size ni por la fecha de modificación (esa cambia al copiar).
print("v1 bytes:", p1.stat().st_size, "v2 bytes:", p2.stat().st_size)print("Mismo tamaño no implica mismo hash:", p1.stat().st_size == p2.stat().st_size)
v1 bytes: 16960 v2 bytes: 16910
Mismo tamaño no implica mismo hash: False
14d) Tabla final de decisión
# ¿Qué se promovería hoy, con el criterio escrito?decision = mismo.copy()decision["promovible"] = decision["run_id"] == ganadorprint(decision[["run_id", "modelo", "C_o_depth", "f1_test", "promovible"]].to_string(index=False))
production/latest.joblib se mueve sin que el cliente lo sepa. Un alias solo es honesto si apunta a un run_id inmutable y el alias queda en el promocion.json.
# Alias como puntero, no como archivo suelto.alias = {"latest": ganador, "hash": hash_v1}(REG /"production"/"alias.json").write_text(json.dumps(alias, indent=2), encoding="utf-8")print(json.dumps(alias, indent=2))
# Qué cambió entre run_a y run_c: modelo y palanca, no los datos.print("mismos datos?:", m_a["data_hash"] == m_c["data_hash"])print("mismo modelo?:", m_a["modelo"] == m_c["modelo"])print("misma palanca?:", m_a["C_o_depth"] == m_c["C_o_depth"])
mismos datos?: True
mismo modelo?: False
misma palanca?: False
14g) Un run por cada palanca, no un Excel de 40 columnas
Meter 15 \(C\) en un solo meta.json es volver al diálogo del 0.91 y además versionarlo. El registry guarda ganadores de protocolos, no tableros de pesca.
# Intento ilegal: promover v2 como si fuera v1.hash_prod = json.loads((REG /"production"/"promocion.json").read_text(encoding="utf-8"))["data_hash"]print("hash en production:", hash_prod)print("hash de run_d :", m_d["data_hash"])print("¿Se permite?:", m_d["data_hash"] == hash_prod)
hash en production: d9200b4ce0e4
hash de run_d     : d15c3bb9703c
¿Se permite?: False
14j) Timeline didáctico
# Orden de aparición de runs (nombre = historia).print(tablero.sort_values("run_id")[["run_id", "data_hash", "f1_test"]].to_string(index=False))
Cita correcta: run_a_log_C1 | hash=d9200b4ce0e4 | F1=0.674 | seed=42
14l) Limpieza de runs
Borrar runs a mano rompe punteros del registry. Primero se verifica que staging y production no citen ese run_id.
citados = { json.loads((REG/e/"promocion.json").read_text(encoding="utf-8"))["run_id"]for e in ("staging", "production")}print("Runs citados por el registry:", citados)print("Se pueden archivar (no borrar a ciegas):", set(tablero["run_id"]) - citados)
Runs citados por el registry: {'run_a_log_C1'}
Se pueden archivar (no borrar a ciegas): {'run_c_tree', 'run_d_datosv2', 'run_b_log_C5'}
15) Errores frecuentes
Comparar F1 de hashes distintos.
Sobrescribir run_a en lugar de crear run_a2.
Copiar a production/ sin promocion.json.
Versionar solo el notebook y no los datos.
Tratar el tamaño del archivo como hash.
Publicar un F1 de test que fue un torneo (sesión 6) y versionarlo “en serio”.
16) Checklist
¿Cada métrica cita un data_hash?
¿Cada artefacto cita un run_id?
¿Production cita un criterio?
¿Se puede reentrenar desde meta.json?
¿Un extraño distingue v1 de v2 sin preguntarle a usted?
17) Conclusiones
Versionar experimentos es negar la frase “el modelo bueno”. En su lugar hay un triple identificable, un leaderboard dentro de un hash, y un registry que no es un cajón. La sesión 9 cargará, o debería cargar, únicamente lo que production nombra.
18) Taller práctico
A. Cree run_f con \(C=0.2\) sobre v1. ¿Entra al leaderboard honesto?
B. Cambie una sola fila de v1, guárdela como v1_sucia y hashee. ¿Coincide con v1?
C. Intente promover run_d_datosv2 a staging con el criterio “mismo hash que production”. Debe rechazarse.
D. Borre (en una copia) el meta.json de un run y liste lo que un auditor ya no puede responder.
E. Escriba un criterio de promoción que incluya un piso de F1 y el hash de v1. Aplíquelo.
print("Runs:", sorted(p.name for p in RUNS.iterdir()))print("Production:", json.loads((REG/'production'/'promocion.json').read_text(encoding='utf-8')))print("Taller A–E. Si el leaderboard mezcla v1 y v2, vuelva a la sección 4.")
Runs: ['run_a_log_C1', 'run_b_log_C5', 'run_c_tree', 'run_d_datosv2', 'run_e_seed99']
Production: {'etapa': 'production', 'run_id': 'run_a_log_C1', 'criterio': 'aprobado para el servicio (sesión 9)', 'data_hash': 'd9200b4ce0e4'}
Taller A–E. Si el leaderboard mezcla v1 y v2, vuelva a la sección 4.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.