Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo V — Monitoreo, interpretabilidad y comunicación
El CI de la sesión 11 pregunta si el artefacto era válido el día del deploy. No pregunta si lo sigue siendo el jueves. Los datos se mueven. El modelo, inmóvil, decide sobre un mundo que ya no es el del train.
Este artículo enseña a vigilar. Distinguimos data drift (cambió \(X\)), concept drift (cambió \(P(y\mid x)\)) y model drift (cambió el desempeño de \(f\)). Medimos un PSI, recalculamos métricas con etiquetas tardías y leemos una serie semanal. No montamos Prometheus: el concepto cabe en una tabla.
Objetivos
Definir data, concept y model drift sin tratarlos como sinónimos.
Calcular PSI y leer umbrales habituales.
Recalcular F1 sobre un lote “de producción” con etiquetas tardías.
Decidir si reentrenar, esperar o apagar, con evidencia temporal.
Qué no cubre
Explicar una predicción individual (sesión 13).
El reporte para negocio (sesión 14).
Ruta
Producción no es un examen estático.
Tres drifts.
Laboratorio: referencia vs producción.
PSI y visualizaciones.
Etiquetas tardías y serie de F1.
Alertas.
Taller.
# Un modelo FIJO y varias ventanas de mundo.import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import f1_score, precision_score, recall_scorefrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalernp.random.seed(42)print("Entorno listo. El modelo no se reentrena en esta sesión: se vigila.")
Entorno listo. El modelo no se reentrena en esta sesión: se vigila.
1) Producción no es un examen estático
En una frase: un modelo en producción es una hipótesis sobre un mundo que sigue generando datos.
El test de la sesión 6 es una foto. Si el negocio lanza un producto, llega una temporada o cambia el etiquetado, la foto envejece. El síntoma no siempre es un crash: a menudo es un F1 que nadie mira.
Observabilidad es poder responder sin reabrir el notebook de train:
¿Qué datos están entrando (volumen, nulos, rangos)?
¿Se parecen a los del train?
Cuando llegan etiquetas (tarde), ¿el desempeño se sostiene?
2) Tres palabras que no son la misma
Nombre
Qué cambió
Se ve sin \(y\)
Acción típica
Data / covariate drift
\(P(x)\)
Sí (PSI, KS)
Revisar captura; quizá reentrenar
Concept drift
\(P(y\mid x)\)
No (hace falta \(y\))
Reentrenar o rediseñar \(T\)
Model / performance drift
las métricas de \(f\)
Solo con \(y\) (tardía)
Gate, rollback, reentrenar
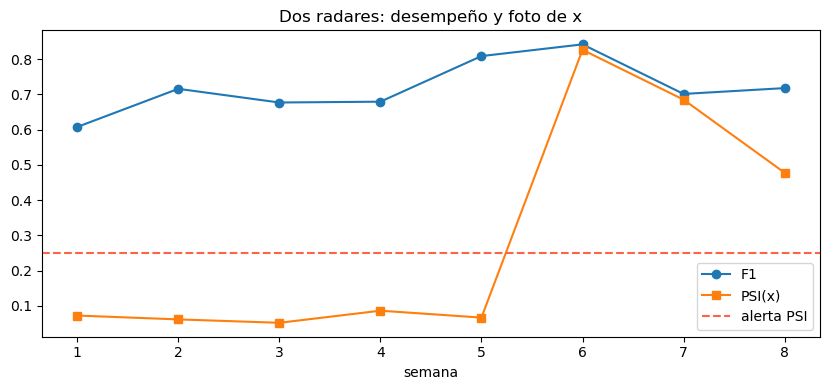
Un PSI alto con F1 estable puede ser un cambio de mix que el modelo aún soporta. Un F1 caído con PSI bajo sugiere concept drift: el mundo cambió la regla, no la foto de \(x\).
3) Laboratorio: un modelo entrenado en el ‘pasado’
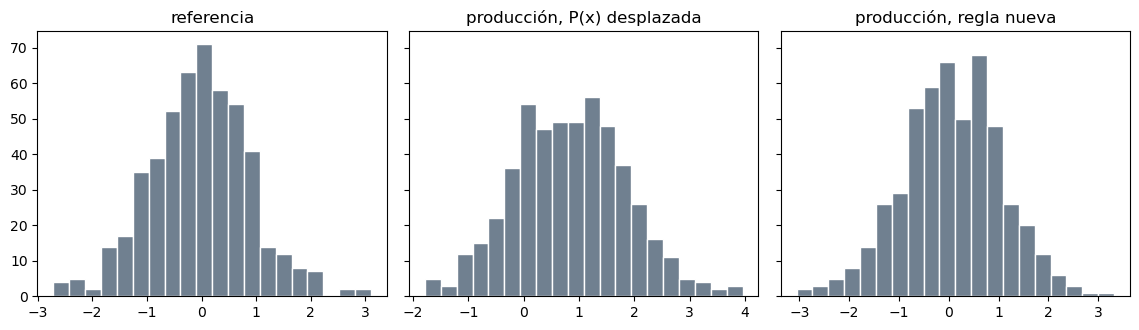
def fabricar(n, semilla, corrimiento_x=0.0, corrimiento_regla=0.0): rng = np.random.default_rng(semilla) x = rng.normal(corrimiento_x, 1.0, n) logit =-0.2+1.4* x + corrimiento_regla y = (rng.random(n) <1/ (1+ np.exp(-logit))).astype(int)return pd.DataFrame({"x": x, "y": y})ref = fabricar(500, 1, 0.0, 0.0)prod_x = fabricar(500, 2, 0.9, 0.0) # solo cambió P(x)prod_concepto = fabricar(500, 3, 0.0, -1.2) # cambió P(y|x)pipe = Pipeline([("sc", StandardScaler()), ("clf", LogisticRegression(max_iter=300))])pipe.fit(ref[["x"]], ref["y"])print("Referencia: media x =", f"{ref['x'].mean():.3f}", "| tasa y =", f"{ref['y'].mean():.3f}")print("Prod (P(x)) : media x =", f"{prod_x['x'].mean():.3f}", "| tasa y =", f"{prod_x['y'].mean():.3f}")print("Prod (regla): media x =", f"{prod_concepto['x'].mean():.3f}", "| tasa y =", f"{prod_concepto['y'].mean():.3f}")
Referencia: media x = -0.036 | tasa y = 0.428
Prod (P(x)) : media x = 0.847 | tasa y = 0.658
Prod (regla): media x = 0.055 | tasa y = 0.282
El modelo no ve las etiquetas de producción al predecir. Nosotros sí las usaremos después, como quien recibe el fraude confirmado dos semanas tarde.
4) PSI: una distancia entre histogramas
El Population Stability Index compara fracciones \(p_i\) (referencia) y \(q_i\) (actual) en \(k\) bins:
[ = _i (q_i - p_i),. ]
Regla de bolsillo (no es ley): \(<0.10\) estable; \(0.10\)–\(0.25\) vigilar; \(>0.25\) alerta. El PSI no dice si el modelo está mal: dice si \(x\) ya no es la misma foto.
def psi(a, b, bins=8): cortes = np.quantile(a, np.linspace(0, 1, bins +1)) cortes[0], cortes[-1] =-np.inf, np.inf p, _ = np.histogram(a, bins=cortes) q, _ = np.histogram(b, bins=cortes) p = np.clip(p /max(p.sum(), 1), 1e-6, None) q = np.clip(q /max(q.sum(), 1), 1e-6, None)returnfloat(np.sum((q - p) * np.log(q / p)))print(f"PSI referencia vs sí misma : {psi(ref['x'], ref['x']):.3f}")print(f"PSI referencia vs prod (P(x)) : {psi(ref['x'], prod_x['x']):.3f}")print(f"PSI referencia vs prod (regla) : {psi(ref['x'], prod_concepto['x']):.3f}")
PSI referencia vs sí misma     : 0.000
PSI referencia vs prod (P(x))  : 0.842
PSI referencia vs prod (regla) : 0.040
Si el tercer PSI es bajo y el F1 de esa ventana cae, estamos ante concept drift: el radar de \(x\) no basta.
Lectura. Compare las columnas psi_x y f1. El patrón didáctico buscado: covariate → PSI alto; concepto → PSI bajo y F1 peor. Si en esta semilla no sale nítido, el principio sigue: un solo radar no basta.
6) Serie temporal: el jueves contra el lunes
# Ocho semanas: las últimas tres desplazan x; las dos finales cambian la regla.semanas = []for w inrange(8): dx =0.0if w <5else0.7 dr =0.0if w <6else-1.0 lote = fabricar(220, 10+ w, dx, dr) m = metricas(f"s{w+1}", lote) m["semana"] = w +1 semanas.append(m)serie = pd.DataFrame(semanas)print(serie.round(3).to_string(index=False))
Una alerta no es “el gráfico se ve raro”. Es un predicado: PSI > 0.25 o F1 < f1_ref - 0.10. Se versiona como el gate de la sesión 11. Rebajarlo porque sonó el pager es, otra vez, pesca.
8) Volumen y nulos: el drift silencioso de captura
Antes del PSI, se vigila si el dato llegó. Una semana con 12 filas o con 40 % de nulos no se compara en F1: se compara en calidad (sesiones 3 y 3a). Tratarla como drift de concepto es un error de diagnóstico.
calidad = pd.DataFrame({"semana": serie["semana"],"n": 220,"nulos_x": 0,"valido_para_psi": True,})print(calidad.to_string(index=False))print("Si nulos_x > 0.05, se abre un ticket de captura, no de reentrenamiento.")
 semana   n  nulos_x  valido_para_psi
      1 220        0             True
      2 220        0             True
      3 220        0             True
      4 220        0             True
      5 220        0             True
      6 220        0             True
      7 220        0             True
      8 220        0             True
Si nulos_x > 0.05, se abre un ticket de captura, no de reentrenamiento.
9) Predicción drift: cambió el output sin etiquetas
Aun sin \(y\), se puede vigilar \(P(\hat{y}=1)\) o la media de scores. Un salto de scores no prueba concept drift; es un proxy. Sirve para despertar. No sirve para promover.
No. Reentrenar con datos ya corridos sin entender la captura puede hornear el error. El árbol de decisión (humano):
¿Calidad de captura OK? Si no, sesión 3.
¿PSI alto y F1 sostenido? Vigilar.
¿F1 bajo? Rollback (sesión 11) y job de train (sesión 6) con hash nuevo (sesión 8).
11) Etiqueta tardía: el lote de ‘esta semana’ aún no tiene \(y\)
En fraude o crédito, \(y\) llega días o meses después. El F1 de la serie asume que ya llegó. Un tablero honesto marca las semanas abiertas (solo PSI y tasa de \(\hat{y}\)) frente a las cerradas (F1). Mezclarlas es mentir con un eje temporal.
serie["cerrada"] = serie["semana"] <=6print(serie[["semana", "cerrada", "f1", "psi_x"]].to_string(index=False))print("Las semanas abiertas no se usan para el gate de F1.")
 semana  cerrada       f1    psi_x
      1     True 0.607595 0.072907
      2     True 0.715686 0.061978
      3     True 0.676923 0.052336
      4     True 0.679245 0.086659
      5     True 0.808511 0.067075
      6     True 0.841751 0.826314
      7    False 0.701195 0.685013
      8    False 0.717742 0.477763
Las semanas abiertas no se usan para el gate de F1.
12) Relación con 11 y 13
11 certifica el nacimiento del artefacto. 12 certifica su vejez. 13 explica un caso cuando alguien pregunta por qué se negó el crédito esta semana —quizá ya en drift.
14b) KS como radar complementario
def ks(a, b): grid = np.sort(np.r_[a, b]) Fa = np.searchsorted(np.sort(a), grid, side="right") /len(a) Fb = np.searchsorted(np.sort(b), grid, side="right") /len(b)returnfloat(np.max(np.abs(Fa - Fb)))print(f"KS covariate: {ks(ref['x'].to_numpy(), prod_x['x'].to_numpy()):.3f}")print(f"KS concepto : {ks(ref['x'].to_numpy(), prod_concepto['x'].to_numpy()):.3f}")print("KS y PSI no se sustituyen: se contrastan.")
KS covariate: 0.364
KS concepto : 0.086
KS y PSI no se sustituyen: se contrastan.
14c) Ventana de referencia: no mezclar train sucio
La referencia del PSI debe ser el mismo hash de la sesión 8, no “un CSV que teníamos”. Si la referencia se actualiza en silencio, el PSI se autoengaña: todo parece estable porque se midió contra ayer, no contra el train del modelo.
14d) Una frase de examen
“PSI alto no autoriza a reentrenar; F1 bajo no se ve sin etiquetas; las etiquetas no llegan el martes.”
14e) PSI por variable, no un único número mágico
Con diez numéricas hay diez PSI. Alertar por el máximo sin mirar cuál variable se movió produce pánicos de ruido. Se reporta el vector y se nombra al culpable.
# Dos variables: x se mueve, z no.z_ref = np.random.default_rng(0).normal(size=500)z_prod = np.random.default_rng(1).normal(size=500)print(f"PSI x (covariate): {psi(ref['x'], prod_x['x']):.3f}")print(f"PSI z (control) : {psi(z_ref, z_prod):.3f}")
PSI x (covariate): 0.842
PSI z (control)  : 0.048
14f) Estacionalidad no es drift
Un pico de ventas en diciembre mueve \(P(x)\)todos los años. El radar debe comparar contra el diciembre anterior, no contra julio. Un PSI alto contra la referencia de verano puede ser el calendario, no una avería.
14g) Feedback loop
Si el modelo niega crédito y por eso no hay \(y\) de esos clientes, el lote cerrado se sesga hacia los aprobados. El F1 ‘estable’ puede ser un espejo. Se documenta el censurado de etiquetas.
14h) Shadow mode
El challenger predice en paralelo sin decidir. Se acumula PSI y, cuando hay \(y\), F1. Es monitoreo antes del CD, no un reemplazo del semáforo.
14i) Champion–challenger en la serie
Dos curvas de F1, mismo eje temporal. Cruzarse no autoriza a promover: autoriza a abrir el protocolo de la sesión 6 sobre el hash nuevo.
# Challenger ficticio: un poco mejor al final, no se promociona aquí.serie["f1_challenger"] = np.clip(serie["f1"] + np.linspace(-0.02, 0.06, len(serie)), 0, 1)print(serie[["semana", "f1", "f1_challenger"]].round(3).to_string(index=False))
política didáctica: cerrada ⇔ semana <= 6
en un banco: cerrada ⇔ fecha_y <= hoy - 18 días
14k) Múltiples tests, un pager
Diez PSI y un KS no se leen como diez alertas independientes sin controlar el error familiar. Se prioriza: primero calidad, luego el PSI de las variables de señal, luego F1 cerrado.
14l) Volumen bajo: el F1 es un dado
Una semana de 30 positivos no sostiene un delta de 0.04. El semáforo debería apagarse por n insuficiente (ámbar de muestra), no ponerse rojo de desempeño.
print("regla: si n_positivos_cerrados < 50, estado='ámbar-muestra', no se compara F1")
regla: si n_positivos_cerrados < 50, estado='ámbar-muestra', no se compara F1
14m) Histéresis: no parpadear el semáforo
Un PSI de 0.21 un día y 0.19 al siguiente no justifica rojo–verde–rojo. Se entra en rojo si el umbral se cruza k ventanas seguidas; se sale solo si baja a un umbral menor (histéresis). El pager deja de ser ruido.
print("entrar_rojo: psi>=0.25 durante 3 ventanas; salir_rojo: psi<0.15 durante 2")
entrar_rojo: psi>=0.25 durante 3 ventanas; salir_rojo: psi<0.15 durante 2
15) Errores frecuentes
Llamar drift a un corte de captura.
Reentrenar ante todo PSI > 0.1.
Calcular F1 en semanas abiertas.
Usar como referencia el lote de ayer.
Confundir tasa de \(\hat{y}\) con desempeño.
16) Checklist
¿Hay referencia hasheada?
¿Hay umbral de PSI y de F1 escritos?
¿Se distingue semana abierta/cerrada?
¿Hay diagnóstico de nulos antes del PSI?
¿La acción (vigilar / rollback / train) está atada a un patrón, no a un presentimiento?
17) Conclusiones
Vigilar es contrastar un artefacto inmóvil con un mundo que no lo es. Tres radares (foto de \(x\), proxy de \(\hat{y}\), F1 tardío) evitan el diagnóstico único. La sesión 13 abre un caso; la 14 traduce esta serie a una decisión de presupuesto.
18) Taller
A. Calcule PSI con 4 bins y con 12. ¿Cambia la alerta?
B. Invente una semana con 40 % de nulos. ¿La marca como inválida?
C. Separe en la serie las alertas que serían solo PSI de las que serían solo F1.
D. Escriba la regla de rollback en una línea.
E. ¿Qué hash de la sesión 8 usaría como referencia y por qué?
print(serie.round(3).to_string(index=False))print("Taller A–E. Si reentrena porque el histograma 'se ve distinto', vuelva a la sección 10.")
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.