Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo V — Monitoreo, interpretabilidad y comunicación
La sesión 12 dice que el modelo se degradó. Un regulador pregunta por qué se le negó el crédito a esta persona. “El F1 era 0.71” no es una respuesta.
Este artículo abre la decisión: importancia global, contribución local (la idea de SHAP) y el riesgo de que el atajo estadístico reproduzca un sesgo. No instalamos shap. Para un lineal, Shapley tiene forma cerrada: \(\varphi_i = \beta_i(x_i-\mathbb{E}[x_i])\). Esa fórmula es SHAP en este laboratorio.
Objetivos
Distinguir explicación global y local, y no confundirlas con causalidad.
Leer importancias de un bosque y contrastarlas con permutación.
Calcular contribuciones aditivas en un lineal y dibujar un caso.
Medir un disparidad simple entre grupos y documentar gobernanza.
Qué no cubre
El dashboard de decisión (sesión 14).
Buscar el mejor bosque (sesión 6).
Ruta
Transparencia como gobernanza.
Dataset con un atributo sensible.
Bosque: impureza vs permutación.
Lineal: SHAP cerrado y waterfall.
Equidad mínima.
Model card.
Taller.
# Bosque para lo global, lineal para lo local. Sin .to_numpy() frágil.import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.inspection import permutation_importancefrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalernp.random.seed(42)print("Entorno listo.")
Entorno listo.
1) Transparencia no es imprimir el predict
En una frase: un sistema es interpretable si un humano puede responder, con evidencia, qué factores pesaron —en general y, cuando importa, en este caso.
Escala
Pregunta
Herramienta
Global
¿En qué variables se apoya el modelo?
Impureza / permutación
Local
¿Por qué esta fila salió positiva?
SHAP lineal
Interpretar no es causalidad. Que ingreso importe no prueba que “subir el ingreso cause aprobación”. Prueba que el modelo usa esa variable.
La transparencia es gobernanza, no un extra de color. Si la decisión toca crédito, salud o empleo, alguien debe poder auditar. “Son 400 árboles” no es una política.
2) Laboratorio: señal, ruido y un atributo sensible
rng = np.random.default_rng(42)n =700ingreso = rng.normal(0, 1, n)visitas = rng.normal(0, 1, n)ruido = rng.normal(0, 1, n)grupo = rng.integers(0, 2, n) # atributo sensible sintético (0/1)# La etiqueta depende de ingreso y visitas; grupo NO entra a y de forma directa.logit =0.2+1.6* ingreso +0.7* visitasy = (rng.random(n) <1/ (1+ np.exp(-logit))).astype(int)df = pd.DataFrame({"ingreso": ingreso, "visitas": visitas, "ruido": ruido, "grupo": grupo, "y": y})# Correlación espuria: el grupo 1 tiende a ingreso un poco mayor (captura, no 'merecimiento').df.loc[df["grupo"] ==1, "ingreso"] +=0.35X = df[["ingreso", "visitas", "ruido", "grupo"]]y = df["y"]Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)print(df.head(3).to_string(index=False))print("tasa y grupo 0:", f"{df.loc[df.grupo==0,'y'].mean():.3f}","| grupo 1:", f"{df.loc[df.grupo==1,'y'].mean():.3f}")
  ingreso   visitas     ruido  grupo  y
 0.304717  1.112966  1.182531      0  0
-0.689984 -0.245061 -0.323985      1  0
 0.750451 -1.030814 -0.204070      0  1
tasa y grupo 0: 0.539 | grupo 1: 0.485
grupo no causa \(y\) en el generador original; una corrimiento de ingreso lo vuelve un atajo. El modelo puede ‘descubrirlo’. Eso es el núcleo ético de la sesión.
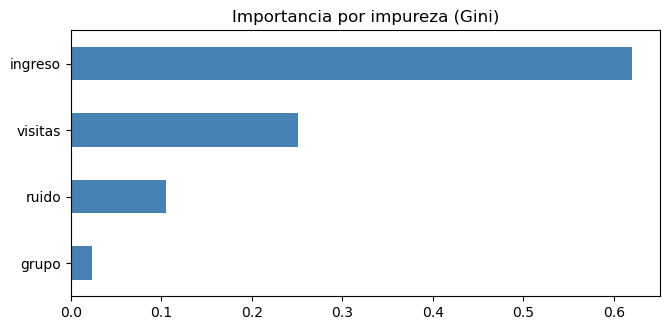
grupo      0.024
ruido      0.105
visitas    0.251
ingreso    0.620
La importancia por impureza favorece variables con muchos cortes posibles y puede hinchar a grupo si correlaciona con ingreso. No es un veredicto moral: es un ranking del bosque, no del mundo.
4) Permutación: romper una columna y ver cuánto duele
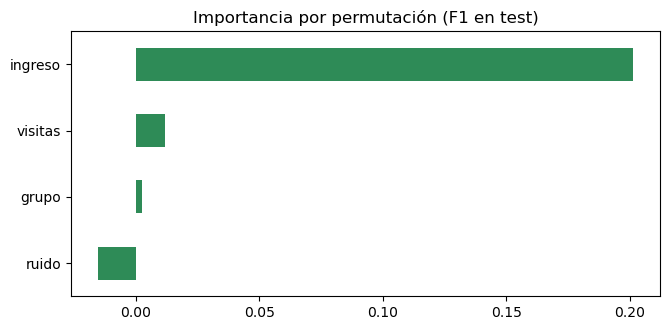
Se baraja una columna en el test y se mide la caída de un score. Si ruido no duele, el modelo no la usaba de verdad. Si grupo duele, el atajo está activo —aunque el generador no lo haya puesto en \(y\).
ruido     -0.015
grupo      0.003
visitas    0.012
ingreso    0.201
Contraste. Si impureza y permutación discrepan en grupo o ruido, el informe debe citar ambas. Una sola barra es un cartel, no una auditoría.
5) SHAP lineal: la factura de un caso
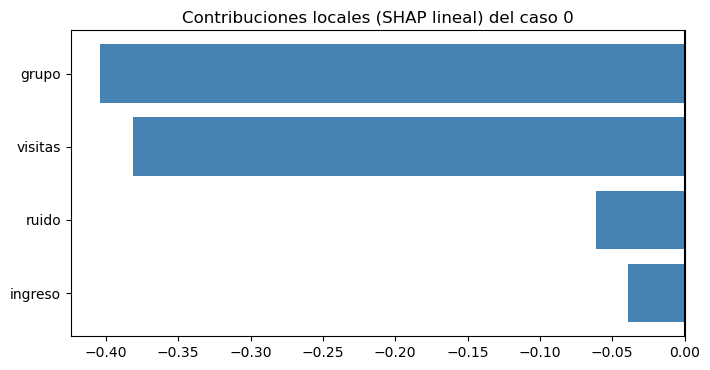
En un modelo lineal sobre features ya centradas, la contribución de \(i\) es \(\varphi_i=\beta_i(x_i-\bar{x}_i)\) (en el espacio transformado). La suma de \(\varphi\) más la base reconstruye el logit. Eso es aditividad: la ‘cuenta’ cierra.
j =1phi_j, _ = shap_lineal(np.asarray(Xte_s[j]).ravel())comp = pd.DataFrame({"caso_0": phi, "caso_1": phi_j}, index=X.columns)print(comp.round(3).to_string())print("Una importancia global no sustituye estas dos facturas.")
         caso_0  caso_1
ingreso  -0.039  -0.975
visitas  -0.381  -0.826
ruido    -0.062   0.019
grupo    -0.404   0.398
Una importancia global no sustituye estas dos facturas.
7) Equidad: paridad demográfica cruda
Tasa de \(\hat{y}=1\) por grupo. No es el único criterio (igualdad de oportunidades, calibración por grupo). Es el más legible para abrir el debate: si el bosque aprueba al grupo 1 el doble, hay que documentarlo, no esconderlo detrás del F1.
         n  tasa_pred  tasa_real
grupo
0      109      0.303      0.523
1      101      0.505      0.505
disparidad de tasa predicha (1 − 0): +0.202
Una disparidad no prueba ‘el modelo es racista’ en este sintético: prueba que el atajo de captura (ingreso corrido) se filtró. La gobernanza consiste en verlo y decidir si grupo debe existir como feature (casi nunca) o si hay que bloquear proxies.
8) ¿Hay que quitar grupo?
rf2 = RandomForestClassifier(n_estimators=200, max_depth=5, random_state=42)cols_sin = ["ingreso", "visitas", "ruido"]rf2.fit(Xtr[cols_sin], ytr)eq2 = pd.DataFrame({"grupo": Xte["grupo"].to_numpy(),"yhat": rf2.predict(Xte[cols_sin])})print(eq2.groupby("grupo")["yhat"].mean().round(3).to_string())print("Quitar la columna no borra el proxy (ingreso). La auditoría no termina al dropear el nombre.")
grupo
0    0.284
1    0.535
Quitar la columna no borra el proxy (ingreso). La auditoría no termina al dropear el nombre.
9) Model card mínima
card = {"proposito": "didáctico: prioridad / crédito sintético","features": list(X.columns),"atributo_sensible": "grupo","explicacion_global": "permutación F1 + impureza","explicacion_local": "SHAP lineal (espacio estandarizado)","limitacion": "interpretar ≠ causa; grupo es proxy de captura","owner": "equipo MLOps del curso",}print(pd.Series(card).to_string())
proposito                   didáctico: prioridad / crédito sintético
features                            [ingreso, visitas, ruido, grupo]
atributo_sensible                                              grupo
explicacion_global                         permutación F1 + impureza
explicacion_local                SHAP lineal (espacio estandarizado)
limitacion            interpretar ≠ causa; grupo es proxy de captura
owner                                         equipo MLOps del curso
La model card viaja con el run_id (sesión 8), no en un slide suelto. Un auditor pregunta por este artefacto.
10) Lo que no se explica en el endpoint
La sesión 9 dejó /predict delgado. /explain es otro recurso: más CPU, otro contrato, otro riesgo de filtrar \(\beta\). No se mezcla en el 200 por costumbre.
11) Relación con 12 y 14
Si hay drift (12), las \(\varphi\) de hoy no son las del train: explicar un caso con un lineal viejo es una factura de un mundo muerto. 14 traducirá disparidad y F1 a una frase que negocio pueda rechazar.
14b) Coeficientes del lineal en lenguaje humano
print(pd.Series(beta, index=X.columns).round(3).to_string())print("Signo positivo empuja el logit hacia la clase 1 *en el espacio estandarizado*.")
ingreso    1.854
visitas    0.960
ruido      0.057
grupo     -0.401
Signo positivo empuja el logit hacia la clase 1 *en el espacio estandarizado*.
14c) Fidelidad: ¿el lineal cuenta la misma historia que el bosque?
# Acuerdo de etiquetas en test: si es bajo, NO use el lineal para explicar al bosque.acord = (rf.predict(Xte) == lin.predict(Xte_s)).mean()print(f"acuerdo rf vs lineal: {acord:.3f}")print("Explicar un bosque con un lineal es un *surrogate*. Hay que declarar el acuerdo.")
acuerdo rf vs lineal: 0.886
Explicar un bosque con un lineal es un *surrogate*. Hay que declarar el acuerdo.
14d) Una frase de examen
“Global dice de qué vive el modelo; local dice por qué esta fila; ninguna de las dos prueba causa; dropear el atributo sensible no mata el proxy.”
14e) Dependencia parcial (idea)
Un PDP pregunta: si muevo ingreso y promedio el resto, ¿cómo cambia \(P(\hat{y}=1)\)? No se implementa aquí. Se nombra para no vender SHAP como la única gráfica posible. PDP es global y asume independencia que a menudo es falsa.
14f) Recurso / contrafactual
“¿Qué tendría que cambiar esta persona para ser aprobada?” es otra pregunta (recurso). No es \(\varphi_i\). Un contrafactual mal hecho sugiere subir el ingreso 300 %: legalmente torpe y éticamente vacío.
14g) Features que se decidió no usar
La model card lista también lo excluido (nacionalidad, código postal fino). La omisión es una decisión de diseño, no un olvido. Debe poder auditarse.
print("excluidas por política: nacionalidad, geohash de 6 dígitos")print("aun así se vigilan proxies (sesión 12 + ingreso).")
excluidas por política: nacionalidad, geohash de 6 dígitos
aun así se vigilan proxies (sesión 12 + ingreso).
14h) Estabilidad de la explicación
Dos filas casi iguales no deberían tener \(\varphi\) opuestas. Si las tienen, el surrogate o el bosque son frágiles. Se puede medir la norma de \(\varphi(x)-\varphi(x+\epsilon)\).
Aunque visitas lidere el ranking, ‘pedir más visitas’ puede ser inútil o dañino. La explicación informa la auditoría, no automáticamente el product design.
14j) Logs de explicación
Si se sirve /explain, se audita quién lo pidió. Una factura local es dato personal del caso. No se vierte a un canal público de Slack.
14k) Límites de Shapley en la práctica
La axiomatización asume un juego cooperativo entre features. Con features dependientes, el valor cambia según el background. El lineal centrado de esta sesión elude parte de esa guerra; un SHAP de bosque no. Se declara el background (train).
14l) Prueba de consistencia del signo
print("signo de β_ingreso:", np.sign(beta[list(X.columns).index('ingreso')]))print("si el negocio espera el signo contrario, hay un bug de T o de etiqueta, no 'IA misteriosa'")
signo de β_ingreso: 1.0
si el negocio espera el signo contrario, hay un bug de T o de etiqueta, no 'IA misteriosa'
14m) El atributo sensible en el servicio
Aunque se quite de \(X\), puede hacer falta después para el informe de disparidad. Se guarda aparte, con control de acceso, no se mete otra vez al predict.
15) Errores frecuentes
Publicar solo Gini.
Llamar causal a \(\varphi_i\).
Explicar el bosque con un lineal sin medir acuerdo.
Dropear grupo y dar por cerrada la equidad.
Meter la explicación en cada /predict.
16) Checklist
¿Hay ranking global y factura local?
¿La cuenta lineal cierra (aditividad)?
¿Se midió disparidad?
¿La model card cita limitaciones?
¿El surrogate declara su fidelidad?
17) Conclusiones
Interpretar es producir evidencia auditable, no un gráfico bonito. Impureza, permutación y SHAP lineal se contrastan. La equidad empieza por mirar el atajo. La sesión 14 convierte esa mirada en una recomendación que alguien puede firmar.
18) Taller
A. Recalcule permutación con scoring="accuracy". ¿Cambia el ranking?
B. Elija el caso de test con mayor \(|\varphi_{grupo}|\). Interprete.
C. Entrene el lineal singrupo. ¿Las \(\varphi\) de ingreso crecen?
D. Redacte tres líneas de model card sobre el proxy.
E. ¿Autorizaría /explain público? Argumente riesgo.
print("acuerdo surrogate:", f"{acord:.3f}")print("disparidad:", f"{tab.loc[1,'tasa_pred']-tab.loc[0,'tasa_pred']:+.3f}")print("Taller A–E. Si solo exporta Gini, no auditó.")
acuerdo surrogate: 0.886
disparidad: +0.202
Taller A–E. Si solo exporta Gini, no auditó.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.