4 Ecosistema Hadoop: el mapa de una plataforma Big Data
Del almacenamiento distribuido al procesamiento: una guía para entender cómo encajan sus componentes
En este capítulo vas a construir el mapa mental de una plataforma Hadoop: no para instalarla ni para memorizar un catálogo de productos, sino para mirar un diagrama y saber qué pregunta responde cada caja. Al terminar deberías poder decir, con tus propias palabras, dónde viven los datos, quién reparte CPU y memoria, quién calcula, qué piezas complementarias existen y cuáles de esas ideas siguen vivas en la nube. Este es un capítulo teórico. La profundidad de HDFS, YARN, MapReduce y Spark llega en materiales posteriores; aquí el objetivo es el mapa.
Tiempo estimado de lectura: 24 minutos
Nivel: Intermedio
Conocimientos previos recomendados: - Manejo básico de la terminal Linux (capítulos 1 y 2) - Fundamentos de Big Data: las 5 V’s, escalar en horizontal, hardware commodity y “llevar el cómputo a los datos”
Tecnologías mencionadas: - Apache Hadoop (Hadoop Common, HDFS, YARN, MapReduce) - Google File System y MapReduce (contexto histórico) - Piezas del ecosistema: Hive, HBase, ZooKeeper, Spark - Almacenamiento de objetos en la nube (S3, ADLS, GCS), a nivel de mapa
Ya entendemos por qué Big Data requiere distribuir almacenamiento y procesamiento. Ahora necesitamos conocer la arquitectura que convirtió esas ideas en una plataforma real.
En Fundamentos viste el porqué: el volumen no cabe en una máquina, el hardware caro no escala, los discos fallan y arrastrar terabytes por la red es el cuello de botella equivocado. En Linux y Docker viste el suelo de cada nodo: el sistema operativo y la forma moderna de empaquetar entornos. Falta el plano de la casa. Hadoop es, históricamente, el plano que la industria usó para convertir esas ideas en un sistema que se podía operar. Este capítulo no abre cada habitación. Te enseña a leer el plano.
El mapa que vamos a construir
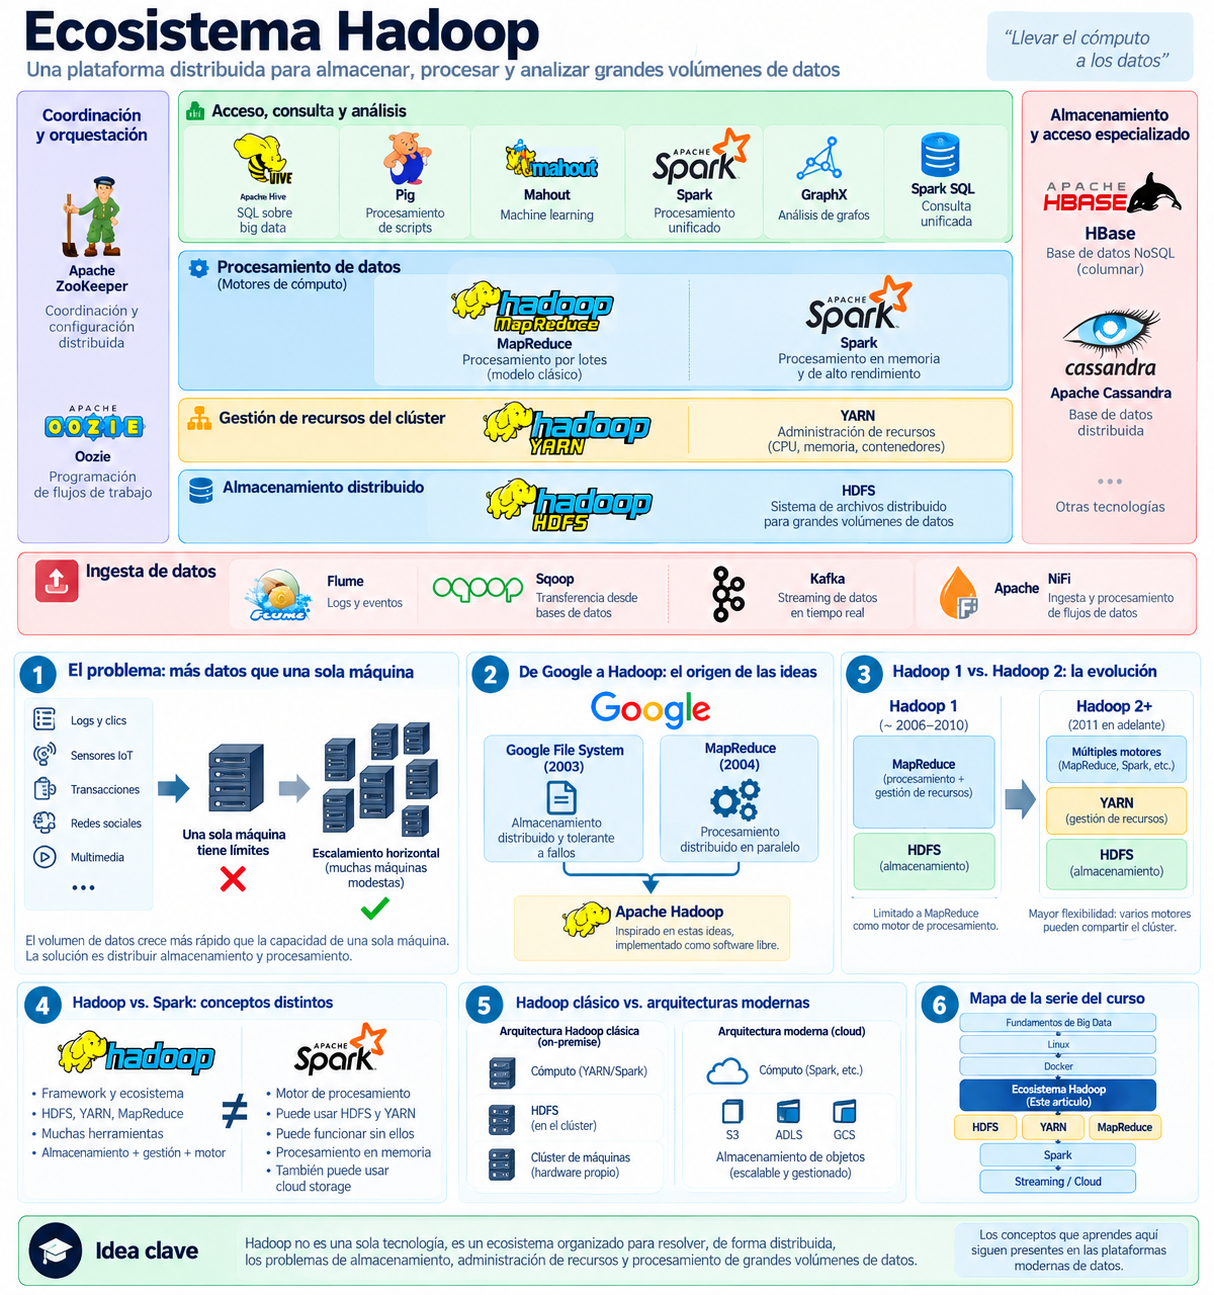
Mapa general. Las herramientas se organizan por responsabilidad y las seis etapas inferiores anticipan el orden del capítulo.
Esta vista anticipa el destino del recorrido. No necesitas comprender todas las cajas todavía: las iremos incorporando en orden, desde el problema que dio origen a Hadoop hasta su relación con las arquitecturas actuales. Al final volveremos al mapa mediante un ejemplo completo.
Parte 1 — Antes de Hadoop: el problema
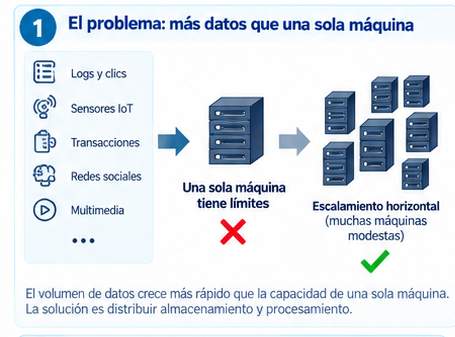
Figura 1. Cuando una sola máquina deja de ser suficiente, el escalamiento horizontal permite agregar capacidad mediante más nodos.
Para entender por qué apareció Hadoop, conviene comenzar con una limitación concreta: una sola máquina solo puede almacenar y procesar hasta cierto volumen de datos. Durante un tiempo es posible ampliar su memoria, incorporar más discos o utilizar un procesador más potente. Esta estrategia, conocida como escalamiento vertical, funciona hasta que el costo y los límites físicos del servidor la vuelven insuficiente.
El crecimiento de fuentes como registros de aplicaciones, transacciones, sensores, redes sociales y contenido multimedia hizo que ese límite llegara cada vez más rápido. La alternativa fue escalar horizontalmente: en lugar de depender de una máquina cada vez más grande, distribuir el trabajo entre muchas máquinas de capacidad moderada. Así, el sistema puede crecer incorporando nuevos nodos al clúster.
Sin embargo, distribuir los datos también introduce nuevos desafíos. Cuando participan cientos o miles de máquinas, los fallos dejan de ser acontecimientos excepcionales: un disco puede dañarse, un nodo puede desconectarse o un enlace de red puede dejar de responder. La plataforma debe continuar operando aunque alguno de esos componentes falle.
También aparece un problema de movimiento. Transportar terabytes de información por la red hasta una máquina encargada de procesarlos puede ser lento y costoso. Por eso, las arquitecturas distribuidas intentan ejecutar las tareas cerca de los nodos donde ya se encuentran los datos. Este principio se conoce como localidad de los datos y suele resumirse como “llevar el cómputo hacia los datos”.
El reto, por tanto, no consiste solamente en disponer de más espacio de almacenamiento. Se necesita coordinar muchas máquinas, distribuir los archivos, aprovechar sus recursos y recuperarse de fallos sin convertir cada aplicación en un proyecto de infraestructura. Esa necesidad conduce a la pregunta central:
¿Cómo construimos una plataforma capaz de almacenar, administrar y procesar datos utilizando cientos o miles de máquinas?
Hadoop surgió como una respuesta arquitectónica a este reto. Su propuesta consiste en separar tres responsabilidades: almacenar los datos de forma distribuida, administrar los recursos del clúster y ejecutar el procesamiento en paralelo. Estas funciones se reparten entre procesos que operan sobre un clúster, es decir, un conjunto de máquinas coordinadas para trabajar como una plataforma.
Esta perspectiva será la guía del resto del capítulo. Cada componente de Hadoop aparecerá como la respuesta a una necesidad concreta: guardar, coordinar recursos o procesar.
Parte 2 — Google y las ideas que cambiaron Big Data

Figura 2. GFS y MapReduce como antecedentes conceptuales de Hadoop.
A principios de los 2000, Google indexaba y servía una web que ya no cabía en el modelo “un gran servidor y una gran base de datos”. Necesitaba guardar archivos enormes en miles de computadores convencionales y, sobre esos archivos, lanzar cálculos que también se distribuyeran entre esas máquinas. No publicó un instalador: publicó las ideas que sostenían su arquitectura.
En 2003, el paper del Google File System (GFS) describió un sistema de archivos distribuido: un almacén que reparte archivos grandes entre muchas máquinas y tolera que esas máquinas mueran. GFS respondía, a nivel conceptual, a dónde viven los datos cuando el disco de una máquina no basta y el fallo es cotidiano.
En 2004, el paper de MapReduce describió un modelo para procesar esas cantidades: partir un cálculo grande en tareas que corren cerca de los datos y combinar resultados. MapReduce respondía a cómo calculamos en paralelo sin que cada equipo reescriba desde cero la distribución, el fallo y la agregación.
La idea que cambia el tablero no es GFS solo ni MapReduce solo, sino su combinación: guardar y calcular en muchas máquinas, acercando el cómputo a los datos. Ese es el núcleo de lo que después llamaríamos una plataforma Big Data. Los papers describían sistemas internos de Google: rigor de ingeniería, no una plataforma que cualquiera pudiera descargar ni un plano para copiar línea a línea.
Quedaba una pregunta natural:
Si esas ideas funcionaban para Google, ¿podía construirse, en código abierto, una plataforma inspirada en ellas y utilizable fuera de Google?
El linaje es de inspiración arquitectónica, no de copia. ¿Para qué sirve entenderlo? Para leer Hadoop como una respuesta abierta a un problema de escala y a dos papers, no como una marca ni como un clon de los sistemas internos de Google. Cuando más adelante hablemos de HDFS y Hadoop MapReduce, estarás viendo la adaptación de dos ideas: almacenar de forma distribuida y procesar de forma distribuida.
Parte 3 — El nacimiento de Hadoop
Apache Hadoop convirtió aquellas ideas de almacenamiento y procesamiento distribuidos en un proyecto de código abierto.
La historia continúa fuera de Google, en un proyecto llamado Apache Nutch. Nutch buscaba construir un motor de búsqueda web de código abierto. Para lograrlo debía recorrer páginas, conservar grandes cantidades de contenido y crear índices que permitieran encontrarlo después. A medida que la web crecía, ejecutar todo ese trabajo en una sola máquina dejó de ser una opción viable.
Dos de los desarrolladores centrales de Nutch eran Doug Cutting, también creador de Apache Lucene, y Mike Cafarella. Su problema era similar al que Google había descrito: necesitaban distribuir tanto el almacenamiento como el procesamiento entre varias máquinas. Los papers de GFS y MapReduce les proporcionaron una referencia arquitectónica para abordar ese desafío con software abierto.
El equipo comenzó a desarrollar dentro de Nutch un sistema de archivos distribuido y una implementación de MapReduce. Sin embargo, esas capacidades podían servir a muchos proyectos, no solamente a un buscador. En febrero de 2006, el código relacionado con almacenamiento y procesamiento distribuidos se separó de Nutch y pasó a un nuevo proyecto llamado Hadoop.
Hadoop quedó bajo el paraguas de la Apache Software Foundation y en 2008 se convirtió en un proyecto Apache de primer nivel. Su nombre no es un acrónimo: provenía del elefante de peluche del hijo de Cutting. Con el tiempo, aquella infraestructura creada para apoyar un buscador se convirtió en una de las plataformas de referencia de la era del Big Data on-premise.
Para entender en qué se convirtió aquel proyecto, debemos distinguir dos conceptos que suelen confundirse: el núcleo de Apache Hadoop y el ecosistema que creció a su alrededor.
Apache Hadoop es un framework de código abierto para almacenar y procesar conjuntos de datos muy grandes de manera distribuida, sobre clústeres de máquinas commodity, asumiendo que algunas de esas máquinas van a fallar. Su núcleo lo componen cuatro piezas: Hadoop Common, HDFS, YARN y Hadoop MapReduce.
Alrededor de ese núcleo surgió el ecosistema Hadoop: un conjunto más amplio de proyectos que nacieron o se integraron junto a Hadoop para resolver necesidades adicionales de consulta, ingesta, coordinación, procesamiento y orquestación. Ahí entran, entre otros, Hive, HBase, ZooKeeper, Spark, Sqoop, Flume y Oozie. Esas tecnologías no son componentes del núcleo de Apache Hadoop.
Apache Hadoop no es “un programa de Big Data”. No es una base de datos. No es Spark. Y, sobre todo, esta frase tiene que quedarte grabada:
Hadoop no es una sola tecnología.
La confusión más cara del oficio es esta:
Apache Hadoop ≠ ecosistema Hadoop ≠ HDFS ≠ MapReduce ≠ Spark.
HDFS es una pieza del núcleo (almacenamiento). Hadoop MapReduce es otra (un modelo de procesamiento). Apache Hadoop es el framework que las junta con YARN y Hadoop Common. El ecosistema es el círculo más grande. Si alguien dice “lo tenemos en Hadoop” y tú no preguntas qué capa, estás hablando idiomas distintos.
¿Para qué sirve esta distinción desde ya? Para el resto del capítulo y del libro. Entender Hadoop es separar responsabilidades de la plataforma, no coleccionar logos.
Parte 4 — Las piezas fundamentales de Hadoop
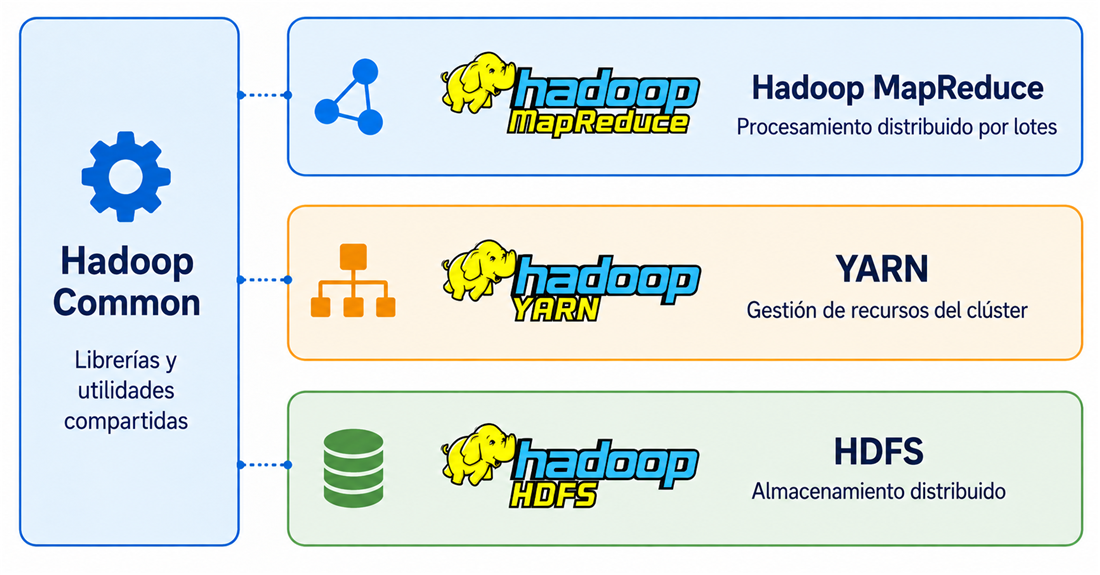
Mapa del núcleo. Hadoop Common aparece como un componente transversal que aporta servicios compartidos a Hadoop MapReduce, YARN y HDFS.
El núcleo de Apache Hadoop —lo que el proyecto empaqueta, no todo el universo de herramientas alrededor— se entiende con cuatro piezas y cuatro preguntas.
| Pregunta | Componente |
|---|---|
| ¿Dónde se almacenan los datos? | HDFS |
| ¿Quién administra CPU, memoria y recursos del clúster? | YARN |
| ¿Cómo se procesan los datos de forma distribuida? | MapReduce |
| ¿Qué librerías y utilidades comparten las demás piezas? | Hadoop Common |
Ese es el mapa mínimo. Si solo recuerdas la tabla, ya puedes leer un diagrama sin ahogarte.
Hadoop Common
Problema que resuelve: las demás piezas no pueden reinventar, cada una por su lado, cómo hablar en red, cómo autenticarse, cómo representar un archivo o cómo leer configuración.
Hadoop Common es el conjunto de librerías, utilidades y componentes compartidos sobre los que se apoyan HDFS, YARN y MapReduce. Es el suelo común del proyecto, no una capa que “guardas” ni una capa que “calculas”.
Qué no es. No es el disco del clúster. No decide qué job corre. No es un motor de SQL.
Dónde se ubica. Debajo y a través de las demás piezas: servicios compartidos, no un producto que operas por separado en el día a día.
No vamos a entrar en APIs internas. Basta la responsabilidad: lo que todas las piezas necesitan y ninguna debería duplicar.
HDFS
Problema que resuelve: un archivo de cientos de gigabytes o de terabytes no cabe, no se lee a tiempo ni sobrevive al fallo de un disco si vive en una sola máquina.
HDFS (Hadoop Distributed File System) es la capa de almacenamiento distribuido del núcleo. A nivel conceptual —y solo conceptual— reparte archivos grandes entre distintas máquinas y mantiene copias para que la muerte de un nodo no borre el dato.
En el siguiente capítulo abrirás esa caja: verás que existen un NameNode, DataNodes y bloques. Aquí son solo nombres en el mapa, un adelanto. No necesitamos todavía arquitectura, replicación, flujos de lectura y escritura ni rack awareness. Eso es HDFS a fondo; no es este texto.
Qué no es. No procesa. No asigna CPU. No es Hive ni una base de datos.
Dónde se ubica. Abajo del todo, en el clúster clásico: el “disco” colectivo.
HDFS responde principalmente a la pregunta: ¿dónde viven los datos?
YARN
Problema que resuelve: si varias aplicaciones quieren usar el mismo clúster —CPU, memoria, el derecho a correr en ciertos nodos—, alguien tiene que repartir sin que una se coma el hardware entero y sin soldar ese reparto a un único estilo de cálculo.
YARN (Yet Another Resource Negotiator) es la capa que administra los recursos del clúster y permite que distintas aplicaciones los pidan y los usen. Conceptualmente: hay un pool de CPU y de memoria; YARN decide quién obtiene qué y en qué máquina puede ejecutar.
No vamos a entrar todavía en ResourceManager, NodeManager, ApplicationMaster ni containers. Esos son el interior de YARN, y tienen su propio material.
Qué no es. No guarda tus logs. No es el algoritmo de tu job. Es el administrador, no el cálculo.
Dónde se ubica. Encima del almacenamiento y debajo de los motores de procesamiento: el sistema operativo del clúster, en sentido figurado.
YARN responde principalmente a la pregunta: ¿quién obtiene los recursos del clúster y dónde puede ejecutar?
MapReduce
Problema que resuelve: un cálculo sobre terabytes hay que partir entre muchas máquinas, tolerar que algunas fallen a mitad de camino y combinar resultados, sin que cada proyecto reinvente esa orquestación.
MapReduce es a la vez un modelo mental y un framework de procesamiento distribuido. En Fundamentos ya lo viste a nivel de idea: dividir, transformar en paralelo, agregar. El framework de Hadoop es la implementación clásica de esa idea sobre el clúster.
No vamos a bajar todavía a map, shuffle y reduce como pipeline interno. Ese es el capítulo de MapReduce.
Qué no es. No es Hadoop entero. No es el único motor posible (la Parte 5 existe precisamente por eso). No es el disco.
Dónde se ubica. Encima de YARN (en Hadoop 2+): pide recursos, lee y escribe en HDFS, calcula.
MapReduce responde principalmente a la pregunta: ¿cómo dividimos un cálculo grande entre muchas máquinas?
Cómo trabajan juntas
Los cuatro componentes colaboran, pero no forman una tubería rígida. Hadoop Common proporciona las utilidades que comparten los demás módulos. HDFS conserva los datos distribuidos entre los nodos. YARN asigna CPU y memoria a las aplicaciones. MapReduce solicita esos recursos y ejecuta tareas que leen y escriben datos en HDFS.
Esta separación permite identificar con mayor precisión dónde ocurre un problema. La capacidad y disponibilidad de los datos corresponden a HDFS; la asignación de recursos, a YARN; y la lógica y el rendimiento del cálculo, al motor de procesamiento. Hadoop Common sostiene la comunicación, la configuración y otras funciones compartidas.
Hadoop Common proporciona la base compartida; HDFS almacena; YARN administra recursos; MapReduce procesa.
Parte 5 — De Hadoop 1 a Hadoop 2: por qué apareció YARN
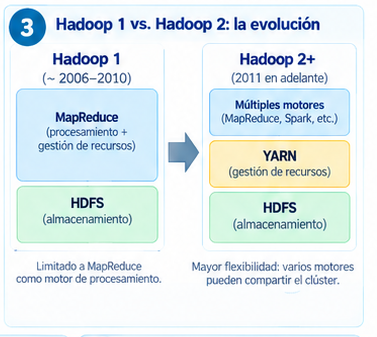
Figura 3. YARN separa la gestión de recursos del motor de procesamiento.
Esta evolución no es nostalgia de versiones. Es la razón por la que gestión de recursos y modelo de procesamiento son cajas distintas.
En Hadoop 1, MapReduce no solo calculaba. También cargaba con buena parte de administrar el clúster: qué tareas corrían, en qué nodo y con qué slot. El almacén era HDFS; el resto era, en la práctica, MapReduce haciendo dos oficios. El clúster quedaba atado a un único estilo de procesamiento. Ejecutar “otra cosa” sobre los mismos nodos significaba luchar contra un diseño que no había previsto otros motores.
Hadoop 2 separa esas responsabilidades. YARN desacopla la gestión de recursos del modelo de procesamiento. El clúster pasa a ser un conjunto de CPU y memoria que distintas aplicaciones pueden solicitar. MapReduce se convierte en un inquilino, no en el dueño del edificio. La idea central es:
Un clúster Hadoop moderno no tiene por qué ejecutar únicamente MapReduce.
Sin ese desacople, Spark —y otros motores— no tendrían un sitio limpio donde pedir CPU y RAM dentro de un clúster Hadoop. YARN no “inventa Spark”. YARN abre la puerta: el almacenamiento sigue siendo HDFS (si así lo eliges), los recursos los arbitra YARN, y el cálculo puede ser MapReduce, Spark u otro framework que sepa hablarle al negociador.
No necesitamos el interior de YARN para entender el porqué. El interior llega en su capítulo. Aquí basta la decisión arquitectónica: separar “quién reparte el clúster” de “cómo se expresa el cálculo”.
¿Para qué sirve esta historia? Para no tratar YARN como una sigla más en una lista. Existe porque Hadoop 1 mezclaba dos problemas. Cuando en el libro llegues a YARN, ya tendrás la pregunta correcta en la cabeza: ¿quién administra recursos para que el motor sea intercambiable?
Parte 6 — El ecosistema Hadoop crece
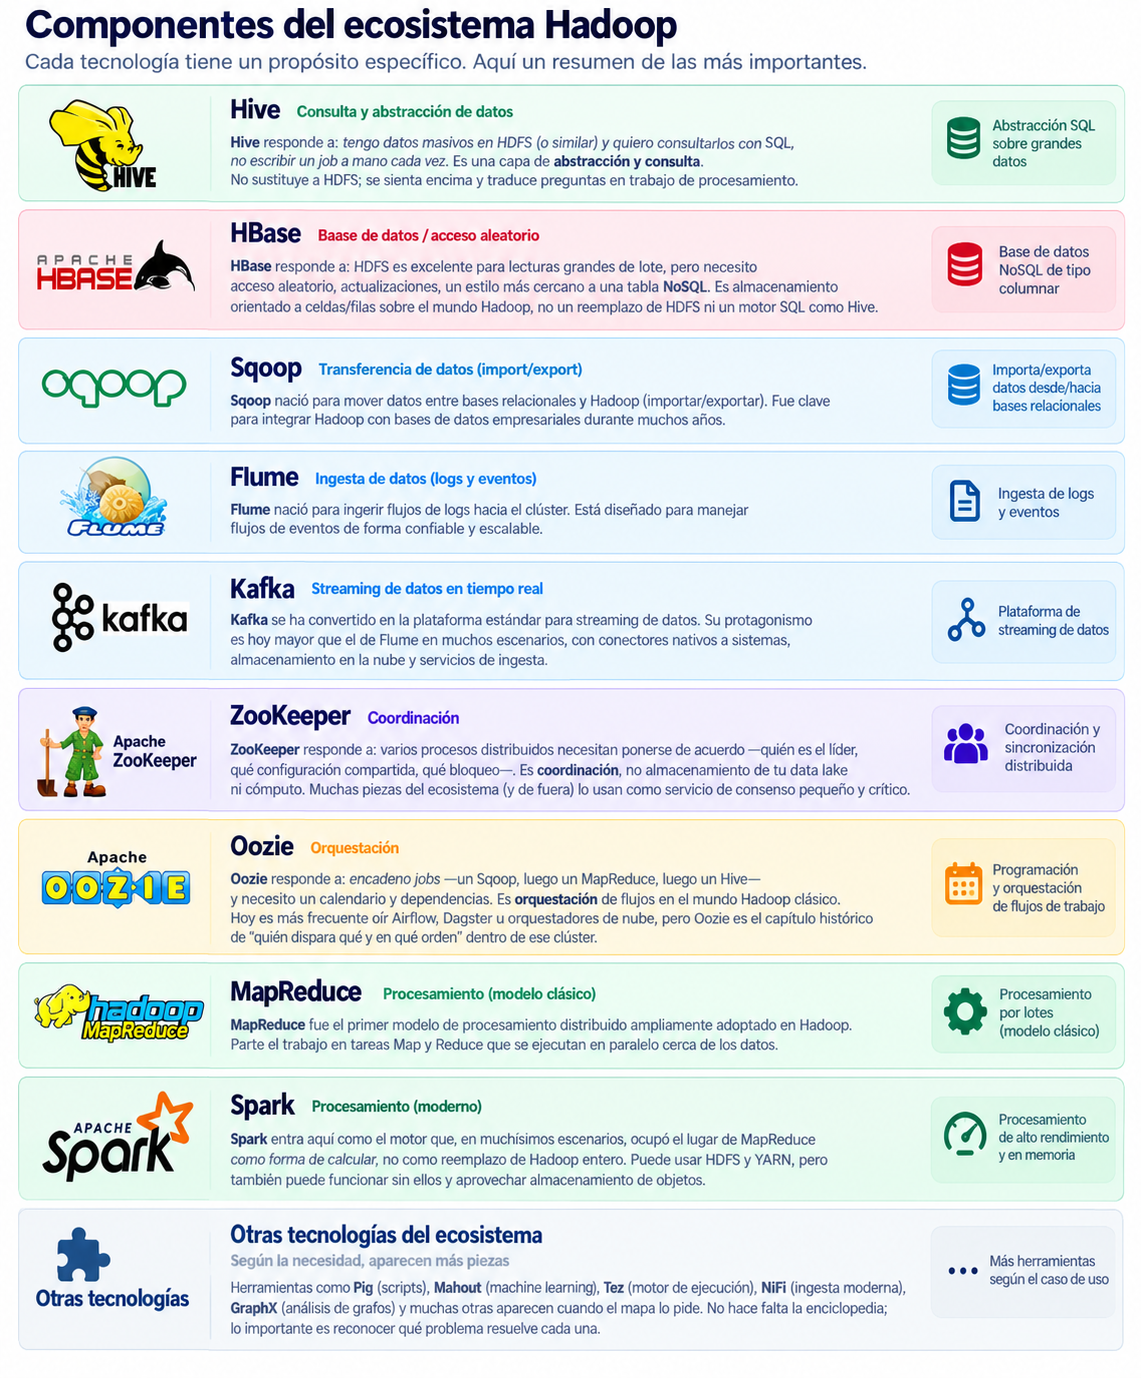
Mapa de componentes. Tecnologías representativas organizadas por el problema que resuelven; algunas, como Sqoop, se conservan por su importancia histórica.
Alrededor del núcleo de Apache Hadoop creció el ecosistema Hadoop: proyectos que no forman parte de ese núcleo, pero que nacieron o se integraron para vivir sobre esas piezas y resolver necesidades que HDFS + YARN + MapReduce no cubrían solos.
Pertenecer al ecosistema Hadoop no significa formar parte del núcleo de Apache Hadoop. Hive, HBase o Spark son vecinos (a veces muy íntimos) del núcleo, no las cuatro cajas de la Parte 4. Lo útil no es la lista de nombres: es la cadena problema → responsabilidad → tecnología.
Consulta y abstracción de datos
Hive responde a: tengo datos masivos en HDFS (o similar) y quiero consultarlos con SQL, no escribir un job a mano cada vez. Es una capa de abstracción y consulta. No sustituye a HDFS; se sienta encima y traduce preguntas en trabajo de procesamiento.
Bases de datos y acceso aleatorio
HBase responde a: HDFS es excelente para lecturas grandes por lotes, pero necesito acceso aleatorio y actualizaciones sobre grandes volúmenes. Es una base de datos NoSQL distribuida, orientada a familias de columnas y construida sobre HDFS. No reemplaza a HDFS ni cumple la función analítica de Hive: resuelve otro patrón de acceso.
Ingesta y transferencia de datos
Sqoop nació para mover datos entre bases relacionales y Hadoop (importar/exportar). El proyecto fue retirado por Apache en 2021 y hoy debe entenderse como una pieza histórica. Flume nació para ingerir flujos de logs hacia el clúster y continúa siendo un proyecto Apache, aunque su protagonismo es menor en arquitecturas nuevas. Hoy es frecuente encontrar Kafka, conectores hacia almacenamiento de objetos y servicios gestionados de ingesta. Conocer estas piezas permite reconocer el problema que resolvían sin convertir una receta de 2014 en una recomendación actual.
Coordinación
ZooKeeper responde a: varios procesos distribuidos necesitan coordinarse —quién es el líder, qué configuración comparten o qué proceso mantiene un bloqueo—. Es un servicio de coordinación distribuida, no almacenamiento del data lake ni un motor de cómputo. Muchas piezas dentro y fuera del ecosistema Hadoop lo han utilizado como un servicio pequeño y crítico.
Orquestación
Oozie responde a: encadeno jobs —un Sqoop, luego un MapReduce, luego un Hive— y necesito un calendario y dependencias. Es orquestación de flujos en el mundo Hadoop clásico. Hoy es más frecuente oír Airflow, Dagster u orquestadores de nube; Oozie es el capítulo histórico de “quién dispara qué y en qué orden” dentro de ese clúster.
Procesamiento
Ya tienes MapReduce en el núcleo. Spark entra aquí como el motor que, en muchísimos escenarios, ocupó el lugar de MapReduce como forma de calcular, no como reemplazo de Hadoop entero. La Parte 7 existe para no mezclar esa frase.
Otras tecnologías (Pig, Impala, Tez, Kafka al borde de la ingesta moderna) aparecen cuando el mapa lo pida. No hace falta la enciclopedia.
| Necesidad | Tecnología representativa |
|---|---|
| Almacenamiento distribuido | HDFS |
| Gestión de recursos | YARN |
| Procesamiento batch | MapReduce / Spark |
| SQL sobre grandes datos | Hive |
| Acceso NoSQL | HBase |
| Coordinación distribuida | ZooKeeper |
| Ingesta histórica | Sqoop / Flume |
| Orquestación histórica | Oozie |
¿Para qué sirve agrupar por problema? Para que mañana, cuando el nombre comercial cambie, sigas sabiendo qué caja del diagrama estás sustituyendo. El ecosistema se memoriza mal; se mapea bien.
Parte 7 — Hadoop no es lo mismo que Spark
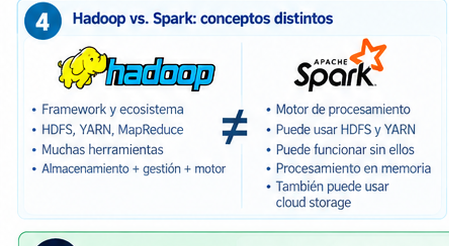
Figura 4. Spark es un motor de procesamiento que puede integrarse con HDFS, YARN y otros servicios.
Esta es la confusión que más se oye, así que vamos a dejarla escrita sin ambigüedad.
- Apache Hadoop es el framework de código abierto (núcleo: Hadoop Common, HDFS, YARN, MapReduce).
- El ecosistema Hadoop es ese núcleo más los proyectos que crecieron alrededor.
- HDFS es almacenamiento.
- YARN es gestión de recursos.
- MapReduce es un modelo y un framework de procesamiento.
- Spark es un motor de procesamiento independiente que puede integrarse con piezas del ecosistema Hadoop.
Spark puede utilizar HDFS y YARN, pero también funcionar sin ellos: puede leer desde almacenamiento de objetos, ejecutarse sobre Kubernetes o administrar sus propios recursos en modo standalone. Por eso la frase popular:
Spark reemplazó Hadoop.
es imprecisa. Una formulación más útil es:
Spark desplazó a MapReduce como motor de procesamiento en muchos escenarios, pero no sustituyó automáticamente a Hadoop como plataforma ni a todas las piezas de su ecosistema.
Donde fue adoptado, cambió principalmente una responsabilidad: cómo se expresa y ejecuta el cálculo, mediante DAG, APIs de más alto nivel y soporte para diversas cargas de trabajo. No sustituyó por sí solo el almacenamiento, el gestor de recursos ni todos los servicios de una plataforma de datos.
¿Para qué sirve esta distinción? Para no diseñar con eslóganes. Si te piden “migrar de Hadoop a Spark”, la pregunta profesional es: ¿migrar el motor, el almacenamiento, el gestor de recursos, o las tres cosas? A menudo es solo el motor. A veces es el paso a la nube, que es otro diagrama (Parte 8).
Parte 8 — Del Hadoop clásico a las arquitecturas modernas
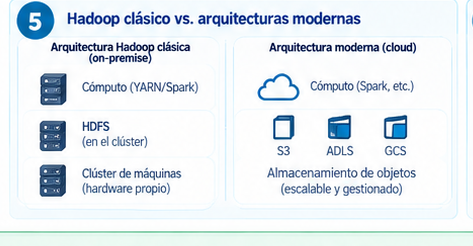
Figura 5. Del clúster con HDFS al desacoplamiento entre almacenamiento y cómputo.
Hadoop consolidó una arquitectura en la que almacenar y procesar grandes volúmenes de datos ocurría dentro del mismo clúster. Las plataformas actuales siguen resolviendo esas dos necesidades, pero no siempre las implementan en las mismas máquinas. El cambio más importante consiste en pasar de una infraestructura acoplada a otra en la que almacenamiento y cómputo pueden evolucionar por separado.
Arquitectura Hadoop clásica on-premise
En una instalación clásica, los nodos del clúster aportan simultáneamente capacidad de almacenamiento y de procesamiento. HDFS distribuye los bloques entre sus discos, YARN administra los recursos disponibles y motores como MapReduce o Spark ejecutan tareas en esos mismos nodos.
Esta cercanía favorece la localidad de los datos: cuando es posible, una tarea se ejecuta en el nodo que ya contiene el bloque que necesita leer. Así se reduce el tráfico de red. Como contrapartida, ampliar, reducir o renovar el almacenamiento suele implicar intervenir también sobre la infraestructura de cómputo.
Arquitectura cloud moderna (simplificada)
En muchas arquitecturas de nube, el data lake se conserva en un servicio de almacenamiento de objetos, mientras que el procesamiento se ejecuta en clústeres o servicios independientes. Los datos permanecen disponibles aunque el entorno de cómputo se detenga, cambie de tamaño o sea reemplazado.
El almacenamiento de objetos no reproduce exactamente un sistema de archivos POSIX ni HDFS. Organiza la información como objetos accesibles mediante API y delega en el proveedor tareas como la durabilidad y la expansión física del servicio. Los motores de procesamiento leen y escriben esos objetos a través de la red.
Tres nombres que vas a ver, sin entrar en ningún proveedor a fondo:
- Amazon S3 (Simple Storage Service)
- Azure Data Lake Storage (ADLS)
- Google Cloud Storage (GCS)
Estos servicios cumplen el papel de almacenamiento persistente, pero no son “HDFS en la nube”. Al separar los datos del clúster, se obtiene mayor flexibilidad para escalar el procesamiento de forma independiente. A cambio, la lectura depende más de la red y de técnicas como cachés, particionamiento eficiente y formatos columnares.
Qué cambia y qué permanece
La implementación evoluciona, pero las preguntas arquitectónicas siguen siendo reconocibles:
- almacenamiento distribuido;
- tolerancia a fallos;
- particionamiento;
- procesamiento paralelo;
- gestión distribuida de recursos;
- data locality;
- escalamiento horizontal.
Un clúster Hadoop clásico resulta coherente cuando una organización opera infraestructura propia, aprovecha la localidad de HDFS y mantiene cargas estables. La separación entre almacenamiento de objetos y cómputo es atractiva cuando se necesita variar recursos con rapidez, conservar los datos más allá de la vida del clúster o utilizar servicios gestionados.
La Figura 5 no presenta una tecnología como reemplazo automático de la otra. Muestra que las responsabilidades permanecen, aunque cambien su ubicación y la forma en que se conectan.
Parte 9 — Recorrer el mapa de principio a fin
Ya conocemos las piezas por separado. Para comprobar cómo colaboran, seguiremos un conjunto de datos desde su llegada hasta el momento en que produce información útil. El ejercicio no pretende imponer una única arquitectura: muestra qué responsabilidad asume cada componente dentro de un flujo posible.
Un ejemplo: llegan 10 TB de logs
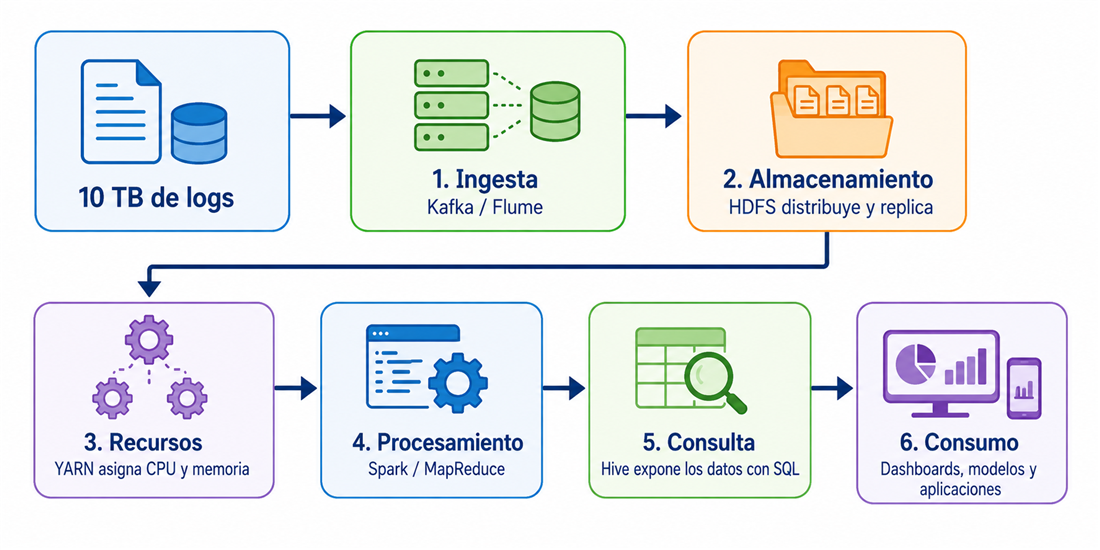
Flujo del ejemplo. Los datos pasan por ingesta, almacenamiento, asignación de recursos, procesamiento, consulta y consumo.
El diagrama resume el recorrido. Veamos ahora qué ocurre en cada etapa:
- Llegan los datos. Un puente de ingesta (en la época clásica, Flume o un volcado por lotes; hoy, a menudo Kafka u otro conector) deposita los logs en el clúster.
- HDFS los almacena. Los 10 TB no viven en “una carpeta de un servidor”. El sistema de archivos distribuido los reparte entre máquinas y guarda copias para sobrevivir a un disco muerto.
- YARN administra los recursos. Cuando alguien lanza un trabajo sobre esos logs, no corre “en el aire”: pide CPU y memoria. YARN decide cuánto y dónde, para que ese trabajo conviva con otros.
- Spark o MapReduce los procesa. El motor parte el cálculo, lee desde HDFS, agrega, filtra, transforma. El resultado vuelve a escribirse —otra vez al almacén— o se entrega a quien lo pidió.
- Hive puede ofrecer consulta. Si el resultado (o los logs ya estructurados) se exponen como tabla, alguien pregunta en SQL sin escribir el job a mano. Hive no guardó los 10 TB; los hace preguntables.
- Otras aplicaciones consumen. Un dashboard, un modelo, un proceso aguas abajo. El clúster no era el destino final: era la plataforma que hizo posible el paso.
Eso es una plataforma, no una pila de descargas. Si cambias Spark por MapReduce, cambia el motor. Si cambias HDFS por S3, cambia el almacén y se afloja el vínculo con los discos del clúster. Las preguntas del diagrama siguen siendo las mismas.
¿Para qué sirve el ejemplo? Para comprobarte. Cierra los ojos y recorre los 10 TB. Si en cada paso sabes qué caja está trabajando, el capítulo cumplió. Si no, vuelve a la tabla de la Parte 4, no a una lista de logos.
Parte 10 — El mapa del libro
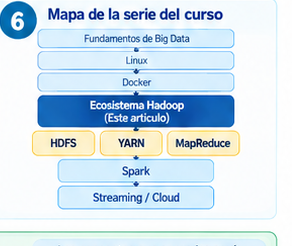
Figura 6. Ubicación del ecosistema Hadoop dentro de la ruta de aprendizaje.
Este texto es la entrada al bloque Hadoop. Lo que sigue abre las cajas una a una, sin repetir el plano. - HDFS — almacenamiento distribuido: dónde viven los datos, cómo se parten, cómo sobreviven al fallo. Es el siguiente capítulo. - YARN — gestión de recursos: quién obtiene CPU y memoria, y cómo conviven varias aplicaciones. - MapReduce — procesamiento distribuido clásico: el modelo que Hadoop implementó primero. - Spark — procesamiento distribuido moderno: el motor que, en muchos escenarios, ocupó el lugar de MapReduce como cálculo. - Streaming — procesamiento continuo, cuando el lote ya no basta. - Cloud — servicios gestionados y la separación entre almacenamiento de objetos y cómputo efímero.
Ahora conocemos el mapa. En el siguiente capítulo, HDFS, abriremos la primera gran pieza de esta arquitectura: el sistema de archivos distribuido de Hadoop.
Referencias esenciales
- Apache Hadoop. Módulos del núcleo: Common, HDFS, YARN y MapReduce.
- Sanjay Ghemawat, Howard Gobioff y Shun-Tak Leung. The Google File System (2003).
- Jeffrey Dean y Sanjay Ghemawat. MapReduce: Simplified Data Processing on Large Clusters (2004).
- Apache Software Foundation. HADOOP-1: traslado inicial del código desde Nutch (2006).
- Apache Hive. Introducción oficial.
- Apache Software Foundation. Apache Sqoop en el Attic.
Resumen
En este capítulo aprendiste a leer una plataforma, no a recitar productos.
- Hadoop surgió para almacenar y procesar grandes volúmenes mediante escalamiento horizontal, tolerancia a fallos y cercanía entre datos y cómputo.
- Su núcleo tiene cuatro responsabilidades: Hadoop Common aporta servicios compartidos, HDFS almacena, YARN administra recursos y MapReduce procesa.
- El ecosistema agrega herramientas especializadas como Hive, HBase, ZooKeeper y Spark; estas no forman parte del núcleo de Hadoop.
- YARN separó la administración de recursos del motor de procesamiento. Spark pudo integrarse con HDFS y YARN, pero también puede funcionar sin ellos.
- Las arquitecturas en la nube suelen separar el almacenamiento de objetos del cómputo. Cambia la implementación, pero permanecen las preguntas sobre almacenamiento, recursos y procesamiento.
El mapa mínimo queda así:
HDFS almacena, YARN administra recursos y los motores como MapReduce o Spark procesan.