14 PySpark: la API de Spark en Python
SparkSession, DataFrames y el motor que ya conoces
En este capítulo vas a entender qué es PySpark: no un motor distinto, sino la API en Python de Spark. El centro es la SparkSession, la diferencia entre RDD y DataFrame, y el par transformación / acción. Verás el mismo wordcount de MapReduce escrito de dos formas, leerás el plan que Spark arma antes de ejecutar y comprobarás dónde aparece el shuffle. Cada ejemplo trae su salida.
Tiempo estimado de lectura: 30 minutos
Nivel: Intermedio
Conocimientos previos recomendados:
- El clúster de los laboratorios, con el cliente Spark y su Jupyter
- MapReduce: el wordcount de cuatro líneas
- Spark: driver, executors, evaluación perezosa, etapas y shuffle
Tecnologías mencionadas:
- PySpark 3.5 (SparkSession, RDD, DataFrame,
pyspark.sql.functions) - Spark SQL
- Catalyst, a través de
explain() - Parquet, como formato de almacenamiento en columnas
Spark está escrito en Scala y corre en la JVM. PySpark es el puente: escribes Python y el driver y los executors siguen siendo Spark. No hay un “clúster PySpark” aparte: el master sigue siendo YARN y en el portal el tipo sigue siendo SPARK.
Cómo leer los ejemplos
Los ejemplos usan los mismos datos que el Taller de PySpark: el texto de cuatro líneas en hdfs://namenode:9000/yarn/entrada/texto.txt y un CSV de ventas en hdfs://namenode:9000/pyspark/entrada/ventas.csv, que el taller crea. Puedes leerlos aquí y ejecutarlos allá, en el Jupyter de spark-client con el kernel Python del clúster. Debajo de cada ejemplo está su salida esperada.
Parte 1 — SparkSession: el punto de entrada
La SparkSession es el objeto por el que tu código Python habla con Spark: crea DataFrames, ejecuta SQL y, por debajo, contiene el SparkContext que conoces del capítulo de Spark.
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("pyspark-teoria").getOrCreate()
print(spark.version)
print(spark.sparkContext.master)
Salida esperada:
3.5.3
yarn
Tres hechos que conviene fijar desde ya:
- Sesión = aplicación.
getOrCreate()crea la aplicación YARN, o reutiliza la que ya existe en ese proceso. Desde ese momento hay executors reservados, aunque no estés calculando nada. - La configuración viene de afuera. En los laboratorios, el master
yarn, la memoria de los executors y el host del driver están enspark-defaults.conf; por eso el código solo pone el nombre de la aplicación. El mismo programa corre en otro clúster cambiando la configuración, no el código. - Se cierra.
spark.stop()termina la aplicación y devuelve la memoria a YARN. En un clúster de 2 GB por nodo, una sesión olvidada abierta deja a la siguiente enACCEPTED.
Error común: que el driver y los executors usen versiones distintas de Python. PySpark se niega a correr y avisa con
PYTHON_VERSION_MISMATCH. Por eso el laboratorio del cliente instala el mismo Python 3.11 enspark-clienty en los NodeManagers.
Parte 2 — RDD y DataFrame
Un RDD es una colección distribuida de elementos cualesquiera: líneas de texto, tuplas, objetos de Python. Tú le dices a Spark cómo transformar cada elemento con funciones (map, filter, reduceByKey).
Un DataFrame es una tabla distribuida: filas con columnas que tienen nombre y tipo. Tú le dices a Spark qué quieres (seleccionar, filtrar, agrupar) y él decide cómo hacerlo.
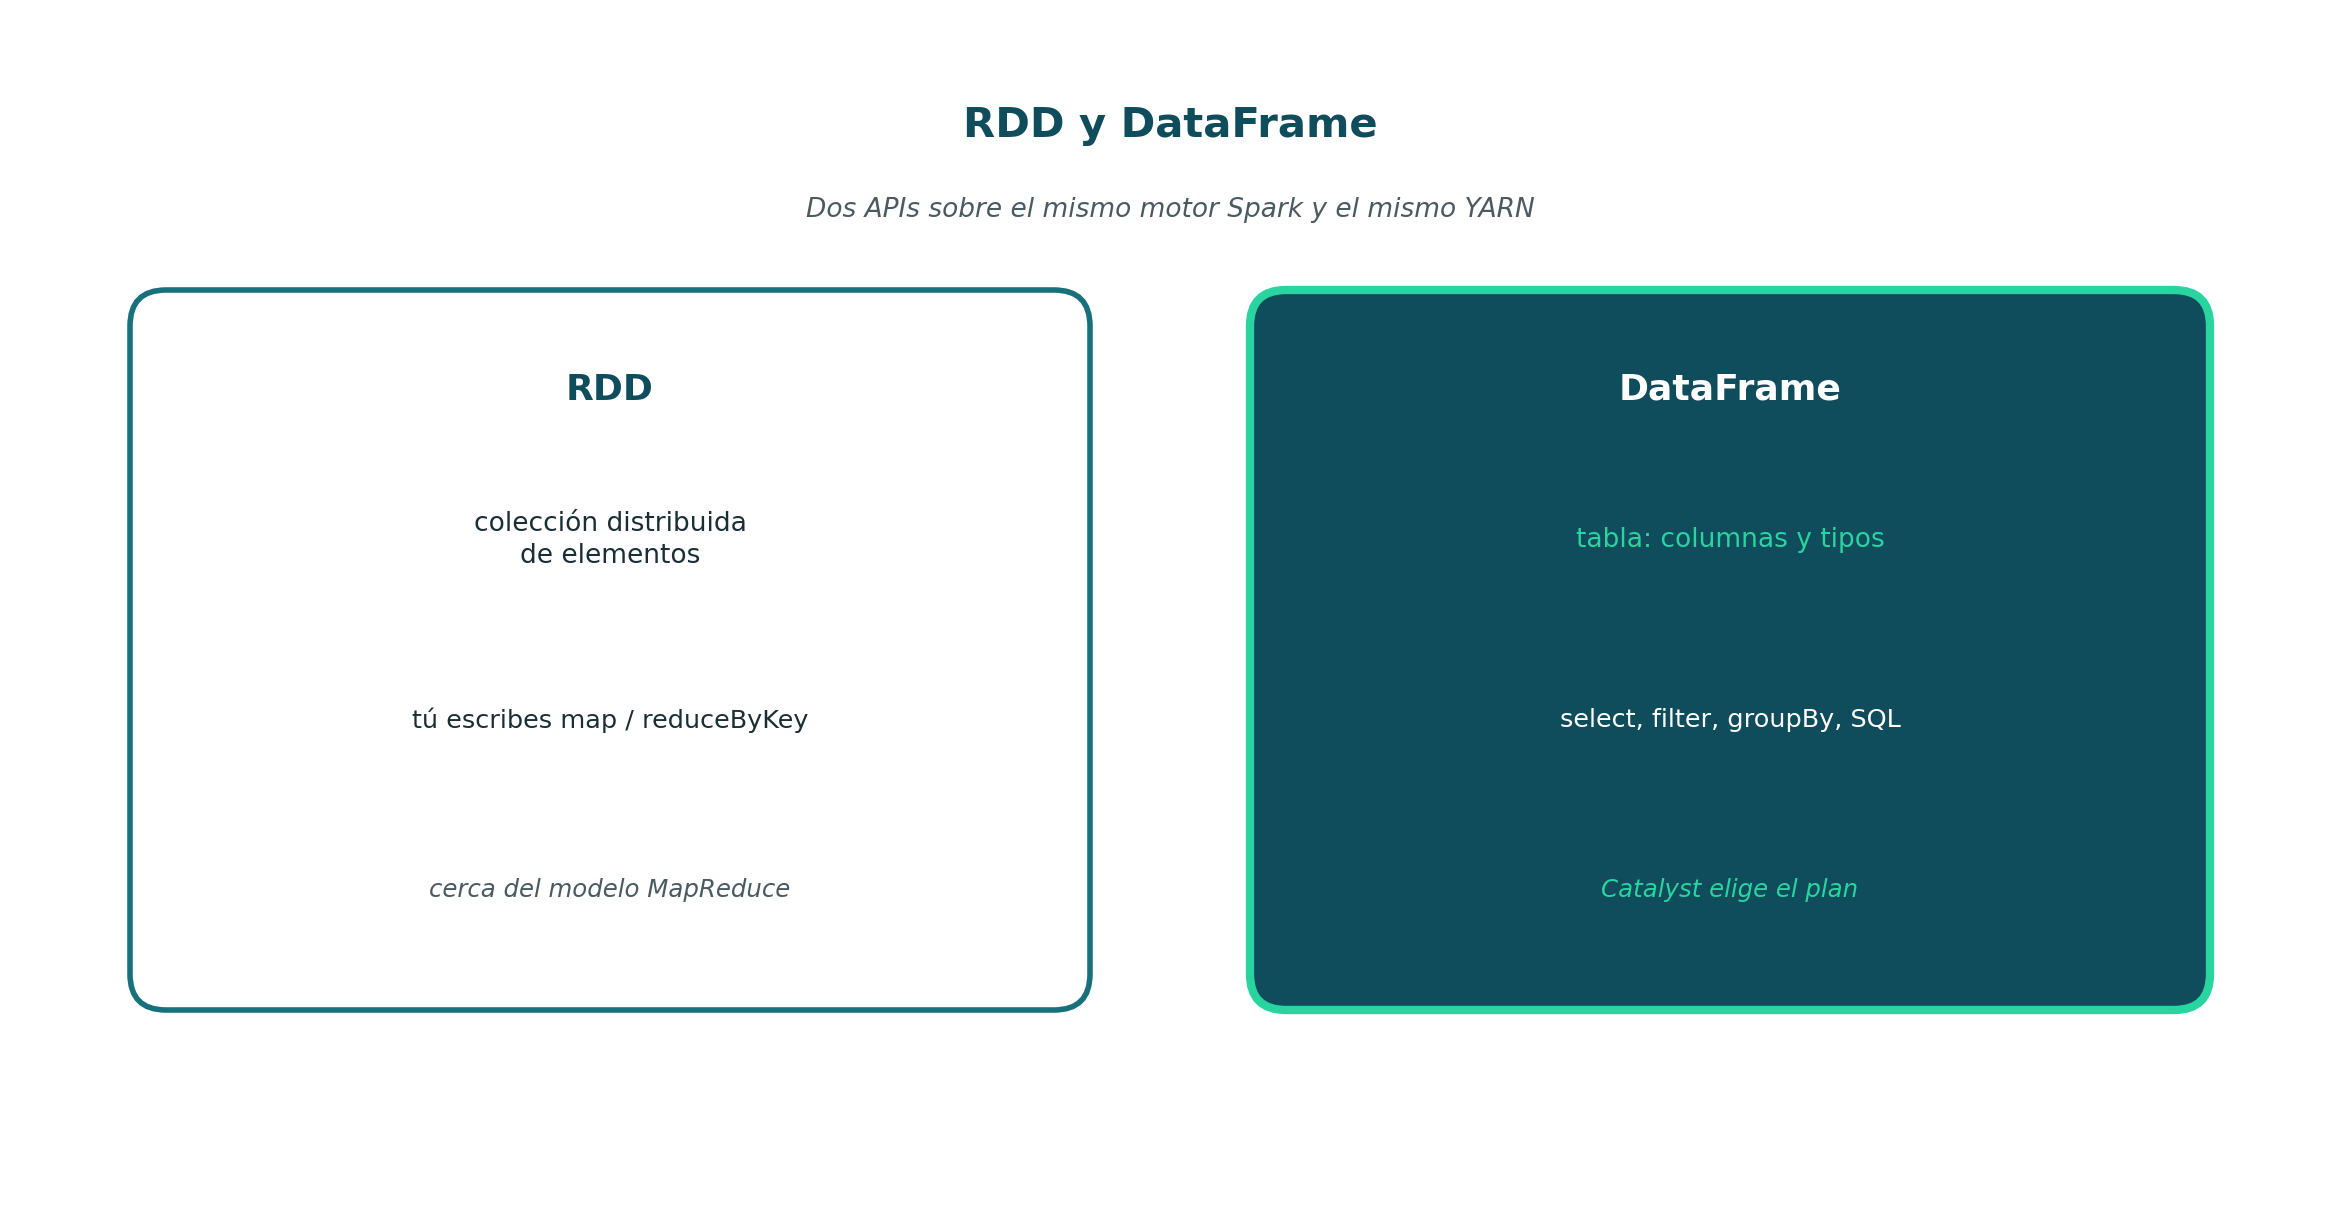
Figura 1. El mismo motor. RDD: funciones sobre elementos. DataFrame: columnas, tipos y un optimizador.
El wordcount con RDD
Es la traducción casi literal del mapper y el reducer de MapReduce:
lineas_rdd = spark.sparkContext.textFile("hdfs://namenode:9000/yarn/entrada/texto.txt")
conteo_rdd = (lineas_rdd
              .flatMap(lambda linea: linea.split())      # una palabra por elemento
              .map(lambda palabra: (palabra, 1))          # el par (clave, valor) del mapper
              .reduceByKey(lambda a, b: a + b))           # shuffle + reduce
print(sorted(conteo_rdd.collect()))
Salida esperada:
[('datos', 3), ('hadoop', 3), ('hdfs', 1), ('mapreduce', 1), ('spark', 1), ('yarn', 3)]El wordcount con DataFrame
Ahora el mismo problema leído como tabla:
from pyspark.sql import functions as F

lineas = spark.read.text("hdfs://namenode:9000/yarn/entrada/texto.txt")
conteo = (lineas
          .select(F.explode(F.split("value", " ")).alias("palabra"))
          .groupBy("palabra")
          .count()
          .orderBy(F.desc("count"), "palabra"))
conteo.show()
Salida esperada:
+---------+-----+
|  palabra|count|
+---------+-----+
|    datos|    3|
|   hadoop|    3|
|     yarn|    3|
|     hdfs|    1|
|mapreduce|    1|
|    spark|    1|
+---------+-----+
Paso a paso: spark.read.text crea una tabla con una sola columna, value, con una fila por línea. F.split convierte cada línea en una lista de palabras; F.explode convierte cada elemento de la lista en una fila. groupBy("palabra").count() agrupa y cuenta: es el shuffle y el reduce. orderBy ordena por frecuencia y desempata por palabra.
¿Cuál usar?
| RDD | DataFrame | |
|---|---|---|
| Unidad de trabajo | Elemento cualquiera | Fila con columnas tipadas |
| Cómo se expresa | Funciones de Python (lambda) |
Operaciones de columnas o SQL |
| Optimización | Ninguna: Spark ejecuta tus funciones tal cual | Catalyst reescribe el plan antes de ejecutar |
| Costo en PySpark | Cada elemento viaja entre la JVM y Python | Casi todo se ejecuta dentro de la JVM |
| Cuándo | Datos sin estructura o lógica que no cabe en columnas | Casi siempre |
La fila “costo en PySpark” es la razón práctica: con RDD, cada elemento se envía a un proceso de Python en el executor y vuelve; con DataFrame, las funciones de pyspark.sql.functions se ejecutan dentro de la JVM. En datos grandes, la diferencia es de varias veces. La API de este libro es DataFrame; los RDD sirven para entender el motor.
Parte 3 — Esquemas: nombres y tipos
Un DataFrame siempre tiene un esquema: la lista de columnas con su tipo. printSchema() lo muestra:
lineas.printSchema()
conteo.printSchema()
Salida esperada:
root
 |-- value: string (nullable = true)

root
 |-- palabra: string (nullable = false)
 |-- count: long (nullable = false)
Al leer un CSV hay dos formas de obtener el esquema:
- Inferirlo con
inferSchema=True: Spark recorre los datos para adivinar los tipos. Es cómodo para explorar, pero cuesta una pasada extra sobre el archivo y puede adivinar mal (un código postal con ceros a la izquierda se convierte en número y los pierde). - Declararlo: tú dices los tipos. Es más rápido y es lo correcto en un proceso que corre todos los días.
from pyspark.sql.types import StructType, StructField, StringType, IntegerType

esquema = StructType([
    StructField("producto", StringType(), True),
    StructField("unidades", IntegerType(), True),
])
ventas = spark.read.csv("hdfs://namenode:9000/pyspark/entrada/ventas.csv",
                        header=True, schema=esquema)
ventas.printSchema()
ventas.show()
Salida esperada:
root
 |-- producto: string (nullable = true)
 |-- unidades: integer (nullable = true)

+--------+--------+
|producto|unidades|
+--------+--------+
| teclado|       1|
| teclado|       3|
|   raton|       2|
+--------+--------+
Parte 4 — Transformaciones y acciones en PySpark
Lo que viste en la teoría de Spark se cumple igual aquí:
- Una transformación (
select,filter,withColumn,groupBy,join,orderBy…) devuelve otro DataFrame y no calcula nada. - Una acción (
show,count,collect,take,first,write…) pide un resultado y dispara un job.
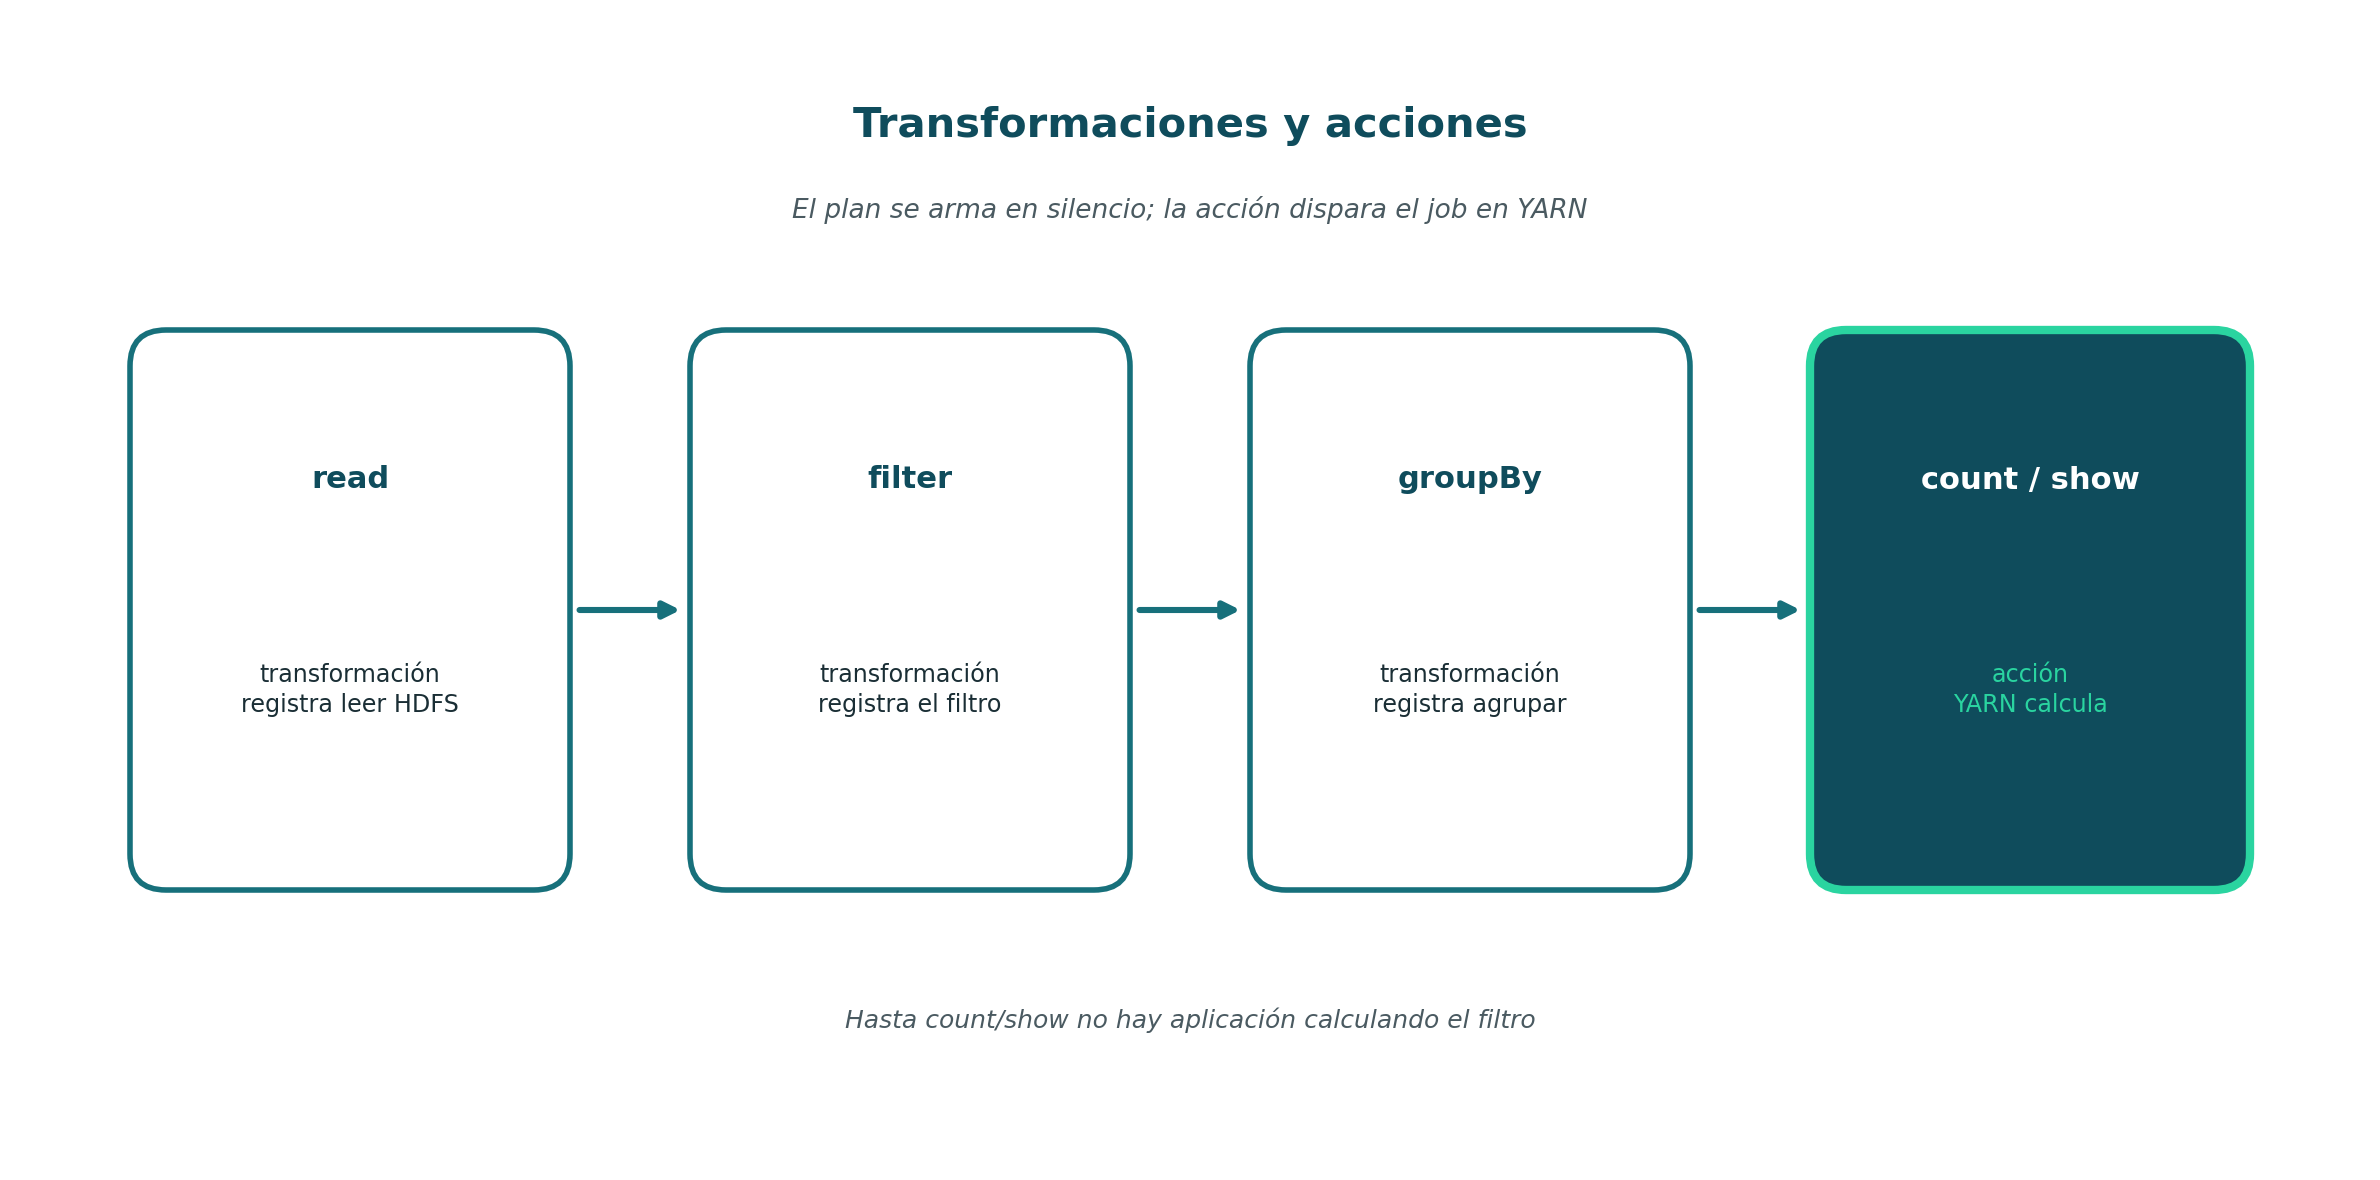
Figura 2. read, filter y groupBy registran pasos. count o show disparan el job.
con_hadoop = lineas.filter(F.col("value").contains("hadoop"))
print(type(con_hadoop).__name__)
print(con_hadoop.count())
Salida esperada:
DataFrame
3
La primera línea solo creó un DataFrame nuevo: un plan. El número 3 —las líneas que contienen “hadoop”— aparece cuando count() lo pide.
Las acciones no son intercambiables. Elige según cuánto necesitas traer al driver:
| Acción | Qué trae al driver | Riesgo |
|---|---|---|
show(n) |
Imprime n filas (20 por defecto) |
Ninguno: es para mirar |
take(n) / first() |
n filas como objetos Row |
Bajo, si n es pequeño |
count() |
Un número | Ninguno, aunque recorre todos los datos |
collect() |
Todas las filas | Con datos grandes llena la memoria del driver |
toPandas() |
Todas las filas, como DataFrame de pandas | El mismo que collect() |
write |
Nada: escribe en HDFS desde los executors | Ninguno para el driver |
print(conteo.take(2))
print(conteo.first())
Salida esperada:
[Row(palabra='datos', count=3), Row(palabra='hadoop', count=3)]
Row(palabra='datos', count=3)
Error común: usar
collect()para “ver los datos” de una tabla grande. Con cuatro palabras es inofensivo; con mil millones de filas tumba el driver. Para mirar,show(); para guardar,write.
Parte 5 — Leer el plan: explain() y el shuffle
explain() muestra el plan físico: lo que Spark va a ejecutar de verdad, después de que Catalyst optimizó tu código. Se lee de abajo hacia arriba, en el orden en que fluyen los datos.
conteo.explain()Salida esperada (los números tras # y la ruta cambian en cada sesión):
== Physical Plan ==
AdaptiveSparkPlan isFinalPlan=false
+- Sort [count#8L DESC NULLS LAST, palabra#3 ASC NULLS FIRST], true, 0
   +- Exchange rangepartitioning(count#8L DESC NULLS LAST, palabra#3 ASC NULLS FIRST, 200), ENSURE_REQUIREMENTS, [plan_id=127]
      +- HashAggregate(keys=[palabra#3], functions=[count(1)])
         +- Exchange hashpartitioning(palabra#3, 200), ENSURE_REQUIREMENTS, [plan_id=124]
            +- HashAggregate(keys=[palabra#3], functions=[partial_count(1)])
               +- Generate explode(split(value#0,  , -1)), false, [palabra#3]
+- FileScan text [value#0] ...| Línea (de abajo arriba) | Qué es |
|---|---|
FileScan text |
Leer el archivo de HDFS |
Generate explode(split(...)) |
Partir en palabras: el map |
HashAggregate ... partial_count |
Contar dentro de cada partición antes del shuffle: el combiner de MapReduce |
Exchange hashpartitioning(palabra#3, 200) |
Shuffle: mandar cada palabra a su partición. Es la dependencia ancha |
HashAggregate ... count |
Sumar los conteos parciales: el reduce |
Exchange rangepartitioning |
Un segundo shuffle, para ordenar el resultado |
AdaptiveSparkPlan |
AQE activado: el plan puede ajustarse durante la ejecución |
Cada Exchange es un shuffle y, por tanto, un corte de etapa. El 200 es el número de particiones que Spark usa por defecto después de un shuffle (spark.sql.shuffle.partitions); con datos pequeños, AQE las fusiona en pocas al ejecutar. Observa también que Spark aplicó por su cuenta la agregación parcial antes del shuffle: con MapReduce tenías que configurar el combiner; con DataFrames, el optimizador lo decide.
Parte 6 — Spark SQL: la misma consulta en SQL
Un DataFrame se puede registrar como vista temporal y consultar con SQL. Las dos formas producen el mismo plan, así que se elige por legibilidad:
ventas.createOrReplaceTempView("ventas")
spark.sql("""
    SELECT producto, SUM(unidades) AS total
    FROM ventas
    GROUP BY producto
    ORDER BY producto
""").show()
Equivale a:
(ventas.groupBy("producto")
       .agg(F.sum("unidades").alias("total"))
       .orderBy("producto")
       .show())
Salida esperada (la misma en los dos casos):
+--------+-----+
|producto|total|
+--------+-----+
|   raton|    2|
| teclado|    4|
+--------+-----+
La vista temporal vive mientras vive la sesión y no copia datos: es solo un nombre para el DataFrame.
Parte 7 — Escribir: Parquet y por qué importa el formato
Un resultado que solo se muestra con show() desaparece al cerrar la sesión. Para conservarlo se escribe con write, que es una acción: los executors escriben en paralelo, un archivo por partición, en una carpeta de HDFS.
El formato importa. CSV es texto plano: fácil de leer para una persona, pero Spark tiene que leer cada fila completa y convertir los tipos cada vez. Parquet es un formato en columnas, comprimido y con el esquema incluido. Esa organización permite a Catalyst dos optimizaciones que se ven en el plan:
ventas.write.mode("overwrite").parquet("hdfs://namenode:9000/pyspark/salida/ventas_parquet")
grandes = (spark.read.parquet("hdfs://namenode:9000/pyspark/salida/ventas_parquet")
                .filter(F.col("unidades") > 2)
                .select("producto"))
grandes.explain()
grandes.show()
Salida esperada (resumida):
== Physical Plan ==
*(1) Project [producto#90]
+- *(1) Filter (isnotnull(unidades#91) AND (unidades#91 > 2))
   +- *(1) ColumnarToRow
      +- FileScan parquet [producto#90,unidades#91] ... PushedFilters: [IsNotNull(unidades), GreaterThan(unidades,2)], ReadSchema: struct<producto:string,unidades:int>

+--------+
|producto|
+--------+
| teclado|
+--------+- Proyección de columnas:
ReadSchemasolo incluyeproductoyunidades. Si la tabla tuviera cincuenta columnas, Spark leería solo esas dos del disco. - Filtros empujados:
PushedFiltersmuestra que la condiciónunidades > 2se envía al lector de Parquet, que puede saltarse bloques enteros cuyos valores no la cumplen.
En un data lake, guardar en Parquet en lugar de CSV suele reducir el tamaño y el tiempo de lectura varias veces. mode("overwrite") reemplaza la carpeta si existe; sin él, Spark falla para no borrar datos por accidente, igual que MapReduce con su directorio de salida.
Parte 8 — Reutilizar: cache()
Cada acción vuelve a ejecutar el plan desde el origen. Si vas a usar el mismo DataFrame varias veces, cache() lo guarda en los executors después de la primera acción:
conteo.cache()
print(conteo.count())   # calcula y guarda en caché
print(conteo.count())   # lee de la caché
print(conteo.is_cached)
conteo.unpersist()
Salida esperada:
6
6
True
El resultado es el mismo; lo que cambia es el trabajo. La segunda acción no vuelve a leer HDFS: puedes comprobarlo en la pestaña Storage de la UI de Spark (:4040). unpersist() libera la memoria cuando ya no lo necesitas.
Parte 9 — Funciones propias (UDF): con cuidado
Si ninguna función de pyspark.sql.functions hace lo que necesitas, puedes escribir una UDF (user-defined function) en Python:
from pyspark.sql.types import StringType

@F.udf(returnType=StringType())
def en_mayusculas(texto):
    return texto.upper() if texto is not None else None

ventas.select(en_mayusculas("producto")).show()
Funciona, pero tiene un costo: cada valor sale de la JVM hacia un proceso de Python, se transforma y vuelve, y Catalyst no puede optimizar lo que pasa dentro. La regla es simple: busca primero una función integrada. Para este ejemplo existe F.upper("producto"), que hace lo mismo sin salir de la JVM. pyspark.sql.functions tiene cientos de funciones de texto, fechas, matemáticas y arreglos.
Parte 10 — Qué no es PySpark
| No es | Porque |
|---|---|
| Un Python local más rápido | El código del driver corre en Python, pero el cálculo distribuido lo hace Spark en la JVM de los executors |
| pandas distribuido | La API se parece en ideas, pero un DataFrame de Spark es perezoso, inmutable y no tiene índice de filas |
| Algo que se instala en el host | En los laboratorios, PySpark viene con el cliente Spark; no se instala con pip en Windows ni en Ubuntu |
| Spark SQL como producto aparte | SQL entra por la misma SparkSession y produce el mismo plan que la API |
| “Sin shuffle” | groupBy, join, distinct y orderBy siguen moviendo datos entre executors, como muestra cada Exchange |
Preguntas de comprensión
- Escribiste
filtradas = lineas.filter(...)y en:8088no apareció ningún job nuevo. ¿Por qué? - En el plan del wordcount aparecen dos
Exchange. ¿Qué operación causó cada uno? - ¿Por qué un filtro sobre Parquet puede leer menos datos del disco que el mismo filtro sobre CSV?
- Tienes que convertir un texto a mayúsculas. ¿UDF o función integrada, y por qué?
Orientaciones. filter es una transformación: solo amplía el plan, y el portal de YARN muestra aplicaciones, no jobs; los jobs se ven en :4040 cuando hay una acción. El primero lo causó groupBy (agrupar por palabra) y el segundo, orderBy (ordenar el resultado global). Parquet guarda por columnas con estadísticas por bloque, así que el lector solo carga las columnas pedidas y puede saltarse bloques que no cumplen el filtro. Función integrada: F.upper corre dentro de la JVM y Catalyst la entiende; la UDF obliga a pasar cada valor por Python.
Referencias para profundizar
- Apache Spark, PySpark Overview (3.5.3).
- Apache Spark, Spark SQL, DataFrames and Datasets Guide.
- Apache Spark, Parquet Files.
- Apache Spark, Performance Tuning: particiones del shuffle y AQE.
- Michael Armbrust et al., Spark SQL: Relational Data Processing in Spark (SIGMOD 2015), el artículo que presentó Catalyst.
Resumen
En este capítulo aprendiste:
- Que PySpark es la API en Python de Spark: el mismo motor, el mismo YARN y el mismo tipo
SPARK. - Que la SparkSession crea la aplicación, toma su configuración de afuera y se cierra con
stop(). - La diferencia entre RDD y DataFrame, y por qué en PySpark conviene casi siempre DataFrame.
- A leer y declarar esquemas, y por qué declararlos es mejor en un proceso diario.
- A distinguir transformaciones de acciones y a elegir la acción según lo que traes al driver.
- A leer un plan con
explain(): cadaExchangees un shuffle, y Spark aplica sola la agregación parcial que en MapReduce era el combiner. - Que Spark SQL y la API producen el mismo plan, que Parquet permite leer solo las columnas y bloques necesarios, y cuándo usar
cache()y cuándo evitar las UDF.
En el siguiente capítulo, el Taller de PySpark, ejecutarás estos pasos sobre el clúster y escribirás el wordcount de vuelta en HDFS.