10 MapReduce: el modelo de procesamiento de Hadoop
Cómo partir un cálculo, agrupar por clave y combinar resultados
En este capítulo vas a entender qué pregunta responde MapReduce, en qué se diferencia de HDFS y de YARN, y cómo un trabajo recorre las fases map, shuffle y reduce. El centro es el enfoque: llevar el cómputo a los datos, emitir pares clave-valor y agregar por clave. Al final ejecutarás un wordcount en el clúster que ya montaste y leerás sus contadores, la evidencia numérica de que cada fase ocurrió.
Tiempo estimado de lectura: 28 minutos (incluye un ejemplo en el clúster)
Nivel: Intermedio
Conocimientos previos recomendados:
- El clúster de los laboratorios: HDFS, YARN y el cliente Spark
- Dominando la terminal para Big Data, en particular el wordcount con
tr | sort | uniq -c - El laboratorio de YARN, donde enviaste
piywordcountdesde el NameNode: este capítulo explica qué era ese tipoMAPREDUCE
Tecnologías mencionadas:
- Hadoop MapReduce (modelo y motor)
- Hadoop Streaming (una forma de escribir MapReduce sin Java)
- YARN (como árbitro, no como el cálculo)
- Spark (como contraste de modelo)
En el capítulo de HDFS resolvimos dónde están los archivos. En el de YARN, quién obtiene CPU y memoria. Falta la pregunta del cálculo: dado un archivo grande ya repartido en bloques, ¿cómo lo procesamos en paralelo sin arrastrar terabytes a una sola máquina y sin que cada equipo reescriba la distribución, la recuperación de fallos y la agregación?
Esa pregunta la responde MapReduce. No es un disco ni el árbitro de recursos. Es un modelo de procesamiento y, en Hadoop, el motor clásico que implementa ese modelo sobre YARN. El clúster ya está montado; aquí no se vuelve a construir. Escribir tu propio mapper.py y reducer.py queda para el Taller de MapReduce Streaming, el capítulo siguiente.
Parte 1 — La pregunta que MapReduce responde
Un modelo de procesamiento es una receta fija de cómo se parte un cálculo y cómo se combinan los resultados. MapReduce fija tres movimientos:
- transformar cada trozo de entrada por separado;
- agrupar lo transformado por clave;
- combinar cada grupo en un resultado.
Jeffrey Dean y Sanjay Ghemawat describieron esa receta en 2004, a partir de la experiencia de Google procesando la web en miles de máquinas. Hadoop MapReduce es la implementación de código abierto que la industria usó durante años como primer motor sobre HDFS. El enfoque no es “un servidor potente ejecuta un for”. Es llevar el cómputo a los datos: las tareas map corren, en lo posible, en los nodos que ya tienen el bloque que van a leer.
La fuerza del modelo está en lo que le quita al programador. Tú escribes dos funciones pequeñas —qué emitir por cada registro y cómo combinar los valores de una clave— y el motor se ocupa de lo difícil: repartir el trabajo, mover datos entre máquinas, reintentar tareas que fallan y escribir el resultado.
¿Para qué sirve esta idea? Para no confundir tres cajas del ecosistema. Si un trabajo falla, la pregunta útil es: ¿falló el disco (HDFS), el árbitro (YARN) o el programa que transforma y agrega (MapReduce)?
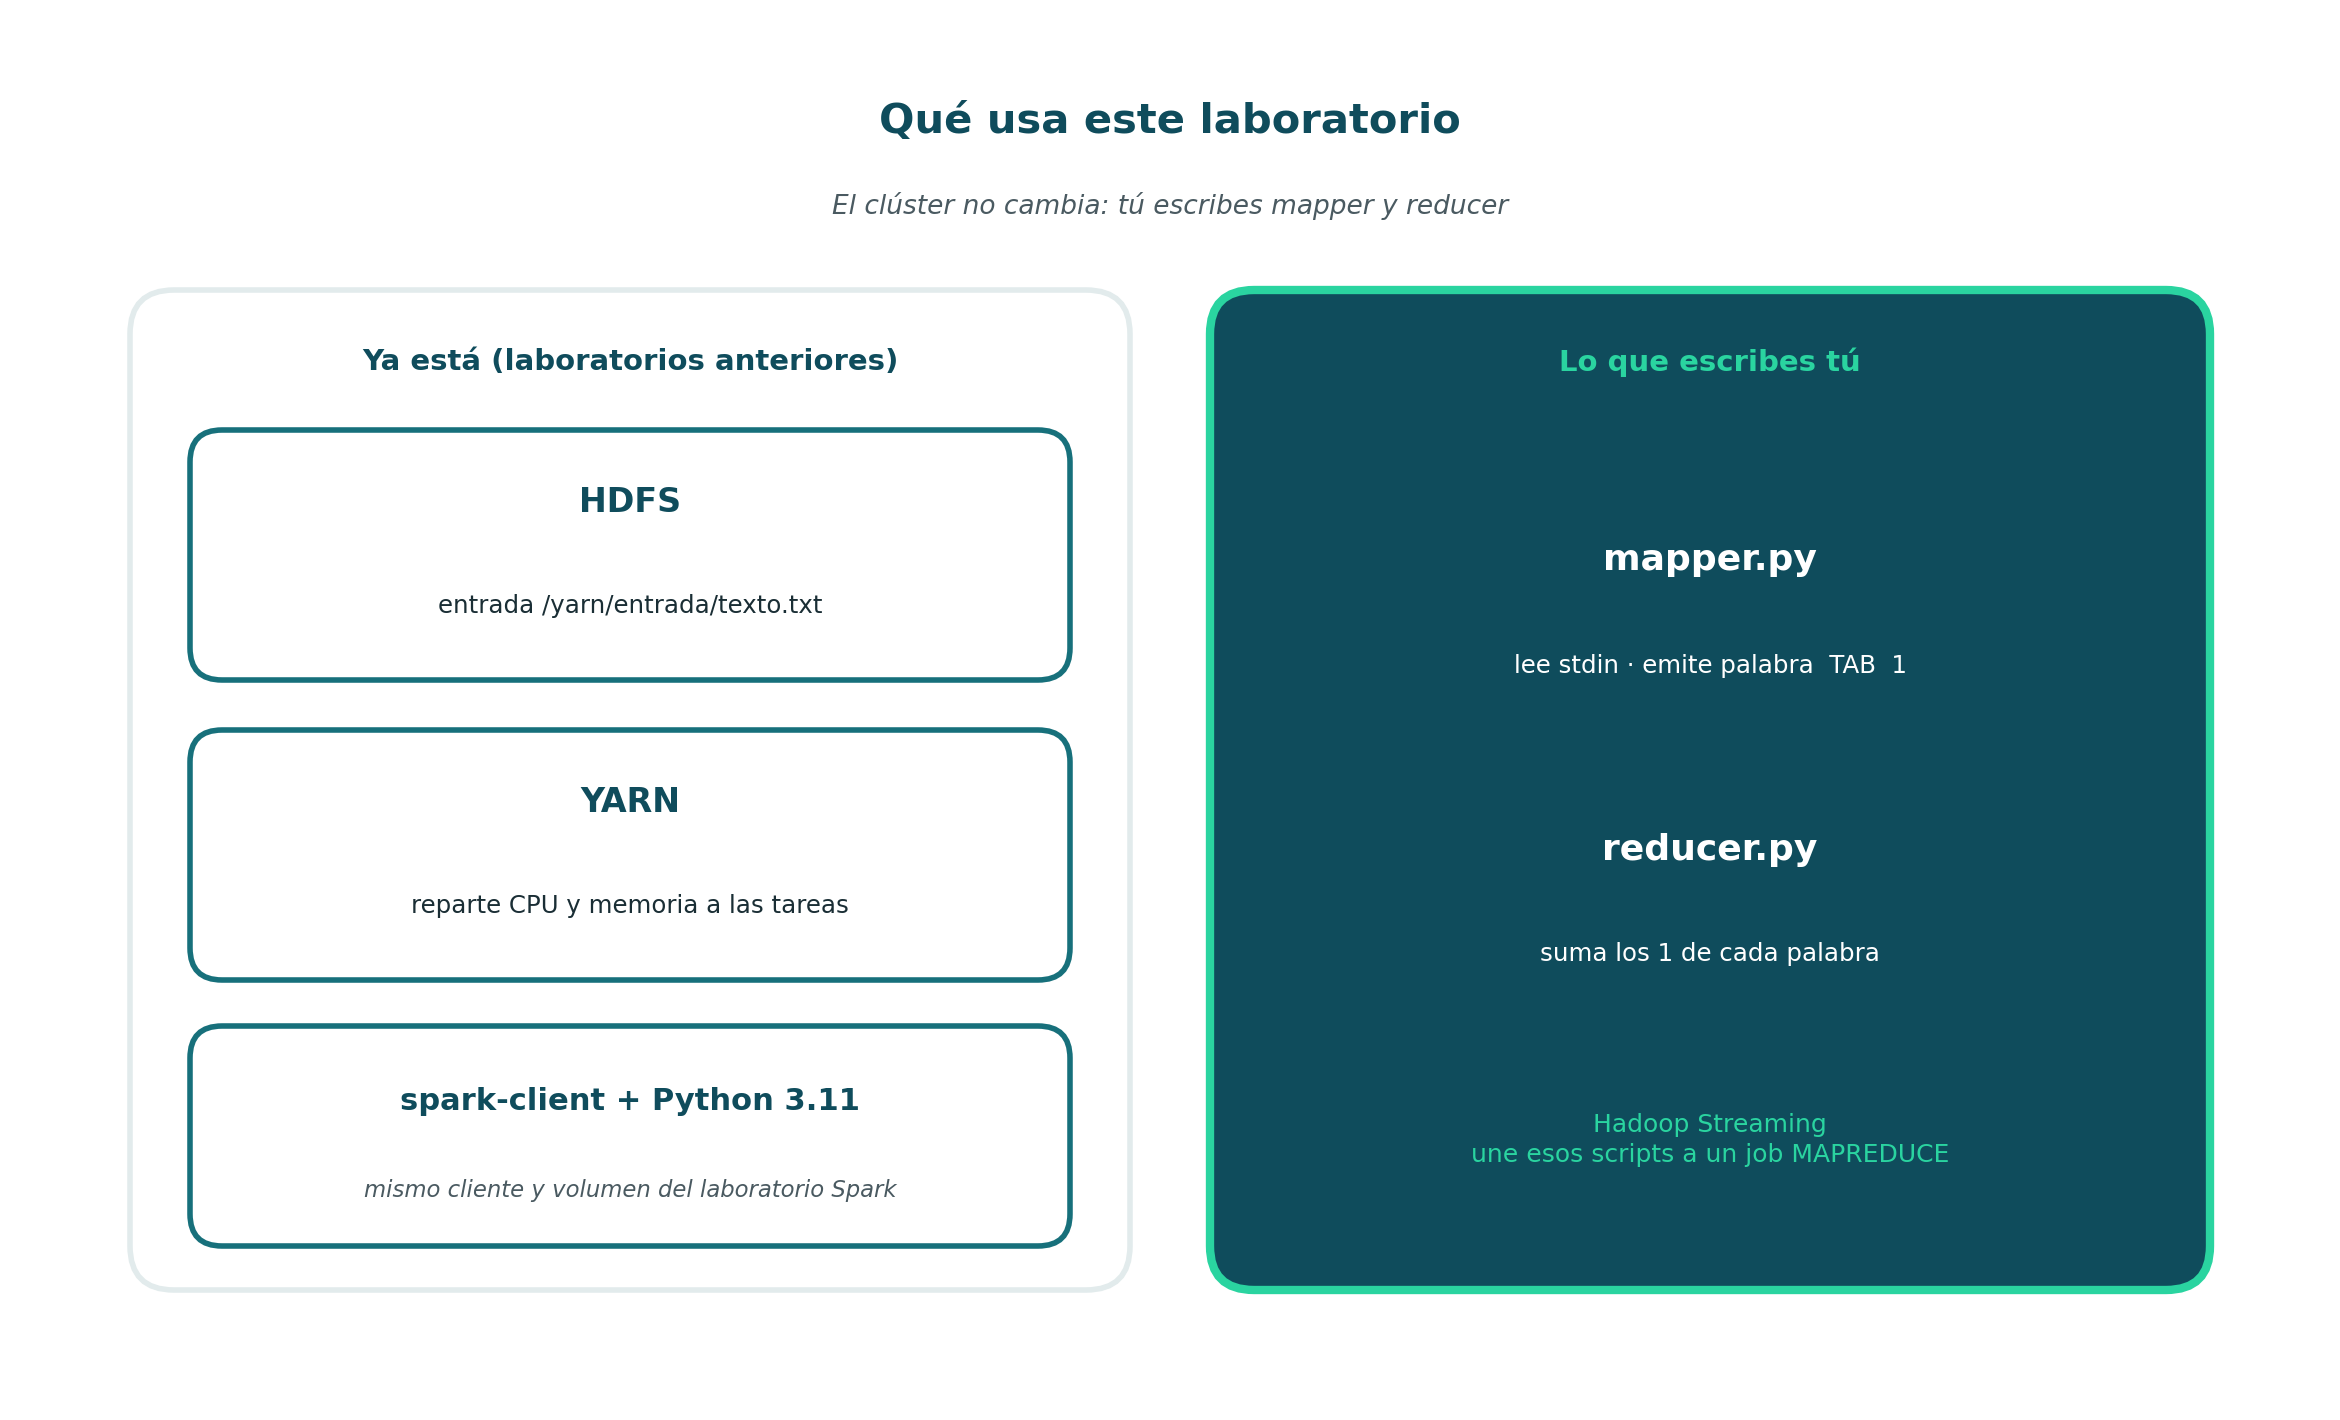
Figura 1. HDFS guarda. YARN reparte hardware. MapReduce es el motor: tú (o un JAR de ejemplos) defines qué se calcula; el clúster decide dónde y con cuánto.
El tipo MAPREDUCE que viste en el portal durante el laboratorio de YARN era este motor.
Parte 2 — Map, shuffle, reduce
Tres fases. Los nombres volverán a aparecer en Spark, con otro motor.
Map. Un programa —el mapper— lee un split (un trozo de entrada, normalmente alineado con un bloque de HDFS) y emite pares clave-valor. Un par clave-valor es el átomo del modelo: una clave (por qué se agrupará) y un valor (qué se agregará). En un wordcount la clave es la palabra y el valor es 1, una aparición. El mapper no suma el archivo entero: declara apariciones, una por una.
Shuffle. Hadoop ordena esos pares por clave y reúne los que coinciden. Todas las apariciones de una misma clave terminan en el mismo reducer, vengan del nodo que vengan. Esta fase mueve datos por la red; por eso suele ser la más cara.
Reduce. Un programa —el reducer— recibe una clave con la lista de valores que le tocó y emite el resultado. En el wordcount, la suma de los 1.
Con el texto de cuatro líneas que usan los laboratorios, el recorrido se puede seguir a mano:
hadoop hdfs yarn
hadoop mapreduce yarn
spark hadoop datos
yarn datos datos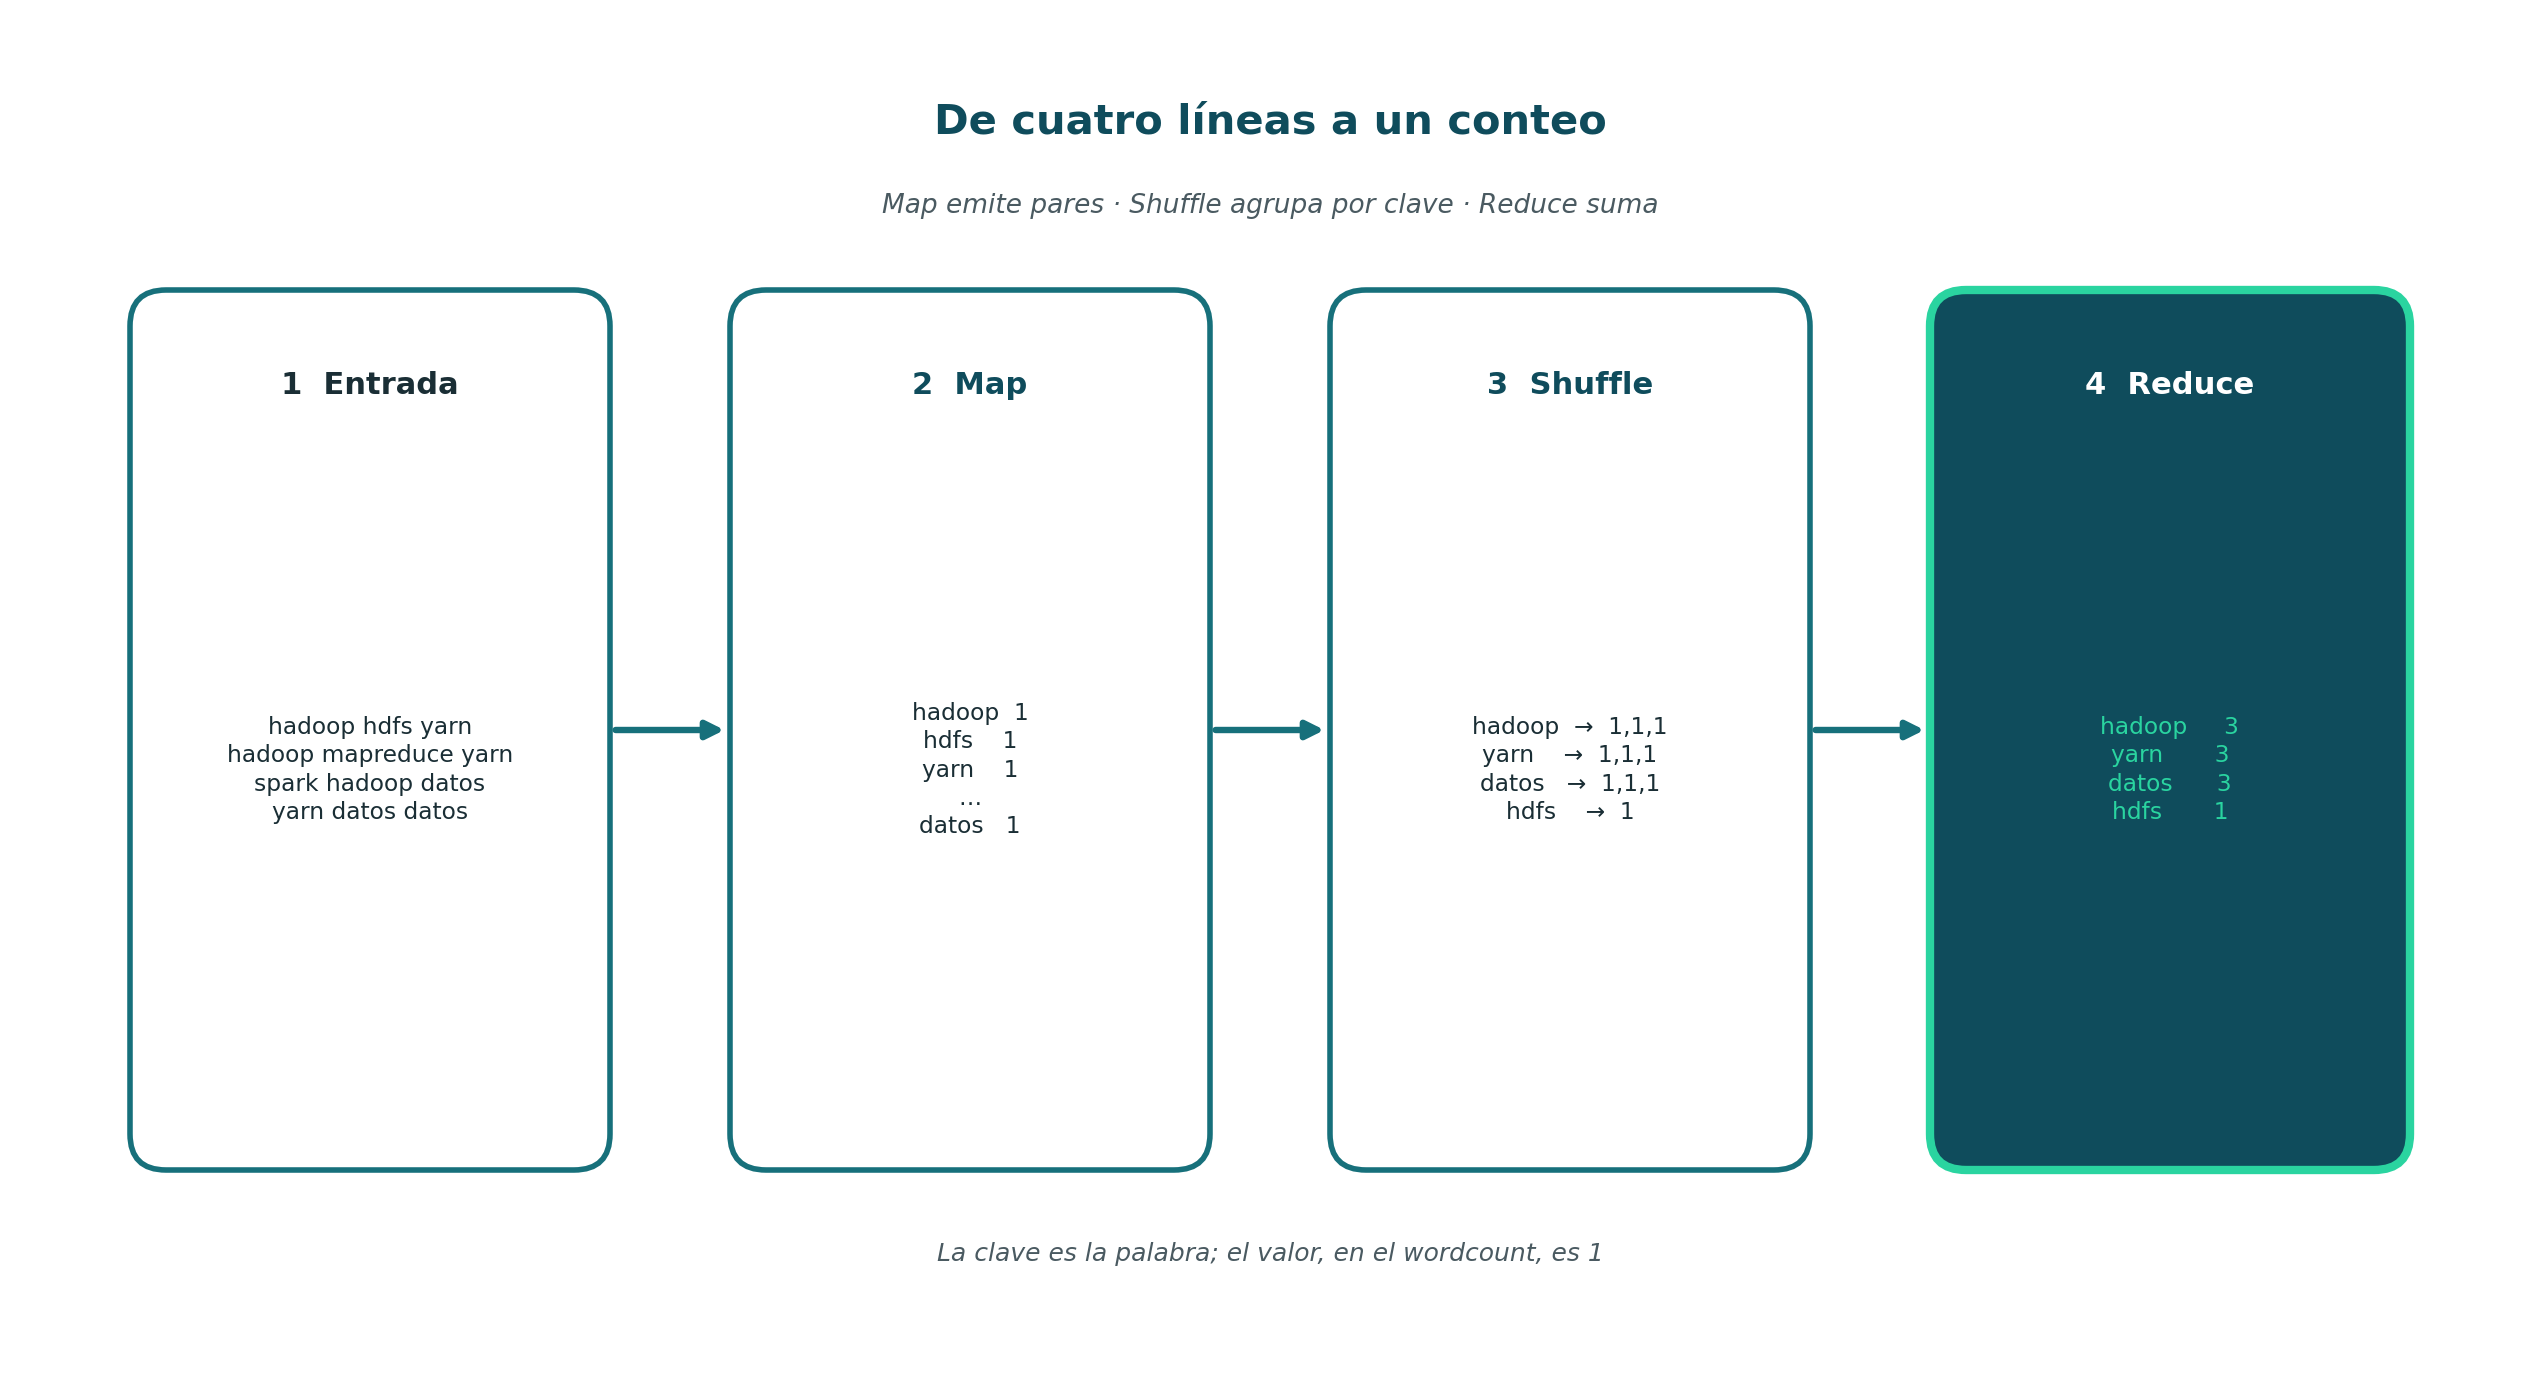
Figura 2. Map emite palabra TAB 1. Shuffle agrupa. Reduce suma. Resultado: hadoop 3, yarn 3, datos 3, hdfs 1, mapreduce 1, spark 1.
En Dominando la terminal para Big Data ya usaste el mismo enfoque en una sola máquina:
tr ' ' '\n' < texto.txt | sort | uniq -ctr parte cada línea y emite una palabra por aparición (map). sort reúne las palabras iguales (shuffle). uniq -c cuenta cada grupo (reduce). Hadoop MapReduce es esa tubería repartida entre nodos, con HDFS en los dos extremos: se lee de HDFS y se escribe en HDFS. Y la lección de aquel capítulo sigue valiendo: sin el paso que agrupa por clave, la agregación sale mal.
Parte 3 — El trabajo sobre YARN
MapReduce no sustituye a YARN. Un trabajo MapReduce es una aplicación YARN más, de tipo MAPREDUCE en el portal. El ResourceManager concede contenedores; el ApplicationMaster de esta aplicación coordina las tareas map y reduce.
Conviene separar dos usos de la palabra contenedor:
| Término | Qué es |
|---|---|
| Contenedor Docker | El proceso aislado que ya tenías (namenode, datanode1, resourcemanager…). Enviar un trabajo no crea uno nuevo. |
| Contenedor YARN | Una reserva de CPU y memoria dentro de un NodeManager para una tarea map o reduce. |
El recorrido de un trabajo:
- El cliente Hadoop (en los laboratorios, el contenedor
namenode) envía el trabajo al ResourceManager. - YARN arranca el ApplicationMaster de MapReduce en un contenedor.
- El ApplicationMaster calcula los splits de la entrada y pide un contenedor por tarea map, preferiblemente en los nodos que tienen esos bloques.
- Las tareas map leen sus splits de HDFS y emiten pares.
- El shuffle reparte los pares por clave entre las tareas reduce.
- Las tareas reduce escriben en HDFS un archivo
part-*cada una y, si todo salió bien, un marcador vacío_SUCCESS.
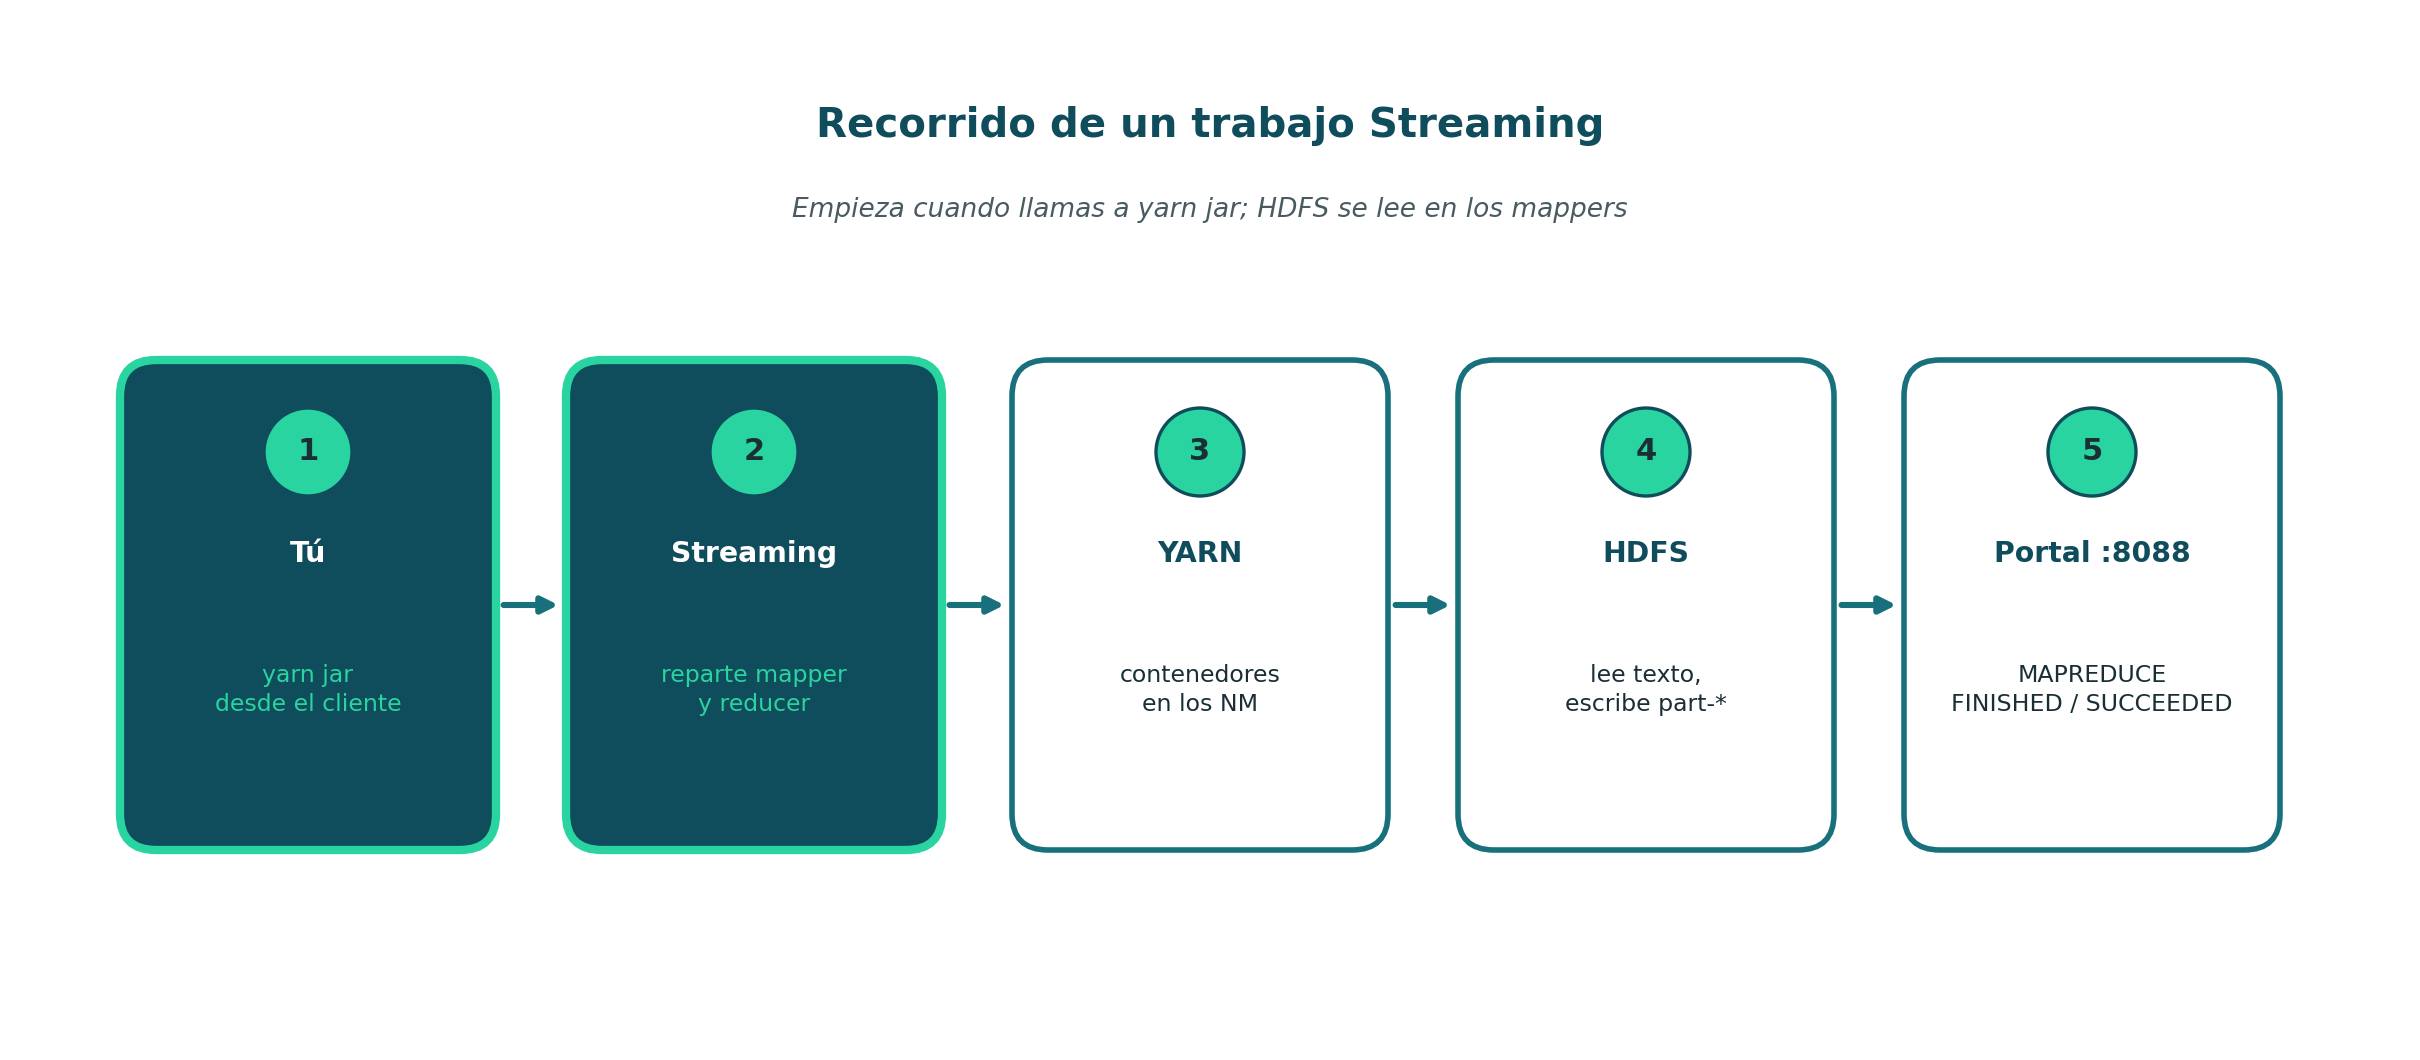
Figura 3. El trabajo empieza en el cliente. YARN lanza las tareas. HDFS se lee en el map y se escribe en el reduce. El portal :8088 muestra una aplicación de tipo MAPREDUCE.
Reducers, particionador y combiner
Número de reducers. Es cuántas tareas reduce pide el trabajo, no cuántas funciones hay en el código. Un reducer produce un part-*; varios reducers, varios part-*. El particionador (partitioner) decide, a partir de la clave, a qué reducer va cada par; por defecto usa un hash de la clave. Por eso una clave nunca aparece en dos archivos de salida, y leer un solo part-* cuando hubo varios reducers da un resultado incompleto.
Combiner. Es un mini-reducer opcional que Hadoop ejecuta después del map, en el mismo nodo, para agregar localmente y recortar lo que viaja por la red en el shuffle. Solo es correcto si la operación se puede aplicar por partes sin cambiar el resultado. Sumar cuentas sí: sumar subtotales da el mismo total. Promediar promedios no: el promedio de 20 y 50 no es el promedio de 10, 30 y 50. Para un promedio hay que propagar (suma, cantidad) y dividir solo al final. Lo practicarás en el taller.
Parte 4 — Hadoop Streaming: el mismo modelo, otro lenguaje
El motor MapReduce de Hadoop está escrito en Java y, en su uso clásico, el programa del usuario también es una clase Java. Hadoop Streaming es un JAR que permite usar el mismo modelo con cualquier programa que lea la entrada estándar y escriba la salida estándar. El JAR no cuenta palabras: adapta stdin y stdout al trabajo. Cada línea que tu mapper imprime con el formato clave<TAB>valor se convierte en un par; Hadoop ordena por clave y entrega esas líneas al reducer, también por stdin.
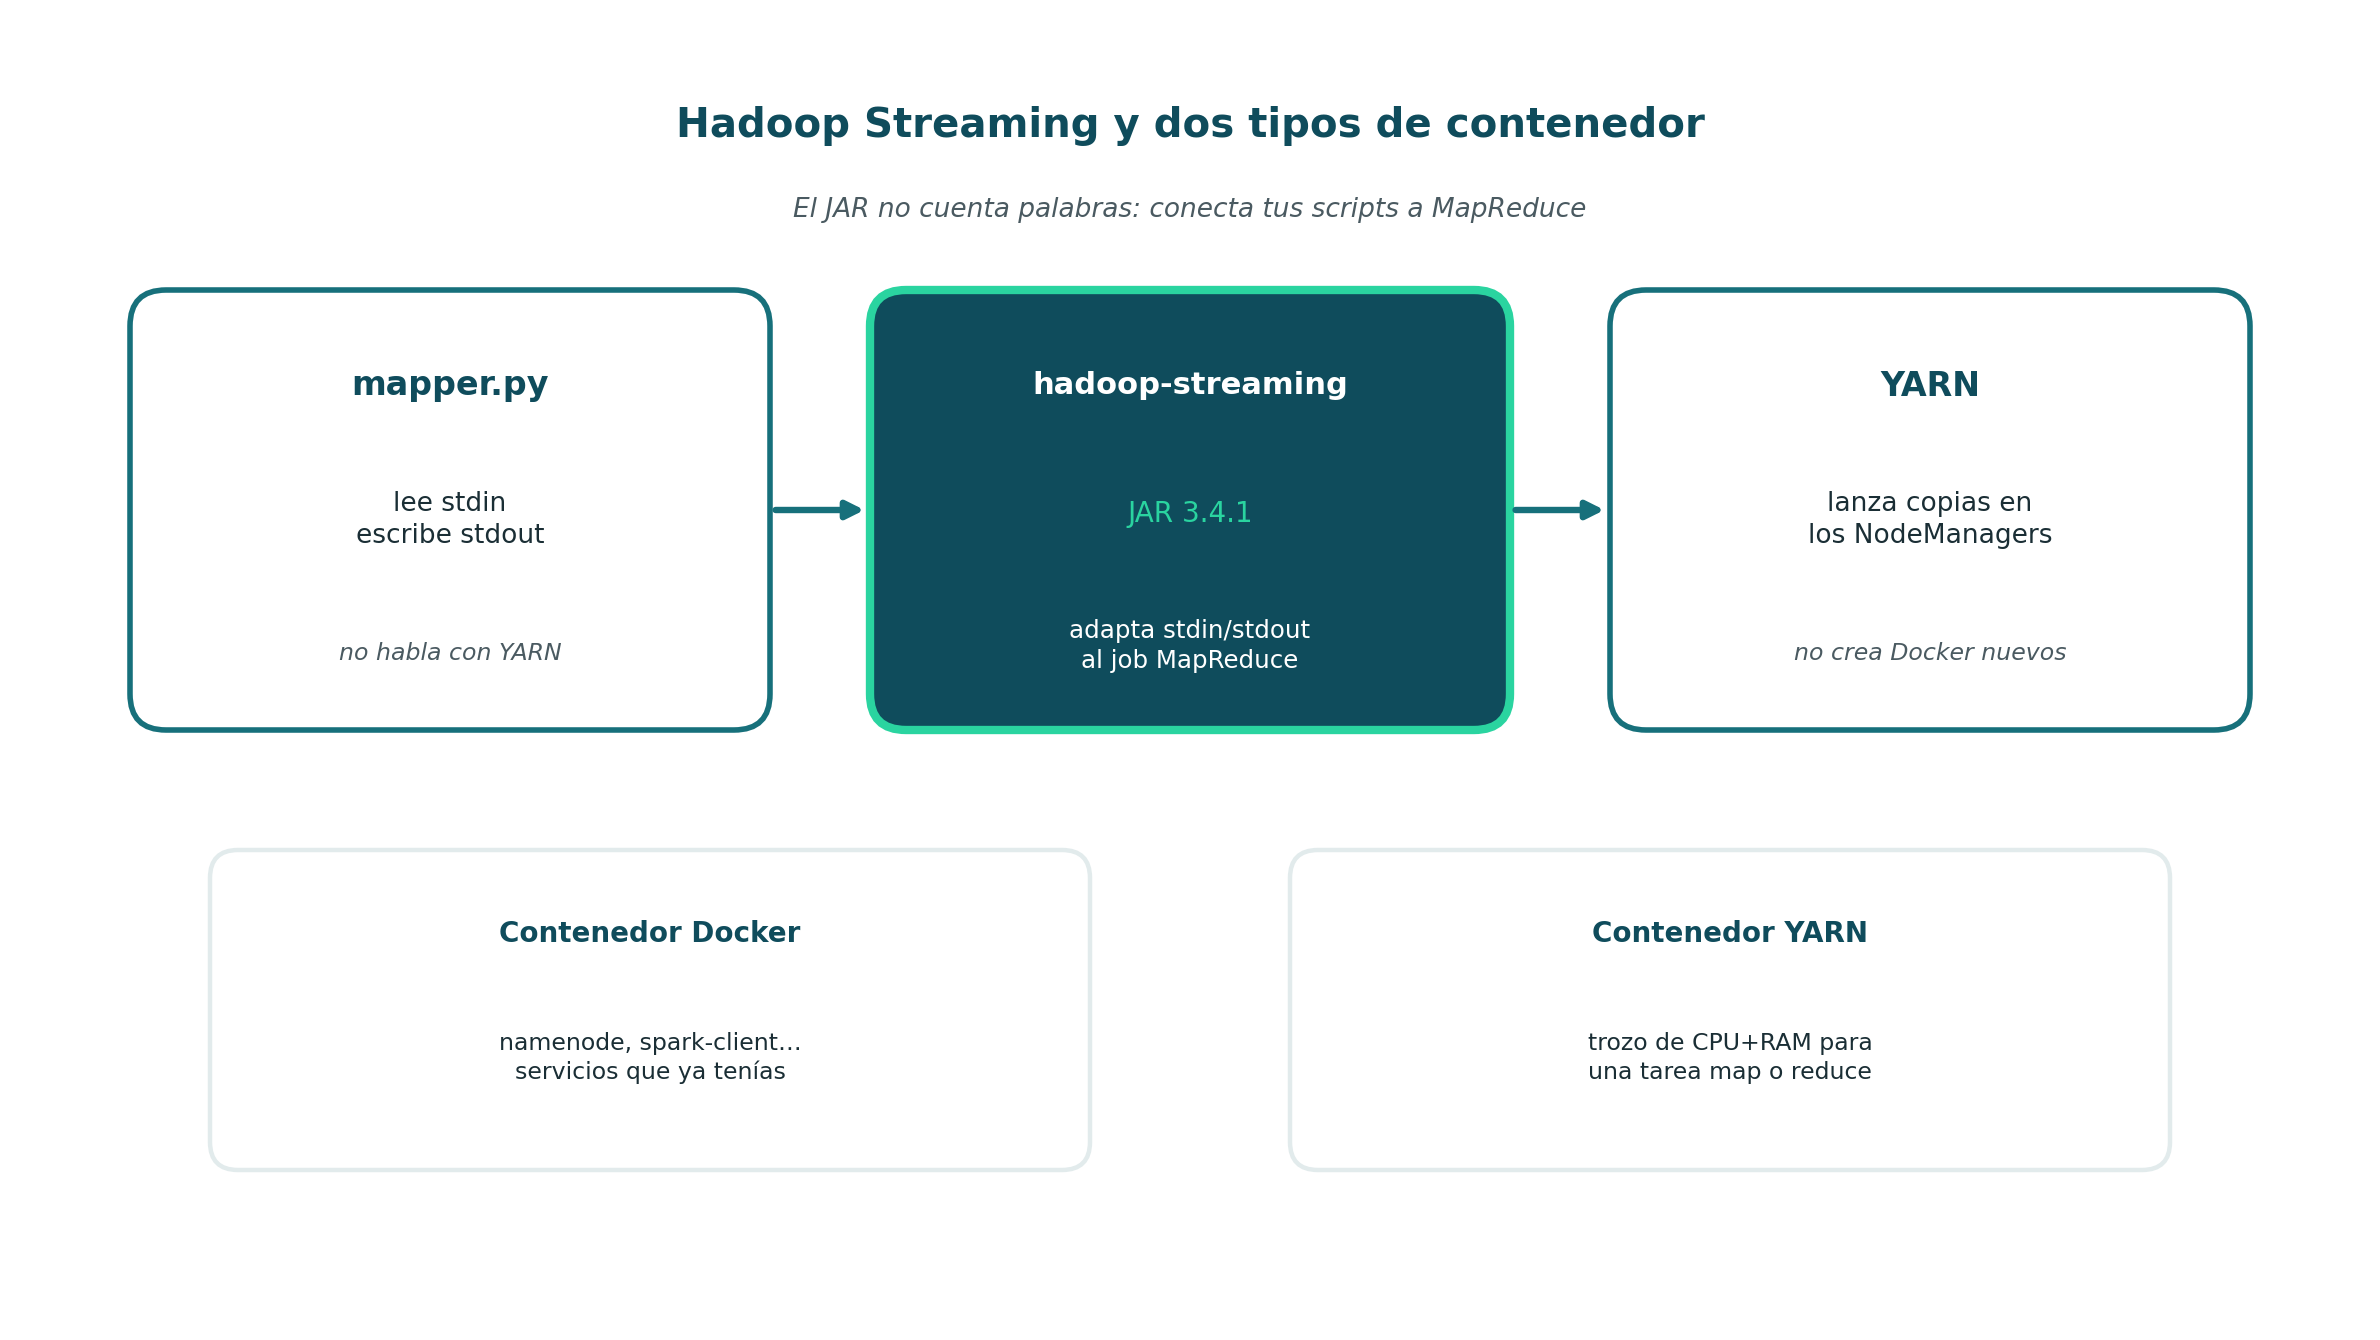
Figura 4. A la izquierda, programas que no hablan con YARN. En el medio, el JAR de Streaming. A la derecha, YARN. Abajo: contenedor Docker ≠ contenedor YARN.
Es el puente natural con la terminal: si un programa sirve en una tubería de Bash, sirve como mapper o reducer de Streaming. En el taller escribirás mapper.py y reducer.py con ese contrato, los probarás primero en una sola máquina y después los enviarás al clúster.
Parte 5 — El modelo en el clúster: leer los contadores
En el laboratorio de YARN ya enviaste dos trabajos de ejemplo: pi, que no lee archivos y solo combina resultados de tareas map, y wordcount. No hace falta repetir pi. Vuelve a lanzar el wordcount, esta vez para mirar algo que en aquel laboratorio pasó de largo: los contadores que Hadoop imprime al terminar. Son la evidencia numérica de cada fase.
Levanta el clúster y confirma que la entrada existe:
cd ~/hdfs-docker-lab
dc() { docker compose -f compose.yaml -f compose.spark.yaml "$@"; }
dc up -d
dc exec namenode hdfs dfsadmin -safemode wait
dc exec namenode yarn node -list
dc exec namenode hdfs dfs -cat /yarn/entrada/texto.txt
Debes ver Safe mode is OFF, dos NodeManagers RUNNING y las cuatro líneas del texto. El aviso de log4j se puede ignorar. Si falta el archivo, créalo con el paso 8 del laboratorio de YARN.
Usa
dc, nodocker composea secas. Desde el Laboratorio: cliente Spark, el clúster se define con dos archivos:compose.yaml(HDFS y YARN) ycompose.spark.yaml(el cliente y el Python montado en los NodeManagers).docker compose up -dsin el segundo archivo recrearía los NodeManagers sin ese Python, sin mostrar ningún error, y el Taller de MapReduce Streaming fallaría conCannot run program "/opt/python/bin/python3".Si justo después de
dc up -dvesConnection refusedoTotal Nodes:0, los servicios todavía están arrancando: espera unos segundos y repite el comando.
MapReduce no escribe sobre un directorio que ya existe, así que primero se borra la salida de una corrida anterior:
dc exec namenode hdfs dfs -rm -r -f /yarn/teoria_mr_wc
dc exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  wordcount /yarn/entrada/texto.txt /yarn/teoria_mr_wc
dc exec namenode hdfs dfs -cat /yarn/teoria_mr_wc/part-r-00000
Salida esperada del archivo de resultados (el ejemplo Java usa el prefijo part-r-):
datos   3
hadoop  3
hdfs    1
mapreduce   1
spark   1
yarn    3
Ahora sube en la salida de yarn jar hasta el bloque Map-Reduce Framework. Entre muchos contadores, busca estos:
| Contador | Valor esperado | Qué demuestra |
|---|---|---|
Map input records |
4 | El mapper leyó las cuatro líneas |
Map output records |
12 | Emitió un par por palabra: 12 apariciones |
Combine input records |
12 | El combiner recibió los 12 pares en el nodo del map |
Combine output records |
6 | Los redujo a uno por palabra antes del shuffle |
Reduce input groups |
6 | Llegaron 6 claves distintas al reducer |
Reduce output records |
6 | Se escribió una línea por clave |
El ejemplo wordcount de Hadoop configura un combiner, y estos contadores lo muestran: de 12 pares solo 6 cruzaron el shuffle. Con un archivo de cuatro líneas el ahorro es anecdótico; con terabytes, es la diferencia entre saturar la red o no. En el portal http://localhost:8088 verás una nueva aplicación MAPREDUCE llamada word count.
| Dónde mirar | Qué confirma |
|---|---|
map 100% reduce 100% en la terminal |
Las dos fases del modelo ocurrieron |
Tipo MAPREDUCE en :8088 |
Es el motor de este capítulo, no Spark |
Contadores Map output y Reduce input groups |
Cuántos pares se emitieron y cuántas claves llegaron agrupadas |
Un solo part-r-00000 |
Hubo un reducer y, por tanto, un archivo con todas las claves |
Para apagar sin borrar datos: dc stop.
Parte 6 — Qué no es MapReduce (y qué viene después)
| No es | Porque |
|---|---|
| HDFS | HDFS guarda bloques; MapReduce los lee y escribe |
| YARN | YARN concede CPU y memoria; MapReduce las usa en tareas map y reduce |
| Un contenedor Docker | El cálculo vive en contenedores YARN dentro de los NodeManagers |
| Spark | Spark también corre sobre YARN, pero su modelo de ejecución es otro: un grafo de etapas, más de un paso por trabajo y la opción de conservar datos en memoria |
Límites del enfoque. Un trabajo MapReduce es, en lo esencial, un map seguido de un reduce, con el shuffle en medio. Encadenar varios pasos —filtrar, agrupar, unir con otra tabla, volver a agrupar— exige varios trabajos y escribir en HDFS entre uno y otro. Cada escritura intermedia cuesta disco, red y tiempo. Esa limitación es la que motivó a Spark.
Spark no invalida MapReduce como idea: reduceByKey, groupBy y el shuffle de Spark son parientes directos de estas tres fases. Por eso MapReduce va antes de Spark y de PySpark en el libro: primero el modelo, después el motor que lo generaliza.
Preguntas de comprensión
- Un trabajo tuvo tres reducers. ¿Cuántos archivos
part-*esperas y qué pasa si lees solo uno? - ¿Por qué un combiner es correcto para contar palabras y no para calcular un promedio directamente?
- En la Parte 5,
Map output recordsfue 12 yReduce input groupsfue 6. ¿Qué representa cada número?
Orientaciones. Tres archivos, uno por reducer; leer uno solo omite las claves que el particionador mandó a los otros dos. Sumar subtotales da el mismo total, pero promediar promedios pierde el peso de cada grupo; hay que propagar suma y cantidad. El 12 son las apariciones emitidas por el mapper; el 6 son las claves distintas que llegaron agrupadas al reducer.
Referencias para profundizar
- Jeffrey Dean y Sanjay Ghemawat, MapReduce: Simplified Data Processing on Large Clusters (2004).
- Apache Hadoop, MapReduce Tutorial (3.4.1).
- Apache Hadoop, Hadoop Streaming (3.4.1).
Resumen
En este capítulo aprendiste:
- Que MapReduce responde cómo se calcula en paralelo sobre datos ya guardados, no dónde se guardan (HDFS) ni quién reparte el hardware (YARN).
- Las tres fases: el mapper emite pares clave-valor, el shuffle agrupa por clave y el reducer combina cada grupo.
- Que el wordcount es la tubería
tr | sort | uniq -crepartida entre nodos, con HDFS en la entrada y la salida. - Que un trabajo MapReduce es una aplicación YARN y que contenedor Docker y contenedor YARN no son lo mismo.
- El papel del particionador, del número de reducers y del combiner, y cuándo un combiner es correcto.
- Que Hadoop Streaming permite escribir mapper y reducer en cualquier lenguaje que lea
stdiny escribastdout. - A leer los contadores de un trabajo como evidencia de cada fase.
En el siguiente capítulo, el Taller de MapReduce Streaming, escribirás tu propio mapper y reducer en Python, los probarás en el cliente y los enviarás al clúster.