12 Spark: el motor de procesamiento sobre YARN
Un DAG de etapas en lugar de un solo map-reduce
En este capítulo vas a entender qué pregunta responde Apache Spark, en qué se diferencia de MapReduce y cómo se reparte el trabajo entre driver y executors cuando corre sobre YARN. El centro es el enfoque: un grafo acíclico dirigido (DAG) de etapas, evaluación perezosa, recuperación de fallos por linaje y una aplicación que puede encadenar muchos pasos sin volver a HDFS entre cada uno.
Tiempo estimado de lectura: 30 minutos
Nivel: Intermedio
Conocimientos previos recomendados:
- El clúster de los laboratorios: HDFS, YARN y el cliente Spark, donde ya enviaste SparkPi
- MapReduce: map, shuffle, reduce y el tipo
MAPREDUCEen el portal
Tecnologías mencionadas:
- Apache Spark 3.5 (driver, executors, SparkContext, RDD, DataFrame)
- YARN como gestor de recursos (modo client y modo cluster)
- Spark SQL, Structured Streaming y MLlib, a nivel de mapa
- MapReduce, como contraste
MapReduce responde cómo calcular en paralelo con una receta rígida: un map, un shuffle, un reduce y un vuelco a HDFS. Eso funciona. También se vuelve incómodo cuando el análisis es una cadena —filtrar, agregar, unir con otra tabla, volver a filtrar— porque cada eslabón es otro trabajo que escribe en disco y el siguiente vuelve a leer.
Spark es otro motor de procesamiento sobre el mismo HDFS y el mismo YARN. No sustituye al NameNode ni al ResourceManager. Cambia cómo se describe y se ejecuta el cálculo: una sola aplicación puede tener muchos pasos, el motor arma un plan antes de tocar los datos y los resultados intermedios pueden quedarse en memoria.
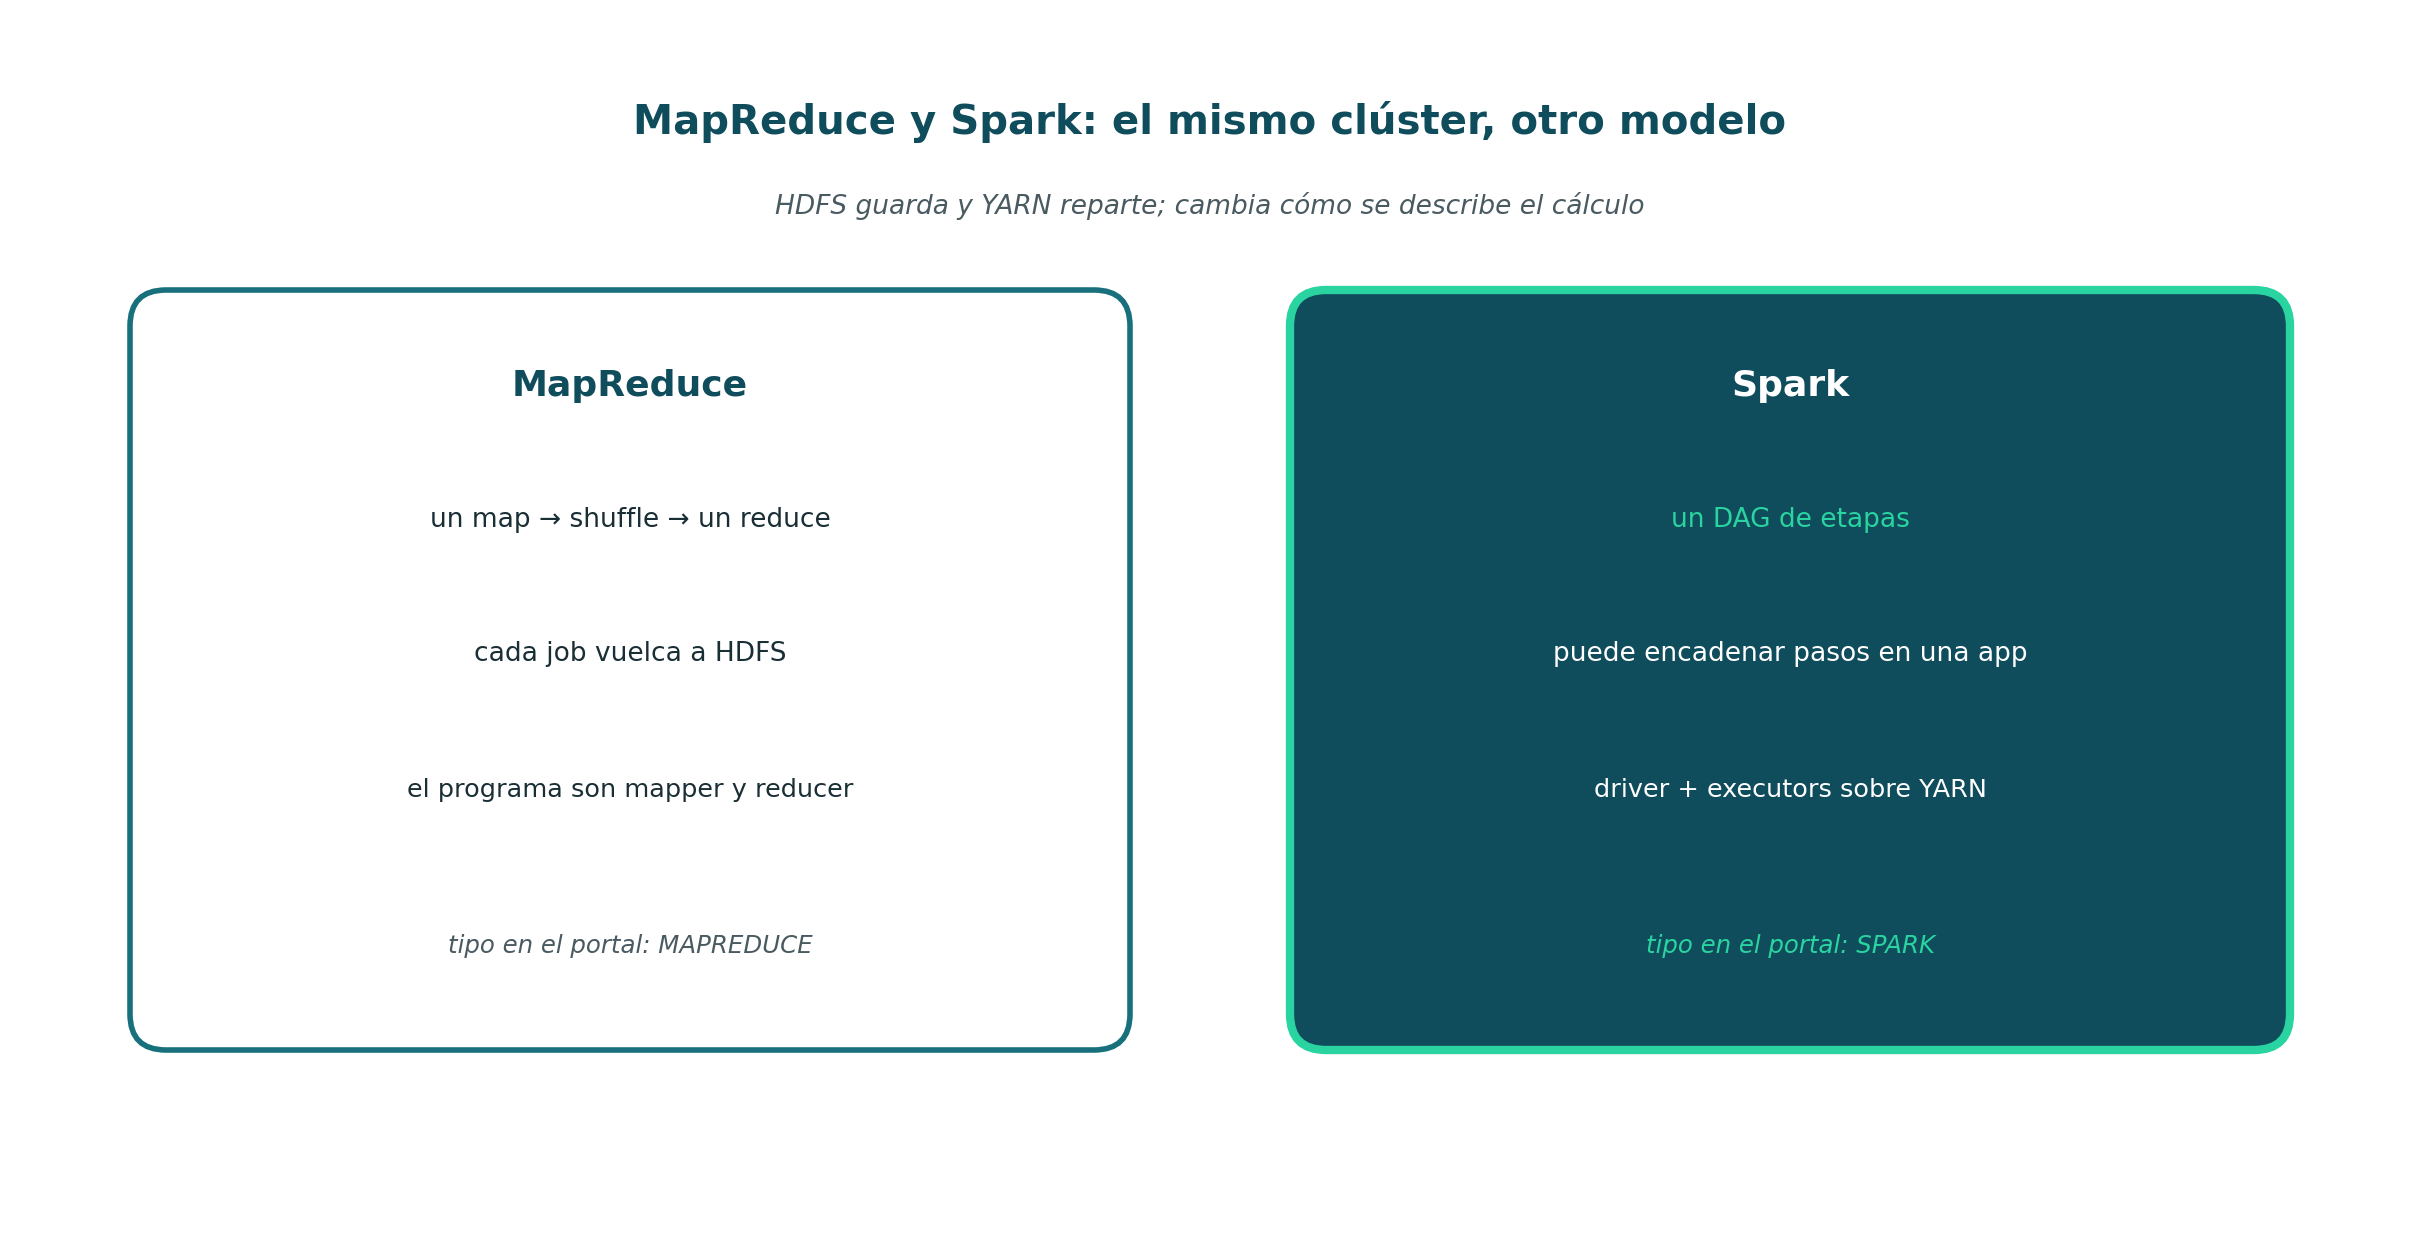
Figura 1. HDFS y YARN no cambian. Cambia el modelo: tres fases fijas frente a un DAG. En el portal, el tipo pasa de MAPREDUCE a SPARK.
Parte 1 — De dónde viene Spark
Spark nació en 2009 en el AMPLab de la Universidad de California en Berkeley, como proyecto de investigación de Matei Zaharia y su grupo. El problema que querían resolver era concreto: los algoritmos de machine learning y el análisis interactivo recorren los mismos datos muchas veces, y con MapReduce cada pasada significaba leer y escribir en disco. La idea central fue una abstracción que permitiera reutilizar datos en memoria entre pasos sin perder la tolerancia a fallos que hacía valioso a MapReduce.
Ese trabajo se publicó en 2012 como el artículo científico de los RDD (Resilient Distributed Datasets). El proyecto pasó a la Apache Software Foundation en 2013, se convirtió en proyecto de primer nivel en 2014 y ese mismo año publicó la versión 1.0. Desde entonces su evolución ha ido de una API de bajo nivel a un motor centrado en tablas:
| Versión | Año | Qué aportó, a grandes rasgos |
|---|---|---|
| 1.x | 2014–2015 | RDD; primeras versiones de Spark SQL y DataFrame |
| 2.x | 2016–2018 | SparkSession como punto de entrada único; Structured Streaming |
| 3.x | 2020–2023 | Ejecución adaptativa de consultas (AQE); la rama 3.5 es de soporte extendido |
| 4.x | desde 2025 | Nueva generación; Spark Connect y SQL como protagonistas |
Los laboratorios de este libro usan Spark 3.5.3. La rama 3.5 tiene soporte extendido y es la que todavía se encuentra en muchas plataformas en producción; todo lo que verás aquí aplica igual en 4.x.
¿Para qué sirve esta historia? Para entender el diseño: Spark existe para que un cálculo con muchos pasos no pague disco en cada uno, sin renunciar a sobrevivir a la caída de un nodo.
Parte 2 — Driver y executors sobre YARN
Spark no instala un clúster paralelo al de Hadoop. Le pide contenedores a YARN, el mismo de los laboratorios.
El driver es el proceso que ejecuta tu programa: arma el plan, pide recursos, reparte tareas y recoge resultados. Dentro del driver vive el SparkContext, el objeto que representa la conexión con el clúster; en Python lo usarás casi siempre a través de la SparkSession, que lo envuelve.
Los executors son los procesos que ejecutan las tareas y guardan los datos en caché. YARN los lanza como contenedores YARN dentro de los NodeManagers; no son contenedores Docker nuevos. Cada executor tiene una cantidad fija de memoria y de núcleos, y vive mientras vive la aplicación.
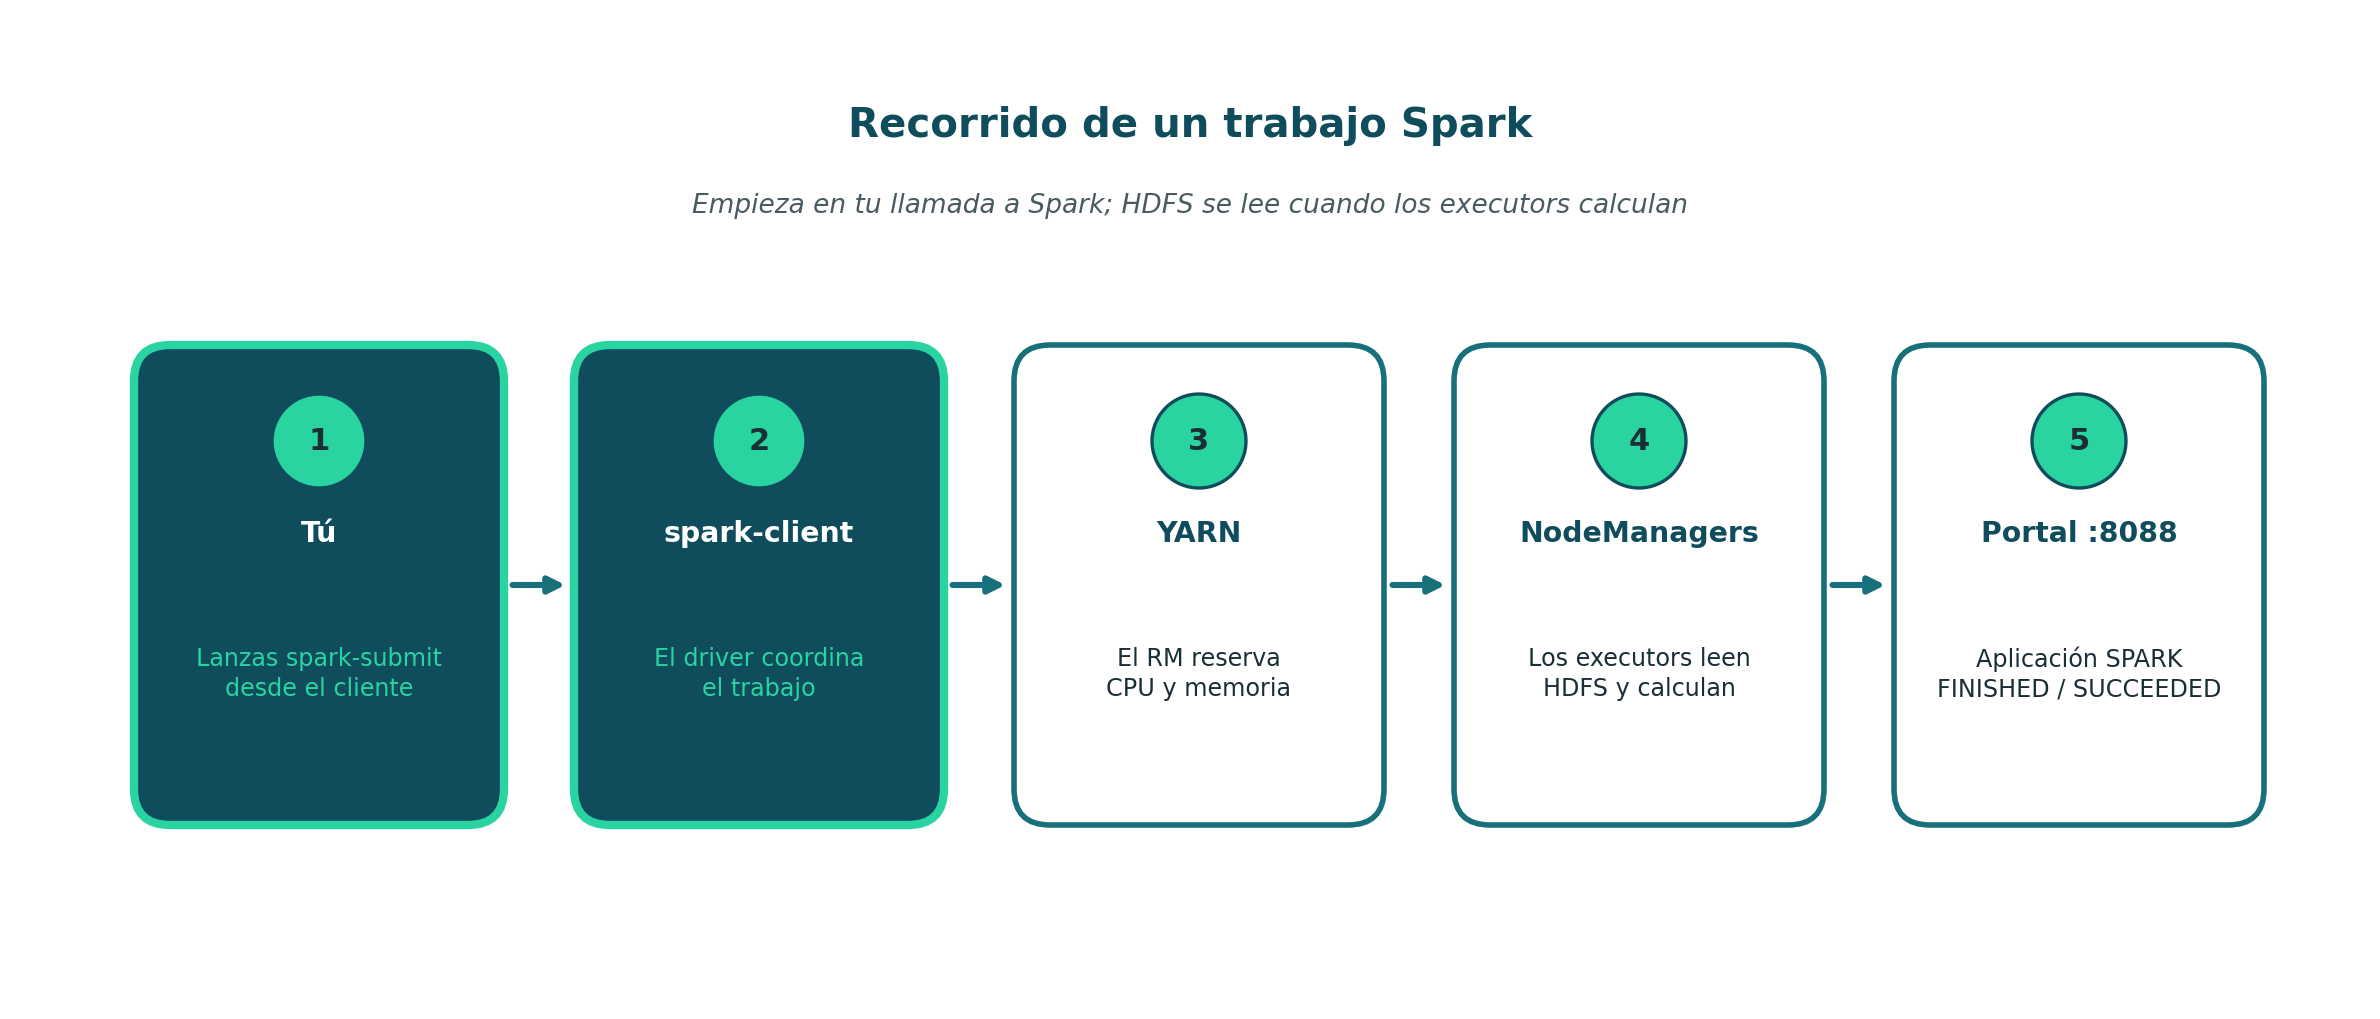
Figura 2. Empieza en tu llamada a Spark. El driver coordina; YARN reparte; los executors leen HDFS. El portal muestra tipo SPARK.
Modo client y modo cluster
Sobre YARN, el driver puede vivir en dos sitios:
| Modo | Dónde vive el driver | Cuándo se usa |
|---|---|---|
| client | En el proceso que lanzó la aplicación (en los laboratorios, spark-client) |
Trabajo interactivo: Jupyter, pyspark, depuración. Si cierras el cliente, la aplicación muere |
| cluster | Dentro del ApplicationMaster, en un contenedor YARN | Trabajos programados en producción: el cliente envía y puede desconectarse |
Los laboratorios usan modo client porque Jupyter necesita el driver en el mismo proceso que el kernel. Por la misma razón el hostname spark-client debe ser alcanzable desde los NodeManagers: los executors le devuelven datos y estado.
YARN no es el único gestor
Spark puede pedir recursos a varios gestores: su propio modo standalone (el mini-clúster del capítulo de Docker), YARN y Kubernetes. El programa no cambia; cambia el valor de --master. Esa independencia es la razón por la que Spark sobrevivió a la migración a la nube mejor que el resto del ecosistema Hadoop.
Parte 3 — RDD: la abstracción de base
Un RDD (Resilient Distributed Dataset) es una colección de elementos distribuida en particiones y de solo lectura. Cada partición vive en un executor y se procesa con una tarea. No modificas un RDD: aplicas una operación y obtienes uno nuevo.
Hoy casi nadie programa directamente con RDD; la API habitual son los DataFrames, que verás en el capítulo de PySpark. Pero los DataFrames se ejecutan sobre la misma maquinaria, y tres ideas del RDD explican casi todo el comportamiento de Spark: particiones, evaluación perezosa y linaje.
Particiones: la unidad de paralelismo
Una partición es un trozo de los datos que se procesa en una sola tarea. Al leer de HDFS, Spark crea en general una partición por bloque, igual que MapReduce crea un split por bloque. El número de particiones decide cuántas tareas pueden correr a la vez:
- Muy pocas particiones desaprovechan el clúster: dos particiones en un clúster con veinte núcleos dejan dieciocho ociosos.
- Demasiadas particiones pequeñas cuestan más en coordinación que en cálculo.
La regla práctica es tener al menos dos o tres particiones por núcleo disponible. En los laboratorios, con dos executors de un núcleo, un archivo pequeño tendrá una o dos particiones, y eso basta.
Transformaciones y acciones: la evaluación perezosa
Las operaciones de Spark son de dos clases:
- Una transformación (
map,filter,flatMap,reduceByKey,join…) describe un dato nuevo a partir de otro. No calcula nada: añade un paso al plan. - Una acción (
count,collect,take,saveAsTextFile…) pide un resultado. Ahí Spark ejecuta el plan.
Eso se llama evaluación perezosa (lazy evaluation). Tiene una ventaja que MapReduce no podía ofrecer: como Spark ve el plan completo antes de ejecutar, puede fusionar pasos que no necesitan reagrupar datos y ejecutarlos de una sola pasada sobre cada partición.
Linaje: tolerancia a fallos sin replicar los datos
Cada RDD recuerda de qué RDD salió y con qué operación. Esa cadena se llama linaje (lineage). Si un executor muere y con él se pierde una partición, Spark no necesita una copia guardada: vuelve a ejecutar las operaciones del linaje solo para esa partición, a partir de los datos de origen en HDFS.
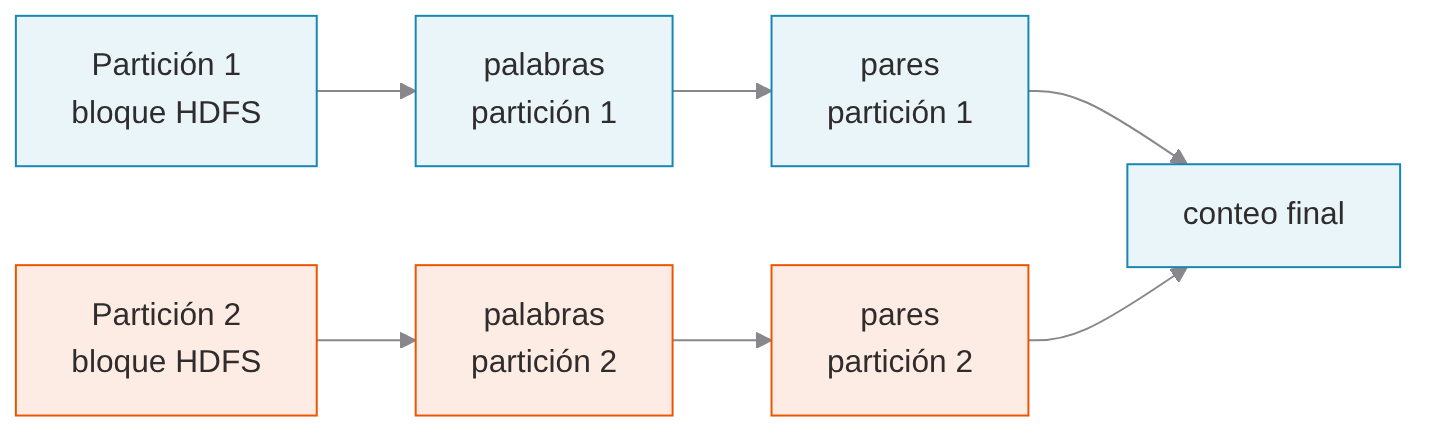
Figura 3. Si se pierde la partición 2 (resaltada), Spark la recalcula siguiendo su linaje desde el bloque de HDFS. La partición 1 no se toca.
Es la “R” de RDD, resilient. HDFS protege los datos guardando tres copias; Spark protege los cálculos guardando la receta. Las dos ideas se complementan: el linaje funciona porque el origen está a salvo en HDFS.
Parte 4 — Del DAG a las etapas: dependencias estrechas y anchas
Cuando llega una acción, el driver convierte el plan en un DAG (directed acyclic graph, grafo acíclico dirigido): pasos unidos por flechas que nunca vuelven atrás. Luego lo corta en etapas (stages). Dónde corta depende del tipo de dependencia entre un paso y el siguiente:
- Dependencia estrecha (narrow): cada partición del resultado depende de una sola partición de la entrada.
map,filteryflatMapson estrechas: cada partición se transforma por su cuenta, en el mismo executor, sin red. - Dependencia ancha (wide): una partición del resultado necesita datos de muchas particiones de la entrada.
reduceByKey,groupByKey,joinydistinctson anchas: hay que reunir todas las apariciones de cada clave, lo que exige un shuffle, el mismo movimiento por la red que en MapReduce.
Spark agrupa todas las dependencias estrechas consecutivas en una etapa y corta una etapa nueva en cada dependencia ancha. El wordcount queda así:
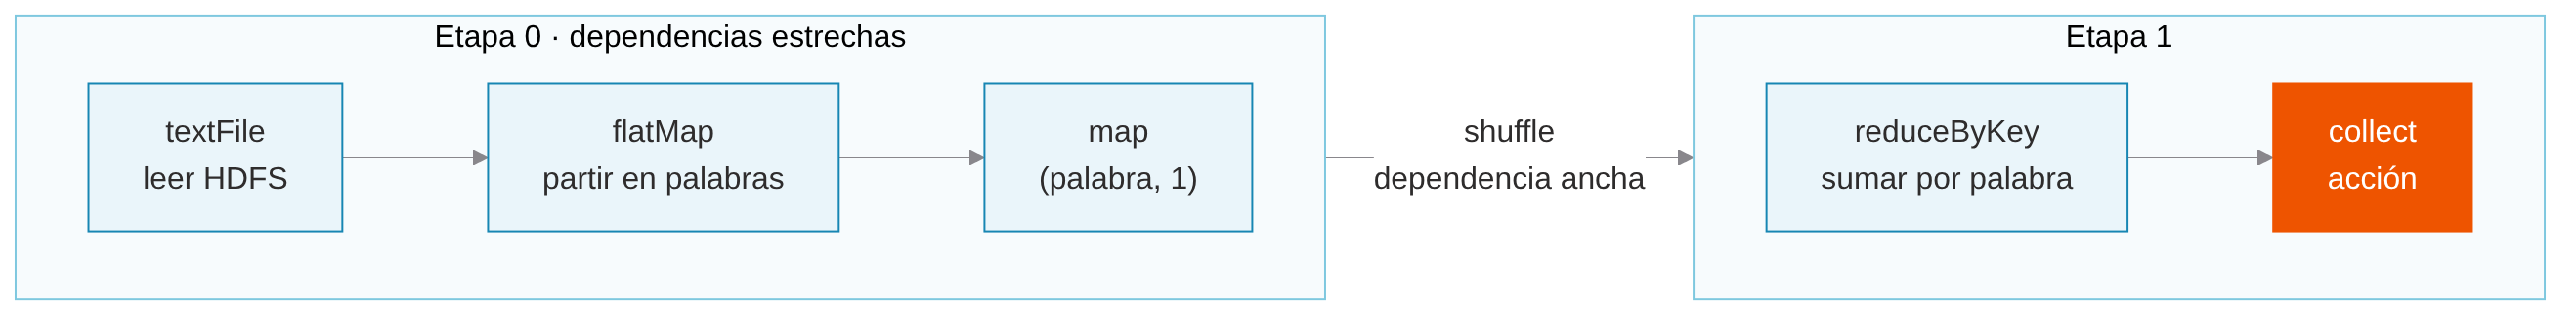
Figura 4. Leer, partir y formar pares son dependencias estrechas y van juntas en la etapa 0. reduceByKey necesita reunir cada palabra, así que el shuffle abre la etapa 1. La acción collect dispara todo.
Compáralo con MapReduce: el mismo cálculo son las mismas dos fases separadas por un shuffle. La diferencia aparece cuando la cadena es más larga. Un análisis que en MapReduce exigiría tres trabajos, con dos escrituras intermedias en HDFS, en Spark es una aplicación con tres o cuatro etapas, y entre ellas solo viajan los datos del shuffle.
La jerarquía completa, de lo más grande a lo más pequeño:
| Término | Qué es | Dónde lo ves |
|---|---|---|
| Aplicación | Todo lo que vive desde que creas la sesión hasta que la cierras | Portal de YARN (application_…, tipo SPARK) |
| Job | Lo que dispara una acción | UI de Spark, pestaña Jobs |
| Etapa (stage) | Tramo del DAG entre dos shuffles | UI de Spark, pestaña Stages |
| Tarea (task) | Una etapa aplicada a una partición, en un executor | UI de Spark, detalle de cada etapa |
Una aplicación puede tener muchos jobs; un job, varias etapas; una etapa, tantas tareas como particiones.
Parte 5 — Memoria, caché y persistencia
“Spark trabaja en memoria” es la frase más repetida y la más malentendida. Lo correcto es: Spark puede conservar datos en memoria entre pasos si se lo pides, y usa memoria para ejecutar cada tarea. No significa que todo el conjunto de datos deba caber en RAM: cuando no cabe, Spark escribe en disco, y el shuffle siempre pasa por disco y red.
Por defecto, cada acción recalcula el plan desde el origen. Si dos acciones usan el mismo resultado intermedio, Spark lo calcula dos veces. Para evitarlo existen:
cache(): conserva el resultado con el nivel de almacenamiento por defecto.persist(nivel): permite elegir dónde guardarlo.
| Nivel | Qué hace | Cuándo conviene |
|---|---|---|
MEMORY_ONLY |
Guarda en memoria; lo que no cabe se recalcula cuando se necesita | Datos pequeños o medianos que se reutilizan mucho |
MEMORY_AND_DISK |
Guarda en memoria y lo que no cabe, en el disco local del executor | Resultados costosos de recalcular |
DISK_ONLY |
Solo disco local | Datos grandes que igual se reutilizan |
Para un RDD, cache() equivale a MEMORY_ONLY; para un DataFrame, usa memoria y disco. La caché ocupa la memoria de los executors, así que se libera con unpersist() cuando ya no se necesita. Cachear todo “por si acaso” es un error común: llena la memoria y obliga a Spark a desalojar datos que sí importaban.
¿Cuándo cachear? Cuando un mismo resultado intermedio alimenta varias acciones o un algoritmo iterativo, como el entrenamiento de un modelo que recorre los datos muchas veces. Ese es exactamente el caso para el que nació Spark.
Parte 6 — El ecosistema: una sola máquina para varias cargas
Sobre el mismo motor, Spark ofrece bibliotecas para distintos tipos de trabajo. Todas comparten la sesión, el clúster y los datos:
| Componente | Para qué sirve |
|---|---|
| Spark SQL y DataFrames | Consultas sobre tablas con SQL o con una API de columnas. Es la forma principal de usar Spark hoy |
| Structured Streaming | Procesar datos que llegan continuamente (eventos, logs, sensores) con la misma API de DataFrames, en pequeños lotes |
| MLlib | Algoritmos de machine learning distribuidos: preparación de variables, regresión, clasificación, clustering, recomendación |
| GraphX | Procesamiento de grafos sobre RDD (de uso más especializado) |
Detrás de Spark SQL trabajan dos piezas que explican por qué un DataFrame suele ser más rápido que un RDD escrito a mano:
- Catalyst, el optimizador: reescribe tu consulta antes de ejecutarla. Por ejemplo, empuja los filtros lo más cerca posible de la lectura para no cargar datos que luego se descartan, y lee solo las columnas que usas.
- Tungsten, el motor de ejecución: guarda los datos en un formato binario compacto y genera código optimizado para la JVM.
Desde Spark 3.2, además, la ejecución adaptativa de consultas (Adaptive Query Execution, AQE) viene activada por defecto: Spark ajusta el plan durante la ejecución con lo que observa en los shuffles, por ejemplo uniendo particiones muy pequeñas o repartiendo una clave desbalanceada.
Lo verás en la práctica en el capítulo de PySpark, donde explain() muestra el plan que Catalyst produjo.
Parte 7 — Observar: la UI de Spark y el portal de YARN
Una aplicación Spark se observa desde dos lugares que responden preguntas distintas:
| Portal | Puerto en los laboratorios | Qué responde |
|---|---|---|
| ResourceManager de YARN | http://localhost:8088 |
¿Qué aplicaciones hay, de qué tipo, en qué cola y en qué estado? |
| UI de Spark (del driver) | http://localhost:4040 |
¿Qué jobs, etapas y tareas tiene esta aplicación, cuánto tardó cada una, cuántos datos movió el shuffle? |
La UI de Spark la sirve el driver, así que solo existe mientras la aplicación vive: cuando el spark-submit termina o cierras la sesión, el puerto 4040 deja de responder. En producción se configura un History Server (puerto 18080 por defecto) que conserva esas vistas después de terminar.
Las pestañas que más vas a usar son Jobs, Stages (donde verás las dos etapas del wordcount y el volumen del shuffle) y Executors (memoria y tareas por executor). Cuando un trabajo es lento, la pregunta casi siempre se responde en Stages: una etapa con una tarea mucho más lenta que las demás indica datos desbalanceados entre particiones.
Parte 8 — Qué no es Spark (y cuándo no usarlo)
| No es | Porque |
|---|---|
| HDFS | Spark lee y escribe datos; no los guarda de forma duradera |
| YARN | YARN concede CPU y memoria; Spark las usa en executors |
| Un segundo NameNode | El laboratorio del cliente añadió un proceso cliente, no otro HDFS |
| “Todo cabe en memoria” | Spark puede persistir en RAM; también usa disco y red, y el shuffle siempre existe |
| PySpark | PySpark es la API en Python. Spark es el motor, escrito en Scala sobre la JVM |
Spark tampoco es la respuesta a todo:
- Datos que caben en una máquina. Si el archivo pesa unos pocos gigabytes, pandas, Polars o DuckDB en un solo equipo suelen ser más rápidos y simples. Spark paga un costo fijo de arranque y coordinación que solo compensa a escala.
- Consultas de baja latencia. Spark está hecho para procesar muchos datos, no para responder en milisegundos a una aplicación web; para eso existen bases de datos.
- Actualizaciones de registros individuales. Spark procesa conjuntos; modificar una fila concreta es tarea de una base de datos (o de formatos de tabla como Delta Lake o Apache Iceberg, que quedan fuera de este libro).
Preguntas de comprensión
- Un programa hace
filter, luegomap, luegoreduceByKeyy termina concount. ¿Cuántas etapas esperas y dónde se corta? - Un executor muere a mitad de un trabajo. ¿Qué datos se pierden y cómo los recupera Spark sin réplicas?
- Llamas dos veces a
count()sobre el mismo resultado intermedio, sincache(). ¿Cuántas veces se lee el archivo de HDFS? - ¿Por qué en los laboratorios el driver no puede estar en modo cluster si usas Jupyter?
Orientaciones. Dos etapas: filter y map son estrechas y van juntas; reduceByKey exige shuffle y abre la segunda. Se pierden las particiones que guardaba ese executor; Spark las recalcula siguiendo el linaje desde HDFS. Dos veces, porque cada acción vuelve a ejecutar el plan desde el origen. Porque en modo cluster el driver vive en un contenedor YARN y el kernel de Jupyter necesita tenerlo en su propio proceso.
Referencias para profundizar
- Matei Zaharia et al., Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing (NSDI 2012).
- Apache Spark, Spark Overview y RDD Programming Guide (3.5.3).
- Apache Spark, Cluster Mode Overview y Running Spark on YARN.
- Apache Spark, Web UI.
- Apache Spark, Performance Tuning: Adaptive Query Execution.
Resumen
En este capítulo aprendiste:
- Que Spark nació para reutilizar datos entre pasos sin pagar disco en cada uno, manteniendo la tolerancia a fallos.
- Que calcula sobre el mismo HDFS y el mismo YARN: el driver planifica y los executors ejecutan tareas en contenedores YARN, en modo client o cluster.
- Las tres ideas del RDD: particiones como unidad de paralelismo, evaluación perezosa y linaje para recalcular lo perdido.
- Cómo el DAG se corta en etapas en cada dependencia ancha, y la jerarquía aplicación → job → etapa → tarea.
- Qué hacen
cache()ypersist(), y cuándo conviene usarlos. - El ecosistema (Spark SQL, Structured Streaming, MLlib) y las piezas que optimizan los DataFrames: Catalyst, Tungsten y AQE.
- Dónde observar una aplicación (portal de YARN y UI de Spark) y cuándo Spark no es la herramienta adecuada.
En el siguiente capítulo, el Taller de Spark, enviarás aplicaciones al clúster y comprobarás con evidencia cada una de estas ideas: el tipo SPARK, el driver, los executors, las etapas y el shuffle.