7 YARN: el gestor de recursos del clúster
Quién decide qué programa procesa los datos, y con cuántos recursos
En este capítulo vas a entender qué significa gestionar recursos en un clúster compartido, por qué Hadoop 1 se quedó corto y cómo YARN separa esa gestión del modelo de procesamiento. El centro del recorrido es la arquitectura —ResourceManager, NodeManager, ApplicationMaster y contenedor— y el ciclo de una aplicación, incluida la localidad respecto a los bloques de HDFS. Este es el material teórico; la construcción práctica del clúster corresponde a Laboratorio: YARN con Docker, del ResourceManager a tu primer trabajo MapReduce.
Tiempo estimado de lectura: 26 minutos
Nivel: Intermedio
Conocimientos previos recomendados: - Manejo básico de la terminal Linux - Lectura de HDFS: el sistema de archivos distribuido de Big Data y de su laboratorio con Docker - Ecosistema Hadoop y fundamentos de Big Data: las cinco V, escalamiento horizontal y la idea de “llevar el cómputo a los datos”
Tecnologías mencionadas: - Apache Hadoop YARN (ResourceManager, NodeManager, ApplicationMaster, contenedor) - Hadoop 1 (JobTracker y TaskTracker) - MapReduce, Spark, Tez y Flink (como motores sobre YARN) - Kubernetes (como contraste moderno)
En HDFS resolvimos dónde viven los datos: archivos partidos en bloques, réplicas en varios DataNodes y un NameNode que guarda el mapa. Eso no responde la pregunta que aparece en cuanto más de un programa quiere usar el clúster a la vez: quién decide qué aplicación procesa esos datos, en qué máquina y con cuánta memoria y CPU. Esa es la capa de recursos. Se llama YARN. Aquí el objetivo es que el modelo te quede claro antes de tocar el clúster.
Parte 1 — El problema: repartir un clúster entre muchos
Un clúster es un conjunto de máquinas que cooperan como si fueran una sola plataforma. En Fundamentos viste por qué Big Data escala en horizontal: más nodos, no un servidor cada vez más gordo. En el ecosistema Hadoop viste el mapa: HDFS almacena, alguien administra CPU y memoria, y un motor —MapReduce, Spark u otro— calcula. Esa pieza del medio parece aburrida hasta que imaginas el día a día.
Tienes, por ejemplo, veinte nodos. En cada uno hay RAM, núcleos de procesador y, si el despliegue es el clásico, también discos con bloques de HDFS. Por la mañana el equipo de finanzas lanza un agregado nocturno que se retrasó. A media mañana Ciencia de Datos arranca un entrenamiento. A la vez, alguien dispara una consulta sobre logs. Los tres quieren memoria. Los tres quieren CPU. Los tres preferirían correr cerca de los datos que ya están en esos discos. Si cada uno toma lo que encuentra, el primero que llega se queda con el clúster y los otros se mueren de hambre.
Eso es, en una frase, el problema de la gestión de recursos: decidir, de forma continua, cuánta memoria y cuánta CPU de cada nodo puede usar cada aplicación, sin que el clúster se convierta en un campo de batalla. No se trata solo de “hay máquinas libres”. Se trata de aislar, limitar y repartir un bien escaso entre inquilinos que no se coordinan entre sí.
Junto a ese reparto vive la planificación de trabajos (job scheduling): el orden y la política con los que se aceptan, esperan o adelantan las aplicaciones cuando no cabe todo al mismo tiempo. Un planificador —en este contexto, el componente que aplica esa política— no ejecuta tu cálculo. No sabe si estás haciendo un map o un join de Spark. Solo responde: a ti te tocan 4 GB y 2 núcleos en el nodo 7; tú esperas; tú puedes usar capacidad que el otro equipo no está ocupando.
Sin un árbitro pasa lo previsible. Un trabajo mal dimensionado pide —o toma— toda la RAM de varios nodos. El sistema operativo de cada máquina empieza a paginar. Las tareas vecinas se vuelven lentas o mueren. No hay forma limpia de decir “este equipo tiene derecho al 40 % del clúster” ni de recuperar el hardware cuando el trabajo termina. El clúster compartido deja de ser una plataforma y se vuelve una colección de servidores en la que gana quien llega primero.
Fíjate en la analogía que ya te sirve: en una sola máquina, el sistema operativo reparte CPU y memoria entre procesos. En un clúster, alguien tiene que hacer de sistema operativo de las veinte máquinas a la vez. Ese alguien no guarda tus archivos —eso es HDFS— ni escribe tu algoritmo. Arbitra el hardware.
¿Para qué sirve esta idea? Para no tratar “el clúster” como si se usara solo. En cuanto hay más de una aplicación, más de un equipo o más de un motor de cálculo, hace falta un negociador. YARN existe para ser ese negociador. El resto del capítulo es cómo lo hace.
Parte 2 — Antes de YARN: los límites de Hadoop 1
En Hadoop 1 el almacenamiento ya era HDFS: NameNode, DataNodes, bloques y réplicas. El procesamiento, en cambio, estaba soldado a MapReduce. No había una capa genérica de recursos. Quien administraba el clúster de cómputo era el propio MapReduce, con dos daemons —procesos de servicio que corren en segundo plano— que conviene nombrar bien.
El JobTracker era el proceso maestro. Recibía el trabajo (job), lo partía en tareas map y reduce, las asignaba a los nodos, vigilaba el progreso y relanzaba lo que fallaba. Al mismo tiempo decidía quién usaba qué: en Hadoop 1 los recursos no se pedían como “2 GB y 1 núcleo”, sino como ranuras (slots). Cada nodo worker ofrecía un número fijo de ranuras de map y de reduce. El JobTracker las ocupaba.
El TaskTracker era el agente en cada nodo esclavo. Recibía tareas, las ejecutaba en esas ranuras y mandaba latidos (heartbeats): mensajes periódicos al JobTracker que dicen “sigo vivo y así está mi carga”. Si los latidos se cortaban, el JobTracker daba al nodo por muerto y reasignaba sus tareas.
El diseño era comprensible para un clúster que solo corría MapReduce. También tenía tres grietas que, a escala, se volvieron inaceptables.
Un único punto de falla. Si el JobTracker caía, caía la coordinación de todos los trabajos. No había un administrador de recursos independiente al que el cálculo pudiera sobrevivir. El TaskTracker podía seguir en su nodo; sin maestro, el clúster de procesamiento quedaba ciego.
Un cuello de botella. El JobTracker no solo aceptaba trabajos: también seguía el estado de cada tarea de cada trabajo. A cientos de nodos eso aguanta. A miles, el maestro se ahoga en seguimiento. La industria lo aprendió en carne propia: Hadoop 1 no escalaba con soltura hacia los clústeres muy grandes porque el cerebro hacía demasiado.
Un solo modelo de cómputo. Las ranuras eran de map o de reduce. El clúster no ofrecía “memoria y CPU para lo que quieras ejecutar”. Si querías otro motor —Spark, un grafo de tareas distinto, un servicio de larga duración—, no había un inquilino de primera clase. MapReduce era a la vez el cálculo y el dueño del edificio. En el capítulo del ecosistema Hadoop ya viste esta frase: un clúster Hadoop moderno no tiene por qué ejecutar únicamente MapReduce. Hadoop 1 no podía cumplirla.
| Hadoop 1 | Hadoop 2 con YARN | |
|---|---|---|
| Quién reparte el clúster | El JobTracker (mezclado con MapReduce) | El ResourceManager (genérico) |
| Agente en cada nodo | TaskTracker | NodeManager |
| Unidad de recurso | Ranuras map / reduce | Contenedor: memoria + CPU |
| Quién coordina un trabajo | El mismo JobTracker, para todos | Un ApplicationMaster por aplicación |
| Motores posibles | Solo MapReduce | MapReduce, Spark, Tez, Flink… |
| Punto débil clásico | JobTracker: cuello de botella y punto único de falla | El ResourceManager sigue siendo maestro, pero ya no sigue cada tarea |
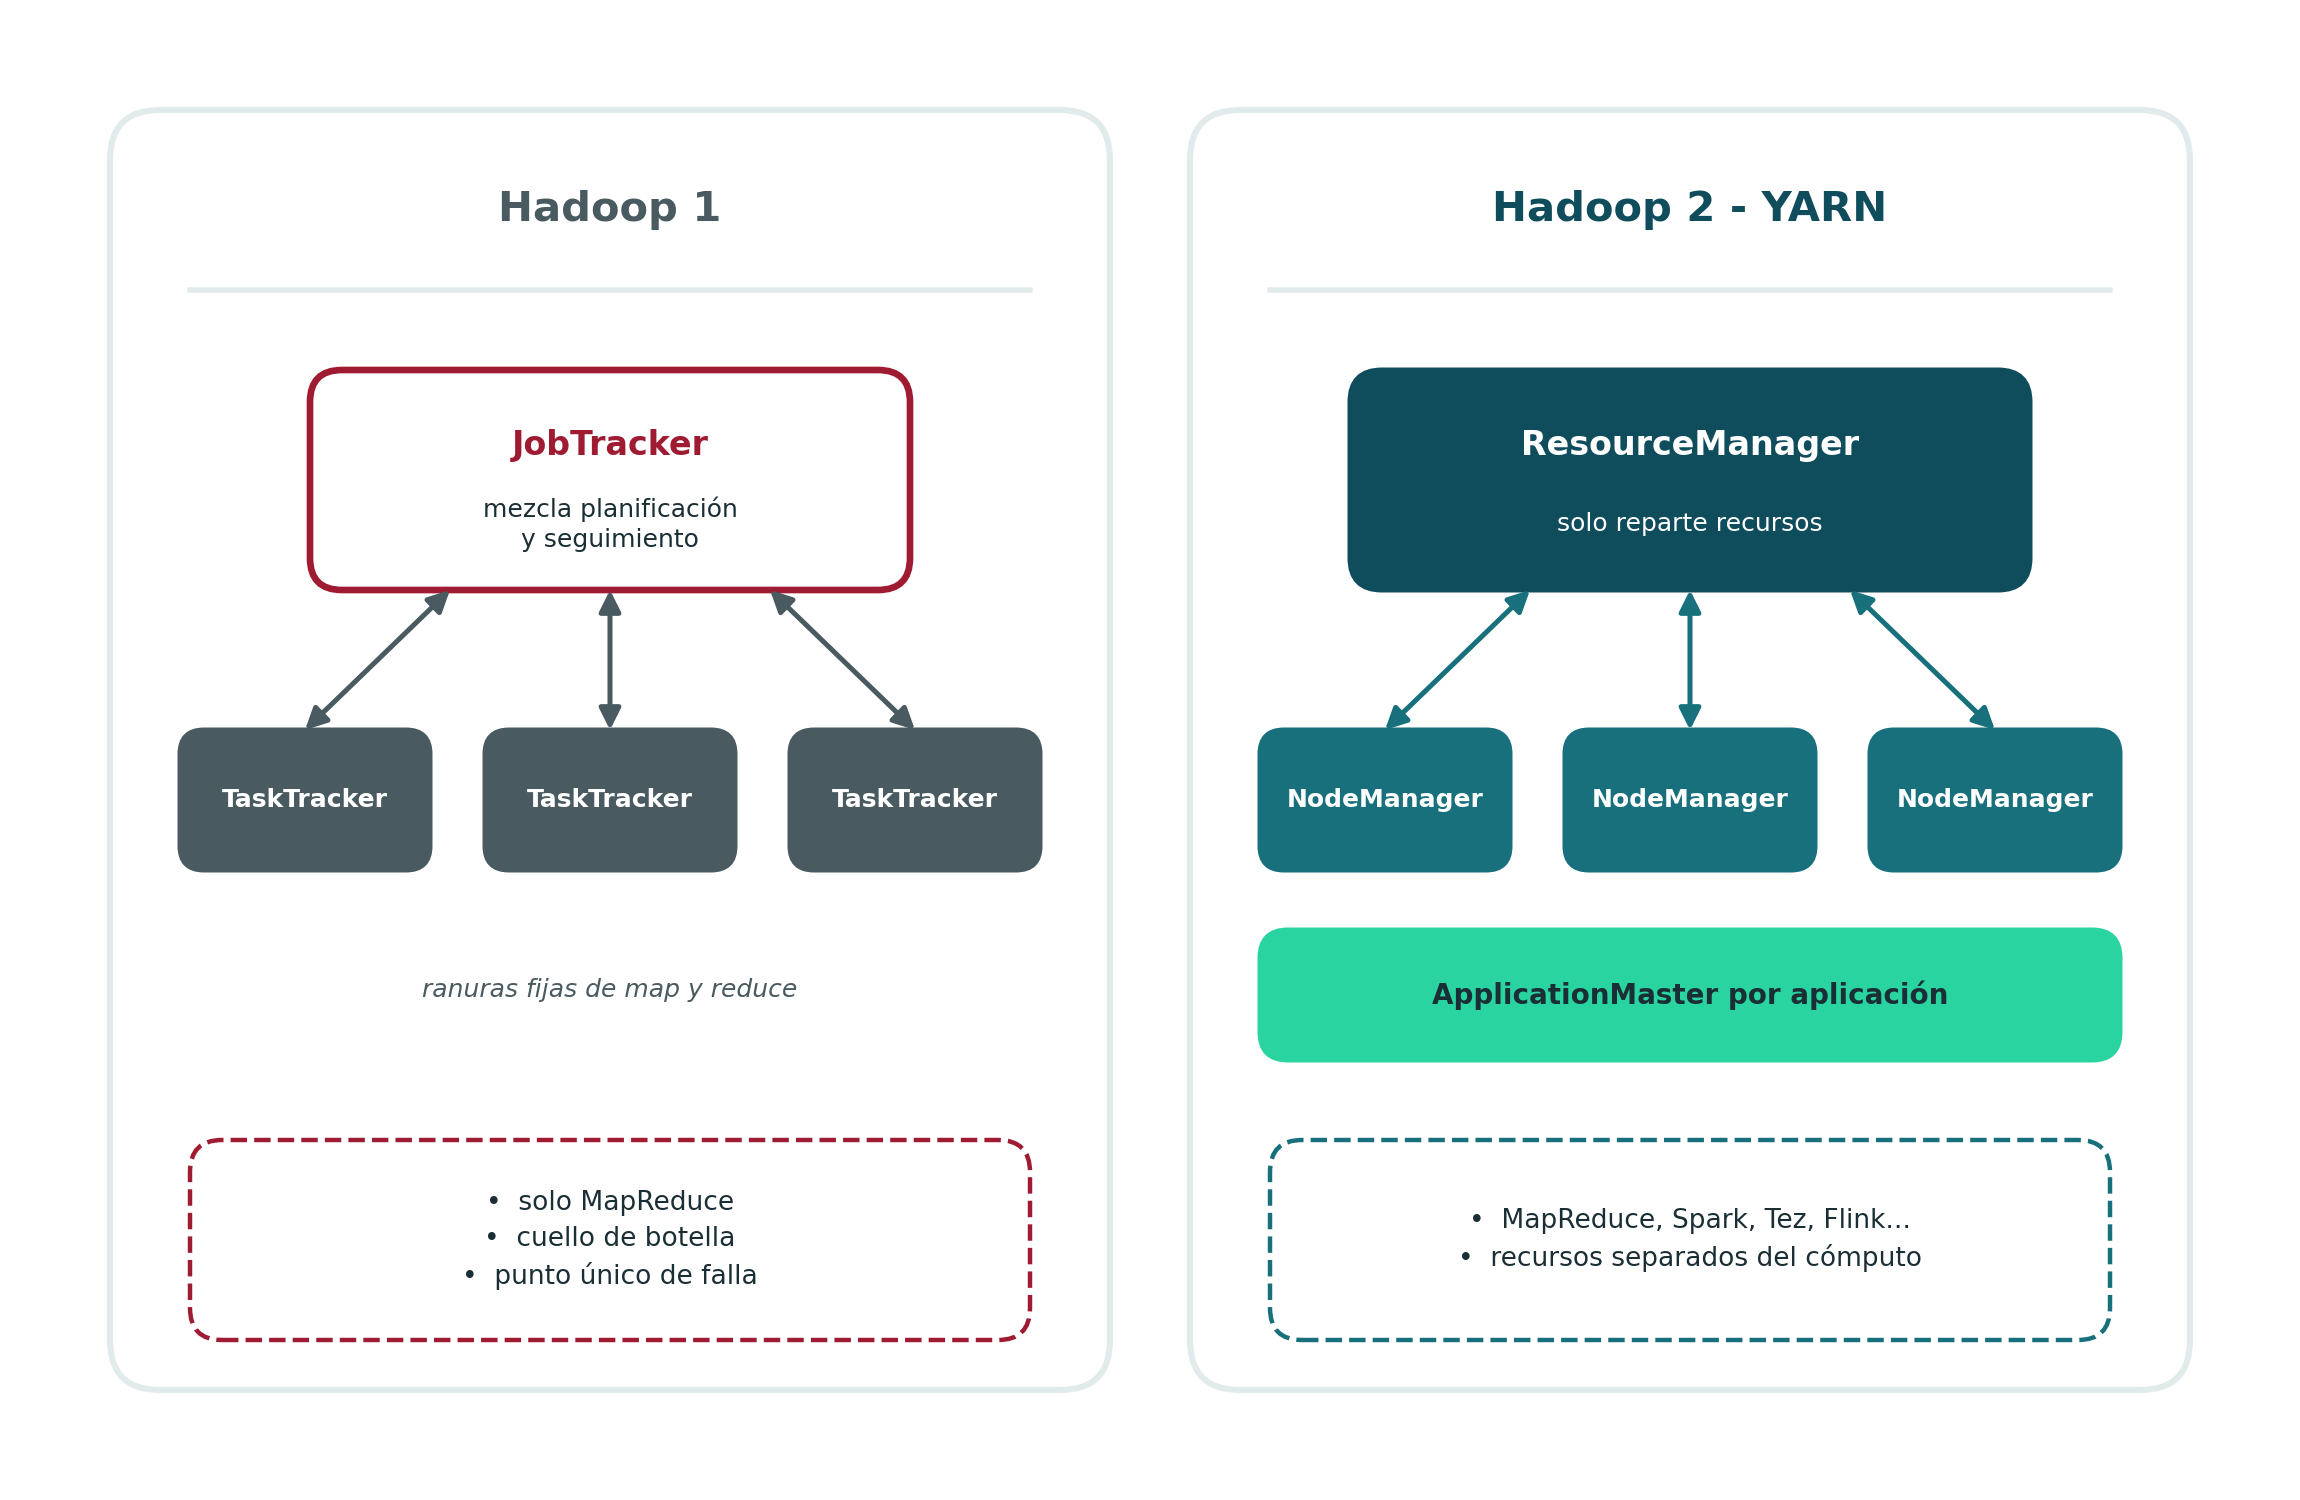
Figura 1. Hadoop 1 (JobTracker y TaskTrackers) frente a Hadoop 2 (ResourceManager, NodeManagers y un ApplicationMaster por aplicación).
Hadoop 2 no “arregló MapReduce un poco”. Cambió de oficio: separó la gestión de recursos del modelo de procesamiento. A esa capa nueva se la llamó YARN. A MapReduce reescrito para correr encima se le llamó a veces MapReduce 2.0 (MRv2): ya no era el sistema operativo del clúster, sino una aplicación más.
¿Para qué sirve esta historia? Para leer YARN como respuesta a un diseño que se quedó corto, no como una sigla que hay que memorizar. Cuando alguien dice “en Hadoop 1 el JobTracker no daba abasto”, ya sabes qué no daba abasto: un solo proceso que arbitraba el hardware y, al mismo tiempo, dirigía cada tarea de cada job.
Parte 3 — Qué es YARN
YARN significa Yet Another Resource Negotiator: “otro negociador de recursos más”. El nombre es irónico a propósito. El contenido no lo es. YARN es el gestor de recursos y planificador del clúster en Hadoop 2 y Hadoop 3. Administra el pool de memoria y CPU de los nodos, acepta aplicaciones, les asigna trozos de hardware y procura que convivan.
La analogía que más rinde —y que el propio ecosistema usa— es la del sistema operativo del clúster. En tu portátil, el SO no es tu hoja de cálculo ni tu navegador: les da memoria, les da tiempo de CPU y los aísla para que uno no tumbe al otro. YARN hace eso con máquinas. Tú no “abres un programa en el nodo 12”. Pides recursos; YARN te concede un trozo; tu código corre dentro de ese trozo.
La idea clave de Hadoop 2 cabe en una línea:
La gestión de recursos y el modelo de procesamiento son problemas distintos, y deben ser capas distintas.
Con esa separación, el clúster deja de estar casado con MapReduce. El mismo HDFS, los mismos discos, el mismo pool de CPU pueden servir a:
- un job MapReduce,
- una aplicación Spark,
- un grafo de Tez (el motor que Hive usó durante años para no bajar todo a MapReduce),
- un job Flink,
- u otro framework que sepa hablarle a YARN.
YARN no calcula. No guarda el data lake. Negocia. Por eso el acrónimo encaja: las aplicaciones piden, el planificador concede o hace esperar, y el hardware se usa como un bien común.
En el mapa que ya construimos:
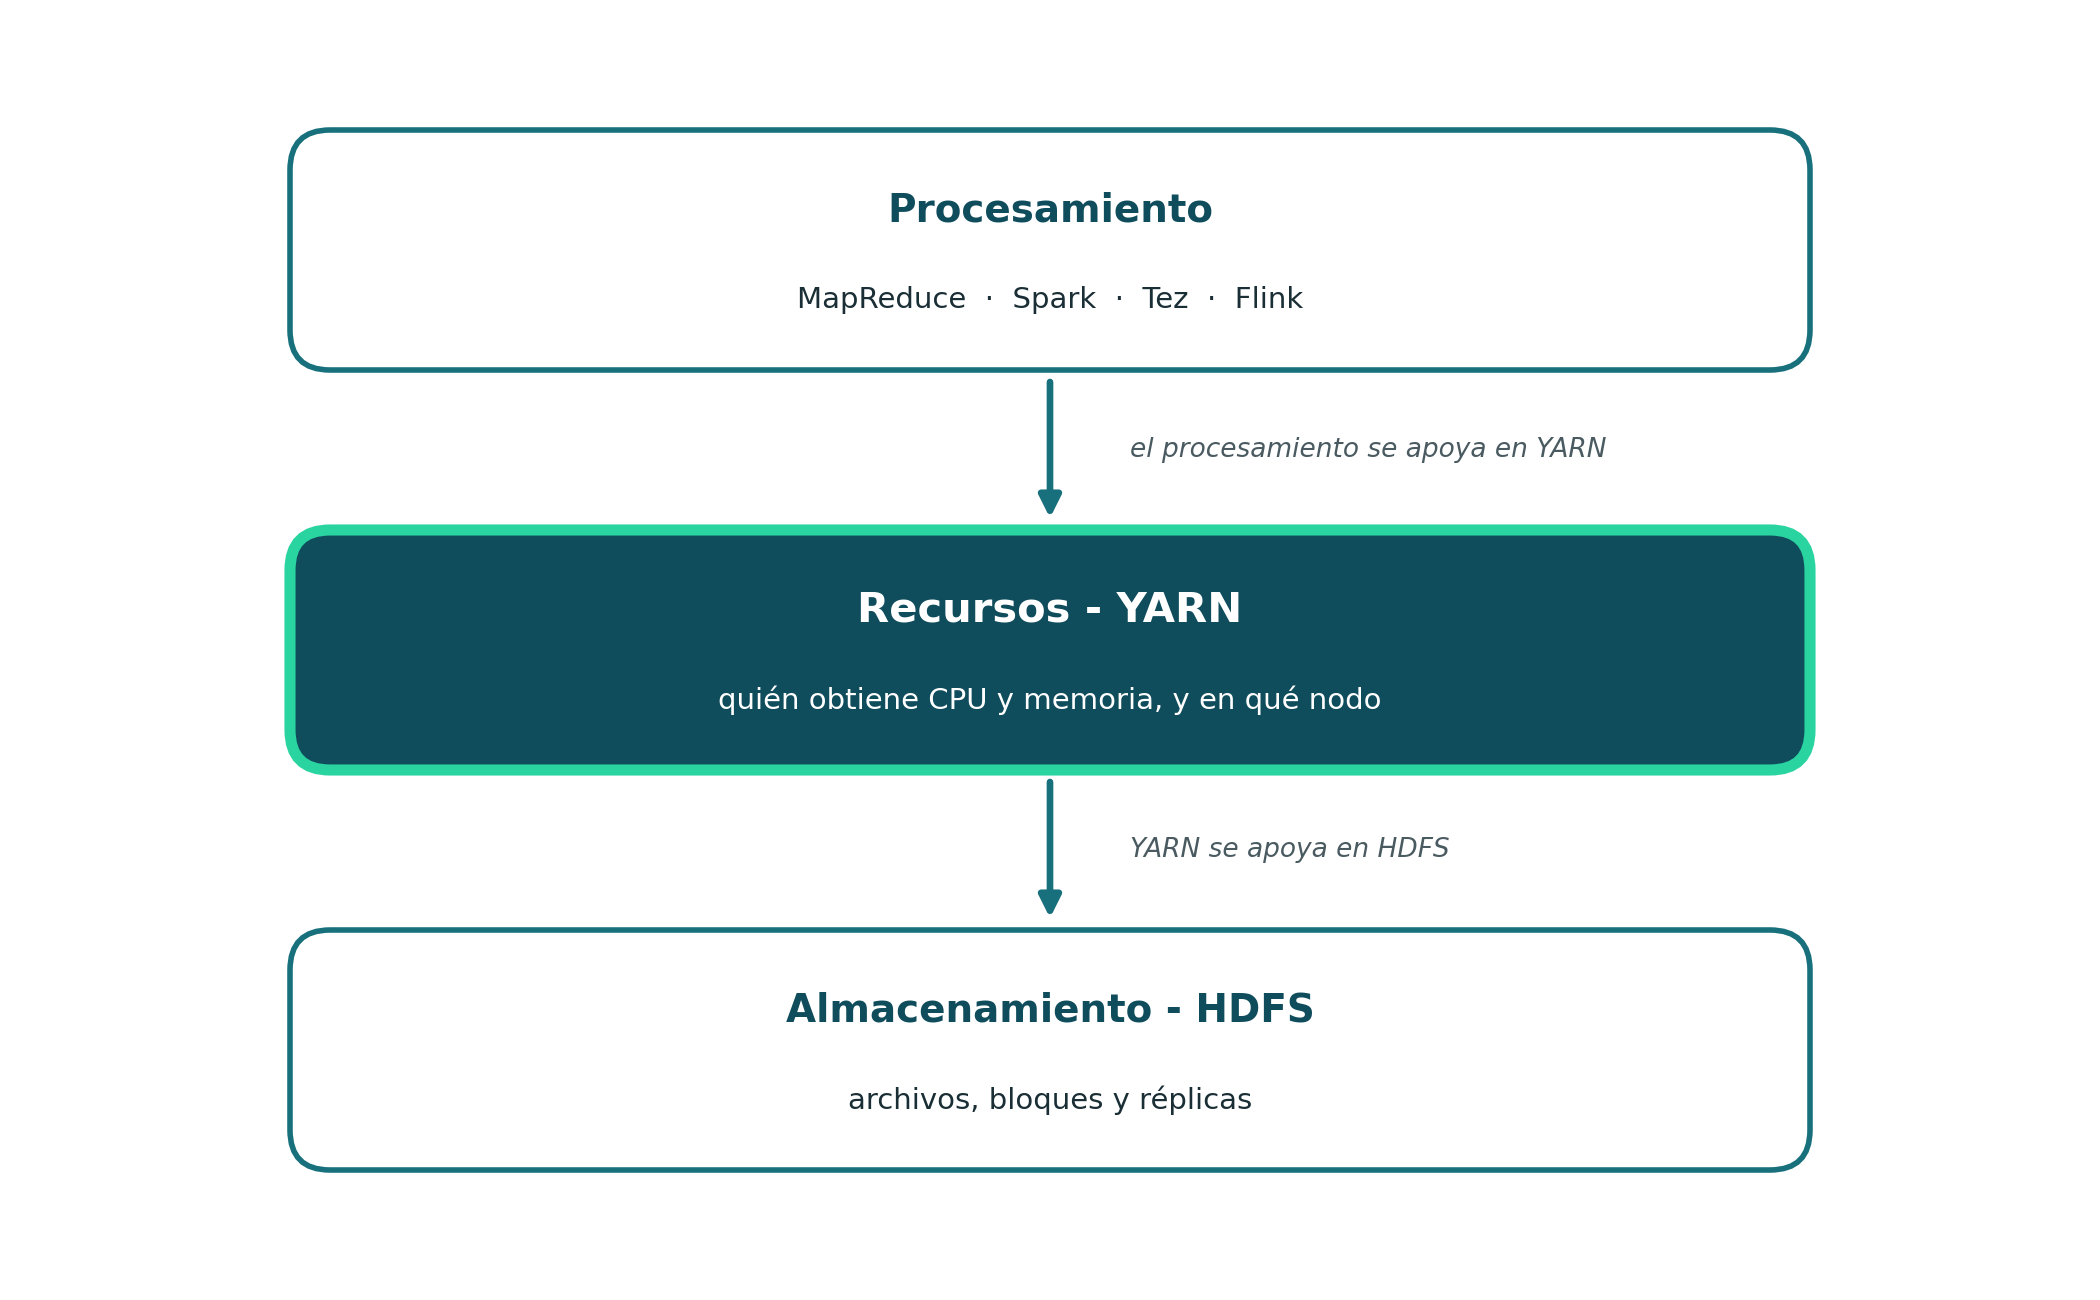
Figura 2. El procesamiento se apoya en YARN y YARN en HDFS.
¿Cuándo entra en juego YARN? Cada vez que una aplicación necesita ejecutarse en el clúster Hadoop y no solo leer HDFS. Recuerda lo que ya vimos: puedes copiar un archivo con el cliente de HDFS sin pasar por YARN. En cuanto lanzas un cálculo distribuido sobre esos datos, alguien tiene que reservar RAM y CPU. Ese alguien es YARN.
Parte 4 — Arquitectura y componentes
YARN no es un proceso único. Es un pacto entre cuatro piezas: un árbitro global, un agente en cada máquina, un coordinador por aplicación y una unidad de asignación llamada contenedor. Si te aprendes esas cuatro, el resto de la documentación deja de parecer un listado de daemons.
ResourceManager: el árbitro global
El ResourceManager (RM) es el maestro de YARN. Hay uno activo por clúster (con alta disponibilidad puede haber un standby, igual que el NameNode). No ejecuta tu map. No lee tus bloques. Tiene dos responsabilidades que conviene no mezclar, porque viven en dos partes internas:
El Scheduler (planificador del RM). Reparte recursos. Mira cuánta memoria y cuántos núcleos hay libres, qué colas existen, qué aplicaciones esperan, y concede contenedores. No vigila si tu tarea va al 40 % o si el código lanzó una excepción. Es frío a propósito: asigna, no dirige el cálculo.
El ApplicationsManager (gestor de aplicaciones; a veces verás ASM). Acepta el envío de una aplicación, recuerda que existe, y se ocupa de un momento crítico: lanzar el ApplicationMaster —el coordinador de esa aplicación— en su primer contenedor. Si ese coordinador muere, el ApplicationsManager puede pedir que se relance, según la política configurada.
La analogía con HDFS ayuda. El NameNode no guarda los bytes del archivo; guarda el mapa. El ResourceManager no calcula; guarda el mapa de quién tiene derecho a qué recursos ahora. Los DataNodes tienen su paralelo: los NodeManagers.
NodeManager: el agente de cada nodo
El NodeManager (NM) corre en cada nodo worker. Es el encargado local de YARN, como el DataNode lo es de HDFS —y en el clúster clásico suelen convivir en la misma máquina, precisamente para que el cómputo pueda sentarse al lado de los bloques.
El NodeManager hace tres cosas que importan:
- Lanza y detiene contenedores cuando se lo piden: arranca el proceso que debe vivir dentro de la reserva de recursos.
- Vigila que ese proceso no se pase de la memoria asignada y que el nodo siga sano.
- Reporta al ResourceManager, con latidos, cuánta capacidad tiene, cuántos contenedores corren y si el nodo sigue disponible.
Si el NodeManager muere, el RM deja de contar con ese nodo. Los contenedores que ahí corrían se consideran perdidos. La aplicación —a través de su ApplicationMaster— puede pedir otros. El fallo de un worker, como en HDFS, se trata como un evento esperado, no como el fin del clúster.
ApplicationMaster: un coordinador por aplicación
Aquí está el giro que Hadoop 1 no tenía. El ApplicationMaster (AM) es un proceso uno por aplicación. Cada job de MapReduce tiene el suyo. Cada aplicación Spark sobre YARN tiene el suyo. No es un daemon permanente del clúster: nace cuando envías el trabajo y muere cuando ese trabajo termina.
El AM hace el oficio que el JobTracker hacía para todos, pero solo para los suyos:
- Negocia con el ResourceManager: “necesito 40 contenedores de 2 GB y 1 núcleo, y preferiría estos nodos”.
- Cuando se los conceden, le pide a cada NodeManager que lance el proceso concreto (una tarea map, un ejecutor de Spark, etc.).
- Sigue el progreso, relanza tareas fallidas y, al terminar, libera lo que pidió y se da de baja.
Por eso YARN escala mejor en este eje: el RM no tiene que conocer el estado de cada tarea de cada job. Conoce aplicaciones y contenedores. El detalle del cálculo se descentraliza hacia el AM. MapReduce deja de ser el dueño del clúster y se convierte en un inquilino con su propio capataz.
Contenedor de YARN: una reserva, no un Docker
Un contenedor (container) de YARN es la unidad de asignación de recursos: un paquete lógico de memoria más CPU en un nodo concreto, durante un tiempo. Cuando el planificador “te da un contenedor”, te está diciendo: en el nodo 4 puedes usar 2048 MB y 1 vcore; el NodeManager va a arrancar ahí tu proceso.
Un vcore (virtual core, núcleo virtual) es la unidad con la que YARN cuenta la CPU. El administrador configura cuántos vcores ofrece cada nodo. No tiene por qué coincidir uno a uno con los núcleos físicos: es una moneda de planificación. Si no hay aislamiento estricto por cgroups (control groups: el mecanismo de Linux que limita CPU y memoria de un proceso), un proceso ruidoso puede usar más CPU de la que “pidió”; el vcore sigue siendo, aun así, lo que el planificador usa para no conceder mil tareas de CPU a un nodo que declara ocho.
Ahora la confusión que hay que matar pronto, sobre todo si vienes del capítulo de Docker:
Un contenedor de YARN no es un contenedor de Docker.
Docker (y más tarde Kubernetes) empaqueta un proceso con su sistema de archivos, sus namespaces y su imagen. El contenedor de YARN, en el modelo clásico, es más pobre y más antiguo: es una reserva lógica —esta RAM, esta CPU, este nodo— dentro de la cual se lanza un proceso, casi siempre una JVM. Hadoop, en versiones posteriores, puede pedir que ese proceso corra además dentro de un contenedor Docker; eso es una opción de ejecución, no la definición. Cuando en YARN leas container, piensa en porción de hardware concedida, no en docker run.
El ApplicationMaster también corre en un contenedor. El primero que el RM concede no es para tus tareas: es para el coordinador. Las tareas van en contenedores siguientes.
Cómo encajan las cuatro piezas
El ResourceManager habla con los NodeManagers (capacidad del clúster) y con los ApplicationMasters (pedidos de cada aplicación). El ApplicationMaster habla con el RM (negocia) y con los NM (lanza). El contenedor es lo que se negocia y se lanza. Nadie más necesita ser maestro de tus tareas.
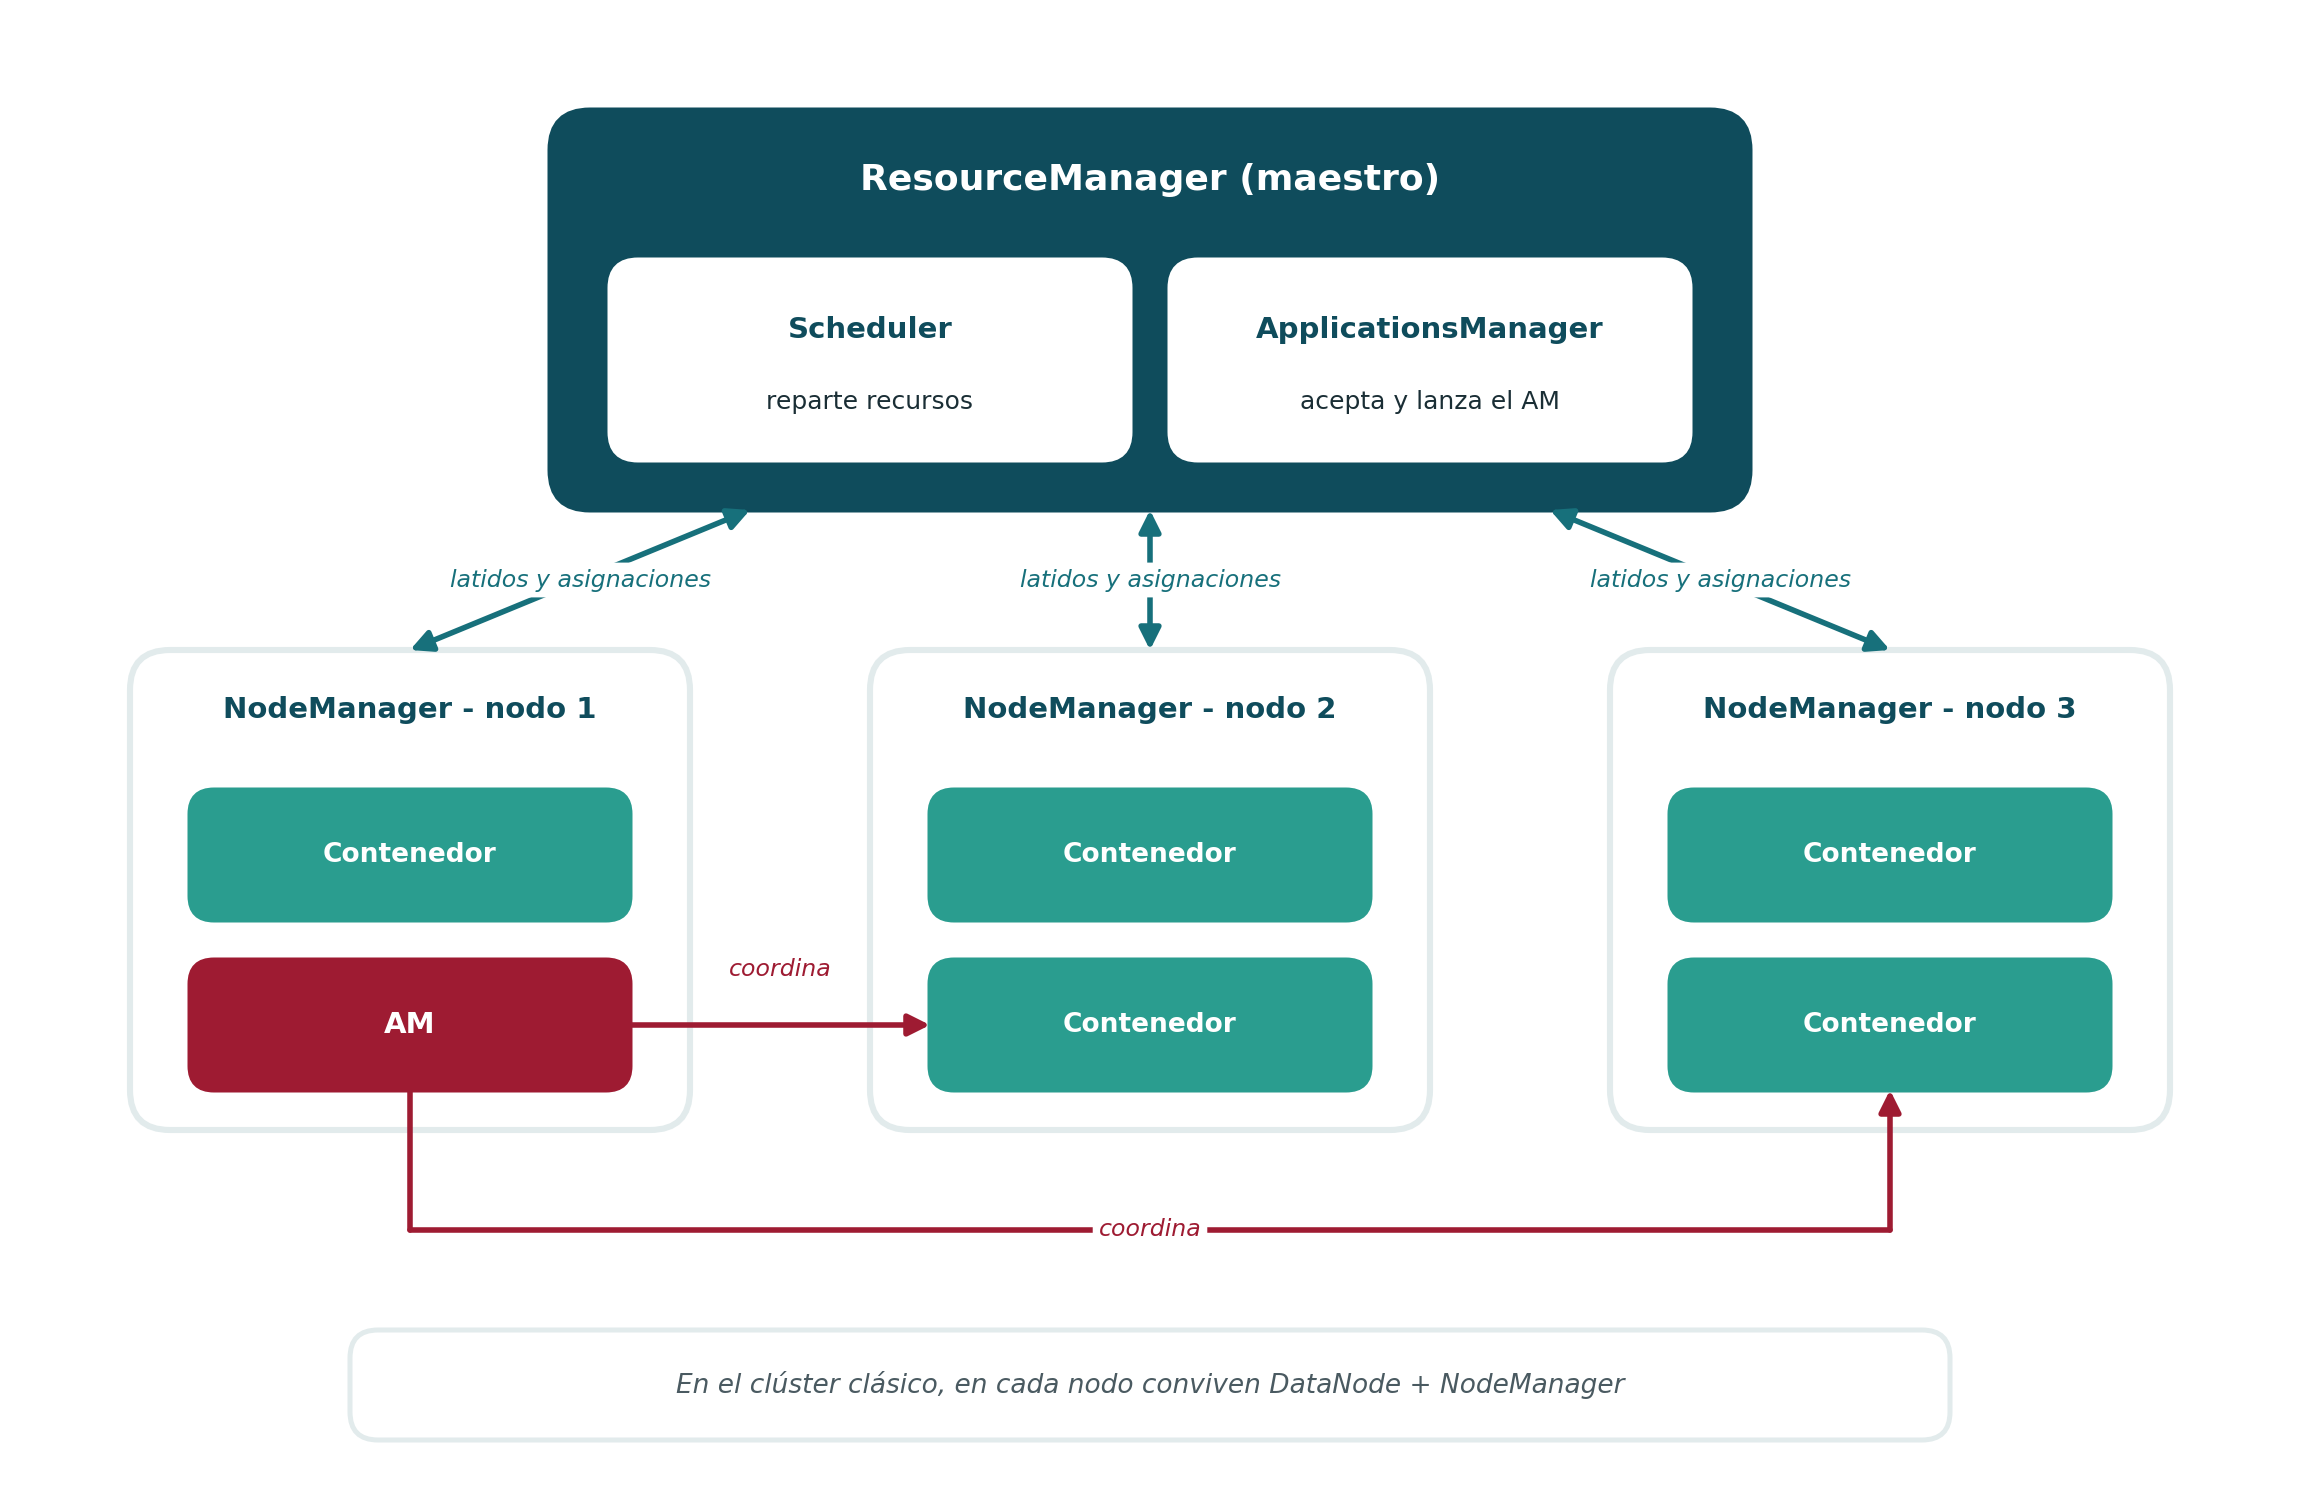
Figura 3. Arquitectura de YARN: un ResourceManager, un NodeManager por nodo y un ApplicationMaster por aplicación.
En un nodo típico del clúster Hadoop clásico conviven DataNode + NodeManager: uno sirve bloques, el otro lanza contenedores. Por eso “llevar el cómputo a los datos” no es una metáfora vaga. Es la posibilidad de que el AM pida un contenedor en el mismo host donde HDFS ya tiene el bloque.
¿Para qué sirve esta arquitectura? Para leer cualquier diagrama de YARN sin perderte. Si ves un maestro, es el RM. Si ves un proceso por máquina, es el NM. Si ves algo que nació con tu job y habla con ambos, es el AM. Si ves una porción de RAM y CPU, es un contenedor. Con eso ya puedes seguir el ciclo de una aplicación.
Parte 5 — Cómo funciona: el ciclo de una aplicación
La arquitectura es el quién. El ciclo es el en qué orden. Una aplicación en YARN es la unidad que envías: un job MapReduce, una aplicación Spark, un programa Tez. No confundas todavía “aplicación YARN” con “aplicación Spark interna” (Spark puede tener varios jobs dentro de una misma aplicación YARN). Para este capítulo, un envío al RM = una aplicación = un ApplicationMaster.
El flujo, paso a paso, es este.
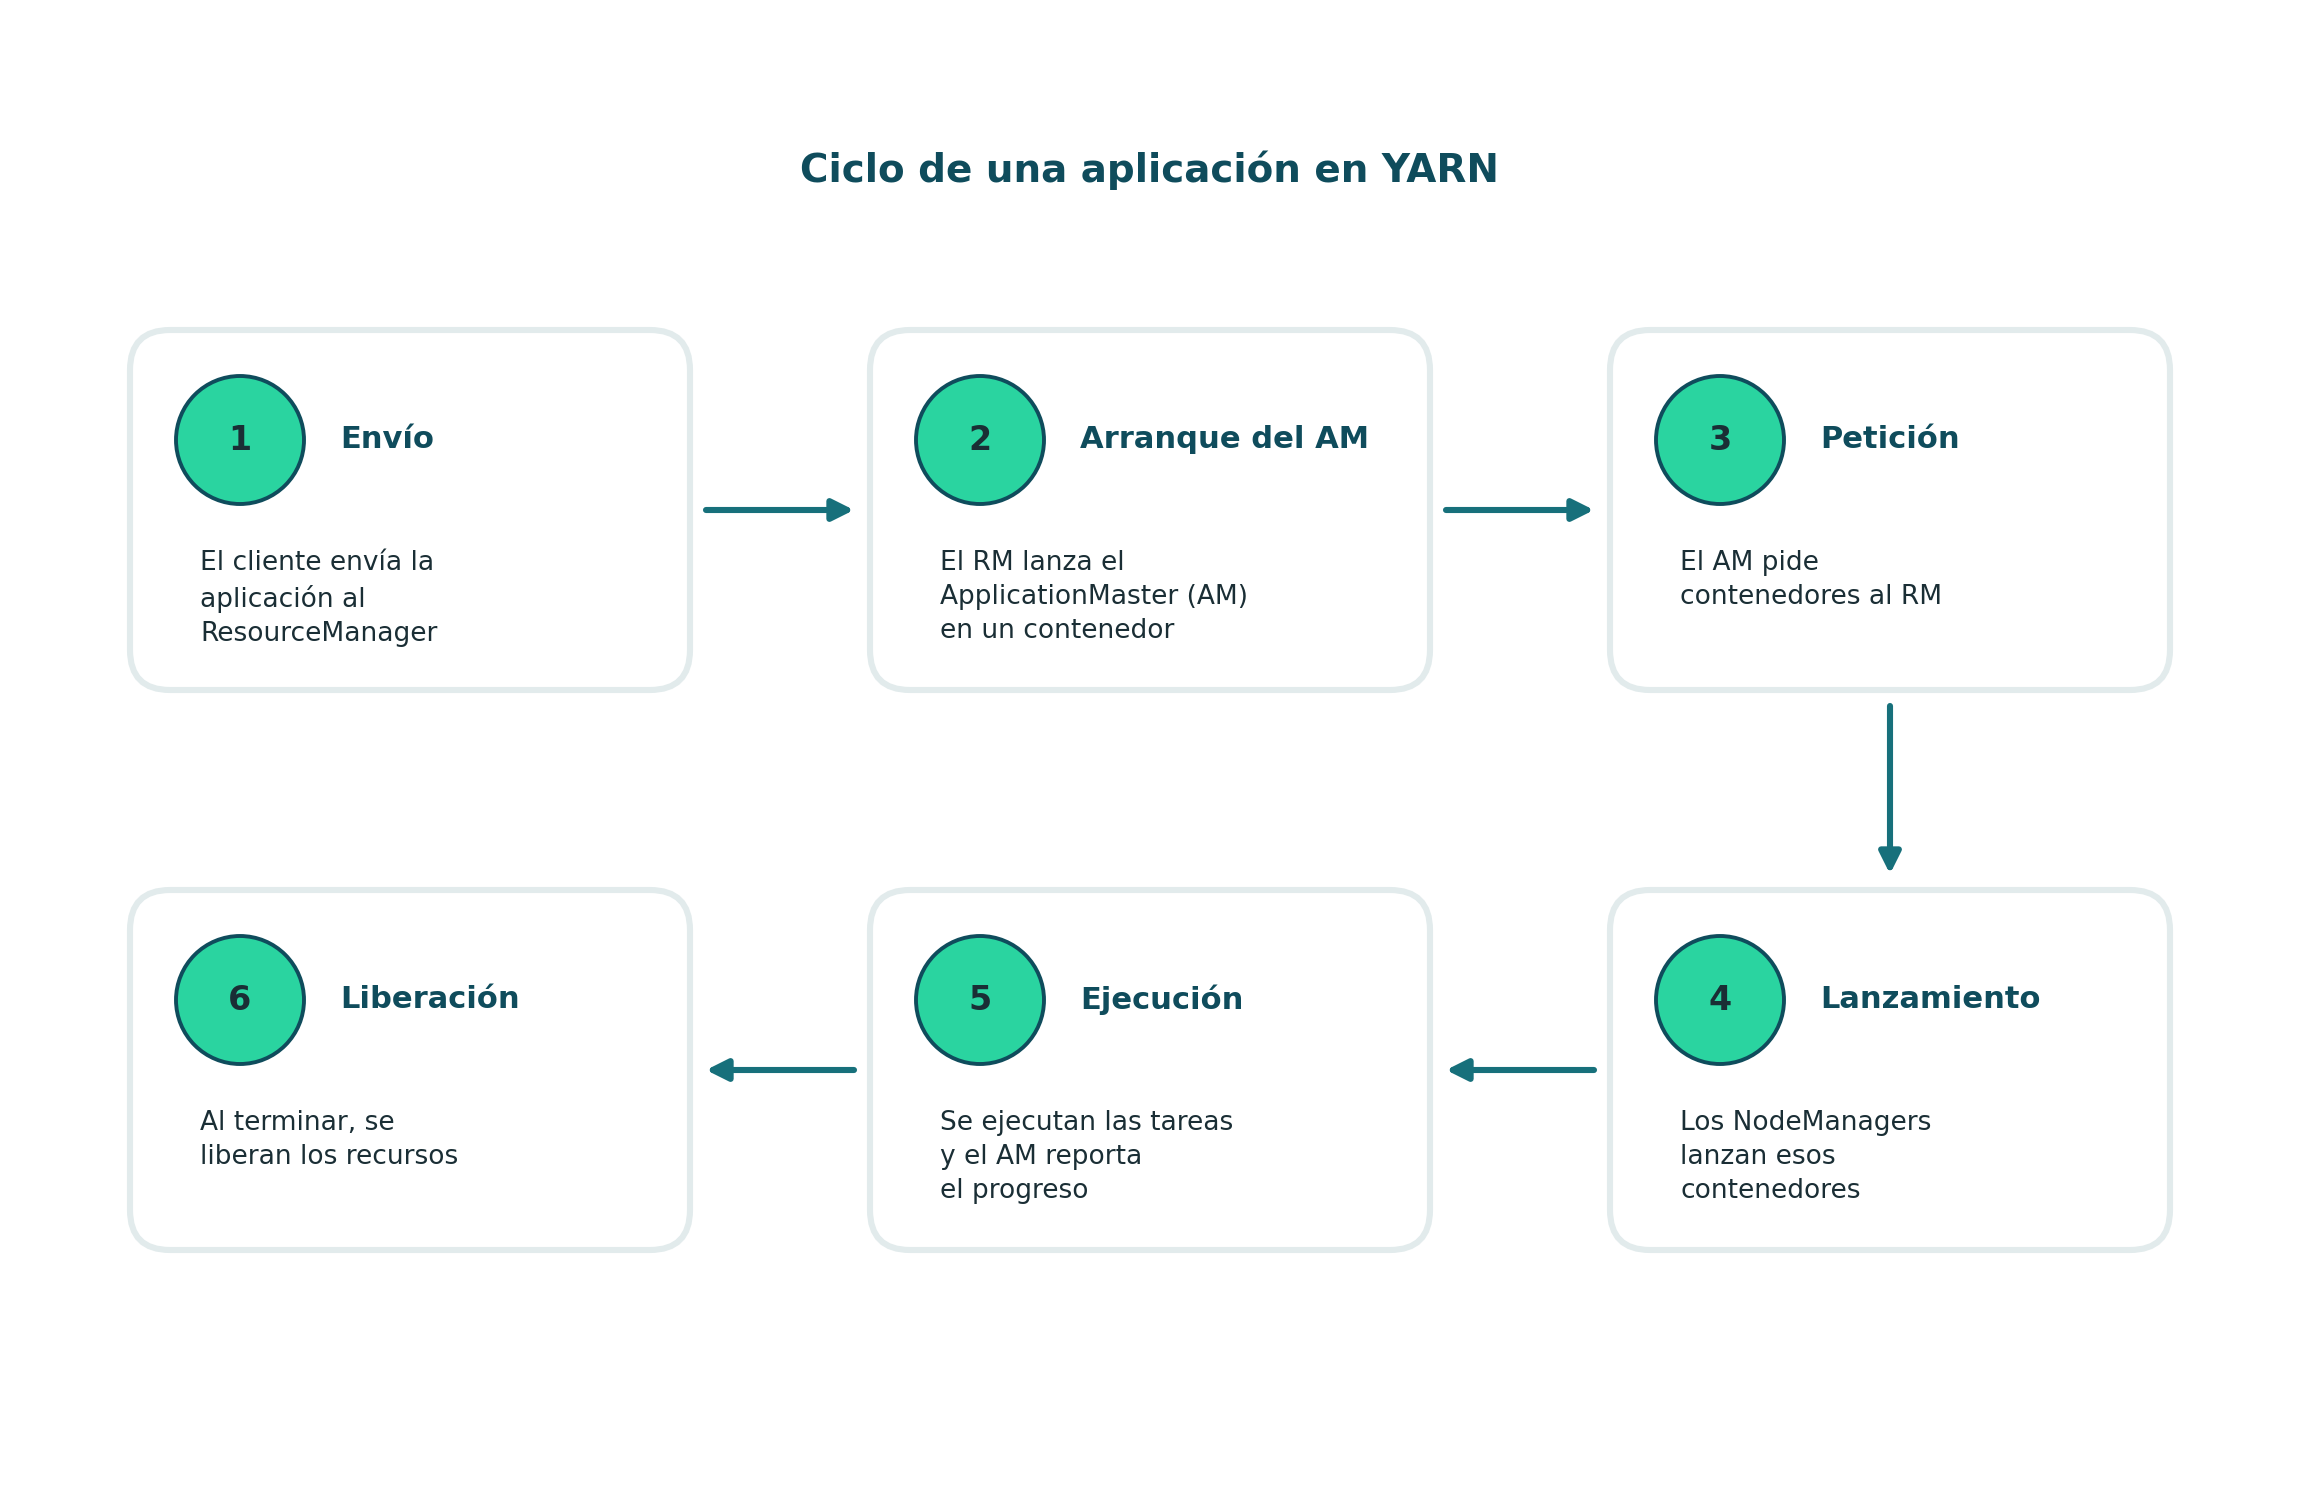
Figura 4. Los seis pasos del ciclo de una aplicación, del envío del cliente a la liberación de recursos.
1. El cliente envía la aplicación al ResourceManager
Tú —o más bien el programa cliente: hadoop jar, spark-submit con --master yarn, un envío de Hive— contactas al RM con una descripción: qué comando debe arrancar el AM, cuánta memoria necesita ese primer contenedor, en qué cola debe entrar, qué archivos locales hay que distribuir. El ApplicationsManager acepta o rechaza según políticas (permisos, recursos mínimos, estado del clúster). En los estados de YARN, eso es el paso de SUBMITTED a ACCEPTED.
Todavía no corre tu cálculo. Solo hay una ficha en la mesa: “esta aplicación existe y necesita un coordinador”.
2. El RM lanza el ApplicationMaster en un contenedor
El Scheduler reserva un contenedor para el AM en algún NodeManager con capacidad. El RM le pide a ese NM que arranque el proceso del AM. A partir de aquí hay un coordinador vivo, específico de tu motor: el AM de MapReduce no es el de Spark. YARN no sabe mapear ni reducir; sabe que hay un proceso al que le va a conceder más contenedores.
El AM se registra ante el RM: “ya estoy arriba; desde ahora yo negociaré”. El estado de la aplicación pasa a RUNNING.
3. El AM pide contenedores al RM
El AM estima cuántos trabajadores necesita y con qué forma: por ejemplo, 50 contenedores de 2 GB y 1 vcore. No pide “máquinas enteras”. Pide porciones.
Aquí entra la localidad de datos, el puente directo con HDFS. El AM (o el cliente, antes de enviarlo) consulta dónde están los bloques de entrada: el NameNode responde con hosts y réplicas, como viste en el capítulo de HDFS. Entonces el AM no pide contenedores “en cualquier parte”: pide, preferentemente, contenedores en los nodos que ya tienen esos bloques.
YARN trabaja con una jerarquía de preferencia que deberías reconocer:
- Local al nodo (node-local): el contenedor cae en la misma máquina que una réplica del bloque. Casi no hay red para leer el dato.
- Local al rack (rack-local): no había hueco en ese nodo, pero sí en otro del mismo rack. La lectura cruza el switch de rack, no todo el datacenter.
- Fuera (off-switch): el dato viaja más lejos. El trabajo no muere; solo paga red.
El planificador puede tardar un poco en conceder un nodo local antes de “relajarse” hacia el rack. Eso no lo decides tú en cada línea de código: lo pide el AM y lo aplica la política. El principio es el de Fundamentos: llevar el cómputo a los datos, ahora con un protocolo de negociación.
Si no hay recursos, el AM espera. No invade. Esa espera es precisamente el árbitro de la Parte 1 haciendo su trabajo.
4. Los NodeManagers lanzan esos contenedores
Cuando el Scheduler concede, el RM se lo comunica al AM (en la práctica, en las respuestas a los latidos del AM). El AM entonces no arranca procesos él mismo en máquinas remotas a lo bruto: le pide a cada NodeManager correspondiente que lance el contenedor con un contexto de ejecución (comando, variables, recursos locales).
El NM crea la reserva, arranca el proceso y lo vigila. Si el proceso se pasa de memoria, el NM puede matarlo. Si el nodo se degrada, lo reporta. El AM se entera y, si hace falta, pide un contenedor nuevo: la tolerancia a fallos de tareas vive aquí, no en el RM.
5. Se ejecutan las tareas y el AM reporta progreso
Dentro de cada contenedor corre una tarea (o un ejecutor que a su vez corre varias, según el motor). El AM coordina: quién ya terminó, quién falló, qué falta. Puede informar al RM del progreso agregado. El cliente puede preguntar al RM “¿sigue RUNNING?” o, según el motor, hablar más de cerca con el AM.
Durante este tramo el clúster es multiinquilino de verdad: tu AM solo ve tus contenedores. El Scheduler sigue repartiendo el resto del hardware a otras aplicaciones.
6. Al terminar, se liberan los recursos
Cuando el trabajo concluye —bien o mal—, el AM se da de baja ante el RM. Los NodeManagers limpian contenedores. La memoria y los vcores vuelven al pool. La cola puede darles inmediatamente a quien esperaba.
Si el AM muere a mitad de camino, el ApplicationsManager puede relanzarlo en otro contenedor. El AM nuevo reconstruye lo que pueda (por eso los motores guardan estado de progreso). Si muere un NM, se pierden sus contenedores y el AM pide sustitutos. El RM no reejecuta tus maps: repondrá recursos; el AM decide qué cálculo repetir.
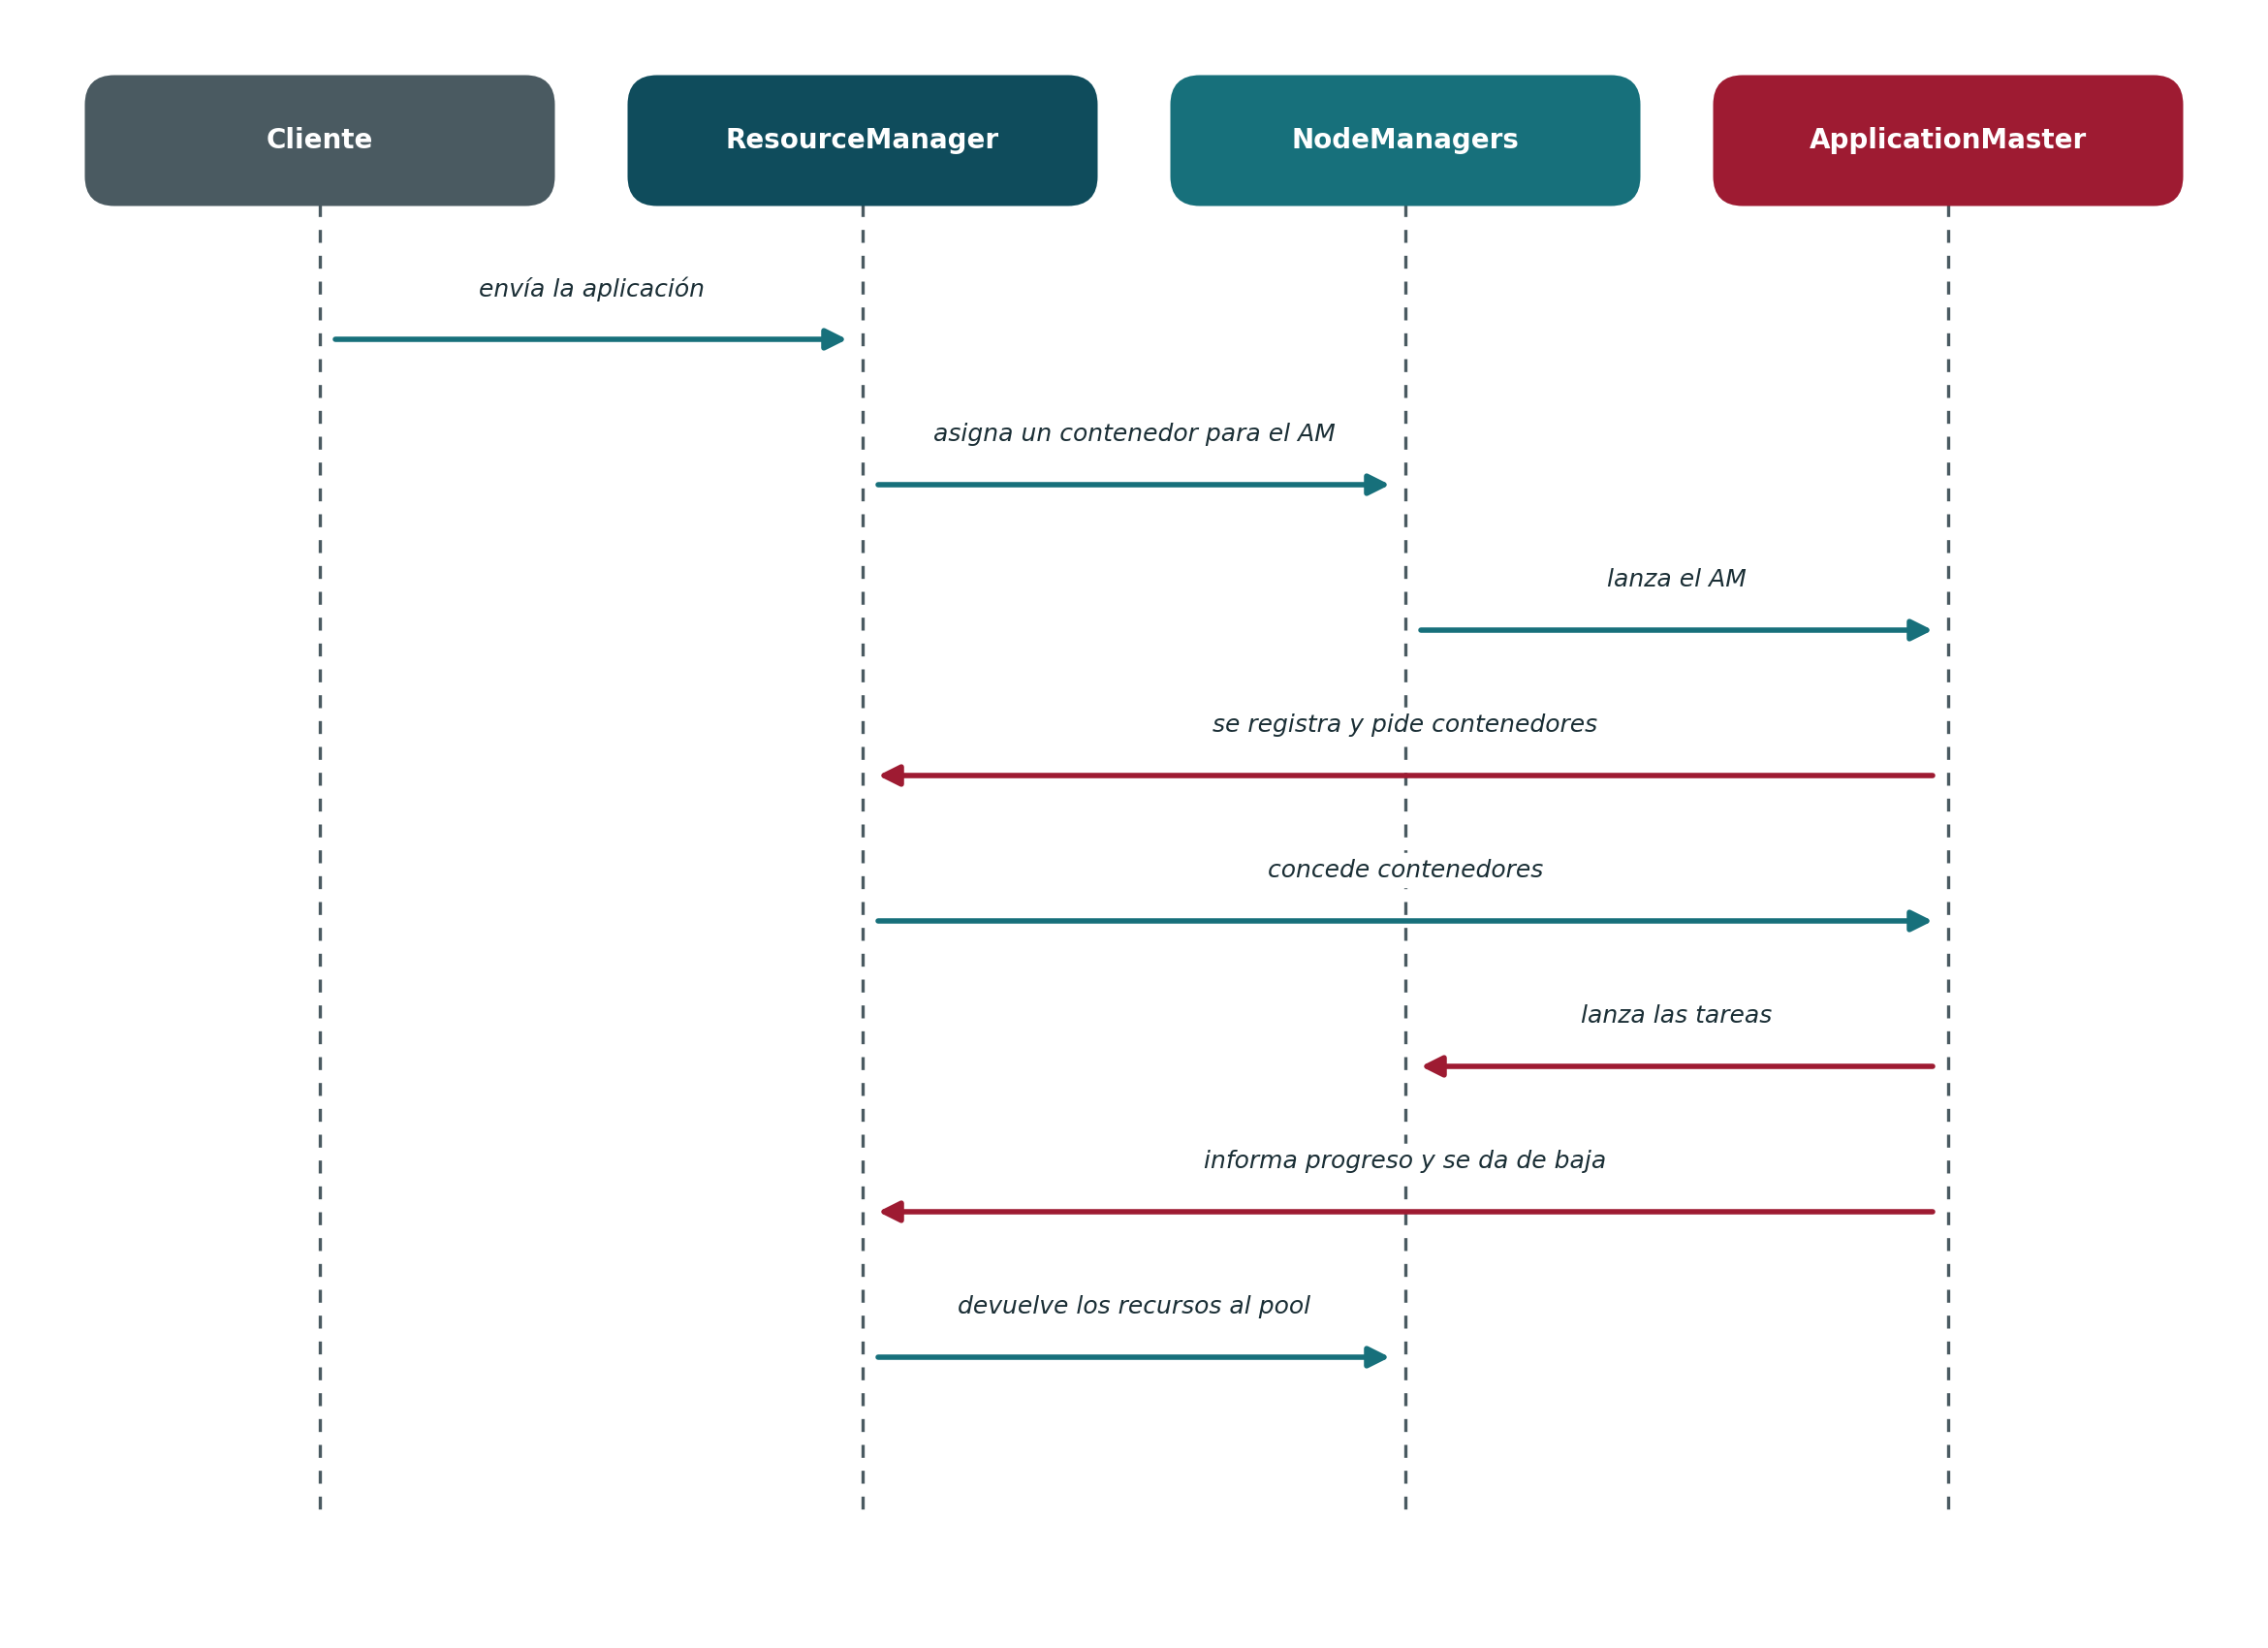
Figura 5. Secuencia de mensajes de una aplicación, del envío del cliente a la devolución de recursos.
Tres detalles que evitan malentendidos:
- El cliente no reparte el clúster. Solo envía. Después observa.
- El RM no conoce tu algoritmo. No distingue un reduce de un ejecutor Spark. Distingue aplicaciones, colas y contenedores.
- La localidad es una preferencia, no una garantía. Si el nodo que tiene el bloque está saturado, el planificador puede darte otro. HDFS seguirá sirviendo el bloque por red; YARN no va a dejar el job congelado para siempre esperando el nodo perfecto.
¿Para qué sirve este ciclo? Para seguir un trabajo de principio a fin sin magia. Cuando más adelante veas MapReduce o Spark “sobre YARN”, no es que el motor reemplace a YARN: es que ese motor aporta el AM y las tareas, y YARN aporta el derecho a existir en el hardware, ojalá cerca de los bloques que ya conoces de HDFS.
Parte 6 — Planificadores
Hasta aquí el RM “reparte”. Falta la política: cuando varios compiten, ¿quién gana? Eso es el planificador. YARN no impone una sola religión; el Scheduler es intercambiable (pluggable). En la práctica vas a oír tres modelos clásicos.
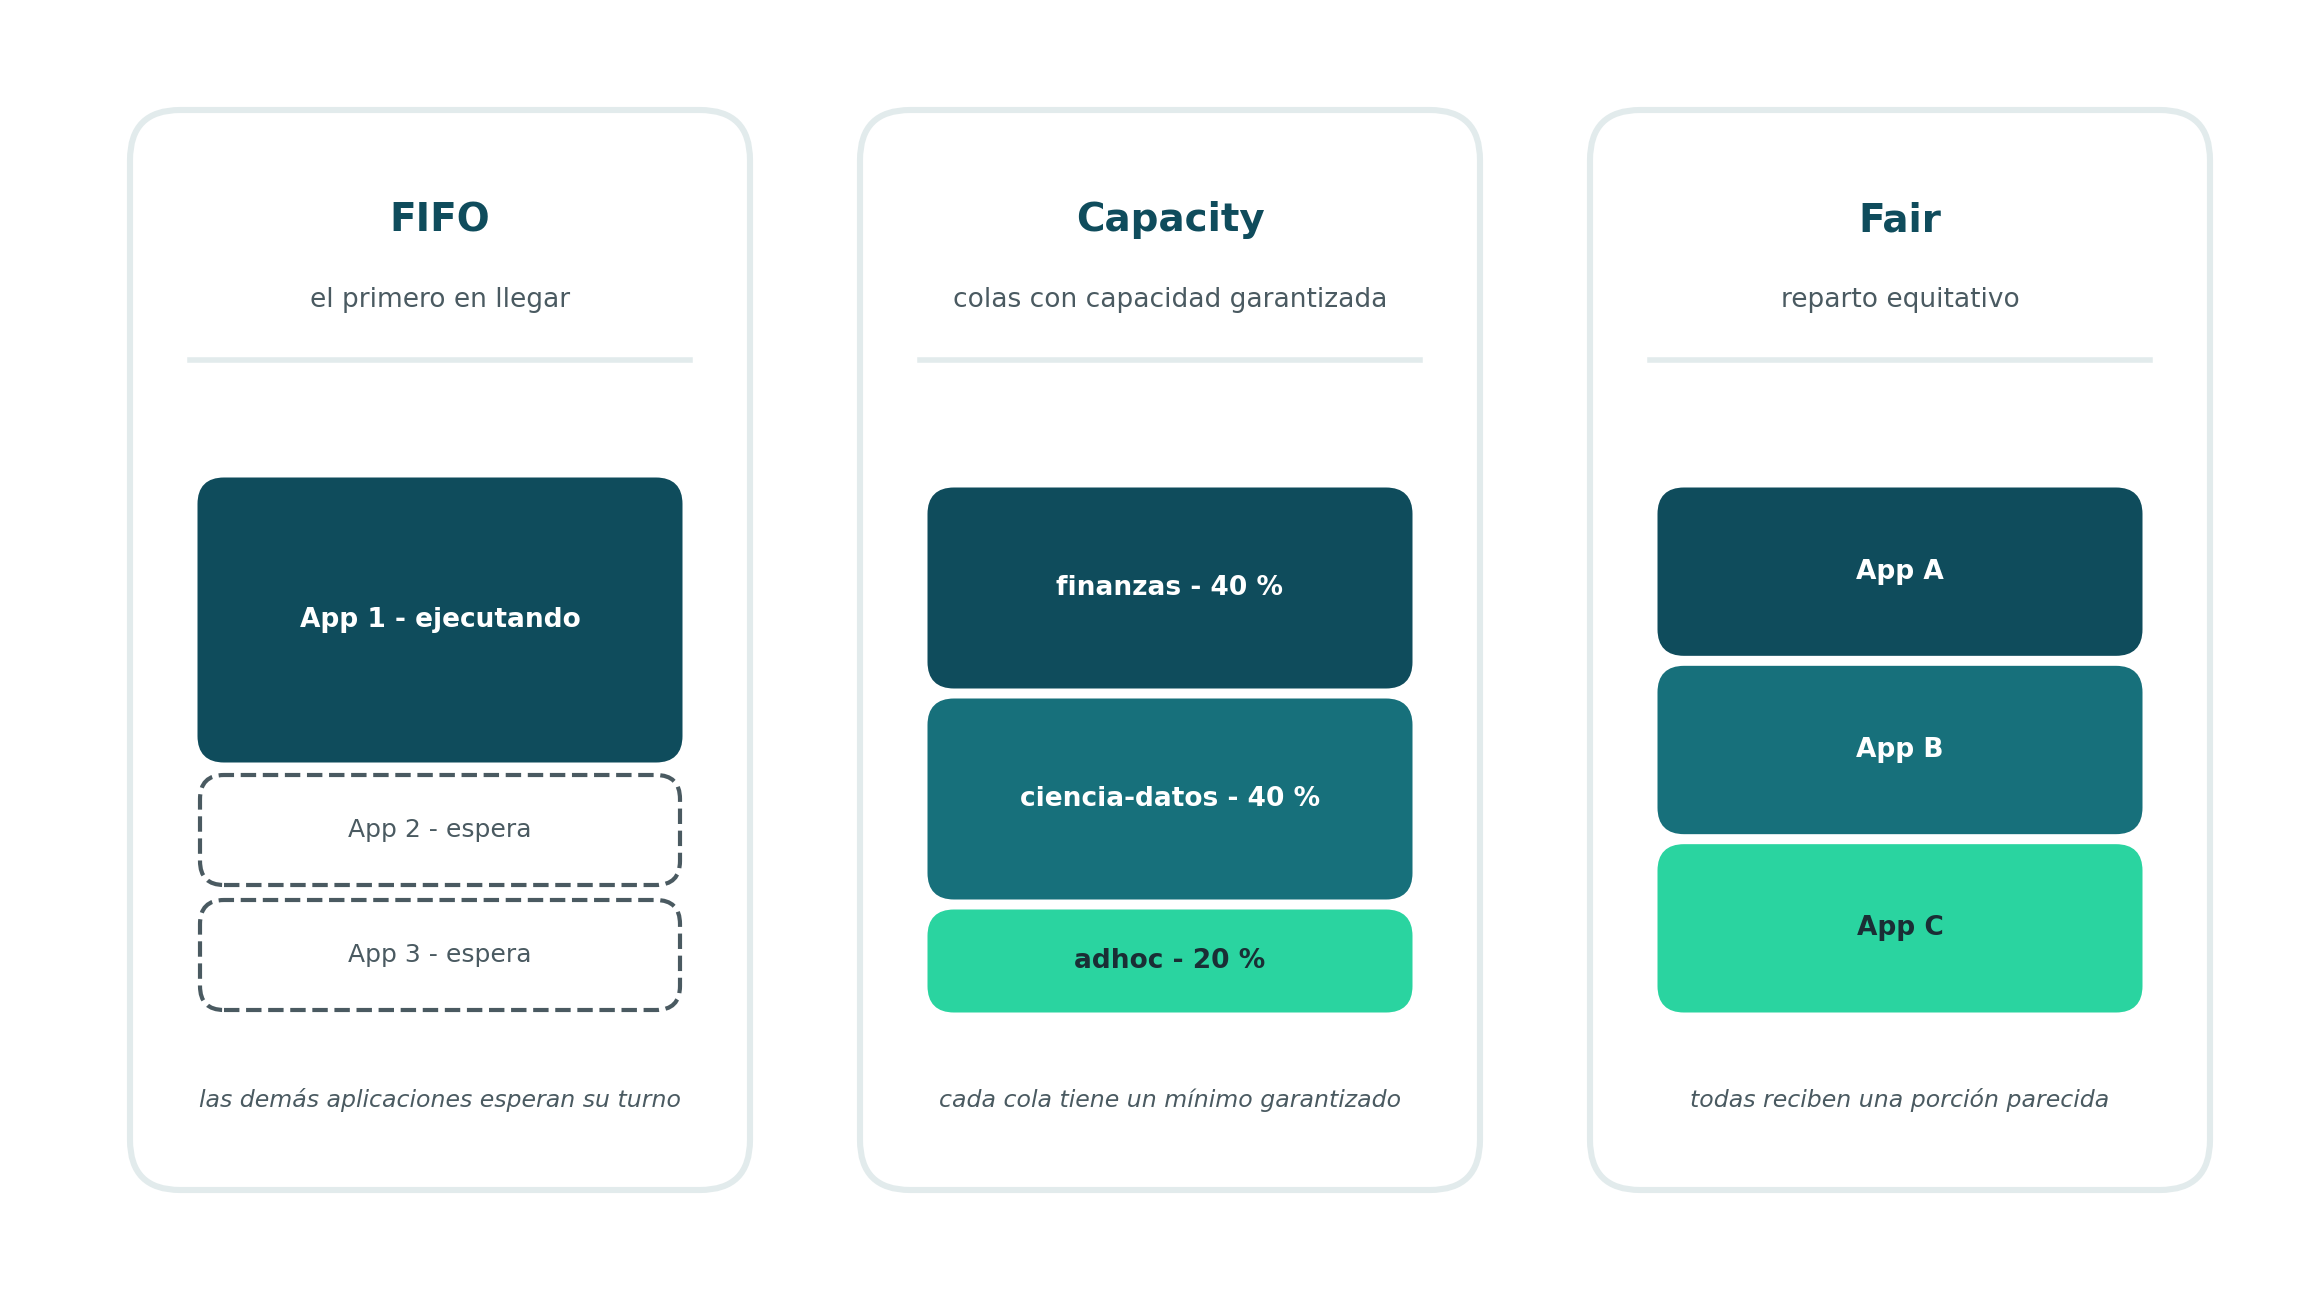
Figura 6. Tres políticas de reparto: FIFO, Capacity (colas con capacidad garantizada) y Fair (porciones parejas).
FIFO: el primero en llegar
FIFO (First In, First Out) es la cola del banco: el primer trabajo aceptado toma los recursos que necesite; los siguientes esperan. Es simple, predecible en un clúster pequeño y cruel en uno compartido. Un job enorme que llegó a las 8:00 puede dejar a diez jobs de cinco minutos mirando el techo hasta el mediodía.
Hadoop 1 vivía, en esencia, en este mundo. Sirve para entender el problema. En un clúster de producción con varios equipos, casi nunca es la respuesta.
Capacity Scheduler: colas con capacidad garantizada
El Capacity Scheduler (planificador de capacidad) parte el clúster en colas. Una cola es una partición lógica de la capacidad: un nombre, un porcentaje garantizado y, casi siempre, un techo. No es una máquina física. Es un derecho.
Imagina:
| Cola | Capacidad garantizada | Uso típico |
|---|---|---|
finanzas |
40 % | Cierres, regulatorios, lotes nocturnos |
ciencia-datos |
40 % | Entrenamiento, exploración |
adhoc |
20 % | Consultas de quien no tiene cola propia |
Finanzas puede usar más del 40 % si los demás no están ocupando su parte (elasticidad). No puede, en cambio, dejar a ciencia de datos en cero para siempre: hay un mínimo garantizado y suele haber un máximo. Dentro de cada cola, los trabajos se ordenan con su propia política (a menudo FIFO o por prioridad).
Este modelo encaja en una organización real: varios equipos, un solo clúster, presupuestos de hardware distintos. El administrador no reparte servidores con cinta adhesiva; reparte porcentajes. Capacity Scheduler es el predeterminado en Hadoop 2 y Hadoop 3, y es el que más vas a encontrar en plataformas empresariales.
Fair Scheduler: reparto equitativo
El Fair Scheduler (planificador equitativo) nació con otra intuición, muy asociada a Facebook en los años de Hadoop: las aplicaciones deben compartir con justicia el clúster a lo largo del tiempo. Si solo hay un job, se come todo. Cuando entra el segundo, el planificador tiende a dejarlos con una porción parecida, en vez de hacer esperar al nuevo hasta que el primero termine.
También se organiza en pools o colas, pero la pregunta mental no es “¿cuál es tu porcentaje garantizado de empresa?” sino “¿cómo evito que un inquilino acapare el presente?”. En clústeres con muchos jobs interactivos y lotes mezclados, esa idea se siente natural. En Hadoop 2 y 3.3 fue una opción real; a partir de Hadoop 3.4 se retiró. El protagonista de producción sigue siendo Capacity. Fair importa como modelo mental y como capítulo histórico del ecosistema.
Qué decide, en el fondo, un planificador
Ninguno de los tres escribe tu Spark. Todos contestan lo mismo con distinta ética:
- Quién espera y quién corre ahora.
- Cuánto puede crecer un equipo cuando el otro duerme.
- Si un job largo puede ser preemptado (desalojado en parte) para cumplir la garantía de otro.
- En qué cola cae tu envío si no especificas nada (casi siempre una
default).
Sin colas, el clúster es un piso compartido sin reglas. Con colas, es un edificio con contratos. El contrato no sustituye al AM ni al NM: condiciona qué contenedores el Scheduler está dispuesto a firmar.
¿Cuándo entra en juego el planificador? En el momento en que el clúster deja de ser “el mío un rato” y pasa a ser de varios. Si estás solo en un laboratorio, FIFO y Capacity se parecen. Si finanzas y ciencia de datos compiten a las 9:00, la cola es la diferencia entre una plataforma y una pelea.
Parte 7 — YARN en el ecosistema
Vuelve al mapa. Apache Hadoop no es una herramienta: son responsabilidades. Hadoop Common pone el suelo compartido. HDFS guarda. YARN arbitra recursos. MapReduce es un motor de procesamiento. El ecosistema alrededor —Hive, HBase, Spark, Tez, Flink— se entiende mejor cuando dejas de pegar logos al azar y preguntas en qué capa viven.
YARN es la capa intermedia:
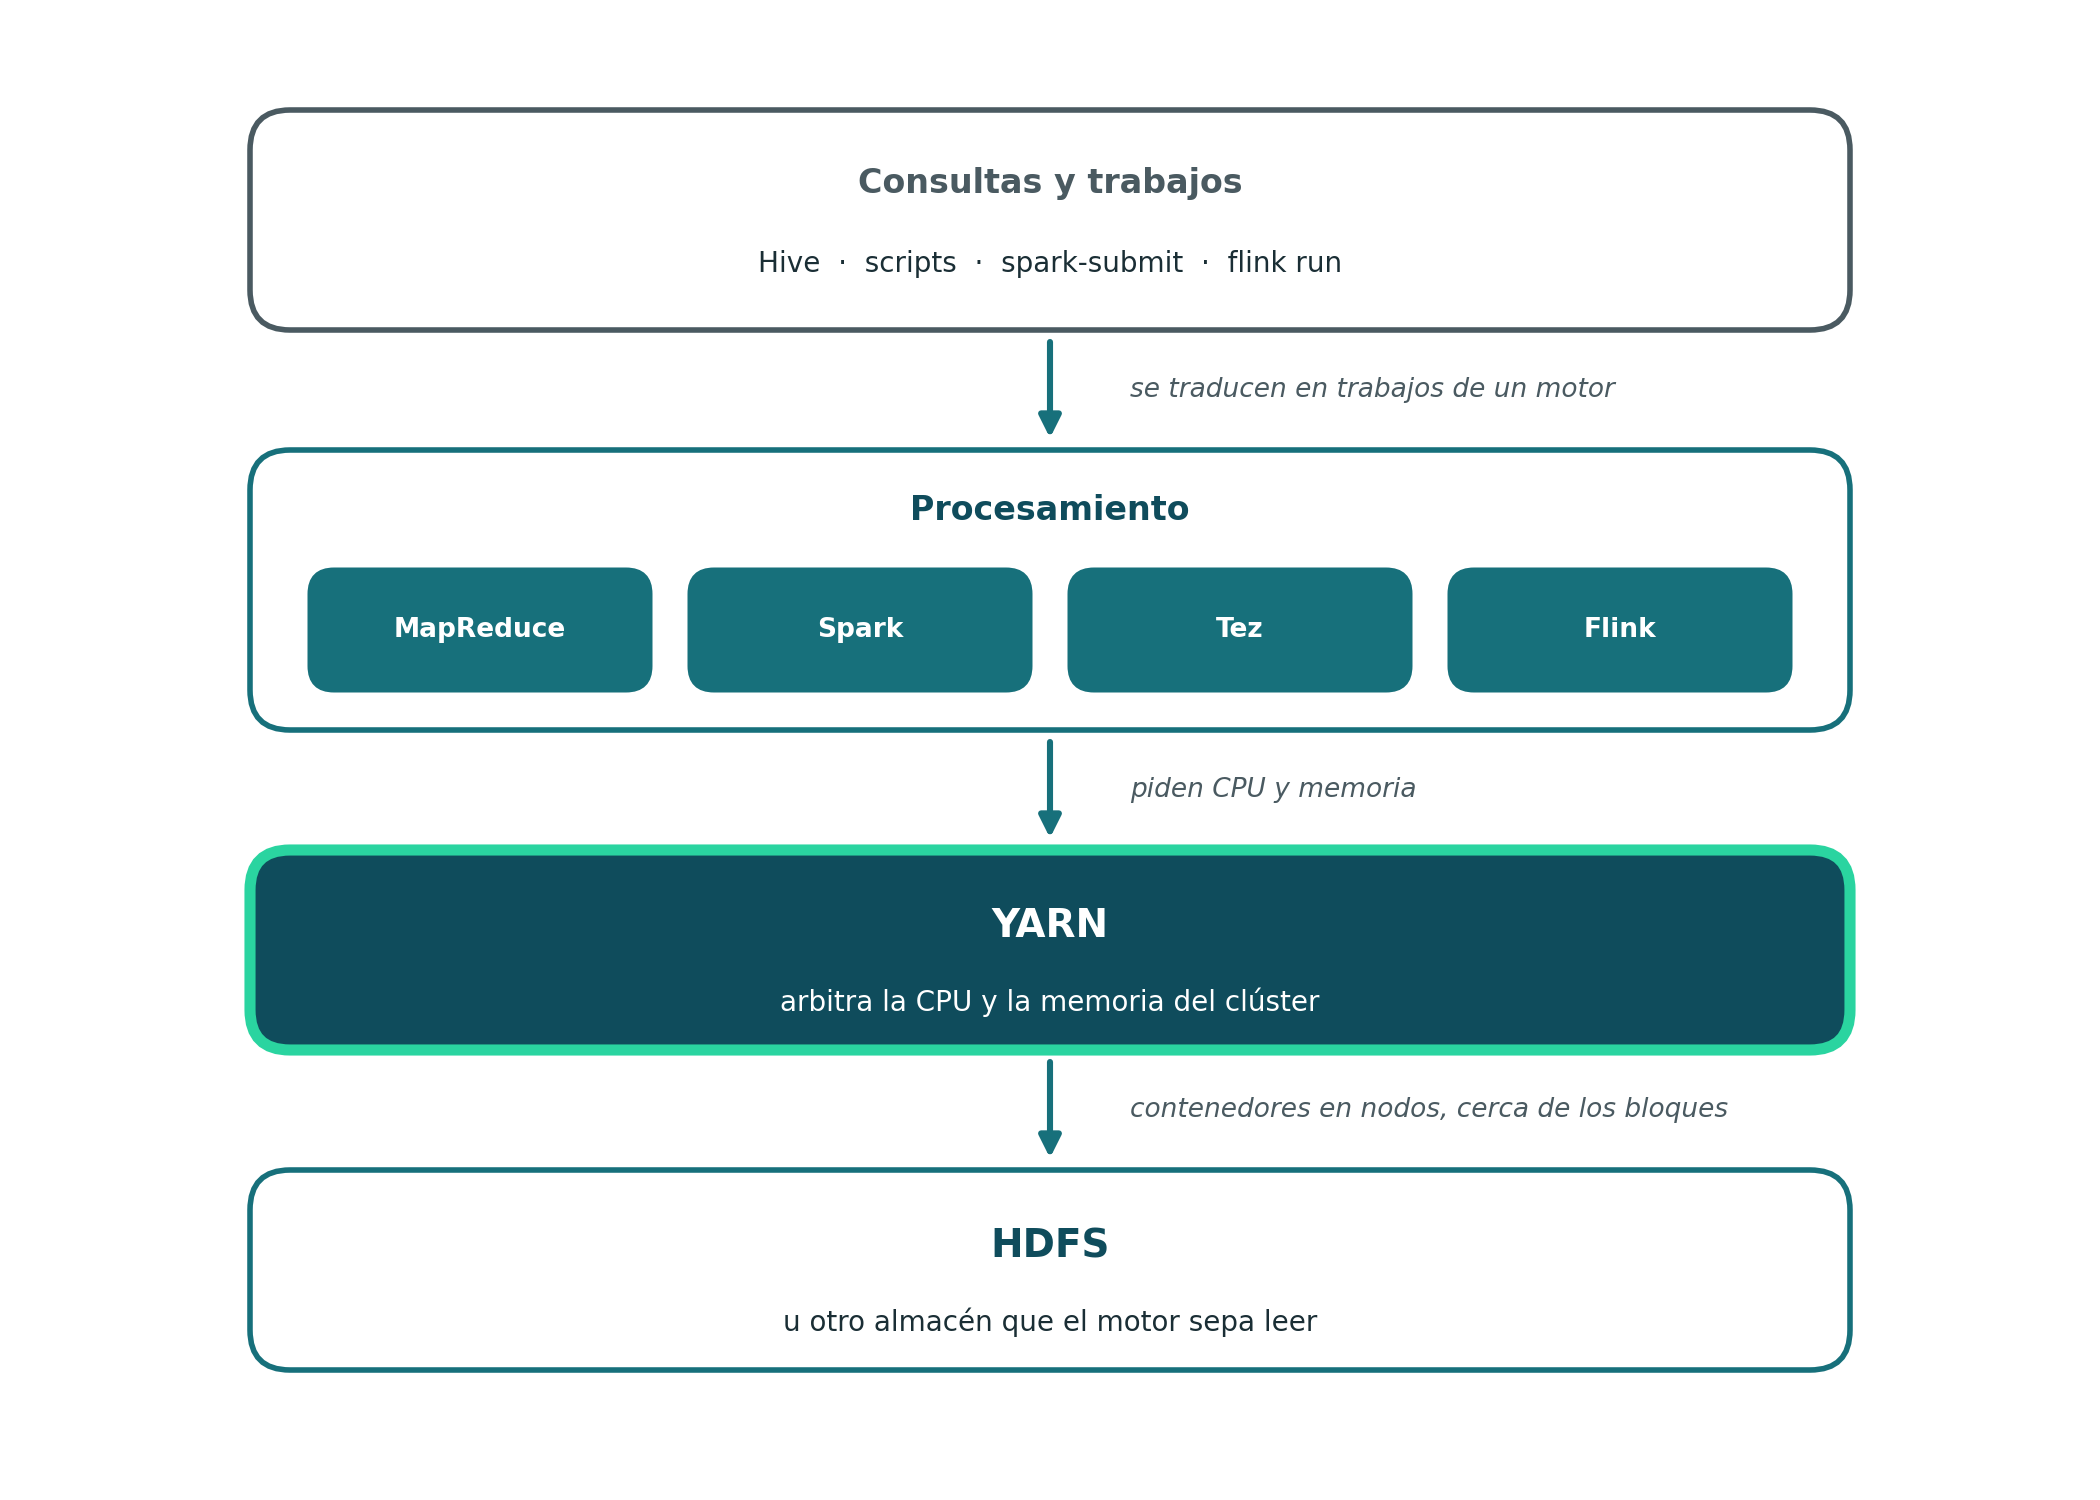
Figura 7. YARN como capa intermedia del ecosistema, con los motores encima y HDFS debajo.
Tres consecuencias prácticas de ese dibujo:
- Cambiar de motor no obliga a cambiar de disco. Spark puede leer el mismo HDFS que MapReduce. YARN les da a ambos un sitio donde correr.
- Cambiar de almacén no obliga a tirar YARN, aunque el emparejamiento clásico sea HDFS + YARN. Spark sobre YARN puede leer, por ejemplo, almacenamiento de objetos; perderás la localidad de disco local, no el árbitro.
- Hive no sustituye a YARN. Hive traduce SQL a trabajo de un motor (MapReduce, Tez o Spark). Ese motor, en un clúster Hadoop, pide recursos a YARN.
En el capítulo del ecosistema Hadoop, YARN quedó como caja cerrada a propósito: quién obtiene CPU y memoria, y dónde puede ejecutar. Ahora esa caja tiene piezas. El mapa no cambió. Solo se volvió habitable.
¿Para qué sirve colocarlo así? Para diagnosticar. Si el archivo no aparece, miras HDFS. Si el job está ACCEPTED y no arranca, miras YARN (colas, capacidad, AM). Si arrancó y el cálculo es lento o incorrecto, miras el motor. Mezclar las tres capas es la forma más cara de no resolver nada.
Parte 8 — Interfaz y modo de uso
Esta parte no es un laboratorio. No instales nada con lo que sigue. Los comandos y la interfaz web existen para que el modelo de las Partes 4 y 5 te deje de parecer abstracto: son vistas del mismo pacto (RM, nodos, aplicaciones, contenedores).
Desde un cliente Hadoop, la línea de comandos de YARN suele verse así de entrada: una lista de nodos que el ResourceManager considera vivos, con estado y contenedores en ejecución.
$ yarn node -list

Total Nodes:3
         Node-Id             Node-State    Node-Http-Address    Running-Containers
nodo1:8041                   RUNNING       nodo1:8042           2
nodo2:8041                   RUNNING       nodo2:8042           2
nodo3:8041                   RUNNING       nodo3:8042           0
Leído con la arquitectura en la cabeza: tres NodeManagers registrados; dos ocupados; uno sin contenedores. No es un docker ps. Es el RM diciéndote cómo ve el pool.
Las aplicaciones —no los archivos de HDFS— aparecen como fichas con identificador, cola, estado y progreso:
$ yarn application -list

Application-Id                    Name         Type        User   Queue    State    Progress
application_1725123456789_0001    wordcount    MAPREDUCE   ana    default  RUNNING  45%
application_1725123456789_0002    etl-diario   SPARK       luis   finanzas ACCEPTED 0%
Una aplicación recorre una cadena de estados. SUBMITTED es el instante en que el cliente ya la envió y el RM la está registrando. ACCEPTED significa que el RM la tomó: está en cola, a la espera de un contenedor para el ApplicationMaster —casi siempre porque aún no hay recursos—. RUNNING significa que el AM ya está en un contenedor y el trabajo avanza.
Cuando termina, el estado de cierre no es SUCCEEDED. Ese nombre es el estado final (Final-Status): el veredicto, no la fase. Los estados de cierre son:
FINISHED: el AM terminó y se dio de baja. Si el cálculo salió bien, el estado final suele serSUCCEEDED.FAILED: el trabajo fracasó (un error, un AM que no pudo relanzarse, etc.).KILLED: alguien lo canceló (el cliente, un administrador o una política).
FINISHED dice “ya no corre y el AM se despidió en orden”; el Final-Status SUCCEEDED confirma que el cálculo salió bien. FAILED y KILLED son a la vez estado y veredicto: fracasó o lo cancelaron. El identificador application_… es la llave para pedir logs agregados:
$ yarn logs -applicationId application_1725123456789_0001yarn top se parece, en espíritu, a un visor de actividad del clúster: aplicaciones, recursos usados, una foto viva del pool. No es tu top de Linux en una sola máquina; es el equivalente mental a escala YARN.
La otra cara es la Web UI del ResourceManager, el portal HTTP del maestro. En muchas instalaciones clásicas escucha en el puerto 8088. Ahí suele haber, con nombres que ya puedes traducir:
- métricas del clúster (memoria y vcores totales, usados, reservados);
- lista de nodos (lo mismo que
yarn node -list, con más detalle); - lista de aplicaciones y su estado;
- vista del Scheduler y las colas (quién tiene qué porcentaje, quién está saturado).
Si abrieras esa UI en un clúster de ejemplo, no estarías “administrando Docker”. Estarías mirando al árbitro: cuánto hardware hay, quién lo pidió y en qué cola espera. El NameNode tiene su propio portal para bloques y archivos; este portal es el de recursos. Confundirlos es confundir HDFS con YARN.
¿Para qué sirve conocer la interfaz así? Para que, cuando en el laboratorio o en el taller listes nodos o abras el puerto del RM, ya sepas qué pregunta le estás haciendo al clúster. El comando no enseña el modelo. El modelo hace que el comando tenga sentido.
Parte 9 — Usos, límites y la era de la nube
YARN no es eterno ni universal. Es la respuesta correcta a un recuadro, y una respuesta mediocre fuera de él.
Es la elección natural cuando:
- Operas (o heredas) un clúster Hadoop con HDFS, colas y un ecosistema que ya habla YARN: Hive, Spark on YARN, jobs MapReduce, Tez.
- Te importa la localidad respecto a bloques en disco local: DataNode y NodeManager en el mismo host.
- Varios equipos comparten un pool on-premise y las colas son el contrato político del hardware.
- El patrón dominante es lote o micro-lote de datos, no un enjambre de microservicios.
No es la elección natural cuando:
- Estás nativo en la nube con almacenamiento de objetos y clústeres de cómputo efímeros: levantas Spark, procesas, apagas. El árbitro suele ser el servicio gestionado o Kubernetes, no un RM que tú operas.
- Necesitas orquestar contenedores Docker/OCI como unidad primera —servicios, APIs, jobs mixtos— con el modelo de pods, deployments y namespaces.
- No quieres cargar con la operación del stack Hadoop solo para tener un planificador.
Kubernetes es, hoy, el gestor de recursos que el resto de la industria usa como sistema operativo del datacenter: declara pods, les pone límites de CPU y memoria, los reparte entre nodos, reinicia lo que muere. Spark, Flink y muchos motores corren sobre Kubernetes. Databricks y buena parte del Spark gestionado ni siquiera te enseñan YARN. Eso no “mata” las ideas de este capítulo. Las traslada.
Lo que sigue vigente del modelo YARN, aunque el producto se llame de otra forma:
- Separar quién reparte el hardware de quién calcula.
- Pedir memoria y CPU en unidades explícitas, no “la máquina entera”.
- Un coordinador por aplicación (el AM; en Spark, en modo cluster, coincide con el driver) y trabajadores que nacen y mueren.
- Multiinquilino con particiones lógicas (colas aquí; namespaces y quotas allá).
- La localidad como preferencia de colocación, no como milagro.
YARN fue el negociador que permitió que Hadoop 2 dejara de ser “el sistema de MapReduce” y se volviera una plataforma. Kubernetes generalizó esa negociación a cualquier carga empaquetada en contenedores. En un lago on-premise clásico, YARN sigue siendo el centro. En una arquitectura nueva, a menudo verás el mismo dibujo con otros nombres.
Puente al siguiente tema
Ya sabes dónde viven los datos (HDFS) y quién concede el derecho a usar las máquinas (YARN). Falta el cálculo. Un trabajo MapReduce sobre YARN no reemplaza al ResourceManager: es una aplicación cuyo ApplicationMaster parte el input en maps, pide contenedores cerca de los bloques, lanza tareas y combina reduces. Spark hace otro tanto con su propio AM y sus ejecutores.
El siguiente paso del libro es precisamente ese: cómo un motor de procesamiento se ejecuta sobre YARN —empezando por MapReduce como modelo mental, y siguiendo con Spark como el motor que hoy ocupa ese lugar en la práctica—. Con este capítulo ya no vas a oír “corre en Hadoop” como una frase hueca. Vas a poder preguntar: ¿en HDFS, en YARN, o en el motor?
Referencias para profundizar
- Apache Hadoop, Apache Hadoop YARN.
- Apache Hadoop, YARN Commands.
- Apache Hadoop, Capacity Scheduler.
- Apache Hadoop, Fair Scheduler (documentación de Hadoop 3.3.6; el planificador se retiró en Hadoop 3.4).
- Vinod Kumar Vavilapalli et al., Apache Hadoop YARN: Yet Another Resource Negotiator (SoCC 2013).
Resumen
En este capítulo aprendiste:
- Qué significa gestionar recursos y planificar trabajos en un clúster compartido: memoria, CPU y un árbitro para que un inquilino no se coma el hardware.
- Por qué Hadoop 1 se quedó corto: el JobTracker mezclaba planificación global y seguimiento de cada tarea, era cuello de botella y punto único de falla, y solo sabía ejecutar MapReduce.
- Qué es YARN (Yet Another Resource Negotiator): el gestor de recursos de Hadoop 2, el “sistema operativo del clúster”, nacido para separar recursos y modelo de cómputo.
- La arquitectura: ResourceManager (Scheduler + ApplicationsManager), NodeManager en cada nodo, ApplicationMaster uno por aplicación, y contenedor como reserva lógica de memoria y vcores —distinta de un contenedor Docker—.
- El ciclo: el cliente envía, el RM lanza el AM, el AM pide contenedores cerca de los bloques de HDFS, los NM los arrancan, las tareas corren y al final los recursos vuelven al pool.
- Los planificadores FIFO, Capacity (colas con capacidad garantizada, el predeterminado) y Fair, y para qué sirve una cola en una organización con varios equipos.
- El lugar de YARN en el mapa: almacenamiento (HDFS) → recursos (YARN) → procesamiento (MapReduce, Spark, Tez, Flink).
- Cómo se ve el modelo en
yarn node -list,yarn application -list, logs y la Web UI del RM, sin convertir eso en un laboratorio. - Cuándo YARN es la pieza correcta, cuándo el mundo se movió hacia Kubernetes, y qué ideas del negociador siguen vivas.
Ya no se trata de memorizar daemons. Se trata de saber quién arbitra el clúster, quién coordina tu aplicación y por qué esa distinción —la que Hadoop 1 no tuvo— es lo que permite que varios motores compartan los mismos datos y las mismas máquinas.
La práctica continúa en el siguiente capítulo, Laboratorio: YARN con Docker: sobre el mismo clúster de HDFS levantarás un ResourceManager y dos NodeManagers, y enviarás tus primeros trabajos MapReduce.