Apéndice C — Herramientas de orquestación: Prefect, Airflow y Dagster
mlops
orquestacion
herramientas
envios
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
30 de octubre de 2026
Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
El problema que vas a resolver
En el capítulo 7 vas a construir un motor pequeño para el lote nocturno de Laura: seis tareas en orden, un reintento cuando la fuente tarda, una bitácora en JSONL y una segunda llamada que no duplica la entrega. Ese motor funciona, pero deja tres preguntas sin responder. ¿Quién lo lanza a las 2:00 de la mañana si nadie abre el notebook? ¿Dónde mira el equipo lo que pasó anoche sin leer un archivo de eventos línea por línea? ¿Qué pasa cuando el lote ya no son 6 tareas sino 60?
Para eso existen las herramientas de orquestación. Este anexo instala las tres más usadas en Python (Prefect, Airflow y Dagster). Antes del caso de Laura, harás tres ejemplos sencillos para un primer contacto: un flujo de dos tareas, un ETL de cinco envíos y una tarea que se reintenta y se reutiliza. Después llevarás a cada herramienta las mismas seis funciones del lote de Laura. Con Prefect harás la demostración completa dentro del notebook: el corte de la fuente, la segunda noche sin repetir trabajo, la báscula dañada y la interfaz web. Airflow y Dagster quedan instalados y probados con el mismo lote, para que puedas compararlos.
Ficha
En este anexo
Pregunta
¿Cómo se pasa del motor casero del capítulo 7 a una herramienta que programa, registra y muestra cada noche?
Datos
Los 600 envíos sintéticos del libro y un lote con la báscula dañada (semilla SEMILLA + 1)
Herramientas
Prefect 3.9.1 (ejecutado aquí), Airflow 3.3.2 y Dagster 1.13.28 (probados desde la terminal)
Lo que produces
Tres flujos de ejemplo, un flujo de Prefect programado, un DAG de Airflow y un grafo de activos de Dagster sobre las mismas funciones
Tiempo estimado
Entre 60 y 90 minutos, contando las instalaciones
Nivel
Intermedio
Objetivos de aprendizaje
Al terminar este anexo podrás:
Nombrar las piezas que una herramienta de orquestación agrega al motor del capítulo 7.
Elegir entre Prefect, Airflow y Dagster según cómo trabaja tu equipo.
Instalar las tres herramientas con versiones fijas sin romper el entorno de los capítulos.
Escribir en Prefect un flujo mínimo, un ETL y una tarea con reintento y caché.
Convertir funciones de Python en un flujo de Prefect con reintentos, caché y dependencias explícitas.
Leer en la interfaz web qué pasó en cada noche y por qué falló una.
Programar el flujo para que corra solo y limpiar todo lo que creaste.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Huella
El SHA-256 de unos bytes identifica un archivo mejor que su nombre.
1) Qué agrega una herramienta al motor del capítulo 7
Piensa en la cocina de un restaurante. El motor del capítulo 7 es un cocinero que sigue la receta en orden y anota en una libreta lo que hizo. Funciona mientras él esté. Una herramienta de orquestación agrega lo que tiene una cocina organizada: alguien que enciende los fogones a la hora fijada, un tablero donde cualquiera ve qué platos salieron y cuáles se quemaron, y un archivo de comandas que no depende de la memoria de nadie.
NotaOrquestador
Un orquestador es un programa que ejecuta flujos de tareas por ti: decide el orden, lanza cada tarea, reintenta las que fallan por algo pasajero, guarda el estado de cada intento en una base de datos y lo muestra en una interfaz web. Algunos también programan las ejecuciones (por ejemplo, cada noche a las 2:00) y reutilizan resultados que ya calcularon.
Piezas de un orquestador. El motor de ejecución es lo que el capítulo 7 construye a mano; las demás piezas son lo que la herramienta agrega.
La tabla compara pieza por pieza. La columna de la izquierda es lo que el capítulo 7 escribe a mano; la de la derecha, lo que la herramienta te da hecho.
En el capítulo 7
En una herramienta de orquestación
TopologicalSorter calcula el orden
El motor deduce el orden de las dependencias que declaras
Un bucle con max_intentos = 2 para TimeoutError
Un parámetro de la tarea: retries=2
estado.json con huellas para no repetir trabajo
Caché de tareas, con una llave que tú defines
eventos.jsonl, que lees con pandas
Una base de datos de estados y una interfaz web
Alguien ejecuta la celda
Un programador lanza el flujo a la hora fijada
En pocas palabras: la lógica del lote (qué hace cada tarea y qué regla decide la entrega) sigue siendo tuya. La herramienta se encarga de todo lo que rodea esa lógica.
2) Tres herramientas, tres maneras de pensar
Prefect, Airflow y Dagster resuelven el mismo problema, pero cada una parte de una idea distinta sobre qué es un flujo. Conviene entender esa idea antes de instalar nada, porque decide cómo vas a escribir el código.
NotaPrefect
Prefect convierte funciones de Python en tareas con el decorador @task y las reúne en un flujo con @flow. El flujo es una función normal: lo llamas, y Prefect registra lo que ocurre. Los datos pasan de una tarea a otra como valores de Python, igual que en un script.
NotaAirflow
Airflow organiza el trabajo en un DAG: un archivo de Python que declara tareas y dependencias y que un programador recorre según un calendario. Es la herramienta con más años y más uso en empresas. Entre tareas solo viajan valores pequeños (lo que Airflow llama XCom); los datos grandes se guardan en disco o en una base y se pasa la ruta.
NotaDagster
Dagster pone en el centro los activos: los datos que deben existir al final (el lote revisado, el modelo, las métricas). Cada activo es una función cuyo nombre es el del dato que produce. Producir un activo se llama materializarlo. Las dependencias salen de los nombres de los parámetros.
El mismo lote, dibujado por cada herramienta. En Dagster las cajas son resultados; en Prefect y Airflow, acciones.
Prefect
Airflow
Dagster
Cómo declaras una dependencia
Pasando el resultado de una tarea a otra
Con >> o pasando el resultado en una tarea @task
Con el nombre de un parámetro igual al de otro activo
Cómo viajan los datos
Como valores de Python
Valores pequeños; lo demás, por archivos
Como valores, guardados por Dagster
Correr sin servidor
Sí, con un servidor temporal
airflow dags test
dagster asset materialize
Windows
Funciona
Solo dentro de WSL2 o Docker
Funciona
Peso de la instalación
Ligera
Pesada: programador, servidor y base de datos
Media
Cuándo la elegiría
Equipo pequeño que ya escribe Python y quiere empezar hoy
Empresa que ya la tiene o que necesita sus integraciones
Equipo que piensa en tablas y modelos que deben estar al día
Mi criterio, después de verlas en proyectos: si el equipo de Laura empieza de cero, Prefect es la ruta más corta. Si la empresa ya tiene Airflow, no vale la pena traer otra herramienta para un solo modelo. Dagster brilla cuando hay muchas tablas que dependen unas de otras y la pregunta frecuente es «¿este dato está al día?».
3) Instalar las tres herramientas
NotaEntorno virtual
Un entorno virtual es una carpeta con su propio Python y sus propias bibliotecas. Lo que instalas dentro no toca a los demás entornos. Aquí lo usas para que Airflow y Dagster traigan sus dependencias sin pisar las del entorno con el que se ejecutan los capítulos del libro.
Las tres herramientas dependen de decenas de bibliotecas, y no siempre de las mismas versiones. Prefect es la más liviana y es la que usa este notebook, así que va en el mismo entorno de los capítulos. Airflow, en cambio, fija sus dependencias con un archivo de restricciones que cambiaría muchas bibliotecas de ese entorno, y Dagster agrega varias más. Las dos van en entornos propios, donde repites las bibliotecas que usan las tareas de Laura con las versiones del libro.
Prefect entra al entorno del libro; Airflow y Dagster van en entornos aparte que repiten las bibliotecas de las tareas.
Ejecuta todos los comandos desde la carpeta de este anexo. Se probaron en Linux con Python 3.13.14. En macOS son iguales. En Windows, Prefect y Dagster se instalan con los mismos pip install; solo cambia la activación del entorno (.venv-dagster\Scripts\Activate.ps1 en PowerShell). Airflow no corre directamente en Windows: usa WSL2 o Docker.
Instalar Prefect
Activa el entorno con el que ejecutas los capítulos del libro e instala Prefect allí:
pip install "prefect==3.9.1"prefect version
Salida esperada (primeras líneas):
Version:              3.9.1
API version:          0.8.4
Python version:       3.13.14
Durante la instalación, pip cambia la versión de FastAPI: Prefect 3.9.1 exige una anterior a 0.151, así que pasa de 0.162.0 a 0.150.0. Los capítulos 9 a 11 se ejecutaron con FastAPI 0.150.0 y sus listas de versiones fijadas lo registran, así que el entorno del libro queda coherente.
Instalar Airflow
Airflow se instala con su archivo de restricciones: una lista publicada por el proyecto con la versión exacta de cada dependencia que se probó con esa versión de Airflow y de Python. Sin él, pip puede elegir combinaciones que nunca se probaron juntas. Las bibliotecas de las tareas van en un segundo comando, sin restricciones.
python3.13-m venv .venv-airflowsource .venv-airflow/bin/activatepip install "apache-airflow==3.3.2"\--constraint"https://raw.githubusercontent.com/apache/airflow/constraints-3.3.2/constraints-3.13.txt"pip install "pandas==3.0.5""numpy==2.5.1""scikit-learn==1.9.0""joblib==1.5.3"airflow version
Salida esperada:
3.3.2
Instalar Dagster
dagster-webserver trae la interfaz web; sin él, Dagster funciona desde la terminal, pero no hay nada que abrir en el navegador.
Si las tres versiones coinciden, las herramientas están montadas. Lo que sigue usa el entorno del libro hasta la sección 7.
4) Primeros pasos con Prefect: tres ejemplos
Antes del caso de Laura, conviene conocer Prefect con ejemplos que caben en una pantalla. Son tres, cada uno con una idea nueva: un flujo de dos tareas, un ETL de cinco envíos y una tarea que se reintenta y luego se reutiliza de la caché. Todo lo que verás en la sección 6 es una combinación de estas tres piezas.
La primera celda prepara el entorno. Prefect guarda su base de datos (SQLite) y su caché en la carpeta que indica PREFECT_HOME. Aquí la pones en una carpeta propia del anexo dentro de tu carpeta de usuario, ~/.prefect-anexo-orquestacion, y la vacías al empezar para que cada ejecución parta de cero. No va junto al notebook por una razón práctica: si trabajas en WSL y el libro está en un disco de Windows (/mnt/c, /mnt/d), SQLite no puede bloquear bien sus archivos y el servidor de Prefect responde con 500 Internal Server Error a mitad de una corrida. En la carpeta de usuario de Linux ese problema no existe.
import jsonimport loggingimport osimport platformimport shutilfrom pathlib import Path# Todo lo que crea el anexo vive en artefactos/; cada ejecución parte de cero.shutil.rmtree("artefactos", ignore_errors=True)Path("artefactos").mkdir()# La base SQLite de Prefect va en la carpeta de usuario, no en un disco de Windows.CARPETA_PREFECT = Path.home() /".prefect-anexo-orquestacion"shutil.rmtree(CARPETA_PREFECT, ignore_errors=True)os.environ["PREFECT_HOME"] =str(CARPETA_PREFECT)os.environ["PREFECT_SERVER_ANALYTICS_ENABLED"] ="false"# sin estadísticas de usoimport joblibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport prefectimport sklearnfrom prefect import flow, taskfrom prefect.cache_policies import INPUTS, TASK_SOURCEfrom IPython.display import displayfrom matplotlib.patches import Rectanglefrom prefect.client.orchestration import get_clientfrom prefect.client.schemas.filters import FlowRunFilter, FlowRunFilterIdfrom prefect.settings import PREFECT_TASKS_REFRESH_CACHE, temporary_settingsimport tareas_envios as tfrom flujo_prefect import noche_de_lauraversiones = {"python": platform.python_version(), "prefect": prefect.__version__,"pandas": pd.__version__, "numpy": np.__version__,"scikit-learn": sklearn.__version__, "joblib": joblib.__version__}print(versiones)
Las versiones son las del entorno del libro, con Prefect 3.9.1 instalado en la sección 3.
Ejemplo 1: un flujo de dos tareas
NotaTarea y flujo en Prefect
Una tarea es una función de Python con el decorador @task: Prefect registra cuándo empieza, cuándo termina y en qué estado queda. Un flujo es una función con @flow que llama tareas; cada llamada al flujo es una corrida con nombre propio.
El ejemplo más pequeño posible: saludar y contar las letras del saludo. log_prints=True hace que los print del flujo aparezcan también en el registro de Prefect.
05:31:54.752 | INFO    | prefect - Starting temporary server on http://127.0.0.1:8471
See https://www.prefect.io/docs/v3/concepts/server#how-to-guides for more information on running a dedicated Prefect server.
05:32:13.368 | INFO | Flow run 'arcane-grouse' - Beginning flow run 'arcane-grouse' for flow 'hola-flujo'
05:32:13.388 | INFO | Task run 'saludar-15b' - Finished in state Completed()
05:32:13.396 | INFO | Task run 'contar_letras-e49' - Finished in state Completed()
05:32:13.399 | INFO | Flow run 'arcane-grouse' - Hola, Laura tiene 11 caracteres
05:32:14.382 | INFO | Flow run 'arcane-grouse' - Finished in state Completed()
El flujo devolvió: 11
Lee el registro de arriba abajo. Como no hay un servidor configurado, Prefect arranca uno temporal en tu equipo, que dura lo que dura el kernel. Ese servidor solo atiende al notebook: si abres en el navegador la dirección que aparece (http://127.0.0.1: y un puerto al azar), verás {"detail":"Not Found"}, porque no trae interfaz web. La interfaz la abrirás en la sección 6.5 con un servidor propio, en http://127.0.0.1:4200. Después anuncia la corrida con un nombre inventado al azar, registra que saludar y contar_letras terminaron en Completed(), muestra el print y cierra el flujo en Completed(). «Hola, Laura» tiene 11 caracteres, y eso es lo que devuelve el flujo: llamarlo es como llamar cualquier función.
Fíjate en lo que no escribiste: ningún orden de ejecución ni ninguna bitácora. Prefect supo que contar_letras va después de saludar porque recibe su resultado.
Ejemplo 2: un ETL de cinco envíos
El capítulo 2 construye el historial de envíos con un ETL: extraer de la fuente, transformar y cargar. Aquí haces uno mínimo con cinco paquetes que llegan de la recepción con dos problemas que ya conoces: la distancia viene en metros y el servicio está escrito de formas distintas («Express», «express », «ESTÁNDAR»). Puedes resolverlo a mano: 520 000 m son 520 km, y las cinco distancias suman 2 195 km.
05:32:14.559 | INFO | Flow run 'sweet-jackrabbit' - Beginning flow run 'sweet-jackrabbit' for flow 'etl-basico'
05:32:14.579 | INFO | Task run 'extraer-99e' - Finished in state Completed()
05:32:14.601 | INFO | Task run 'transformar-03d' - Finished in state Completed()
05:32:14.838 | INFO | Task run 'cargar-ca2' - Finished in state Completed()
05:32:15.564 | INFO | Flow run 'sweet-jackrabbit' - Finished in state Completed()
Filas cargadas: 5 | km totales: 2195.0
id_envio
peso_kg
servicio
distancia_km
0
1
2.5
económico
520.0
1
2
1.2
express
85.0
2
3
NaN
estándar
300.0
3
4
7.8
estándar
1250.0
4
5
0.6
express
40.0
Las tres tareas terminan en Completed() y se cargan 5 filas. La tabla limpia tiene la distancia en kilómetros (520, 85, 300, 1 250 y 40, que suman 2 195 km) y el servicio escrito siempre igual: «económico», «express» y «estándar». El peso vacío del envío 3 sigue vacío: el ETL no inventa datos, y decidir qué hacer con él es tarea de la calidad del dato (capítulo 3).
Observa que entre tareas viajan tablas de pandas, como en cualquier script. El archivo recepcion.csv queda en artefactos/etl-basico/; en la sección 7 lo usarás para hacer este mismo ETL en Airflow y en Dagster.
Ejemplo 3: un reintento y la caché
Supón que el precio de cada servicio se consulta a un sistema externo que a veces no responde. El ejemplo simula esa consulta: la primera llamada falla con ConnectionError y las siguientes responden. Un contador anota cuántas veces se llamó de verdad a la función. La tarea tiene dos opciones nuevas:
retries=2: si falla, Prefect la vuelve a intentar hasta dos veces más.
cache_policy=INPUTS + TASK_SOURCE: si se llama con las mismas entradas y el código no cambió, Prefect devuelve el resultado guardado sin ejecutarla.
05:32:15.729 | INFO | Flow run 'prehistoric-caiman' - Beginning flow run 'prehistoric-caiman' for flow 'tarifas-del-dia'
05:32:15.741 | INFO | Task run 'consultar_tarifa-ff9' - Task run failed with exception: ConnectionError('El sistema de tarifas no respondió') - Retry 1/2 will start 1 second(s) from now
05:32:16.749 | INFO | Task run 'consultar_tarifa-ff9' - Finished in state Completed()
05:32:16.769 | INFO | Task run 'consultar_tarifa-9d4' - Finished in state Completed()
05:32:16.790 | INFO | Task run 'consultar_tarifa-7ae' - Finished in state Completed()
05:32:17.736 | INFO | Flow run 'prehistoric-caiman' - Finished in state Completed()
Primera corrida | total: 33000 u.m. | llamadas reales: 4
05:32:17.840 | INFO | Flow run 'lurking-peacock' - Beginning flow run 'lurking-peacock' for flow 'tarifas-del-dia'
05:32:17.849 | INFO | Task run 'consultar_tarifa-ff7' - Finished in state Cached(type=COMPLETED)
05:32:17.862 | INFO | Task run 'consultar_tarifa-122' - Finished in state Cached(type=COMPLETED)
05:32:17.876 | INFO | Task run 'consultar_tarifa-68c' - Finished in state Cached(type=COMPLETED)
05:32:18.845 | INFO | Flow run 'lurking-peacock' - Finished in state Completed()
Segunda corrida | total: 33000 u.m. | llamadas reales: 4
En la primera corrida, la consulta de «express» falla con ConnectionError, Prefect anuncia el reintento 1 de 2 y, un segundo después, la tarea termina bien. Las otras dos consultas responden a la primera. El total es 33 000 u.m. (18 000 + 9 000 + 6 000) y la función se llamó 4 veces: 3 servicios más el intento fallido.
En la segunda corrida, las tres consultas terminan en Cached(type=COMPLETED): el total sigue en 33 000 u.m. y el contador sigue en 4, porque la función no se ejecutó ni una vez. Con las mismas entradas y el mismo código, Prefect devolvió lo que había guardado.
Ya tienes todas las piezas del caso de Laura: tareas que se pasan datos, un ETL, reintentos para lo pasajero y caché para no repetir trabajo. Lo que sigue las junta en un lote real de seis tareas.
5) Las seis tareas de Laura, sin ninguna herramienta
Antes de envolver nada, separa el trabajo de quien lo dirige. El archivo tareas_envios.py, junto a este notebook, contiene las seis tareas del lote como funciones de Python normales: traer, revisar, preparar, entrenar, evaluar y entregar. Son las del capítulo 7, con dos cambios. Las tareas reciben y devuelven datos en lugar de leer y escribir archivos intermedios, y revisar incluye un acuerdo de calidad nuevo: a lo sumo 20 % de pesos vacíos. Además, ninguna importa Prefect, Airflow ni Dagster, y eso es lo que permite llevarlas a las tres.
Este es el comienzo del archivo, con las dos primeras tareas; el archivo completo está al final del anexo.
SEMILLA =42REGLA = {"f1_minimo": 0.50, "sensibilidad_minima": 0.60}MAX_PESOS_VACIOS =0.20# acuerdo de calidad: a lo sumo 20 % de pesos sin registrarSERVICIOS = ["express", "estándar", "económico"]def huella_bytes(contenido):"""Devuelve el SHA-256 de unos bytes."""return hashlib.sha256(contenido).hexdigest()def traer(ruta_fuente, simular_corte=False):"""Lee el lote de la fuente. Con simular_corte, la primera llamada falla.""" marca = Path(ruta_fuente).with_name("corte-simulado")if simular_corte andnot marca.exists(): marca.touch()raiseTimeoutError("La fuente agotó el tiempo de respuesta")return pd.read_csv(ruta_fuente)def revisar(tabla):"""Comprueba columnas, dominios y el acuerdo de pesos vacíos.""" esperadas = ["distancia_km", "peso_kg", "servicio", "llega_tarde"]iflist(tabla.columns) != esperadas:raiseValueError("El lote tiene columnas distintas de las esperadas") vacios =float(tabla["peso_kg"].isna().mean())if vacios > MAX_PESOS_VACIOS:raiseValueError(f"Pesos vacíos: {vacios:.1%}; el acuerdo admite {MAX_PESOS_VACIOS:.0%}") validas = tabla["distancia_km"].ge(0) & tabla["servicio"].isin(SERVICIOS)ifnot validas.all():raiseValueError("El lote contiene filas fuera del esquema")return {"filas": len(tabla), "pesos_vacios": round(vacios, 4)}
traer puede simular el corte de la fuente: la primera vez deja una marca en la carpeta y lanza TimeoutError; la segunda encuentra la marca y lee el archivo. entrenar hace la búsqueda en grilla y la elección del umbral del capítulo 6, y devuelve el modelo como bytes junto con su huella. La razón de esa decisión aparecerá con la caché, en la sección 6.
Las mismas funciones, tres envoltorios. Cada herramienta tiene su archivo, que importa tareas_envios.py sin modificarlo.
Esta separación es el consejo más útil de todo el anexo. Si mañana el equipo cambia de herramienta, las tareas no se tocan: se reescribe solo el envoltorio, que son unas decenas de líneas.
Ahora sí, los datos de Laura. La siguiente celda genera los 600 envíos con el mismo código de todo el libro y prepara cuatro carpetas de lote: la de Prefect, una copia para Airflow, otra para Dagster y el lote de la báscula dañada.
La báscula dañada parte de los mismos envíos y borra el peso de cada paquete con probabilidad 0.60, usando un generador propio con semilla SEMILLA + 1. Así el problema es solo de registro: las distancias, los servicios y los resultados no cambian.
El lote sano tiene los 600 envíos, 67 pesos vacíos y 24.3 % de tardíos de todo el libro. El lote de la báscula llega a 395 pesos vacíos, el 65.8 %, muy por encima del 20 % que admite el acuerdo de calidad.
Ahora llama a las seis tareas a mano, en orden, como lo haría un script. Este resultado es la referencia: cada herramienta tiene que reproducir exactamente estos números.
Sin ninguna herramienta, el lote da lo mismo que en los capítulos 6 y 7: C = 10, pesos balanced, relleno con mediana, F1 de validación cruzada 0.518076 y umbral 0.45. En los 150 envíos de prueba, F1 0.527473, sensibilidad 0.666667 y precisión 0.436364, así que la regla de aceptación se cumple. La revisión reporta 600 filas y 11.17 % de pesos vacíos, dentro del acuerdo.
Faltó entregar a propósito. Esa tarea escribe archivos, y la vas a llamar a través de Prefect.
6) Demostración con Prefect: el turno de noche de Laura
El envoltorio
El archivo flujo_prefect.py convierte cada función en una tarea con task(...) y las encadena en el flujo noche_de_laura. Es el archivo completo:
"""El lote nocturno de Laura como flujo de Prefect."""from pathlib import Pathfrom prefect import flow, taskfrom prefect.cache_policies import INPUTS, TASK_SOURCEimport tareas_envios as t# revisar, preparar, entrenar, evaluar y entregar reutilizan su resultado# si reciben las mismas entradas y su código no cambió.CACHE = INPUTS + TASK_SOURCEdef llave_por_contenido(contexto, parametros):"""La caché de traer depende de los bytes de la fuente, no de su nombre."""return t.huella_bytes(Path(parametros["ruta_fuente"]).read_bytes())def solo_cortes(tarea, corrida, estado):"""Autoriza el reintento solo si el fallo fue un TimeoutError."""try: estado.result()exceptTimeoutError:returnTrueexceptException:returnFalsereturnFalsetraer = task(t.traer, name="traer", retries=2, retry_delay_seconds=1, retry_condition_fn=solo_cortes, cache_key_fn=llave_por_contenido)revisar = task(t.revisar, name="revisar", cache_policy=CACHE)preparar = task(t.preparar, name="preparar", cache_policy=CACHE)entrenar = task(t.entrenar, name="entrenar", cache_policy=CACHE)evaluar = task(t.evaluar, name="evaluar", cache_policy=CACHE)entregar = task(t.entregar, name="entregar", cache_policy=CACHE)@flow(name="noche-de-laura")def noche_de_laura(carpeta: str="artefactos/lote-envios", simular_corte: bool=False):"""Encadena las seis tareas. Prefect anota estados, reintentos y caché.""" ruta_fuente = (Path(carpeta) /"fuente.csv").as_posix() tabla = traer(ruta_fuente, simular_corte) revision = revisar(tabla)# preparar no usa la revisión, pero debe esperarla: wait_for declara esa flecha. desarrollo, prueba = preparar(tabla, wait_for=[revision]) seleccion = entrenar(desarrollo) metricas = evaluar(seleccion, prueba)return entregar(seleccion, metricas, carpeta)if__name__=="__main__":# Programación: una corrida diaria a las 2:00 (hora del servidor). noche_de_laura.serve(name="noche-de-laura-diaria", cron="0 2 * * *")
Vale la pena leer cuatro decisiones de este archivo:
Reintentos con condición.traer admite 2 reintentos con 1 segundo de espera, pero solo_cortes los autoriza solo si el error fue TimeoutError. Es la misma regla del capítulo 7: un corte se reintenta, una columna faltante no.
Dependencias por datos. Prefect dibuja una flecha cada vez que el resultado de una tarea entra a otra. preparar no usa el resultado de revisar, así que sin wait_for=[revision] no habría flecha entre ellas. En este flujo el orden se respeta igual porque las tareas se llaman una tras otra, pero el dibujo de la interfaz quedaría mal y, si algún día ejecutas tareas en paralelo, preparar podría empezar antes de que termine la revisión.
Caché por contenido. La llave de traer es la huella del archivo fuente, no su ruta. Las demás tareas usan INPUTS + TASK_SOURCE: sus entradas y su código.
Programación. Al final, serve deja el flujo programado cada día a las 2:00. Esa parte solo corre desde la terminal (sección 6.5).
NotaCaché de tareas
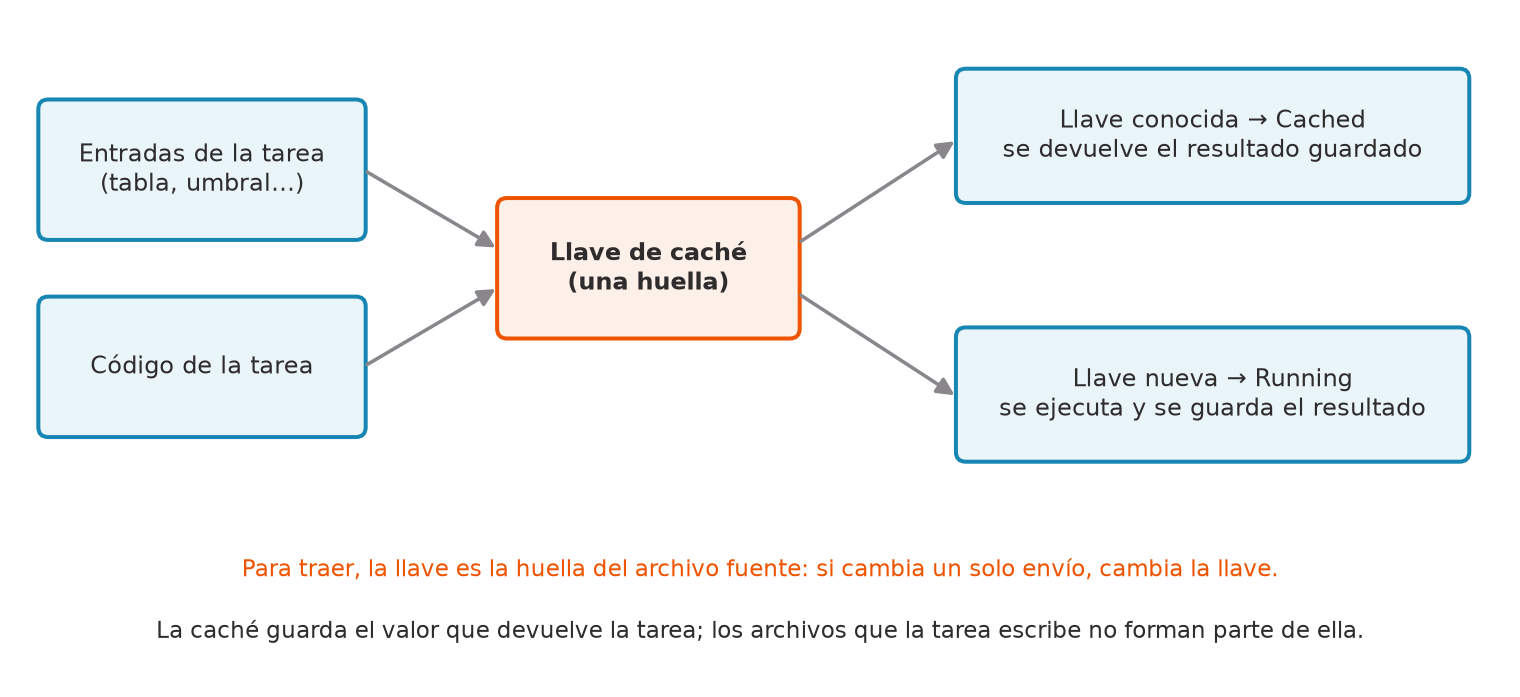
La caché de tareas guarda el resultado de una tarea junto con una llave de caché: una huella calculada a partir de lo que define ese resultado. Si en otra ejecución la llave es la misma, Prefect devuelve el resultado guardado y marca la tarea como Cached sin ejecutarla. Si la llave cambia, la tarea corre y guarda el nuevo resultado.
Cómo decide Prefect si reutiliza un resultado.
Aquí aparece la razón de que el modelo viaje como bytes. Para calcular la llave de evaluar, Prefect saca una huella de sus entradas, y una de ellas es el resultado de entrenar. Un objeto Pipeline recuperado de la caché no siempre da la misma huella que el original, así que evaluar volvería a correr cada noche. Unos bytes, en cambio, son siempre los mismos bytes.
6.1) Primera noche: la fuente se corta
Llama al flujo como a una función. Con simular_corte=True, el primer intento de traer falla. return_state=True hace que la llamada devuelva el estado final en lugar de lanzar una excepción si algo sale mal.
05:32:22.179 | INFO | Flow run 'sparkling-seriema' - Beginning flow run 'sparkling-seriema' for flow 'noche-de-laura'
05:32:22.208 | INFO | Task run 'traer-cb2' - Task run failed with exception: TimeoutError('La fuente agotó el tiempo de respuesta') - Retry 1/2 will start 1 second(s) from now
05:32:23.251 | INFO | Task run 'traer-cb2' - Finished in state Completed()
05:32:23.281 | INFO | Task run 'revisar-e4e' - Finished in state Completed()
05:32:23.319 | INFO | Task run 'preparar-d89' - Finished in state Completed()
05:32:26.880 | INFO | Task run 'entrenar-362' - Finished in state Completed()
05:32:26.908 | INFO | Task run 'evaluar-a0b' - Finished in state Completed()
05:32:26.947 | INFO | Task run 'entregar-d1a' - Finished in state Completed()
05:32:27.205 | INFO | Flow run 'sparkling-seriema' - Finished in state Completed()
Estado del flujo: Completed
Umbral: 0.45 | métricas: {'f1': 0.527473, 'sensibilidad': 0.666667, 'precision': 0.436364, 'aceptado': True}
Lee los mensajes de Prefect de arriba abajo. El primer intento de traer falla con TimeoutError('La fuente agotó el tiempo de respuesta') y Prefect anuncia el reintento 1 de 2. Un segundo después, traer termina en Completed() y las otras cinco tareas lo siguen. El flujo queda Completed y la entrega está en artefactos/lote-envios/entrega.json, con umbral 0.45, F1 0.527473, sensibilidad 0.666667 y aceptado en True: las mismas cifras de la sección 5.
Compara con el capítulo 7, donde el bucle de intentos, el registro de cada evento y la lectura de la bitácora se escriben a mano. Aquí lo único que escribiste fue retries=2 y la condición.
6.2) Segunda noche: el mismo lote
Suponer que el lote de mañana es idéntico al de hoy no es realista, pero es la mejor prueba de idempotencia: si nada cambió, nada debería recalcularse ni reescribirse. Guarda las huellas de los dos archivos entregados y la hora de modificación de entrega.json antes de llamar otra vez.
def huellas_entrega():"""Huellas de los archivos que deja entregar."""return {nombre: t.huella_bytes((LOTE / nombre).read_bytes())for nombre in ["entrega.json", "modelo.joblib"]}huellas_antes = huellas_entrega()modificado_antes = (LOTE /"entrega.json").stat().st_mtime_nsnoche_2 = noche_de_laura(LOTE.as_posix(), return_state=True)print("Estado del flujo:", noche_2.name)print("Mismas huellas:", huellas_entrega() == huellas_antes)print("entrega.json reescrito:", (LOTE /"entrega.json").stat().st_mtime_ns != modificado_antes)
05:32:27.377 | INFO | Flow run 'spotted-hippo' - Beginning flow run 'spotted-hippo' for flow 'noche-de-laura'
05:32:27.399 | INFO | Task run 'traer-252' - Finished in state Cached(type=COMPLETED)
05:32:27.410 | INFO | Task run 'revisar-b79' - Finished in state Cached(type=COMPLETED)
05:32:27.424 | INFO | Task run 'preparar-6e3' - Finished in state Cached(type=COMPLETED)
05:32:27.436 | INFO | Task run 'entrenar-717' - Finished in state Cached(type=COMPLETED)
05:32:27.446 | INFO | Task run 'evaluar-5a1' - Finished in state Cached(type=COMPLETED)
05:32:27.456 | INFO | Task run 'entregar-78c' - Finished in state Cached(type=COMPLETED)
05:32:28.383 | INFO | Flow run 'spotted-hippo' - Finished in state Completed()
Estado del flujo: Completed
Mismas huellas: True
entrega.json reescrito: False
Las seis tareas terminan en Cached(type=COMPLETED): ninguna se ejecutó. Las huellas de entrega.json y modelo.joblib son las mismas y el archivo de entrega ni siquiera se reescribió (False). Es la idempotencia del capítulo 7 sin estado.json y sin comparar huellas a mano.
Observa el orden de la cadena. traer encontró su llave porque el archivo fuente tiene los mismos bytes. Su resultado, la tabla, es idéntico, así que las llaves de revisar y preparar también coinciden, y así sucesivamente hasta entregar. Si cambias un solo envío en fuente.csv, cambia la llave de traer y toda la cadena se recalcula, como comprobarás en el ejercicio 2.
6.3) Tercera noche: la báscula dañada
Este lote debe detenerse en revisar. Antes de llamarlo, apaga los mensajes de consola: cuando una tarea falla, Prefect imprime la traza completa del error, decenas de líneas que taparían el resultado. No se pierde nada, porque los estados quedan en la base de Prefect y los leerás en la sección 6.4.
logging.disable(logging.CRITICAL) # silencia la consola; los estados siguen en la basenoche_3 = noche_de_laura(LOTE_BASCULA.as_posix(), return_state=True)logging.disable(logging.NOTSET)print("Estado del flujo:", noche_3.name)print("Motivo:", noche_3.message.splitlines()[0])print("¿Hay entrega?", (LOTE_BASCULA /"entrega.json").exists())
Estado del flujo: Failed
Motivo: Flow run encountered an exception: ValueError: Pesos vacíos: 65.8%; el acuerdo admite 20%
¿Hay entrega? False
El flujo termina Failed y el motivo es el mensaje de la regla: ValueError: Pesos vacíos: 65.8%; el acuerdo admite 20%. No hay entrega en la carpeta de la báscula. Laura sigue usando el modelo de la noche anterior, y el equipo sabe exactamente qué regla detuvo el lote.
6.4) Leer la historia que guardó Prefect
Antes de ver las cuatro noches juntas, provoca a propósito un error que sorprende a casi todos la primera vez. Borra entrega.json y vuelve a correr el lote sano.
Estado del flujo: Completed
¿Existe entrega.json? False
El flujo dice Completed, pero entrega.json no existe. Las seis tareas encontraron su llave, devolvieron el valor guardado y no se ejecutaron. entregar tampoco corrió, así que nadie volvió a escribir el archivo.
La caché recuerda el valor que devuelve una tarea, no los archivos que la tarea escribió de paso. Si un archivo desaparece o alguien lo modifica, la caché no se entera. El motor del capítulo 7 sí lo nota, porque comprueba la huella de cada salida antes de reutilizarla.
Para recuperar la entrega, pide a Prefect que ignore la caché en esta ejecución con PREFECT_TASKS_REFRESH_CACHE. Todas las tareas vuelven a correr y guardan resultados nuevos.
logging.disable(logging.CRITICAL)with temporary_settings(updates={PREFECT_TASKS_REFRESH_CACHE: True}): noche_5 = noche_de_laura(LOTE.as_posix(), return_state=True)logging.disable(logging.NOTSET)print("Estado del flujo:", noche_5.name)print("¿Existe entrega.json?", (LOTE /"entrega.json").exists())print("Mismo modelo que la primera noche:", huellas_entrega()["modelo.joblib"] == huellas_antes["modelo.joblib"])
Estado del flujo: Completed
¿Existe entrega.json? True
Mismo modelo que la primera noche: True
Con la caché ignorada, el flujo termina Completed, entrega.json vuelve a existir y el modelo tiene la misma huella que el de la primera noche (True): mismos datos, mismo código y misma semilla dan los mismos bytes.
Ahora sí, consulta a Prefect lo que pasó en las cinco ejecuciones. La interfaz web lee de esta misma base; aquí la consultas con el cliente de Python y armas una tabla con una fila por noche y una columna por tarea. Cada celda dice el estado final y, para las tareas que se ejecutaron, cuántos intentos hicieron.
noches = {noche_1: "1 · corte de la fuente", noche_2: "2 · mismo lote", noche_3: "3 · báscula dañada", noche_4: "4 · sin entrega.json", noche_5: "5 · caché ignorada"}filas = []with get_client(sync_client=True) as cliente:for estado, noche in noches.items(): filtro = FlowRunFilter(id=FlowRunFilterId(any_=[estado.state_details.flow_run_id]))for corrida in cliente.read_task_runs(flow_run_filter=filtro): filas.append({"noche": noche, "tarea": corrida.name.rsplit("-", 1)[0],"estado": corrida.state.name, "intentos": corrida.run_count})historia = pd.DataFrame(filas)orden_tareas = ["traer", "revisar", "preparar", "entrenar", "evaluar", "entregar"]# Una tarea en caché no se ejecuta: solo se anotan los intentos de las que corrieron.historia["celda"] = historia.estado.where( historia.estado =="Cached", historia.estado +" ("+ historia.intentos.astype(str) +")")resumen = (historia.pivot(index="noche", columns="tarea", values="celda") .reindex(columns=orden_tareas).fillna("no se creó"))display(resumen)
tarea
traer
revisar
preparar
entrenar
evaluar
entregar
noche
1 · corte de la fuente
Completed (2)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
2 · mismo lote
Cached
Cached
Cached
Cached
Cached
Cached
3 · báscula dañada
Completed (1)
Failed (1)
no se creó
no se creó
no se creó
no se creó
4 · sin entrega.json
Cached
Cached
Cached
Cached
Cached
Cached
5 · caché ignorada
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
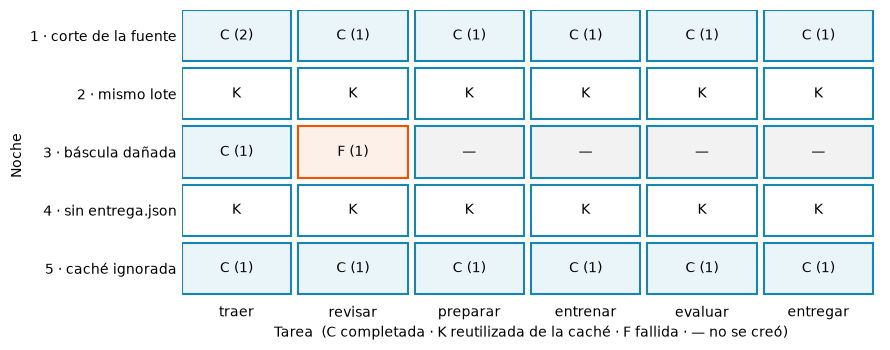
La tabla resume las cinco noches. En la primera, traer aparece Completed (2): dos intentos, por el corte; las demás tareas, Completed (1). La segunda y la cuarta son seis Cached: ninguna tarea se ejecutó. En la tercera, traer corrió una vez, revisar quedó Failed (1) y las cuatro tareas siguientes dicen «no se creó». En la quinta, las seis vuelven a Completed (1) porque la caché se ignoró.
Ese «no se creó» marca una diferencia entre herramientas. Prefect crea una tarea cuando el flujo llega a ella. Como revisar lanzó una excepción, el flujo se detuvo y preparar, entrenar, evaluar y entregar nunca existieron en la base. Airflow, que conoce el DAG completo antes de empezar, las habría mostrado con el estado upstream_failed. La gráfica muestra la misma tabla con colores y letras, para que se lea también en blanco y negro.
colores = {"Completed": "#EAF5FA", "Cached": "#FFFFFF", "Failed": "#FDF0E9", "no se creó": "#F2F2F2"}letras = {"Completed": "C", "Cached": "K", "Failed": "F", "no se creó": "—"}figura, eje = plt.subplots(figsize=(9, 3.6))for fila, noche inenumerate(resumen.index):for columna, tarea inenumerate(orden_tareas): texto = resumen.loc[noche, tarea] estado = texto.split(" (")[0] borde ="#EE5400"if estado =="Failed"else"#1786B3" eje.add_patch(Rectangle((columna, fila), 0.94, 0.88, facecolor=colores[estado], edgecolor=borde, linewidth=1.5)) etiqueta = letras[estado]if"("in texto: etiqueta = etiqueta +" ("+ texto.split("(")[1] eje.text(columna +0.47, fila +0.44, etiqueta, ha="center", va="center", fontsize=10)eje.set_xlim(0, len(orden_tareas))eje.set_ylim(len(resumen), 0)eje.set_xticks([i +0.47for i inrange(len(orden_tareas))], orden_tareas)eje.set_yticks([i +0.44for i inrange(len(resumen))], resumen.index)eje.set_xlabel("Tarea (C completada · K reutilizada de la caché · F fallida · — no se creó)")eje.set_ylabel("Noche")eje.tick_params(length=0)for lado in eje.spines.values(): lado.set_visible(False)figura.tight_layout()plt.show()
Estado final de cada tarea en las cinco noches del lote de Laura
La cuadrícula confirma la tabla: la única celda con 2 intentos es traer en la noche 1, la única F es revisar en la noche 3 y las filas 2 y 4 son caché pura. Con 6 tareas y 5 noches ya cuesta seguir la historia en una tabla; con 60 tareas y un mes de noches, la interfaz web deja de ser un lujo.
6.5) Ver las noches en la interfaz web
El servidor temporal desaparece al cerrar el kernel. Para tener una interfaz permanente, arranca un servidor propio en una terminal y déjala abierta:
# con el entorno del libro activoprefect server start
Salida esperada (final):
Configure Prefect to communicate with the server with:

    prefect config set PREFECT_API_URL=http://127.0.0.1:4200/api

View the API reference documentation at http://127.0.0.1:4200/docs

Check out the dashboard at http://127.0.0.1:4200
Para que el notebook envíe sus corridas a ese servidor, define la dirección en la terminal desde la que abres Jupyter y vuelve a ejecutar el notebook:
Abre http://127.0.0.1:4200 en el navegador. Las capturas que siguen son de la interfaz de Prefect 3.9.1 (software de código abierto con licencia Apache 2.0) después de correr las tres primeras noches.
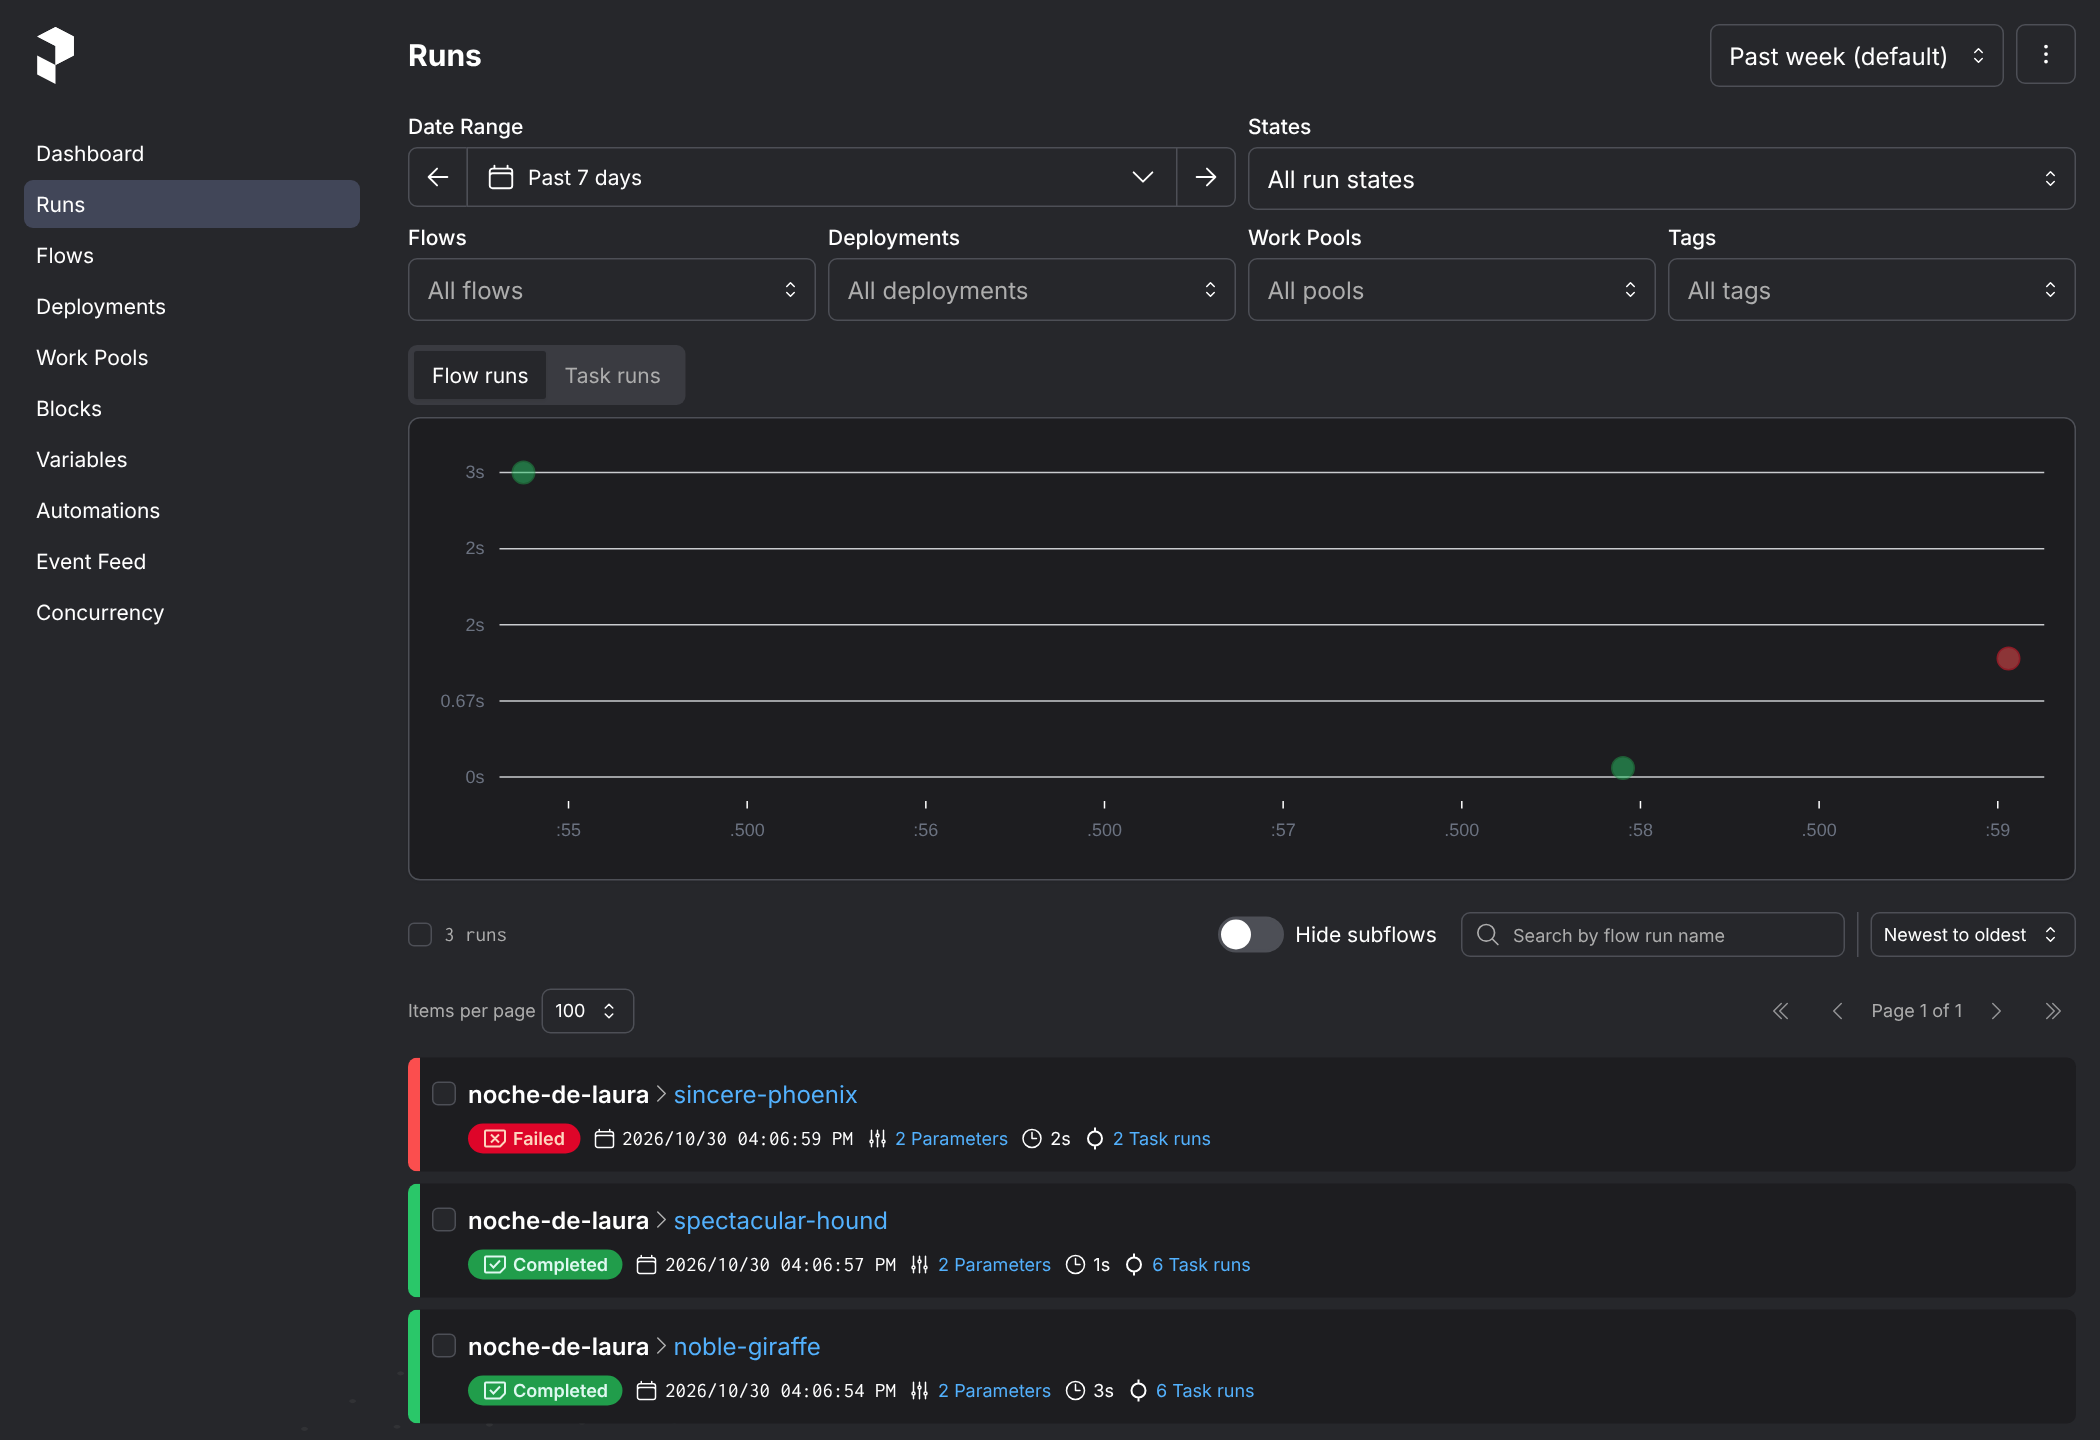
La lista de corridas. Cada noche es una fila con su estado, su duración y el número de tareas.
Los nombres de las corridas (por ejemplo sincere-phoenix) los inventa Prefect al azar. Lo que importa es la columna de estado: dos Completed con 6 tareas y un Failed con 2.
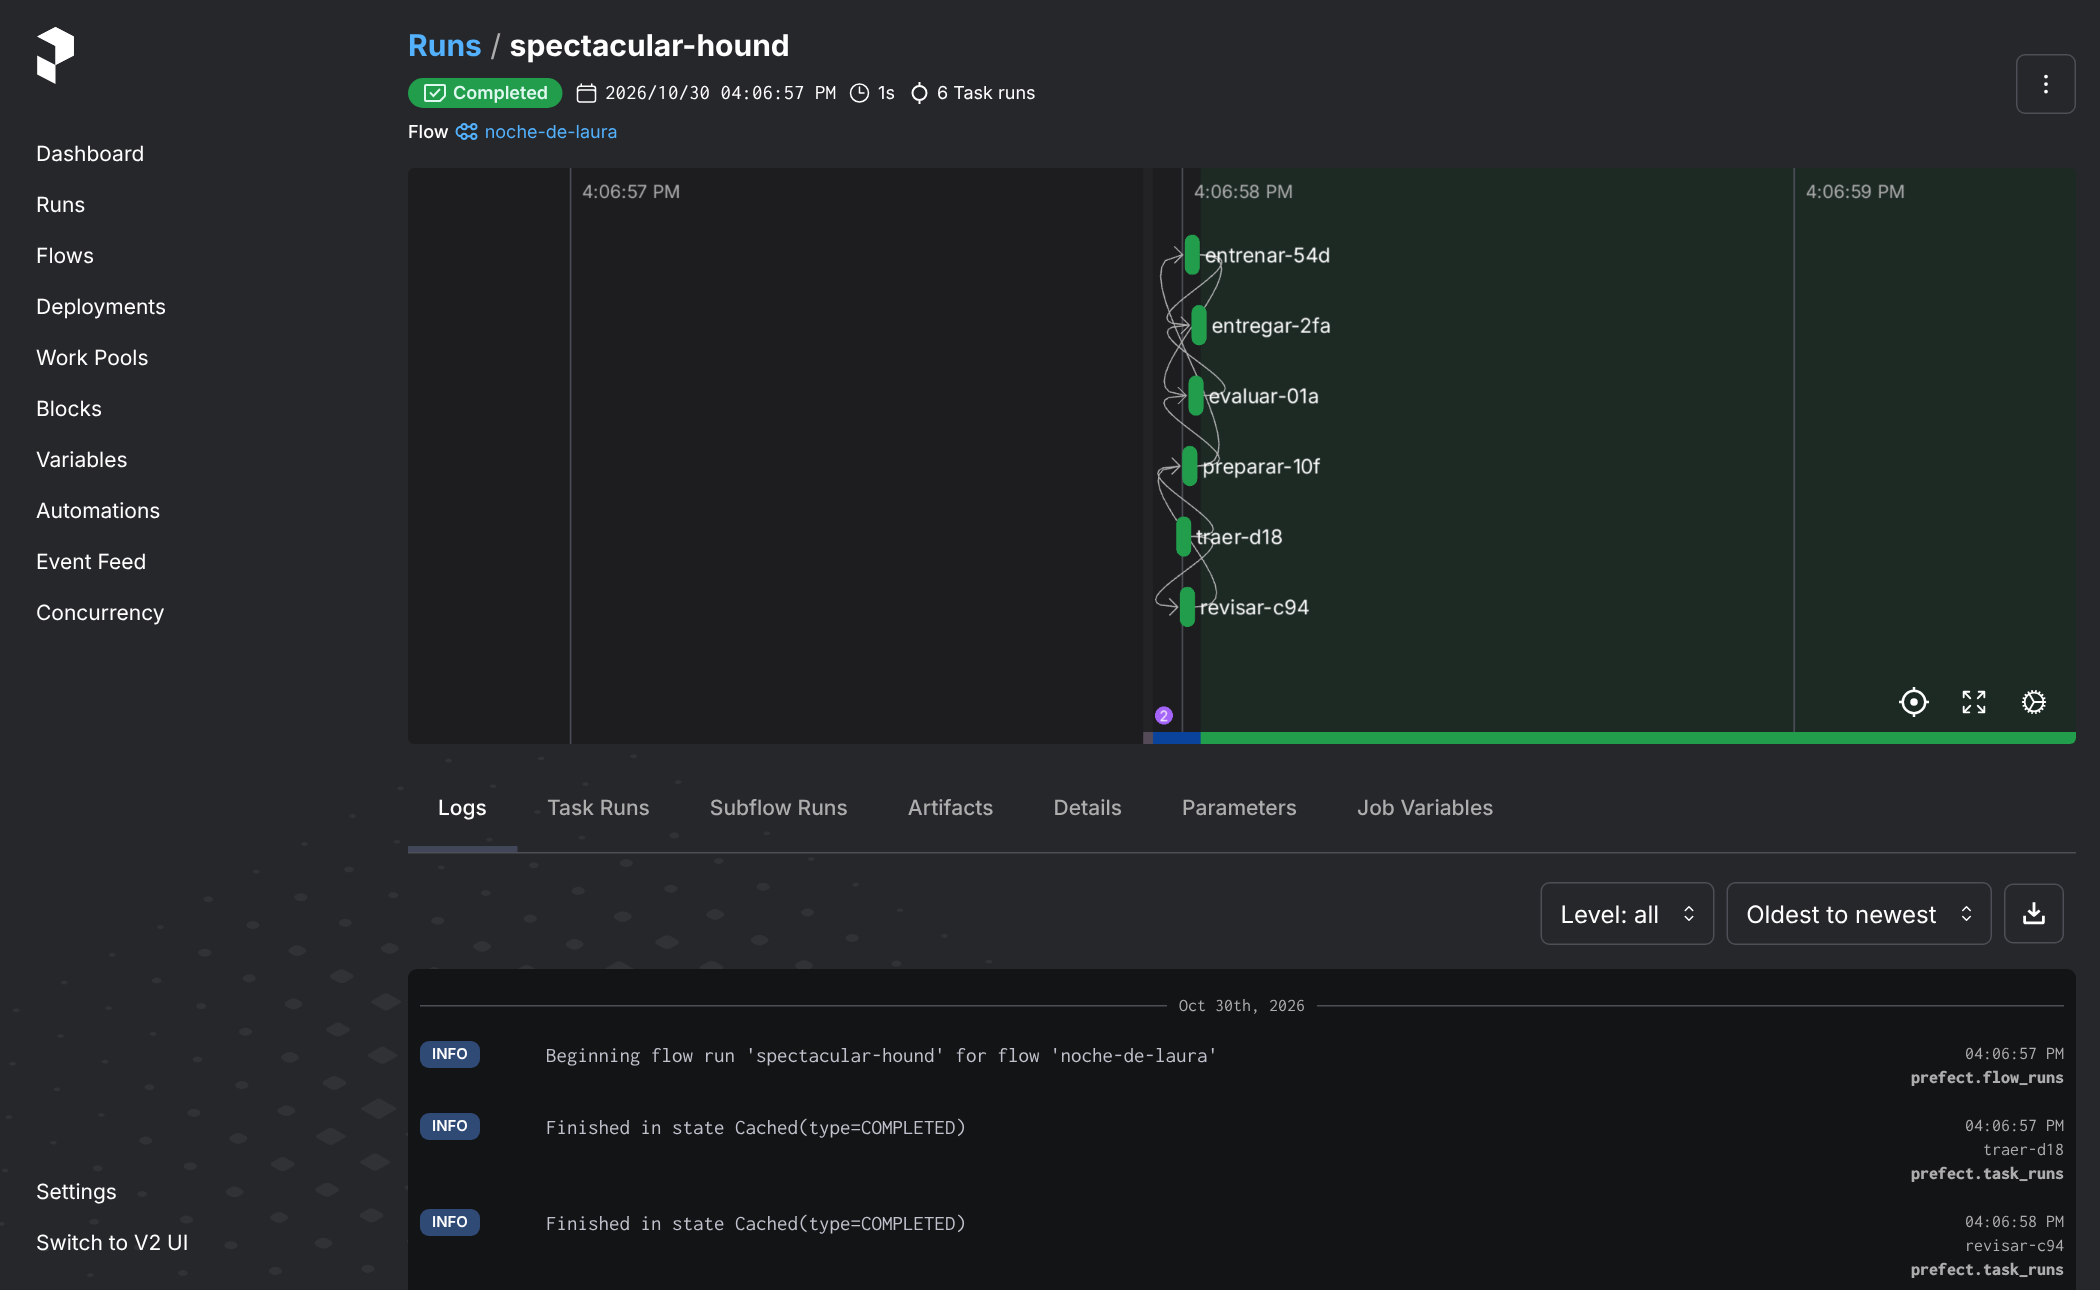
Primera noche. El grafo muestra cuándo empezó y terminó cada tarea y las flechas entre ellas; el registro muestra el reintento de traer.
En el grafo de la primera noche, la barra de traer es larga porque incluye el segundo de espera antes del reintento, y la de entrenar es la más larga por la búsqueda en grilla. La flecha de revisar a preparar existe gracias a wait_for.
Segunda noche. Las seis tareas terminan casi al mismo tiempo porque ninguna se ejecutó.
Tercera noche. revisar falla y el flujo se detiene; el registro muestra el motivo.
6.6) Programar el flujo cada noche
NotaDespliegue
En Prefect, un despliegue (deployment) es un flujo registrado en el servidor con un nombre, unos parámetros y, si quieres, un calendario. Mientras el proceso que lo sirve siga vivo, el servidor lanza una corrida en cada fecha del calendario.
La última línea de flujo_prefect.py crea el despliegue con serve. Con el servidor de la sección 6.5 en marcha, abre otra terminal:
# con el entorno del libro activoexportPREFECT_API_URL=http://127.0.0.1:4200/apipython flujo_prefect.py
Salida esperada (el identificador al final de la dirección cambia en cada equipo):
Your flow 'noche-de-laura' is being served and polling for scheduled runs!

To trigger a run for this flow, use the following command:

        $ prefect deployment run 'noche-de-laura/noche-de-laura-diaria'
El despliegue programado: listo y con la corrida diaria a las 2:00.
El despliegue aparece Ready con el calendario «At 02:00 AM every day». La hora es la del servidor. Desde esta página también puedes lanzar una corrida a mano, sin esperar a la noche. En una empresa, este proceso no corre en tu portátil: corre en un servidor que no se apaga, y la entrega va a una ubicación compartida, no a una carpeta local.
7) Airflow y Dagster: el ETL básico y el lote de Laura
Con cada herramienta harás lo mismo que con Prefect: primero el ETL de cinco envíos del ejemplo 2, para ver la forma mínima de un flujo, y después el lote de Laura. Cada herramienta tiene sus archivos en una subcarpeta propia (airflow/ y dagster/), para que ninguna intente leer los de la otra. Necesitas haber ejecutado este notebook antes, porque los datos de entrada están en artefactos/.
El ETL básico en Airflow
"""Primer contacto con Airflow: un ETL de cinco envíos."""from datetime import datetimefrom io import StringIOfrom pathlib import Pathimport pandas as pdfrom airflow.sdk import dag, taskCARPETA = Path(__file__).resolve().parents[1] /"artefactos"/"etl-basico"@dag(dag_id="etl_basico", schedule=None, start_date=datetime(2026, 10, 1), catchup=False)def etl_basico():@taskdef extraer():# Cinco filas caben sin problema en un XCom: viajan como texto JSON.return pd.read_csv(CARPETA /"recepcion.csv").to_json(orient="records")@taskdef transformar(texto): tabla = pd.read_json(StringIO(texto), orient="records", precise_float=True) tabla["distancia_km"] = tabla["distancia_m"] /1000 tabla["servicio"] = tabla["servicio"].str.strip().str.lower()return tabla.drop(columns="distancia_m").to_json(orient="records")@taskdef cargar(texto): tabla = pd.read_json(StringIO(texto), orient="records", precise_float=True) tabla.to_csv(CARPETA /"limpio-airflow.csv", index=False)returnlen(tabla) cargar(transformar(extraer()))etl_basico()
Compáralo con el ejemplo 2. Las tres tareas son las mismas, pero entre ellas viaja un texto JSON en lugar de una tabla: en Airflow, lo que una tarea devuelve se guarda como XCom en la base de datos, y solo deben pasar así valores pequeños. Cinco filas caben sin problema; 600 envíos con un modelo ya no, y por eso el DAG de Laura pasa rutas de archivo. schedule=None significa que este DAG solo corre cuando lo lanzas tú. Con el entorno de Airflow activo y desde la carpeta del anexo:
exportAIRFLOW_HOME="$HOME/airflow-anexo-orquestacion"# SQLite fuera de /mnt/...exportAIRFLOW__CORE__DAGS_FOLDER="$PWD/airflow"exportAIRFLOW__CORE__LOAD_EXAMPLES=Falseairflow db migrateairflow dags test etl_basico
El resultado queda en artefactos/etl-basico/limpio-airflow.csv, con las mismas cinco filas que dejó Prefect.
El ETL básico en Dagster
"""Primer contacto con Dagster: un ETL de cinco envíos como dos activos."""from pathlib import Pathimport dagster as dgimport pandas as pdCARPETA = Path(__file__).resolve().parents[1] /"artefactos"/"etl-basico"@dg.assetdef recepcion():"""Los envíos tal como llegan de la recepción."""return pd.read_csv(CARPETA /"recepcion.csv")@dg.assetdef envios_limpios(recepcion):"""Distancia en kilómetros y servicio escrito siempre igual.""" tabla = recepcion.copy() tabla["distancia_km"] = tabla["distancia_m"] /1000 tabla["servicio"] = tabla["servicio"].str.strip().str.lower() tabla = tabla.drop(columns="distancia_m") tabla.to_csv(CARPETA /"limpio-dagster.csv", index=False)return tabladefs = dg.Definitions(assets=[recepcion, envios_limpios])
Aquí no hay tres tareas sino dos activos: recepcion (los datos tal como llegan) y envios_limpios (los datos listos). La transformación y la carga viven dentro de envios_limpios, porque en Dagster lo que importa es qué datos existen, no cuántos pasos hay. La dependencia sale del nombre del parámetro: envios_limpios(recepcion).
exportDAGSTER_HOME="$HOME/dagster-anexo-orquestacion"# SQLite fuera de /mnt/...mkdir-p"$DAGSTER_HOME"dagster asset materialize -f dagster/etl_basico.py --select'*'
Salida esperada (extracto):
recepcion - STEP_SUCCESS - Finished execution of step "recepcion" in 48ms.
envios_limpios - STEP_SUCCESS - Finished execution of step "envios_limpios" in 76ms.
RUN_SUCCESS - Finished execution of run for "__ASSET_JOB".
El lote de Laura en Airflow
Airflow 3 permite escribir el DAG con decoradores @task, muy parecidos a los de Prefect. La diferencia está en lo que viaja entre tareas: como entre tareas de Airflow solo deben pasar valores pequeños, cada tarea guarda sus datos con joblib en la carpeta del lote y devuelve la ruta. Los reintentos se declaran para todo el DAG en default_args.
"""El lote nocturno de Laura como DAG de Airflow 3."""from datetime import datetime, timedeltafrom pathlib import Pathimport sysimport joblibfrom airflow.sdk import dag, task# tareas_envios.py vive una carpeta más arriba que este archivo.CARPETA_ANEXO = Path(__file__).resolve().parents[1]sys.path.insert(0, str(CARPETA_ANEXO))import tareas_envios as t # noqa: E402LOTE = CARPETA_ANEXO /"artefactos"/"lote-airflow"def guardar(objeto, nombre):"""Airflow pasa entre tareas solo valores pequeños: los datos van a disco.""" ruta = LOTE /f"{nombre}.joblib" joblib.dump(objeto, ruta)return ruta.as_posix()@dag(dag_id="noche_de_laura", schedule="0 2 * * *", start_date=datetime(2026, 10, 1), catchup=False, default_args={"retries": 2, "retry_delay": timedelta(seconds=1)})def noche_de_laura():@taskdef traer():return guardar(t.traer((LOTE /"fuente.csv").as_posix(), simular_corte=True), "crudo")@taskdef revisar(ruta_crudo):return t.revisar(joblib.load(ruta_crudo))@taskdef preparar(ruta_crudo, revision): desarrollo, prueba = t.preparar(joblib.load(ruta_crudo))return {"desarrollo": guardar(desarrollo, "desarrollo"),"prueba": guardar(prueba, "prueba")}@taskdef entrenar(rutas):return guardar(t.entrenar(joblib.load(rutas["desarrollo"])), "seleccion")@taskdef evaluar(ruta_seleccion, rutas):return t.evaluar(joblib.load(ruta_seleccion), joblib.load(rutas["prueba"]))@taskdef entregar(ruta_seleccion, metricas):return t.entregar(joblib.load(ruta_seleccion), metricas, LOTE) crudo = traer() rutas = preparar(crudo, revisar(crudo)) seleccion = entrenar(rutas) entregar(seleccion, evaluar(seleccion, rutas))noche_de_laura()
airflow dags test ejecuta una corrida completa en el proceso actual, sin programador ni servidor web: es la forma más rápida de comprobar un DAG. Con las mismas variables del ETL básico (si abriste otra terminal, vuelve a definirlas):
exportAIRFLOW_HOME="$HOME/airflow-anexo-orquestacion"# SQLite fuera de /mnt/...exportAIRFLOW__CORE__DAGS_FOLDER="$PWD/airflow"exportAIRFLOW__CORE__LOAD_EXAMPLES=Falseairflow db migrateairflow dags test noche_de_laura
Salida esperada (extracto; Airflow escribe varias líneas por tarea):
[error    ] Task failed with exception     [task]
TimeoutError: La fuente agotó el tiempo de respuesta
[info     ] Task instance state updated    ... new_state=up_for_retry
[info     ] [DAG TEST] running task <TaskInstance: noche_de_laura.traer ...
[info     ] Task instance state updated    ... new_state=success
...
[info     ] Marking run <DagRun noche_de_laura ... successful
La entrega queda en artefactos/lote-airflow/entrega.json, con F1 0.527473, sensibilidad 0.666667 y umbral 0.45: las mismas cifras de Prefect. Para ver la interfaz, airflow standalone arranca juntos el programador, el servidor web y el resto de los servicios. La variable de la primera línea desactiva el inicio de sesión; úsala solo en tu equipo.
Abre http://localhost:8080 y activa el DAG con el interruptor junto a su nombre.
Una corrida del DAG en Airflow 3.3.2 (licencia Apache 2.0). La columna Try Number muestra que traer necesitó 2 intentos.
El lote de Laura en Dagster
En Dagster cada función tiene el nombre del dato que produce, y las dependencias salen de los nombres de los parámetros: revision(lote) depende de lote. particion no recibe la revisión, pero debe esperarla; deps=[revision] cumple el papel del wait_for de Prefect. Dagster guarda cada activo materializado, así que los datos viajan como en Prefect, sin rutas.
"""El lote nocturno de Laura como activos de Dagster."""from pathlib import Pathimport sysimport dagster as dgCARPETA_ANEXO = Path(__file__).resolve().parents[1]sys.path.insert(0, str(CARPETA_ANEXO))import tareas_envios as t # noqa: E402LOTE = CARPETA_ANEXO /"artefactos"/"lote-dagster"@dg.asset(retry_policy=dg.RetryPolicy(max_retries=2, delay=1))def lote():"""Envíos del día leídos de la fuente."""return t.traer((LOTE /"fuente.csv").as_posix(), simular_corte=True)@dg.assetdef revision(lote):"""Resumen de calidad; falla si el lote no cumple el acuerdo."""return t.revisar(lote)@dg.asset(deps=[revision])def particion(lote):"""Desarrollo y prueba, solo si la revisión terminó bien."""return t.preparar(lote)@dg.assetdef seleccion(particion):"""Modelo, configuración y umbral elegidos con desarrollo."""return t.entrenar(particion[0])@dg.assetdef metricas(seleccion, particion):"""Medición única en prueba con la regla de aceptación."""return t.evaluar(seleccion, particion[1])@dg.assetdef entrega(seleccion, metricas):"""Manifiesto para Laura."""return t.entregar(seleccion, metricas, LOTE)programa = dg.ScheduleDefinition(name="noche_de_laura_diaria", cron_schedule="0 2 * * *", target=dg.AssetSelection.all())defs = dg.Definitions(assets=[lote, revision, particion, seleccion, metricas, entrega], schedules=[programa])
Para materializar todos los activos desde la terminal, con el entorno de Dagster activo:
exportDAGSTER_HOME="$HOME/dagster-anexo-orquestacion"# SQLite fuera de /mnt/...mkdir-p"$DAGSTER_HOME"dagster asset materialize -f dagster/activos_envios.py --select'*'
Salida esperada (extracto):
lote - STEP_UP_FOR_RETRY - Execution of step "lote" failed and has requested a retry in 1 seconds.
lote - STEP_RESTARTED - Started re-execution (attempt # 2) of step "lote".
lote - STEP_SUCCESS - Finished execution of step "lote" in 39ms.
revision - STEP_SUCCESS - Finished execution of step "revision" in 61ms.
...
dagster dev -f dagster/activos_envios.py abre la interfaz en http://127.0.0.1:3000. La primera vez aparece una ventana que invita a unirse a la comunidad de Dagster; puedes cerrarla con «Skip».
El grafo de activos en Dagster 1.13.28 (licencia Apache 2.0): seis datos, todos materializados.
Lo que necesitas
Capítulo 7
Prefect
Airflow
Dagster
Declarar una tarea
Una función en un diccionario
task(funcion)
@task dentro de @dag
@dg.asset
Declarar una dependencia
Diccionario de dependencias
Pasar el resultado o wait_for
Pasar el resultado
Nombre del parámetro o deps
Reintentar un corte
Bucle con max_intentos
retries y retry_condition_fn
retries en default_args
RetryPolicy
No repetir trabajo
estado.json con huellas
Caché con llave
Nueva ejecución de las tareas falladas
Activos ya materializados
Programar
No existía
serve(cron=...)
schedule= en el DAG
ScheduleDefinition
Ver la historia
Leer eventos.jsonl
Interfaz en el puerto 4200
Interfaz en el puerto 8080
Interfaz en el puerto 3000
8) Limpiar lo que creaste
Detén cada servidor con Ctrl+C en su terminal: prefect server start, python flujo_prefect.py, airflow standalone y dagster dev. Luego borra los artefactos y, si no vas a seguir usándolos, los entornos virtuales:
artefactos/ contiene los lotes y las entregas; las tres carpetas de tu carpeta de usuario guardan las bases de datos de Prefect, Airflow y Dagster y la caché de Prefect. El servidor permanente de Prefect (sección 6.5) guarda su base en ~/.prefect; bórrala también si quieres empezar de cero. Prefect queda instalado en el entorno del libro. En Windows, el equivalente de rm -rf es Remove-Item -Recurse -Force, con las mismas rutas.
NotaAlcance de la demostración
Los envíos son sintéticos y el corte de la fuente es simulado con una marca en la carpeta. Todo corre en un solo equipo: el servidor, el trabajador y la entrega están en el mismo disco, y las bases de datos son SQLite. En producción, el servidor y los trabajadores corren en máquinas que no se apagan, la base suele ser PostgreSQL, la entrega va a un registro de modelos (capítulo 8) y los permisos, las credenciales y las alertas se configuran aparte. Las instalaciones se probaron en Linux con Python 3.13.14 y las versiones indicadas; las herramientas cambian rápido, así que revisa sus notas de versión antes de actualizar.
Errores frecuentes
Lo que ves
Qué pasó
Cómo se arregla
Dos tareas distintas devuelven el mismo resultado guardado
La caché usa solo INPUTS y las dos tareas reciben las mismas entradas: la llave coincide
Agrega TASK_SOURCE a la política para que el código de la tarea entre en la llave
Cambias una constante del módulo (por ejemplo REGLA) y nada se recalcula
La llave usa las entradas y el código de la tarea, no las variables globales que lee
Pasa esos valores como argumentos de la tarea, o ignora la caché en esa ejecución
El flujo dice Completed pero falta un archivo de la entrega
La caché devolvió el valor guardado y la tarea que escribe el archivo no corrió
Ejecuta con PREFECT_TASKS_REFRESH_CACHE, o haz que la llave dependa del archivo
evaluar corre todas las noches aunque nada cambió
Una de sus entradas es un objeto cuya huella cambia al recuperarlo de la caché
Pasa el modelo como bytes, o define la llave con cache_key_fn
En la interfaz no hay flecha entre revisar y preparar
Prefect dibuja flechas solo cuando un resultado entra a otra tarea
Declara la espera con wait_for=[revision]
PrefectHTTPStatusError: Server error '500 Internal Server Error' a mitad de una corrida
En WSL, la base SQLite de Prefect quedó en un disco de Windows (/mnt/d/...), donde SQLite no bloquea bien sus archivos
Pon PREFECT_HOME (y AIRFLOW_HOME, DAGSTER_HOME) en tu carpeta de usuario de Linux
Después de instalar Prefect, FastAPI aparece en 0.150.0
Prefect 3.9.1 exige FastAPI anterior a 0.151 y pip la ajusta
Es lo esperado: el entorno del libro usa FastAPI 0.150.0 desde los capítulos 9 a 11
ModuleNotFoundError: No module named 'pandas' al probar el DAG
Airflow no instala pandas; el DAG corre en el entorno de Airflow
Instala las bibliotecas de las tareas también en .venv-airflow
Airflow no instala o no arranca en Windows
Airflow no se ejecuta de forma nativa en Windows
Usa WSL2 o Docker
airflow dags list muestra errores de importación de otros archivos
La carpeta de DAG contiene archivos que no son DAG, como flujo_prefect.py
Deja los DAG en su propia carpeta (airflow/)
El flujo programado no corre a las 2:00
El proceso de serve o el servidor se cerraron
Ambos deben seguir vivos; en producción, en un servidor que no se apague
Lista de verificación
Ejercicios
Los ejercicios son «sabotajes»: cada uno rompe algo del lote para que veas cómo responde la herramienta.
Corte largo. Cambia traer para que la fuente falle tres veces seguidas. ¿En qué estado termina la tarea con retries=2? ¿Y el flujo?
Un envío corregido. Cambia una sola distancia en artefactos/lote-envios/fuente.csv y corre el flujo. ¿Qué tareas quedan Cached y cuáles se ejecutan?
Un cambio de código. Agrega un comentario dentro de evaluar en tareas_envios.py y reinicia el kernel. ¿Qué tareas recalculan? ¿Por qué no recalcula entrenar?
Una regla más exigente. Sube f1_minimo a 0.60 en REGLA, dentro de tareas_envios.py, reinicia el kernel y corre el flujo. ¿Se detiene la entrega? Si no, ¿por qué?
La báscula en Airflow. Copia el lote de la báscula a artefactos/lote-airflow/fuente.csv y ejecuta airflow dags test noche_de_laura. ¿En qué estado quedan preparar y las tareas siguientes? Compáralo con el «no se creó» de Prefect.
TipOrientaciones
traer queda Failed después de 3 intentos (el original y 2 reintentos) y el flujo también falla, porque las demás tareas dependen de su resultado. Para un corte largo, aumenta retries o espacia los intentos con retry_delay_seconds=[1, 10, 60].
Cambian los bytes del archivo y con ellos la llave de traer. Su resultado es otra tabla, así que cambian las entradas de todas las tareas siguientes: las seis se ejecutan. Es lo que quieres: un dato distinto exige un modelo recalculado.
TASK_SOURCE toma el código de la tarea, así que cambia la llave de evaluar. Como evaluar devuelve las mismas métricas, la llave de entregar puede coincidir y quedar Cached; compruébalo en la tabla de la sección 6.4. entrenar no cambia de código ni de entradas, así que sigue en caché.
No se detiene, y es la trampa de este ejercicio. REGLA es una constante del módulo: no es una entrada de evaluar ni forma parte de su código, así que la llave no cambia. Las seis tareas quedan Cached y la entrega conserva aceptado: True con una regla que ya no la aprobaría. Para que el cambio cuente, corre con PREFECT_TASKS_REFRESH_CACHE o, mejor, pasa la regla como argumento de evaluar, para que entre en la llave. Entonces evaluar devuelve aceptado: False (F1 0.527473 < 0.60) y entregar falla con «El modelo queda retenido por la regla de aceptación».
revisar falla y Airflow marca preparar, entrenar, evaluar y entregar como upstream_failed: existen en la corrida porque Airflow conoce el DAG completo antes de empezar. En Prefect esas tareas no se crean porque el flujo se detuvo antes de llegar a ellas.
Glosario
Orquestador: programa que ejecuta flujos de tareas, guarda el estado de cada intento y lo muestra.
Flujo (flow): en Prefect, la función que encadena las tareas de un trabajo.
Tarea (task): unidad de trabajo que el orquestador ejecuta, reintenta y registra por separado.
Corrida (run): una ejecución concreta de un flujo o de una tarea, con su estado y su historia.
Caché de tareas: resultados guardados que se reutilizan cuando la llave de caché coincide.
Llave de caché: huella calculada a partir de lo que define el resultado de una tarea (sus entradas, su código o el contenido de un archivo).
Despliegue (deployment): flujo registrado en el servidor de Prefect con nombre, parámetros y calendario.
XCom: mecanismo de Airflow para pasar valores pequeños entre tareas.
Archivo de restricciones: lista de versiones exactas de dependencias que Airflow publica para instalarlo de forma reproducible.
Activo (asset): en Dagster, un dato que debe existir, definido por la función que lo produce.
Materializar: en Dagster, ejecutar la función de un activo y guardar su resultado.
Entorno virtual: carpeta con su propio Python y sus propias bibliotecas, aislada de las demás.
Qué aprendiste
Un orquestador agrega al motor del capítulo 7 un programador, una base de estados, una interfaz web y una caché; la lógica de las tareas sigue siendo tuya.
Prefect piensa en funciones, Airflow en un DAG programado y Dagster en los datos que deben existir.
Un ETL de cinco envíos basta para ver la forma de cada herramienta: tareas que se pasan tablas en Prefect, XCom pequeños en Airflow y activos en Dagster.
Prefect cabe en el entorno del libro (con FastAPI 0.150.0); Airflow, con su archivo de restricciones, y Dagster van en entornos propios.
Separar las tareas en un archivo sin herramienta permitió llevarlas a las tres sin cambiar una línea, y las tres dieron F1 0.527473 y sensibilidad 0.666667.
En Prefect, retries con una condición repite solo el corte; wait_for declara la espera que no pasa datos; la caché con llave por contenido hace idempotente la segunda noche.
La caché recuerda valores, no archivos: un archivo borrado no se recupera hasta que la caché se ignora.
serve deja el flujo programado cada noche mientras el proceso y el servidor sigan vivos.
Con el lote corriendo solo cada noche, la siguiente pregunta es qué hacer con tantas entregas: cuál está en uso, con qué datos se entrenó y si la de esta noche es mejor que la de ayer. Esa es la pregunta del capítulo 8, donde cada entrega pasa a un registro de modelos.
Estas son las seis tareas que Prefect, Airflow y Dagster envuelven en este anexo, junto con las funciones de apoyo huella_bytes y crear_pipeline. Es el archivo que está junto al notebook; ninguna línea depende de una herramienta de orquestación.
"""Las seis tareas del lote nocturno de Laura, sin ninguna herramienta de orquestación.Prefect, Airflow y Dagster envuelven estas mismas funciones. Ninguna sabe quién la llama."""from io import BytesIOfrom pathlib import Pathimport hashlibimport jsonimport joblibimport numpy as npimport pandas as pdfrom sklearn.compose import ColumnTransformerfrom sklearn.impute import SimpleImputerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import f1_score, precision_score, recall_scorefrom sklearn.model_selection import GridSearchCV, StratifiedKFold, cross_val_predictfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScalerSEMILLA =42REGLA = {"f1_minimo": 0.50, "sensibilidad_minima": 0.60}MAX_PESOS_VACIOS =0.20# acuerdo de calidad: a lo sumo 20 % de pesos sin registrarSERVICIOS = ["express", "estándar", "económico"]def huella_bytes(contenido):"""Devuelve el SHA-256 de unos bytes."""return hashlib.sha256(contenido).hexdigest()def traer(ruta_fuente, simular_corte=False):"""Lee el lote de la fuente. Con simular_corte, la primera llamada falla.""" marca = Path(ruta_fuente).with_name("corte-simulado")if simular_corte andnot marca.exists(): marca.touch()raiseTimeoutError("La fuente agotó el tiempo de respuesta")return pd.read_csv(ruta_fuente)def revisar(tabla):"""Comprueba columnas, dominios y el acuerdo de pesos vacíos.""" esperadas = ["distancia_km", "peso_kg", "servicio", "llega_tarde"]iflist(tabla.columns) != esperadas:raiseValueError("El lote tiene columnas distintas de las esperadas") vacios =float(tabla["peso_kg"].isna().mean())if vacios > MAX_PESOS_VACIOS:raiseValueError(f"Pesos vacíos: {vacios:.1%}; el acuerdo admite {MAX_PESOS_VACIOS:.0%}") validas = tabla["distancia_km"].ge(0) & tabla["servicio"].isin(SERVICIOS)ifnot validas.all():raiseValueError("El lote contiene filas fuera del esquema")return {"filas": len(tabla), "pesos_vacios": round(vacios, 4)}def preparar(tabla):"""Separa desarrollo (75 %) y prueba (25 %) sin ajustar transformaciones.""" desarrollo, prueba = train_test_split( tabla, test_size=0.25, random_state=SEMILLA, stratify=tabla.llega_tarde)return desarrollo, pruebadef crear_pipeline():"""Pipeline de envíos del capítulo 5, sin ajustar.""" numericas = Pipeline([("rellenar", SimpleImputer(strategy="mean")), ("escalar", StandardScaler())]) columnas = ColumnTransformer([ ("numericas", numericas, ["distancia_km", "peso_kg"]), ("categoricas", OneHotEncoder(handle_unknown="ignore"), ["servicio"]), ])return Pipeline([("preparar", columnas), ("modelo", LogisticRegression(max_iter=1000))])def entrenar(desarrollo):"""Búsqueda en grilla y umbral del capítulo 6; el modelo viaja como bytes.""" X = desarrollo.drop(columns="llega_tarde") y = desarrollo.llega_tarde cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA) grilla = {"modelo__C": [0.01, 0.1, 1, 10, 100],"modelo__class_weight": [None, "balanced"],"preparar__numericas__rellenar__strategy": ["mean", "median"]} busqueda = GridSearchCV(crear_pipeline(), grilla, cv=cv, scoring="f1", n_jobs=1) busqueda.fit(X, y) ganador = busqueda.best_estimator_ probabilidades = cross_val_predict(ganador, X, y, cv=cv, method="predict_proba")[:, 1] opciones = []for corte in np.arange(0.15, 0.751, 0.05): corte =round(float(corte), 2) prediccion = (probabilidades >= corte).astype(int) opciones.append({"umbral": corte, "f1": f1_score(y, prediccion),"sensibilidad": recall_score(y, prediccion)}) candidatas = pd.DataFrame(opciones).query("sensibilidad >= 0.70") elegida = candidatas.sort_values(["f1", "umbral"], ascending=False).iloc[0] memoria = BytesIO() joblib.dump(ganador, memoria) modelo = memoria.getvalue()return {"modelo": modelo, "huella_modelo": huella_bytes(modelo),"configuracion": busqueda.best_params_,"f1_cv": round(float(busqueda.best_score_), 6), "umbral": float(elegida.umbral)}def evaluar(seleccion, prueba):"""Mide una sola vez en prueba y aplica la regla de aceptación.""" modelo = joblib.load(BytesIO(seleccion["modelo"])) probabilidades = modelo.predict_proba(prueba.drop(columns="llega_tarde"))[:, 1] prediccion = (probabilidades >= seleccion["umbral"]).astype(int) y = prueba.llega_tarde metricas = {"f1": round(f1_score(y, prediccion), 6),"sensibilidad": round(recall_score(y, prediccion), 6),"precision": round(precision_score(y, prediccion, zero_division=0), 6)} metricas["aceptado"] =bool(metricas["f1"] >= REGLA["f1_minimo"]and metricas["sensibilidad"] >= REGLA["sensibilidad_minima"])return metricasdef entregar(seleccion, metricas, carpeta):"""Escribe el modelo y el manifiesto para Laura solo si la regla se cumple."""ifnot metricas["aceptado"]:raiseValueError("El modelo queda retenido por la regla de aceptación") carpeta = Path(carpeta) (carpeta /"modelo.joblib").write_bytes(seleccion["modelo"]) manifiesto = {"modelo": "modelo.joblib", "huella_modelo": seleccion["huella_modelo"],"umbral": seleccion["umbral"], "metricas": metricas} ruta = carpeta /"entrega.json" ruta.write_text(json.dumps(manifiesto, indent=2, ensure_ascii=False), encoding="utf-8")return ruta.as_posix()