Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
El problema que vas a resolver
Son las 5:40 de la mañana en BITLogística. Las sedes de Bogotá, Medellín y Cali cerraron la recepción del día anterior: unos 600 paquetes que saldrán a ruta a las 6:00. Antes de esa hora, Laura tiene que entregar a los tres coordinadores de despacho la lista de envíos con riesgo de llegar tarde, para que alcancen a cambiarlos de ruta o avisar al cliente. Una mañana, el archivo de Cali llega tarde. Otra, la báscula de Medellín deja de registrar pesos. Laura no puede esperar a que alguien abra un notebook para saber qué pasó.
El lunes aparece otra pregunta. El modelo corrida_02 lleva semanas en producción, y cada semana llegan las etiquetas reales de los envíos que ya se entregaron. ¿Sigue funcionando? ¿Conviene reemplazarlo por uno entrenado con datos recientes? Un cambio mal hecho empeora una semana entera de alertas; no cambiar nunca deja a Laura con un modelo que se queda atrás.
Este anexo resuelve las dos situaciones con flujos de Prefect, de principio a fin. El anexo C te mostró las piezas con ejemplos pequeños; aquí las verás trabajar con el tamaño, los tropiezos y las decisiones de una operación.
NotaEmpresa y datos ficticios
BITLogística es una empresa ficticia de mensajería en Colombia, la misma de los libros de Deep Learning y Big Data de esta colección. Todos los datos de este anexo son sintéticos: se generan con el mecanismo de envíos del libro y no corresponden a BIT ni a ningún cliente.
Ficha
En este anexo
Pregunta
¿Cómo se orquestan decisiones de operación cuando los archivos llegan tarde, con errores o sin etiquetas?
Datos
Historial de 600 envíos, tres sedes de 200 envíos durante cuatro noches y seis semanas de 600 envíos
Herramientas
Prefect 3.9.1, pandas, NumPy, scikit-learn, joblib y matplotlib
Lo que produces
Una lista diaria con cobertura por sede y un registro de modelos con una promoción aprobada
Tiempo estimado
Entre 60 y 75 minutos
Nivel
Intermedio
Objetivos de aprendizaje
Al terminar este anexo podrás:
Diseñar un flujo que procesa varias fuentes por separado, para que el fallo de una no detenga a las demás.
Distinguir lo que se reintenta (un archivo que todavía no llega) de lo que se detiene (un archivo con errores).
Publicar un resultado parcial que declara qué cubre, y relanzarlo sin duplicarlo.
Comparar un modelo en producción con uno reentrenado sin fuga de datos y con una regla escrita antes de medir.
Separar la propuesta automática de un cambio de modelo de la aprobación de una persona.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Acuerdo de calidad
Una regla escrita sobre el lote; aquí, como máximo 20 % de pesos vacíos por sede.
En el anexo C, el lote de Laura venía de una sola fuente, nadie esperaba el resultado a una hora fija y un fallo detenía todo. En la operación de BITLogística cambian cuatro cosas, y cada una se convierte en una decisión de diseño de este anexo:
En el anexo C
En la operación de BITLogística
Decisión que toma el flujo
Una fuente
Tres sedes que entregan por separado
Esperar y validar cada sede en su propia rama
Un fallo detiene el lote
Si falla Medellín, Bogotá y Cali igual necesitan su lista
Publicar lo válido y declarar qué quedó por fuera
La entrega se escribe una vez
Una fecha se puede relanzar después de corregir
Una sola lista vigente por fecha
El modelo nunca cambia
Cada lunes llegan etiquetas nuevas
Proponer un cambio con una regla escrita; aprobarlo es de Laura
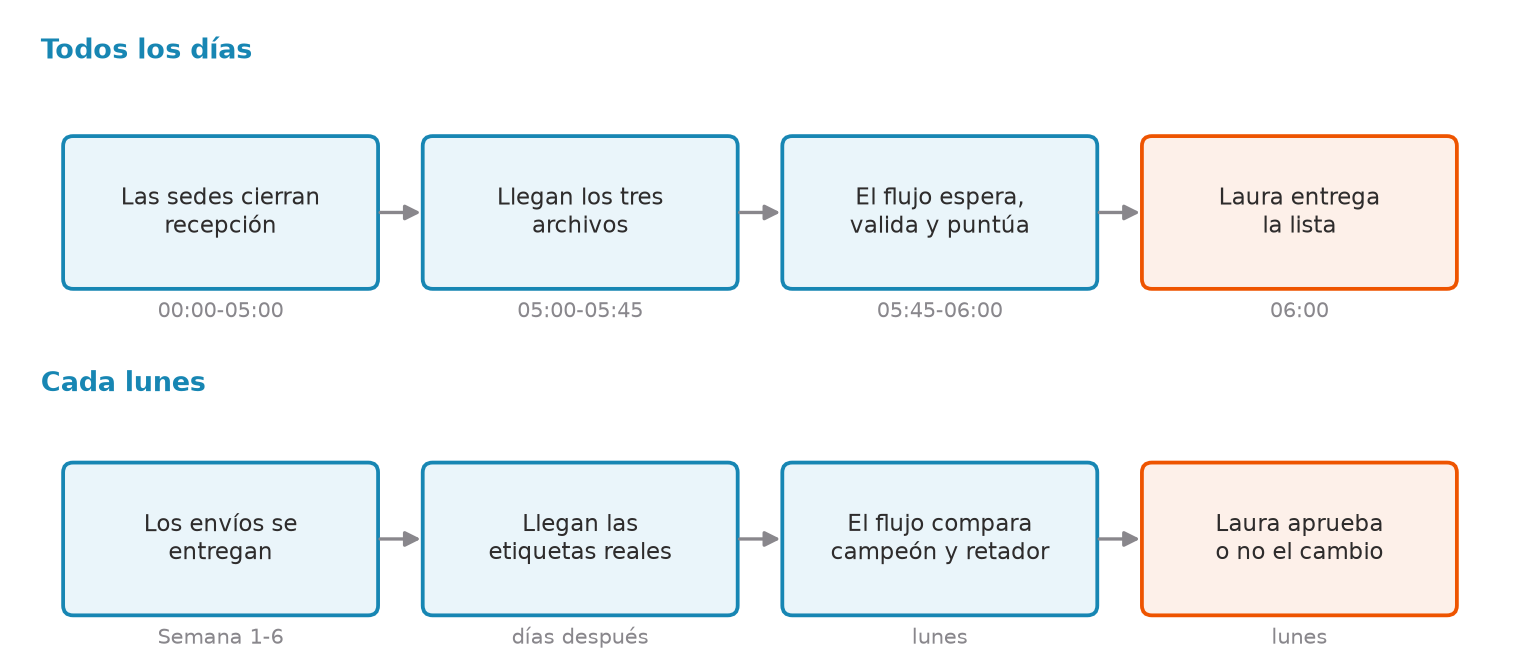
Los dos casos tienen relojes distintos. El de la mañana se mide en minutos: lo que no llega a las 6:00 ya no sirve. El del lunes se mide en semanas: lo importante es tener suficientes etiquetas para que la comparación sea justa.
Los dos relojes de la operación. Cada día, la lista de las 6:00; cada lunes, la decisión sobre el modelo. En los dos, la última palabra es de Laura.
Preparar el entorno
La primera celda prepara todo. Tres decisiones, cada una con su motivo:
La base de Prefect va en tu carpeta de usuario (~/.prefect-anexo-casos), no junto al notebook. Si trabajas en WSL y el libro está en un disco de Windows (/mnt/c, /mnt/d), SQLite no puede bloquear bien sus archivos y Prefect falla con 500 Internal Server Error. Es lo mismo que hace el anexo C.
Las tareas de Laura vienen del anexo C, en una copia exacta de tareas_envios.py guardada en la carpeta de este anexo: el modelo es exactamente el mismo y el anexo se ejecuta sin depender de otra carpeta. Más abajo verás el archivo completo.
Las dos carpetas se vacían al empezar, para que cada ejecución parta de cero.
# 0. Biblioteca estándar: archivos, rutas, registros y entorno.import jsonimport loggingimport osimport platformimport shutilfrom io import BytesIOfrom pathlib import Path# 1. Carpetas de la práctica: se vacían para que cada ejecución parta de cero.ARTEFACTOS = Path("artefactos")PREFECT_HOME = Path.home() /".prefect-anexo-casos"# fuera de /mnt: SQLite necesita bloquear archivosshutil.rmtree(ARTEFACTOS, ignore_errors=True)shutil.rmtree(PREFECT_HOME, ignore_errors=True)ARTEFACTOS.mkdir()os.environ["PREFECT_HOME"] =str(PREFECT_HOME)os.environ["PREFECT_SERVER_ANALYTICS_ENABLED"] ="false"# sin estadísticas de uso# 2. Bibliotecas (Prefect se importa después de fijar PREFECT_HOME).import joblibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport prefectimport sklearnfrom IPython.display import Markdown, displayfrom prefect import flow, taskfrom prefect.artifacts import create_markdown_artifact, create_table_artifactfrom prefect.cache_policies import NO_CACHEfrom prefect.client.orchestration import get_clientfrom prefect.client.schemas.filters import FlowRunFilter, FlowRunFilterIdfrom sklearn.metrics import f1_score, recall_score# 3. Las tareas de Laura: copia exacta del archivo del anexo C, en esta misma carpeta.import tareas_envios as tareas# 4. Constantes que comparte todo el anexo.SEMILLA =42# la semilla de todo el libro: los datos salen iguales en cada ejecuciónUMBRAL =0.45# punto de decisión de corrida_02 (capítulo 6)# 5. Versiones del entorno, para compararlas con las tuyas si algún resultado no coincide.print({"python": platform.python_version(), "prefect": prefect.__version__,"pandas": pd.__version__, "numpy": np.__version__,"scikit-learn": sklearn.__version__, "joblib": joblib.__version__})
Las versiones son las del entorno del libro, con Prefect 3.9.1 instalado como indica el anexo C.
Las tareas de Laura en este anexo
tareas_envios.py es una copia exacta del archivo del anexo C. Está en esta carpeta por dos razones: el anexo se ejecuta solo, sin depender de otra carpeta, y puedes leer lo que se importa sin cambiar de página. De ese archivo, el anexo usa cuatro funciones y dos constantes:
preparar, entrenar y evaluar reconstruyen corrida_02, el modelo en producción, con la misma búsqueda, el mismo umbral y la misma prueba del capítulo 6.
crear_pipeline da el pipeline del capítulo 5, sin ajustar; el caso 2 lo usa para entrenar al retador.
SERVICIOS y MAX_PESOS_VACIOS son parte del acuerdo de datos; el caso 1 los usa para validar cada sede.
Los archivos del anexo y qué hace cada uno. El código va del original del anexo C a su copia y de ahí al notebook; al ejecutarse, cada flujo escribe sus propios archivos, y Prefect anota todo en su base, fuera del libro.
traer, revisar y entregar pertenecen al lote del anexo C y aquí no se llaman. La primera línea del archivo menciona Airflow y Dagster porque viene del anexo C, donde las tres herramientas envuelven estas mismas funciones.
Las dos copias son independientes: si cambias el archivo del anexo C, el de este anexo no cambia. La celda siguiente muestra el archivo tal como está en la carpeta.
# El archivo completo, leído de la carpeta del anexo para que lo que ves sea lo que se importa.codigo = Path("tareas_envios.py").read_text(encoding="utf-8")display(Markdown(f"```python\n{codigo}```"))
"""Las seis tareas del lote nocturno de Laura, sin ninguna herramienta de orquestación.Prefect, Airflow y Dagster envuelven estas mismas funciones. Ninguna sabe quién la llama."""from io import BytesIOfrom pathlib import Pathimport hashlibimport jsonimport joblibimport numpy as npimport pandas as pdfrom sklearn.compose import ColumnTransformerfrom sklearn.impute import SimpleImputerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import f1_score, precision_score, recall_scorefrom sklearn.model_selection import GridSearchCV, StratifiedKFold, cross_val_predictfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScalerSEMILLA =42REGLA = {"f1_minimo": 0.50, "sensibilidad_minima": 0.60}MAX_PESOS_VACIOS =0.20# acuerdo de calidad: a lo sumo 20 % de pesos sin registrarSERVICIOS = ["express", "estándar", "económico"]def huella_bytes(contenido):"""Devuelve el SHA-256 de unos bytes."""return hashlib.sha256(contenido).hexdigest()def traer(ruta_fuente, simular_corte=False):"""Lee el lote de la fuente. Con simular_corte, la primera llamada falla.""" marca = Path(ruta_fuente).with_name("corte-simulado")if simular_corte andnot marca.exists(): marca.touch()raiseTimeoutError("La fuente agotó el tiempo de respuesta")return pd.read_csv(ruta_fuente)def revisar(tabla):"""Comprueba columnas, dominios y el acuerdo de pesos vacíos.""" esperadas = ["distancia_km", "peso_kg", "servicio", "llega_tarde"]iflist(tabla.columns) != esperadas:raiseValueError("El lote tiene columnas distintas de las esperadas") vacios =float(tabla["peso_kg"].isna().mean())if vacios > MAX_PESOS_VACIOS:raiseValueError(f"Pesos vacíos: {vacios:.1%}; el acuerdo admite {MAX_PESOS_VACIOS:.0%}") validas = tabla["distancia_km"].ge(0) & tabla["servicio"].isin(SERVICIOS)ifnot validas.all():raiseValueError("El lote contiene filas fuera del esquema")return {"filas": len(tabla), "pesos_vacios": round(vacios, 4)}def preparar(tabla):"""Separa desarrollo (75 %) y prueba (25 %) sin ajustar transformaciones.""" desarrollo, prueba = train_test_split( tabla, test_size=0.25, random_state=SEMILLA, stratify=tabla.llega_tarde)return desarrollo, pruebadef crear_pipeline():"""Pipeline de envíos del capítulo 5, sin ajustar.""" numericas = Pipeline([("rellenar", SimpleImputer(strategy="mean")), ("escalar", StandardScaler())]) columnas = ColumnTransformer([ ("numericas", numericas, ["distancia_km", "peso_kg"]), ("categoricas", OneHotEncoder(handle_unknown="ignore"), ["servicio"]), ])return Pipeline([("preparar", columnas), ("modelo", LogisticRegression(max_iter=1000))])def entrenar(desarrollo):"""Búsqueda en grilla y umbral del capítulo 6; el modelo viaja como bytes.""" X = desarrollo.drop(columns="llega_tarde") y = desarrollo.llega_tarde cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA) grilla = {"modelo__C": [0.01, 0.1, 1, 10, 100],"modelo__class_weight": [None, "balanced"],"preparar__numericas__rellenar__strategy": ["mean", "median"]} busqueda = GridSearchCV(crear_pipeline(), grilla, cv=cv, scoring="f1", n_jobs=1) busqueda.fit(X, y) ganador = busqueda.best_estimator_ probabilidades = cross_val_predict(ganador, X, y, cv=cv, method="predict_proba")[:, 1] opciones = []for corte in np.arange(0.15, 0.751, 0.05): corte =round(float(corte), 2) prediccion = (probabilidades >= corte).astype(int) opciones.append({"umbral": corte, "f1": f1_score(y, prediccion),"sensibilidad": recall_score(y, prediccion)}) candidatas = pd.DataFrame(opciones).query("sensibilidad >= 0.70") elegida = candidatas.sort_values(["f1", "umbral"], ascending=False).iloc[0] memoria = BytesIO() joblib.dump(ganador, memoria) modelo = memoria.getvalue()return {"modelo": modelo, "huella_modelo": huella_bytes(modelo),"configuracion": busqueda.best_params_,"f1_cv": round(float(busqueda.best_score_), 6), "umbral": float(elegida.umbral)}def evaluar(seleccion, prueba):"""Mide una sola vez en prueba y aplica la regla de aceptación.""" modelo = joblib.load(BytesIO(seleccion["modelo"])) probabilidades = modelo.predict_proba(prueba.drop(columns="llega_tarde"))[:, 1] prediccion = (probabilidades >= seleccion["umbral"]).astype(int) y = prueba.llega_tarde metricas = {"f1": round(f1_score(y, prediccion), 6),"sensibilidad": round(recall_score(y, prediccion), 6),"precision": round(precision_score(y, prediccion, zero_division=0), 6)} metricas["aceptado"] =bool(metricas["f1"] >= REGLA["f1_minimo"]and metricas["sensibilidad"] >= REGLA["sensibilidad_minima"])return metricasdef entregar(seleccion, metricas, carpeta):"""Escribe el modelo y el manifiesto para Laura solo si la regla se cumple."""ifnot metricas["aceptado"]:raiseValueError("El modelo queda retenido por la regla de aceptación") carpeta = Path(carpeta) (carpeta /"modelo.joblib").write_bytes(seleccion["modelo"]) manifiesto = {"modelo": "modelo.joblib", "huella_modelo": seleccion["huella_modelo"],"umbral": seleccion["umbral"], "metricas": metricas} ruta = carpeta /"entrega.json" ruta.write_text(json.dumps(manifiesto, indent=2, ensure_ascii=False), encoding="utf-8")return ruta.as_posix()
El generador y el modelo en producción
La celda siguiente hace dos trabajos. Los dos preparan lo que necesitan los casos: datos de envíos y el modelo que los puntúa.
Primer trabajo: generar_envios, la fábrica de datos. BITLogística es ficticia, así que sus envíos no se descargan de ningún lado: se generan. La función recibe cuántos envíos quieres (n) y una semilla (semilla), y devuelve una tabla con cuatro columnas: distancia_km, peso_kg, servicio y llega_tarde. Lo hace en cuatro pasos, los mismos de todo el libro:
Sortea cada envío. La distancia sale de una gamma(2, 150), con un promedio de 300 km. El peso sale de una lognormal(1.2, 0.6), alrededor de 4 kg. El servicio es express en el 25 % de los casos, estándar en el 50 % y económico en el 25 %.
Calcula su probabilidad de llegar tarde con una fórmula fija: sube con la distancia y con el peso, y cambia según el servicio. La tabla muestra lo que da para un envío típico, de 300 km y 4 kg.
Sortea llega_tarde con esa probabilidad. Esta columna es la verdad que, en la operación real, se conoce días después de la entrega.
Borra el peso en el 10 % de los envíos. Lo hace después de sortear el retraso, porque una báscula que no registra no cambia si el paquete llega tarde: solo deja un hueco en los datos. Por eso el modelo tiene que saber rellenar pesos vacíos.
Envío típico (300 km, 4 kg)
Efecto del servicio
Probabilidad de llegar tarde
Express, todo el libro
−1.0
10 %
Estándar
0.0
23 %
Económico
+0.9
43 %
Express en temporada alta (caso 2)
+1.0
45 %
La función tiene un solo parámetro que no está en el resto del libro: efecto_express. Vale −1.0, como siempre, salvo en las semanas 5 y 6 del caso 2, donde sube a +1.0 para simular la temporada alta. La última fila muestra lo que eso significa: un express típico pasa de llegar tarde 1 de cada 10 veces a casi 1 de cada 2, como un económico.
Con la misma semilla, la función devuelve siempre la misma tabla. Por eso tus cifras deben coincidir con las del libro.
Segundo trabajo: reconstruir corrida_02, el modelo en producción.
ImportanteQué es corrida_02 y para qué se crea
Qué es. El modelo que BITLogística tiene en producción, elegido en el capítulo 6. Es una regresión logística con C = 10, pesos de clase balanceados, pesos vacíos rellenados con la mediana y umbral de decisión 0.45. Recibe la distancia, el peso y el servicio de un envío y devuelve la probabilidad de que llegue tarde. Si esa probabilidad es 0.45 o más, el envío se marca como alerta.
Para qué se crea aquí. Los dos casos necesitan el modelo que ya está en producción, no uno inventado para el anexo:
En el caso 1, arma la lista de las 6:00. Cada noche, después de validar los archivos, el flujo junta los envíos de las sedes que pasaron (200 por sede). corrida_02puntúa cada uno, es decir, le calcula una probabilidad de llegar tarde a partir de su distancia, su peso y su servicio. Los envíos con 0.45 o más se marcan como alerta y entran en la lista, que los despachadores atienden primero, antes de que el retraso ocurra. En una noche normal, de 600 envíos se marcan 273: 86 de Bogotá, 98 de Medellín y 89 de Cali. El modelo solo puntúa lo que le llega: si una sede queda en cuarentena, sus envíos no se puntúan y la lista lo dice en la cobertura.
En el caso 2, es el campeón. Es la referencia contra la que se mide el retador cada lunes.
Qué aporta. Continuidad con el libro. Como es el mismo modelo del capítulo 6, sus cifras se pueden comparar con las de ese capítulo, y lo único nuevo en este anexo es la orquestación. Si los casos usaran un modelo distinto, no sabrías si un cambio en los resultados viene del flujo o del modelo.
Por qué se entrena otra vez en lugar de cargarlo de un archivo. Así el anexo se ejecuta solo, sin depender de un archivo .joblib guardado en otro capítulo. La comprobación del paso 3 garantiza que el modelo reconstruido es exactamente el mismo.
La celda lo reconstruye en cuatro pasos, con las funciones de tareas_envios.py:
generar_envios(600, SEMILLA) produce el mismo historial de 600 envíos del capítulo 6, y preparar lo separa en desarrollo (450 envíos) y prueba (150).
entrenar repite la búsqueda en grilla y la elección del umbral sobre desarrollo, y evaluar mide una sola vez sobre prueba.
Comprobación. Si la configuración ganadora no es la de corrida_02 o el F1 de prueba no es exactamente 0.527473, la celda se detiene con un error. Así, si algo es distinto en tu entorno, por ejemplo otra versión de scikit-learn, lo sabes aquí y no tres secciones más abajo, con cifras que no cuadran.
campeon es el pipeline ya entrenado, listo para calcular probabilidades. Es lo que reciben los dos flujos.
def generar_envios(n, semilla, efecto_express=-1.0):"""Genera n envíos con el mecanismo del libro y devuelve una tabla con su etiqueta. efecto_express es el único parámetro nuevo: el caso 2 lo cambia para simular la temporada alta. Con el valor por defecto, la función es la de todo el libro. """# 1. Variables del envío, con las distribuciones de todo el libro. rng = np.random.default_rng(semilla) distancia = rng.gamma(2.0, 150, n).round(1) peso = rng.lognormal(1.2, 0.6, n).round(2) servicio = rng.choice(["express", "estándar", "económico"], size=n, p=[0.25, 0.50, 0.25])# 2. Probabilidad de retraso: sube con la distancia y el peso, y depende del servicio. efectos = {"express": efecto_express, "estándar": 0.0, "económico": 0.9} efecto_servicio = pd.Series(servicio).map(efectos).to_numpy() logit =-1.2+0.0035* (distancia -300) +0.12* (peso -4) + efecto_servicio# 3. La etiqueta se sortea con esa probabilidad. llega_tarde = (rng.random(n) <1/ (1+ np.exp(-logit))).astype(int) peso[rng.random(n) <0.10] = np.nan # la báscula falla después: el retraso no cambiareturn pd.DataFrame({"distancia_km": distancia, "peso_kg": peso,"servicio": servicio, "llega_tarde": llega_tarde})# corrida_02: misma búsqueda, mismo umbral y misma prueba del capítulo 6.# 1. Mismos datos y misma partición del capítulo 6.desarrollo, prueba = tareas.preparar(generar_envios(600, SEMILLA))# 2. Búsqueda en grilla y umbral; después, una sola medición en prueba.seleccion = tareas.entrenar(desarrollo)metricas = tareas.evaluar(seleccion, prueba)# 3. Comprobación: si el modelo no es exactamente corrida_02, la celda se detiene.CONFIGURACION = {"modelo__C": 10, "modelo__class_weight": "balanced","preparar__numericas__rellenar__strategy": "median"}if seleccion["configuracion"] != CONFIGURACION or metricas["f1"] !=0.527473:raiseValueError("El modelo de referencia no coincide con corrida_02 del capítulo 6.")campeon = joblib.load(BytesIO(seleccion["modelo"])) # el pipeline listo para predecirprint("corrida_02 | umbral:", seleccion["umbral"], "| prueba:", metricas)
La comprobación pasa: corrida_02 usa umbral 0.45 y en los 150 envíos de prueba da F1 0.527473, sensibilidad 0.666667 y precisión 0.436364, las cifras del capítulo 6. aceptado: True quiere decir que cumple la regla de aceptación del libro: F1 de al menos 0.50 y sensibilidad de al menos 0.60. A partir de aquí, campeon es ese pipeline: el modelo que está en producción cuando empiezan los dos casos.
2) Caso 1: El corte de las 6:00, tres sedes y una lista
La situación en BITLogística
Cada sede cierra la recepción por su cuenta y deja un archivo con los envíos del día: recepcion_<sede>_<fecha>.csv. A las 6:00, Laura reparte una sola lista con los envíos marcados por el modelo, y cada coordinador revisa los de su sede antes de cargar los vehículos. Equivocarse cuesta de dos maneras:
Si no hay lista, los envíos salen sin revisar y los retrasos se descubren cuando el cliente reclama.
Si la lista trae datos malos, el equipo pierde la ventana buscando paquetes equivocados: un identificador repetido manda a dos personas a buscar la misma caja.
Los datos
Cada sede envía 200 envíos con cuatro columnas: id_envio, distancia_km, peso_kg y servicio. La etiqueta llega_tarde no viene en el archivo, porque a las 6:00 nadie sabe todavía si el paquete llegará tarde. Bogotá, Medellín y Cali usan las semillas SEMILLA + 10, + 11 y + 12, y las cuatro noches reutilizan esos mismos lotes: así, cualquier diferencia entre noches se debe solo a la incidencia que se simula, no a otros paquetes.
El identificador lleva el nombre de la sede (cali-0001) porque cada sede numera desde 1: sin el prefijo, el envío 1 de Bogotá y el de Cali serían el mismo al unir los archivos.
Las incidencias se fabrican a propósito y a la vista:
Cali llega tarde: su archivo se escribe con la extensión .en_camino y cambia al nombre definitivo justo después del primer intento de lectura. Así funciona un acuerdo común entre sistemas: el archivo se escribe con un nombre provisional y se renombra cuando está completo, para que nadie lea uno a medio escribir.
Medellín con la báscula dañada: sus primeros 70 envíos quedan sin peso y dos identificadores se repiten.
Las reglas, escritas antes de ejecutar
Regla
Valor
Por qué ese valor
Quién la acordaría
Espera
2 reintentos de 1 segundo, solo si el archivo no existe
Un archivo ausente puede aparecer; uno con errores no se arregla solo. En producción serían minutos: aquí son segundos para que el notebook no tarde
Recepción y despacho
Identidad
id_envio único y con el prefijo de su sede
Evita buscar dos veces el mismo paquete
Datos
Dominio
Distancia y peso positivos; peso vacío permitido; servicio conocido
Separa lo desconocido (vacío) de lo imposible (negativo)
Calidad
Pesos vacíos
Como máximo 20 % por sede
Es el acuerdo del anexo C; medirlo por sede evita que dos sedes sanas escondan a una dañada en el promedio
Calidad
Cobertura
Publicar si al menos una sede es válida, diciendo cuáles faltan y por qué
Las sedes despachan por separado: la lista de Bogotá sirve aunque falte Medellín
Despacho
Alerta
Probabilidad ≥ 0.45 con corrida_02
Es el umbral acordado con Laura en el capítulo 6
Modelos
Entrega
Un solo archivo por fecha, que se reemplaza completo
Relanzar una fecha no debe dejar dos listas
Integración
ImportanteLa decisión central del caso
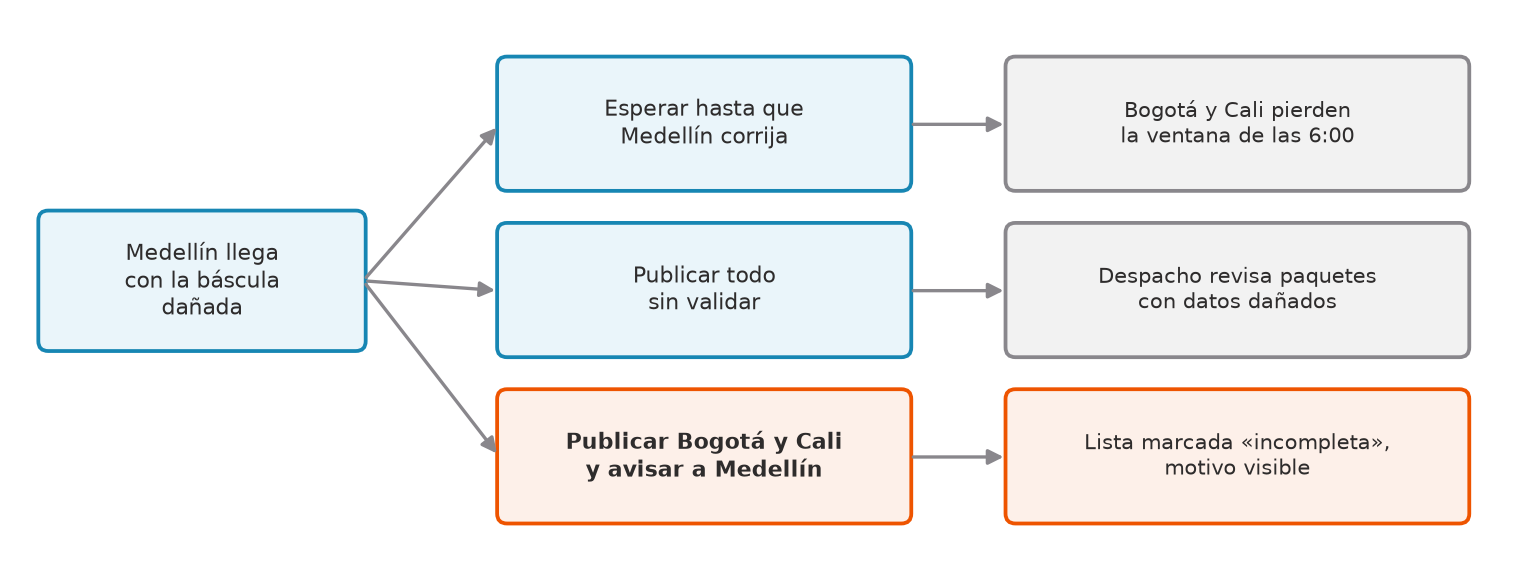
Si una sede no llega o llega con errores, el flujo publica la lista de las demás, marcada como «incompleta», con el motivo de cada sede que faltó. No espera indefinidamente ni publica datos sin validar.
Tres respuestas posibles cuando Medellín llega con la báscula dañada. Solo la tercera protege a las otras sedes sin publicar datos malos.
Esta regla depende de cómo trabaja la empresa. En BITLogística cada sede tiene sus propios vehículos, así que la lista de Bogotá es útil por sí sola. Si las tres sedes compartieran una flota y la lista sirviera para repartir vehículos, publicar sin Medellín podría llevar a una mala asignación, y lo prudente sería escalar el problema antes de publicar.
El flujo dibujado
El flujo del turno. Cada sede tiene su rama de espera y validación; las inválidas van a cuarentena con su motivo. Las válidas se unen, se puntúan y se publican.
Cada sede tiene su propia rama: su tarea de espera y su tarea de validación. Si todo fuera una sola tarea que lee los tres archivos, un error en Medellín la haría fallar entera y Bogotá y Cali se quedarían sin lista.
El código, tarea por tarea
Primero, los lotes de las tres sedes y la función que fabrica cada noche con sus incidencias.
# 0. Sedes, columnas acordadas y las tres carpetas del turno.SEDES = ["bogota", "medellin", "cali"]COLUMNAS = ["id_envio", "distancia_km", "peso_kg", "servicio"]RECEPCION = ARTEFACTOS /"recepcion"# donde las sedes dejan sus archivosLISTAS = ARTEFACTOS /"listas"# donde Laura publica la lista del díaCUARENTENA = ARTEFACTOS /"cuarentena"# archivos rechazados, con su motivofor carpeta in [RECEPCION, LISTAS, CUARENTENA]: carpeta.mkdir()# 1. Un lote fijo por sede: las cuatro noches usan los mismos 200 envíos.lotes = {}for desplazamiento, sede inzip([10, 11, 12], SEDES): lote = generar_envios(200, SEMILLA + desplazamiento).drop(columns="llega_tarde") lote.insert(0, "id_envio", [f"{sede}-{numero:04d}"for numero inrange(1, 201)]) lotes[sede] = lote# 2. Cada noche se fabrica escribiendo los tres archivos como llegarían de las sedes.def preparar_noche(fecha, sede_tardia=None, sede_danada=None):"""Escribe los tres archivos de la fecha con las incidencias pedidas. sede_tardia deja su archivo con nombre provisional (.en_camino). sede_danada pierde 70 pesos y repite dos identificadores. """for sede, original in lotes.items(): tabla = original.copy() # el lote fijo no se toca: cada noche trabaja sobre una copiaif sede == sede_danada: tabla.loc[:69, "peso_kg"] = np.nan # 70 de 200: 35 % más de vacíos tabla.loc[1, "id_envio"] = tabla.loc[0, "id_envio"] # primer duplicado tabla.loc[3, "id_envio"] = tabla.loc[2, "id_envio"] # segundo duplicado ruta = RECEPCION /f"recepcion_{sede}_{fecha}.csv"if sede == sede_tardia: ruta = ruta.with_suffix(".en_camino") # todavía se está escribiendo tabla.to_csv(ruta, index=False)# 3. Comprobación: 200 envíos por sede y las primeras filas de Cali.print({sede: len(tabla) for sede, tabla in lotes.items()})print(lotes["cali"].head(3).to_string(index=False))
Cada sede tiene sus 200 envíos y el identificador lleva el prefijo de la sede, como muestran las tres primeras filas de Cali. Ninguna tabla tiene la columna llega_tarde.
Ahora la tarea de espera. Es la de traer del anexo C con un cambio: el reintento solo se autoriza si el error es FileNotFoundError, es decir, si el archivo todavía no existe. Para simular que Cali termina de escribir entre un intento y otro, la tarea renombra el archivo provisional cuando lo encuentra: en una operación real, ese cambio de nombre lo haría el sistema de la sede.
Las tareas de este anexo llevan cache_policy=NO_CACHE: leen y escriben archivos que cambian entre noches, y no queremos que Prefect devuelva un resultado guardado de otra ejecución. task_run_name le pone a cada corrida el nombre de su sede (esperar-cali), para que la historia de Prefect se lea sin adivinar.
# 1. Condición de reintento: Prefect la consulta después de cada intento fallido.def solo_si_falta(tarea, corrida, estado):"""Autoriza otro intento solo si el archivo todavía no existe."""try: estado.result() # vuelve a lanzar la excepción que hizo fallar el intentoexceptFileNotFoundError:returnTrue# el archivo puede aparecer: vale la pena esperarexceptException:returnFalse# cualquier otro error no se arregla esperandoreturnFalse# el intento no falló: no hay nada que reintentar# 2. Tarea de espera: hasta 3 intentos (el primero y 2 reintentos), con 1 segundo entre ellos.@task(task_run_name="esperar-{sede}", retries=2, retry_delay_seconds=1, retry_condition_fn=solo_si_falta, cache_policy=NO_CACHE)def esperar_archivo(sede, ruta):"""Devuelve el texto del archivo de la sede cuando existe con su nombre definitivo."""try:return ruta.read_text(encoding="utf-8")exceptFileNotFoundError: provisional = ruta.with_suffix(".en_camino")if provisional.exists(): provisional.replace(ruta) # simulación: la sede termina de escribirraise# este intento falla igual; el siguiente lo leerá
NotaCuarentena
La cuarentena es una carpeta donde se guarda, sin modificar, un archivo que no pasó la validación, junto con el motivo del rechazo. El flujo no intenta corregirlo: quien puede arreglarlo es la sede que lo produjo, y para eso necesita ver exactamente qué llegó y qué estaba mal.
La validación revisa cada regla y acumula todos los motivos antes de rechazar. Si se detuviera en el primer error, Medellín corregiría los duplicados, volvería a enviar y solo entonces se enteraría del problema de la báscula: dos vueltas en lugar de una.
# Validación de una sede: revisa todas las reglas y anota todos los motivos antes de decidir.@task(task_run_name="validar-{sede}", cache_policy=NO_CACHE)def validar(sede, fecha, texto):"""Devuelve la tabla de la sede si cumple todas las reglas. Si no las cumple, guarda el archivo y sus motivos en cuarentena y falla. """ motivos = []# 1. ¿Se puede leer como CSV? El identificador se lee como texto.try: tabla = pd.read_csv(BytesIO(texto.encode("utf-8")), dtype={"id_envio": "string"})except (pd.errors.ParserError, pd.errors.EmptyDataError): tabla = pd.DataFrame() motivos.append("CSV ilegible")# 2. ¿Tiene las columnas acordadas y al menos una fila?iflist(tabla.columns) != COLUMNAS or tabla.empty: motivos.append("columnas distintas de las acordadas o archivo vacío")else:# 3. Identidad: prefijo de la sede y sin repetidos.ifnot tabla.id_envio.str.fullmatch(rf"{sede}-[0-9]+", na=False).all(): motivos.append("identificador sin el prefijo de la sede") repetidos =int(tabla.id_envio.duplicated().sum())if repetidos >0: motivos.append(f"{repetidos} identificadores repetidos")# 4. Dominios: lo imposible se rechaza; el peso vacío se permite. distancia = pd.to_numeric(tabla.distancia_km, errors="coerce") peso = pd.to_numeric(tabla.peso_kg, errors="coerce")ifnot distancia.gt(0).all(): motivos.append("distancia vacía, no numérica o no positiva")ifnot (tabla.peso_kg.isna() | peso.gt(0)).all(): motivos.append("peso no numérico o no positivo")ifnot tabla.servicio.isin(tareas.SERVICIOS).all(): motivos.append("servicio desconocido")# 5. Acuerdo de calidad: como máximo 20 % de pesos vacíos en esta sede. vacios = tabla.peso_kg.isna().mean()if vacios > tareas.MAX_PESOS_VACIOS: motivos.append(f"pesos vacíos {vacios:.1%}, el acuerdo admite 20 %")# 6. Rechazo: se guarda lo que llegó y por qué, y la tarea falla.if motivos: motivo ="; ".join(motivos) base = CUARENTENA /f"recepcion_{sede}_{fecha}" base.with_suffix(".csv").write_text(texto, encoding="utf-8") base.with_suffix(".motivo.txt").write_text(motivo, encoding="utf-8")raiseValueError(motivo)# 7. Aceptada: se anota la sede para poder contar sus alertas después. tabla["sede"] = sedereturn tabla
Las cuatro tareas que siguen trabajan con las sedes que ya pasaron la validación. publicar_lista es la que hace idempotente la entrega: escribe primero un archivo temporal en la misma carpeta y luego lo pone en el lugar de la lista de esa fecha con replace, que reemplaza el archivo en un solo paso. Quien abra la lista ve la versión anterior completa o la nueva completa, nunca una mezcla. Y como el nombre solo lleva la fecha, relanzar el 29 de octubre reemplaza la lista del 29 en lugar de crear una segunda.
NotaTablas publicadas en Prefect (artifacts)
Una tarea puede publicar una tabla o un texto en la interfaz de Prefect con create_table_artifact o create_markdown_artifact. Prefect los llama artifacts; aquí los llamamos tablas publicadas, para no confundirlos con la carpeta artefactos/. Quedan pegados a la corrida que los produjo y se pueden consultar sin abrir el notebook ni los archivos. La key agrupa las versiones: cada turno publica una nueva tabla «cobertura-del-turno» y la interfaz guarda la historia.
La última tarea, resumen_del_turno, aprovecha esa ventaja: además de escribir una línea en el registro, publica la tabla de cobertura. Así Laura, o el coordinador de Medellín, pueden ver desde el navegador qué sede faltó y por qué, sin pedirle a nadie que abra un archivo.
La lista guarda en un mismo documento las alertas y la cobertura: qué sedes incluye, cuántos envíos aporta cada una y por qué faltó alguna. Si fueran dos archivos, alguien podría abrir las alertas sin ver que Medellín no está.
# Las cuatro tareas finales del turno. NO_CACHE: cada noche se calcula de nuevo.@task(cache_policy=NO_CACHE)def unir_sedes_validas(tablas):"""Une en una sola tabla las sedes que pasaron la validación."""return pd.concat(tablas, ignore_index=True)@task(cache_policy=NO_CACHE)def puntuar_con_modelo(tabla, modelo):"""Devuelve los envíos cuya probabilidad de retraso alcanza el umbral.""" X = tabla[["distancia_km", "peso_kg", "servicio"]] # las variables con que se entrenó corrida_02 probabilidad = modelo.predict_proba(X)[:, 1] # probabilidad de llegar tarde marcados = probabilidad >= UMBRAL # la decisión de corrida_02 alertas = tabla.loc[marcados, ["id_envio", "sede"]].copy() alertas["probabilidad"] = probabilidad[marcados].round(4)return alertas@task(cache_policy=NO_CACHE)def publicar_lista(fecha, cobertura, alertas):"""Escribe la lista de la fecha (alertas + cobertura) y devuelve su ruta."""# La lista es «completa» solo si las tres sedes pasaron la validación. completa =all(fila["situacion"] =="válida"for fila in cobertura) documento = {"fecha": fecha,"estado": "completa"if completa else"incompleta","modelo": "corrida_02", "umbral": UMBRAL,"cobertura": cobertura,"alertas": alertas.to_dict("records")} ruta = LISTAS /f"alertas_{fecha}.json" temporal = ruta.with_suffix(".tmp") # 1. se escribe aparte... temporal.write_text(json.dumps(documento, ensure_ascii=False, indent=2), encoding="utf-8") temporal.replace(ruta) # 2. ...y se pone en su lugar de una vezreturn ruta@task(cache_policy=NO_CACHE)def resumen_del_turno(fecha, cobertura, ruta):"""Deja en Prefect el mensaje y la tabla de cobertura que leería Laura.""" faltan = [fila["sede"] for fila in cobertura if fila["situacion"] !="válida"] mensaje =f"Lista del {fecha}: {ruta.as_posix() if ruta else'no se publicó'}"if faltan: mensaje +=" | faltan: "+", ".join(faltan) prefect.get_run_logger().info(mensaje) # 1. una línea en el registro create_table_artifact(table=cobertura, key="cobertura-del-turno", # 2. una tabla en la interfaz description=mensaje)return mensaje
NotaLanzar una tarea y revisar cómo terminó
Cuando un flujo llama a una tarea normalmente, tarea(...), y la tarea falla, el flujo entero se detiene. Para que el fallo de una sede no detenga a las otras, el flujo usa tarea.submit(...): lanza la tarea y devuelve un futuro, un objeto que representa una tarea en curso. Con futuro.wait() el flujo espera a que termine; con futuro.state pregunta cómo terminó (Completed, Failed); y solo si terminó bien, futuro.result() entrega el valor.
El flujo recorre las sedes una por una y anota la cobertura de cada una: si fue válida, si faltó o si quedó en cuarentena, y el motivo. El motivo se toma del mensaje del estado de Prefect, quitando el prefijo con que Prefect lo envuelve, para que Laura lea «2 identificadores repetidos» y no un texto técnico.
Las sedes se procesan una tras otra para que puedas seguir la historia en orden. Con submit, Prefect también podría correr las tres esperas a la vez; en un turno real, con esperas de minutos, eso ahorraría tiempo y el diseño de las ramas sería el mismo.
def motivo_de(estado):"""Devuelve el motivo legible de una tarea fallida, sin el prefijo de Prefect."""# Prefect guarda un mensaje largo; el motivo propio está al final de la primera línea. primera_linea = estado.message.splitlines()[0]return primera_linea.split("exception ", 1)[-1].replace("ValueError: ", "")@flow(name="lista-del-turno")def lista_del_turno(fecha, modelo):"""Procesa las tres sedes de una fecha y publica la lista con su cobertura.""" cobertura = [] validas = []# 1. Una rama por sede: esperar el archivo y validarlo.for sede in SEDES:# La fila parte como «sin archivo» y se actualiza según lo que le pase a la sede. fila = {"sede": sede, "situacion": "sin archivo", "motivo": "", "envios": 0, "marcados": 0} cobertura.append(fila)# submit lanza la tarea sin detener el flujo si falla; wait espera a que termine. lectura = esperar_archivo.submit(sede, RECEPCION /f"recepcion_{sede}_{fecha}.csv") lectura.wait()ifnot lectura.state.is_completed(): # agotó los reintentos fila["motivo"] = motivo_de(lectura.state)continue# la siguiente sede sigue su camino revision = validar.submit(sede, fecha, lectura.result()) revision.wait()ifnot revision.state.is_completed(): # no pasó las reglas fila["situacion"] ="cuarentena" fila["motivo"] = motivo_de(revision.state)continue# Sede aceptada: entra a la lista. tabla = revision.result() validas.append(tabla) fila["situacion"] ="válida" fila["envios"] =len(tabla)# 2. Con al menos una sede válida: unir, puntuar y publicar. ruta =Noneif validas: alertas = puntuar_con_modelo(unir_sedes_validas(validas), modelo)for fila in cobertura: fila["marcados"] =int((alertas.sede == fila["sede"]).sum()) ruta = publicar_lista(fecha, cobertura, alertas)# 3. El mensaje para Laura queda en el registro de Prefect.return resumen_del_turno(fecha, cobertura, ruta)def mostrar_turno(fecha):"""Lee la lista publicada de una fecha, muestra su cobertura y la devuelve.""" documento = json.loads((LISTAS /f"alertas_{fecha}.json").read_text(encoding="utf-8")) display(pd.DataFrame(documento["cobertura"]))print("Estado:", documento["estado"], "| alertas:", len(documento["alertas"]))return documento
Las cuatro noches
Noche 1, normal. Las tres sedes entregan a tiempo y sin errores. Los mensajes de Prefect se apagan con logging.disable para que la salida muestre solo la cobertura; en la noche 2 los verás completos.
# Noche 1: las tres sedes entregan a tiempo y sin errores.preparar_noche("2026-10-27")logging.disable(logging.CRITICAL) # sin mensajes de Prefect en esta noche# return_state=True guarda el estado de la corrida para consultar Prefect más adelante.noche_1 = lista_del_turno("2026-10-27", campeon, return_state=True)logging.disable(logging.NOTSET)lista_1 = mostrar_turno("2026-10-27")
sede
situacion
motivo
envios
marcados
0
bogota
válida
200
86
1
medellin
válida
200
98
2
cali
válida
200
89
Estado: completa | alertas: 273
Las tres sedes quedan válidas con 200 envíos cada una, y la lista marca 273 de los 600: 86 de Bogotá, 98 de Medellín y 89 de Cali. Esta noche es la referencia para las demás: como los lotes no cambian, cualquier diferencia posterior viene de la incidencia simulada.
Vale la pena detenerse en el tamaño: 273 alertas son el 46 % de los envíos. El umbral 0.45 se eligió en el capítulo 6 para detectar al menos el 70 % de los retrasos, y el precio es una lista larga. Si los tres coordinadores no alcanzan a revisar tantos paquetes entre las 5:45 y las 6:00, la conversación con Laura no es sobre el flujo sino sobre el umbral; el capítulo 14 muestra cómo plantearla en costos.
Noche 2, Cali llega tarde. Esta vez los mensajes de Prefect quedan a la vista.
# Noche 2: Cali deja su archivo con nombre provisional.# Los mensajes de Prefect quedan visibles para ver el reintento.preparar_noche("2026-10-28", sede_tardia="cali")noche_2 = lista_del_turno("2026-10-28", campeon, return_state=True)lista_2 = mostrar_turno("2026-10-28")
09:33:26.078 | INFO | Flow run 'independent-chihuahua' - Beginning flow run 'independent-chihuahua' for flow 'lista-del-turno'
09:33:26.089 | INFO | Task run 'esperar-bogota' - Finished in state Completed()
09:33:26.105 | INFO | Task run 'validar-bogota' - Finished in state Completed()
09:33:26.114 | INFO | Task run 'esperar-medellin' - Finished in state Completed()
09:33:26.123 | INFO | Task run 'validar-medellin' - Finished in state Completed()
09:33:26.131 | INFO | Task run 'esperar-cali' - Task run failed with exception: FileNotFoundError(2, 'No such file or directory') - Retry 1/2 will start 1 second(s) from now
09:33:27.134 | INFO | Task run 'esperar-cali' - Finished in state Completed()
09:33:27.144 | INFO | Task run 'validar-cali' - Finished in state Completed()
09:33:27.151 | INFO | Task run 'unir_sedes_validas-399' - Finished in state Completed()
09:33:27.164 | INFO | Task run 'puntuar_con_modelo-f98' - Finished in state Completed()
09:33:27.176 | INFO | Task run 'publicar_lista-f6d' - Finished in state Completed()
09:33:27.180 | INFO | Task run 'resumen_del_turno-cd4' - Lista del 2026-10-28: artefactos/listas/alertas_2026-10-28.json
09:33:27.205 | INFO | Task run 'resumen_del_turno-cd4' - Finished in state Completed()
09:33:28.087 | INFO | Flow run 'independent-chihuahua' - Finished in state Completed()
sede
situacion
motivo
envios
marcados
0
bogota
válida
200
86
1
medellin
válida
200
98
2
cali
válida
200
89
Estado: completa | alertas: 273
Lee el registro de arriba abajo. Bogotá y Medellín pasan su espera y su validación. En Cali, el primer intento falla con FileNotFoundError, Prefect anuncia el reintento 1 de 2 y, un segundo después, la lectura termina en Completed(). La validación de Cali pasa a la primera y el resumen del turno dice dónde quedó la lista.
El resultado es idéntico al de la noche 1: 600 envíos y 273 alertas, con 89 de Cali. La única diferencia está en la ejecución: un segundo de espera que nadie tuvo que gestionar.
Noche 3, Medellín con la báscula dañada.
# Noche 3: Medellín llega con identificadores repetidos y demasiados pesos vacíos.preparar_noche("2026-10-29", sede_danada="medellin")logging.disable(logging.CRITICAL) # la traza del error de Medellín es larga; el motivo va en la tablanoche_3 = lista_del_turno("2026-10-29", campeon, return_state=True)logging.disable(logging.NOTSET)lista_3 = mostrar_turno("2026-10-29")# Lo que quedó en cuarentena: el archivo tal como llegó y su motivo.print(sorted(path.name for path in CUARENTENA.iterdir()))
Medellín queda en cuarentena con dos motivos a la vez: 2 identificadores repetidos y 41.5 % de pesos vacíos, por encima del 20 % del acuerdo. El 41.5 % sale de los 70 pesos borrados a propósito más los que el generador ya deja vacíos. La lista se publica incompleta, con los 400 envíos de Bogotá y Cali y 175 alertas (86 + 89). En la carpeta de cuarentena quedan el archivo tal como llegó y su motivo.
Observa lo que no pasó: Bogotá y Cali no esperaron a Medellín, y las 98 alertas que Medellín tuvo la noche 1 no se copiaron a esta lista. La cobertura dice claramente que esos envíos no están.
Noche 3 relanzada. Medellín corrige y vuelve a enviar. Laura relanza la misma fecha.
# Relanzamiento: Medellín corrigió su archivo y se vuelve a correr la misma fecha.preparar_noche("2026-10-29") # el mismo día, con los archivos corregidoslogging.disable(logging.CRITICAL)noche_3_relanzada = lista_del_turno("2026-10-29", campeon, return_state=True)logging.disable(logging.NOTSET)lista_3_relanzada = mostrar_turno("2026-10-29")# Idempotencia: la fecha sigue teniendo un solo archivo.print("Listas del 2026-10-29 en disco:", len(list(LISTAS.glob("alertas_2026-10-29*"))))
sede
situacion
motivo
envios
marcados
0
bogota
válida
200
86
1
medellin
válida
200
98
2
cali
válida
200
89
Estado: completa | alertas: 273
Listas del 2026-10-29 en disco: 1
Con el archivo corregido, Medellín vuelve con sus 200 envíos y 98 alertas: la lista del 29 queda completa, con 600 envíos y 273 alertas. En disco hay una lista para esa fecha: la nueva reemplazó a la incompleta. La cuarentena, en cambio, conserva el archivo dañado y su motivo, porque es la evidencia de lo que pasó esa madrugada.
Lo que vio el equipo
Prefect guardó cada tarea de las cuatro noches. Esta celda consulta su base, como en el anexo C, y arma una tabla con una fila por noche y una columna por tarea de sede. Cada celda dice cómo terminó la tarea y, entre paréntesis, cuántos intentos hizo.
def historial_prefect(corridas):"""Devuelve una fila por tarea de las corridas indicadas: estado e intentos.""" filas = []# El cliente consulta la base de Prefect, donde quedó anotada cada corrida con sus tareas.with get_client(sync_client=True) as cliente:for nombre, estado in corridas.items(): filtro = FlowRunFilter(id=FlowRunFilterId(any_=[estado.state_details.flow_run_id]))for tarea in cliente.read_task_runs(flow_run_filter=filtro): filas.append({"corrida": nombre, "tarea": tarea.name,"estado": tarea.state.name, "intentos": tarea.run_count})return pd.DataFrame(filas)# Una fila por noche y una columna por tarea de sede: estado (número de intentos).noches = {"1 · normal": noche_1, "2 · Cali tarde": noche_2,"3 · Medellín dañada": noche_3, "3 · relanzada": noche_3_relanzada}historia_turno = historial_prefect(noches)de_sede = historia_turno[historia_turno.tarea.str.startswith(("esperar-", "validar-"))].copy()de_sede["celda"] = de_sede.estado +" ("+ de_sede.intentos.astype(str) +")"columnas = [f"{paso}-{sede}"for sede in SEDES for paso in ["esperar", "validar"]]display(de_sede.pivot(index="corrida", columns="tarea", values="celda") .reindex(index=list(noches), columns=columnas))
tarea
esperar-bogota
validar-bogota
esperar-medellin
validar-medellin
esperar-cali
validar-cali
corrida
1 · normal
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
2 · Cali tarde
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (2)
Completed (1)
3 · Medellín dañada
Completed (1)
Completed (1)
Completed (1)
Failed (1)
Completed (1)
Completed (1)
3 · relanzada
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
Completed (1)
La tabla confirma la historia: esperar-cali es la única lectura con 2 intentos (noche 2) y validar-medellin es la única tarea Failed (noche 3). El resto son Completed (1). Si alguien pregunta el miércoles qué pasó el martes en la madrugada, la respuesta está aquí, sin depender de la memoria de nadie.
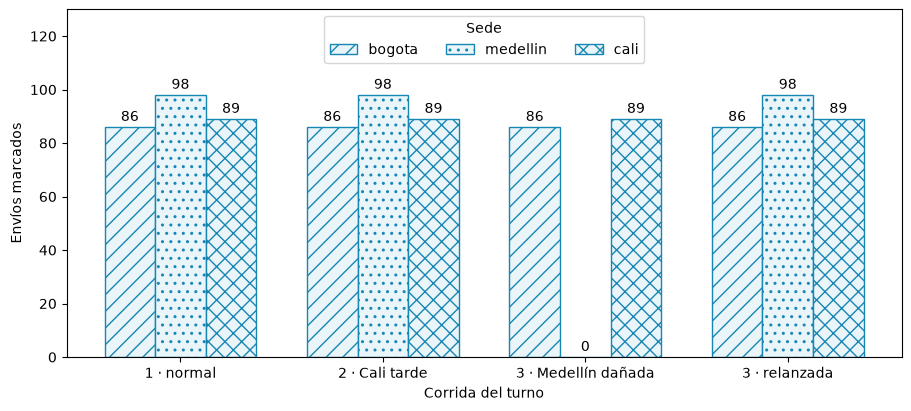
La gráfica resume lo que recibió despacho cada noche. Cada sede tiene una trama distinta, para que se lea también en blanco y negro.
# Una barra por sede y por corrida, con trama distinta para leerla también en blanco y negro.listas = [lista_1, lista_2, lista_3, lista_3_relanzada]posiciones = np.arange(len(listas))figura, eje = plt.subplots(figsize=(9, 4), layout="constrained")for indice, (sede, trama) inenumerate(zip(SEDES, ["//", "..", "xx"])): valores = [lista["cobertura"][indice]["marcados"] for lista in listas] barras = eje.bar(posiciones + (indice -1) *0.25, valores, width=0.25, hatch=trama, color="#EAF5FA", edgecolor="#1786B3", label=sede) eje.bar_label(barras, padding=2)eje.set(xticks=posiciones, xticklabels=list(noches), xlabel="Corrida del turno", ylabel="Envíos marcados", ylim=(0, 130))eje.legend(title="Sede", loc="upper center", ncol=3)plt.show()
Envíos marcados por sede en cada corrida del turno
Bogotá y Cali sostienen sus 86 y 89 alertas en las cuatro corridas. Medellín cae a 0 en la noche dañada y vuelve a 98 al relanzar. Ese cero no significa «Medellín no tiene envíos riesgosos»: significa «Medellín no está en la lista», y por eso la cobertura viaja junto a las alertas.
Las cuatro noches en la interfaz de Prefect
La tabla y la gráfica anteriores las armaste tú, con código. En una operación real nadie hace eso a las 5:50 de la mañana: el equipo abre la interfaz de Prefect. Para verla, arranca un servidor propio como en el anexo C (sección 6.5) y vuelve a ejecutar el notebook con la dirección del servidor:
prefect server start # en una terminal; déjala abiertaexportPREFECT_API_URL=http://127.0.0.1:4200/api # en otra, antes de abrir Jupyter
Las capturas que siguen son de la interfaz de Prefect 3.9.1 (software de código abierto con licencia Apache 2.0) después de ejecutar este anexo.
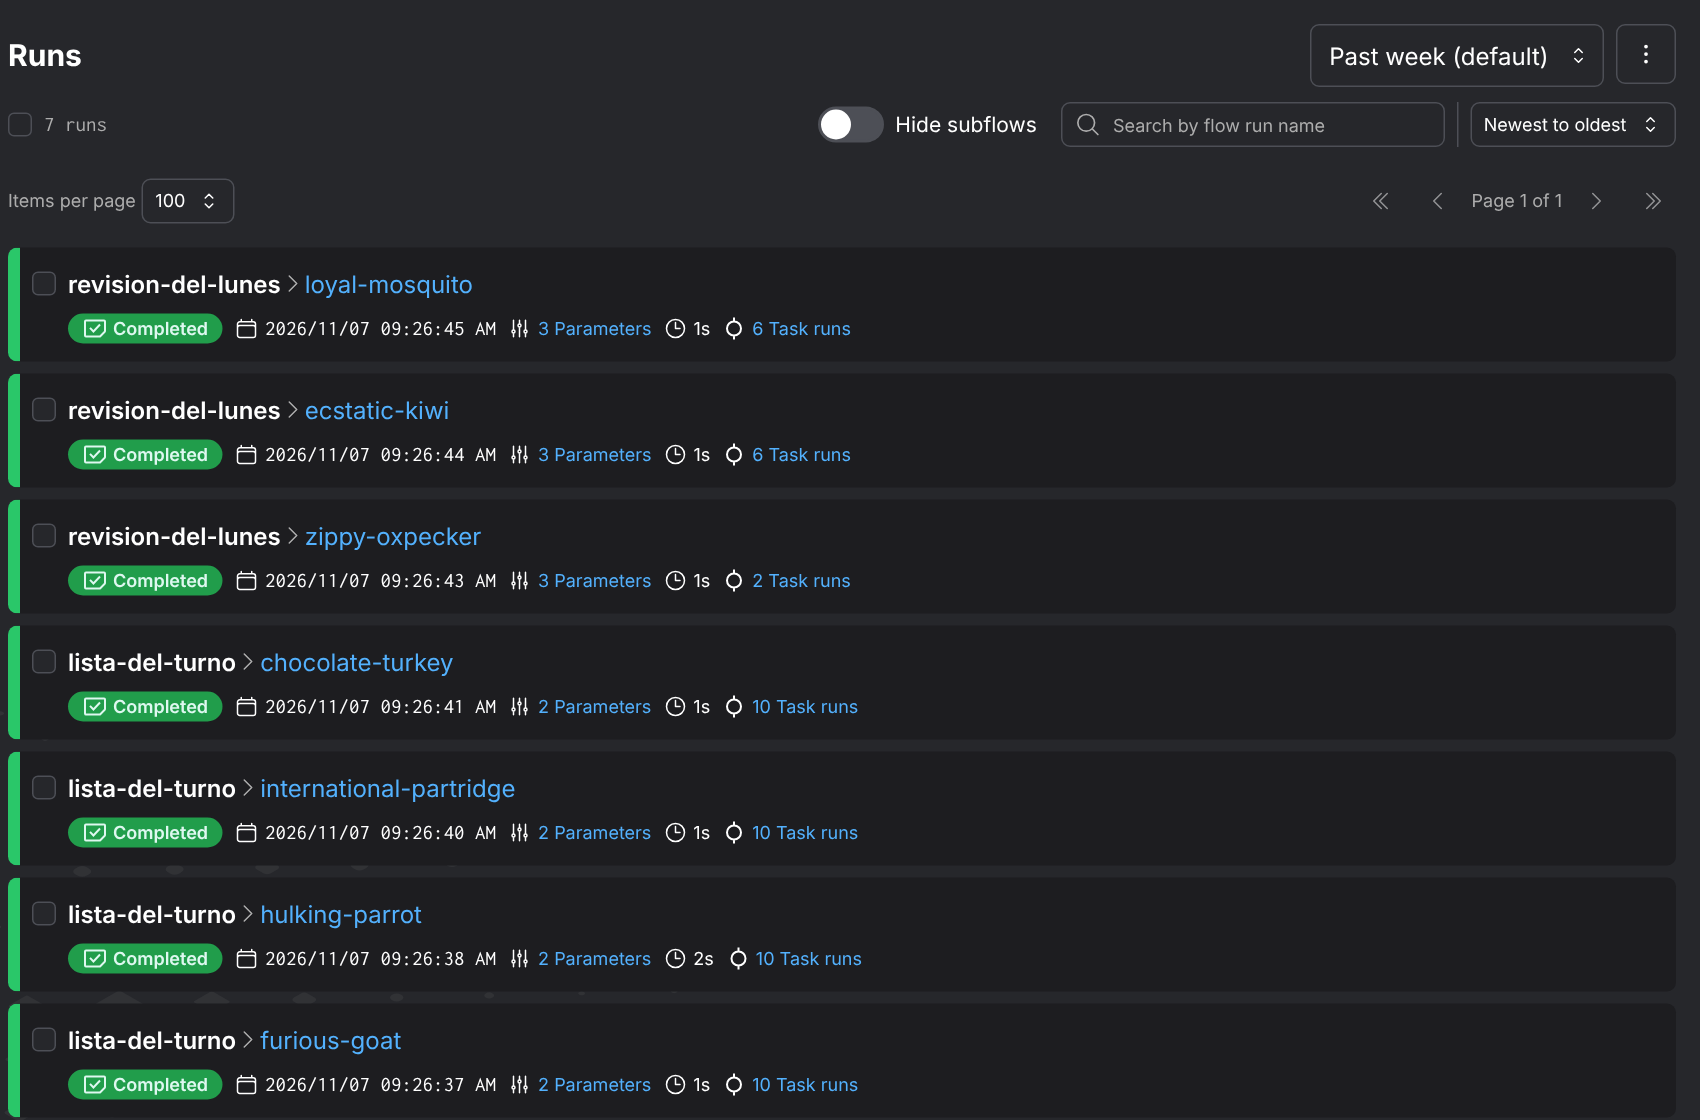
La lista de corridas que dejó este anexo: cuatro de lista-del-turno y tres de revision-del-lunes, cada una con su estado, su duración y su número de tareas.
Esta pantalla reemplaza a la tabla corridas que armaste a mano. Cada fila es una ejecución, con un nombre que Prefect inventa (furious-goat, hulking-parrot…) y que sirve para buscarla. Fíjate en el número de tareas: los turnos tienen 10 siempre, porque las tres sedes se intentan todas las noches; las revisiones del lunes tienen 2 o 6, porque la semana 3 se detuvo al ver que faltaban etiquetas y nunca entrenó un retador, y eso lo ves aquí sin abrir ningún archivo.
El turno de la noche 2 (hulking-parrot): la barra larga de esperar-cali es el tiempo que la tarea pasó reintentando hasta que llegó el archivo.
Aquí se ve el reintento sin leer el registro: Bogotá y Medellín terminan en un instante y esperar-cali se estira mientras Prefect espera y vuelve a intentar. Las flechas muestran que unir_sedes_validas no arranca hasta que las tres ramas terminan. Con el motor del capítulo 7 este dibujo no existía; tenías que deducirlo de las marcas de hora.
Las tareas del turno de la noche 3 (international-partridge): nueve en Completed y validar-medellin en Failed.
Esta es la noche que más importa. La corrida completa aparece como Completed y, sin embargo, una de sus tareas falló: validar-medellin, en rojo. Las dos cosas son ciertas a la vez, y esa es la decisión de diseño del caso: una sede dañada no detiene la lista de las otras dos. Lo que no puede pasar es que el fallo quede escondido, y Prefect lo pone en el encabezado: 9 completadas, 1 fallida.
El artefacto cobertura-del-turno publicado por la noche 3, tal como lo ve Laura en el navegador.
Esta es la tabla que resumen_del_turno publica con create_table_artifact. Laura no abre el notebook ni el JSON: entra a Prefect y lee, en una línea, que la lista de ese día no trae Medellín y por qué. La razón de la cuarentena (2 identificadores repetidos, 41.5 % de pesos vacíos) es el mismo texto que escribió la validación. Como todas las noches publican con la misma clave, la página del artefacto guarda las cuatro versiones una tras otra, y comparar noches es cuestión de hacer clic.
Por qué se decidió así
Decisión
Alternativa descartada
Por qué
Una rama de espera y validación por sede
Una tarea que lee las tres
Un error en una sede no debe dejar sin lista a las otras
Reintentar solo FileNotFoundError
Reintentar cualquier error
Un archivo ausente puede aparecer; uno con duplicados seguirá con duplicados
Acumular todos los motivos
Detenerse en el primero
La sede corrige todo en una sola vuelta
Cuarentena sin corrección automática
Borrar los duplicados y seguir
Quien sabe cuál de los dos registros es el bueno es la sede, no el flujo
Lista «incompleta» con su cobertura
Esperar o publicar sin validar
Las sedes despachan por separado; la cobertura evita leer un cero como «sin riesgo»
Un archivo por fecha, reemplazado de una vez
Un archivo por cada ejecución
Siempre hay una sola lista vigente, y nunca una a medio escribir
Hay una situación que este diseño todavía no resuelve, y aparece en los ejercicios: si un relanzamiento no encuentra ninguna sede válida, no publica nada y en disco queda la lista anterior de esa fecha. Para despacho, esa lista vieja parecería vigente.
3) Caso 2: El lunes de Laura, ¿cambiamos de modelo?
La situación en BITLogística
El resultado real de un envío (llega_tarde) se conoce cuando se entrega, días después de la alerta. Cada lunes, el equipo de modelos revisa la semana anterior: ¿cómo le fue a corrida_02? ¿Lo haría mejor un modelo entrenado con las semanas recientes? Los dos errores posibles tienen costo:
Cambiar sin motivo: el modelo nuevo puede ser peor por azar, y Laura lo descubre con una semana de malas alertas.
No cambiar nunca: si la operación cambia, corrida_02 se queda con lo que aprendió del historial y empieza a fallar.
NotaCampeón y retador
El campeón es el modelo que está en producción; aquí, corrida_02. El retador es un modelo candidato, entrenado con datos más recientes, que se compara con el campeón en las mismas condiciones. El retador solo reemplaza al campeón si le gana según una regla escrita antes de comparar.
Los datos
El equipo tiene seis semanas de 600 envíos, con semillas SEMILLA + 20 a SEMILLA + 25 para las semanas 1 a 6. Dos situaciones se fabrican a propósito:
Semana 3, etiquetas incompletas: el lunes de la revisión, 60 de sus 600 envíos todavía no tienen resultado. Más tarde llegan, y la semana 3 completa sirve para entrenar en revisiones posteriores.
Semanas 5 y 6, temporada alta: el aliado aéreo que mueve el servicio express se satura y los express empiezan a retrasarse. En el generador, el efecto del express pasa de −1.0 a +1.0: un paquete express deja de ser el más puntual y se comporta como uno económico. Es un cambio en la relación entre el servicio y el retraso, como el del capítulo 12: corrida_02 aprendió que express casi nunca llega tarde, y ahora se equivoca justo ahí.
NotaCohorte cerrada
La cohorte de una semana son los envíos de esa semana. Está cerrada cuando ya se conoce el resultado de casi todos: aquí, al menos el 95 %. Medir con una cohorte abierta es injusto, porque los envíos que tardan en confirmarse pueden ser justamente los retrasados.
Las reglas, escritas antes de ejecutar
Regla
Valor
Por qué ese valor
Quién la acordaría
Cierre
Al menos 95 % de etiquetas
Tolera unas pocas confirmaciones atrasadas sin medir sobre una cohorte a medias
Operaciones
Sin fuga
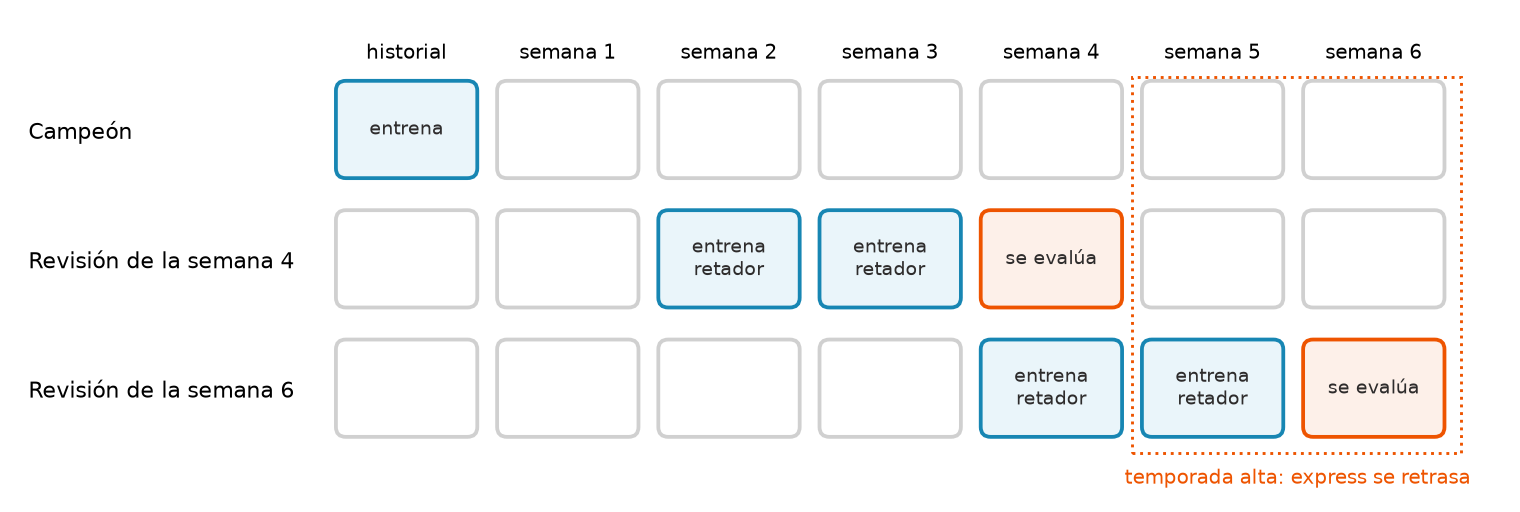
El retador se entrena con las dos semanas anteriores a la evaluada; ninguno de los dos modelos ve la semana evaluada
Medir con datos que el modelo ya vio infla su resultado
Modelos
Misma vara
Campeón y retador se miden sobre las mismas filas, con umbral 0.45
La diferencia de F1 debe deberse al modelo, no a los datos
Monitoreo
Configuración
El retador usa la configuración de corrida_02
Lo único que cambia son los datos de entrenamiento: así se sabe por qué gana o pierde
Modelos
Margen
F1 del retador al menos 0.02 por encima del campeón
Diferencias menores pueden ser azar y no justifican el costo de cambiar
Modelos y operaciones
Sensibilidad
Retador ≥ 0.60
Es el piso de la regla de aceptación del libro
Operaciones
Muestra
Al menos 30 retrasos reales en la semana
Con 10 retrasos, un acierto más mueve la sensibilidad 0.10; con 30, menos de 0.034
Monitoreo
Aprobación
El flujo solo propone; Laura aprueba
Laura sabe si despacho puede absorber una lista distinta
Laura
¿Por qué dos semanas y no todo el historial? Porque la pregunta del lunes es si los datos recientes enseñan algo que el campeón no sabe. Una ventana más larga diluiría la temporada alta entre semanas normales; una de una sola semana tendría pocos retrasos para aprender.
ImportanteLa decisión central del caso
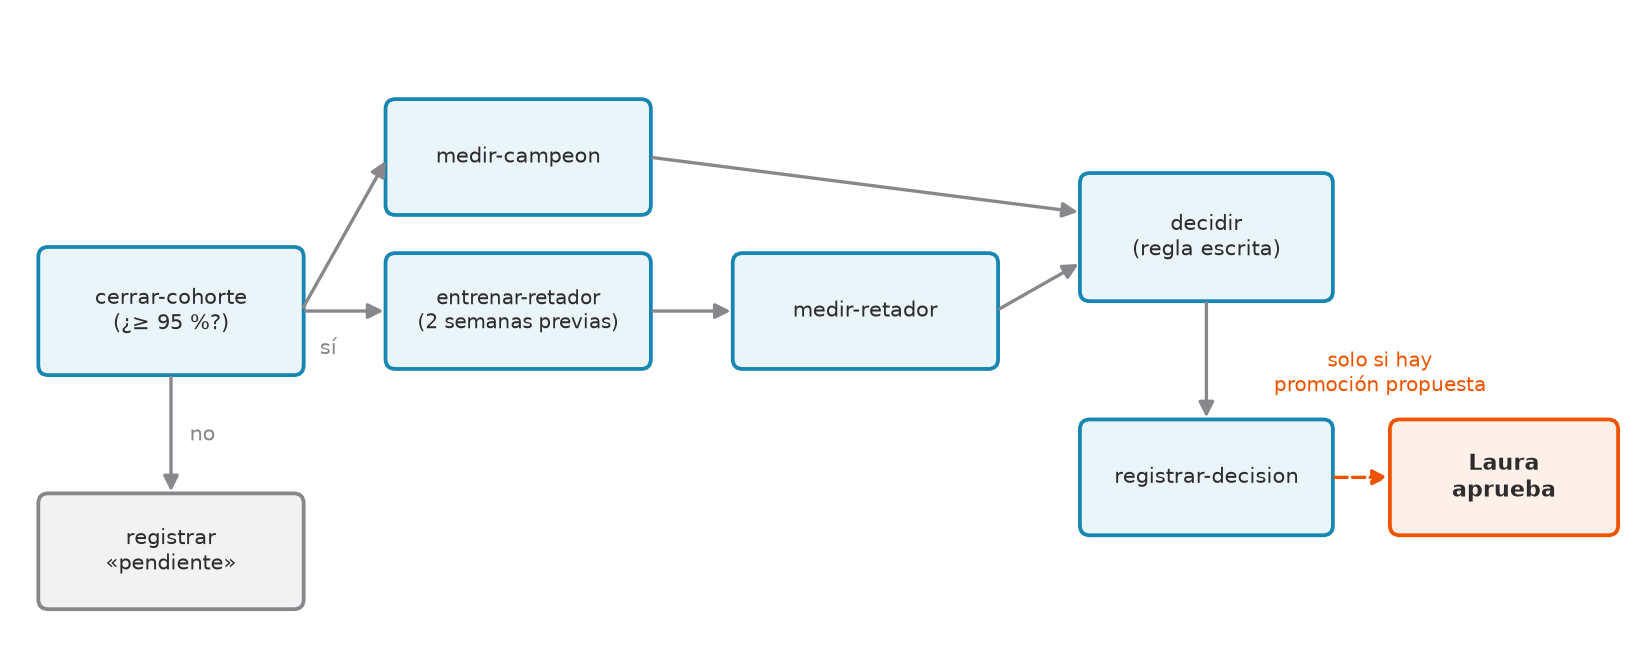
El flujo nunca cambia el modelo en producción. Su salida es un registro con una de tres palabras: pendiente (faltan etiquetas), mantener (el retador no cumplió la regla) o promoción propuesta. El cambio solo ocurre cuando Laura aprueba la propuesta.
El flujo dibujado
El flujo del lunes. Si la cohorte no está cerrada, registra «pendiente» y termina. Si lo está, mide al campeón, entrena y mide al retador, aplica la regla y registra la decisión; una promoción propuesta pasa a Laura.
Qué ve cada modelo. El campeón se entrenó con el historial. Para revisar la semana 4, el retador se entrena con las semanas 2 y 3; para la semana 6, con la 4 y la 5. La semana evaluada nunca entra al entrenamiento.
El código, tarea por tarea
Primero, las seis semanas, la vista incompleta de la semana 3 y el registro de modelos, que empieza con corrida_02 en producción.
# 1. Seis semanas de 600 envíos; desde la 5, temporada alta para el express.semanas = {}for semana inrange(1, 7): efecto =1.0if semana >=5else-1.0# -1.0 es el valor de todo el libro semanas[semana] = generar_envios(600, SEMILLA +19+ semana, efecto_express=efecto)# 2. Lo que el flujo ve el lunes de la semana 3: 60 envíos sin resultado todavía.semana_3_el_lunes = semanas[3].copy()semana_3_el_lunes["llega_tarde"] = semana_3_el_lunes.llega_tarde.astype("Int64") # entero que admite vacíossemana_3_el_lunes.loc[540:, "llega_tarde"] = pd.NA # los últimos 60 todavía no se confirman# 3. El registro de modelos, con el formato del capítulo 8.REGISTRO = ARTEFACTOS /"registro_modelos.json"MODELOS = ARTEFACTOS /"modelos"MODELOS.mkdir()REGISTRO.write_text(json.dumps({"en_produccion": "corrida_02","etapas": {"corrida_02": "en producción"},"historia": [],}, ensure_ascii=False, indent=2), encoding="utf-8")# 4. La temporada alta antes de cualquier modelo: % de express tarde y retrasos por semana.resumen_semanas = pd.DataFrame({"semana": list(semanas),"express_tarde_%": [round(100* tabla[tabla.servicio =="express"].llega_tarde.mean(), 1)for tabla in semanas.values()],"retrasos": [int(tabla.llega_tarde.sum()) for tabla in semanas.values()],})display(resumen_semanas)
semana
express_tarde_%
retrasos
0
1
11.2
151
1
2
15.8
169
2
3
10.7
142
3
4
12.8
169
4
5
47.7
199
5
6
41.4
188
La tabla muestra la temporada alta antes de cualquier modelo: en las semanas 1 a 4, entre el 10.7 % y el 15.8 % de los express llegan tarde; en las semanas 5 y 6, el 47.7 % y el 41.4 %. Los retrasos totales pasan de entre 142 y 169 por semana a 199 y 188. El campeón no sabe nada de esto: aprendió del historial, donde express era el servicio más puntual.
Las tres tareas de medición son cortas. cerrar_cohorte devuelve la cobertura y solo las filas con resultado. medir_modelo aplica el umbral 0.45 y devuelve F1, sensibilidad y número de alertas: este último no entra en la regla, pero Laura lo necesita para saber si despacho puede revisar la nueva lista. entrenar_retador ajusta un pipeline nuevo, con la configuración de corrida_02, solo con las semanas que recibe.
# Las tres tareas de medición del lunes.@task(task_run_name="cerrar-cohorte", cache_policy=NO_CACHE)def cerrar_cohorte(tabla):"""Devuelve la proporción de envíos con resultado y solo esas filas.""" confirmados = tabla.dropna(subset=["llega_tarde"]).copy() # solo envíos con resultado conocido confirmados["llega_tarde"] = confirmados.llega_tarde.astype(int)returnlen(confirmados) /len(tabla), confirmados@task(task_run_name="medir-{nombre}", cache_policy=NO_CACHE)def medir_modelo(nombre, modelo, tabla):"""Mide un modelo con umbral 0.45: F1, sensibilidad y número de alertas.""" X = tabla.drop(columns="llega_tarde") alertas = modelo.predict_proba(X)[:, 1] >= UMBRAL # la misma vara para los dos modelosreturn {"f1": round(float(f1_score(tabla.llega_tarde, alertas)), 6),"sensibilidad": round(float(recall_score(tabla.llega_tarde, alertas)), 6),"alertas": int(alertas.sum())}@task(task_run_name="entrenar-retador", cache_policy=NO_CACHE)def entrenar_retador(historial_reciente):"""Entrena un pipeline nuevo con la configuración de corrida_02 y los datos recibidos.""" modelo = tareas.crear_pipeline().set_params(**CONFIGURACION) X = historial_reciente.drop(columns="llega_tarde")# Escalado e imputación se ajustan aquí, solo con las semanas recibidas.return modelo.fit(X, historial_reciente.llega_tarde)
decidir es la regla de la tabla, traducida a código en el mismo orden. Cada if corresponde a una fila y devuelve el motivo exacto, para que el registro diga por qué se mantuvo el campeón. registrar_decision agrega la semana a la historia del registro; si hay promoción propuesta, guarda el retador en disco y lo anota como «candidato». Además publica en Prefect un resumen corto de la decisión, con las cifras que Laura necesita: es la misma idea de la tabla de cobertura del caso 1.
# La regla escrita antes de medir (tabla «Las reglas, escritas antes de ejecutar»).MARGEN_F1 =0.02# ventaja mínima de F1 del retador sobre el campeónSENSIBILIDAD_MINIMA =0.60# piso de la regla de aceptación del libroRETRASOS_MINIMOS =30# muestra mínima para que las métricas no dependan de pocos casos@task(task_run_name="decidir", cache_policy=NO_CACHE)def decidir(retrasos, campeon_mide, retador_mide):"""Aplica la regla escrita y devuelve (decisión, motivo). No cambia ningún modelo."""# Cada if es una fila de la regla; el primero que no se cumple da el motivo.if retrasos < RETRASOS_MINIMOS:return"mantener", f"solo {retrasos} retrasos; la regla pide {RETRASOS_MINIMOS}" ventaja = retador_mide["f1"] - campeon_mide["f1"]if ventaja < MARGEN_F1:return"mantener", f"ventaja de F1 {ventaja:.4f}, menor que {MARGEN_F1}"if retador_mide["sensibilidad"] < SENSIBILIDAD_MINIMA:return"mantener", f"sensibilidad del retador menor que {SENSIBILIDAD_MINIMA}"return"promoción propuesta", f"ventaja de F1 {ventaja:.4f} y sensibilidad suficiente"@task(task_run_name="registrar-decision", cache_policy=NO_CACHE)def registrar_decision(fila, retador=None):"""Agrega la decisión de la semana al registro; guarda el retador si se propone.""" registro = json.loads(REGISTRO.read_text(encoding="utf-8"))if fila["decision"] =="promoción propuesta": nombre = fila["retador"] joblib.dump(retador, MODELOS /f"{nombre}.joblib") registro["etapas"][nombre] ="candidato"# todavía no está en producción registro["historia"].append(fila) REGISTRO.write_text(json.dumps(registro, ensure_ascii=False, indent=2), encoding="utf-8")# Un resumen legible en la interfaz de Prefect, para quien revisa los lunes. texto = [f"## Semana {fila['semana']}: {fila['decision']}", "",f"- Cobertura de etiquetas: {100* fila['cobertura']:.0f} %",f"- Retrasos confirmados: {fila['retrasos']}",f"- Motivo: {fila['motivo']}"]if fila.get("campeon"): texto.append(f"- F1 campeón: {fila['campeon']['f1']} · F1 retador: {fila['retador_mide']['f1']}") texto.append(f"- Alertas campeón: {fila['campeon']['alertas']} · "f"alertas retador: {fila['retador_mide']['alertas']}") create_markdown_artifact(markdown="\n".join(texto), key="decision-del-lunes", description=f"Revisión de la semana {fila['semana']}")return fila
El flujo une las piezas. La primera pregunta es si la cohorte está cerrada; si no, registra «pendiente» y termina sin entrenar ni medir nada. Si está cerrada, mide al campeón, entrena al retador con las dos semanas anteriores, lo mide sobre las mismas filas y aplica la regla.
@flow(name="revision-del-lunes")def revision_del_lunes(semana, tabla, modelo_en_produccion):"""Revisa una semana: registra pendiente, o compara campeón y retador y decide."""# 1. ¿Hay suficientes etiquetas? cobertura, confirmados = cerrar_cohorte(tabla) fila = {"semana": semana, "cobertura": round(cobertura, 4),"retrasos": int(confirmados.llega_tarde.sum()), "retador": None}if cobertura <0.95: fila.update(decision="pendiente", motivo=f"cobertura {100* cobertura:.0f} %, la regla pide 95 %")return registrar_decision(fila)# 2. Campeón y retador, sobre las mismas filas; el retador no ve la semana evaluada. anteriores = [semana -2, semana -1] historial_reciente = pd.concat([semanas[numero] for numero in anteriores], ignore_index=True) retador = entrenar_retador(historial_reciente) campeon_mide = medir_modelo("campeon", modelo_en_produccion, confirmados) retador_mide = medir_modelo("retador", retador, confirmados)# 3. La regla escrita decide; el registro guarda la evidencia. decision, motivo = decidir(fila["retrasos"], campeon_mide, retador_mide) fila.update(retador=f"retador_semana_{semana:02d}", entrenado_con=anteriores, campeon=campeon_mide, retador_mide=retador_mide, decision=decision, motivo=motivo)return registrar_decision(fila, retador)def mostrar_revision(semana):"""Muestra la última decisión registrada para una semana y la devuelve.""" registro = json.loads(REGISTRO.read_text(encoding="utf-8")) fila = [f for f in registro["historia"] if f["semana"] == semana][-1] # la última, si hubo variasfor clave, valor in fila.items():print(f"{clave:>14}: {valor}")return fila
Tres lunes
Semana 3, con etiquetas incompletas.
# Semana 3: el lunes faltan 60 resultados.logging.disable(logging.CRITICAL) # sin mensajes de Prefect en las revisioneslunes_3 = revision_del_lunes(3, semana_3_el_lunes, campeon, return_state=True)logging.disable(logging.NOTSET)revision_3 = mostrar_revision(3)
El lunes de la semana 3, el flujo encuentra 540 de 600 resultados: cobertura del 90 %, por debajo del 95 %. Registra pendiente y termina. Ya hay 129 retrasos confirmados, pero el flujo no los usa: si los 60 que faltan fueran justamente envíos atrasados, cualquier métrica calculada hoy estaría sesgada. La semana se podrá revisar cuando lleguen esas etiquetas.
Semana 4, una semana normal. El retador aprende de las semanas 2 y 3, esta última ya completa.
# Semana 4: semana normal; el retador aprende de las semanas 2 y 3.logging.disable(logging.CRITICAL)lunes_4 = revision_del_lunes(4, semanas[4], campeon, return_state=True)logging.disable(logging.NOTSET)revision_4 = mostrar_revision(4)
        semana: 4
     cobertura: 1.0
      retrasos: 169
       retador: retador_semana_04
 entrenado_con: [2, 3]
       campeon: {'f1': 0.521158, 'sensibilidad': 0.692308, 'alertas': 280}
  retador_mide: {'f1': 0.539749, 'sensibilidad': 0.763314, 'alertas': 309}
      decision: mantener
        motivo: ventaja de F1 0.0186, menor que 0.02
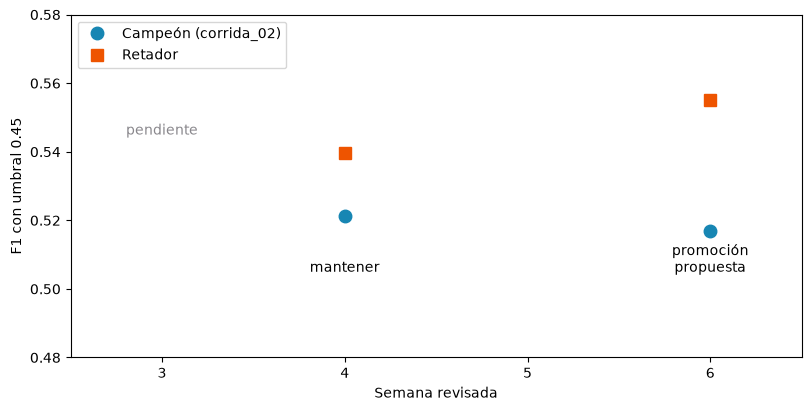
Sobre los mismos 600 envíos y 169 retrasos, el campeón obtiene F1 0.521158 y el retador 0.539749. La ventaja es 0.0186, apenas por debajo del margen de 0.02, así que la decisión es mantener. Es un buen ejemplo de por qué existe el margen: el retador se entrenó con 1 200 envíos y el campeón con 450, y parte de esa pequeña ventaja puede venir solo de tener más datos, no de que la operación haya cambiado. Cambiar de modelo por 0.0186 sería pagar el costo de un cambio sin una razón clara.
Semana 6, temporada alta. El retador aprende de las semanas 4 y 5; la 5 ya trae el express saturado.
# Semana 6: temporada alta; el retador aprende de las semanas 4 y 5.logging.disable(logging.CRITICAL)lunes_6 = revision_del_lunes(6, semanas[6], campeon, return_state=True)logging.disable(logging.NOTSET)revision_6 = mostrar_revision(6)
Ahora la historia es otra. En la semana 6 hay 188 retrasos. El campeón obtiene F1 0.516949 y su sensibilidad baja a 0.648936 (era 0.692308 en la semana 4): se le escapan los express que ahora llegan tarde. El retador, que vio la semana 5, obtiene F1 0.555102 y sensibilidad 0.723404. La ventaja de 0.0382 supera el margen, la sensibilidad supera 0.60 y hay más de 30 retrasos: promoción propuesta. El retador quedó guardado y anotado como candidato, pero corrida_02 sigue en producción.
La aprobación de Laura
Antes de aprobar, Laura revisa lo que la regla no mide: cuánto trabajo le cambia a despacho. El retador marca 302 envíos en la semana frente a 284 del campeón, 18 más, unos 3 por día entre las tres sedes. Laura lo considera manejable y aprueba. La aprobación no es una tarea de Prefect: es una persona que firma una decisión, y la función solo la deja escrita en el registro.
def aprobar_promocion(semana, aprobada_por, nota):"""Pasa a producción el candidato de una semana. La llama una persona, no el flujo.""" registro = json.loads(REGISTRO.read_text(encoding="utf-8"))# 1. Busca la propuesta de esa semana en el registro. propuesta = [f for f in registro["historia"]if f["semana"] == semana and f["decision"] =="promoción propuesta"][-1]# 2. Cambia las etapas: el campeón se retira y el candidato pasa a producción. anterior = registro["en_produccion"] nuevo = propuesta["retador"] registro["etapas"][anterior] ="retirado"# se conserva, por si hay que volver registro["etapas"][nuevo] ="en producción" registro["en_produccion"] = nuevo# 3. La aprobación queda en la historia: quién, por qué y qué cambió. registro["historia"].append({"semana": semana, "decision": "promoción aprobada","aprobada_por": aprobada_por, "nota": nota,"anterior": anterior, "nuevo": nuevo}) REGISTRO.write_text(json.dumps(registro, ensure_ascii=False, indent=2), encoding="utf-8")return registro# Laura revisó la decisión publicada de la semana 6 y aprueba.registro_final = aprobar_promocion(6, "Laura (operaciones)","18 alertas más por semana; despacho puede absorberlas en temporada alta")print("En producción:", registro_final["en_produccion"])print("Etapas:", registro_final["etapas"])print("Decisiones registradas:", [(f["semana"], f["decision"]) for f in registro_final["historia"]])
El registro cuenta la historia completa: retador_semana_06 está en producción, corrida_02 queda retirado (no borrado: si la temporada alta termina y el nuevo modelo falla, se puede volver a él, como en la reversión del capítulo 11) y la historia guarda las cuatro decisiones en orden: semana 3 pendiente, semana 4 mantener, semana 6 promoción propuesta y semana 6 promoción aprobada, con quién la aprobó y por qué.
Lo que vio el equipo
Las tres corridas en la base de Prefect, con las tareas que se crearon en cada una:
# Una fila por lunes y una columna por tarea; las que no existieron se marcan «no se creó».lunes = {"semana 3": lunes_3, "semana 4": lunes_4, "semana 6": lunes_6}historia_lunes = historial_prefect(lunes)orden = ["cerrar-cohorte", "entrenar-retador", "medir-campeon", "medir-retador","decidir", "registrar-decision"]display(historia_lunes.pivot(index="corrida", columns="tarea", values="estado") .reindex(index=list(lunes), columns=orden).fillna("no se creó"))
tarea
cerrar-cohorte
entrenar-retador
medir-campeon
medir-retador
decidir
registrar-decision
corrida
semana 3
Completed
no se creó
no se creó
no se creó
no se creó
Completed
semana 4
Completed
Completed
Completed
Completed
Completed
Completed
semana 6
Completed
Completed
Completed
Completed
Completed
Completed
En la semana 3 solo existen cerrar-cohorte y registrar-decision: las tareas de entrenamiento y medición «no se crearon», porque el flujo terminó antes de llegar a ellas. Es lo esperado: una semana pendiente no es un fallo, es un resultado. En las semanas 4 y 6 se crearon las seis tareas y todas terminaron en Completed; la diferencia entre mantener y proponer está en los números, no en los estados.
La gráfica pone lado a lado al campeón y al retador en las dos semanas que se pudieron medir.
# F1 de los dos modelos en las semanas que se pudieron medir (4 y 6).medidas = pd.DataFrame([{"semana": f["semana"], "campeon": f["campeon"]["f1"],"retador": f["retador_mide"]["f1"]}for f in [revision_4, revision_6]])figura, eje = plt.subplots(figsize=(8, 4), layout="constrained")# Solo marcadores: la semana 5 no se revisó y no hay nada que unir entre la 4 y la 6.eje.plot(medidas.semana, medidas.campeon, "o", markersize=9, color="#1786B3", label="Campeón (corrida_02)")eje.plot(medidas.semana, medidas.retador, "s", markersize=9, color="#EE5400", label="Retador")# Etiquetas con la decisión de cada lunes.eje.text(3, 0.545, "pendiente", ha="center", color="#89878C")eje.text(4, 0.505, "mantener", ha="center")eje.text(6, 0.505, "promoción\npropuesta", ha="center")eje.set(xlabel="Semana revisada", ylabel="F1 con umbral 0.45", xticks=[3, 4, 5, 6], xlim=(2.5, 6.5), ylim=(0.48, 0.58))eje.legend(loc="upper left")plt.show()
F1 del campeón y del retador en las semanas revisadas
En la semana 4 los dos puntos están a 0.0186 de distancia; en la semana 6, a 0.0382: el campeón baja un poco y el retador sube. La semana 5 no tiene punto porque en esta práctica no se revisó: su papel es servir de entrenamiento para la revisión de la semana 6.
Los tres lunes en la interfaz de Prefect
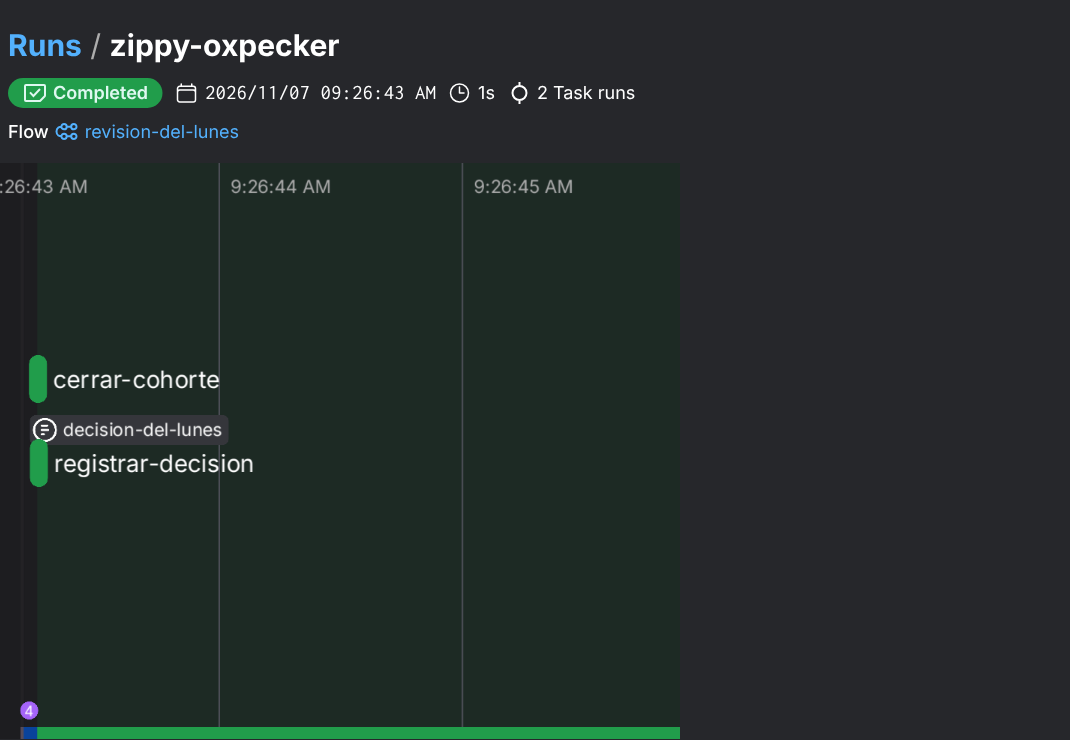
La revisión de la semana 3 (zippy-oxpecker): solo corrieron cerrar-cohorte y registrar-decision.
Un grafo con dos tareas es una buena noticia. Al cerrar la cohorte, el flujo vio que solo había 90 % de etiquetas y fue directo a registrar «pendiente». No midió al campeón ni entrenó un retador con datos incompletos, y la interfaz lo deja a la vista: lo que no se ejecutó, no aparece.
La revisión de la semana 6 (loyal-mosquito): las seis tareas del flujo completo.
Ahora sí está el camino largo: cerrar la cohorte, entrenar el retador, medir a los dos modelos sobre la misma semana, decidir y registrar. Las flechas cruzan porque medir al campeón y entrenar al retador no dependen entre sí; decidir espera a las dos mediciones.
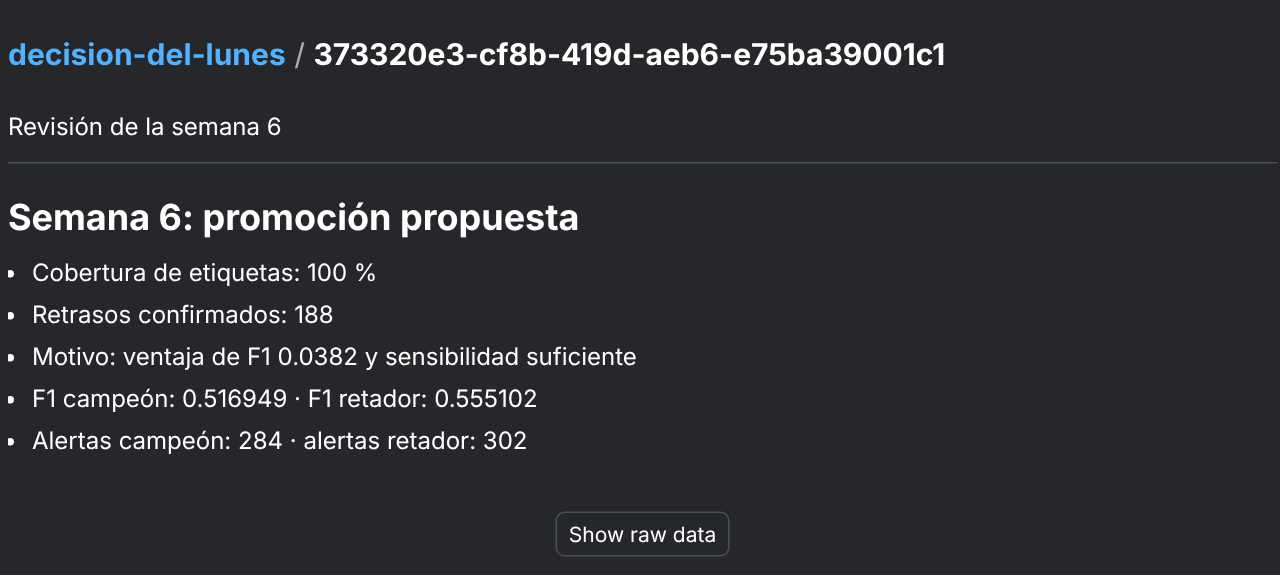
El artefacto decision-del-lunes publicado por la semana 6: la decisión, el motivo y las cifras que Laura necesita para aprobar.
Este es el documento que Laura lee el lunes antes de llamar a aprobar_promocion. Las cifras son las de la tabla de arriba: F1 de 0.516949 contra 0.555102, y 18 alertas más en la semana (302 frente a 284). La propuesta queda escrita en el mismo lugar donde quedó la corrida que la produjo, así que dentro de un mes cualquiera puede saber por qué retador_semana_06 llegó a producción.
Por qué se decidió así
Decisión
Alternativa descartada
Por qué
Registrar «pendiente» con menos de 95 % de etiquetas
Medir con lo que haya
Las etiquetas que tardan pueden ser justamente los retrasos
Entrenar al retador solo con semanas anteriores
Incluir la semana evaluada
Un modelo que ya vio la semana parece mejor de lo que es
Misma configuración que corrida_02
Una búsqueda en grilla nueva cada lunes
Si el retador gana, se sabe que es por los datos recientes
Margen de 0.02 en F1
Cambiar si el retador es mejor por poco
La semana 4 muestra que una ventaja pequeña puede venir solo de tener más datos
El flujo propone, Laura aprueba
Promover automáticamente
La regla no mide la carga de despacho; Laura sí
El campeón anterior se retira, no se borra
Reemplazarlo
Si el nuevo falla, se puede volver atrás
Un límite que conviene decir en voz alta: una semana de 600 envíos es una muestra pequeña. La regla de 30 retrasos y el margen de 0.02 reducen el riesgo de decidir por azar, pero no lo eliminan; con más semanas de temporada alta, el equipo podría confirmar que la ventaja se sostiene antes de aprobar.
4) Lo que ganó Laura con una herramienta de orquestación
Los dos casos se podrían haber escrito con el motor casero del capítulo 7. La tabla resume lo que Prefect resolvió sin código adicional, con el lugar del anexo donde lo viste:
Necesidad de la operación
Con el motor del capítulo 7
Con Prefect
Dónde lo viste
Esperar un archivo que llega tarde
Un bucle de intentos escrito a mano
retries, retry_delay_seconds y una condición de una función
Noche 2: esperar-cali con 2 intentos
Que el fallo de una sede no detenga el turno
Capturar excepciones en cada paso
submit, wait y el estado de cada futuro
Noche 3: validar-medellin en rojo y el turno completo
Saber qué pasó en cada corrida
Leer un archivo de eventos
Historia consultable: estado, intentos y duración de cada tarea
La lista de corridas y los grafos
Mostrarle el resultado a quien decide
Enviar un archivo aparte
Tablas y textos publicados junto a la corrida
La cobertura del turno y la decisión del lunes
Ver qué tareas no llegaron a ejecutarse
Deducirlo de lo que falta en los registros
El grafo muestra solo las tareas que existieron
El lunes de la semana 3
Programar el turno de las 5:45 y la revisión del lunes
Un programador externo
serve(cron=...), como en el anexo C
Ejercicio 6
La lógica de negocio (las reglas de validación, la cobertura, la regla de promoción) sigue siendo tuya en los dos casos. Lo que cambia es todo lo que rodea esa lógica: con la herramienta, el equipo deja de mantener código de reintentos, bitácoras y reportes, y gana una vista común de la operación.
5) Lo que tienen en común los dos casos
Pregunta
Caso 1: la lista de las 6:00
Caso 2: el lunes de Laura
¿Qué se espera?
Un archivo que todavía no llega
Etiquetas que todavía no se confirman
¿Qué se reintenta?
Solo la lectura, si falta el archivo
Nada: se registra «pendiente» y se vuelve a revisar después
¿Qué se detiene?
La sede con errores, no el turno
El entrenamiento y la medición, si la cohorte está abierta
¿Qué decide una persona?
Corregir el archivo y relanzar
Aprobar o no la promoción
¿Qué queda escrito?
Lista con cobertura, cuarentena con motivo
Registro de modelos con cada decisión y quién la tomó
En los dos casos, el flujo hace el trabajo repetitivo y deja la evidencia ordenada; las decisiones que cambian la operación quedan en manos de quien responde por ellas.
Ninguna de estas decisiones depende de Prefect. Esperar lo que no ha llegado, reintentar solo lo que se arregla esperando, aislar la rama que falla, publicar una sola vez por fecha, detenerse cuando faltan datos y dejar la aprobación a una persona son decisiones de diseño que existen en cualquier orquestador. En Airflow o Dagster cambian las piezas con que se escriben, no las decisiones. El anexo C presenta esas herramientas y cuándo conviene cada una.
Errores frecuentes
Lo que ves
Qué pasó
Cómo se arregla
Una sede con 0 alertas que en realidad no se procesó
Se leyó la lista sin mirar la cobertura
Publicar alertas y cobertura en el mismo documento
El flujo tarda mucho y al final igual falla
Se reintenta un error que no se arregla esperando
Condición de reintento solo para FileNotFoundError
La sede corrige un error y al reenviar aparece otro
La validación se detuvo en el primer motivo
Acumular todos los motivos antes de rechazar
Dos listas para la misma fecha
Cada ejecución escribe un archivo nuevo
Un nombre por fecha y replace sobre un temporal
El fallo de una sede detiene el turno entero
Las tareas se llamaron directamente
submit, wait y revisar el estado de cada rama
El retador gana por mucho y luego decepciona
Se entrenó con la semana que se evalúa
Entrenar solo con semanas anteriores
Las métricas del lunes cambian el martes
Se midió con la cohorte abierta
Esperar el 95 % de etiquetas y registrar «pendiente»
500 Internal Server Error de Prefect en WSL
La base de Prefect quedó en /mnt/...
PREFECT_HOME en la carpeta de usuario de Linux
Lista de verificación
Ejercicios
Los ejercicios son sabotajes: cada uno rompe algo de los casos para ver cómo responde el diseño.
Cali no llega nunca. Prepara una noche en la que el archivo de Cali no exista ni con nombre provisional. ¿Cuántos intentos hace esperar-cali, qué dice la cobertura y en qué estado queda la lista?
Un relanzamiento sin ninguna sede válida. Relanza la fecha 2026-10-29 con las tres sedes dañadas. ¿Qué queda en artefactos/listas/? Propón un cambio para que despacho no confunda esa lista con una vigente.
Una distancia negativa. Cambia una distancia de Bogotá a −40 km. ¿Qué motivo aparece y qué pasa con Medellín y Cali?
Una regla más exigente. Sube el margen a 0.05 y vuelve a correr la semana 6. ¿Qué decide el flujo? ¿Es correcto cambiar la regla después de ver el resultado?
Un retador con trampa. Entrena el retador de la semana 6 con las semanas 5 y 6. ¿Cómo cambia su F1? Explica por qué esa cifra no sirve para decidir.
Programar los dos flujos. Copia lista_del_turno y revision_del_lunes, con sus tareas, a un archivo operacion.py y prográmalos con serve: el turno todos los días a las 5:45 y la revisión los lunes a las 7:00. Revisa en la interfaz cómo aparecen.
TipOrientaciones
esperar-cali hace 3 intentos (el original y 2 reintentos) y termina Failed; la condición de reintento autoriza los tres porque el error es FileNotFoundError. La cobertura dice «sin archivo» para Cali y la lista se publica incompleta con Bogotá y Medellín.
El flujo no publica nada porque no hay sedes válidas, y la lista anterior del 29 sigue en disco. Una solución es publicar siempre un documento de la fecha, aunque sea con cero sedes y estado «sin datos», o guardar la hora de cada intento para que despacho vea que la lista es vieja.
Bogotá queda en cuarentena con el motivo «distancia vacía, no numérica o no positiva». Medellín y Cali siguen su camino y la lista sale incompleta: es exactamente para esto que cada sede tiene su rama.
Con margen 0.05, la ventaja de 0.0382 ya no alcanza y la decisión es mantener. Cambiar la regla después de ver los números es una forma de fuga: la regla se ajustaría al resultado que alguien quería. Si el equipo cree que el margen es otro, lo acuerda y lo aplica desde la semana siguiente.
El F1 sube de 0.555 a 0.584, porque el retador ya vio los envíos con los que se le mide. Es la misma trampa del maleficio del ganador del capítulo 6: esa cifra mide memoria, no capacidad de anticipar la semana siguiente.
Al final del archivo, crea un despliegue por flujo y sírvelos juntos: prefect.serve(lista_del_turno.to_deployment(name="turno", cron="45 5 * * *", parameters=...), revision_del_lunes.to_deployment(name="lunes", cron="0 7 * * 1", parameters=...)). Los parámetros (la fecha, la tabla de la semana) saldrían de la fecha de la corrida en una versión real. En la página de despliegues aparecen los dos, con su calendario; es la sección 6.6 del anexo C aplicada a estos casos.
Glosario
Cobertura (de una lista): qué sedes incluye una lista publicada, cuántos envíos aporta cada una y por qué faltó alguna.
Cuarentena: carpeta donde se guarda, sin modificar, un archivo rechazado junto con su motivo.
Futuro: objeto que devuelve tarea.submit(...) y representa una tarea en curso; permite esperar y revisar su estado sin detener el flujo.
Campeón: el modelo que está en producción.
Retador: modelo candidato, entrenado con datos recientes, que se compara con el campeón.
Cohorte cerrada: semana de envíos con al menos el 95 % de los resultados confirmados.
Promoción propuesta: salida del flujo cuando el retador cumple la regla; no cambia el modelo hasta que alguien la aprueba.
Retirado: etapa de un modelo que dejó producción y se conserva por si hay que volver a él.
NotaAlcance de los casos
Los datos son sintéticos, la llegada tardía de Cali se simula con un cambio de nombre y todo corre en un solo equipo con archivos locales. Los reintentos duran segundos para que la práctica sea rápida; en producción serían minutos y se acordarían con las sedes. El caso 2 revisa tres semanas con muestras de 600 envíos: suficiente para mostrar el mecanismo, no para afirmar que el retador será mejor durante toda la temporada alta. Las reglas (20 % de pesos vacíos, 95 % de etiquetas, margen de 0.02, 30 retrasos) son valores razonados para la práctica, que una empresa real acordaría con sus equipos.
Cómo limpiar la práctica
Cierra el kernel para que se apague el servidor temporal de Prefect. Luego puedes borrar las dos carpetas que crea el anexo:
rm-rf artefactos ~/.prefect-anexo-casos
Si vuelves a ejecutar el notebook desde el principio, las dos se crean de nuevo con los mismos datos.
Qué aprendiste
Un flujo con una rama por fuente sigue funcionando aunque una fuente falle, y la cobertura dice qué se publicó y qué no.
Se reintenta lo que puede arreglarse esperando; lo que tiene errores se pone en cuarentena con todos sus motivos.
Un nombre por fecha y un reemplazo de una sola vez permiten relanzar sin duplicar.
submit, wait y el estado de cada futuro dejan que el flujo decida qué hacer cuando una tarea falla.
Comparar campeón y retador exige cohorte cerrada, las mismas filas y un retador que nunca vio la semana evaluada.
La regla de cambio se escribe antes de medir; en la semana 4 dijo mantener (ventaja 0.0186) y en la 6, con la temporada alta, propuso la promoción (ventaja 0.0382).
El flujo propone y una persona aprueba; el registro guarda las dos cosas.
El registro de modelos de este anexo es una versión mínima del que construye el capítulo 8, donde cada corrida queda identificada por sus datos, su código y su huella, y la promoción a producción sigue reglas como las que usaste aquí.
Taller: tu propio flujo orquestado con Prefect
Los dos casos de este anexo siguieron el mismo recorrido: un proceso que se repite y alguien que depende de él, un acuerdo sobre lo que deben cumplir los datos, un flujo que reintenta lo que puede esperar y aparta lo que llega dañado, una salida que se puede relanzar sin duplicar y una interfaz donde se ve qué pasó en cada corrida. El taller entregable propone hacer ese recorrido con un proceso propio: escoges datos reales que se puedan partir en lotes, diseñas el flujo, lo construyes en Prefect y lo pones a prueba con un archivo que llega tarde, un lote dañado y un relanzamiento, dejando como evidencia las capturas de tus propias corridas.