En noviembre de 2021 Zillow anunció el cierre gradual de Zillow Offers. Su informe trimestral registró una depreciación de inventario de 304,4 millones de dólares en el tercer trimestre y anticipó una reducción de aproximadamente el 25 % de la plantilla. La compañía describió dificultades para prever precios y riesgos operativos. Informe trimestral de Zillow.
El caso permite plantear una pregunta de evaluación: ¿qué ocurre si las condiciones futuras difieren de las observadas? El documento público no permite atribuir todo el desenlace a una partición incorrecta ni concluir que un bootstrap lo habría evitado. Para precios que cambian en el tiempo se necesita una evaluación que respete ese orden, como verás en el capítulo de series temporales.
Tiempo estimado de lectura: 55 minutos (unas 2 horas si ejecutas el código y respondes las preguntas)
Tecnologías mencionadas: Python 3.13, NumPy, pandas, Matplotlib, scikit-learn y statsmodels.
Los datos son el conjunto Diabetes de 442 pacientes usado por Efron, Hastie, Johnstone y Tibshirani (2004), cargado desde scikit-learn, cuya distribución se publica bajo BSD de tres cláusulas; el capítulo usa su API y no redistribuye un archivo independiente. El ejemplo pequeño del bootstrap es una lista de ocho números escrita a mano. Todo corre en CPU, con una semilla central, y las versiones se imprimen en la primera celda de código.
En este capítulo usas los datos de 442 pacientes para separar tres preguntas: cuánto error tiene un modelo en observaciones reservadas, cuánto cambian las métricas al cambiar la partición y cómo aproximar la incertidumbre de un coeficiente mediante remuestreo. La validación mide la predicción fuera de muestra, y el bootstrap remuestrea observaciones para estudiar un estadístico definido de antemano. Cada procedimiento responde una pregunta distinta, y su dispersión la interpretas dentro del diseño que la produjo.
Objetivos
Al terminar este capítulo vas a ser capaz de:
comparar el error de un modelo en entrenamiento y en una prueba independiente, y explicar qué dice y qué no dice esa brecha sobre el sobreajuste;
calcular e interpretar MAE, MSE, RMSE y \(R^2\), reconociendo qué pregunta responde cada uno;
aplicar validación cruzada k-fold para estimar el desempeño sin depender de una sola partición y comparar modelos con los mismos bloques;
encapsular el preprocesamiento en un Pipeline para evitar la fuga de datos;
implementar el bootstrap (remuestreo con reemplazo) para aproximar la distribución de un estadístico;
construir un intervalo percentil para un coeficiente y contrastarlo con el intervalo analítico de OLS y con el robusto HC3.
Ejecuta las celdas en orden: las secciones comparten variables y generadores.
18.1 Preparación del entorno
Primero, las librerías que vas a usar y una semilla fija para que los resultados sean reproducibles.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.datasets import load_diabetesfrom sklearn.linear_model import LinearRegression, Ridge, Lassofrom sklearn.model_selection import train_test_split, KFold, cross_val_scorefrom sklearn.metrics import mean_absolute_error, mean_squared_error, r2_scoreimport statsmodels.api as smSEMILLA =2026rng = np.random.default_rng(SEMILLA)# Dataset de diabetes: viene incluido en scikit-learn (no requiere internet)datos = load_diabetes(as_frame=True)X = datos.datay = datos.targetprint('Observaciones:', X.shape[0], '| Variables:', X.shape[1])X.head()# Generadores configurados una sola vez para cada experimento de remuestreo.rng_oob = np.random.default_rng(SEMILLA)rng_coef = np.random.default_rng(SEMILLA +1)from sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerX_cruda = load_diabetes(as_frame=True, scaled=False).data# Versiones del entorno usado para ejecutar este capítulo.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'statsmodels']:print(paquete +':', metadatos.version(paquete))import matplotlib.pyplot as pltfrom cycler import cyclerplt.rcParams['axes.prop_cycle'] = cycler(color=['#1786B3', '#EE5400', '#487A35', '#7851A9']) + cycler(linestyle=['-', '--', '-.', ':'])plt.rcParams['font.size'] =10
El entorno queda con Python 3.13.14, NumPy 2.5.1, pandas 3.0.5, scikit-learn 1.9.0 y statsmodels 0.14.6, y el conjunto tiene 442 observaciones y 10 variables (edad, sexo, IMC, presión arterial y seis marcadores de sangre).
Las columnas no muestran valores clínicos como 25 de IMC o 120 de presión, porque scikit-learn entrega estas variables centradas y escaladas: a cada columna le resta su promedio sobre los 442 pacientes y la divide por su desviación estándar multiplicada por \(\sqrt{n}\), de modo que cada columna tiene media 0 y norma euclídea 1 (su desviación estándar es ≈ 0.048, no 1). Incluso el sexo, que es binario, aparece codificado con dos valores (0.051 y −0.045). La respuesta sí conserva su escala original: una medida cuantitativa de la progresión de la enfermedad un año después de la medición inicial.
18.2 El error de entrenamiento engaña
El error más común al evaluar un modelo es medirlo sobre los mismos datos con los que se entrenó. Como el modelo ya vio esos datos, su desempeño ahí es optimista. Compara el error medido en entrenamiento contra el medido en datos que el modelo no usó para aprender.
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=SEMILLA)modelo_2 = LinearRegression().fit(X_tr, y_tr)# El mismo modelo, medido en los datos que vio y en los que no vior2_entrenamiento = r2_score(y_tr, modelo_2.predict(X_tr))r2_prueba = r2_score(y_te, modelo_2.predict(X_te))print(f'R2 medido en entrenamiento (optimista): {r2_entrenamiento:.3f}')print(f'R2 medido en datos nuevos (honesto): {r2_prueba:.3f}')
R2 medido en entrenamiento (optimista): 0.513
R2 medido en datos nuevos (honesto):    0.513
El \(R^2\) de entrenamiento y de prueba coincide a tres decimales: 0.513. En esta partición no aparece una brecha apreciable, pero eso no demuestra ausencia de sobreajuste. El modelo se ajustó con 309 pacientes y se evaluó con 133; cambiar esos grupos también cambia el resultado.
Informa la prueba como evaluación de esta partición y acompáñala con el tamaño de muestra y las métricas en unidades del objetivo. Una brecha grande motivaría revisar complejidad, representatividad y preprocesamiento, sin atribuirla automáticamente a una sola causa.
18.3 Métricas de regresión: MAE, MSE, RMSE y R²
Para regresión, estas son las cuatro métricas que vas a usar todo el tiempo. Sea \(y_i\) el valor real de la observación \(i\), \(\hat{y}_i\) el valor predicho por el modelo, \(\bar{y}\) el promedio de los valores reales, y \(n\) el número de observaciones:
MAE (Error Absoluto Medio): promedio de los errores en valor absoluto, en las mismas unidades que la variable objetivo.
MSE (Error Cuadrático Medio): promedio de los errores al cuadrado; castiga más los errores grandes, pero queda en unidades al cuadrado.
RMSE (Raíz del MSE): vuelve a las unidades originales; es el más reportado.
R²: la fracción de la variabilidad total (\(SS_{tot}\)) que el modelo logra explicar y no deja como error residual (\(SS_{res}\)). 1 es perfecto, 0 equivale a predecir siempre la media \(\bar{y}\).
Métrica       Valor
    MAE   42.258535
    MSE 2804.920028
   RMSE   52.961496
     R2    0.512744
El MAE de 42.3 y el RMSE de 53.0 están en unidades del índice de progresión. El segundo da más peso a errores grandes. Su cociente, aproximadamente 1.25, no demuestra normalidad ni descarta casos extremos: examina también los residuos.
El MSE de 2804.9 está en unidades al cuadrado y sirve como criterio de optimización. El \(R^2\) de 0.513 compara los errores con la variación del objetivo en esta prueba. Ninguna de estas cifras establece por sí sola utilidad clínica: necesitarías definir la decisión, el costo del error y una evaluación apropiada para su uso.
18.4 Una sola partición entrenamiento/prueba no basta
Dividir en entrenamiento y prueba es lo mínimo, pero tiene una debilidad: el resultado depende de qué filas cayeron en cada lado. Repite la partición con distintas semillas y observa cuánto se mueve el R².
r2_por_particion = []for semilla inrange(30): Xa, Xb, ya, yb = train_test_split(X, y, test_size=0.3, random_state=semilla) m = LinearRegression().fit(Xa, ya) r2_por_particion.append(r2_score(yb, m.predict(Xb)))r2_por_particion = np.array(r2_por_particion)print(f'R2 mínimo: {r2_por_particion.min():.3f}')print(f'R2 máximo: {r2_por_particion.max():.3f}')print(f'R2 promedio: {r2_por_particion.mean():.3f} (desviación {r2_por_particion.std():.3f})')
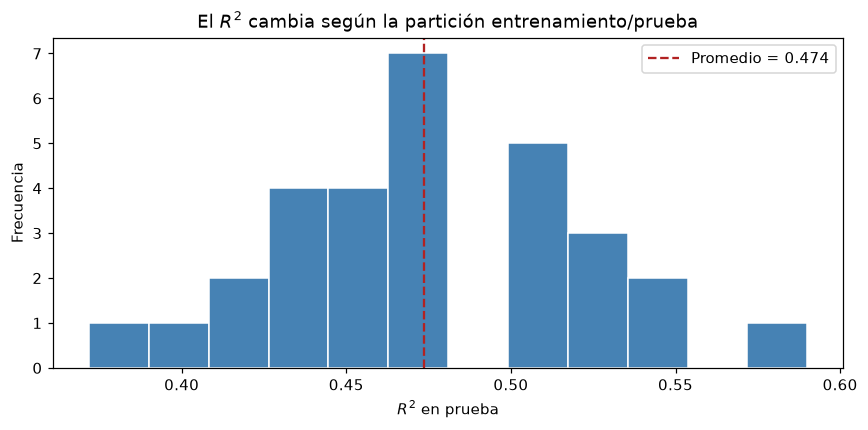
Los 30 valores de r2_por_particion se dibujan en un histograma. La línea vertical señala su media y permite localizar la puntuación de la primera partición.
plt.figure(figsize=(8, 4))plt.hist(r2_por_particion, bins=12, color='steelblue', edgecolor='white')plt.axvline(r2_por_particion.mean(), color='firebrick', linestyle='--', label=f'Promedio = {r2_por_particion.mean():.3f}')plt.xlabel('$R^2$ en prueba')plt.ylabel('Frecuencia')plt.title('El $R^2$ cambia según la partición entrenamiento/prueba')plt.legend()plt.tight_layout()plt.show()
Las 30 particiones producen \(R^2\) entre 0.372 y 0.590, con promedio 0.474. La primera partición, 0.513, queda por encima del promedio. El experimento muestra sensibilidad al reparto de estos mismos 442 pacientes; su centro tampoco identifica un desempeño verdadero conocido ni la dispersión equivale a un intervalo de confianza sobre pacientes futuros.
18.5 Validación cruzada k-fold
La validación cruzada resuelve el problema anterior de forma sistemática. La idea del k-fold (validación cruzada en \(k\) bloques): divides los datos en \(k\) bloques (folds) de tamaño similar, aquí, con \(n = 442\) y \(k = 5\), de 88 u 89 observaciones; entrenas con \(k-1\) y evalúas en el que sobra; repites \(k\) veces rotando cuál bloque queda para prueba.
Si \(\text{Error}_j\) es la métrica obtenida al usar el fold\(j\) como conjunto de prueba (un error como el MSE o, como en el código de abajo, el \(R^2\), que en rigor es una medida de ajuste y no un error), el estimador de validación cruzada del desempeño del modelo es el promedio de los \(k\) valores:
Así, cada observación se usa para evaluar exactamente una vez, y en vez de un solo número obtienes un promedio \(\text{CV}_k\) acompañado de su desviación \(s_{\text{CV}}\), que resume qué tanto varía el desempeño según qué datos caen en cada fold. Ese par promedio ± desviación, que ya no depende del azar de una sola partición, es también la base para comparar modelos entre sí en igualdad de condiciones.
kfold = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)scores = cross_val_score(LinearRegression(), X, y, cv=kfold, scoring='r2')print('R2 en cada fold:', np.round(scores, 3))print(f'R2 promedio (validación cruzada): {scores.mean():.3f} 'f'± {scores.std():.3f}')
R2 en cada fold: [0.539 0.47  0.441 0.534 0.493]
R2 promedio (validación cruzada): 0.495 ± 0.037
Los cinco folds de diabetes permiten comparar OLS, Ridge y Lasso con los mismos pacientes reservados. Las diferencias siguen sujetas a variabilidad y a las configuraciones elegidas.
# Misma partición para todos y escalado ajustado dentro de cada fold.modelos = {'Lineal': make_pipeline(StandardScaler(), LinearRegression()),'Ridge': make_pipeline(StandardScaler(), Ridge(alpha=1.0)),'Lasso': make_pipeline(StandardScaler(), Lasso(alpha=0.1, max_iter=20000)),}resultados = {}for nombre, modelo in modelos.items(): s = cross_val_score(modelo, X_cruda, y, cv=kfold, scoring='r2') resultados[nombre] = sprint(f'{nombre:7s} R2 = {s.mean():.3f} ± {s.std():.3f}')for nombre in ['Ridge', 'Lasso']: dif = resultados[nombre] - resultados['Lineal']print(f'{nombre} - Lineal por fold: {np.round(dif, 3)} (promedio {dif.mean():+.3f})')
Los pipelines con escalado dentro de cada fold dan \(R^2\) medio de 0.495 para OLS, 0.495 para Ridge y 0.495 para Lasso. A tres decimales los tres son cercanos; sus desviaciones entre folds son 0.037, 0.038 y 0.039.
Las diferencias pareadas impresas muestran cómo cambia cada configuración respecto a OLS en los mismos pacientes reservados. Una diferencia pequeña, o que cambie de signo, no prueba igualdad; que conserve el signo tampoco establece significancia. Los entrenamientos se solapan y la dispersión de cinco puntuaciones no es automáticamente la incertidumbre del promedio.
Los valores alpha=1.0 y alpha=0.1 son ilustrativos, no optimizados. Para elegirlos utiliza una búsqueda interna como la del capítulo de regularización y evalúa el procedimiento seleccionado con una prueba reservada o un diseño anidado.
18.6 Pipelines de scikit-learn
Antes de seguir comparando modelos, hay una trampa silenciosa que puede sesgar una validación cruzada en cuanto agregues preprocesamiento: dónde y cuándo lo aplicas.
Un Pipeline de scikit-learn encadena varios pasos, típicamente una o más transformaciones (por ejemplo, estandarizar las variables) seguidas de un modelo, en un solo objeto que se comporta exactamente como cualquier estimador: tiene .fit() y .predict(). Por fuera, usar un pipeline se ve igual que usar un modelo solo; por dentro, cada vez que llamas a .fit(), el pipeline ajusta primero las transformaciones y luego el modelo, y cada vez que llamas a .predict(), aplica esas mismas transformaciones (ya ajustadas) antes de predecir.
Importa justo aquí, en la validación cruzada, porque si estandarizas todo tu dataset antes de partirlo en folds, el StandardScaler calcula la media y la desviación estándar usando también las observaciones que en cada fold terminarán en el conjunto de prueba. Es la misma lógica que distingue fit_transform de transform: fit_transform se usa sobre el entrenamiento porque ahí sí “aprende” los parámetros de la transformación, mientras que transform se usa sobre la prueba porque solo aplica lo ya aprendido, sin volver a mirar esos datos. Si mezclas las dos, ajustando el escalador con todo el dataset antes de dividirlo, filtras información del conjunto de prueba al de entrenamiento. Esto se llama fuga de datos (data leakage), y el riesgo es que tu R² de validación cruzada quede artificialmente inflado: que te diga que el modelo generaliza mejor de lo que en realidad generaliza. Con un simple escalado la fuga suele ser pequeña; con pasos que aprenden más de los datos, imputar faltantes, seleccionar variables, codificar categorías usando la respuesta, puede ser grande.
Un pipeline resuelve esto de forma automática: cuando le pasas el pipeline completo a cross_val_score, en cada fold el StandardScaler se ajusta (fit) solo con los datos de entrenamiento de ese fold, y luego se aplica (transform) tanto a ese entrenamiento como al fold de prueba. El preprocesamiento queda encapsulado dentro de cada partición, exactamente donde debe estar.
In a Jupyter environment, please rerun this cell to show the HTML representation or trust the notebook. On GitHub, the HTML representation is unable to render, please try loading this page with nbviewer.org.
Evalúa el pipeline OLS con los mismos cinco folds de kfold. Compara las puntuaciones con la validación anterior para comprobar la invariancia al reescalado en este modelo.
scores_pipeline = cross_val_score(pipeline, X, y, cv=kfold, scoring='r2')print('R2 en cada fold:', np.round(scores_pipeline, 3))print(f'R2 promedio (pipeline + validación cruzada): {scores_pipeline.mean():.3f} 'f'± {scores_pipeline.std():.3f}')
R2 en cada fold: [0.539 0.47  0.441 0.534 0.493]
R2 promedio (pipeline + validación cruzada): 0.495 ± 0.037
OLS obtiene \(R^2\) medio de 0.495 y desviación entre folds de 0.037, tanto con el pipeline como sin él. Con intercepto y diseño de rango completo, un reescalado afín invertible cambia las unidades de los coeficientes y conserva las predicciones salvo diferencias numéricas.
Esa invariancia particular de OLS no justifica ajustar transformaciones con toda la muestra. En la comparación de Ridge y Lasso ya usaste las columnas sin escalar y un escalador dentro de cada fold. La penalización depende de la escala, por lo que su preprocesamiento forma parte del procedimiento que validas.
18.7 El método Bootstrap: intuición
La validación cruzada estima el desempeño; el bootstrap estima la incertidumbre de casi cualquier cantidad. Su idea es simple: como solo tienes una muestra \(\{x_1, x_2, \dots, x_n\}\) de tamaño \(n\), el bootstrap la trata como si fuera la población y genera \(B\) “nuevas” muestras remuestreando con reemplazo:
\[x_1^{*(b)}, x_2^{*(b)}, \dots, x_n^{*(b)} \sim \text{muestreo uniforme con reemplazo de } \{x_1, \dots, x_n\}, \qquad b = 1, \dots, B\]
Para cada remuestreo \(b\) calculas tu estadístico de interés \(\hat{\theta}^{*(b)}\) (por ejemplo, un R² o un coeficiente de regresión). La distribución empírica de \(\hat{\theta}^{*(1)}, \dots, \hat{\theta}^{*(B)}\), la distribución bootstrap, aproxima la distribución muestral real de \(\hat{\theta}\), y su dispersión aproxima la incertidumbre real del estadístico.
La muestra original tiene media 11.5, pero cada remuestreo da una media distinta (11.12, 12.25, 12.62) porque al elegir con reemplazo unos valores se repiten y otros quedan afuera por puro azar. Esa variación de un remuestreo a otro es exactamente lo que el bootstrap va a usar para medir incertidumbre.
18.8 Variación del desempeño fuera de la remuestra
En cada una de 1000 remuestras ajustas un OLS y calculas dos \(R^2\): el aparente, sobre las observaciones usadas en el ajuste, y el de las filas que quedaron fuera (out-of-bag, OOB). El primero es in-sample, y por eso optimista.
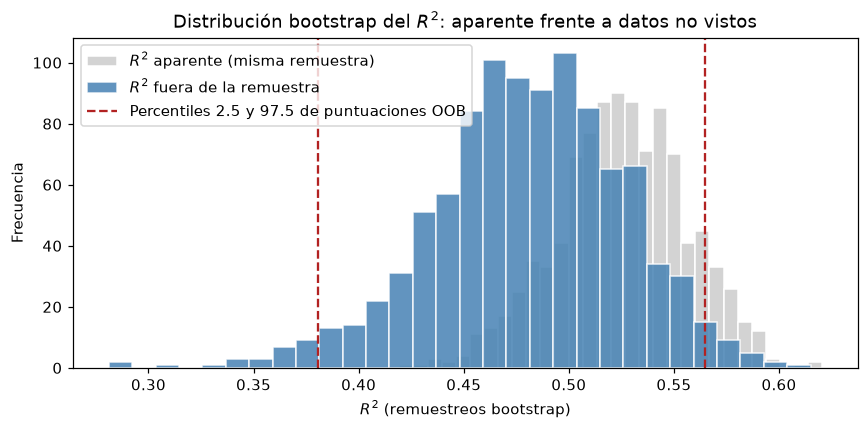
Una remuestra de tamaño \(n\) contiene cerca del 63 % de filas distintas. Los modelos OOB se ajustan con observaciones repetidas y se evalúan en grupos que también cambian. Sus percentiles 2.5 y 97.5 delimitan el 95 % central de las puntuaciones de este experimento. No los leas como un intervalo de confianza del desempeño del modelo final entrenado con los 442 pacientes: cambian el modelo, la prueba y el denominador del \(R^2\).
En la sección siguiente construyes un intervalo percentil para un estadístico con un objetivo definido: la pendiente de la regresión simple sobre bmi.
Xv = X.valuesyv = y.valuesn =len(yv)B =1000# número de remuestreos bootstrapr2_aparente = np.empty(B) # R2 sobre la misma remuestra con la que se entrenó (optimista)r2_boot = np.empty(B) # R2 sobre las observaciones que quedaron fuera de la remuestrafor b inrange(B): idx = rng_oob.integers(0, n, size=n) # índices con reemplazo fuera = np.setdiff1d(np.arange(n), idx) # observaciones que no salieron en esta remuestra m = LinearRegression().fit(Xv[idx], yv[idx]) r2_aparente[b] = r2_score(yv[idx], m.predict(Xv[idx])) r2_boot[b] = r2_score(yv[fuera], m.predict(Xv[fuera]))ic_bajo, ic_alto = np.percentile(r2_boot, [2.5, 97.5])print(f'R2 aparente (sobre la propia remuestra): media = {r2_aparente.mean():.3f}')print(f'R2 fuera de la remuestra: media = {r2_boot.mean():.3f}')print(f'Rango central 95% de puntuaciones OOB (descriptivo): [{ic_bajo:.3f}, {ic_alto:.3f}]')
R2 aparente (sobre la propia remuestra): media = 0.526
R2 fuera de la remuestra:                media = 0.481
Rango central 95% de puntuaciones OOB (descriptivo): [0.381, 0.565]
Dibuja las 1000 puntuaciones aparentes y OOB en histogramas superpuestos. Las dos líneas verticales marcan percentiles descriptivos de r2_boot.
plt.figure(figsize=(8, 4))plt.hist(r2_aparente, bins=30, color='lightgray', edgecolor='white', label='$R^2$ aparente (misma remuestra)')plt.hist(r2_boot, bins=30, color='steelblue', edgecolor='white', alpha=0.85, label='$R^2$ fuera de la remuestra')plt.axvline(ic_bajo, color='firebrick', linestyle='--', label='Percentiles 2.5 y 97.5 de puntuaciones OOB')plt.axvline(ic_alto, color='firebrick', linestyle='--')plt.xlabel('$R^2$ (remuestreos bootstrap)')plt.ylabel('Frecuencia')plt.title('Distribución bootstrap del $R^2$: aparente frente a datos no vistos')plt.legend()plt.tight_layout()plt.show()
El \(R^2\) aparente medio es 0.526, frente a 0.481 fuera de la remuestra. La diferencia ilustra el optimismo de evaluar con las filas del ajuste. Los percentiles OOB [0.381, 0.565] describen la variación conjunta de los modelos remuestreados y de sus grupos de evaluación.
El promedio OOB de 0.481, el de CV de 0.495 y el de las 30 particiones de 0.474 corresponden a tamaños y esquemas de entrenamiento distintos. Su proximidad es informativa dentro de este ejemplo, pero no los convierte en estimadores idénticos ni valida la cobertura de un intervalo para el desempeño final.
18.9 Bootstrap para un coeficiente (y su contraste con statsmodels)
El bootstrap sirve para muchas otras estimaciones, incluido un coeficiente de regresión. Recuerda que el estimador de mínimos cuadrados ordinarios (OLS), en notación matricial, es:
\[\hat{\beta} = (X^T X)^{-1} X^T y\]
donde \(X\) es la matriz de diseño (los predictores más una columna de unos para el intercepto) y \(y\) es el vector de la variable de respuesta. Bajo los supuestos clásicos de OLS (errores con media condicional cero, varianza constante \(\sigma^2\) y ausencia de correlación; la normalidad permite el intervalo t exacto, mientras que en muestras grandes se utiliza una aproximación bajo regularidad), el error estándar de cada coeficiente \(\hat{\beta}_j\) permite construir un intervalo de confianza analítico:
donde \(\text{EE}(\hat{\beta}_j)\) es el error estándar del coeficiente y \(t_{n-p,\,0.975}\) es el cuantil 97.5 de una distribución t de Student con \(n-p\) grados de libertad (\(n\) observaciones, \(p\) parámetros estimados). Esta es justo la fórmula que usa statsmodels por debajo. Para que la comparación sea fácil de seguir, usas una regresión simple de la progresión de la enfermedad sobre una sola variable, el índice de masa corporal (bmi); su coeficiente no es el mismo que tendría esa variable dentro del modelo con las 10 variables. Estimas su incertidumbre con bootstrap y la comparas con este intervalo analítico.
Remuestreas pares completos \((bmi_i,y_i)\), manteniendo fija la unidad en que está codificado bmi. El intervalo percentil aproximado es \([q_{0.025}(\hat\beta^*),q_{0.975}(\hat\beta^*)]\). Su cobertura requiere observaciones independientes, una muestra representativa y condiciones de regularidad; 1000 remuestras reducen el error de simulación, pero no reparan sesgos de muestreo ni dependencia entre pacientes.
variable ='bmi'x1 = X[[variable]].valuescoef_boot = np.empty(B)for b inrange(B): idx = rng_coef.integers(0, n, size=n) m = LinearRegression().fit(x1[idx], yv[idx]) coef_boot[b] = m.coef_[0]ic_b_bajo, ic_b_alto = np.percentile(coef_boot, [2.5, 97.5])print(f'Coeficiente de {variable} (bootstrap): media = {coef_boot.mean():.1f}')print(f'IC 95% por bootstrap: [{ic_b_bajo:.1f}, {ic_b_alto:.1f}]')
Coeficiente de bmi (bootstrap): media = 953.2
IC 95% por bootstrap:  [843.8, 1061.3]
Ajusta la regresión simple de bmi con statsmodels y compara su pendiente e intervalos con las 1000 remuestras. HC3 calcula otra covarianza para los mismos coeficientes.
X_sm = sm.add_constant(x1)ols = sm.OLS(yv, X_sm).fit()ic_sm = ols.conf_int(alpha=0.05)[1] # fila 1 = pendiente (fila 0 = intercepto)print(f'Coeficiente de {variable} (statsmodels): {ols.params[1]:.1f}')print(f'IC 95% analítico: [{ic_sm[0]:.1f}, {ic_sm[1]:.1f}]')# Errores estándar: dispersión bootstrap frente a la fórmula clásicaprint(f'Error estándar: bootstrap = {coef_boot.std(ddof=1):.1f} | fórmula = {ols.bse[1]:.1f}')# Intervalo con errores estándar robustos a varianza no constante (HC3)ic_hc3 = ols.get_robustcov_results(cov_type='HC3').conf_int(alpha=0.05)[1]print(f'IC 95% robusto (HC3): [{ic_hc3[0]:.1f}, {ic_hc3[1]:.1f}]')
Coeficiente de bmi (statsmodels): 949.4
IC 95% analítico:      [826.6, 1072.3]
Error estándar: bootstrap = 55.9 | fórmula = 62.5
IC 95% robusto (HC3):  [836.7, 1062.2]
Para la pendiente de bmi, el intervalo percentil bootstrap es [843.8, 1061.3], frente al clásico de statsmodels [826.6, 1072.3]. La media bootstrap es 953.2 y la pendiente OLS de la muestra es 949.4. Ambos describen la asociación de una regresión simple en la unidad fija de bmi, no un efecto causal.
HC3 produce [836.7, 1062.2]. La proximidad de intervalos no diagnostica homoscedasticidad ni valida todos los supuestos. Sus diferencias pueden deberse al método de covarianza, al remuestreo y a la muestra. El bootstrap de pares exige observaciones independientes y representativas y condiciones de regularidad; no corrige automáticamente dependencia, sesgo de selección o especificación incorrecta.
18.10 Por qué importa en IA y machine learning
Casi toda decisión sobre un modelo de aprendizaje automático (qué algoritmo usar, qué hiperparámetro elegir, si desplegar) se toma comparando métricas, y este capítulo muestra cuánto se mueven esas métricas sin que el modelo cambie:
Las tablas de resultados que comparan modelos con una sola partición pueden ordenar mal: aquí, la misma regresión dio \(R^2\) entre 0.372 y 0.590 según qué 133 pacientes quedaron en la prueba.
La búsqueda de hiperparámetros (GridSearchCV, el capítulo de regularización) usa la validación cruzada de este capítulo; el promedio de cinco folds (0.495) y su desviación (0.037) son la información con la que elige.
La fuga de datos por preprocesar antes de partir es uno de los errores más frecuentes en proyectos de IA, y el Pipeline es la herramienta estándar para evitarlo, sobre todo con pasos que aprenden más que una media, como la imputación o la selección de variables.
La incertidumbre de una métrica o de un coeficiente se reporta cada vez más junto al valor puntual; el bootstrap de pares es la forma general de aproximarla cuando no hay fórmula, como el intervalo [843.8, 1061.3] para la pendiente de bmi.
Los cambios de condiciones, como los del caso de Zillow, no se corrigen con más remuestreo: piden un diseño de evaluación que reproduzca el uso, por ejemplo respetando el orden temporal.
18.11 Preguntas de comprensión
El \(R^2\) de entrenamiento y el de prueba del mismo modelo coinciden a tres decimales (0.513). ¿Qué te dice eso sobre si el modelo memoriza los datos de entrenamiento, y qué te diría una brecha grande?
¿Cuál de las cuatro métricas usarías para explicar el resultado a alguien no técnico, cuál no conviene interpretar directamente, y qué te dice que el RMSE (53.0) sea mayor que el MAE (42.3)?
Si solo hubieras hecho una partición y te hubiera tocado el \(R^2\) más bajo (0.372) o el más alto (0.590), ¿qué conclusión equivocada habrías sacado sobre el modelo?
Los tres pipelines usan los mismos 5 folds de diabetes. ¿Qué aportan las diferencias pareadas por fold y qué quedaría pendiente para estudiar su incertidumbre?
El rango central de las puntuaciones OOB es [0.381, 0.565]. ¿Por qué no es un intervalo de confianza del desempeño del modelo final entrenado con los 442 pacientes?
Para la pendiente de bmi, ¿qué revisarías si los intervalos bootstrap y de statsmodels fueran muy distintos?
TipOrientaciones
La coincidencia describe una partición: no aparece una brecha apreciable, pero eso no demuestra ausencia de sobreajuste, porque con otros 309 y 133 pacientes el resultado cambia. Una brecha grande motivaría revisar complejidad, representatividad y preprocesamiento, sin atribuirla por sí sola a una causa.
El MAE o el RMSE, que están en unidades del índice de progresión; el MSE (2 804.9) está en unidades al cuadrado y sirve como criterio de optimización. Que el RMSE supere al MAE indica que los errores grandes pesan, sin probar normalidad ni descartar casos extremos.
Habrías tomado una partición afortunada o desafortunada por el desempeño del modelo. Los dos extremos vienen de repartos de los mismos 442 pacientes, y ninguno identifica por sí solo el desempeño poblacional; el promedio de las 30 particiones fue 0.474.
Muestran cómo cambia cada configuración respecto de OLS en los mismos pacientes reservados, que es una comparación más justa que la de promedios sueltos. Una diferencia pequeña o que cambia de signo no prueba igualdad, y los entrenamientos se solapan entre folds, así que estudiar su incertidumbre requiere repetir la validación cruzada o un diseño específico.
Porque en cada remuestra cambian el conjunto de ajuste (con filas repetidas), el modelo y el grupo de evaluación OOB. El rango describe ese experimento; no tiene una cobertura demostrada para el desempeño de un único modelo entrenado con todos los datos.
Los supuestos de la regresión (varianza constante, independencia), la estabilidad del remuestreo (más remuestras), el tamaño de muestra y la presencia de datos influyentes. Ningún método merece confianza automática; aquí el bootstrap dio [843.8, 1061.3], el clásico [826.6, 1072.3] y HC3 [836.7, 1062.2].
18.12 Referencias para profundizar
Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. El artículo que introdujo el bootstrap.
Efron, B. y Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall. Intervalos percentiles y bootstrap de pares en regresión.
Efron, B. y Tibshirani, R. (1997). Improvements on cross-validation: The .632+ bootstrap method. Journal of the American Statistical Association, 92(438), 548–560. Por qué las puntuaciones fuera de la remuestra no equivalen a las de validación cruzada.
Davison, A. C. y Hinkley, D. V. (1997). Bootstrap Methods and their Application. Cambridge University Press.
Efron, B., Hastie, T., Johnstone, I. y Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. Origen del conjunto Diabetes.
Cada procedimiento de evaluación responde una pregunta distinta, y su dispersión solo se interpreta dentro del diseño que la produjo.
Una sola prueba da cifras en unidades del problema (MAE de 42.3 y RMSE de 53.0) y un \(R^2\) de 0.513 que describe esa partición.
Las 30 particiones de los mismos pacientes dieron \(R^2\) entre 0.372 y 0.590: una sola partición puede ser afortunada o desafortunada.
La validación cruzada de cinco folds dio 0.495 ± 0.037 y permitió comparar OLS, Ridge y Lasso con los mismos bloques, con diferencias pareadas de una milésima.
El preprocesamiento va dentro del Pipeline; OLS es invariante al reescalado (0.495 con y sin él), pero los modelos penalizados no.
Las puntuaciones fuera de la remuestra ([0.381, 0.565]) describen un experimento, no un intervalo del modelo final.
Para la pendiente de bmi, el bootstrap de pares dio [843.8, 1061.3], cerca del intervalo clásico [826.6, 1072.3] y del HC3 [836.7, 1062.2], bajo supuestos de independencia y representatividad.
18.14 Puente hacia los siguientes capítulos
El capítulo de validación cruzada k-fold recorre las particiones paso a paso: cómo se dibujan, por qué se barajan, cómo elegir \(k\) y qué no esperar de la dispersión entre folds. Cuando los datos tienen orden temporal, como los precios del caso de Zillow, el capítulo de series temporales reemplaza las particiones al azar por evaluaciones que respetan ese orden.